Vai al contenuto
Giallo

Modelli e strumenti AI

Cosa sono e come si usano i principali modelli e strumenti di intelligenza artificiale, spiegati per chi li deve usare in azienda.

113 guide in questa categoria
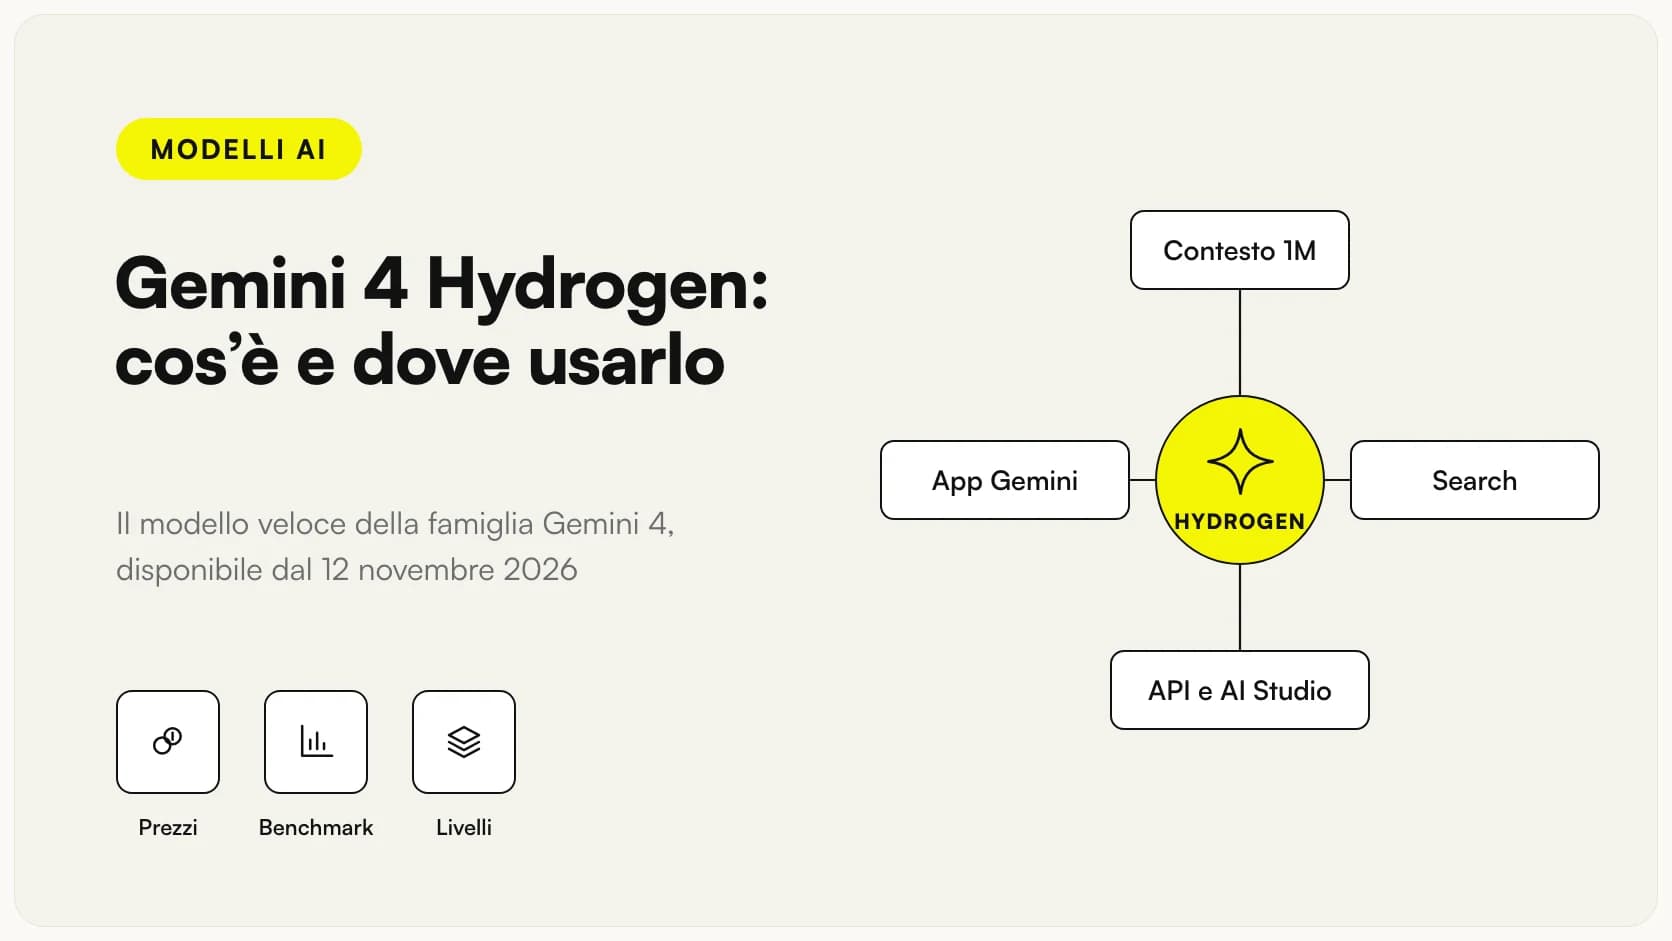
Gemini 4 Hydrogen al centro di un diagramma che lo collega a contesto da 1 milione di token, app Gemini, Google Search, API e AI StudioGemini 4 Hydrogen: cos’è, come funziona e dove usarloGemini 4 Hydrogen cos’è: il modello veloce di Google del 12 novembre 2026. Specifiche, disponibilità per superficie, prezzo, Search e Italia.
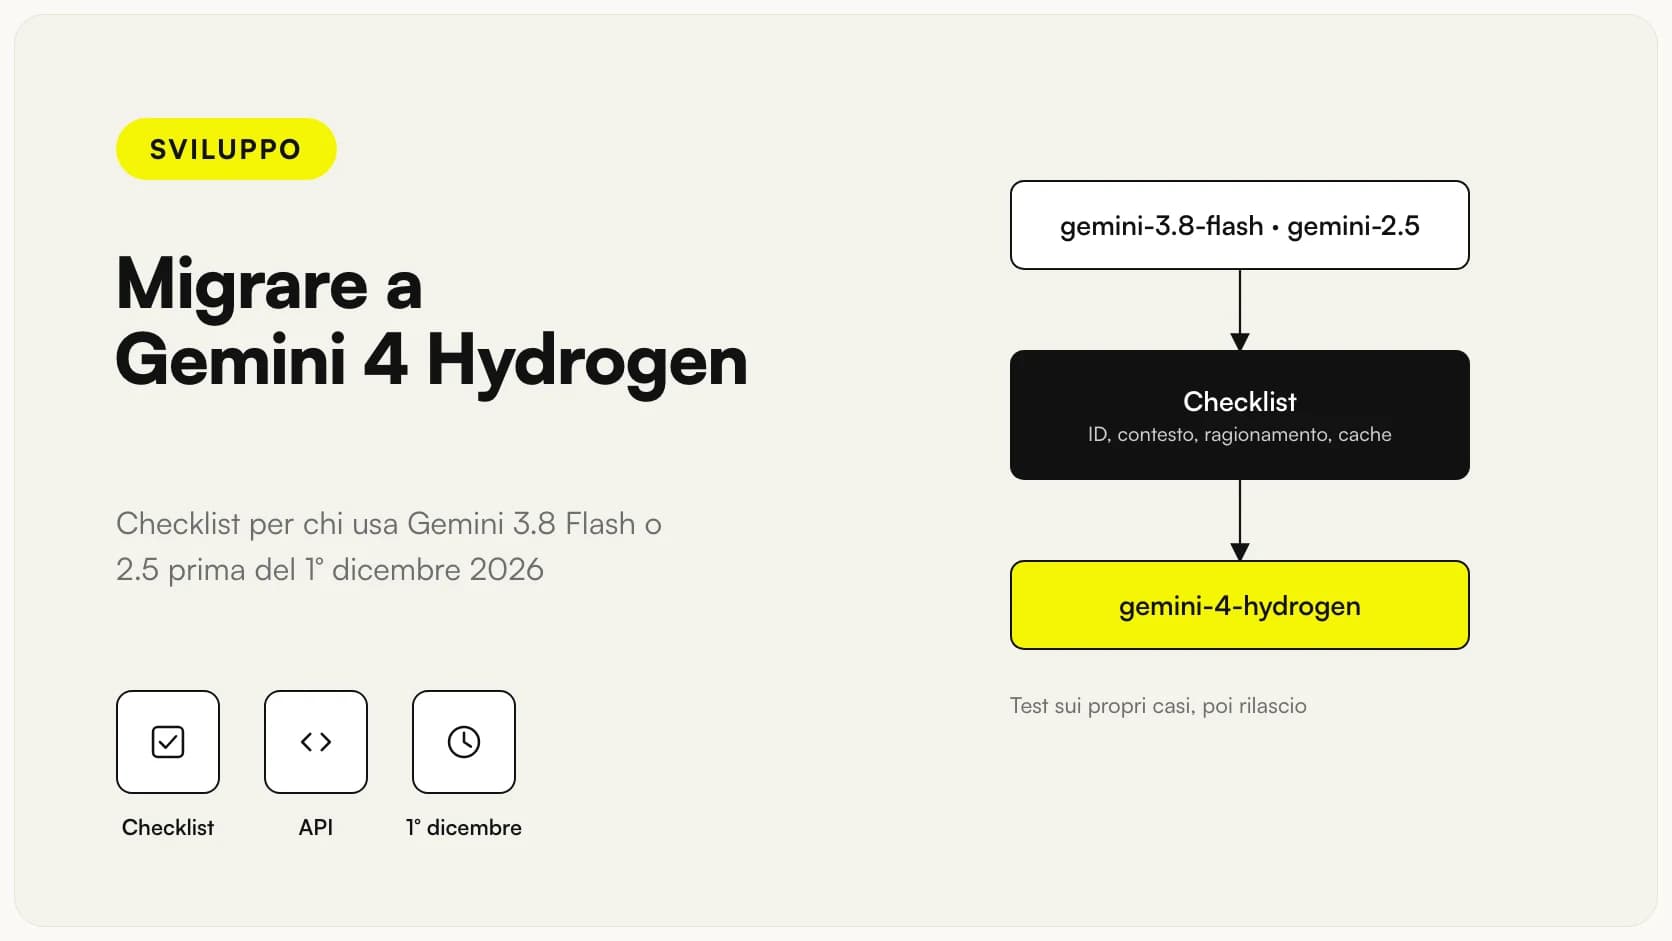
Diagramma per migrare a Gemini 4 Hydrogen: da gemini-3.8-flash e gemini-2.5 alla checklist e poi a gemini-4-hydrogenMigrare a Gemini 4 Hydrogen: checklist da Gemini 3.8 Flash e 2.5 prima del 1° dicembreCome migrare a Gemini 4 Hydrogen da Gemini 3.8 Flash e 2.5: parametri da cambiare, piano di prova, ritorno indietro e cosa succede il 1° dicembre 2026.
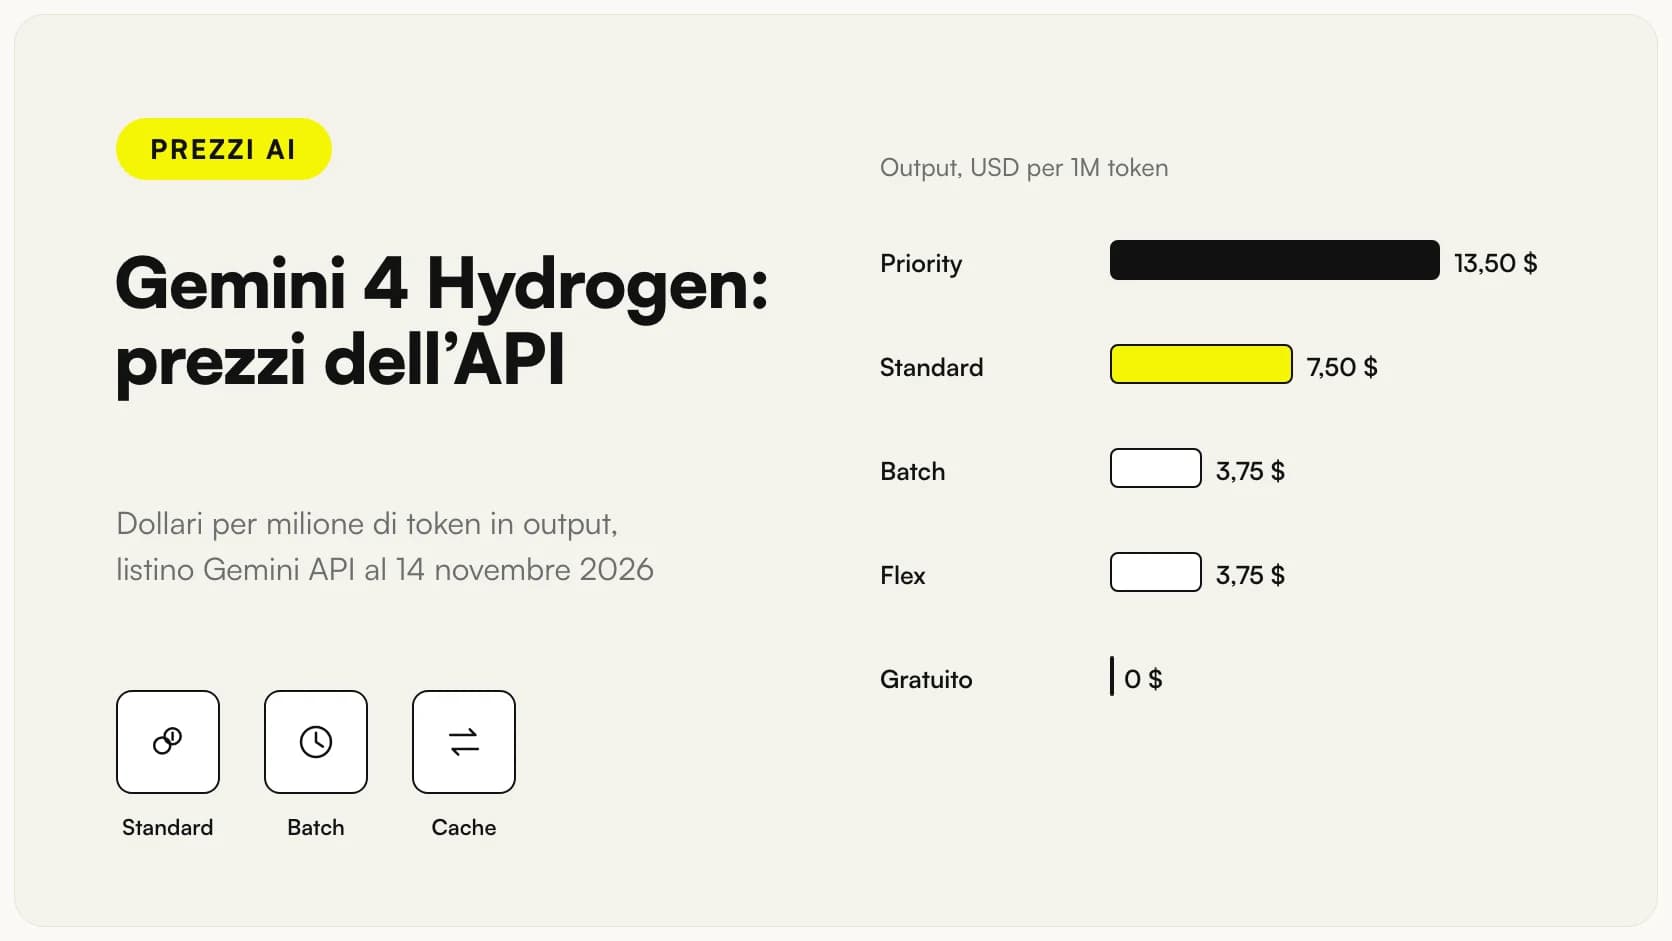
Grafico dei Gemini 4 Hydrogen prezzi: costo dell’output per milione di token nei livelli Priority, Standard, Batch, Flex e gratuitoGemini 4 Hydrogen prezzi: quanto costa l’API e come stimare la spesaGemini 4 Hydrogen prezzi: 1,50 $ in input e 7,50 $ in output per milione di token, Batch a metà prezzo, esempi di calcolo e tetti di spesa.
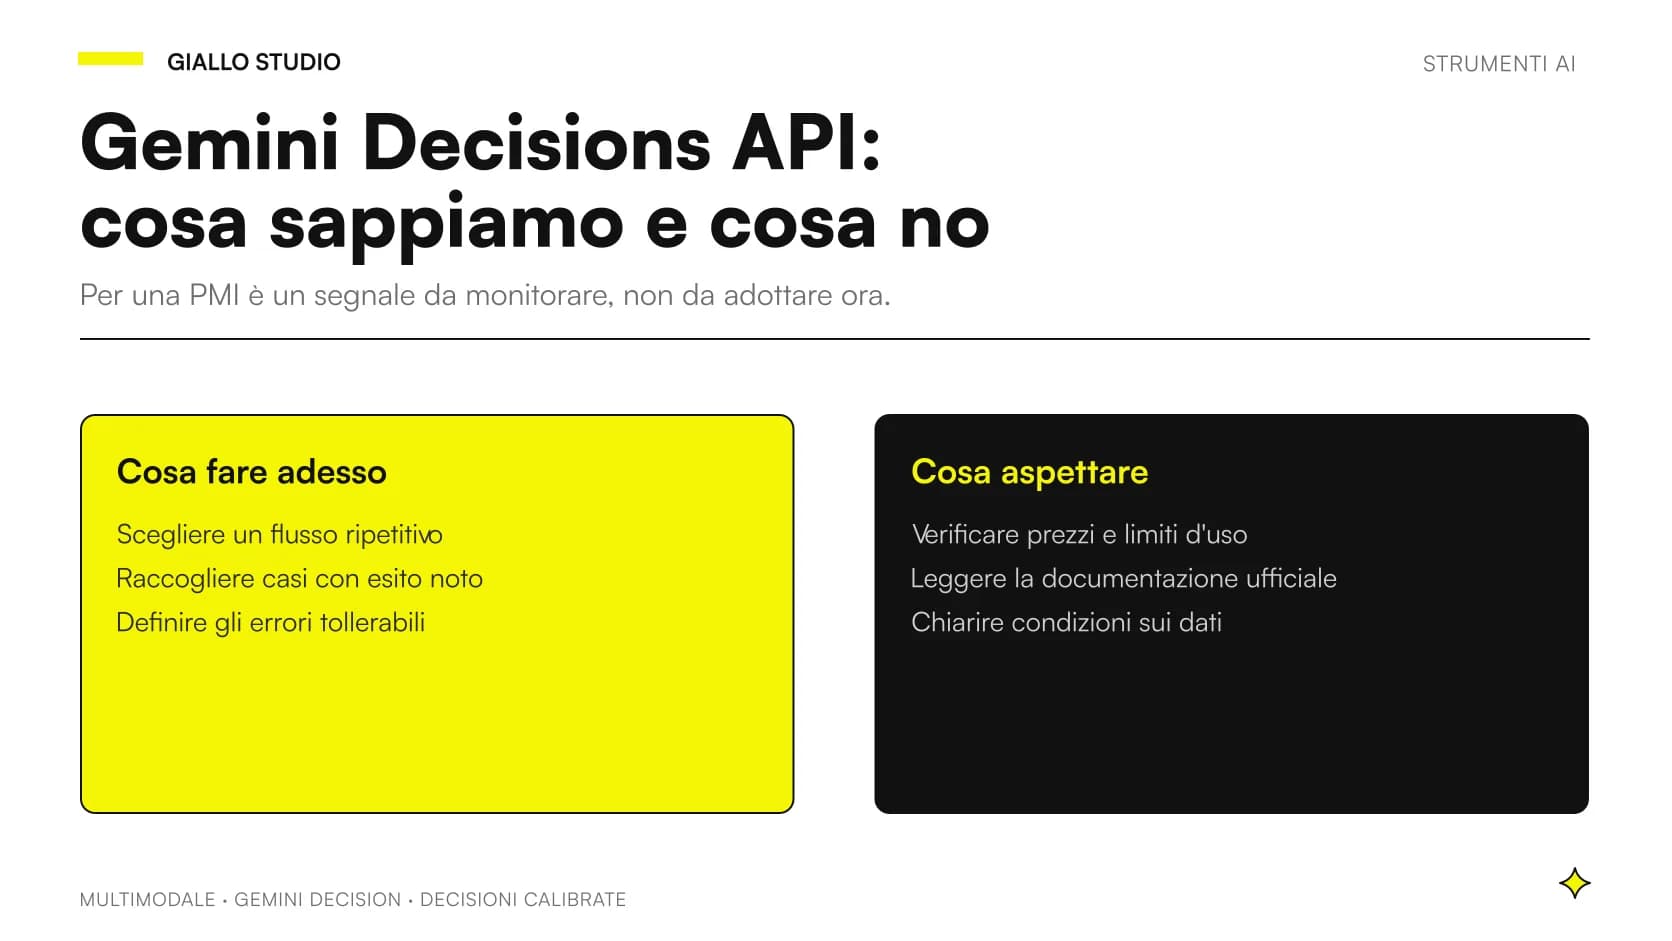
Schema di una API che riceve testo, immagini e documenti e restituisce una decisione da verificareGemini Decisions API: cos'è e cosa può cambiare per una PMIGoogle annuncia la Gemini Decisions API per decisioni multimodali veloci e calibrate. Cosa è noto, cosa manca e come prepararsi senza fretta.
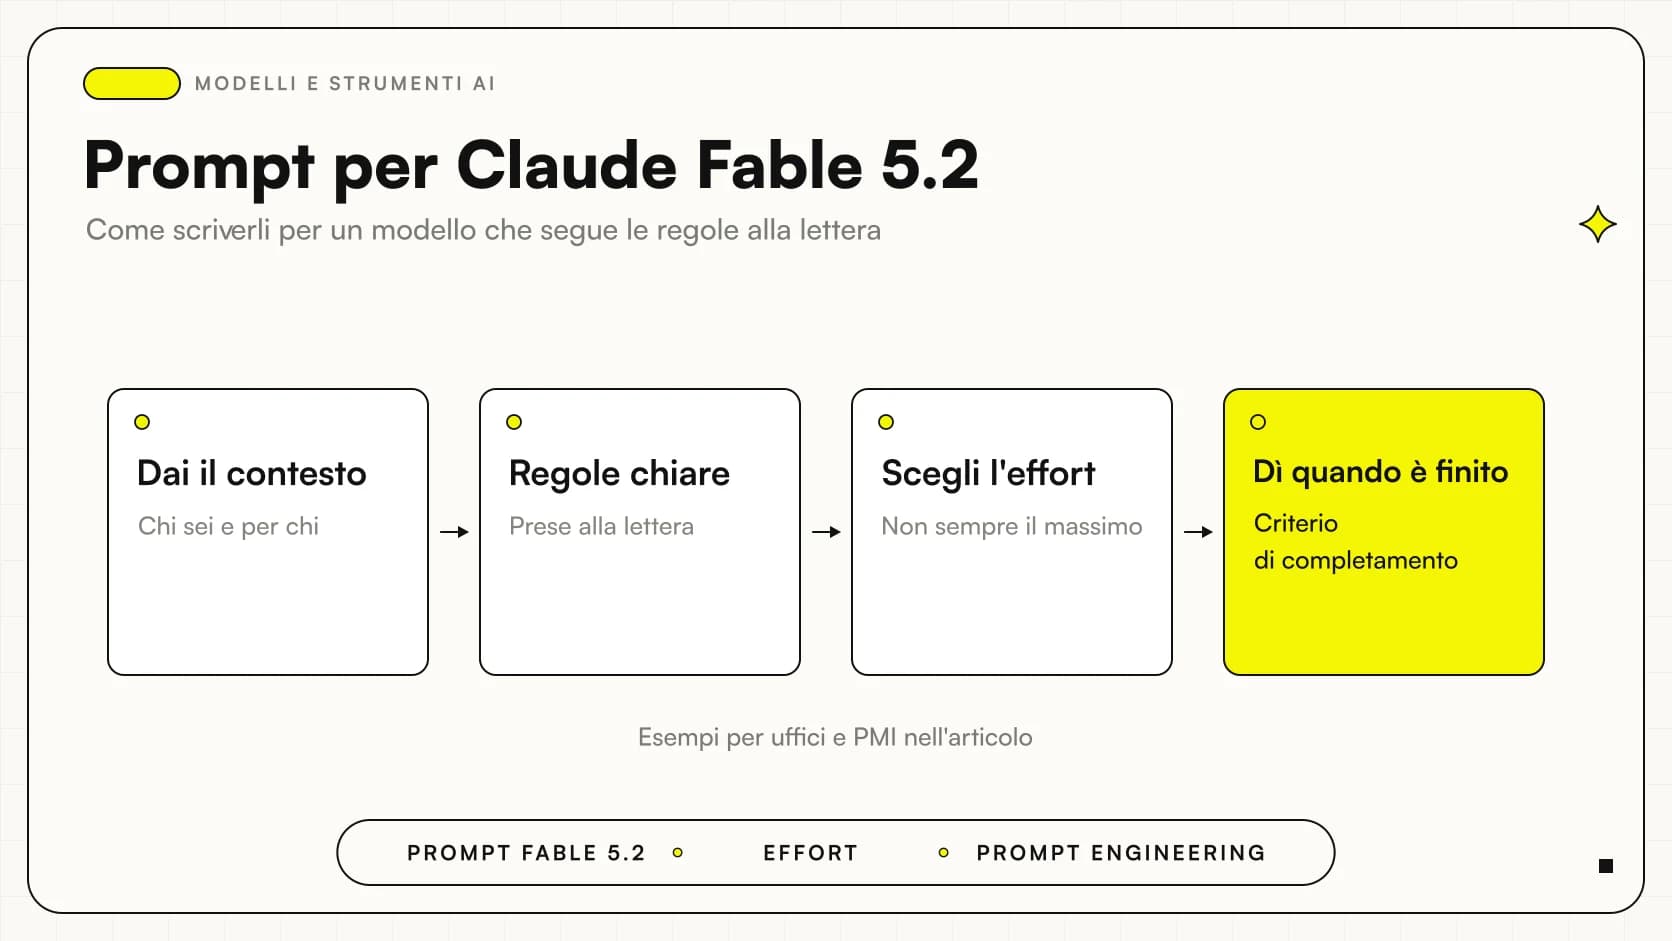
Prompt Claude Fable 5.2: schema di un prompt con effort, linea di arrivo e regole di stilePrompt Claude Fable 5.2: come scriverli e 5 esempi prontiCome scrivere un prompt Claude Fable 5.2: effort, linea di arrivo, regole di stile e 5 esempi per un ufficio HR, secondo la guida ufficiale di Anthropic.
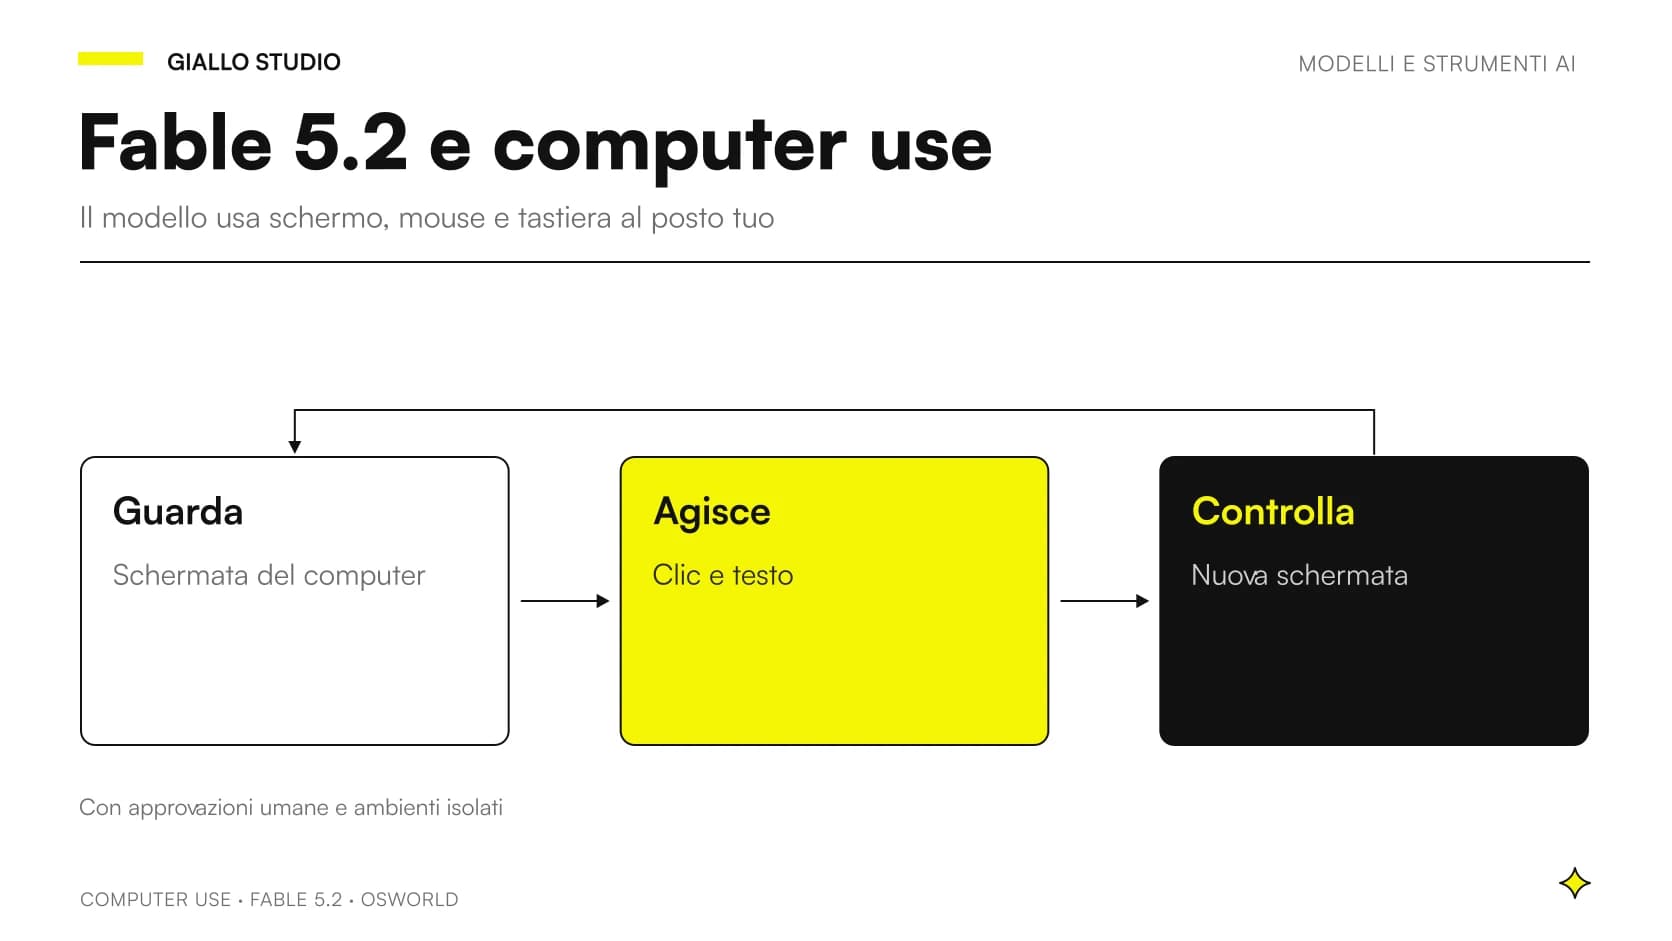
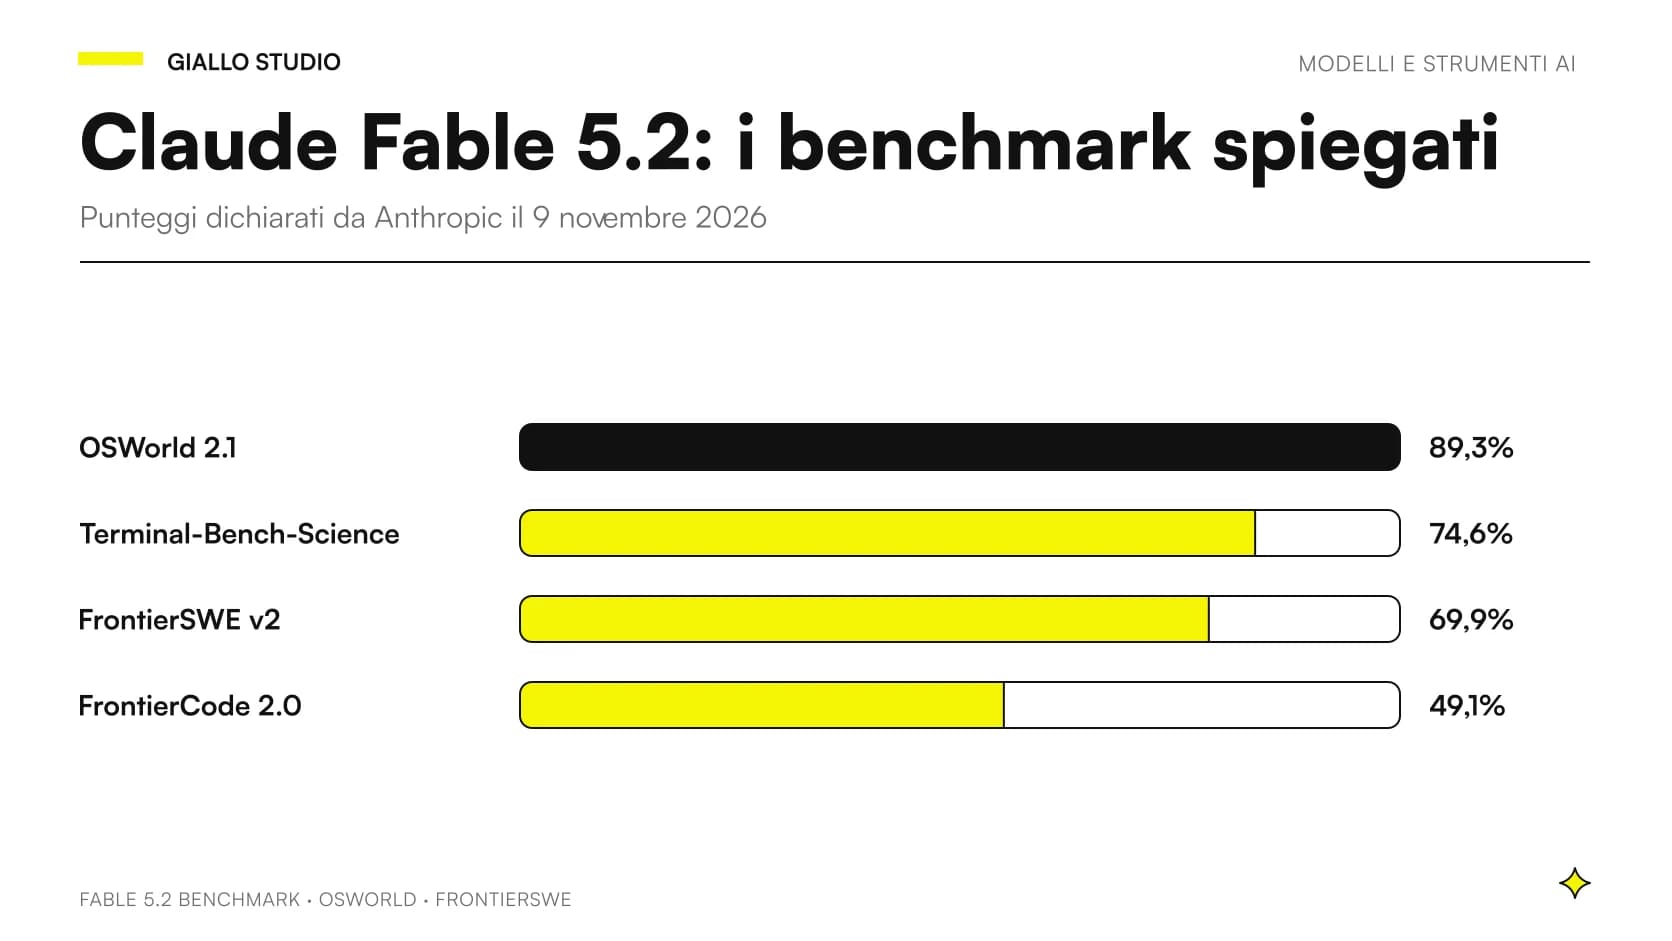
Claude computer use con Fable 5.2: il modello guarda lo schermo, propone un'azione, una persona approva, il gestionale esegue in un ambiente isolatoClaude computer use con Fable 5.2: usare il PC da soloClaude computer use con Fable 5.2: OSWorld 2.1 all'89,3%, nuovo computer_toolset_20260801, errore 400 sul vecchio tool. Cosa automatizzare e con quali cautele.
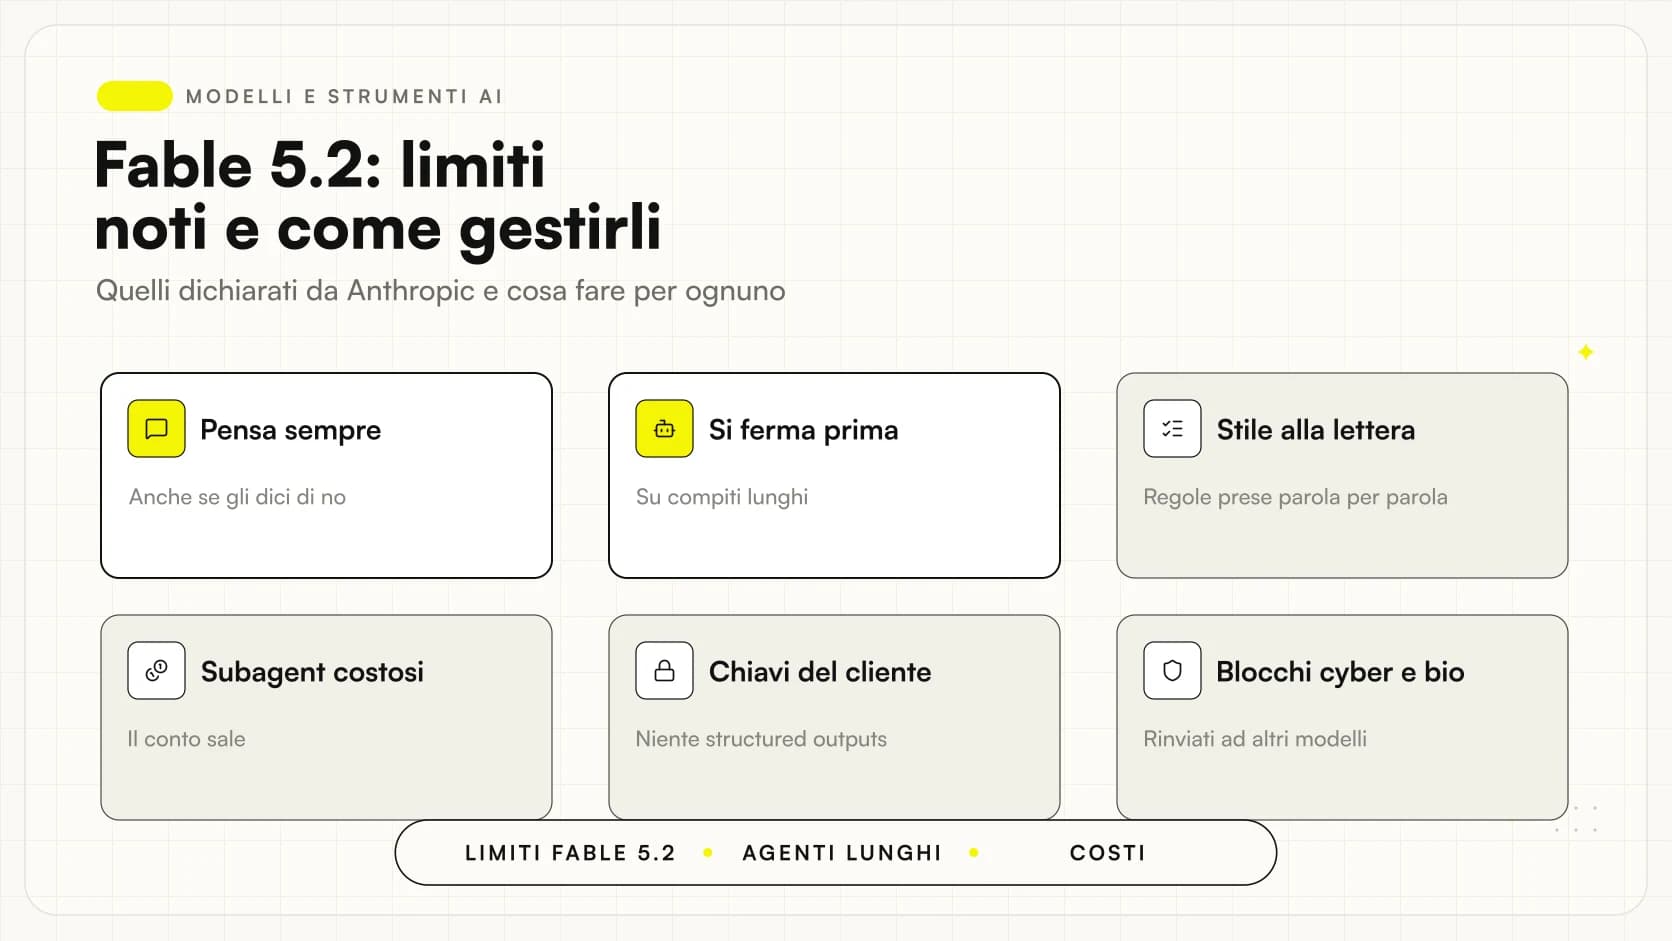
Claude Fable 5.2 limiti: diagramma dei comportamenti noti del modello e delle contromisure, dal pensiero sempre attivo ai blocchi cyber e biologiaClaude Fable 5.2 limiti: quelli noti e come aggirarliClaude Fable 5.2 limiti dichiarati da Anthropic: pensa anche se gli dici di no, si ferma prima, subagent costosi. Per ognuno, cosa fare in pratica.
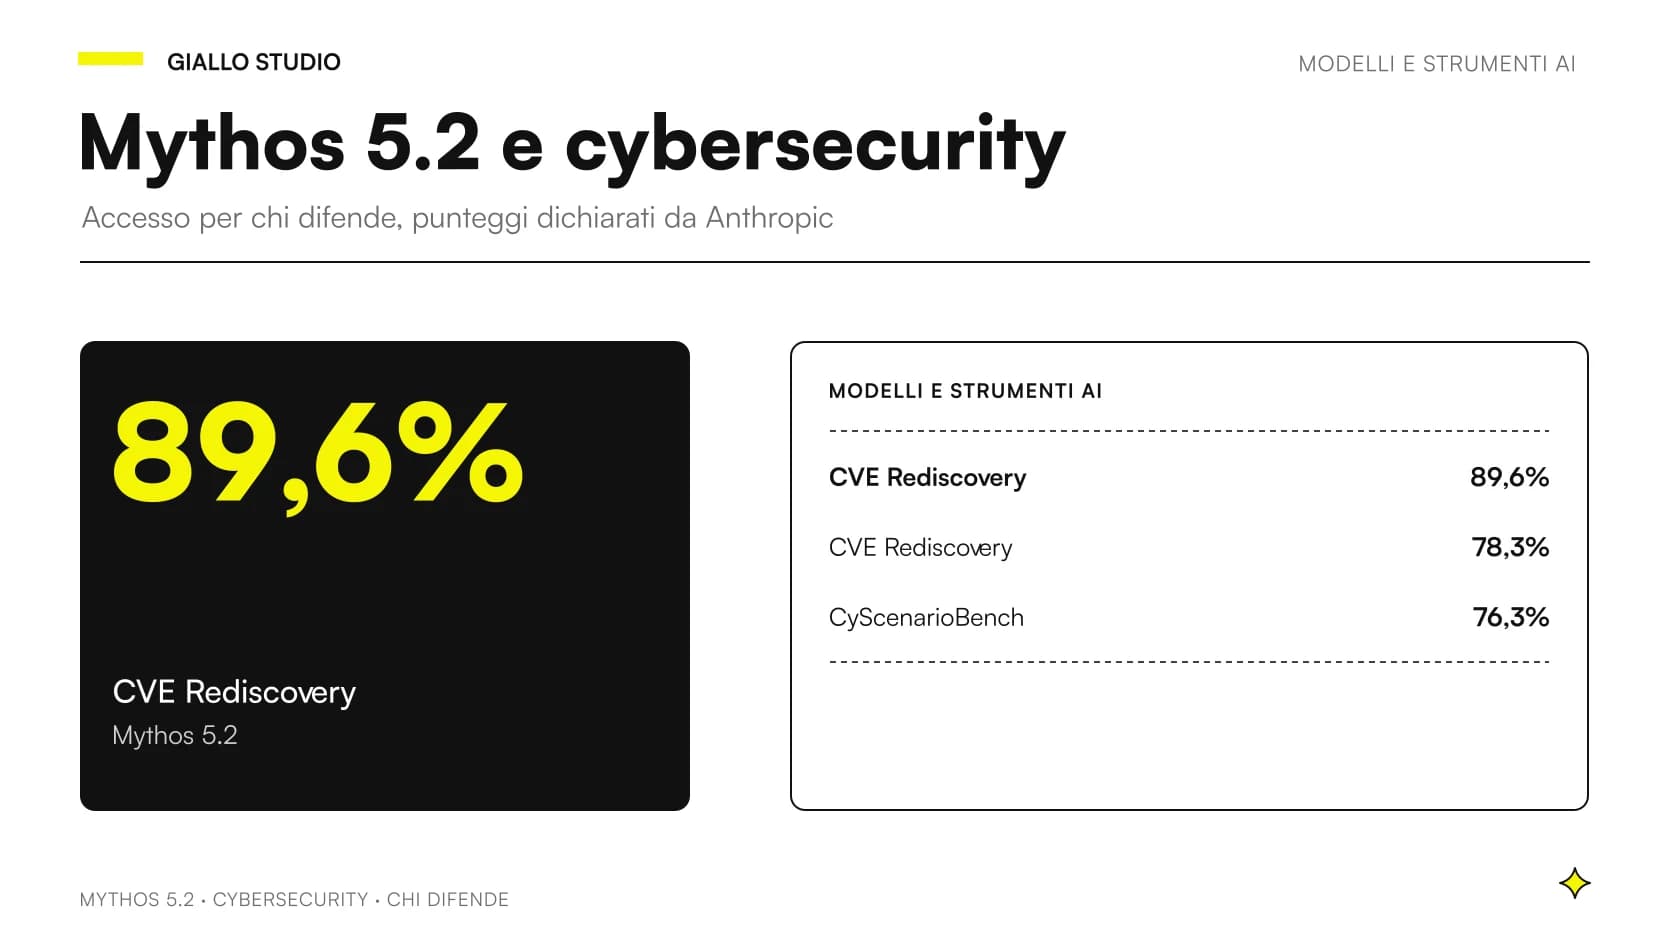
Claude Mythos cybersecurity: percorso di accesso al Cyber Verification Program e Claude Security per chi difendeClaude Mythos cybersecurity: chi può usarlo e cosa fa davveroClaude Mythos cybersecurity: cos'è il Cyber Verification Program, chi ottiene l'accesso a Mythos 5.2, cosa dicono i benchmark e cosa fare se sei una PMI.
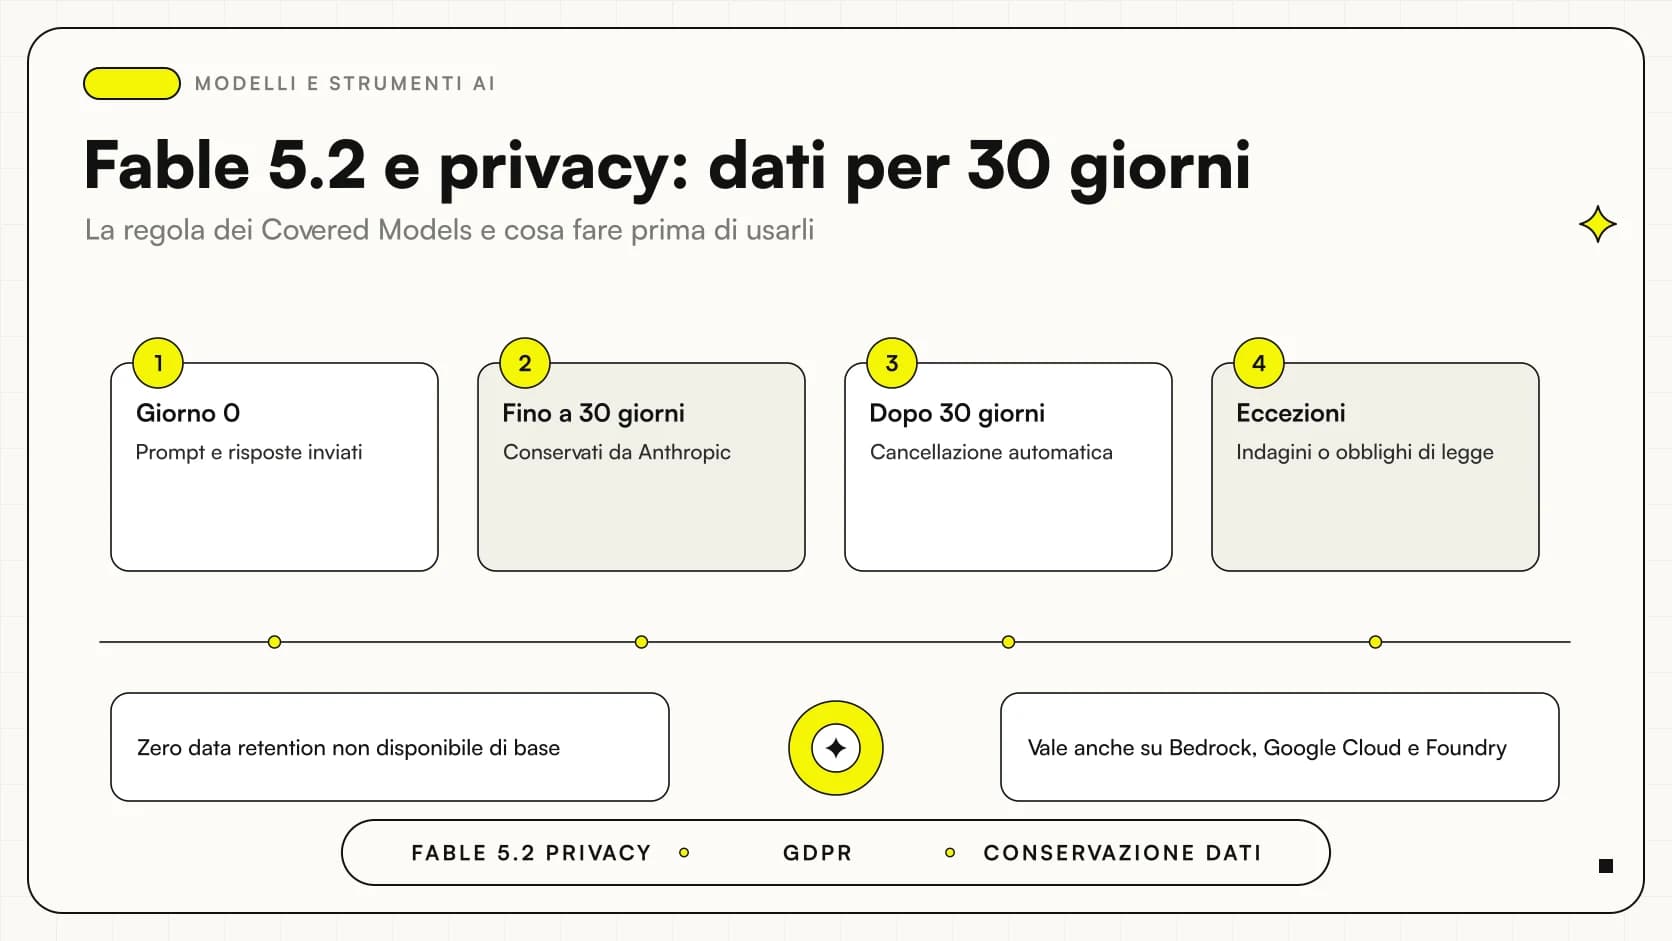
Fable 5.2 privacy: schema della conservazione di 30 giorni di prompt e risposte e delle domande da fare al responsabile datiFable 5.2 privacy: dati conservati 30 giorni e cosa fare in una PMIFable 5.2 privacy: Anthropic conserva prompt e risposte per almeno 30 giorni e niente zero data retention. Cosa significa per il GDPR di una PMI.
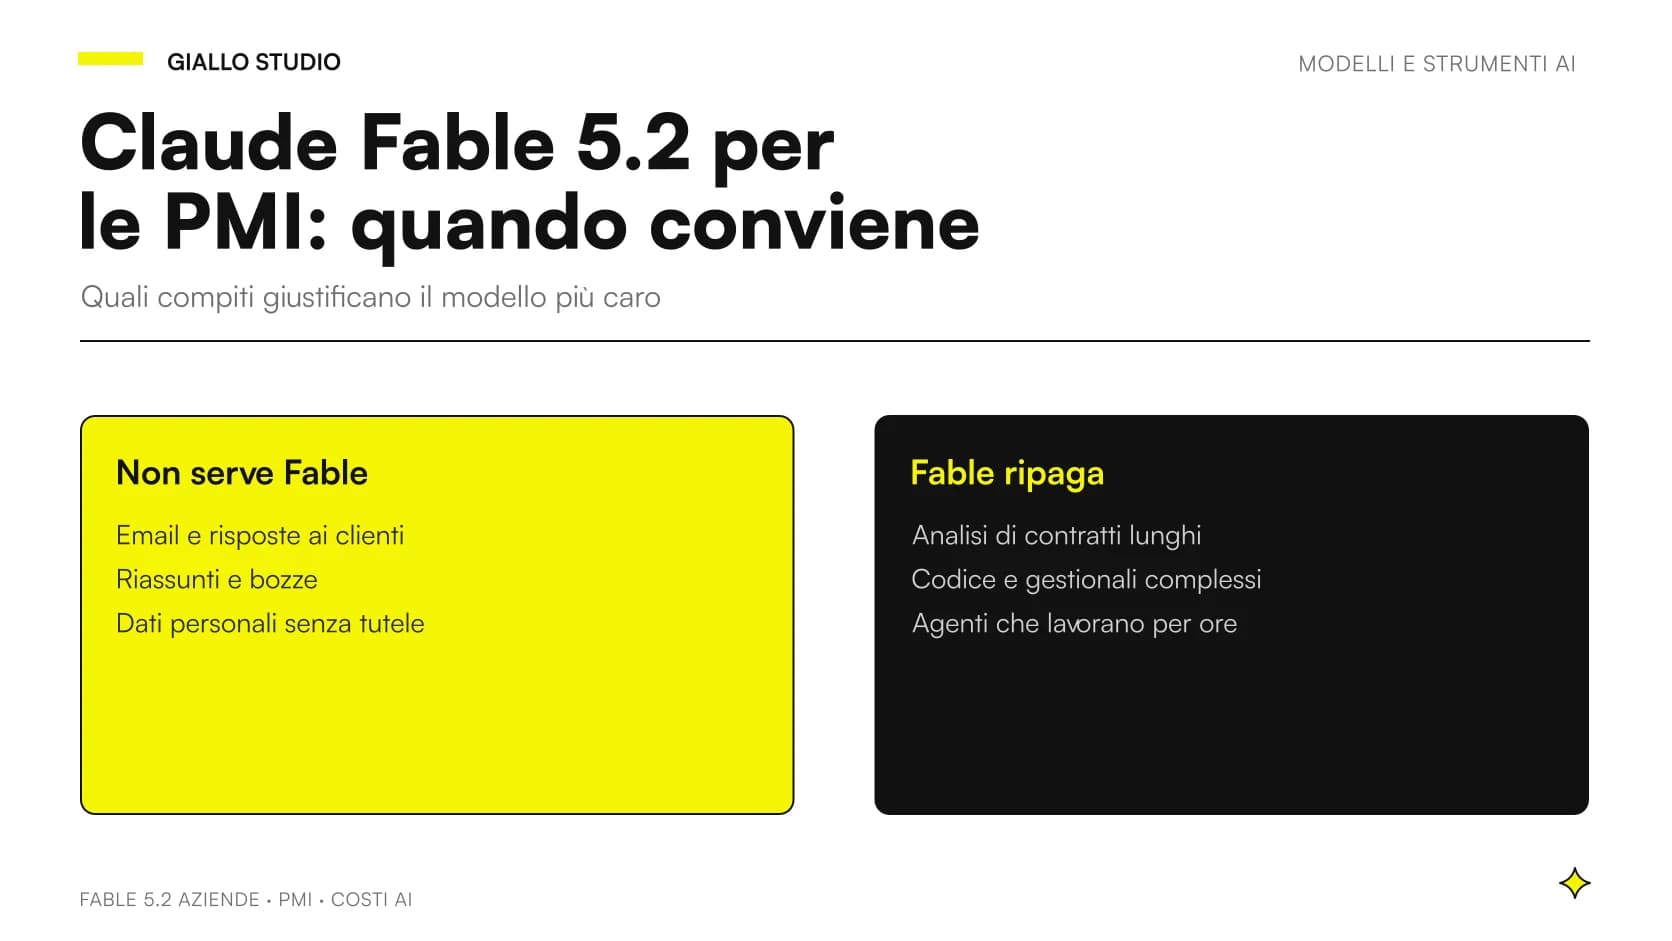
Claude Fable 5.2 per le aziende: diagramma che assegna i compiti di una PMI a Fable, Opus, Sonnet e Haiku in base a difficoltà e costoClaude Fable 5.2 aziende: quando conviene alle PMIClaude Fable 5.2 aziende: quali compiti giustificano 8/40 $ per milione di token, quali restano a Opus 5.5 o Sonnet, e come adottarlo in 4 passi.
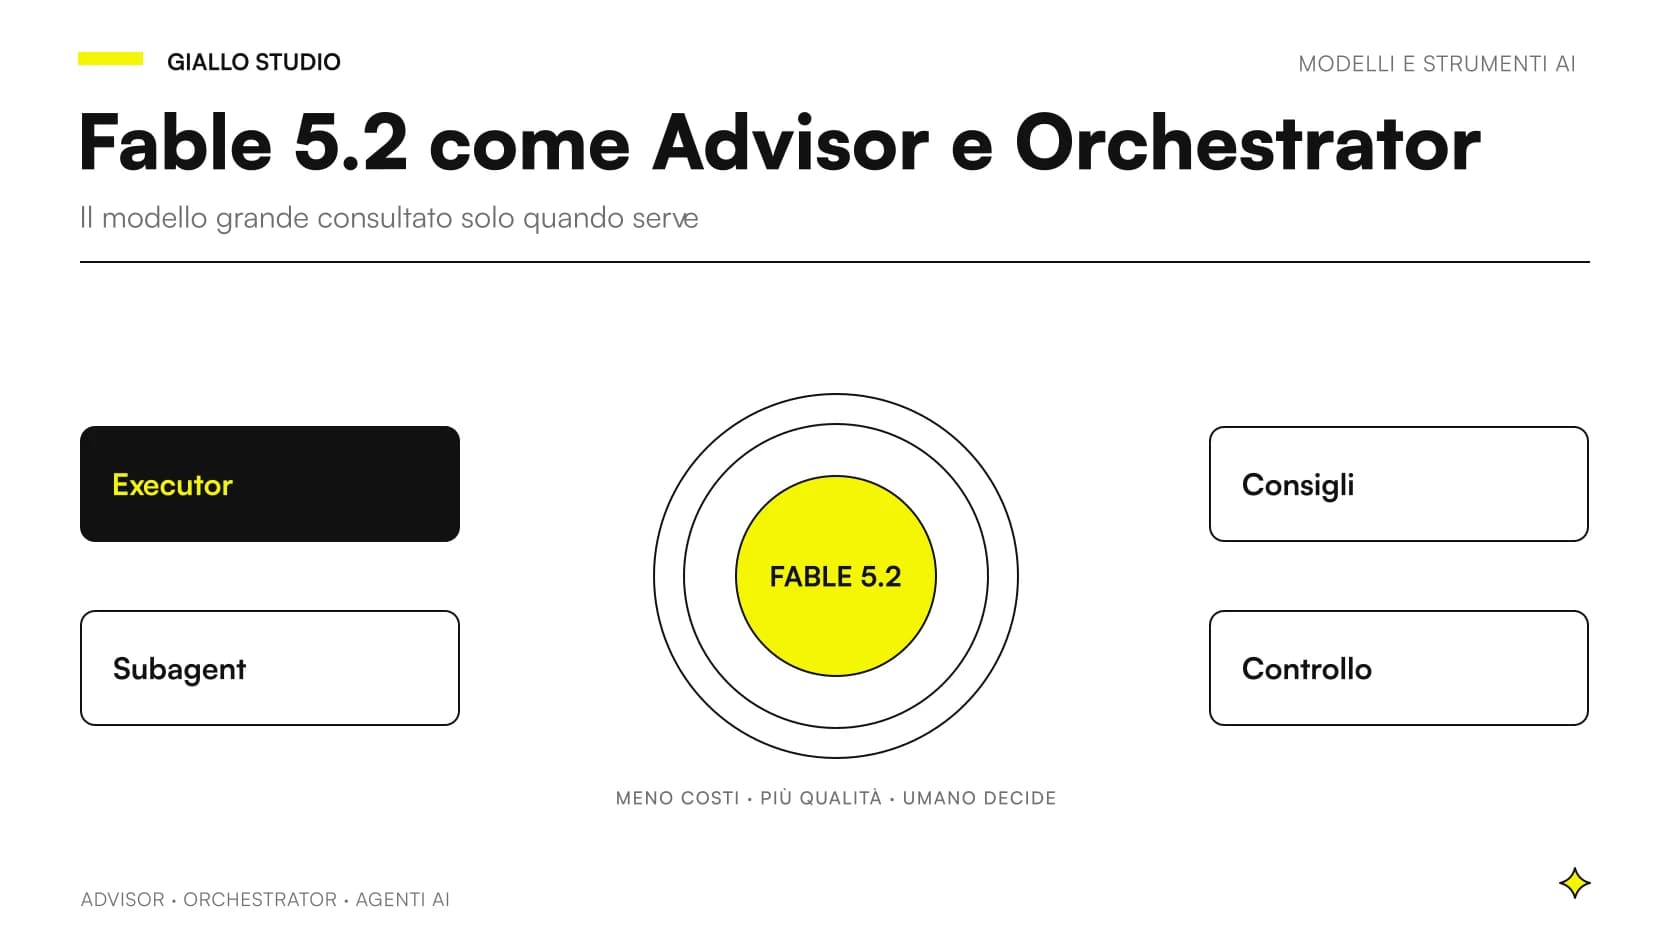
Claude advisor orchestrator: diagramma con Fable 5.2 che consiglia un modello esecutore più piccolo (Advisor) e coordina più subagent (Orchestrator)Claude advisor orchestrator: come usare Fable 5.2 negli agenti AIClaude advisor orchestrator: Fable 5.2 può consigliare modelli più piccoli o coordinarli. Regole, costi e un esempio per una PMI, dalle doc Anthropic.
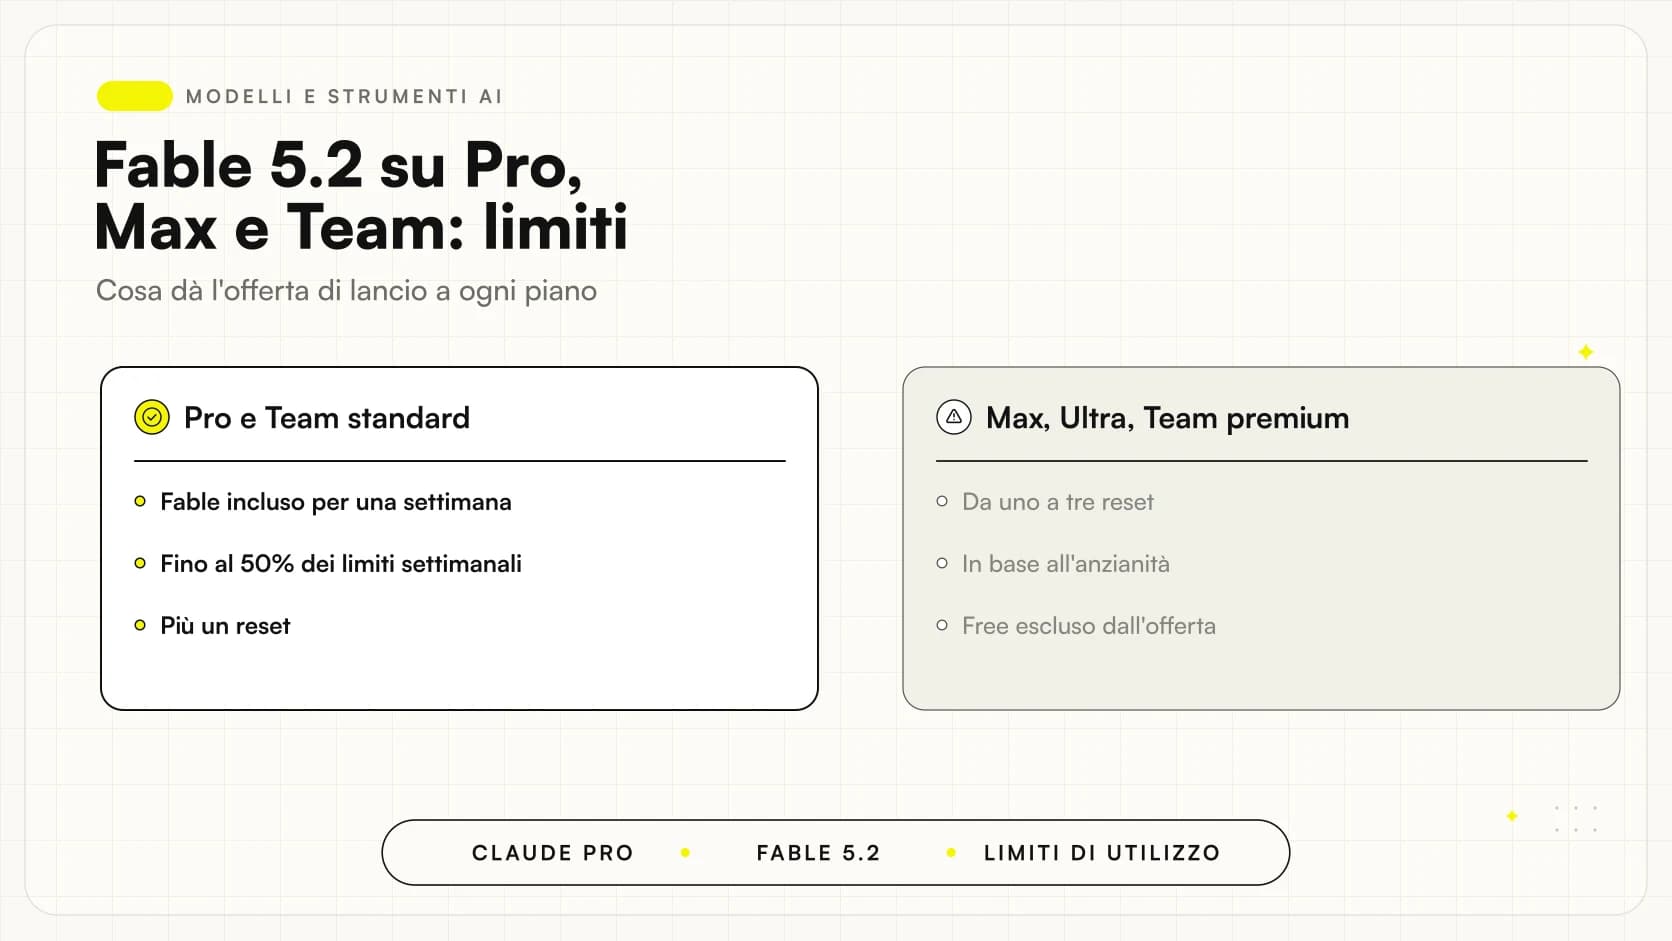
Claude Fable 5.2 Pro, Max e Team: schema dei piani, dell'offerta di lancio di una settimana e del reset dei limitiClaude Fable 5.2 Pro, Max e Team: limiti, reset e offerta di lancioClaude Fable 5.2 Pro, Max e Team: quali piani includono Fable, come funziona il reset dei limiti e cosa prevede l'offerta di lancio del 9 novembre 2026.
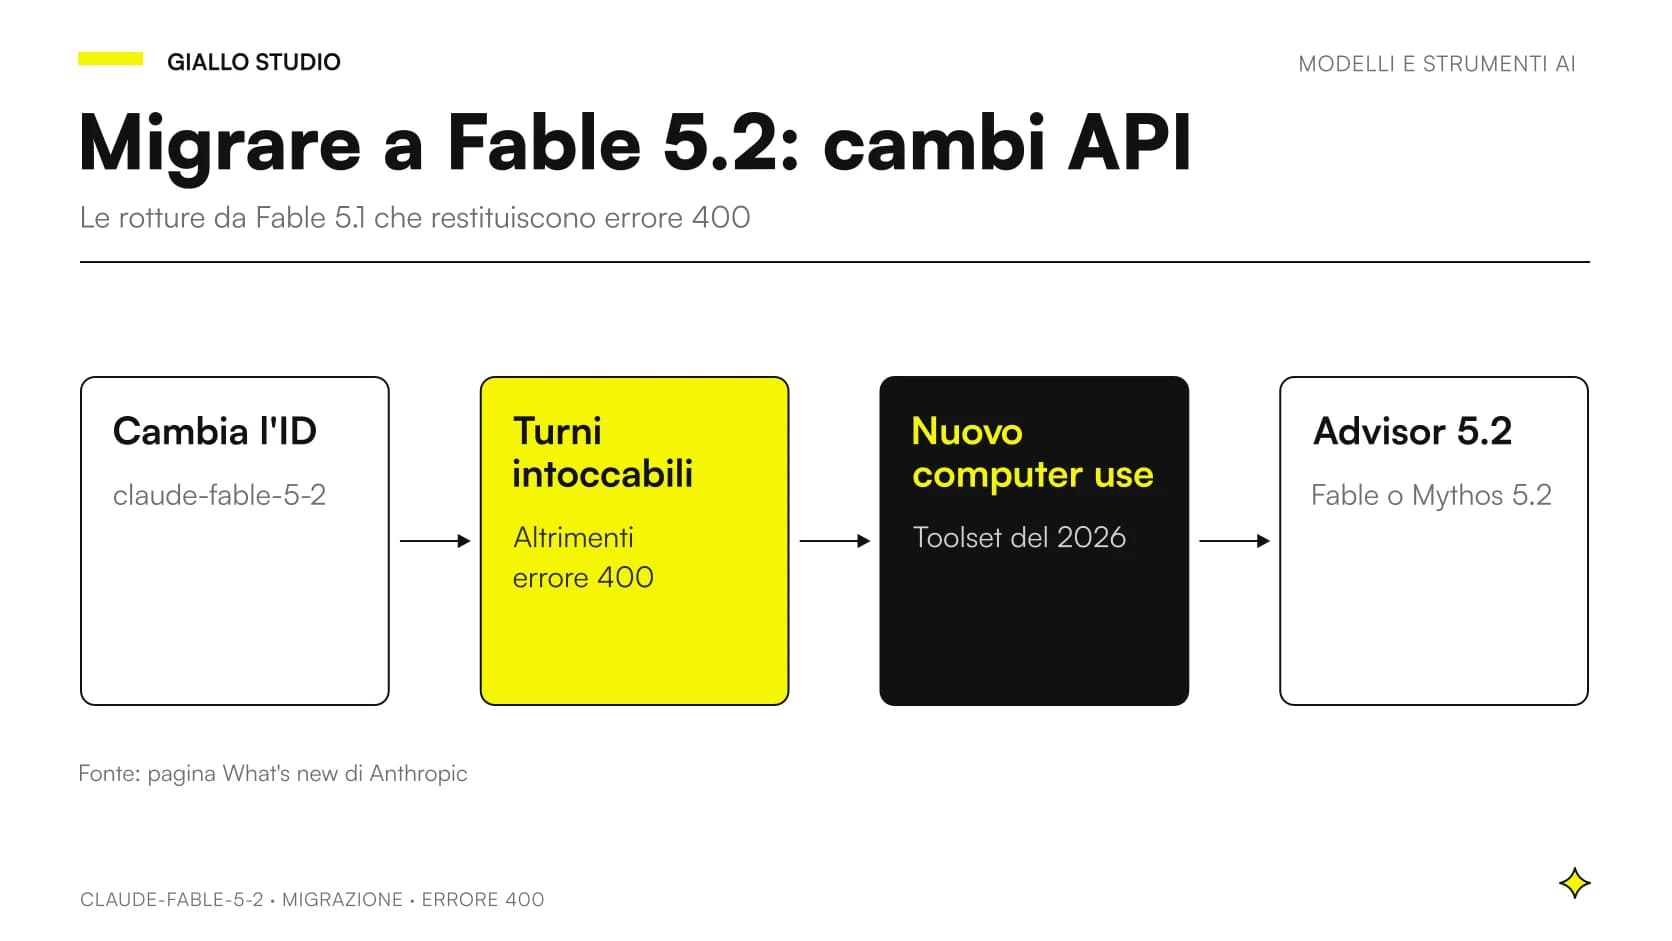
Fable 5.2 migration: diagramma del passaggio da Fable 5.1 a Fable 5.2 con le modifiche API che causano errori 400Fable 5.2 migration: cosa cambia nell'API e perché compaiono gli errori 400Fable 5.2 migration da 5.1: ID per piattaforma, quattro modifiche che rompono il codice, errori 400 e checklist per sviluppatori. Dati al 9 novembre 2026.
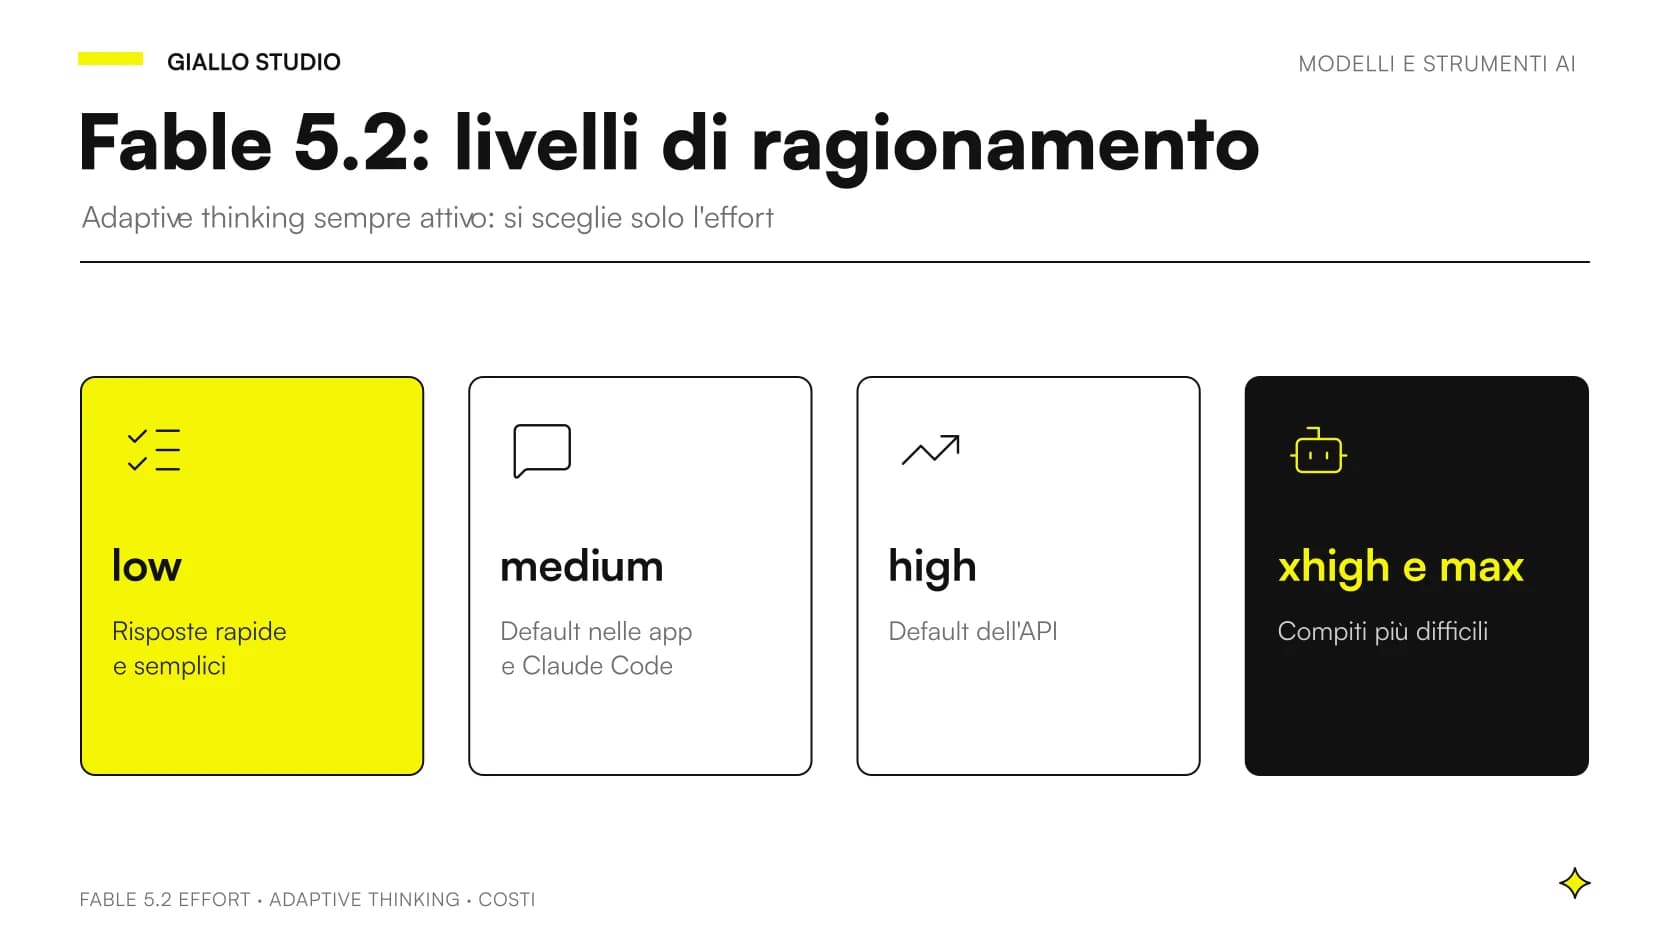
Fable 5.2 effort: i cinque livelli di ragionamento da low a max, con il livello predefinito in API e nelle app ClaudeFable 5.2 effort: i livelli di ragionamento e come sceglierliFable 5.2 effort spiegato: cinque livelli di ragionamento, default high in API e medium nelle app, cosa scegliere per compito e quanto incide su costo.
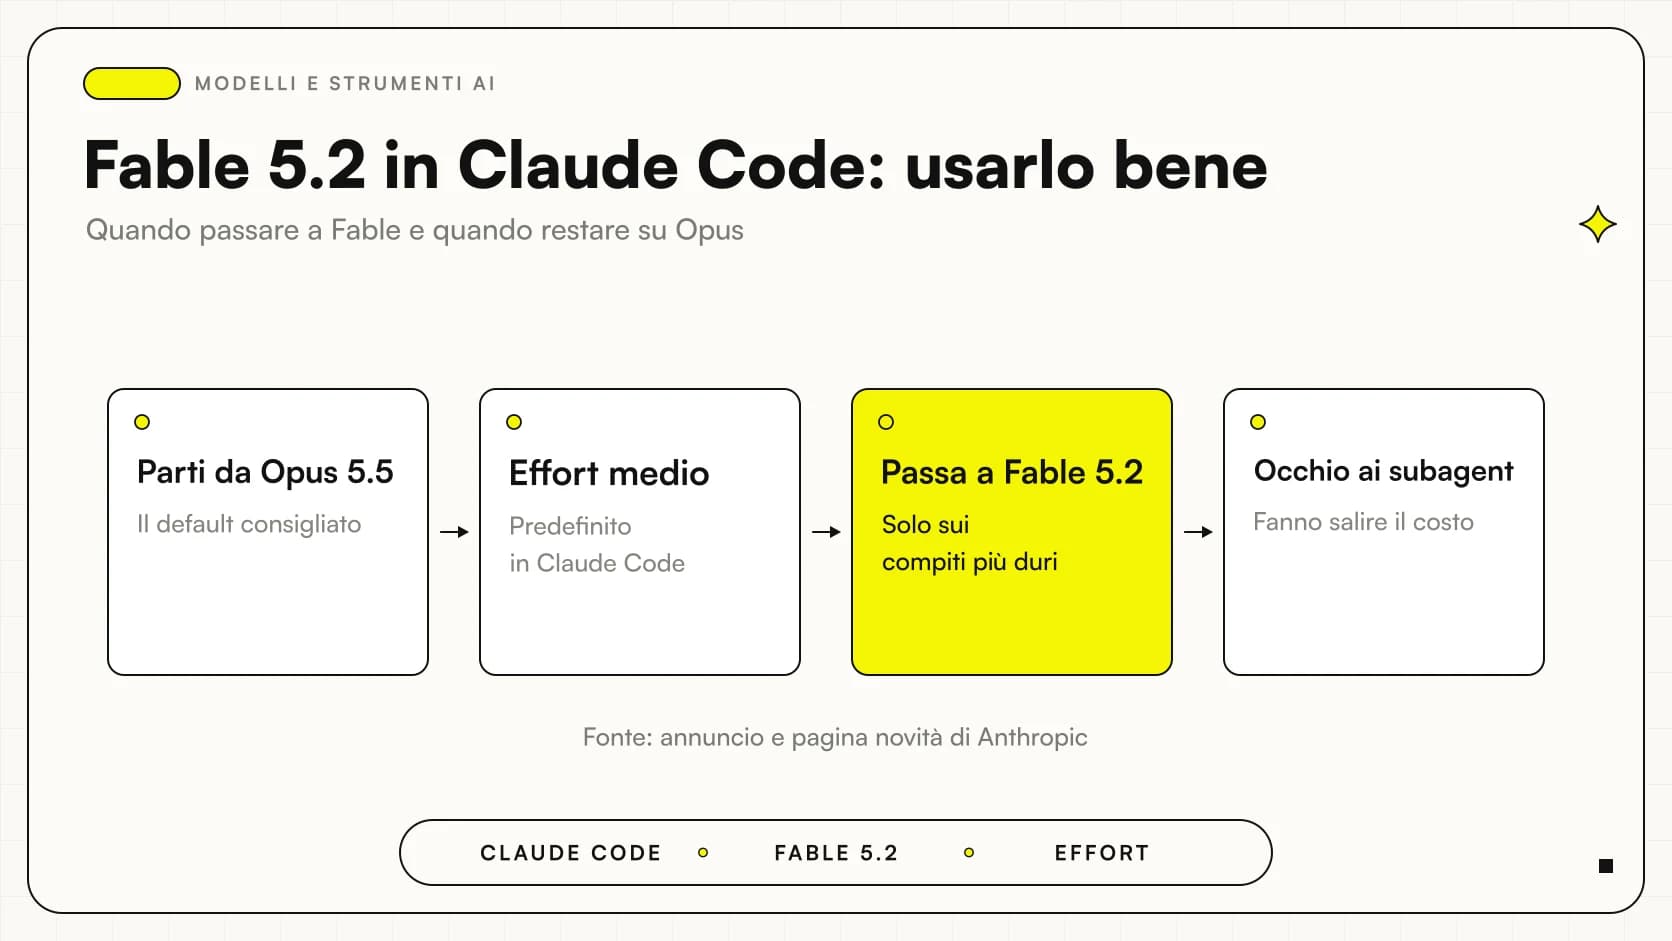
Claude Code Fable 5.2: come usarlo bene, con schema di scelta tra Fable 5.2 e Opus 5.5, effort, fast mode e subagentClaude Code Fable 5.2: come usarlo bene e quando restare su Opus 5.5Claude Code Fable 5.2: effort medio di default, fast mode, costo dei subagent e quando restare su Opus 5.5. Guida pratica con dati ufficiali del 9 novembre.
Claude Fable 5.2 benchmark: diagramma con i punteggi di FrontierCode, FrontierSWE e OSWorld a confronto con Fable 5.1 e Opus 5.5Claude Fable 5.2 benchmark: cosa misurano davvero e come verificarliClaude Fable 5.2 benchmark spiegati in parole semplici: FrontierCode, OSWorld, AutomationBench e gli altri, con i numeri di Anthropic e come testarli.
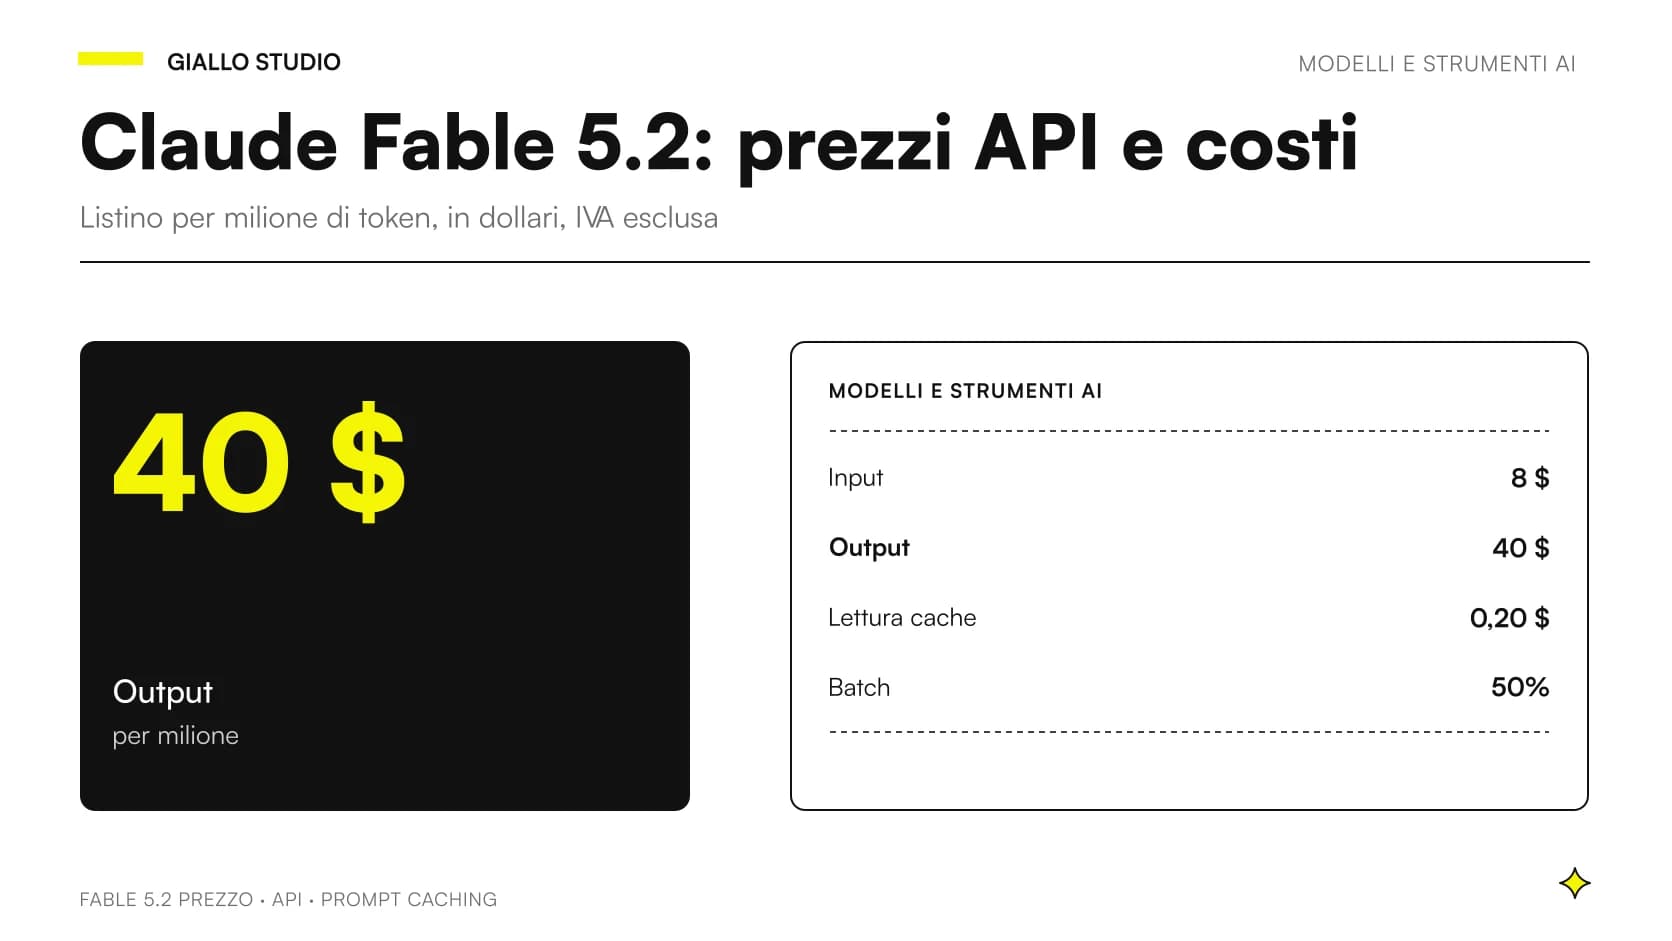
Claude Fable 5.2 prezzo: listino API con input, output, cache, batch e fast mode a confronto con Opus 5.5 e Sonnet 5.5Claude Fable 5.2 prezzo: listino API e costi realiClaude Fable 5.2 prezzo: 8 $ input e 40 $ output per milione di token. Cache, batch, fast mode e un conto passo passo per un caso d'esempio.
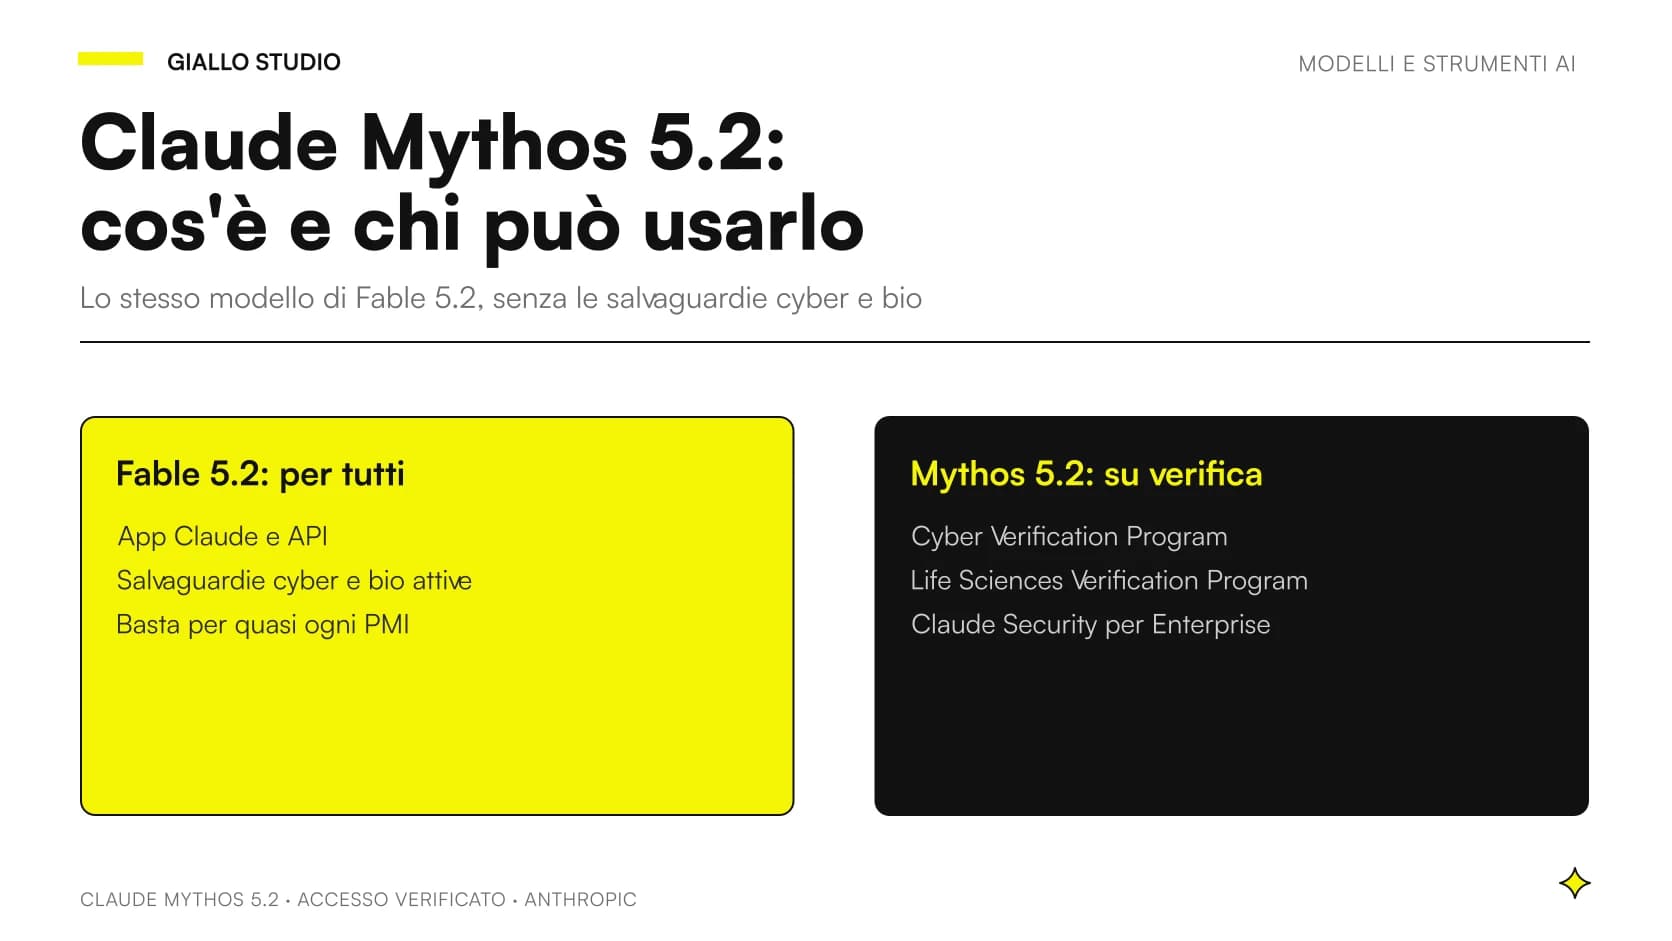
Claude Mythos 5.2: schema del modello Anthropic uguale a Fable 5.2 ma senza le salvaguardie cyber e biologia, con accesso solo per organizzazioni verificateClaude Mythos 5.2: cos'è e chi può usarloClaude Mythos 5.2 è il modello Anthropic del 9 novembre 2026 senza i blocchi cyber e biologia, per organizzazioni verificate. Serve a una PMI? Quasi mai.
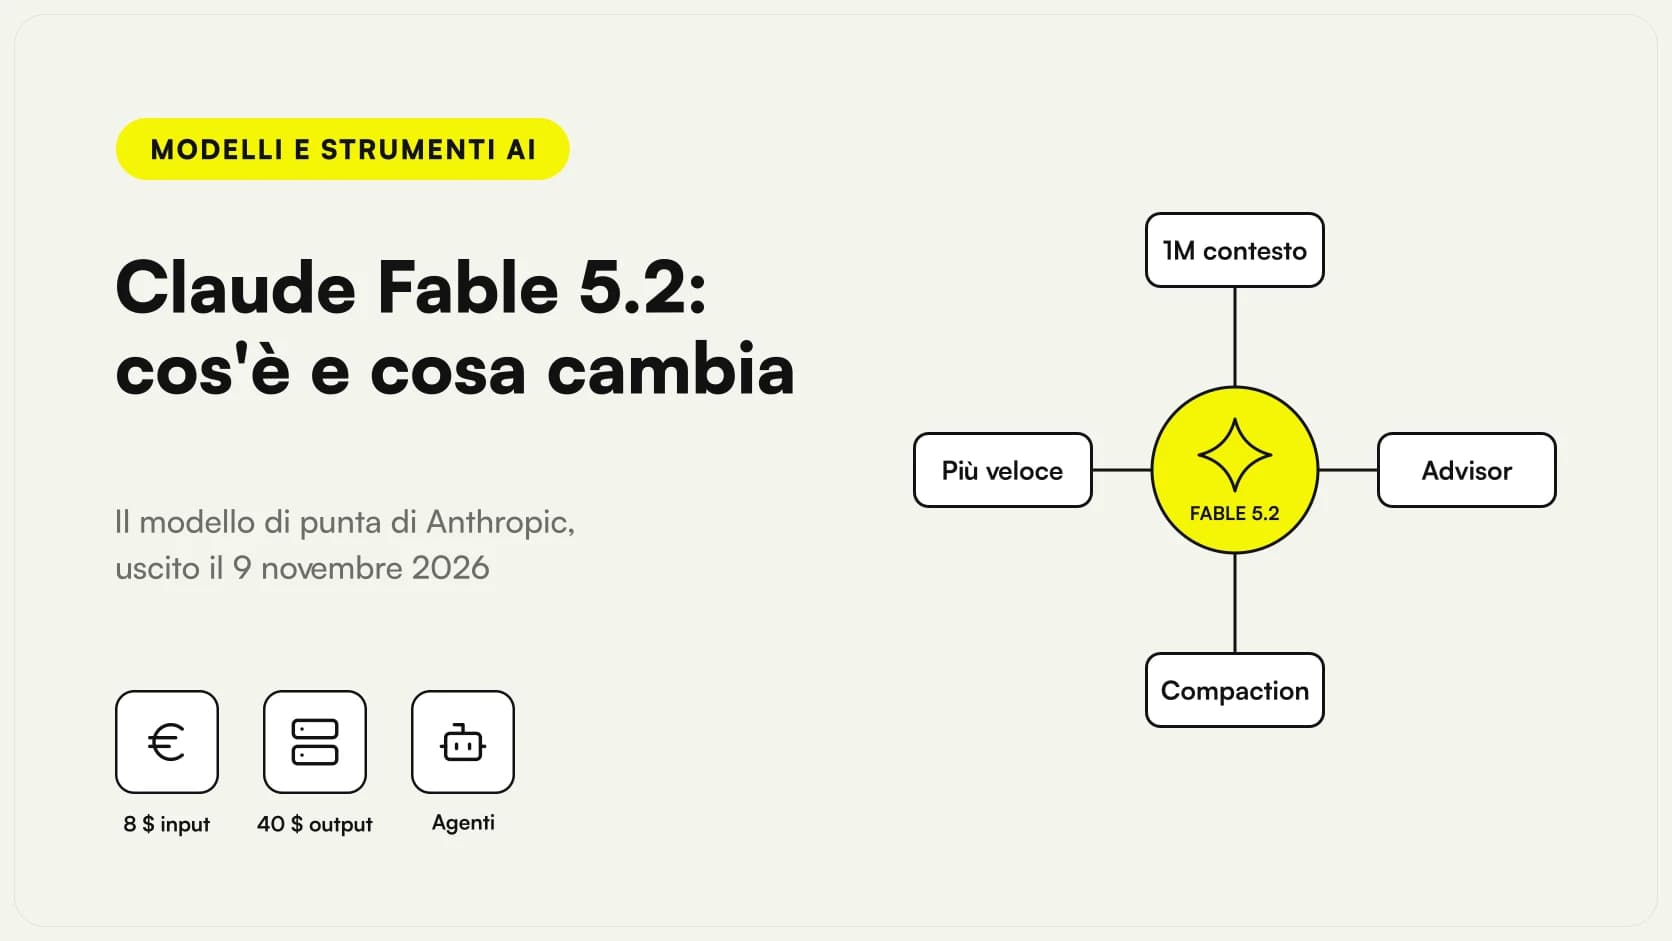
Claude Fable 5.2: scheda del modello Anthropic con prezzo, contesto da 1 milione di token e confronto con Opus 5.5 e Mythos 5.2Claude Fable 5.2: cos'è, cosa cambia, quanto costa e a chi serveClaude Fable 5.2 è il modello Anthropic del 9 novembre 2026: prezzo 8/40 $, contesto 1M, benchmark dichiarati e quando conviene rispetto a Opus 5.5.
Alternative a Grok: quattro strade diverse per chat, ricerca con fonti, immagini e agenti AI che partono dallo stesso bisognoAlternative a Grok: le opzioni migliori per chat, immagini e agenti AIAlternative a Grok per bisogno: chat quotidiana, ricerca con fonti, immagini e video, agenti operativi come Grok Bot. E quando serve un agente su misura.
Limiti di Grok: un indicatore di utilizzo settimanale che si esaurisce accanto ai punti di attenzione per l’uso in aziendaLimiti di Grok: utilizzo settimanale, versione gratuita e rischi per chi lo usa in aziendaLimiti di Grok: monte settimanale unico da giugno 2026, cosa succede quando finisce, limiti della versione gratuita, video, file e i rischi per un’azienda.
Grok Imagine: una serie di immagini generate in formati diversi, con il watermark grok e un fotogramma video in lavorazioneGrok Imagine: come creare immagini e video con Grok, limiti e regoleGrok Imagine: come creare immagini e video con Grok nell’app e via API, costo per immagine e per secondo, watermark, limiti e regole su persone reali.
Grok per aziende: workspace di team con connettori verso posta, documenti e CRM e una console di amministrazione delle licenzeGrok per aziende: Business, Teams ed Enterprise, cosa offre e quando ha sensoGrok per aziende: Teams da $30 per utente al mese, Enterprise su preventivo, connettori, controlli admin e quando serve un agente su misura.
Grok e GDPR: conversazioni con un assistente AI, impostazioni di controllo dei dati e autorità europee per la privacyGrok e GDPR: privacy, addestramento sui dati e indagini in EuropaGrok e GDPR: chi è il titolare, come fermare l’addestramento sulle chat, dove vanno i dati e quali indagini europee sono aperte (novembre 2026).
Grok API: richiesta a Grok 4.7 con l'SDK OpenAI verso api.x.ai e tabella dei prezzi per milione di tokenGrok API: prezzi, chiave e primi passi per sviluppatoriGrok API a novembre 2026: listino per modello, soglia dei 200k token, SDK OpenAI, conservazione dei dati, Zero Data Retention e watermark AI Act.
Grok prezzo e abbonamento: i piani Free, Plus, Premium, Super e Ultra di The X Subscription affiancati con il costo mensileGrok prezzo: quanto costa l'abbonamento nel 2026 (Free, Plus, Premium, Super, Ultra)Grok prezzo a novembre 2026: Free 0 $, Plus 8 $, Premium 30 $, Super 100 $, Ultra 200 $ al mese, IVA esclusa. Cosa include ogni piano e i limiti.
Come usare Grok su X: una conversazione in cui un utente tagga @grok in risposta a un post e riceve una replicaCome usare Grok su X: taggare @grok, cosa cambia con @bot e perché in Italia non sempre rispondeCome usare Grok su X: chiedere a @grok in una risposta, cosa fa @bot, perché dall'Italia @bot non risponde e quali regole valgono per privacy e immagini.
Grok Bot: agente AI che lavora su un computer nel cloud tra browser, file e terminale, con una richiesta di approvazione in primo pianoGrok Bot: cos'è e cosa fa davvero (e perché non è la chat Grok)Grok Bot è l'agente di SpaceXSI con un computer nel cloud: non è la chat Grok né @grok su X. Come funziona, dispositivi, approvazioni, privacy e costo.
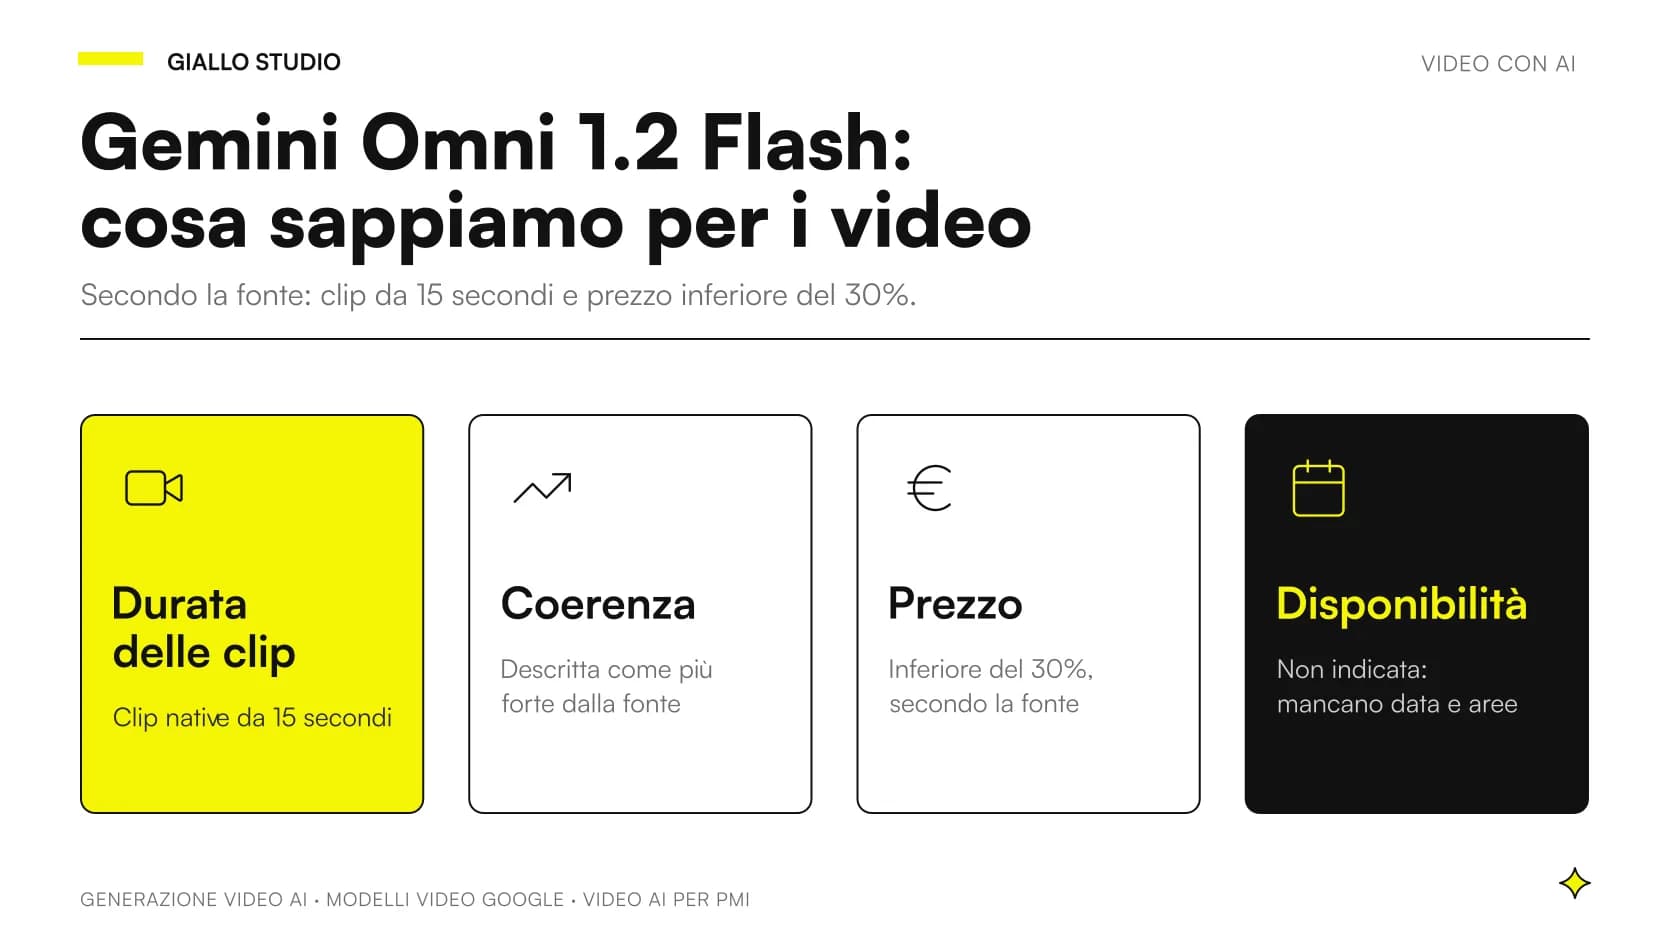
Montaggio video su un monitor in uno studio di una piccola azienda italianaGemini Omni 1.2 Flash: cos'è e cosa cambia per i video di una PMIGemini Omni 1.2 Flash genera e modifica video nativi. Cosa dichiara Google, cosa manca e come valutarlo senza farsi guidare dall'entusiasmo.
Scrivania di una piccola azienda con un portatile che mostra una schermata di controllo della sicurezza informaticaGPT-6 Cyber: cos'è il modello OpenAI per la cybersecurity e cosa cambia per le PMIGPT-6 Cyber è il modello OpenAI per la cybersecurity: cosa dichiara la fonte, cosa non sappiamo ancora e come una PMI può prepararsi senza illusioni.
Gemini 4 Carbon al centro di un percorso di lavoro lungo con verifiche, strumenti e accesso tramite API e appGemini 4 Carbon: cos’è, dove si usa e quanto costa oggiGemini 4 Carbon cos’è: il modello più forte di Google, disponibile via API dal 10 novembre 2026. Dove si usa, prezzo, specifiche e differenze con Argon.
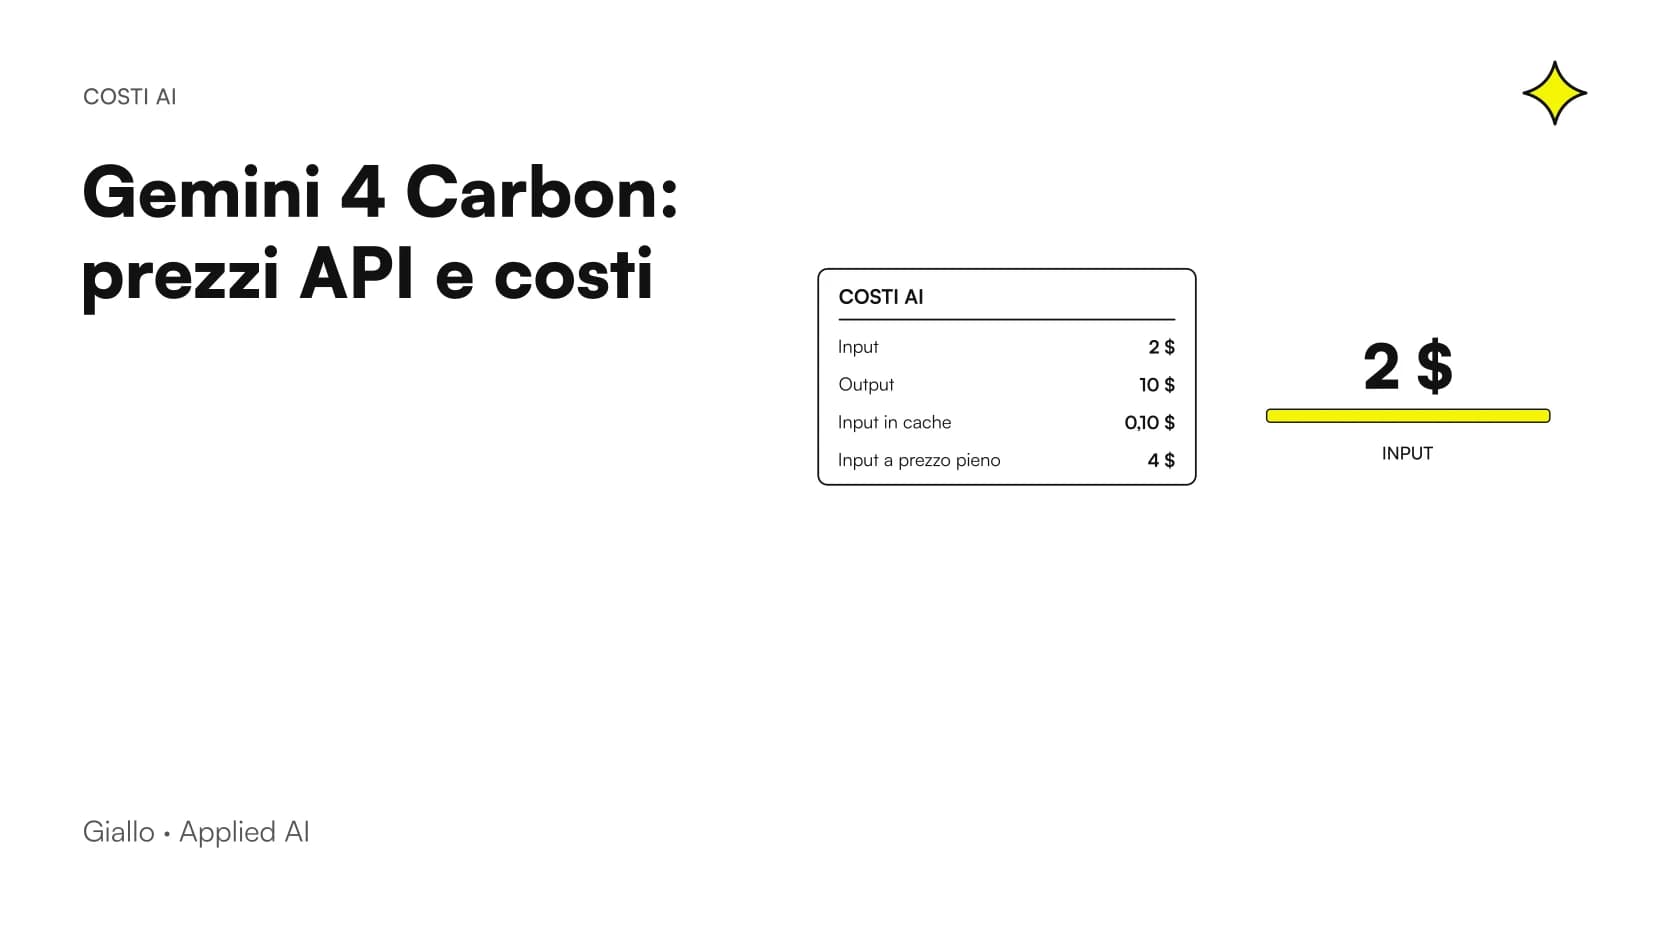
Gemini 4 Carbon prezzi: tariffe API per milione di token di input, output e cache fino al 30 novembre e dal 1° dicembre 2026 a confronto con altri modelli AIGemini 4 Carbon prezzi: costo API per milione di token e confrontoGemini 4 Carbon prezzi: 2/10 $ per milione di token fino al 30/11/2026, poi 4/20 $. Batch, Flex, cache e confronto con Argon, GPT-6 Astra e Claude.
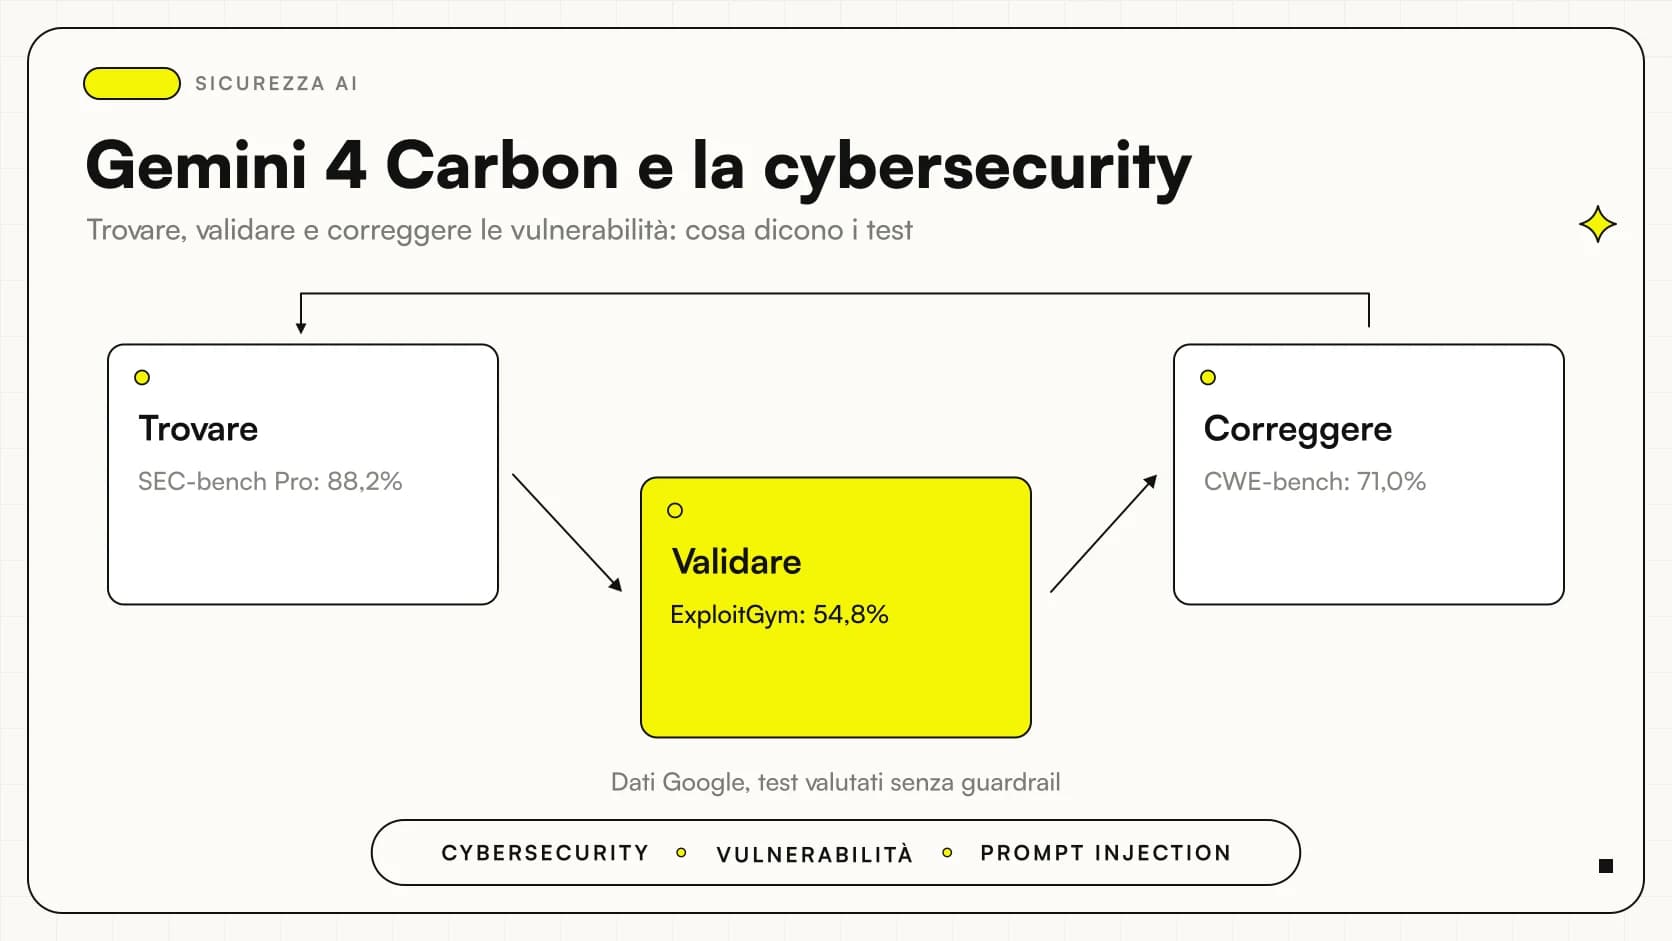
Gemini 4 Carbon cybersecurity: il ciclo di difesa tra rilevamento, validazione con exploit e correzioneGemini 4 Carbon cybersecurity: trovare, validare e correggere le vulnerabilitàGemini 4 Carbon cybersecurity: benchmark, Carbon for cyber via Fairwind, prompt injection e protezioni dichiarate il 10 novembre. Cosa cambia per una PMI.
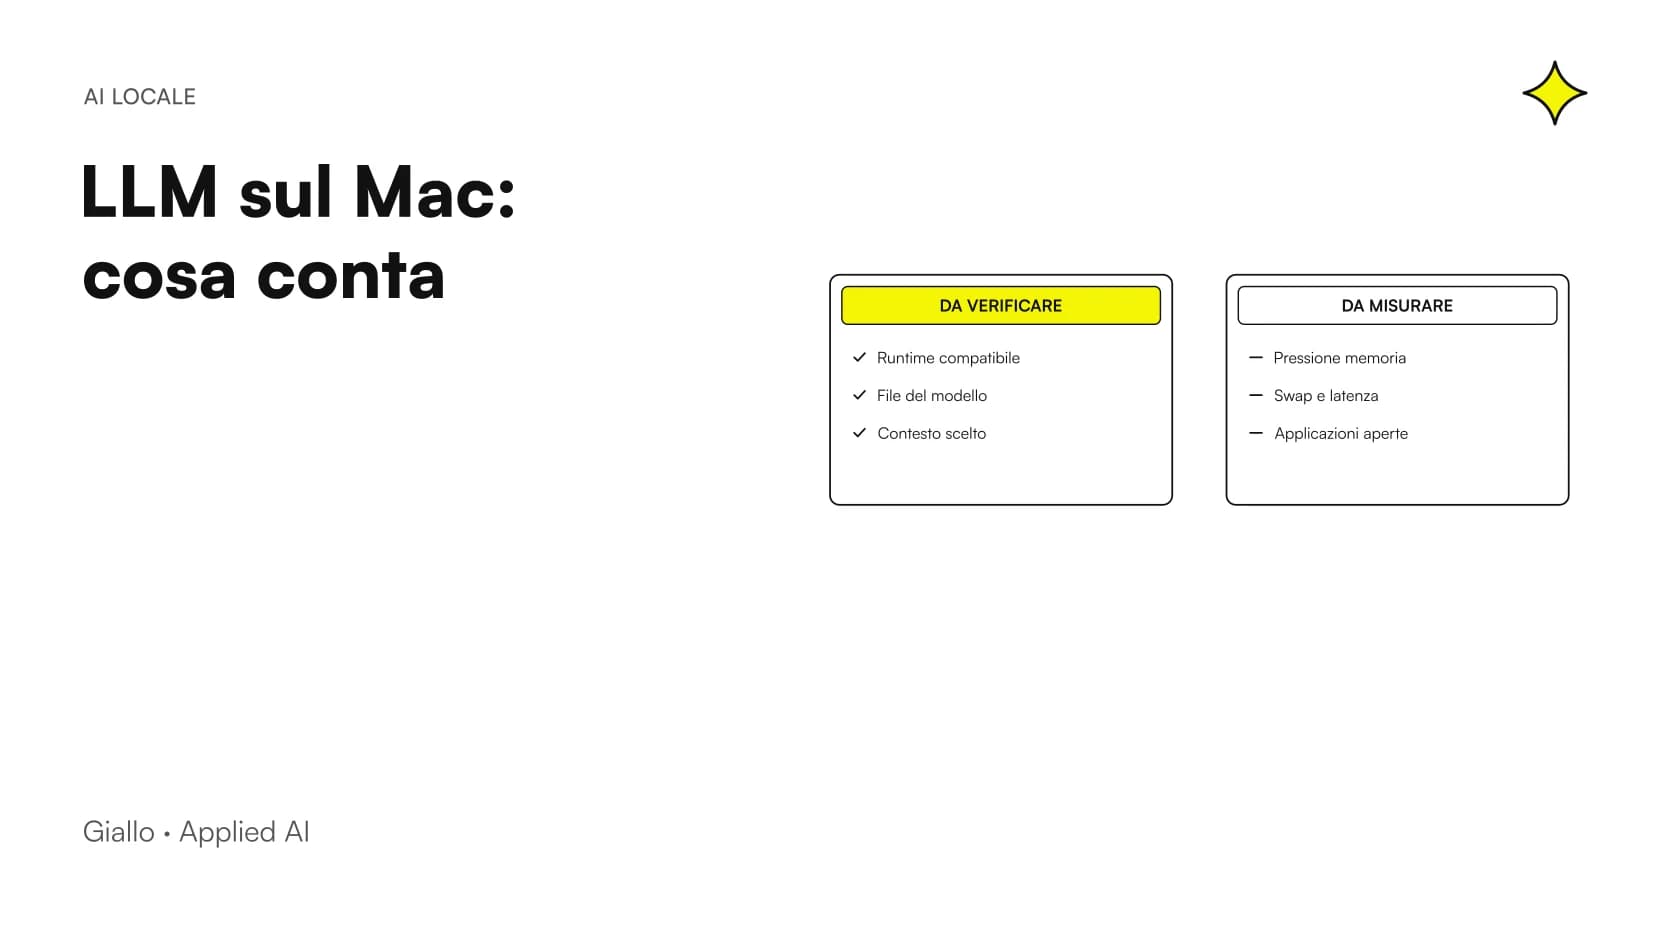
LLM locale su Mac con 16, 24 o 32 GB: controlli del runtime e misure di pressione memoria, swap e latenza.LLM locale su Mac: scegliere con 16, 24 o 32 GBLLM locale su Mac con 16, 24 o 32 GB: memoria unificata, modelli, contesto e pressione memoria. Valuta il lavoro reale prima dell'acquisto.
LLM locale su Windows: driver, modello, offload e contesto attorno al sistema, con RAM e VRAM distinte.LLM locale su Windows: GPU, VRAM e limiti praticiCome scegliere un LLM locale su Windows: memoria RAM e VRAM, driver, offload e controlli pratici prima di acquistare una GPU.
Schema di Qwen3.8-27B in locale con pesi, immagini, contesto e licenza collegati al modello.Qwen3.8-27B in locale: capacità, limiti e requisitiQwen3.8-27B in locale: modello, licenza, immagini, contesto e memoria. Cosa verificare prima di usarlo sui documenti della tua azienda.
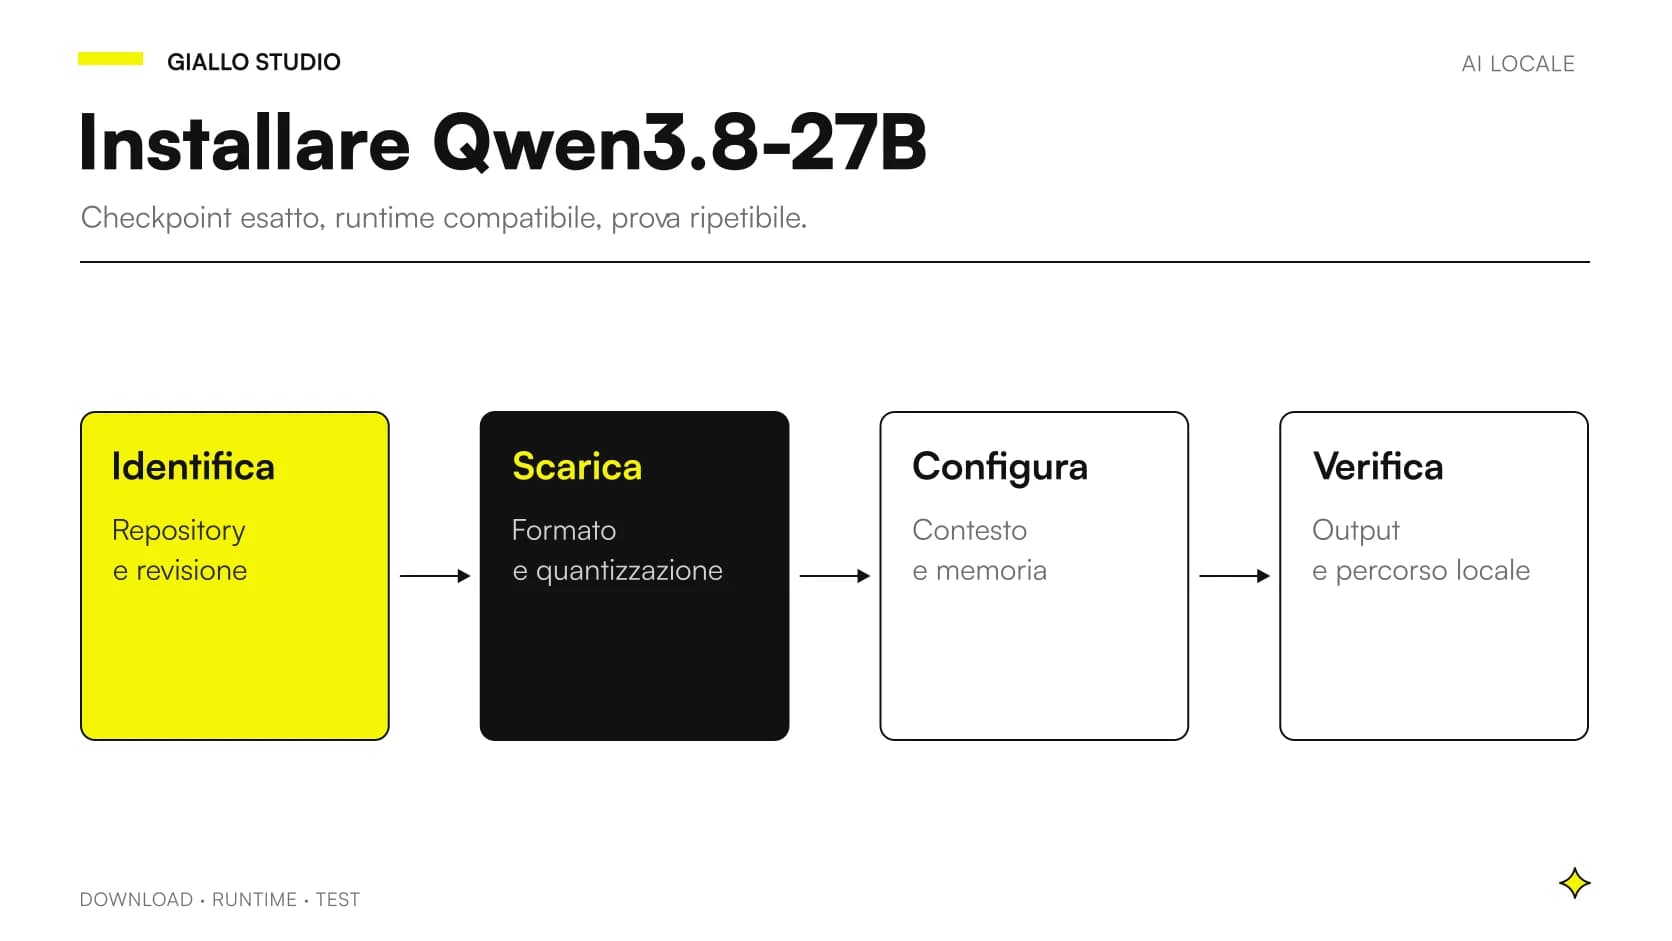
Procedura per installare Qwen3.8-27B in locale: identificare, scaricare, configurare e verificare.Installare Qwen3.8-27B in locale: controlli e proceduraInstallare Qwen3.8-27B in locale: verifica pesi, runtime, memoria e API. Procedura documentata, comandi essenziali e diagnosi degli errori.
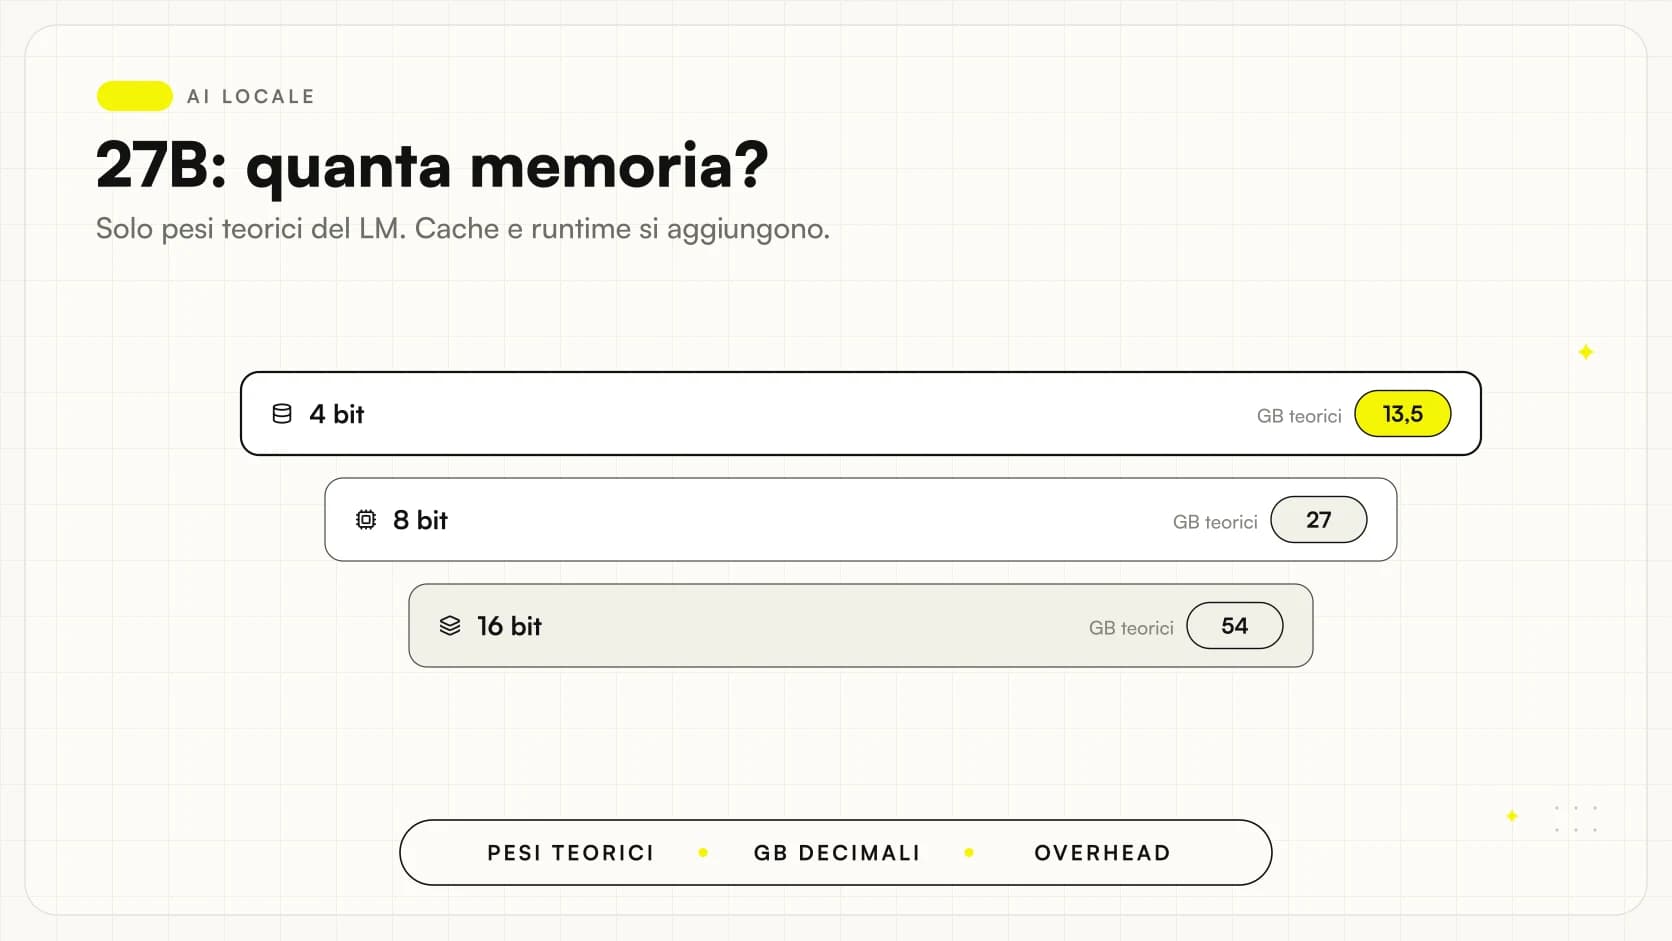
RAM e VRAM di Qwen3.8-27B: pesi linguistici teorici a 4, 8 e 16 bit, esclusi cache e overhead.Qwen3.8-27B: quanta RAM e VRAM servono davvero?Quanta RAM e VRAM serve a Qwen3.8-27B? Distingui pesi teorici, file quantizzati, cache, contesto e memoria reale prima di scegliere l'hardware.
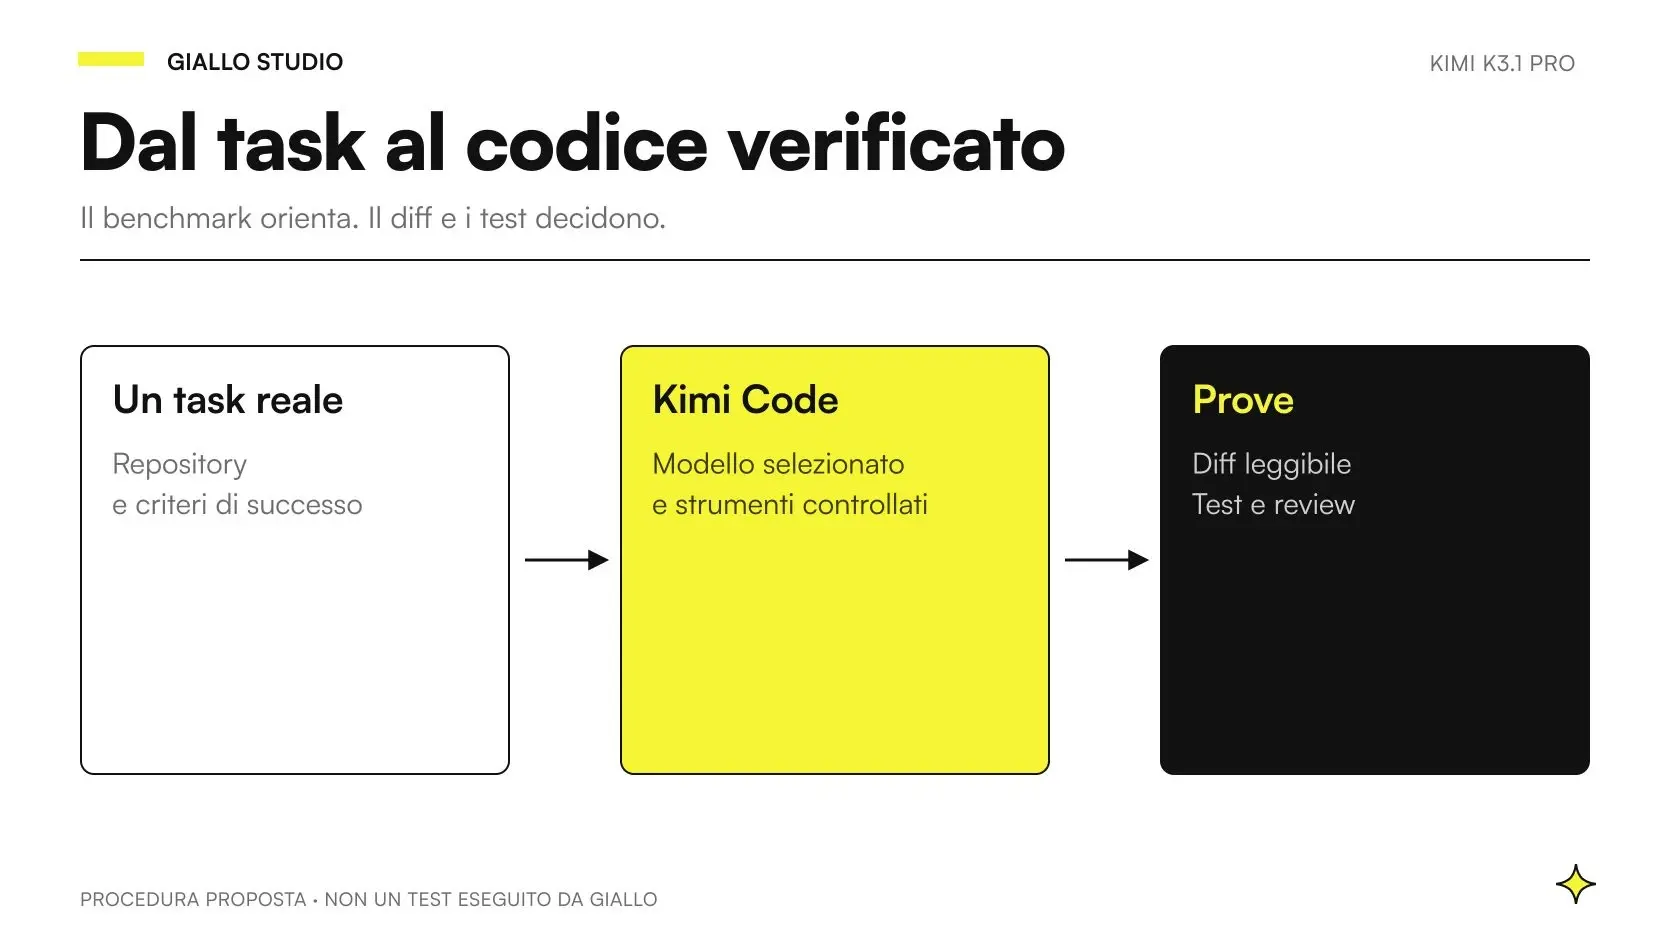
Kimi K3.1 Pro per coding tra configurazione del modello, repository e verifica del risultatoKimi K3.1 Pro per coding: configurazione e prove utiliKimi K3.1 Pro per coding: ID esatti, differenze fra Code e API, reasoning e benchmark. Come provarlo su un repository senza confondere demo e verifica.
Kimi K3.1 Pro collega documenti, codice e strumenti in un processo aziendale verificabileKimi K3.1 Pro: cos’è, cosa cambia e quando usarloKimi K3.1 Pro spiegato: disponibilità, contesto da 1M token, API, coding e pesi annunciati. Cosa verificare prima di usarlo in una PMI.
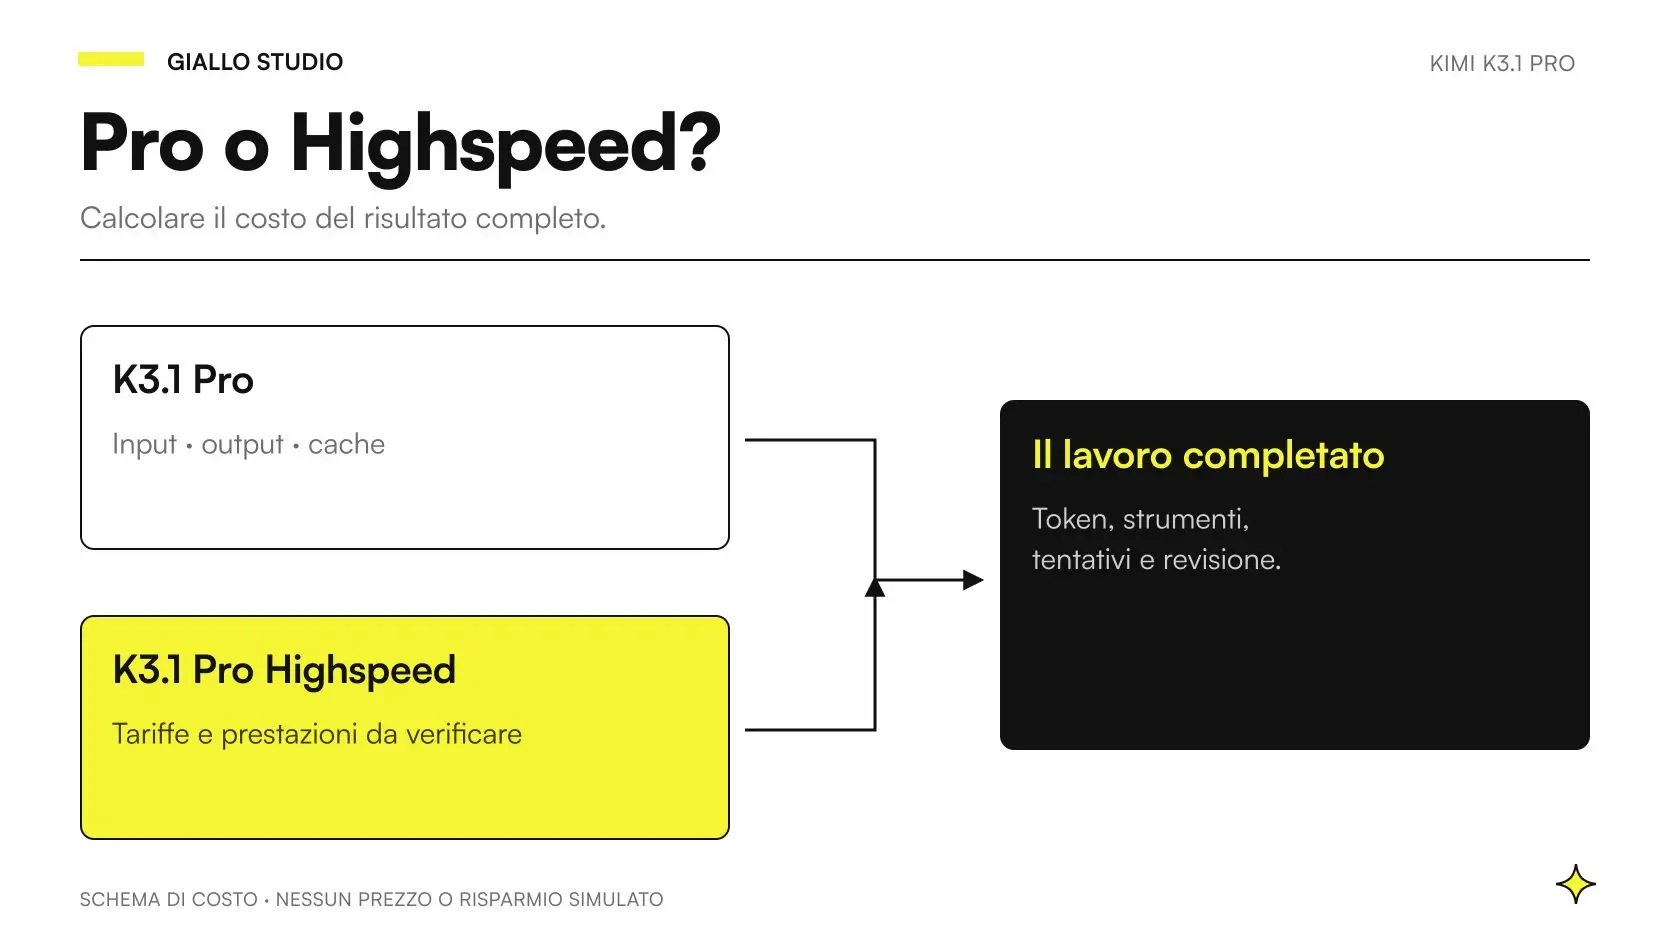
Prezzi API di Kimi K3.1 Pro divisi tra input, output, scrittura e lettura della cacheKimi K3.1 Pro: prezzi API, cache e budget per le PMIPrezzi API di Kimi K3.1 Pro e Highspeed al 24 ottobre 2026. Input, output e cache spiegati con calcoli ipotetici e criteri per il budget aziendale.
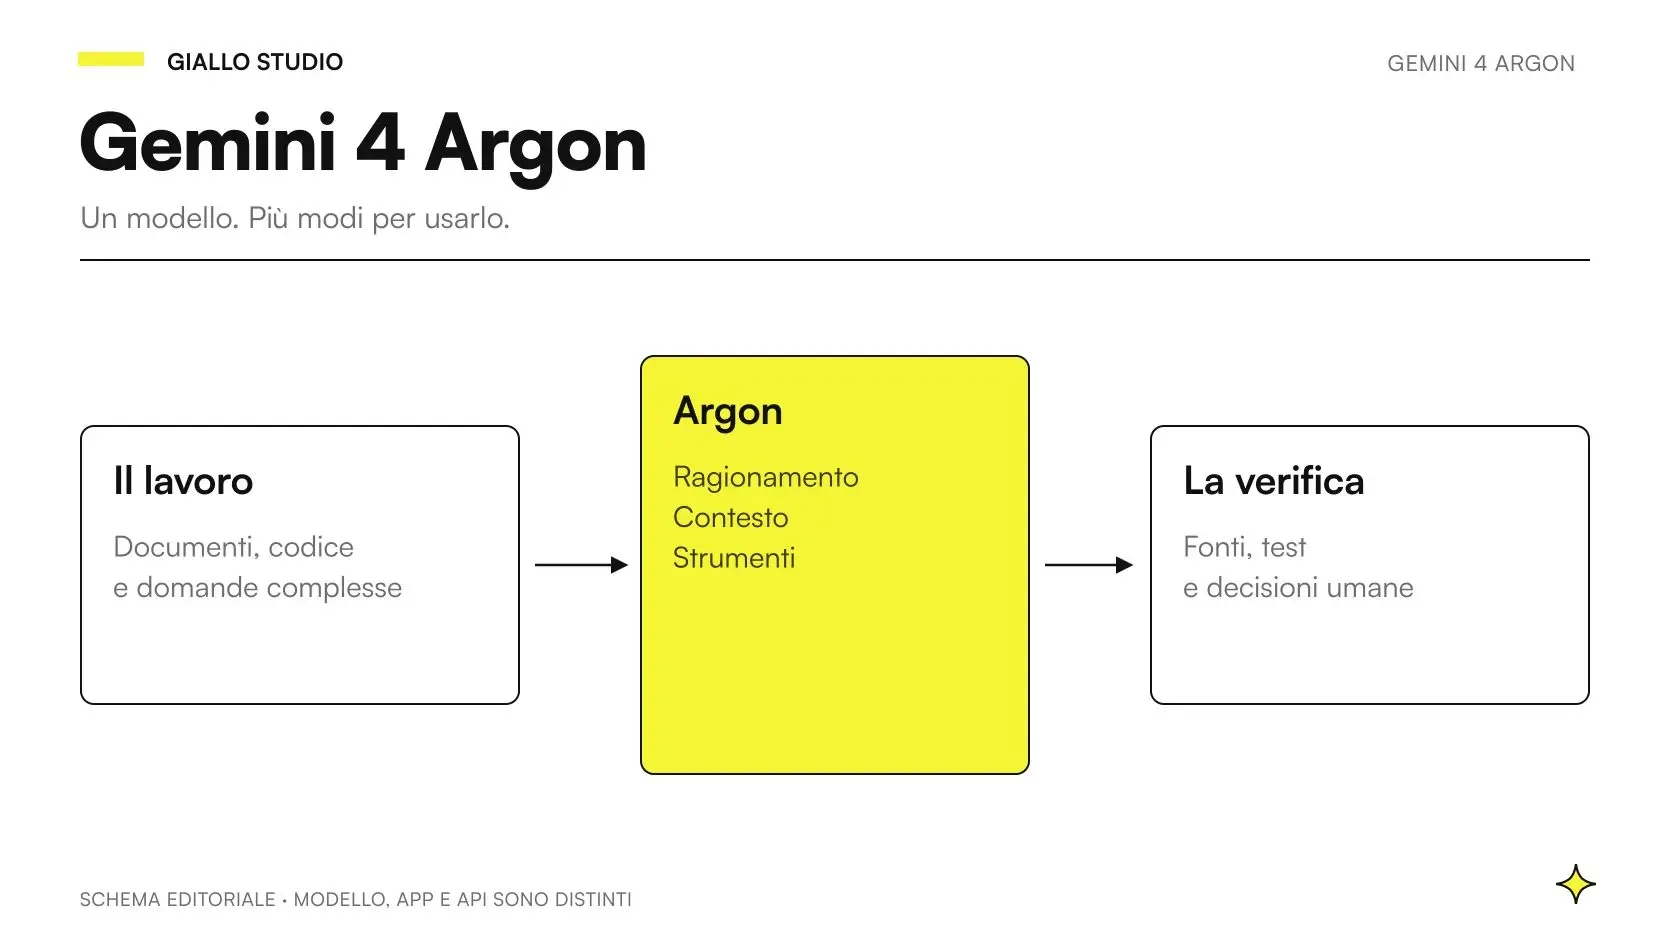
Gemini 4 Argon al centro di un sistema che collega documenti, strumenti e verifica umana dei risultatiGemini 4 Argon: cos’è, cosa fa e quando usarlo in aziendaGemini 4 Argon spiegato: modello, app e API, capacità multimodali, contesto, limiti e disponibilità. Criteri concreti per una prima prova aziendale.
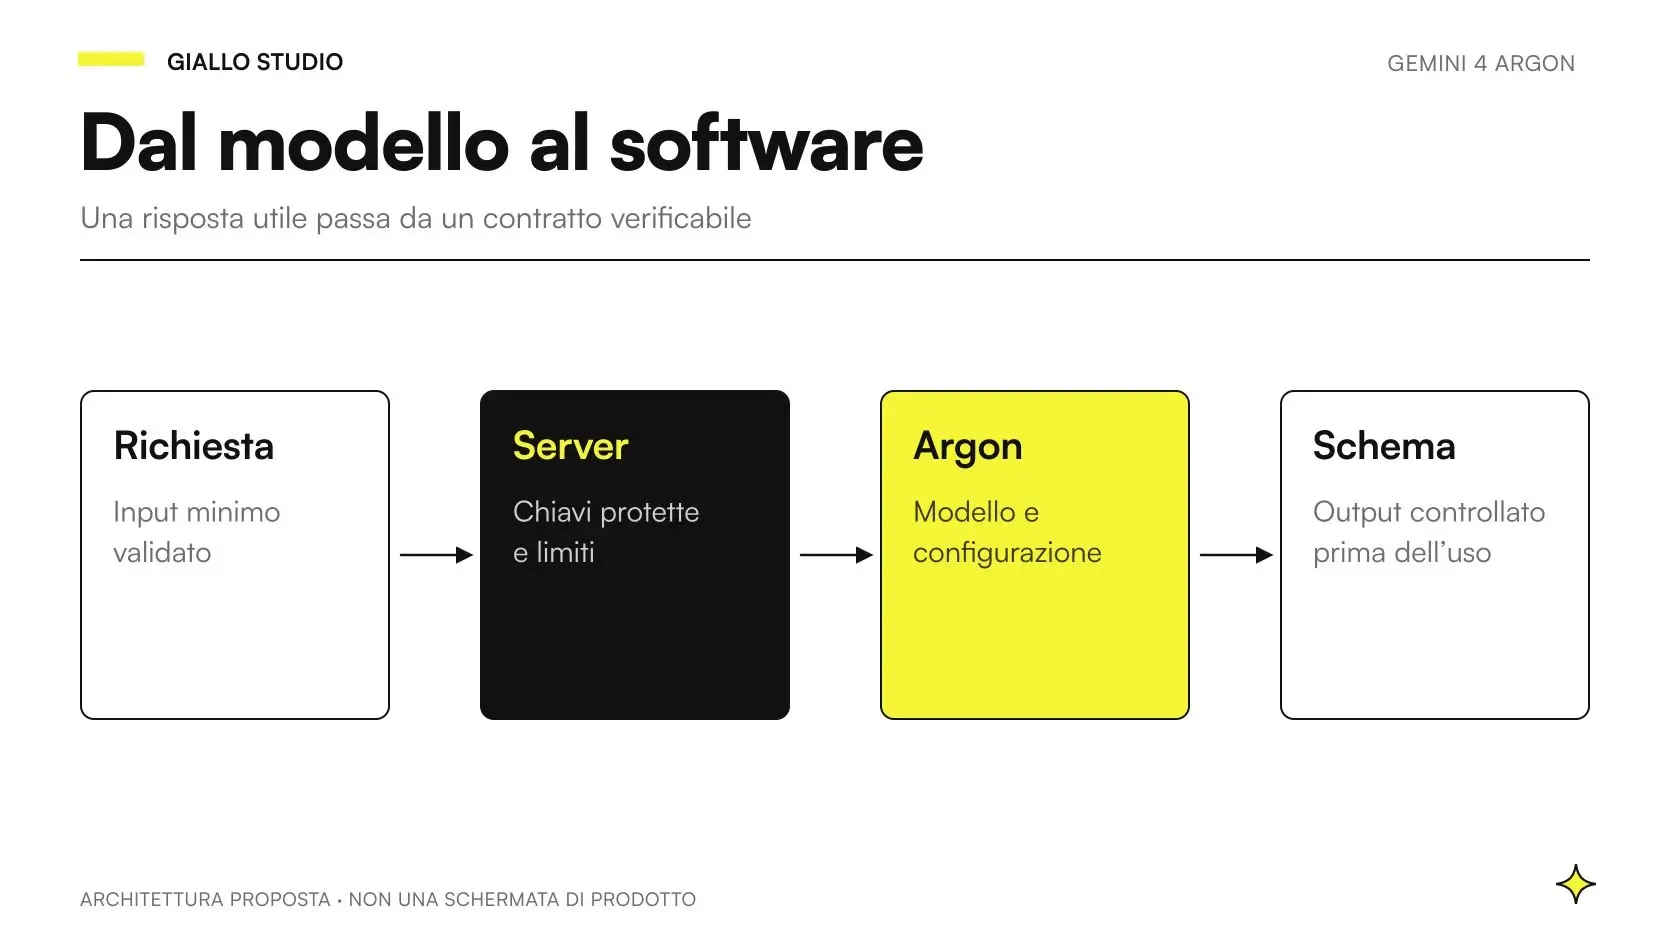
Integrazione Gemini 4 Argon API tra applicazione aziendale, controlli del server e gestionaleGemini 4 Argon API: integrare il modello nei processi aziendaliCome integrare Gemini 4 Argon API in un gestionale: chiamata REST, output strutturati, tempi, errori e controlli per un progetto aziendale verificabile.
Gemini 4 Argon coding: valutazione di patch software con repository, test e revisione umanaGemini 4 Argon coding: come valutarlo nello sviluppo softwareGemini 4 Argon coding: benchmark, strumenti e criteri per patch affidabili. Come progettare una prova su repository senza promettere codice sicuro.
Accesso a Gemini 4 Argon dall’Italia attraverso app, AI Studio e API con requisiti distintiGemini 4 Argon in Italia: accesso e come iniziareGemini 4 Argon in Italia: differenze tra app, AI Studio e API, requisiti, funzioni escluse dall’UE e un percorso concreto per la prima valutazione.
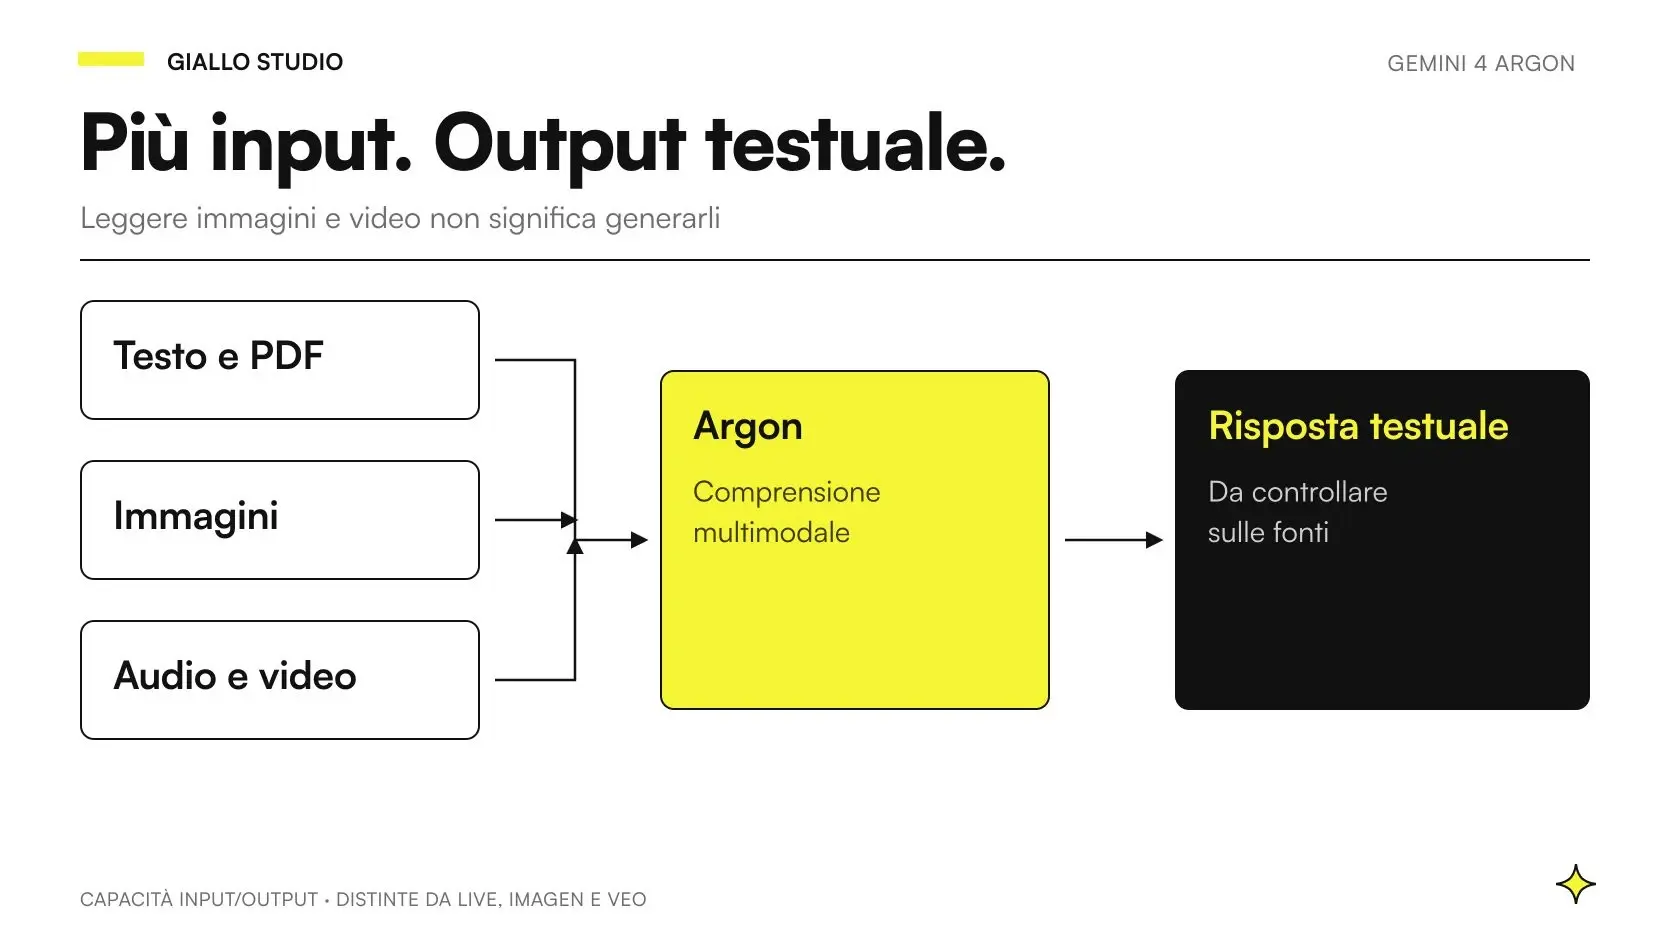
Gemini 4 Argon multimodale analizza fotografie, fotogrammi video e PDF per produrre risultati testuali verificabiliGemini 4 Argon multimodale: analizzare immagini, video e PDFGemini 4 Argon multimodale: input supportati, output testuale, analisi video e limiti. Due esempi PMI per verificare evidenze e informazioni mancanti.
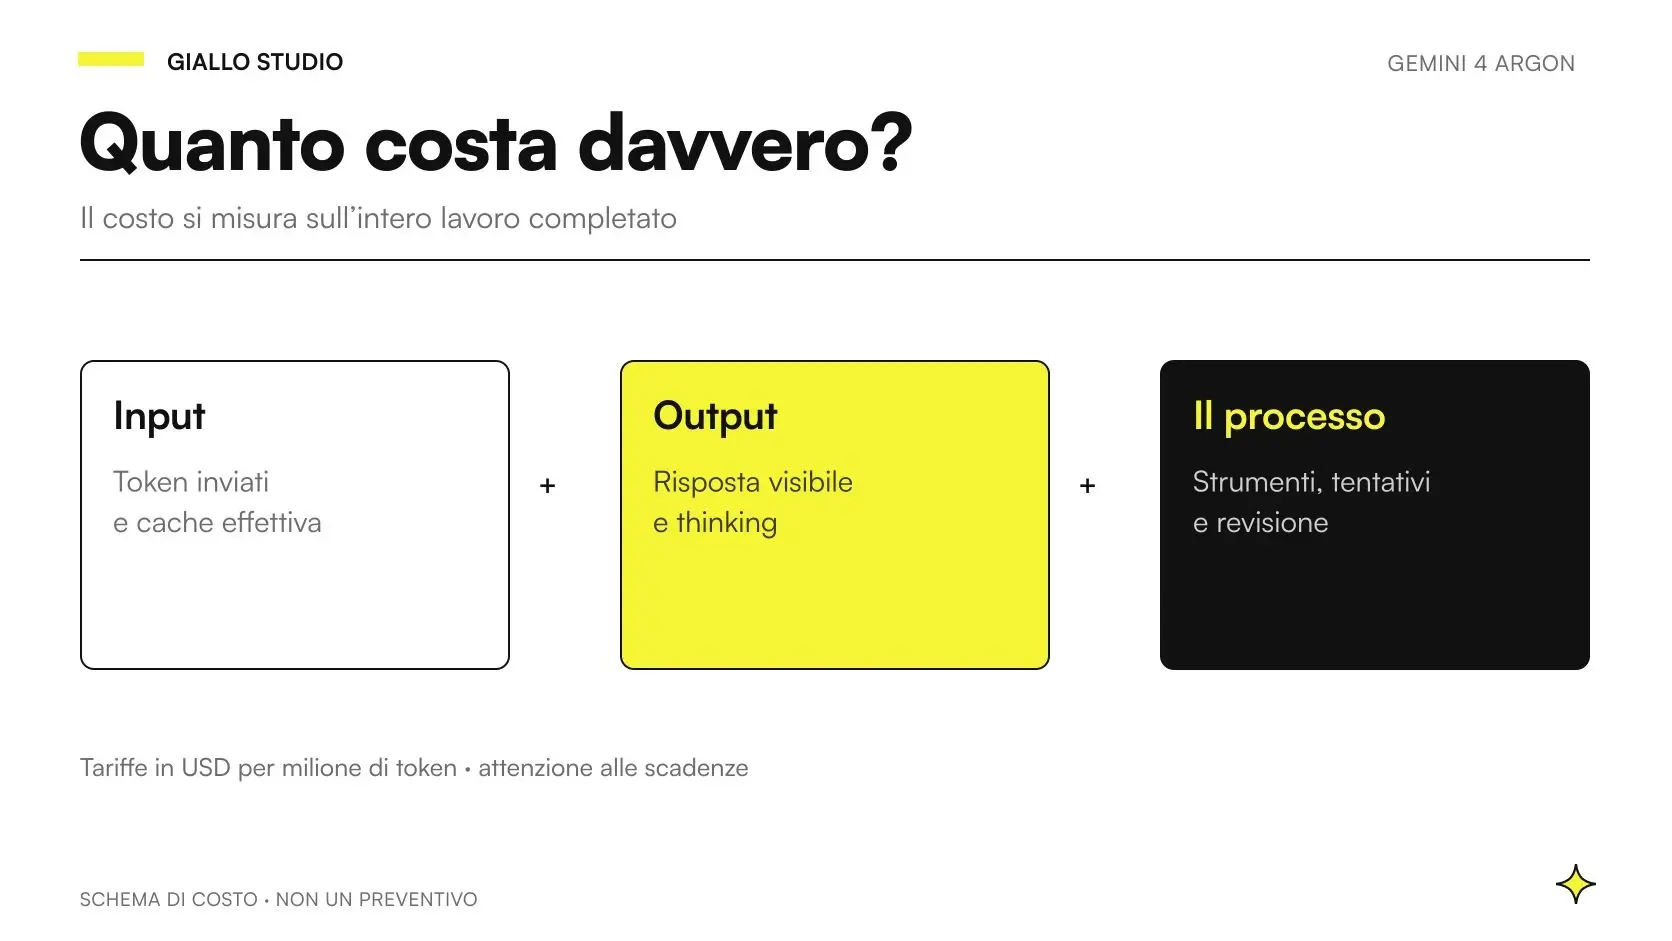
Calcolo dei prezzi di Gemini 4 Argon tra token di input, output, cache e richieste agli strumentiGemini 4 Argon: prezzi API e calcolo dei costi aziendaliPrezzi di Gemini 4 Argon, promozione fino al 30 novembre 2026, thinking, cache e strumenti. Esempi di calcolo per stimare un budget aziendale.
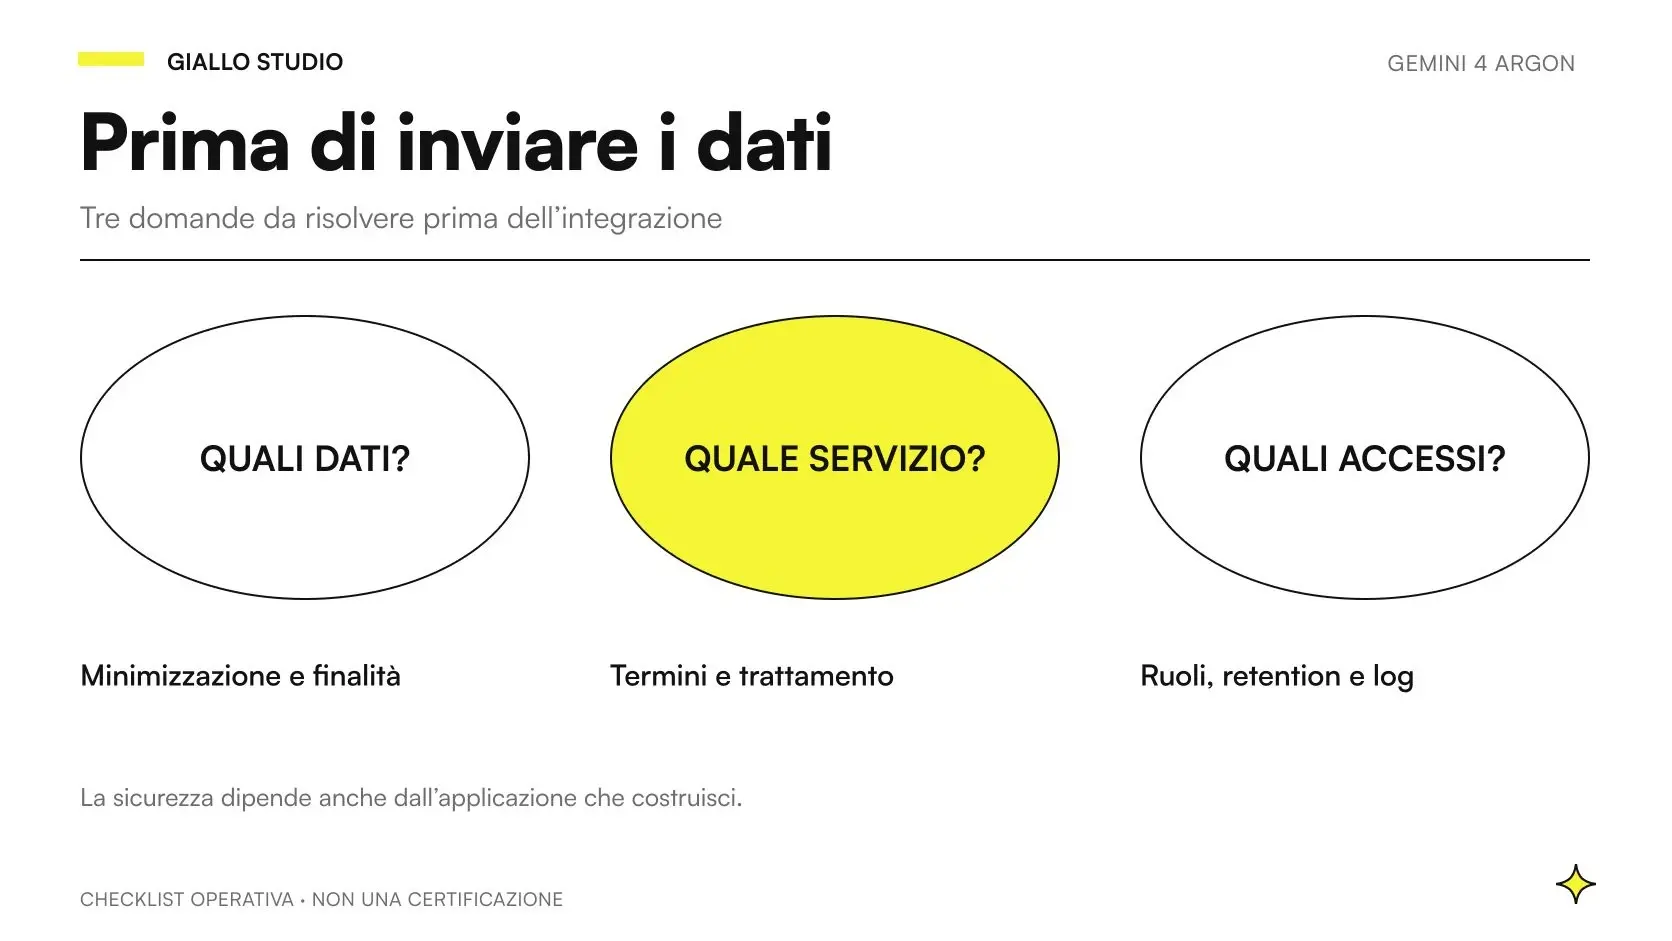
Gemini 4 Argon privacy: confini tra account, dati aziendali, conservazione e autorizzazioniGemini 4 Argon privacy e sicurezza: guida per aziendeGemini 4 Argon privacy: differenze tra consumer, API, Workspace e Cloud. Dati, training, conservazione e permessi da verificare prima della prova.
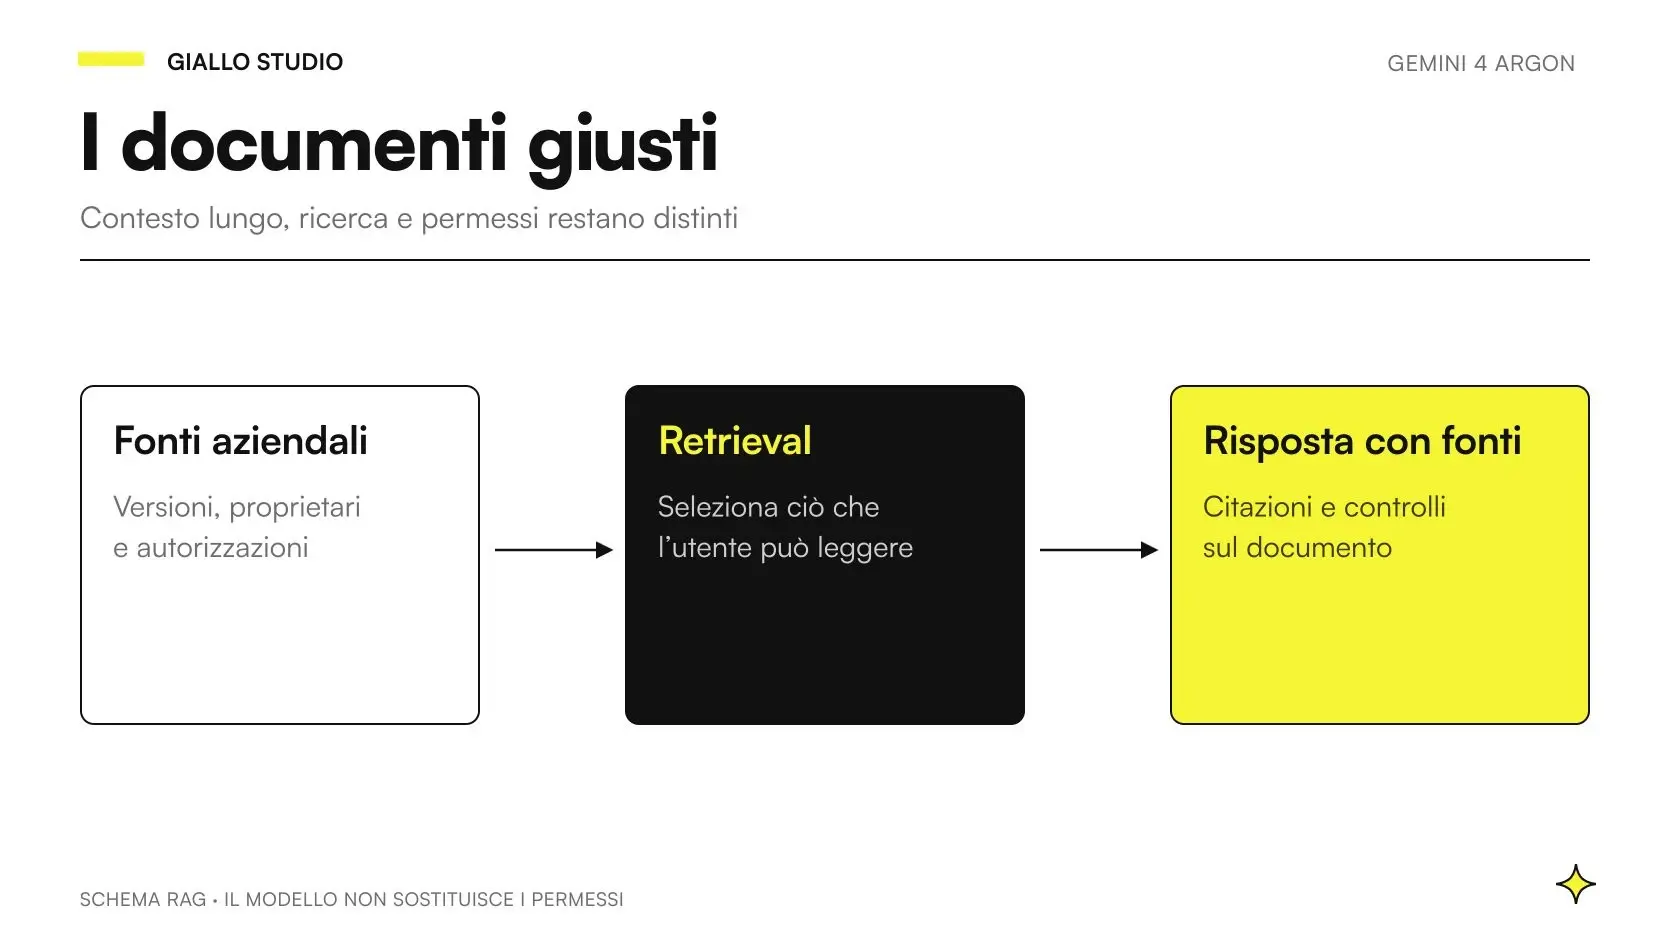
Gemini 4 Argon RAG recupera documenti aziendali autorizzati con versione, fonte e permessi distintiGemini 4 Argon per RAG e documenti aziendali: fonti e permessiGemini 4 Argon RAG per documenti aziendali: quando serve retrieval, come applicare i permessi e verificare citazioni, versioni e risposte mancanti.
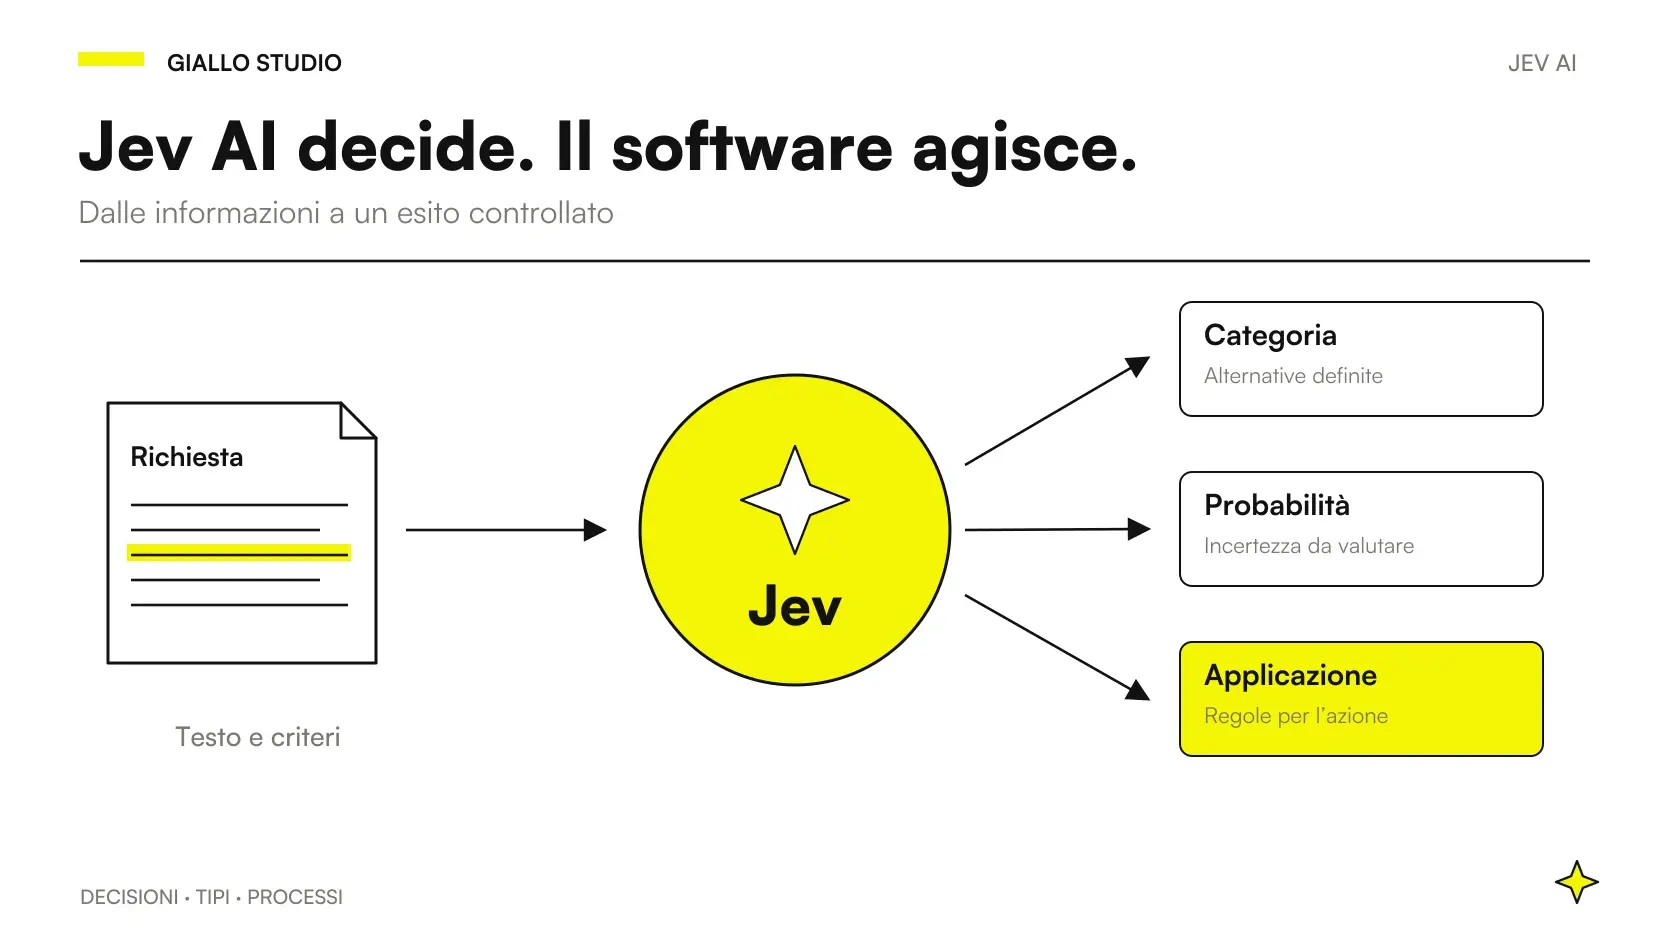
Jev AI al centro di un diagramma di decisioni e percorsi aziendaliJev AI: cos’è e cosa cambia nelle automazioni per PMIJev AI aiuta a classificare e instradare richieste. Scopri come inserirlo nei processi PMI, cosa affidargli e quali controlli mantenere.
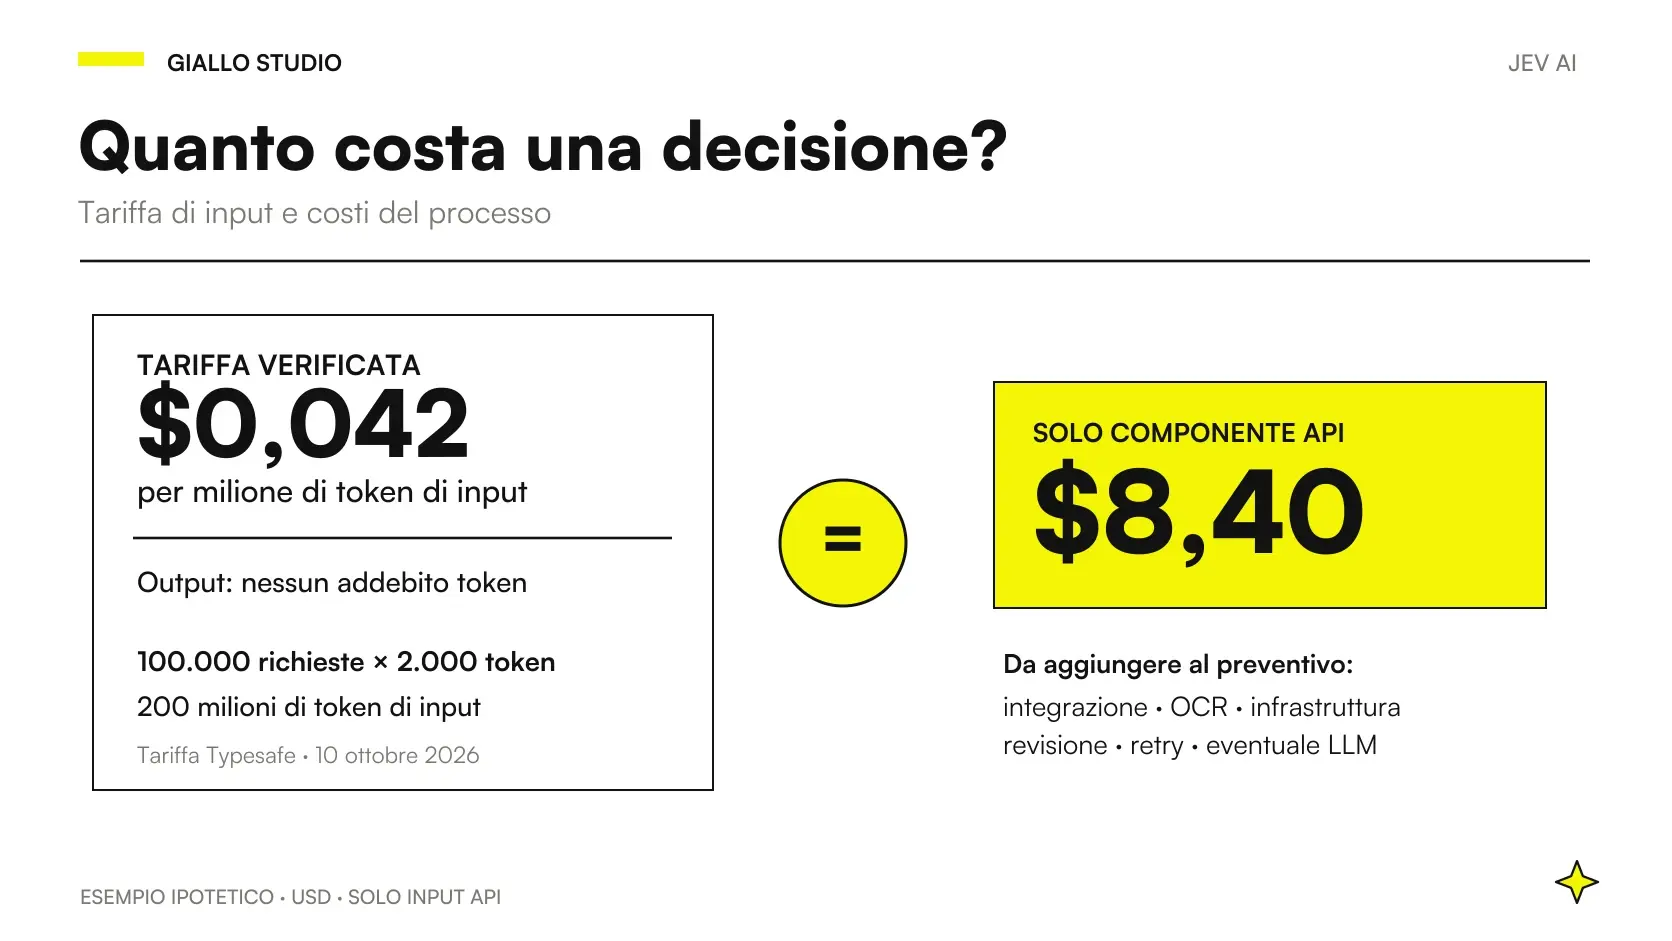
Tariffa API di Jev e calcolo illustrativo per centomila richieste da duemila tokenJev AI: prezzi API e costo di un’automazione aziendaleCalcoli trasparenti sui prezzi API di Jev AI: token, volumi, revisione e integrazione. Come costruire un budget senza confondere tariffa e risparmio.
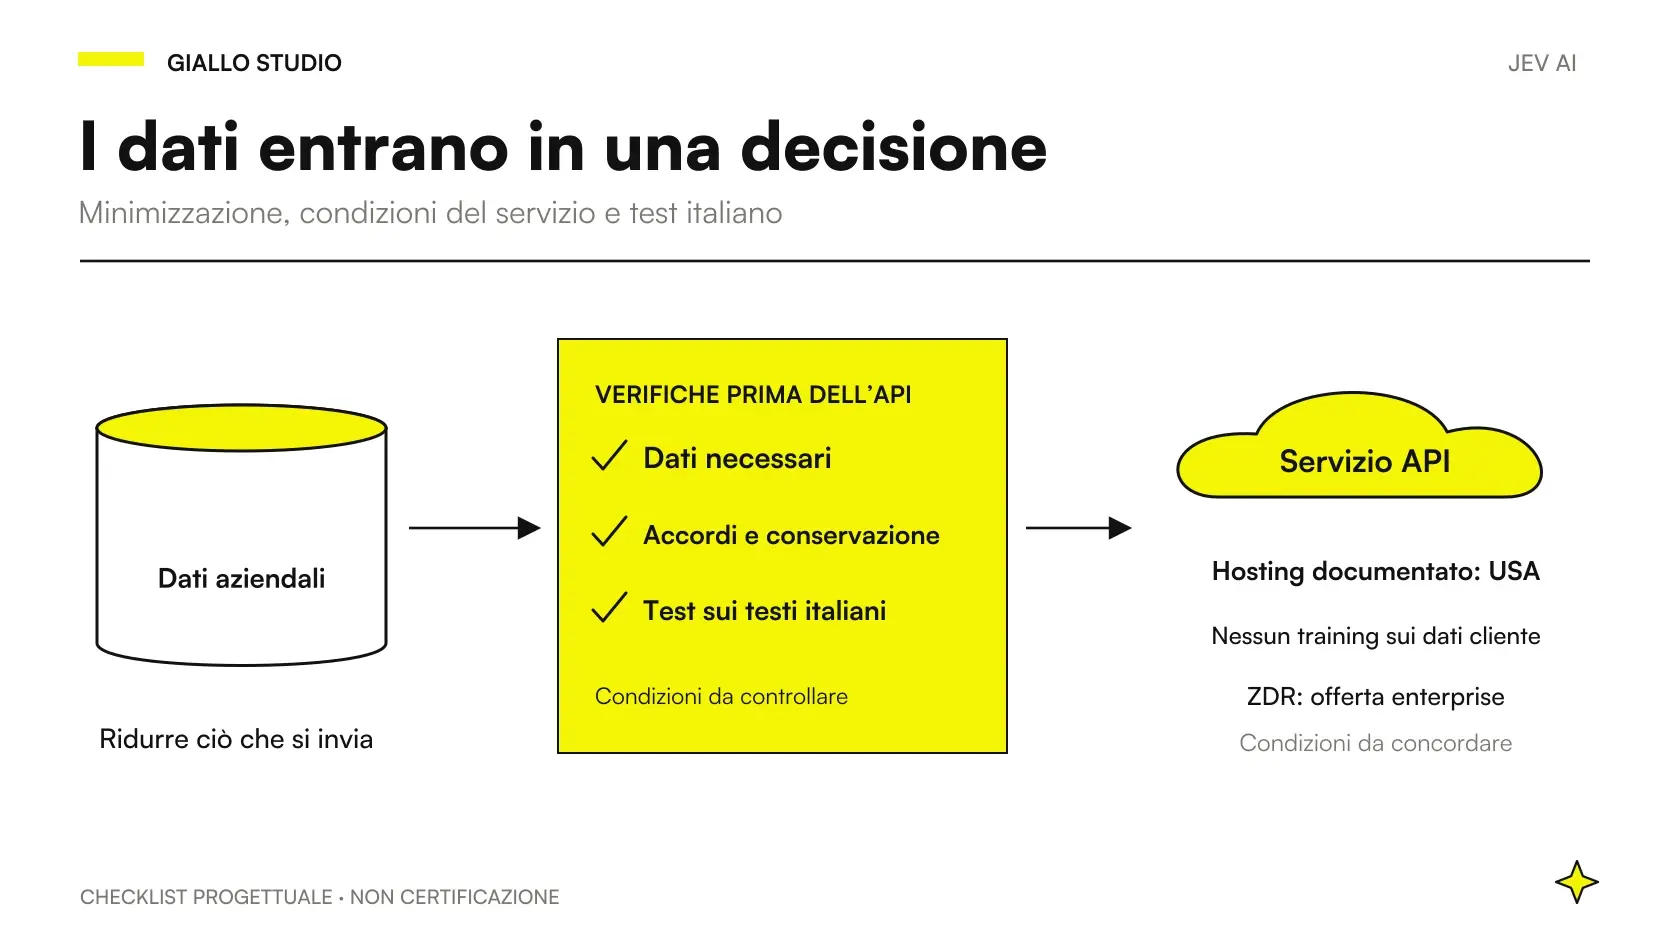
Database e checklist su dati, accordi e test italiano precedono API USA, no training e ZDR enterpriseJev AI in azienda: privacy, limiti e test sui dati italianiPrima di usare Jev AI in azienda: dati minimi, hosting USA, condizioni di conservazione e un pilota sui messaggi italiani con controlli concreti.
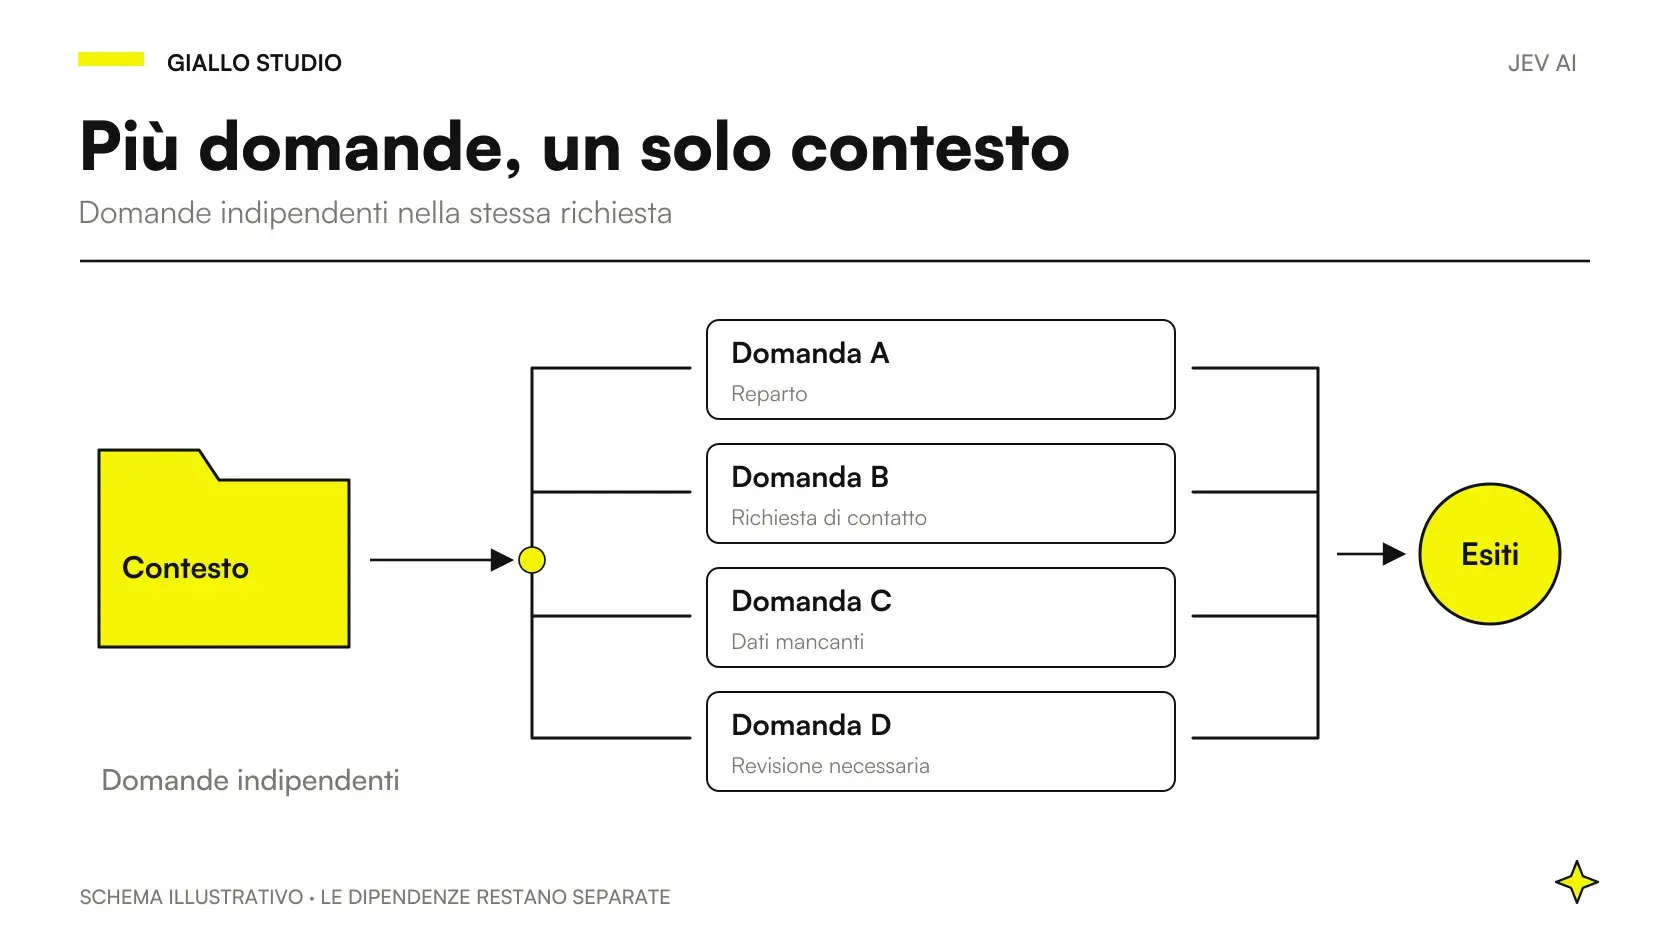
Un contesto condiviso si ramifica in quattro domande indipendenti per Jev AIDomande parallele in Jev AI: ridurre richieste e ripetizioniQuando raggruppare le domande in Jev AI e quando serve una seconda chiamata. Formule, dipendenze e misure per ottimizzare un flusso aziendale.
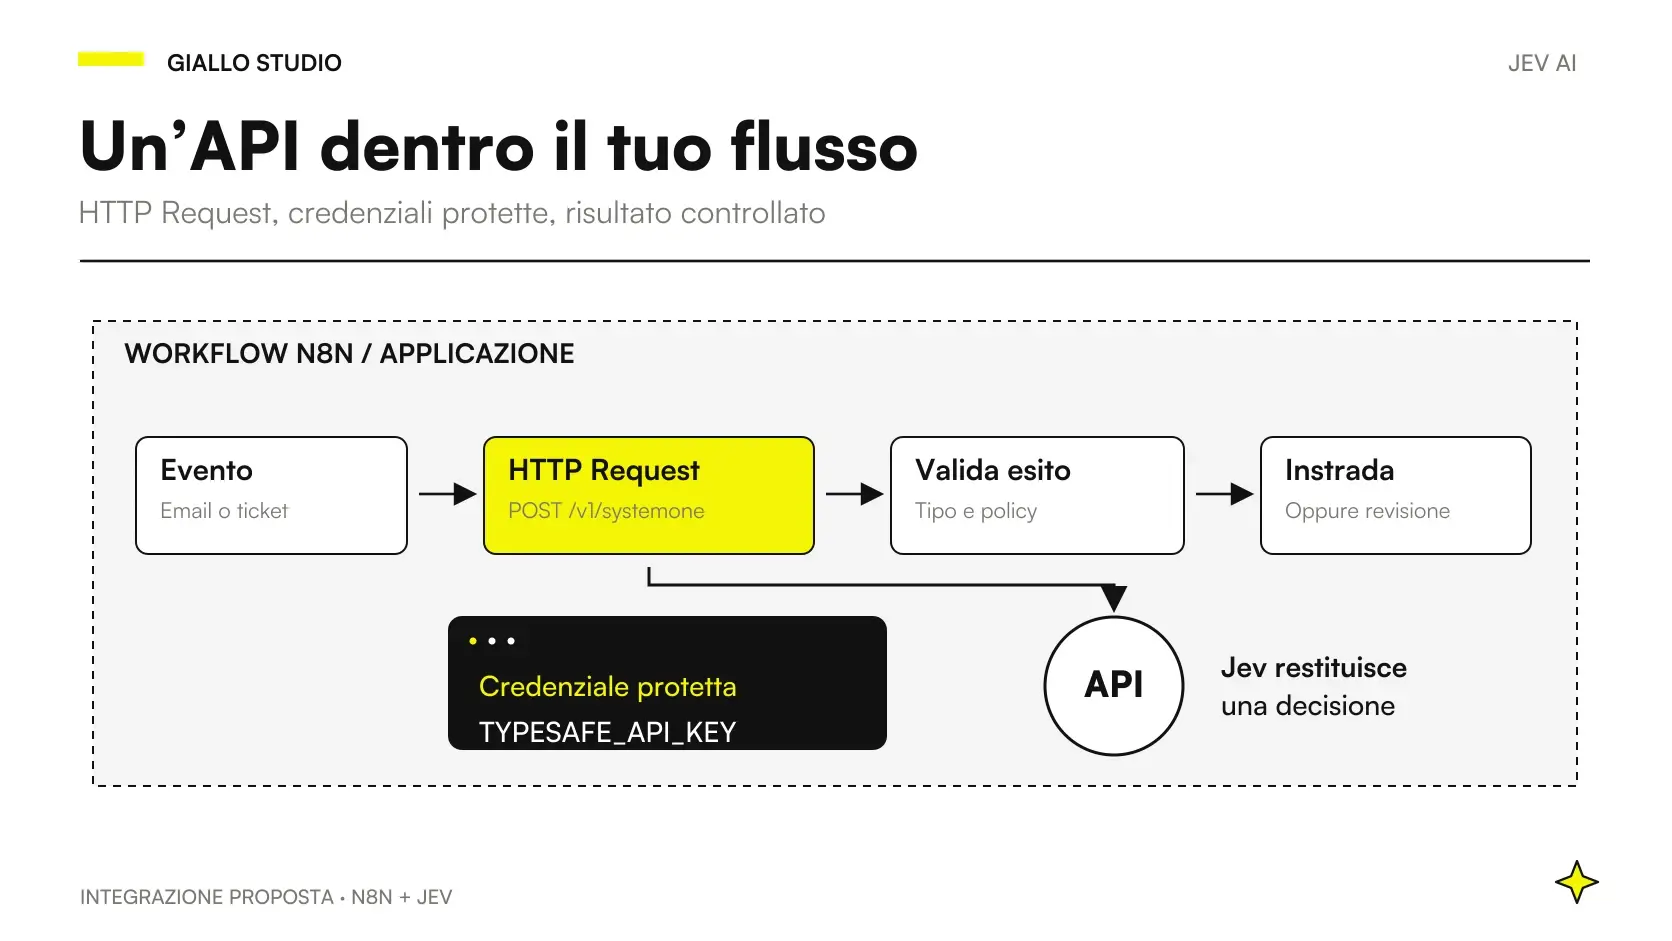
Flusso da n8n al nodo HTTP Request e all’API di Jev AIIntegrare Jev AI via API: un flusso per n8n e software aziendaliCome collegare Jev AI con HTTP Request in n8n: payload verificato, credenziali, errori e controlli prima di aggiornare un gestionale.
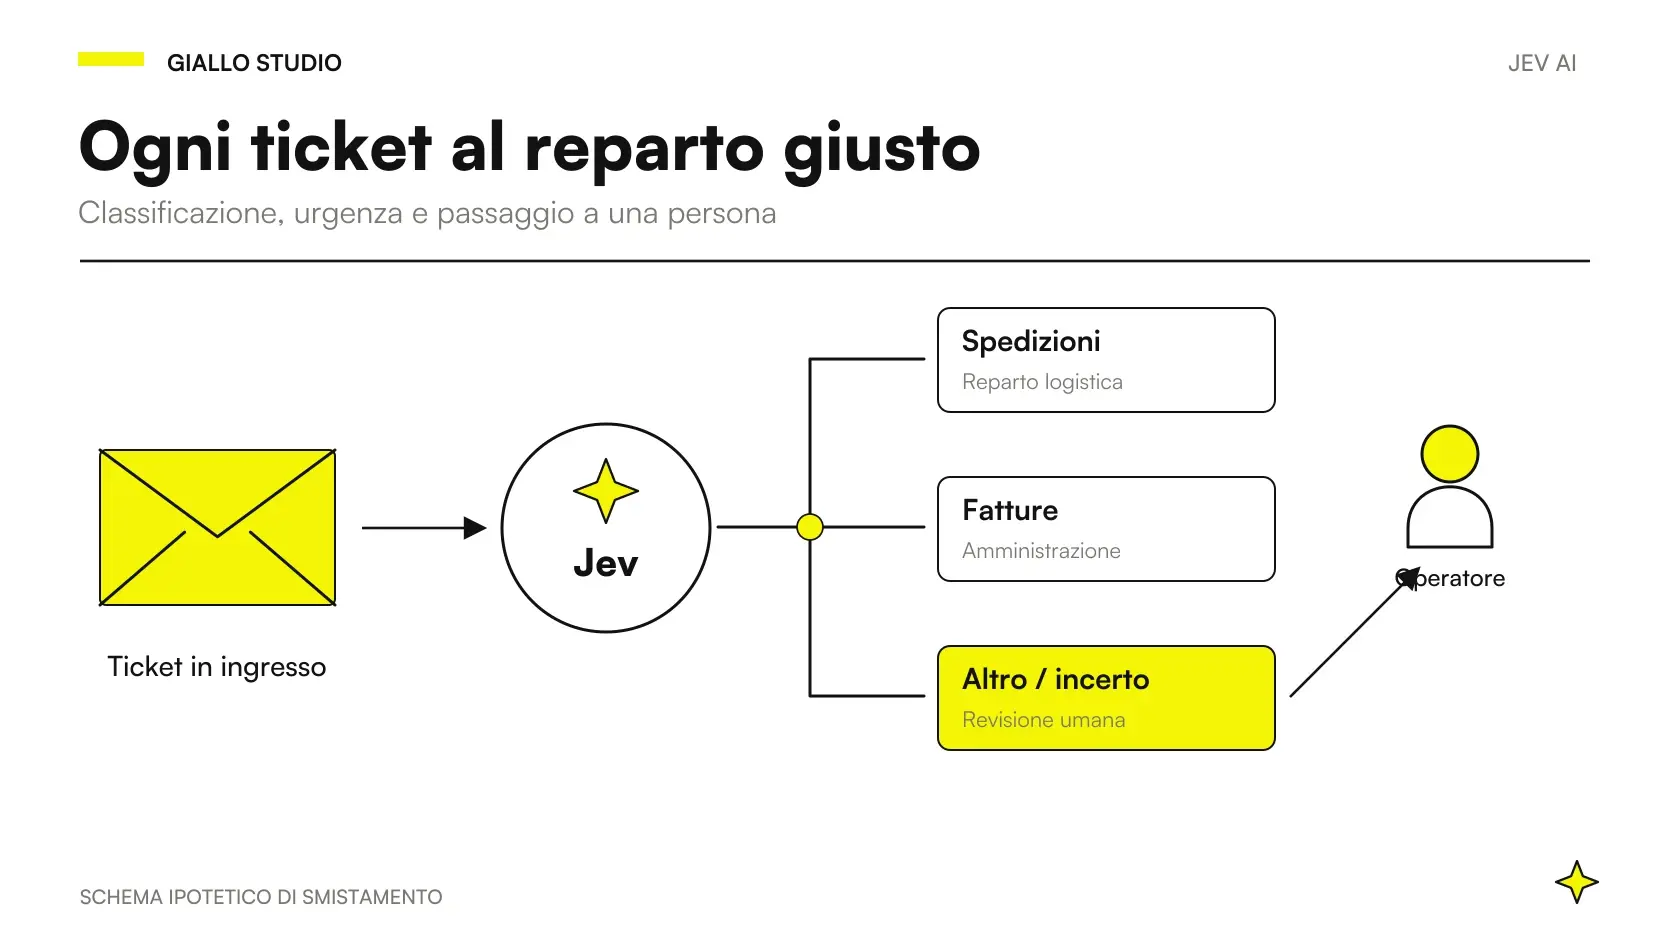
Ticket instradato da Jev AI verso spedizioni, fatture o revisione di un operatoreSmistare ticket di assistenza con Jev AI: reparto, urgenza e revisioneCome progettare il triage dei ticket con Jev AI: categorie chiare, urgenza separata, passaggi umani e controlli prima di assegnare le richieste.
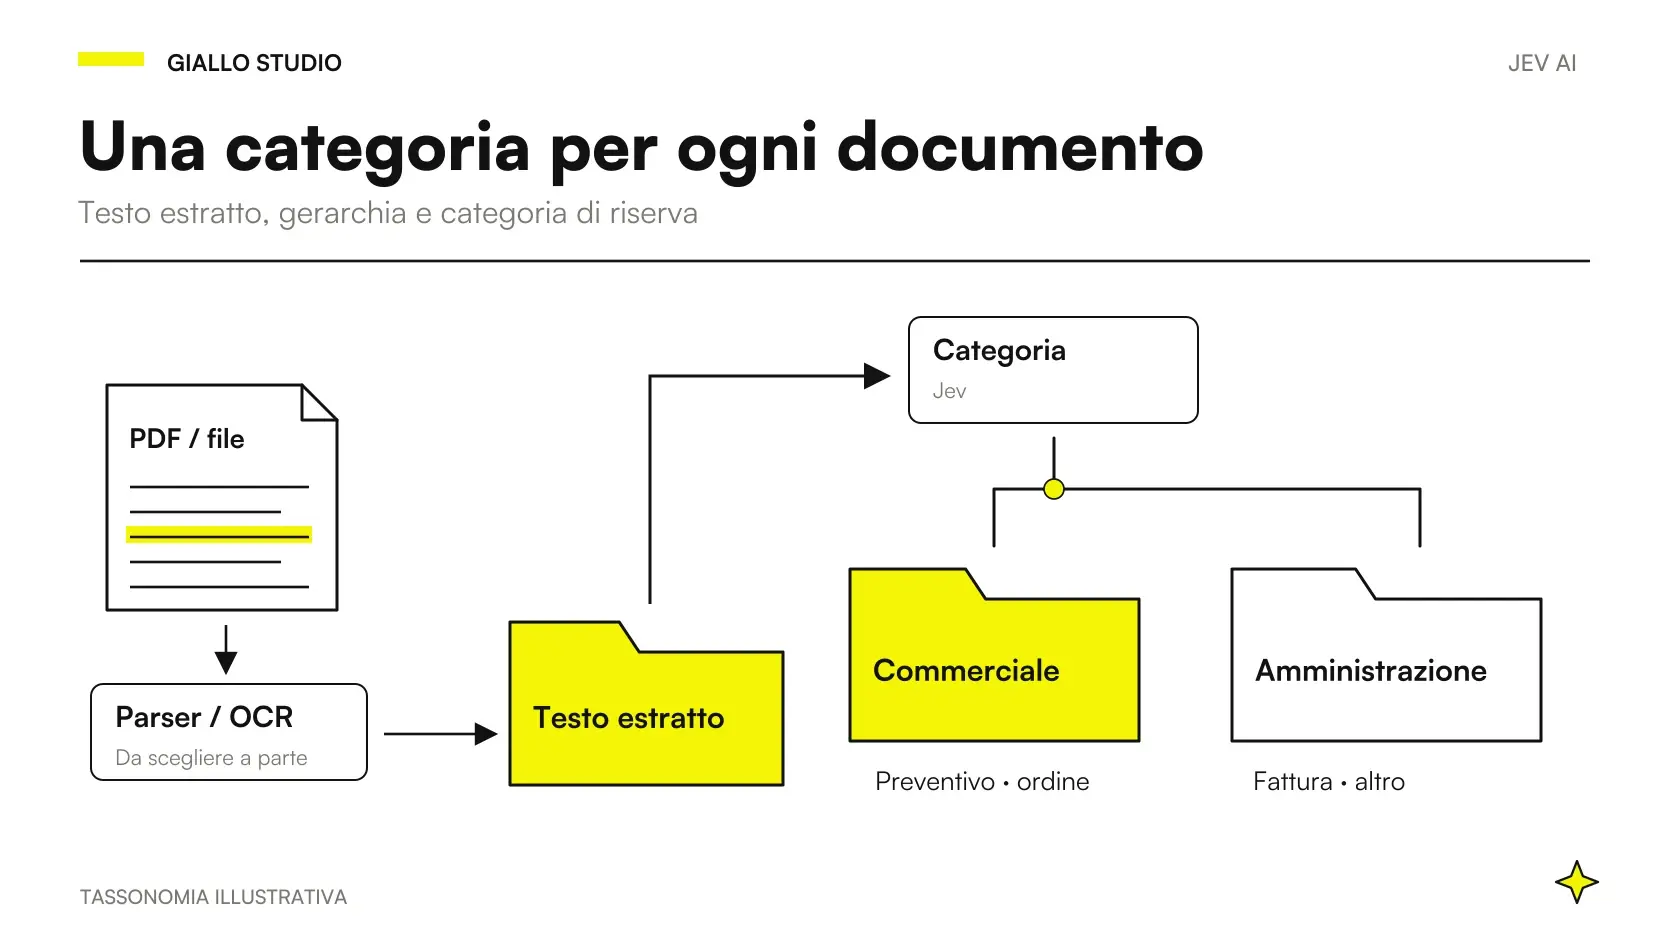
Documento preparato con parser o OCR e testo classificato in commerciale o amministrazioneClassificazione documenti con Jev AI: costruire categorie che reggonoOrganizza documenti aziendali con categorie, gerarchie e revisioni chiare. Un metodo per Jev AI, dalla preparazione del testo alle prove sull'archivio.
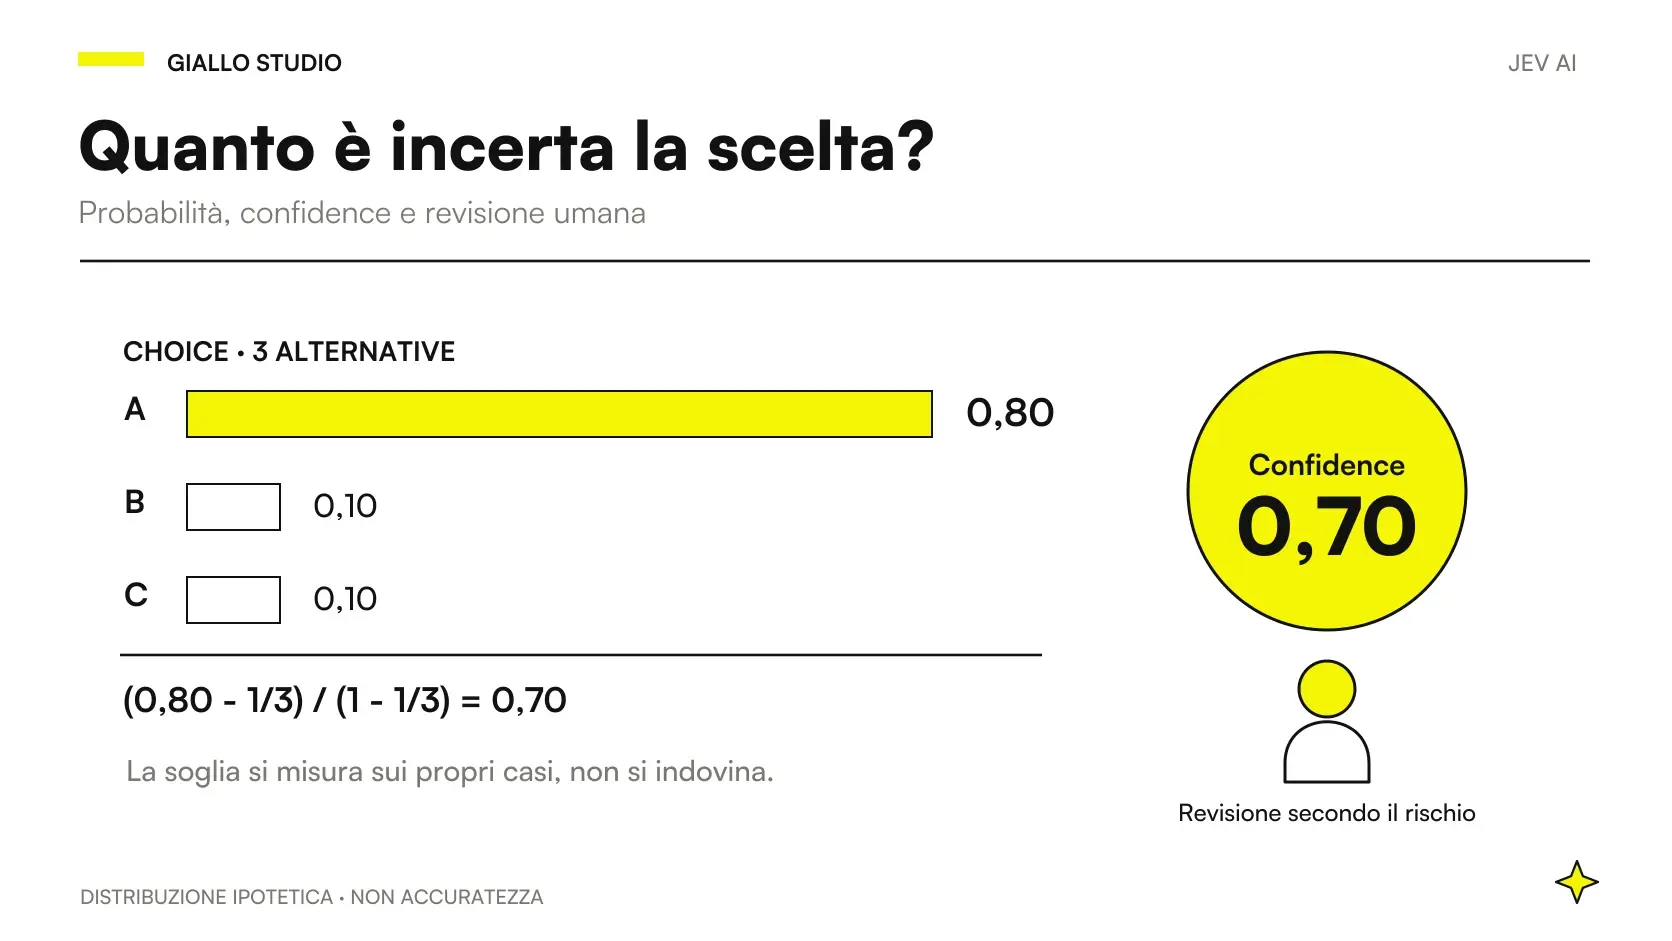
Tre barre Choice con probabilità 0,8, 0,1 e 0,1, confidence 0,7 e un operatore per la revisioneJev AI, confidence e probabilità: quando far intervenire una personaCome interpretare confidence e probabilità di Jev AI, scegliere soglie per il processo e costruire una revisione umana che corregge gli errori.
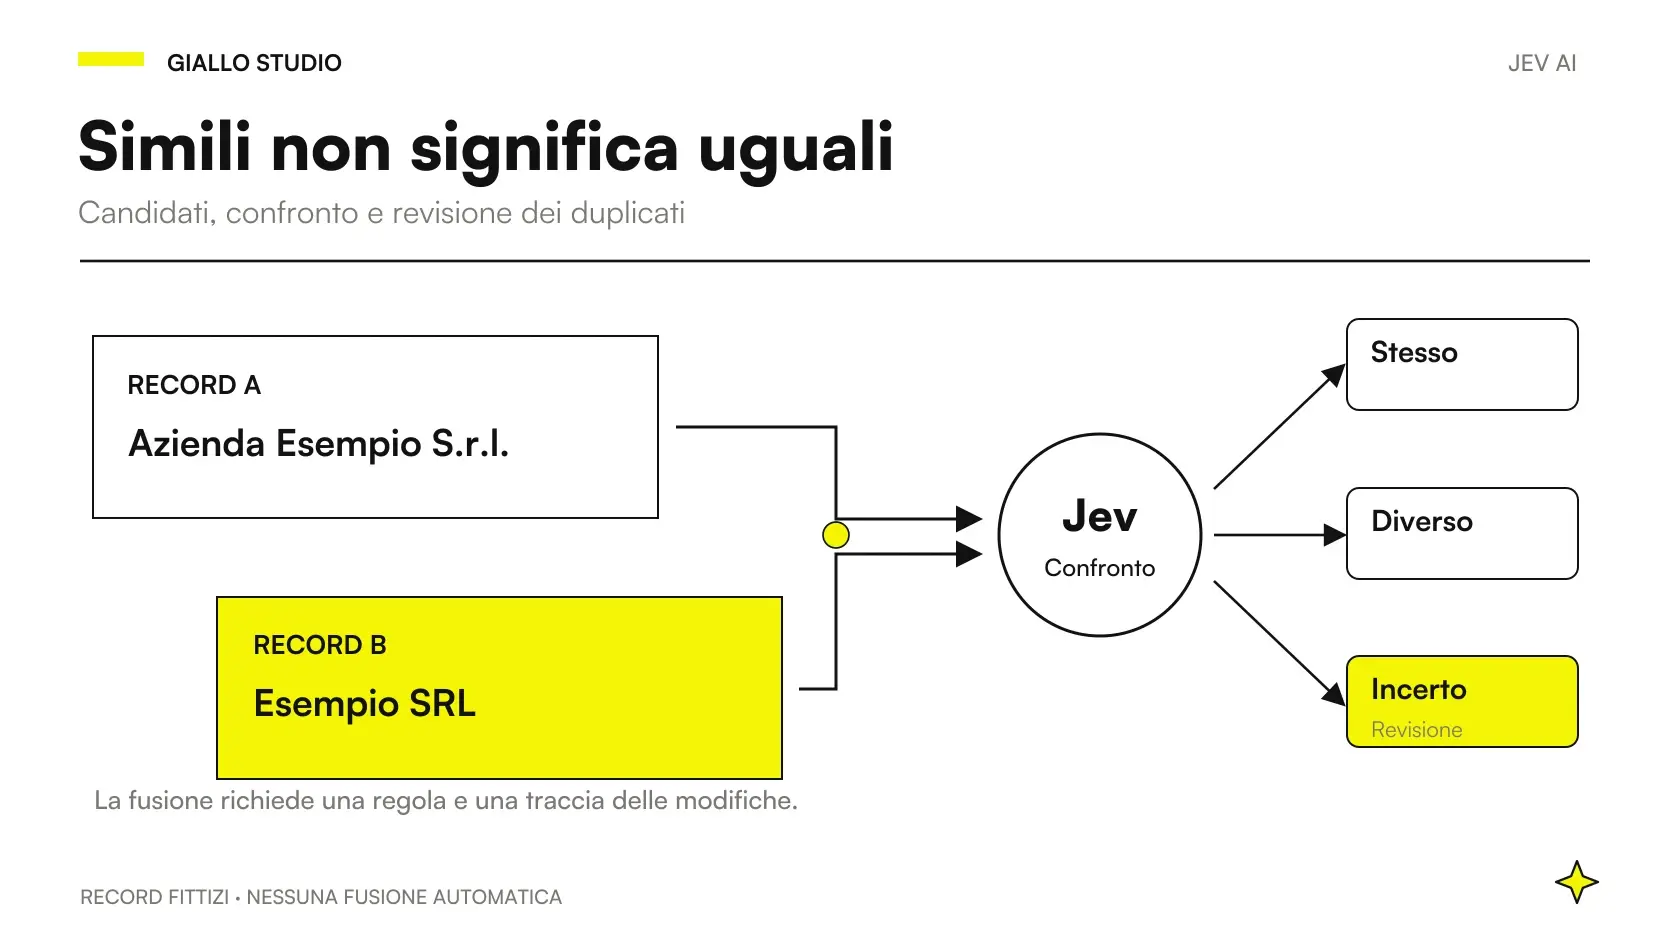
Due record aziendali fittizi confrontati con Jev AI tra stesso, diverso e incerto, prima della revisioneDeduplicazione con Jev AI: collegare record senza fondere quelli sbagliatiUsa Jev AI per confrontare coppie candidate nel CRM o nel catalogo. Separa stesso, diverso e incerto, con revisione prima di ogni fusione.
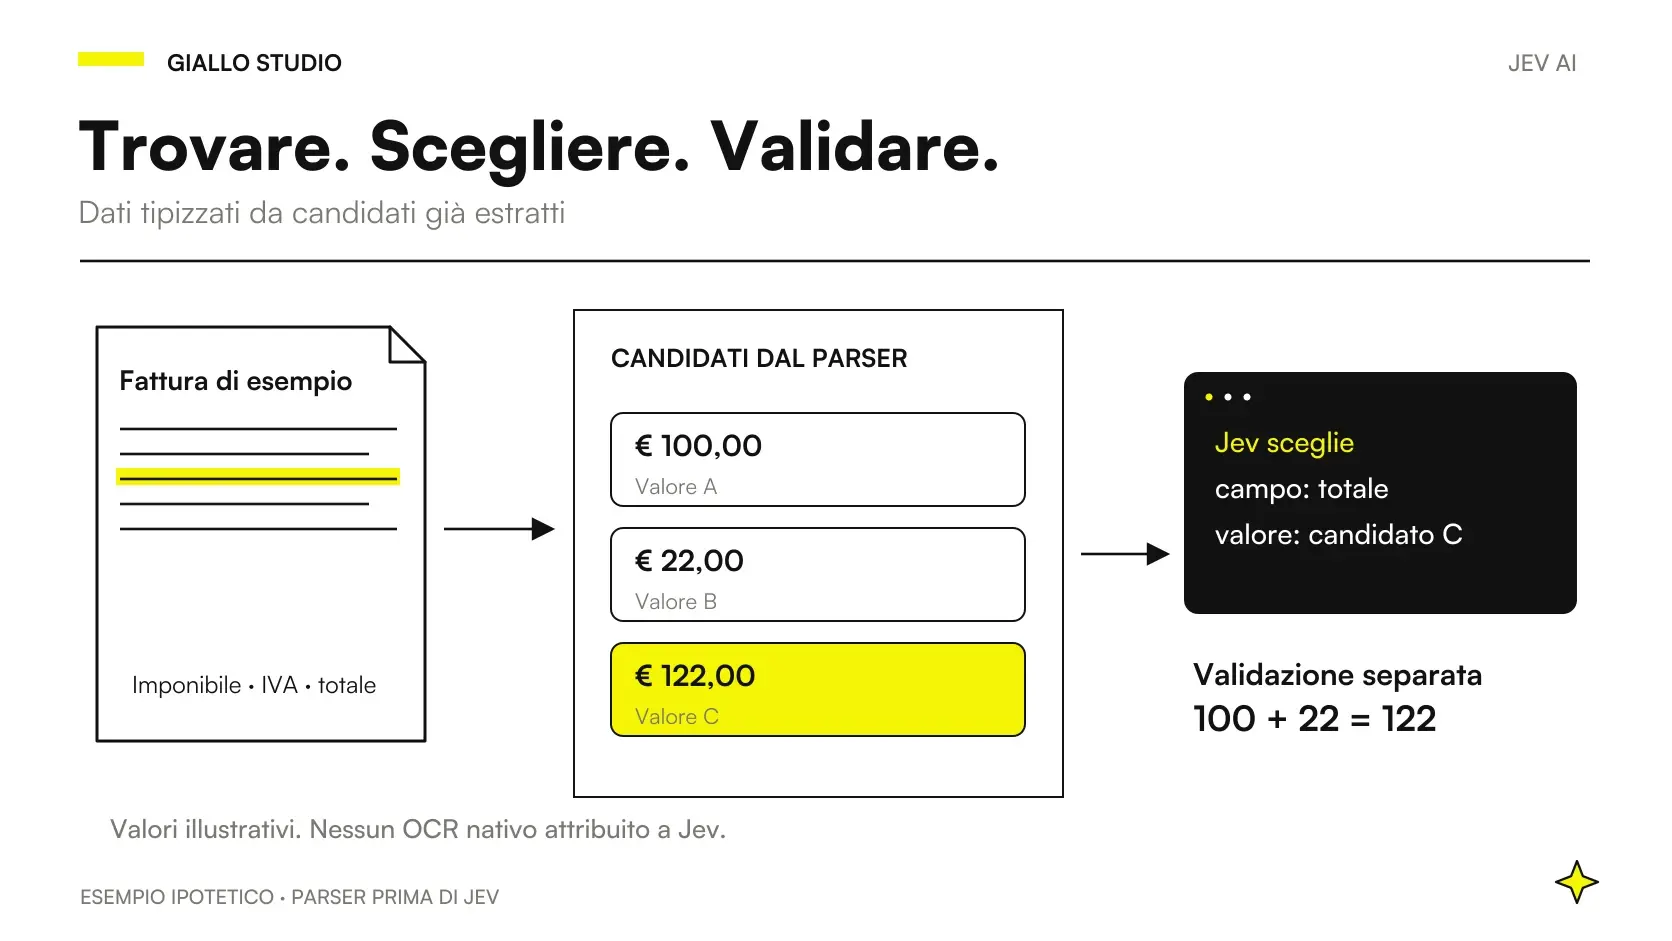
Esempio ipotetico: Jev sceglie il totale tra importi candidati e il software verifica 100 più 22 uguale 122Jev AI per estrarre dati da email e fatture: prima trovare, poi scegliereSepara parser, candidati, scelta semantica e controlli: un metodo per estrarre dati con Jev AI senza inventare importi, date o stringhe mancanti.
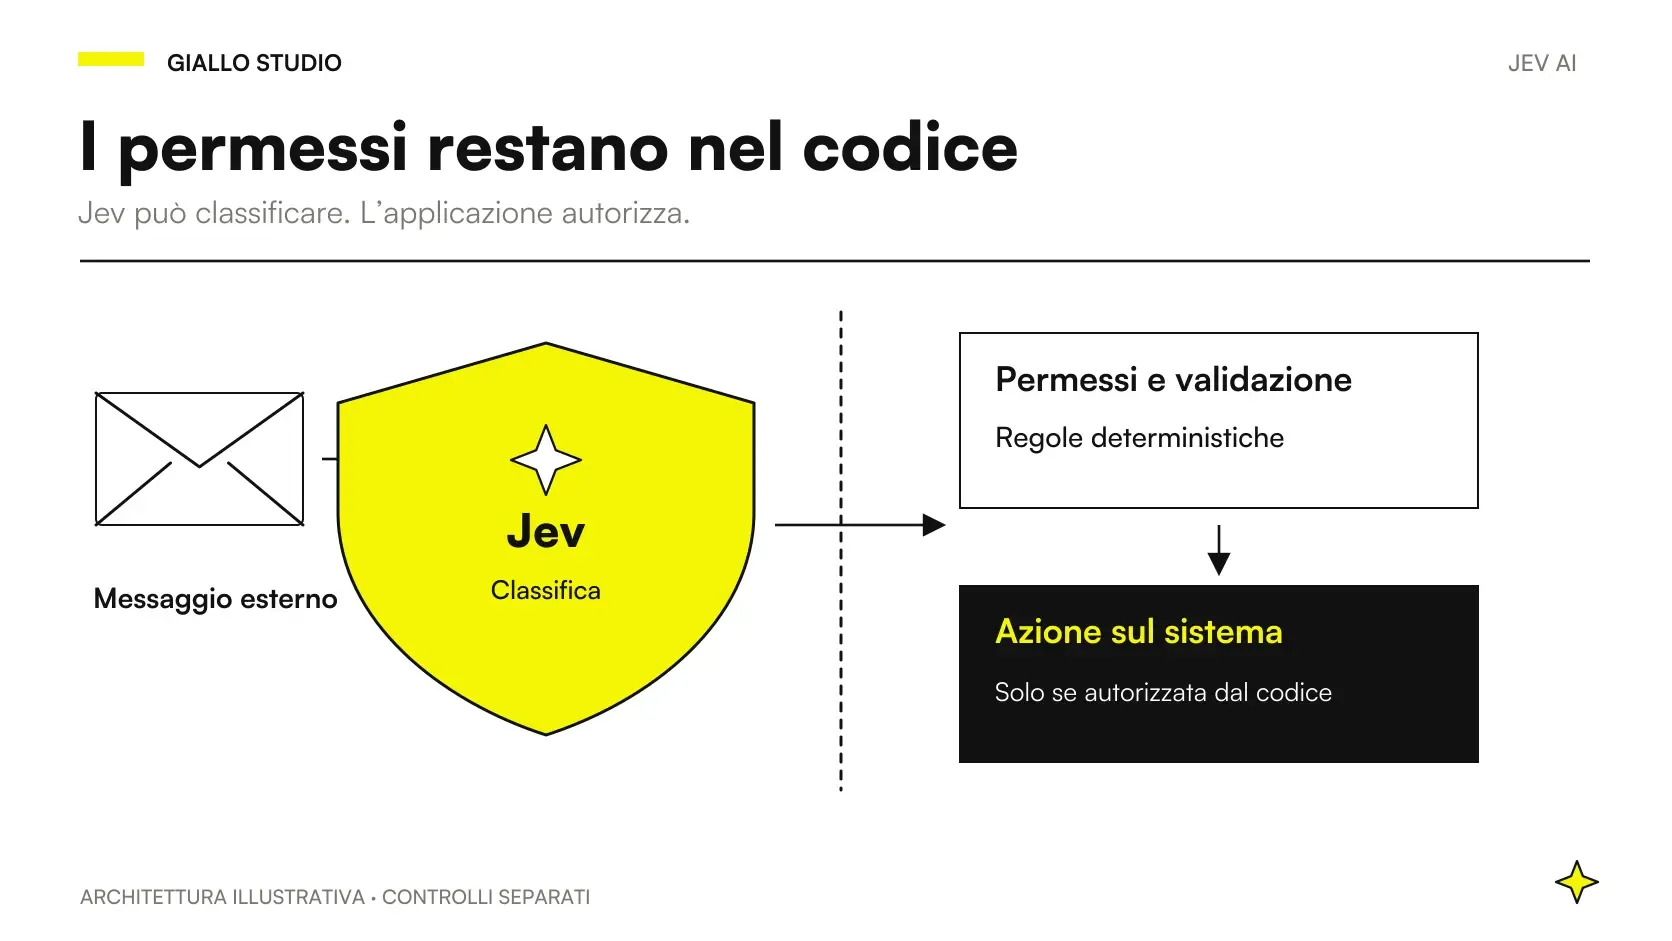
Messaggio valutato da Jev e poi sottoposto ai permessi deterministici del codice prima dell’azioneGuardrail per chatbot aziendali: dove usare Jev AICome usare Jev AI per classificare rischi e instradare messaggi, mantenendo autorizzazioni, controlli tecnici e approvazioni nel software.
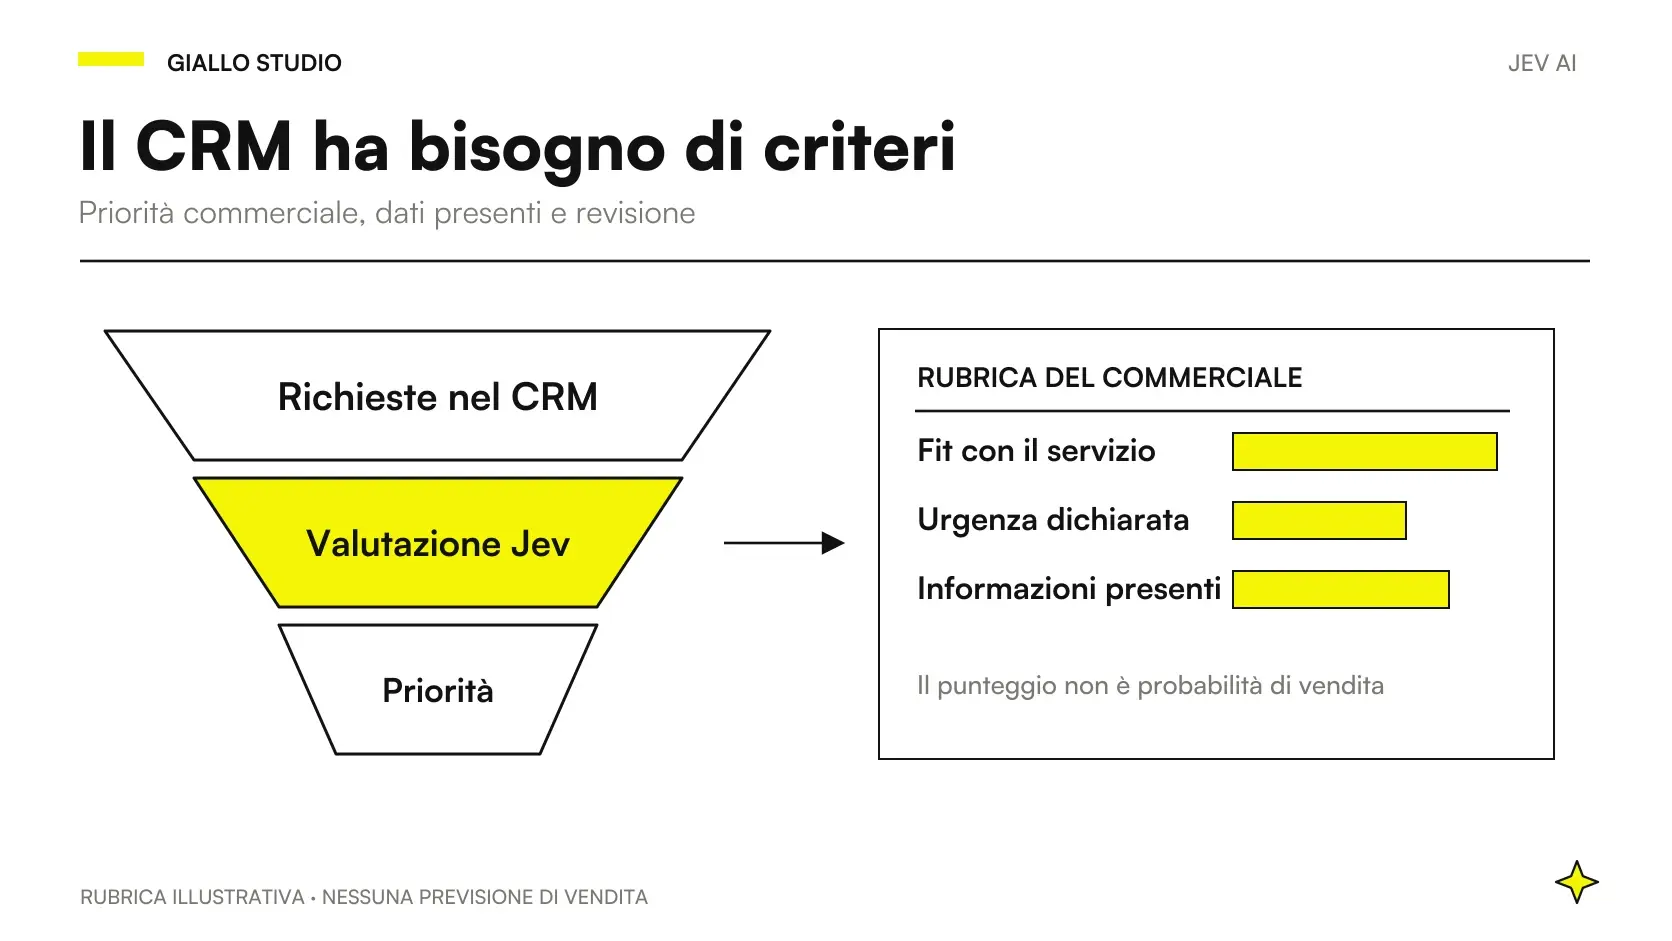
Richieste CRM ordinate con Jev AI e rubriche illustrative per fit, urgenza e informazioniLead scoring con Jev AI: dare priorità alle richieste nel CRMProgetta priorità commerciali con Jev AI: rubriche separate per fit, urgenza e completezza, pesi controllati dal team e verifica nel CRM.
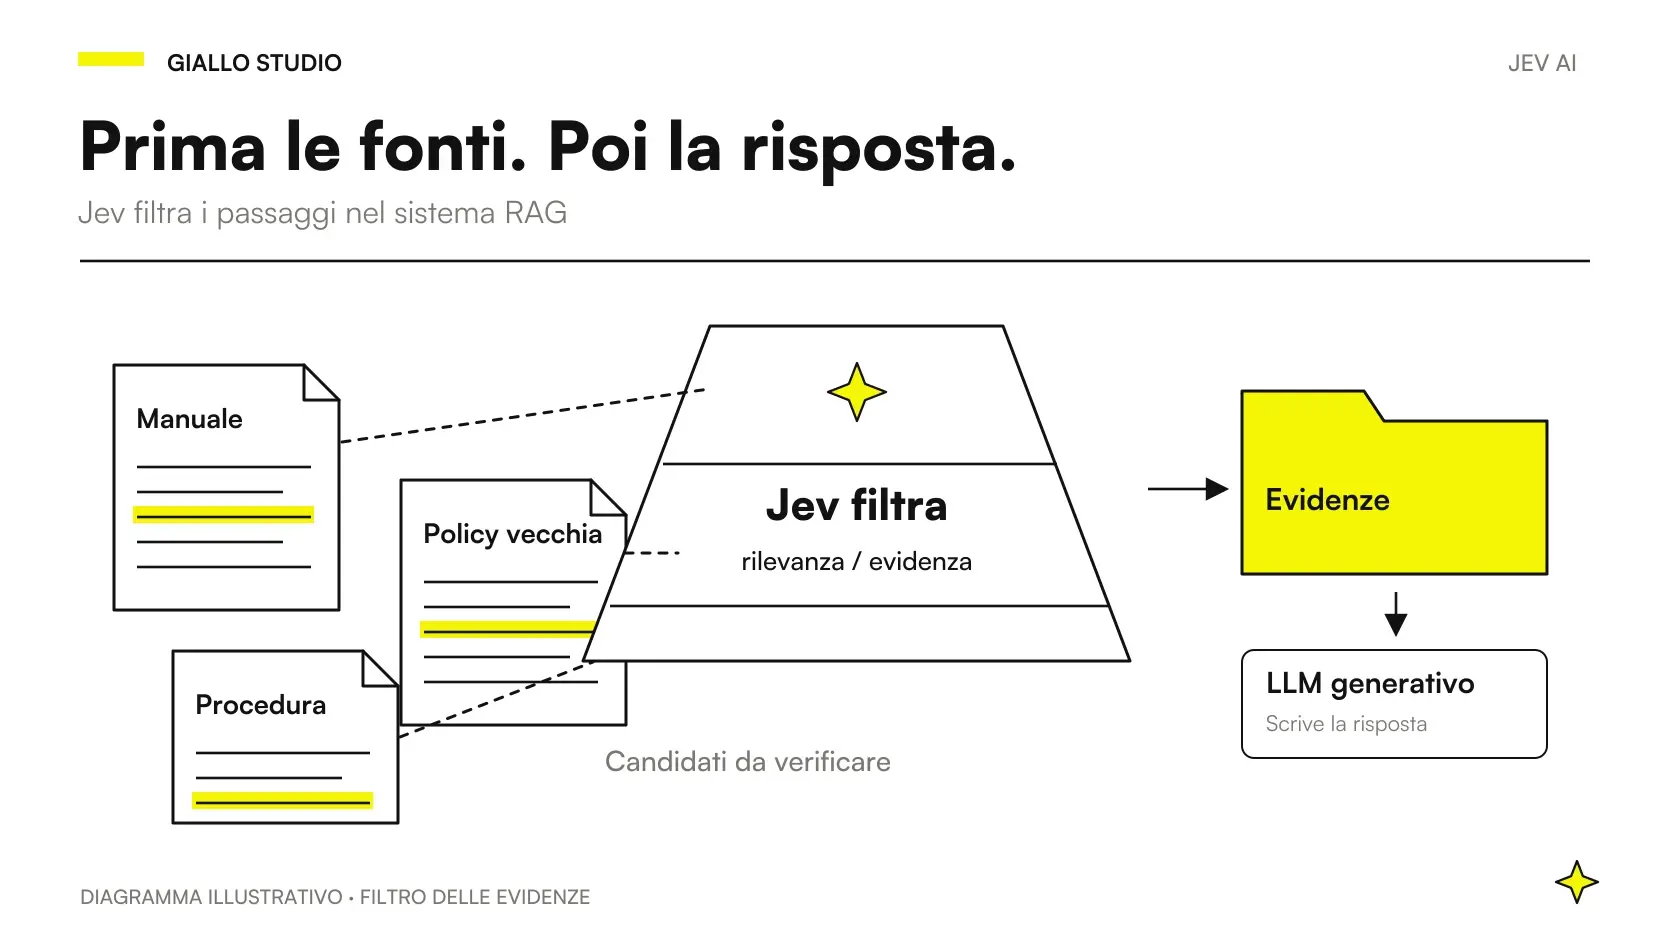
Documenti attraversano un setaccio verso le evidenze e un LLM che scrive la rispostaJev AI nel RAG: scegliere le fonti prima della rispostaDove inserire Jev AI in un RAG aziendale: pertinenza, evidenza e conflitti, con permessi separati e un test concreto sulla knowledge base.
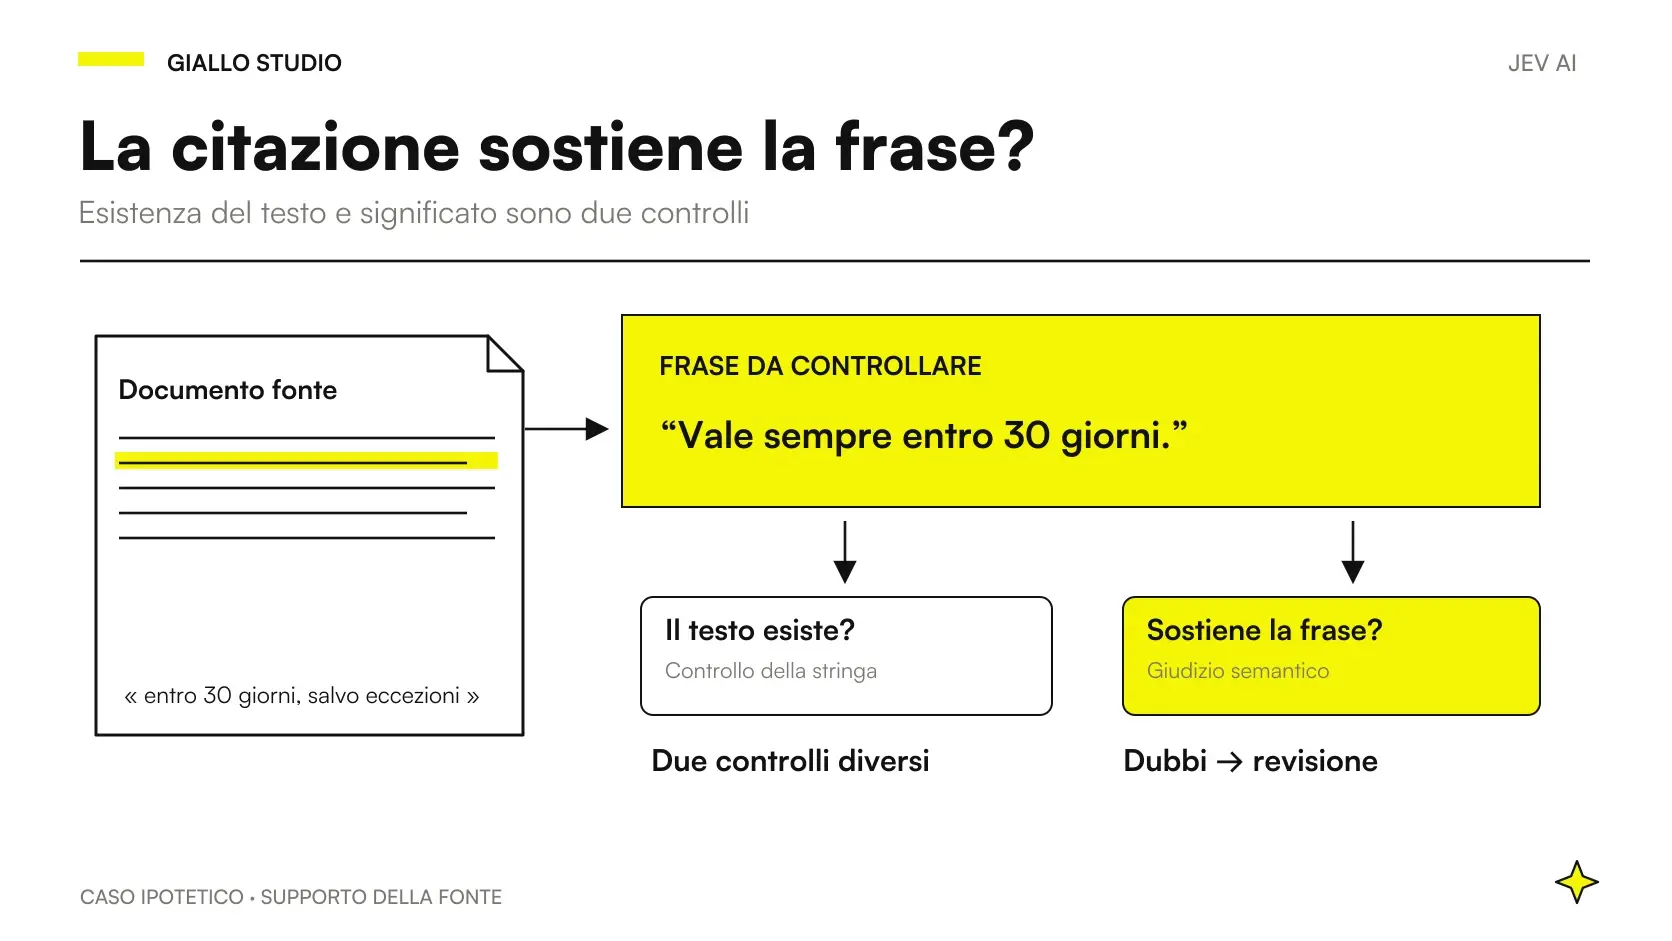
Documento con una condizione sui trenta giorni confrontato con una frase che omette le eccezioniVerificare le citazioni dei chatbot con Jev AIUna fonte esistente non basta: scopri come verificare citazioni e supporto delle risposte AI, gestire condizioni e fermare le affermazioni dubbie.
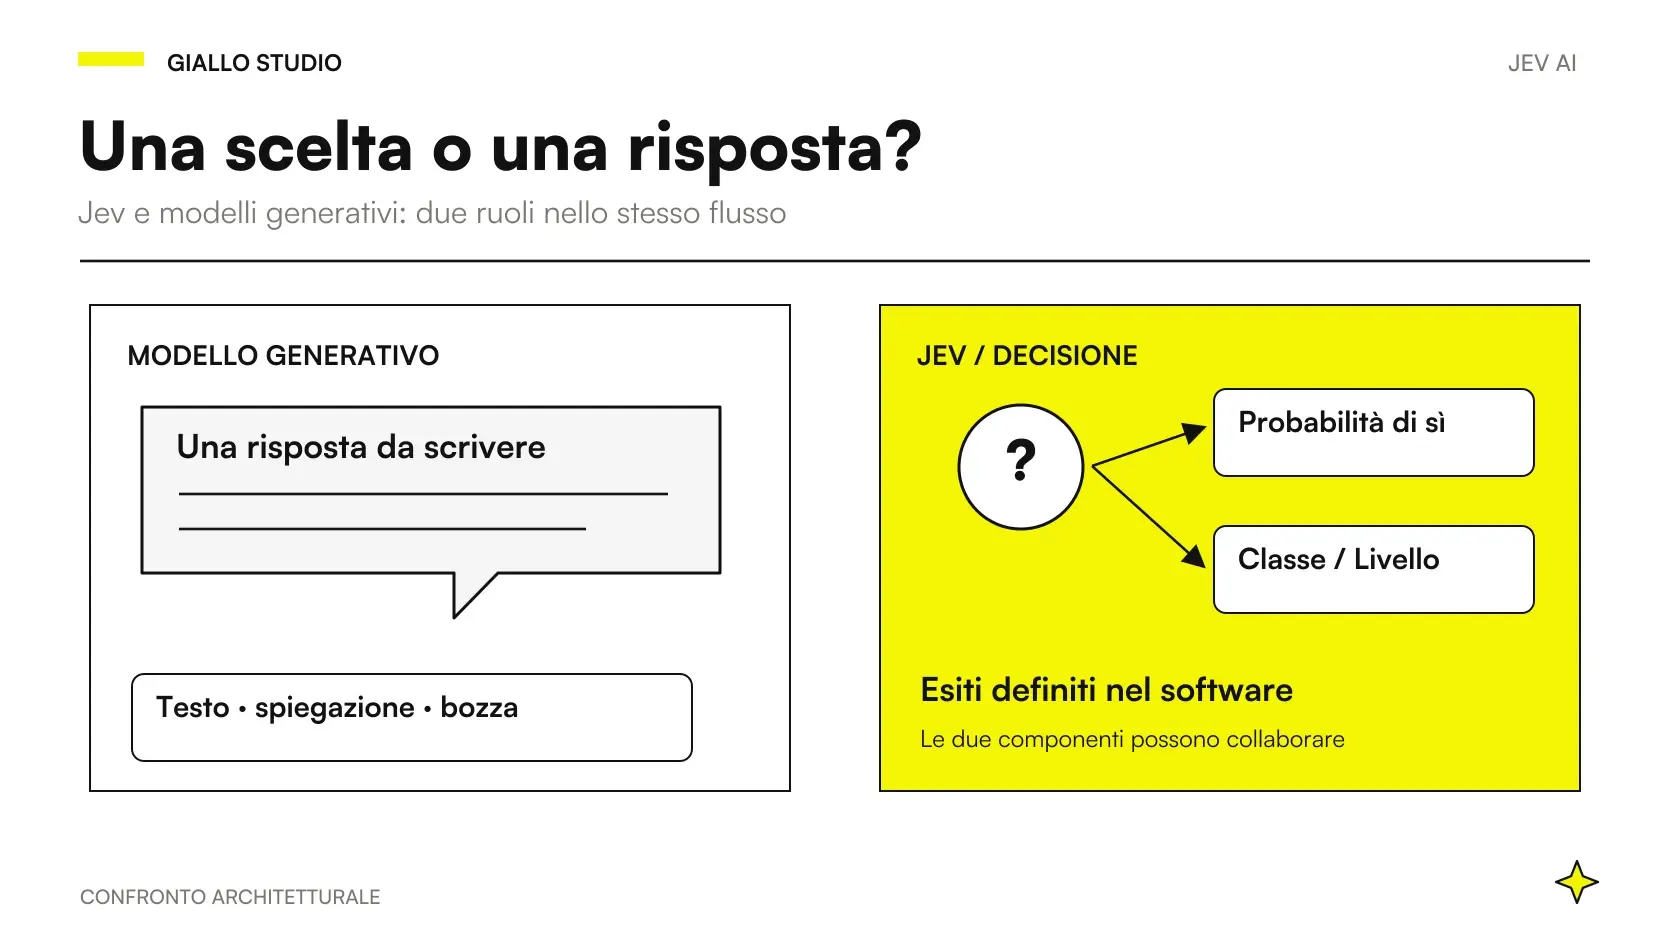
Confronto visivo tra un percorso di decisione e uno di generazione testualeJev AI vs LLM: come scegliere il modello giustoDecisioni chiuse, testi e ragionamento richiedono ruoli diversi. Una matrice per scegliere Jev AI, un LLM o un flusso misto nei processi PMI.
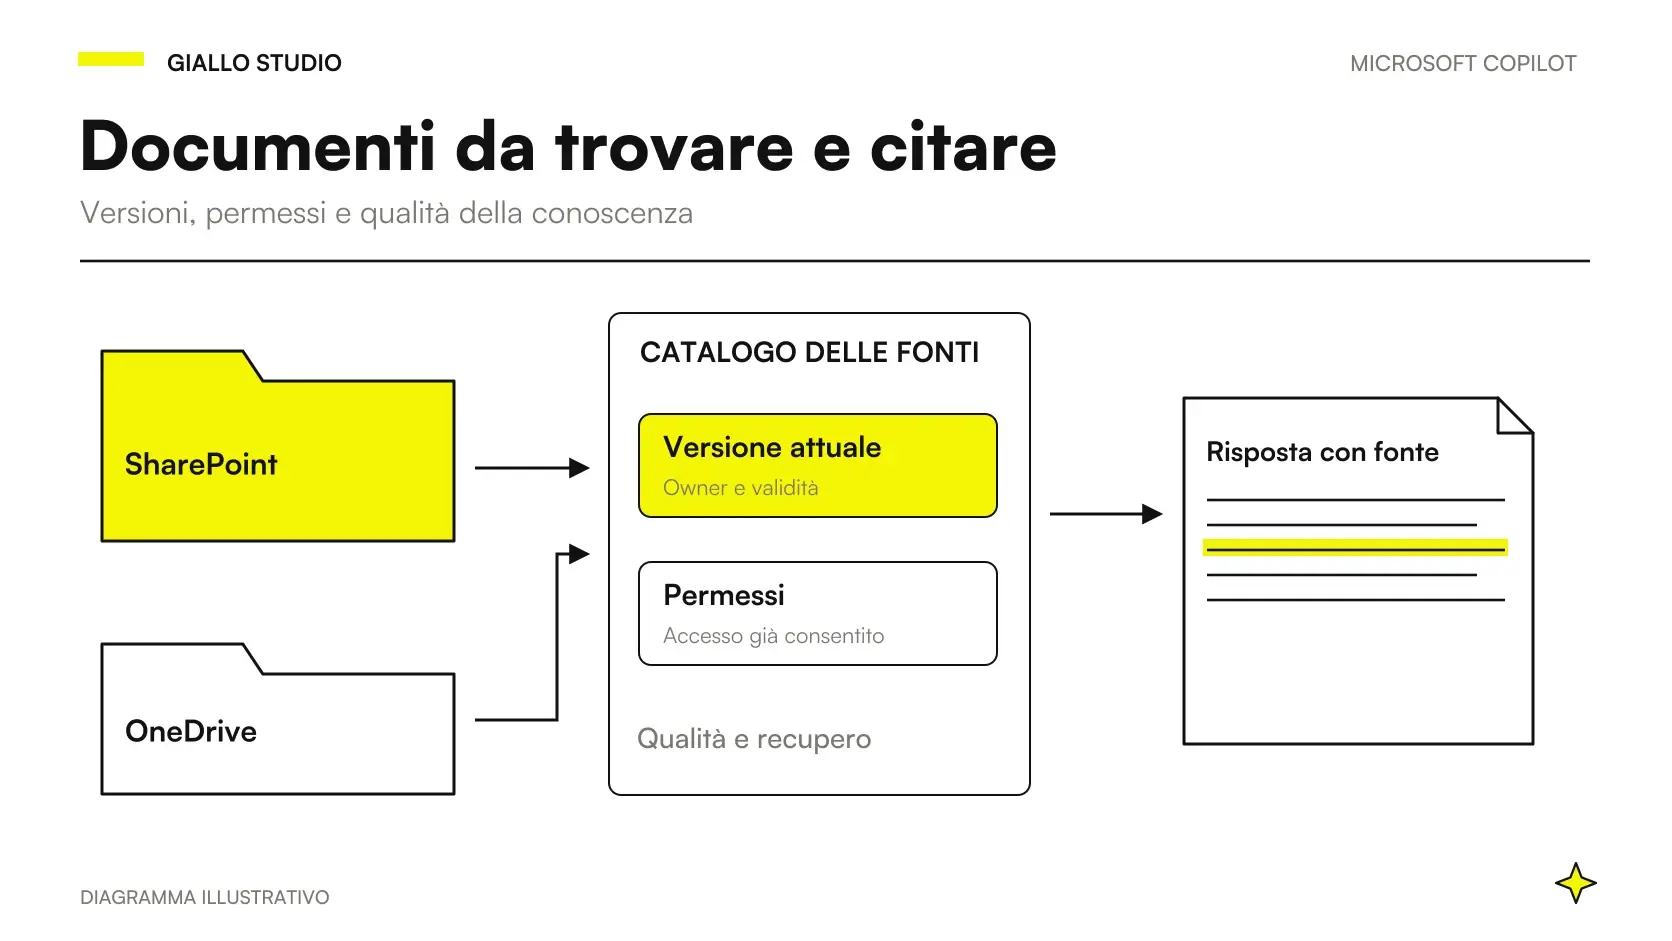
Un archivio digitale collega documenti approvati, versioni e accessi alle risposte di CopilotCopilot, SharePoint e OneDrive: trovare documenti affidabiliCome preparare SharePoint e OneDrive per Copilot: documenti approvati, versioni, permessi e prove di ricerca. Un metodo concreto per gli archivi delle PMI.
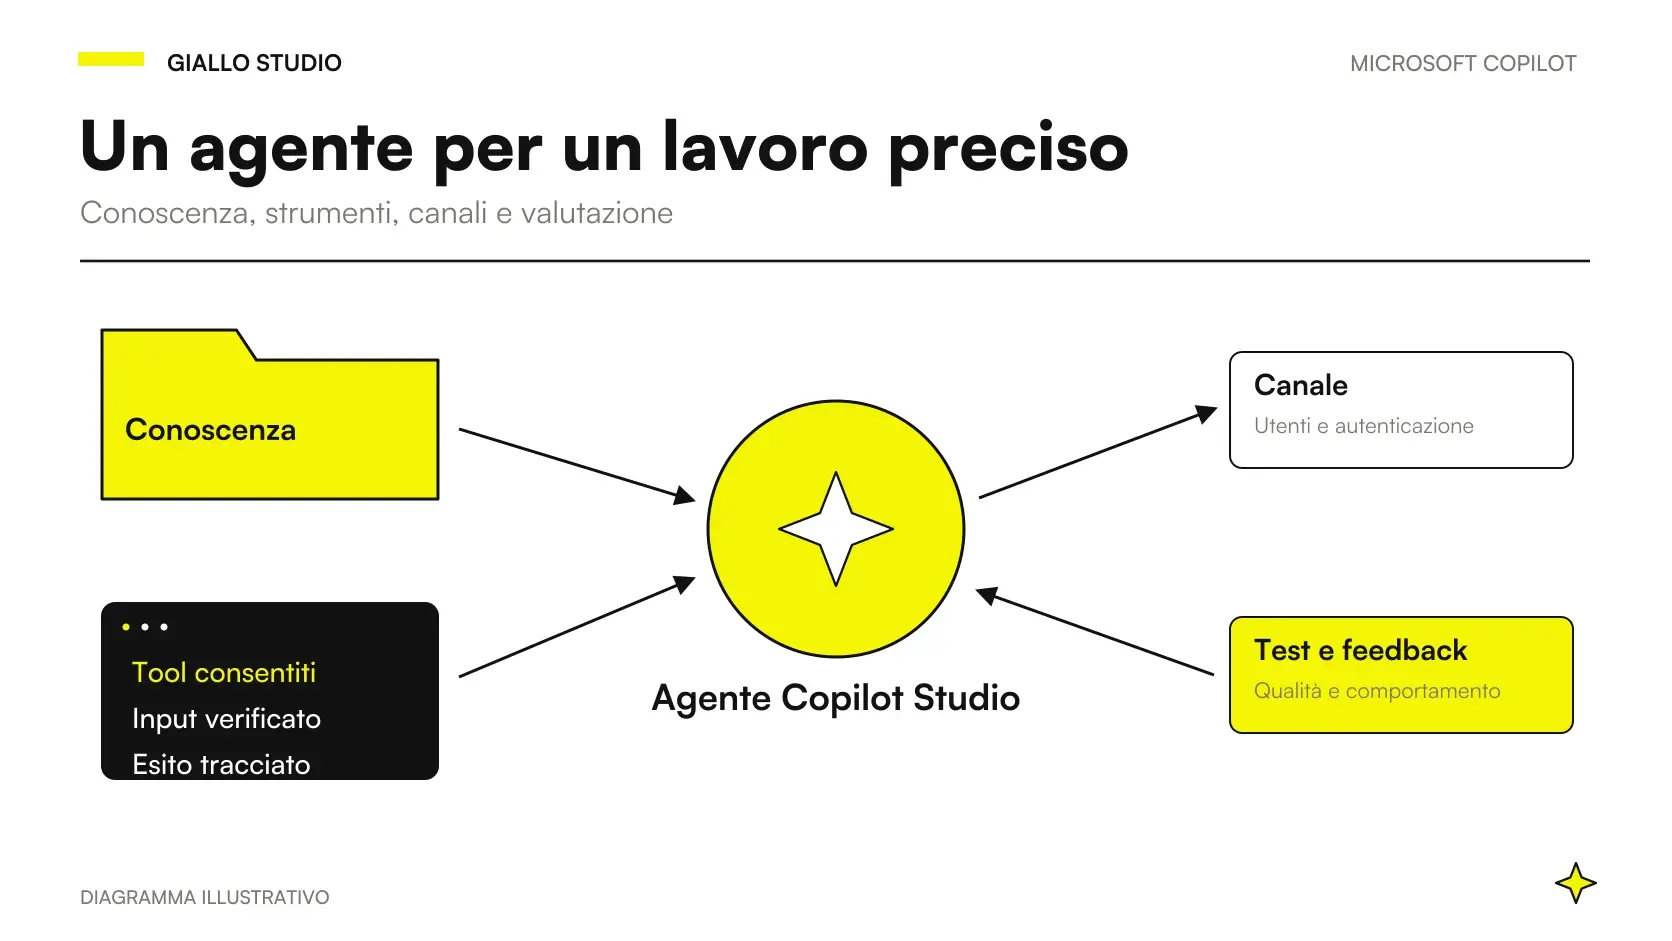
Un agente Copilot Studio collega documenti, strumenti e operatore in un ambiente aziendaleCopilot Studio: creare un agente AI per l’aziendaCome progettare un agente AI con Copilot Studio: fonti, strumenti, canali, permessi e test. Differenze da Agent Builder e percorso per una PMI.
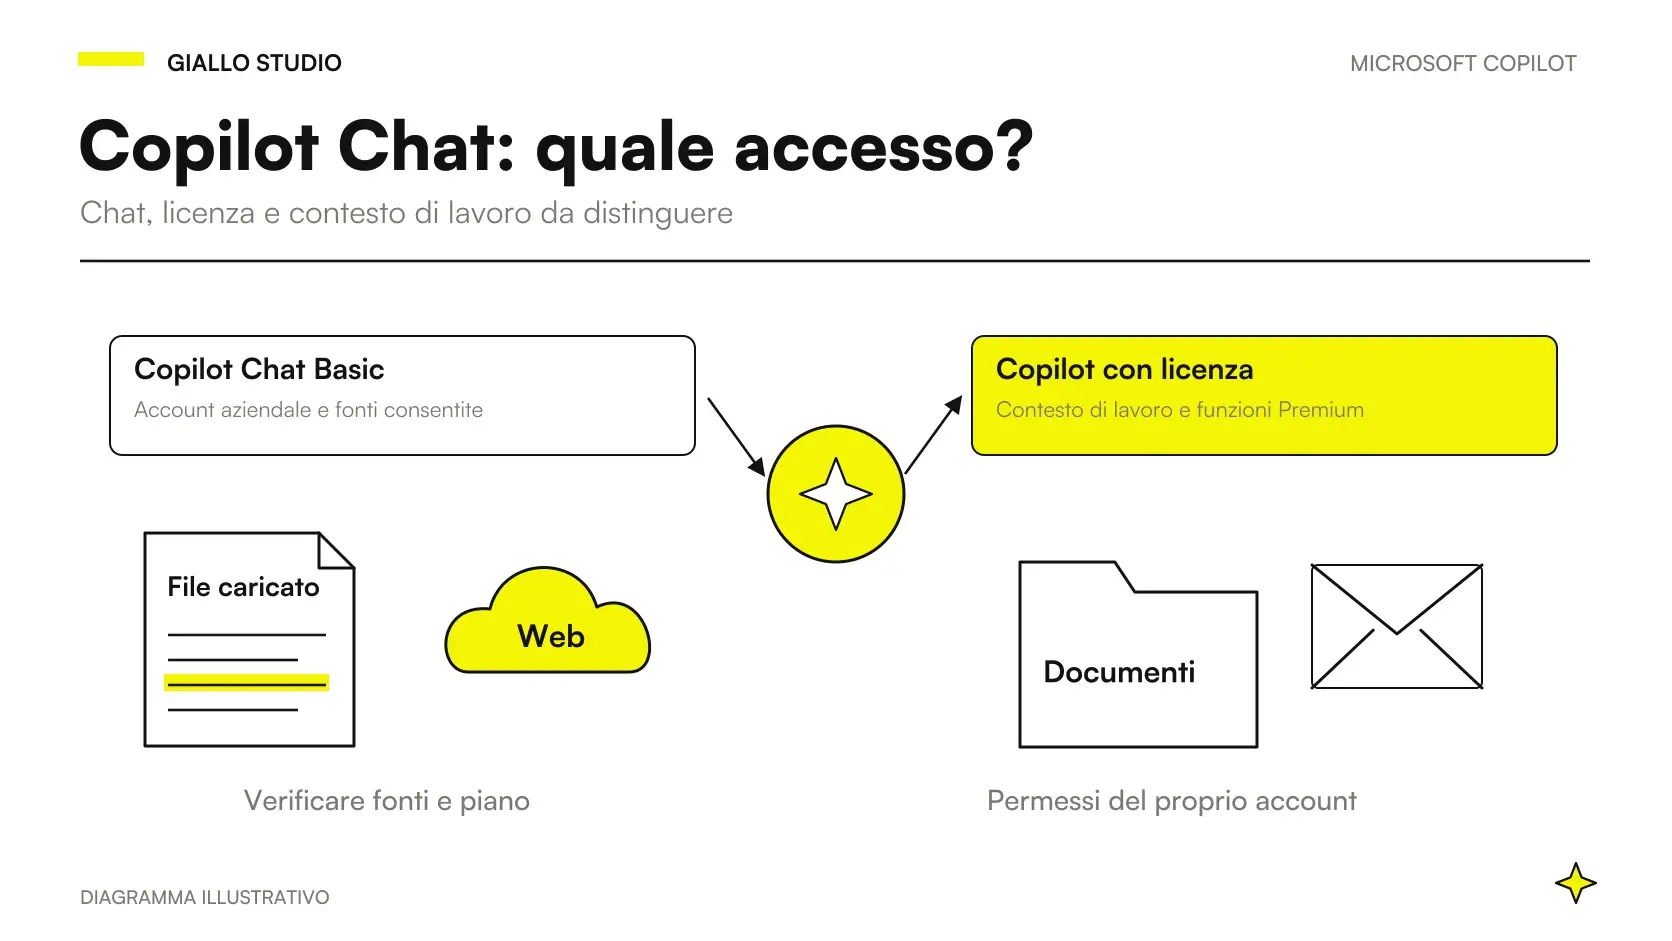
Tre percorsi di accesso a Microsoft Copilot collegano account, documento e contesto aziendaleCopilot Chat e Microsoft 365 Copilot: cosa cambiaCopilot Chat e Microsoft 365 Copilot: account, licenze Basic e Premium, file aziendali e agenti. Come scegliere l’accesso utile per ogni ruolo della PMI.
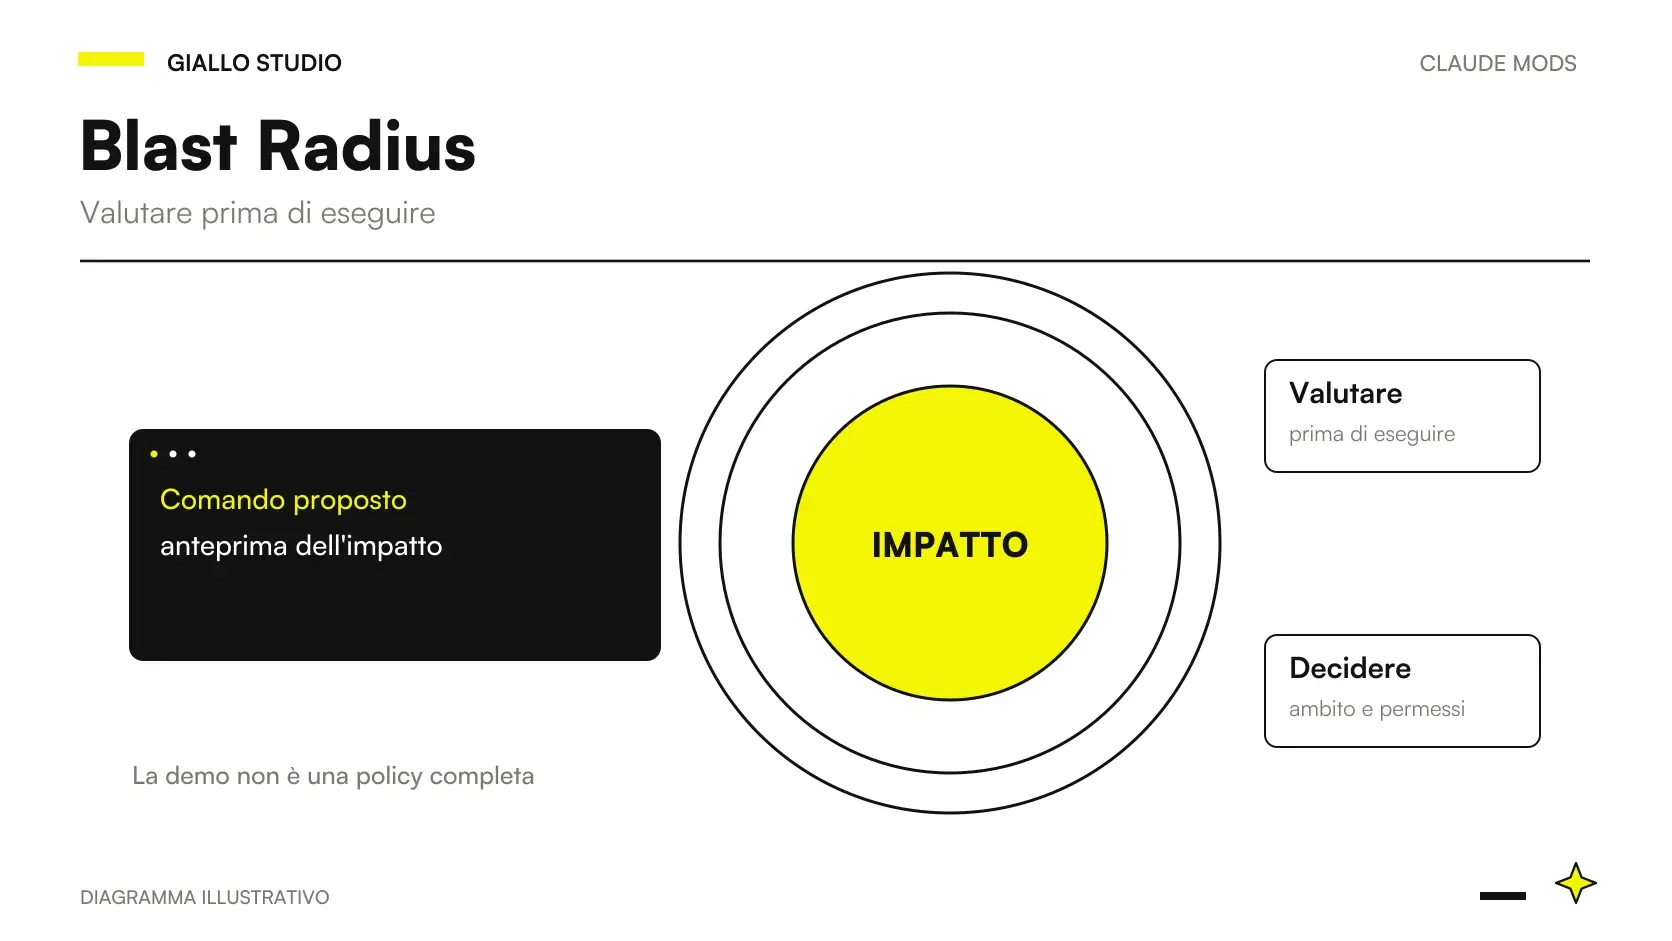
Claude Code Blast Radius Mod: comando sospeso, impatto previsto e scelta fra procedere e annullareBlast Radius in Claude Code: valutare i comandi prima di agireClaude Code Blast Radius Mod: anteprima, scelta utente e limiti dei comandi riconosciuti. Come valutarlo senza confondere una demo con una policy aziendale.
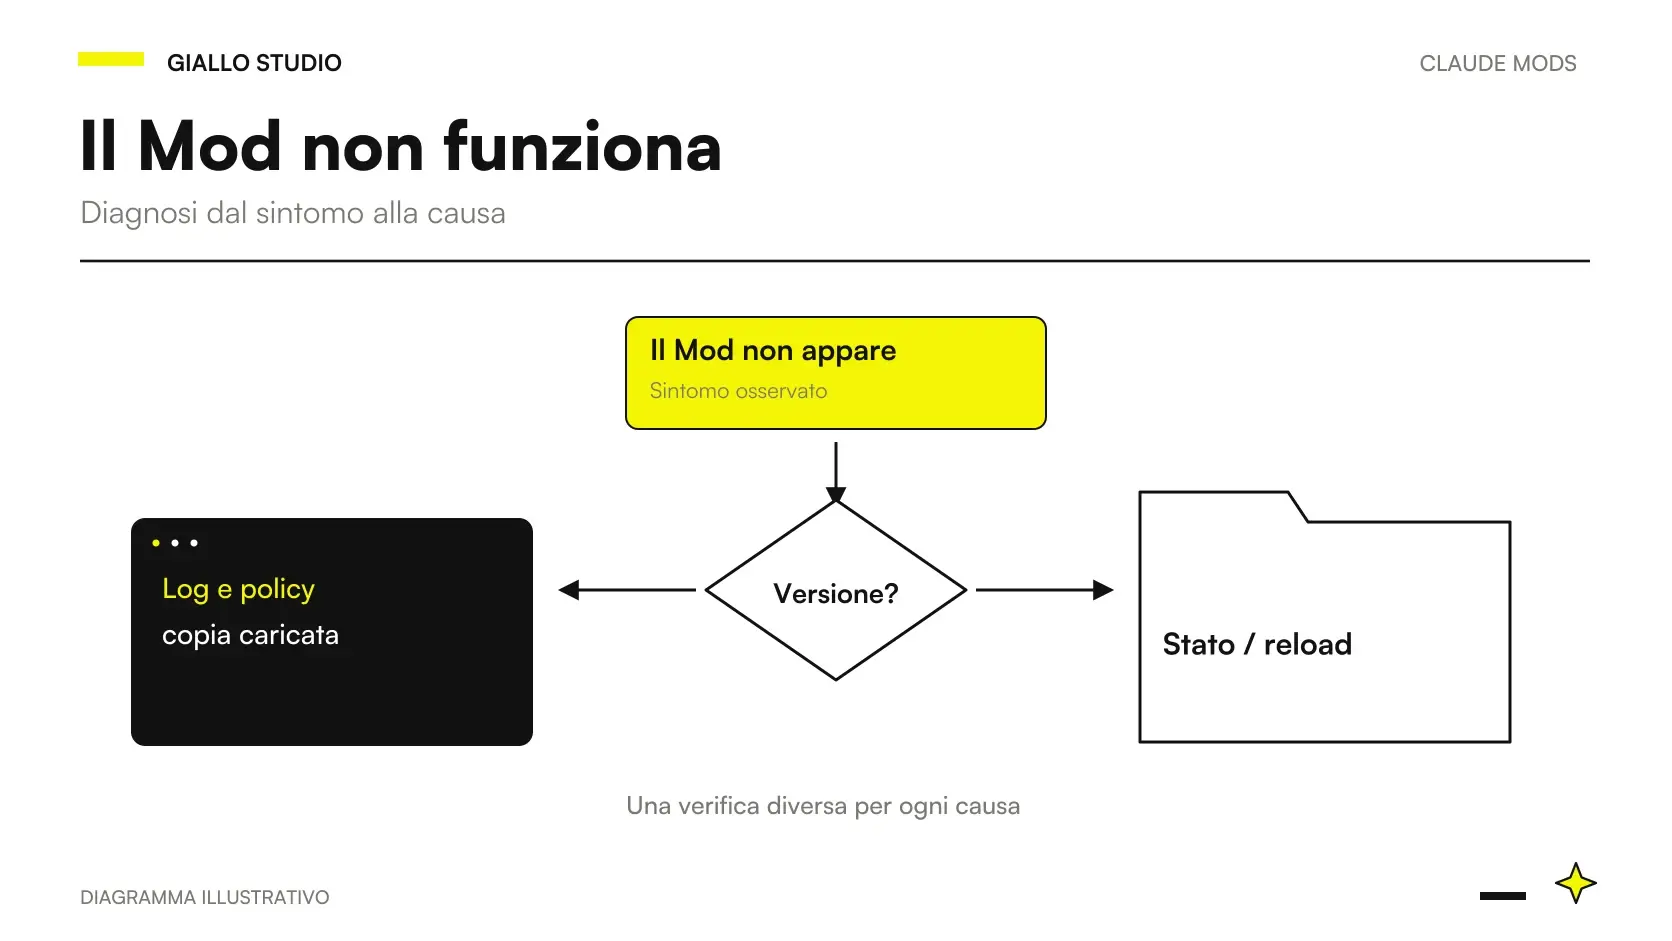
Claude Code Mod non funziona hot reload: percorso dal sintomo a versione, policy, caricamento, UI e statoClaude Code Mod non funziona: caricamento, hot reload e statoClaude Code Mod non funziona hot reload: distingui versione, policy, codice caricato, UI e stato. Una diagnosi ordinata con log e prove riproducibili.
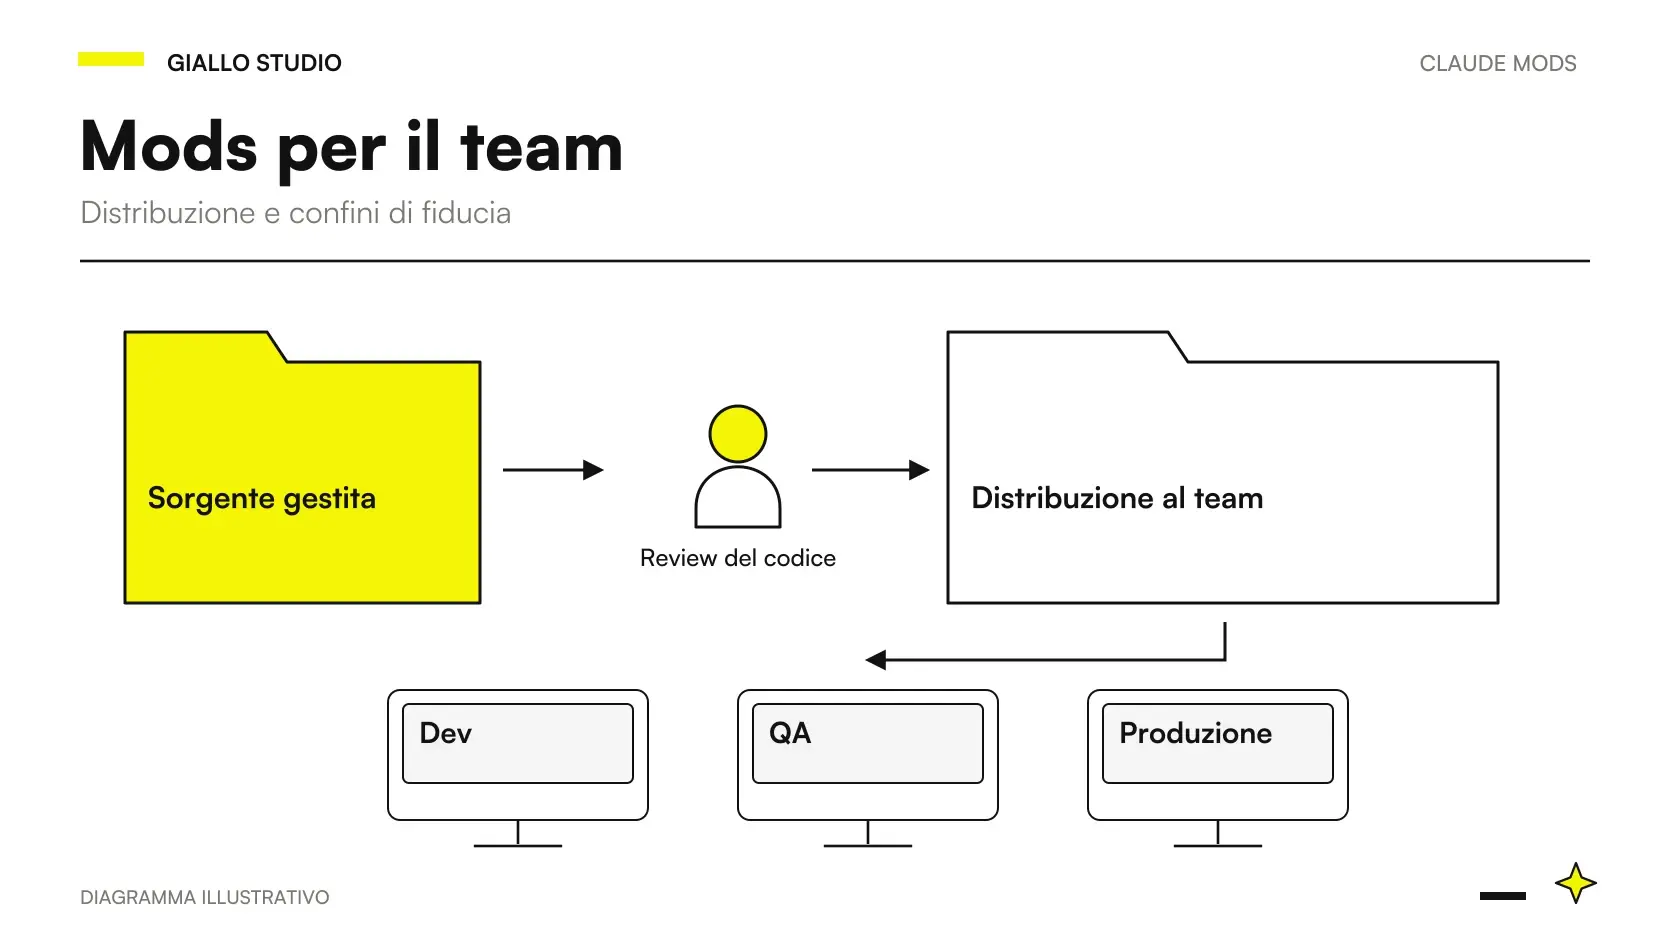
Claude Code Mods team enterprise sicurezza: provenienza gestita, review, distribuzione e confine delle policyClaude Code Mods per team: distribuzione, policy e sicurezzaClaude Code Mods team enterprise sicurezza: marketplace privato, versioni, review e policy gestite. Confini del codice e piano di adozione per un piccolo team.
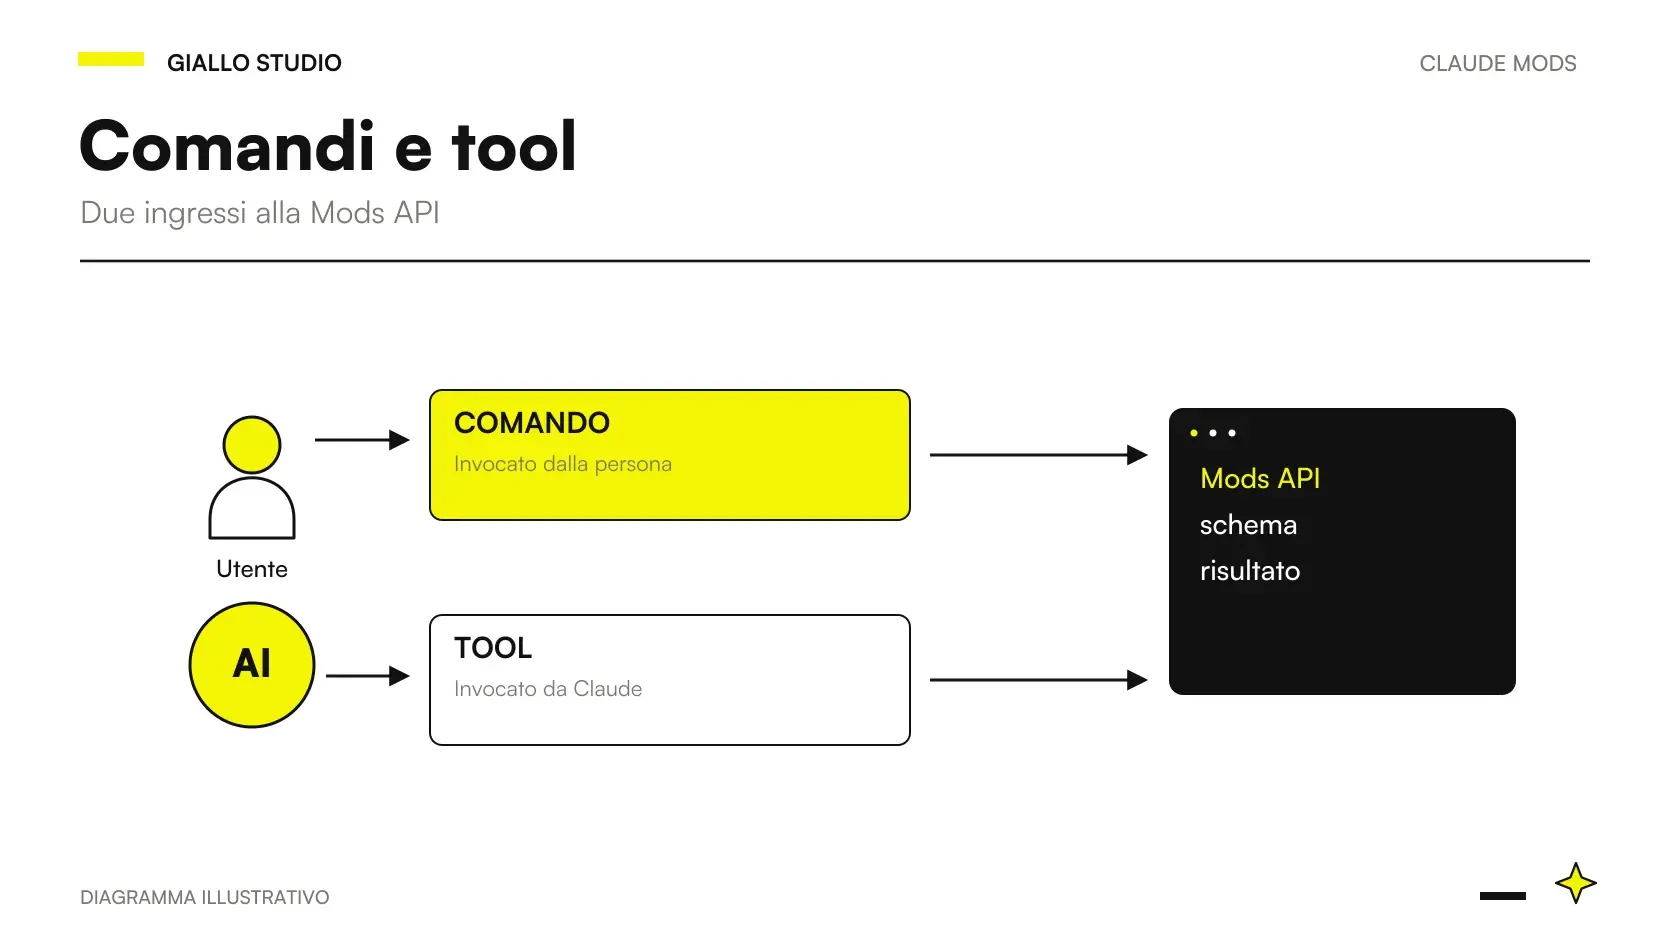
Claude Mods API comando tool personalizzato: due ingressi separati verso un lookup ticket in sola letturaClaude Mods API: aggiungere comandi e tool personalizzatiClaude Mods API comando tool personalizzato: scegli l’ingresso, definisci input ed errori e verifica i nomi canonici. Esempio read-only con ticket fittizi.
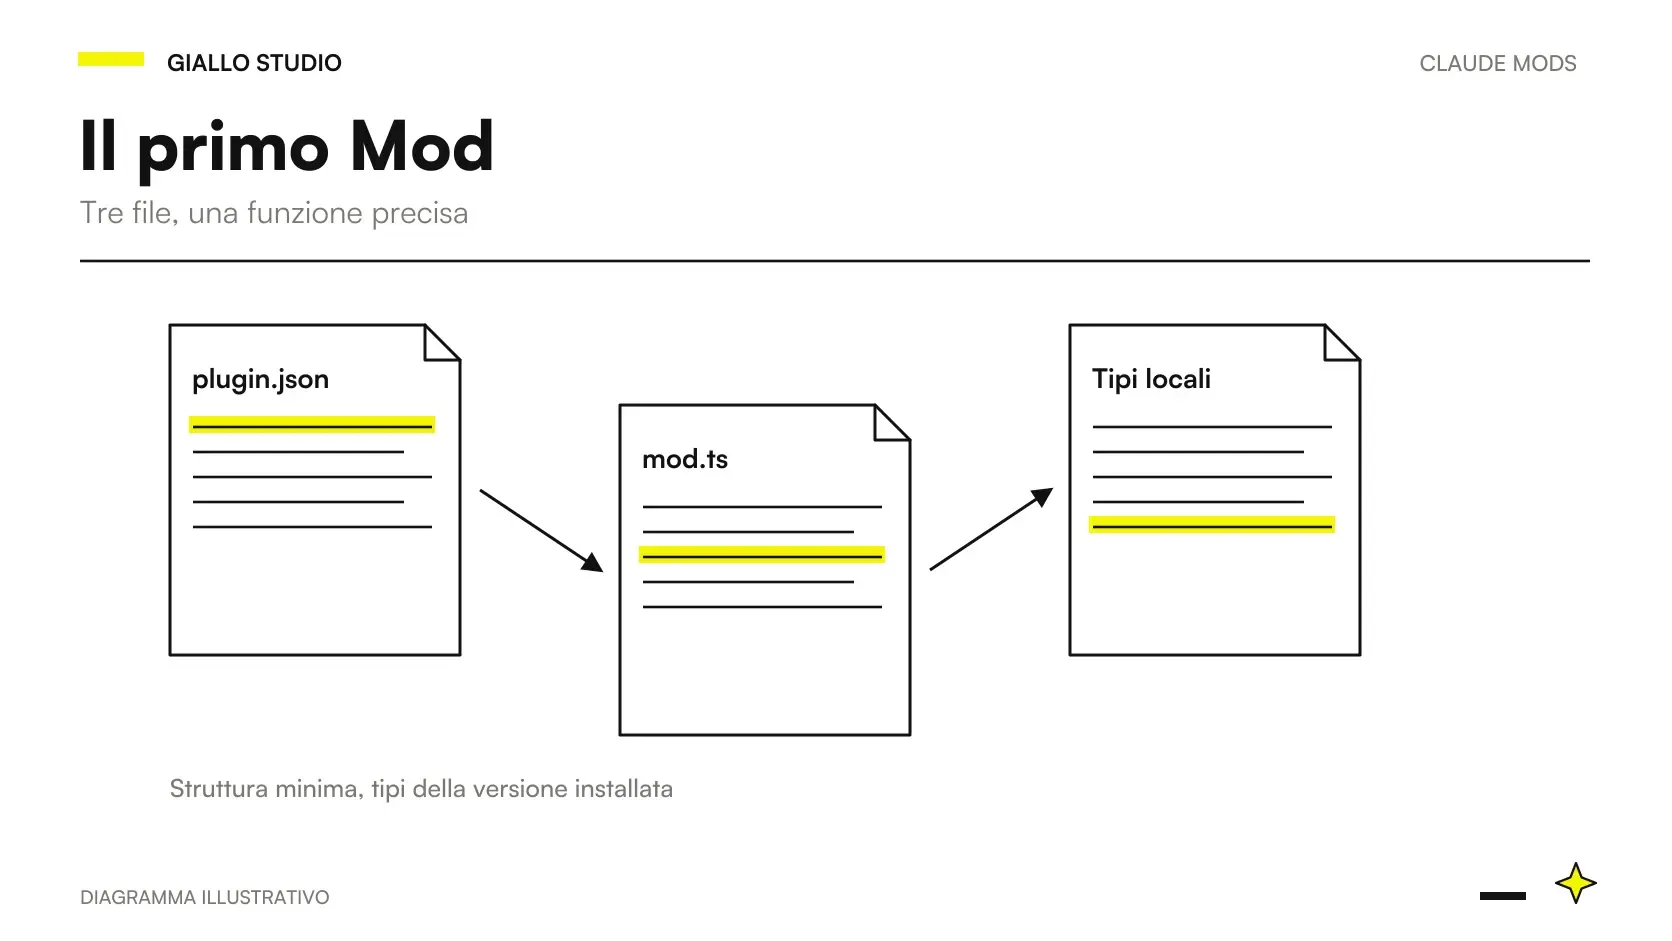
Creare Claude Code Mod TypeScript: manifest, modulo di ingresso e ciclo di verificaCreare un Claude Code Mod in TypeScript: il primo progettoCreare Claude Code Mod TypeScript: tre file, tipi locali, caricamento e validazione. Un primo progetto piccolo, con confini e verifiche espliciti.
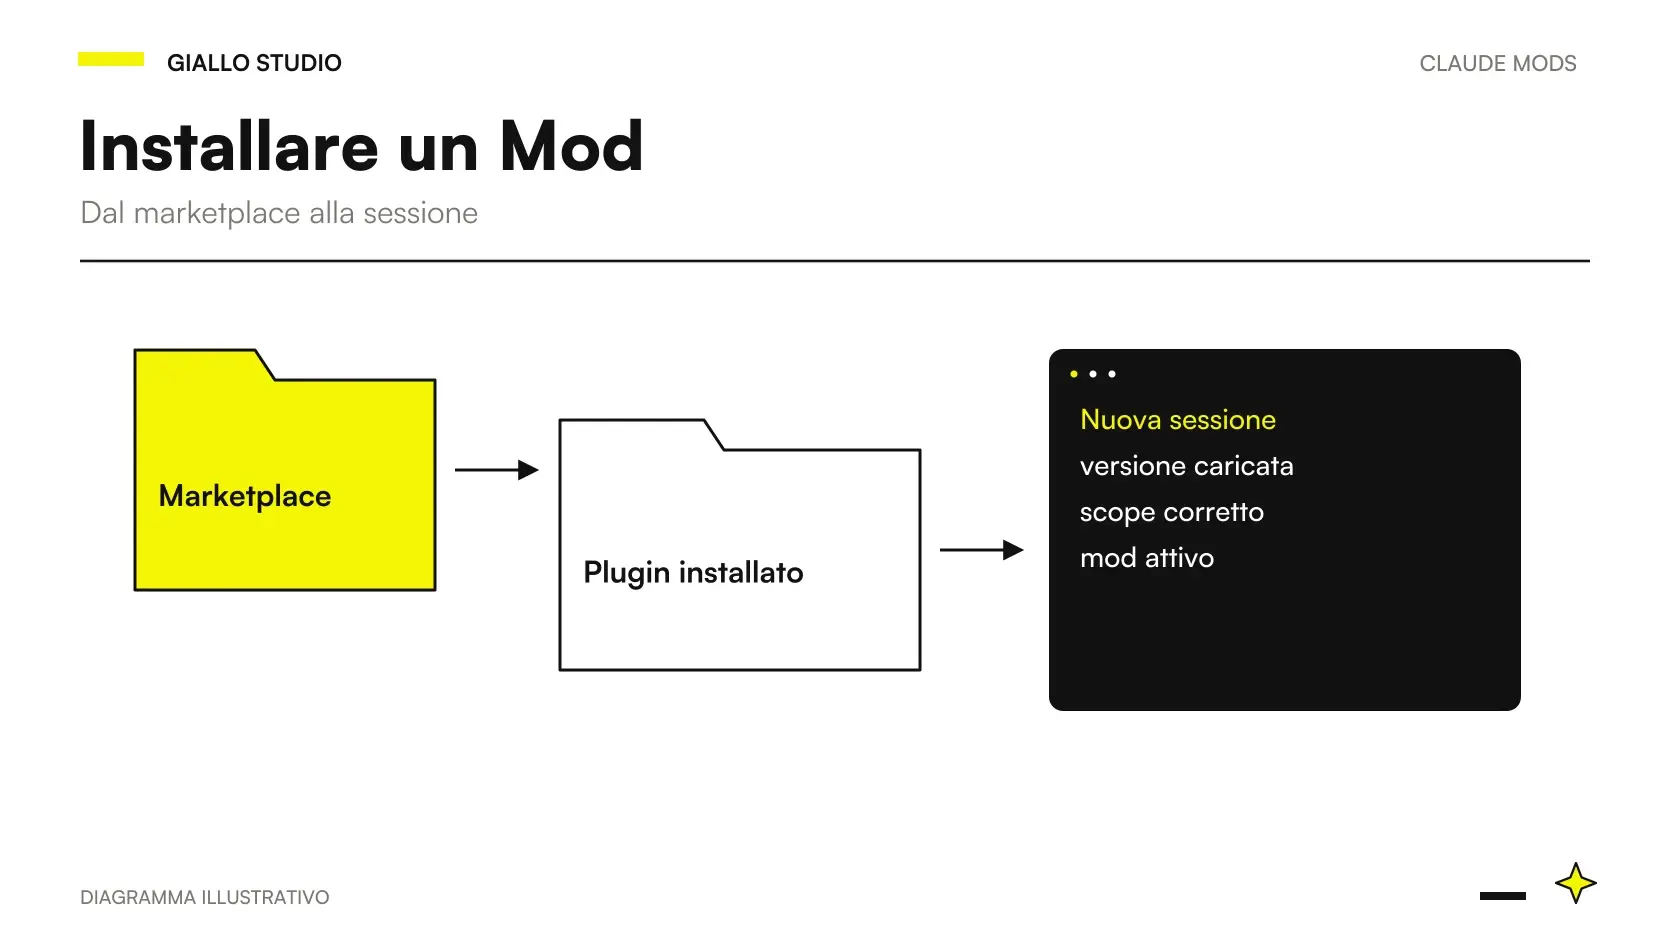
Installare Mods Claude Code: percorso da marketplace a scope, caricamento e aggiornamentoInstallare Mods in Claude Code: scope, reload e aggiornamentiInstallare Mods Claude Code: scegli marketplace e scope, verifica il caricamento e aggiorna la copia giusta. Procedura e diagnosi senza comandi alla cieca.
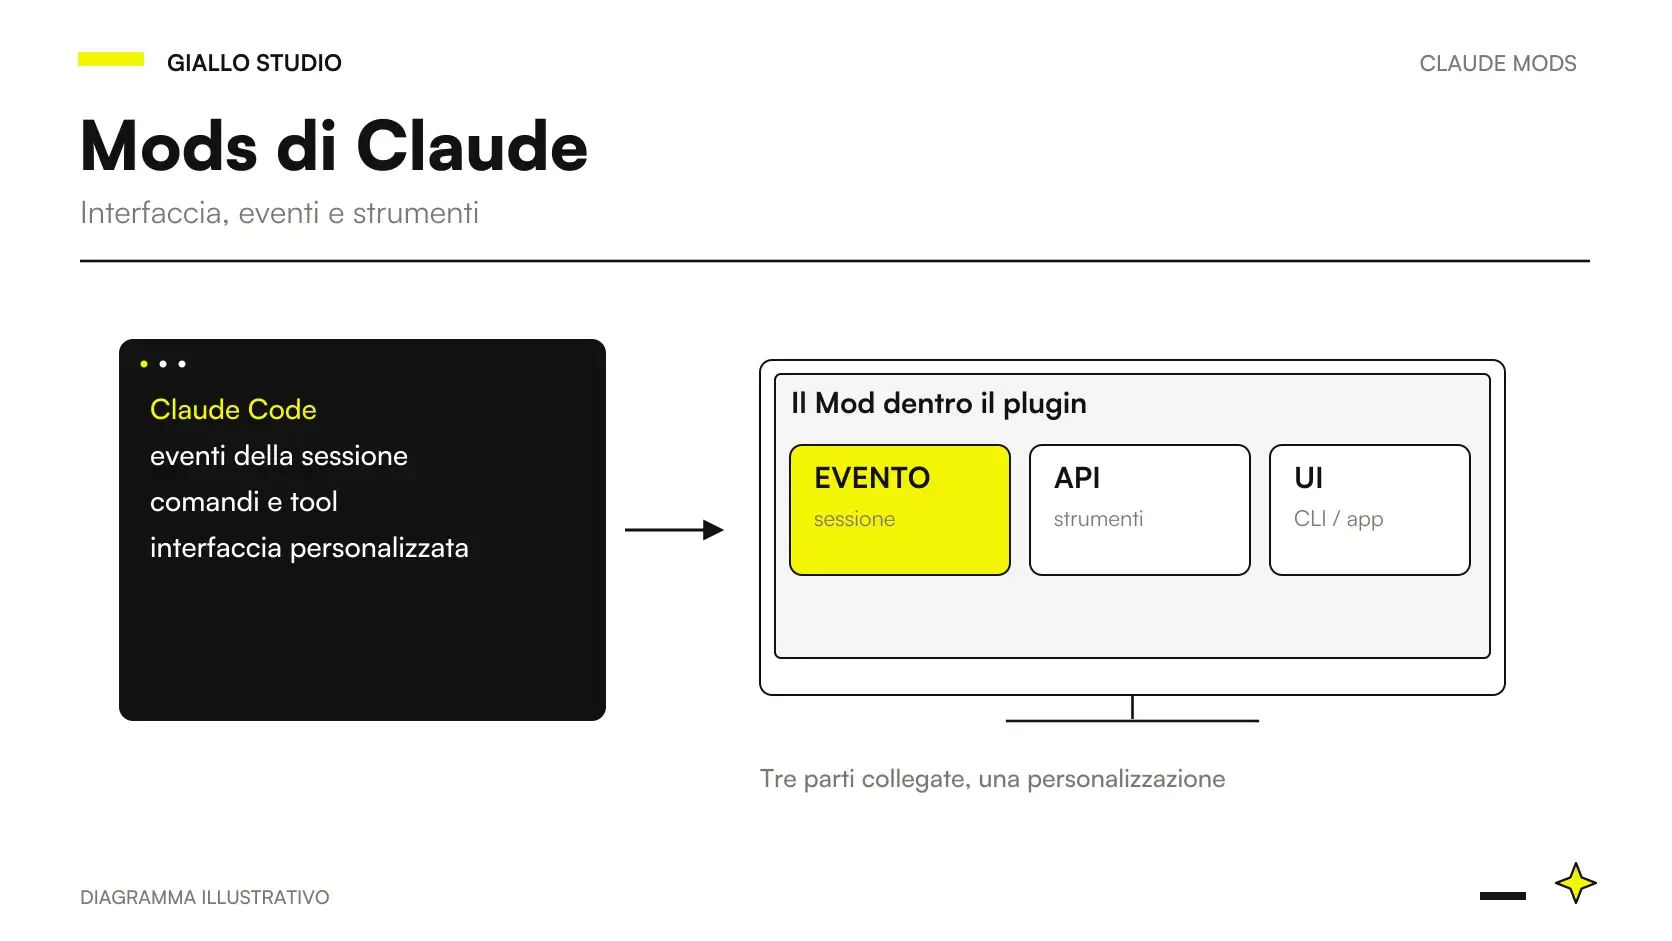
Mods Claude: cosa sono e come si collegano a interfaccia, eventi e strumenti di Claude CodeMods di Claude: cosa sono e quando servono in Claude CodeMods Claude: cosa sono, cosa cambiano in Claude Code e quando preferire Hooks, Skills o MCP. Casi pratici, demo ufficiali e limiti per i team.
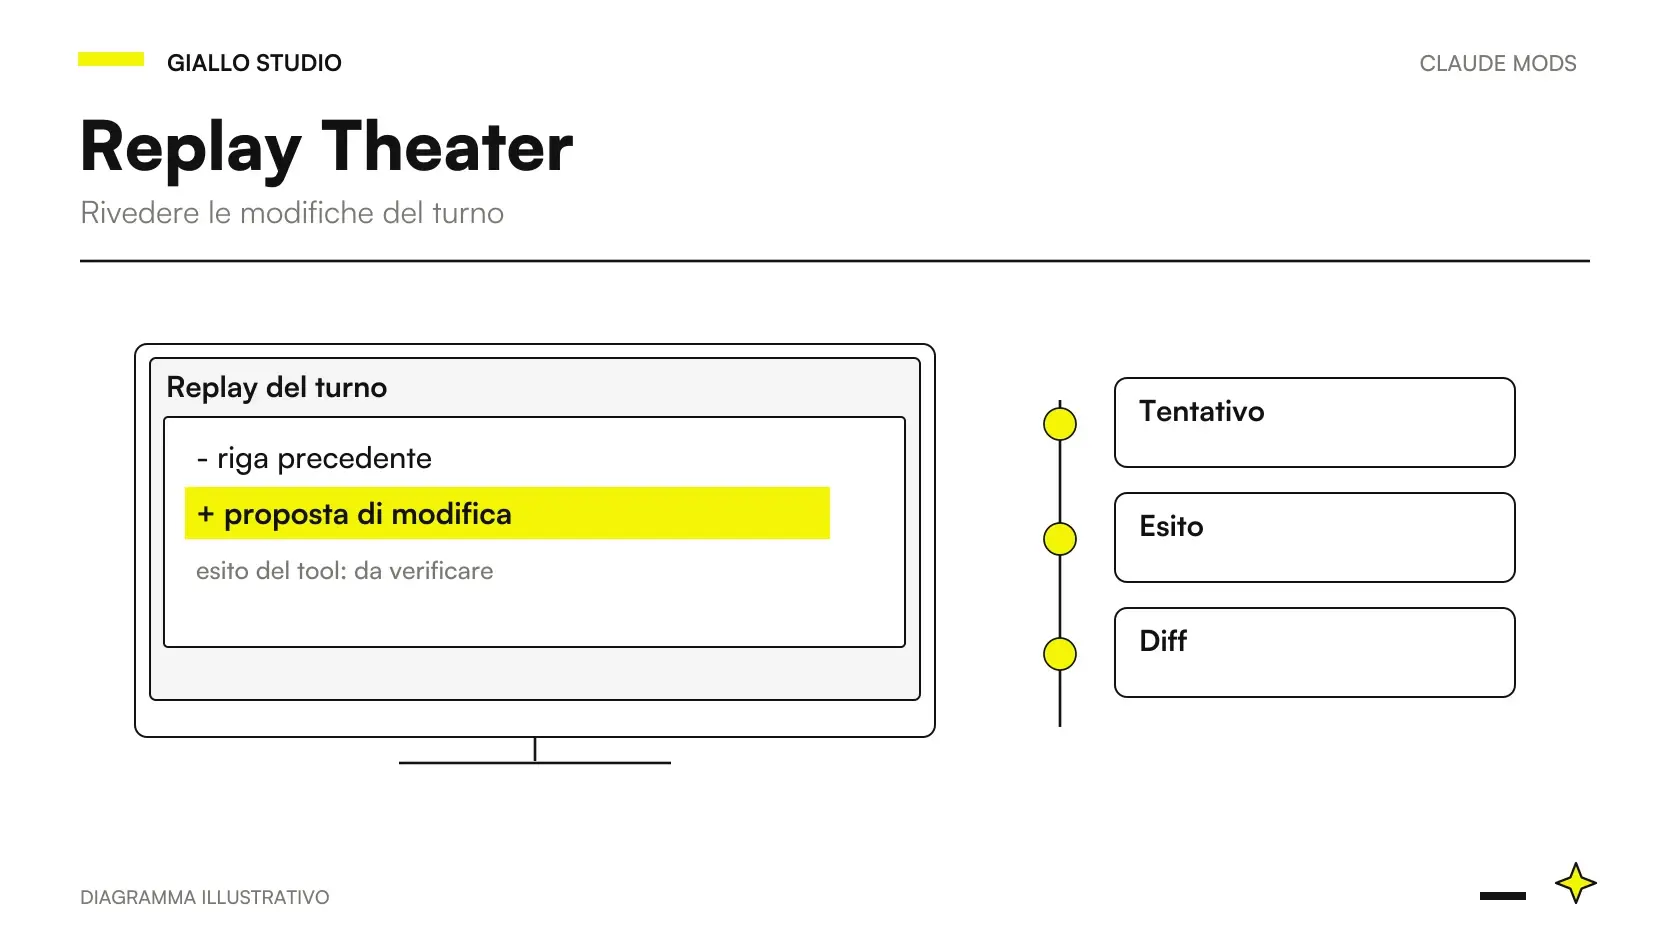
Claude Code Replay Theater modifiche: sequenza delle edit del turno confrontata con diff e stato GitReplay Theater in Claude Code: rivedere le modifiche di un turnoClaude Code Replay Theater modifiche: distingui edit tentate, diff del turno e storico Git. Guida alla demo ufficiale e a una review con prove reali.
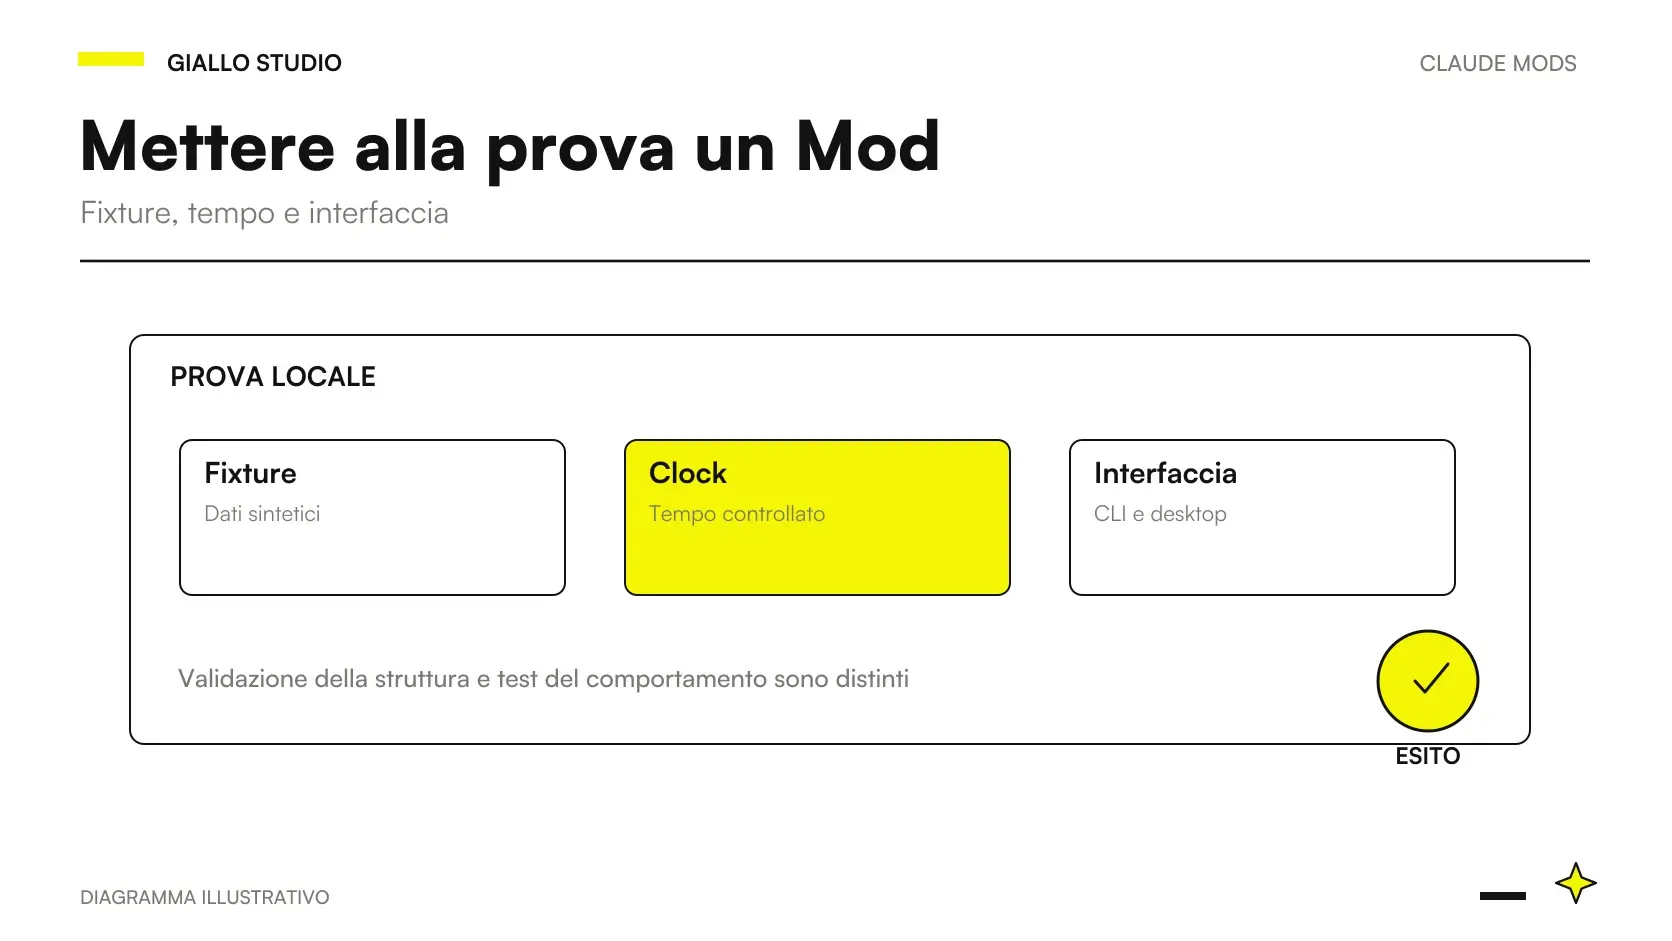
Test Claude Code Mod claude plugin test: eventi sintetici, stub del servizio e verifica su due superficiTestare un Claude Code Mod senza login o chiamate al modelloTest Claude Code Mod claude plugin test: verifica eventi, stub, clock e interazioni UI senza login o rete. Casi positivi, errori e limiti della prova.
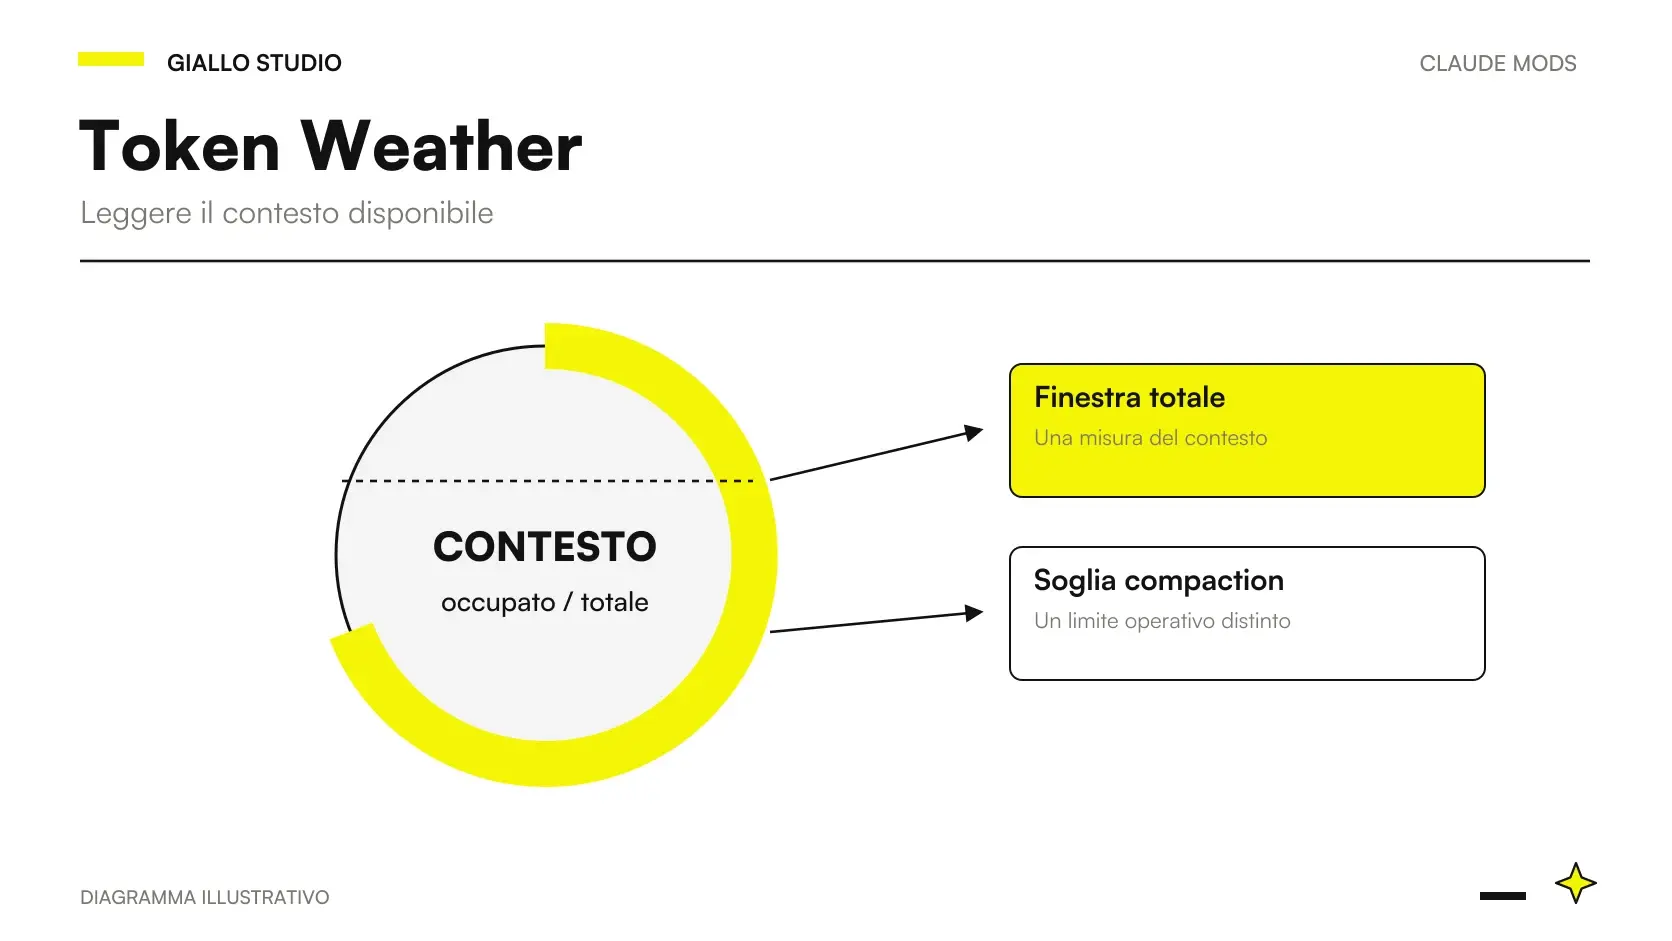
Claude Code Token Weather context window: percentuale assoluta e andamento del contesto per turnoToken Weather in Claude Code: leggere la finestra di contestoClaude Code Token Weather context window: leggi percentuale, storia e soglia di compaction. Cosa misura la demo, perché i dati differiscono e come usarli.
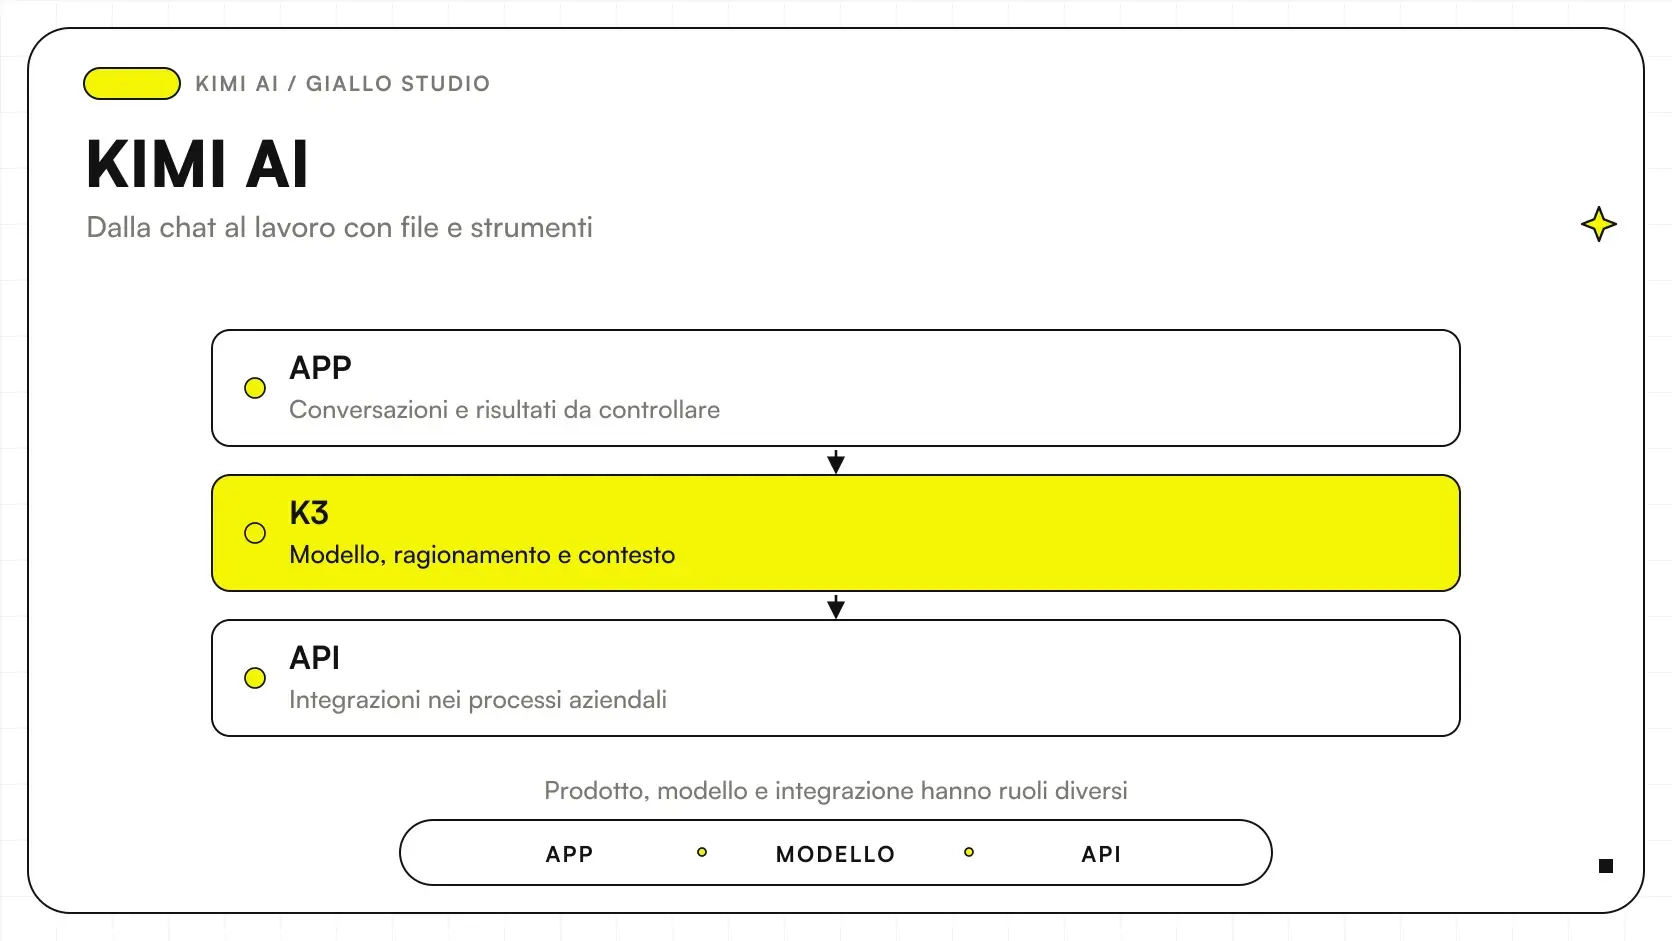
Kimi AI tra chat, documenti e strumenti per il lavoro aziendaleKimi AI: cos'è, cosa fa e quando usarloScopri Kimi AI: chat in italiano, documenti, Excel, presentazioni e ricerca. Differenze tra app, K3, Code e API, con limiti e criteri per scegliere.
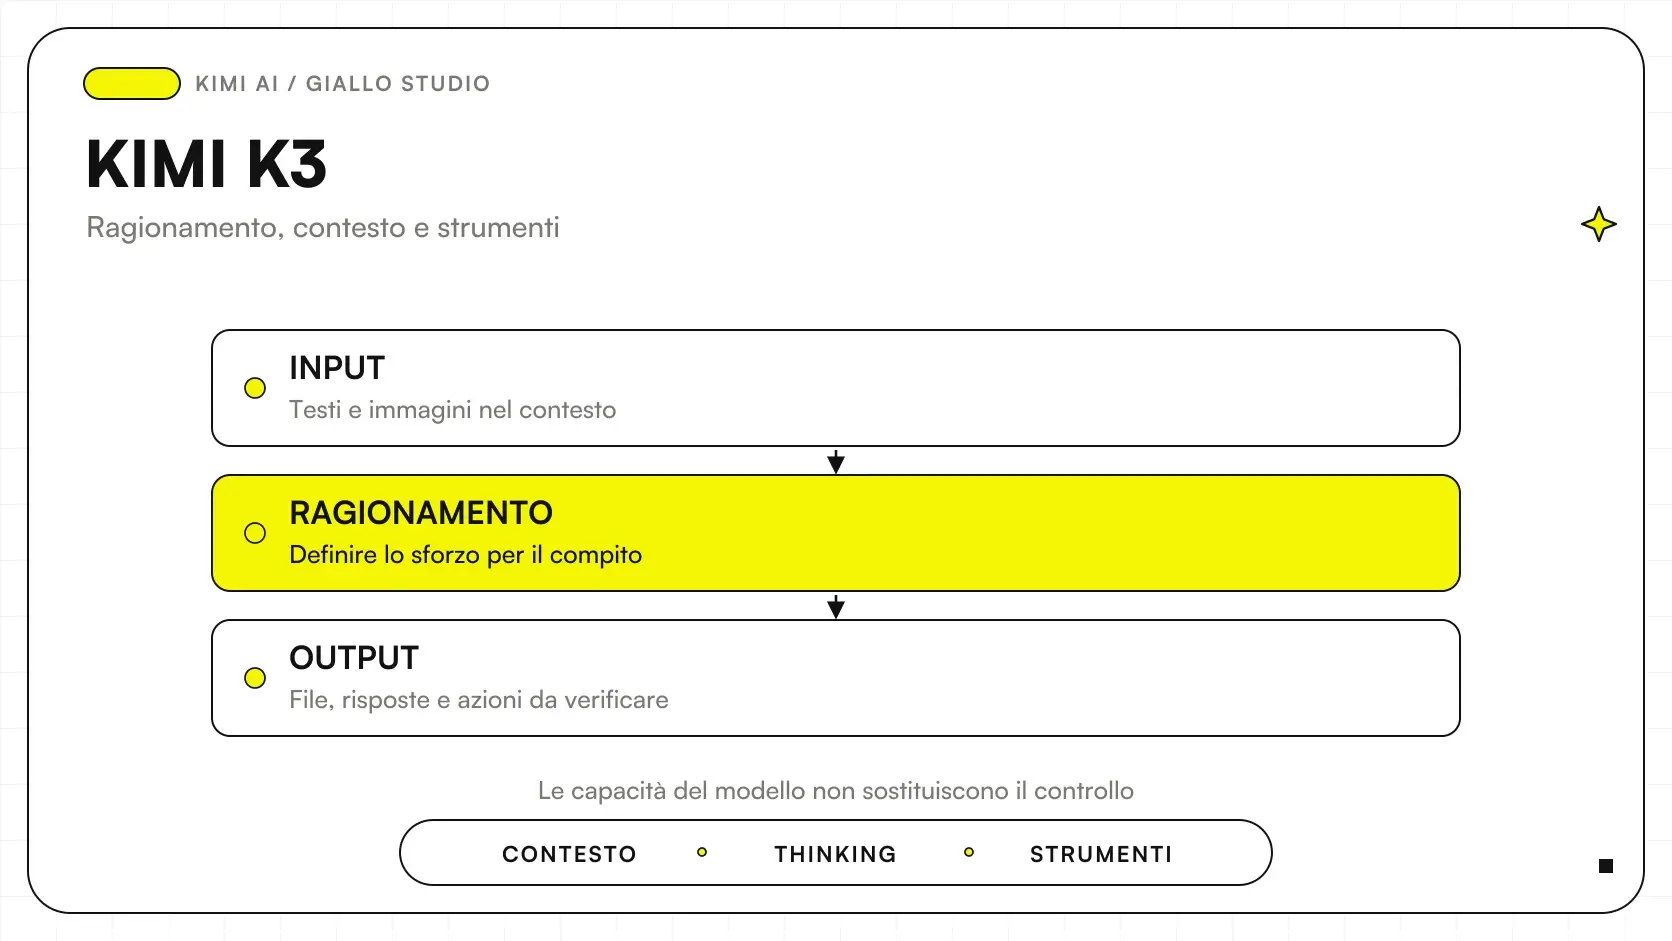
Kimi K3 tra ragionamento, contesto e strumenti degli agenti AIKimi K3: modello, ragionamento e limiti praticiKimi K3: contesto, thinking, strumenti e open weights. Distingui modello, app e K3 Cluster per capire come usarlo in un processo aziendale verificabile.
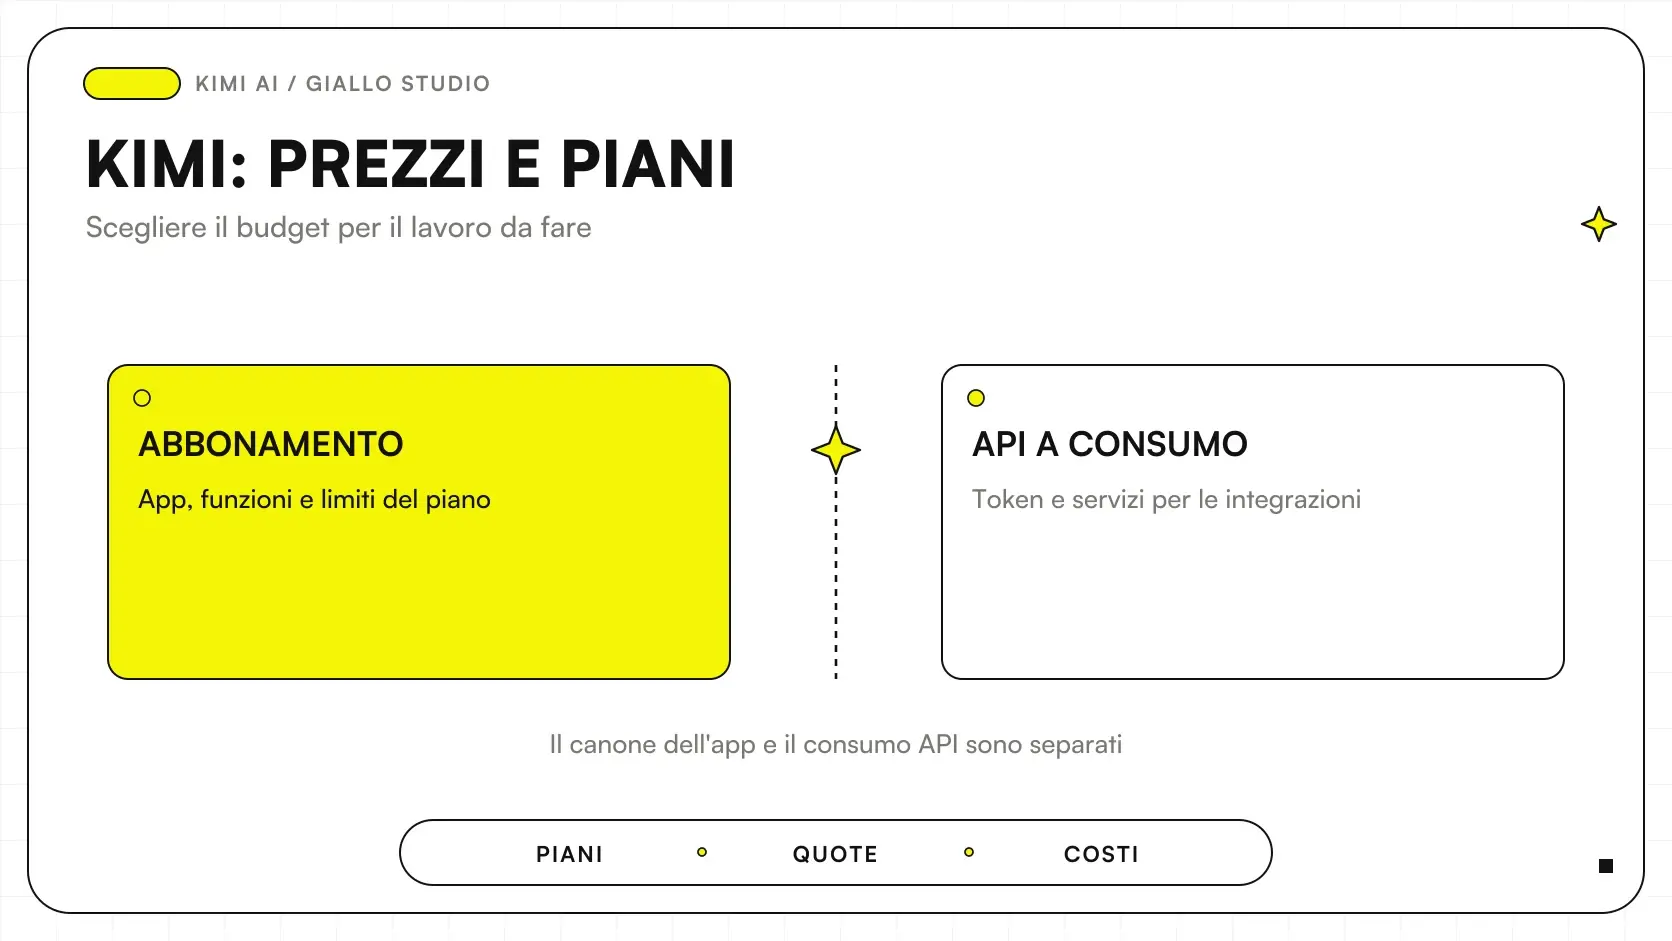
Kimi AI prezzi e piani globali per valutare l'abbonamentoKimi AI è gratis? Prezzi e piani per scegliereKimi AI prezzi: listino globale in USD, piani mensili e annuali, quote condivise e costi extra. Scegli distinguendo membership, Kimi Code e API.
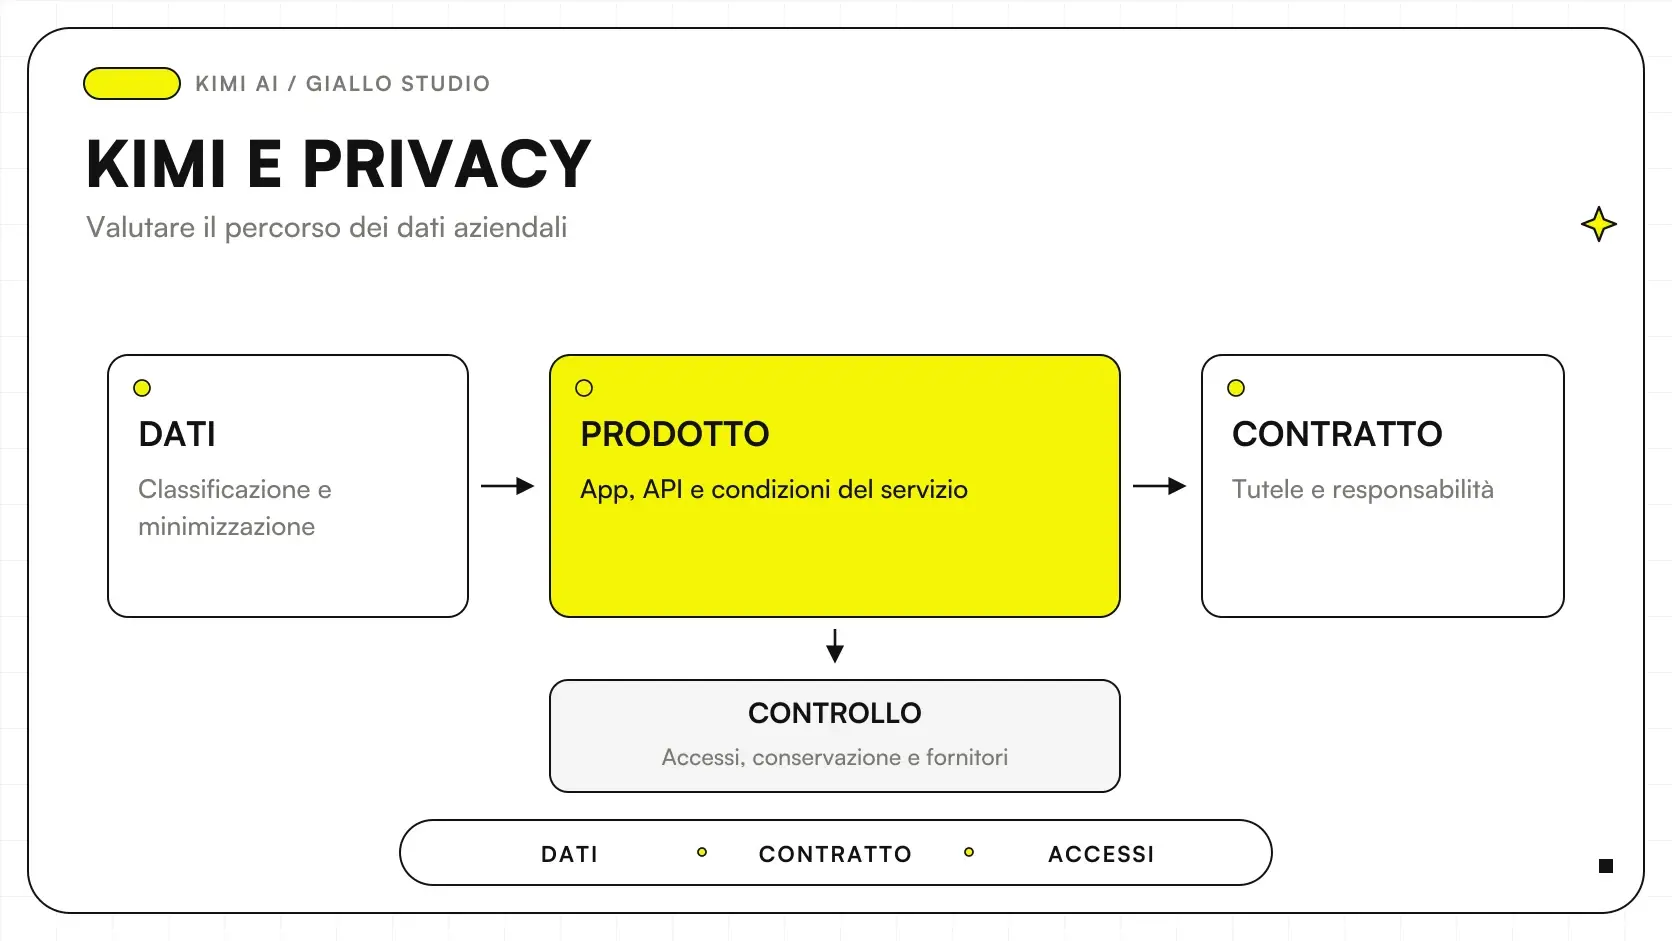
Kimi AI privacy con percorsi distinti per dati aziendali, app e APIKimi AI e privacy: cosa verificare sui dati aziendaliKimi AI e privacy: policy app e API, training, Singapore e Zero Data Retention. Le verifiche da fare prima di usare documenti e dati aziendali.
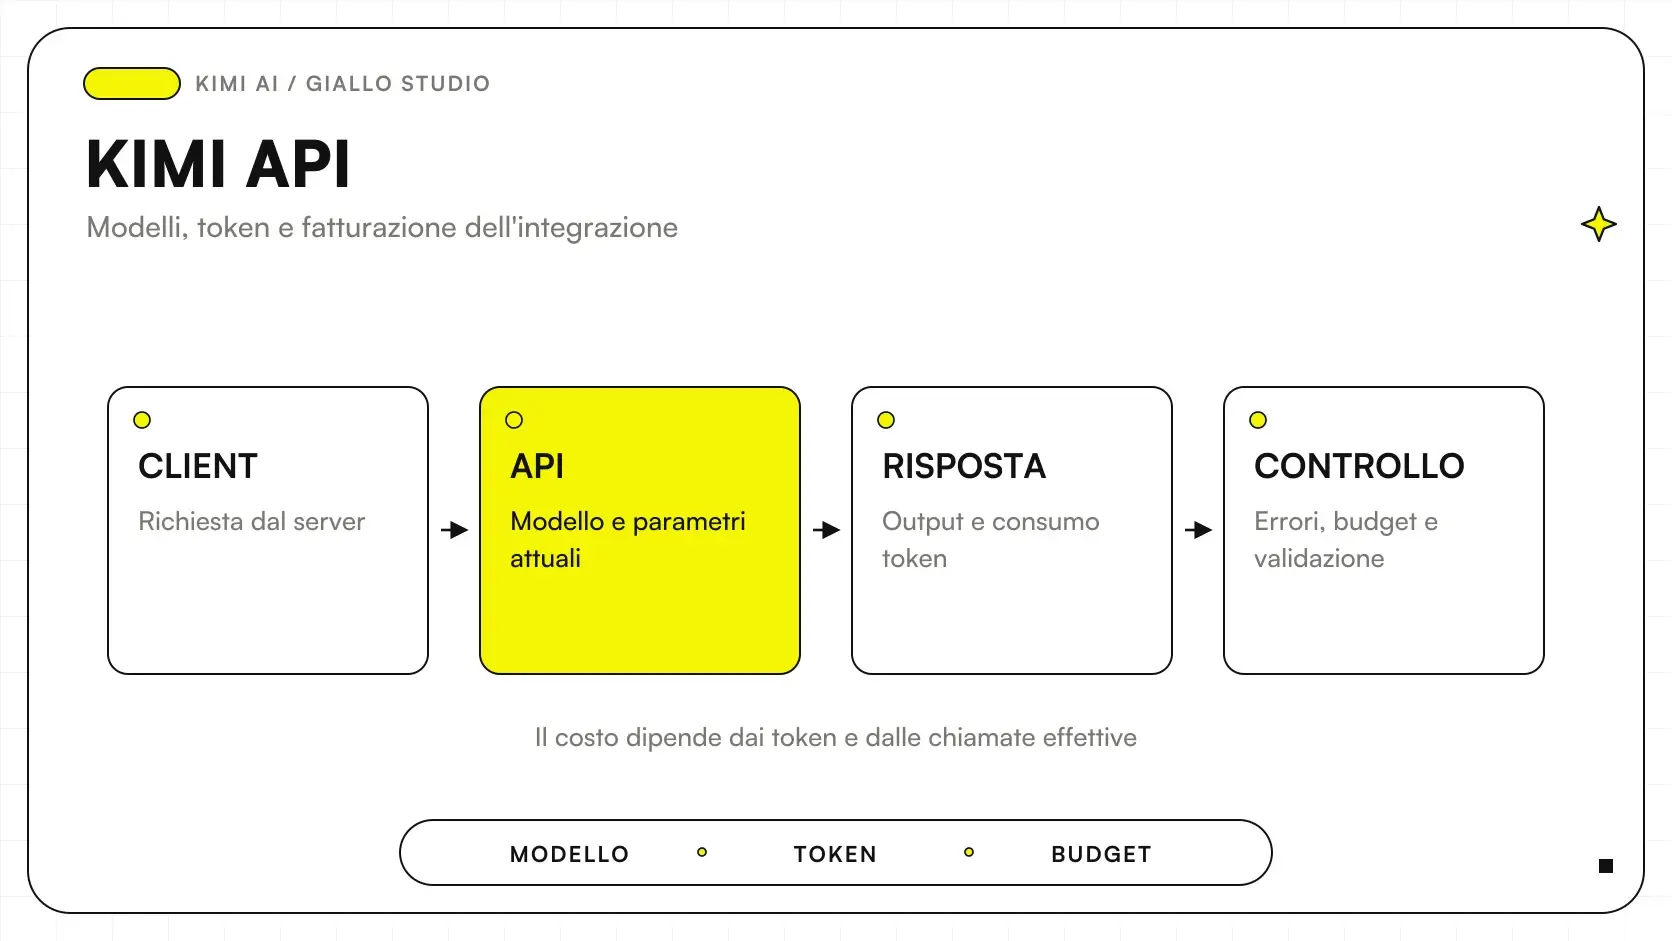
Kimi API e Moonshot collegati a un software aziendale con controllo di token e strumentiKimi API: modelli, prezzi e integrazione MoonshotKimi API: endpoint Moonshot, modelli attuali, token, cache e strumenti. Come stimare il costo e progettare un'integrazione aziendale controllabile.
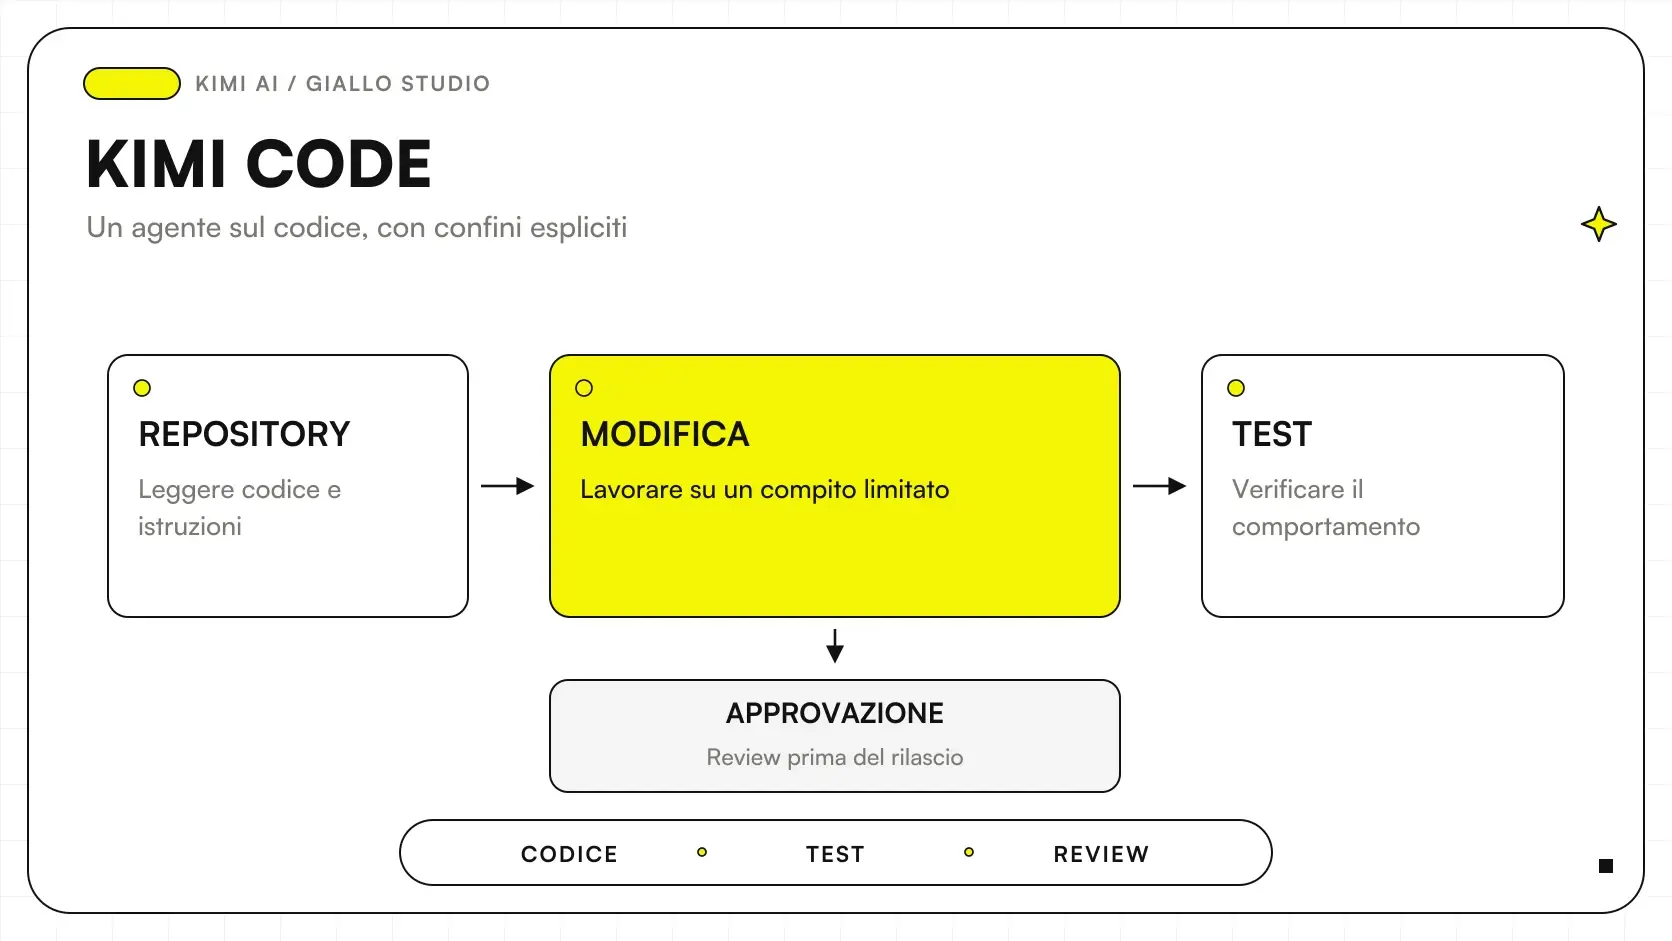
Kimi Code al lavoro su un repository con controlli e revisione del codiceKimi Code: agente per programmare e lavorare sul codiceKimi Code per programmare: CLI, VS Code, modelli e differenze dalle API. Come preparare il repository e verificare le modifiche prima del rilascio.
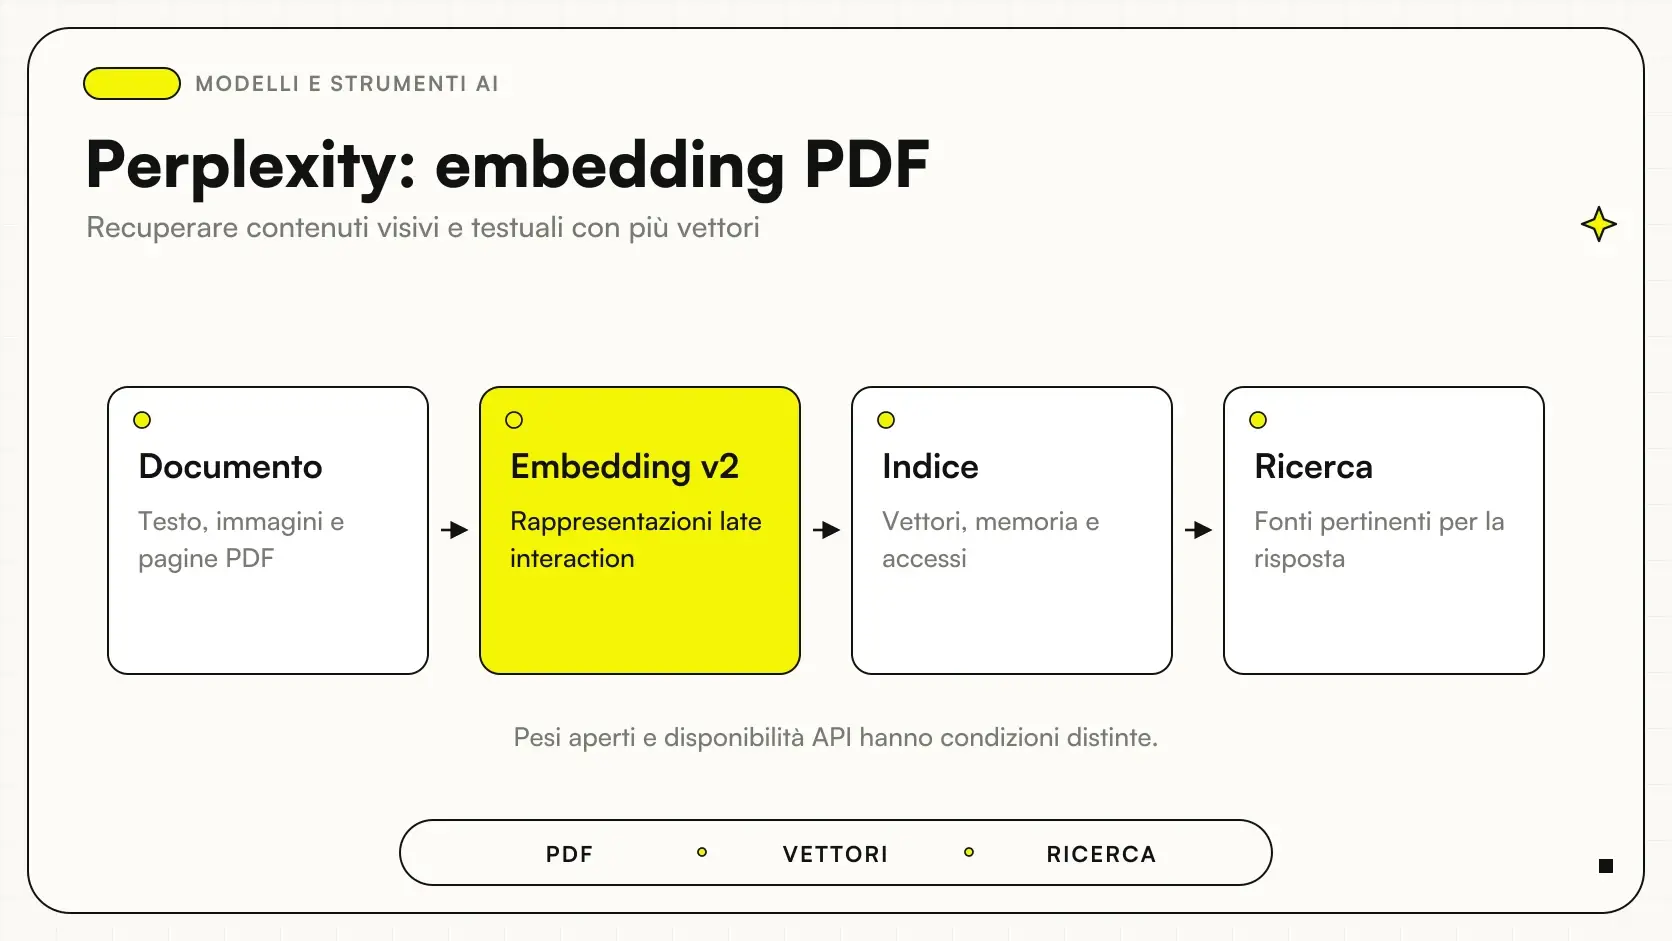
Perplexity: embedding PDF: Documento → Embedding v2 → Indice → Ricerca.Perplexity apre i nuovi embedding multimodali: cercare anche nelle pagine PDFPerplexity embedding multimodali PDF: pesi pubblici, ricerca su pagine e immagini, rollout API e verifiche per un archivio aziendale con fonti.
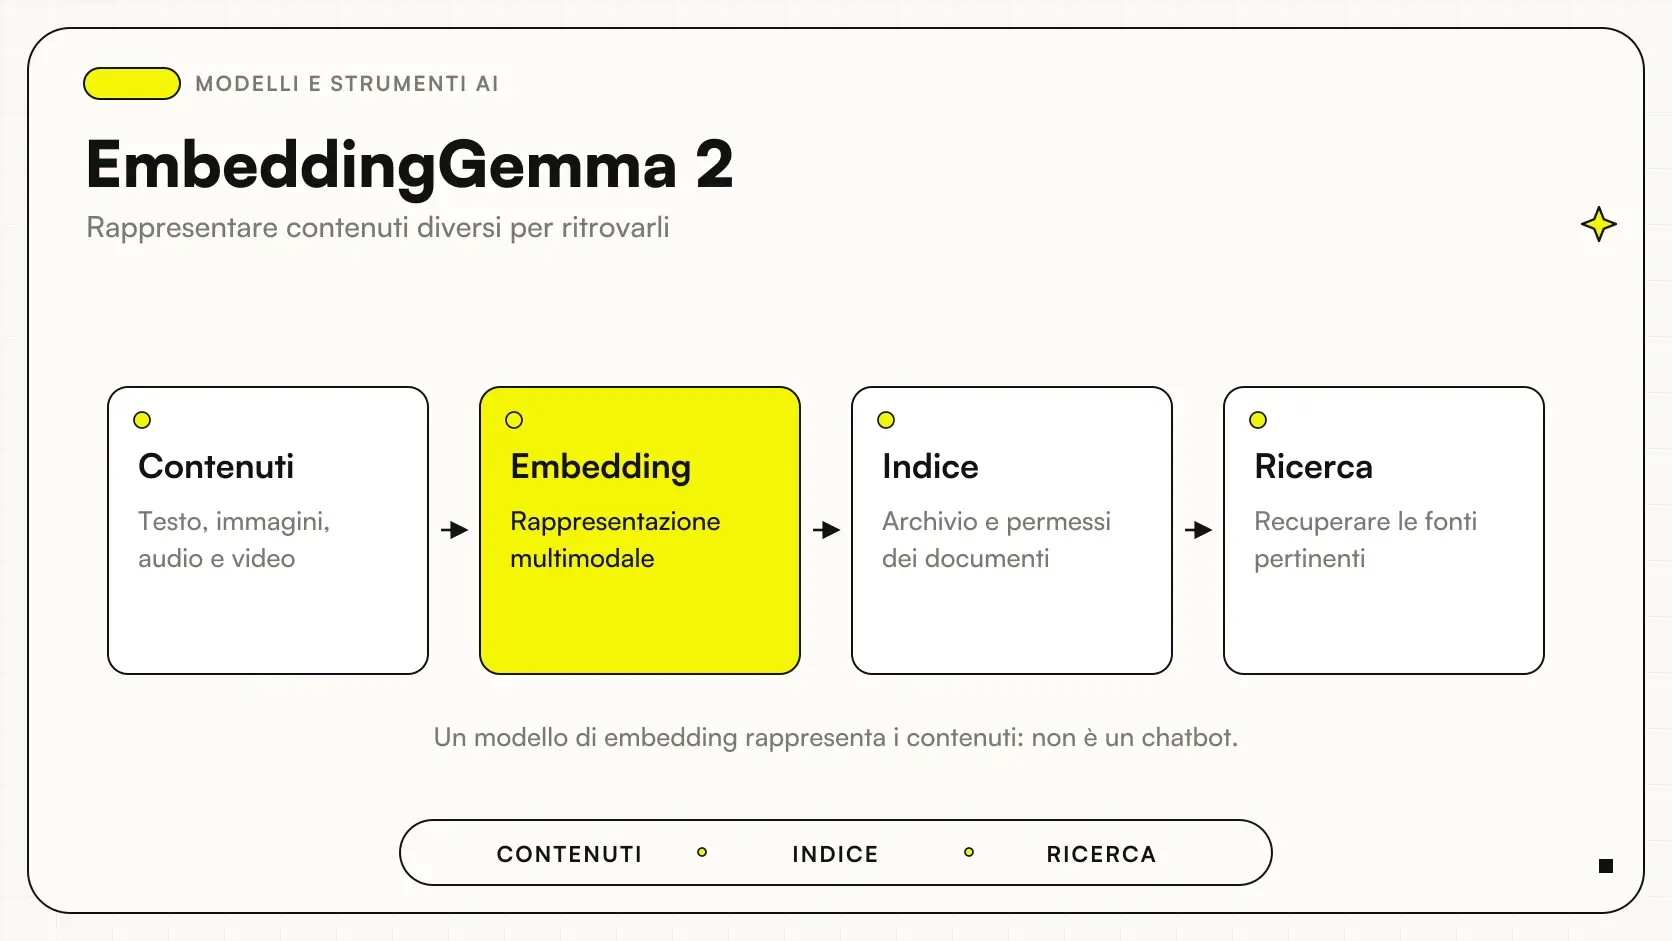
EmbeddingGemma 2: Contenuti → Embedding → Indice → Ricerca.EmbeddingGemma 2: ricerca AI locale nei documenti aziendaliEmbeddingGemma 2 per cercare in documenti e immagini aziendali: funzionamento, prova su hardware reale, permessi e limiti della ricerca locale.
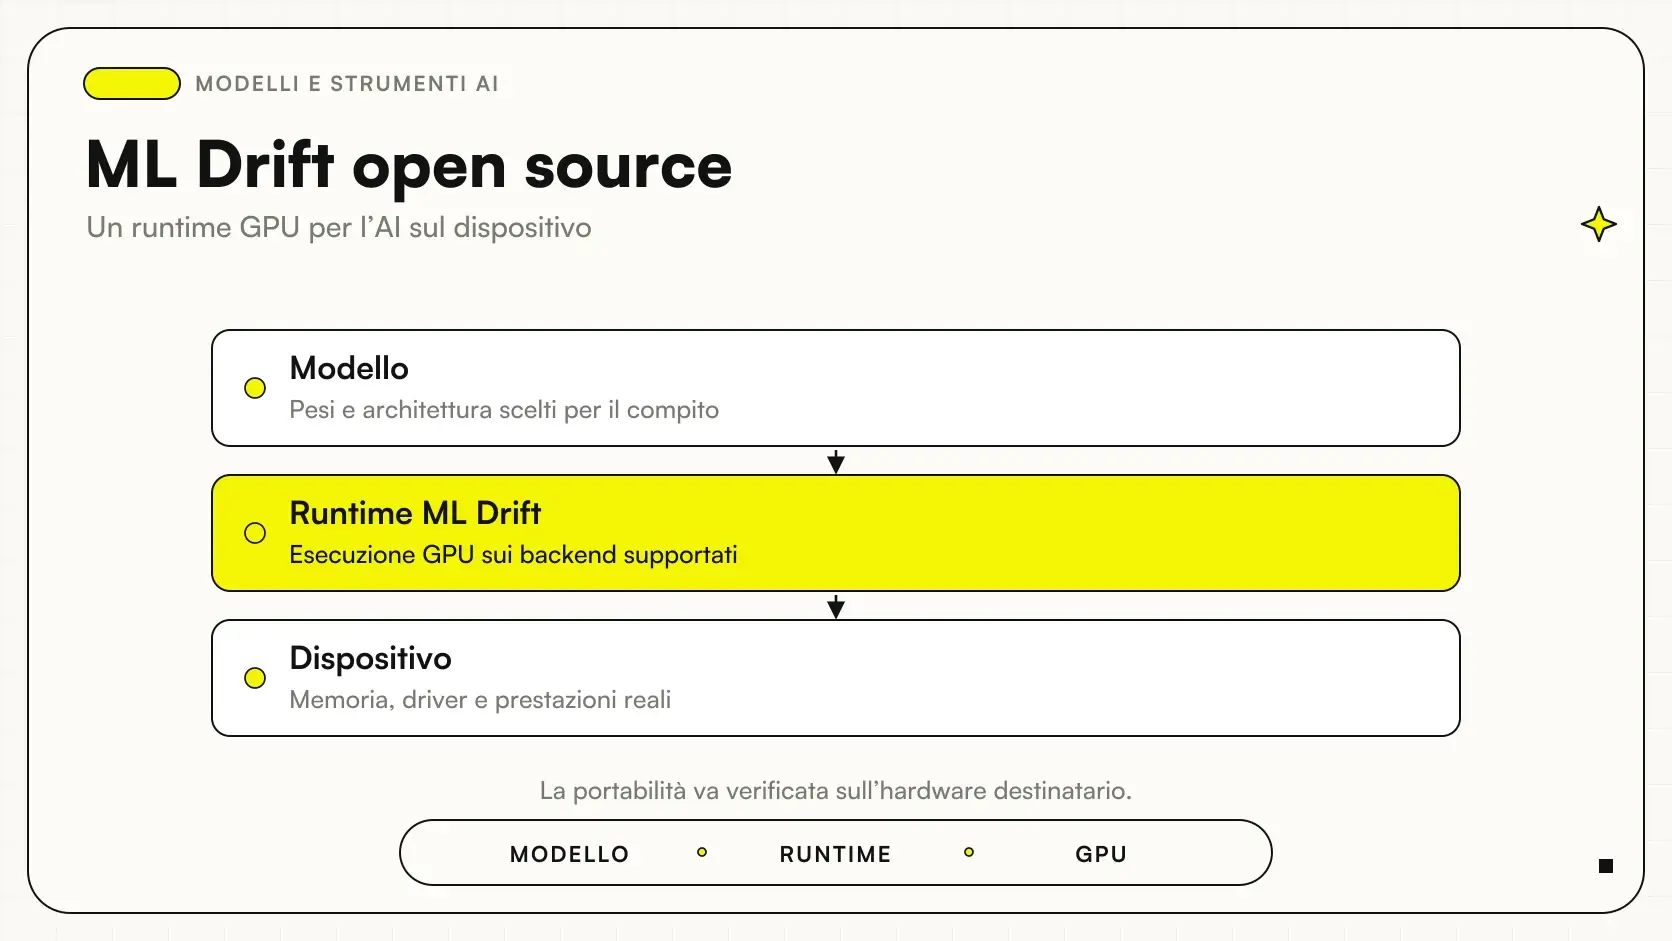
ML Drift open source: Modello → Runtime ML Drift → Dispositivo.ML Drift diventa open source: AI locale su smartphone, browser e desktopML Drift Google diventa open source standalone: differenza fra runtime e modello, backend GPU, limiti e prove per applicazioni AI locali.
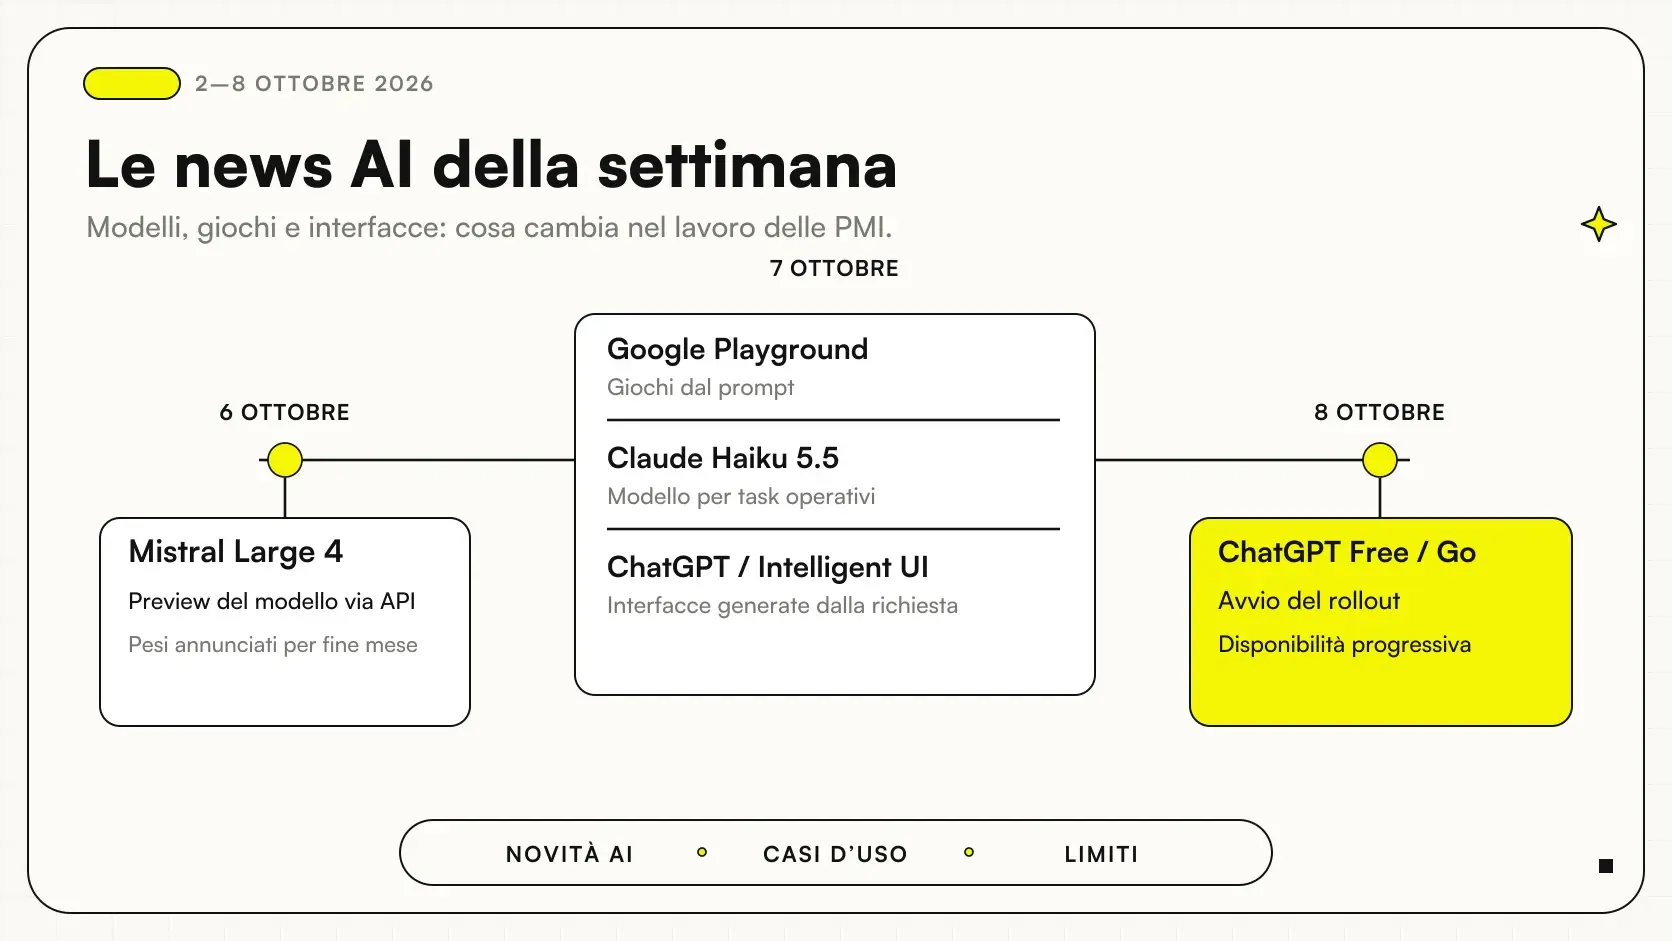
News AI ottobre 2026: cronologia di Mistral Large 4, Google Playground, Haiku 5.5 e ChatGPT Intelligent UINews AI dal 2 all’8 ottobre 2026: cosa cambia per le PMILe news AI del 2–8 ottobre: Playground, Claude, OpenAI, Google, Make, n8n e altri strumenti. Fonti, accesso e percorsi pratici per le PMI.
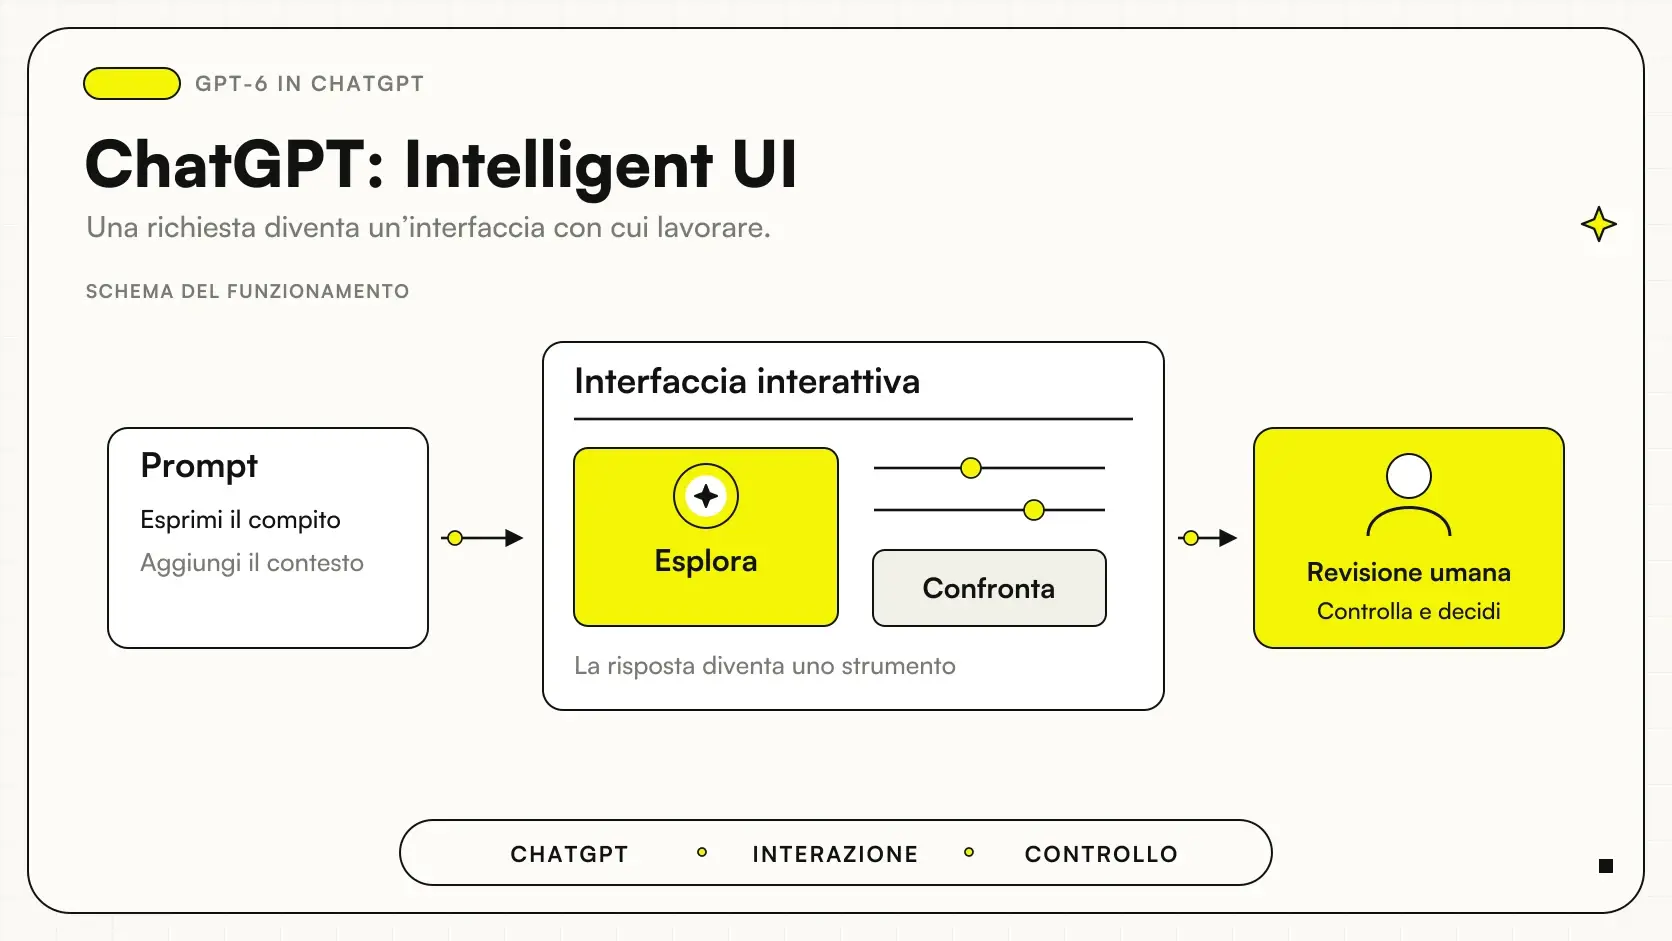
GPT-6 Intelligent UI: confronto visuale di dati e controlli interattivi in ChatGPTGPT-6 e Intelligent UI in ChatGPT: cosa cambia per chi lavoraGPT-6 porta Intelligent UI in ChatGPT: risposte visuali, confronti e strumenti interattivi. Rollout, limiti e prove utili per PMI italiane.
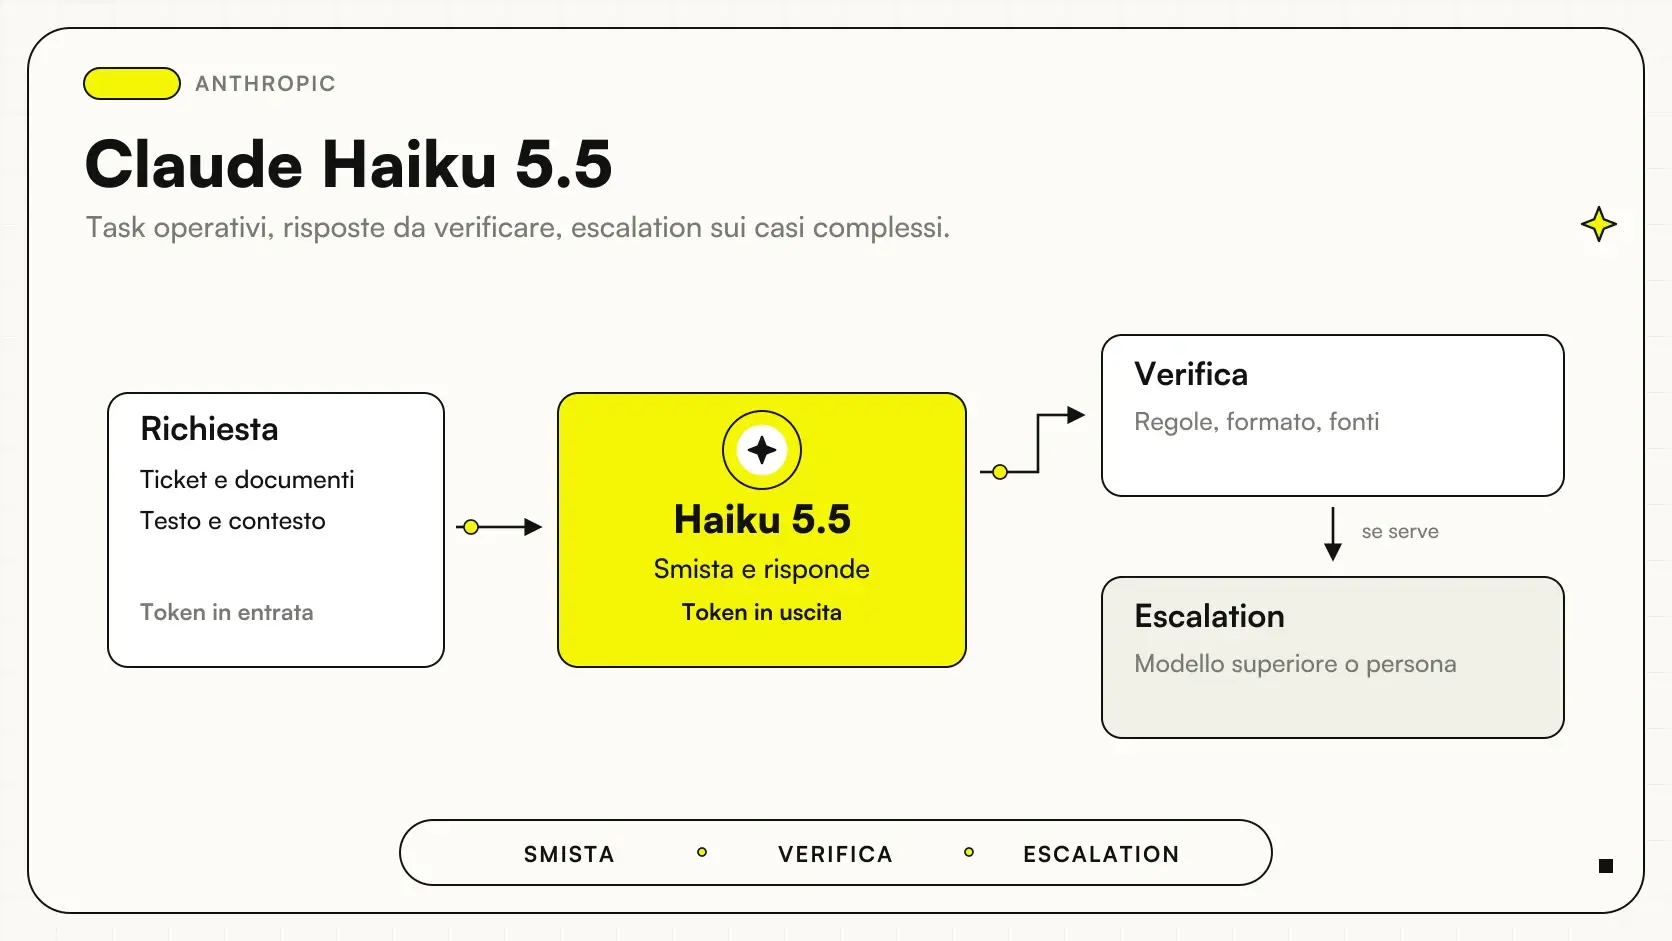
Claude Haiku 5.5: instradamento dei task aziendali tra velocità, costo e verificaClaude Haiku 5.5: prezzi API e quando usarlo nei processi aziendaliClaude Haiku 5.5: costi API, soglie dei token e criteri per usarlo su ticket, documenti e CRM. Esempi pratici e limiti della migrazione.
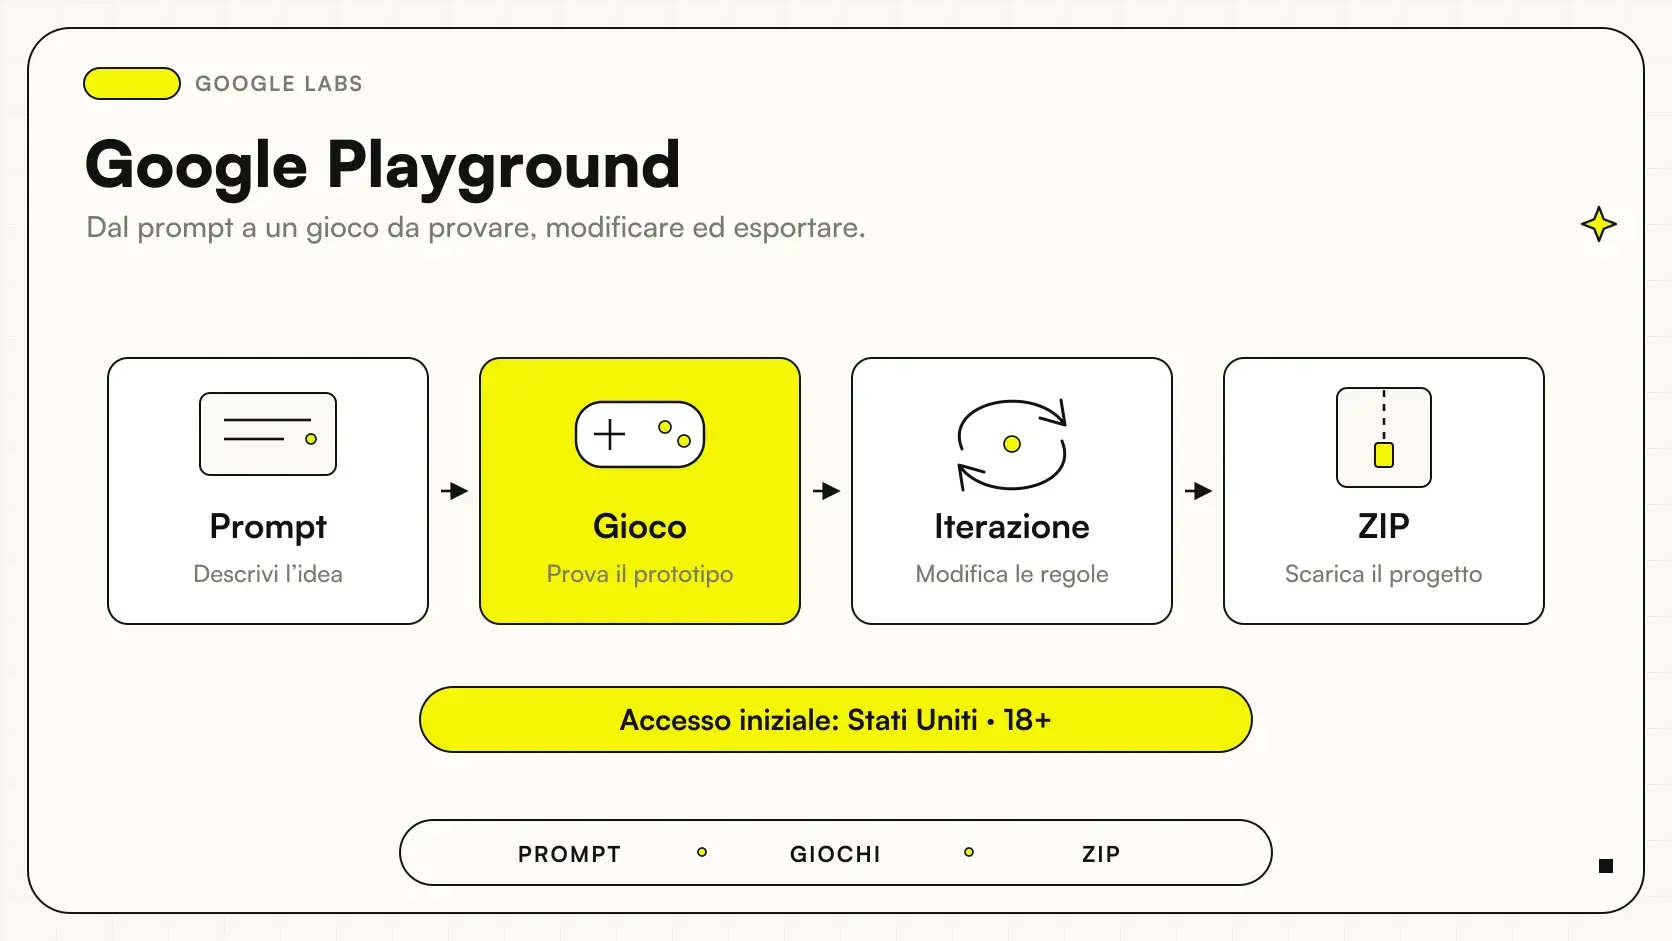
Google Playground: percorso da prompt a gioco, iterazione ed esportazione ZIP, con accesso iniziale USA 18+Google Playground: giochi con l'AI, accesso e limiti in ItaliaGoogle Playground crea giochi da prompt. Cosa cambia dal lancio del 7 ottobre 2026: accesso USA, costi, export e scenari concreti per le PMI italiane.
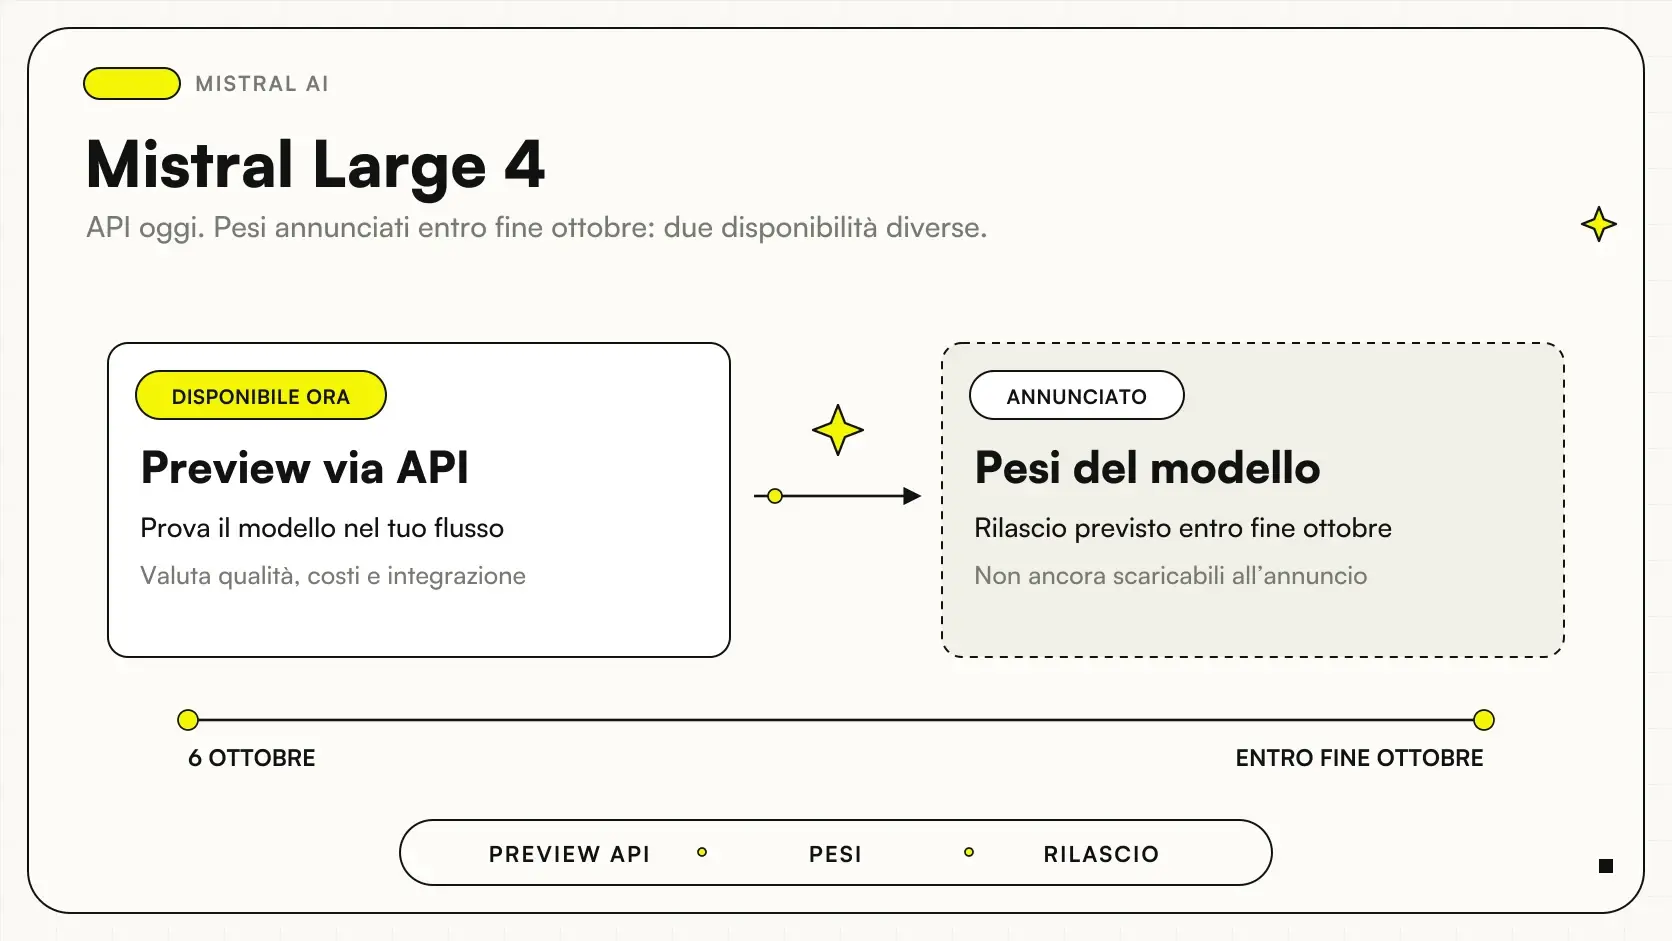
Mistral Large 4: confronto tra preview API disponibile e rilascio dei pesi annunciato entro fine ottobre 2026Mistral Large 4: cosa offre la preview e cosa valutare prima di usarloMistral Large 4 è in public preview: prezzi API, pesi attesi e controlli su hosting, documenti e dati. Guida concreta per PMI italiane.
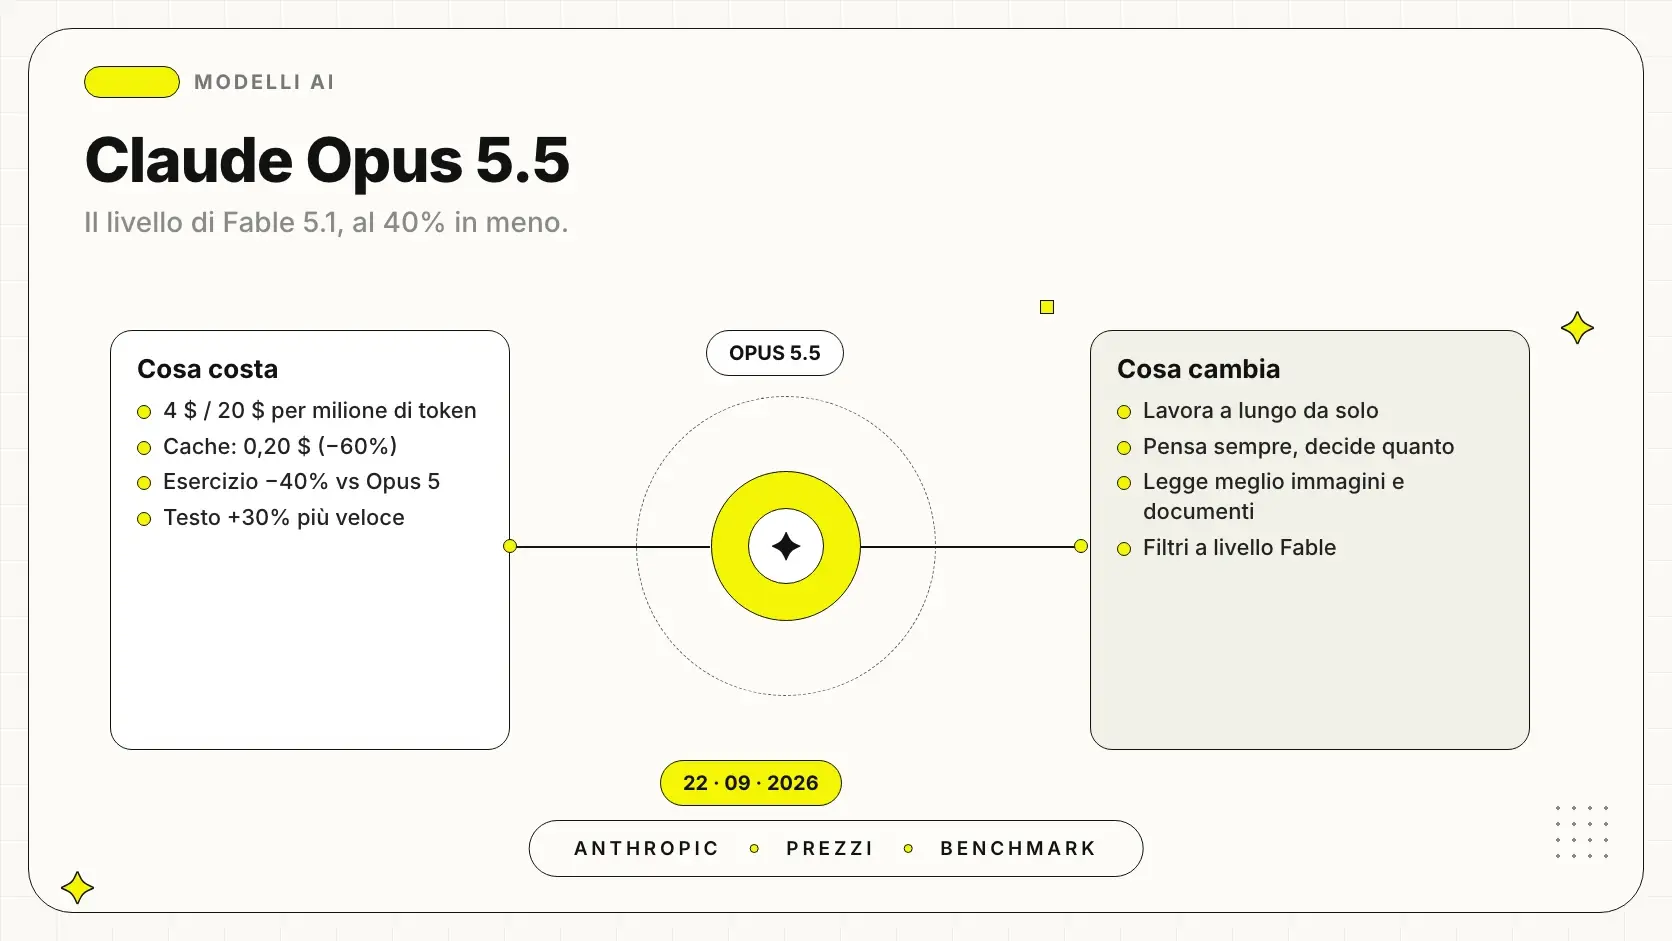
Claude Opus 5.5: cos'è il nuovo modello Anthropic e cosa cambiaClaude Opus 5.5: cos'è, cosa cambia e a chi convieneCos'è Claude Opus 5.5: differenze rispetto a Opus 5, funzioni, accesso e casi d'uso. Come capire quando conviene e quando basta un modello più leggero.
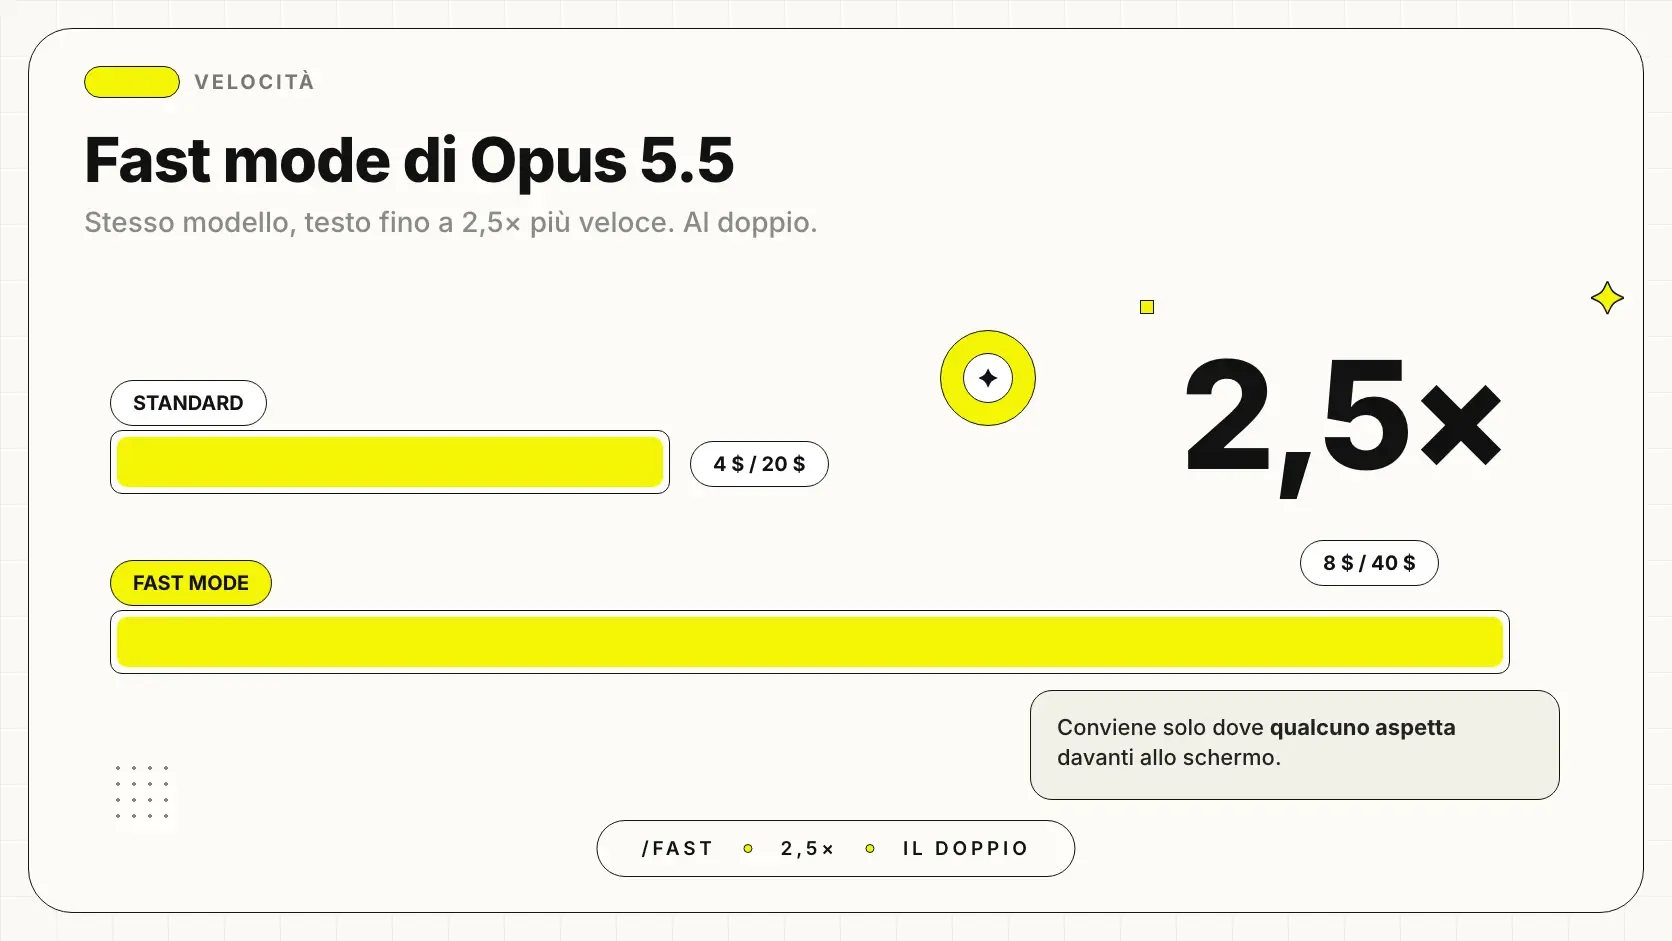
Fast mode di Claude Opus 5.5: cos'è e quando convieneFast mode di Claude Opus 5.5: cos'è, quanto costa e quando convieneFast mode di Claude Opus 5.5: stesso modello, testo fino a 2,5 volte più veloce, prezzi di 8 e 40 $ per milione di token. Come capire quando conviene.
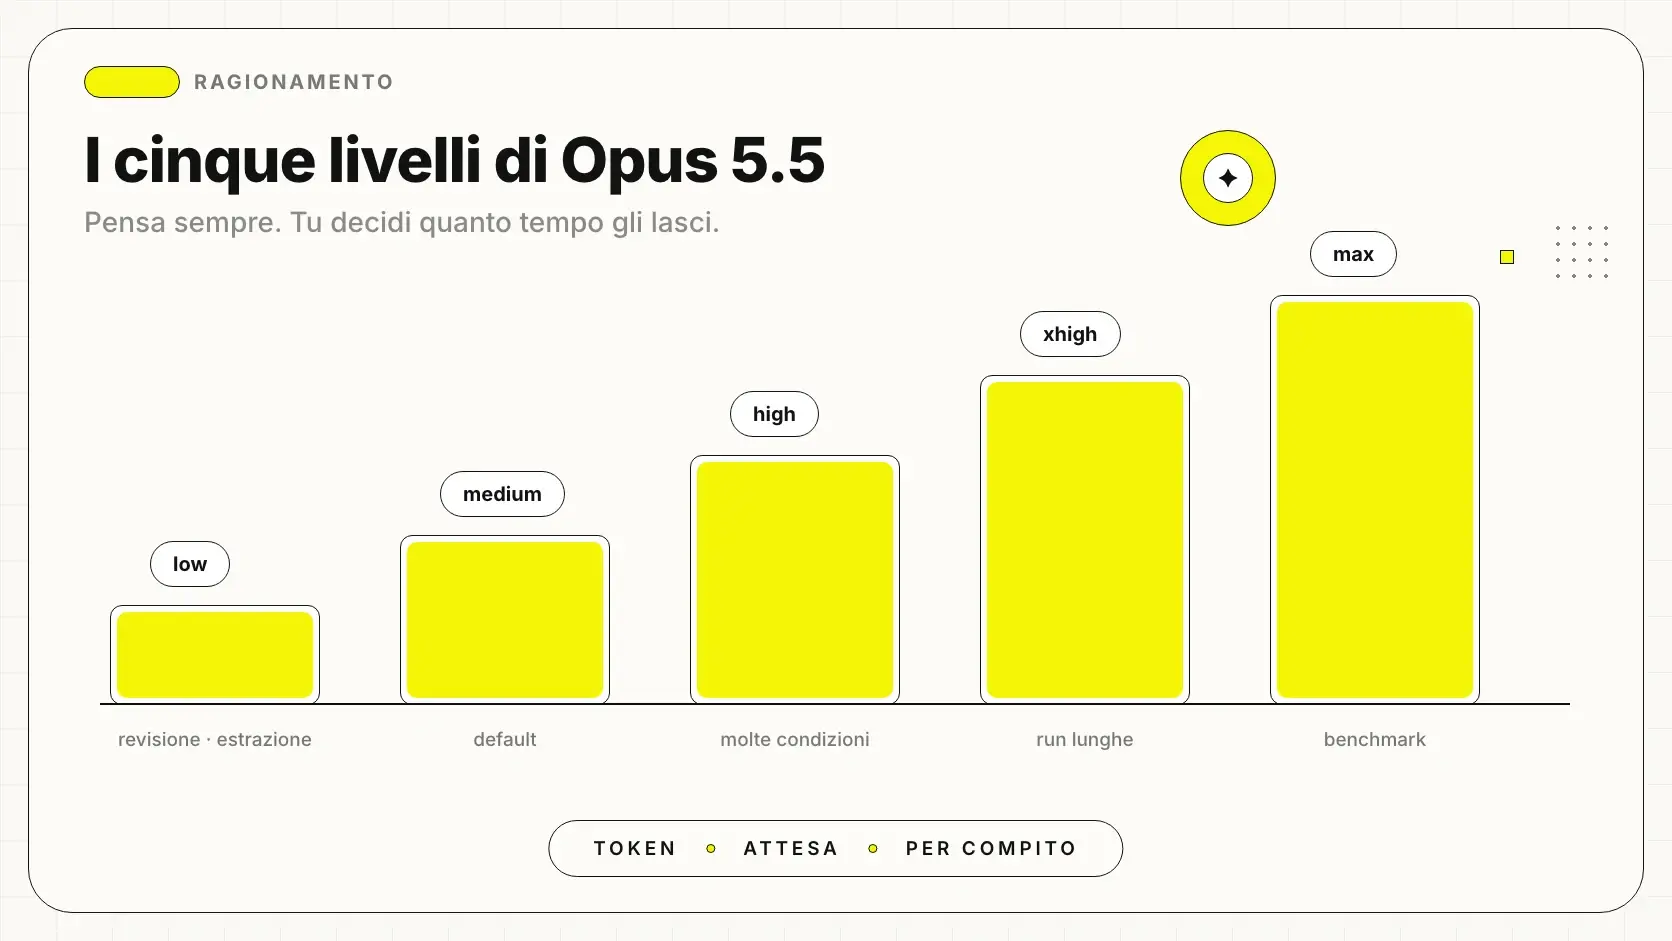
I cinque livelli di ragionamento di Claude Opus 5.5I livelli di ragionamento di Claude Opus 5.5: cosa sono e quando alzarliCosa sono i cinque livelli di ragionamento di Claude Opus 5.5, cosa significa che pensa da solo, quando alzare il livello e quanto costa in tempo e token.
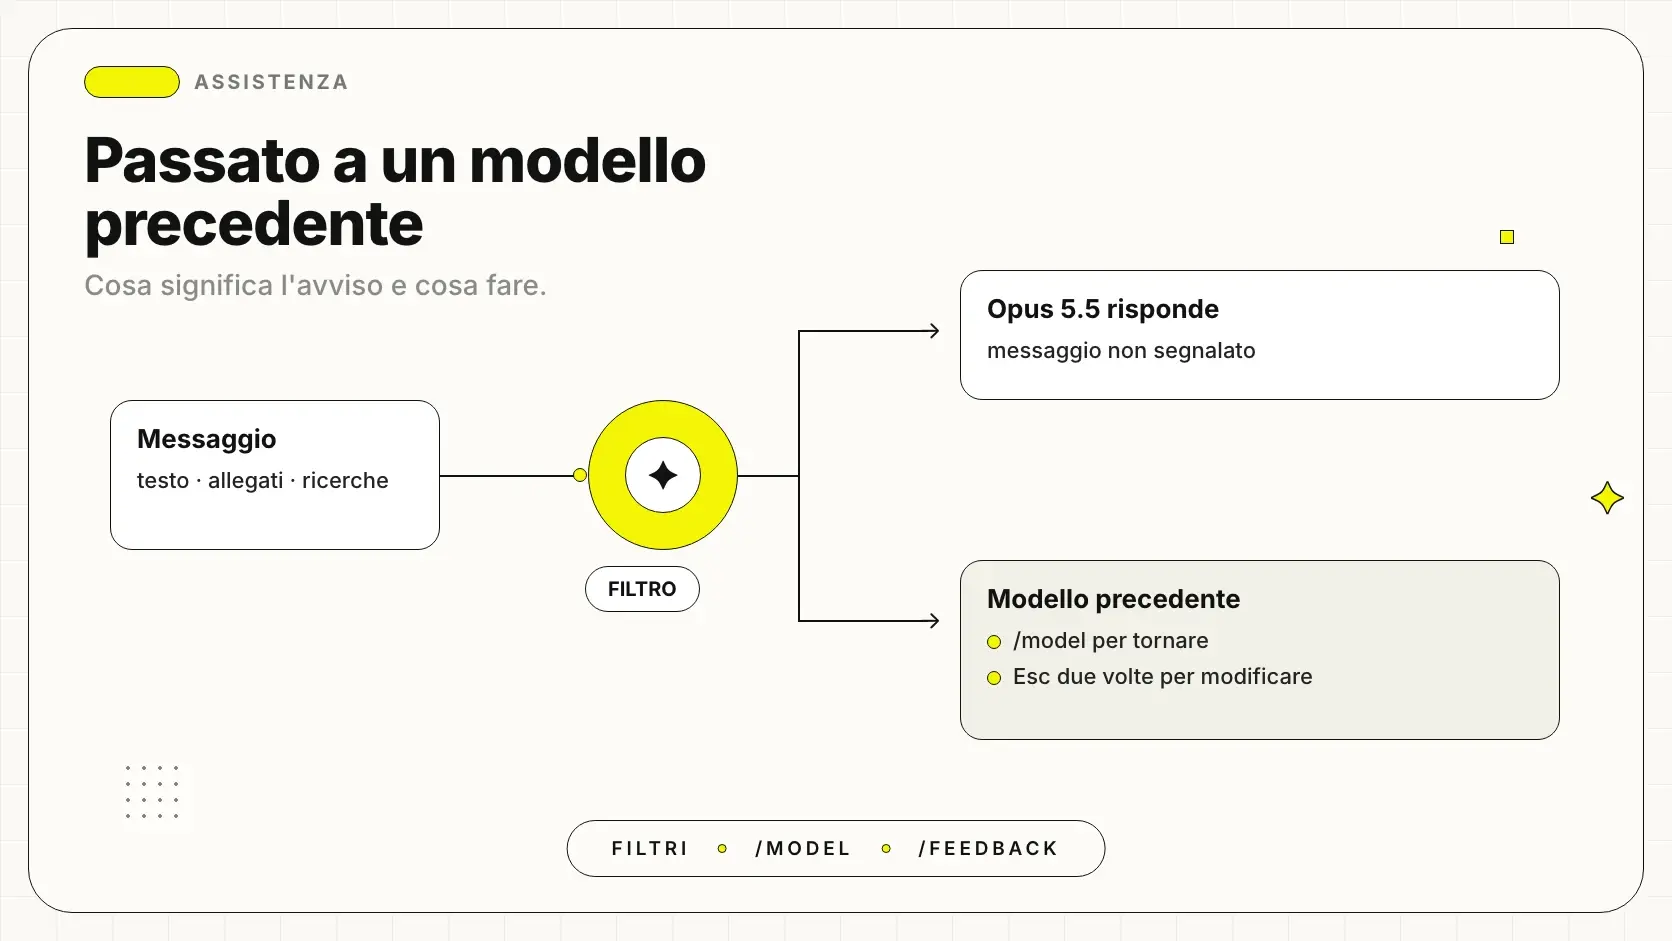
Claude è passato a un modello precedente: cosa significa il messaggioClaude è passato a un modello precedente: perché succede e cosa fareMessaggi segnalati in Claude Opus 5.5: perché passa a un modello precedente, come tornare a Opus nell'app e in Claude Code e come evitare il problema.
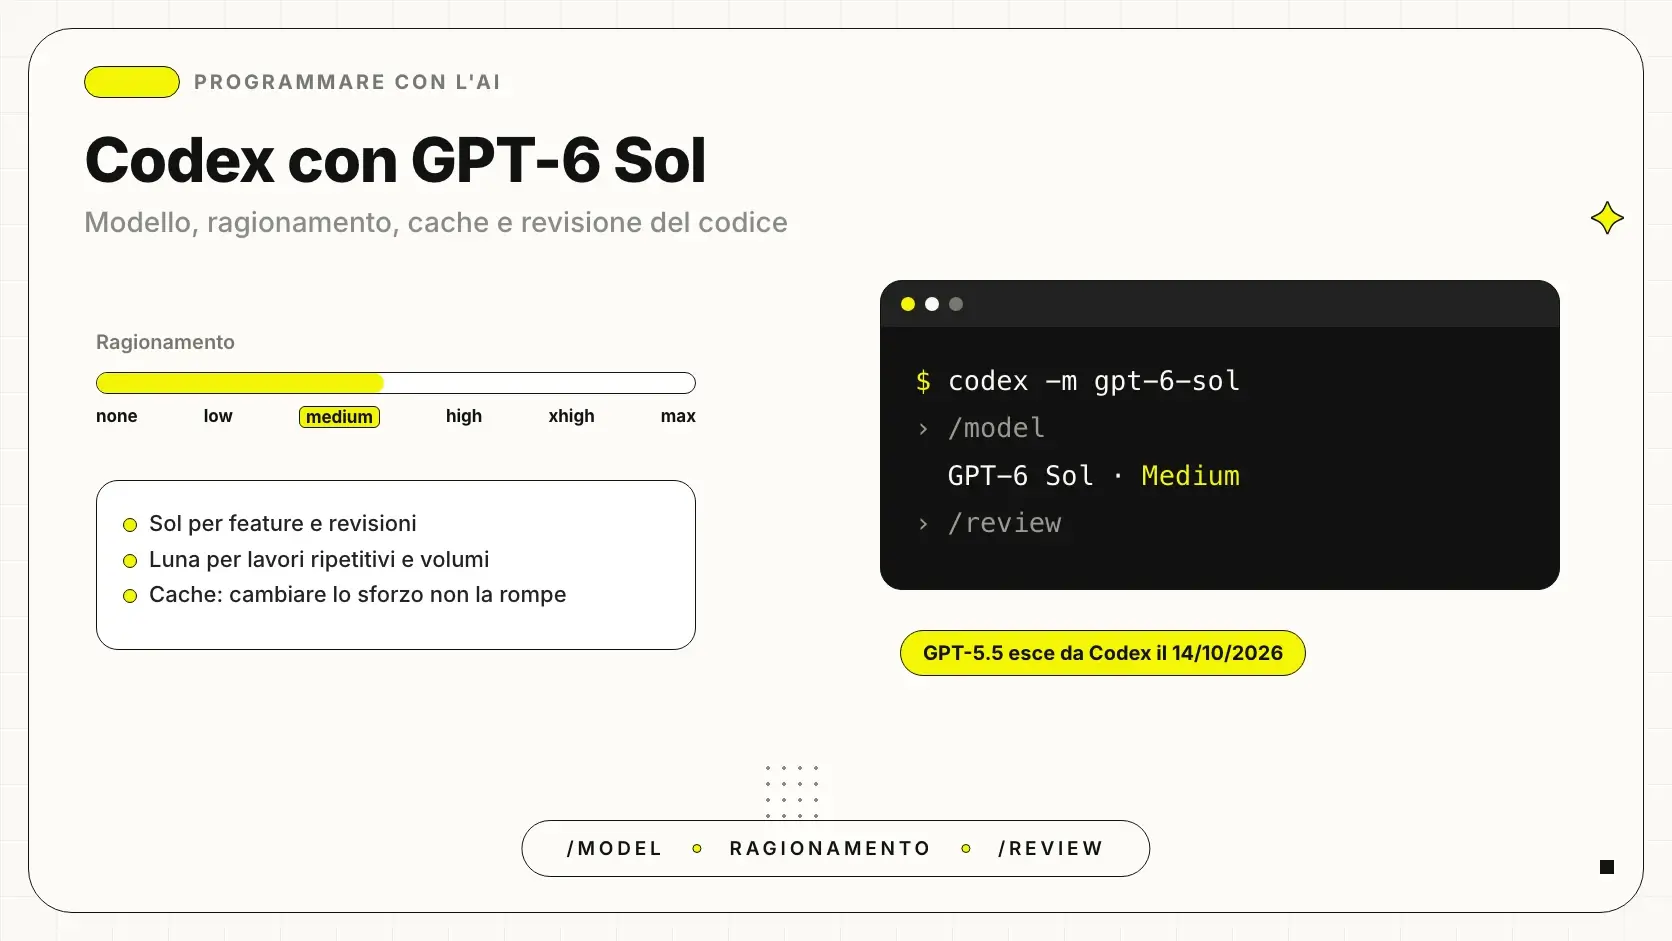
Codex con GPT-6 Sol: selettore del modello e livelli di ragionamentoCodex con GPT-6 Sol e Luna: modello, ragionamento, costi e revisioneCodex con GPT-6 Sol e Luna: come scegliere modello e livello di ragionamento, cosa cambia nel catalogo, cache per gli agenti, costi per task e revisione.
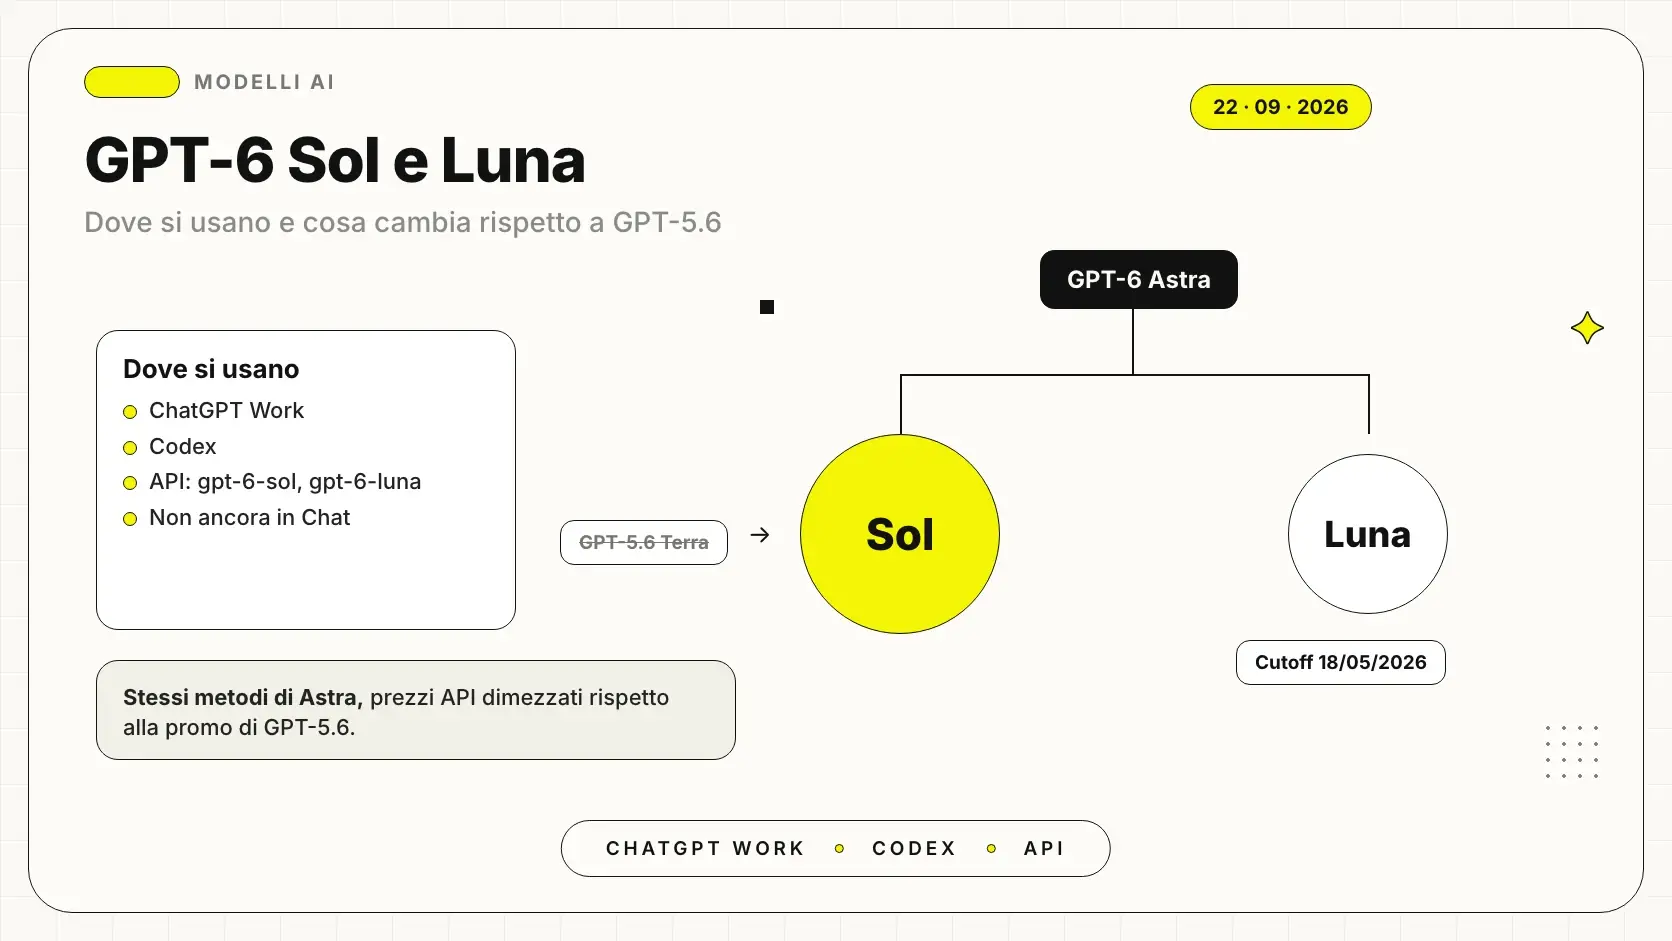
GPT-6 Sol e Luna, i due nuovi modelli OpenAI accanto a GPT-6 AstraGPT-6 Sol e Luna: cosa sono, dove si usano e cosa cambiaGPT-6 Sol e Luna, i modelli OpenAI del 22 settembre 2026: a cosa servono, dove si usano, cosa cambia da GPT-5.6 e cosa dicono davvero i benchmark.
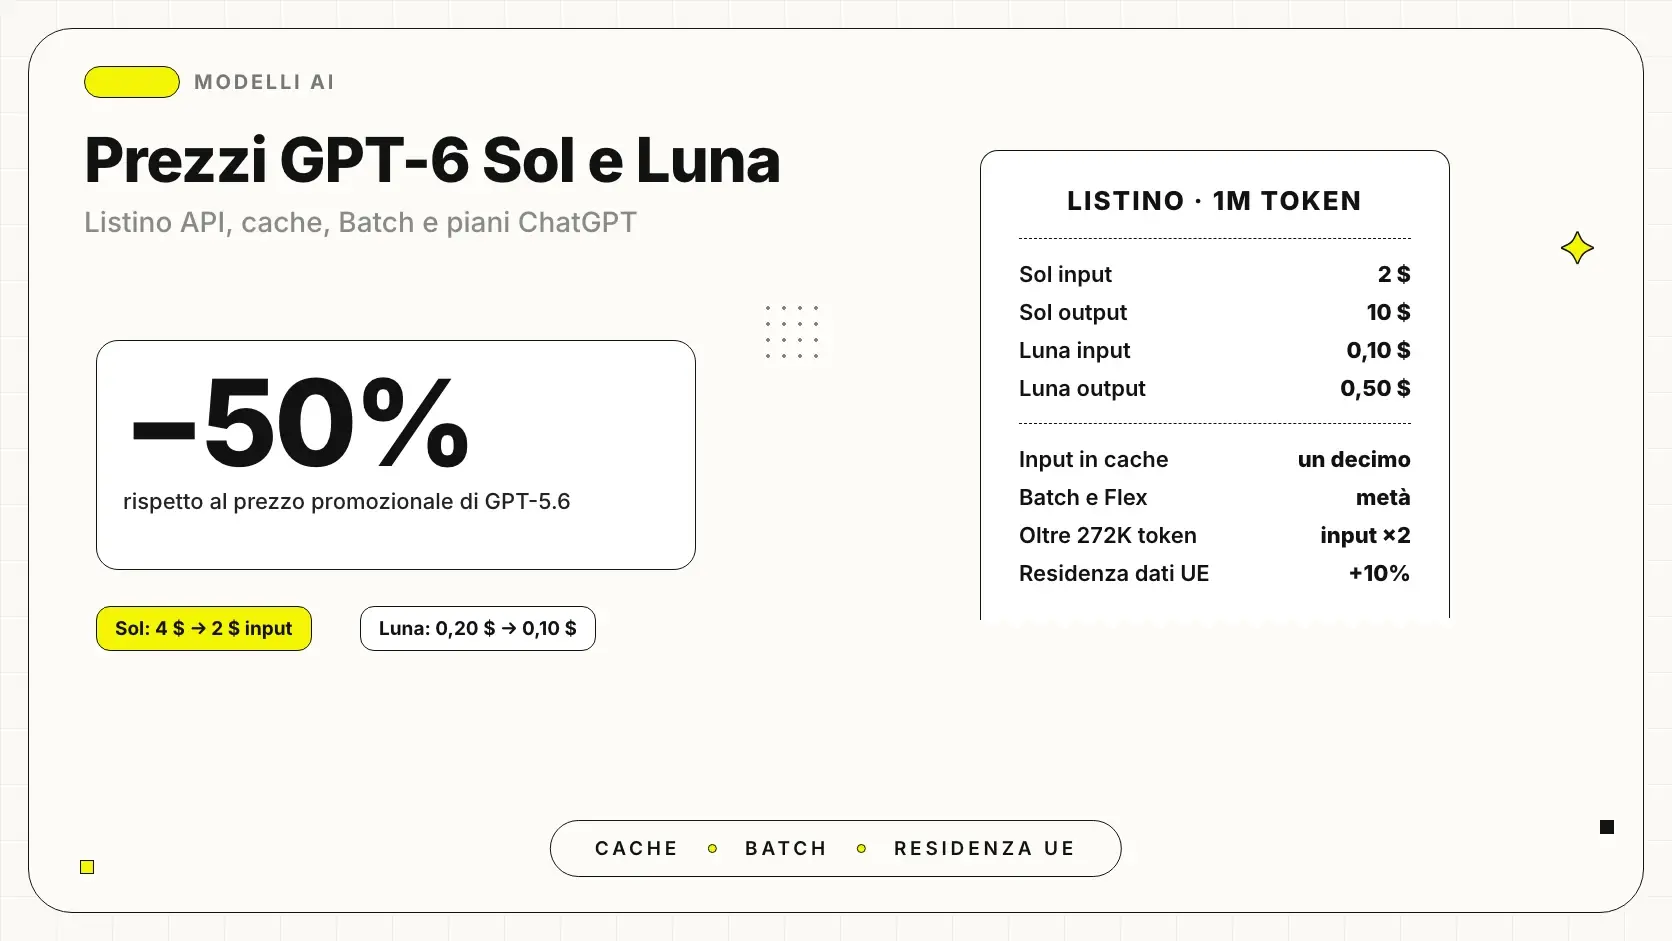
Prezzi GPT-6 Sol e Luna per milione di token, con cache, Batch e contesto lungoPrezzi GPT-6 Sol e Luna: listino API, conti di esempio e piani ChatGPTPrezzi GPT-6 Sol e Luna: listino API completo con cache, contesto lungo, Batch e residenza UE, confronto con GPT-5.6 e Astra, tre conti e piani ChatGPT.
Schema di modelli AI locali in esecuzione su un computer aziendale: dati che restano on-premise senza uscire verso il cloudModelli AI locali: quando convengonoModelli AI locali (Ollama, LM Studio): quando convengono a una PMI, vantaggi su privacy e costi, limiti reali e confronto locale vs cloud.
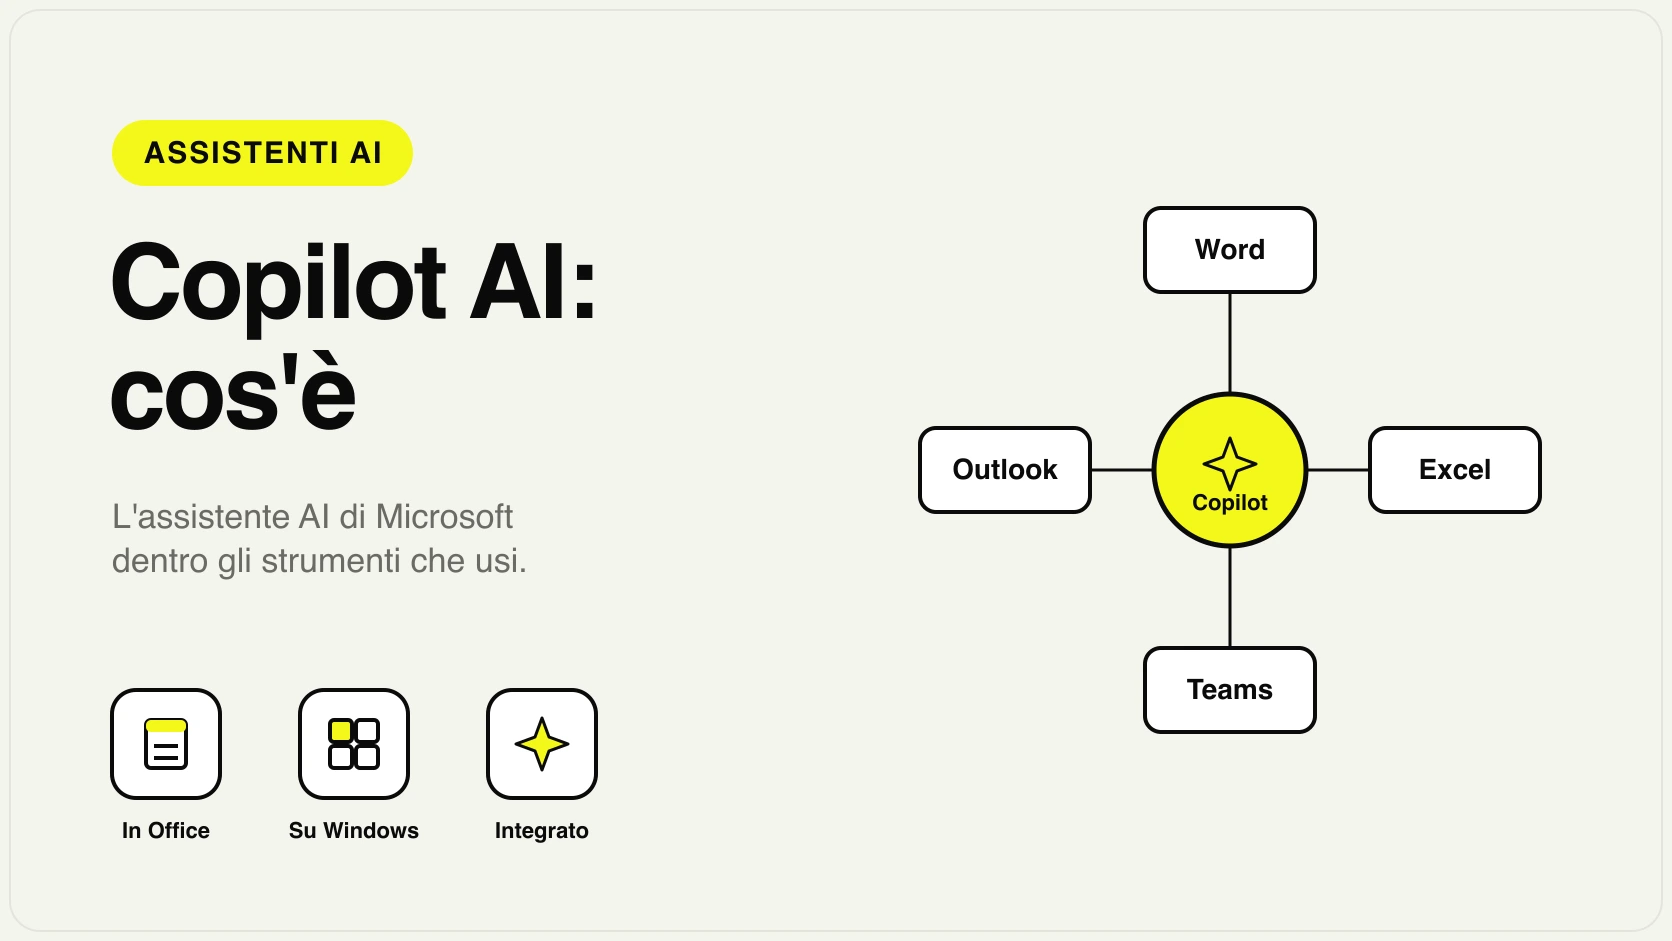
Copilot AI integrato in Microsoft 365 e Windows: assistente AI dentro Word, Excel, Outlook e TeamsCopilot AI: cos'è e come usarloCos'è Copilot AI e come usarlo: cosa fa in Office e Windows, le sue varianti, privacy e licenze, quando conviene davvero per un'azienda.
Copilot per aziende integrato in Microsoft 365: produttività e governance dei permessi sui dati aziendaliCopilot per aziendeCopilot per aziende: come usarlo davvero, governance dei permessi M365, privacy, licenze, ROI e adozione. La guida pratica per PMI e team italiani.
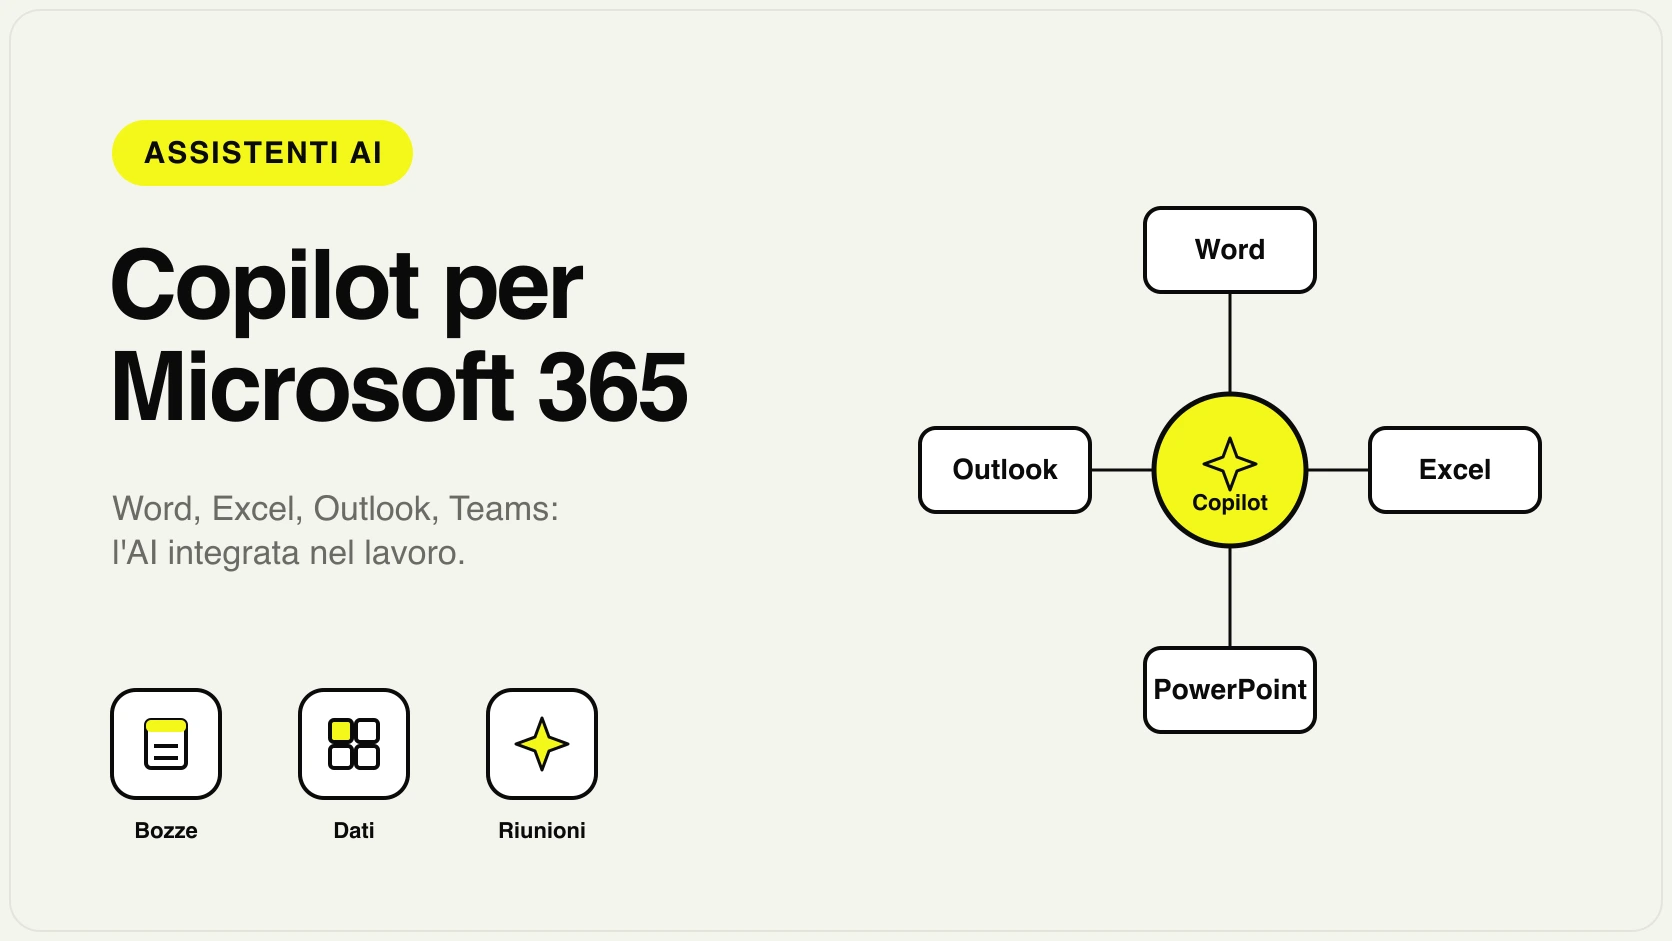
Copilot per Microsoft 365 al lavoro dentro Word, Excel, PowerPoint, Outlook e TeamsCopilot per Microsoft 365Copilot per Microsoft 365: cosa fa in Word, Excel, PowerPoint, Outlook e Teams, esempi pratici, confronto con Gemini e come usarlo davvero in azienda.
Hub di selezione tra modelli AI: criteri di scelta come qualità, lingua, privacy e costo che convergono su una decisioneCome scegliere un modello AICome scegliere un modello AI per la tua azienda: qualità, italiano, privacy e costi. Un metodo con test interno e matrice decisionale per casi reali.
Migliori AI per immagini a confronto: Midjourney, OpenAI, Gemini, Firefly, Ideogram e Stable Diffusion con licenze e diritti d'usoMigliori modelli AI per immaginiMigliori AI per immagini per aziende: Midjourney, OpenAI, Gemini, Firefly, Ideogram e Stable Diffusion letti su licenze, visibilità e legge italiana.
Migliori AI per video a confronto: generatori di scene, avatar parlanti e traduzione video con labiale per le PMIMigliori modelli AI per videoMigliori AI per video per PMI: Runway, Veo, Kling, Pika, Synthesia e HeyGen per scene, avatar e traduzioni, con diritti, consenso e regole sui deepfake.
Schema dei modelli AI open source: pesi del modello scaricabili e self-hosting su server proprioModelli AI open source: guida completaCosa sono i modelli AI open source, la differenza con i pesi aperti, vantaggi e limiti, le famiglie principali e quando convengono a una PMI.
Perplexity AI per aziende: schermata di ricerca con risposta sintetica e fonti citate per uso aziendalePerplexity AI per aziendePerplexity AI per aziende: casi reali (ricerca mercato, monitoraggio, knowledge interna), privacy e dati, e quando serve invece un sistema RAG su misura.
Perplexity AI per ricerche: una domanda che genera una risposta con fonti citate e numeratePerplexity AI per fare ricercheCome usare Perplexity AI per ricerche con fonti: ricerche di mercato, analisi competitor, due diligence e fact-checking. Guida pratica con esempi e limiti.
Schema di Mistral AI: modello europeo con pesi aperti e API, assistente Vibe (ex Le Chat) e dati che restano in EuropaMistral AI: cos'è e perché è importanteCos'è Mistral AI, l'azienda europea di modelli AI: pesi aperti vs API, Vibe (ex Le Chat), sovranità dei dati e quando ha senso per una PMI italiana.
Schema di come funziona DeepSeek, il modello AI cinese: prompt in ingresso, ragionamento, rispostaDeepSeek: cos'è e perché se ne parlaCos'è DeepSeek, il modello AI cinese noto per costi bassi e reasoning. Come funziona, privacy e residenza dati per le aziende UE, quando usarlo.
Schermata di Grok AI di xAI integrato nella piattaforma X, con un prompt e una risposta basata su dati in tempo realeGrok AI: cos'è e come funzionaCos'è Grok AI e come funziona: il modello di xAI integrato in X, l'accesso ai dati in tempo reale, casi d'uso, limiti e quando ha senso per un'azienda.
Llama AI di Meta: il modello a pesi aperti che gira on-premise sui server dell'aziendaLlama AI: cos'è il modello open source di MetaCos'è Llama AI, la famiglia di modelli a pesi aperti di Meta: come funziona, vantaggi (self-hosting, privacy, costi), licenza e quando conviene a un'azienda.
Schema di come funziona Perplexity AI: domanda, ricerca sul web, risposta sintetizzata con fonti citatePerplexity AI: cos'è e come funzionaCos'è Perplexity AI: ricerca sul web e risposte con fonti citate. Differenze con ChatGPT e Google, piano Pro, limiti e casi d'uso nel lavoro aziendale.

Le altre categorie