
Qwen3.8-27B: quanta RAM e VRAM servono davvero?
Quanta RAM e VRAM serve a Qwen3.8-27B? Distingui pesi teorici, file quantizzati, cache, contesto e memoria reale prima di scegliere l'hardware.
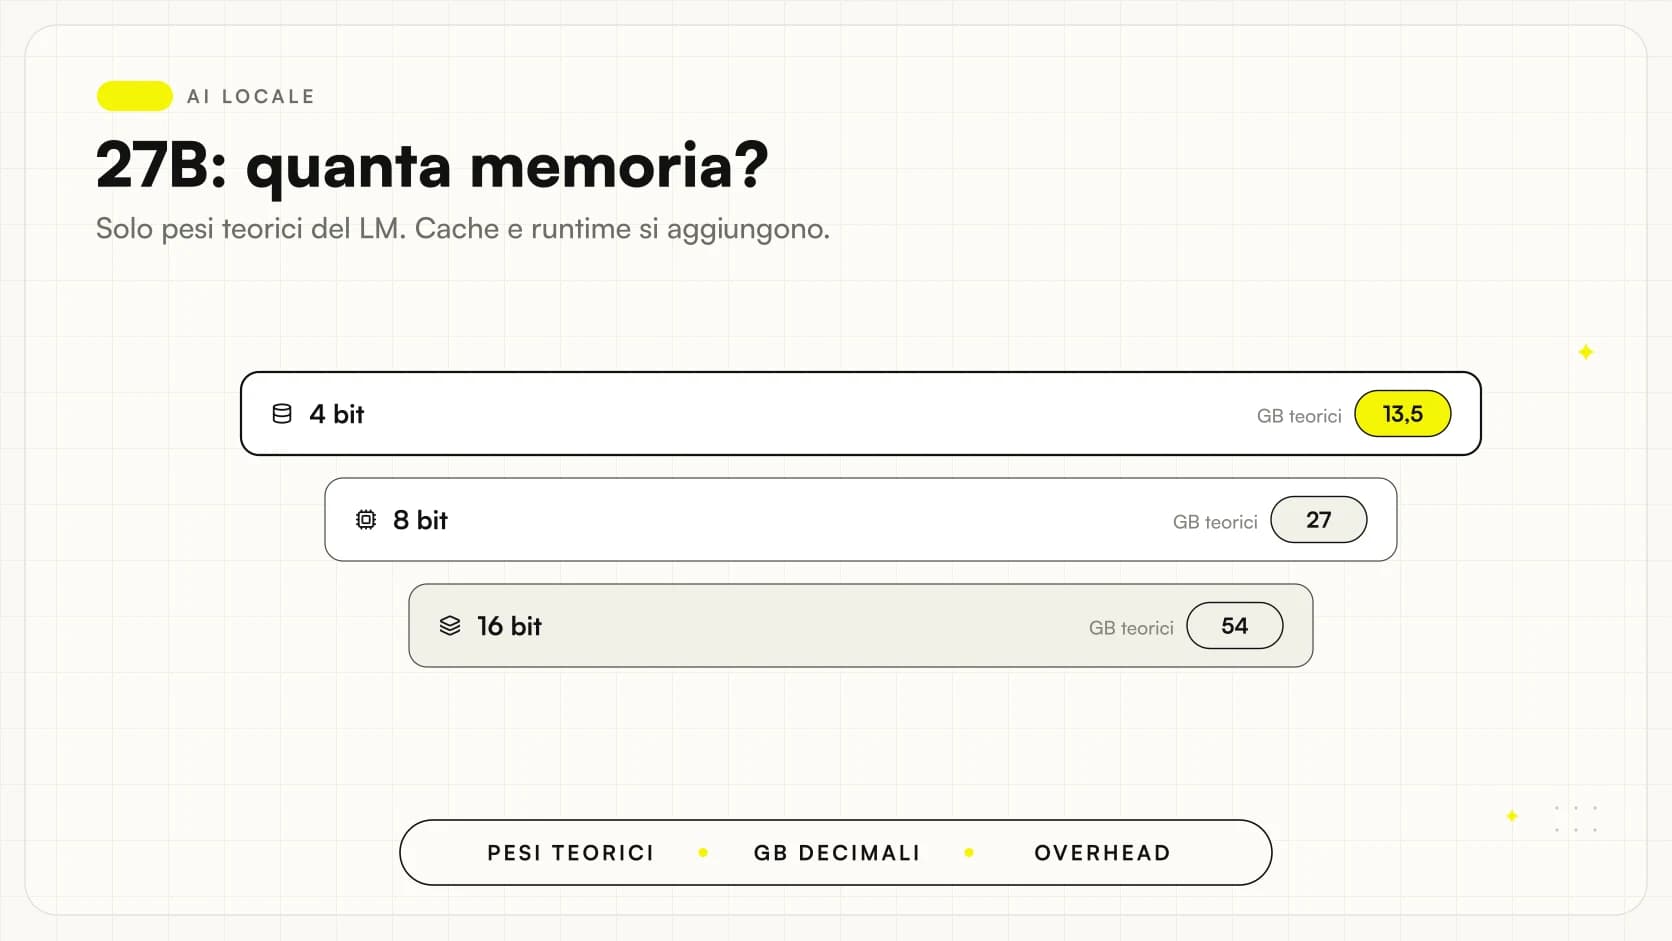
Per Qwen3.8-27B non esiste un numero unico di RAM o VRAM valido per ogni installazione: i pesi sono soltanto una parte del consumo. La risposta utile richiede checkpoint, quantizzazione, runtime, contesto e numero di richieste simultanee; una formula sui parametri non dimostra che il modello lavori bene sul tuo computer.
Come riferimento, il repository Qwen/Qwen3.8-27B identifica il modello, mentre la sua configurazione ufficiale descrive le componenti. Le fonti sono state consultate il 27 ottobre 2026. Giallo non ha misurato memoria o velocità su una macchina campione: le formule qui sotto sono calcoli teorici esplicitamente separati dai requisiti operativi.
In sintesi
- Il nome 27B non descrive tutta la memoria del servizio.
- Quattro bit teorici sui pesi linguistici danno circa 13,5 GB decimali.
- Un file quantizzato reale può avere componenti a precisioni diverse.
- Contesto, immagini e concorrenza cambiano il dimensionamento.
- La configurazione si approva dopo una prova del carico previsto.
Come si calcola il peso teorico di un modello 27B?
La formula elementare è parametri moltiplicati per bit per parametro e divisi per otto. Usando 27 miliardi come dimensione della sola componente linguistica, si ottengono questi valori ideali. La tabella è un nostro calcolo matematico, non una misura del checkpoint distribuito.
| Precisione ideale dei pesi | Calcolo | GB decimali teorici | GiB teorici approssimati |
|---|---|---|---|
| 16 bit | 27 miliardi × 16 / 8 | 54 GB | 50,3 GiB |
| 8 bit | 27 miliardi × 8 / 8 | 27 GB | 25,1 GiB |
| 4 bit | 27 miliardi × 4 / 8 | 13,5 GB | 12,6 GiB |
I GB decimali usano miliardi di byte; i GiB usano potenze di due. Questa differenza spiega parte degli scarti fra numeri visualizzati da strumenti diversi, ma non tutto il consumo aggiuntivo. Il calcolo serve a escludere aspettative irrealistiche prima di scaricare file grandi. Non autorizza a chiamare una macchina “compatibile” quando la memoria nominale supera di poco la colonna dei pesi.
Perché un GGUF Q4 non coincide con quattro bit su ogni parametro?
Una quantizzazione reale può includere scale, metadati e parti del modello conservate a precisione diversa. Anche formati con nomi simili possono impiegare schemi differenti. La panoramica Hugging Face sulla quantizzazione distingue metodi e compromessi: la scelta richiede supporto del modello e dell'hardware.
Per il dimensionamento conta quindi il file effettivo, con autore e revisione della conversione. Se il pacchetto comprende più file, il progetto deve identificare quali saranno caricati e quando. Non basta leggere una cifra nell'etichetta. La guida a GGUF, Q4 e Q8 spiega questa differenza; nel verbale hardware conviene riportare anche la dimensione su disco, senza confonderla con il picco di memoria durante l'inferenza.
Quali componenti vanno aggiunti ai pesi linguistici?
Un servizio può richiedere componenti visivi, strutture di cache, buffer del motore e memoria delle librerie. Se la pipeline converte PDF o elabora immagini, entrano altri processi nel carico complessivo. Il sistema operativo e le applicazioni degli utenti conservano a loro volta un fabbisogno che non può essere ignorato.
Conviene descrivere il consumo come un bilancio: pesi, componenti aggiuntivi, memoria per richieste e spazio operativo del computer. Le voci non sono tutte fisse. Un modello può caricarsi e fallire soltanto quando arriva un input più impegnativo. Per questo il test non finisce alla comparsa del messaggio di avvio. La procedura d'installazione Qwen separa caricamento e verifica applicativa, mantenendo visibili le fasi nelle quali una richiesta può esaurire risorse.
RAM, VRAM e memoria unificata: che cosa cambia?
Con una GPU dedicata, RAM di sistema e VRAM sono risorse distinte. Un runtime può distribuire parte del lavoro tramite offload, ma quel percorso ha vincoli e prestazioni da osservare. Sommare semplicemente le capacità nominali non descrive una configurazione reale né garantisce che un certo modello sia utilizzabile.
Su Apple Silicon la memoria unificata è condivisa dal sistema e dai componenti di calcolo. Il confronto con una GPU dedicata richiede quindi attenzione al carico complessivo, non una conversione diretta fra etichette commerciali. Per un acquisto si parte dal processo: uso individuale, workstation con altri programmi o servizio condiviso. Le guide per Mac con 16, 24 o 32 GB e per GPU e VRAM su Windows affrontano i rispettivi percorsi di prova.
Quanto incide il contesto sulla memoria?
Il contesto comprende il materiale che il modello usa durante la richiesta, non soltanto la domanda appena scritta. Possono esserci istruzioni, conversazione precedente, documenti, risultati degli strumenti e spazio per la generazione. Aumentarne il limite può cambiare l'occupazione del runtime anche quando i pesi restano identici.
La guida Hugging Face alle cache mostra strategie con compromessi diversi fra memoria e prestazioni. Non conviene applicare una formula generica senza conoscere l'architettura e l'implementazione. Per dimensionare il progetto si definiscono input ordinario, caso più lungo ammesso e limite della risposta. “Supporta un contesto molto grande” è una capacità dichiarata del modello; “questa macchina sostiene quel contesto” è un risultato da verificare separatamente.
Perché Qwen3.8 richiede attenzione alle stime della cache?
La ricetta specifica vLLM descrive un'architettura ibrida, con componenti di attenzione diverse. Non è corretto trattare tutti gli strati come un normale transformer a piena attenzione e ricavare da quella supposizione una cifra apparentemente precisa. Il risultato potrebbe essere lontano dal comportamento del motore effettivo.
Anche il cookbook SGLang dedica impostazioni specifiche alla distribuzione della memoria. Questi riferimenti mostrano perché una stima deve dichiarare il runtime. Non occorre riprodurre ogni dettaglio tecnico nel preventivo aziendale; occorre però chiedere una configurazione documentata e una misura del carico. Le ottimizzazioni per un acceleratore non diventano automaticamente ricette valide per un portatile o un altro backend.
Immagini e video possono cambiare il risultato del test?
Un test soltanto testuale non copre il carico di documenti visivi. Risoluzione, numero di immagini e trasformazioni della pipeline possono modificare il lavoro richiesto. Lo stesso PDF può diventare testo estratto o una sequenza di immagini, con un percorso operativo diverso. Il campione deve rappresentare l'uso effettivo.
La prova registra anche la preparazione del contenuto: conversione, ritagli e componenti che restano attivi insieme al server. Se si misura soltanto il processo principale, una parte del costo può rimanere nascosta. Per un ufficio che legge scansioni, la guida all'AI multimodale locale aiuta a separare qualità della lettura e consumo dell'elaborazione. Il modello va scelto dopo aver deciso quale percorso serve, non prima.
Perché una chat singola non dimensiona un servizio condiviso?
Due utenti possono sovrapporre richieste, documenti e generazioni. Il runtime deve gestire quello stato insieme ai pesi già caricati. Un servizio che sembra adeguato nella dimostrazione individuale può quindi comportarsi diversamente quando il lavoro del team si concentra nello stesso momento.
La prova stabilisce quante richieste devono essere attive e quali possono attendere. Una coda esplicita può essere una scelta più semplice di un'espansione immediata dell'hardware, se il processo la tollera. Al contrario, un flusso che richiede interazione continua non può essere dimensionato come un'elaborazione notturna. Non esiste una percentuale universale da aggiungere alla RAM: si simulano le condizioni previste e si osservano errori, occupazione e tempi. L'architettura applicativa contribuisce al dimensionamento quanto il checkpoint.
Uno scenario: il portatile con 16 GB già usato per lavorare
Immaginiamo un professionista con un portatile da 16 GB, browser, posta e programmi del proprio mestiere aperti. È uno scenario illustrativo. Il calcolo teorico da 13,5 GB non dimostra che il 27B quantizzato lasci spazio sufficiente a quel carico. La prova deve osservare il computer intero, non soltanto se il file viene caricato.
Una scelta ragionevole è partire da un candidato più piccolo che copra il compito e usare il 27B come confronto soltanto se esiste una configurazione compatibile. Si valuta il risultato utile, non il prestigio del numero di parametri. Se il modello più grande rende il computer difficile da usare, il costo ricade anche sulle altre attività. La guida su come scegliere un modello AI propone di legare dimensione e capacità a un obiettivo verificabile.
Uno scenario: il server interno che elabora documenti a gruppi
Secondo esempio ipotetico: un'impresa prepara un servizio che legge documenti a gruppi quando gli utenti non sono attivi. Il requisito può permettere coda e ritardi, ma richiede che l'intero gruppo sia completato senza perdere lo stato. La prova misura input più lungo, eventuali immagini e comportamento dopo un errore.
Qui può essere utile limitare la concorrenza e conservare una coda ripetibile, invece di caricare più richieste del necessario. Le impostazioni vanno provate sul runtime scelto. Se un documento supera il perimetro, il servizio deve segnalarlo e proseguire con una gestione esplicita, senza far sembrare concluso il lavoro. Il bilancio economico include amministrazione, aggiornamenti e verifiche: la comparazione dei costi locale e cloud aiuta a collegare le risorse al processo.
Quali misure salvare per approvare la configurazione?
- Checkpoint, revisione, conversione e precisione effettive.
- Macchina, sistema, acceleratore e versione del runtime.
- Contesto configurato, dimensione degli input e limite dell'output.
- Richieste simultanee, altre applicazioni e percorso multimodale.
- Occupazione osservata, errori e tempi del campione di riferimento.
Per Ollama, quando il checkpoint è supportato, la pagina context length documenta i controlli sul contesto e sull'offload. Altri runtime espongono log e indicatori propri. La lettura deve distinguere memoria prenotata, effettivamente usata e risorse del sistema: una cifra isolata senza definizione non è una base sufficiente per confrontare due configurazioni.
Quali scorciatoie evitare prima di comprare hardware?
Il primo errore è comprare una macchina dalla formula dei soli pesi. Il secondo è trasferire una misura da una precisione all'altra. Il terzo è applicare a Qwen un requisito pubblicato per un modello diverso. Le stime ufficiali possono essere utili, ma restano legate a definizioni e ambiente: per esempio, Google distingue esplicitamente caricamento e contesto nelle proprie tabelle Gemma.
Un altro errore è contare la possibilità di usare memoria su disco come se fosse equivalente alla disponibilità di memoria per il calcolo. La domanda operativa non è soltanto “si avvia?”, ma “sostiene questo lavoro entro i limiti concordati?”. Una prova su hardware disponibile può rispondere prima dell'acquisto, purché configurazione e condizioni siano registrate con precisione sufficiente a interpretare l'esito.
Come confrontare due configurazioni senza confondere i consumi?
Se cambi precisione, contesto e concorrenza contemporaneamente, la differenza osservata diventa difficile da interpretare. Conviene fissare un riferimento e modificare una variabile alla volta, mantenendo uguali input e limite dell'output. Il primo caricamento va distinto dalle richieste con modello già pronto; anche i processi rimasti attivi dopo una prova precedente devono essere identificati.
Si annota inoltre che cosa significa la cifra registrata: dimensione del file, memoria del processo, quota riservata dal runtime o occupazione dell'acceleratore. Sono misure utili per domande diverse. Una riduzione del file su disco non dimostra automaticamente una riduzione proporzionale del picco; una prenotazione elevata non equivale da sola a un errore del servizio.
La scheda finale dovrebbe includere un caso ordinario e il caso più impegnativo ammesso dal processo. Se il secondo fallisce, bisogna decidere se ridimensionare il requisito, cambiare configurazione o scegliere un ambiente diverso. Nascondere quel caso dietro una media rende la macchina apparentemente adeguata, ma lascia il problema all'operatore quando arriva il documento reale. Una scelta sostenibile conserva anche gli esiti sfavorevoli e il motivo per cui una configurazione è stata esclusa.
Come trasformare il numero di GB in una scelta aziendale?
Definisci un compito, un campione e un limite accettabile per errori e attesa. Poi confronta una configurazione che lasci margine operativo con eventuali alternative più piccole. Se il requisito cresce, ripeti il test prima di promettere documenti più lunghi o nuovi utenti. Il benchmark locale in italiano serve proprio a mantenere questo collegamento fra qualità e risorse.
Se vuoi dimensionare Qwen sul tuo processo prima di investire, la consulenza AI di Giallo Studio può definire carico, misure e criteri di accettazione. Il risultato è una scelta documentata dell'ambiente necessario, con limiti espliciti, invece di una cifra di RAM presentata come garanzia per qualsiasi utilizzo.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 DeepSeek R1 Distill 32B vs Qwen3.8-27B in locale
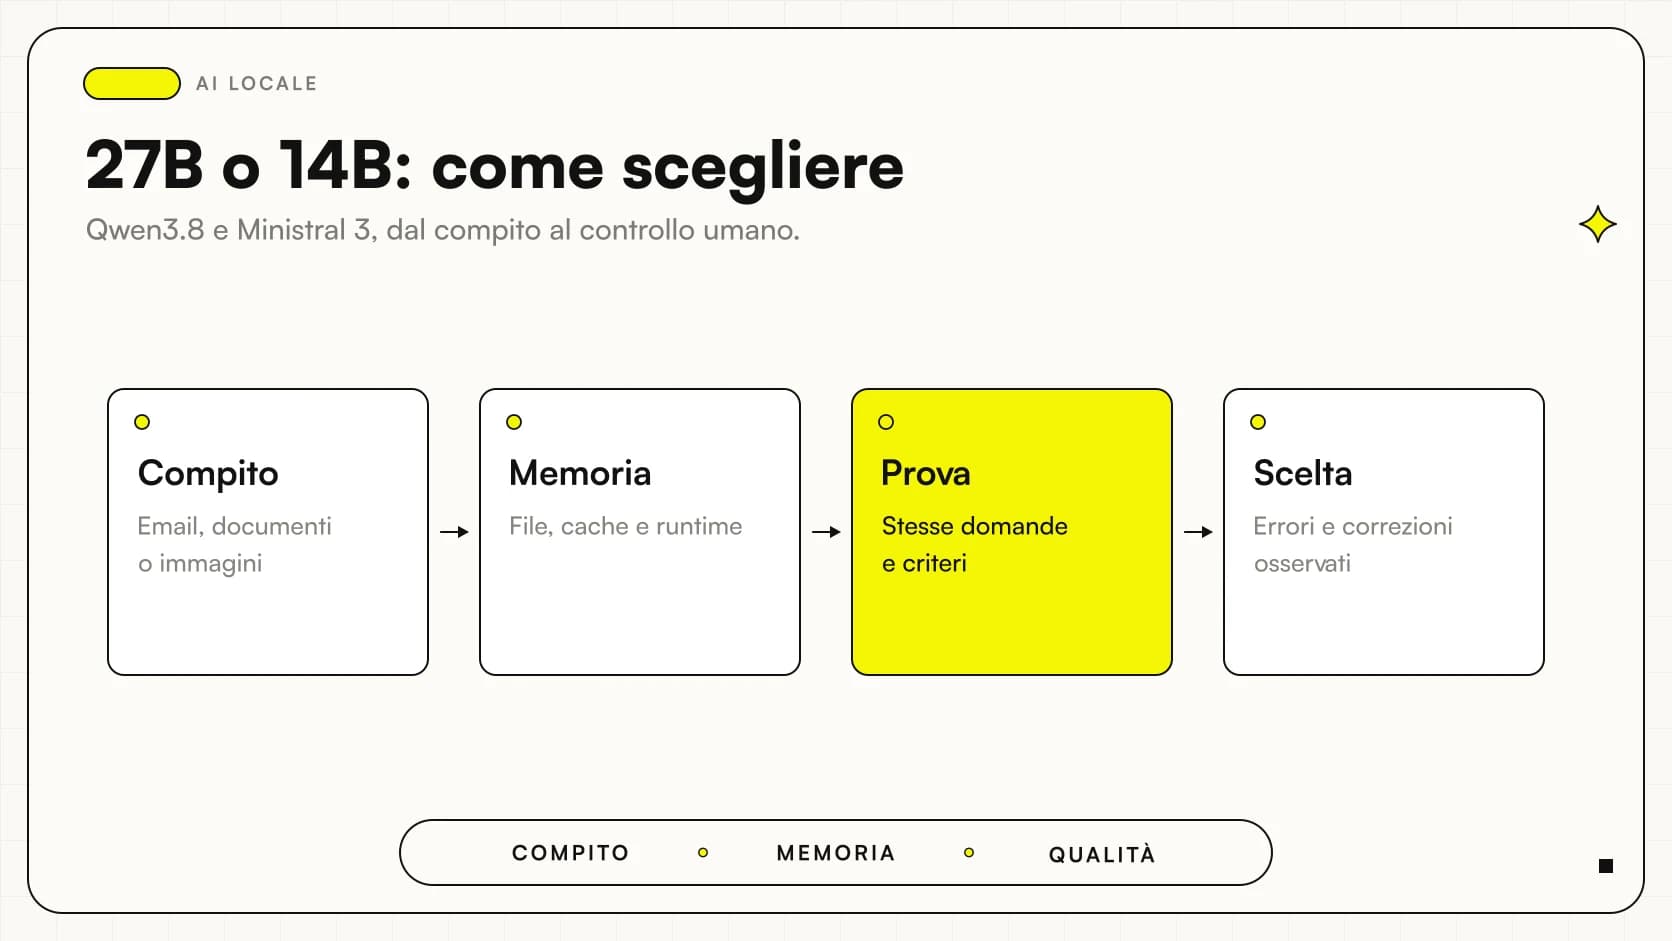 Qwen3.8-27B vs Ministral 3 14B: quale portare in locale
 Qwen3.8-27B in locale: capacità, limiti e requisiti
 Installare Qwen3.8-27B in locale: controlli e procedura
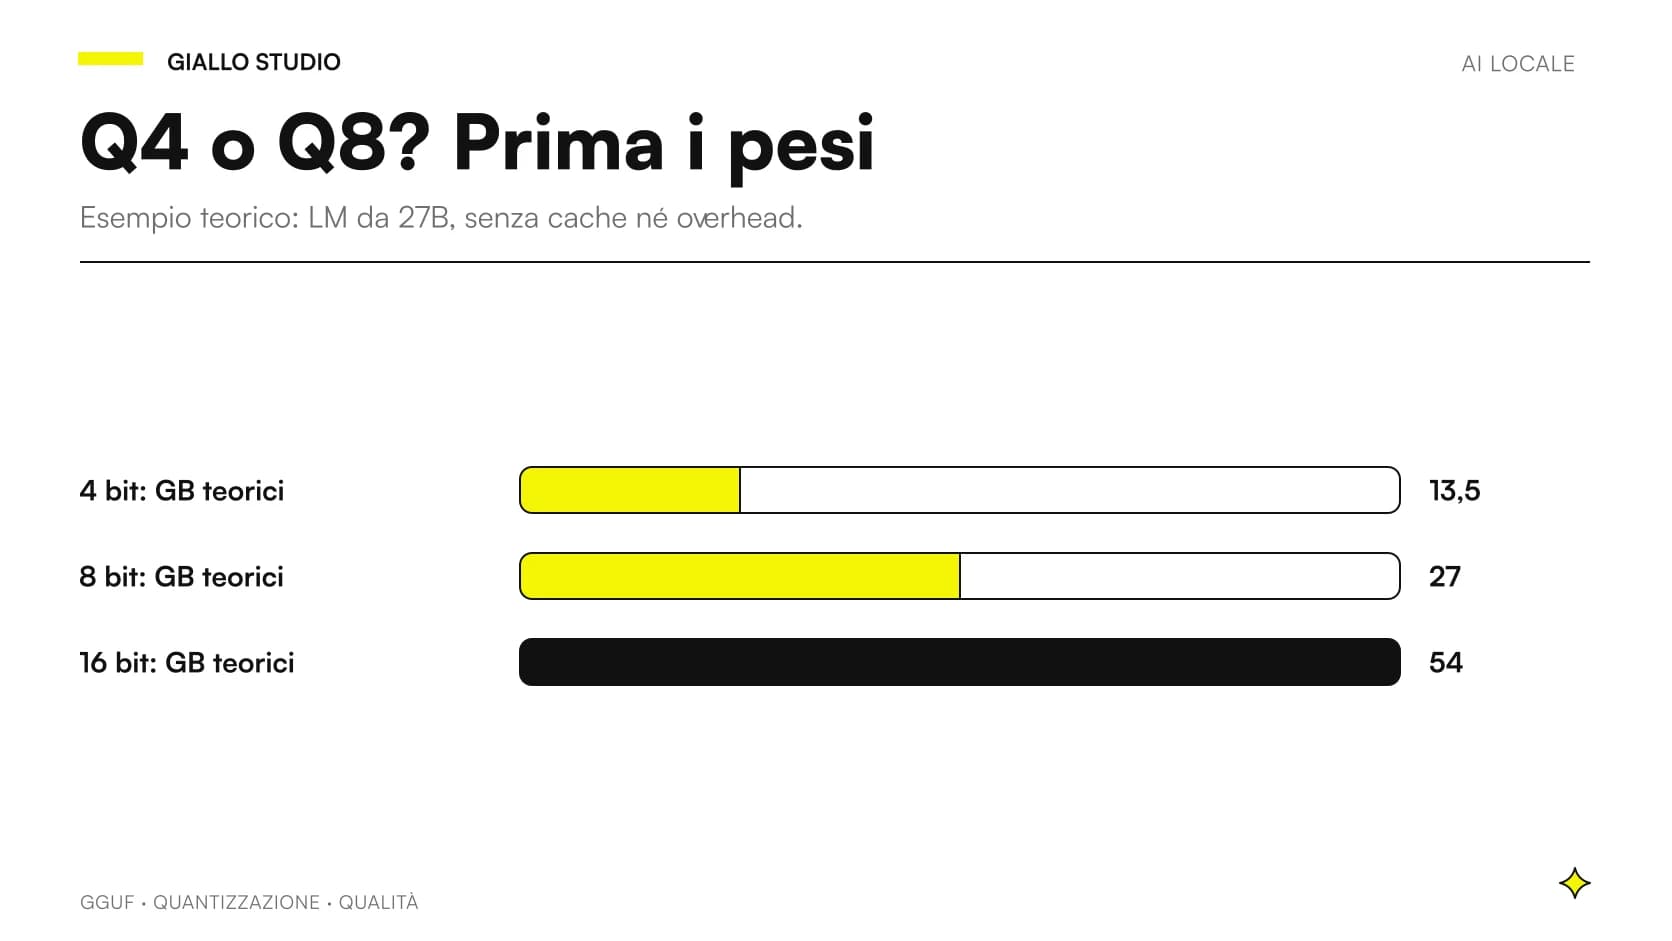 Quantizzazione GGUF: Q4 o Q8 per gli LLM locali?
 LLM locale su Mac: scegliere con 16, 24 o 32 GB
 LLM locale su Windows: GPU, VRAM e limiti pratici
FAQ
Qwen3.8-27B richiede soltanto 13,5 GB a quattro bit?
13,5 GB decimali è il calcolo teorico sui soli 27 miliardi di parametri linguistici a quattro bit esatti. Mancano metadati, componenti aggiuntivi, cache, buffer e sistema operativo: non è un requisito sufficiente.
Un Mac con 16 GB può eseguirlo bene?
Non si può garantirlo dalla memoria nominale. Occorre verificare il file preciso, la memoria disponibile e il carico; una stima dei soli pesi non dimostra che il sistema abbia spazio per il lavoro.
RAM e VRAM si possono sommare automaticamente?
No. Con GPU dedicata sono risorse differenti; un runtime può distribuirvi parte del lavoro tramite offload, con conseguenze da misurare. La memoria unificata segue un'organizzazione diversa e resta condivisa con il sistema.
Il contesto massimo indica la RAM necessaria?
No. Il contesto supportato dal modello e quello sostenibile dall'hardware sono limiti differenti. Cache, tipo di attenzione, precisione, richieste simultanee e runtime influenzano l'occupazione.
Dove trovare il dato di memoria più utile?
Nel test della configurazione reale: file, versione del runtime, contesto, input e concorrenza devono essere registrati insieme ai log e ai picchi osservati. Le misure di altri ambienti vanno trattate come riferimenti circoscritti.