
Claude Fable 5.2 limiti: quelli noti e come aggirarli
Claude Fable 5.2 limiti dichiarati da Anthropic: pensa anche se gli dici di no, si ferma prima, subagent costosi. Per ognuno, cosa fare in pratica.
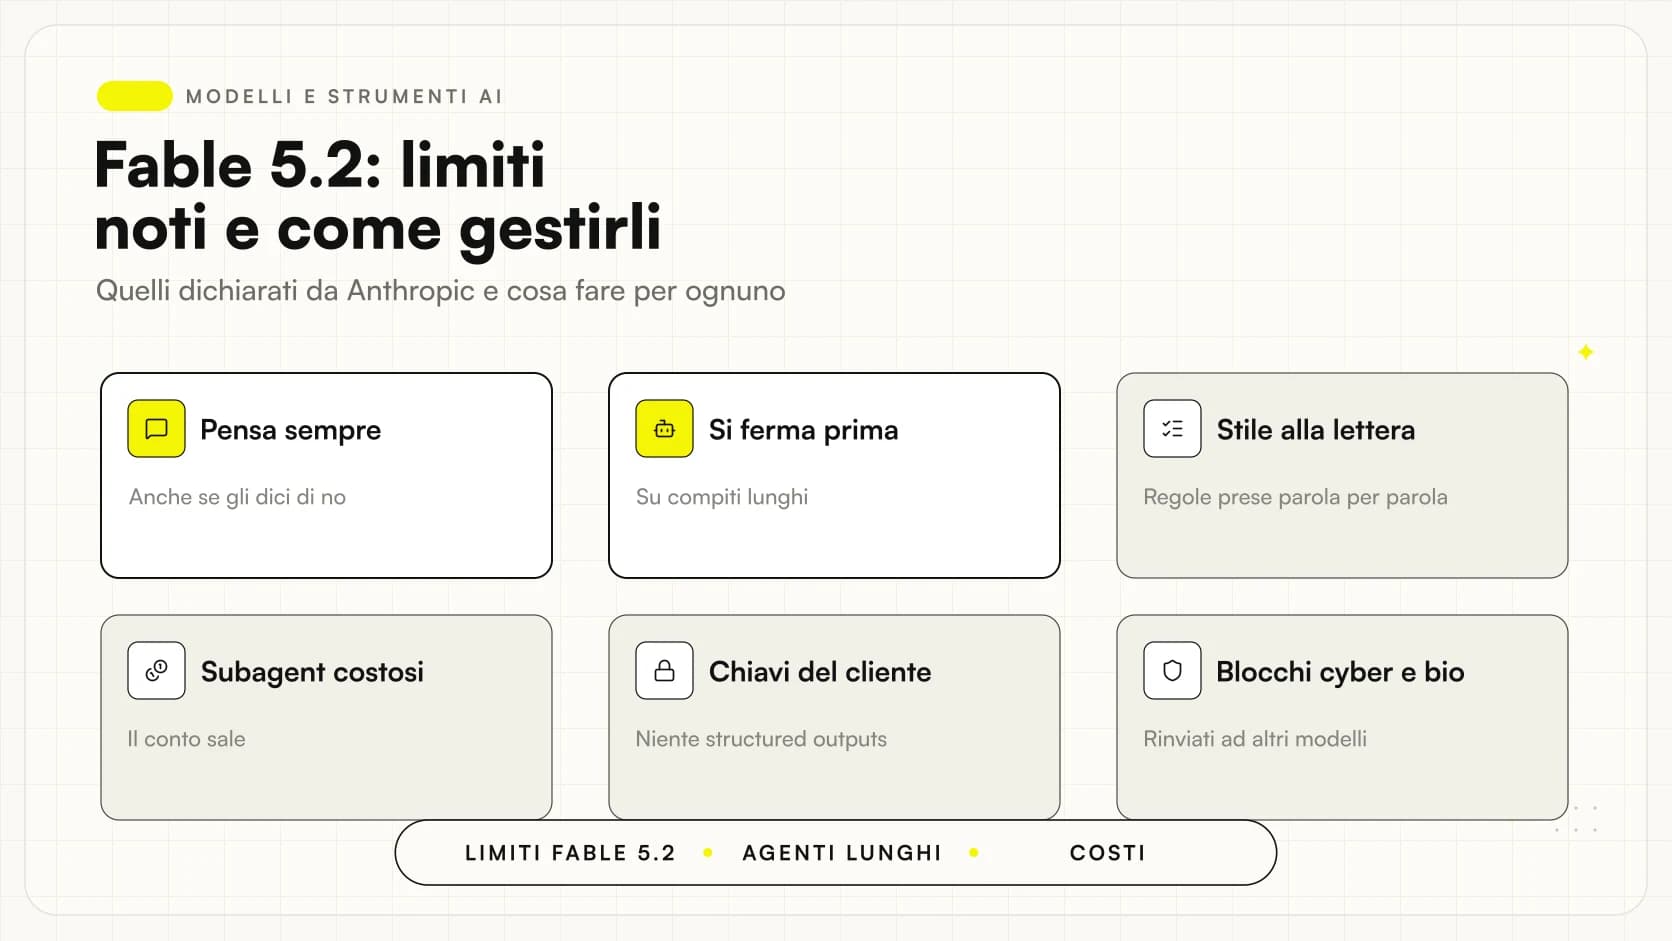
I limiti noti di Claude Fable 5.2, il modello rilasciato da Anthropic il 9 novembre 2026, sono pochi e ben descritti: pensa anche quando gli si chiede di non farlo, può chiudere un lavoro lungo prima della fine, esegue le regole di stile alla lettera, può far salire i costi con i subagent e non supporta gli structured outputs con chiavi di cifratura gestite dal cliente. Sono i punti che la pagina «What's new» della documentazione indica, consultata il 9 novembre 2026. Quasi tutti si aggirano con una scelta di effort o con tre righe di prompt.
Qui trovate i limiti uno per uno: cosa succede, perché, cosa fare. Per la scheda tecnica del modello c'è il pillar su Claude Fable 5.2. Non riportiamo opinioni da forum o da Reddit: nel giorno del rilascio non sono verificabili. Restano fuori anche i test indipendenti, che al momento non risultano disponibili.
In sintesi
- Fable 5.2 pensa prima di quasi ogni risposta a effort high e superiori, e secondo Anthropic una riga di prompt che chiede di non ragionare non lo ferma a effort medium e oltre.
- Il ragionamento non si spegne: la richiesta con thinking disabilitato restituisce un errore 400, e anche tool_choice forzato (
anyotool) restituisce 400. - Sui compiti lunghi può chiudere il turno con un elenco di cose rimaste o un'offerta di continuare: più spesso a effort low e medium.
- Rispetta le regole di stile alla lettera: un limite rigido sulla lunghezza delle frasi può rendere la prosa spezzata.
- I subagent possono pesare molto sul costo di una sessione, e con chiavi di cifratura gestite dal cliente gli structured outputs non sono disponibili.
- I classificatori su cybersecurity e biologia girano le richieste a Opus 4.8 e Opus 5; Anthropic dichiara circa il 55% di blocchi in meno rispetto a Fable 5.1.
I benchmark citati da Anthropic sono dichiarati dal produttore e non replicati da terzi. Qui contano meno: parliamo di comportamenti, non di punteggi.
Fable 5.2 pensa anche se gli dico di non farlo: perché e cosa fare?
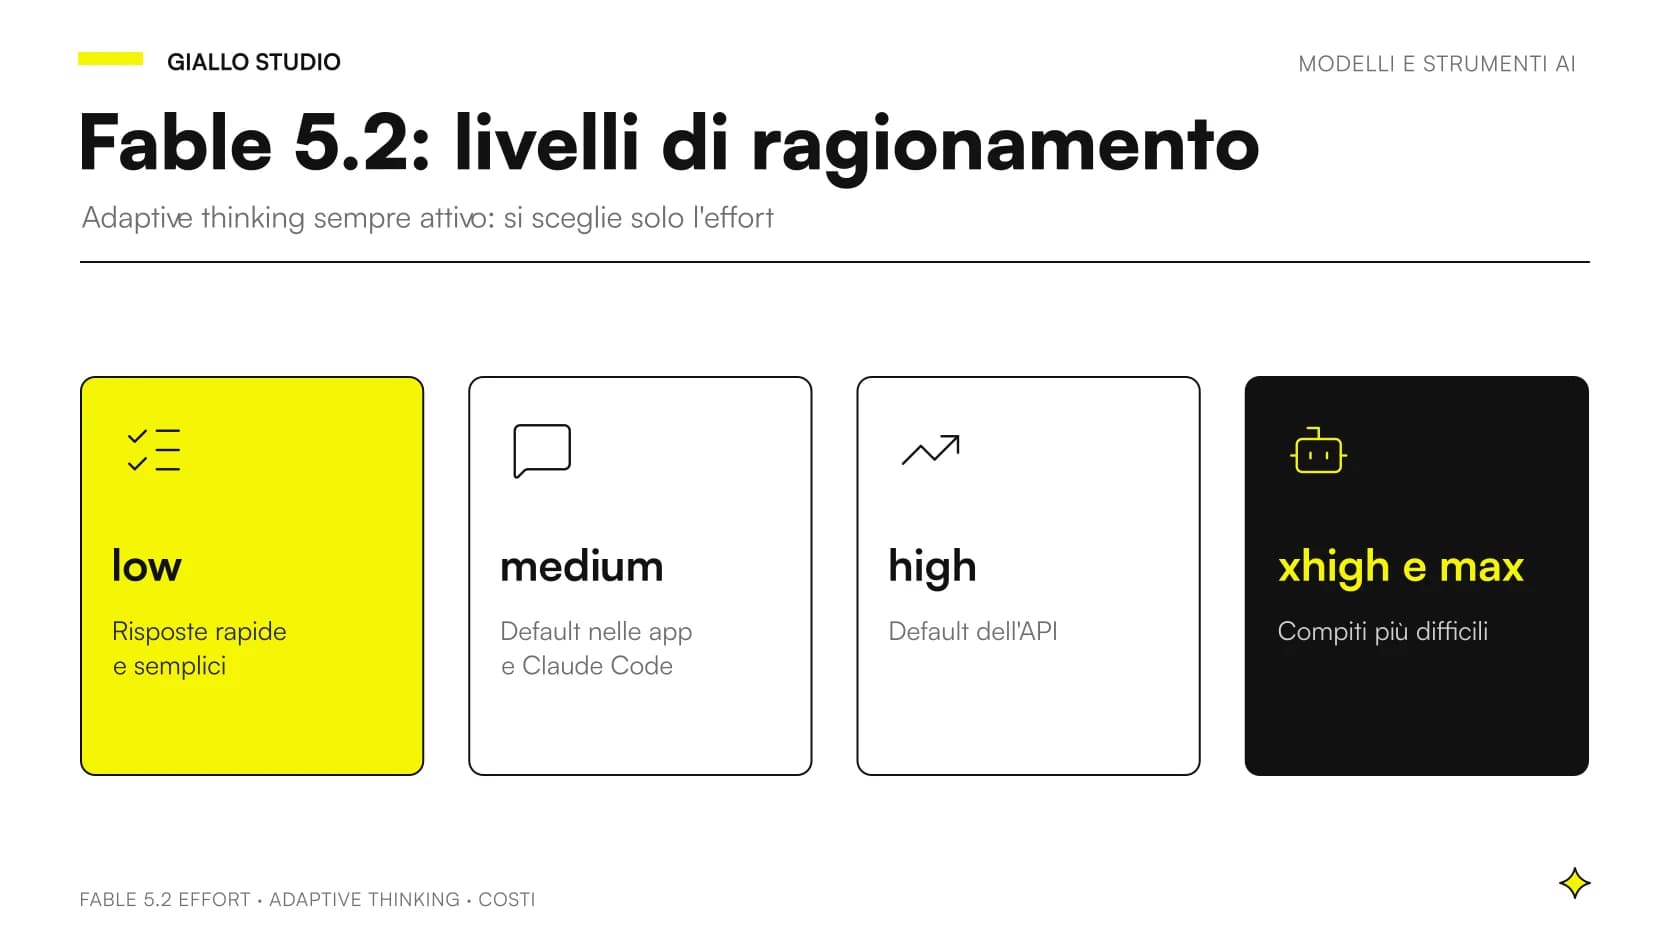
Con Fable 5.1 una riga come «rispondi direttamente, senza deliberare» di solito funzionava. Con Fable 5.2, nei test di Anthropic, a effort medium e superiori non basta: a high e oltre il modello ragiona prima di quasi ogni risposta. Il pensiero adattivo è sempre attivo e non si disattiva. Una richiesta con thinking: {"type": "disabled"} restituisce un errore 400, e lo stesso vale per budget_tokens.
Cosa fare. Non lottate con il prompt: scegliete un effort più basso per i turni facili. Il valore predefinito dell'API è high; per riassunti brevi, classificazioni ed estrazioni di campi ha più senso low. La guida completa ai livelli è nell'articolo sugli effort di Fable 5.2; per il modello precedente c'è quella sui livelli di ragionamento di Opus 5.5.
Un esempio, dichiarato come tale. La redazione di un giornale locale usa il modello per due lavori: titolare e classificare i comunicati stampa in arrivo, e preparare ogni settimana un'inchiesta sui bilanci del Comune. I comunicati richiedono risposte rapide e poco ragionamento: low. L'inchiesta richiede più passaggi e verifiche: high, o xhigh se un test sui propri casi mostra un vantaggio. Un solo livello per tutto significa pagare troppo per i comunicati o ottenere poco per l'inchiesta.
Perché Fable 5.2 si ferma prima di aver finito?
Anthropic descrive il comportamento così: sui compiti lunghi e a più passaggi, il modello a volte conclude il turno con un elenco di ciò che manca, con l'offerta di continuare o con uno stop davanti a un ostacolo ordinario. Succede più spesso a effort low e medium. Non è un errore dell'API: la risposta è regolare, solo incompleta rispetto a ciò che vi aspettavate.
Cosa fare, in ordine di costo:
- Alzate l'effort per quel compito, ad esempio da medium a high. È la leva più semplice.
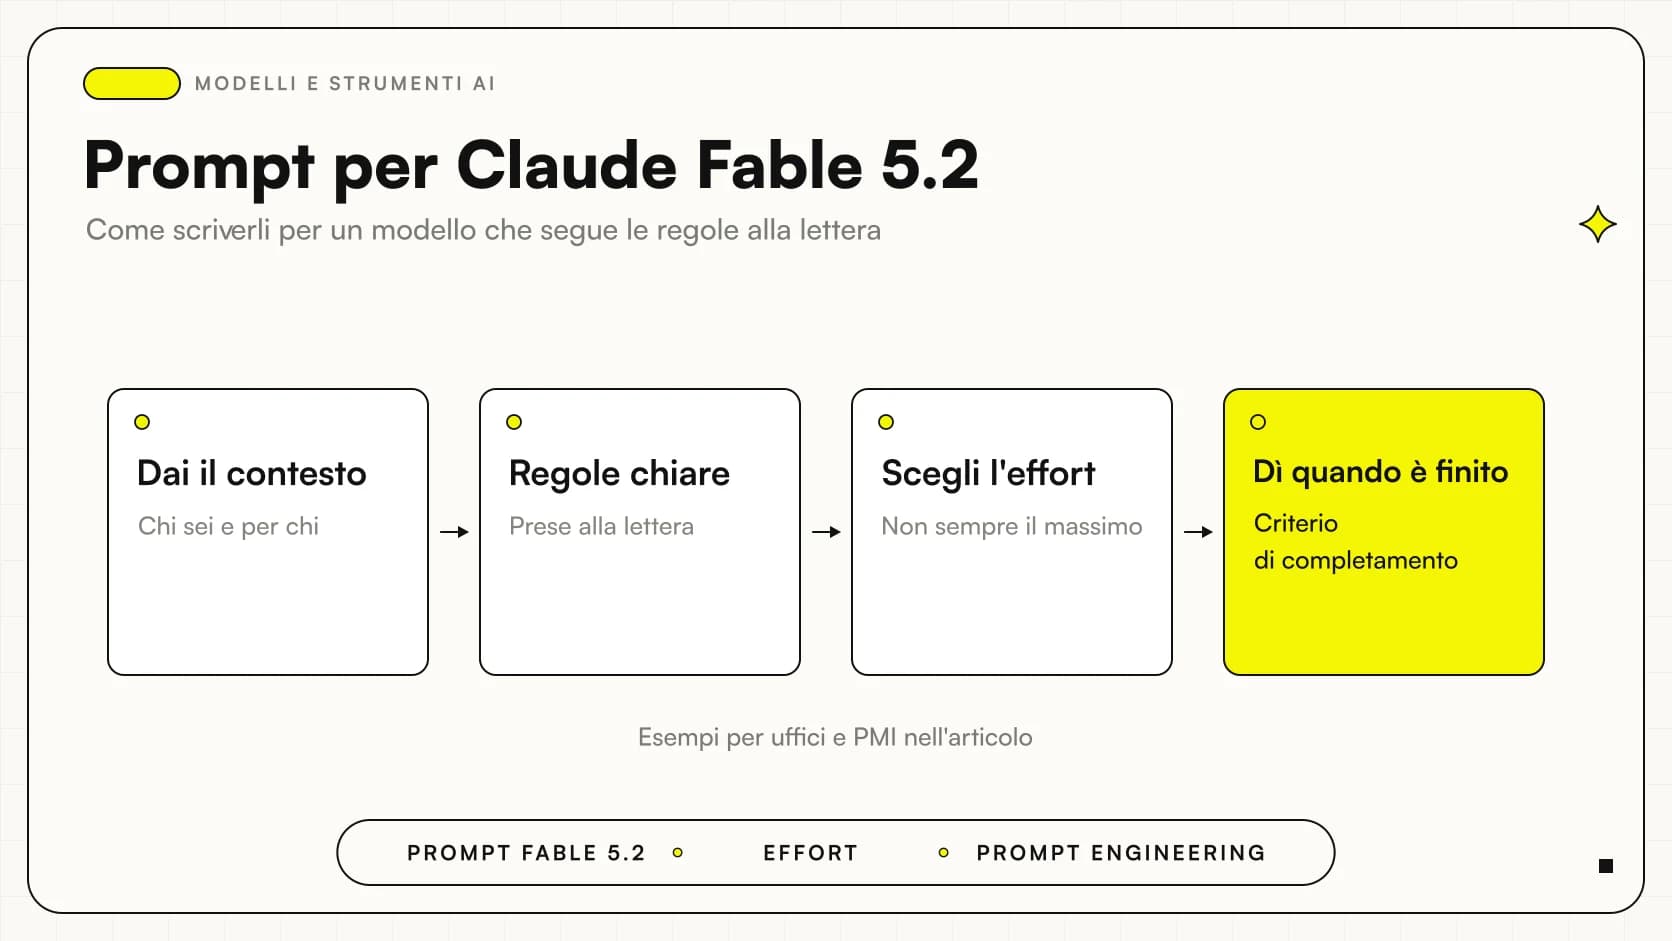
- Scrivete nel prompt il criterio di fine lavoro: «il compito è finito quando tutti i 40 file sono elaborati e il report è salvato; se trovi un ostacolo, risolvilo o scegli un'alternativa e annotala, senza fermarti a chiedere».
- Per i lavori lunghi, fate verificare la fine da fuori: uno script che controlla se il file esiste o se la lista è vuota, e rilancia il modello se manca qualcosa.
Il secondo e il terzo punto sono la nostra pratica, non una regola scritta da Anthropic nella pagina citata. La documentazione rimanda a una sezione dedicata della guida di prompting. Per scrivere istruzioni migliori c'è l'articolo con i prompt per Claude Fable 5.2; per le basi, la guida ai prompt per Claude.
Perché ignora una regola di stile o la applica troppo?
Fable 5.2 segue le regole di stile da vicino. Il lato positivo è che le regole del vostro tono di voce vengono rispettate. Il lato negativo, scrive Anthropic, è che un limite rigido sulla lunghezza delle frasi può rendere la prosa spezzata. Se nelle istruzioni di un modello precedente avevate scritto «frasi di massimo 15 parole» per compensare uno stile prolisso, ora il testo può uscire a scatti.
Cosa fare. Rivedete le istruzioni scritte per modelli precedenti. Sostituite i limiti numerici con l'intento («frasi brevi e dirette, con qualche variazione di ritmo») e provate su tre testi veri. Una regola che avete dimenticato in un prompt di sistema ora pesa di più.
Lo stesso vale per il codice. Nei test di Anthropic su piccoli compiti, se il prompt non diceva a chi appartiene il codice, il modello tendeva ad aggiungere alla struttura esistente e a segnalare i problemi vicini invece di correggerli. Se volete che li corregga, scrivetelo: «questo repository è tuo, correggi anche i difetti che trovi lungo la strada».
I subagent fanno salire i costi: come tenerli sotto controllo?
Quanto Fable 5.2 delega ai subagent dipende dal vostro ambiente e dai compiti. In un prodotto di coding i cui prompt invitano a delegare, delega volentieri, e i subagent possono costituire una parte rilevante del costo di una sessione. Il listino è un'altra parte: 8 dollari per milione di token in input e 40 in output, per ogni agente che lavora.
Cosa fare. Fissate voi le regole: quando delegare (compiti davvero indipendenti), quanti subagent e con quale modello. Un modello più economico può svolgere i sotto-compiti ripetitivi. Misurate il costo di una sessione tipo prima di estenderla a tutto il team. Il confronto con il modello inferiore è nell'articolo su Fable 5.2 e Opus 5.5; per scegliere il modello giusto per gli agenti c'è la guida al miglior modello AI per gli agenti.
Il modello lavora in silenzio: come farsi aggiornare?
Nei lavori lunghi con molte chiamate a strumenti, Fable 5.2 può produrre poco testo per l'utente, e fare la prima chiamata senza dire cosa sta per fare. Per un agente che gira in background è irrilevante; per un collaboratore che guarda lo schermo è fastidioso.
Cosa fare. Chiedete un aggiornamento a intervalli: «prima di ogni fase scrivi una riga su cosa farai; a fine fase una riga sul risultato». Costa pochi token e rende il lavoro verificabile.
Quali richieste vengono bloccate e dove finiscono?
Fable 5.2 ha classificatori di sicurezza. Bloccano attività cyber ad alto rischio, tra cui penetration testing, exploit generation e analisi di vulnerabilità su binari, e la maggior parte dei compiti di ricerca in biologia. Secondo l'annuncio di Anthropic, la richiesta bloccata riceve invece una risposta da Opus 4.8 per la cybersecurity e da Opus 5 per la biologia. Anthropic dichiara circa il 55% di blocchi in meno rispetto a Fable 5.1, circa il 60% in meno sulla cybersecurity e circa il 40% in meno sulla biologia, in test iniziali.
Via API, un rifiuto arriva con HTTP 200 e stop_reason: "refusal", con un oggetto stop_details che indica l'area di policy. Per riprovare su un altro modello esistono il fallback lato server (beta), un middleware dell'SDK o un vostro nuovo tentativo. Se il rifiuto arriva prima di qualsiasi output, la fatturazione dipende dalla categoria, e in ogni caso conta nei limiti di velocità.
Cosa fare. Un'azienda che non fa sicurezza offensiva o ricerca biologica li incontrerà di rado. Chi lavora sul serio in quegli ambiti guardi Mythos 5.2 e la cybersecurity: è lo stesso modello senza quelle salvaguardie, con accesso tramite i programmi di verifica. Se vedete un messaggio segnalato nell'app, l'articolo su come leggere un messaggio segnalato spiega cosa è successo (scritto per Opus 5.5).
Quali vincoli tecnici fanno fallire le richieste?
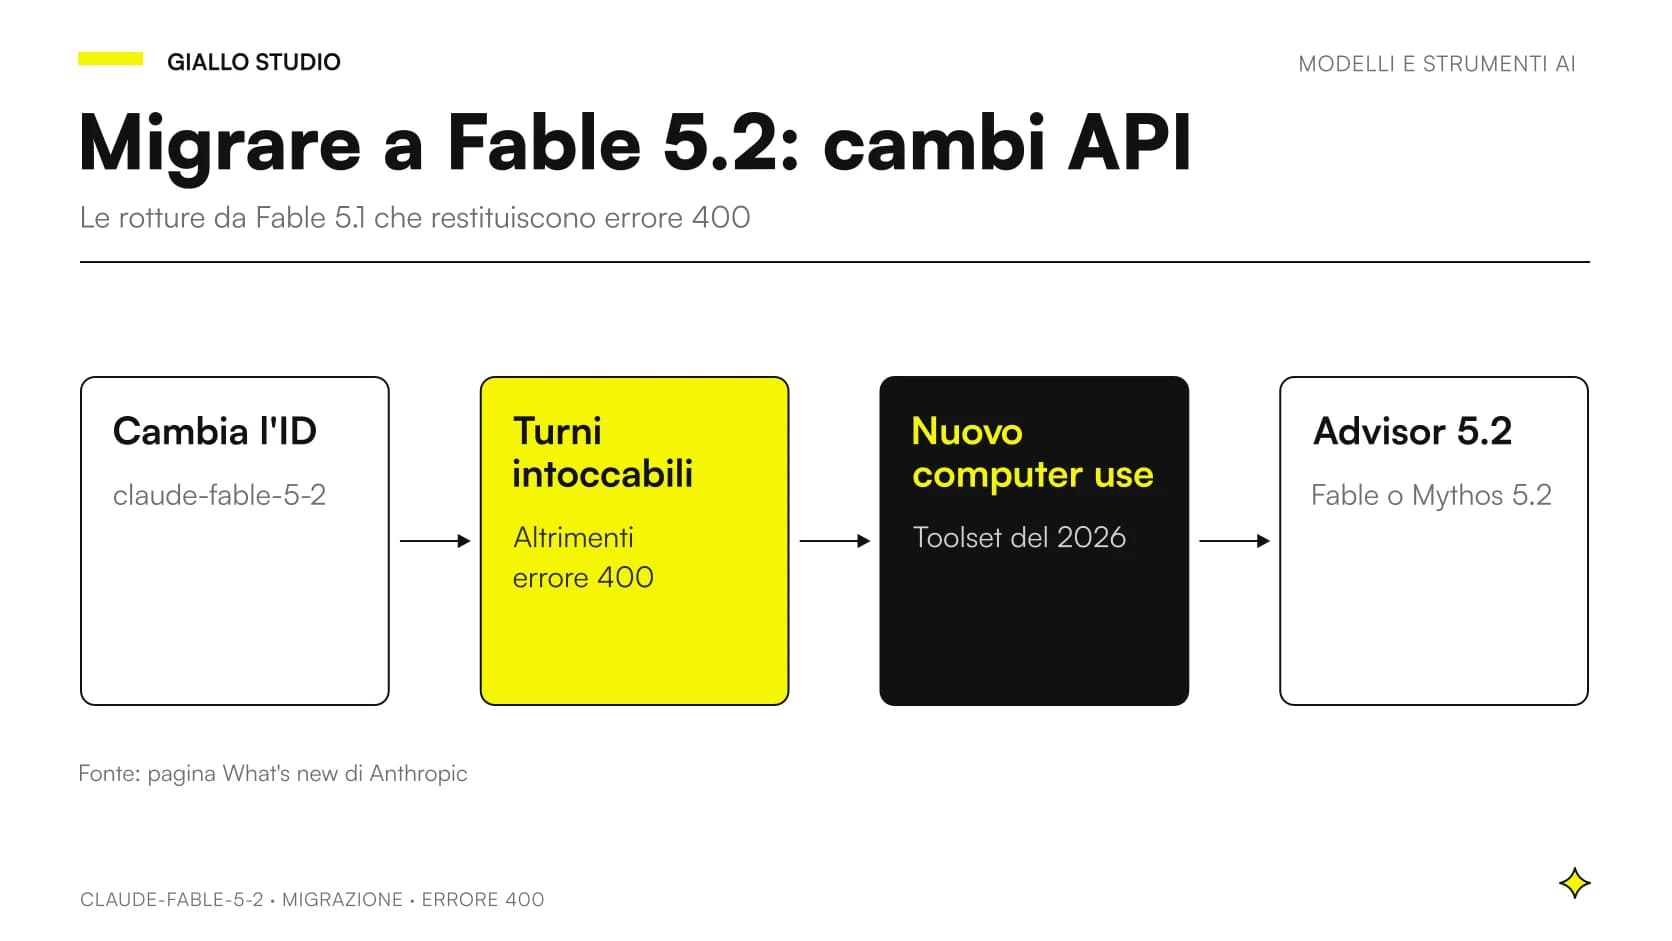
Alcuni limiti non sono di comportamento: sono regole dell'API che producono errori 400. Il tema è la migrazione, e lo sviluppo completo sta nella guida alla migrazione API. Qui la lista di ciò che incontrate più spesso, tutta tratta dalla pagina «What's new»:
| Limite | Cosa succede | Cosa fare |
|---|---|---|
| Thinking disabilitato | Errore 400 | Omettere thinking e usare effort |
tool_choice forzato (any o tool) |
Errore 400 | Usare auto con strict: true, oppure i JSON outputs |
| Modifica di turni precedenti | Errore 400 sul controllo del prefisso | Solo aggiunte alla conversazione, nessuna modifica |
Strumento computer_20251124 |
Errore 400 (tranne su Amazon Bedrock) | Passare a computer_toolset_20260801 |
| Advisor diverso da Fable 5.2 o Mythos 5.2 | Errore 400 | Impostare il modello dell'advisor su claude-fable-5-2 |
| Chiavi di cifratura gestite dal cliente | Structured outputs non disponibili | Omettere strict e validare nel proprio codice |
Un ultimo effetto riguarda i cambi di modello. I blocchi di ragionamento di Fable 5.2 vengono letti solo da Fable 5.2 e Mythos 5.2: se un router sposta la conversazione su Opus 5.5 o su un altro modello, il ragionamento di quei turni si perde. La richiesta non fallisce e i blocchi scartati non sono fatturati, ma il modello successivo parte con meno contesto.
E i dati? La zero data retention non c'è
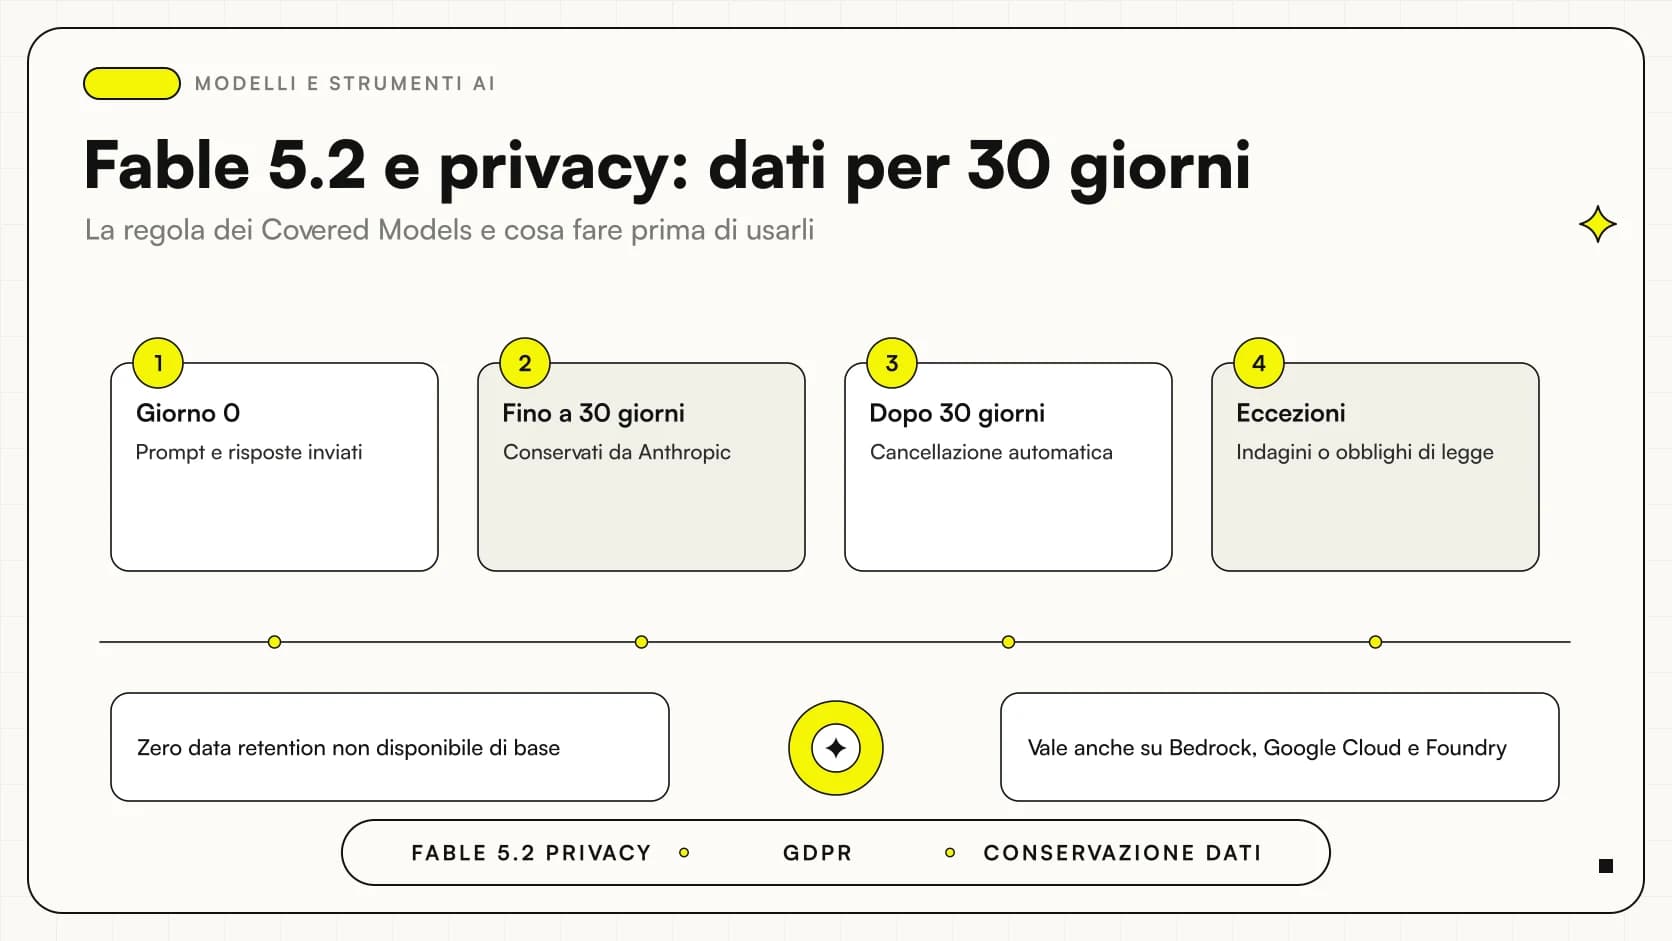
Un limite non tecnico, ma decisivo per molte PMI. Fable 5.2 e Mythos 5.2 sono Covered Models: richiedono almeno 30 giorni di conservazione dei dati e non sono disponibili in zero data retention, salvo autorizzazione espressa di Anthropic. Vale anche per i clienti Enterprise e per le piattaforme di terzi. Chi è già in zero data retention può continuare con i modelli precedenti.
Se trattate dati personali di clienti, pazienti o dipendenti, serve una valutazione prima del primo test, non dopo. Le regioni di elaborazione per l'Unione europea non risultano indicate nelle pagine ufficiali consultate il 9 novembre 2026. Il dettaglio sta nell'articolo su privacy e conservazione dei dati.
Quando i limiti contano e quando no
I limiti pesano poco se
- Il compito è lungo e difficile e potete lasciare effort high o superiore.
- Il modello lavora dentro un processo con un controllo finale, non da solo.
- I vostri dati non sono soggetti a vincoli di zero retention.
I limiti pesano molto se
- Fate migliaia di richieste semplici al giorno e pagate il ragionamento su ognuna.
- Avete codice che modifica la cronologia o forza tool_choice.
- Siete in zero data retention per contratto o per policy interna.
Errori da evitare con Fable 5.2
- Usarlo per tutto. Anthropic stessa consiglia di partire dall'ultimo Opus e di passare a Fable quando le prove a effort più alto non bastano. Un classificatore di email non ha bisogno di Fable.
- Correggere il pensiero con il prompt. Se le richieste semplici costano troppo, abbassate l'effort: la riga «non ragionare» non è la leva giusta.
- Lasciare un lavoro lungo senza controllo finale. Il turno che termina presto sembra una risposta normale. Verificate la fine con un controllo automatico.
- Portare i vecchi prompt senza rileggerli. Regole di stile rigide e istruzioni pensate per modelli meno obbedienti possono dare risultati strani.
- Dimenticare i dati. Mandare dati sensibili senza aver verificato la conservazione di almeno 30 giorni è l'errore che costa di più, perché non si rimedia dopo.
Come provarlo senza sorprese
Prendete 15-20 casi reali del vostro lavoro e fateli girare su Opus 5.5 e su Fable 5.2, con effort diversi. Annotate qualità, costo e quante volte il modello si ferma prima del tempo. Le differenze di costo e capacità tra i due modelli si capiscono solo così. Dopo la prova avrete una scelta fatta sui vostri numeri, non su quelli di un benchmark del produttore.
Se volete un aiuto per disegnare quel test, o per costruire un agente che usa il modello giusto per ogni compito con un controllo di fine lavoro, Giallo Studio progetta agenti AI per PMI a partire dai vostri processi reali. Per una valutazione preliminare dei costi e dei vincoli sui dati c'è la consulenza AI.
Metodo e fonti delle guide di Giallo Studio
Vuoi applicarlo alla tua azienda?In 30 minuti, gratis: il processo da automatizzare per primo e il ritorno stimato, per iscritto.
Prenota l’audit gratuitoCome lo applichiamo in azienda
Risorse correlate
 Claude computer use con Fable 5.2: usare il PC da solo
 Claude Fable 5.2 aziende: quando conviene alle PMI
 Claude Fable 5.2: cos'è, cosa cambia, quanto costa e a chi serve
 Fable 5.2 effort: i livelli di ragionamento e come sceglierli
 Fable 5.2 migration: cosa cambia nell'API e perché compaiono gli errori 400
 Prompt Claude Fable 5.2: come scriverli e 5 esempi pronti
 Fable 5.2 privacy: dati conservati 30 giorni e cosa fare in una PMI
 Claude Mythos cybersecurity: chi può usarlo e cosa fa davvero
 Fable 5.2 vs Opus 5.5: quale usare e quando
 Claude è passato a un modello precedente: perché succede e cosa fare
FAQ
Quali sono i limiti noti di Claude Fable 5.2?
Secondo la pagina «What's new» di Anthropic consultata il 9 novembre 2026, i principali sono cinque. Il modello pensa anche quando il prompt gli chiede di non farlo, può chiudere un turno prima che il lavoro sia finito, segue alla lettera le regole di stile, può delegare molto ai subagent facendo salire i costi e non offre structured outputs con chiavi di cifratura gestite dal cliente. A questi si aggiungono i blocchi dei classificatori su cybersecurity e biologia.
Perché Fable 5.2 si ferma prima di aver finito?
Anthropic descrive il comportamento così: sui compiti lunghi e a più passaggi, il modello a volte chiude il turno con un elenco di ciò che resta, con l'offerta di continuare o fermandosi davanti a un ostacolo ordinario. Succede più spesso a effort low e medium. Le contromisure sono alzare l'effort e scrivere nel prompt il criterio di completamento.
Posso disattivare il ragionamento di Fable 5.2?
No. Il pensiero adattivo è sempre attivo e una richiesta con thinking disabilitato restituisce un errore 400. Si controlla la profondità con il parametro effort: per le richieste semplici si usa un livello più basso. Anthropic precisa che una riga del prompt come «rispondi senza ragionare» non basta a effort medium o superiore.
Perché Fable 5.2 rifiuta alcune richieste di sicurezza informatica o biologia?
Perché Fable 5.2 ha classificatori che bloccano attività cyber ad alto rischio, come penetration testing ed exploit generation, e la maggior parte dei compiti di ricerca in biologia. La richiesta bloccata viene girata a Opus 4.8 per la cybersecurity e a Opus 5 per la biologia. Anthropic dichiara circa il 55% di blocchi in meno rispetto a Fable 5.1; chi lavora davvero in quegli ambiti può chiedere Mythos 5.2 tramite i programmi di verifica.
Fable 5.2 si può usare con zero data retention?
No, salvo autorizzazione espressa di Anthropic. Fable 5.2 è un Covered Model e richiede una conservazione di almeno 30 giorni, anche per i clienti Enterprise e sulle piattaforme di terzi. I clienti che oggi sono in zero data retention possono continuare a usare i modelli precedenti.
Quali sono i problemi di Fable 5.2 su Reddit e nei forum?
In questo articolo non riportiamo opinioni da forum non verificabili. Ci basiamo sui limiti che Anthropic dichiara nella documentazione ufficiale, consultata il 9 novembre 2026, nel giorno stesso del rilascio. Recensioni indipendenti e test di terzi non risultano ancora disponibili: conviene provare il modello sui propri casi.