
Gemini 4 Argon: prezzi API e calcolo dei costi aziendali
Prezzi di Gemini 4 Argon, promozione fino al 30 novembre 2026, thinking, cache e strumenti. Esempi di calcolo per stimare un budget aziendale.
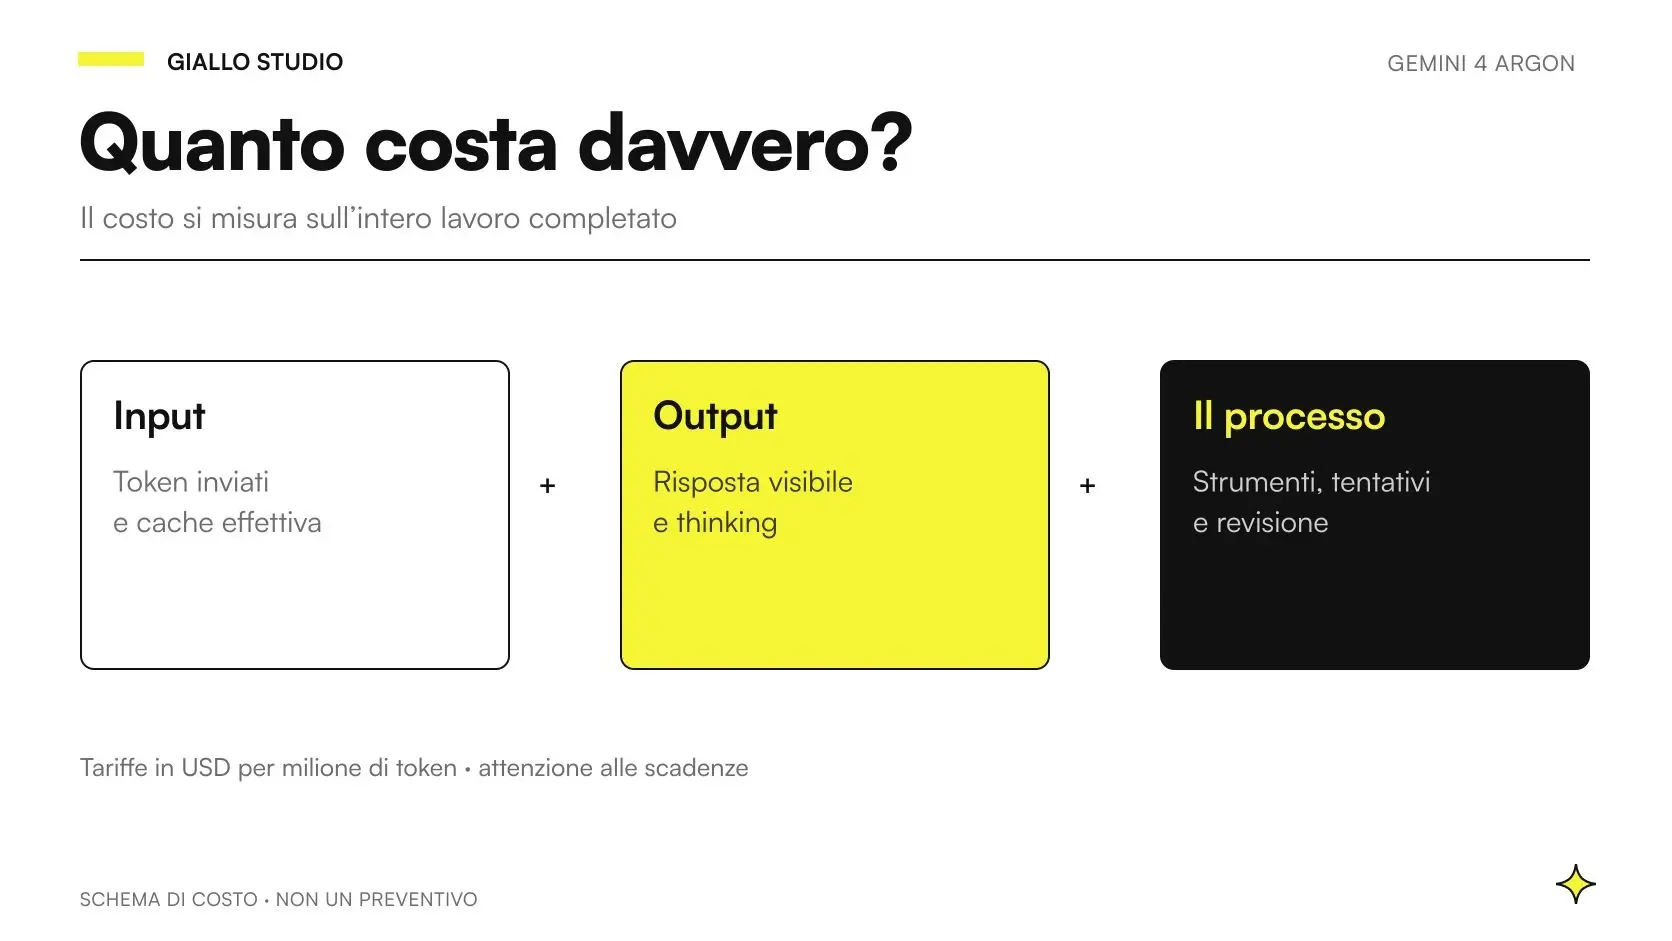
I prezzi di Gemini 4 Argon via Gemini Developer API partono, al 23 ottobre 2026, da 2 dollari per milione di token in input e 10 dollari per milione di token in output nella modalità Standard. Sono tariffe promozionali fino al 30 novembre 2026: dal 1 dicembre il listino documentato passa rispettivamente a 4 e 20 dollari. L’output fatturato comprende il thinking. La fonte è il listino ufficiale Gemini API, verificato il 23 ottobre 2026.
Per un’azienda il preventivo non finisce qui. Contano la lunghezza delle richieste, quanto ragionamento viene prodotto, l’uso degli strumenti e quante prove servono prima che il risultato sia utilizzabile. Questa guida separa le tariffe documentate dagli esempi di budget, che sono ipotesi di calcolo e non consumi misurati da Giallo.
In sintesi
- Il listino API e il prezzo di un abbonamento alle app Google AI descrivono prodotti diversi.
- La promozione Argon scade il 30 novembre 2026: un budget continuativo deve includere anche il prezzo successivo.
- Input, input in cache e output hanno tariffe differenti; il thinking fa parte dell’output fatturato.
- Una stima utile include strumenti, tentativi ripetuti e costo della revisione dei risultati.
- Il numero da controllare nel processo è il costo per risultato accettato, insieme alla qualità.
Quale prezzo di Argon stiamo confrontando: app, API o piattaforma Cloud?
Gemini è un nome usato per una famiglia di modelli e per prodotti con cui le persone interagiscono. Gemini 4 Argon identifica il modello; la Gemini Developer API è un canale per integrarlo nel software. L’app Gemini e una piattaforma Cloud aggiungono condizioni, funzioni e modalità di fatturazione proprie. La guida generale ad Argon chiarisce questi livelli.
La tabella di questa pagina riguarda esclusivamente la Gemini Developer API. Non va applicata automaticamente al conto di un altro servizio, a un piano Google One o a una piattaforma aziendale. Quando si confrontano due offerte bisogna annotare il nome del canale e la valuta, non soltanto il nome del modello.
Per l’app l’annuncio Google presenta l’accesso attraverso piani Pro e Ultra; requisiti e funzioni vanno verificati nelle pagine di supporto aggiornate. Questo non equivale a un monte token dell’API da spendere in un gestionale. Fonti: annuncio dell’accesso ad Argon nell’app Gemini e supporto Google AI Pro, controllati il 23 ottobre 2026. Non riportiamo un prezzo consumer in euro perché il prezzo localizzato va verificato sull’offerta pertinente.
Quali sono le tariffe API documentate al 23 ottobre 2026?
Tutte le cifre della tabella sono dollari statunitensi per un milione di token. Il costo effettivo dipende dai token conteggiati dal servizio. Input e output sono voci separate; la riga della cache riguarda la parte di input riconosciuta come input in cache.
| Modalità e voce | Fino al 30 novembre 2026 | Dal 1 dicembre 2026 | Che cosa misurare |
|---|---|---|---|
| Standard, input ordinario | 2 USD | 4 USD | Token di input non fatturati come cache |
| Standard, input in cache | 0,10 USD | 0,20 USD | Token per cui il servizio registra il riuso in cache |
| Standard, output | 10 USD | 20 USD | Output fatturato, thinking compreso |
| Batch, input | 1 USD | 2 USD | Token delle richieste eseguite nella modalità Batch |
| Batch, output | 5 USD | 10 USD | Output fatturato delle richieste Batch |
| Flex, input | 1 USD | 2 USD | Token delle richieste eseguite nella modalità Flex |
| Flex, output | 5 USD | 10 USD | Output fatturato delle richieste Flex |
| Priority, input | 3,60 USD | 7,20 USD | Token delle richieste eseguite nella modalità Priority |
| Priority, output | 18 USD | 36 USD | Output fatturato delle richieste Priority |
Fonte di tutte le tariffe: Gemini Developer API pricing, verifica del 23 ottobre 2026. La tabella non attribuisce una tariffa cache a modalità per cui non è stata qui verificata. Prima di cambiare modalità vanno controllate anche le condizioni operative: un prezzo diverso non rende intercambiabili i percorsi di esecuzione.
La scadenza promozionale deve comparire nel budget. Un progetto valutato soltanto sul prezzo di ottobre rischia di avere una previsione sbagliata per dicembre anche a parità di utilizzo. Non è una variazione ipotizzata: sono le due fasce temporali pubblicate nel listino consultato.
Come si calcola il consumo partendo dai token?
La formula di base è: token di input divisi per un milione, moltiplicati per la tariffa input, più token di output divisi per un milione, moltiplicati per la tariffa output. Se una parte dell’input viene riconosciuta in cache, quella parte usa la tariffa cache. Gli eventuali strumenti si aggiungono secondo le rispettive condizioni.
Un token non coincide sempre con una parola. Allegati, istruzioni, cronologia e contenuti multimodali influiscono sulla quantità elaborata secondo le regole del servizio. Per una spiegazione accessibile c’è la guida ai token nell’AI; per un preventivo operativo serve poi il conteggio del flusso effettivo.
L’unità di misura più comoda è spesso la singola attività: una scheda prodotto, una sintesi di pratica o una richiesta di assistenza. Si osserva quanti passaggi richiede l’attività e si sommano i consumi. Una conversazione che chiama il modello più volte non va stimata come un’unica richiesta solo perché la persona vede un solo risultato finale.
Esempio di budget: preparare schede per un catalogo tecnico
Immaginiamo un distributore che prepari seimila schede al mese. Per il calcolo ipotizziamo seimila token in input e milleduecento token di output fatturato per scheda, thinking incluso. Sono quantità inventate per mostrare il metodo: non una previsione delle prestazioni di Argon né una conversione dal numero di parole.
L’input mensile sarebbe 36 milioni di token; l’output 7,2 milioni. In Standard, senza cache né altri costi, la promozione produce una stima di 72 dollari per l’input più 72 per l’output, cioè 144 dollari. Dal 1 dicembre la stessa quantità corrisponderebbe a 288 dollari. Il calcolo applica le tariffe del listino ufficiale, controllato il 23 ottobre 2026.
Il budget non dimostra che le schede siano corrette. Il responsabile deve verificare codici, caratteristiche e unità prima dell’uso. Se il sistema produce una seconda versione per le schede respinte, anche quel consumo entra nel conto. Se serve una ricerca esterna, la relativa voce va aggiunta separatamente.
L’esempio permette di fare una domanda concreta al fornitore: quanti token sono ipotesi e quanti derivano da una misura sul campione? È una domanda più utile di «quanto costa un testo?», perché testi della stessa lunghezza possono richiedere contesti e controlli diversi.
Il thinking cambia il costo anche se la risposta è breve?
Sì, perché per Argon il thinking rientra nell’output fatturato. La guida Google documenta livelli low, medium e high, con medium come impostazione predefinita. Queste informazioni provengono dalla guida alle novità di Argon, verificata il 23 ottobre 2026. La lunghezza del testo mostrato alla persona non è quindi sufficiente per ricostruire il conto.
Una stima corretta usa una quantità di output che comprenda già il thinking, oppure distingue le componenti e le somma una volta sola. Nell’esempio delle schede, i milleduecento token erano dichiarati come output fatturato complessivo: aggiungere un’altra quota generica per il ragionamento produrrebbe un doppio conteggio.
La scelta del livello va valutata sul compito. Una classificazione semplice e una verifica con fonti contraddittorie non richiedono per forza la stessa configurazione. Non si può però promettere che ridurre il thinking mantenga invariata la qualità: serve una prova su esempi rappresentativi. Il protocollo di migrazione e valutazione di Argon propone come confrontare costo e risultato insieme.
Quando la cache riduce davvero la spesa?
Argon supporta la cache implicita e non la cache esplicita. La soglia documentata per il prompt è di almeno 4.096 token. Il fatto di superare la soglia non autorizza a stimare che ogni token ripetuto verrà necessariamente riconosciuto in cache: il budget deve usare i riusi osservati o presentarli come ipotesi. Fonte: guida Google ad Argon, verifica del 23 ottobre 2026.
Riprendiamo l’esempio ipotetico delle seimila schede, ciascuna con un input di seimila token. Supponiamo che il servizio contabilizzi dodici dei 36 milioni mensili come input in cache e i restanti ventiquattro come input ordinario. In Standard promozionale il conto diventa 48 dollari di input ordinario, 1,20 di input in cache e 72 di output: 121,20 dollari. Dal 1 dicembre, con le stesse quantità, diventa 242,40 dollari. Quantità e riuso sono ipotesi; tariffe dalla pagina prezzi ufficiale, controllata il 23 ottobre 2026.
Non bisogna aggiungere input inutile per inseguire lo sconto. Un contesto più lungo può essere superfluo, aumentare l’esposizione dei dati e complicare il controllo. Prima viene la scelta del materiale pertinente, poi l’ottimizzazione del consumo. Per le basi documentali il tema è approfondito nella guida ad Argon con RAG e documenti aziendali.
Quali strumenti possono aggiungere altre voci al conto?
Il listino documenta per il grounding con Google Search una quota di cinquemila richieste gratuite mensili condivise tra i modelli Gemini 3 e successivi; oltre la quota, la tariffa indicata è 14 dollari per mille richieste. È una voce relativa allo strumento, distinta dal consumo di token. Fonte: prezzi Gemini API, verificati il 23 ottobre 2026.
Per fare una stima non basta quindi moltiplicare la quantità di pratiche per il prezzo del modello. Occorre capire quando il flusso esegue una ricerca, quali richieste condividano la quota e come il consumo venga riportato. Non va attribuita una nuova quota gratuita a ogni automazione senza verificarne il perimetro.
Un agente può inoltre chiamare altri servizi, eseguire più passaggi o ripetere un’attività dopo un errore. Il numero di incarichi affidati dalla persona e il numero di chiamate tecniche possono divergere. La guida agli agenti AI con Gemini 4 Argon affronta questi passaggi dal punto di vista del processo.
Scenario ipotetico: stimare il budget di un ufficio assistenza
Un’impresa che vende attrezzature vuole preparare bozze per le richieste ricevute dal servizio clienti. Alcune richiedono soltanto la classificazione della domanda; altre il recupero del manuale; altre ancora una ricerca aggiornata. Un prezzo medio unico, scelto prima di distinguere questi percorsi, nasconderebbe la parte più variabile della spesa.
La scheda di budget può separare tre classi. Per ogni classe annota frequenza attesa, documenti necessari, numero di passaggi e modalità di revisione. Le richieste senza informazioni sufficienti devono terminare con una domanda di chiarimento, anziché continuare a generare tentativi per completare dati assenti.
Si misura poi un campione e si confronta la stima con il consumo registrato. Se i casi complessi richiedono molte ricerche, la correzione potrebbe riguardare l’archivio o il modo di selezionare i documenti. Non è detto che il rimedio sia acquistare un piano diverso. La scelta economica va letta insieme all’architettura dell’integrazione API.
Come evitare un budget che sembra preciso ma non lo è?
Il primo errore è applicare il prezzo promozionale a tutto l’anno senza annotarne la fine. Il secondo è confondere token di output visibile e output fatturato, perdendo il thinking. Il terzo è stimare un cache hit garantito per ogni richiesta ripetuta, anche quando non esistono dati osservati.
Il quarto è confrontare una tariffa API con un abbonamento personale come se offrissero lo stesso servizio. Il quinto è escludere dal conto le richieste scartate. Un sistema poco costoso per tentativo può diventare caro per pratica conclusa se richiede rigenerazioni e correzioni frequenti.
Non bisogna infine scambiare una quota tecnica o un limite di frequenza per un tetto di spesa. Prima del rilascio il team deve verificare quali controlli di consumo siano effettivamente disponibili sul proprio account e come intervenga il software quando viene raggiunto il budget interno. Un avviso ha valore solo se qualcuno lo riceve e sa quale azione intraprendere.
Apri la scheda minima per un preventivo Argon controllabile
- Prodotto: canale utilizzato, modello esatto e modalità di esecuzione.
- Periodo: tariffa applicabile prima e dopo la scadenza promozionale.
- Volume: attività previste e passaggi tecnici per ogni attività.
- Consumo: input ordinario, input in cache e output fatturato.
- Extra: strumenti, servizi collegati, tentativi e gestione degli errori.
- Qualità: risultati accettati e lavoro di revisione necessario.
- Controllo: responsabile del budget e procedura in caso di scostamento.
Quale numero deve guidare la decisione finale?
Il costo per risultato accettato collega il conto tecnico al lavoro reale. Si divide il costo del percorso per il numero di risultati che superano i criteri del processo; a parte si rende visibile la revisione umana. Non è una promessa di ritorno economico: è un modo per evitare che il numero di richieste venga scambiato per produttività.
Un preventivo ben costruito presenta ipotesi, quantità misurate e variabili ancora aperte. La disponibilità di Argon in Italia e i requisiti del canale vanno verificati prima di acquistare, mentre il campione di valutazione permette di aggiornare la stima senza affidarsi a un prezzo generico per testo.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Gemini 4 Argon: cos’è, cosa fa e quando usarlo in azienda
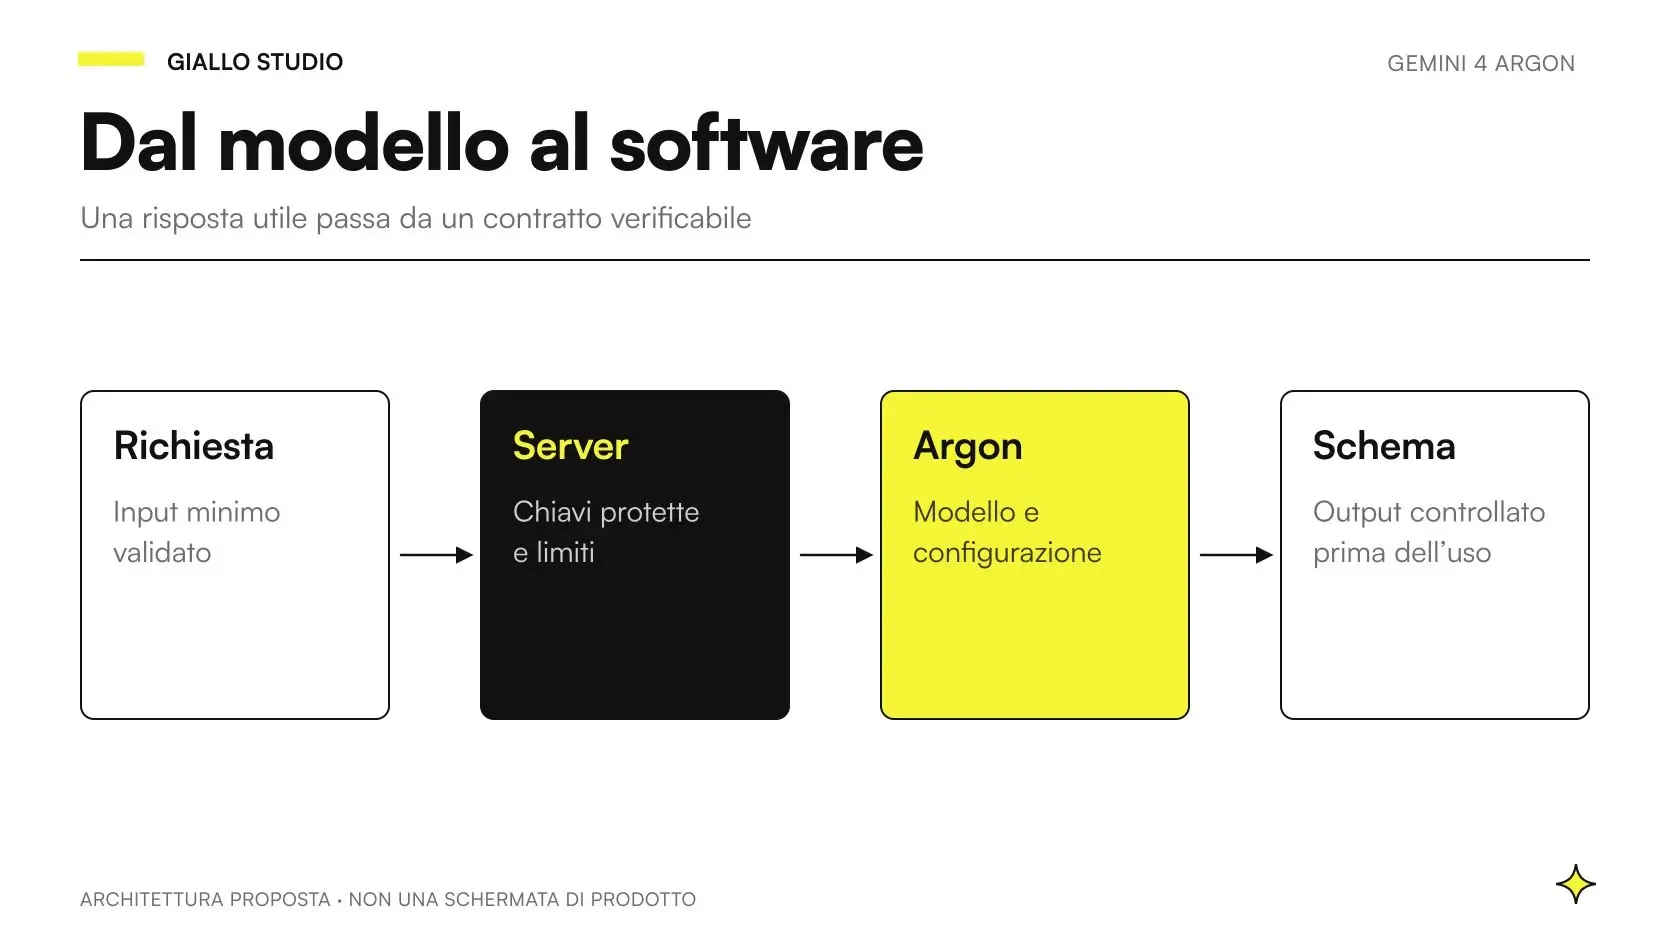 Gemini 4 Argon API: integrare il modello nei processi aziendali
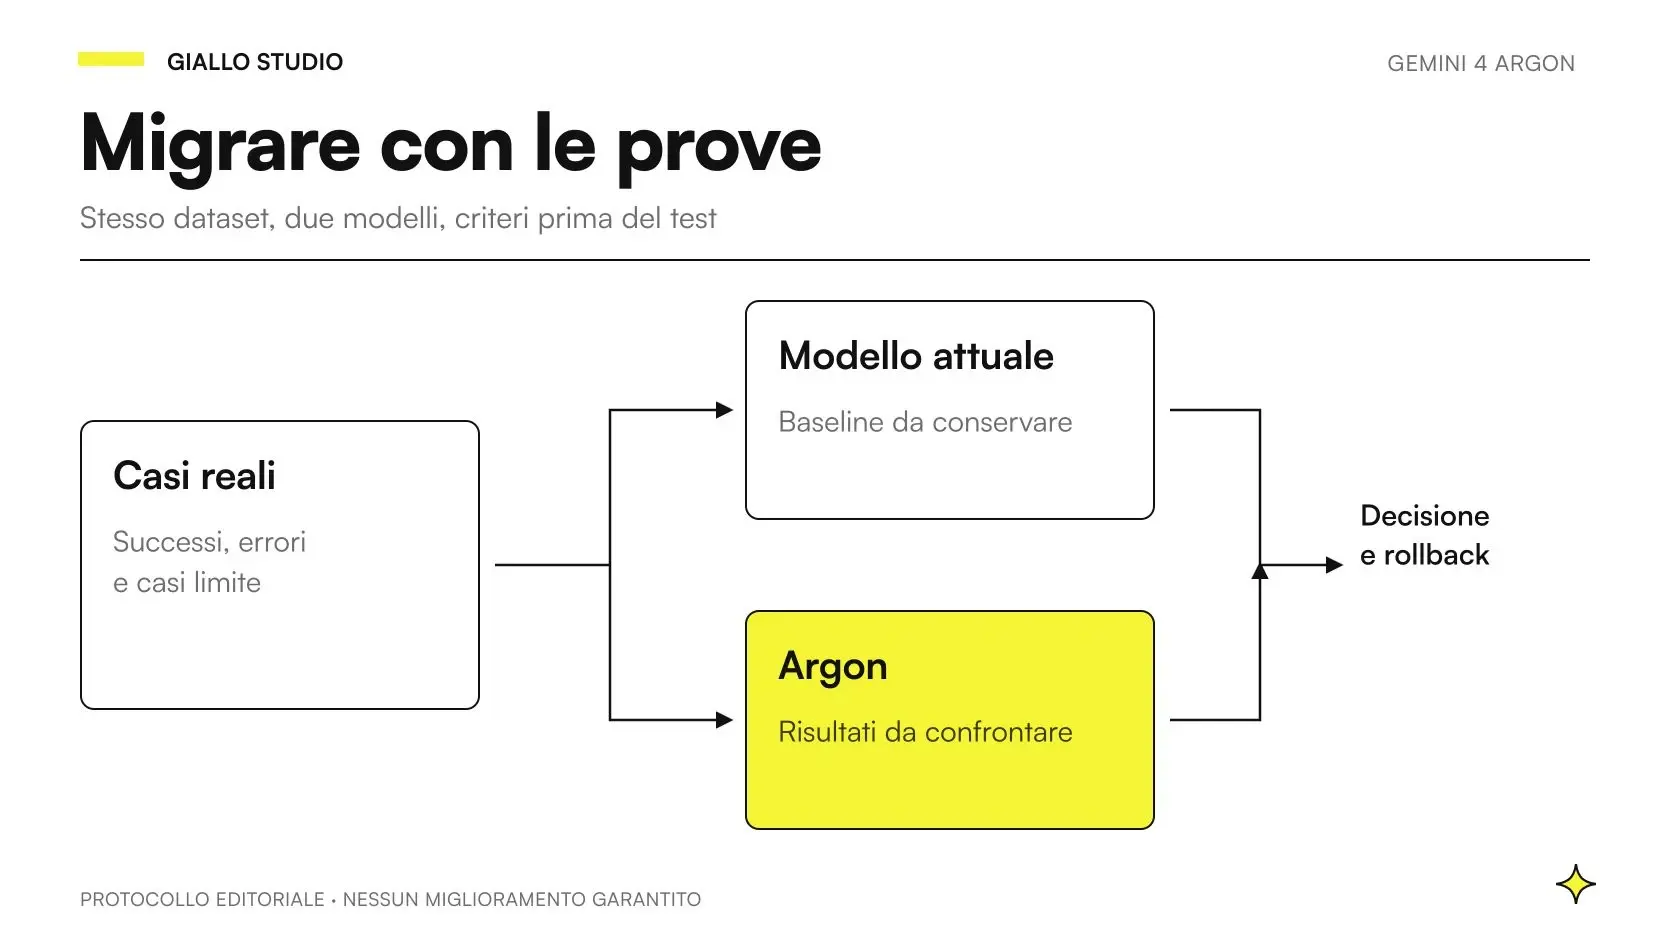 Migrare a Gemini 4 Argon: valutazione, test e rollback
 Gemini 4 Argon in Italia: accesso e come iniziare
 Gemini 4 Argon per agenti AI e automazioni: strumenti e approvazioni
 Cosa sono i token AI: come si contano e quanto costano (ottobre 2026)
FAQ
Quanto costa Gemini 4 Argon via API?
Al 23 ottobre 2026 il prezzo Standard della Gemini Developer API è 2 dollari per milione di token in input e 10 dollari per milione in output, thinking compreso. La promozione termina il 30 novembre 2026; dal 1 dicembre le tariffe documentate diventano 4 e 20 dollari.
Gemini 4 Argon ha un livello API gratuito?
Il listino Gemini Developer API consultato il 23 ottobre 2026 non include Argon nel Free tier. Non bisogna confondere l’accesso gratuito ad altri modelli o prodotti con il prezzo di questo modello.
Il thinking viene addebitato separatamente?
I token di thinking rientrano nell’output fatturato. Quando si prepara una stima, bisogna includerli nella quantità di output ed evitare di aggiungerli una seconda volta se il totale misurato li comprende già.
Quanto costa l’input in cache di Argon?
Il listino indica 0,10 dollari per milione di token di input in cache fino al 30 novembre 2026 e 0,20 dal 1 dicembre. Argon supporta la cache implicita, con soglia documentata di almeno 4.096 token per il prompt; non è corretto presumere un cache hit per tutte le richieste.
Un abbonamento Google AI Pro include il budget delle API?
Le tariffe dell’API e i piani di utilizzo delle app sono voci distinte. Prima di acquistare si deve verificare quale prodotto serve: accesso personale nell’app oppure consumo di un’integrazione software. Non si può dedurre un credito API dal solo nome dell’abbonamento.
Come posso stimare il costo mensile di un’automazione?
Si stimano richieste, token di input e output, strumenti e tentativi aggiuntivi, applicando il listino del canale scelto. La stima va poi confrontata con i consumi osservati e con il numero di risultati realmente accettati dal processo.