
Migrare a Gemini 4 Hydrogen: checklist da Gemini 3.8 Flash e 2.5 prima del 1° dicembre
Come migrare a Gemini 4 Hydrogen da Gemini 3.8 Flash e 2.5: parametri da cambiare, piano di prova, ritorno indietro e cosa succede il 1° dicembre 2026.
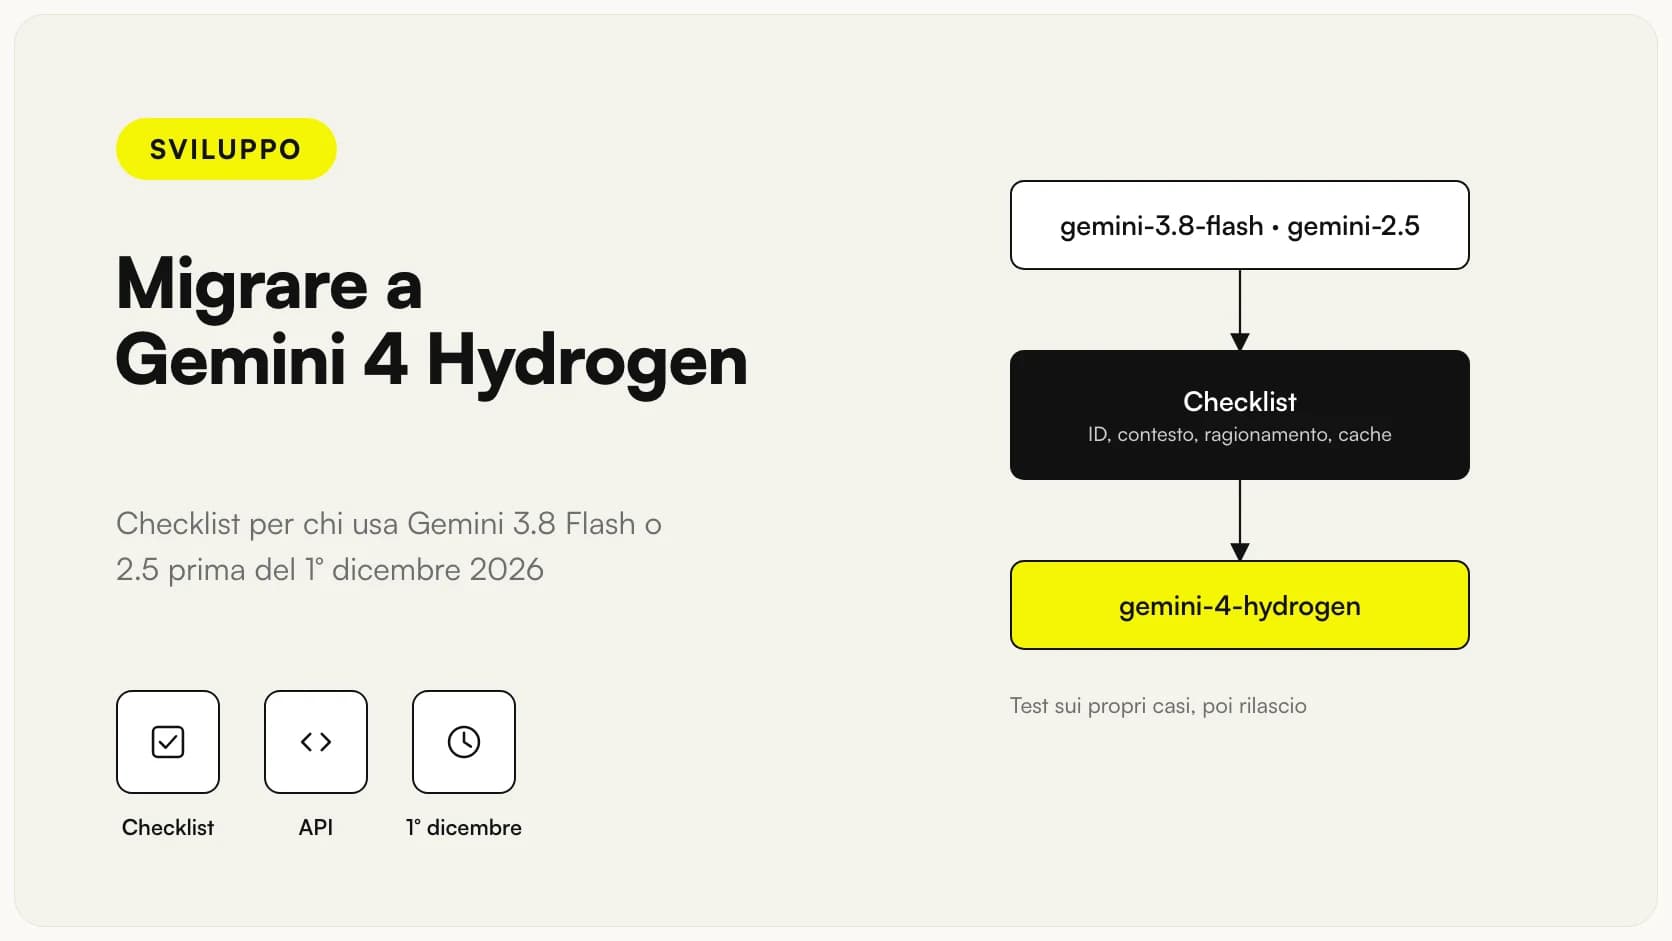
Migrare a Gemini 4 Hydrogen significa sostituire l’ID del modello con gemini-4-hydrogen e rivedere le impostazioni che cambiano rispetto a Gemini 3.8 Flash, da fare con calma prima del 1° dicembre 2026, quando Google comincia a instradare in automatico le richieste di Gemini 2.5 Pro e 2.5 Flash. Le fonti sono la guida «What’s new in Gemini 4 Hydrogen», l’elenco dei modelli, il listino della Gemini API e la scheda del modello su Agent Platform, consultati il 14 novembre 2026.
Questa pagina serve a chi ha già un’integrazione in produzione: un gestionale, un chatbot, un’automazione. Per capire che cos’è il modello c’è Gemini 4 Hydrogen: cos’è. La checklist riporta la documentazione di Google e un metodo di prova che proponiamo; Giallo non ha eseguito questa migrazione sui sistemi di terzi.
In sintesi
- Dal 1° dicembre 2026 le richieste a
gemini-2.5-propassano agemini-3.8-flashe quelle agemini-2.5-flashagemini-3.5-flash-lite, con le tariffe del nuovo modello (elenco dei modelli, listino). - Google indica Hydrogen come aggiornamento consigliato da Gemini 3.8 Flash e dai modelli Gemini 3 e 2.5 precedenti (guida ufficiale).
- Non basta cambiare l’ID: Hydrogen parte da
high, rifiutaminimal, ignoratemperature,top_petop_ke non supporta il caching esplicito. - Il tetto di output per richiesta è 65.536 token dentro una finestra unica da 1.048.576: un vecchio limite basso su
max_output_tokenstaglia le risposte. - Da Carbon o Argon lo schema delle richieste resta uguale; cambiano il livello di ragionamento predefinito e il tetto dei passi.
- Il ritorno indietro si prepara prima: ID del modello in configurazione, prova su casi reali con più livelli di ragionamento, rilascio graduale.
Che cosa succede il 1° dicembre 2026 a Gemini 2.5 Pro e 2.5 Flash?
Il 1° dicembre 2026 Google smette di servire gemini-2.5-pro e gemini-2.5-flash con il modello originale: le richieste vengono reindirizzate a un altro modello e fatturate alle sue tariffe. I due modelli risultano già deprecati, non selezionabili in AI Studio, con accesso API limitato a chi li usava. Le informazioni vengono dalla pagina modelli e dal listino.
| Modello nel codice | Cosa dice Google il 14 novembre 2026 | Dove arrivano le richieste |
|---|---|---|
gemini-2.5-pro |
Deprecato; dal 1° dicembre 2026 instradamento automatico, tariffe di 3.8 Flash (fonte) | gemini-3.8-flash |
gemini-2.5-flash |
Deprecato; dal 1° dicembre 2026 instradamento automatico, tariffe di 3.5 Flash-Lite (fonte) | gemini-3.5-flash-lite |
gemini-2.5-flash-lite |
Non deprecato, servito fino a nuovo avviso; per nuovi progetti Google indica Hydrogen o 3.5 Flash-Lite (fonte) | Nessun cambio annunciato |
gemini-3.8-flash |
Modello stabile della generazione precedente; nessuna data di dismissione nelle pagine consultate | Nessun cambio annunciato |
Per Gemini 2.5 Flash la pagina dei modelli invita ad aggiornare la stringa a gemini-3.5-flash-lite; chi vuole vedere dove si colloca Flash-Lite rispetto alla fascia Flash trova prezzi e confronto in Gemini 3.6 Flash vs 3.5 Flash. La guida di Hydrogen, invece, indica Hydrogen come aggiornamento dai modelli 2.5 e riserva Flash-Lite a classificazione e instradamento in grandi volumi. La scelta dipende dal compito: il confronto è in Hydrogen, Carbon e Argon.
Qual è l’ordine giusto per migrare un’integrazione esistente?
Prima si scopre dove il modello è usato, poi si cambia una cosa alla volta, infine si rilascia in modo graduale.
- Inventario. Elencate ogni punto in cui compare un ID di modello: codice, variabili d’ambiente, flussi di automazione, configurazioni per cliente, ambienti di prova.
- ID in un solo posto. Portate l’ID in un’impostazione unica, così il passaggio a
gemini-4-hydrogene il ritorno indietro sono la modifica di un valore. - Pulizia dei parametri. Togliete
cached_content,temperature,top_petop_ke correggete i tetti bassi dimax_output_tokens. - Insieme di prove. Raccogliete casi reali anonimizzati, con il risultato atteso scritto prima del test.
- Confronto a più livelli. Eseguite la stessa suite almeno su
mediumehigh; Google suggerisce di provare tutti e quattro i livelli con unmax_output_tokensalto e di scegliere il più basso che rispetta la vostra soglia di qualità. - Rilascio graduale. Fate passare prima una quota ridotta del traffico, con il vecchio modello pronto a ricevere di nuovo tutto.
- Chiusura. Togliete il vecchio ID solo quando costi, tempi ed errori sono stati letti per un periodo che avete deciso prima.
Che cosa cambia nei parametri rispetto a Gemini 3.8 Flash?
La tabella segue la sezione di migrazione della guida ufficiale e, per Agent Platform, la scheda su Google Cloud.
| Area | Da cercare nel codice (3.8 Flash e precedenti) | Con Hydrogen | Che cosa fare |
|---|---|---|---|
| Modello | gemini-3.8-flash |
gemini-4-hydrogen |
Cambiare la stringa del modello |
| Finestra e output | 1M di input e 64K di output in budget separati | Una sola finestra da 1.048.576 token per input, ragionamento e output; 65.536 come valore predefinito e tetto per richiesta | Togliere tetti bassi di max_output_tokens (Google cita 8.192) o portarli a 65.536 |
| Ragionamento | medium come valore predefinito (3.8 Flash) |
high predefinito, nuovo xhigh, minimal restituisce un errore |
Provare medium e high sulla propria suite |
| Caching | cachedContents, caches.create, campo cached_content |
Solo caching implicito, da almeno 4.096 token, con sconto del 95% sui token in cache (guida) | Togliere il caching esplicito |
| Campionamento | temperature, top_p, top_k |
Valori ignorati se in range, errore 400 se fuori range |
Togliere i tre parametri |
| Strumenti | Istruzioni che chiedono un JSON «a mano», senza strumenti dichiarati | Strumenti dichiarati con function calling o structured output | Dichiarare gli strumenti, altrimenti si rischia MALFORMED_FUNCTION_CALL |
| Stato | Cronologia ricostruita dal vostro codice | previous_interaction_id nell’Interactions API; in generateContent thought signatures restituite invariate |
Non modificare né copiare le thought signatures |
| Output lunghi | Risposte oltre 64K token | background: true e max_output_tokens sopra 65.536 |
Usarli solo quando serve |
| Costi | Stime fatte sul vecchio modello | Si pagano tutti i token elaborati, ragionamento compreso, a 7,50 $ per milione in output (listino) | Rifare le stime con i token reali |
Per chi usa Gemini Enterprise Agent Platform (ex Vertex AI) vale una precisazione: la scheda indica che una richiesta con thinking_budget o con thinking_level su MINIMAL restituisce un errore HTTP 400.
Perché max_output_tokens e thinking_level vanno rivisti insieme?
Perché il tetto max_output_tokens conta insieme ragionamento e risposta, e il livello high consuma più ragionamento di medium. Un tetto scelto per il vecchio modello può esaurirsi prima che il testo finale cominci. Google lo dice in modo esplicito: il campo «caps combined thinking and output tokens», quindi va lasciato spazio alla risposta (guida).
Per compiti normali si tiene il valore predefinito o si omette il campo. Per spendere meno si abbassa il livello di ragionamento, non il tetto. Per risposte molto lunghe si imposta background su true e max_output_tokens a 131.072 o 262.144, fino a 1.048.576 meno i token di input; senza max_output_tokens il server si ferma a 65.536.
Per il livello: low dà meno token e latenza minima, medium serve al coding interattivo e alla chat reattiva, high è consigliato per la maggior parte dei compiti, xhigh è per i problemi in cui high non basta e sui prompt semplici può ragionare più del necessario (in inglese overthinking). Il principio generale è in reasoning effort; token AI: cosa sono spiega perché il ragionamento si paga come output.
Quali abitudini del codice vecchio smettono di funzionare?
La temperatura bassa per avere risposte stabili. Con Hydrogen temperature, top_p e top_k non si regolano più: su Agent Platform sono fissi a 1,0, 0,95 e 64. Ne consegue, come ragionamento nostro, che la ripetibilità non può più venire dalla temperatura e va cercata altrove: uno schema di output rigido, istruzioni chiare, controlli sul risultato prima di scriverlo nel gestionale.
Il caching esplicito. Chi creava una cache a mano deve toglierla. Il caching implicito si attiva da solo sui prompt di almeno 4.096 token: conviene tenere all’inizio del prompt le parti stabili, come istruzioni e documenti di riferimento, e in fondo quelle che cambiano ad ogni richiesta. Questa disposizione è un nostro consiglio di metodo, non una regola scritta da Google. Su Agent Platform dal 12 gennaio 2027 arrivano controlli di cache con TTL, con scritture in cache a 1,25 volte il prezzo di input per impostazione predefinita (scheda).
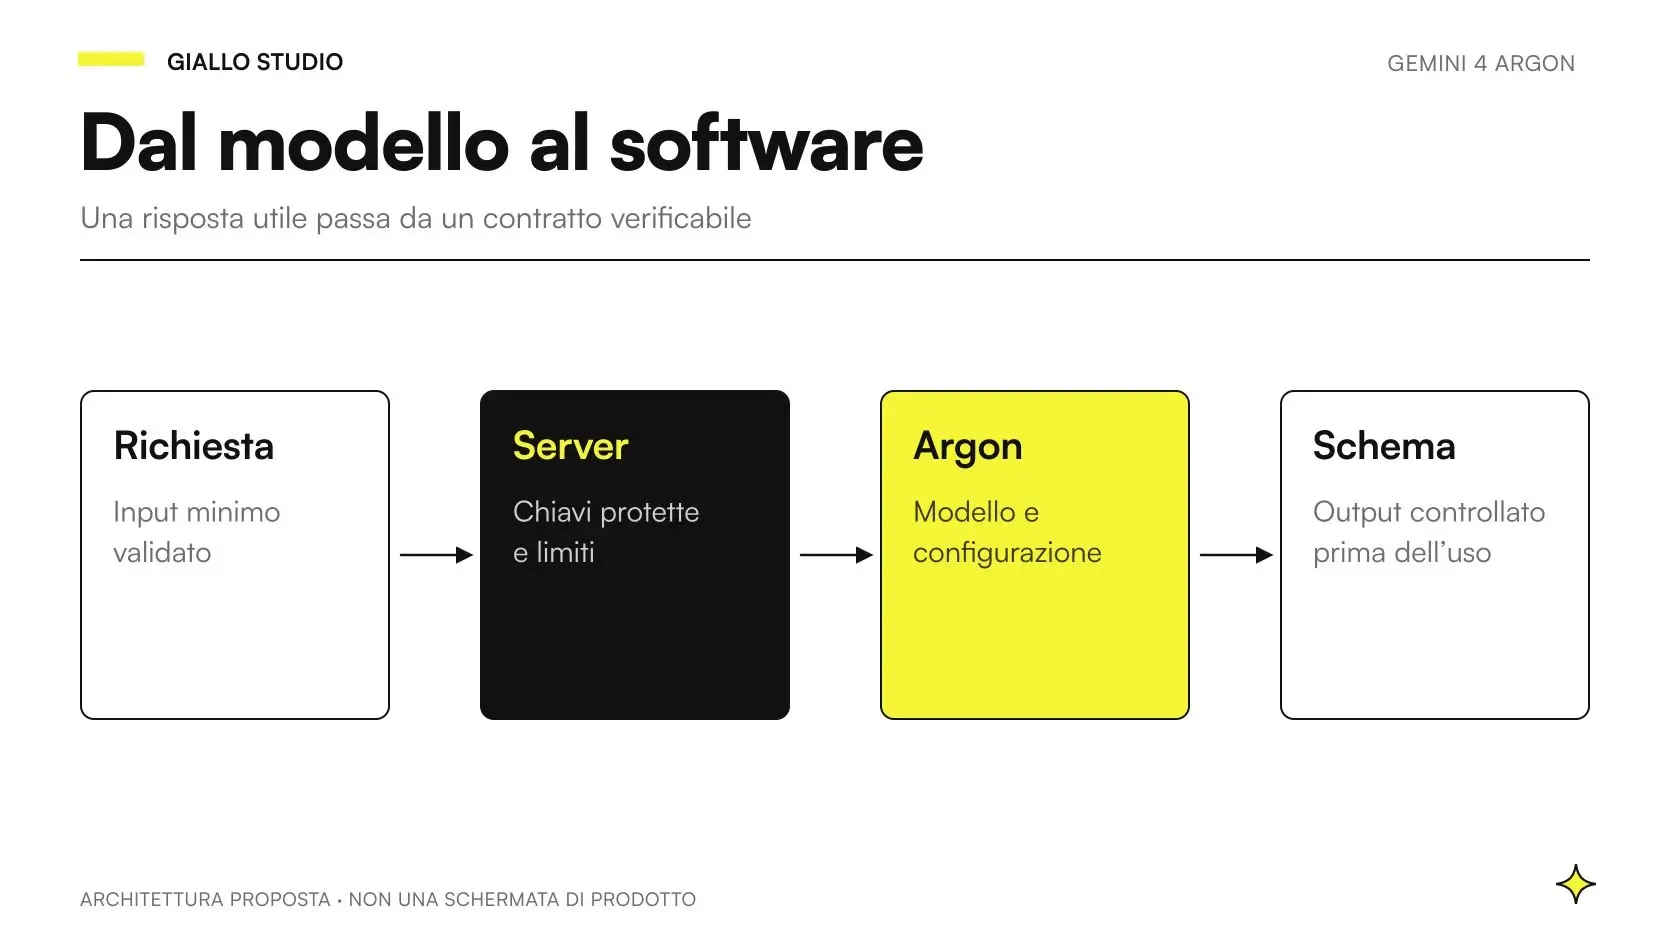
Il JSON chiesto «a parole». Se il prompt dice al modello di scrivere un finto richiamo a uno strumento senza dichiarare strumenti, la richiesta può fallire con MALFORMED_FUNCTION_CALL. Si dichiarano gli strumenti con il function calling nativo, oppure si vincola la risposta con uno structured output. Per contratto di output e gestione degli errori vale anche qui Gemini 4 Argon API, perché lo schema è lo stesso.
Lo stato della conversazione. Con l’Interactions API si usa previous_interaction_id. Se invece la cronologia la tiene il vostro codice con generateContent, i turni del modello e le thought signatures vanno rimandati identici a ogni turno, e una thought signature non va copiata su più chiamate di funzione parallele.
Che cosa cambia se si parte da Carbon o da Argon?
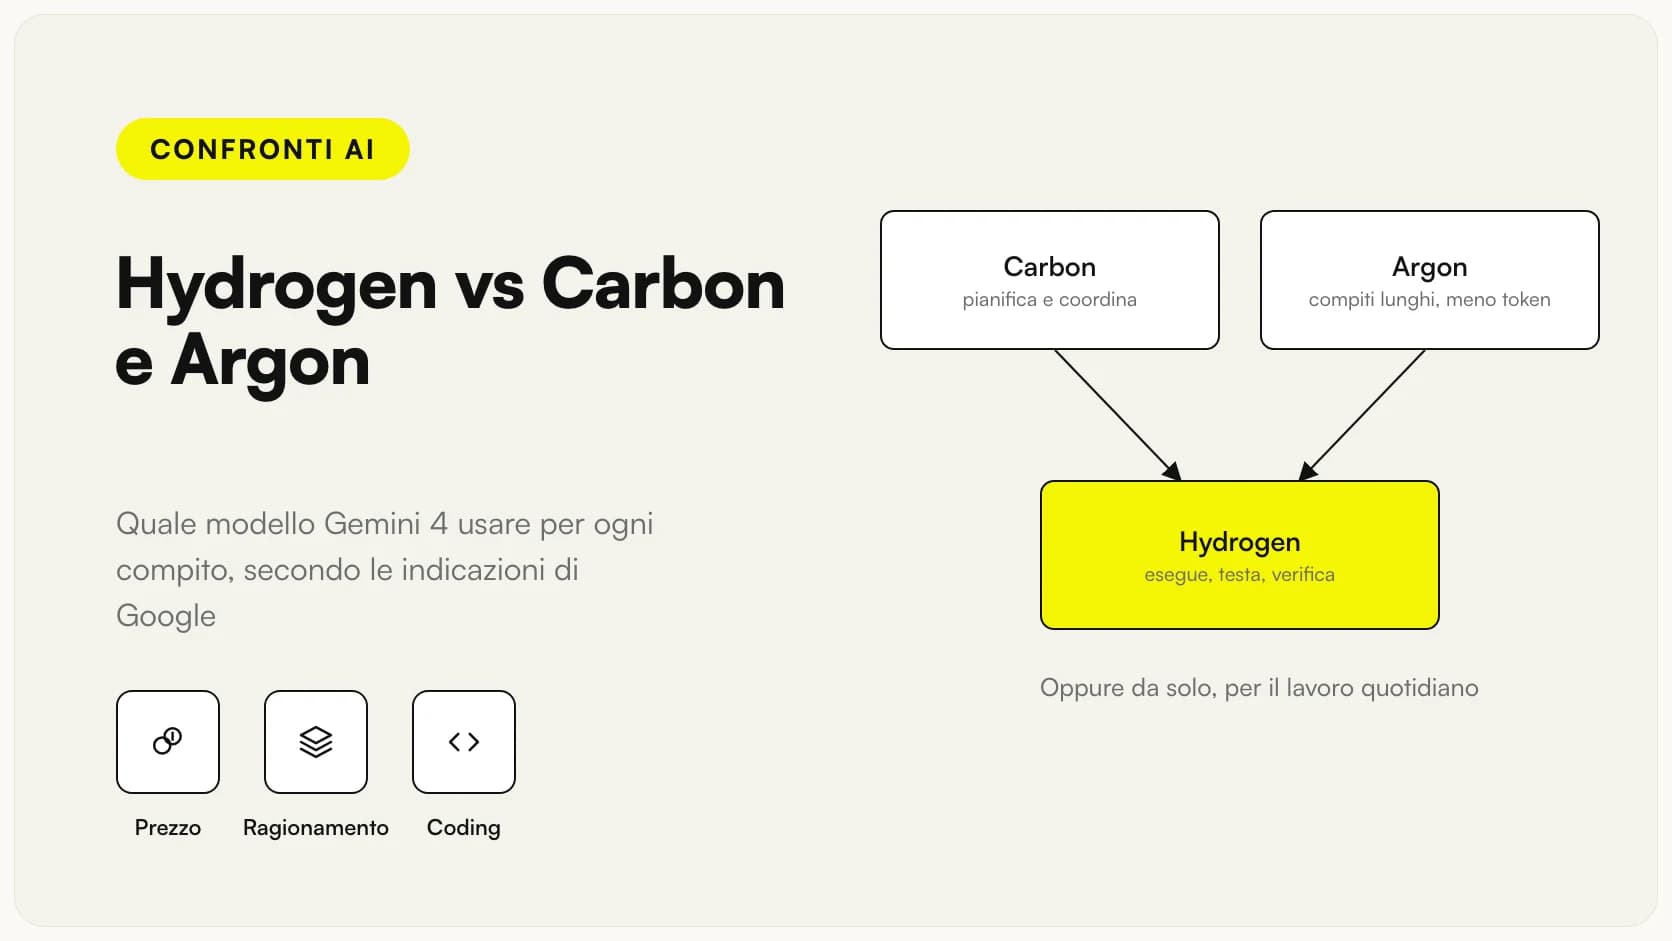
Secondo la guida, chi usa gemini-4-carbon o gemini-4-argon non deve cambiare lo schema delle richieste: cambiano solo i valori predefiniti.
| Voce | Carbon e Argon | Hydrogen |
|---|---|---|
| ID del modello | gemini-4-carbon, gemini-4-argon |
gemini-4-hydrogen |
| Ragionamento predefinito | medium, massimo high |
high, con xhigh in più |
| Passo non in streaming via REST | 32.768 token | 65.536 token |
I modelli si possono anche usare insieme: pianificazione a Carbon ed esecuzione a Hydrogen nella stessa sessione, con previous_interaction_id; Google rimanda a una pagina sui limiti di questi turni misti.
Come si prova la migrazione e si torna indietro senza rischi?
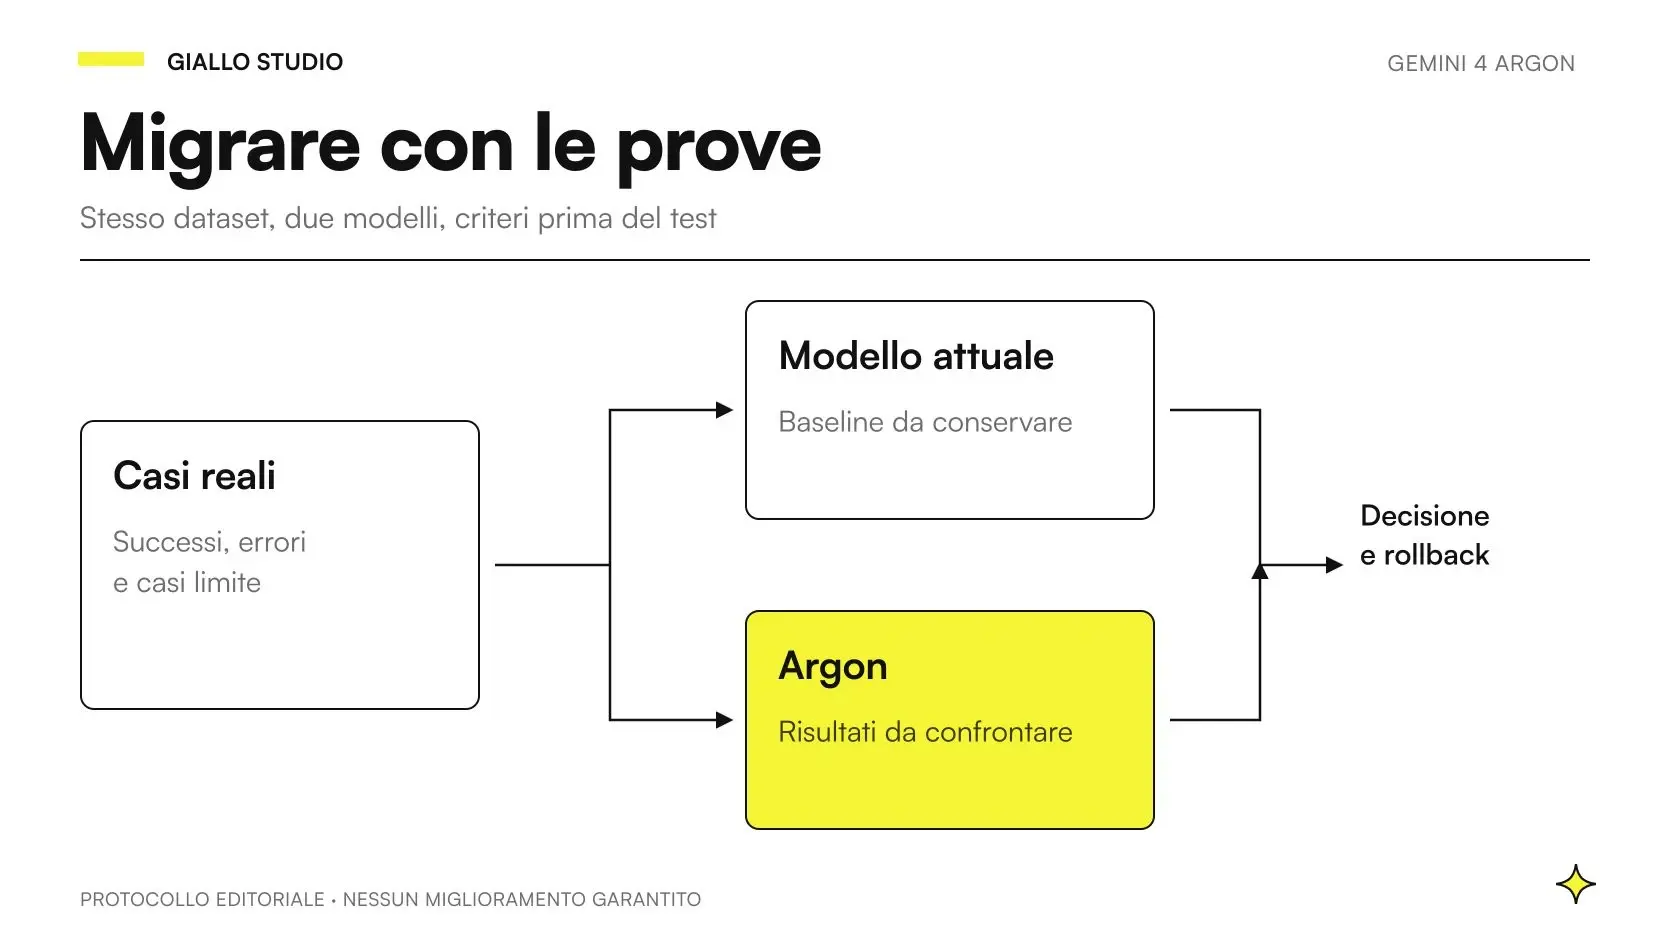
Si prova con casi reali, si confrontano più livelli di ragionamento e si prepara il ritorno indietro prima del rilascio. Un metodo completo è in valutazione, test e rollback per Argon; qui la versione per un’integrazione in produzione.
- L’ID del modello sta in un’impostazione, non sparso in più file.
- La suite contiene casi tipici, casi difficili e casi in cui il modello deve rifiutare o chiedere aiuto, ciascuno con un risultato atteso scritto prima del test.
- Le prove girano con un
max_output_tokensalto, perché un tetto basso falsa il confronto (guida di Google). - Per ogni richiesta si registrano modello, livello di ragionamento, token, tempo ed errori.
- Un risultato non valido non scrive nel gestionale né risponde al cliente.
- C’è un limite di tentativi e una gestione dell’errore
429 RESOURCE_EXHAUSTED, che Google associa ai limiti di spesa. - Il modello precedente resta richiamabile fino alla chiusura del periodo di osservazione.
Per il ritorno indietro, due precisazioni. Chi parte da 3.8 Flash torna a gemini-3.8-flash; Google non indica una dismissione nelle pagine consultate, ma la pagina dei modelli va riletta a ogni rilascio. Chi parte da Gemini 2.5 dopo il 1° dicembre 2026 non ha più il 2.5 come punto di ritorno, perché quelle richieste vengono instradate: il confronto va fatto prima di quella data.
Come affronta la migrazione una software house che mantiene l’integrazione AI di un gestionale?
Esempio, non un caso reale. Il gestionale classifica le segnalazioni di assistenza e prepara bozze di risposta. Nel codice ci sono un ID di modello ripetuto in più moduli, una temperature bassa per avere risposte simili e un max_output_tokens di 8.192, il tetto che la guida di Google cita come da togliere.
Il lavoro, in ordine: ID in configurazione, via temperature, tetto alzato o tolto, schema di output che il gestionale controlla prima di salvare, poi medium e high sulle segnalazioni di un periodo passato. Il risultato è un confronto tra due colonne di risposte: dove cambia il tono, dove cambia la classificazione, dove aumentano i token. xhigh si prova solo sui casi difficili. Conviene tenere la suite di prova separata per cliente, perché i casi difficili non sono gli stessi.
E un chatbot di assistenza su WhatsApp?
Altro esempio dichiarato. Un negozio ha un chatbot su WhatsApp che risponde su ordini e resi e interroga il gestionale con uno strumento. Contano la velocità e la correttezza dello strumento. Google indica low per la chat veloce e medium per la chat reattiva, mentre high è il valore consigliato per la maggior parte dei compiti: si misura la durata su tutti e tre e si sceglie il livello più basso che mantiene giuste le risposte sugli ordini. Lo strumento va dichiarato nativamente, e se la cronologia la conserva il vostro codice, turni e thought signatures tornano indietro senza modifiche.
C’è poi un punto contrattuale: i termini della Gemini API ammettono solo i Paid Services quando si mettono a disposizione applicazioni basate sull’API a utenti nello Spazio economico europeo, in Svizzera o nel Regno Unito, quindi il progetto deve avere la fatturazione attiva. Il resto del tema dati è in Gemini 4 Hydrogen per aziende; chi deve costruire il chatbot da zero trova il percorso nella pagina chatbot WhatsApp.
Quanto costa migrare e quando conviene aspettare?
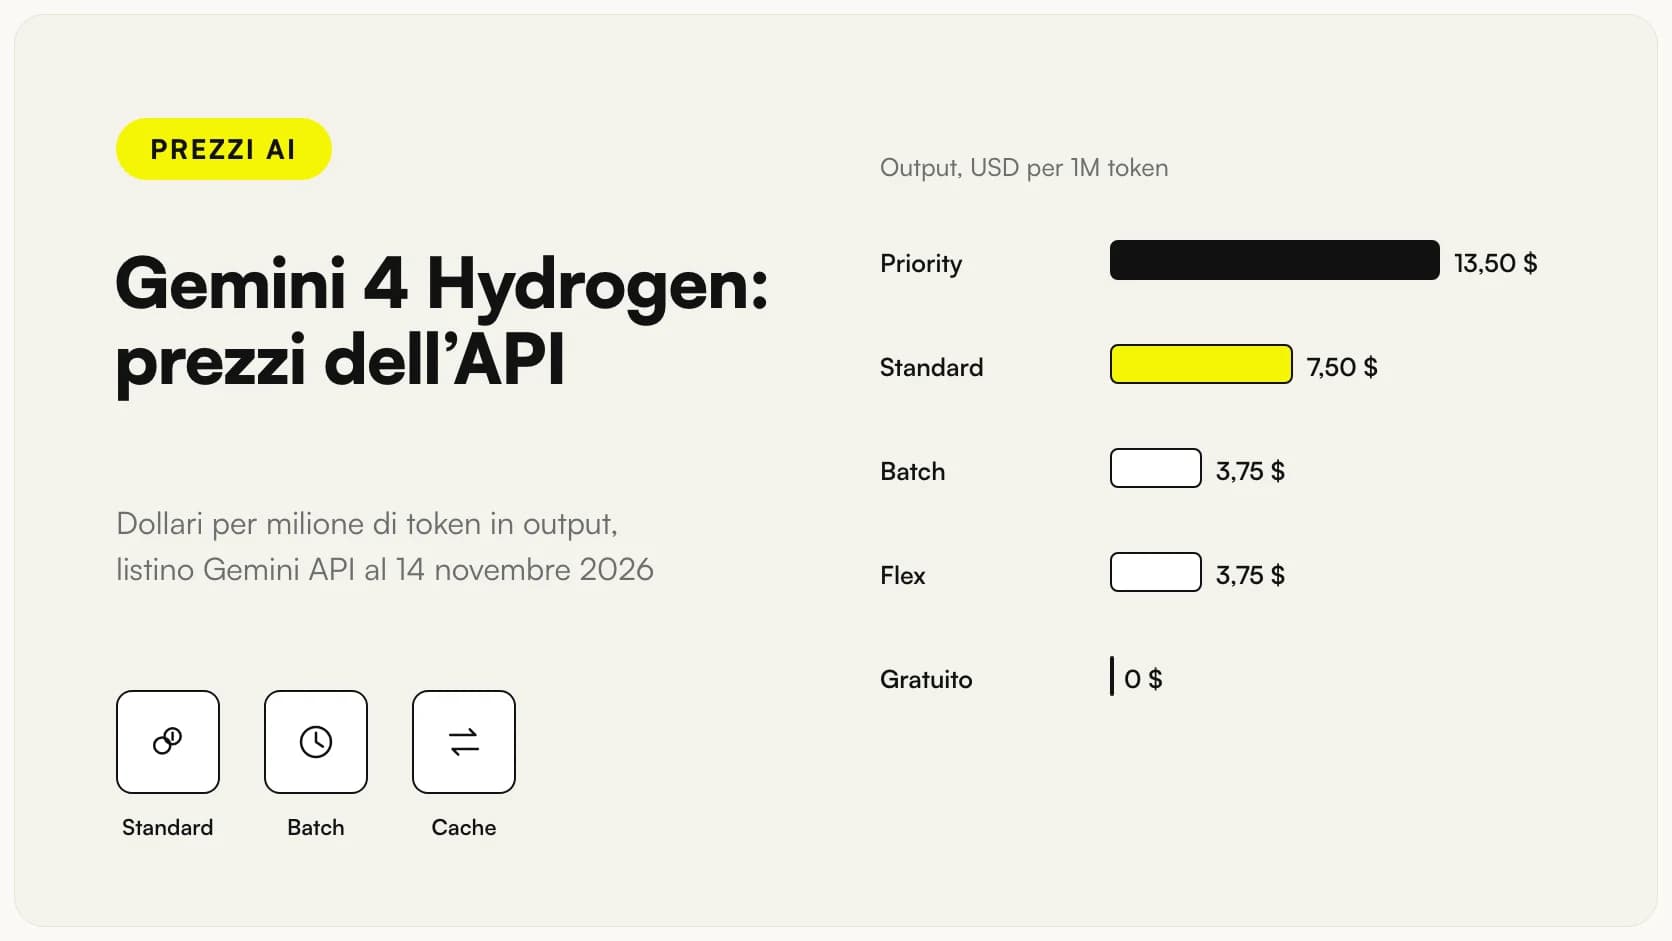
Hydrogen costa 1,50 $ per milione di token in input e 7,50 $ in output, ragionamento compreso (listino). Gemini 3.8 Flash costa 0,75 $ e 3,75 $ fino al 31 dicembre 2026, poi 1,50 $ e 7,50 $ dal 1° gennaio 2027, cioè come Hydrogen. A parità di token, quindi, restare su 3.8 Flash costa meno fino a fine anno; ma i token per risposta cambiano da modello a modello, e solo la prova sui vostri casi dice quale costa meno. Esempi di calcolo e tetti di spesa sono in Gemini 4 Hydrogen prezzi; per il metodo generale, costo API AI: come calcolarlo.
Conviene muoversi subito
- Se usate ancora
gemini-2.5-proogemini-2.5-flash: dopo il 1° dicembre 2026 le richieste cambiano modello senza che lo decidiate. - Se avete già una suite di prova e un ID in configurazione.
Si può aspettare
- Se siete su
gemini-3.8-flashe funziona, perché Google non indica una dismissione nelle pagine consultate. - Se il compito è classificazione in grandi volumi, dove Google indica Flash-Lite.
Quali errori rendono rischiosa una migrazione di modello?
Quattro, tutti evitabili.
- Cambiare solo l’ID e rilasciare. Con il livello
highpredefinito e il tetto di output vecchio, il comportamento può cambiare senza che nessuna riga dica perché. - Lasciare
temperaturenel codice «per sicurezza». Con un valore in range viene ignorata e dà l’illusione di un controllo che non c’è; fuori range la richiesta fallisce con400. - Aspettare il 1° dicembre per osservare il nuovo comportamento. Dopo quella data il 2.5 non è più disponibile come termine di confronto.
- Non registrare token ed errori. Senza questi dati non si capisce se un aumento di costo viene dal livello di ragionamento o da un tetto troppo alto.
Da dove cominciare questa settimana?
Cominciate dall’inventario degli ID di modello e dai punti in cui un instradamento automatico cambierebbe un risultato per il cliente. Poi spostate l’ID in configurazione e togliete i parametri che Hydrogen ignora. Il resto segue l’ordine dei passi sopra.
Se volete un controllo esterno, Giallo può fare con voi un primo giro sull’integrazione: inventario degli ID, parametri da correggere e suite di prova sui vostri casi, con il modello attuale a confronto con Hydrogen. Si parte da una consulenza AI. I dati che Google dichiara sulle prestazioni sono in Gemini 4 Hydrogen benchmark.
Metodo e fonti delle guide di Giallo Studio
Vuoi applicarlo alla tua azienda?In 30 minuti, gratis: il processo da automatizzare per primo e il ritorno stimato, per iscritto.
Prenota l’audit gratuitoCome lo applichiamo in azienda
Risorse correlate
 Gemini 4 Hydrogen per aziende: casi d’uso, costi e privacy per una PMI
 Gemini 4 Hydrogen benchmark: confronto con Claude Sonnet 5.5 e GPT-6.1 Terra
 Gemini 4 Hydrogen: cos’è, come funziona e dove usarlo
 Gemini 4 Hydrogen prezzi: quanto costa l’API e come stimare la spesa
 Gemini 4 Hydrogen vs Carbon e Argon: quale modello Gemini scegliere
 Migrare a Gemini 4 Argon: valutazione, test e rollback
 Gemini 4 Argon API: integrare il modello nei processi aziendali
 API AI: cosa sono e come funzionano
 Gemini 3.6 Flash vs 3.5 Flash
 Reasoning effort: cosa cambia nei confronti
FAQ
Che cosa succede a Gemini 2.5 Pro e Gemini 2.5 Flash il 1° dicembre 2026?
Dal 1° dicembre 2026 le richieste a gemini-2.5-pro vanno in automatico a gemini-3.8-flash e quelle a gemini-2.5-flash a gemini-3.5-flash-lite, con le tariffe del modello di arrivo. Google ha già tolto i due modelli dalla selezione in AI Studio e limita l’accesso API a chi li usava.
Basta cambiare l’ID del modello per passare a Gemini 4 Hydrogen?
No. L’ID gemini-4-hydrogen è solo il primo passo: cambiano il livello di ragionamento predefinito, il tetto di output, il caching e i parametri di campionamento. Chi non li rivede rischia errori 400, risposte troncate o costi più alti del previsto.
Posso ancora impostare temperature, top_p e top_k con Gemini 4 Hydrogen?
No. Google chiede di toglierli dalle richieste: i valori entro i limiti vengono ignorati, quelli fuori limite restituiscono un errore 400. Su Agent Platform i valori sono fissi: temperatura 1,0, topP 0,95, topK 64.
Gemini 4 Hydrogen supporta il caching esplicito del contesto?
No. Non supporta cachedContents né caches.create: vanno tolti i campi cached_content dalle richieste. Resta il caching implicito, attivo di default dai 4.096 token in su, con sconto del 95% sui token di input trovati in cache.
Se uso già Gemini 4 Carbon o Argon, cosa devo cambiare per passare a Hydrogen?
Lo schema delle richieste non cambia: basta l’ID gemini-4-hydrogen. Va controllato il livello di ragionamento, perché Hydrogen parte da high e ammette xhigh, mentre Carbon e Argon partono da medium e arrivano a high.
Gemini 3.8 Flash verrà spento?
Nelle pagine consultate il 14 novembre 2026 Google non indica una data di dismissione per Gemini 3.8 Flash, che l’elenco dei modelli presenta come modello stabile della generazione precedente. Consiglia però Hydrogen come aggiornamento, e dal 1° gennaio 2027 i due modelli hanno lo stesso prezzo.
Come si torna indietro se la migrazione a Gemini 4 Hydrogen dà problemi?
Tenendo l’ID del modello in un’impostazione di configurazione e non nel codice, così il ritorno a gemini-3.8-flash è una modifica di un valore. Per chi arriva da Gemini 2.5, dopo il 1° dicembre 2026 il punto di ritorno è il modello verso cui Google instrada, perché da quella data le richieste non raggiungono più il 2.5.