Vai al contenuto
Giallo

Confronti modelli AI

Claude, GPT, Gemini e gli altri modelli messi a confronto su prezzi, benchmark ufficiali e compiti reali, per scegliere quello giusto per ogni lavoro.

46 guide in questa categoria
Claude Opus 5.5: benchmark ufficiali e prezzi a confronto con Fable 5.1 e GPT-6 AstraClaude Opus 5.5: benchmark ufficiali, prezzi e confronto con Fable 5.1 e GPT-6 AstraClaude Opus 5.5 è uscito il 22 settembre 2026: 4 $ input e 20 $ output per milione di token, livello di Fable 5.1. Tutti i benchmark ufficiali a confronto con GPT-6 Astra.
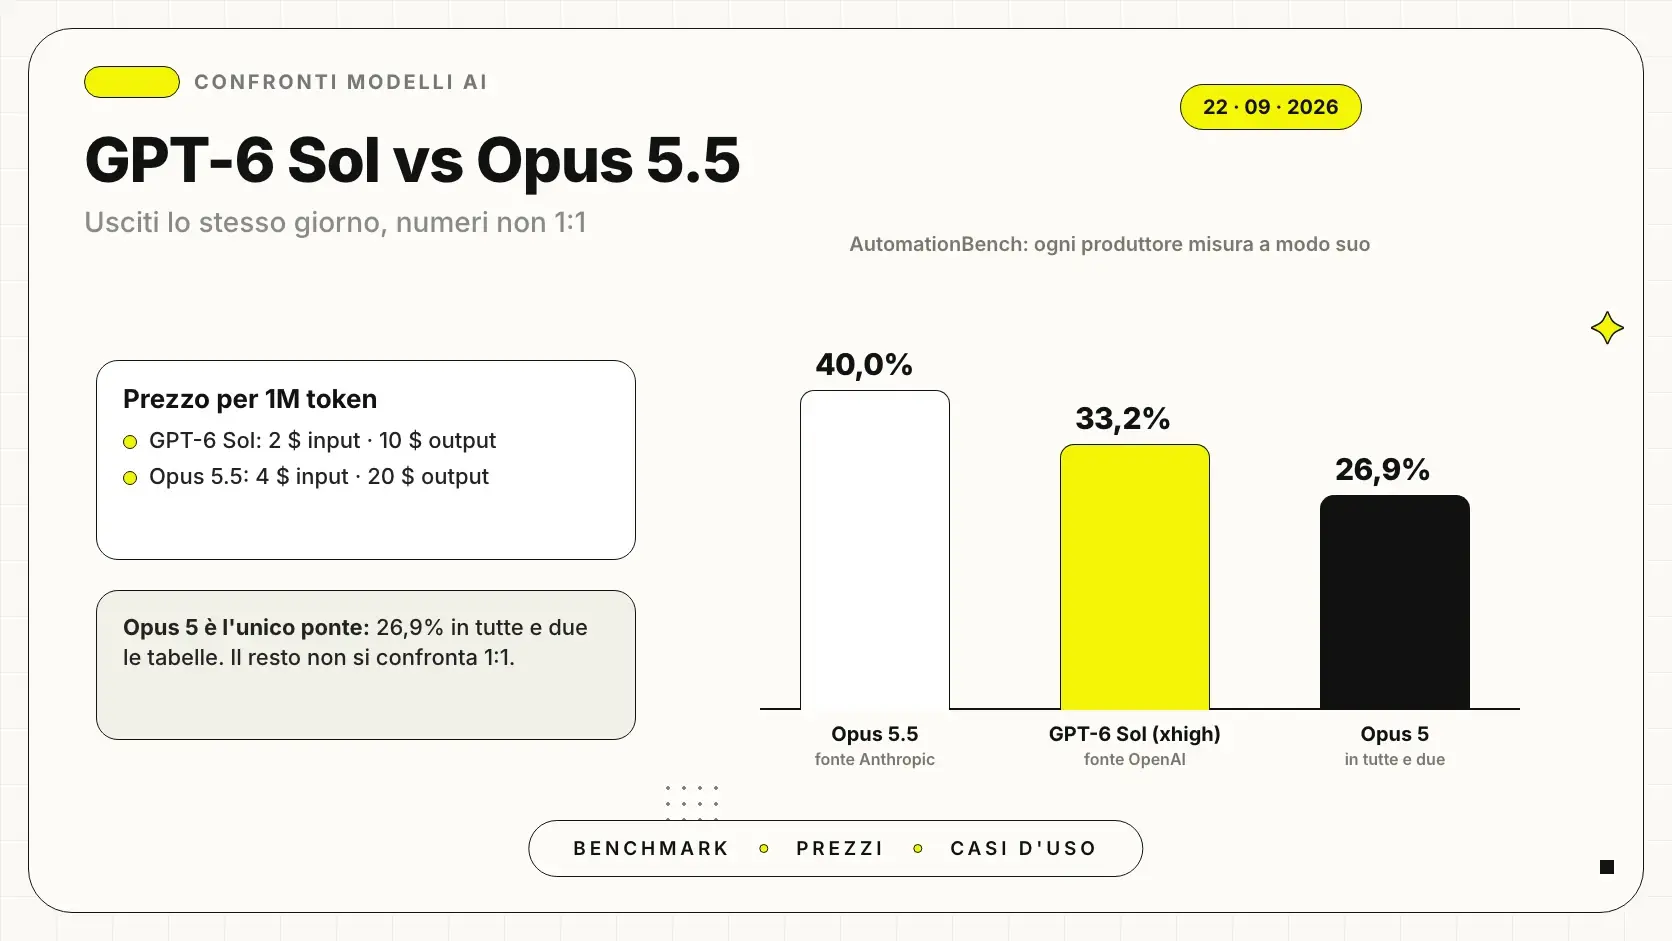
GPT-6 Sol vs Claude Opus 5.5: benchmark ufficiali di OpenAI e Anthropic messi a confrontoGPT-6 Sol vs Claude Opus 5.5: i numeri ufficiali e quando usare qualeGPT-6 Sol vs Claude Opus 5.5, usciti lo stesso giorno: i benchmark pubblicati da OpenAI e Anthropic, perché non si confrontano 1:1, prezzi e casi d'uso.
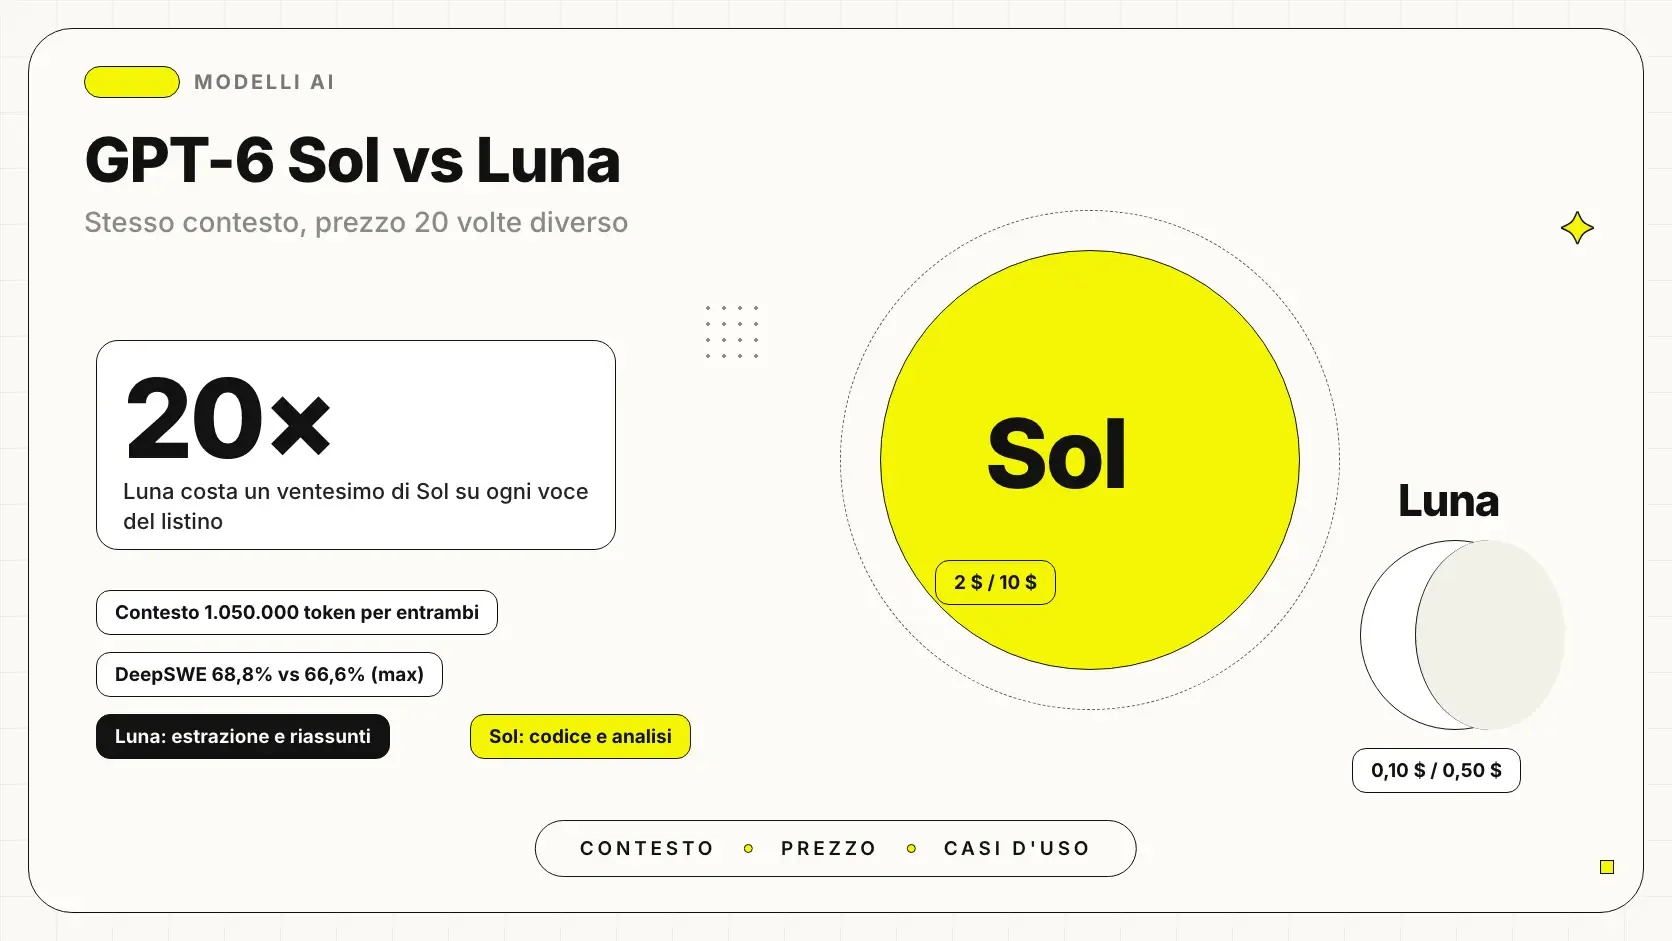
GPT-6 Sol vs Luna: i due modelli OpenAI con lo stesso contesto e un prezzo venti volte diversoGPT-6 Sol vs Luna: quale scegliere e per quali lavoriGPT-6 Sol vs Luna: stessa finestra da 1,05 milioni di token, prezzo 20 volte diverso. Benchmark ufficiali, esempi di costo e una tabella per scegliere.
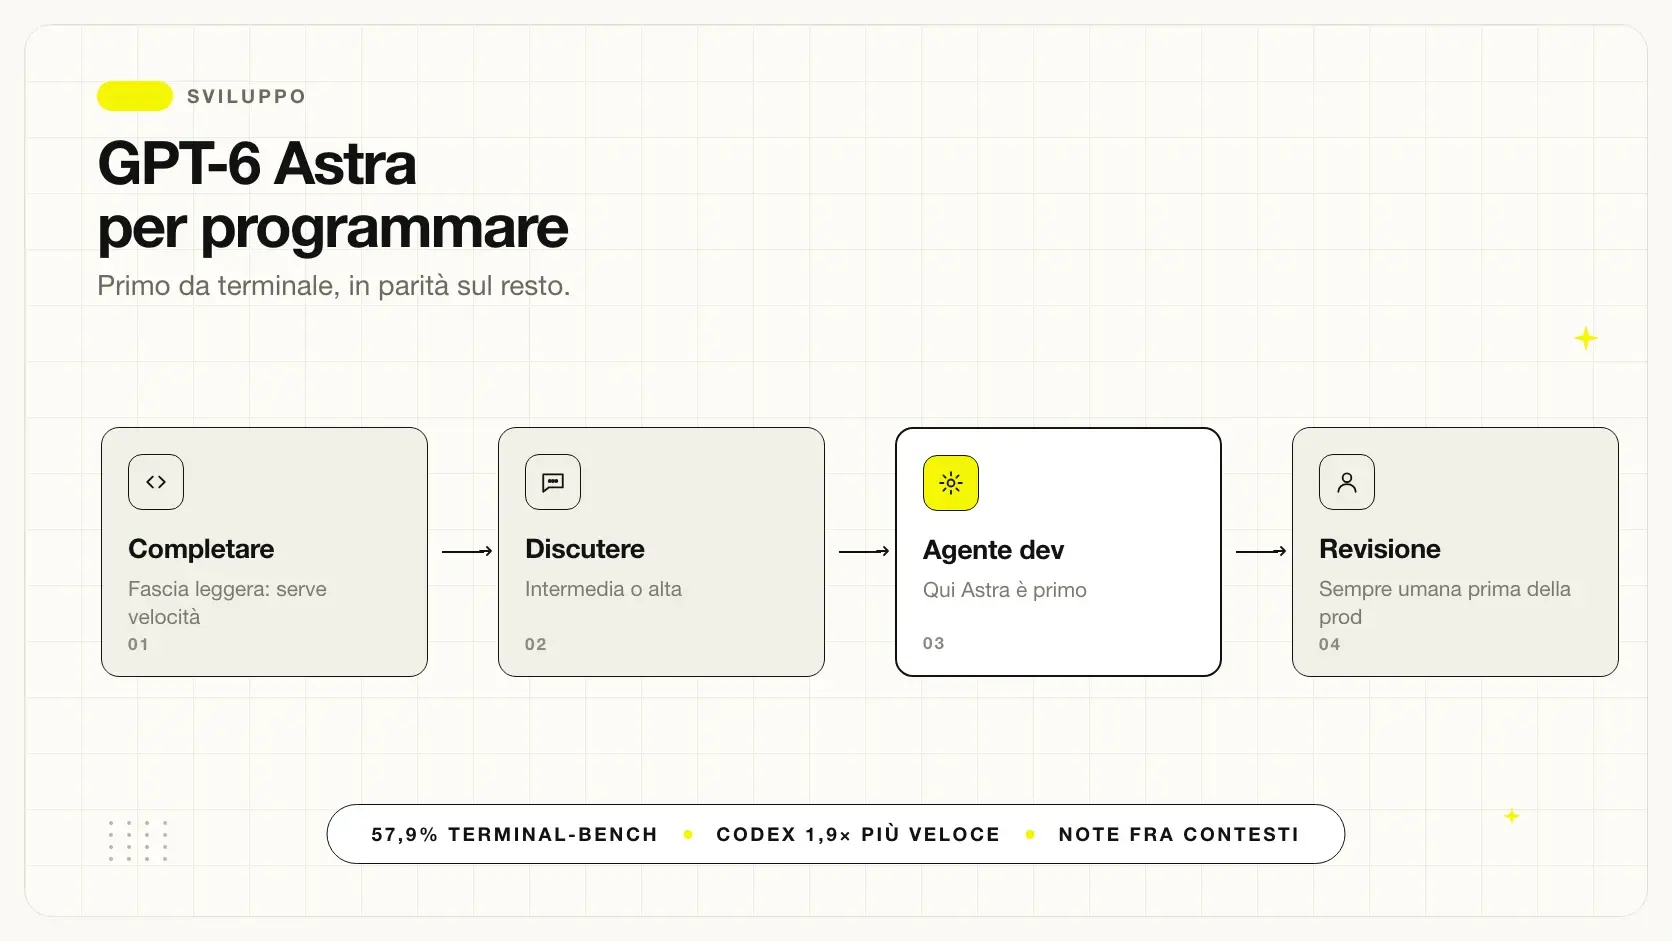
GPT-6 Astra per programmare: benchmark di coding a confrontoGPT-6 Astra per sviluppatori: codice, API e uso del computerGPT-6 Astra lato sviluppo: punteggi sul codice, endpoint e strumenti dell'API, livelli di ragionamento, contesto lungo e uso del computer.
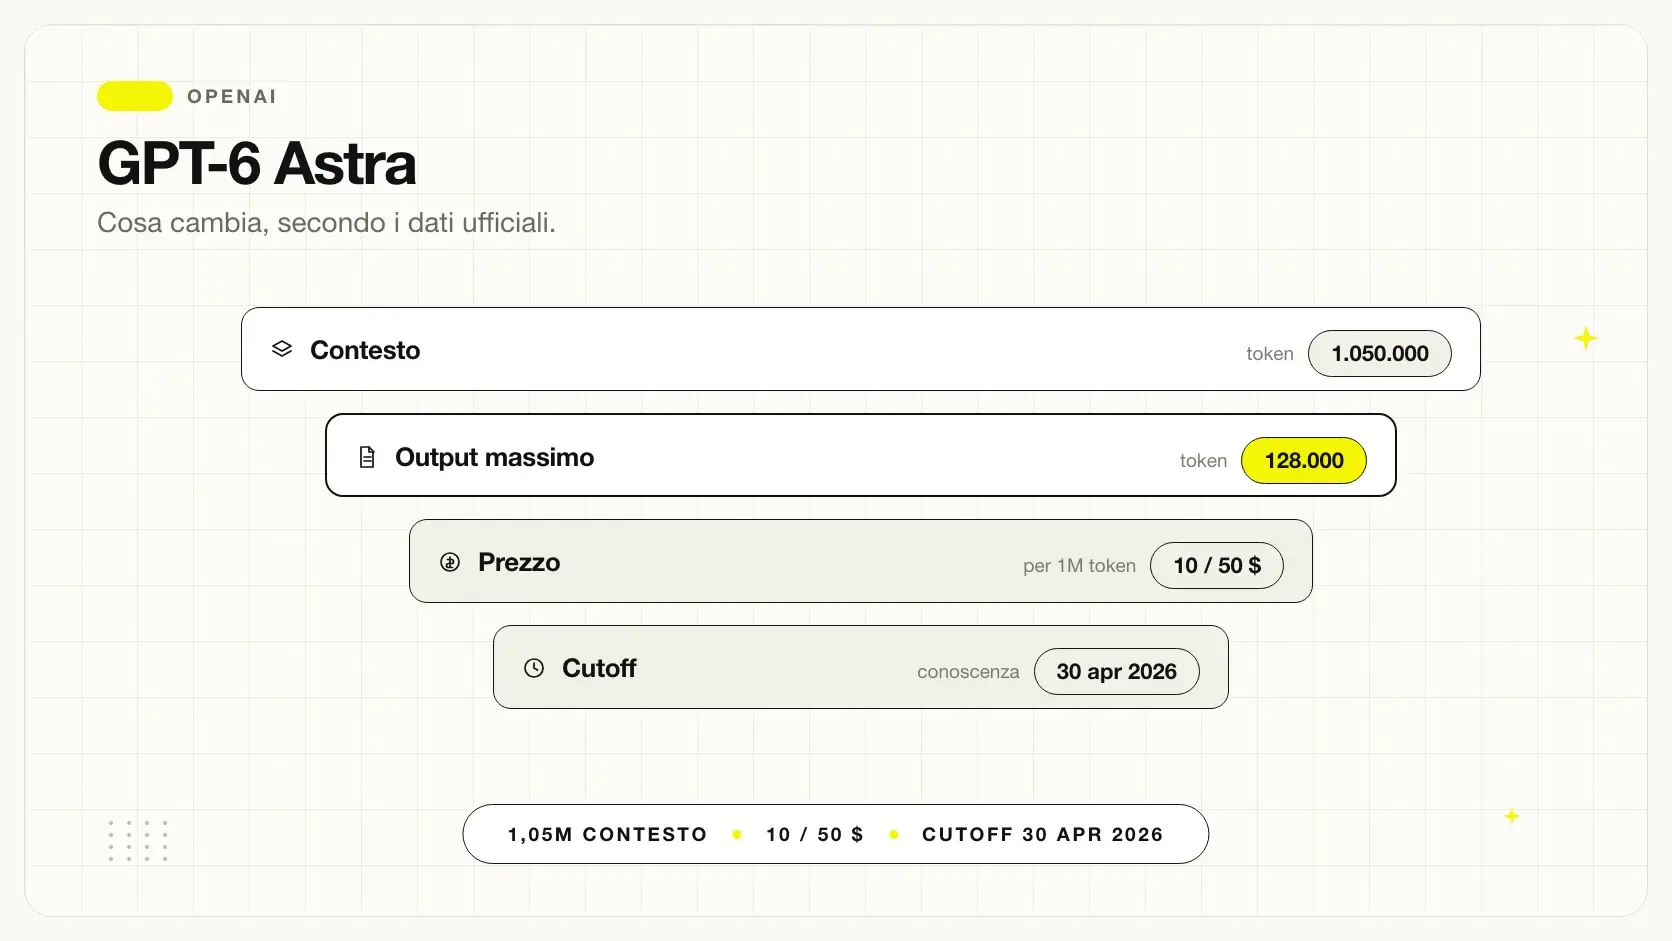
GPT-6 Astra: cos'è il nuovo modello OpenAI e cosa cambiaGPT-6 Astra: cos'è, come si usa e dove non arrivaCos'è GPT-6 Astra: scheda tecnica, come si accede da ChatGPT o API, i benchmark che non vince e i limiti che OpenAI dichiara.
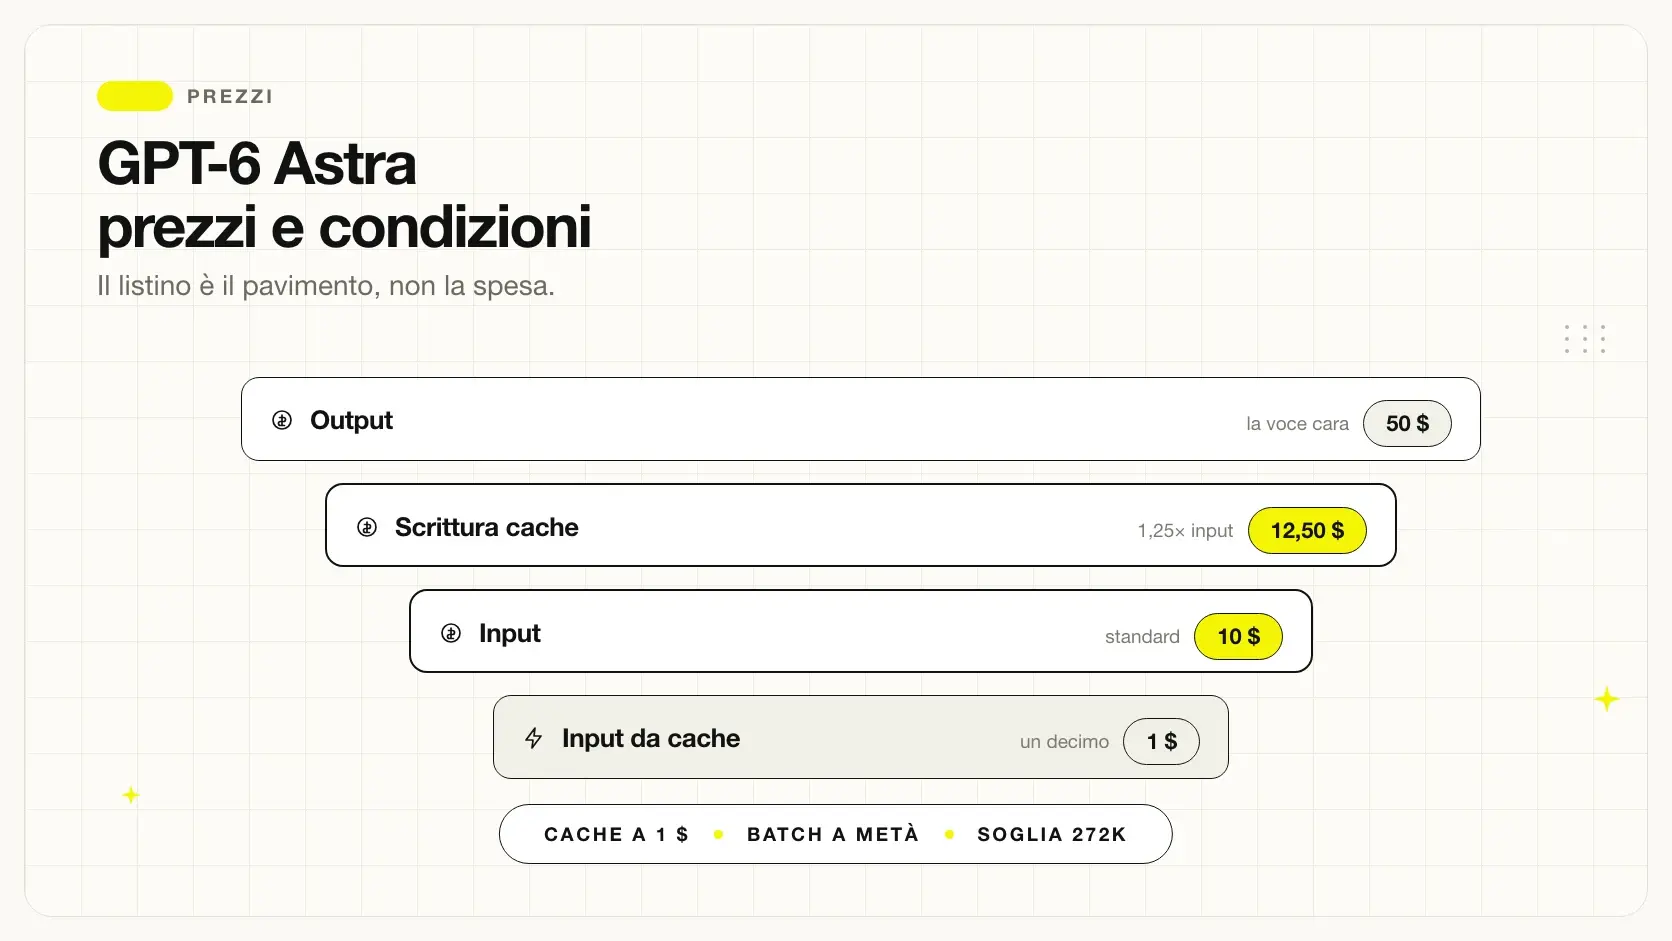
Prezzi ufficiali di GPT-6 Astra per milione di tokenGPT-6 Astra: prezzi, costo reale e quando convieneListino ufficiale di GPT-6 Astra, le voci di costo che il listino non contiene e i casi in cui per un'azienda si giustifica davvero.
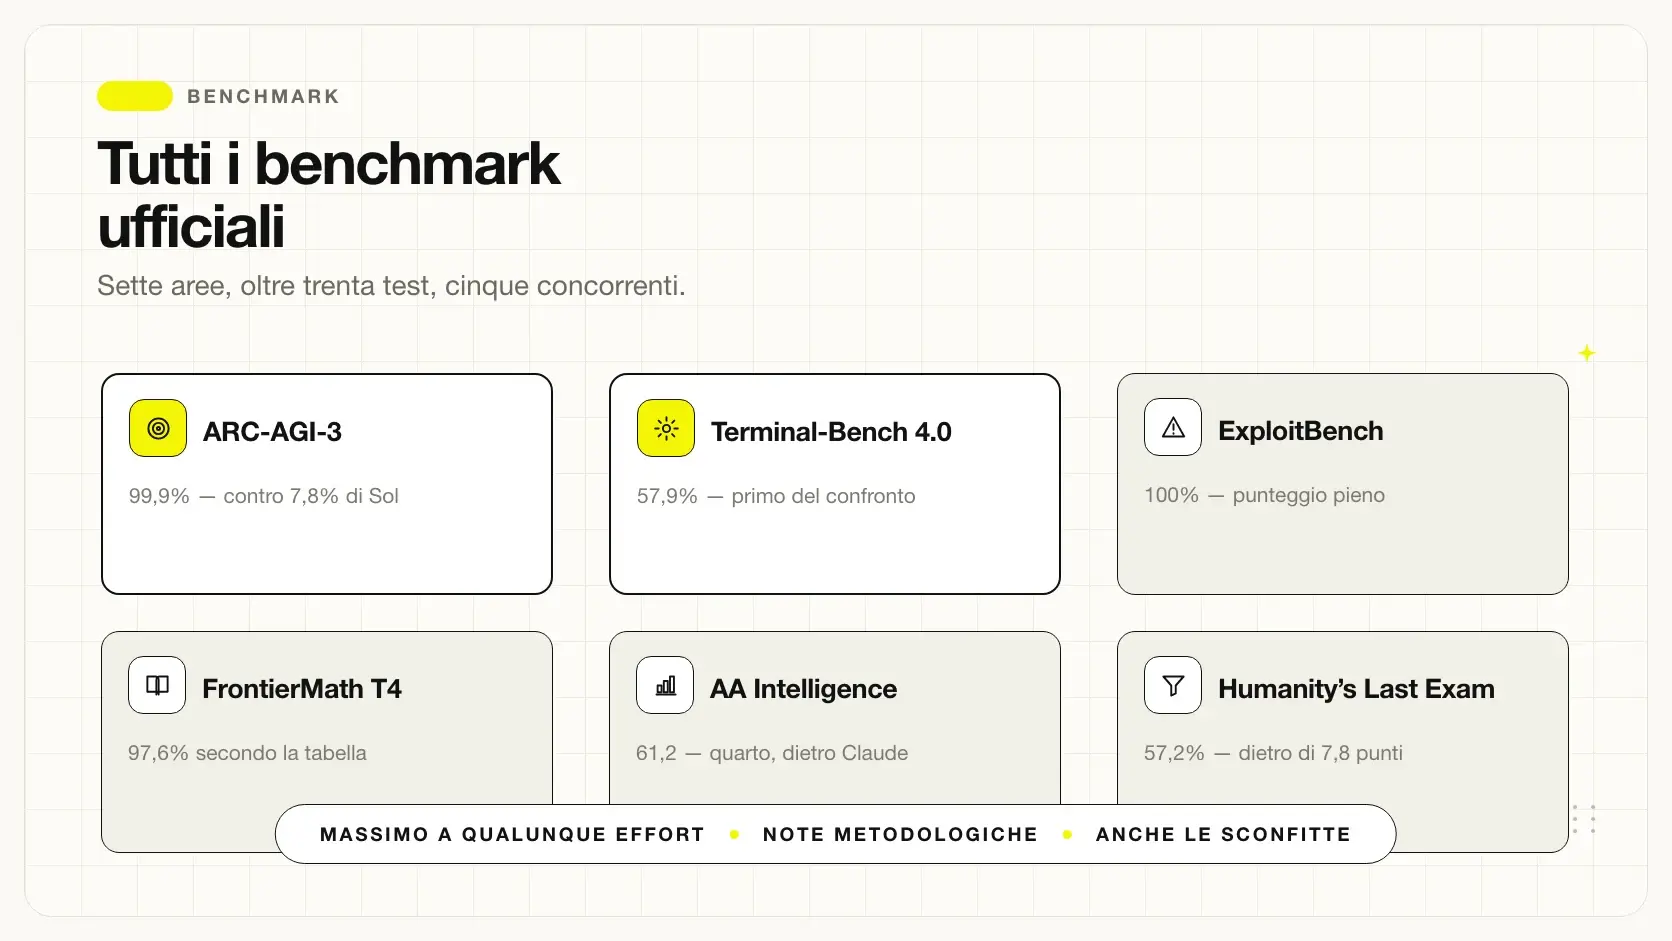
Tutti i benchmark ufficiali di GPT-6 Astra a confrontoGPT-6 Astra: tutti i benchmark ufficialiI benchmark di GPT-6 Astra dalle tabelle ufficiali OpenAI: ragionamento, coding, scienza, cybersecurity, e le note metodologiche da leggere.
Confronto tra i modelli Claude: Opus 5, Fable 5.1, Sonnet 5 e Haiku 4.5Modelli Claude a confronto: quale scegliere e quando cambiareCome scegliere fra i modelli Claude per caso d'uso e budget, quanto si risparmia scendendo di fascia e come cambiare versione senza sorprese.
Confronto fra i modelli AI di Anthropic, OpenAI e GoogleClaude, GPT e Gemini a confrontoConfronto fra i modelli Claude, GPT e Gemini: prezzi ufficiali, contesto, data limite e come leggere un confronto fra fornitori diversi.
Come si leggono i benchmark dei modelli AI e perché i numeri dei vendor non sono confrontabiliCome si leggono i benchmark AICosa dicono davvero i benchmark dei modelli AI, perché i numeri dei vendor non sono confrontabili e come scegliere senza farsi ingannare.
Come scegliere il modello AI giusto in base al proprio caso d'usoIl miglior modello AI dipende dal caso d'usoNon esiste il miglior modello AI in assoluto. Guida per scegliere in base al compito, ai volumi e alla latenza, con una prova pratica.
Confronto dei modelli AI economici di Anthropic, OpenAI e GoogleModelli AI economici a confrontoI modelli AI più economici di Anthropic, OpenAI e Google a confronto: prezzi ufficiali, limiti e quando bastano davvero.
Cos'è il test ARC-AGI e cosa misura nei modelli AIARC-AGI: cos'è e perché se ne parlaCos'è ARC-AGI, il test di ragionamento astratto pensato per resistere alla memorizzazione, e quanto conta per un'azienda.
Confronto tra Claude Fable 5.1 e Claude Sonnet 5 su prezzo e capacitàClaude Fable 5.1 vs Sonnet 5Confronto tra Claude Fable 5.1 e Sonnet 5: cinque volte di differenza di prezzo, stesso contesto. Quando si giustifica.
Confronto fra Claude Haiku 4.5 e i modelli Gemini Flash-LiteClaude Haiku 4.5 vs Gemini Flash-LiteConfronto fra Claude Haiku 4.5 e i modelli Gemini Flash-Lite: prezzi ufficiali, piani di servizio e quando conviene ciascuno.
Confronto fra Claude Haiku 4.5 e GPT-5.6 Luna nella fascia economicaClaude Haiku 4.5 vs GPT-5.6 LunaConfronto fra Claude Haiku 4.5 e GPT-5.6 Luna: cinque volte di differenza in input, contesto e data limite molto diversi.
Confronto tra Claude Opus 5 e Claude Fable 5.1 su prezzo e capacitàClaude Opus 5 vs Fable 5.1Confronto tra Claude Opus 5 e Fable 5.1: prezzi ufficiali, contesto, velocità e criteri concreti per capire quale conviene.
Confronto fra Claude Opus 5 e Gemini 3.1 Pro su prezzo e caratteristicheClaude Opus 5 vs Gemini 3.1 ProConfronto fra Claude Opus 5 e Gemini 3.1 Pro: listini ufficiali, scaglioni di prezzo, piani di servizio e come scegliere.
Confronto fra Claude Opus 5 e GPT-6 Astra su prezzo e caratteristicheClaude Opus 5 vs GPT-6 AstraConfronto fra Claude Opus 5 e GPT-6 Astra: listini ufficiali, contesto, data limite e come scegliere fra i due.
Confronto tra Claude Opus 5 e Claude Sonnet 5 su prezzo e prestazioniClaude Opus 5 vs Sonnet 5Confronto tra Claude Opus 5 e Sonnet 5: prezzi ufficiali, contesto, velocità e quando la differenza di costo si giustifica.
Confronto delle finestre di contesto dei principali modelli AIFinestra di contesto: quanto conta davveroCosa significa 1 milione di token di contesto, quando serve davvero e perché una finestra grande non basta a garantire buone risposte.
Cos'è Frontier-Bench e come misura le capacità degli agenti AIFrontier-Bench: cos'è e cosa misuraCos'è Frontier-Bench, il benchmark di compiti agentici successore di Terminal-Bench, e perché misura la coppia agente più modello.
Confronto fra Gemini 3.6 Flash e Gemini 3.5 FlashGemini 3.6 Flash vs 3.5 FlashConfronto fra Gemini 3.6 Flash e 3.5 Flash: stesso prezzo di input, output più economico sulla versione nuova. Quando conviene passare.
Confronto fra le varianti GPT-5.6 Sol e GPT-5.6 TerraGPT-5.6 Sol vs Terra: quale convieneConfronto fra GPT-5.6 Sol e GPT-5.6 Terra: prezzi ufficiali, differenze e quando la variante più cara si giustifica.
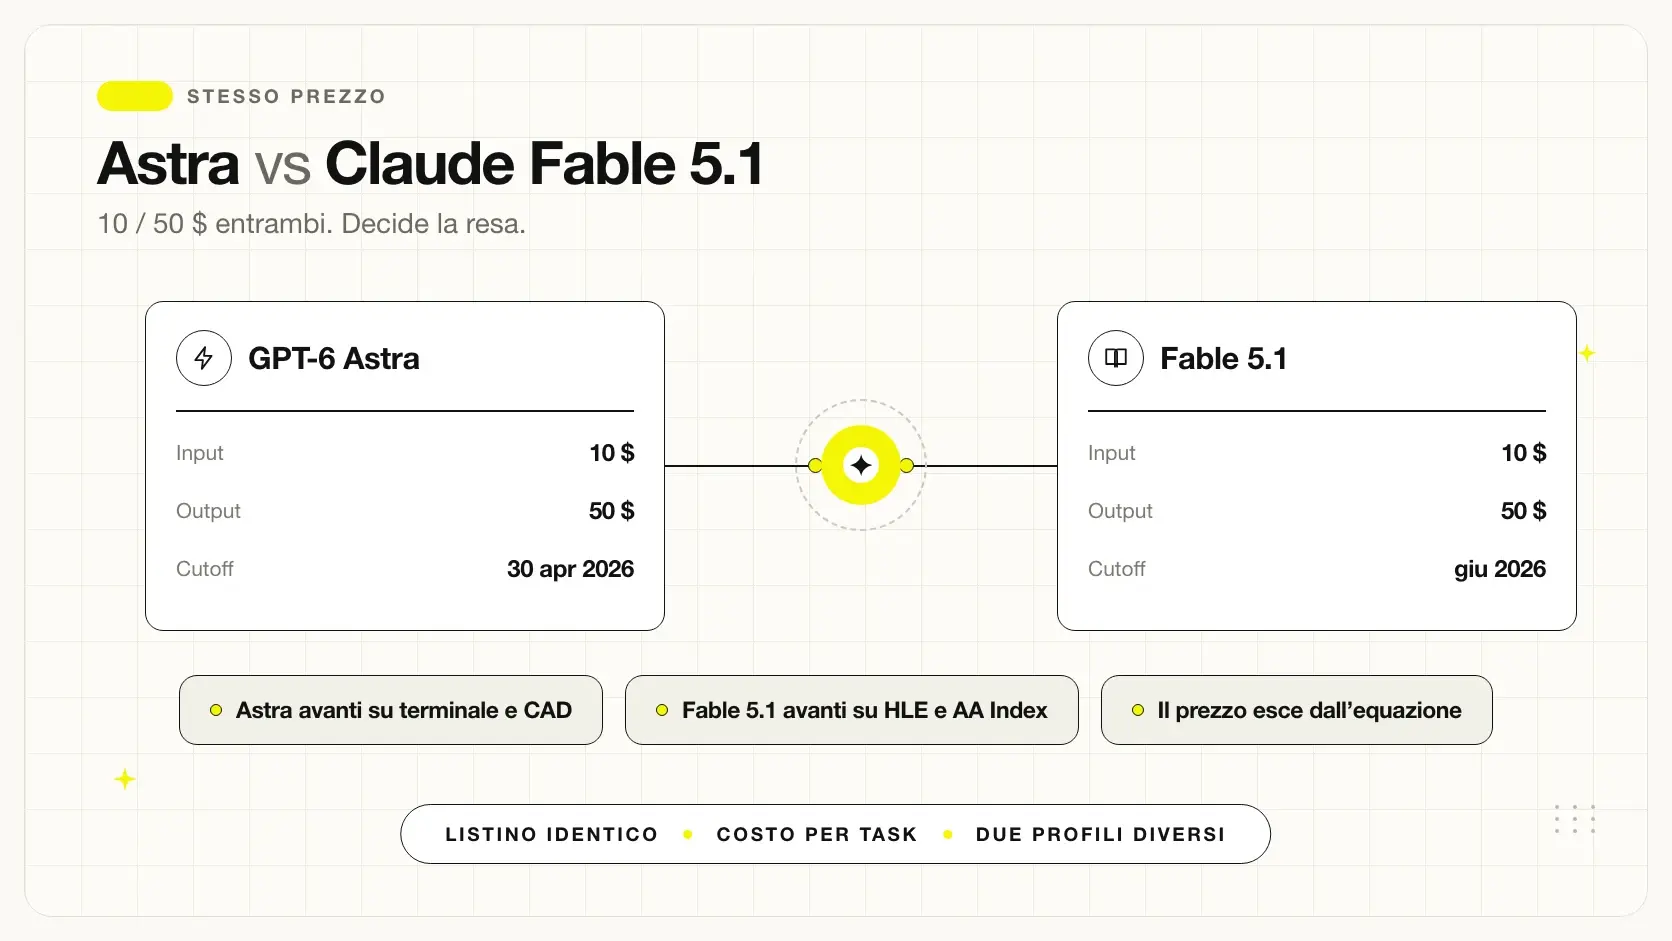
Confronto fra GPT-6 Astra e Claude Fable 5.1, stesso listinoGPT-6 Astra vs Claude Fable 5.1Astra e Fable 5.1 costano identico. Confronto sui benchmark ufficiali: dove vince Astra e dove vince Claude.
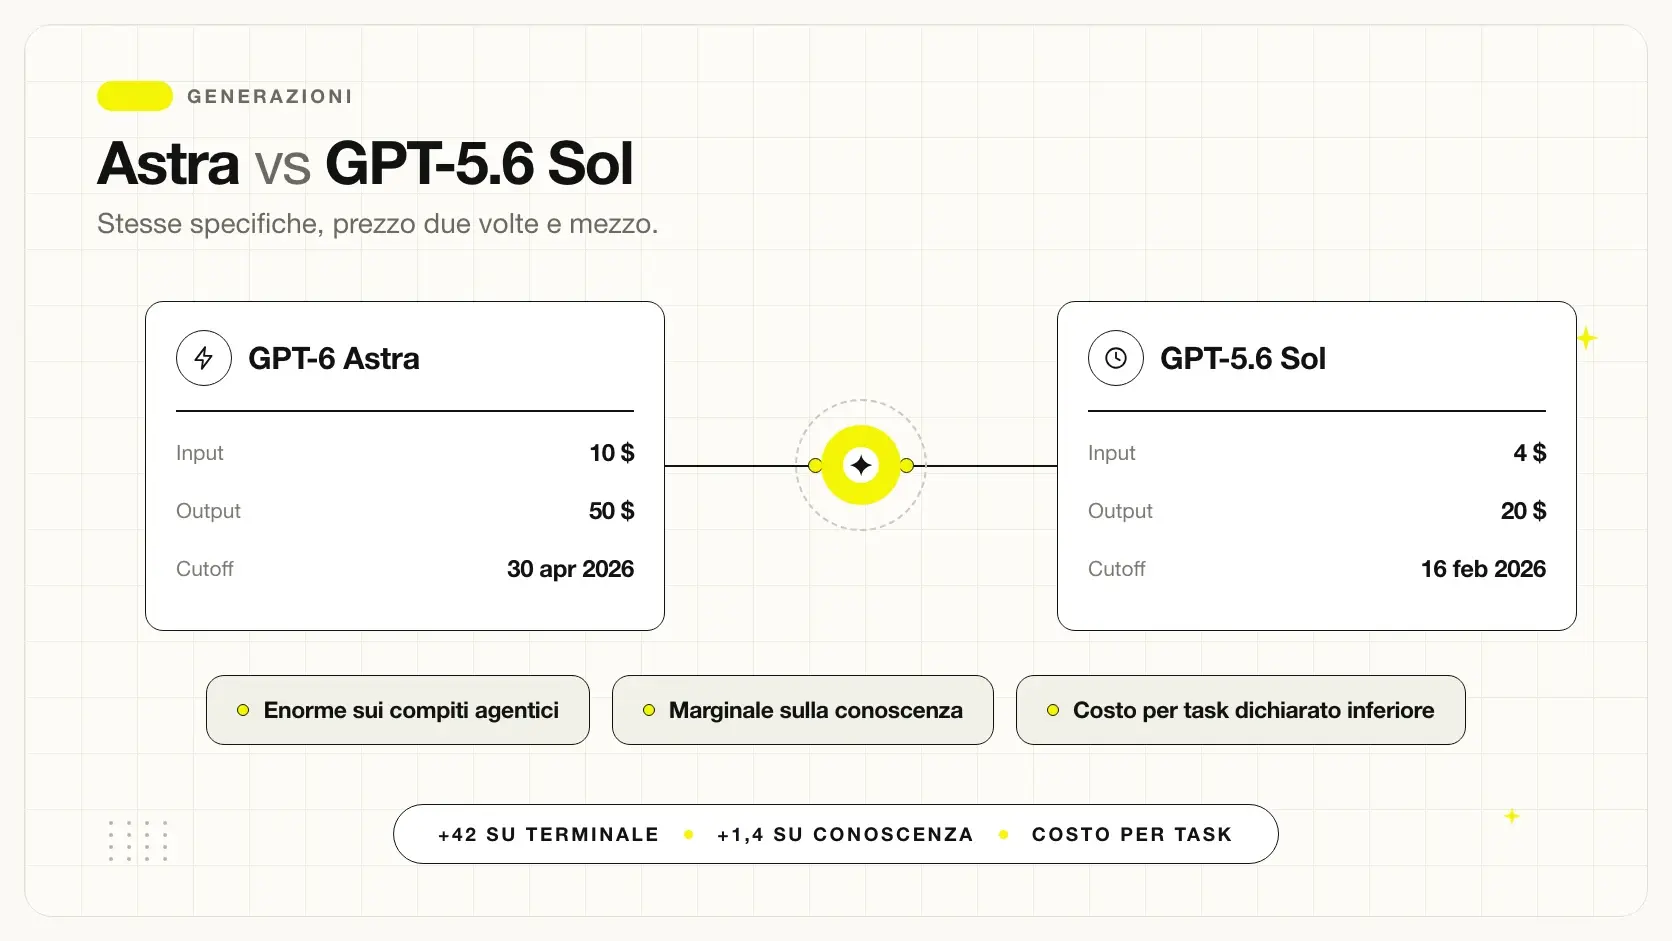
Confronto fra GPT-6 Astra e GPT-5.6 Sol sui benchmark ufficialiGPT-6 Astra vs GPT-5.6 SolConfronto generazionale fra GPT-6 Astra e GPT-5.6 Sol: benchmark ufficiali, prezzi e dove il salto si vede davvero.
Cosa significa il knowledge cutoff dei modelli AI e come influisce sulle risposteKnowledge cutoff: cosa significa in praticaCos'è il knowledge cutoff, perché due modelli della stessa famiglia hanno date diverse e come si lavora con informazioni più recenti.
Come la latenza dei modelli AI influenza la scelta in aziendaLatenza dei modelli AI a confrontoCome la velocità di risposta influenza la scelta del modello AI, quando è critica e come misurarla sui propri casi.
Come scegliere il modello AI giusto per un agente aziendaleMiglior modello AI per agentiCome scegliere il modello per un agente AI che esegue compiti multi-passo: quali benchmark contano e cosa misurare davvero.
Come scegliere il modello AI giusto per l'analisi dei dati aziendaliMiglior modello AI per analisi datiCome scegliere un modello AI per analizzare dati aziendali, e perché il rischio principale è un'analisi plausibile ma sbagliata.
Come scegliere il modello AI giusto per analizzare documenti lunghiMiglior modello AI per documenti lunghiCome scegliere un modello AI per contratti, capitolati e documenti lunghi: finestra di contesto, costi e la trappola del mandare tutto.
Come scegliere il modello AI per estrarre dati dai documenti aziendaliMiglior modello AI per estrarre dati da documentiCome scegliere un modello AI per l'estrazione dati da fatture e documenti: quale fascia serve e la prova che separa i modelli usabili.
Come scegliere il modello AI giusto per l'assistenza clientiMiglior modello AI per il customer careCome scegliere un modello AI per l'assistenza clienti: perché la latenza conta quanto la qualità e cosa il modello deve saper fare.
Come valutare quale modello AI funziona meglio in italianoMiglior modello AI per l'italianoCome capire quale modello AI funziona meglio in italiano: perché i benchmark pubblici non lo dicono e come provarlo in un'ora.
Come scegliere il modello AI migliore per programmareMiglior modello AI per programmareCome scegliere un modello AI per lo sviluppo software: quali benchmark guardare, cosa non misurano e come provarlo sul proprio codice.
Come scegliere un modello AI per lavorazioni ad alto volumeModelli AI per lavori ad alto volumeCome scegliere e progettare un sistema AI che elabora centinaia di migliaia di casi al mese senza far esplodere i costi.
Perché i benchmark pubblicati dai vendor AI non sono confrontabili tra loroPerché i benchmark dei vendor non sono comparabiliAnthropic, OpenAI e Google pubblicano numeri non confrontabili tra loro. Perché succede, cosa cambia nelle misure e come leggerli lo stesso.
Tabella di confronto dei prezzi dei modelli Claude per milione di tokenPrezzi dei modelli Claude a confrontoPrezzi ufficiali dei modelli Claude per milione di token, come calcolare il costo reale e dove si nasconde la spesa vera.
Come funziona il prezzo per milione di token nei modelli AIPrezzo per milione di token spiegatoCosa significa il prezzo per milione di token, quanto è un token, perché l'output costa di più e come stimare la spesa reale.
Come una PMI sceglie il modello AI giusto per i propri processiQuale modello AI conviene a una PMICome una PMI sceglie il modello AI giusto senza competenze tecniche: tre domande, una prova da mezza giornata e gli errori da evitare.
Quali benchmark AI guardare in base al caso d'uso aziendaleQuali benchmark AI contano davveroQuali benchmark guardare in base al tuo caso d'uso: coding, agenti, uso del computer, ragionamento. E quali ignorare.
Come capire quando un modello AI economico è sufficienteQuando basta un modello economicoCome capire se il tuo compito si risolve con un modello AI economico, con una prova pratica da fare in un'ora.
Come decidere quando cambiare il modello AI di un sistema in produzioneQuando conviene cambiare modello AICome capire se vale la pena cambiare modello AI, quando conviene fermarsi e come fare il passaggio senza rompere niente.
Come il livello di reasoning effort cambia risultati e costi di un modello AIReasoning effort: cosa cambia nei confrontiIl livello di ragionamento cambia risultati e costi dello stesso modello AI. Perché un confronto che non lo dichiara è incompleto.
Schema di una strategia AI a due modelli: leggero e potenteStrategia a modello misto: leggero e potenteCome usare un modello leggero e uno potente insieme: criteri di passaggio, verifiche e quanto si risparmia davvero.
Come funzionano SWE-bench e i benchmark di coding per i modelli AISWE-bench e i benchmark di codingCos'è SWE-bench, come funzionano i benchmark di programmazione e cosa dicono davvero sulla capacità di un modello di scrivere codice.

Le altre categorie