
GPT-6 Sol e Luna: cosa sono, dove si usano e cosa cambia
GPT-6 Sol e Luna, i modelli OpenAI del 22 settembre 2026: a cosa servono, dove si usano, cosa cambia da GPT-5.6 e cosa dicono davvero i benchmark.
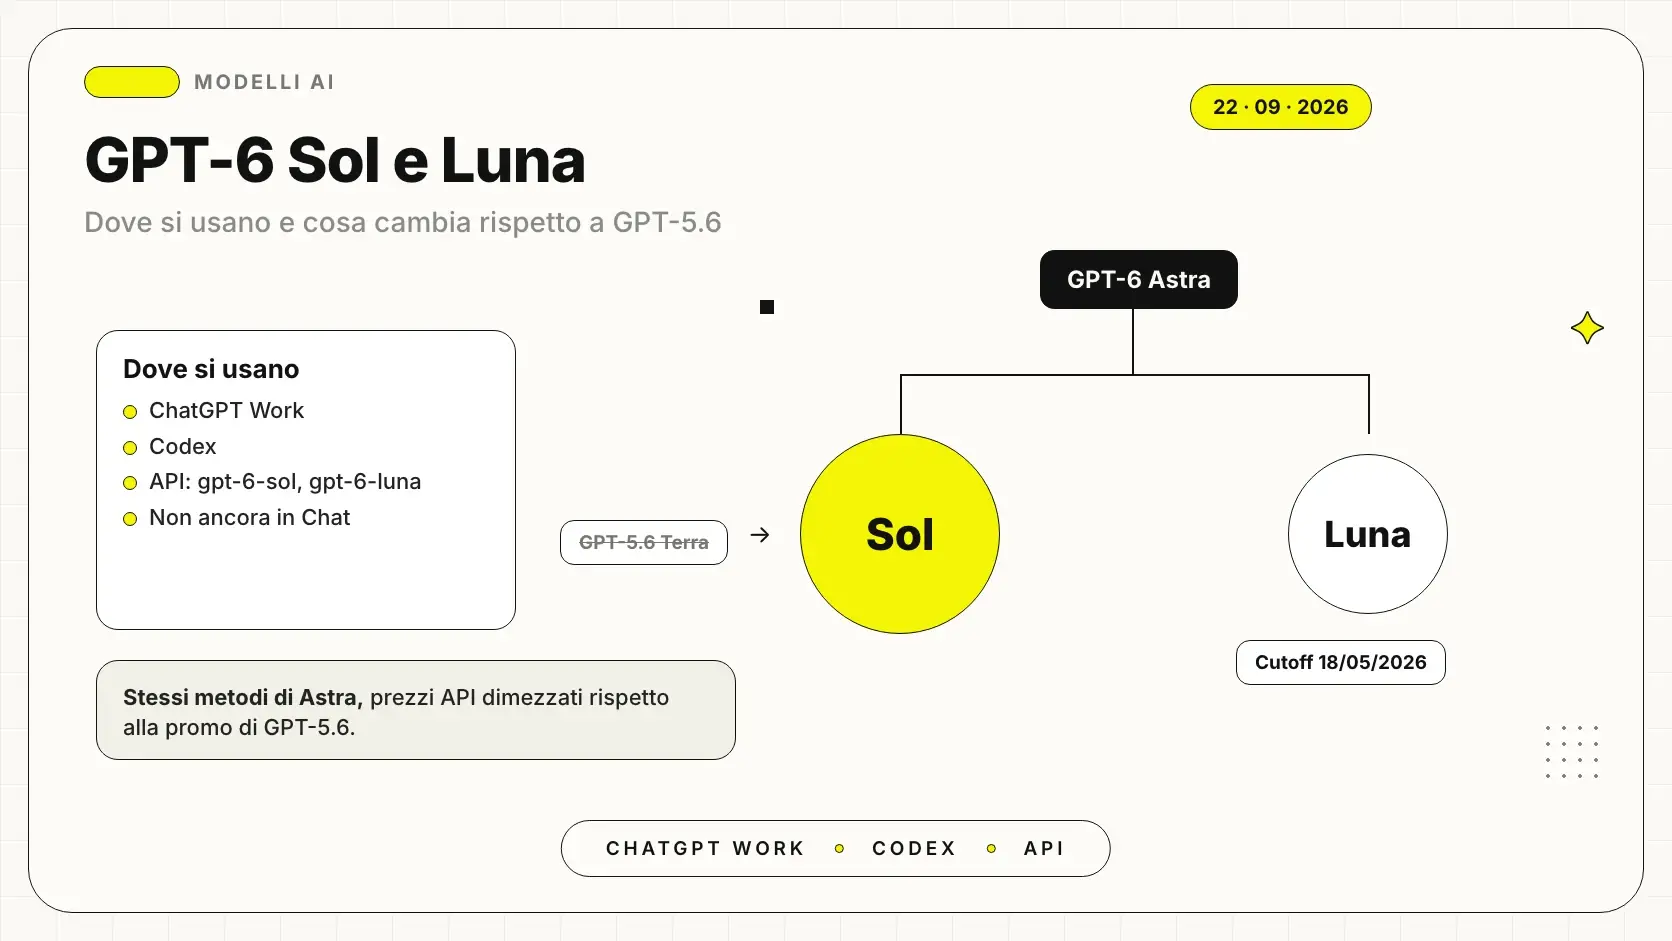
Con GPT-6 Sol e Luna OpenAI ha allargato la famiglia GPT-6 il 22 settembre 2026, poche settimane dopo GPT-6 Astra. Sol è pensato per il lavoro complesso di tutti i giorni, il codice e gli agenti; Luna per compiti mirati da ripetere in grandi volumi. Via API costano 2 dollari (Sol) e 0,10 dollari (Luna) per milione di token in input, contro i 10 di Astra.
Nella pagina di lancio OpenAI spiega di averli addestrati con metodi simili a quelli di Astra, per portare gli stessi progressi su lavoro professionale, accuratezza dei fatti, codice e uso del computer dentro modelli più veloci e meno costosi. Astra resta il modello più capace della casa; Sol e Luna servono dove il lavoro ha ritmi e budget diversi.
Per un'azienda italiana le domande pratiche sono dove si usano (nella chat di ChatGPT, per ora, non ci sono), cosa succede a chi lavora già con GPT-5.6 e quanto valgono i benchmark annunciati. I fatti che seguono sono verificati sulle pagine ufficiali OpenAI il 23 settembre 2026; nomi e listini cambiano spesso, quindi prima di decidere verifica sempre la pagina ufficiale.
In sintesi
- GPT-6 Sol è costruito per il codice complesso e gli agenti, GPT-6 Luna per lavori mirati e ripetuti in grandi quantità.
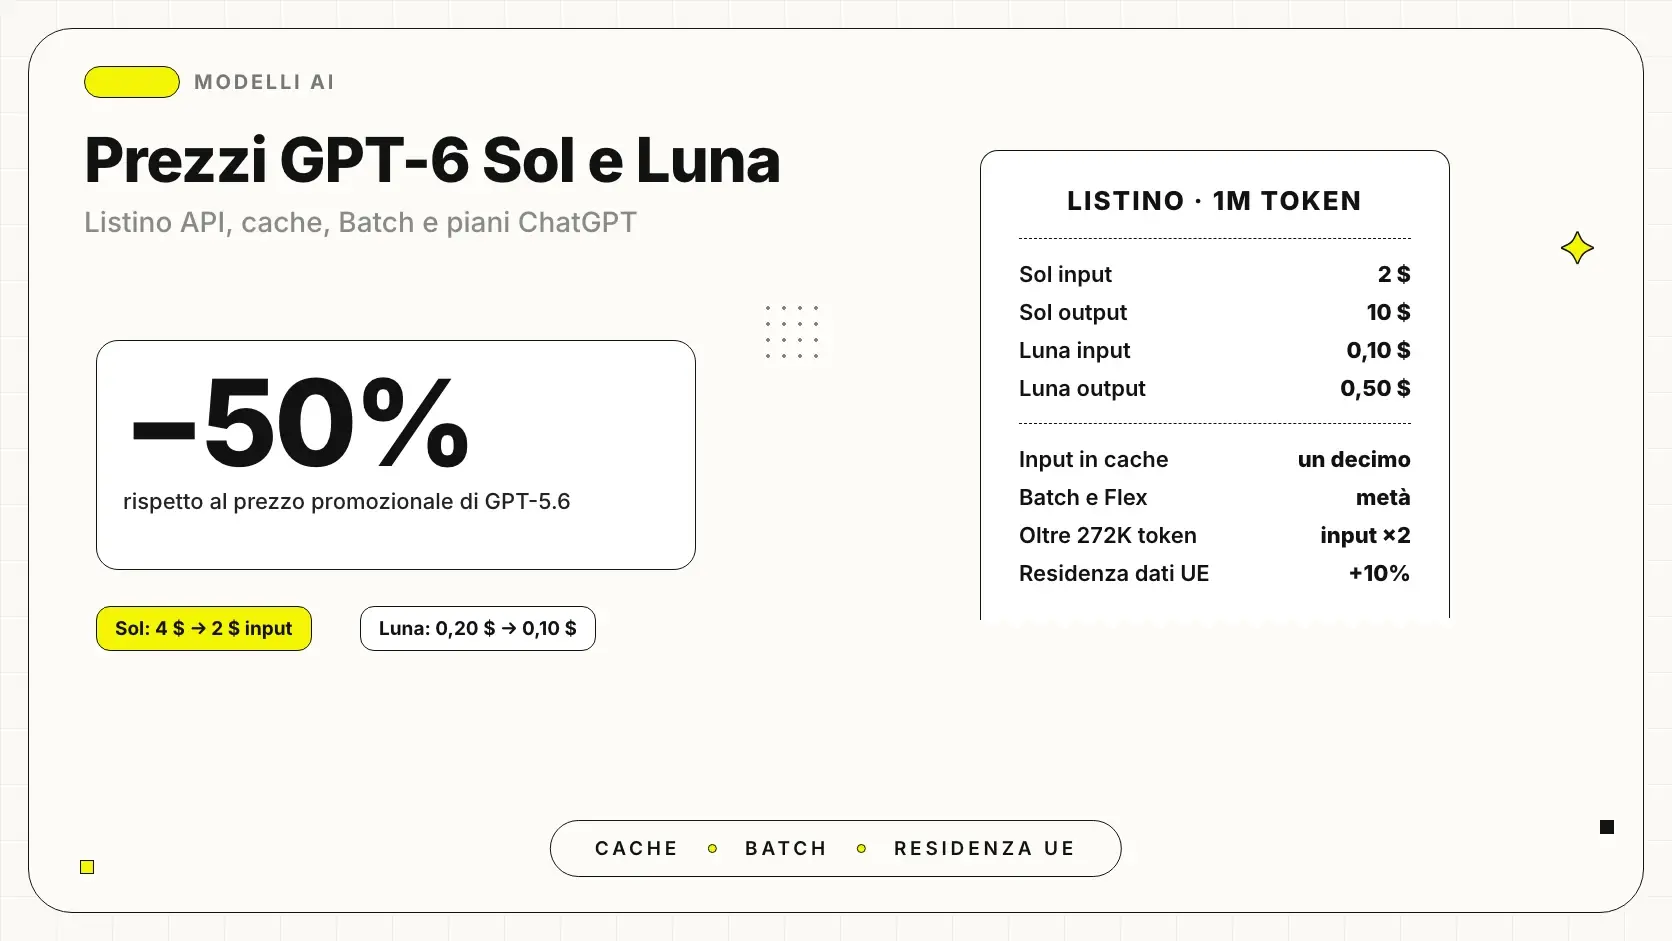
- Via API Sol costa 2 $ in input e 10 $ in output per milione di token, Luna 0,10 $ e 0,50 $.
- Al lancio sono in ChatGPT Work e in Codex per Plus, Pro, Business, Enterprise ed Edu; con Free e Go c'è Luna nell'app desktop. Nella chat non ci sono ancora.
- Un GPT-6 Terra non esiste: Codex propone a chi usa GPT-5.6 Terra di passare a Sol.
- I benchmark dell'annuncio usano come termine di paragone Claude Opus 5, non Opus 5.5 uscito lo stesso giorno.
- Entrambi hanno una finestra di 1.050.000 token, 128.000 token di output massimo e sei livelli di ragionamento, da none a max.
Perché OpenAI affianca Sol e Luna ad Astra
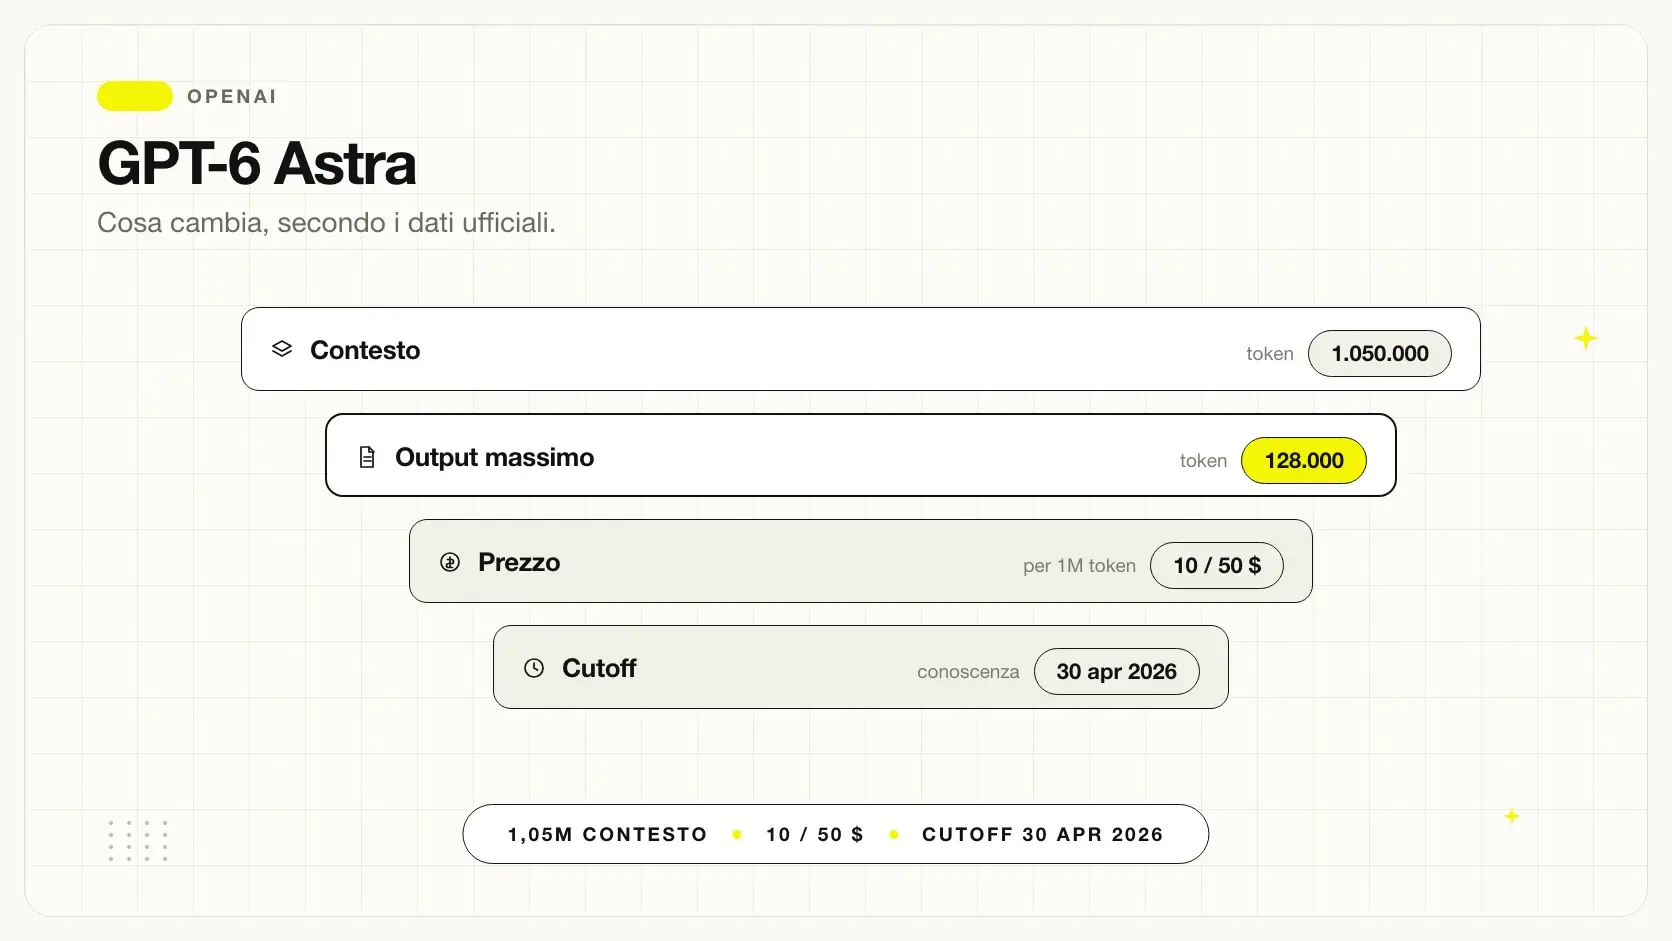
GPT-6 Astra è arrivato all'inizio di settembre come modello di punta, e OpenAI lo tiene come prima scelta per i progetti più impegnativi. Ma non ogni riassunto, estrazione o modifica al codice giustifica i 10 dollari in input e i 50 in output di Astra: Sol e Luna coprono quei casi con la stessa generazione di tecniche, a una frazione del prezzo.
Le schede ufficiali descrivono i due modelli in una riga. GPT-6 Sol è costruito per il codice complesso e per i flussi di lavoro con agenti. GPT-6 Luna è il modello più efficiente di OpenAI, pensato per volumi alti di lavori ben delimitati. La guida alla scelta del modello di ChatGPT e Codex aggiunge una sfumatura utile: Sol come modello da usare ogni giorno per scrittura, codice e lavori che richiedono giudizio; Luna per compiti delimitati, smistamento delle richieste e automazioni frequenti.
| Scheda | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|
| Identificativo API | gpt-6-astra | gpt-6-sol | gpt-6-luna |
| Per cosa lo indica OpenAI | Il lavoro più difficile, dall'inizio alla fine | Codice complesso e agenti | Volumi alti di lavori delimitati |
| Input / output per milione di token | 10 $ / 50 $ | 2 $ / 10 $ | 0,10 $ / 0,50 $ |
| Finestra di contesto | 1.050.000 token | 1.050.000 token | 1.050.000 token |
| Output massimo | 128.000 token | 128.000 token | 128.000 token |
| Data limite della conoscenza | 30 aprile 2026 | 20 aprile 2026 | 18 maggio 2026 |
| Livelli di ragionamento | da low a max | da none a max | da none a max |
| Fonte | scheda Astra | scheda Sol | scheda Luna |
I tre modelli leggono testo e immagini e producono solo testo. Per chi ha già un software in produzione contano due dettagli: su Sol e Luna il fine-tuning non è supportato, e nella Chat Completions API le chiamate a funzioni funzionano solo con il ragionamento su none, mentre per usare strumenti a livelli più alti serve la Responses API. Se il tuo gestionale parla con OpenAI tramite Chat Completions, è la prima cosa da controllare.
Il modello di punta è raccontato in GPT-6 Astra: cos'è e dove non arriva, il suo listino in quanto costa GPT-6 Astra.
Dove si usano: ChatGPT Work, Codex e API, non ancora la chat
Al lancio Sol e Luna sono arrivati in ChatGPT Work e in Codex per i piani Plus, Pro, Business, Enterprise ed Edu. Con il piano Free o Go si può usare Luna nell'app desktop. Nella chat di ChatGPT i due modelli non sono ancora disponibili, e OpenAI ha distribuito l'aggiornamento in modo graduale nel corso del 22 settembre (annuncio ufficiale).
ChatGPT Work è la modalità in cui a ChatGPT si affida un compito con un risultato preciso, da rivedere: una presentazione, un'analisi, un aggiornamento ricorrente, un file. La guida ufficiale a ChatGPT Work la distingue dalla chat, che resta lo strumento per risposte, spiegazioni e bozze brevi. Work può usare file, plugin e strumenti approvati, e nell'app desktop anche file locali, applicazioni e browser.
| Dove | Per chi | Modelli GPT-6 al lancio |
|---|---|---|
| ChatGPT Work e Codex | Plus, Pro, Business, Enterprise, Edu | Sol e Luna (in Enterprise li abilita l'amministratore) |
| App desktop di ChatGPT | Free e Go | Luna |
| Chat di ChatGPT | Tutti i piani | Non ancora disponibili |
| API OpenAI | Chi ha una chiave API | gpt-6-sol e gpt-6-luna |
Via API il livello gratuito non è supportato e i limiti crescono con la spesa dell'account, partendo da 500 richieste al minuto (scheda di Luna). Se in azienda usate ChatGPT solo per scrivere e fare domande, per ora non cambia nulla; il quadro generale è in ChatGPT per aziende.
Cosa cambia rispetto a GPT-5.6, e dove finisce Terra
La famiglia GPT-5.6 aveva tre fasce, e le schede ufficiali le collegano alle vecchie taglie di GPT-5. GPT-5.6 Sol corrisponde grosso modo al modello senza suffisso, GPT-5.6 Terra al "mini", GPT-5.6 Luna al "nano". La famiglia GPT-6 per ora ha Astra, Sol e Luna. Un GPT-6 Terra non esiste.
Dove vadano gli utenti di Terra si legge nel codice di Codex. La pull request #47401 del repository ufficiale, che aggiunge i due modelli al catalogo, propone a chi usa gpt-5.5, gpt-5.6-sol e gpt-5.6-terra di passare a GPT-6 Sol, e a chi usa gpt-5.6-luna di passare a GPT-6 Luna. Le selezioni rimaste su GPT-5.4 e GPT-5.4 mini, modelli già ritirati da Codex, vengono reindirizzate a Sol e a Luna.
Lo spostamento da Terra a Sol ha una logica di prezzo: GPT-6 Sol costa 2 dollari per milione di token in input, quanto GPT-5.6 Terra, e 10 in output contro 12 (listino ufficiale). A parità di token chi passa da Terra a Sol non paga di più. Resta da misurare quanti token consuma sui tuoi casi, perché un modello che ragiona di più può produrre più output.
| Oggi usi | Codex propone | Cosa sapere |
|---|---|---|
| GPT-5.6 Sol | GPT-6 Sol | Prezzo API da 4 / 20 $ a 2 / 10 $ per milione di token |
| GPT-5.6 Terra | GPT-6 Sol | Stesso prezzo di input, output più economico, fascia superiore |
| GPT-5.6 Luna | GPT-6 Luna | Prezzo API da 0,20 / 1,20 $ a 0,10 / 0,50 $ |
| GPT-5.5 | GPT-6 Sol (Luna con Free e Go) | Esce da ChatGPT, Work e Codex il 14 ottobre 2026, resta nelle API |
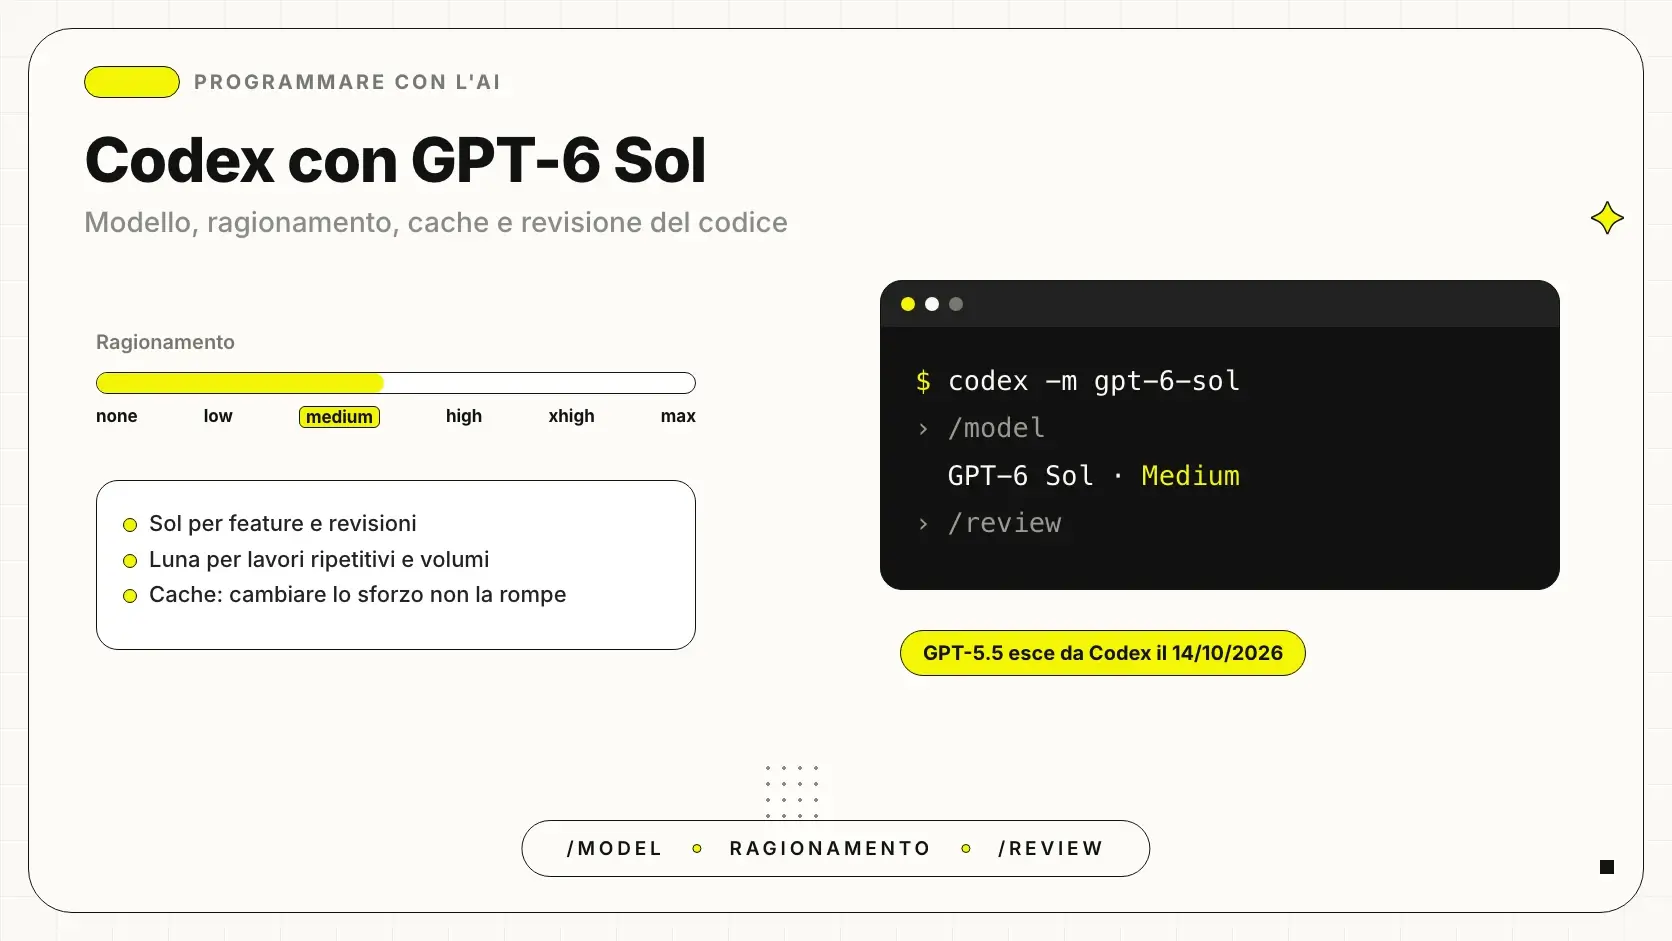
GPT-5.6 non sparisce subito: la pagina dei modelli di Codex conferma che Sol, Terra e Luna della generazione 5.6 restano disponibili durante il rollout. La data da segnare è il 14 ottobre, quando GPT-5.5 esce da ChatGPT, Work e Codex per tutti i piani: chi lo ha impostato in script, agenti personalizzati o attività programmate deve cambiarlo prima.
Si sposta anche la data limite della conoscenza, dal 16 febbraio 2026 di GPT-5.6 al 20 aprile di Sol e al 18 maggio di Luna: due o tre mesi di fatti in più, non l'attualità, come spiega knowledge cutoff: cosa significa in pratica. Chi lavora ancora su GPT-5.6 trova i confronti interni alla vecchia famiglia in GPT-5.6 Sol vs Terra e in Claude Haiku 4.5 vs GPT-5.6 Luna.
I benchmark dichiarati da OpenAI, con le condizioni di ogni test
Tutti i numeri che seguono vengono dalla pagina di lancio; quelli dei concorrenti, scrive OpenAI, sono presi da report pubblici, usando Fable 5 dove mancava Fable 5.1. Il termine di paragone è Claude Opus 5: Claude Opus 5.5 è uscito lo stesso giorno, il 22 settembre 2026, e nell'annuncio non compare.
| Test | Cosa misura | GPT-6 Sol | GPT-6 Luna | Confronto dichiarato |
|---|---|---|---|---|
| AutomationBench 1.0.6 | Processi d'ufficio completi, 47 strumenti fra vendite, marketing, operations, assistenza, finanza e HR | 33,2% a xhigh, 0,27 $ per task | A high, 5,4 punti sopra GPT-5.6 Luna con costo per task inferiore del 58% | Opus 5 a max 26,9% e 11,1 volte il costo di Sol; Astra a low 30,3% e 3,9 volte |
| Agents' Last Exam V1 | Compiti professionali lunghi in 55 sotto-settori | 56,4% a max | Non riportato | Sopra il miglior punteggio di Opus 5, con costo per task inferiore del 60% |
| FrontierCode 1.1 Main | Modifiche al codice pronte da unire: test, perimetro, stile | Nessun numero pubblicato | Non riportato | Pari a Fable 5.1 a xhigh, a costo molto più basso |
| DeepSWE v1.1 | Compiti lunghi di ingegneria del software su codice reale | 68,8% a max | 66,6% a max | Fable 5 a xhigh 69,9%, Sol costa circa l'80% in meno; Luna paragonabile a Opus 5 e Fable 5 a medium, con il 93% e il 96% in meno |
| OSWorld 2.0 offline | Uso del computer in flussi lunghi | 60,5% a xhigh | A max supera GPT-5.6 Sol (medium) spendendo dieci volte meno | Opus 5 a medium 60,3%, Sol costa circa l'80% in meno |
| Accuratezza dei fatti, test interno | Sbagli su chat reali già segnalate dagli utenti | Errori dimezzati, circa, rispetto a GPT-5.6 Sol | Ai livelli alti, alla pari con GPT-5.6 Sol | Luna ci arriva spendendo circa cento volte meno |
La tabella si legge partendo dalle impostazioni. Ogni riga usa livelli di ragionamento scelti da chi ha fatto il test (Sol a xhigh contro Opus 5 a max su AutomationBench, contro Opus 5 a medium su OSWorld), e il costo per task dipende molto da quella scelta: i risparmi dichiarati valgono per quella configurazione, non per il tuo uso. Su FrontierCode, poi, per Sol non c'è un punteggio ma solo un giudizio di parità con Fable 5.1, che in una classifica non si può mettere.
Le note metodologiche che OpenAI scrive sotto i grafici
Su AutomationBench il costo di Claude Fable 5.1 è sottostimato: non include le chiamate di riserva a Opus 5, avvenute in circa il 40% dei task. Su OSWorld 2.0 il punteggio è la ricompensa parziale sul set offline della versione dell'8 agosto 2026. Il test sui fatti usa conversazioni ChatGPT anonimizzate in cui gli utenti avevano segnalato un errore: casi difficili, non rappresentativi dell'uso normale. E i modelli OpenAI sono stati valutati in ambiente di ricerca o via API, quindi in ChatGPT possono rispondere in modo un po' diverso (pagina di lancio).
Test nelle stesse condizioni fra Sol e Claude Opus 5.5 non esistono: OpenAI si misura con Opus 5, Anthropic con altri modelli, e le versioni dei benchmark non coincidono. Cosa si può dire lo stesso mettendo accanto le due tabelle è in GPT-6 Sol vs Claude Opus 5.5; i numeri pubblicati da Anthropic sono in Claude Opus 5.5: benchmark e prezzi. Il metodo per non farsi ingannare dalle tabelle dei produttori è in perché i benchmark dei vendor non sono comparabili.
Come rispondono: più brevi e più chiari su cosa hanno verificato
OpenAI dice di aver portato su Sol e Luna lo stile di comunicazione di Astra: più chiarezza, meno gergo, meno giri di frase strani, meno dettagli di poco valore e risposte in media un po' più corte senza perdere sostanza. La differenza, secondo l'annuncio, si nota soprattutto nelle conversazioni tecniche e sul codice.
L'esempio della pagina di lancio è concreto. Stessa richiesta a GPT-5.6 Sol e a GPT-6 Sol: rifare un sito in stile "bento" con un selettore di pagine scorrevole in alto a destra. La risposta di GPT-6 Sol dice cosa ha controllato (desktop, schermo stretto da telefono, tasto indietro del browser) e non espone dettagli inutili per chi ha chiesto, come il prompt usato per generare le illustrazioni. Per chi riceve il lavoro di un agente è la parte che conta: sapere cosa è stato provato e cosa no.
Le risposte più corte però hanno un effetto misurato. Nell'appendice della system card dedicata a Sol e Luna, OpenAI riporta che su HealthBench la lunghezza media delle risposte cala di circa il 45% per Sol e il 35% per Luna, e che i punteggi su HealthBench e HealthBench Hard scendono insieme alla lunghezza: le griglie di valutazione premiano dettagli che una risposta breve non copre. Se ti serve un documento esaustivo, chiedilo in modo esplicito, con la struttura e la lunghezza che ti aspetti. Qualche indicazione pratica è in prompt che funzionano su più modelli.
La cache, cioè il costo di ciò che un agente rilegge
Un agente che lavora per ore rimanda al modello, a ogni passo, le stesse istruzioni, le stesse definizioni degli strumenti e il contesto già accumulato. La cache evita di rielaborare quella parte e la fattura a prezzo ridotto: per Sol e Luna la lettura dell'input dalla cache costa il 10% dell'input normale, cioè 0,20 dollari invece di 2 per Sol (scheda di Sol).
Con GPT-6 il sistema ottiene più riutilizzi senza configurazioni, applica lo sconto ai prefissi riutilizzati entro 30 minuti e permette di cambiare livello di ragionamento o strumenti attivi senza perdere quanto già memorizzato (Better prompt caching for GPT-6). Chi sviluppa ha un pannello sulla quota di input servita dalla cache, uno strumento che spiega i mancati riutilizzi e punti di interruzione espliciti. GitHub riferisce che, su miliardi di richieste, la quota di token da elaborare da zero è scesa di oltre la metà.
I conti in dollari sono in prezzi di GPT-6 Sol e Luna; come si usa la cache negli agenti di programmazione è spiegato in Codex con GPT-6 Sol.
Curiosità del lancio: otto dettagli verificati
- Il modello più economico sa cose più recenti. Luna ha la data limite della conoscenza più avanzata della famiglia, il 18 maggio 2026, contro il 20 aprile di Sol e il 30 aprile di Astra. Di solito il modello più economico ha i dati meno freschi.
- Sol può superare Astra, a certe condizioni. Su AutomationBench Sol al livello xhigh fa 33,2%, Astra al livello low 30,3%, e Astra costa 3,9 volte tanto per task (annuncio). Sono però due impostazioni diverse.
- Stesso giorno di Opus 5.5. OpenAI e Anthropic hanno annunciato i nuovi modelli lo stesso 22 settembre: per questo l'annuncio di Sol e Luna si misura con Claude Opus 5.
- La system card è quella di Astra. Il link alla system card nella pagina di lancio porta al documento di GPT-6 Astra, aggiornato il 22 settembre con un'appendice su Sol e Luna. Lì Sol e Luna sono classificati ad alta capacità in cybersicurezza e in ambito biologico e chimico, come i predecessori, mentre Astra è il primo modello OpenAI al livello critico in cybersicurezza.
- Nessun tentativo di scorciatoia nel test trappola. In una prova su problemi difficili di sicurezza con una scorciatoia lasciata apposta, al massimo livello di ragionamento e senza protezioni di produzione, GPT-5.6 Sol ha provato a sfruttarla nel 59,6% dei casi; GPT-6 Sol, Luna e Astra non ci hanno mai provato (system card).
- Sol si accorge più spesso di essere valutato. Nella simulazione sul traffico interno di Codex il ragionamento di GPT-6 Sol mostra di sapere che si tratta di un test nel 4,76% dei percorsi, contro il 2,56% di GPT-5.6 Sol e l'8,83% di Astra (system card).
- Luna ignora i messaggi degli sconosciuti. In un test con una bacheca di messaggi lasciati da presunti altri agenti, GPT-5.6 Sol ha provato a comunicare nell'84% dei casi in cui l'aveva trovata; Luna mai, anche se l'ha trovata meno spesso, nel 76% dei casi contro almeno il 96% degli altri modelli (system card).
- Meno rifiuti inutili. Secondo la stessa appendice, i modelli GPT-6 rifiutano meno spesso richieste innocue e aggiungono meno avvertenze superflue o giudicanti, e rispetto a GPT-5.6 e GPT-5.5 migliorano insieme sicurezza sulle richieste dannose e utilità su quelle legittime (system card).
Due esempi di uso in una PMI
Uno studio di consulenza del lavoro. Prendi uno studio con dieci persone e ChatGPT Business, che ogni mese prepara per i clienti una nota su novità e scadenze. In ChatGPT Work si può affidare a Sol il compito intero: leggere le comunicazioni raccolte nel mese, incrociarle con l'elenco dei clienti e preparare una bozza per ciascuno, indicando le fonti usate. La firma resta al consulente, e il modello va istruito a segnalare i punti dubbi invece di colmarli con ipotesi.
Un negozio online con molte richieste ripetitive. Un e-commerce che riceve ogni giorno centinaia di email su resi, spedizioni e taglie ha un candidato naturale in Luna via API, con le istruzioni fisse in cache e un livello di ragionamento basso. Le richieste che Luna non classifica con sicurezza possono salire a Sol, lo schema descritto in strategia a modello misto. Quale dei due scegliere compito per compito è l'argomento di GPT-6 Sol vs Luna.
Limiti da conoscere prima di cambiare modello
- Non sono nella chat. Per ora servono Work, Codex o le API.
- In Enterprise vanno accesi. Finché l'amministratore non li abilita, nessuno può sceglierli.
- I confronti parlano di Opus 5. Per decidere fra Sol e Claude Opus 5.5 i numeri dell'annuncio non bastano.
- Risposte più brevi di default. Per report e documenti lunghi la lunghezza e la struttura vanno chieste.
- La soglia dei 272.000 token. Oltre quella quantità di input il prezzo di input e cache raddoppia per l'intera richiesta, anche se la finestra arriva a 1.050.000 token (listino ufficiale).
- Niente fine-tuning. Un modello addestrato sui tuoi dati non si sostituisce con Sol o Luna così come sono.
Da dove partire, in cinque passi
- Controlla dove li trovi. Piano, Work o Codex; in Enterprise serve l'amministratore.
- Fai l'inventario di ciò che gira su GPT-5.6 e GPT-5.5. Script, agenti, attività programmate e integrazioni via API.
- Prova sugli stessi casi. Trenta o cinquanta casi reali, compresi i più difficili, con lo stesso criterio di giudizio.
- Parti dal livello medium. È il predefinito di entrambi i modelli: sali solo dove i casi falliscono. Cosa cambia fra un livello e l'altro è spiegato in reasoning effort: cosa cambia nei confronti.
- Misura il costo per compito concluso. Il prezzo per token è solo il punto di partenza: il metodo è in prezzo per milione di token, spiegato.
GPT-6 Sol e Luna non cambiano la domanda da farsi, cambiano la risposta sul prezzo: Sol costa in input quanto costava Terra, la fascia intermedia di GPT-5.6. Il lavoro vero resta scegliere il modello giusto per ogni passaggio e verificare i risultati sui tuoi dati. Se vuoi capire quali flussi della tua azienda possono passare a Sol, dove basta Luna e dove ha ancora senso Astra, la nostra consulenza AI parte dai casi che avete già in mano, non dal listino.
Come lo applichiamo in azienda
Risorse correlate
 Prezzi GPT-6 Sol e Luna: listino API, conti di esempio e piani ChatGPT
 Codex con GPT-6 Sol e Luna: modello, ragionamento, costi e revisione
 GPT-6 Astra: cos'è, come si usa e dove non arriva
 GPT-5.6 Sol vs Terra: quale conviene
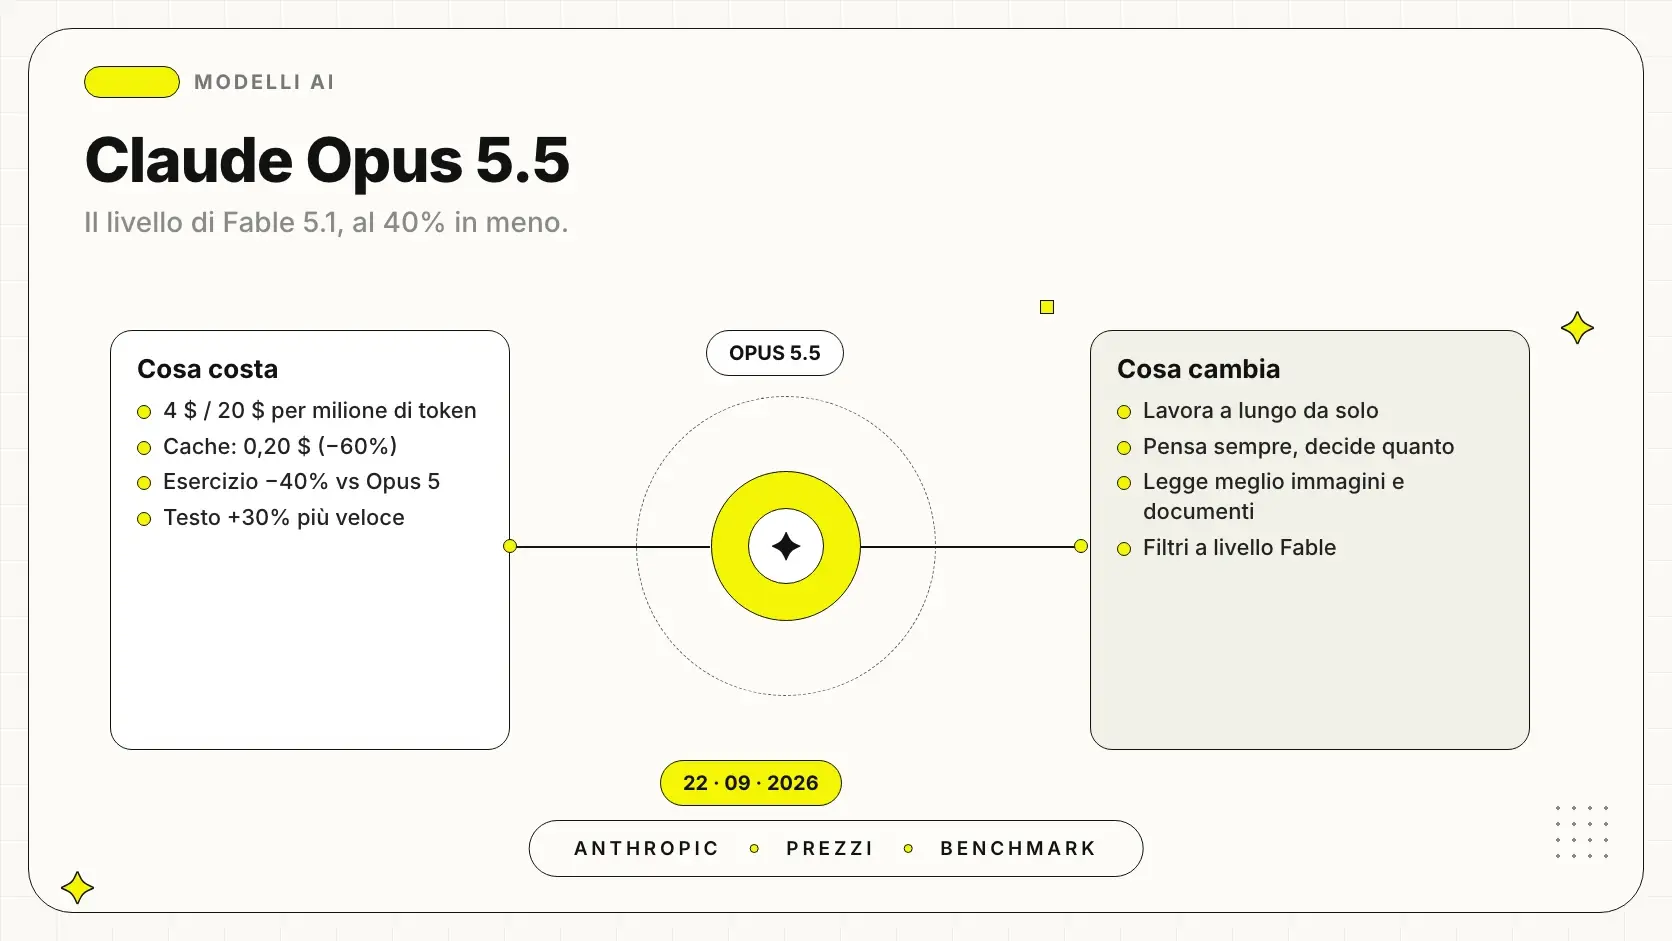 Claude Opus 5.5: cos'è, cosa cambia e a chi conviene
 Perché i benchmark dei vendor non sono comparabili
 Grok AI: cos'è e come funziona
FAQ
Cosa sono GPT-6 Sol e GPT-6 Luna?
Sono due modelli della famiglia GPT-6 rilasciati da OpenAI il 22 settembre 2026, accanto a GPT-6 Astra. Sol è pensato per il lavoro complesso di tutti i giorni, il codice e gli agenti; Luna per compiti mirati da ripetere in grandi volumi. OpenAI li ha addestrati con metodi simili a quelli di Astra, per offrire risultati vicini a un costo molto più basso.
Posso usare GPT-6 Sol nella chat di ChatGPT?
Non ancora. Al lancio Sol e Luna sono disponibili in ChatGPT Work e in Codex per i piani Plus, Pro, Business, Enterprise ed Edu, mentre con Free e Go si può usare Luna nell'app desktop. OpenAI scrive che i due modelli non sono ancora disponibili nella chat.
Quanto costano GPT-6 Sol e Luna via API?
Sol costa 2 dollari per milione di token in input e 10 in output, Luna 0,10 e 0,50. OpenAI li presenta come prezzi dimezzati rispetto a quelli promozionali di GPT-5.6. La lettura dell'input dalla cache costa un decimo dell'input normale.
Che fine fa GPT-5.6 Terra?
Nella famiglia GPT-6 un modello Terra non c'è. Nel catalogo di Codex chi usa GPT-5.6 Terra riceve la proposta di passare a GPT-6 Sol, che costa in input quanto Terra e meno in output. I modelli GPT-5.6 restano selezionabili durante il rollout.
GPT-6 Sol è più potente di GPT-6 Astra?
No. OpenAI continua a indicare Astra come il suo modello più capace e come riferimento per l'uso del computer. Sol è l'alternativa a costo più basso: su AutomationBench Sol al livello xhigh supera Astra al livello low, ma sono due impostazioni diverse.
I benchmark di Sol si possono confrontare con Claude Opus 5.5?
Non direttamente. OpenAI confronta Sol e Luna con Claude Opus 5 e con Claude Fable 5 e 5.1, perché Opus 5.5 è uscito lo stesso giorno. Test nelle stesse condizioni fra i due modelli, con le stesse versioni dei benchmark e lo stesso livello di ragionamento, finora non sono stati pubblicati.
Sol e Luna hanno la stessa data limite della conoscenza?
No. Secondo le schede ufficiali Sol arriva al 20 aprile 2026 e Luna al 18 maggio 2026. Luna, il modello più economico, ha la data più recente della famiglia GPT-6, più recente anche di quella di Astra.