
Qwen3.8-27B in locale: capacità, limiti e requisiti
Qwen3.8-27B in locale: modello, licenza, immagini, contesto e memoria. Cosa verificare prima di usarlo sui documenti della tua azienda.
Qwen3.8-27B è un modello multimodale a pesi scaricabili che puoi eseguire sul tuo hardware, a condizione di scegliere un formato e un motore compatibili. Offre comprensione di testo, immagini e video; non esiste però un requisito di memoria valido per qualsiasi quantizzazione, contesto e computer. Le caratteristiche riportate qui provengono dalla model card ufficiale Qwen, consultata il 27 ottobre 2026.
Per una PMI, la scelta riguarda soprattutto il processo: leggere documenti, preparare risposte basate su un archivio, assistere chi sviluppa software. Una risposta convincente in chat dimostra che il modello sa conversare; l'affidabilità su scadenze, importi o procedure va verificata separatamente. Questa guida distingue i dati pubblicati dal produttore dalle valutazioni operative; non presenta benchmark eseguiti da Giallo Studio.
In sintesi
- Qwen3.8-27B usa un modello linguistico dense da 27 miliardi di parametri, affiancato da un encoder visivo.
- Il contesto nativo dichiarato è di 262.144 token; l'estensione fino a un milione richiede una configurazione adatta.
- La licenza del checkpoint ufficiale è Apache 2.0.
- La memoria effettiva comprende pesi, cache, componenti visive e spazio del runtime.
- Il funzionamento locale dell'intero processo va verificato anche per documenti, strumenti e connessioni esterne.
Che modello è Qwen3.8-27B?
Qwen3.8-27B è un checkpoint della famiglia Qwen distribuito dall'organizzazione ufficiale Qwen su Hugging Face. La sua architettura linguistica è dense: non è un MoE in cui soltanto alcuni esperti vengono selezionati per ciascun token. La card specifica 27 miliardi di parametri per il language model e la presenza di un encoder visivo; la scheda riassuntiva della piattaforma può arrotondare il totale a 28B. Le due cifre descrivono perimetri diversi, non due versioni equivalenti. Fonte: model card Qwen.
Per capire il lessico senza confondere modello e applicazione puoi partire dalla guida ai modelli AI locali. Il modello fornisce la generazione; il programma con cui lo apri decide invece come caricare i file, conservare le conversazioni e collegare altri strumenti. Questa separazione conta quando chiedi che l'intero lavoro resti nel computer.
Qwen3.8-27B e Qwen3.8-Max sono la stessa cosa?
No. Il nome di famiglia non rende intercambiabili i checkpoint. Nell'annuncio ufficiale di Qwen3.8-Max, Max viene descritto con 2,4 trilioni di parametri totali e 95 miliardi attivi. Sono dimensioni e architettura diverse dal modello dense da 27B di questa pagina.
Prima di valutare un risultato trovato online, controlla il nome completo usato nel test. Un confronto effettuato con Max non dimostra che il 27B produca la stessa risposta. Anche un derivato quantizzato o modificato dalla comunità può comportarsi diversamente dal checkpoint originale. Conserva autore, nome del repository, revisione e formato dei pesi: questa piccola scheda permette di ripetere il test e capire se un aggiornamento ha cambiato il comportamento.
Cosa può leggere oltre al testo?
La card descrive capacità native di comprensione di immagini e video. Questo rende il modello un candidato per interpretare schermate, fotografie di documenti, grafici e sequenze visive. La comprensione visiva non coincide con una garanzia di estrazione esatta: una cifra minuscola, un timbro sovrapposto o una tabella complessa possono richiedere controlli specifici. Fonte: capacità Qwen3.8-27B.
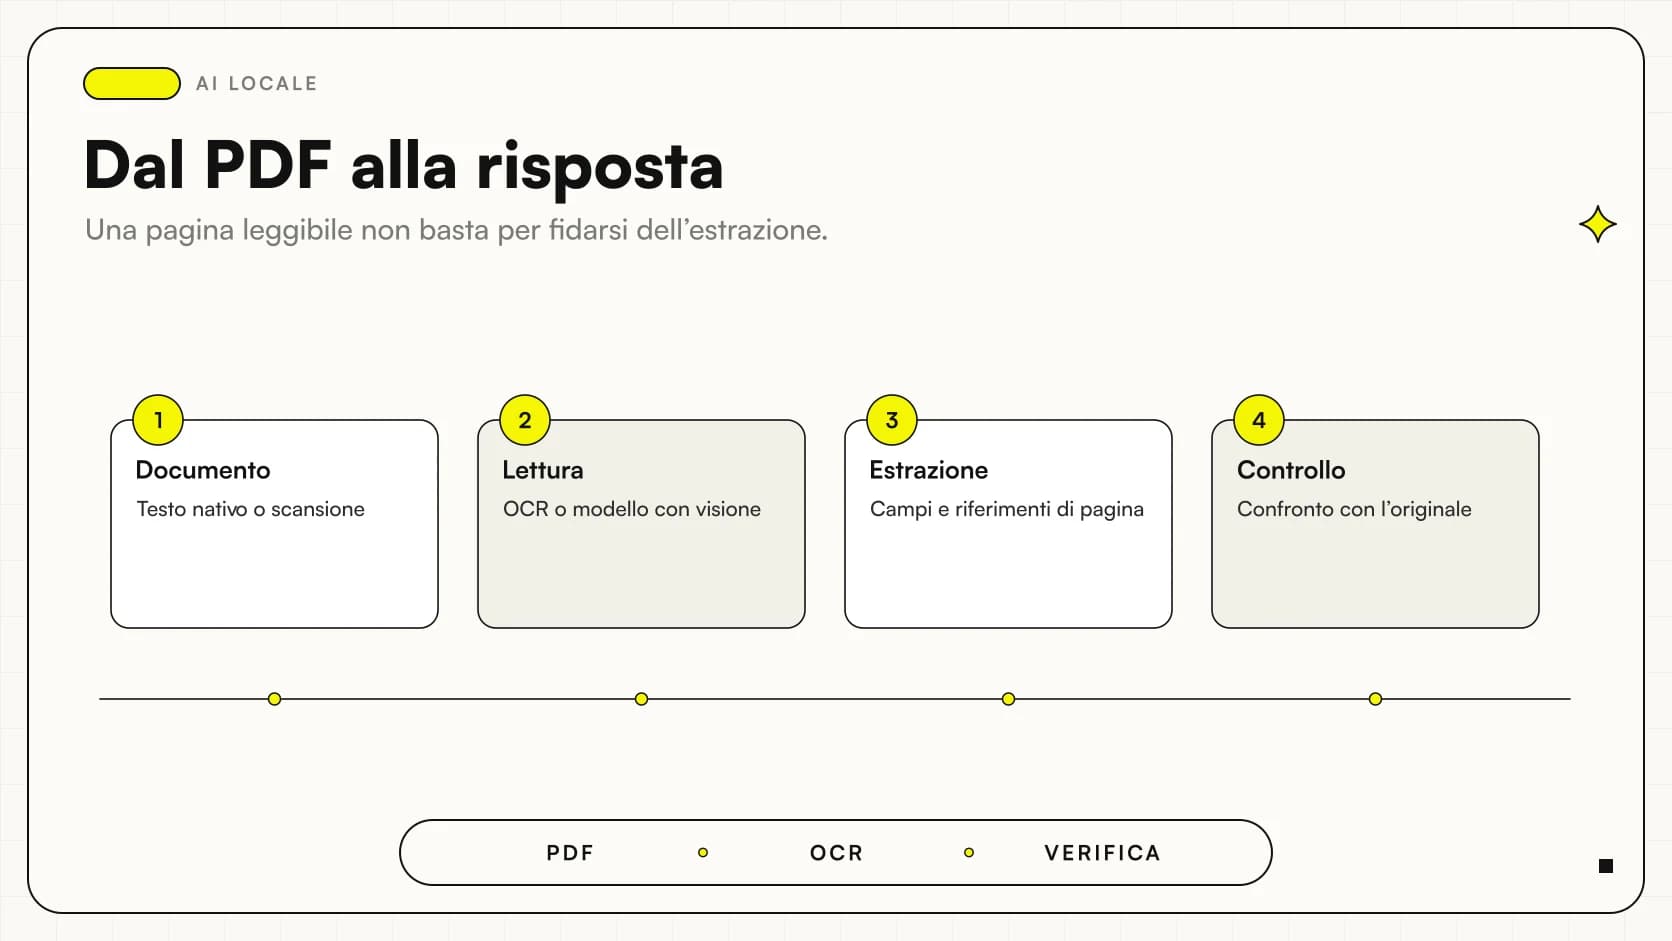
Un PDF può contenere testo selezionabile, pagine scansionate o entrambi. Il sistema deve decidere se estrarre testo, renderizzare le pagine oppure applicare OCR, e poi mantenere il collegamento con il documento originale. Nel nostro approfondimento sull'AI multimodale locale per PDF e immagini trovi i passaggi da verificare. Prima di automatizzare un ordine, chiedi sempre che l'operatore possa vedere la pagina da cui arriva ogni campo.
Quanto contesto supporta davvero?
Il contesto nativo dichiarato è 262.144 token, estensibile fino a 1.000.000 tramite le configurazioni descritte dal produttore. Il valore massimo non rappresenta la quantità di testo che qualsiasi computer potrà elaborare agevolmente. Contano runtime, memoria, immagini inserite, lunghezza della risposta e altre richieste contemporanee. Fonte: contesto e scaling Qwen.
Un contesto molto ampio non sostituisce la selezione dei documenti pertinenti. Se chiedi una procedura vigente, inserire anche tutte le versioni superate può creare ambiguità. Meglio fornire fonte, data di validità e istruzione su quale versione prevale. La guida al RAG spiega un approccio diverso: recuperare i passaggi utili dall'archivio invece di incollare indiscriminatamente tutto nella conversazione.
Un altro controllo riguarda l'attualità. Le conoscenze apprese durante l'addestramento non garantiscono informazioni aggiornate su cataloghi, disponibilità o regole interne. Se la domanda riguarda lo stato di una pratica, serve una fonte corrente autorizzata; il modello non deve ricostruirlo per plausibilità. Definisci quindi quali domande possono usare soltanto i documenti allegati e quali richiedono l'accesso a un sistema informativo. Per queste ultime, indica anche cosa fare quando il sistema è irraggiungibile. L'assenza di connessione deve produrre un limite dichiarato, non un dato inventato per completare la risposta.
Quanta memoria richiede il checkpoint?
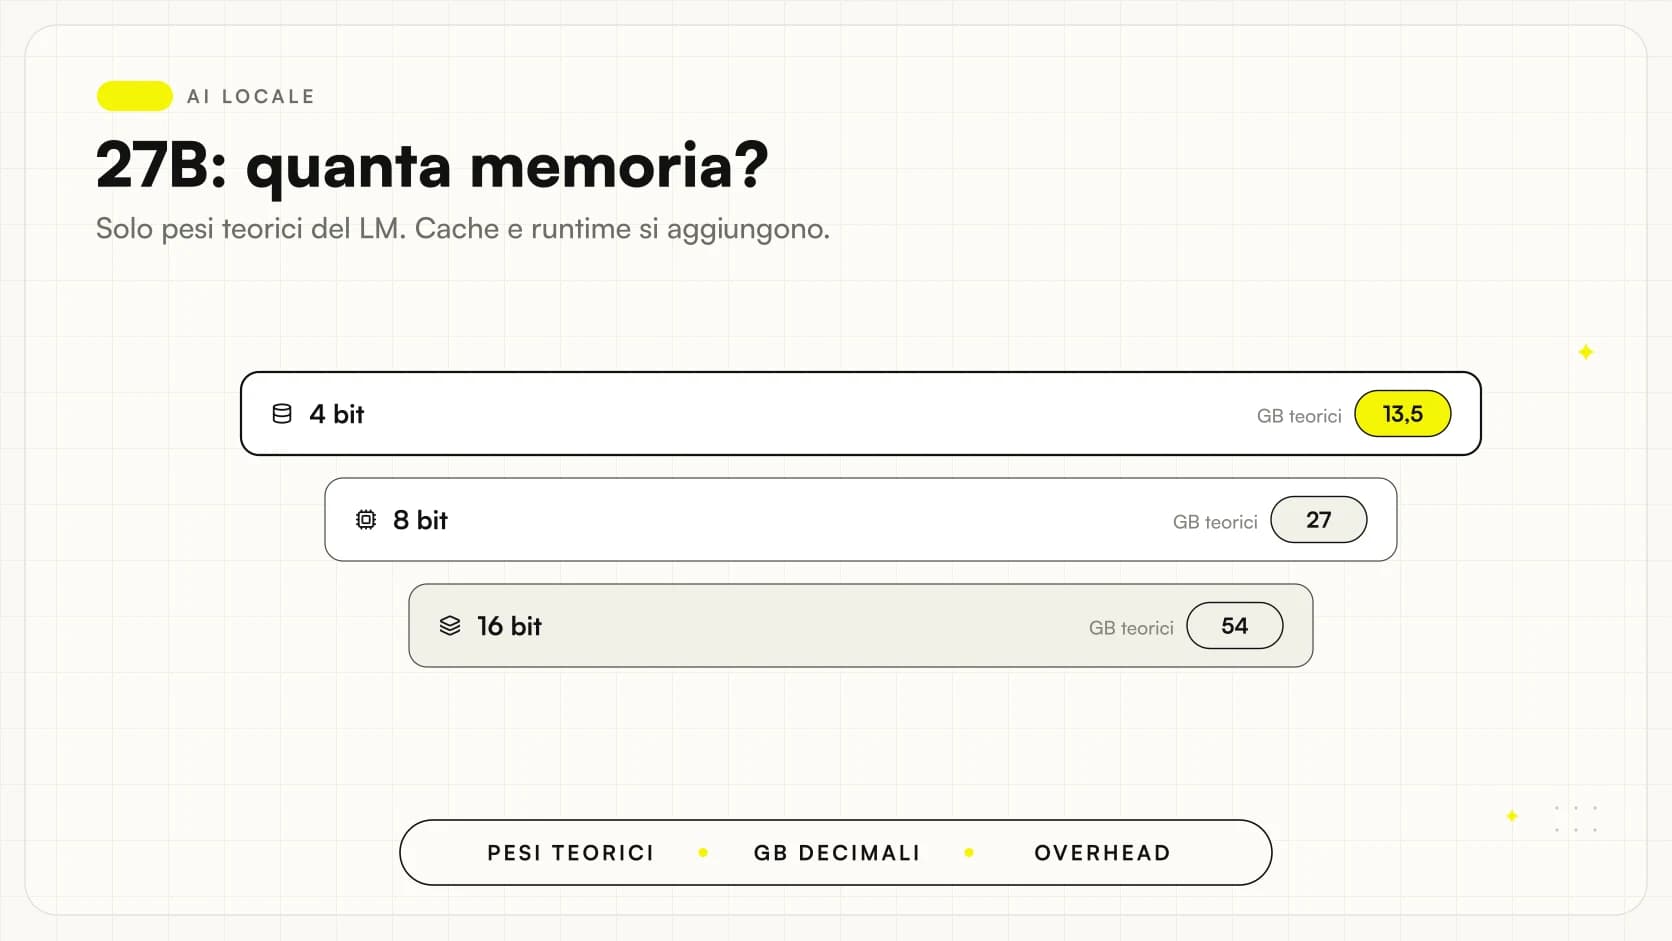
Il calcolo di base aiuta soltanto a stimare l'ordine di grandezza. Considerando 27 miliardi di parametri, a 16 bit si ottengono circa 54 GB decimali di soli pesi linguistici; a 8 bit circa 27 GB; a 4 bit circa 13,5 GB. Sono calcoli teorici, ricavati da parametri moltiplicati per bit e divisi per otto: non sono requisiti misurati.
Restano da aggiungere encoder visivo, scale della quantizzazione, cache del contesto, buffer e sistema operativo. I formati reali non assegnano necessariamente lo stesso numero di bit a ogni tensore. Per questo la dimensione del file scaricato e la memoria osservata durante una richiesta contano più di una divisione sulla carta. L'articolo su RAM e VRAM di Qwen3.8-27B distingue caricamento, margine operativo e prove da effettuare prima di comprare hardware.
Quali dati controllare prima di installarlo?
La prima verifica è l'origine dei file. Nel repository ufficiale trovi la card, i file di configurazione e il collegamento alla licenza; una conversione della comunità va ricondotta a quella base, senza trattare descrizioni commerciali e commenti come documentazione tecnica. Il config del modello aiuta a riconoscere architettura e impostazioni del checkpoint.
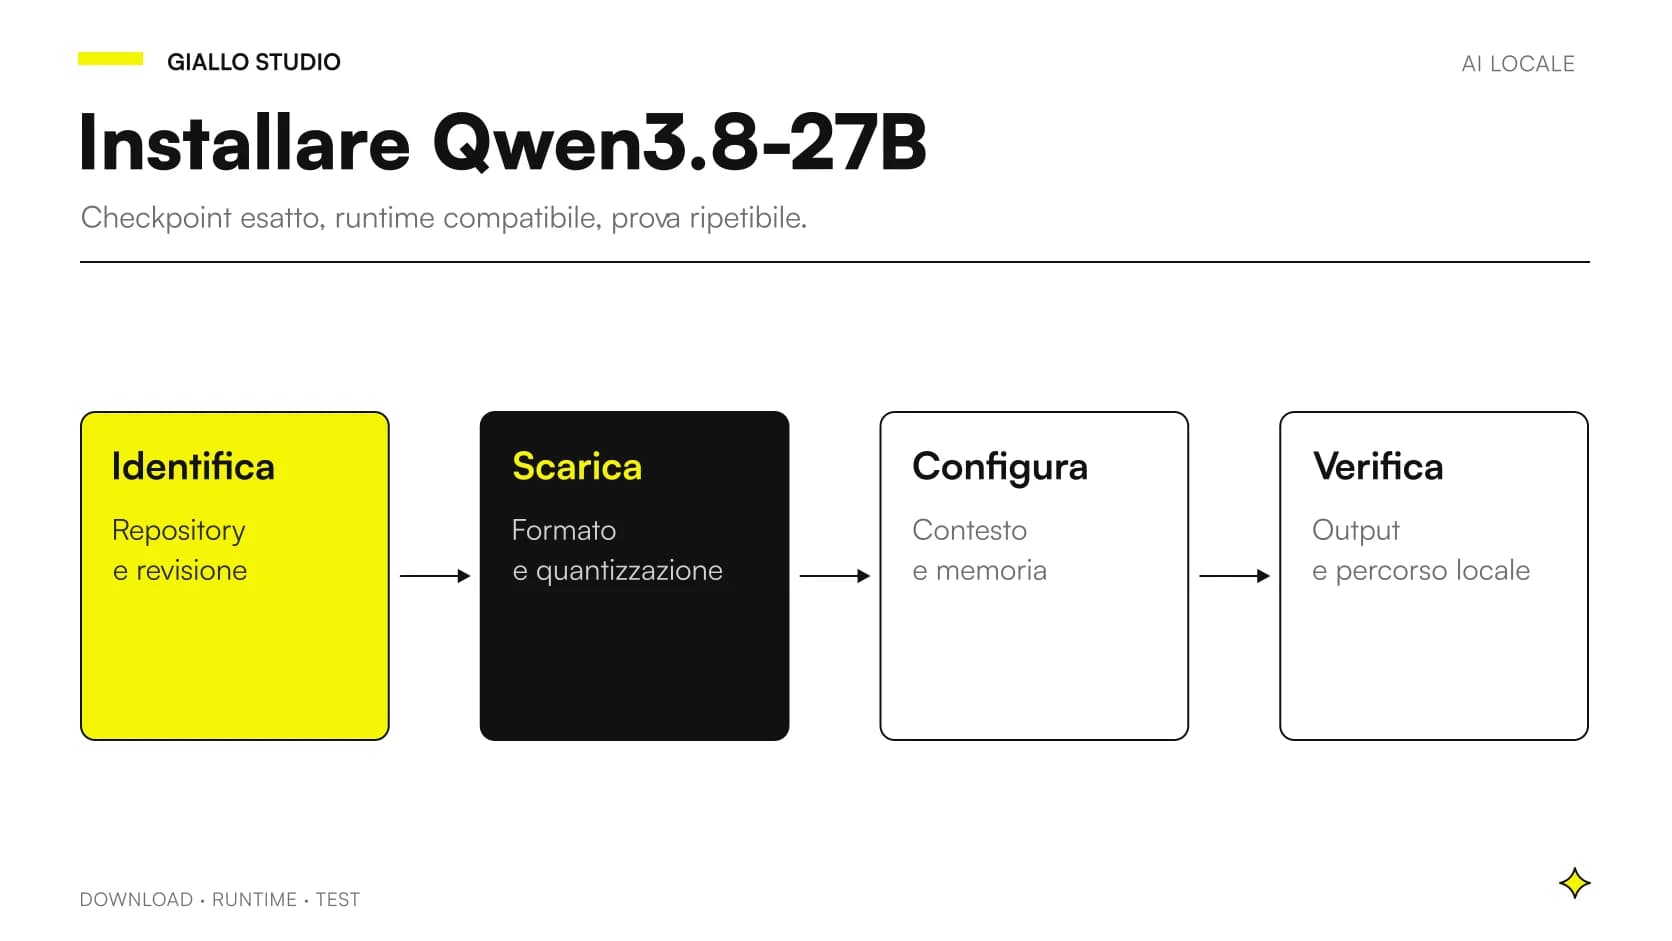
Annota anche il motore scelto e la sua versione. La card propone integrazioni con framework come vLLM e SGLang; il supporto effettivo del formato scaricato deve comunque corrispondere alla versione installata. Se una guida suggerisce un tag che non trovi nel catalogo del runtime, non sostituirlo con un nome simile. La procedura per installare Qwen3.8-27B in locale parte proprio dalla verifica di questa corrispondenza.
Per quali attività aziendali vale la pena provarlo?
Ha senso sperimentarlo dove serve combinare linguaggio e materiale visivo, oppure mantenere un checkpoint sotto il proprio controllo. Una prima prova può riguardare la sintesi di manuali, la classificazione di richieste interne o la preparazione di bozze con riferimenti ai documenti forniti. Le capacità dichiarate sono un motivo per testarlo, non una certificazione del processo.
| Attività | Prova utile | Criterio di accettazione |
|---|---|---|
| Manuali di assistenza | Domanda con riferimenti a due versioni | Cita quella valida e segnala il conflitto |
| Documenti fotografati | Estrazione di campi prestabiliti | Ogni campo rimanda alla pagina corretta |
| Risposte interne | Richiesta con informazione assente | Si astiene senza inventare |
| Supporto al codice | Modifica isolata con test esistente | Il test passa e il diff resta pertinente |
Questi sono criteri progettuali, non risultati già ottenuti. Se vuoi una panoramica dei fattori decisionali, usa anche come scegliere un modello AI.
Come provarlo in uno studio professionale?
Scenario ipotetico: uno studio tecnico vuole preparare una bozza di risposta su una pratica. Il materiale comprende una relazione, una planimetria e una corrispondenza con modifiche successive. La prova dovrebbe chiedere al sistema di distinguere fatti leggibili nei documenti, punti incerti e domande da rivolgere al professionista responsabile.
Il test più utile non è “riassumi tutto”. È una domanda precisa, per esempio quale revisione riporti una certa indicazione e su quale pagina. Inserisci anche un documento che non contiene la risposta: il modello deve poter dire che manca. Il professionista conserva la decisione finale e il sistema offre riferimenti controllabili. Se l'interfaccia rende impossibile risalire alla pagina, il problema riguarda anche il prodotto costruito attorno al modello, non soltanto la qualità della generazione.
Come valutarlo in una PMI manifatturiera?
Secondo scenario ipotetico: un'azienda vuole aiutare il reparto commerciale a leggere specifiche e schede tecniche. Il punto delicato è distinguere un requisito richiesto dal cliente da una caratteristica già disponibile a catalogo. Una risposta che li mescola può sembrare precisa e risultare operativamente sbagliata.
Prepara domande in cui le due informazioni sono su documenti diversi e richiedi una tabella con requisito, evidenza, conformità e punti da verificare. Fai esaminare gli esiti a chi conosce davvero i prodotti. Non dare al modello il permesso di inviare preventivi o aggiornare l'ERP durante il pilota: prima devi sapere quali campi estrae correttamente. Questa prova offre un confronto molto più utile di una classifica generica costruita su problemi lontani dal lavoro del reparto.
Come funzionano thinking e strumenti esterni?
La card indica il thinking attivo per impostazione iniziale e descrive controlli per disabilitarlo o regolare il ragionamento. Queste opzioni vanno confrontate sul lavoro richiesto: una classificazione semplice e una diagnosi tecnica non impongono lo stesso compromesso tra tempo di attesa e approfondimento. Fonte: controlli thinking ufficiali.
Gli strumenti sono un altro livello. Il modello può formulare una richiesta a un tool; è l'applicazione che decide se eseguirla e con quali permessi. Per un assistente aziendale, separa lettura e scrittura, limita le cartelle accessibili e richiedi revisione prima delle azioni esterne. Puoi usare un modello locale anche quando un tool contatta un servizio remoto: in quel caso il processo completo non è offline. La verifica deve seguire il percorso effettivo dei dati.
Quali errori falsano la prima valutazione?
Il primo errore è confrontare una versione quantizzata con un risultato del checkpoint originale e attribuire ogni differenza al nome del modello. Il secondo è assegnare tutto il margine disponibile al contesto, lasciando il sistema senza spazio per completare la richiesta. Il terzo è usare solo domande facili, tutte con una risposta presente e non ambigua.
Un quarto errore riguarda i prompt: cambiare istruzioni, documenti e motore nello stesso momento impedisce di capire che cosa ha migliorato o peggiorato il risultato. Infine, non usare la fluidità dell'italiano come prova di correttezza. Una citazione inesistente o un importo sbagliato restano errori anche dentro un testo ben scritto. Per impostare un confronto più solido trovi un protocollo in benchmark degli LLM locali in italiano.
Come verificare licenza e riservatezza?
Il checkpoint ufficiale Qwen3.8-27B dichiara Apache 2.0; leggi il file LICENSE del repository per gli obblighi applicabili. Non trasferire questa licenza a qualsiasi modello chiamato Qwen: alcune varianti hanno condizioni diverse. Per conversioni e derivati controlla anche le informazioni dell'autore che distribuisce i file.
Sul piano operativo, verifica dove vengono salvati chat, documenti, log e backup, oltre al luogo dell'inferenza. Un embedding remoto o un servizio OCR esterno può far uscire i contenuti anche se la risposta finale viene generata sul server aziendale. Questo non risolve da solo gli aspetti trattati nella guida su AI e privacy aziendale: il controllo del flusso deve accompagnarsi a permessi, conservazione e responsabilità definiti.
Da una prova personale a un assistente utilizzabile
Quale scheda conservare per ogni prova?
Registra checkpoint e revisione, provenienza dei pesi, quantizzazione, runtime e versione, macchina, contesto configurato, documenti inseriti e impostazioni di generazione. Per ogni domanda conserva risposta, fonti mostrate, errori rilevati e giudizio del referente del processo. Usa contenuti di prova autorizzati e limita i dati nei log.
Parti da un'attività circoscritta, con un responsabile che possa giudicare le risposte e un criterio esplicito per fermare l'automazione. Se il modello soddisfa il compito, valuta l'integrazione, l'assistenza e il costo operativo; se fallisce su un requisito essenziale, confrontalo con un'alternativa invece di aumentare indiscriminatamente il contesto.
Puoi approfondire le differenze con Gemma 4 31B e con Ministral 3 14B. Per trasformare la prova in un assistente con fonti e confini verificabili, la consulenza AI di Giallo Studio parte dal processo e dai documenti che userai davvero; in The Lab puoi esplorare altri modi di portare l'AI nel lavoro.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 DeepSeek R1 Distill 32B vs Qwen3.8-27B in locale
 Qwen3.8-27B vs Gemma 4 26B A4B: dense o MoE?
 Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
 Installare Qwen3.8-27B in locale: controlli e procedura
 Qwen3.8-27B: quanta RAM e VRAM servono davvero?
 AI multimodale locale: leggere PDF e immagini aziendali
 Modelli AI locali: quando convengono
FAQ
Qwen3.8-27B si può usare in locale?
Sì, i pesi del checkpoint ufficiale sono scaricabili. Occorrono un runtime compatibile, un formato supportato e memoria sufficiente per il carico previsto.
Qwen3.8-27B è dense o MoE?
Il modello linguistico è dense e conta 27 miliardi di parametri, oltre alla componente visiva. Non va confuso con i modelli MoE della famiglia Qwen.
Qual è il contesto nativo di Qwen3.8-27B?
La model card dichiara 262.144 token nativi, estensibili fino a un milione con configurazione appropriata. La capacità effettivamente utilizzabile dipende anche dalla memoria e dal runtime.
Qwen3.8-27B legge immagini e video?
La model card descrive comprensione nativa di immagini e video. Un documento PDF richiede comunque una pipeline che prepari il contenuto e mantenga i riferimenti alle pagine.
Qwen3.8-27B è gratuito per le aziende?
Il checkpoint ufficiale è distribuito con licenza Apache 2.0. Restano costi di hardware, gestione e integrazione, e vanno rispettati gli obblighi della licenza e quelli applicabili al processo.