
Prezzi GPT-6 Sol e Luna: listino API, conti di esempio e piani ChatGPT
Prezzi GPT-6 Sol e Luna: listino API completo con cache, contesto lungo, Batch e residenza UE, confronto con GPT-5.6 e Astra, tre conti e piani ChatGPT.
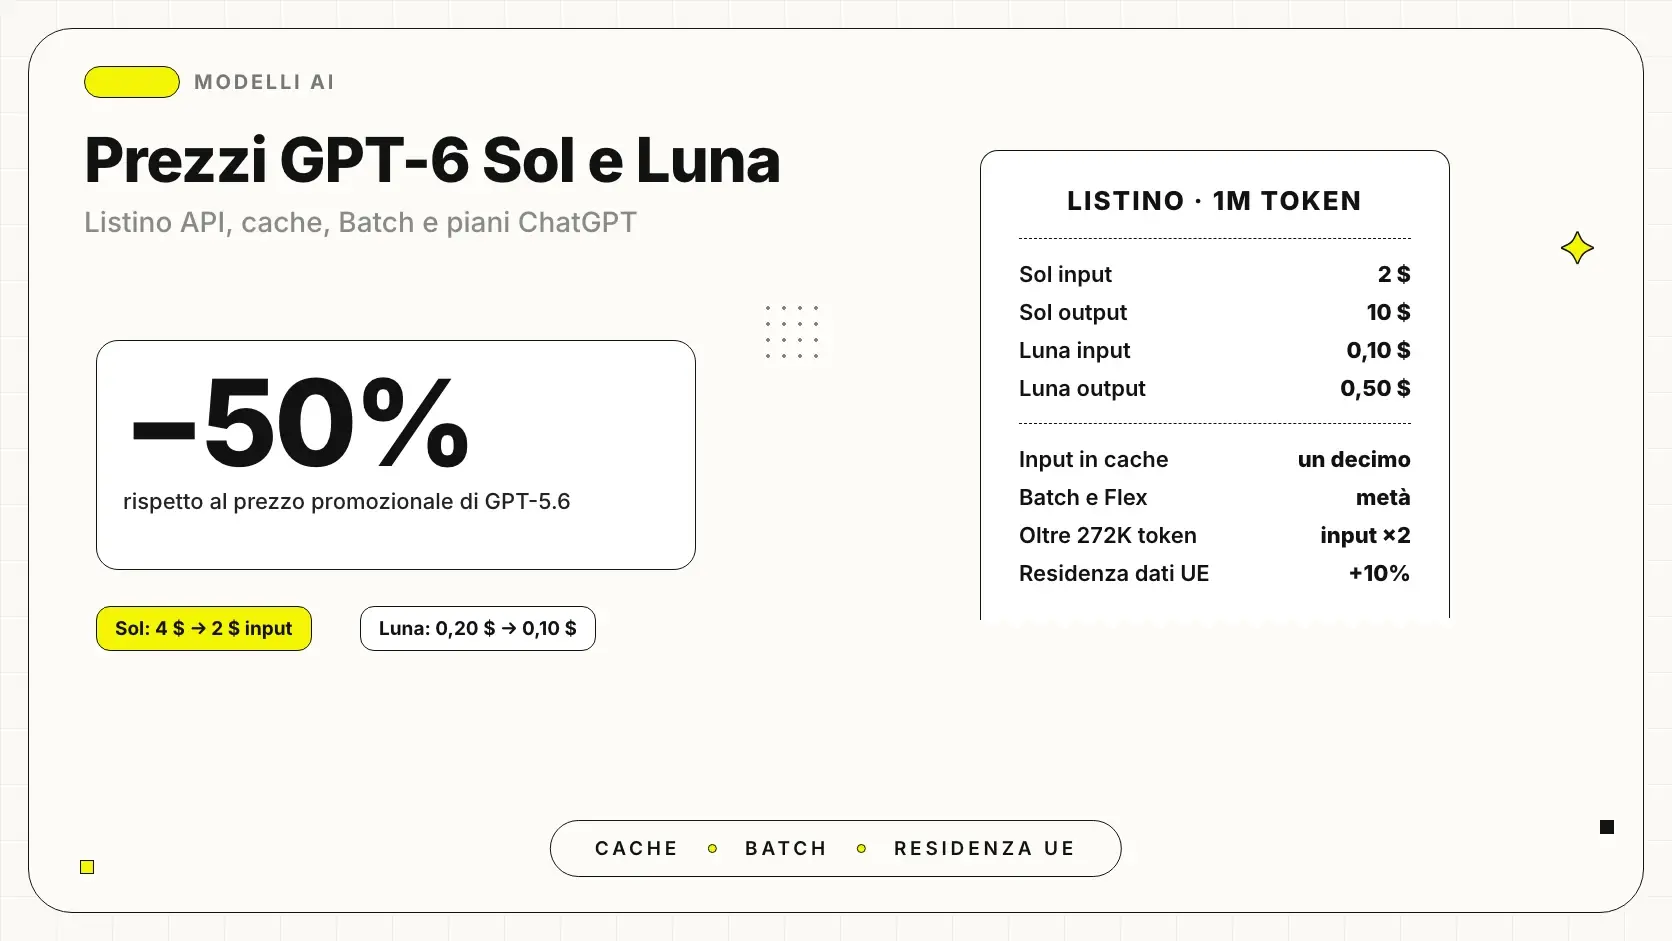
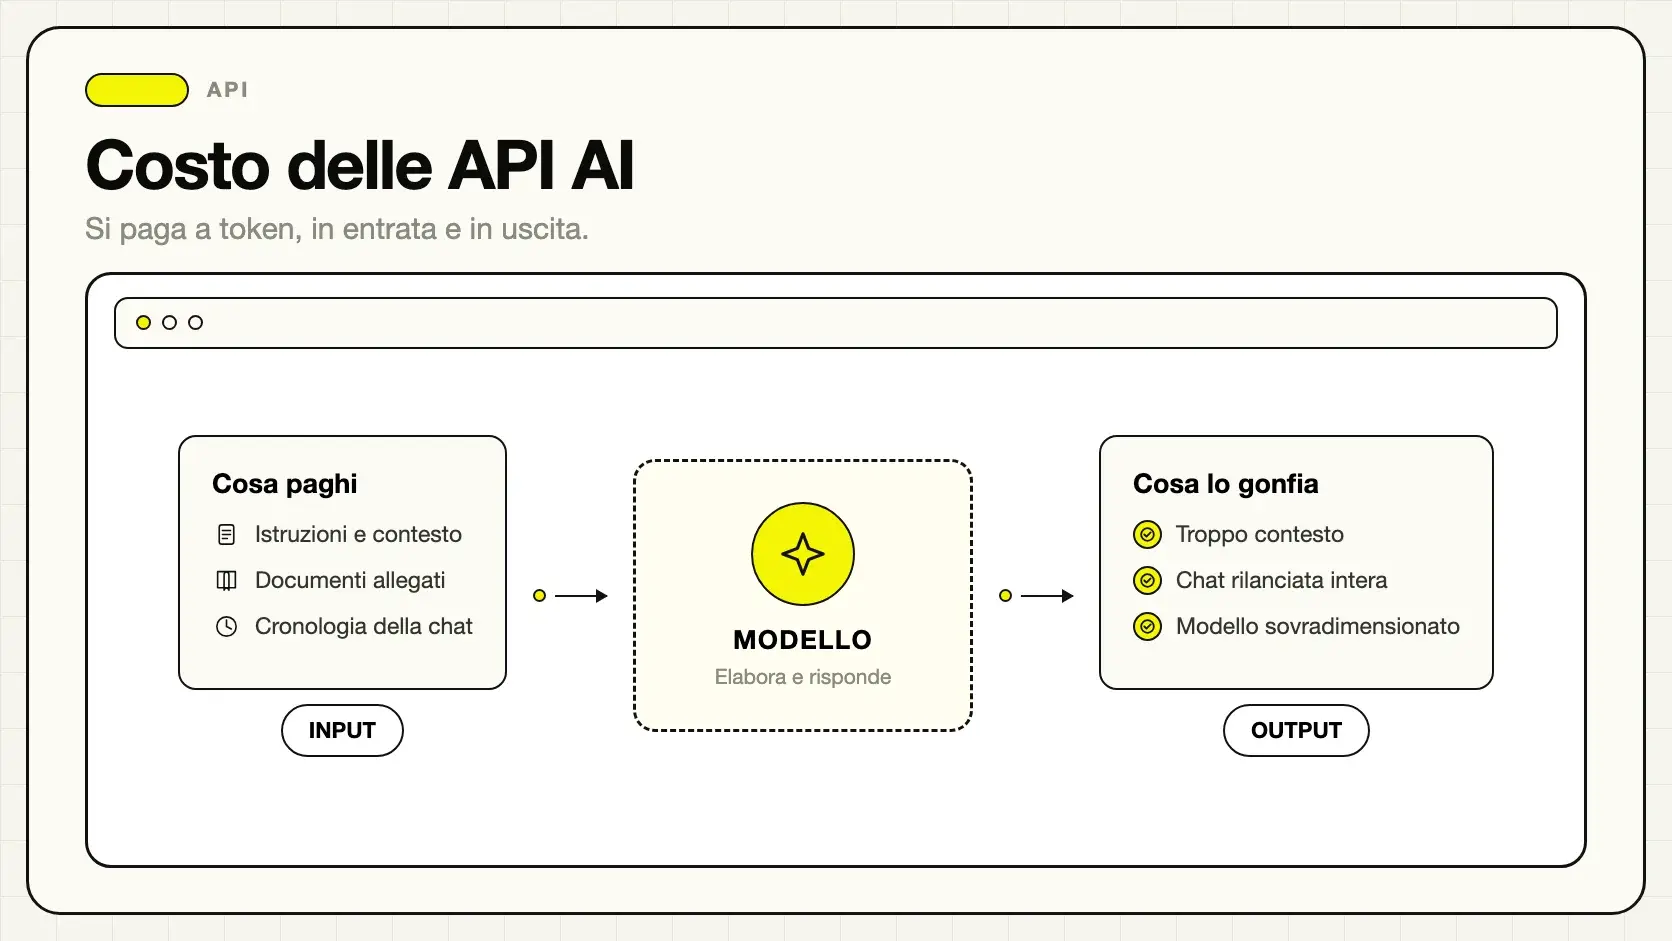
I prezzi di GPT-6 Sol e Luna via API partono da 2 dollari per milione di token in input e 10 in output per Sol, e da 0,10 e 0,50 dollari per Luna, con l'elaborazione Standard e richieste sotto i 272.000 token di input. L'input letto dalla cache costa un decimo, Batch e Flex costano la metà, Fast mode il doppio. Nei piani ChatGPT e Codex invece non si paga a token: i due modelli sono inclusi nell'abbonamento, con limiti d'uso diversi da modello a modello.
OpenAI presenta le nuove tariffe come un taglio del 50% rispetto ai prezzi promozionali di GPT-5.6 (annuncio del 22 settembre 2026). Qui trovi il listino voce per voce, il confronto con GPT-5.6 e con Astra, tre conti di esempio fatti con le tariffe ufficiali e le voci che un preventivo tende a dimenticare. Prezzi verificati il 23 settembre 2026 sul listino ufficiale OpenAI: prima di impegnare un budget, ricontrollali.
In sintesi
- GPT-6 Sol: 2 $ input, 0,20 $ input in cache, 2,50 $ scrittura in cache, 10 $ output per milione di token.
- GPT-6 Luna: 0,10 $, 0,01 $, 0,125 $ e 0,50 $ sulle stesse voci.
- Oltre i 272.000 token di input tutta la richiesta paga input e cache al doppio e output a una volta e mezza.
- Batch e Flex costano la metà, Fast mode il doppio; la residenza dei dati in UE è solo in Standard, con un sovrapprezzo del 10% (listino).
- Ogni voce di Sol costa un quinto di quella di Astra, ogni voce di Luna un centesimo.
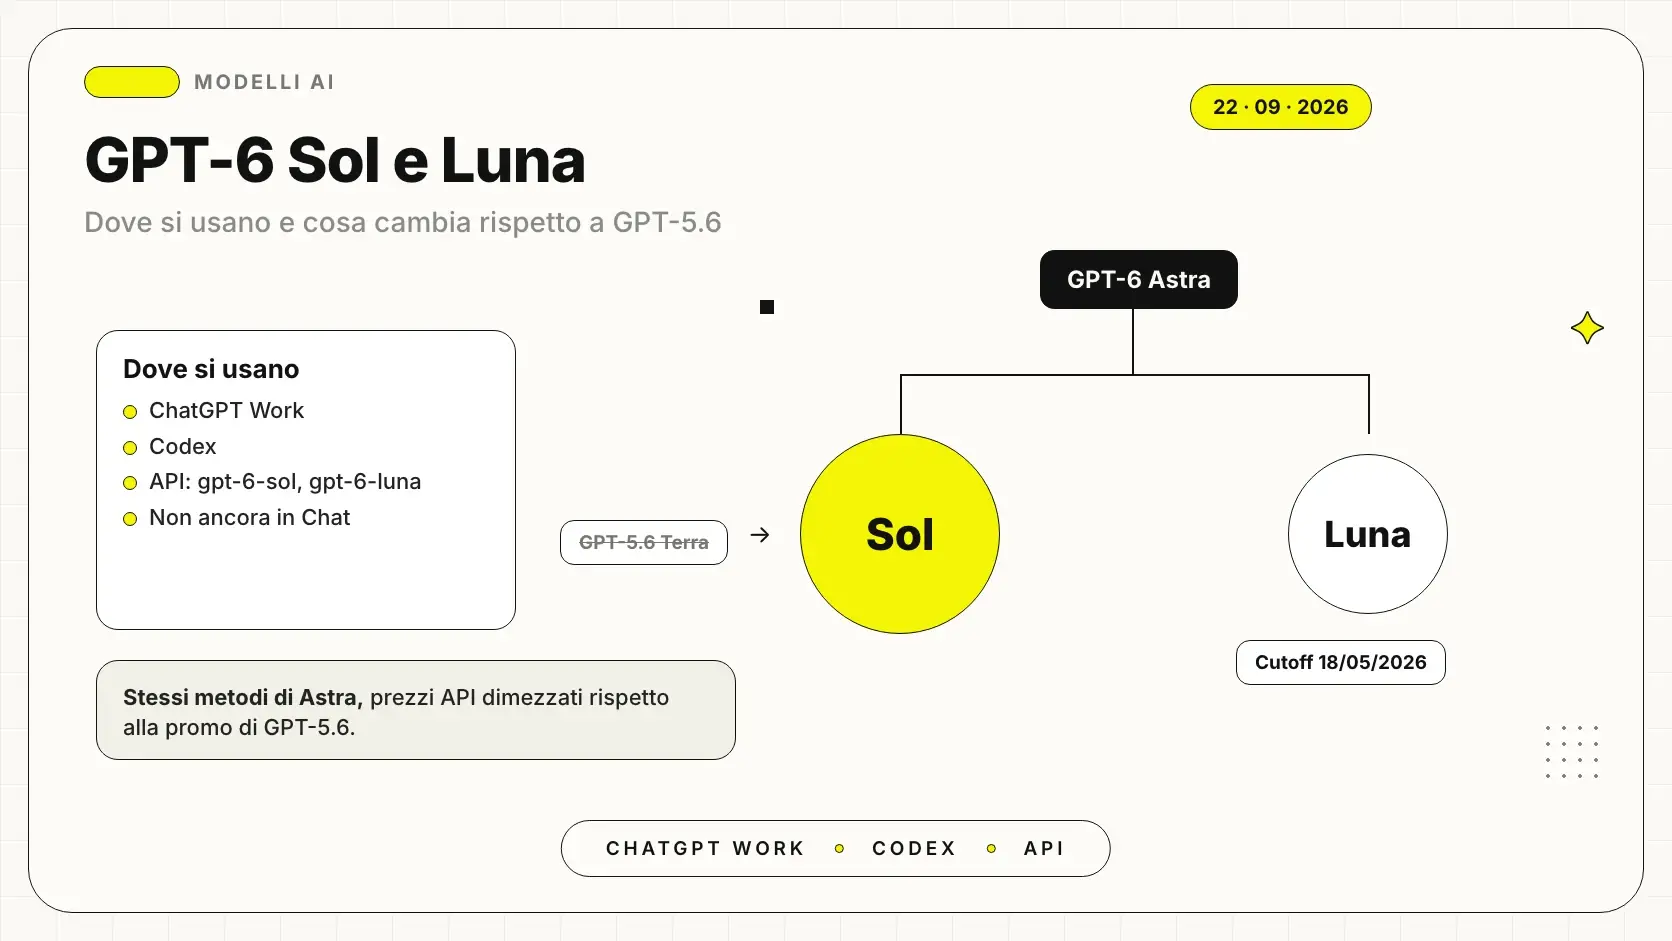
- In ChatGPT e Codex sono inclusi nei piani: Plus ha Sol e Luna, Free e Go hanno Luna nell'app desktop.
Quanto costano Sol e Luna via API: le otto voci del listino
Ogni modello ha quattro voci (input, input letto dalla cache, scrittura in cache, output) e due fasce, a seconda che la richiesta resti sotto o superi i 272.000 token di input. I valori sono quelli dell'elaborazione Standard, in dollari per milione di token.
| Voce | Sol fino a 272.000 token | Sol oltre 272.000 | Luna fino a 272.000 token | Luna oltre 272.000 |
|---|---|---|---|---|
| Input | 2,00 $ | 4,00 $ | 0,10 $ | 0,20 $ |
| Input letto dalla cache | 0,20 $ | 0,40 $ | 0,01 $ | 0,02 $ |
| Scrittura in cache | 2,50 $ | 5,00 $ | 0,125 $ | 0,25 $ |
| Output | 10,00 $ | 15,00 $ | 0,50 $ | 0,75 $ |
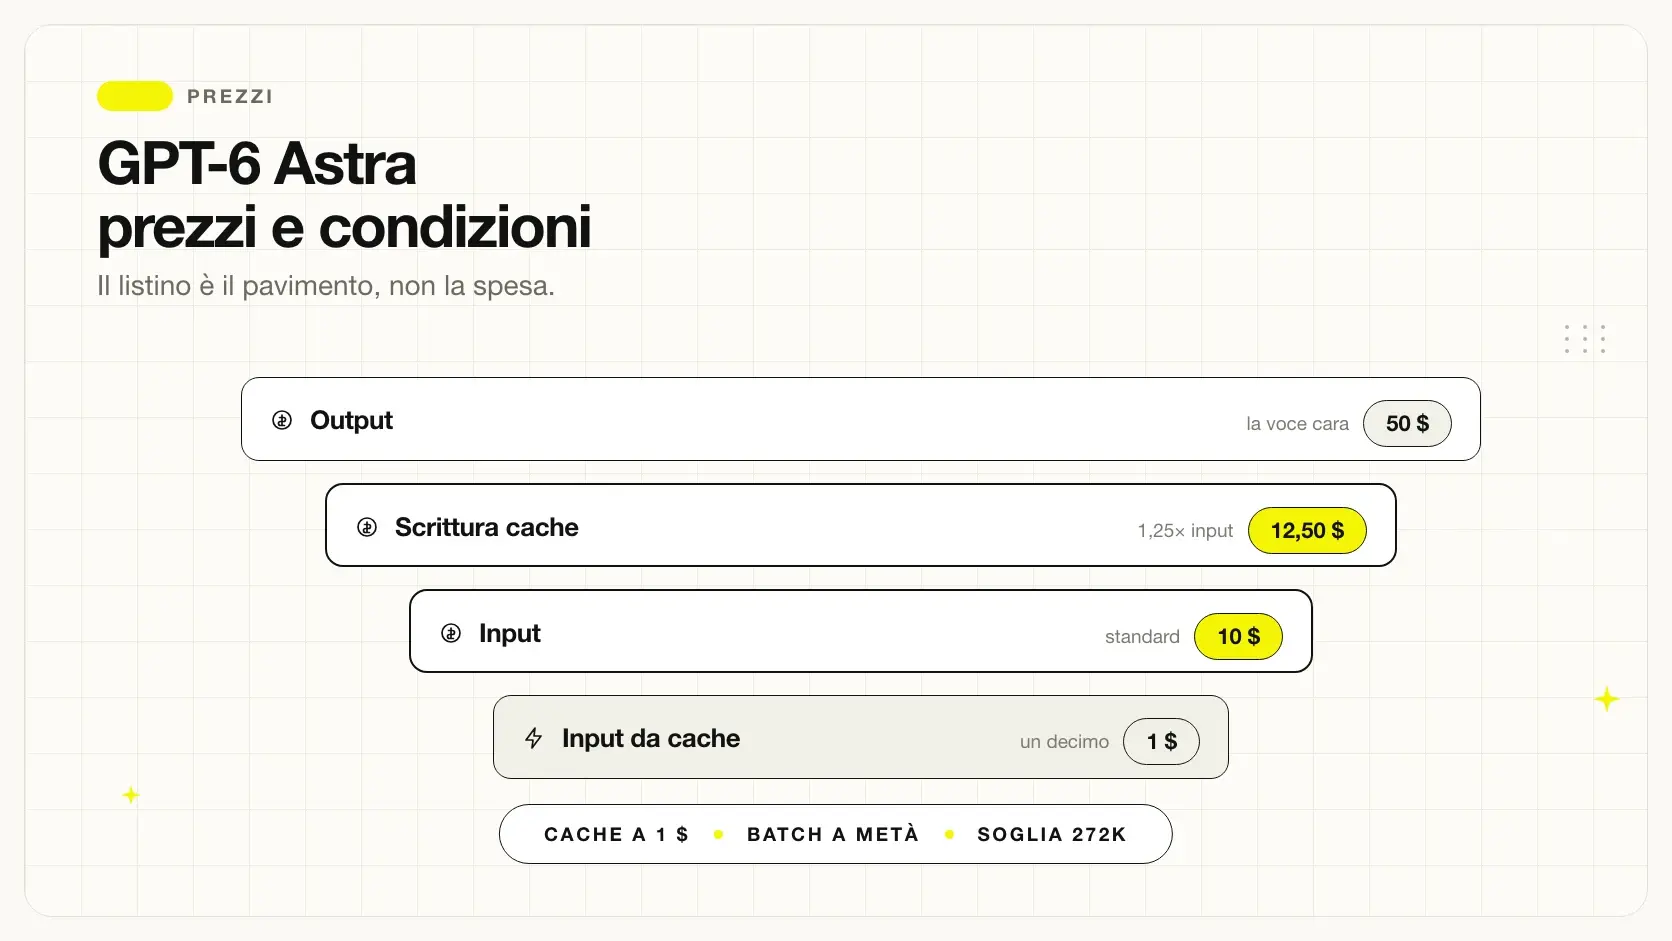
Le regole dietro i numeri sono scritte nelle schede di GPT-6 Sol e GPT-6 Luna. L'input in cache costa il 10% dell'input normale, la scrittura in cache 1,25 volte. Quando una richiesta supera i 272.000 token di input, input e cache raddoppiano e l'output sale di una volta e mezza, per tutta la richiesta e non solo per la parte in eccesso.
Quattro modi di chiamare lo stesso modello, quattro tariffe
La stessa richiesta può essere elaborata in modi diversi, e il prezzo cambia con la modalità. Per chi usa le API è la leva più semplice: non richiede di cambiare modello né di riscrivere i prompt.
| Modalità | Quando ha senso | Sol, input / output | Luna, input / output |
|---|---|---|---|
| Standard | Un utente o un processo aspetta la risposta | 2 $ / 10 $ | 0,10 $ / 0,50 $ |
| Batch | Lotti di richieste con risultati entro 24 ore | 1 $ / 5 $ | 0,05 $ / 0,25 $ |
| Flex | Lavori non urgenti, accettando risposte più lente e qualche indisponibilità | 1 $ / 5 $ | 0,05 $ / 0,25 $ |
| Fast mode | Quando la velocità vale il doppio del prezzo | 4 $ / 20 $ | 0,20 $ / 1,00 $ |
Due note dal listino. Fast mode è il nuovo nome della vecchia elaborazione Priority, cambiato il 30 luglio 2026. E per Sol e Luna la residenza dei dati in UE è disponibile solo con l'elaborazione Standard, con un sovrapprezzo del 10% che vale per i modelli usciti dal 5 marzo 2026 in poi: applicato al listino significa 2,20 $ in input e 11 $ in output per Sol, 0,11 $ e 0,55 $ per Luna.
La residenza dei dati non si attiva con un clic. Secondo la guida OpenAI sui dati va richiesta al team commerciale, si imposta per progetto e, per le regioni fuori dagli Stati Uniti, richiede l'approvazione dei controlli sul monitoraggio degli abusi e un accordo di conservazione modificato; le richieste passano poi dall'indirizzo eu.api.openai.com. Per un'azienda che tratta dati personali di clienti o dipendenti è una scelta da fare prima del preventivo, con il quadro descritto in dati aziendali e AI: cosa succede a quello che scrivi.
Rispetto a GPT-5.6 e ad Astra: cosa vuol dire metà prezzo
| Modello | Input | Input in cache | Output | Nota |
|---|---|---|---|---|
| GPT-6 Astra | 10 $ | 1 $ | 50 $ | Il più capace della famiglia |
| GPT-6 Sol | 2 $ | 0,20 $ | 10 $ | |
| GPT-6 Luna | 0,10 $ | 0,01 $ | 0,50 $ | |
| GPT-5.6 Sol | 4 $ | 0,40 $ | 20 $ | Prezzo promozionale, almeno fino al 21 novembre 2026 |
| GPT-5.6 Terra | 2 $ | 0,20 $ | 12 $ | Nessun successore nella famiglia GPT-6 |
| GPT-5.6 Luna | 0,20 $ | 0,02 $ | 1,20 $ |
Il "metà prezzo" dell'annuncio è preciso su Sol: input, cache e output di GPT-6 Sol sono esattamente la metà di GPT-5.6 Sol. Su Luna l'input si dimezza e l'output scende da 1,20 a 0,50 dollari, un taglio del 58% che nella tabella di lancio compare comunque come "50% cheaper" (annuncio). Il termine di paragone però è un prezzo promozionale: la scheda di GPT-5.6 Sol lo indica valido almeno fino al 21 novembre 2026, quindi il confronto andrà rifatto se le condizioni di GPT-5.6 cambiano.
Con Astra il rapporto è netto e uguale su ogni riga: Sol costa un quinto, Luna un centesimo. Chi oggi usa Astra per tutto può chiedersi quali passaggi reggerebbero con Sol, tenendo conto che OpenAI continua a indicare Astra come il modello per i lavori più impegnativi; il listino di Astra con le sue regole è in quanto costa GPT-6 Astra. Chi è rimasto su GPT-5.6 Terra noterà che Sol costa uguale in input e meno in output, e il confronto della vecchia famiglia resta in GPT-5.6 Sol vs Terra.
Tre conti di esempio con i prezzi ufficiali
Volumi e token sono ipotesi dichiarate, scelte per mostrare come si combinano le voci del listino: non sono misure fatte su un'azienda. Tutti i prezzi sono quelli del listino ufficiale in dollari.
Esempio 1: un assistente interno su Sol, con e senza cache. Ipotesi: 20.000 richieste al mese all'assistente dell'ufficio tecnico. Ogni richiesta ha una parte fissa di 8.000 token (istruzioni, definizioni degli strumenti, estratti dei manuali) e 1.000 token variabili, e produce 800 token di output ragionamento compreso. Con la cache e un punto di interruzione esplicito dopo la parte fissa, ipotizziamo 600 scritture al mese e 19.400 letture.
| Voce | Senza cache | Con cache |
|---|---|---|
| Parte fissa | 160 milioni di token × 2 $ = 320,00 $ | 4,8 milioni scritti × 2,50 $ = 12,00 $, più 155,2 milioni letti × 0,20 $ = 31,04 $ |
| Parte variabile | 20 milioni × 2 $ = 40,00 $ | 20 milioni × 2 $ = 40,00 $ |
| Output | 16 milioni × 10 $ = 160,00 $ | 16 milioni × 10 $ = 160,00 $ |
| Totale al mese | 520,00 $ | 243,04 $ |
La cache più che dimezza il conto, e dopo la cache la voce più pesante diventa l'output: due terzi della spesa. La leva successiva è quindi la lunghezza delle risposte e il livello di ragionamento, non il prezzo dell'input.
Esempio 2: un capitolato da 300.000 token su Sol. Ipotesi: un documento di gara da 300.000 token di input, con 10.000 token di output per l'analisi. In una sola richiesta si supera la soglia e si paga la tariffa lunga: 0,3 milioni × 4 $ = 1,20 $ più 0,01 milioni × 15 $ = 0,15 $, cioè 1,35 $. Diviso in due richieste da 150.000 token con 5.000 di output ciascuna, restano nella fascia corta: 0,60 $ di input e 0,10 $ di output, 0,70 $ in tutto. Su cento documenti al mese sono 135 $ contro 70 $. La divisione però ha un costo nascosto: se le clausole della seconda metà richiamano quelle della prima, il modello non le vede insieme. Spesso conviene prima togliere gli allegati che non servono e restare sotto soglia con un documento unico.
Esempio 3: l'arricchimento notturno del catalogo su Luna. Ipotesi: 200.000 schede prodotto al mese da completare con attributi e testi brevi, 1.200 token di input e 300 di output ciascuna, cioè 240 milioni di token in input e 60 milioni in output.
| Modalità | Calcolo | Totale al mese |
|---|---|---|
| Standard | 240 × 0,10 $ + 60 × 0,50 $ | 54,00 $ |
| Batch | Metà dello Standard | 27,00 $ |
| Standard con residenza UE | Standard più il 10% | 59,40 $ |
Il lavoro notturno è il candidato ideale per Batch, che restituisce i risultati entro 24 ore. Se però i dati devono restare in Europa, con Luna Batch non è disponibile e si paga il 120% in più rispetto a Batch. Su Luna la differenza vale poche decine di dollari; con volumi più grandi o con Sol, dove ogni voce costa venti volte tanto, la stessa scelta sposta cifre che vanno messe a budget. Metodo e formule sono in costo delle API AI: come si calcola davvero.
Cosa paghi se usi Sol e Luna in ChatGPT o in Codex
Nelle app di OpenAI non c'è un contatore di token in fattura: paghi il piano, e ogni modello consuma una quota diversa dei limiti inclusi. La pagina dei prezzi di Codex chiarisce che ChatGPT Work e Codex condividono prezzi, crediti e limiti d'uso. I prezzi sono in dollari come li riporta la pagina: al momento dell'acquisto controlla l'importo in euro.
| Piano | Prezzo indicato | Cosa include di GPT-6 Sol e Luna |
|---|---|---|
| Free | 0 $ | Luna nell'app desktop, velocità Standard, secondo il rollout |
| Go | 8 $ al mese | Luna nell'app desktop, velocità Standard, secondo il rollout |
| Plus | 20 $ al mese | Sol e Luna, con crediti aggiuntivi se servono |
| Pro | Da 100 $ al mese | Uso di Codex 5 o 20 volte quello di Plus |
| Business | 20 $ per utente al mese con fatturazione annuale, 25 $ con quella mensile, da 2 utenti | Sol e Luna, con crediti aggiuntivi |
| Enterprise ed Edu | Su richiesta | Sol e Luna, da abilitare a cura dell'amministratore |
| Codex con chiave API | A consumo | Tariffe API, senza le funzioni cloud |
La stessa pagina stima quanti messaggi locali si inviano in una finestra di cinque ore: con Plus, da 15 a 150 con Sol, da 350 a 3.000 con Luna, da 5 a 45 con Astra, contro 10-100 del vecchio GPT-5.6 Sol. Sono stime, non limiti fissi, e possono valere anche limiti settimanali. Oltre i limiti inclusi si paga in crediti: per milione di token Sol consuma 50 crediti in input, 5 in cache e 250 in output, Luna 2,5, 0,25 e 12,5, senza un addebito separato per la scrittura in cache. Fast mode in Codex consuma 2,5 volte i crediti Standard (velocità in Codex).
Piano ChatGPT o Codex
- Persone che lavorano in ChatGPT Work o in Codex
- Costo fisso per utente, più crediti quando servono
- Limiti per finestra di cinque ore e, a volte, settimanali
- Nessun lavoro da fare sulla fatturazione a token
API a consumo
- Processi automatici dentro gestionale, sito o CRM
- Paghi i token effettivi, con cache, Batch e Flex
- Residenza dei dati in UE possibile, solo in Standard
- Serve qualcuno che controlli i consumi ogni mese
Molte PMI hanno bisogno di entrambe le cose: abbonamenti per le persone che usano Work e Codex, API per i processi che girano da soli. Se ti chiedi quale modello mettere su quale processo, il ragionamento è in GPT-6 Sol vs Luna; come si imposta il modello dentro Codex è spiegato in Codex con GPT-6 Sol.
Le voci che sfuggono ai preventivi
- Il ragionamento si paga come output. Un livello alto su migliaia di richieste può pesare più di tutto l'input.
- Le scritture in cache inutili. Un blocco resta riutilizzabile per almeno 30 minuti dall'ultimo uso: se nessuno lo rilegge in quel tempo, la scrittura è costata un quarto in più per niente (guida alla cache).
- La soglia dei 272.000 token. Un allegato in più può far passare tutta la richiesta alla tariffa lunga.
- Fast mode lasciato acceso. Nelle API costa il doppio, in Codex consuma 2,5 volte i crediti.
- La residenza UE esclude Batch e Flex. Va deciso prima di stimare, non dopo.
- Il confronto con un prezzo promozionale. Il risparmio sul vecchio GPT-5.6 Sol è calcolato su tariffe promozionali, disponibili almeno fino al 21 novembre 2026.
Le voci di costo che non stanno nel listino (revisione umana, tentativi falliti, manutenzione) sono raccolte in i costi nascosti dei progetti AI.
Come stimare la spesa prima di firmare
- Fai girare cinquanta o cento casi reali con il modello e il livello di ragionamento che useresti davvero.
- Leggi i token effettivi di input, cache e output che l'API riporta per ogni chiamata, e controlla nel pannello della cache quanta parte dell'input viene riutilizzata.
- Separa ciò che può aspettare da ciò che deve rispondere subito: il primo gruppo va su Batch o Flex.
- Decidi se ti serve la residenza UE prima di fare i conti, perché cambia le modalità disponibili.
- Dividi la spesa per i compiti conclusi, compresi quelli rifatti a mano. Il metodo è in prezzo per milione di token, spiegato.
Con Sol e Luna il prezzo per token scende, ma il conto finale lo decidono cache, soglie e modalità di elaborazione più del listino. Se vuoi una stima fatta sui tuoi volumi prima di scegliere fra abbonamenti e API, l'audit AI gratuito parte proprio dai processi e dai numeri che hai già.
Come lo applichiamo in azienda
Risorse correlate
FAQ
Quanto costa GPT-6 Sol via API?
Nell'elaborazione Standard costa 2 dollari per milione di token in input, 0,20 per l'input letto dalla cache, 2,50 per la scrittura in cache e 10 per l'output. Se una richiesta supera i 272.000 token di input, l'intera richiesta si paga 4, 0,40, 5 e 15 dollari.
Quanto costa GPT-6 Luna via API?
Costa 0,10 dollari per milione di token in input, 0,01 per la cache in lettura, 0,125 per la scrittura in cache e 0,50 per l'output. Oltre i 272.000 token di input le tariffe diventano 0,20, 0,02, 0,25 e 0,75 dollari.
Batch e Flex quanto fanno risparmiare?
Costano la metà dell'elaborazione Standard, sia per Sol sia per Luna. Batch restituisce i risultati entro un giorno, Flex risponde più lentamente e a volte non trova risorse libere: vanno bene per i lavori che possono aspettare.
Posso usare Batch se mi serve la residenza dei dati in Europa?
Con Sol e Luna no. La residenza dei dati nell'Unione europea è disponibile solo con l'elaborazione Standard, che in quel caso costa un decimo in più del listino. L'accesso alla residenza dei dati va richiesto a OpenAI.
Quanto costano Sol e Luna in ChatGPT e in Codex?
Non si pagano a token: sono inclusi nei piani. Con Plus, Pro, Business, Enterprise ed Edu si usano in ChatGPT Work e in Codex, con Free e Go c'è Luna nell'app desktop. Quando i limiti del piano finiscono si possono usare crediti aggiuntivi, secondo le regole del piano.
Perché OpenAI dice che costano la metà?
Il confronto è con i prezzi promozionali di GPT-5.6. GPT-5.6 Sol costa 4 dollari in input e 20 in output, GPT-6 Sol 2 e 10. OpenAI indica il prezzo promozionale di GPT-5.6 Sol come valido almeno fino al 21 novembre 2026.
La scrittura in cache costa più dell'input normale?
Sì, un quarto in più: 2,50 dollari contro 2 per Sol. Si ripaga se lo stesso blocco di testo viene riletto almeno una volta mentre è ancora in cache: la documentazione OpenAI garantisce almeno mezz'ora dall'ultimo uso.