
Codex con GPT-6 Sol e Luna: modello, ragionamento, costi e revisione
Codex con GPT-6 Sol e Luna: come scegliere modello e livello di ragionamento, cosa cambia nel catalogo, cache per gli agenti, costi per task e revisione.
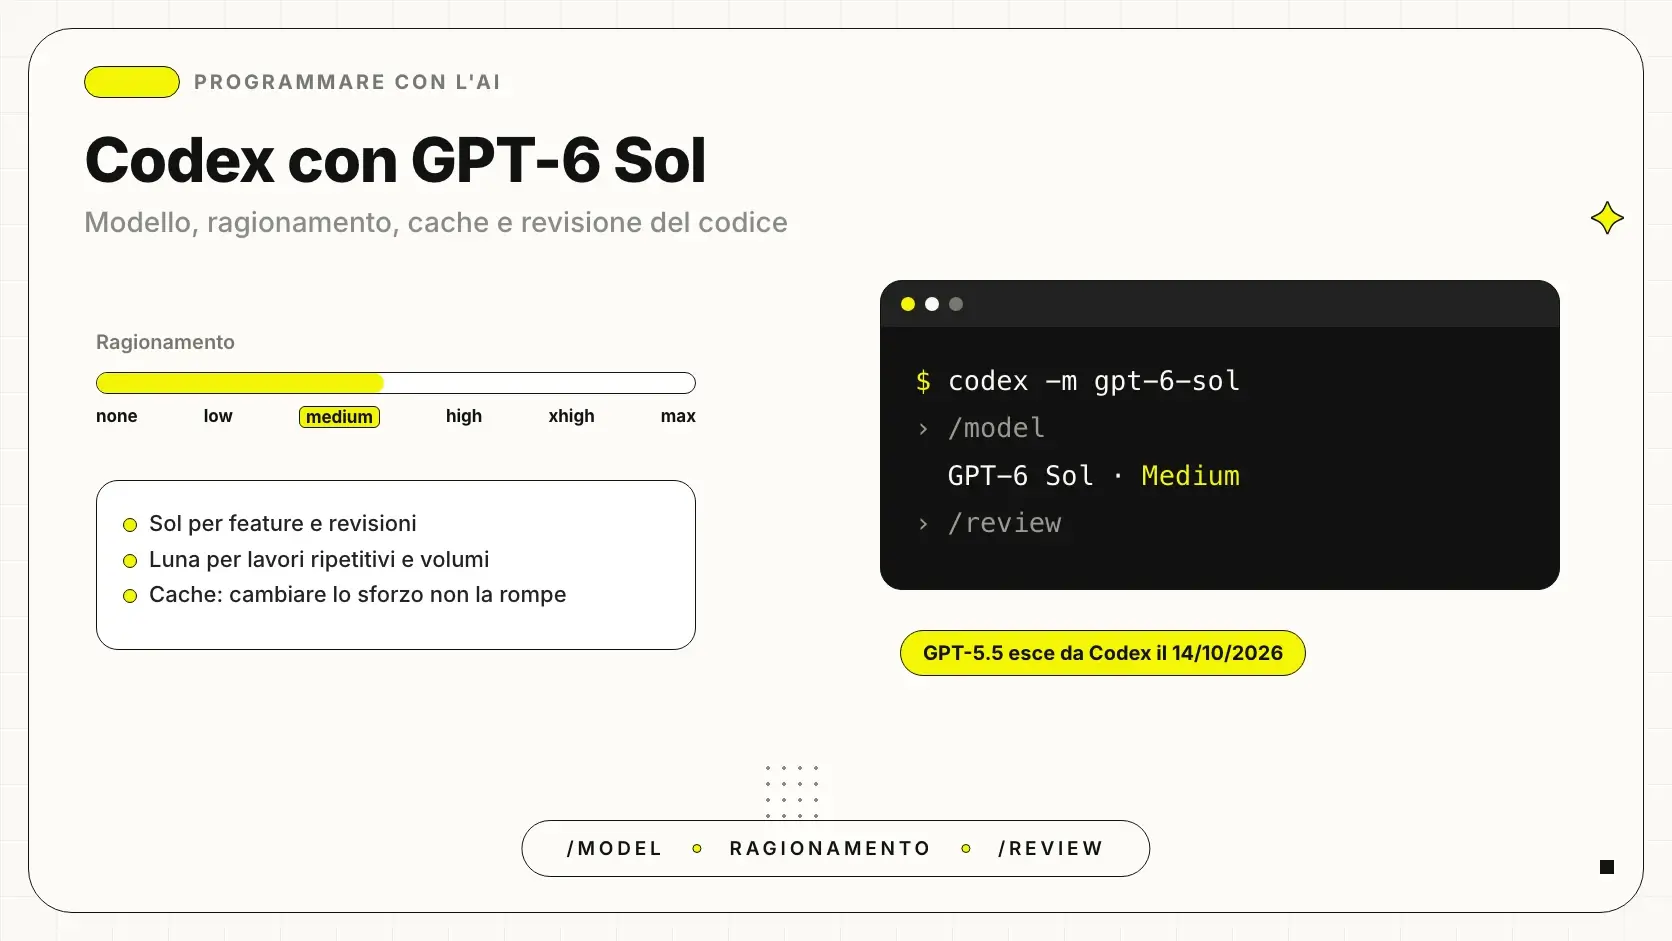
Per lavorare in Codex con GPT-6 Sol basta sceglierlo nel selettore dei modelli dell'app o, nella CLI, usare il comando /model oppure avviare codex --model gpt-6-sol. Il livello di ragionamento predefinito è Medium. Per i compiti mirati e ripetitivi c'è GPT-6 Luna, per cui la documentazione consiglia di partire da High. Nel cloud di Codex, invece, il modello per ora non si sceglie.
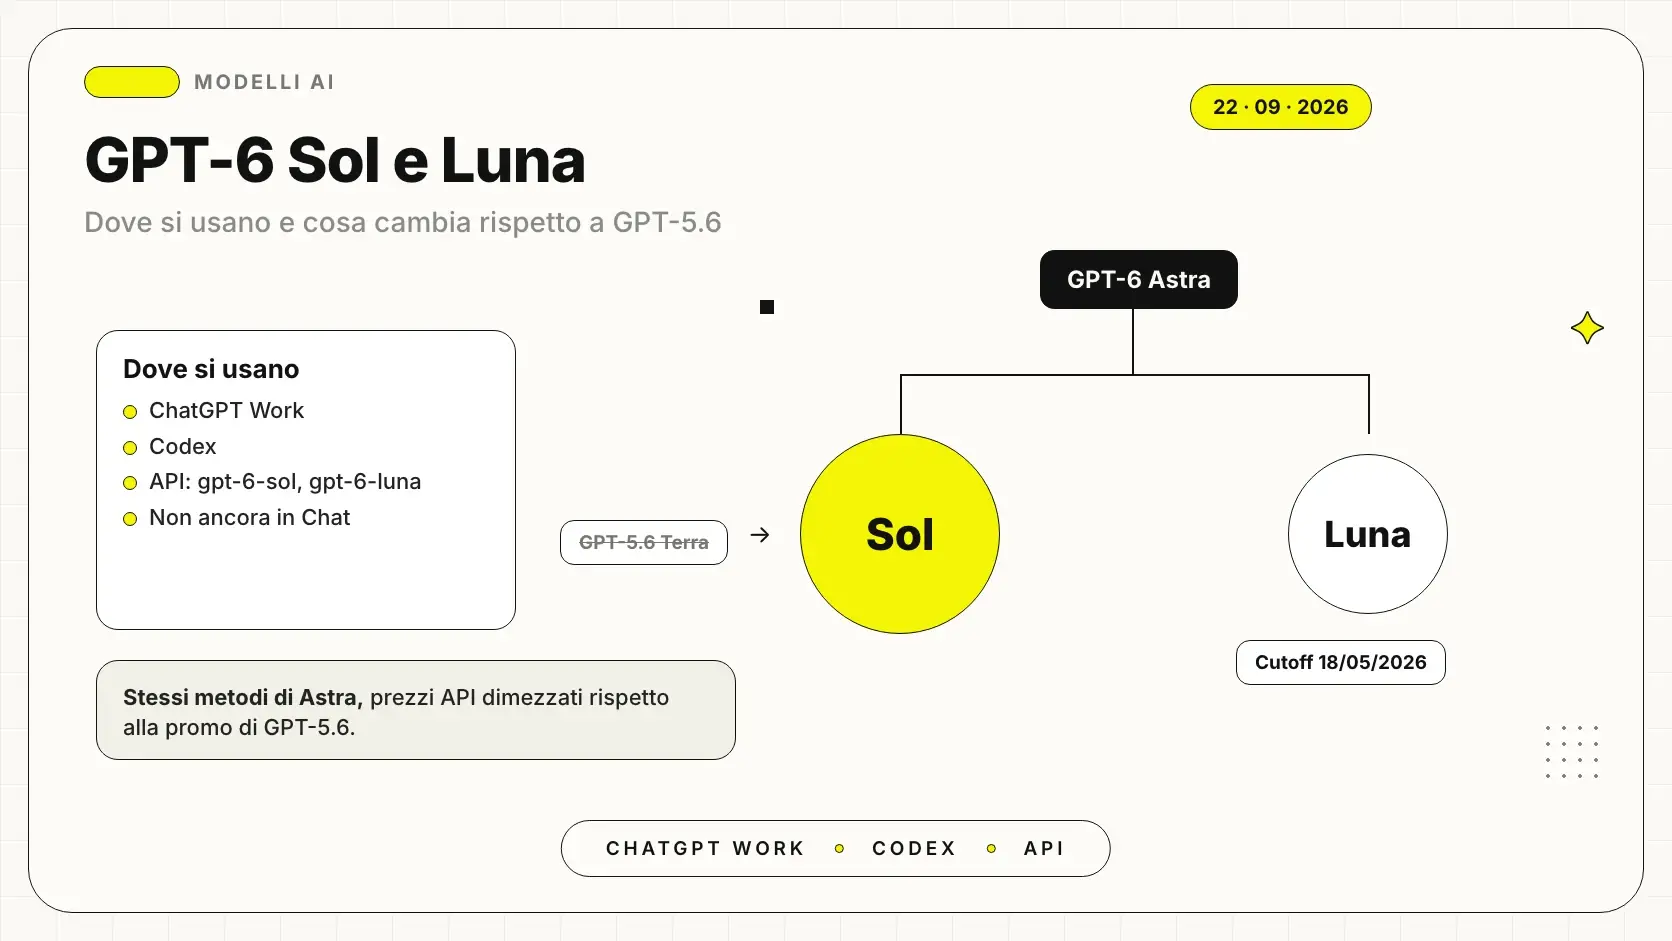
I due modelli sono arrivati in Codex il 22 settembre 2026 ed entrati nel selettore della CLI con la versione 0.156.1 del giorno dopo (changelog). Questa guida è per chi programma o fa programmare il proprio team; per il modello di punta della famiglia c'è GPT-6 Astra per sviluppatori.
In sintesi
- Sol si sceglie con /model, con codex -m gpt-6-sol o dal selettore sotto la casella di testo; il livello predefinito è Medium.
- Luna parte da High e arriva fino a Max; Ultra, che divide il lavoro fra subagenti, c'è per Sol e non per Luna.
- Codex propone di passare a Sol a chi usa GPT-5.5, GPT-5.6 Sol e GPT-5.6 Terra, e a Luna a chi usa GPT-5.6 Luna.
- GPT-5.5 esce da ChatGPT, Work e Codex il 14 ottobre 2026: va tolto da script, agenti e configurazioni.
- In Codex cloud il modello non si sceglie; Sol e Luna lavorano in locale, nell'app, nella CLI e nell'IDE.
- Nella simulazione di OpenAI sul traffico interno di Codex, Sol riduce le segnalazioni gravi senza azzerarle (system card).
Come si sceglie GPT-6 Sol in Codex, superficie per superficie
Le regole sono scritte nella pagina dei modelli di Codex e cambiano secondo dove lavori.
| Dove lavori | Come scegli Sol | Da sapere |
|---|---|---|
| App desktop, Work e Codex | Selettore di modello e ragionamento sotto la casella di testo | Nella documentazione il preset di partenza del cursore è Sol Light |
| ChatGPT Work sul web ed estensione per l'IDE | Stesso selettore | In queste interfacce il livello più basso si chiama Light |
| Codex CLI | /model durante la sessione, oppure codex --model gpt-6-sol all'avvio | Qui il livello più basso si chiama Low |
| Esecuzioni non interattive | codex exec -m gpt-6-sol seguito dal compito | Utile negli script e nella CI |
| Codex cloud | Non si sceglie | Le chat in cloud dei piani ChatGPT usano GPT-5.6 Sol |
Per non ripetere la scelta a ogni sessione si scrive nel file config.toml. Le chiavi sono documentate nel riferimento della configurazione: model per il modello, model_reasoning_effort per il livello, plan_mode_reasoning_effort per la modalità di pianificazione e review_model se vuoi che il comando /review usi un modello diverso da quello della sessione.
model = "gpt-6-sol"
model_reasoning_effort = "medium"
review_model = "gpt-6-astra"
L'ultima riga è facoltativa, e Astra è solo un esempio.
Due eccezioni per le aziende. In Enterprise Sol e Luna sono spenti di default, li abilita un amministratore e config.toml non scavalca il workspace (disponibilità dei modelli). Con una chiave API, invece, valgono i modelli della chiave e i prezzi API, senza funzioni cloud come la revisione automatica su GitHub.
Quale livello di ragionamento, per quale lavoro
La documentazione dà un punto di partenza netto: Medium per Sol, High per Luna, Light per Astra, alzando solo quando il compito chiede più pianificazione o controlli. Avverte anche che i livelli non si corrispondono fra generazioni: il Medium di GPT-6 Sol non equivale a quello di GPT-5.6 Sol, quindi rifai una prova su un compito che conosci. Il livello none delle API nel selettore di Codex non c'è.
| Modello e livello | Per cosa lo indica la guida alla scelta del modello |
|---|---|
| Luna, Low | Modifiche puntuali, problemi ben delimitati, estrazione di dati semplici |
| Luna, Medium | Lavoro da istruzioni chiare e aggiornamenti coordinati a materiale esistente |
| Luna, Extra high | Cercare contesto fra più applicazioni, dare priorità, risolvere problemi con vincoli chiari |
| Sol, Low | Scrittura e revisione mirate, verifica dei fatti, lavori lineari nelle app |
| Sol, Medium | Codice, ricerca e flussi quotidiani che richiedono giudizio e completezza |
| Sol, Extra high | Analisi profonde, verifiche accurate, revisione attenta di documenti, dati e codice |
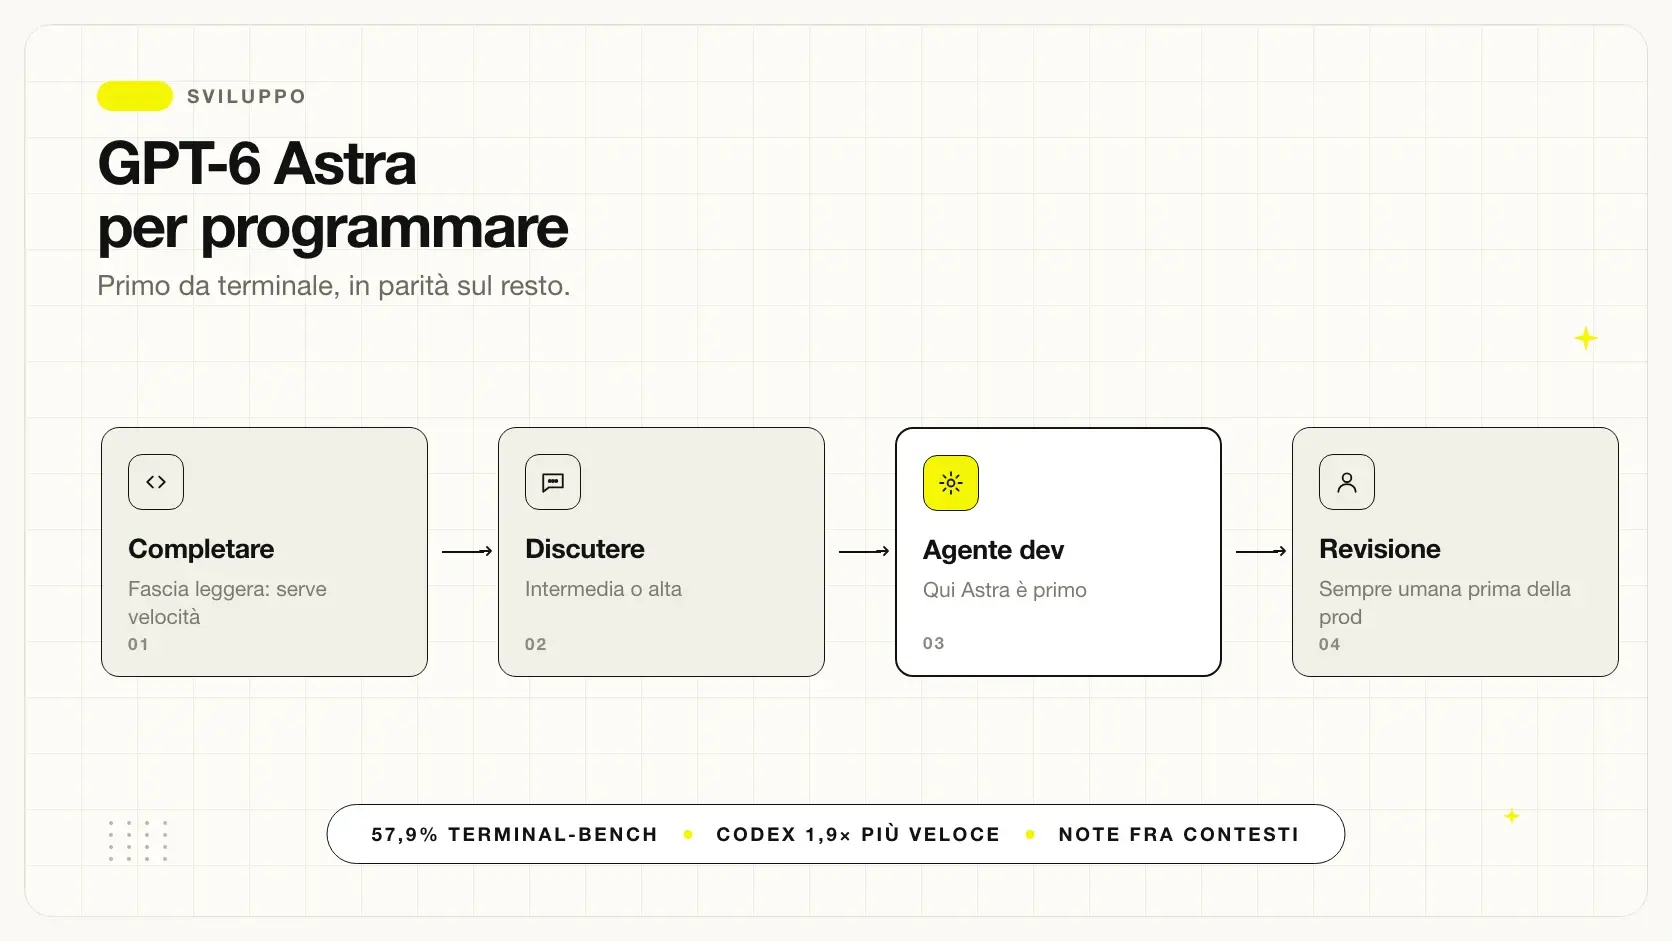
In cima alla scala ci sono due livelli diversi. Max dà al modello più tempo su un singolo compito, e nell'app va attivato nelle impostazioni se non compare. Ultra usa subagenti in parallelo su parti separate dello stesso compito: ha senso quando il lavoro si divide davvero, come una migrazione su moduli indipendenti. Luna arriva fino a Max. E la pagina avverte che la maggior parte dei compiti non ha bisogno né dell'uno né dell'altro. Cosa succede al conto quando si alza il livello è spiegato in reasoning effort: cosa cambia nei confronti.
Cosa cambia nel catalogo di Codex, e cosa devi aggiornare
La modifica che aggiunge Sol e Luna al catalogo è descritta nella pull request #47401 del repository ufficiale, la versione per un ramo di rilascio della #47332, entrata nel ramo principale il 22 settembre. Fa quattro cose: aggiunge i due modelli con descrizioni aggiornate, propone la migrazione da gpt-5.5, gpt-5.6-sol e gpt-5.6-terra verso gpt-6-sol e da gpt-5.6-luna verso gpt-6-luna, reindirizza le selezioni rimaste sui ritirati GPT-5.4 e GPT-5.4 mini, e quando raggiungi i limiti d'uso ti suggerisce di passare a Luna.
Nel file del catalogo Sol è il modello da lavoro per il codice e le attività di ogni giorno, Luna quello veloce ed economico per i compiti più semplici, GPT-5.6 Sol ormai il "vecchio" modello per il lavoro complesso. Per i GPT-5.6 non c'è una data di ritiro: restano disponibili durante il rollout.
La scadenza che richiede un intervento: il 14 ottobre 2026 GPT-5.5 esce da ChatGPT, ChatGPT Work e Codex su tutti i piani, mentre nelle API resta (pagina dei modelli). Chi usa Codex con l'accesso ChatGPT deve sostituirlo con Sol, o con Luna sui piani Free e Go, in tutti questi posti:
- Le impostazioni predefinite del workspace e i modelli salvati nelle preferenze
- Le configurazioni gestite dall'amministratore
- Gli agenti personalizzati e le attività programmate
- Gli script e le pipeline che scelgono il modello per nome
La cache negli agenti: il prefisso che Codex rimanda a ogni turno
Un agente di programmazione rimanda al modello, a ogni passo, un prefisso quasi identico: istruzioni di sistema, strumenti, il tuo AGENTS.md, i file già letti. Solo le istruzioni di base con cui Codex presenta Sol superano le 2.900 parole nel file del catalogo, prima ancora del tuo progetto: per questo la cache pesa più del listino.
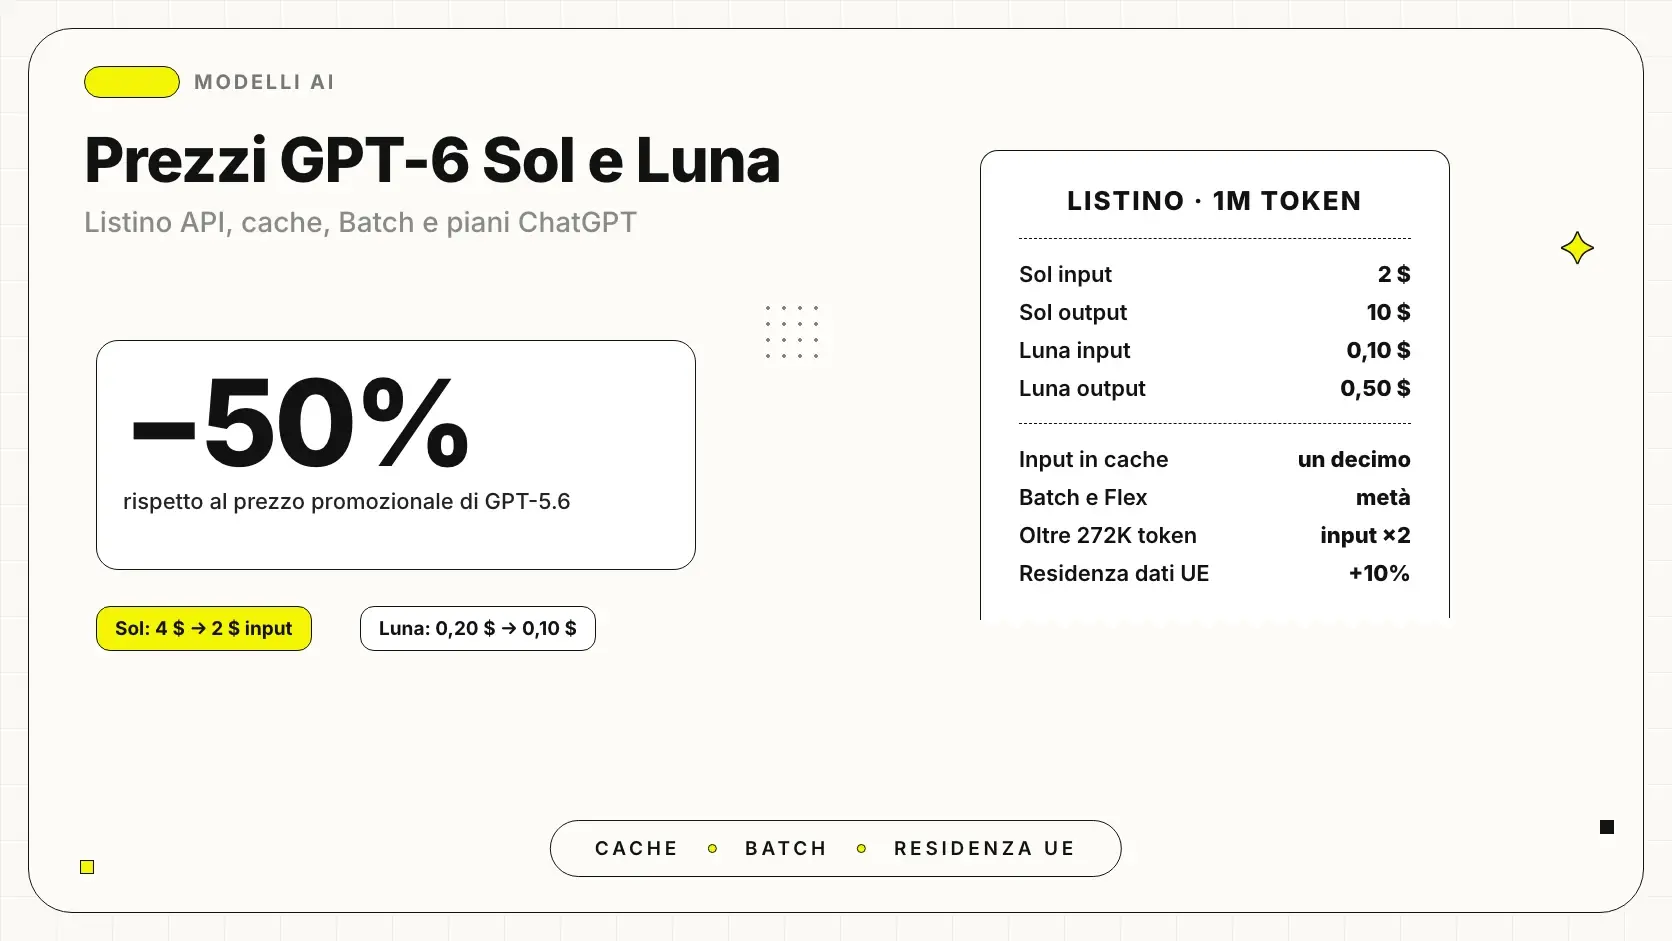
Con GPT-6 la lettura dalla cache costa un decimo dell'input normale e lo sconto vale per i prefissi riutilizzati entro 30 minuti (Better prompt caching for GPT-6). Cambiare livello di ragionamento a metà conversazione non la rompe più, se lo fai con un aggiornamento di configurazione. Per gli strumenti vale il contrario dell'istinto: definizioni, schemi e ordine stabili, limitando quelli richiamabili invece di toglierli e rimetterli. La diagnostica di OpenAI dice perché un prefisso non è stato riutilizzato, per esempio perché gli strumenti sono cambiati.
Chi usa Codex con un piano ChatGPT ha un incentivo in più: nei crediti l'input in cache di Sol costa 5 crediti per milione di token contro 50 dell'input normale, e la scrittura in cache non si paga a parte (prezzi di Codex). La stessa pagina dà due consigli pratici: tenere piccolo AGENTS.md, eventualmente dividendolo per cartella, e spegnere i server MCP che non servono, perché ognuno aggiunge contesto a ogni messaggio.
Se costruisci un agente tuo sulle API con Sol
La guida alla cache permette di mettere punti di interruzione espliciti dove finisce la parte stabile del prompt: quello che viene dopo si paga all'input normale, senza costo di scrittura. Il prefisso minimo memorizzabile è di 1.024 token e ogni richiesta può creare fino a quattro scritture in cache. Per cambiare livello fra una risposta e l'altra senza perdere il prefisso si usa un elemento configuration_update.
Quanto costa un task, secondo i numeri di OpenAI
L'annuncio dà un solo costo per task in dollari e diversi risparmi relativi, misurati da OpenAI con punteggi dei concorrenti presi da report pubblici e livelli di ragionamento diversi da riga a riga (pagina di lancio).
| Test | Configurazione | Costo dichiarato |
|---|---|---|
| AutomationBench 1.0.6 | Sol a xhigh, 33,2% | 0,27 $ per task, circa un undicesimo di Opus 5 a max |
| DeepSWE v1.1 | Sol a max, 68,8% | Circa l'80% in meno per task di Fable 5 a xhigh (69,9%) |
| DeepSWE v1.1 | Luna a max, 66,6% | Il 93% in meno di Opus 5 e il 96% in meno di Fable 5, confrontati a medium |
| FrontierCode 1.1 Main | Sol (livello non indicato) pari a Fable 5.1 a xhigh | "Molto più basso", senza numeri |
| OSWorld 2.0 offline | Sol a xhigh, 60,5% | Circa l'80% in meno di Opus 5 a medium (60,3%) |
Il confronto è con Claude Opus 5 e Fable, non con Opus 5.5 uscito lo stesso giorno, e test comuni fra Sol e Opus 5.5 non ce ne sono: cosa si può dire lo stesso è in GPT-6 Sol vs Claude Opus 5.5. E un benchmark misura compiti scelti da altri, non il tuo repository, come spiega SWE-bench e i benchmark di coding. Nei piani ChatGPT il costo si legge nei limiti d'uso, raccolti in prezzi di GPT-6 Sol e Luna.
Quanto spendono in token i ricercatori di OpenAI
OpenAI scrive che il suo uso interno di agenti di programmazione cresce in modo esponenziale: valutato ai prezzi delle API, il consumo giornaliero supera i 600 dollari per il ricercatore mediano e i 7.000 dollari al novantesimo percentile (annuncio). Il dato viene da un rapporto del 6 settembre, Research acceleration: the view inside OpenAI, che definisce "ricercatore" chiunque lavori nell'organizzazione di ricerca e aggiunge due numeri utili: a metà agosto l'organizzazione usava 3,1 giornate di lavoro di agenti per ogni giornata di lavoro umano, e negli ultimi sei mesi più della metà dei compiti riusciti da quattro a otto ore ha richiesto almeno un intervento di una persona.
Per una PMI la lezione non è la cifra. È che quando gli agenti lavorano per ore il costo per compito diventa la voce che decide, e che anche dentro OpenAI i compiti lunghi riescono solo con qualcuno che interviene.
Dove Sol sbaglia ancora: limiti e revisione del codice
La system card di Astra contiene un'appendice su Sol e Luna con un test fatto proprio su Codex. OpenAI ha simulato il passaggio a GPT-6 Sol su 50.319 task del proprio traffico interno di Codex: le segnalazioni di comportamento scorretto di gravità 3 o superiore scendono da 66 (0,131%) a 42 (0,083%), nessuna di gravità 4, e quelle di gravità 1 o 2 passano dal 19,67% al 14,80% dei task (system card). I cali maggiori riguardano istruzioni ignorate, incertezza nascosta e inganno; le segnalazioni di esfiltrazione invece aumentano.
Tradotto: su un task ogni sette circa qualcosa merita ancora un'occhiata. Il comando /review serve a questo: nella CLI, nell'app e nell'IDE rivede il ramo rispetto a quello di base, le modifiche non ancora registrate in un commit o un singolo commit, anche con criteri tuoi, e riporta i problemi in ordine di priorità senza toccare i file (guida alla revisione). Se chiedi a Codex di applicare le correzioni, valgono le tue regole di sandbox e di approvazione.
Due modi di organizzare il lavoro del team
Un team di tre sviluppatori su un gestionale interno. Un esempio: il team lavora nell'IDE con Sol a Medium come predefinito nel config.toml condiviso. I lavori ripetitivi, come rinominare un campo in cento file o scrivere i test di base, vanno su Luna a High, che consuma molto meno quota del piano. Prima di ogni merge si lancia /review sul ramo e una persona legge i problemi segnalati.
Una software house che usa Codex nella pipeline. Un altro esempio: Codex gira in CI con una chiave API e codex exec -m gpt-6-sol che rivede le modifiche. Qui contano i prezzi API a consumo, quindi livello di ragionamento e cache diventano voci da misurare ogni mese. Il quadro dei modelli per il codice è in miglior modello AI per programmare, la scelta fra i due modelli OpenAI in GPT-6 Sol vs Luna.
Le impostazioni che fanno perdere tempo e crediti
- Max o Ultra fissi per sicurezza. Allungano i tempi e consumano quota per niente.
- Fast mode sempre acceso. Per Sol e Luna consuma 2,5 volte i crediti Standard; si controlla con /fast status (velocità in Codex).
- Server MCP accesi e spenti a metà sessione. Cambiano gli strumenti nel prefisso e possono far perdere la cache.
- Aspettarsi Sol nel cloud. Codex cloud sceglie da solo il modello.
- Credere che il modello scelto in ChatGPT valga anche nella CLI. Un'impostazione del workspace ChatGPT non si applica da sola a Codex.
Da dove partire con il tuo team
- Aggiorna la CLI e l'app. Sol e Luna compaiono nel selettore della CLI dalla versione 0.156.1.
- Imposta Sol a Medium come predefinito e sposta su Luna i lavori ripetitivi.
- Rifai dieci compiti già chiusi e confronta tempi, iterazioni e qualità con il modello di prima.
- Togli GPT-5.5 da script e configurazioni prima del 14 ottobre.
- Metti /review prima di ogni merge e controlla i limiti con /status.
Codex con GPT-6 Sol costa meno per token e, secondo OpenAI, fa durare di più i limiti del piano, ma resta un collega da istruire e da rileggere. Se vuoi portare Codex o un agente di programmazione dentro i processi del tuo team, o farti costruire lo strumento che manca, parliamone partendo dal tuo codice: è il lavoro che facciamo nel software su misura.
Come lo applichiamo in azienda
Risorse correlate
FAQ
Come si sceglie GPT-6 Sol in Codex?
Nella CLI si usa il comando /model oppure si avvia Codex con codex --model gpt-6-sol. Nell'app desktop, in ChatGPT Work sul web e nell'estensione per l'IDE c'è il selettore sotto la casella di testo. Per renderlo predefinito si imposta model = "gpt-6-sol" nel file config.toml.
Qual è il livello di ragionamento predefinito di Sol in Codex?
Medium. La documentazione di Codex consiglia di partire da Medium con Sol, da High con Luna e da Light con Astra, e di alzare il livello solo quando il compito richiede più pianificazione, analisi o verifiche.
Cos'è il livello Ultra di Codex?
È un livello che va oltre il singolo agente: Codex divide il compito e usa dei subagenti che lavorano in parallelo su parti separate. È disponibile con Sol ma non con Luna, che arriva fino a Max, e secondo OpenAI la maggior parte dei compiti non ha bisogno né di Max né di Ultra.
Posso usare GPT-6 Sol in Codex cloud?
Per ora no. Il modello di Codex cloud non si sceglie e, secondo la pagina dei prezzi, le chat in cloud dei piani ChatGPT usano GPT-5.6 Sol. Sol e Luna si usano nell'app desktop, in ChatGPT Work sul web, nella CLI e nell'estensione per l'IDE.
Cosa devo cambiare prima del 14 ottobre?
Se usi Codex con l'accesso ChatGPT, GPT-5.5 va sostituito ovunque sia impostato: il 14 ottobre 2026 esce da ChatGPT, ChatGPT Work e Codex, mentre nelle API resta. La documentazione indica impostazioni del workspace, modelli salvati, configurazioni gestite, agenti personalizzati, attività programmate e script.
Quanto costa un task di programmazione con GPT-6 Sol?
Dipende dal compito e dal livello di ragionamento. L'unico costo per task in dollari pubblicato da OpenAI riguarda AutomationBench, 0,27 dollari con Sol al livello xhigh; per i test sul codice l'annuncio indica solo risparmi relativi rispetto ai modelli Claude. Sul tuo codice il numero va misurato.
Con Sol serve ancora rileggere il codice?
Sì. Nella simulazione di OpenAI sul proprio traffico interno di Codex, GPT-6 Sol riceve meno segnalazioni di comportamenti scorretti di GPT-5.6 Sol, ma non zero. Il comando /review e la lettura di una persona prima del merge restano parte del lavoro.