
Claude Fable 5.2 aziende: quando conviene alle PMI
Claude Fable 5.2 aziende: quali compiti giustificano 8/40 $ per milione di token, quali restano a Opus 5.5 o Sonnet, e come adottarlo in 4 passi.
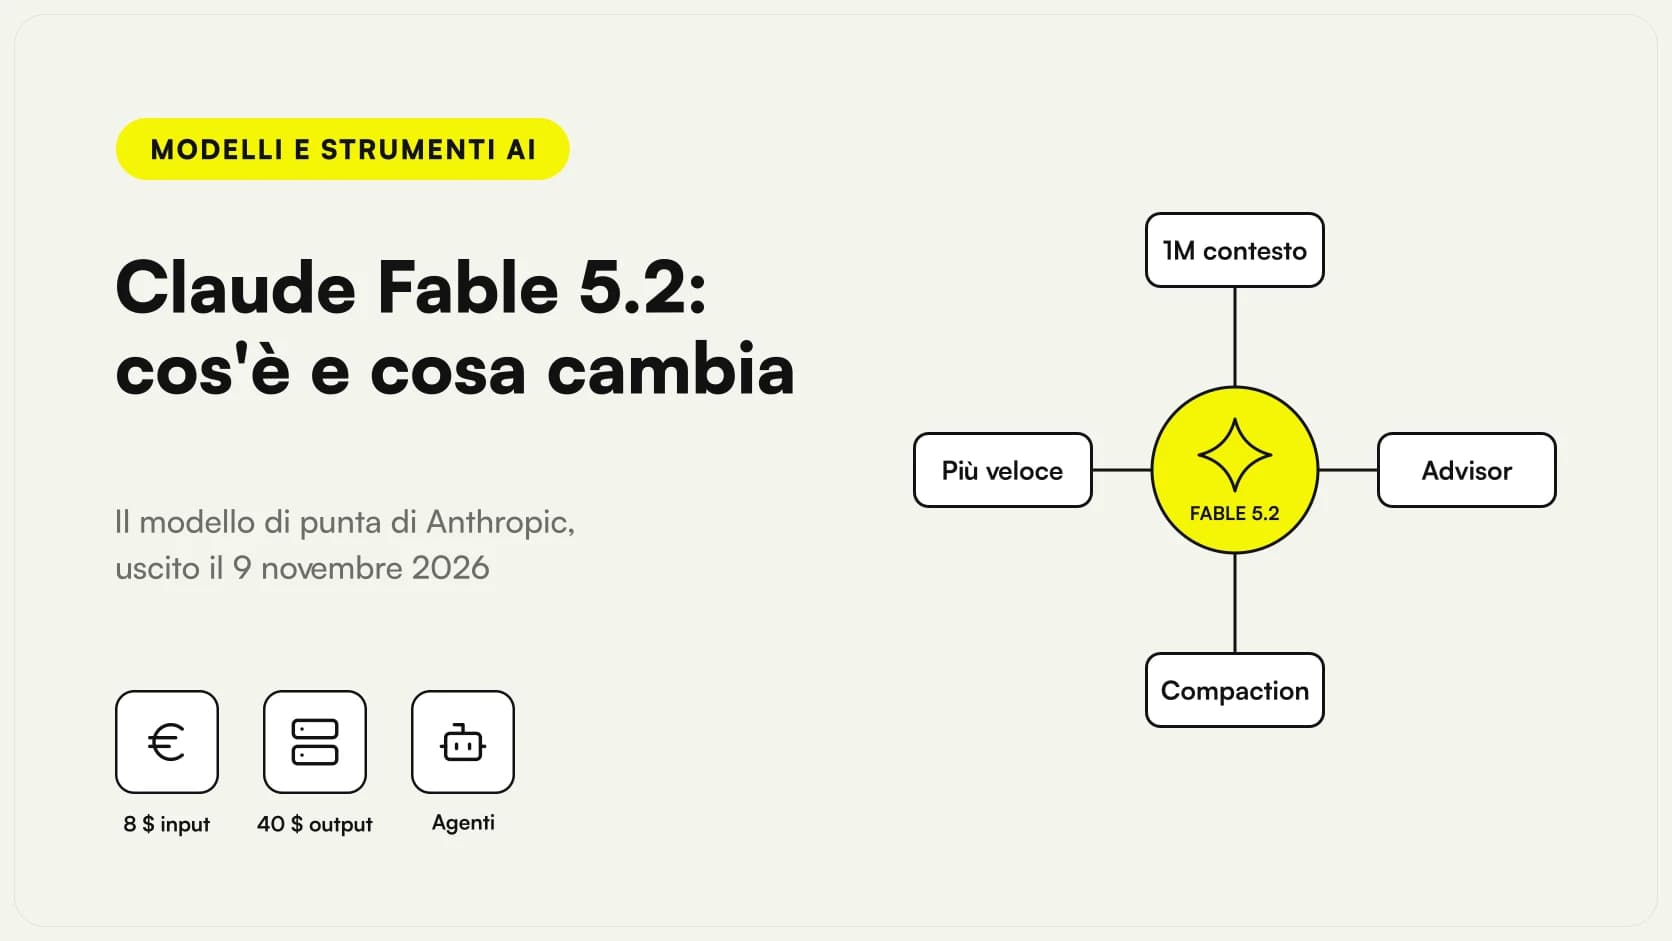
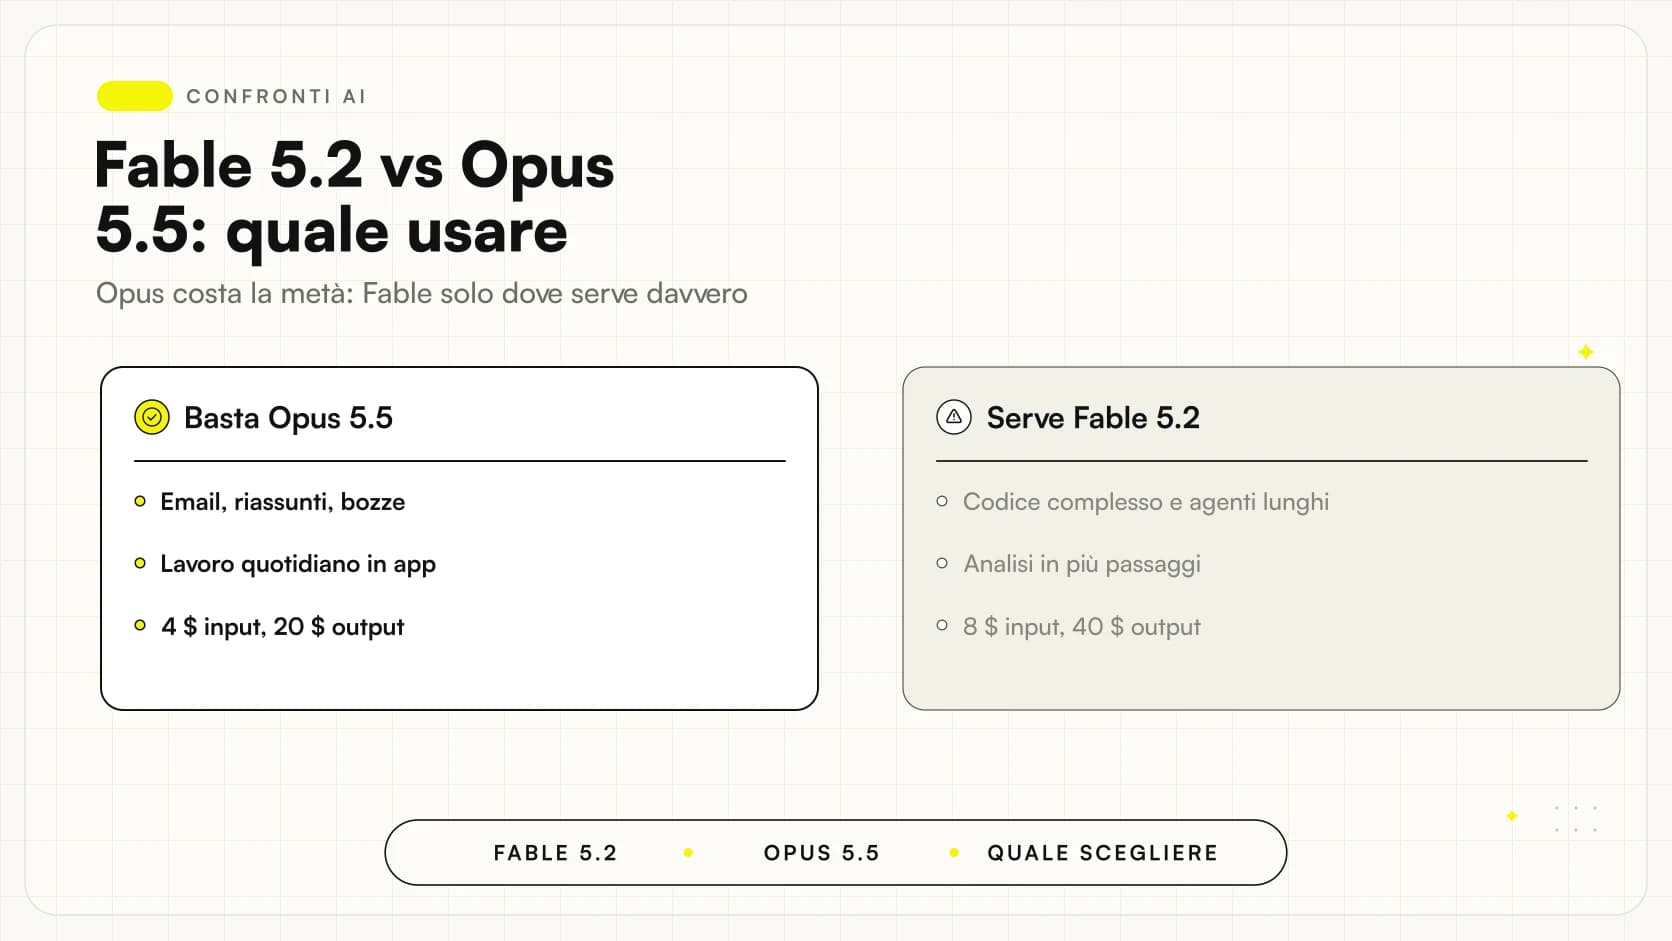
Claude Fable 5.2, rilasciato da Anthropic il 9 novembre 2026, in azienda serve per un numero ristretto di compiti: quelli lunghi, difficili e costosi da sbagliare. Il listino è 8 e 40 dollari ogni milione di token (lettura e scrittura), il doppio di Claude Opus 5.5, ed è lo stesso Anthropic a indicare Opus 5.5 come modello di partenza per la maggior parte del lavoro. Per una PMI la domanda giusta quindi non è «è il modello migliore?», ma «quali dei nostri compiti valgono il doppio del prezzo?». I dati arrivano dall'annuncio ufficiale e dalla scheda del modello, consultati il 9 novembre 2026.
Questa guida è pensata per chi decide: titolari, responsabili IT, professionisti. Le specifiche del modello stanno nella guida a Claude Fable 5.2; qui trovate un criterio per assegnare ogni compito al modello giusto, i costi di esempio, i limiti sui dati e un percorso di adozione in quattro passi.
In sintesi
- Anthropic indica Fable 5.2 per il lavoro tecnico più ambizioso e consiglia Opus 5.5 come modello quotidiano, come si legge nell'annuncio del 9 novembre 2026.
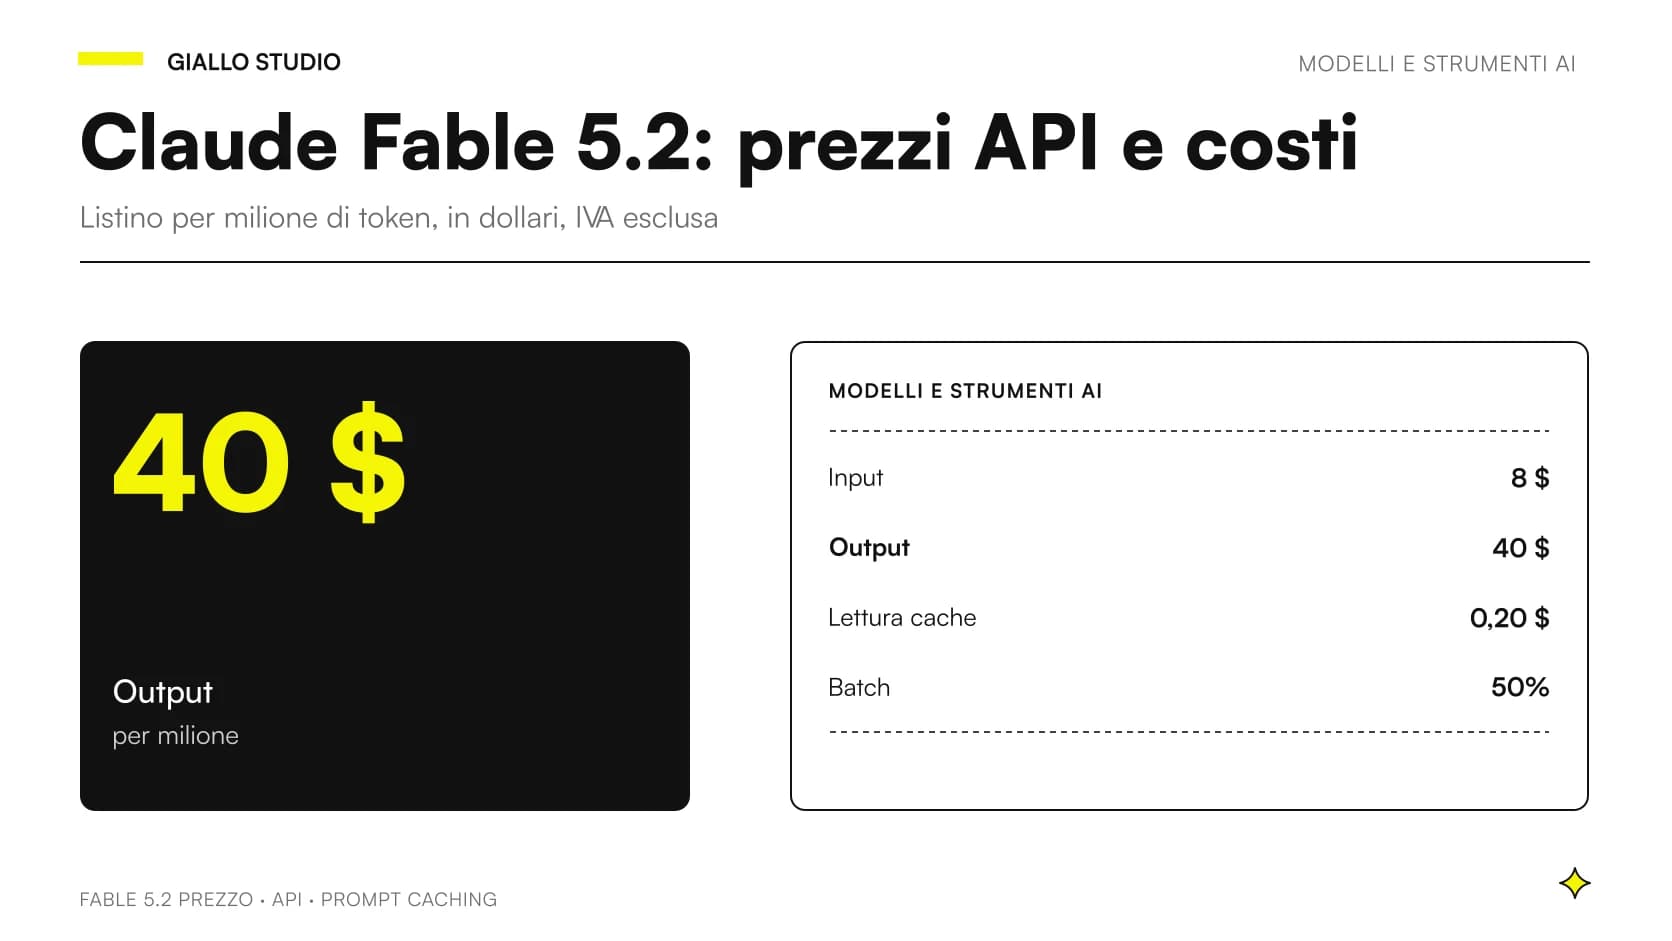
- Il listino di Fable 5.2 è 8 e 40 dollari per milione di token, quello di Opus 5.5 è 4 e 20, secondo la scheda ufficiale.
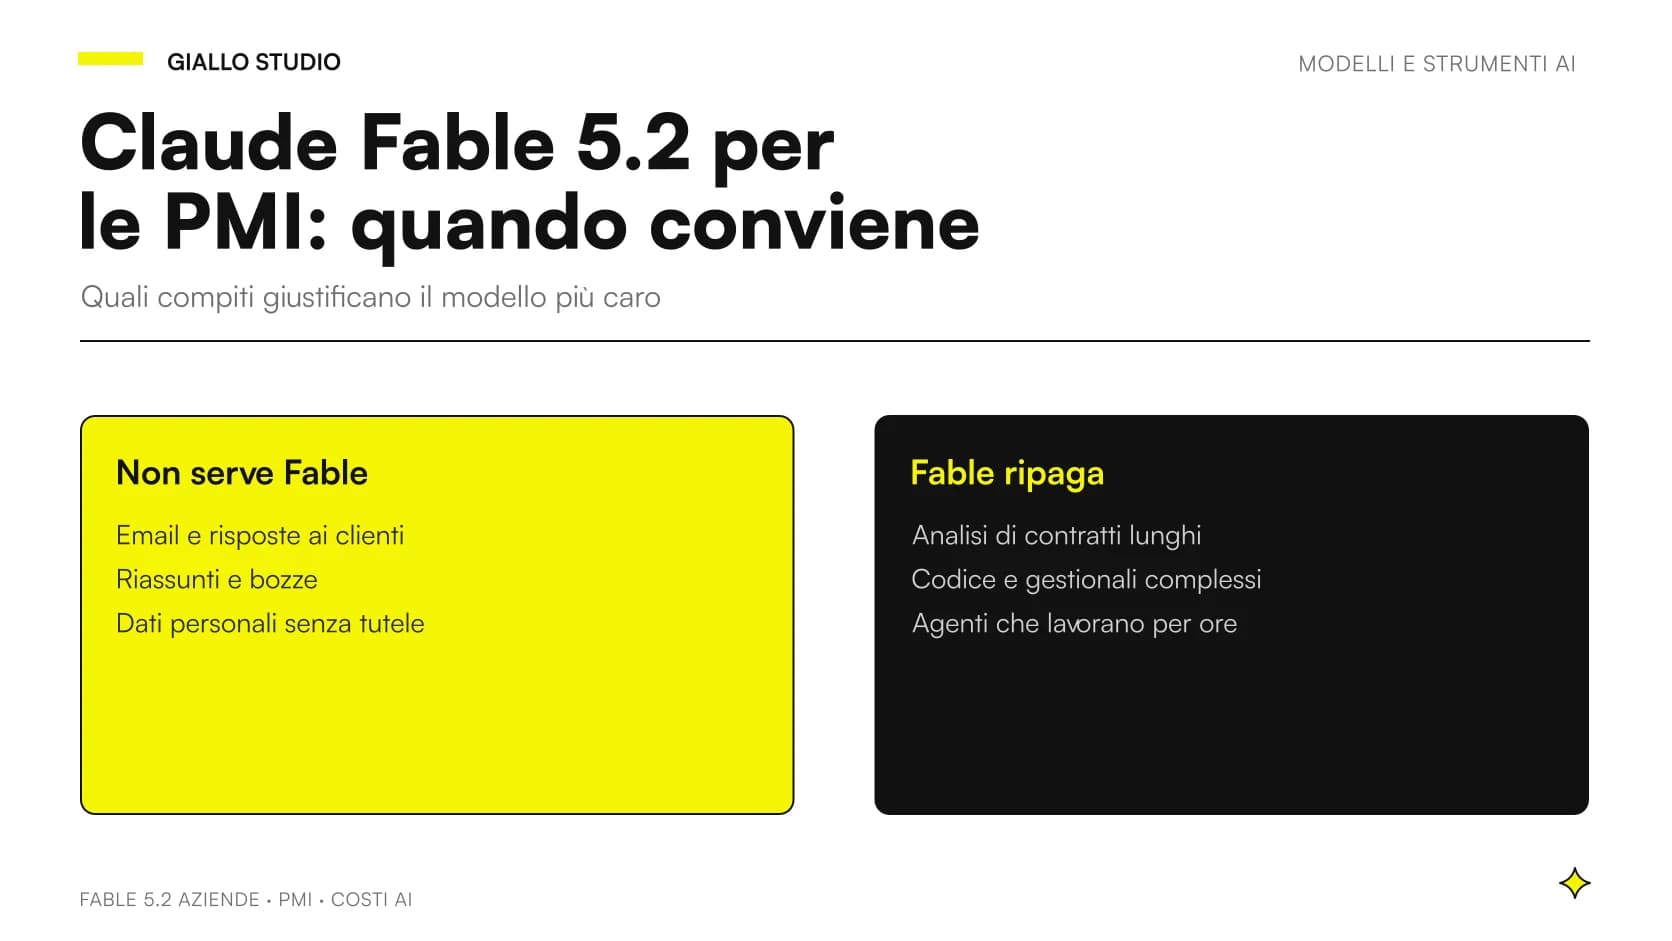
- Fable 5.2 giustifica il costo quando un errore a metà compito fa perdere ore: analisi di molti documenti, codice complesso, agenti di lunga durata.
- Per scrittura, riassunti, risposte ai clienti e compiti ripetitivi bastano Opus 5.5, Sonnet 5.5 o Haiku 5.5.
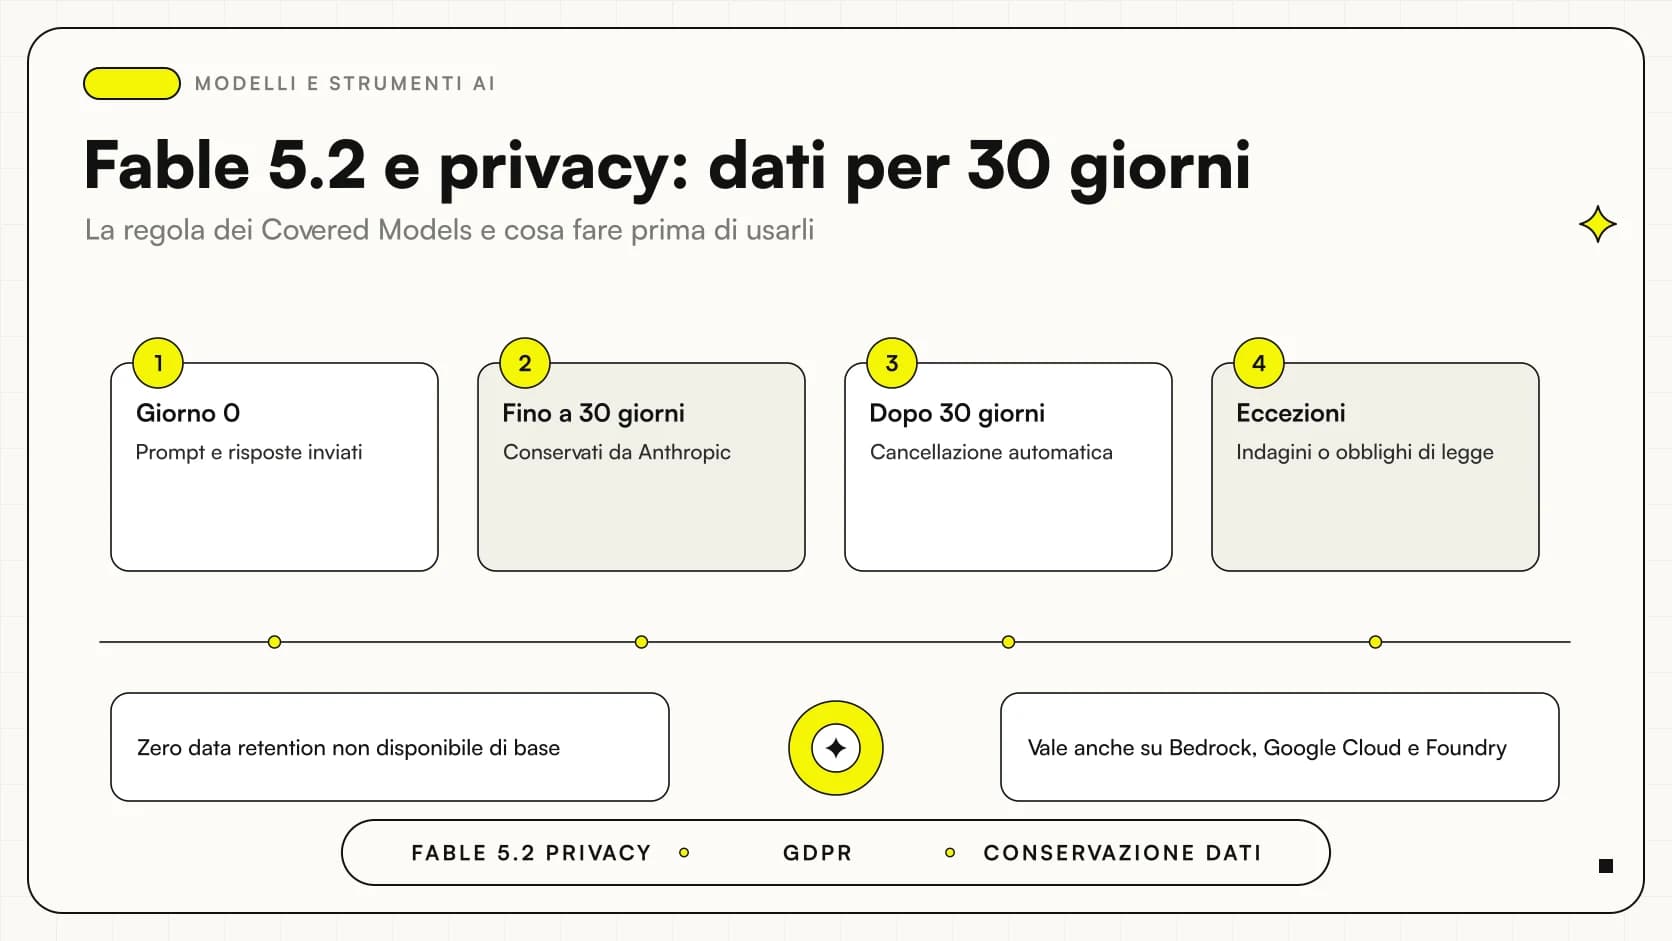
- I dati inviati a Fable 5.2 sono conservati almeno 30 giorni e la zero data retention non è disponibile, come indica la pagina Covered Models.
- Il modo sicuro di adottarlo è un test su 15-20 casi reali, confrontando Opus 5.5 e Fable 5.2 su qualità, tempo e costo.
Per quali compiti aziendali vale la pena usare Fable 5.2?
Vale la pena quando il compito ha tre caratteristiche insieme: è lungo (molti passaggi, molti documenti), è difficile (serve incrociare informazioni, non solo riassumerle) ed è costoso da sbagliare (un errore scoperto tardi fa rifare tutto). La scheda ufficiale lo presenta per lavori da agente che durano ore, per ricerche a più tappe e per analisi che arrivano a un documento completo.
Tradotto in attività di una PMI, a titolo di esempio:
- Controllo incrociato di documenti: capitolato, offerte e contratti da confrontare per trovare incoerenze (è il terreno che trattiamo in Claude per documenti lunghi).
- Codice e integrazioni complesse: migrazioni di un gestionale, scrittura di test, correzione di errori sparsi in più file.
- Agenti che lavorano a lungo: elaborazioni che girano per ore con strumenti, dove il modello deve decidere cosa fare a ogni passo (il quadro è in agenti AI per aziende).
- Analisi con molte variabili: confronti tra fornitori, controllo di margini su centinaia di righe, relazioni con questioni aperte.
Un punto a favore dei compiti lunghi: secondo Anthropic, in una prova di programmazione (FrontierCode 2.0) Fable 5.2 con ragionamento «High» raggiunge Opus 5.5 al livello «Max» spendendo circa la metà per compito. È un dato del produttore, non replicato da terzi, ma indica la direzione: il prezzo per token più alto non coincide sempre con un costo per compito più alto.
Quali compiti restano a Opus 5.5, Sonnet 5.5 e Haiku 5.5?
La maggior parte. Nella documentazione Anthropic il listino per milione di token è 4 e 20 dollari per Opus 5.5, 2 e 10 per Sonnet 5.5, da 0,10 e 0,50 per Haiku 5.5 (panoramica dei modelli). La regola pratica è assegnare ogni attività al livello più basso che passa il vostro test, e salire solo se fallisce.
| Tipo di attività | Modello da cui partire | Perché |
|---|---|---|
| Classificare email, smistare richieste, estrarre campi da moduli | Haiku 5.5 | Volume alto, regole semplici, costo minimo |
| Bozze di email, riassunti, schede prodotto, verbali | Sonnet 5.5 | Qualità adeguata, risposte veloci |
| Analisi di un contratto, codice di media difficoltà, preventivi articolati | Opus 5.5 | Il «modello quotidiano» indicato da Anthropic |
| Incroci tra molti documenti, migrazioni, agenti di ore | Fable 5.2 | Si sale solo se Opus a effort alto non basta |
| Ricerca di sicurezza informatica o biomedica | Mythos 5.2, su approvazione | Non è il caso di una PMI generica |
Il confronto con la famiglia intera, e come scegliere nel concreto, è in Modelli Claude a confronto; il livello intermedio è trattato in Claude Opus 5.5 per una PMI. I due livelli alti sono messi a confronto in Fable 5.2 contro Opus 5.5.
Quanto costa davvero un compito con Fable 5.2?
Il costo dipende da quanti token il modello legge e da quanti ne scrive, ragionamento compreso. Gli esempi qui sotto sono calcoli dichiarati come tali, fatti sul listino ufficiale del 9 novembre 2026, senza cache né Batch API e con token ipotizzati. I prezzi sono in dollari e IVA esclusa per l'Italia; prezzi in euro non risultano nelle pagine ufficiali consultate.
| Compito di esempio (token in ingresso / uscita) | Fable 5.2 (dollari) | Opus 5.5 (dollari) | Sonnet 5.5 (dollari) |
|---|---|---|---|
| Riassunto di una email: 2.000 / 500 | 0,036 | 0,018 | 0,009 |
| Analisi di un contratto lungo: 200.000 / 5.000 | 1,80 | 0,90 | 0,45 |
| Sessione di agente di ore, somma di più chiamate: 1.500.000 / 200.000 | 20 | 10 | 5 |
Due cose da tenere a mente. La prima: su un singolo compito le differenze sono centesimi o pochi dollari; diventano un tema solo a volume alto, per esempio mille email al giorno. La seconda: sulle sessioni lunghe pesano i subagent, che la documentazione indica come una parte importante del costo di una sessione. Per ridurlo, Anthropic prevede il Batch API a metà prezzo per i lavori non urgenti e la cache per le parti ripetute; il dettaglio si trova in prezzi API di Fable 5.2.
Meglio un modello solo o più modelli insieme?
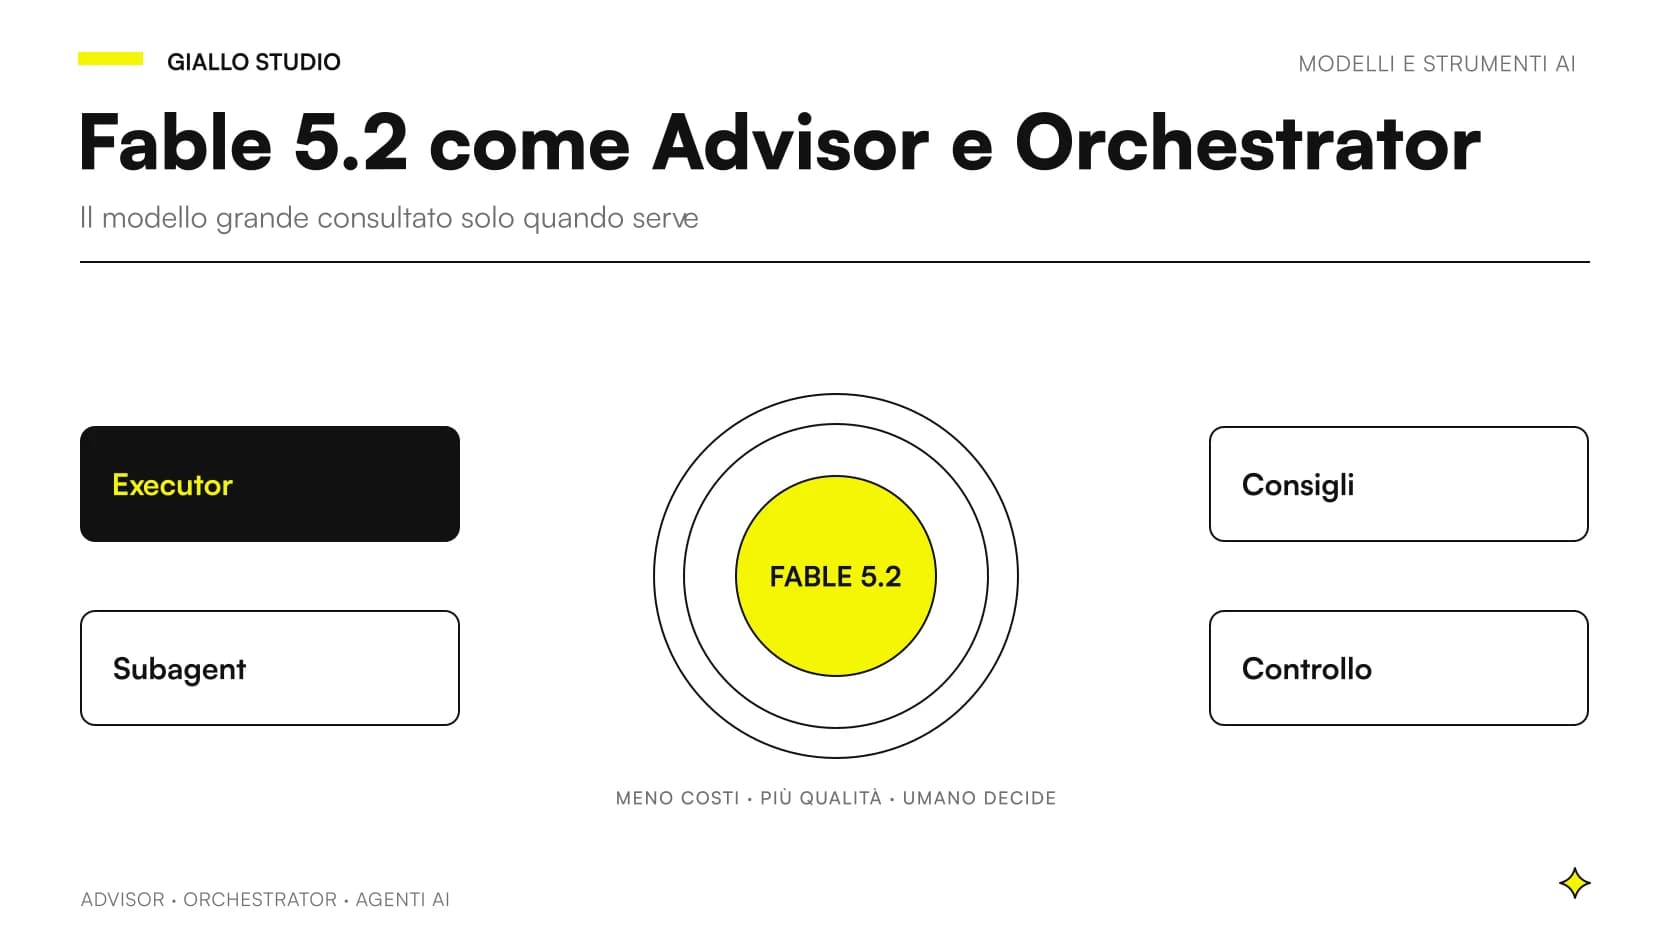
Quasi sempre più modelli. Nell'annuncio Fable 5.2 ha due ruoli possibili: Advisor, il consulente che Haiku, Sonnet o Opus interpellano se il problema è ostico, e Orchestrator, il coordinatore che affida le parti facili a modelli più piccoli. In una PMI significa pagare il livello alto solo nei passaggi che lo richiedono, per esempio la decisione finale di un agente, mentre il lavoro di routine resta su modelli economici. Per la configurazione c'è la guida su Advisor e Orchestrator; l'approccio generale è in strategia a modello misto.
Il tema ha un approfondimento: privacy e conservazione dei dati con Fable 5.2. Per un test, la strada più semplice è usare documenti anonimizzati o di fantasia.
Un esempio: un'impresa edile a Bologna prepara un'offerta di gara
Esempio dichiarato come tale, non un caso reale. Un'impresa edile a Bologna deve rispondere a una gara privata con capitolato, computo metrico, tre offerte di subfornitori e un cronoprogramma. Il lavoro ha tre livelli di difficoltà diversi:
- Smistare e riassumere i documenti ricevuti e preparare la scheda di ogni offerta: lavoro lineare, adatto a Sonnet 5.5.
- Confrontare le tre offerte voce per voce e segnalare le differenze rispetto al capitolato: livello Opus 5.5.
- Verificare la coerenza tra capitolato, computo e cronoprogramma: trovare le voci che non tornano tra documenti diversi e produrre l'elenco delle questioni aperte. È il passaggio in cui un errore costa di più, perché si scopre dopo la consegna.
Solo il terzo punto è un candidato per Fable 5.2, e solo se il test lo conferma. L'impresa prende cinque gare già chiuse, di cui conosce le incongruenze reali, e le passa a Opus 5.5 e a Fable 5.2: se Fable individua le incoerenze sfuggite a Opus, la spesa extra è giustificata; se il risultato è pari, resta su Opus. In ogni caso l'offerta la firma una persona, non il modello. La stessa logica vale per uno studio professionale o per un'officina con il suo gestionale.
Quali limiti di Fable 5.2 contano in azienda?
La documentazione ufficiale elenca comportamenti utili da conoscere prima di metterlo in un flusso di lavoro:
- dal livello di ragionamento «medium» in su riflette anche quando gli si chiede di non farlo: per richieste semplici è meglio un modello più leggero;
- nei lavori lunghi può interrompersi prima della fine, soprattutto ai livelli bassi: servono un criterio di completamento scritto e un controllo del risultato;
- prende alla lettera le regole di stile: un tetto rigido alla lunghezza delle frasi produce testi a scatti;
- se avete già un'integrazione con la versione 5.1, alcune modifiche all'API richiedono lavoro di migrazione.
Non abbiamo trovato recensioni indipendenti né dati ufficiali sulla qualità in italiano: i benchmark pubblicati sono dichiarati da Anthropic. Per questo il test sui vostri documenti, in italiano, è parte della decisione. I limiti sono approfonditi in limiti noti di Fable 5.2.
Quali errori evitare quando si introduce Fable 5.2?
- Sceglierlo perché è il più potente. Su compiti banali un modello di punta, che costa il doppio di Opus 5.5, è una spesa senza ritorno.
- Decidere sui benchmark. Una prova di coding pubblica non misura i vostri contratti, il vostro gestionale o il vostro italiano.
- Inviare dati reali al primo test. Per via della conservazione di 30 giorni, il primo giro va fatto su materiale anonimizzato.
- Non fissare un budget. Nelle sessioni di agente conviene un tetto di spesa per compito e un controllo dei token a fine giornata.
- Togliere la revisione umana. Anche con punteggi alti, i passaggi con conseguenze (offerte, contratti, comunicazioni ai clienti) vanno controllati da una persona.
Come adottarlo in quattro passi
- Partite da un compito difficile, non dal più frequente: un controllo tra documenti, una migrazione, un'analisi lunga.
- Raccogliete 15 o 20 casi reali anonimizzati, con la risposta giusta già nota, e scrivete in anticipo cosa significa «riuscito».
- Fate girare Opus 5.5 e Fable 5.2, entrambi a effort high, sugli stessi casi, registrando qualità, tempo e spesa di ciascuno.
- Scegliete in base ai risultati: Fable solo dove il miglioramento ripaga la spesa, con una persona che controlla i passaggi importanti e un nuovo test a ogni versione del modello.
Noi di Giallo Studio lavoriamo così: partiamo da una prova su casi vostri, non da un abbonamento, e assegniamo ogni attività al modello più economico che supera il test. Per le attività con molti documenti o con agenti di lunga durata, inseriamo Fable 5.2 solo dopo la misura. Se non sapete ancora quali compiti della vostra azienda meritino un modello di questo livello, la nostra consulenza AI comincia da questa domanda; per l'inquadramento generale dell'assistente nel lavoro quotidiano, Claude per aziende. Prezzi e offerte cambiano spesso: controllate le pagine ufficiali di Anthropic prima di impegnarvi.
Metodo e fonti delle guide di Giallo Studio
Vuoi applicarlo alla tua azienda?In 30 minuti, gratis: il processo da automatizzare per primo e il ritorno stimato, per iscritto.
Prenota l’audit gratuitoCome lo applichiamo in azienda
Risorse correlate
 Claude Fable 5.2 Pro, Max e Team: limiti, reset e offerta di lancio
 Claude Mythos vs Fable 5.2: differenze vere e chi può usarli
 Claude Fable 5.2: cos'è, cosa cambia, quanto costa e a chi serve
 Fable 5.2 vs Opus 5.5: quale usare e quando
 Claude Fable 5.2 prezzo: listino API e costi reali
 Claude advisor orchestrator: come usare Fable 5.2 negli agenti AI
 Fable 5.2 privacy: dati conservati 30 giorni e cosa fare in una PMI
 Claude Fable 5.2 limiti: quelli noti e come aggirarli
 Claude AI per aziende
 Claude Opus 5.5 per una PMI: cinque usi concreti e quando non serve
FAQ
Claude Fable 5.2 conviene a una PMI?
Conviene solo per i compiti difficili e lunghi dove Opus 5.5 non basta, non come modello di tutti i giorni. Anthropic stessa consiglia di partire da Opus 5.5 e di salire a Fable per il lavoro più ambizioso. Per email, riassunti e risposte ai clienti si spende il doppio senza un vantaggio visibile.
Quanto costa usare Fable 5.2 in azienda?
Il listino è di 8 dollari per milione di token in input e 40 in output, secondo la scheda ufficiale consultata il 9 novembre 2026. Il costo reale di un compito dipende dai token letti, da quelli generati (compreso il ragionamento) e dall'effort scelto. Prezzi in euro non risultano indicati nelle pagine ufficiali consultate.
Quali attività giustificano Fable 5.2?
Quelle in cui un errore a metà percorso costa ore di lavoro: analisi di molti documenti da incrociare, codice complesso, agenti che lavorano per ore. Sono i casi per cui Anthropic descrive il modello. Prima di adottarlo va misurato sui vostri esempi, non sui benchmark.
Posso usare Fable 5.2 con dati dei clienti?
Sì, ma con cautela: Fable 5.2 è un Covered Model e prompt e risposte sono conservati per almeno 30 giorni, senza zero data retention salvo autorizzazione di Anthropic. Prima di inviare dati personali servono informativa, accordo sul trattamento e il parere di un consulente privacy. Sull'elaborazione in UE le pagine consultate non dicono nulla.
Serve un abbonamento Enterprise per usare Fable 5.2?
No. Il modello è disponibile nelle app Claude, nella Claude Platform via API e sulle piattaforme cloud di Amazon, Google e Microsoft. Nemmeno con Enterprise è disponibile la zero data retention per i Covered Model, salvo autorizzazione di Anthropic, quindi il piano non cambia il quadro dei dati. I dettagli dei piani sono sulle pagine ufficiali.
Come si prova Fable 5.2 senza rischiare?
Si scelgono 15-20 casi reali anonimizzati di cui si conosce la risposta giusta e si confrontano Opus 5.5 e Fable 5.2 su qualità, tempo e costo. Poi si decide con i numeri, tenendo un revisore umano sui passaggi che contano. Il test si fa in pochi giorni e costa poco.