
Kimi API: modelli, prezzi e integrazione Moonshot
Kimi API: endpoint Moonshot, modelli attuali, token, cache e strumenti. Come stimare il costo e progettare un'integrazione aziendale controllabile.
Tempo di lettura: 10 min
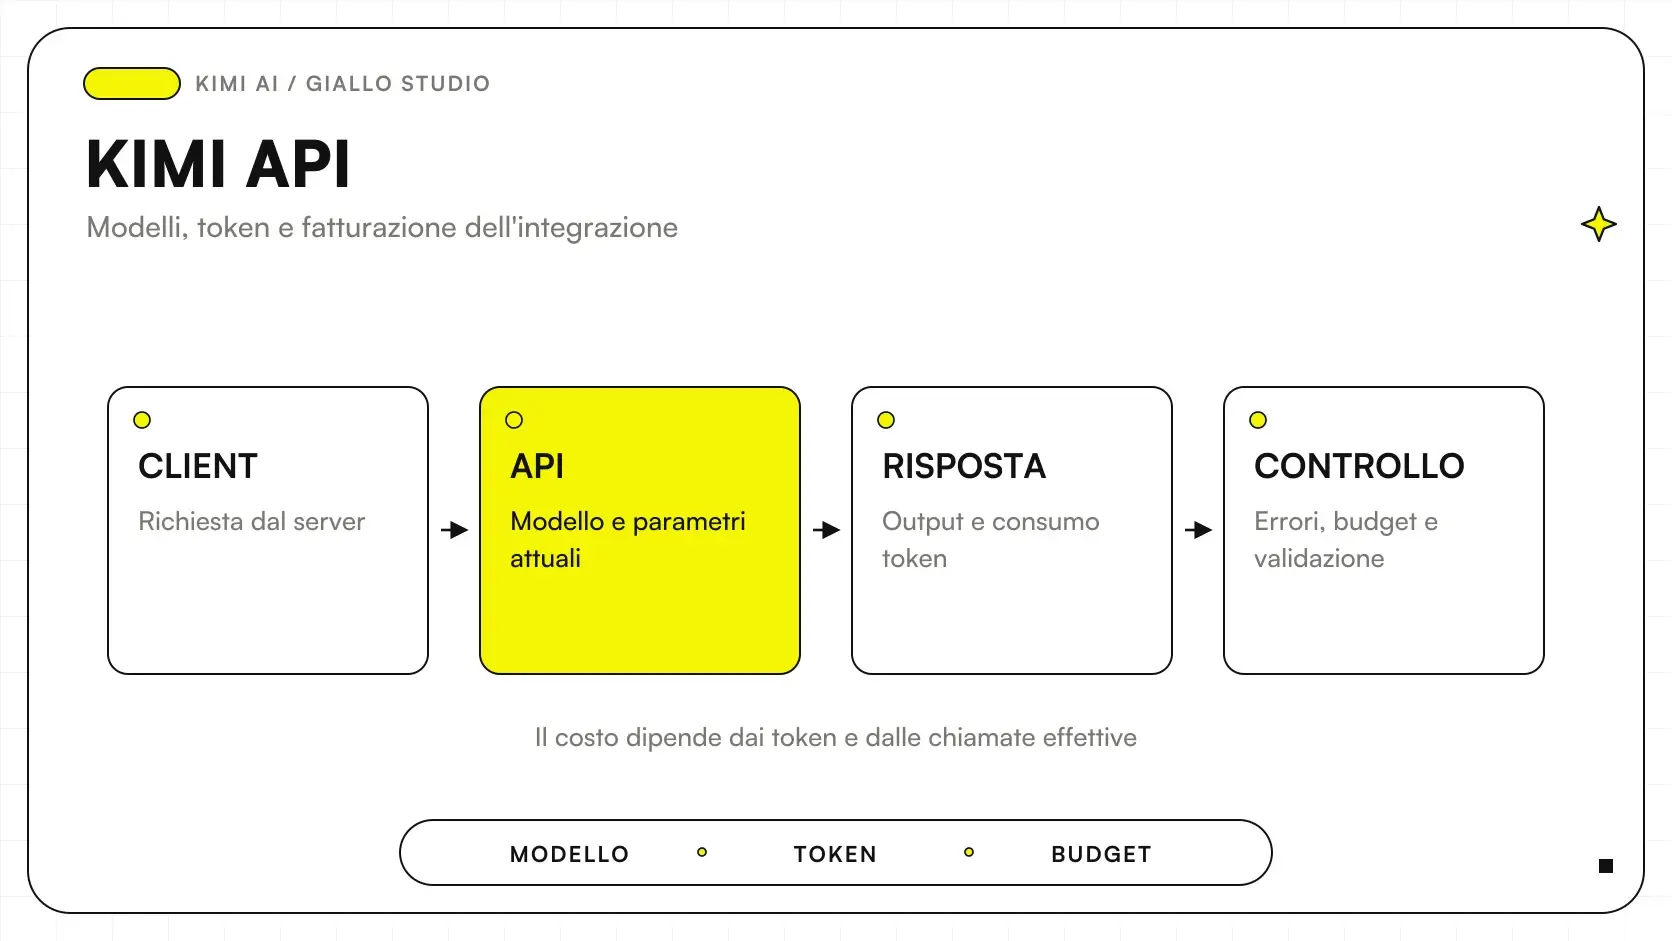
Le Kimi API permettono di usare i modelli Kimi dentro un software, senza automatizzare l'interfaccia della chat. Il backend invia una richiesta autenticata alla piattaforma, riceve una risposta e decide come utilizzarla: compilare una bozza, estrarre campi, rispondere con fonti oppure proporre un'azione. La piattaforma documenta protocolli compatibili OpenAI e Anthropic. API Overview ufficiale.
La compatibilità semplifica il collegamento tecnico; non rende intercambiabili costi, parametri o responsabilità. Nel prodotto pubblico puoi scegliere una funzione dall'interfaccia. In un'integrazione devi invece progettare cosa succede quando il modello sbaglia, il servizio rallenta, una risposta arriva incompleta o il budget viene consumato.
Le informazioni qui riportate sono verificate al 9 ottobre 2026. Per capire la famiglia di prodotti prima del collegamento, leggi cos'è Kimi AI. Questa pagina riguarda il servizio API a consumo; abbonamenti chat e quote coding hanno un perimetro diverso.
In sintesi
- La chiave API appartiene al backend: il frontend deve chiamare il tuo servizio, non esporre le credenziali del provider.
- La compatibilità del protocollo non elimina i parametri specifici del modello scelto.
- Il costo comprende input, output, cache ed eventuali strumenti: il prezzo del solo input è insufficiente.
- Il modello propone contenuti e chiamate a strumenti; il software applica permessi, controlli e limiti.
- Un pilota utile misura costo per pratica completata, errori e lavoro di revisione.
Qual è l'endpoint Kimi API corretto?
Per il servizio internazionale OpenAI-compatible, il base URL è https://api.moonshot.ai/v1; la piattaforma documenta Chat Completions su /chat/completions e Responses su /responses. Il protocollo Anthropic Messages usa la base https://api.moonshot.ai/anthropic. L'autenticazione avviene tramite chiave Bearer. Endpoint e autenticazione.
Il nome Moonshot nell'endpoint non indica che devi usare una vecchia serie di modelli. È l'indirizzo del servizio: il modello viene scelto separatamente nella richiesta. È una distinzione importante quando copi una configurazione trovata online, perché molte guide continuano a riportare identificatori storici.
Anche Kimi Code è separato. Il base URL internazionale coding OpenAI-compatible è https://api.kimi.ai/coding/v1, con credenziali e benefici propri. Non sostituire l'indirizzo nell'integrazione aziendale pensando di trasferire automaticamente le quote della membership. Configurazione Code ufficiale. Il relativo prodotto è spiegato nella guida a Kimi Code.
Nel progetto registra quindi protocollo, base URL, ID del modello e origine della chiave. Se uno di questi elementi non corrisponde agli altri, cambiare il testo del prompt non risolve il problema. Per chi parte da zero, la guida alle API AI chiarisce il ruolo di richiesta, risposta e backend.
Quali modelli Kimi API sono disponibili?
La lista corrente comprende kimi-k3, kimi-k2.7-code, kimi-k2.7-code-highspeed e kimi-k2.6. Il contesto documentato è 1.048.576 token per K3 e 262.144 token per gli altri modelli elencati. Sono capacità dell'API: non vanno trasferite automaticamente alla chat o al piano Code. Verifica sempre la lista ufficiale dei modelli.
La stessa fonte dichiara dismesse le API kimi-k2.5 e moonshot-v1 dal 31 agosto 2026, la serie kimi-k2 dal 25 maggio 2026 e anche l'alias kimi-latest. Un tutorial che usa questi nomi può essere ancora utile per un concetto, ma non è una configurazione attuale da portare in produzione. La disponibilità delle weights di un modello storico è un'altra questione. Modelli disponibili e deprecazioni.
Non scegliere sempre il contesto più grande. Se il processo deve classificare una richiesta breve, inviare l'intero archivio aumenta rumore e materiale trattato. Se deve confrontare documenti, prepara il corpus e i riferimenti. La capacità di contenere testo non garantisce che ogni passaggio venga compreso o che un dato venga recuperato correttamente.
Come fare una richiesta a Kimi K3 senza parametri obsoleti?
K3 API ha thinking sempre attivo. Il campo reasoning_effort ammette low, high e max, con default max. La guida segnala parametri di campionamento fissi: evita di incollare opzioni generiche per temperature e penalità da un'integrazione di un altro modello. Guida Kimi K3 API.
Questo esempio mostra il corpo minimo di una richiesta verso Chat Completions. È illustrativo e non è stato eseguito con una chiave o credito API; la configurazione di autenticazione resta nel backend.
{
  "model": "kimi-k3",
  "reasoning_effort": "low",
  "messages": [
    {
      "role": "user",
      "content": "Classifica questa richiesta sintetica: vorrei il catalogo dei ricambi. Rispondi con categoria e motivo, senza inventare dati."
    }
  ]
}
Il passo successivo non è mostrarne liberamente la risposta al cliente. Prima definisci un contratto: categorie ammesse, campi obbligatori, gestione delle richieste ambigue. La guida documenta output strutturato json_schema con modalità strict; il tuo software deve comunque verificare se i valori hanno senso per il processo. Un JSON formalmente valido può classificare male il contenuto. Output strutturato K3.
Nelle conversazioni successive la guida richiede di conservare il messaggio assistant completo, inclusi reasoning_content e tool_calls, invece del solo testo finale. Evita di ricostruire una cronologia parziale se il workflow usa strumenti. Conversazioni e chiamate K3. Questo comportamento è approfondito anche nella pagina su Kimi K3.
Quanto costano le Kimi API?
Il listino corrente è in USD per milione di token, tasse escluse. La tabella seguente separa input in cache, input non in cache e output; riguarda l'inferenza, non l'abbonamento alla chat. Prezzi e disponibilità vanno ricontrollati nel listino ufficiale API.
| Modello | Input cache hit | Input cache miss | Output |
|---|---|---|---|
| K3 | 0,30 USD | 3,00 USD | 15,00 USD |
| K2.7 Code | 0,19 USD | 0,95 USD | 4,00 USD |
| K2.7 Code HighSpeed | 0,38 USD | 1,90 USD | 8,00 USD |
| K2.6 | 0,16 USD | 0,95 USD | 4,00 USD |
Per K3 la scrittura cache ha una voce distinta: 3 USD per milione di token con TTL di cinque minuti oppure 6 USD con TTL di un'ora. Il default documentato è cinque minuti; un hit rinnova il TTL senza ulteriore write fee. In Chat Completions e Responses, letture cache, scritture e residuo non in cache sono parti mutuamente esclusive dell'input totale: non addebitare gli stessi token anche come cache miss. Prezzi inferenza e regole di contabilizzazione cache.
Ecco un calcolo ipotetico, senza strumenti e senza tasse: una richiesta K3 con 20.000 token di input totale, tutti contabilizzati come cache write con TTL cinque minuti, e 2.000 token di output costa 0,06 + 0,03 = 0,09 USD. Non si aggiungono altri 20.000 token cache miss. Con lo stesso input scritto a TTL un'ora, il conto diventa 0,12 + 0,03 = 0,15 USD. I valori derivano dal listino ufficiale e dalla ripartizione dell'input nella guida cache, non da una fattura osservata.
Una richiesta ipotetica con gli stessi 20.000 token interamente in cache e 2.000 di output avrebbe invece inferenza pari a 0,006 + 0,03 = 0,036 USD, senza nuovo write fee per quell'hit. Non significa che tutti gli input futuri colpiranno la cache: dati variabili, prefissi diversi e scadenza cambiano il risultato. Pricing e regole cache.
Per riconciliare i consumi Chat Completions, leggi usage.prompt_tokens come totale, poi sottrai cached_tokens e cache_write_tokens dai relativi dettagli per ottenere il residuo non in cache. Applica a ciascuna parte la propria tariffa e aggiungi l'output. Campi usage e contabilizzazione ufficiale.
Per il budget aziendale conta il costo della pratica completa. Aggiungi tentativi ripetuti, passaggi dell'agente, strumenti e revisione. La guida al calcolo dei costi API AI offre un metodo; quella sui token AI spiega perché pagine, parole e token non sono equivalenti.
Come usare cache e strumenti senza gonfiare il conto?
La cache lavora meglio quando il contesto stabile precede i dati variabili. Una buona struttura mette prima istruzioni, definizioni e materiale condiviso; dopo colloca la nuova richiesta. Non aggiungere un timestamp casuale all'inizio di ogni prompt se vuoi riutilizzare un prefisso. La guida descrive caching automatico e isolamento per organizzazione. Context caching.
La ricerca web ha un costo distinto. Il listino documenta REST Basic /v1/tools/search a 0,002 USD per chiamata, Pro /v1/tools/search_pro a 0,003 USD e fetch /v1/tools/fetch a 0,002 USD, tasse escluse; le condizioni di addebito dipendono dal successo con risultati o contenuto. Il legacy $web_search è previsto in dismissione il 20 ottobre 2026: non costruire un nuovo flusso su quel metodo. WebSearch Pricing.
La guida K3 contiene inoltre un avviso sulla ricerca web in aggiornamento e sul suo uso nei workflow di produzione nel breve termine. La presenza di un endpoint e di un listino non elimina questo limite documentale. Valuta una ricerca separata e controllata oppure attendi conferme operative per il tuo caso. Avviso della guida K3.
Quando la cache può essere conveniente?
Quando ripeti davvero lo stesso prefisso entro la durata utile: ad esempio istruzioni e documentazione stabile per richieste ravvicinate. Confronta letture, scritture e scadenze nei consumi osservati. Se ogni pratica contiene un documento differente o le richieste sono distanti, il beneficio può ridursi. La decisione deve partire dalle tracce di utilizzo del pilota, non dal solo prezzo cache hit.
Due integrazioni italiane con un risultato delimitato
Scenario ipotetico: distributore di componenti a Padova. Il gestionale riceve richieste commerciali in testo libero. Un servizio legge soltanto la descrizione necessaria e chiede al modello categoria, informazioni mancanti e motivazione. Non invia il listino riservato né autorizza un'offerta.
Il backend controlla che la categoria appartenga al catalogo delle categorie ammesse. Se il messaggio contiene richieste incompatibili o riferimenti mancanti, apre una pratica da completare. L'operatore vede testo originale e proposta affiancati; l'invio al cliente avviene con approvazione. Il pilota misura riclassificazioni e tempo di revisione, senza promettere un risparmio prima della prova.
Scenario ipotetico: società di manutenzione a Parma. Un'app raccoglie note tecniche scritte dopo l'intervento. Il modello propone un riepilogo e segnala campi mancanti, usando un vocabolario interno approvato. I codici dell'intervento arrivano dal gestionale: non vengono inventati dall'AI.
Il sistema salva il riepilogo come bozza e mantiene il testo di origine. Il responsabile verifica materiali e attività prima della chiusura. Una risposta vaga o un errore di rete non deve trasformarsi in un intervento completato. Questo confine evita che un problema di generazione diventi un cambiamento operativo irreversibile.
Cosa succede con limiti, errori e risposte incomplete?
La piattaforma collega i tier e i limiti alla ricarica cumulativa; per iniziare documenta una ricarica minima di 1 USD. Concorrenza, richieste e token hanno quote distinte, e la ricerca ha limiti propri. Non progettare il flusso assumendo che ogni account gestisca lo stesso traffico. Recharge and Rate Limits.
In caso di HTTP 429, applica backoff e retry controllati, come indica la documentazione sui limiti. Una coda può assorbire un picco; tentativi simultanei senza controllo possono aggravarlo. Definisci anche quando smettere di riprovare e passare la pratica a una persona. Gestione dei limiti API.
Controlla la completezza della risposta prima di usarla. Output troncato, assenza di campi o categorie sconosciute devono produrre uno stato visibile, non un valore di comodo. Conserva un identificativo interno della pratica per evitare duplicazioni quando un operatore ripete l'azione dopo un timeout.
L'errore più costoso è lasciare che il modello scelga permessi e destinazioni. Un tool call è una proposta: il backend deve validare argomenti, identità e autorizzazione. Se vuoi costruire questo percorso con nodi visuali, la guida Kimi AI con n8n mostra come separare interpretazione e scrittura.
Quale contratto deve avere l'API dentro il tuo software?
Definisci un'interfaccia interna che descriva il lavoro, anziché esporre al resto dell'applicazione ogni dettaglio del provider. Una funzione aziendale come “proponi categoria della richiesta” dovrebbe restituire proposta, motivazione e stato di revisione. Il componente che chiama Kimi gestisce protocollo, metering ed errori; il gestionale continua a conoscere il proprio processo.
Questo confine permette di aggiornare la configurazione del modello senza cambiare il significato della pratica. Non serve costruire un sistema universale per tutti i provider: basta evitare che il codice commerciale dipenda da un testo libero difficile da validare. Conserva anche la versione delle istruzioni usate, così una classificazione anomala può essere ricondotta al comportamento effettivamente richiesto.
Per le operazioni con effetti reali, aggiungi un vincolo separato: nessuna risposta del modello equivale da sola a una conferma dell'utente. È il servizio applicativo a stabilire se una proposta può essere salvata, inviata oppure soltanto mostrata.
Come decidere se l'integrazione è pronta?
Prima del rilascio devi poter rispondere a domande concrete: quali dati escono dall'azienda, quanto costa una pratica completata, come si riconosce un errore e chi può autorizzare un aggiornamento. Privacy e retention non si deducono dalla presenza di un'API; controlla il prodotto e il contratto nella guida Kimi AI privacy.
Porta in produzione soltanto un flusso con ingressi definiti, output validati e un percorso umano per le eccezioni. Se vuoi collegare Kimi a un'applicazione o a un gestionale con questi confini già progettati, Giallo sviluppa il software necessario all'integrazione. Il criterio finale è una pratica verificabile dall'inizio alla fine.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
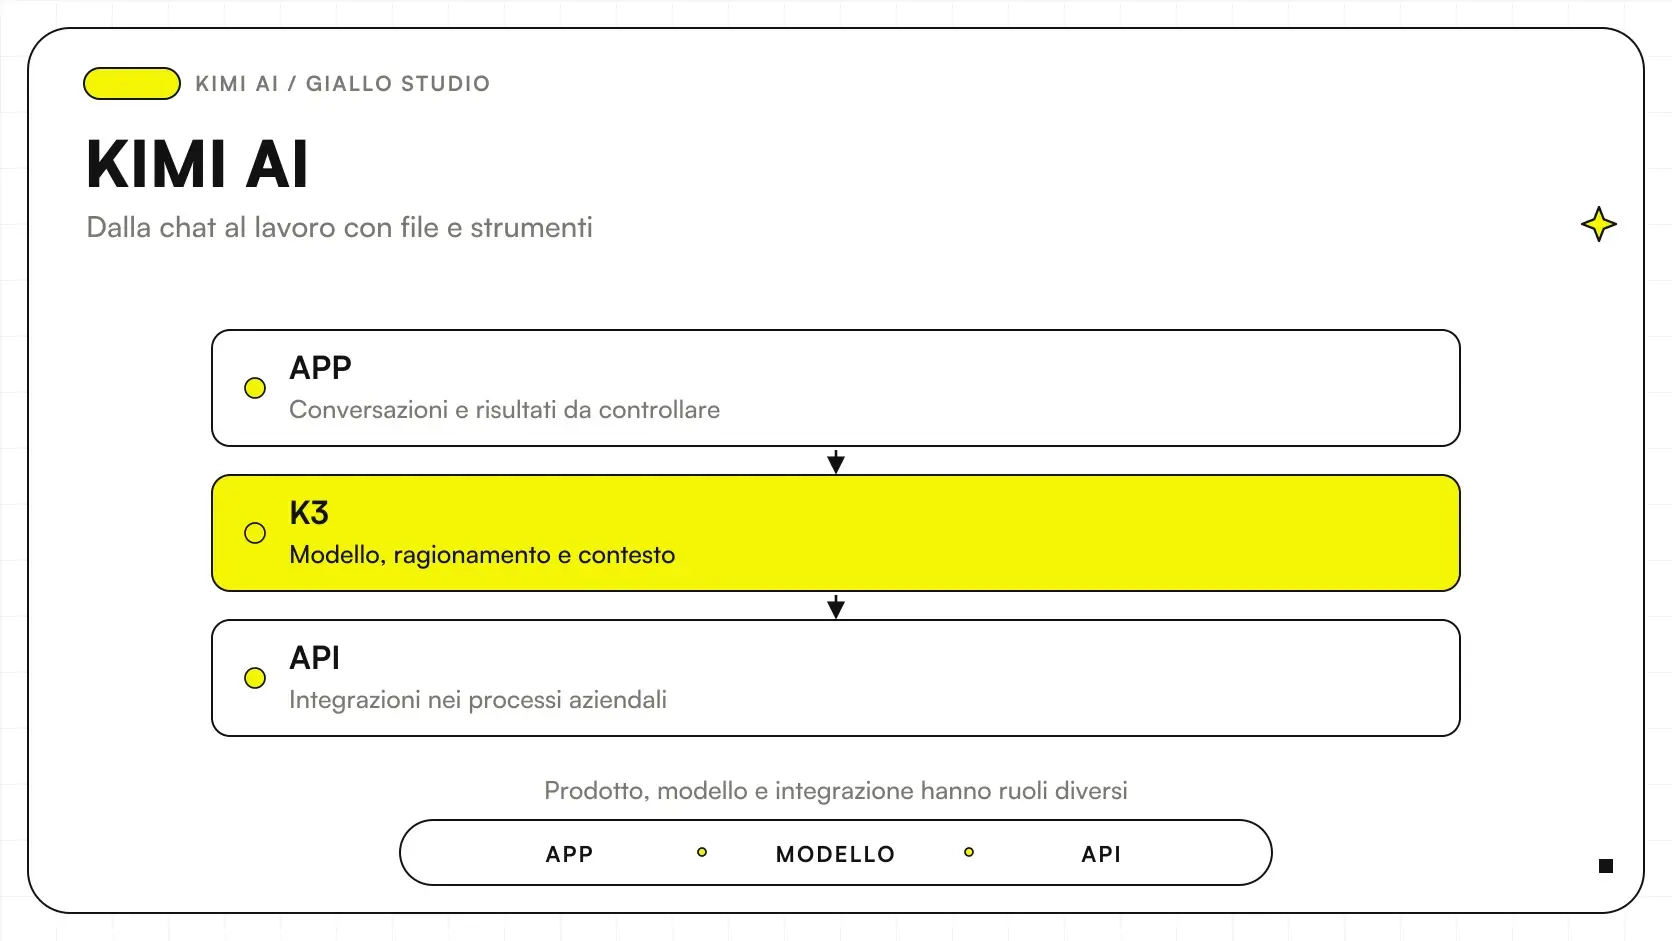 Kimi AI: cos'è, cosa fa e quando usarlo
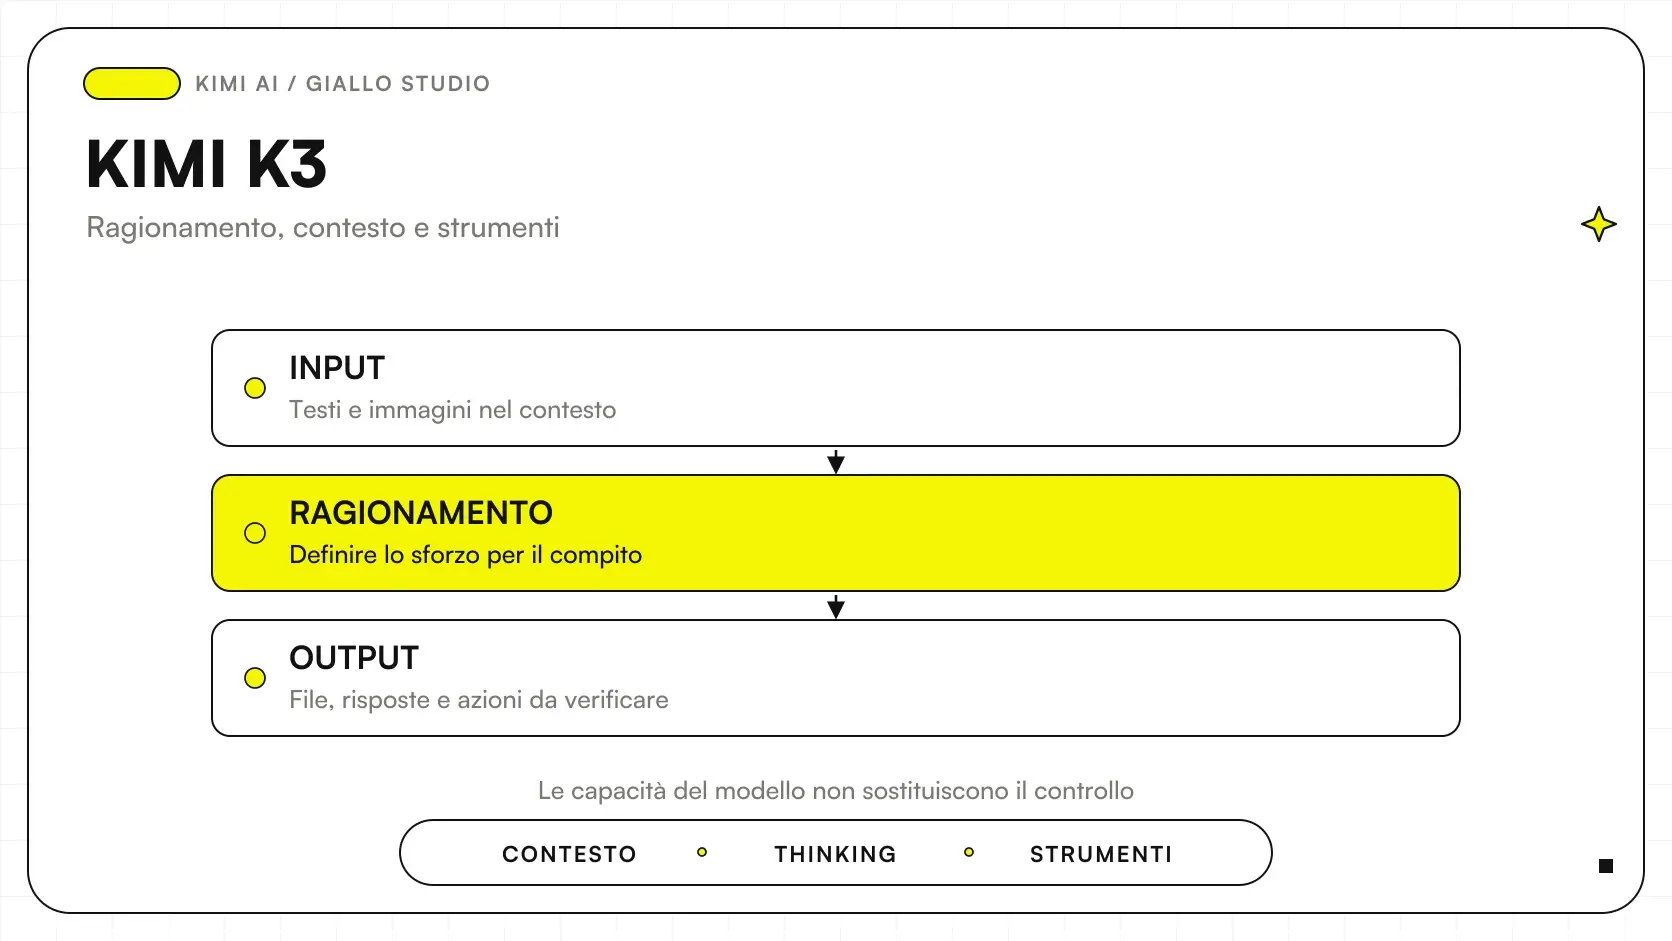 Kimi K3: modello, ragionamento e limiti pratici
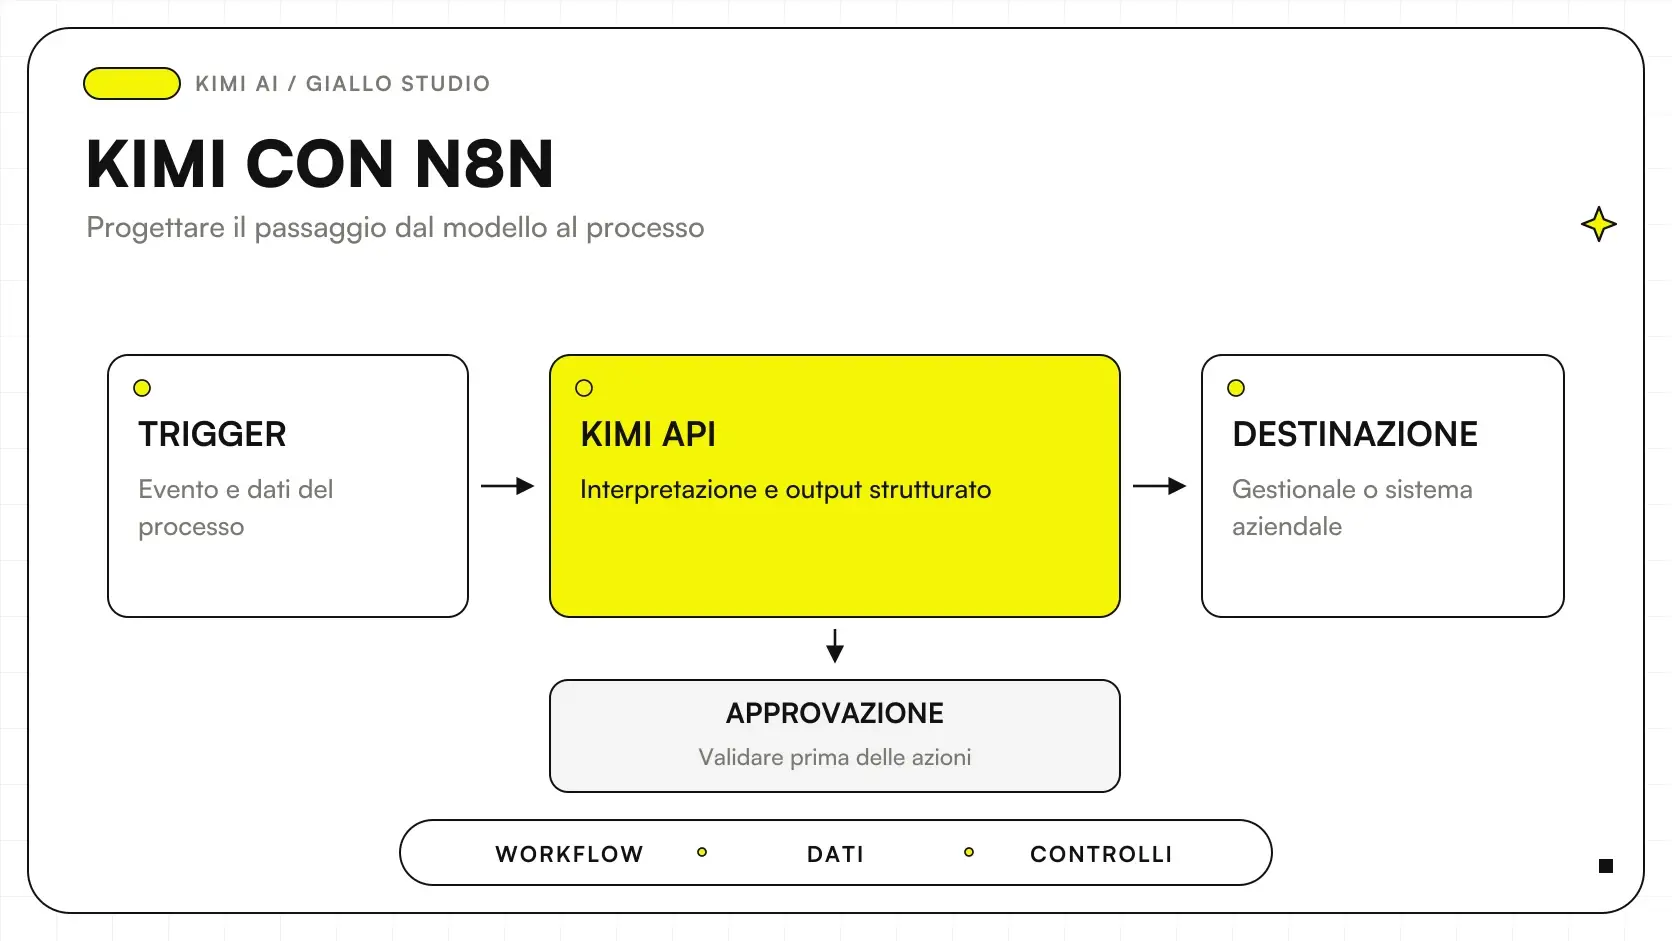 Kimi AI con n8n: come progettare un workflow
 Kimi Code: agente per programmare e lavorare sul codice
 Kimi AI e privacy: cosa verificare sui dati aziendali
 API AI: cosa sono e come funzionano
 Costo delle API AI: come si calcola davvero
FAQ
Che cosa sono le Kimi API?
Sono le interfacce della piattaforma Kimi per chiamare i modelli da un software. Consentono di inviare richieste dal backend e usare le risposte dentro un processo, con autenticazione e costi a consumo.
L'abbonamento alla chat comprende il credito API?
Non va assunto. Membership della chat, servizio Code e piattaforma API sono prodotti distinti: verifica credito, chiave e fatturazione nella piattaforma che userai.
Compatibile OpenAI significa identico a OpenAI?
No. Puoi riusare un protocollo o un client compatibile, ma modelli, parametri e limiti restano quelli del provider. Una configurazione generica può inviare opzioni non supportate.
Come tengo al sicuro la chiave Kimi API?
Conservala nelle credenziali o nei secret del backend, con accesso limitato. Non inserirla in un prompt, nel browser del visitatore o in un repository; prepara anche una procedura di revoca.
La cache rende gratuite le richieste ripetute?
No. Il listino distingue lettura della cache, input non in cache, output e scrittura della cache. Il costo effettivo dipende dal prefisso riutilizzato e dalla durata configurata.
Le API possono aggiornare direttamente il gestionale?
Il modello può proporre l'uso di uno strumento, ma è il tuo software a eseguirlo. Autorizzazioni, validazione degli argomenti e approvazione delle operazioni devono essere implementate dal sistema.