
EmbeddingGemma 2: ricerca AI locale nei documenti aziendali
EmbeddingGemma 2 per cercare in documenti e immagini aziendali: funzionamento, prova su hardware reale, permessi e limiti della ricerca locale.
Tempo di lettura: 11 min
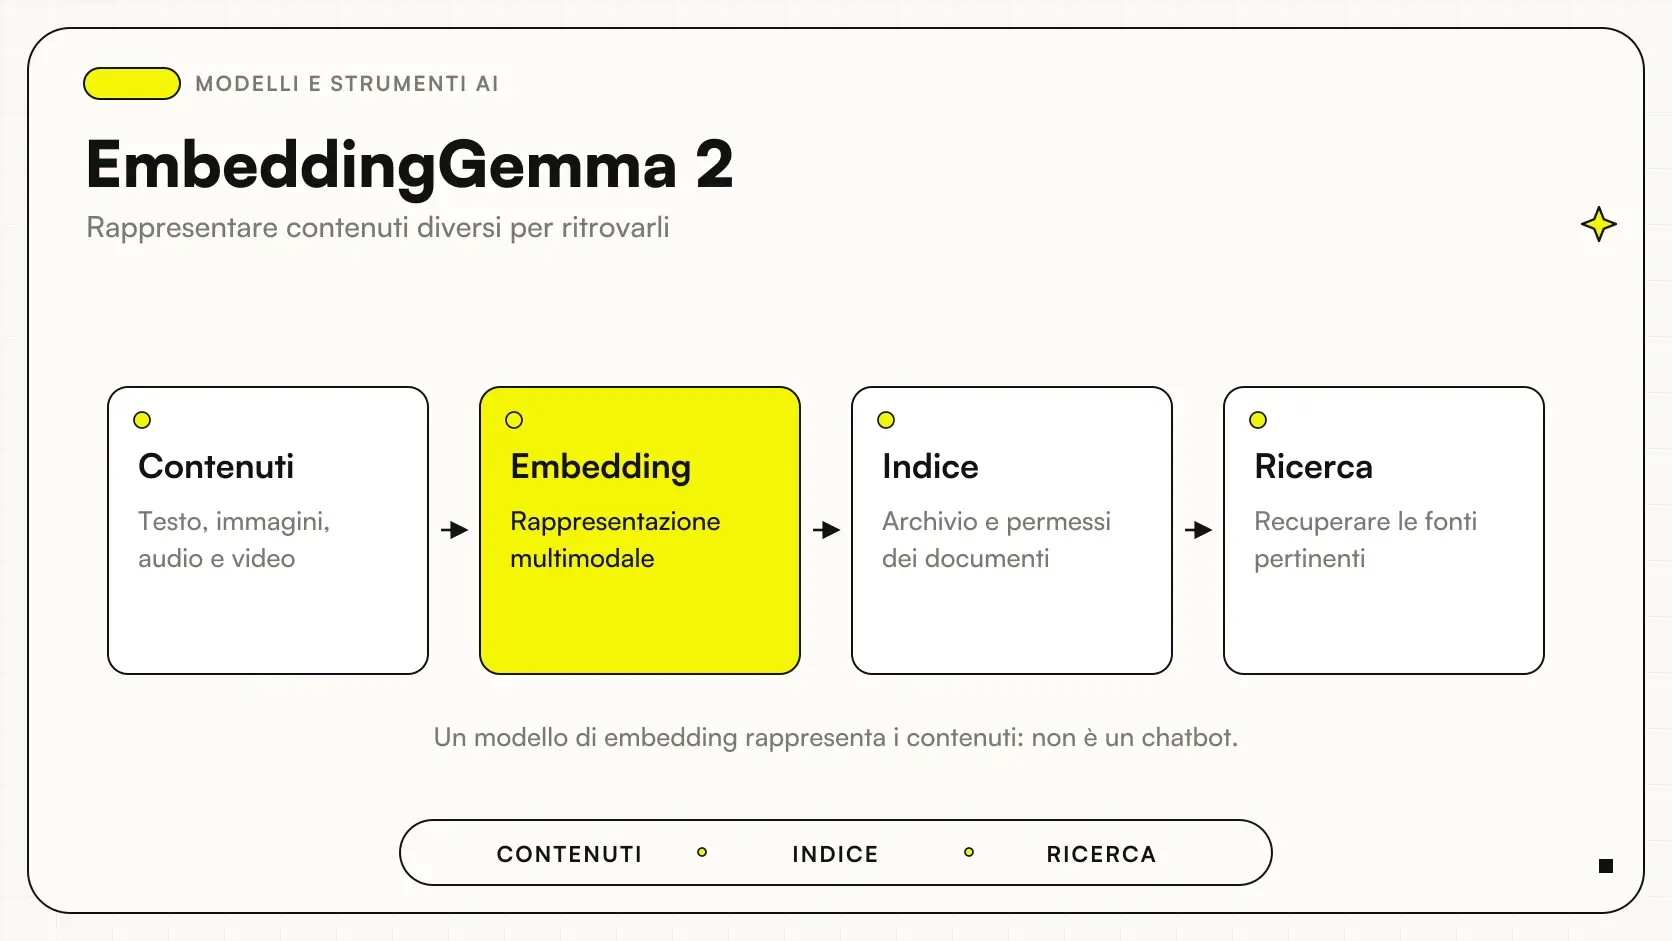
EmbeddingGemma 2 è un modello di embedding multimodali: trasforma contenuti diversi in rappresentazioni numeriche che permettono di cercarli per significato. Per un'azienda interessa soprattutto come componente di una ricerca interna, anche locale, su documenti e materiali che non si esauriscono nel testo. Non è una chat pronta da collegare alle cartelle aziendali.
Google lo ha presentato il 6 ottobre 2026. L'annuncio descrive uno spazio condiviso per testo, codice, immagini, audio e video; la possibilità di esecuzione locale va valutata sulla configurazione effettiva. La novità riguarda il modello, mentre gestione dei documenti, permessi e interfaccia restano parti del progetto. Annuncio ufficiale Google.
In sintesi
- EmbeddingGemma 2 rappresenta i contenuti per la ricerca: non genera da solo risposte conversazionali.
- La ricerca locale richiede un'applicazione, un indice e un processo di aggiornamento delle fonti.
- La multimodalità va provata sui materiali dell'azienda, comprese immagini e documenti poco leggibili.
- I permessi devono essere verificati anche nell'indice e nei risultati restituiti.
- La decisione dipende dalla qualità delle risposte trovate e dall'hardware disponibile.
Che cosa trova un embedding che la ricerca per parole perde?
La ricerca tradizionale funziona bene quando chi cerca conosce il nome del documento o la terminologia usata dall'autore. Diventa meno immediata quando il cliente parla di «pezzo che si blocca» e il manuale descrive un «arresto dell'attuatore». Un embedding cerca relazioni di significato fra la domanda e i materiali indicizzati. Non garantisce che il risultato sia corretto: rende possibile un confronto diverso dalla semplice presenza delle stesse parole.
EmbeddingGemma 2 estende questo principio oltre i documenti testuali. Google descrive rappresentazioni che possono mettere in relazione modalità diverse nello stesso spazio. L'architettura dichiarata comprende 740 milioni di parametri totali e vettori di 768 dimensioni riducibili, con licenza Apache 2.0. Sono caratteristiche del modello, non una promessa sul consumo di memoria dell'intera applicazione. Model card ufficiale.
Per chi deve scegliere, la domanda utile è concreta: i materiali che oggi non vengono trovati contengono informazioni che il modello può rappresentare meglio? Un archivio ordinato di semplici schede potrebbe funzionare già con una ricerca più essenziale. Un insieme di istruzioni illustrate merita invece un confronto su domande reali. La guida alla RAG chiarisce il passaggio successivo: recuperare fonti e, se serve, usarle per costruire una risposta verificabile.
Che cosa serve per costruire una ricerca documentale locale?
Il modello è soltanto uno degli elementi. Occorre raccogliere i file autorizzati, capire quali versioni siano valide, estrarre o preparare i contenuti, calcolare le rappresentazioni e conservarle in un indice. Quando arriva una domanda, l'applicazione deve trasformarla, cercare materiali pertinenti e mostrare riferimenti comprensibili a una persona. Se è prevista una risposta generata, entra in gioco anche un modello linguistico separato.
Questo percorso non obbliga a costruire subito un assistente completo. Una prima interfaccia può restituire il titolo del documento, il punto rilevante e il collegamento alla fonte. È spesso più facile capire perché una ricerca fallisce quando il risultato è visibile direttamente, senza che una risposta fluida ne nasconda le debolezze. La scelta dell'esperienza utente deve seguire il lavoro da svolgere, non il desiderio di aggiungere una chat.
Un altro elemento essenziale è l'aggiornamento. Un indice costruito su un archivio corretto può diventare poco affidabile se rimangono procedure superate o se nuove versioni non vengono elaborate. Serve stabilire chi pubblica un documento, come viene sostituito e cosa succede ai materiali eliminati. È il lavoro organizzativo alla base di una knowledge base aziendale, indipendentemente dal modello scelto.
Locale significa davvero che i dati non escono dall'azienda?
L'esecuzione locale descrive dove avviene un calcolo. Non descrive automaticamente l'intero percorso dei dati. Un'applicazione può calcolare embedding sul computer e poi inviare domande, log o risposte a un servizio esterno. Può sincronizzare l'indice, usare un sistema di monitoraggio remoto o conservare allegati in una cartella condivisa. La verifica deve quindi seguire il contenuto dall'origine fino alla visualizzazione finale.
Conviene disegnare questo percorso prima di scegliere l'hardware: dove arrivano i file, chi può leggerli, dove vengono prodotti gli embedding, come si conserva l'indice e quali informazioni finiscono nei log. Per ciascun passaggio va indicato il responsabile e l'accesso necessario. La privacy nell'uso aziendale dell'AI riguarda anche questi componenti, non soltanto il fornitore del modello.
La stessa attenzione serve per i permessi interni. Se un dipendente non può aprire un'offerta riservata, non dovrebbe leggerne un estratto attraverso la ricerca. Conservare una copia locale non risolve questo problema. Bisogna collegare l'identità dell'utente alle autorizzazioni delle fonti e verificare che una modifica dei permessi venga recepita anche dall'indice. Un risultato semanticamente pertinente può comunque essere un risultato che quella persona non è autorizzata a vedere.
Quando scegliere il locale e quando valutare altre strade?
| Esigenza del progetto | Possibile orientamento | Verifica decisiva |
|---|---|---|
| Ricerca su una postazione con connettività limitata | Elaborazione locale da sperimentare | Disponibilità dei materiali e comportamento senza rete |
| Archivio condiviso con autorizzazioni variabili | Servizio interno con gestione delle identità | Aggiornamento dei permessi su ogni risultato |
| PDF con figure e tabelle importanti | Recupero multimodale da confrontare | Qualità sulle domande che dipendono dalle figure |
| Pochi documenti testuali ben classificati | Ricerca più semplice da confrontare | Beneficio aggiuntivo rispetto alla ricerca esistente |
| Applicazione per dispositivi diversi | Prova su hardware rappresentativo | Memoria, attese, compatibilità e manutenzione |
Queste opzioni non sono prodotti intercambiabili. Il nuovo lavoro sugli embedding multimodali Perplexity per PDF, per esempio, offre un altro punto di confronto sul recupero di pagine e immagini. Per scegliere servono lo stesso archivio di prova, le stesse domande e criteri uguali. Confrontare soltanto la scheda tecnica dei modelli lascia fuori il problema dell'azienda.
Quando invece l'informazione importante vive nelle colonne di SharePoint, il limite potrebbe non essere il modello di embedding. L'approccio illustrato nel PoC Foundry IQ con metadati mostra perché stato, reparto e classificazione devono entrare nel recupero. Un'immagine ben rappresentata non sostituisce un campo strutturato che dice se il documento è ancora valido.
Quale prova fare prima di investire nell'integrazione?
Partirei da una raccolta di domande a cui il personale dovrebbe riuscire a rispondere consultando l'archivio. Le domande devono includere sinonimi, termini usati dai clienti, richieste incomplete e casi in cui la risposta non esiste. Per ogni domanda si annotano la fonte corretta, i documenti accettabili e quelli da escludere. Questa raccolta diventa un riferimento condiviso fra chi conosce il lavoro e chi costruisce la ricerca.
Il confronto deve osservare separatamente recupero e risposta. Prima si controlla se il documento giusto compare fra i risultati; dopo si valuta l'eventuale testo generato. Se la fonte non viene recuperata, migliorare il prompt della chat può mascherare il problema senza risolverlo. Se la fonte viene trovata ma interpretata male, il lavoro riguarda invece il passaggio successivo.
Google documenta esecuzione quantizzata locale e risultati legati a specifiche condizioni di prova. Il benchmark su Pixel 11 Pro non dimostra le prestazioni sul computer dell'azienda: occorre ripetere la valutazione sulla configurazione prevista. Modello, precisione e applicazione devono essere descritti insieme al risultato, senza trasferire automaticamente le misure del fornitore. Annuncio e configurazioni riportate da Google.
La prova restituisce documenti plausibili, ma non quelli giusti?
Controlla prima la fonte: il documento corretto è stato acquisito, è leggibile e appartiene alla versione valida? Poi verifica la domanda e la suddivisione dei contenuti. Solo dopo confronta un altro modello. Conserva anche gli esempi falliti: servono a capire se il miglioramento riguarda davvero il lavoro dell'azienda.
Un'officina con manuali illustrati: scenario ipotetico
Immaginiamo un'officina che assiste macchinari industriali e conserva manuali, fotografie e note di intervento. Il tecnico cerca una procedura usando il nome informale di un componente. Oggi deve conoscere la cartella e aprire diversi documenti. L'obiettivo della prova sarebbe trovare il manuale pertinente e il passaggio corretto, mantenendo visibili modello del macchinario e versione della documentazione.
In questo scenario ipotetico la multimodalità interessa perché alcune informazioni sono nelle figure, ma non si presume che ogni fotografia possa essere interpretata correttamente. Si preparano richieste che dipendono dal testo e altre che richiedono una figura. Si osserva dove il sistema trova la fonte e dove invece propone un documento di una macchina simile. La somiglianza visiva è utile solo se non cancella le differenze operative.
La ricerca dovrebbe fermarsi quando mancano identificativi sufficienti. Il tecnico può ricevere una richiesta di precisazione anziché una procedura presentata come certa. L'esito del progetto non sarebbe «abbiamo installato un modello», ma «possiamo ritrovare istruzioni autorizzate e verificarle sulla macchina corretta». Le decisioni operative resterebbero legate al manuale e alla responsabilità della persona.
Uno studio tecnico con capitolati: scenario ipotetico
Consideriamo ora uno studio tecnico che prepara offerte e cerca requisiti fra capitolati, tavole e relazioni. Qui la domanda non riguarda il funzionamento di una macchina, ma il recupero di precedenti pertinenti. Un professionista potrebbe cercare richieste simili a quelle di una gara, senza poter condividere materiali riservati con collaboratori esterni.
La prova ipotetica distinguerebbe l'archivio comune dai fascicoli riservati. Ogni risultato dovrebbe riportare progetto, data del documento e collegamento alla versione autorizzata. Le tavole potrebbero essere valutate come contenuti multimodali, mentre i dati che definiscono accessibilità e stato del fascicolo rimarrebbero informazioni esplicite dell'applicazione. Non si affiderebbe al modello la decisione su chi possa aprire un progetto.
Un rischio concreto sarebbe recuperare una clausola simile ma non applicabile al nuovo incarico. Per questo l'interfaccia dovrebbe favorire confronto e lettura della fonte, evitando di presentare il precedente come una risposta definitiva. Chi vuole esplorare questo tipo di lavoro può partire anche dalla guida all'analisi dei documenti aziendali con AI: il recupero pertinente viene prima dell'interpretazione professionale.
Come gestire i documenti che cambiano dopo la prova?
Un prototipo usa spesso una fotografia dell'archivio. La ricerca quotidiana deve invece convivere con documenti aggiunti, sostituiti e ritirati. Per questo conviene definire una fonte autorevole per ogni famiglia di materiali. Se lo stesso manuale compare in una cartella di lavoro e in un archivio approvato, l'applicazione deve sapere quale versione mostrare. La somiglianza semantica non contiene da sola questa informazione organizzativa.
La procedura di aggiornamento dovrebbe includere anche gli errori di acquisizione. Un file che non viene letto o un contenuto che non viene elaborato non deve scomparire silenziosamente. Chi cura l'archivio dovrebbe poter vedere i materiali esclusi e decidere se correggerli, sostituirli o lasciarli fuori. In caso contrario, una risposta mancante potrebbe essere attribuita al modello mentre il documento non è mai entrato nell'indice.
Serve poi una regola per la rimozione. Quando un materiale non deve più essere disponibile, bisogna intervenire sulla fonte e sulla copia utilizzata dalla ricerca. Lo stesso vale per una persona che cambia ruolo o perde l'accesso a un fascicolo. Il controllo va provato con utenti differenti: vedere la fonte corretta con il proprietario dell'archivio non dimostra che la separazione funzioni per tutti gli altri.
Infine, la valutazione iniziale va conservata come riferimento quando cambia il sistema. Una nuova versione del modello, un diverso metodo di suddivisione o un aggiornamento dell'applicazione possono modificare i risultati. Ripetere le domande già concordate permette di capire se la modifica aiuta, introduce regressioni o sposta semplicemente gli errori. Il responsabile aziendale dovrebbe poter leggere questo confronto senza dover interpretare da solo vettori e parametri: fonte trovata, fonte mancata, risultato non autorizzato e richiesta da chiarire sono categorie comprensibili e utili alla decisione.
Gli errori che rendono fragile il progetto
Il primo errore è trattare il modello aperto come un servizio senza costi. La disponibilità dei pesi non comprende preparazione degli archivi, hardware, aggiornamenti e assistenza. La pagina ufficiale del modello su Hugging Face permette di verificare distribuzione e licenza; il preventivo dell'applicazione deve descrivere anche tutto ciò che circonda il modello.
Il secondo è indicizzare l'intera cartella condivisa prima di capirne contenuto e autorizzazioni. Materiali duplicati, bozze e procedure superate possono produrre risultati convincenti ma inappropriati. Il terzo è valutare solo domande facili, scritte con le stesse parole del documento. È proprio sulle richieste ambigue, sulle fonti mancanti e sui permessi diversi che emerge la qualità utile al lavoro quotidiano.
Infine, locale non significa una sola architettura. Un assistente per sviluppatori, come nel caso di Copilot CLI con modelli locali tramite Ollama, risolve un compito diverso da una ricerca documentale aziendale. Il collegamento utile è la necessità di verificare dipendenze e percorso dei dati, non l'idea di sostituire un componente con l'altro senza riprogettare il sistema.
Per decidere su EmbeddingGemma 2 serve quindi un archivio autorizzato, un confronto osservabile e un responsabile delle fonti. Se questi elementi sono disponibili, possiamo progettare una ricerca documentale su misura che renda espliciti documenti recuperati, permessi e criteri di accettazione prima di estenderla al resto dell'azienda.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 RAG: cos'è e perché migliora le risposte AI
 AI per knowledge base aziendale: smetti di cercare informazioni
 AI per analizzare documenti aziendali: guida pratica
 AI e privacy aziendale: cosa succede ai tuoi dati nei tool AI
 Perplexity apre i nuovi embedding multimodali: cercare anche nelle pagine PDF
 Foundry IQ e SharePoint: perché i metadati cambiano le risposte della knowledge base
 Copilot CLI trova i modelli Ollama locali: requisiti e limiti della modalità offline
FAQ
EmbeddingGemma 2 è una chat AI?
No. È un modello di embedding che rappresenta i contenuti per permettere la ricerca per significato. Un assistente conversazionale richiede anche altri componenti, compreso un modello che generi la risposta.
EmbeddingGemma 2 può funzionare in locale?
Google documenta configurazioni di esecuzione locale quantizzata. La fattibilità dell’applicazione va verificata sull’hardware previsto, considerando modello, indice e altri componenti.
Quali contenuti rappresenta EmbeddingGemma 2?
Google descrive uno spazio condiviso per testo, codice, immagini, audio e video. La qualità utile alla ricerca va provata sui materiali e sulle domande dell’azienda.
La ricerca locale rende automaticamente privati i dati?
No. Occorre controllare anche sincronizzazione, log, servizi esterni, identità e autorizzazioni. Il luogo in cui vengono calcolati gli embedding non descrive l’intero percorso dei dati.
Il modello aperto elimina il costo del progetto?
No. Restano preparazione delle fonti, hardware, applicazione, aggiornamento dell’indice e manutenzione. La distribuzione del modello non equivale a un servizio documentale completo.
Come si decide se adottare EmbeddingGemma 2?
Si confrontano domande e fonti attese su un archivio autorizzato, verificando recupero, permessi e comportamento sull’hardware reale. La prova deve includere fonti mancanti, versioni superate e richieste ambigue.