
LLM locale su Windows: GPU, VRAM e limiti pratici
Come scegliere un LLM locale su Windows: memoria RAM e VRAM, driver, offload e controlli pratici prima di acquistare una GPU.
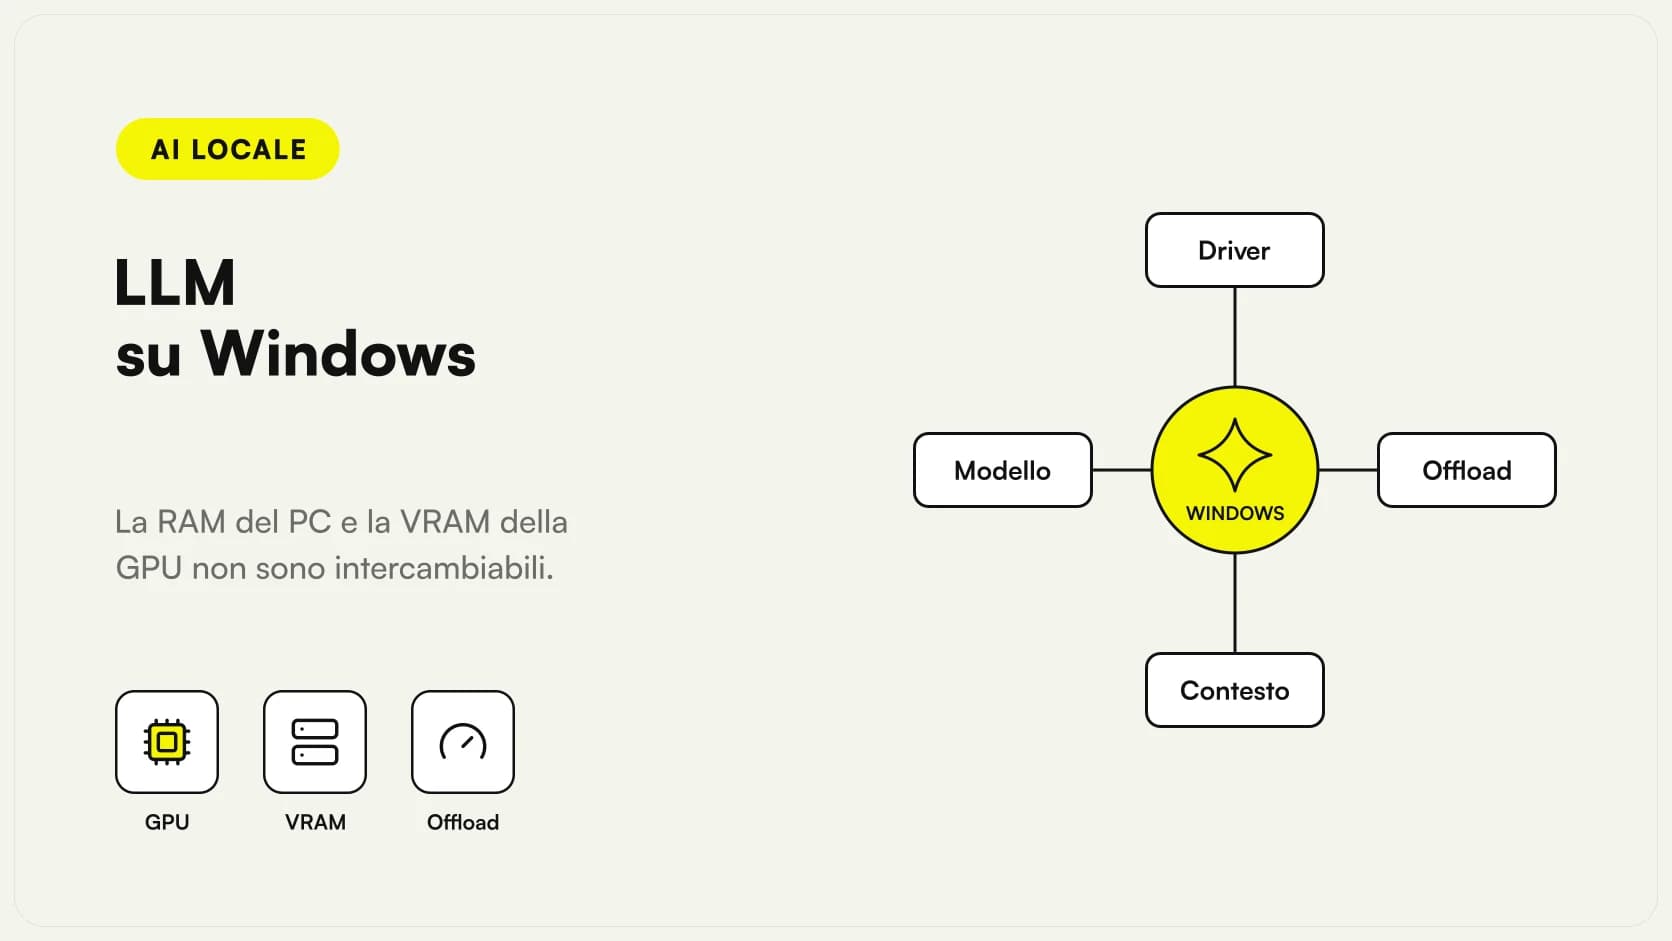
Per eseguire un LLM locale su Windows bisogna verificare insieme modello, memoria disponibile e supporto del runtime alla GPU. La sola quantità di RAM del computer non permette di stabilire quale modello funzionerà bene, perché la memoria dedicata della scheda grafica e quella di sistema hanno ruoli diversi.
Un PC che avvia Qwen3.8-27B non è automaticamente adatto a servirlo a un ufficio: contano documenti caricati, richieste simultanee e tempo massimo accettabile. Qui trovi un metodo per valutare la macchina che possiedi prima di acquistare hardware. Non presentiamo velocità misurate da Giallo Studio né una graduatoria di schede grafiche.
In sintesi
- RAM di sistema, VRAM dedicata e memoria condivisa non sono quantità intercambiabili.
- Il modello deve lasciare spazio a contesto, cache, runtime e altre applicazioni.
- Il supporto GPU dipende da backend e driver, oltre che dalla marca della scheda.
- Ridurre il modello o il contesto può essere più utile di aggiungere memoria indiscriminatamente.
- Il test decisivo riproduce il lavoro reale sul PC usato dalle persone.
Come leggere RAM e VRAM in un PC Windows?
La RAM serve al sistema operativo e alle applicazioni. La VRAM dedicata, in una GPU discreta, risiede sulla scheda grafica. Windows distingue inoltre memoria GPU dedicata e condivisa: quest'ultima utilizza memoria di sistema e non trasforma fisicamente una scheda piccola in una scheda con più VRAM. La distinzione è documentata da Microsoft nel funzionamento di Gestione attività.
Annota separatamente le quantità installate e quelle disponibili durante il lavoro. Un totale nominale non dice quanto resta dopo browser, gestionale, videochiamata e strumenti di sicurezza aziendali.
Per orientarti nella scelta generale del checkpoint, parti dalla guida ai modelli AI locali. La domanda successiva è concreta: la macchina deve rispondere a una chat personale oppure sostenere un servizio condiviso? Nel secondo caso il dimensionamento deve includere anche utenti e carichi sovrapposti.
Perché la dimensione del download non basta?
Il file contiene i pesi del modello e informazioni necessarie al caricamento. L'esecuzione richiede altra memoria: strutture del runtime, elaborazione degli input, stato della conversazione e, secondo architettura e backend, cache associate al contesto. Per i modelli multimodali entrano in gioco anche i componenti che elaborano le immagini.
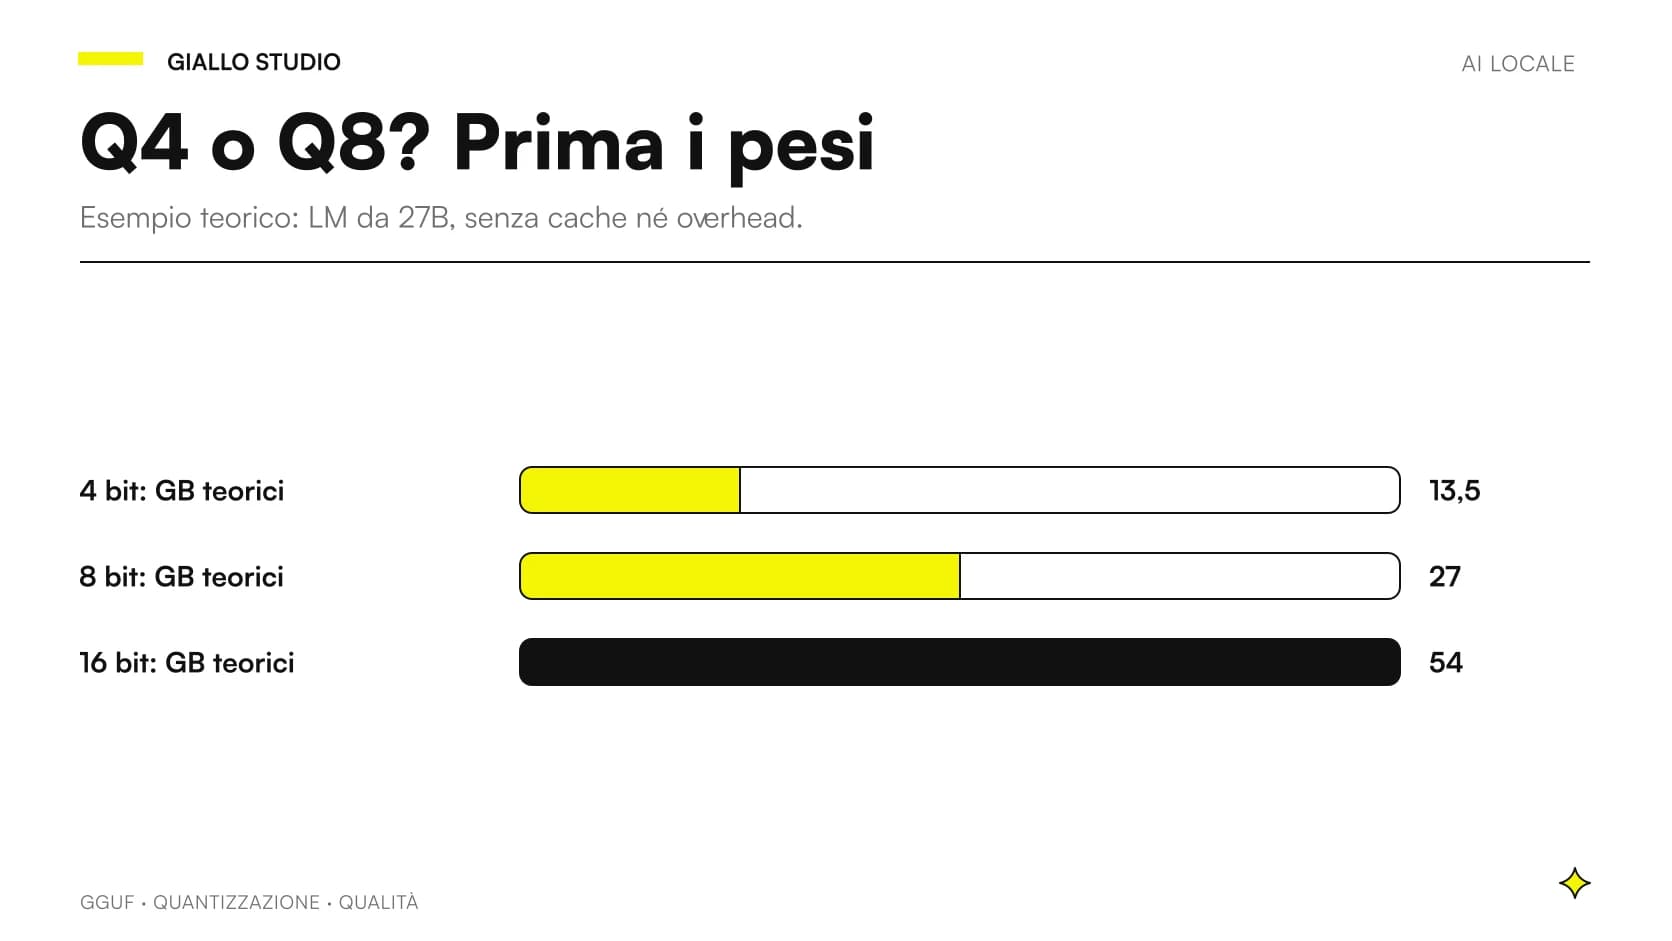
Un calcolo teorico aiuta a escludere aspettative impossibili. Per 27 miliardi di parametri, quattro bit per parametro corrispondono a circa 13,5 GB decimali di soli pesi teorici: 27 miliardi × 4 / 8. Non è la dimensione garantita di un GGUF e non è un requisito sufficiente. Qwen distingue il linguaggio dall'encoder visivo nella model card ufficiale del 27B.
La guida su RAM e VRAM per Qwen3.8-27B separa questi livelli. Prima di comprare una scheda, controlla la dimensione del file esatto e il consumo osservato con il contesto previsto.
Quali GPU sono supportate dal programma scelto?
Non esiste un unico elenco valido per ogni applicazione. CUDA, ROCm e Vulkan sono percorsi differenti; un modello di GPU supportato da un motore può avere limitazioni in un altro o richiedere specifici driver.
La matrice hardware di Ollama elenca schede e requisiti dei backend. La pagina Windows descrive l'esecuzione nativa e le particolarità dei driver NVIDIA e AMD. Verifica entrambe: una riga generale sulla famiglia della GPU non sostituisce le note per il sistema operativo.
Conserva il nome completo della scheda, la versione del driver e quella del runtime nel verbale di prova. Evita di aggiornare tutto insieme durante un confronto: se cambia il risultato, devi poter capire quale modifica lo ha prodotto.
Ollama o LM Studio per il primo controllo?
Ollama e LM Studio permettono percorsi diversi per arrivare all'inferenza locale. La scelta dipende dal lavoro: interfaccia desktop, server per applicazioni, integrazioni e gestione dei modelli. Il confronto tra Ollama e LM Studio approfondisce queste differenze.
LM Studio indica requisiti di sistema e raccomandazioni proprie nella documentazione ufficiale. Quelle raccomandazioni riguardano l'applicazione: non significano che ogni modello del catalogo entrerà nella macchina.
Per la prima prova usa un checkpoint compatibile e sufficientemente contenuto, così distingui un problema di installazione da uno di capacità. Solo dopo passa al candidato aziendale. In questo modo non confondi un driver non riconosciuto con un modello troppo impegnativo.
Che cosa succede quando il modello non entra nella GPU?
Alcuni runtime possono distribuire parte del lavoro sulla CPU e sulla memoria di sistema. Questo meccanismo viene spesso chiamato offload. Può rendere possibile un caricamento che altrimenti fallirebbe, ma modifica il percorso di elaborazione e richiede una verifica pratica dei tempi.
Non assegniamo un rallentamento universale: dipende dall'hardware, dai trasferimenti, dal motore e dal lavoro. Il dato utile è il tempo dell'intera operazione che l'utente deve completare.
Con Ollama, il comando ollama ps mostra i modelli caricati e la ripartizione del processore secondo la documentazione sul contesto e l'offload. Se ti aspettavi tutta l'elaborazione sulla GPU, verifica questa informazione prima di attribuire il risultato alla qualità del modello.
Quali componenti controllare prima di spendere?
| Componente | Domanda utile | Errore frequente |
|---|---|---|
| VRAM dedicata | Quanto resta libero con le applicazioni aperte? | Considerare solo il numero sulla confezione |
| RAM | Sistema e parti del modello hanno margine? | Sommarla alla VRAM senza distinguere il percorso |
| Driver e backend | La combinazione è supportata dal runtime? | Scegliere solo per marca |
| SSD | Entrano file, versioni e documenti di lavoro? | Confondere spazio disco con memoria di esecuzione |
| Raffreddamento | Il comportamento resta stabile durante il lavoro? | Basarsi su una singola risposta iniziale |
| Rete e accessi | Il servizio è personale o condiviso? | Esporre la macchina come server senza progetto |
La tabella è una checklist progettuale, non una lista di componenti consigliati. Per una decisione economica confronta anche costi dell'AI locale e cloud: un hardware più capiente può evitare un limite tecnico, ma richiede comunque manutenzione e gestione.
Quanto conta il contesto di conversazione?
Il contesto è il materiale che il modello può considerare durante una richiesta: istruzioni, conversazione, documenti e spazio per la risposta. Un checkpoint che dichiara una finestra ampia non garantisce che il tuo PC possa utilizzarla tutta.
La documentazione Ollama sul context length chiarisce che aumentarlo accresce la memoria necessaria. Per questo la prova deve riportare la configurazione effettiva e non soltanto il limite pubblicizzato dal produttore.
Inizia con una domanda rappresentativa e un documento della dimensione abituale. Aumenta gradualmente il carico, registrando consumo e tempi. Se il lavoro consiste nel consultare molti documenti, valuta un RAG locale: selezionare i passaggi pertinenti è spesso più sensato che inserire un archivio intero nel prompt.
Come verificare il PC senza costruire un benchmark fittizio?
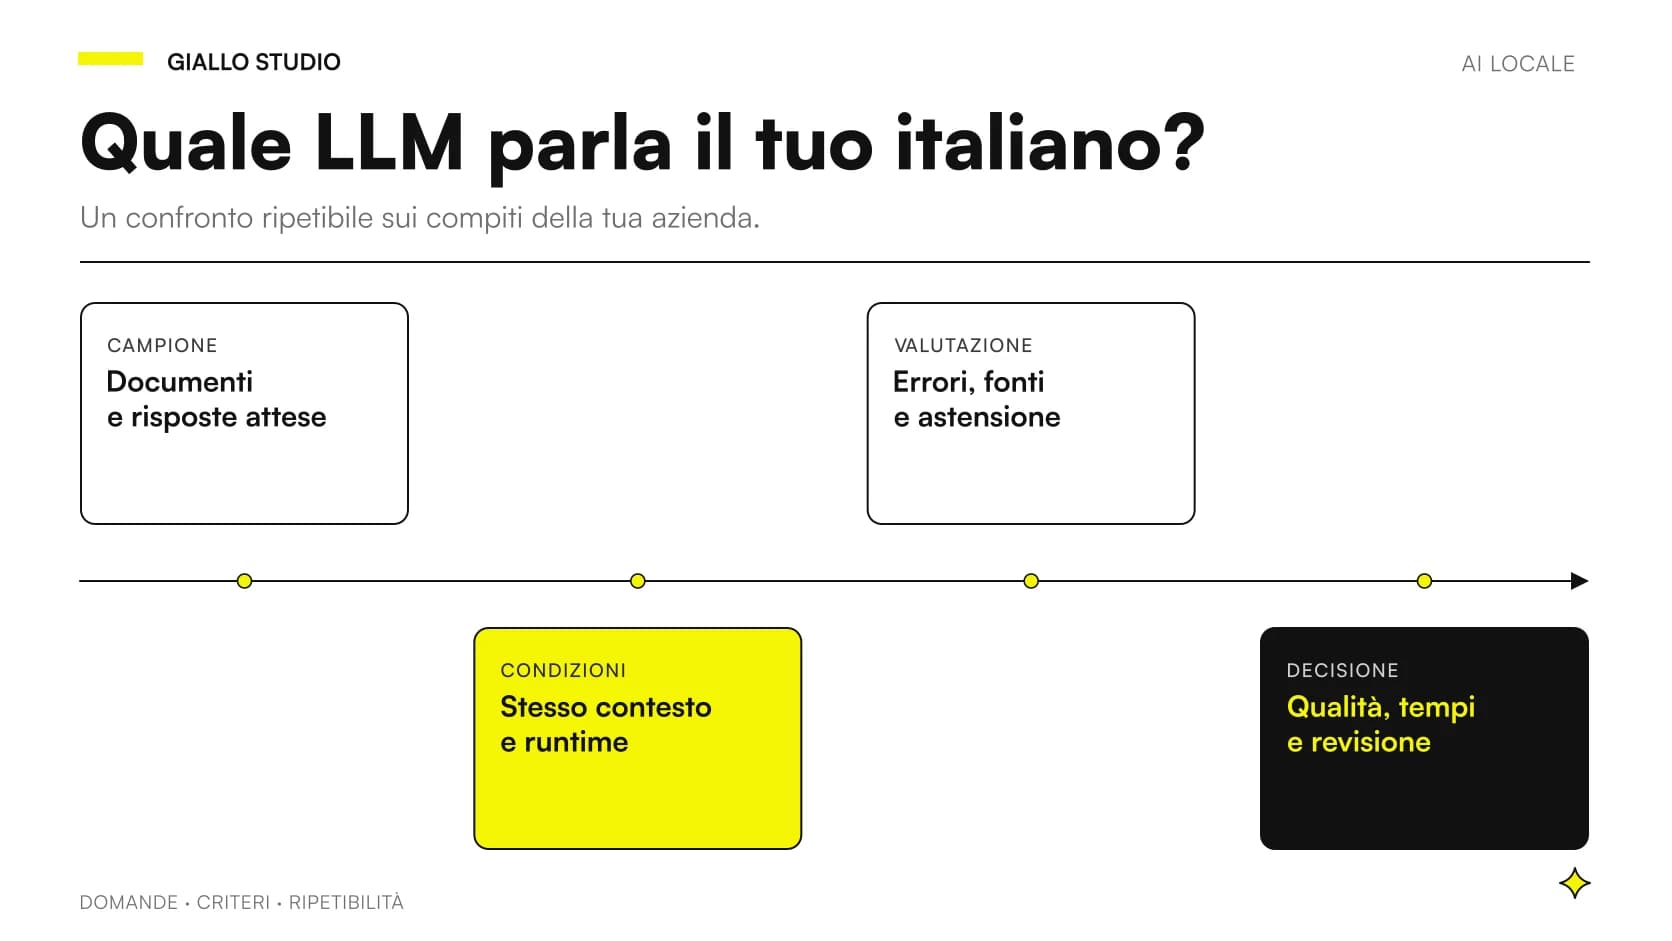
Prepara un piccolo fascicolo di prova con documenti sintetici o autorizzati. Definisci prima cosa rende una risposta utilizzabile: dati corretti, citazione verificabile, formato e tempo compatibile con l'attività. Il protocollo per confrontare LLM in italiano aiuta a evitare valutazioni basate sulla sola impressione.
- Registra modello esatto, file, versione del programma e impostazioni.
- Chiudi soltanto ciò che non sarebbe aperto nel normale lavoro.
- Esegui una prima richiesta per osservare il caricamento.
- Ripeti il compito con documenti e conversazioni rappresentativi.
- Controlla memoria, ripartizione CPU/GPU, errori e risultato finale.
- Valuta un secondo utente soltanto se il servizio dovrà davvero gestirlo.
Non confrontare una macchina appena avviata con un'altra che sta aggiornando il sistema. Mantieni i test ripetibili e segnala le condizioni che non riesci a controllare.
Una PMI commerciale: meglio una postazione o un servizio?
Consideriamo uno scenario ipotetico: un distributore vuole ricavare bozze di risposta dalle schede tecniche. Una sola persona prepara le bozze e controlla le fonti prima dell'invio.
La prima prova può riguardare la sua postazione Windows, con il gestionale aperto e documenti simili a quelli quotidiani. Se il risultato è corretto ma il PC diventa poco utilizzabile, il problema non si risolve dichiarando che il modello «funziona»: occorre valutare dimensioni, impostazioni o una macchina dedicata.
Se invece più commerciali devono interrogare lo stesso archivio, cambia il progetto. Servono accessi, isolamento dei documenti, gestione delle code e responsabilità operative. La GPU è una componente; non sostituisce il software che governa il servizio.
Un criterio utile per questo esempio è conservare il vantaggio dell'assistente senza obbligare il commerciale a cambiare continuamente ambiente. La bozza dovrebbe arrivare insieme al riferimento della scheda utilizzata e a un'indicazione chiara quando manca un dato. Il responsabile del processo può così distinguere un limite del modello da una scheda prodotto incompleta. Se la macchina è condivisa con altre attività pesanti, annota anche quali lavorazioni possono coincidere: il risultato di una prova isolata potrebbe non rappresentare il momento in cui l'ufficio ne ha davvero bisogno. Tutte queste condizioni entrano nella decisione prima del modello della scheda grafica.
Uno studio tecnico: cosa verificare con PDF e tavole?
In un secondo esempio ipotetico, uno studio prepara riepiloghi di capitolati e tavole scansionate. Il modello va valutato anche sul percorso di lettura: un PDF con testo selezionabile e una pagina acquisita come immagine possono richiedere elaborazioni differenti.
Un file che entra in memoria con input testuale può avere un comportamento diverso con immagini, documenti lunghi o elaborazioni parallele. Verifica il flusso descritto nella guida all'AI multimodale per PDF e immagini.
Per la prova usa dettagli controllabili: riferimenti di pagina, unità di misura e dati da non confondere. Misurare soltanto la velocità con cui compare un riassunto non dimostra che le informazioni estratte siano affidabili per il lavoro tecnico.
Prepara inoltre un documento nel quale l'informazione richiesta non esiste. Il sistema dovrebbe segnalare il limite invece di completare la risposta con una supposizione plausibile. Poi modifica un valore nel fascicolo e verifica che la nuova richiesta non riproponga una versione precedente recuperata dalla cronologia. Sono controlli progettuali, non risultati già ottenuti: servono a scegliere cosa osservare durante la prova. Se il PC supera la parte hardware ma il flusso non distingue versioni e fonti, aumentare la VRAM non affronta il problema che interessa allo studio. Prima correggi il percorso documentale, poi ripeti le misure sulla configurazione candidata.
Perché una NPU e tanti TOPS non rispondono alla domanda?
Le specifiche di un AI PC descrivono capacità hardware, ma l'applicazione deve poterle utilizzare. Il percorso effettivo dipende da supporto del motore, formato dei pesi e operazioni richieste dal modello.
Non dedurre la velocità di Qwen3.8-27B dal numero di TOPS della NPU. Prima cerca una combinazione ufficialmente supportata e una prova che riguardi proprio quel modello o una configurazione pertinente. La matrice di Ollama è un riferimento per quel runtime, non un'approvazione automatica di qualsiasi acceleratore.
Questa distinzione evita acquisti motivati da etichette generiche. Un computer può essere ottimo per funzioni AI del sistema operativo e richiedere un percorso diverso per il tuo LLM scaricato.
Quali errori rendono il confronto poco utile?
Il primo è scegliere il checkpoint più grande disponibile, comprimendolo finché entra senza verificare se il compito peggiora. La guida alla quantizzazione GGUF spiega perché occupazione e qualità vanno confrontate insieme.
Il secondo è usare prompt cortissimi durante la prova e documenti lunghi nel lavoro. Il terzo è attribuire alla GPU un errore di driver, template o versione del runtime. Il quarto è dimenticare che lo stesso programma può offrire anche percorsi cloud: controlla dove avviene davvero l'elaborazione.
Infine, non usare lo swap o il semplice mancato arresto dell'applicazione come criterio di successo. Una prova deve verificare continuità del lavoro e correttezza, non soltanto assenza di un messaggio di errore.
Quando la macchina è pronta per il lavoro quotidiano?
La decisione diventa solida quando sai descrivere cosa funziona, con quali limiti e chi interviene se smette di farlo. Conserva una configurazione riproducibile, una procedura di aggiornamento e un piccolo insieme di richieste da ripetere dopo ogni modifica significativa.
Definisci anche cosa non deve essere elaborato su quella postazione, dove restano conversazioni e documenti e chi può accedervi. La guida alla verifica offline e alla privacy completa il controllo tecnico senza confondere esecuzione locale e conformità automatica.
Se vuoi dimensionare il servizio partendo dalle attività dell'ufficio, la consulenza AI di Giallo Studio può trasformare la scheda del PC in un piano di prova: checkpoint candidati, carico rappresentativo e criteri chiari per decidere se usare la macchina esistente o progettare un sistema dedicato.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
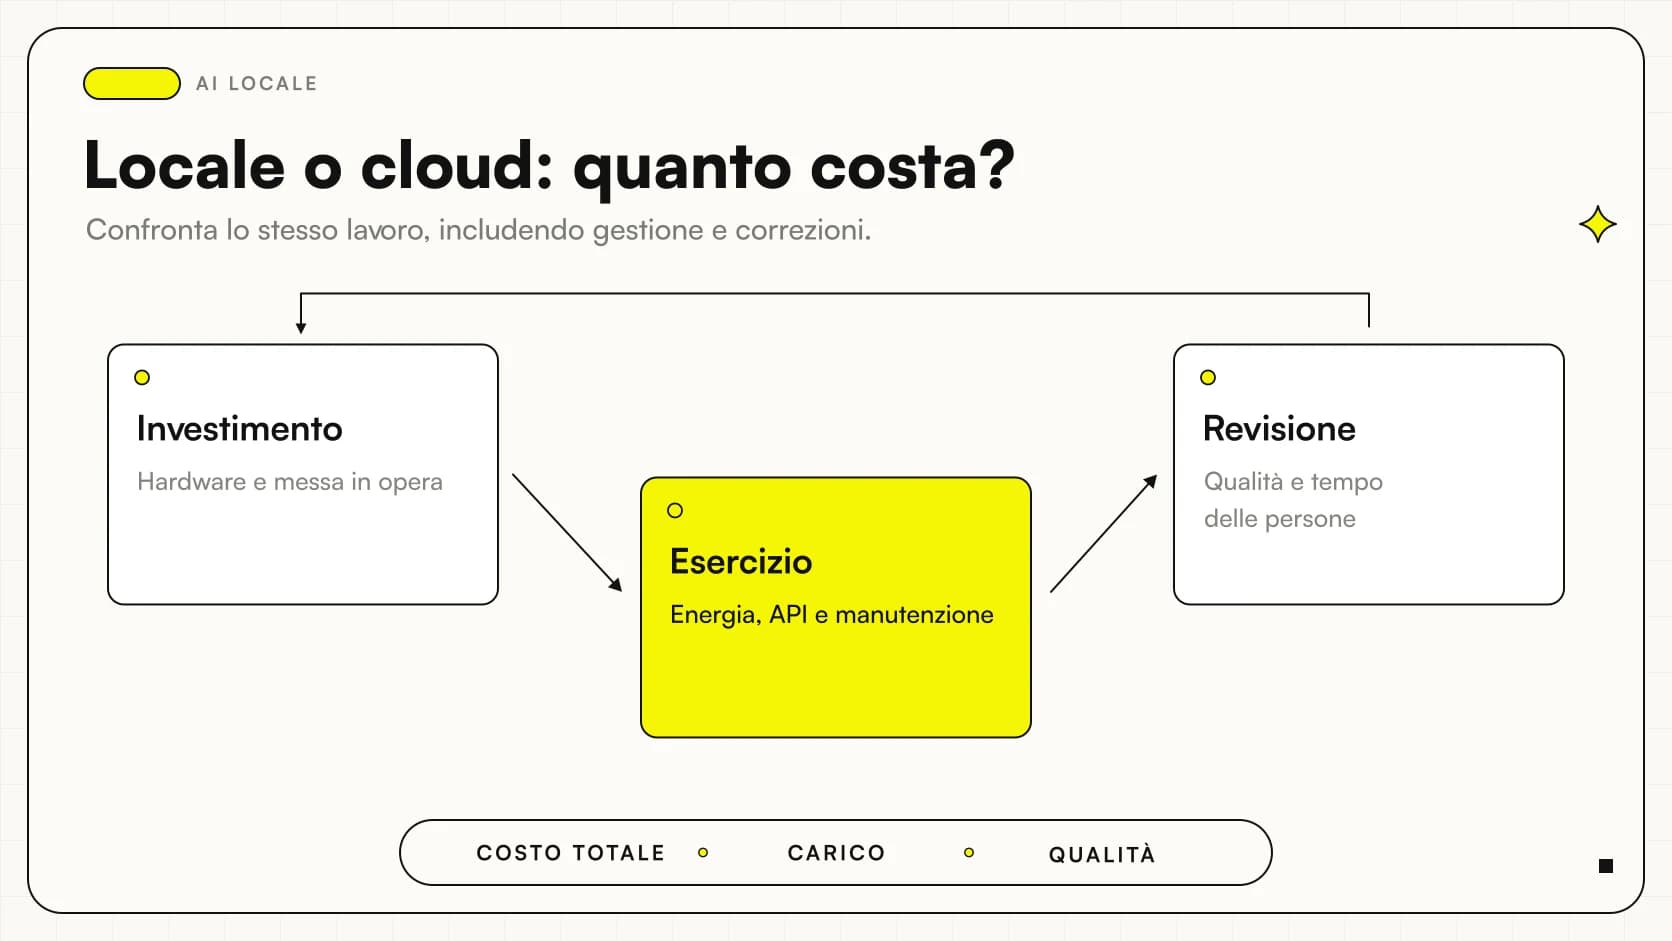 AI locale vs cloud: come confrontare i costi in azienda
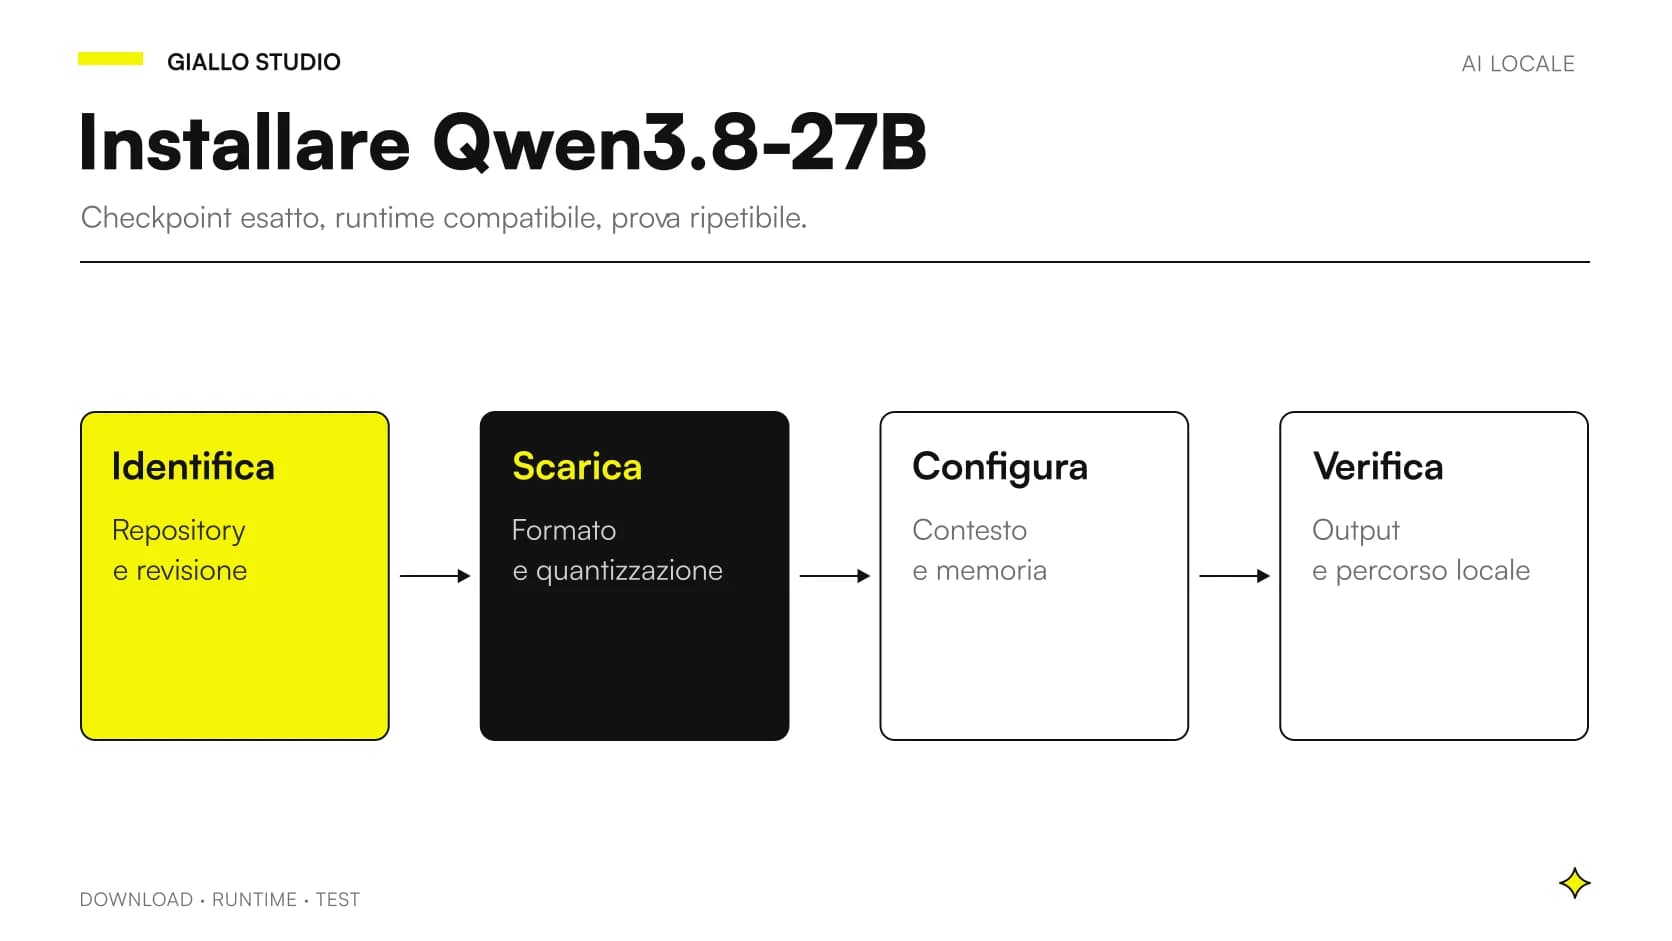 Installare Qwen3.8-27B in locale: controlli e procedura
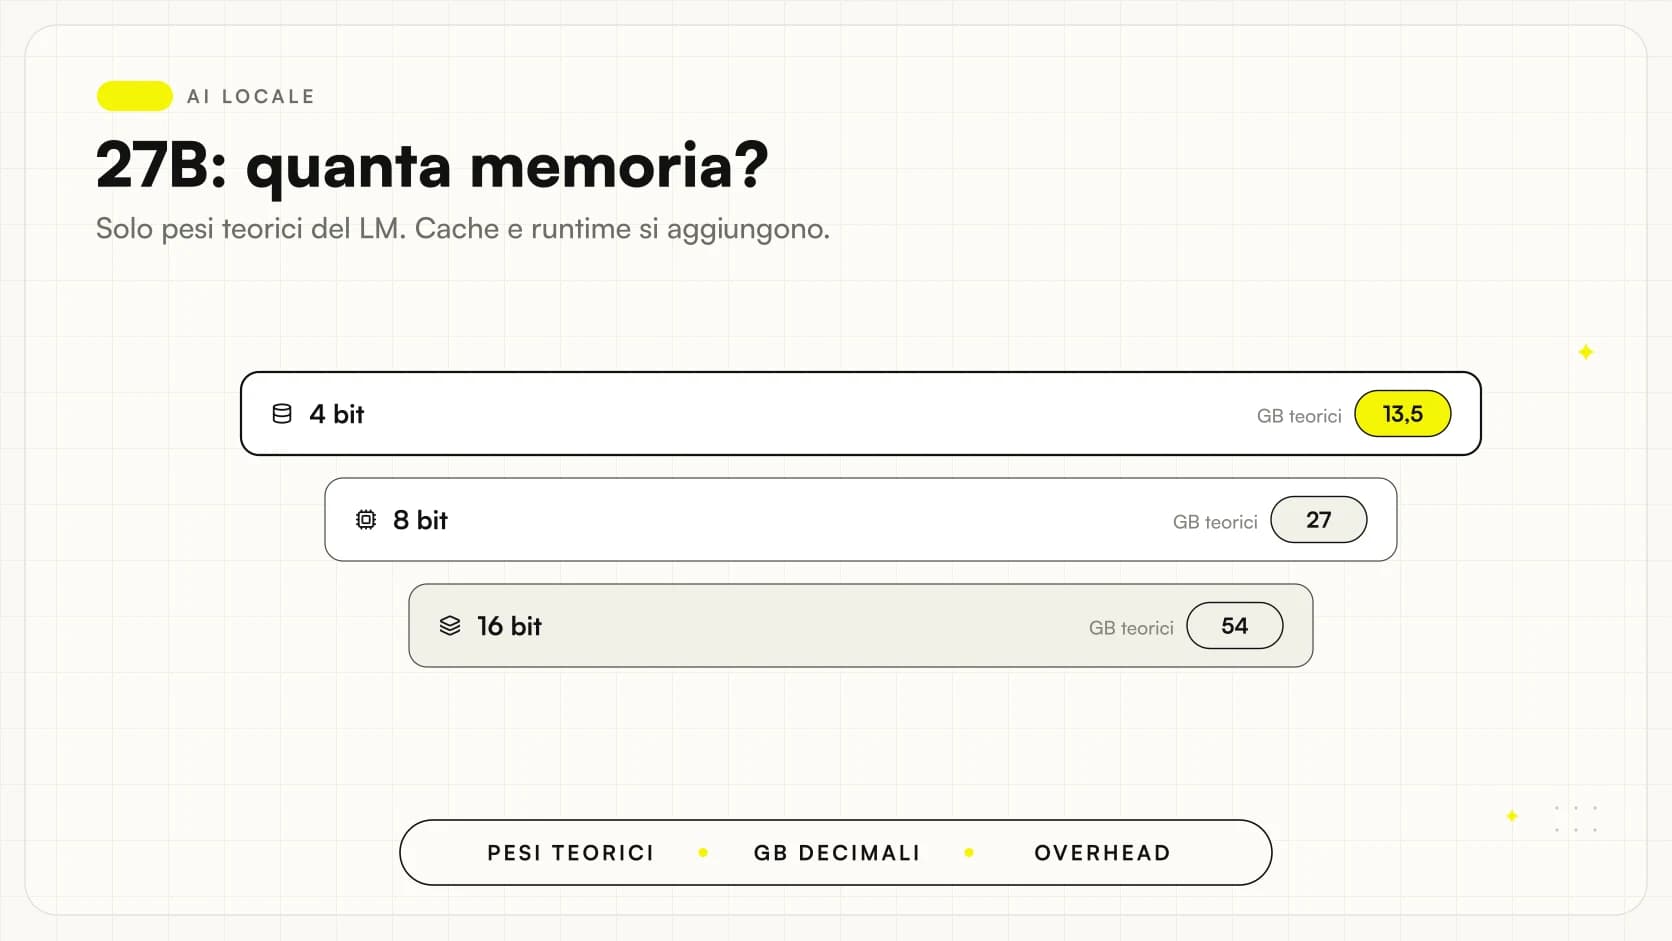 Qwen3.8-27B: quanta RAM e VRAM servono davvero?
 Quantizzazione GGUF: Q4 o Q8 per gli LLM locali?
 Ollama vs LM Studio: come scegliere per l'AI locale
 LLM locali in italiano: come confrontarli senza falsi test
 AI locale e privacy: come verificare che resti offline
FAQ
Quanta VRAM serve per un LLM locale su Windows?
Dipende dal checkpoint, dalla quantizzazione, dal contesto e dalle richieste contemporanee. La dimensione del file è un primo riferimento, ma servono margini per cache e runtime. Non esiste una soglia valida per ogni modello.
Posso sommare RAM e VRAM per scegliere il modello?
Non come se fossero un unico banco di memoria con le stesse prestazioni. Alcuni runtime distribuiscono il lavoro tra CPU e GPU, ma il comportamento cambia e va misurato. La memoria condivisa mostrata da Windows non equivale a VRAM dedicata aggiuntiva.
Ollama funziona su Windows senza WSL?
La documentazione ufficiale prevede un'applicazione Windows nativa. Il supporto della GPU dipende da modello della scheda, driver e backend; verifica la matrice corrente prima dell'installazione.
Un PC senza scheda grafica dedicata può eseguire un LLM?
Può essere possibile con un percorso CPU o una GPU integrata supportata. Modello, memoria e tempo di risposta accettabile determinano se l'uso è pratico. Il fatto che un file venga caricato non prova che il processo aziendale sia sostenibile.
La NPU di un AI PC accelera automaticamente Ollama?
No: serve un percorso di esecuzione che supporti quella NPU, il modello e il formato utilizzato. Le specifiche commerciali in TOPS non dimostrano da sole compatibilità o velocità del proprio LLM.