
Installare Qwen3.8-27B in locale: controlli e procedura
Installare Qwen3.8-27B in locale: verifica pesi, runtime, memoria e API. Procedura documentata, comandi essenziali e diagnosi degli errori.
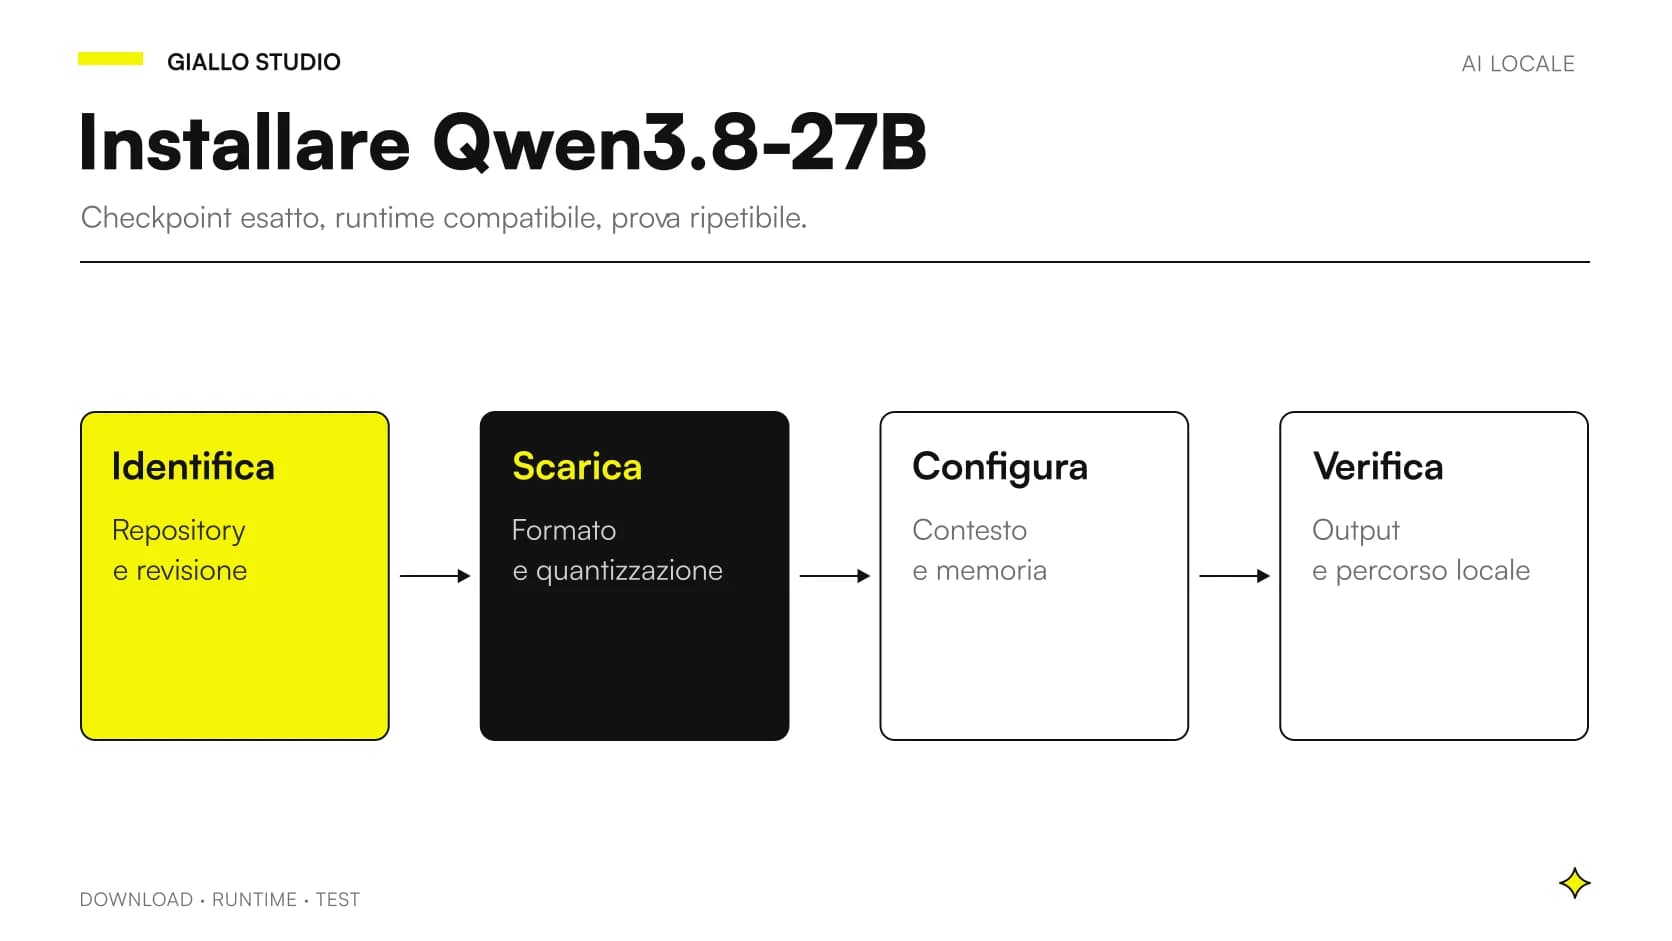
Per installare Qwen3.8-27B in locale devi prima scegliere il checkpoint esatto e un runtime che ne supporti l'architettura, poi verificare memoria e percorso delle richieste. Non esiste un comando universale che renda il modello adatto a qualsiasi PC o Mac; i passaggi seguenti distinguono un percorso documentato dalle verifiche necessarie sulla tua macchina.
Il riferimento è Qwen/Qwen3.8-27B. La guida usa la documentazione consultata il 27 ottobre 2026 e un esempio testuale con vLLM. I comandi sono verificati nelle fonti primarie; non rappresentano una prova hardware svolta da Giallo. Per un portatile con memoria limitata può essere più ragionevole scegliere un modello più piccolo o una conversione compatibile, invece di forzare i pesi originali.
In sintesi
- Conserva repository, revisione e formato dei pesi.
- Il supporto del runtime deve riguardare il checkpoint preciso.
- Un avvio riuscito non dimostra qualità o memoria sufficiente per ogni input.
- La prima prova usa dati fittizi e un server raggiungibile solo dal computer.
- Le funzioni visive richiedono una verifica distinta da quelle testuali.
Quale Qwen stai realmente per scaricare?
Nomi simili possono indicare modelli diversi per dimensione, architettura e formato. Il primo passaggio è aprire la scheda del repository, controllare autore, licenza e file. Una conversione di terzi non coincide con i pesi originali anche quando deriva dallo stesso checkpoint. Può essere utile, ma va documentata come componente distinto.
La scheda di valutazione dovrebbe riportare l'identificativo completo e una revisione, non soltanto il nome visualizzato dall'app. Questo permette di capire che cosa è cambiato dopo un aggiornamento o un nuovo download. La guida a Qwen3.8-27B descrive il modello; qui interessa creare una configurazione che un'altra persona possa ricostruire. Per un servizio aziendale si conserva anche una copia del verbale della prova e delle impostazioni, separata dalle conversazioni degli utenti.
Perché controllare l'ambiente prima del download?
Sistema operativo, driver e acceleratore determinano quale percorso software utilizzare. La documentazione d'installazione vLLM distingue piattaforme e modalità di esecuzione. Non si deve assumere che una ricetta per una GPU Linux sia direttamente applicabile a un Mac o a una configurazione Windows diversa.
Prima di procedere si annotano macchina, memoria disponibile, spazio su disco e applicazioni che resteranno attive. Lo spazio per scaricare i file non coincide con la memoria necessaria a caricarli. Se il progetto prevede documenti lunghi o più richieste, quel requisito entra nel dimensionamento iniziale. La guida su RAM e VRAM per Qwen3.8-27B spiega perché il solo numero 27B non basta e come distinguere stime teoriche da risorse effettivamente richieste.
Quali percorsi sono documentati e quali vanno verificati?
| Percorso | Riferimento primario | Controllo prima dell'uso |
|---|---|---|
| Checkpoint originale con vLLM | Ricetta specifica Qwen3.8-27B | Versioni, hardware e precisione |
| Checkpoint con SGLang | Cookbook specifico Qwen3.8-27B | Backend e componenti supportati |
| Conversione per app desktop | Scheda della conversione e motore | Architettura, template e visione |
| Tag in un catalogo runtime | Pagina del tag effettivo | File distribuiti e revisione |
La ricetta vLLM e il cookbook SGLang descrivono il modello preciso. Le configurazioni ottimizzate dipendono dall'hardware: copiarne soltanto alcune opzioni può produrre una combinazione mai verificata. Per la prima installazione conviene mantenere il percorso semplice e rinviare ottimizzazioni, tool e contesti estremi a una seconda fase.
Come preparare il percorso vLLM senza mescolare dipendenze?
In un ambiente supportato, la scheda del modello indica l'installazione di vLLM; la ricetta specifica richiede Transformers almeno 5.8.0. È opportuno usare un ambiente Python dedicato e seguire prima le istruzioni ufficiali per il proprio backend. Quando tale ambiente è pronto, la forma d'installazione dei pacchetti è:
python -m pip install vllm "transformers>=5.8.0"
python -m pip show vllm transformers
Il primo comando non sostituisce i prerequisiti del sistema e non promette che i pesi originali entrino in memoria. Il secondo aiuta a registrare le versioni effettivamente installate. Per rendere riproducibile una configurazione approvata si conservano poi le versioni risolte e il riferimento alla guida hardware usata, invece di lasciare che ogni nuova installazione scelga componenti diversi senza controllo.
Se il gestore dei pacchetti segnala incompatibilità, si risolve quella prima di avviare il modello. Aggiungere opzioni casuali al server non corregge una dipendenza mancante o una build inadatta all'acceleratore.
Come avviare una prima prova testuale sul computer?
Il comando base pubblicato nella model card usa vllm serve con il repository originale. Nell'esempio seguente aggiungiamo opzioni documentate nella CLI vLLM: ascolto soltanto locale, contesto di prova contenuto e una richiesta concorrente. Il parser del reasoning segue la ricetta del modello.
vllm serve Qwen/Qwen3.8-27B \
  --host 127.0.0.1 \
  --port 8000 \
  --max-model-len 8192 \
  --max-num-seqs 1 \
  --reasoning-parser qwen3
Gli 8.192 token sono una scelta illustrativa per la prima prova, non il contesto massimo del modello né un requisito garantito per qualunque hardware. Il checkpoint originale resta grande: ridurre il contesto non comprime i pesi. Si aspetta il completamento del caricamento e si leggono i log prima di inviare richieste. Questa configurazione iniziale non abilita strumenti automatici e non espone il server alla rete del team.
Come inviare una richiesta minima verificabile?
Con il server pronto, una richiesta testuale tramite endpoint compatibile permette di verificare il percorso. L'esempio usa una domanda fittizia, senza documenti o informazioni personali:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen/Qwen3.8-27B","messages":[{"role":"user","content":"Rispondi in italiano: che cosa significa eseguire un modello sul proprio computer?"}],"max_tokens":1024,"chat_template_kwargs":{"enable_thinking":false}}'
Si controllano risposta HTTP, identificativo richiesto e contenuto restituito. L'opzione enable_thinking disattiva il ragionamento esplicito per questo controllo breve, secondo il formato documentato nella ricetta. Una generazione interrotta dal limite non dimostra necessariamente un errore d'installazione: occorre osservare stato e motivo della conclusione. Il test serve soltanto a stabilire che client, server e modello comunicano. Per valutare accuratezza e utilità serve poi il campione descritto nel protocollo di benchmark locale in italiano.
Posso usare Ollama o LM Studio al posto di vLLM?
Sono alternative da valutare quando esiste una distribuzione compatibile con il motore e la versione installati. Non è corretto inventare un tag Ollama dal nome del repository, né presumere che qualsiasi file GGUF supporti automaticamente tutte le capacità di Qwen3.8. La guida Ollama all'importazione descrive un meccanismo, non certifica ogni architettura possibile.
Anche un'app che permette di scaricare un file può richiedere un motore aggiornato o componenti aggiuntivi. Si verifica la pagina della conversione, il template e l'eventuale supporto visivo, poi si prova il risultato. Il confronto fra Ollama e LM Studio aiuta a scegliere il percorso operativo; nessuna etichetta sostituisce la prova del checkpoint effettivo. In questa guida non pubblichiamo un comando di download per un tag che non abbiamo verificato.
Che cosa fare se il modello non entra in memoria?
Prima si identifica la fase del fallimento: download, caricamento dei pesi, preparazione della cache o generazione. Sono problemi differenti. Il log completo va conservato in un luogo controllato, evitando di pubblicare dati eventualmente presenti nelle richieste. La diagnosi parte dall'errore reale, non da una lista di modifiche trovate per altri modelli.
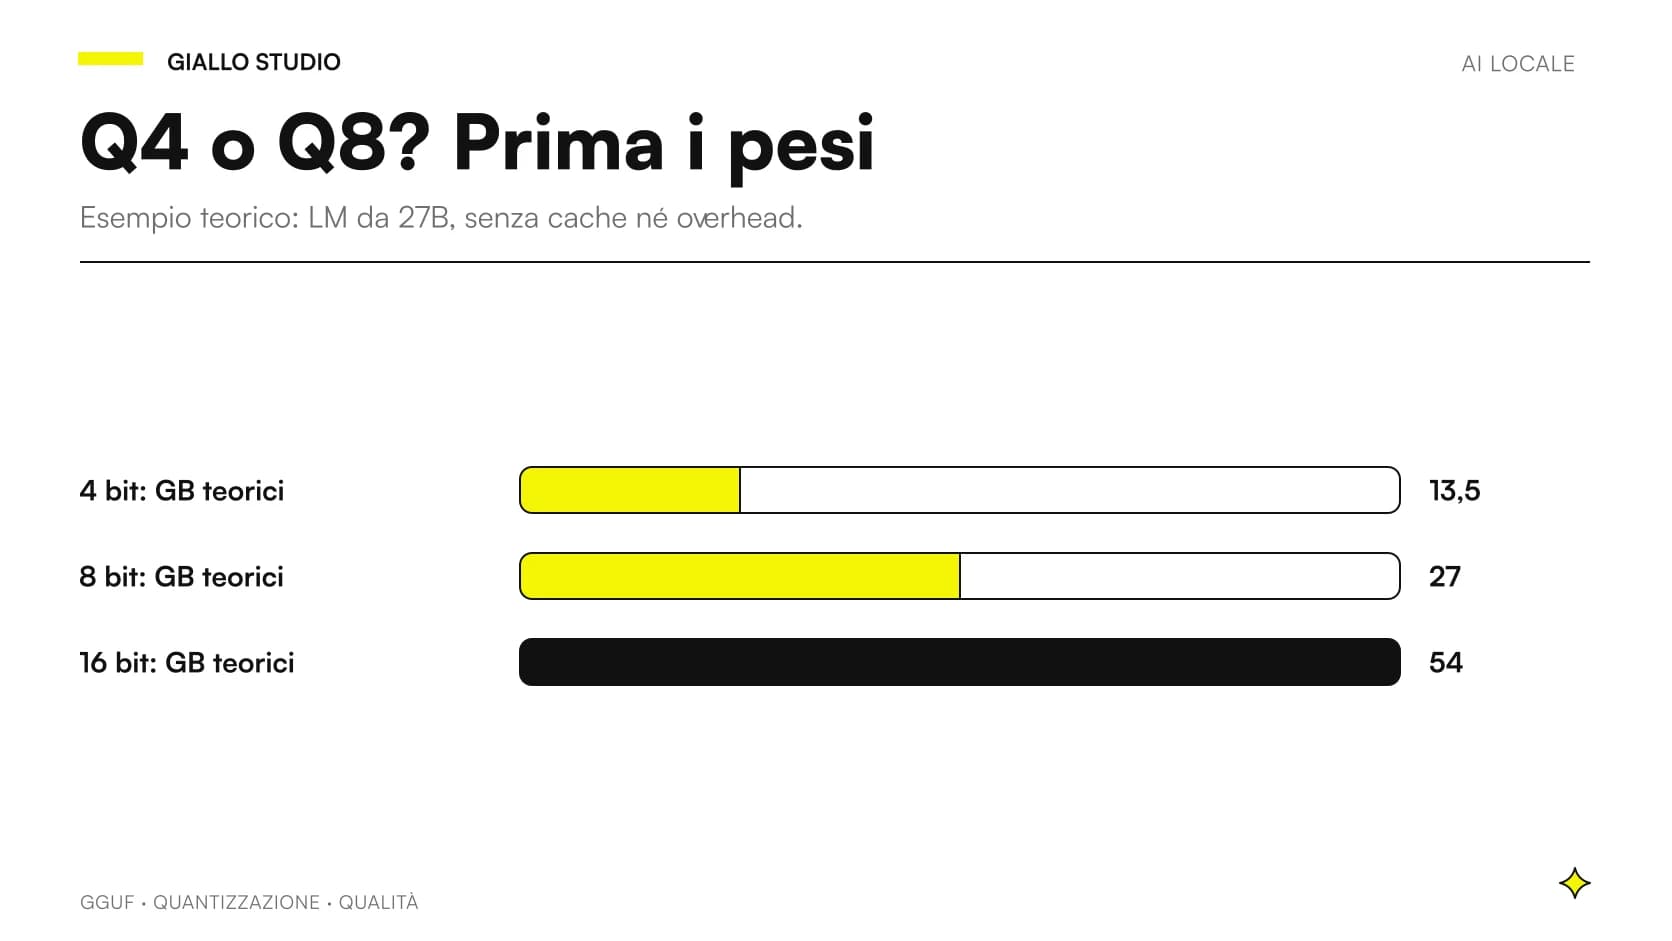
Si confrontano poi file selezionati, precisione e risorse disponibili. Un checkpoint quantizzato compatibile può ridurre il consumo dei pesi, ma richiede una nuova verifica della qualità. Ridurre contesto o concorrenza interviene su altre parti del carico. Se il problema resta nei pesi originali, può essere più semplice scegliere un modello più piccolo. Ripetere lo stesso avvio cambiando molte opzioni insieme rende difficile capire che cosa abbia funzionato e quale compromesso sia stato introdotto.
Come verificare immagini e PDF dopo il primo avvio?
Una risposta testuale corretta non prova che il percorso multimodale sia completo. Si prepara un'immagine fittizia con un'informazione non contenuta nella domanda e si utilizza il formato supportato dal runtime. L'esito deve dimostrare che l'immagine sia stata ricevuta e interpretata, senza ricorrere a indizi nel nome del file.
Per un PDF bisogna inoltre sapere come l'applicazione lo trasforma: estrazione testuale, immagini delle pagine o recupero di frammenti. L'inferenza è soltanto una fase. La guida all'AI multimodale locale per PDF descrive i controlli su pagina e citazioni. Non conviene introdurre documenti reali finché non sono chiari percorso dei file, accessi e salvataggi. Si parte da materiale fittizio che riproduca le difficoltà del compito, comprese scansioni illeggibili.
Uno scenario: un tecnico prepara il computer di prova
Immaginiamo un tecnico che debba valutare un assistente per classificare richieste interne. È un esempio ipotetico. Prepara un ambiente dedicato, un insieme di messaggi fittizi e una tabella con le categorie attese. Dopo il primo avvio verifica il formato, poi salva configurazione e risultati prima di aggiungere un'interfaccia grafica o collegare il gestionale.
Questa sequenza permette di capire dove nasce un errore. Se il modello classifica male una richiesta già nel test diretto, il problema non è il modulo del gestionale. Se il test diretto riesce ma l'integrazione fallisce, si confrontano le richieste effettive. La prova evita di modificare simultaneamente pesi, prompt e codice applicativo, mantenendo leggibile il rapporto fra cambiamento e risultato.
Uno scenario: lo studio vuole consultare documenti offline
In un secondo caso illustrativo, uno studio desidera cercare informazioni in procedure riservate. L'installazione non si considera conclusa perché il modello risponde senza browser. Si verifica anche dove avvengono estrazione, ricerca e conservazione delle conversazioni, poi si prova il percorso completo con file fittizi.
Il responsabile deve sapere quali operazioni richiedono rete, come preparare aggiornamenti e chi può usare il servizio. Se un documento manca o non è leggibile, l'applicazione deve mostrare il limite invece di nascondere il problema con una risposta generica. La verifica di AI locale, privacy e offline aiuta a definire questo perimetro. Il modello installato è una condizione tecnica; l'uso affidabile richiede anche una procedura per gli operatori.
Come distinguere un errore del server da una richiesta non valida?
Un server avviato correttamente può rifiutare una richiesta perché il client usa un identificativo diverso, un formato non supportato o un limite incompatibile con il contesto configurato. Prima di reinstallare tutto, si conserva la richiesta minima e si confronta l'errore con i log dello stesso tentativo. Occorre verificare che il client stia interrogando proprio il processo appena avviato, soprattutto quando sul computer sono presenti più runtime.
Il controllo va svolto prima senza interfacce aggiuntive. Se la richiesta minima funziona, si introduce un solo componente alla volta: applicazione, allegato, strumenti o memoria della conversazione. Questo permette di attribuire il fallimento al passaggio che lo produce. Un messaggio generico dell'interfaccia potrebbe nascondere una risposta HTTP utile, che lo sviluppatore deve poter leggere senza esporre il contenuto delle richieste degli utenti.
Che cosa conservare per tornare a una configurazione funzionante?
Oltre alle versioni dei pacchetti, si salvano il comando d'avvio, la revisione del modello e un input fittizio con esito atteso. Prima di aggiornare si verifica che quel riferimento sia ancora riproducibile. Dopo l'aggiornamento si ripete lo stesso percorso e si osservano eventuali differenze, comprese modalità di risposta e campi restituiti dall'API.
Il ripristino deve riguardare una combinazione conosciuta, non soltanto un numero di versione scritto nelle note. File convertiti, template e impostazioni del client possono aver cambiato il risultato anche quando il nome del runtime è rimasto identico. Per questo la consegna tecnica dovrebbe spiegare come ricostruire il percorso completo e quali parti restano fuori dal primo perimetro di utilizzo.
Quali controlli chiudono davvero l'installazione?
- Repository, revisione, file e versioni software sono registrati.
- La richiesta raggiunge il server locale previsto e usa il modello corretto.
- Il campione copre input reali, limiti ed errori osservabili.
- Un riavvio riproduce la configurazione senza interventi non documentati.
- Esiste un responsabile degli aggiornamenti e del ripristino.
Un verbale essenziale riporta anche ciò che non è stato provato: immagini, utenti simultanei, documenti lunghi o integrazioni possono restare fuori dal primo perimetro. Non è un difetto dichiarare questo limite; è il modo per non trasformare una verifica circoscritta in una promessa generale.
Se vuoi passare dall'installazione a un servizio usato dal team, Giallo Studio progetta agenti AI intorno a dati, permessi e verifiche del processo. La scelta del runtime diventa così parte di una configurazione documentata, capace di essere mantenuta anche da chi non ha eseguito il primo comando.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Quantizzazione GGUF: Q4 o Q8 per gli LLM locali?
 Qwen3.8-27B vs Qwen3.6-35B-A3B: cosa cambia in locale
 Qwen3.8-27B in locale: capacità, limiti e requisiti
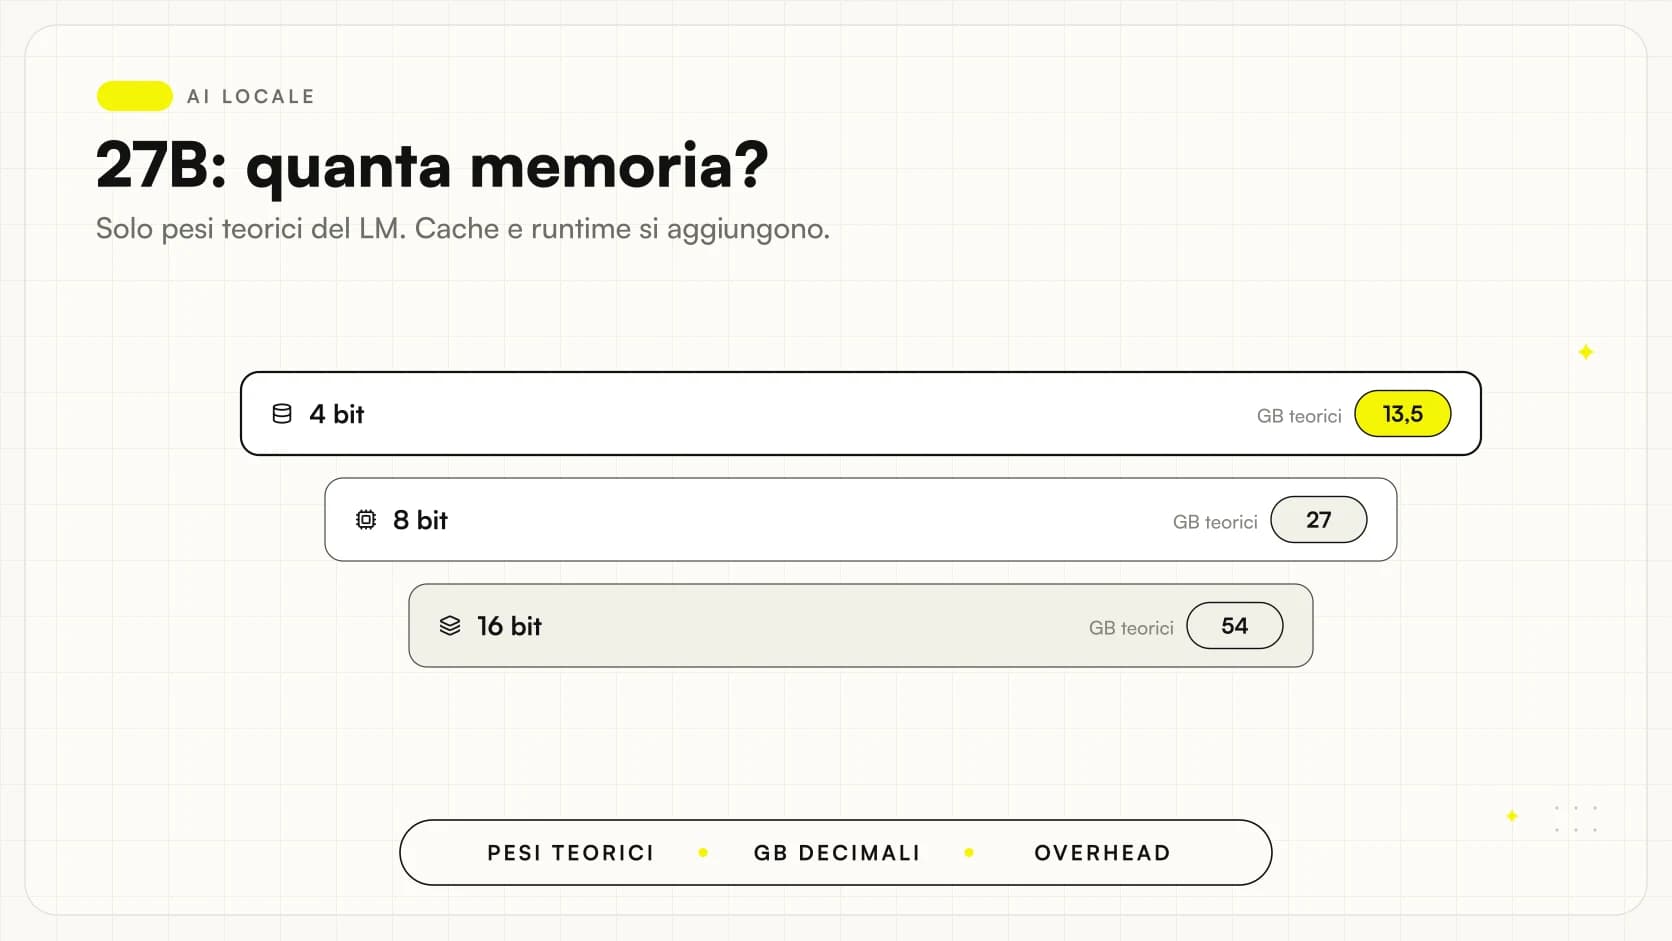 Qwen3.8-27B: quanta RAM e VRAM servono davvero?
 Ollama vs LM Studio: come scegliere per l'AI locale
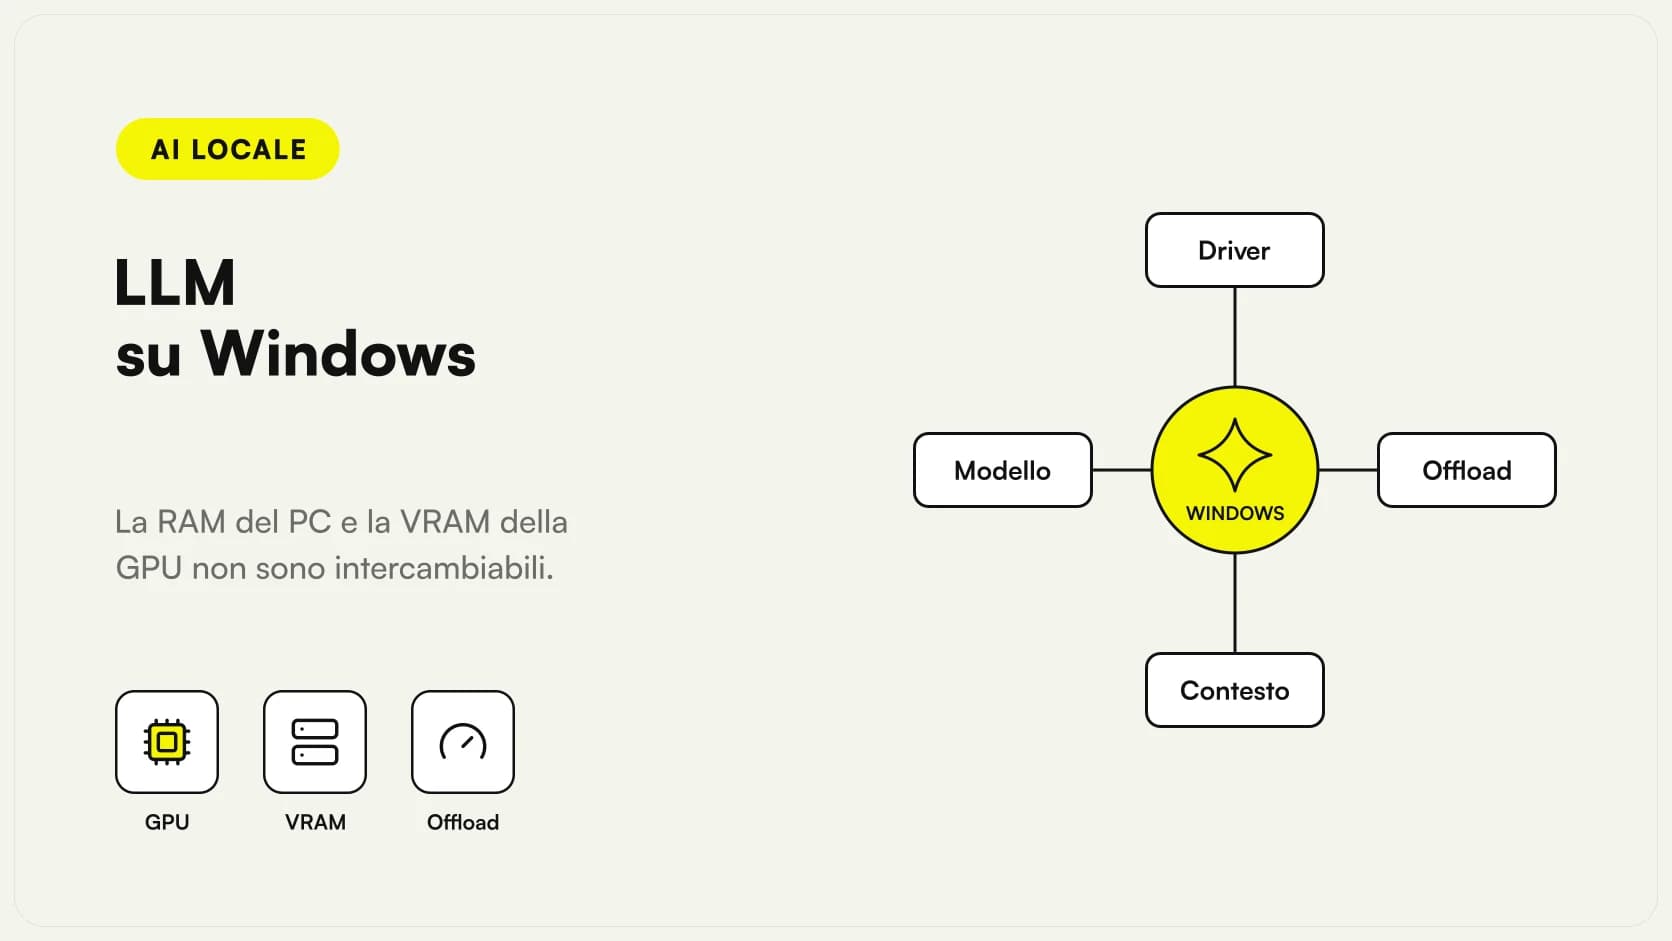 LLM locale su Windows: GPU, VRAM e limiti pratici
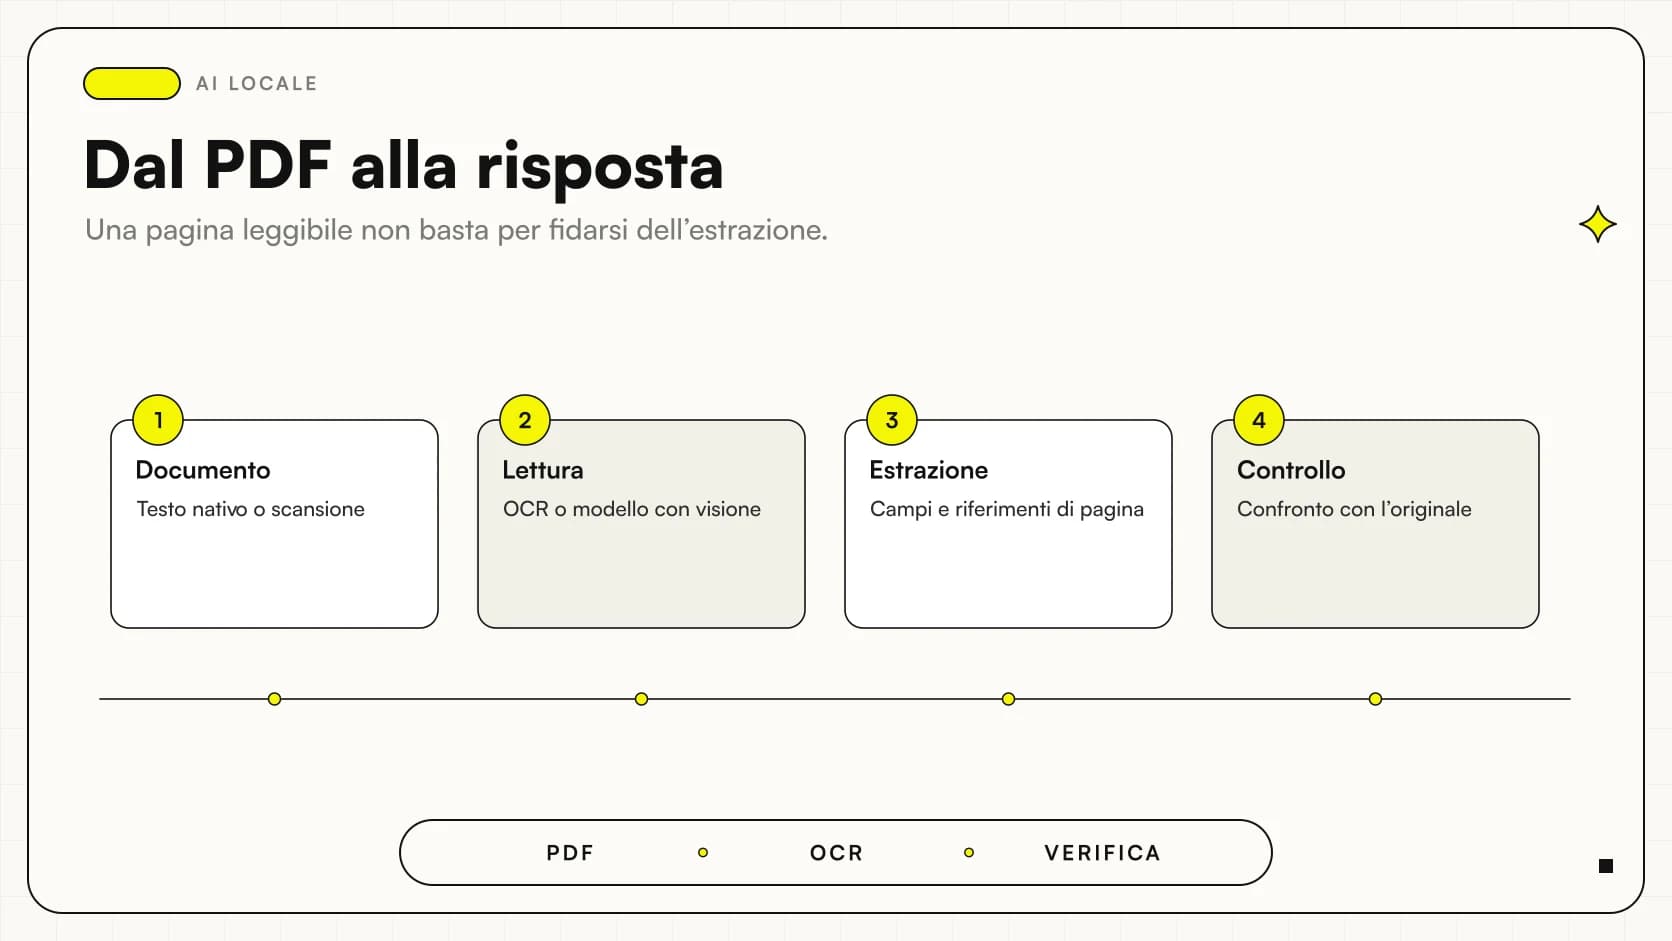 AI multimodale locale: leggere PDF e immagini aziendali
FAQ
Qual è il repository ufficiale da usare?
Il checkpoint di riferimento è Qwen/Qwen3.8-27B su Hugging Face. Varianti quantizzate, conversioni e modelli dal nome simile vanno identificati separatamente, conservando autore e revisione.
Esiste un unico comando valido per qualsiasi computer?
No. Sistema operativo, acceleratore, driver, formato dei pesi e runtime devono essere compatibili. La procedura vLLM descritta presuppone un ambiente supportato e memoria sufficiente per il checkpoint originale.
Posso inventare un tag Ollama dal nome Qwen3.8-27B?
No. Occorre usare il tag pubblicato e verificarne contenuto e compatibilità. Il supporto generico della famiglia Qwen o del formato GGUF non dimostra quello del checkpoint esatto.
Una risposta alla prima domanda dimostra che l'installazione è corretta?
Dimostra soltanto un primo percorso funzionante. Servono controlli su identità del modello, formati richiesti, memoria, input rappresentativi e comportamento dopo un riavvio.
La procedura pubblicata è un benchmark hardware Giallo?
No. I comandi e i requisiti software sono ricavati dalla documentazione primaria. Giallo non ha eseguito questa installazione su tutte le configurazioni né misurato velocità o memoria su una macchina campione.