
LLM locale su Mac: scegliere con 16, 24 o 32 GB
LLM locale su Mac con 16, 24 o 32 GB: memoria unificata, modelli, contesto e pressione memoria. Valuta il lavoro reale prima dell'acquisto.
Per scegliere un LLM locale su Mac con 16, 24 o 32 GB devi confrontare il modello e il lavoro effettivo, lasciando memoria a macOS e alle applicazioni. La capacità nominale non identifica una classe di modelli garantita: quantizzazione, contesto, immagini e runtime possono cambiare il risultato.
Questa guida riguarda soprattutto Apple Silicon e propone un metodo di scelta, non una classifica di computer. Non abbiamo eseguito benchmark Giallo su tre Mac equivalenti e non attribuiamo velocità universali a una quantità di RAM. Le fonti primarie citate sono state consultate il 27 ottobre 2026; requisiti e compatibilità degli strumenti vanno ricontrollati prima di installare o acquistare.
In sintesi
- La memoria del Mac serve anche al sistema e alle altre applicazioni.
- 16, 24 e 32 GB sono budget da verificare, non garanzie di un modello.
- Un modello più piccolo può essere migliore per il processo se resta utilizzabile.
- Pressione memoria e swap vanno osservati durante il lavoro rappresentativo.
- Prima dell'acquisto prova anche input lunghi, immagini e riavvio.
Perché memoria unificata non significa memoria illimitata per l'AI?
Il modello locale deve convivere con il computer che utilizzi. Browser, editor, applicazioni del mestiere e macOS occupano risorse insieme al runtime. Anche quando una configurazione riesce a caricare i pesi, potrebbe lasciare poco margine per la richiesta o rendere meno agevoli altre attività.
La documentazione MLX di Apple descrive un framework progettato per Apple Silicon e la memoria unificata. Questo non elimina la necessità di dimensionare il carico. La domanda utile è quanta memoria rimane nel momento in cui il lavoro viene svolto, con le applicazioni necessarie aperte. Per una prova aziendale occorre riprodurre quella situazione. Un test eseguito dopo aver chiuso tutto può essere una misura tecnica, ma va distinto dal comportamento del Mac nella giornata ordinaria.
Come leggere la scelta fra 16, 24 e 32 GB?
| Memoria nominale | Punto di partenza della prova | Domanda decisiva |
|---|---|---|
| 16 GB | Candidato contenuto e contesto circoscritto | Rimane spazio per lavorare nelle altre app? |
| 24 GB | Più alternative da verificare sullo stesso compito | Il beneficio giustifica il maggiore carico? |
| 32 GB | Configurazioni più impegnative, se compatibili | Quali input e richieste sono davvero sostenibili? |
La tabella esprime un metodo prudente, non requisiti minimi verificati per modelli specifici. Il passaggio a una capacità maggiore amplia il budget, ma non dimostra che ogni variante entri o sia conveniente. Conta anche il chip preciso e il percorso software; non sarebbe corretto confrontare due Mac diversi e attribuire ogni differenza alla sola memoria.
Se possiedi già la macchina, il primo obiettivo è trovare una configurazione utile. Se devi acquistarla, il campione del processo dovrebbe precedere la decisione, evitando di trasformare il modello più grande disponibile in un requisito non necessario.
Quali strumenti controllare prima di scaricare i modelli?
La pagina ufficiale LM Studio System Requirements indica Apple Silicon, macOS 14 o successivo e raccomanda almeno 16 GB; segnala anche che i Mac Intel non sono attualmente supportati. Questi sono requisiti dell'applicazione, non una promessa per qualsiasi checkpoint o contesto.
Altri percorsi usano software e formati differenti. MLX LM è un progetto per eseguire modelli linguistici con MLX; un'app può invece gestire un motore con un'altra interfaccia. Prima della prova si verifica il supporto della variante esatta, non soltanto della famiglia. La guida Ollama vs LM Studio distingue esperienza d'uso e integrazione. La disponibilità di un file in un catalogo non dimostra che tutte le modalità del modello siano operative nella tua versione.
Quale modello scegliere come primo candidato?
Parti da un compito circoscritto: classificare messaggi fittizi, estrarre campi da testo o preparare una bozza controllabile. Poi scegli un candidato con dimensioni e capacità pertinenti. Un modello più grande non porta automaticamente un vantaggio utilizzabile su ogni richiesta, mentre il maggiore consumo può incidere sulla comodità quotidiana.
Fra i riferimenti da valutare ci sono varianti più contenute come Qwen3.5-9B o membri della famiglia Gemma 4. Sono esempi di checkpoint reali, non un'affermazione che qualunque loro distribuzione funzioni entro un certo budget. Si seleziona una conversione compatibile, si registra la precisione e si prova il campione. La guida alla scelta dei modelli AI aiuta a evitare una selezione fondata soltanto su dimensioni e annunci.
È realistico partire da Qwen3.8-27B su un Mac da 16 GB?
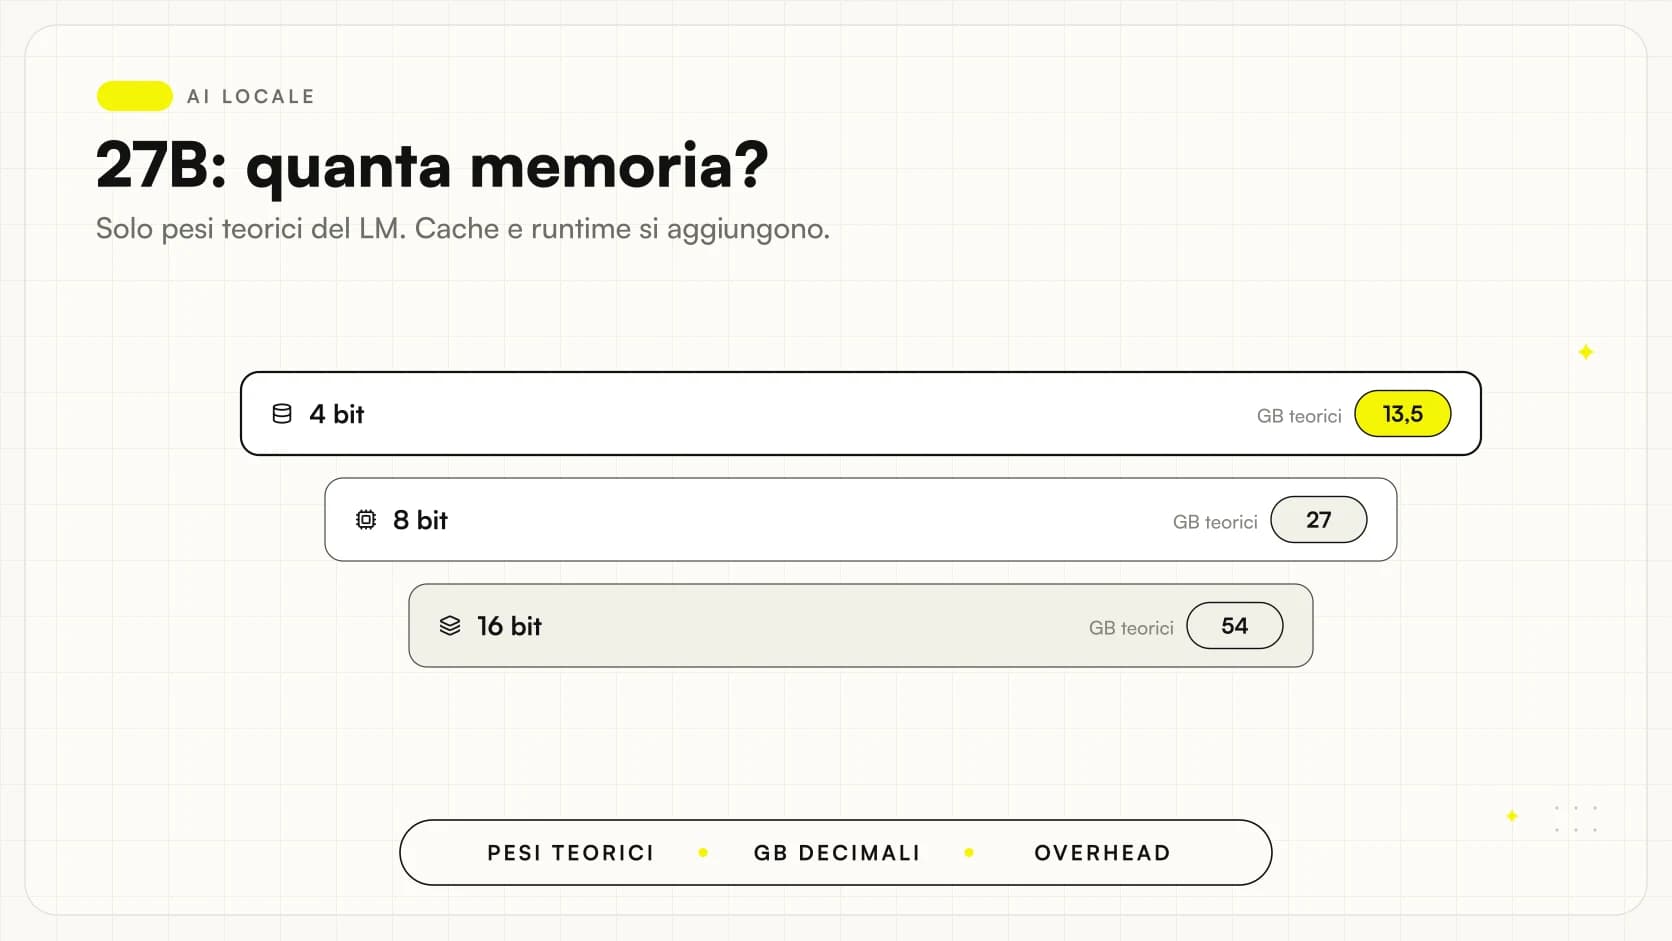
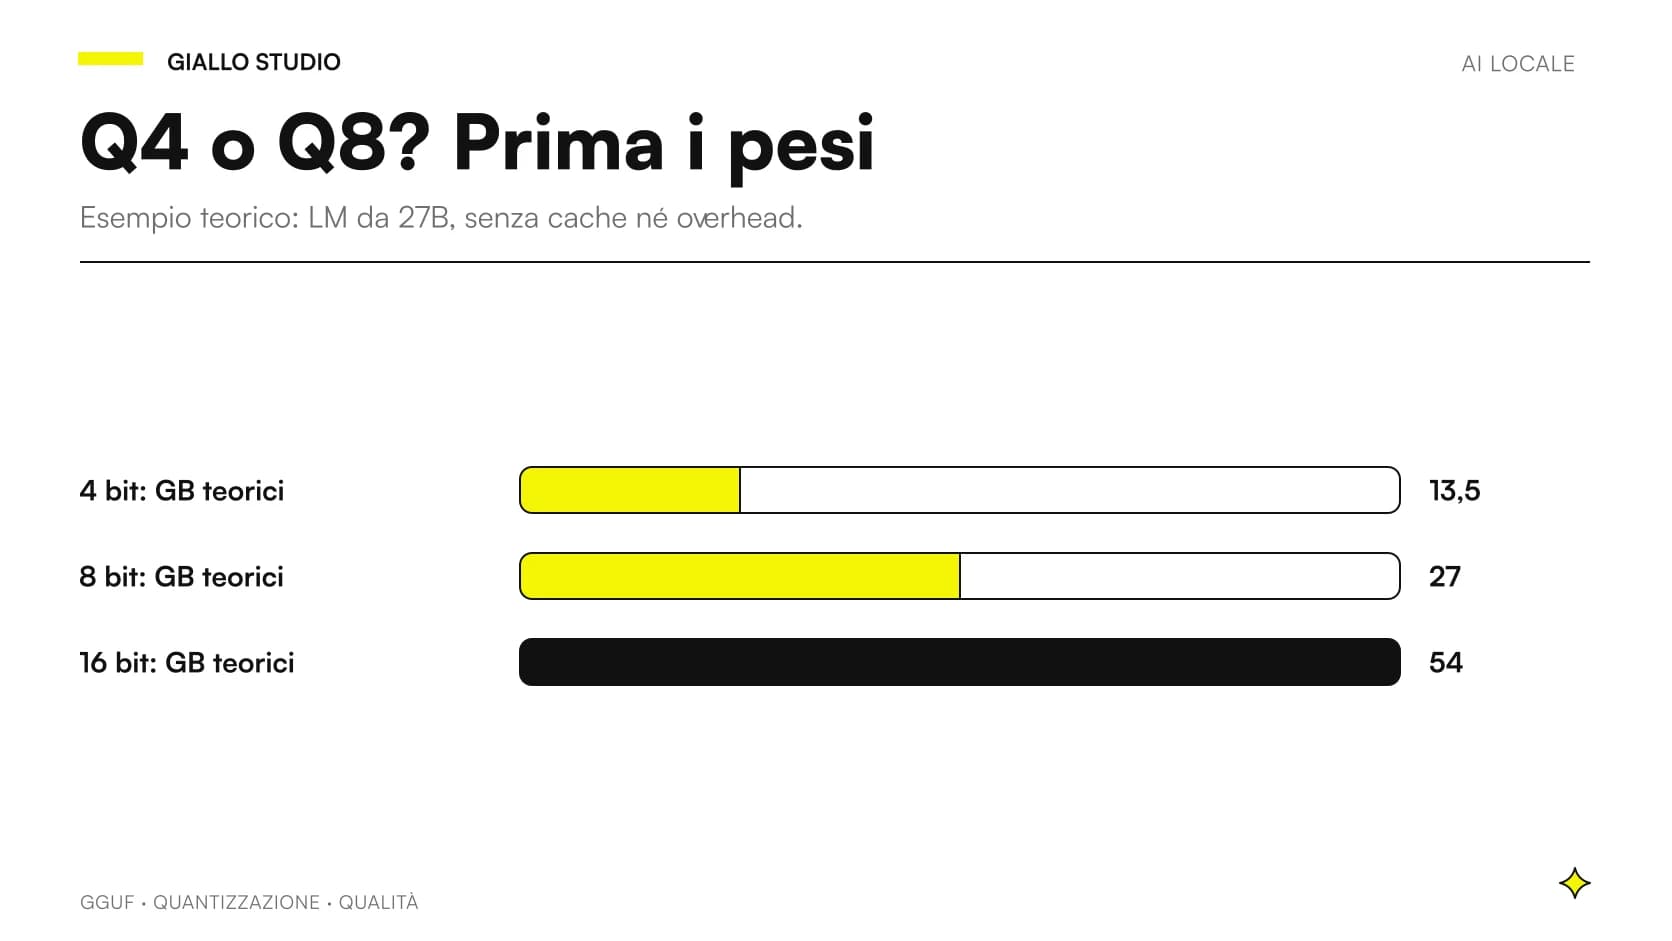
Non è una scelta da promettere usando il solo nome del modello. Come calcolo teorico sui soli pesi linguistici, 27 miliardi di parametri a quattro bit esatti corrispondono a circa 13,5 GB decimali. Mancano però componenti, metadati, cache e spazio operativo. Il valore non dimostra che il Mac abbia memoria sufficiente per lavorare.
Lo stesso ragionamento vale con 24 o 32 GB: un budget maggiore richiede comunque il file e la configurazione precisi. La guida a RAM e VRAM di Qwen3.8-27B separa questi livelli. In assenza di una misura, è più utile scegliere un primo candidato contenuto e confrontare il 27B in un ambiente adeguato, invece di sacrificare l'uso del computer per raggiungere una dimensione arbitraria.
Quanto cambia il compromesso fra Q4 e Q8?
La precisione dei pesi influenza occupazione e comportamento, ma il risultato non si riduce a “meno bit è sempre meglio”. Una quantizzazione deve essere compatibile con il motore e verificata sul compito. Piccole differenze di qualità possono contare molto quando il modello deve conservare codici o distinguere informazioni simili.
La documentazione Hugging Face sulla quantizzazione spiega le alternative; la guida GGUF Q4 e Q8 affronta il confronto operativo. Sul Mac si prova prima la qualità sufficiente, poi il margine di memoria e l'usabilità. Una variante molto compressa che richiede numerose correzioni può essere meno conveniente di un modello più piccolo distribuito a una precisione diversa. Il verbale deve mantenere separati questi due cambiamenti.
Come usare Monitoraggio Attività durante il test?
Apple documenta nella sezione memoria di Monitoraggio Attività pressione memoria, memoria utilizzata, compressione e swap. Non conviene osservare soltanto una cifra del processo principale: il comportamento del computer nel suo insieme è parte della prova.
Si registra una situazione iniziale, poi si carica il modello e si eseguono richieste rappresentative, mantenendo visibili gli indicatori. L'obiettivo è capire se il sistema conserva un margine coerente con il lavoro. Un singolo picco o un valore dello swap senza contesto non basta a decretare il fallimento; si osservano andamento, errori, attese e interazione con le altre app. Si conserva inoltre la configurazione per poter ripetere il confronto dopo un aggiornamento.
Perché il contesto può essere più importante della domanda iniziale?
La richiesta include spesso molto più del testo appena digitato: istruzioni, conversazione precedente, documenti e risultati di strumenti. Se il contesto cresce senza controllo, una prova breve può non rappresentare la sessione che l'utente avrà dopo numerosi scambi. L'occupazione deve essere osservata anche nel percorso prolungato previsto.
Non occorre usare il contesto massimo dichiarato soltanto perché il modello lo supporta. Si definisce il limite necessario al processo e si verifica la qualità entro quel confine. Se l'archivio è grande, recuperare i passaggi pertinenti può essere un percorso da valutare rispetto all'inserimento indiscriminato dei file. Il RAG locale aziendale tratta questa progettazione, che dipende da ricerca, permessi e citazioni, oltre che dalla capacità del modello.
Come cambiano le prove quando entrano immagini e PDF?
Un'app può elaborare un PDF estraendo testo oppure trasformando pagine in immagini. I due percorsi possono avere carichi differenti e non devono essere confusi. Anche componenti esterni al modello, come conversione e OCR, possono usare memoria durante la stessa operazione.
Per il Mac si prepara quindi un campione visivo distinto, con file fittizi di qualità rappresentativa. Si osservano caricamento, elaborazione e risposta, poi si verifica che il contenuto sia stato letto correttamente. La guida all'AI multimodale locale spiega perché una risposta riuscita sul testo non certifica la lettura di una scansione. Se il flusso richiede immagini soltanto occasionalmente, può essere utile progettare un passaggio separato invece di dimensionare ogni operazione come il caso più impegnativo.
Uno scenario: un consulente usa il Mac durante gli appuntamenti
Immaginiamo un consulente che voglia riordinare appunti fittizi in una struttura da rivedere. È un esempio ipotetico. Il Mac resta anche lo strumento per agenda, documenti e videochiamate. La prova deve riflettere quella convivenza e non soltanto produrre una risposta quando il computer è libero.
Il campione include un appunto chiaro, uno incompleto e due informazioni in contraddizione. Il modello dovrebbe conservare i dubbi, non riempire le parti mancanti con una formulazione sicura. Si misura il lavoro che rimane al consulente e si controlla la fluidità delle altre attività. Se una configurazione più contenuta offre già il risultato richiesto, non c'è motivo operativo per sostituirla con un modello che rende il computer meno gestibile soltanto perché ha più parametri.
Uno scenario: un piccolo team vuole condividere un Mac
Secondo caso illustrativo: un team pensa di usare un Mac come servizio comune per preparare bozze da record fittizi. La memoria richiesta non si deduce dalla chat di una sola persona. Si devono definire richieste simultanee, code, accessi e comportamento quando il computer è occupato o viene riavviato.
Una soluzione condivisa dovrebbe avere un responsabile operativo. Se la macchina viene usata anche per attività personali, il progetto deve valutare quanto questa sovrapposizione sia compatibile con la continuità richiesta. Il confronto può includere una configurazione dedicata o un servizio remoto, senza presumere che il locale sia sempre più economico. L'analisi di costi fra AI locale e cloud distingue investimento e gestione: comprare più memoria non risolve da solo le responsabilità del servizio.
Quale prova fare prima di decidere un acquisto?
- Definire compito, campione e qualità minima accettabile.
- Registrare chip, memoria, sistema, runtime e checkpoint.
- Provare con le applicazioni necessarie aperte e contesto definito.
- Controllare qualità, memoria, attese ed errori, poi ripetere dopo un riavvio.
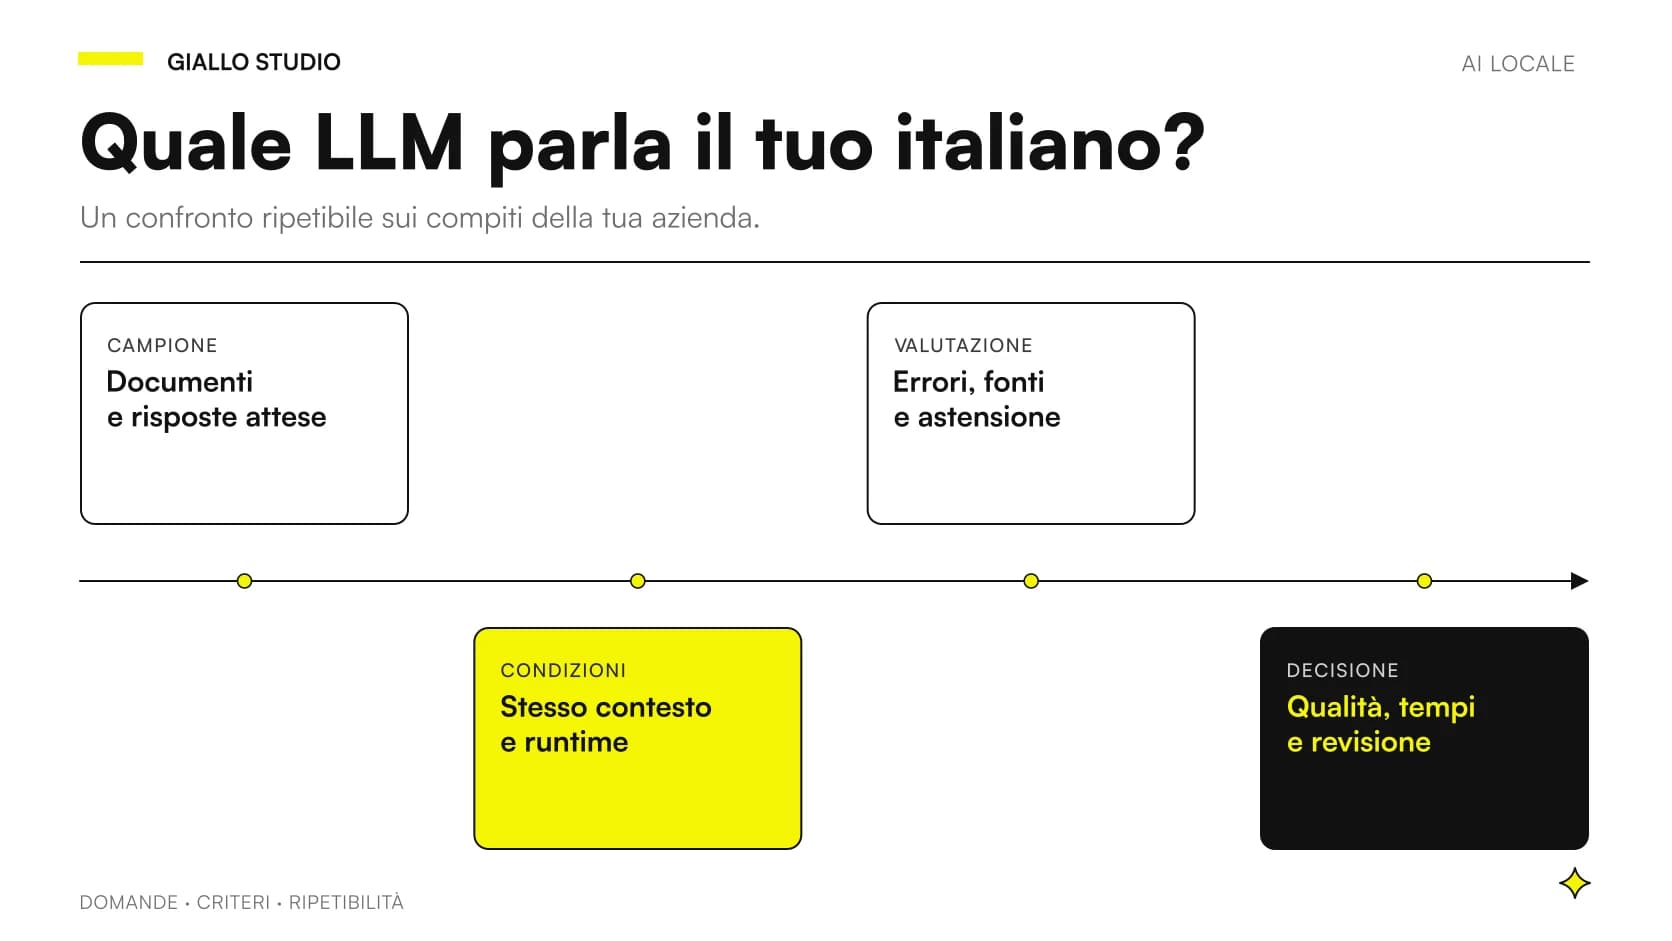
Il campione dovrebbe restare consultabile per aggiornamenti futuri. È utile conservare anche una configurazione di confronto più piccola: se il candidato impegnativo non migliora il risultato, il dato permette di scegliere senza inseguire l'hardware. Il protocollo dei benchmark locali in italiano aiuta a documentare questi passaggi. Non serve affermare una soglia universale per prendere una decisione fondata sul proprio lavoro.
Quali errori rendono poco utile una prova sul Mac?
Il primo è considerare soltanto se il modello si avvia. Il secondo è usare un campione troppo semplice rispetto ai documenti reali. Il terzo è cambiare modello, precisione e contesto insieme, senza capire quale variabile abbia migliorato o peggiorato il comportamento. Un altro errore frequente è valutare la macchina a programmi chiusi e poi pretendere la stessa esperienza durante la giornata.
Si evita inoltre di attribuire ogni rallentamento alla memoria: la diagnosi deve osservare log, input e condizioni effettive. Un collo di bottiglia del flusso documentale richiede un intervento diverso da un checkpoint troppo grande. Il risultato del test deve poter indicare anche “questa configurazione non è adatta”, senza trasformare la prova in una ricerca di impostazioni sempre più complesse per giustificare una scelta iniziale.
Dalla quantità di memoria alla configurazione che userai
La scelta utile fra 16, 24 e 32 GB è quella che sostiene il compito e lascia il Mac utilizzabile nel contesto previsto. Il modello più grande resta un'opzione da dimostrare, non un obiettivo obbligatorio. Si conservano i limiti della configurazione approvata e si ripete il campione quando cambiano documenti, utenti o runtime.
Per esplorare i processi possibili puoi partire dalle demo di The Lab, poi definire una prova sui tuoi dati fittizi. Se stai valutando l'hardware per un progetto di lavoro, la consulenza AI di Giallo Studio può collegare modello, memoria e verifiche al processo concreto prima dell'acquisto, così il budget segue un'esigenza dimostrata e una configurazione mantenibile.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 AI locale vs cloud: come confrontare i costi in azienda
 Gemma 4 12B vs Ministral 3 14B: AI locale compatta
 Qwen3.8-27B: quanta RAM e VRAM servono davvero?
 Ollama vs LM Studio: come scegliere per l'AI locale
 Quantizzazione GGUF: Q4 o Q8 per gli LLM locali?
 LLM locali in italiano: come confrontarli senza falsi test
 Modelli AI locali: quando convengono
FAQ
16 GB bastano per usare un LLM locale su Mac?
Possono bastare per alcune configurazioni, ma non definiscono un requisito universale. Occorre scegliere un modello compatibile e verificare memoria disponibile, contesto, qualità e applicazioni aperte.
Con 32 GB qualsiasi modello 27B funziona bene?
No. Precisione dei pesi, componenti visivi, cache e runtime possono cambiare molto il consumo. La capacità nominale non garantisce velocità o contesto sostenibile.
La memoria unificata è tutta riservata al modello?
No. È condivisa con macOS e le altre applicazioni. Il progetto deve osservare il carico complessivo del computer e lasciare spazio alle attività ordinarie.
LM Studio supporta anche i vecchi Mac Intel?
La pagina ufficiale dei requisiti consultata il 27 ottobre 2026 indica Apple Silicon e macOS 14 o successivo, mentre esclude attualmente i Mac Intel. Il supporto va comunque ricontrollato prima dell'installazione.
Come controllare se il modello mette in difficoltà il Mac?
Usa Monitoraggio Attività per osservare pressione memoria, memoria utilizzata e swap durante un campione rappresentativo. Confronta anche i tempi e l'usabilità delle altre applicazioni.