
Gemini 4 Argon coding: come valutarlo nello sviluppo software
Gemini 4 Argon coding: benchmark, strumenti e criteri per patch affidabili. Come progettare una prova su repository senza promettere codice sicuro.
Gemini 4 Argon può essere valutato come componente di un assistente di sviluppo, ma i suoi benchmark non garantiscono la qualità di una patch sul tuo software. Il risultato dipende anche da strumenti, accesso al repository, istruzioni e verifiche. Per decidere se introdurlo, prepara task riproducibili e chiedi modifiche piccole, controllabili e accompagnate da evidenze.
Al 23 ottobre 2026, la model card Google mostra risultati forti su alcune prove di coding e risultati inferiori ai concorrenti su altre. Non abbiamo eseguito una prova Argon su un repository cliente: gli esempi qui sotto sono ipotetici e il piano di test è una proposta, non un resoconto di prestazioni osservate.
La guida a Gemini 4 Argon presenta il modello in generale. Qui ci concentriamo su un requisito più utile per chi sviluppa: trasformare una richiesta in una patch revisionabile, senza confondere una risposta plausibile con una correzione verificata.
In sintesi
- Argon guida DeepSWE 1.1 nella raccolta Google, ma perde su FrontierSWE v2.
- Il modello e l'agente che esplora file, esegue comandi e applica patch sono componenti differenti.
- Una prova utile parte da bug riproducibili, requisiti espliciti e test pertinenti.
- Permessi, segreti e conseguenze esterne devono essere controllati dal sistema che esegue gli strumenti.
- Misura anche regressioni, ampiezza del diff e lavoro di revisione, oltre ai task risolti.
Che cosa dicono davvero i benchmark di coding?
La raccolta Google di ottobre confronta Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. Su DeepSWE 1.1 Argon risulta davanti; su FrontierSWE v2 risulta dietro agli altri tre. I valori provengono dalla model card e vanno letti insieme alla metodologia, non come un test indipendente Giallo.
| Modello | DeepSWE 1.1, successo pass@1 | FrontierSWE v2, successo task |
|---|---|---|
| Gemini 4 Argon | 77,9% | 55,0% |
| GPT-6 Astra | 74,1% | 65,5% |
| Claude Fable 5.1 | 67,4% | 56,3% |
| Claude Opus 5.5 | 74,2% | 62,3% |
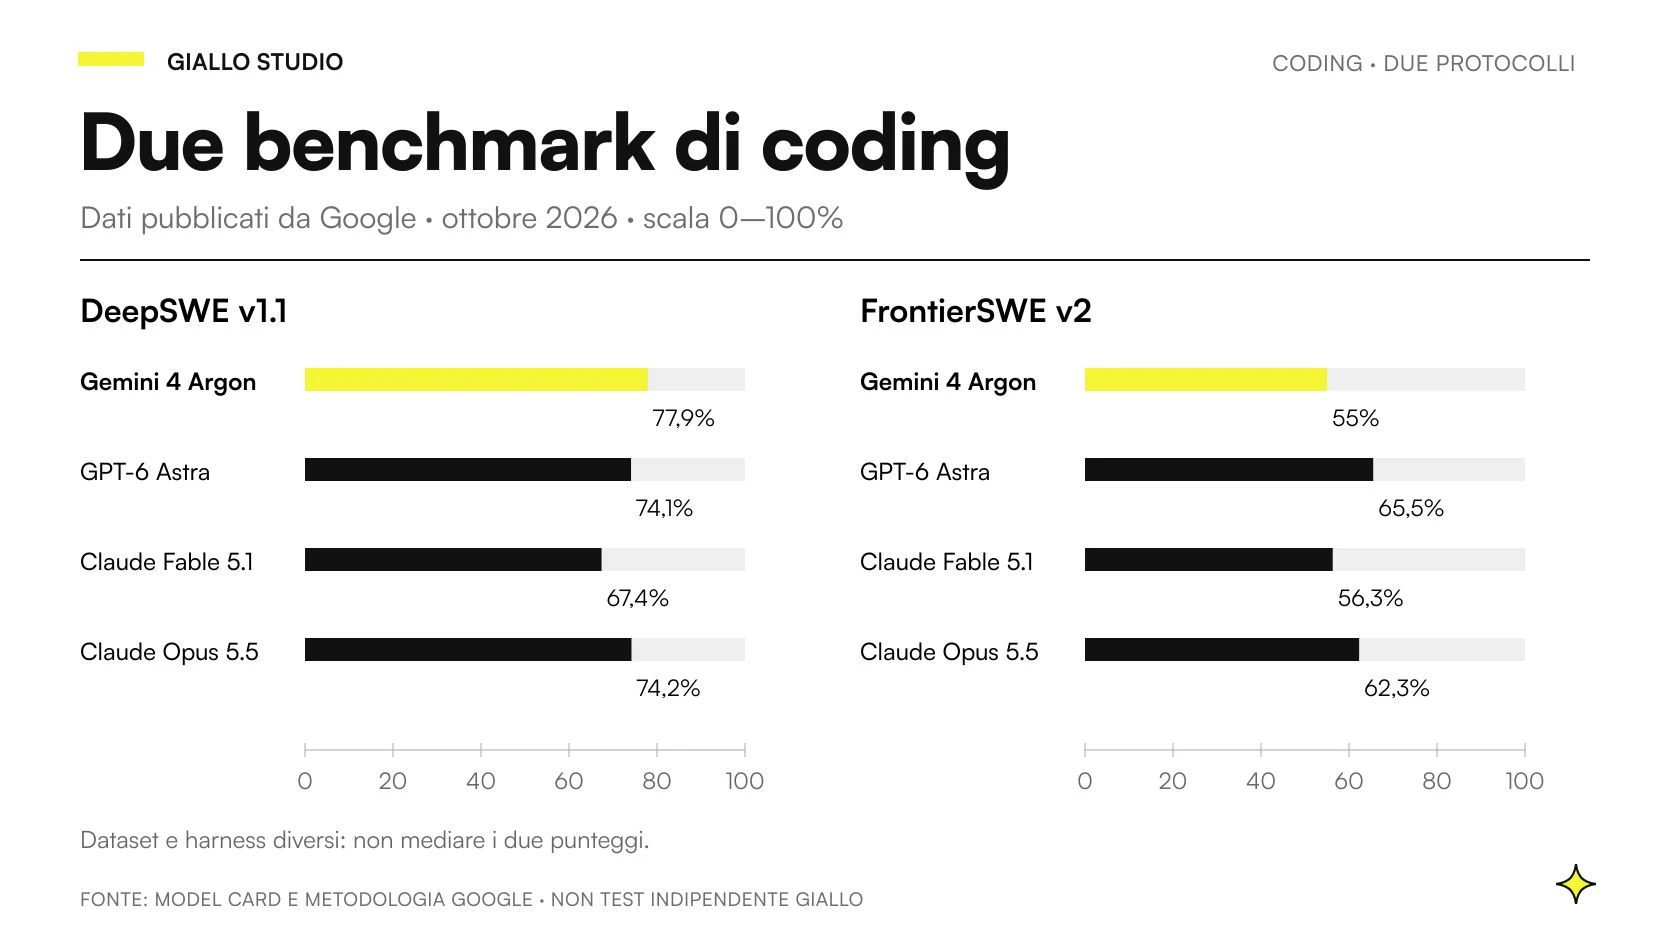
Google calcola DeepSWE Argon con mini-swe, mentre i dati Astra e Claude arrivano dalle rispettive fonti pubbliche indicate. Le impostazioni di ragionamento riportate sono quelle elevate del confronto. Per FrontierSWE la metodologia rimanda alla leaderboard Proximal. Provenienze e ambienti diversi limitano ciò che possiamo attribuire al solo modello.
La conclusione pratica è scegliere candidati, non proclamare un vincitore. Se il repository del tuo team contiene vincoli differenti dai task del benchmark, il risultato può cambiare. Nella lettura critica dei benchmark Argon separiamo anche i punteggi sintetici dalle misure di produttività aziendale.
Qual è la differenza tra modello, agente ed editor?
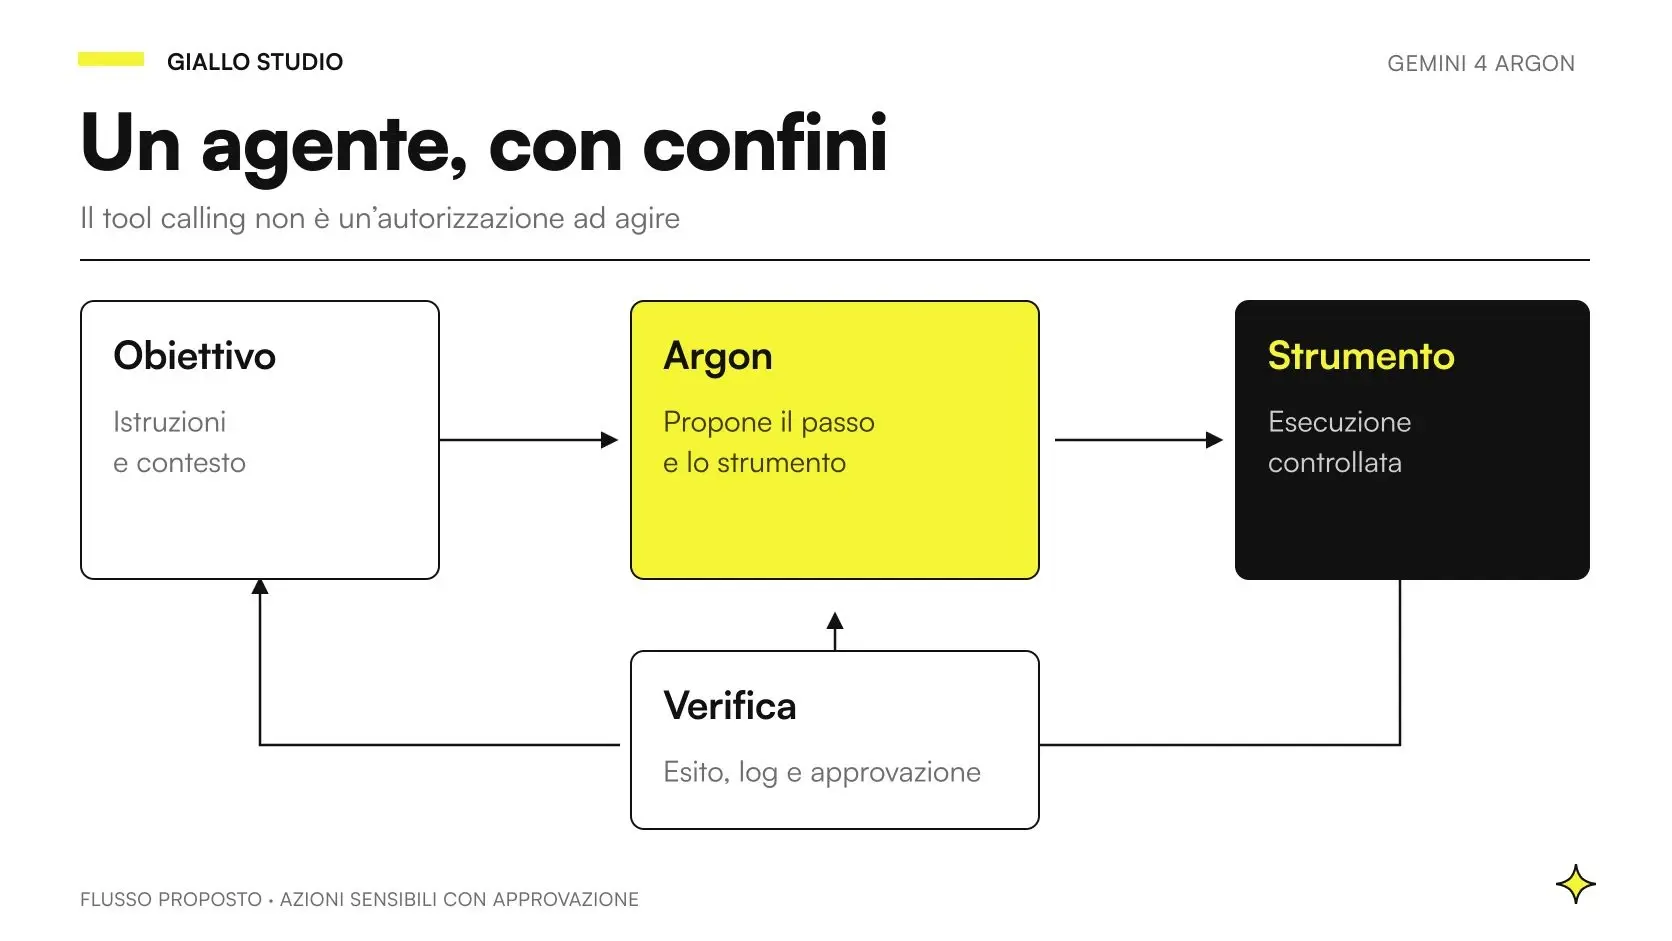
Il modello produce testo o richieste strutturate. Un agente organizza il ciclo di lavoro: legge il problema, decide quali file esaminare, richiede strumenti e usa i risultati per continuare. L'editor offre l'interfaccia con cui il team osserva o approva il lavoro. Il medesimo modello può quindi comportarsi in modo diverso dentro sistemi differenti.
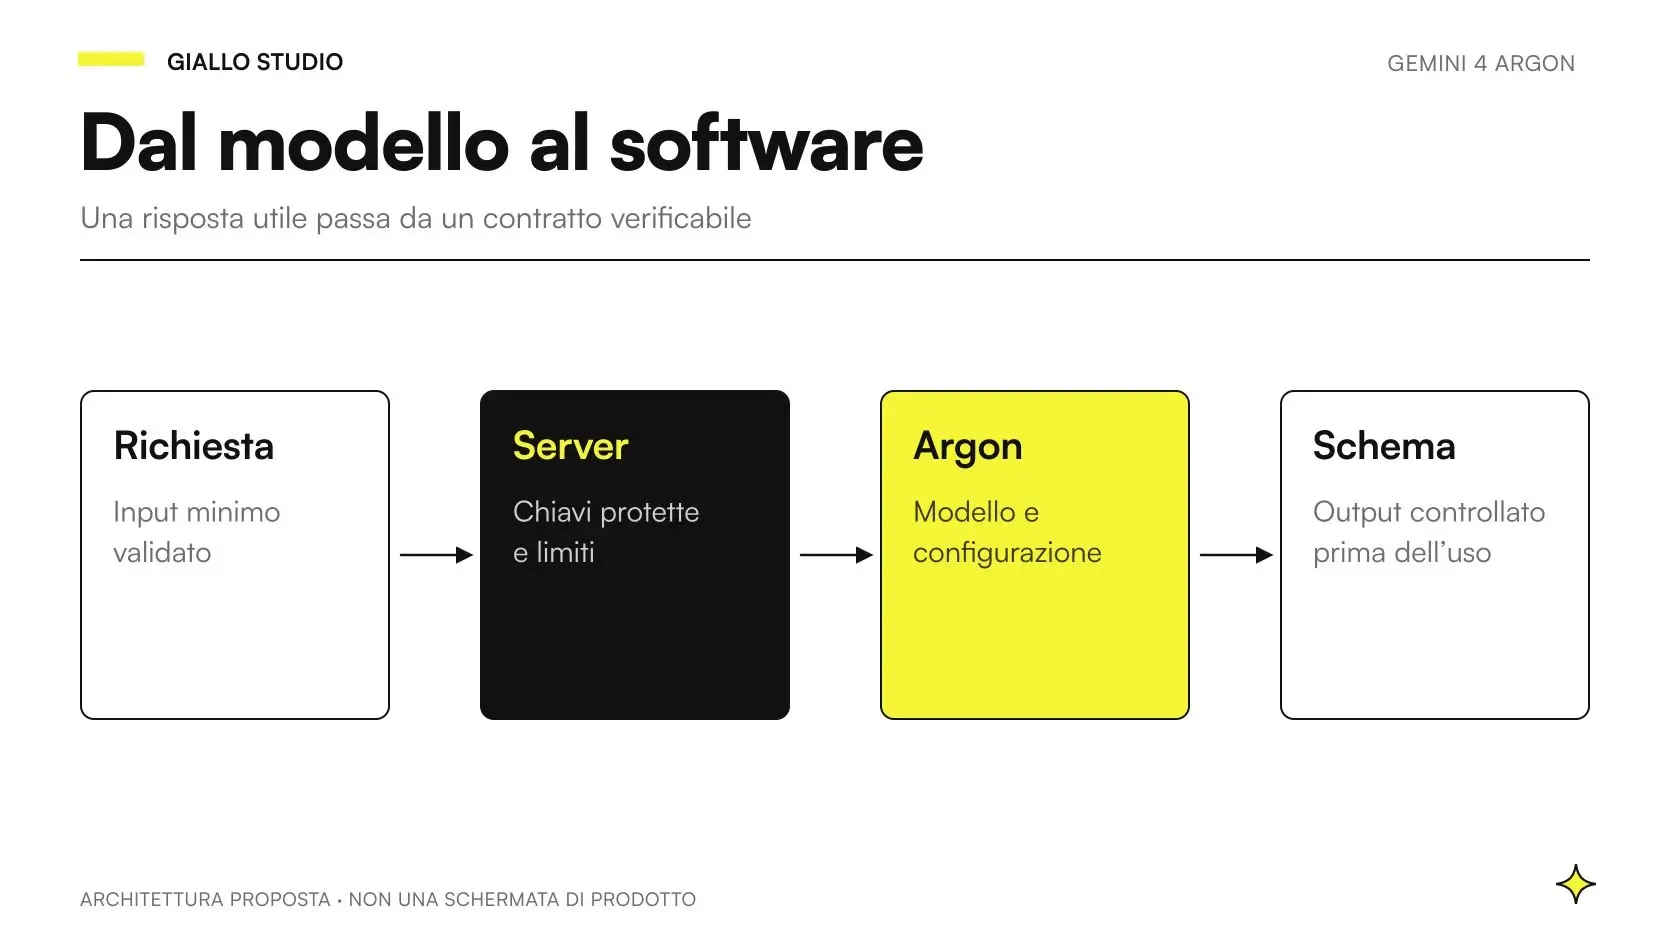
La scheda API Argon elenca supporto a function calling, code execution e output strutturati. Non significa che una chiamata generica possa accedere autonomamente al repository, utilizzare le credenziali del team o pubblicare una versione. Questi collegamenti richiedono un'integrazione e autorizzazioni precise.
Con il function calling ufficiale, è l'applicazione a validare ed eseguire la funzione proposta. Il sistema può così offrire lettura dei file e test in un ambiente dedicato senza concedere accesso alla produzione. Prima del confronto documenta quegli strumenti: altrimenti rischi di attribuire al modello una differenza dovuta all'ambiente.
Quali task sono adatti al primo esperimento?
Scegli attività chiuse, con un risultato verificabile e un perimetro limitato. Una regressione riproducibile è un buon candidato; «migliora l'architettura» lascia troppo spazio a interpretazioni non confrontabili. Il task deve specificare comportamento osservato, comportamento atteso e vincoli che non devono essere violati.
Prepara anche casi in cui la risposta corretta è chiedere un chiarimento. Se manca una regola commerciale, il sistema non dovrebbe inventarla per completare l'implementazione. Questa capacità conta soprattutto nei gestionali, dove una funzione può funzionare tecnicamente e applicare la politica sbagliata.
| Task proposto | Evidenza da ottenere | Motivo di rifiuto della patch |
|---|---|---|
| Correggere un filtro che esclude risultati ammessi | Riproduzione del difetto e test sul comportamento corretto | Modifica delle regole di accesso per far comparire i dati |
| Gestire un errore di importazione | Messaggio utile e mantenimento dei dati precedenti | Dati scartati senza segnalazione |
| Adattare una chiamata API | Richiesta valida e gestione degli errori documentata | Assunzioni su parametri o versioni non verificati |
| Migliorare una query lenta | Risultati equivalenti e misura nell'ambiente di prova | Cambiamento del contenuto restituito |
| Preparare una revisione di sicurezza | Riferimento al codice e caso che dimostra il problema | Allarme generico privo di percorso verificabile |
Questa tabella è un piano proposto. Non dichiara che Argon abbia risolto quei task. Il confronto con ChatGPT e Claude aiuta a scegliere quali candidati includere senza confondere prodotti e versioni.
Come preparare il repository senza dare accessi superflui?
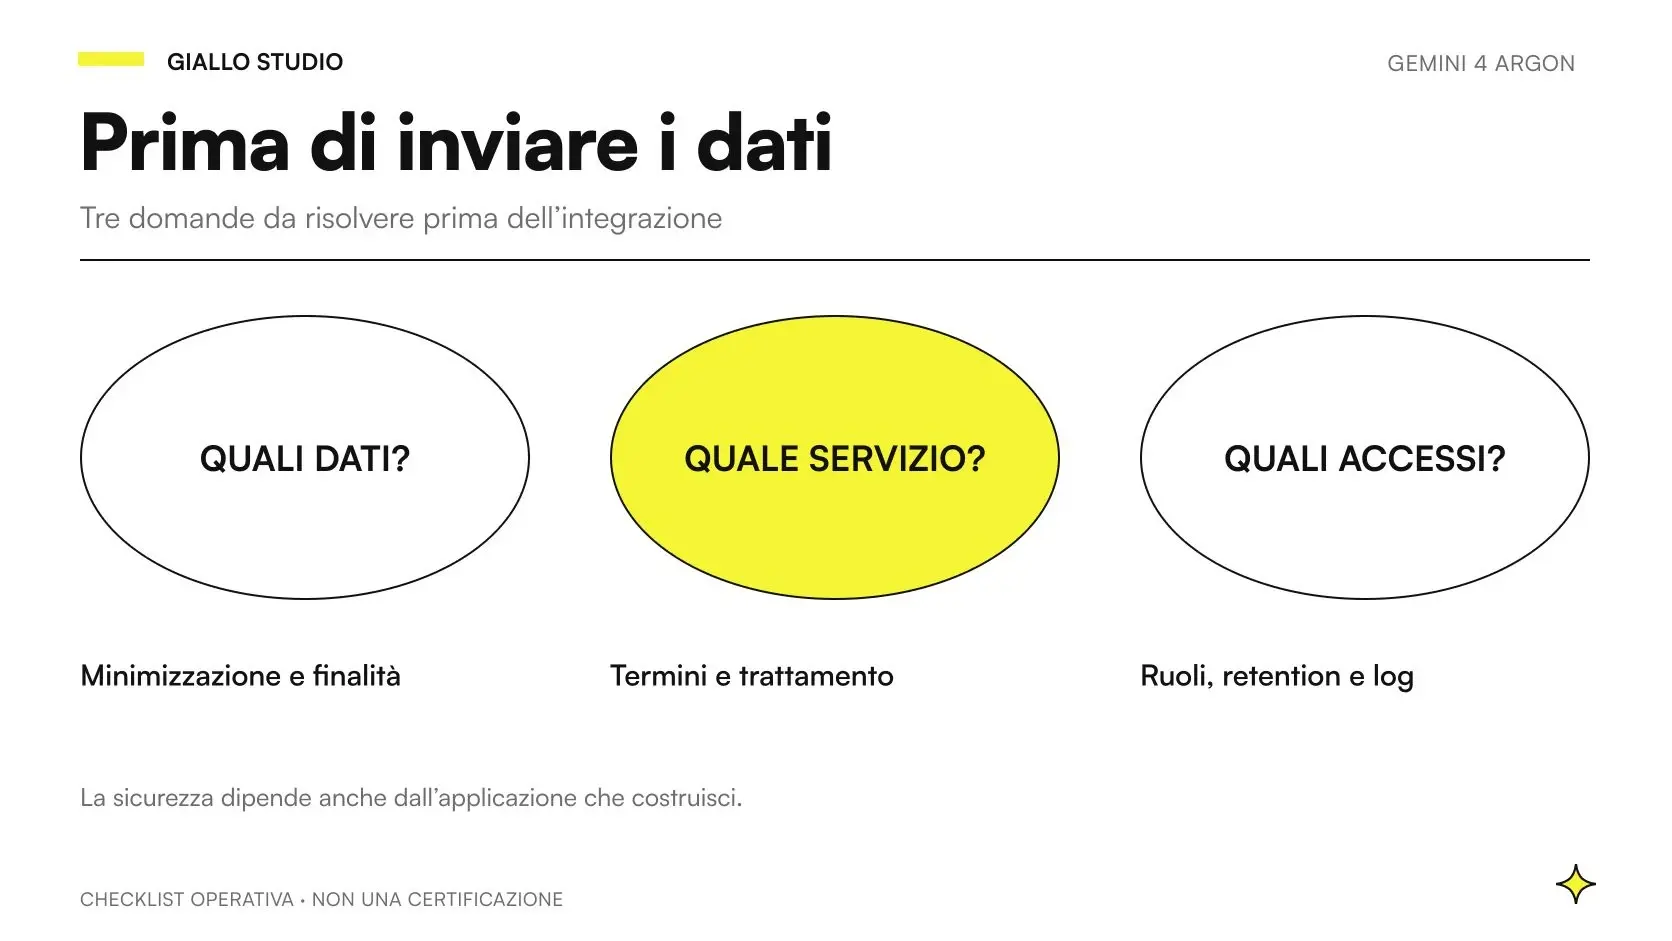
Usa un ambiente di prova con il codice necessario al task, dati sintetici e istruzioni sui comandi disponibili. Identifica i file che contengono segreti o informazioni riservate e impediscine l'accesso quando non servono. Una frase che chiede di ignorarli non sostituisce un confine tecnico.
Se il task richiede accesso a un servizio esterno, valuta una simulazione o un account di test con permessi circoscritti. Il campione iniziale dovrebbe poter produrre una patch senza inviare email, modificare record reali o attivare pagamenti. Le credenziali di produzione non sono un requisito ordinario per riprodurre un errore di logica locale.
Rendi esplicite anche le regole del repository: stack, comandi di verifica, convenzioni e parti del sistema che il task può coinvolgere. Una richiesta vaga costringe il modello a colmare vuoti con ipotesi. La guida privacy e sicurezza Argon descrive come distinguere contenuti, account e copie lungo questo percorso.
Che cosa cambia nell'integrazione API con Argon?
La guida di migrazione ufficiale, letta il 23 ottobre, indica thinking medium come default e precisa che temperature, top_p e top_k vengono ignorati. Se un'integrazione precedente dipende da quei parametri, non basta cambiare il nome del modello e supporre che il comportamento resti equivalente.
La stessa guida raccomanda timeout client di almeno 15 minuti per prompt difficili e distingue richieste lunghe dal normale percorso sincrono. La scheda Argon fissa il limite unificato input più output a 1.048.576 token. È un budget condiviso, non spazio da riempire indiscriminatamente con tutto il repository.
| Aspetto API | Indicazione ufficiale al 23 ottobre 2026 | Implicazione per la prova |
|---|---|---|
| Modello | Identificativo stabile gemini-4-argon nella scheda API |
Registrare l'identificativo effettivamente chiamato |
| Thinking | Default medium nella guida di migrazione | Dichiarare l'impostazione del confronto |
| Campionamento | Temperature, top_p e top_k ignorati nella stessa guida | Rimuovere assunzioni ereditate dal vecchio modello |
| Timeout per prompt difficili | Almeno 15 minuti consigliati nella guida | Gestire attesa, interruzione e stato del lavoro |
| Contesto totale | 1.048.576 token input più output nella scheda | Riservare spazio al risultato e alle continuazioni |
| Cache | Implicita, con soglia input di 4.096 token nella documentazione cache | Verificare hit effettivi; evitare cache esplicita non supportata |
Il thinking rientra nell'output fatturato secondo il listino API. Registra perciò consumo effettivo e tentativi scartati. La guida a prezzi e costi Argon spiega la differenza fra costo del token e costo del risultato accettato.
Quali evidenze chiedere insieme alla patch?
La consegna dovrebbe permettere a un collega di capire il problema senza ricostruire l'intera conversazione. Chiedi una descrizione del difetto, una spiegazione della causa sostenuta dal codice, il diff e l'esito dei controlli eseguiti. Gli eventuali controlli mancanti devono essere visibili: una frase come «dovrebbe funzionare» non documenta un test.
Rivedi l'ampiezza della modifica. Se un bug richiede un cambiamento locale e la patch riorganizza moduli non coinvolti, aumenta il lavoro di verifica. Può esserci un motivo valido, ma deve essere spiegato e giudicato prima di accettare quel costo. La semplicità del diff è una qualità osservabile, non un limite alla capacità del modello.
Apri i controlli proposti per accettare una patch
- Il comportamento errato è riproducibile e il requisito atteso è esplicito.
- La modifica riguarda il perimetro necessario al task.
- I test pertinenti distinguono il difetto originale dal comportamento corretto.
- Typecheck, lint e build applicabili hanno esito documentato.
- Permessi, dati sensibili e dipendenze sono stati riesaminati quando coinvolti.
- Il diff è stato letto e i controlli non eseguiti sono dichiarati.
- La proposta resta separata dall'autorizzazione a pubblicare in produzione.
Un test utile controlla il requisito, non soltanto la forma della nuova implementazione. Se il modello modifica sia codice sia aspettative del test per far coincidere i risultati, il passaggio verde perde valore. Conserva i criteri di accettazione originari e chiedi evidenze che coprano anche casi limite pertinenti.
Come proverebbe Argon una software house di gestionali?
Scenario ipotetico: un team mantiene un gestionale per ordini e disponibilità. Il bug proposto riguarda un filtro che nasconde righe quando manca un campo facoltativo. Il campione è sintetico e non rappresenta un cliente Giallo. Il requisito stabilisce quali righe devono restare visibili e mantiene invariati i permessi dell'operatore.
La prova confronta la capacità di trovare la causa e correggerla con un diff contenuto. Inserisci un caso con campo presente, uno con campo assente e uno con utente non autorizzato. La patch è rifiutata se mostra tutti i record aggirando il controllo di accesso, anche quando il difetto visibile sembra sparito.
Il revisore annota tempo necessario, chiarimenti richiesti e verifiche da aggiungere. Se Argon risolve il bug ma cambia componenti estranei, il risultato richiede una valutazione diversa da una correzione locale. La metrica non è soltanto «test verdi»: conta quanto lavoro resta al team per fidarsi della proposta.
Come cambierebbe il test per un e-commerce su misura?
Scenario ipotetico: un piccolo team corregge l'importazione di un catalogo prodotti. Alcune righe hanno dati incompleti e la procedura attuale interrompe tutto senza una spiegazione utile. La prova proposta usa un catalogo inventato, nessuna credenziale del negozio e un database di test.
Prima di chiamare il modello, il responsabile decide se le righe valide debbano essere importate oppure se l'operazione debba restare interamente sospesa. È una scelta del processo commerciale, non un dettaglio che l'assistente può inventare. Se manca questa decisione, chiedere un chiarimento è il risultato corretto.
Una volta definita la regola, il test controlla dati mantenuti, messaggi e possibilità di ripetere l'importazione senza duplicazioni. Una patch che risolve il messaggio ma crea prodotti doppi non soddisfa il requisito. Questo scenario mostra perché task piccoli ma completi insegnano più di una richiesta generica come «rendi robusto l'importatore».
Come valutare sicurezza e vulnerabilità senza false garanzie?
Un modello può aiutare a individuare percorsi da controllare, ma la segnalazione deve mostrare codice coinvolto, condizioni e conseguenza. Chiedi un esempio che distingua il caso vulnerabile dal comportamento atteso. Per patch che toccano autenticazione, pagamenti o dati personali, serve una revisione specifica del rischio introdotto.
Nella raccolta Google, CWE-bench v1 riporta pass@1 68% per Argon e Astra, 58% per Fable e 67% per Opus. La metodologia attribuisce i risultati alla leaderboard del benchmark e indica pass@4 per gli spareggi del ranking completo. Queste misure non certificano la sicurezza di un'applicazione reale.
| CWE-bench v1 nella raccolta Google | Correzione vulnerabilità pass@1 |
|---|---|
| Gemini 4 Argon | 68% |
| GPT-6 Astra | 68% |
| Claude Fable 5.1 | 58% |
| Claude Opus 5.5 | 67% |
Non usare un'analisi del modello come unico controllo delle dipendenze o delle autorizzazioni. Un suggerimento di libreria deve essere verificato nella documentazione e nel contesto del progetto; una nuova dipendenza porta manutenzione e superficie aggiuntiva anche quando il codice di esempio sembra comodo.
Quali errori evitare nell'adozione di un agente di coding?
Il primo è chiedere modifiche ampie prima di avere una riproduzione del difetto. Il secondo è dare accesso alla produzione per comodità. Il terzo è accettare test verdi dopo che il requisito è stato modificato implicitamente. Il quarto è valutare soltanto la prima risposta riuscita, nascondendo timeout e tentativi falliti.
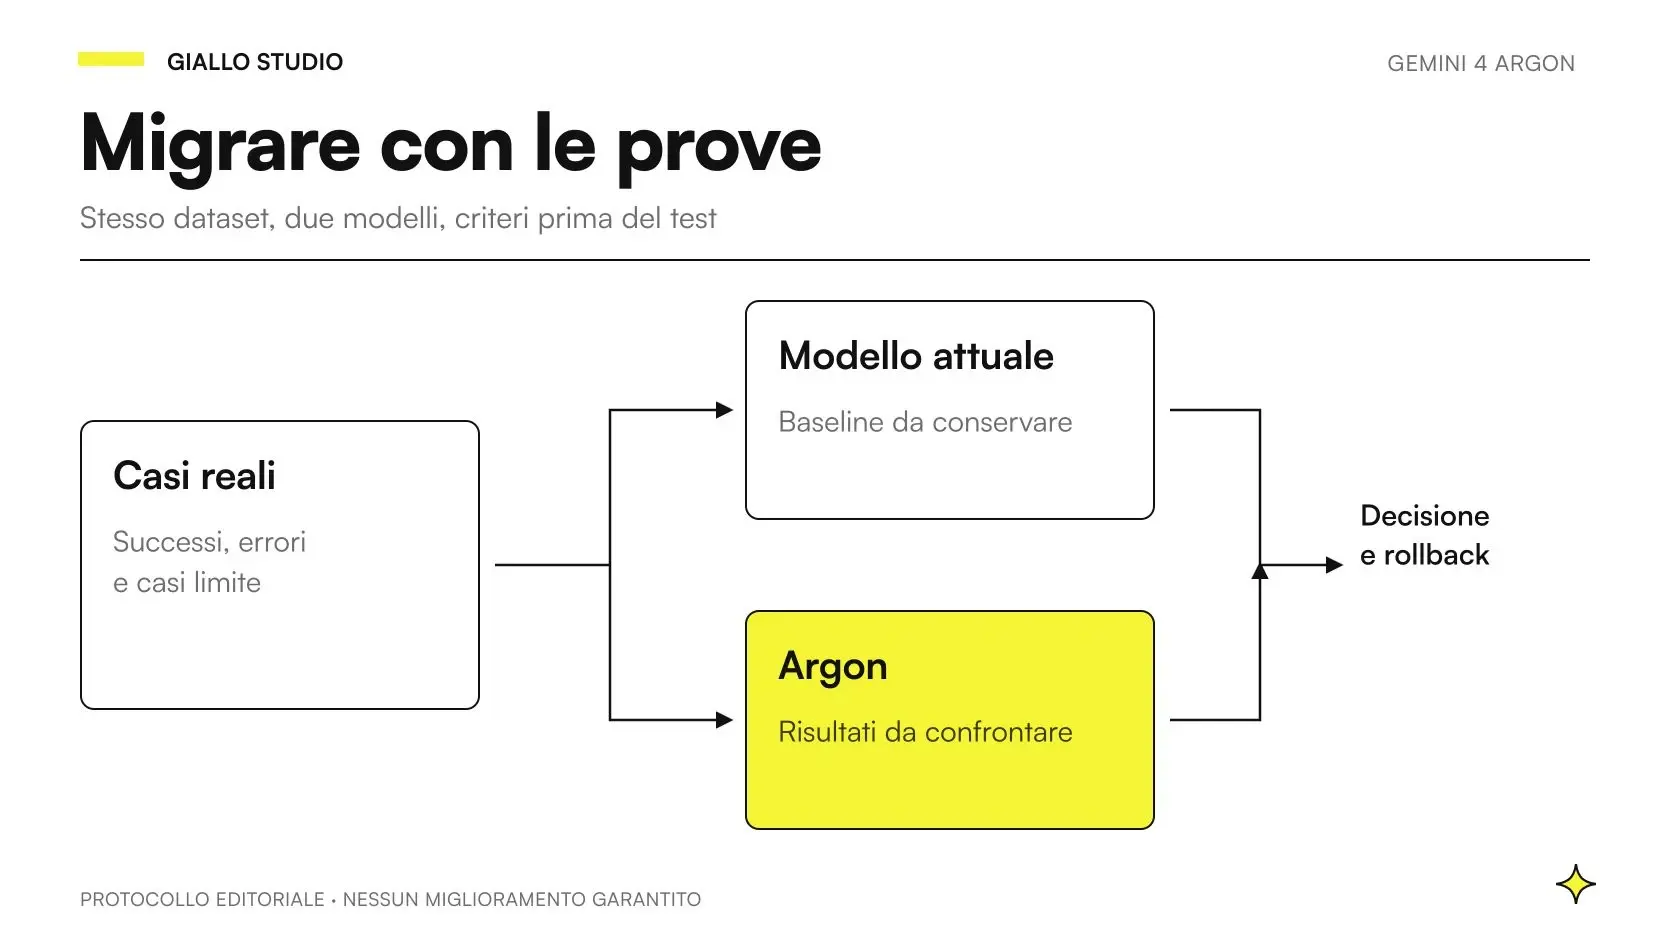
Un altro errore è cambiare contemporaneamente modello, strumenti e struttura del task: diventa difficile capire cosa abbia migliorato il risultato. Mantieni un confronto documentato e modifica un elemento alla volta quando vuoi apprendere dall'esperimento. L'adozione e migrazione Argon dovrebbe lasciare una strada per tornare alla configurazione precedente.
Se il sistema è più lento o richiede più correzioni di quanto il team possa sostenere, quel risultato va mantenuto visibile. Una risposta articolata non compensa una patch che non si riesce a verificare. I benchmark aiutano a trovare candidati promettenti; la manutenzione del tuo software richiede prove sul tuo ambiente.
Quale risultato cercare prima di estendere l'uso?
Il primo obiettivo è una serie di patch con requisiti chiari, evidenze ripetibili e revisione sostenibile. Da lì puoi decidere quali task affidare all'assistenza e quali mantenere interamente al team. Il modello può diventare utile senza ricevere la responsabilità di un rilascio o accessi estesi.
Se vuoi trasformare un bug ricorrente o una procedura fragile in una prova concreta, lo sviluppo software su misura di Giallo può partire dal repository e dai criteri di accettazione, verificando dove Argon riduce davvero il lavoro e dove servono strumenti o controlli diversi.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Gemini 4 Argon benchmark: come leggere il confronto LLM
 Gemini 4 Argon vs ChatGPT e Claude: quale scegliere
 Gemini 4 Argon API: integrare il modello nei processi aziendali
 Migrare a Gemini 4 Argon: valutazione, test e rollback
 Gemini 4 Argon privacy e sicurezza: guida per aziende
 Gemini 4 Argon per agenti AI e automazioni: strumenti e approvazioni
FAQ
Gemini 4 Argon è il migliore modello per programmare?
I dati pubblicati non dimostrano un vincitore universale. Nella raccolta Google di ottobre 2026 Argon guida DeepSWE 1.1 ma resta sotto GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5 su FrontierSWE v2. Serve una prova sui task e sull'ambiente del team.
Un punteggio DeepSWE descrive una normale chat di coding?
No. Il risultato riguarda un sistema con protocollo, strumenti e impostazioni specifici. Per Argon Google indica l'harness mini-swe e ragionamento elevato. Una chat senza accesso ai file o esecuzione dei test non riproduce quel sistema.
Argon esegue da solo le funzioni del mio gestionale?
Nel function calling propone il nome della funzione e gli argomenti. È l'applicazione a validarli, autorizzare l'azione ed eseguire il codice. L'accesso al repository o al gestionale va progettato separatamente.
Quali parametri cambiano passando ad Argon?
La guida ufficiale indica thinking medium come impostazione predefinita e segnala che temperature, top_p e top_k vengono ignorati. Argon supporta cache implicita, non cache esplicita. Controlla la documentazione della versione prima di adattare un'integrazione esistente.
Una patch che passa i test è pronta per la produzione?
I test disponibili verificano soltanto i comportamenti che coprono. Occorre anche rileggere il diff, controllare requisiti, autorizzazioni, dipendenze e impatto operativo. Un passaggio verde non certifica l'assenza di vulnerabilità o regressioni.
Giallo ha provato Argon su un repository cliente?
Questo articolo non riporta un test autenticato o una prova su un cliente. Analizza documentazione e benchmark pubblicati, consultati il 23 ottobre 2026, e propone un piano di valutazione con task ripuliti e criteri di accettazione.