
Kimi K3.1 Pro per coding: configurazione e prove utili
Kimi K3.1 Pro per coding: ID esatti, differenze fra Code e API, reasoning e benchmark. Come provarlo su un repository senza confondere demo e verifica.
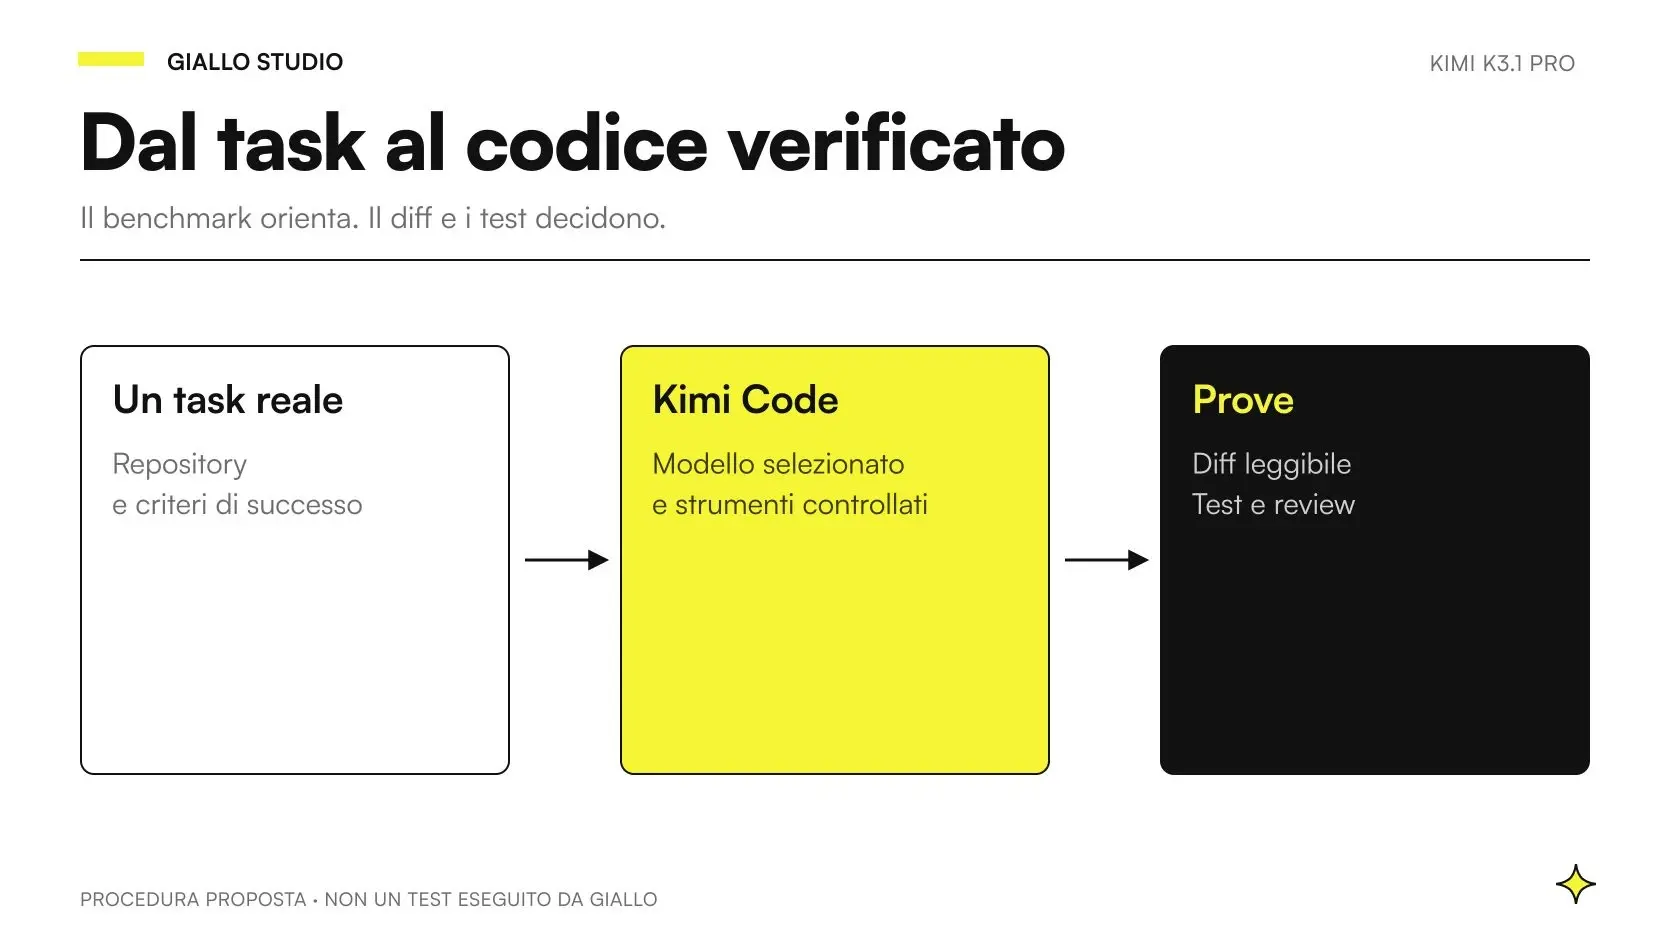
Kimi K3.1 Pro si può usare per coding attraverso Kimi Code oppure integrandolo in un agente via API. La disponibilità è verificata al 24 ottobre 2026. Il modello aiuta a interpretare e produrre codice; il client gli permette di leggere file, usare strumenti e lavorare sul repository. Questa distinzione conta quando si vuole capire cosa si sta confrontando. Fonte: annuncio ufficiale K3.1 Pro, consultato il 24 ottobre 2026.
Per una PMI il risultato utile è un comportamento del software corretto: un'importazione che conserva i dati, una schermata accessibile oppure un'integrazione che gestisce gli errori. La demo di un'app generata mostra una possibilità; il lavoro sul gestionale deve produrre una modifica circoscritta, leggibile e verificata. In questa guida non riportiamo prove eseguite da Giallo: distinguiamo documentazione, benchmark del fornitore ed esempi progettuali.
In sintesi
- K3.1 Pro identifica il modello; Code e API sono canali diversi con identificatori e condizioni proprie.
- La configurazione deve specificare modello, protocollo e livello di reasoning coerenti con il servizio scelto.
- Un contesto ampio aiuta a mantenere riferimenti, ma serve comunque selezionare file e istruzioni pertinenti.
- I benchmark pubblicati sono indizi per una prova: non certificano la correttezza del software aziendale.
- La consegna utile comprende il diff, i controlli realmente eseguiti e la prova del comportamento richiesto.
K3.1 Pro per coding: modello, agente o applicazione?
Un modello riceve un contesto e produce risposte, che possono includere richieste agli strumenti. Un agente organizza il ciclo: raccoglie un risultato, aggiorna il contesto e prosegue. Il client stabilisce l'interfaccia disponibile, mentre l'ambiente decide quali operazioni sono possibili. Sono componenti collegate, ma non intercambiabili.
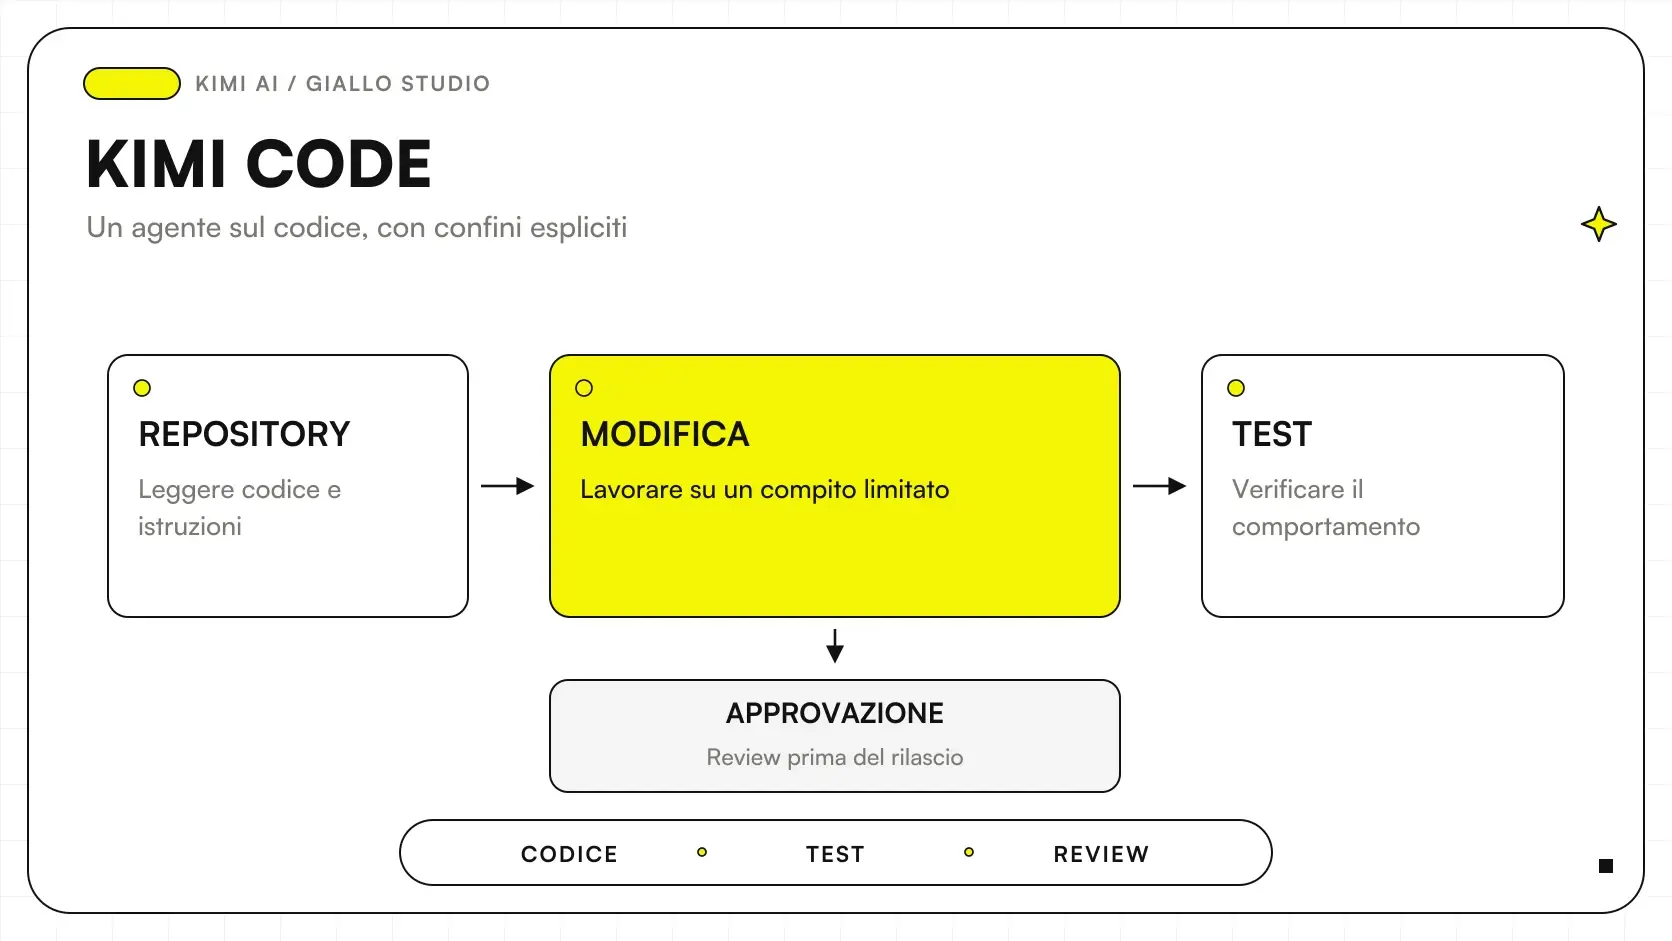
La guida generale a K3.1 Pro presenta il modello; la guida a Kimi Code descrive il prodotto per sviluppare. La documentazione della CLI lo presenta come agente da terminale capace di leggere e modificare codice, eseguire comandi e usare il feedback. È il motivo per cui un confronto fra due chat non riproduce necessariamente il lavoro di due agenti sullo stesso progetto. Fonte: Kimi Code CLI, introduzione, consultata il 24 ottobre 2026.
Prima di scegliere, definisci quale attività vuoi affidare al sistema. Capire un modulo esistente richiede soprattutto lettura e spiegazioni ancorate ai file. Correggere un bug richiede una riproduzione del problema e una verifica della patch. Costruire una funzione nuova richiede anche decisioni sui requisiti. Un prompt che mescola queste attività rende difficile capire se la sessione sta progredendo.
Quali ID usare nelle API e in Kimi Code?
Gli identificatori sono diversi. La piattaforma internazionale a consumo usa il prefisso kimi-; il servizio Code espone gli ID brevi. Non basta scrivere “K3.1 Pro” nel campo tecnico sperando che il client scelga quello giusto. Fonti consultate il 24 ottobre 2026: quickstart API e modelli di Kimi Code.
| Canale | K3.1 Pro | Variante Highspeed | Base URL internazionale OpenAI compatible |
|---|---|---|---|
| Kimi API Platform a consumo | kimi-k3.1-pro |
kimi-k3.1-pro-highspeed |
https://api.moonshot.ai/v1 |
| Kimi Code | k3.1-pro |
k3.1-pro-highspeed |
https://api.kimi.ai/coding/v1 |
La configurazione deve associare credenziale, endpoint, protocollo e modello dello stesso servizio. Una chiave creata nella console del prodotto Code e una chiave della piattaforma API non vanno considerate equivalenti per il solo fatto che entrambe riguardano Kimi. La documentazione del percorso Code con Responses parte esplicitamente dalla console Code. Fonte: integrazione ufficiale con strumenti Responses, consultata il 24 ottobre 2026. La guida alle Kimi API approfondisce il percorso a consumo.
Il dominio internazionale non dimostra dove vengano conservati i dati né che esista una regione europea selezionabile. Sono condizioni da verificare separatamente nel contratto e nel servizio scelto. Il primo esperimento dovrebbe usare codice e dati che l'azienda è autorizzata a inviare, con credenziali gestite fuori dai file condivisi del repository.
Come funzionano reasoning, fallback e contesto?
Nell'API generalista reasoning_effort accetta low, high e max, con max predefinito. Il modello mantiene il thinking attivo. Nei turni con strumenti la documentazione richiede di conservare il messaggio assistant completo, anziché ricostruirlo usando solo il testo visibile. Fonte: Reasoning Effort API, consultata il 24 ottobre 2026.
Il servizio Code documenta gli stessi tre livelli ma un valore predefinito high. Per K3.1 Pro una richiesta con thinking disattivato viene rifiutata. Un ID modello errato può invece ricadere su K2.8 Preview senza thinking: una risposta ricevuta non dimostra da sola che stai usando il modello richiesto. Il contesto arriva fino a 1.048.576 token sui piani abilitati; non è una quota garantita a ogni account. Fonte: configurazione dei modelli Code, consultata il 24 ottobre 2026.
Conserva quindi una scheda della prova con il canale e la configurazione effettiva. Quando il comportamento cambia, quella scheda permette di distinguere una differenza di modello da una differenza del client. È particolarmente utile quando si aggiorna uno strumento o si importa una configurazione preparata per un servizio diverso.
Il contesto esteso non invita a inviare qualsiasi file. Un repository contiene spesso output generati, dipendenze, registri e copie di materiale già presente altrove. Raccogliere tutto può rendere meno leggibili i riferimenti importanti. Parti da istruzioni del progetto, punto di ingresso interessato e prove pertinenti; allarga la lettura quando emerge una dipendenza concreta.
Che cosa dicono i benchmark di coding pubblicati?
Due righe del report Moonshot aiutano a capire perché una classifica unica è poco utile. I numeri sotto sono punteggi pubblicati dal fornitore, consultati il 24 ottobre 2026, e non risultati riprodotti da Giallo. Ogni colonna va letta nel proprio benchmark: le percentuali non rappresentano la probabilità che una modifica al tuo gestionale sia corretta. Fonte: tabella e note del report K3.1 Pro.
| Sistema riportato nel confronto | Terminal-Bench 4.0 | SWE Marathon v1.1 |
|---|---|---|
| Kimi K3.1 Pro, max | 65,7 | 51,7 |
| Claude Opus 5.5, max, con fallback indicato | 66,4 | 46,3 |
| GPT-6 Astra, max, con fallback indicato | 58,2 | 42,5 |
| Claude Fable 5.1, max, con fallback indicato | 57,9 | 45,6 |
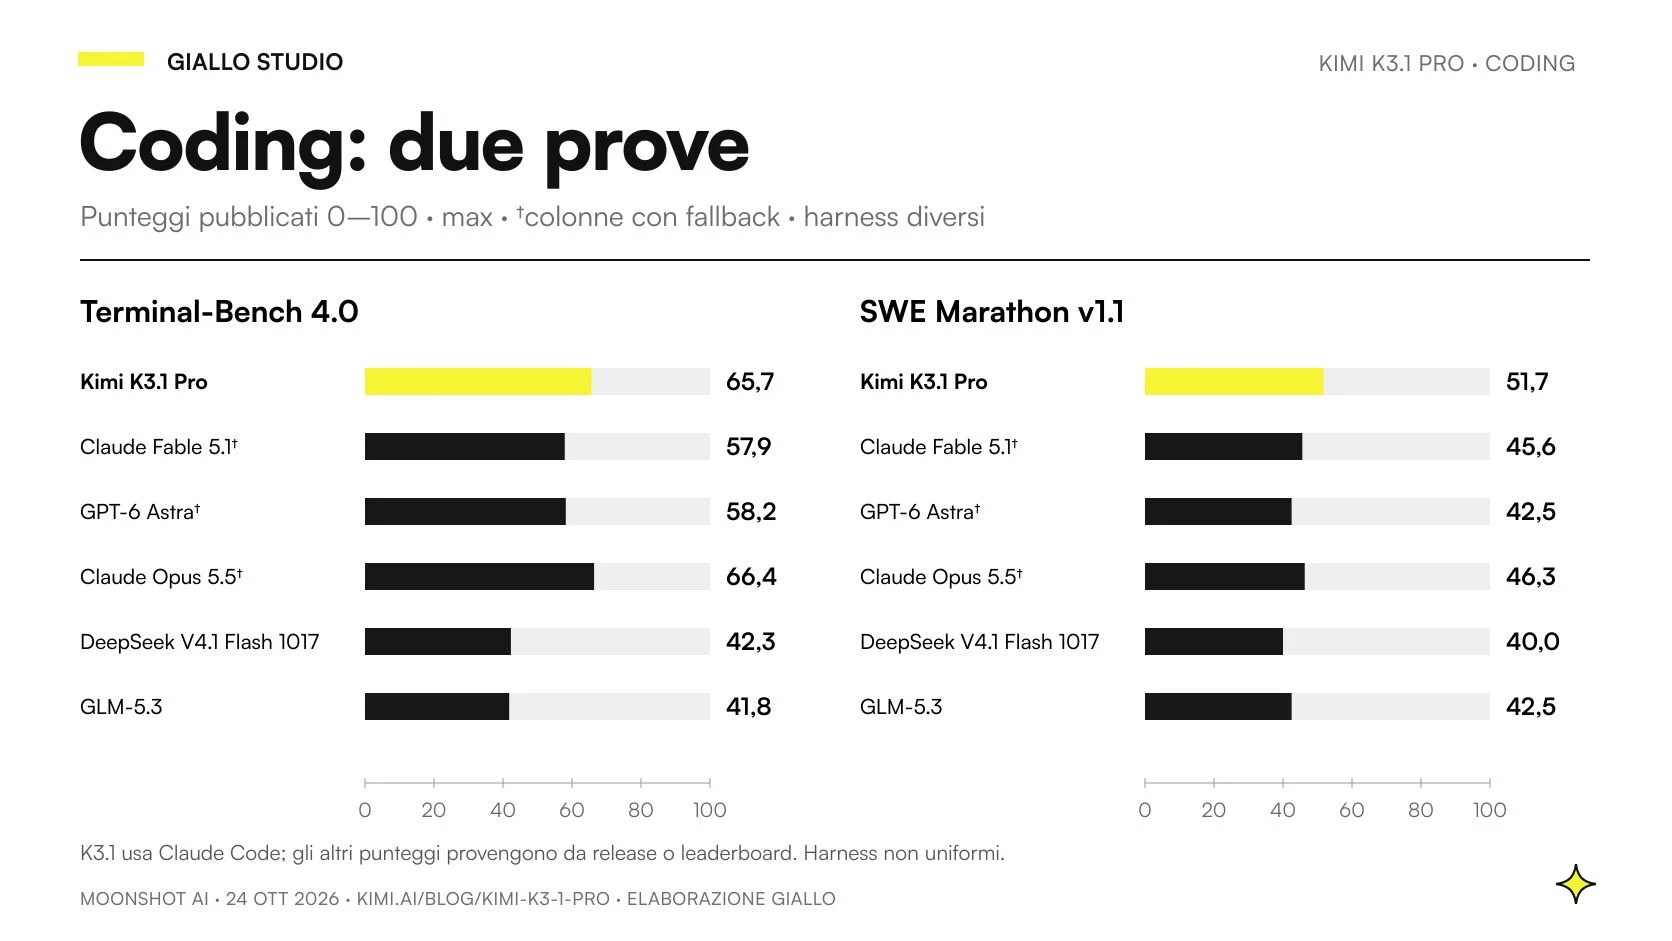
Il report valuta K3.1 Pro con l'ambiente agente Claude Code. Per Terminal-Bench combina gli altri risultati da release e leaderboard; per SWE Marathon usa Claude Code anche per DeepSeek e prende gli altri punteggi dalla leaderboard. Sono quindi confronti di sistemi con provenienze e condizioni diverse, non un esperimento controllato a parità completa di ambiente. Queste note fanno parte della fonte, non sono dettagli da rimuovere dal grafico.
Il confronto suggerisce quali attività provare, senza designare un vincitore valido per qualsiasi progetto. La guida ai benchmark di K3.1 Pro approfondisce metriche e limiti. Sul repository aziendale resta da verificare se il sistema comprende i vincoli, evita modifiche laterali e lascia una patch che il team sa mantenere.
Come preparare una prova sul repository aziendale?
Scegli un compito piccolo ma rappresentativo. Una correzione con un input che riproduce il problema è spesso un buon inizio: è possibile riconoscere l'errore prima e il comportamento atteso dopo. Evita una richiesta come “modernizza il gestionale”, che lascia all'agente troppe decisioni commerciali e tecniche insieme.
Prepara una copia di lavoro separata e annota lo stato iniziale. Le modifiche già presenti devono restare distinguibili da quelle dell'esperimento. Se il team usa Git, un branch dedicato permette di leggere la proposta rispetto a una base chiara. Il rilascio segue poi il normale processo del progetto, con un'autorizzazione distinta dalle prove locali.
Raccogli i comandi realmente supportati per controlli statici, test e build. Scrivi anche come riprodurre il comportamento nell'interfaccia o nell'API. Un build riuscito non dimostra che un import conservi le colonne giuste; un test che non viene raccolto non è un test passato. Le prove devono rispondere al requisito, oltre a terminare senza errori.
Sostituisci i dati reali con un campione sintetico quando bastano a riprodurre il difetto. Per un problema sulle date servono formati, fusi e casi limite; spesso non servono nomi dei clienti o documenti completi. In questo modo il primo esperimento resta più semplice da condividere anche con il revisore.
Quale brief aiuta a ottenere una modifica verificabile?
Un brief utile contiene il comportamento attuale, quello desiderato, i vincoli e la prova. Non serve trasformarlo in una specifica enorme. Serve rendere evidente quale risultato permetterà di chiudere il compito e quali interventi richiedono invece una decisione ulteriore.
Per esempio, uno sviluppatore potrebbe consegnare questo incarico:
Il riepilogo degli ordini esclude quelli registrati nell'ultimo giorno del periodo. Individua la causa usando il campione sintetico e i test esistenti. Conserva il formato della risposta e le regole di autorizzazione. Proponi la modifica minima e verifica i limiti del periodo, compreso il comportamento rispetto al fuso previsto dal progetto. Riporta i controlli eseguiti e i casi che non hai potuto provare.
È un esempio di brief, non una prova svolta da Giallo. Dà all'agente uno spazio di indagine e impedisce di considerare successo una schermata apparentemente corretta ottenuta rimuovendo un vincolo. Se emerge un dubbio sulla regola commerciale, il sistema deve farlo presente anziché decidere autonomamente quali ordini includere.
L'agente propone di riscrivere il modulo: come decidere?
Chiedi di collegare ogni modifica al difetto osservato. Una riscrittura può essere motivata, ma richiede di dimostrare che il percorso più piccolo non preserva il comportamento richiesto. Fai indicare compatibilità, casi limite e modalità di verifica. Se il requisito può essere soddisfatto con una correzione limitata, mantieni separata l'eventuale riorganizzazione del codice.
Come provarlo su un importatore per e-commerce?
Scenario ipotetico: commercio di articoli professionali a Padova. Il catalogo arriva da un fornitore tramite un file strutturato. Una nuova esportazione contiene codici con zeri iniziali e descrizioni con virgolette; l'importatore altera alcuni codici. Il team prepara dati sintetici che riproducono quelle caratteristiche e identifica il risultato atteso per ogni riga.
Il compito di K3.1 Pro è seguire il percorso dal file al record, localizzare dove viene persa l'informazione e proporre una patch. La consegna deve conservare i codici come richiesto dal dominio aziendale e gestire le righe non valide senza trasformarle silenziosamente in prodotti diversi. L'aggiornamento del catalogo reale rimane un'operazione successiva.
La prova comprende un secondo import dello stesso campione, per controllare anche duplicazioni e stabilità. Il revisore confronta i record attesi, legge le variazioni al parser e verifica che una correzione locale non abbia cambiato la gestione di altri file. Se il modello propone una dipendenza, deve spiegarne il ruolo rispetto al problema.
Questo scenario non attribuisce a Kimi un tempo di esecuzione o un risparmio. Mostra un incarico per cui l'azienda può definire la qualità. Se la patch funziona, il risultato del test è una base per decidere se ampliare l'uso; non dimostra che il modello saprà gestire ogni futuro catalogo.
Come usarlo per un gestionale di assistenza tecnica?
Scenario ipotetico: impresa di manutenzione a Varese. Il responsabile vuole una schermata che distingua gli interventi in attesa di ricambi da quelli pronti per la pianificazione. Il problema non è soltanto disegnare due colonne. Bisogna capire quali stati esistono, chi può cambiarli e come viene mostrata una pratica incompleta.
Prima del codice si concordano i casi: intervento senza materiale, ricambio arrivato, pratica annullata e utente senza autorizzazione. K3.1 Pro può esplorare i componenti e proporre un intervento coerente con il progetto. Il referente commerciale decide il significato degli stati; il modello implementa il comportamento approvato entro quei vincoli.
La verifica attraversa l'intero percorso: dati restituiti dal servizio, autorizzazione, rendering, aggiornamento ed errore. Il browser serve a controllare leggibilità e interazione, mentre i test pertinenti devono intercettare la regressione più probabile. Un'immagine della schermata da sola non dimostra che una persona senza permessi non possa cambiare uno stato.
Per una PMI questa è una forma concreta di collaborazione fra chi conosce il processo e chi segue lo sviluppo. L'agente può accelerare singole operazioni, ma il requisito resta leggibile dal team. La qualità della prova dipende dalla precisione con cui si è descritto il lavoro da svolgere.
Immagini, interfacce e strumenti funzionano allo stesso modo in ogni client?
No: la capacità del modello e l'interfaccia scelta vanno controllate insieme. Un riferimento visivo può essere utile per ricostruire una schermata, ma il client deve saperlo trasmettere nel formato supportato. La guida del percorso Code attraverso Responses, per esempio, descrive testo e immagini e non il video diretto. Fonte: documentazione dell'integrazione Responses, consultata il 24 ottobre 2026.
Per uno sviluppo frontend prepara gli stati dell'interfaccia, non solo la schermata ideale: caricamento, dati mancanti, errore, contenuto lungo e dimensioni ridotte. Il modello può riprodurre un riferimento gradevole e ignorare uno stato operativo essenziale se il brief non lo rende visibile. Anche l'accessibilità va verificata con interazioni reali.
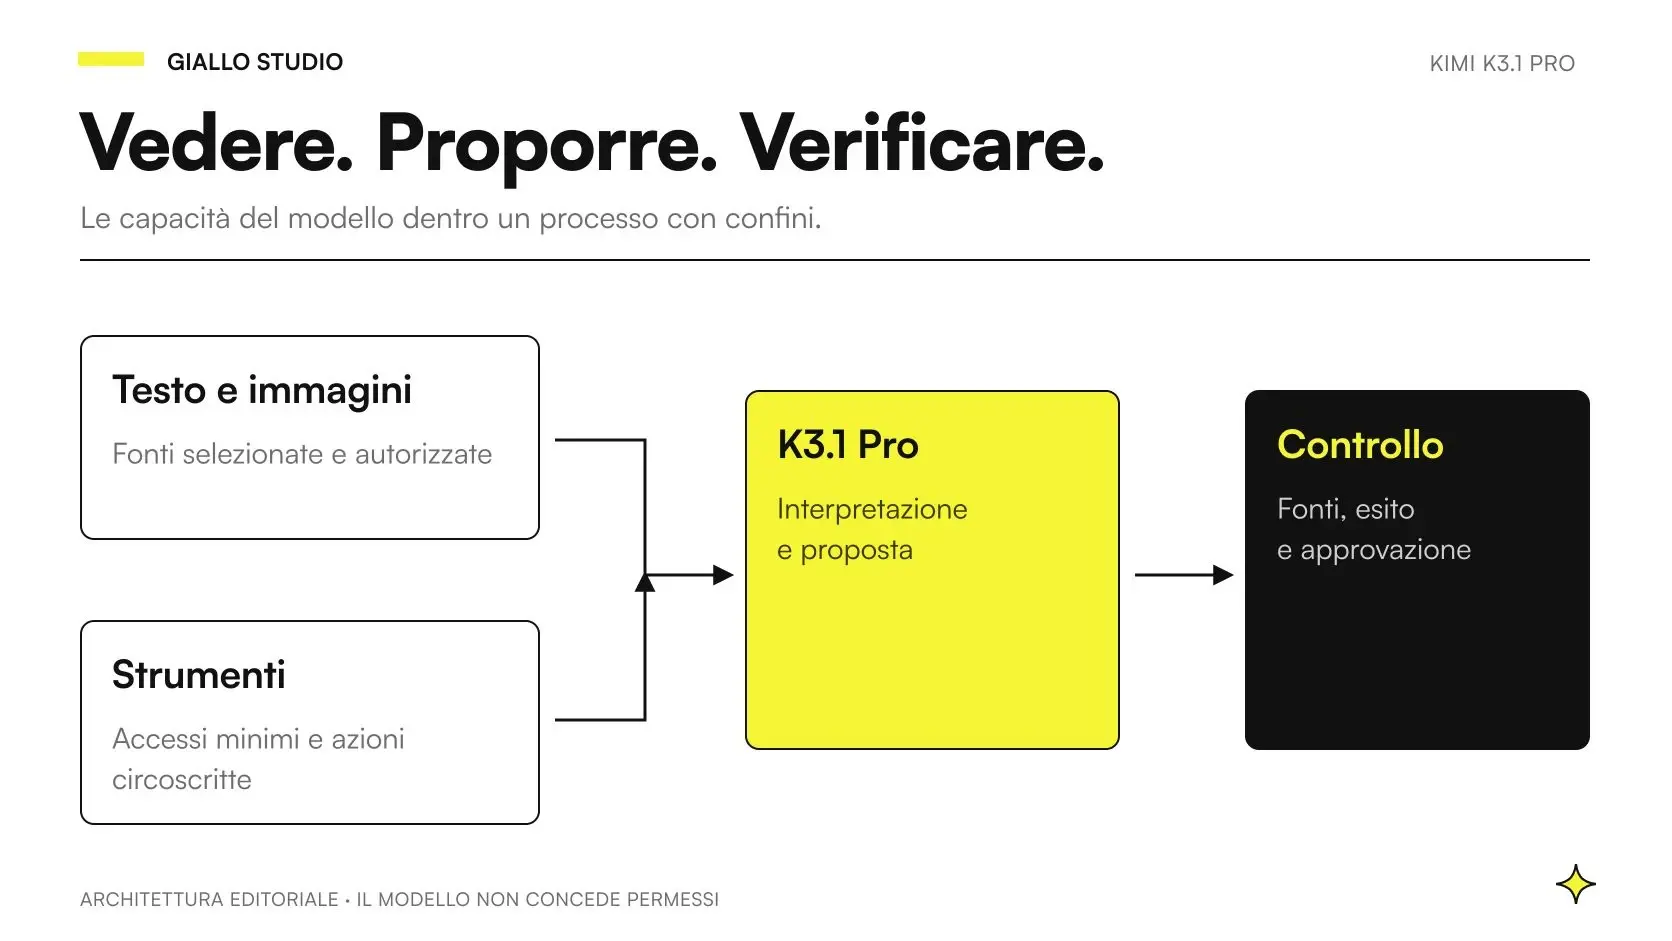
Quando il progetto coinvolge analisi di immagini o una sequenza di strumenti, la guida agli agenti multimodali K3.1 Pro aiuta a separare lettura, proposta ed esecuzione. Il principio è utile anche nel coding: avere uno strumento disponibile non implica che ogni sua azione debba essere autorizzata.
Quando scegliere Highspeed e come controllare il consumo?
La variante Highspeed va provata quando l'attesa del modello incide sul lavoro interattivo. Se la sessione passa soprattutto tempo in build, test o servizi esterni, una generazione più rapida può cambiare poco il tempo totale. Registra quindi l'attività completa, includendo revisione e correzioni, senza trasformare una dichiarazione di velocità del fornitore in una promessa al cliente.
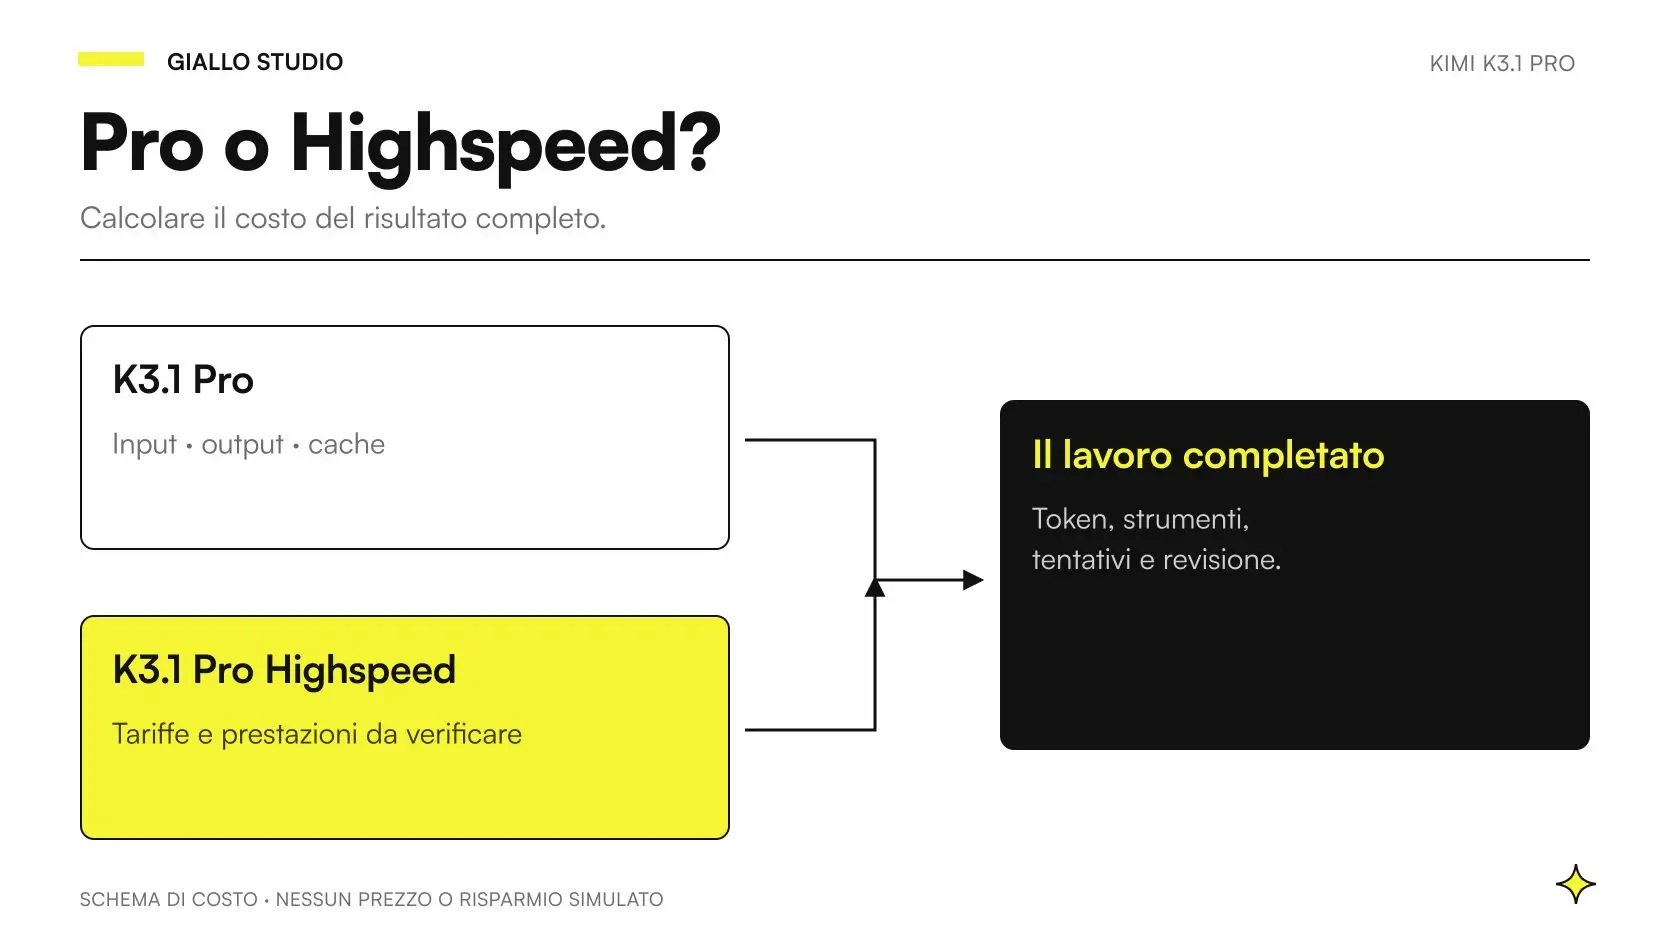
Tieni distinti i consumi del prodotto Code e il listino API. La guida ai prezzi di K3.1 Pro spiega la differenza fra input, output e cache. Nel confronto sul progetto serve anche sapere quante proposte vengono accettate e quanto lavoro rimane al revisore: una risposta economica ma inutilizzabile non chiude il compito.
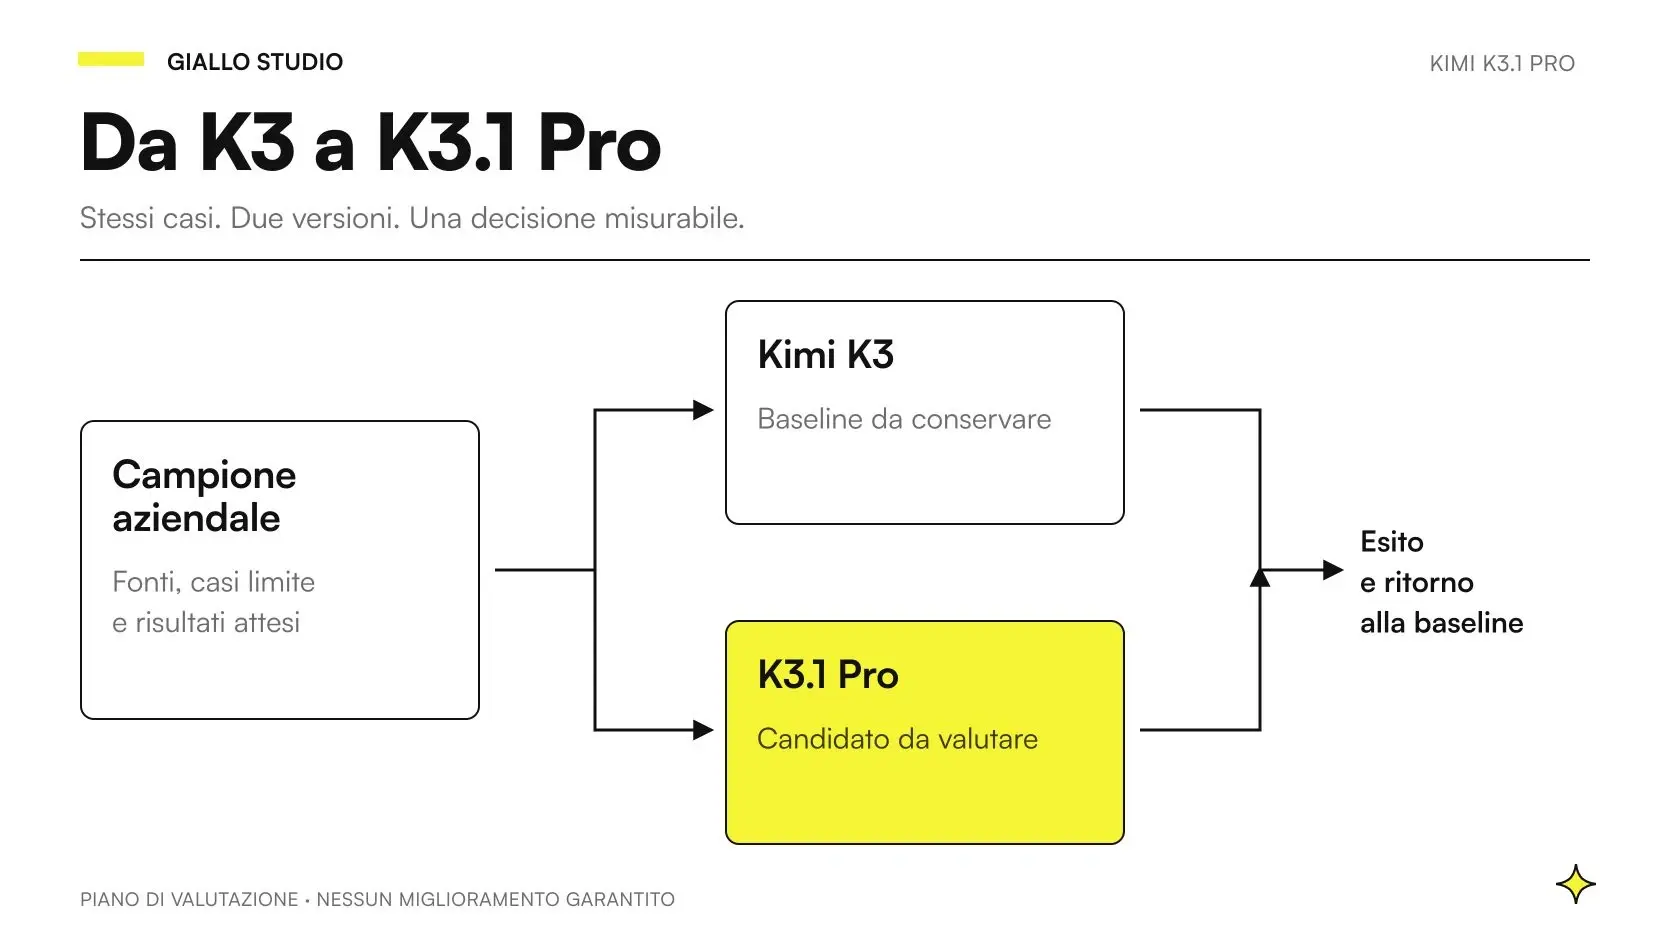
Se stai passando da K3, conserva un caso di confronto ripetibile e segui la guida alla migrazione K3.1 Pro. Mantieni stabili il requisito e le prove. Cambiare insieme modello, framework, dipendenze e istruzioni impedisce di capire quale cambiamento ha causato un difetto o un miglioramento.
Quali errori evitare prima di accettare il codice?
Il primo è dare valore di verifica alla frase “ho eseguito i test”. Chiedi quali comandi, quali risultati e quale comportamento coprono. Il secondo è accettare file estranei al requisito senza una motivazione. Il terzo è confondere un'interfaccia funzionante con autorizzazioni corrette. Il quarto è consentire che l'esperimento usi direttamente dati e servizi di produzione.
Controlla il diff dall'inizio alla fine. Una patch può correggere il sintomo e introdurre una modifica inutile al formato dei dati, al lockfile oppure alla gestione degli errori. Se il progetto richiede una revisione di sicurezza, il modello che ha prodotto il codice non sostituisce quel passaggio. Lo stesso criterio vale per qualsiasi altro agente di sviluppo.
L'adozione diventa ragionevole quando il team può ripetere la prova e mantenere il risultato. Parti da un difetto concreto, una base chiara e condizioni di accettazione condivise. Se vuoi impostare questo percorso su un gestionale o un'integrazione aziendale, Giallo affianca il team nello sviluppo di software su misura. Il modello si sceglie dentro quel processo, verificando ciò che consegna.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Kimi K3.1 Pro: cos’è, cosa cambia e quando usarlo
 Kimi K3.1 Pro benchmark: confronto con gli altri LLM
 Kimi K3.1 Pro: prezzi API, cache e budget per le PMI
 Kimi K3.1 Pro: agenti multimodali per processi aziendali
 Kimi K3.1 Pro vs K3: differenze e migrazione verificabile
 Kimi Code: agente per programmare e lavorare sul codice
 Kimi API: modelli, prezzi e integrazione Moonshot
FAQ
Kimi K3.1 Pro si può usare per programmare?
Sì. La disponibilità in Kimi Code e via API è verificata al 24 ottobre 2026. Per valutare l'utilità nel proprio progetto servono un incarico preciso, strumenti autorizzati e controlli sul risultato prodotto.
Kimi K3.1 Pro e Kimi Code sono la stessa cosa?
K3.1 Pro è il modello; Kimi Code è il prodotto con cui un agente lavora sul progetto. Il comportamento finale dipende anche da strumenti, istruzioni, permessi e client, non soltanto dal modello.
Quale identificatore devo usare per K3.1 Pro?
Dipende dal servizio. La tabella di questa guida distingue l'identificatore della piattaforma API da quello del servizio Code; copiare il nome visualizzato o l'ID dell'altro canale può produrre un errore o un modello inatteso.
Posso disattivare il thinking di K3.1 Pro?
Il modello lavora con thinking attivo. Nel servizio Code la documentazione indica che una richiesta con thinking disabilitato viene rifiutata: conviene controllare la configurazione effettiva del client.
Highspeed rende più veloci anche test e build?
La velocità maggiore dichiarata riguarda il modello. Compilazione, esecuzione degli strumenti e revisione seguono i tempi del rispettivo ambiente; bisogna misurare l'attività completa.
Il contesto massimo è disponibile con ogni piano Code?
No. La documentazione collega l'accesso al contesto esteso al piano del servizio Code. La capacità massima del modello non dimostra che il proprio account o client la renda disponibile.
Un buon benchmark dimostra che la patch è pronta?
No. I punteggi pubblicati descrivono sistemi e condizioni di valutazione specifici. Una modifica aziendale deve soddisfare i propri requisiti, superare controlli pertinenti e avere un comportamento verificabile.