
Kimi K3.1 Pro: cos’è, cosa cambia e quando usarlo
Kimi K3.1 Pro spiegato: disponibilità, contesto da 1M token, API, coding e pesi annunciati. Cosa verificare prima di usarlo in una PMI.
Kimi K3.1 Pro è il nuovo modello multimodale di Moonshot AI, primo della serie K3.1 e sviluppato attraverso ulteriore post-training di K3. È già disponibile nei prodotti ospitati e nel catalogo API alla verifica del 24 ottobre 2026. Il produttore dichiara un contesto da un milione di token e presenta risultati su coding, uso di strumenti, documenti e compiti visivi. Questi fatti provengono dal blog tecnico ufficiale Kimi; non sono prestazioni misurate da Giallo.
La data richiede una distinzione: il changelog Kimi Code colloca il rilascio al 23 ottobre 2026, mentre il blog riporta una modifica del 24 ottobre. I pesi completi sono annunciati entro il 4 novembre 2026 e non risultano ancora nel catalogo pubblico Moonshot AI consultato. Accesso online, accesso API e download dei pesi sono tre disponibilità diverse.
Per una PMI la novità interessante è poter valutare un altro candidato su attività complesse, mantenendo chiaro che cosa fa il modello e che cosa deve fare il sistema intorno. Questa guida serve a orientare la prima scelta; prezzi, configurazione e confronto quantitativo hanno approfondimenti dedicati. Non è una recensione basata su prove autenticate né una promessa di produttività.
In sintesi
- Kimi K3.1 Pro è un modello di Moonshot AI; app, API e Kimi Code ne organizzano l’utilizzo in modi diversi.
- Il rilascio è datato 23 ottobre nel changelog ufficiale; questa guida verifica le fonti al 24 ottobre 2026.
- Il contesto dichiarato è di un milione di token e non garantisce una lettura corretta di ogni fonte.
- I pesi completi sono promessi entro il 4 novembre; download e licenza K3.1 restano da verificare.
- API a consumo e Kimi Code usano identificatori e impostazioni predefinite differenti.
- La scelta aziendale richiede un processo definito e risultati controllabili, oltre ai benchmark pubblicati.
Kimi 3.1 e Kimi K3.1 Pro sono lo stesso nome?
Chi cerca “Kimi 3.1” di solito vuole informazioni sulla nuova versione, ma il nome da utilizzare per identificare il prodotto documentato è Kimi K3.1 Pro. La precisione serve soprattutto quando si passa da un articolo a una console, a una configurazione o a un confronto con altri modelli. “Kimi” da solo può indicare il servizio, la famiglia oppure l’interfaccia di conversazione.
La pubblicazione di lancio lo descrive come il primo modello della serie K3.1. Non permette di attribuire automaticamente lo stesso comportamento a ogni futuro membro della serie, né di leggere “Pro” come un abbonamento valido in tutti i canali. Nome del modello, piano commerciale e modalità di accesso vanno registrati separatamente.
La guida generale a Kimi AI aiuta a capire il contesto della famiglia. Questa pagina riguarda invece la versione K3.1 Pro: che cosa è disponibile, che cosa è soltanto annunciato e come trasformare le sue capacità dichiarate in una prova aziendale sensata.
Qual è la differenza tra modello, app Kimi, API e Kimi Code?
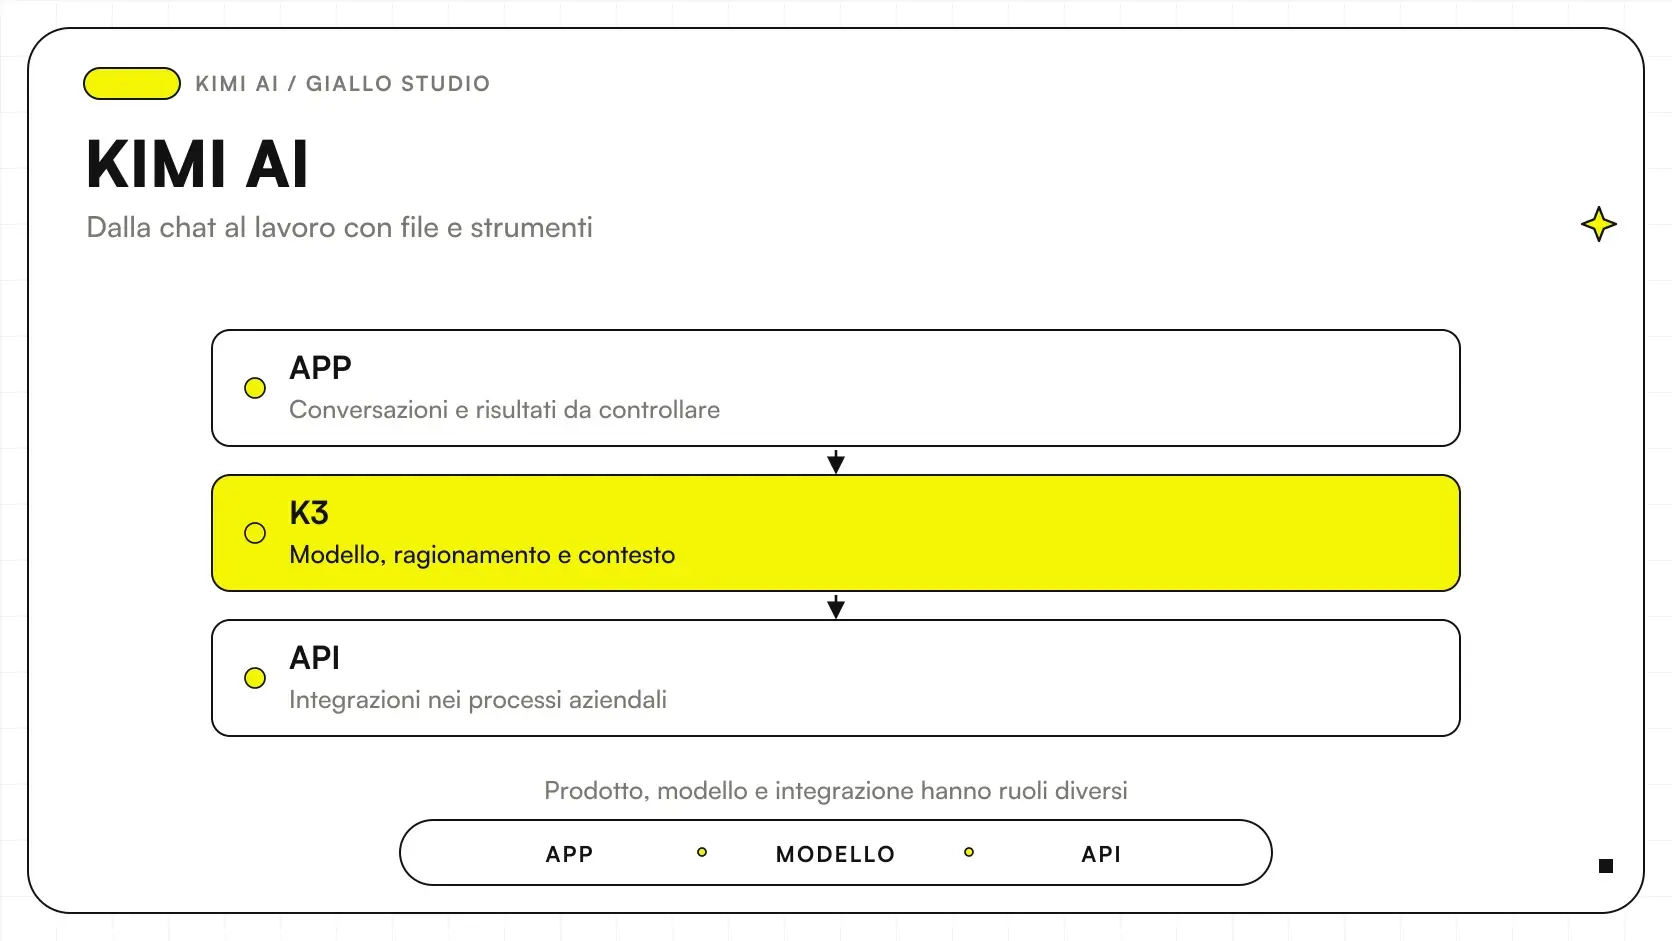
Il modello elabora gli input e produce una risposta. L’app offre un’interfaccia per usarlo; l’API permette a un software di richiamarlo; Kimi Code organizza un’esperienza dedicata al lavoro sul codice. Un agente può impiegare il modello insieme a strumenti, istruzioni, memoria del lavoro e regole di arresto. Sono livelli collegati, con responsabilità differenti.
| Livello | Che cosa offre | Che cosa verificare nel proprio progetto |
|---|---|---|
| Kimi K3.1 Pro | Capacità del modello e comportamento di ragionamento | Input supportati, contesto, limiti e qualità sui propri casi |
| Prodotto ospitato Kimi | Interfaccia e funzioni accessibili all’utente | Modello selezionato, piano, disponibilità e condizioni del servizio |
| API a consumo | Integrazione richiamabile da software | ID, effort, consumi, errori e contratto del canale |
| Kimi Code | Ambiente operativo per attività di sviluppo | Modello attivo, strumenti, sessione, permessi e verifiche |
| Agente aziendale | Sequenza di azioni per un incarico | Accessi ai dati, azioni consentite, approvazioni e tracciamento |
| Pesi scaricabili | Artefatti per un eventuale uso su infrastruttura propria | Effettivo rilascio, licenza, requisiti e sostenibilità operativa |
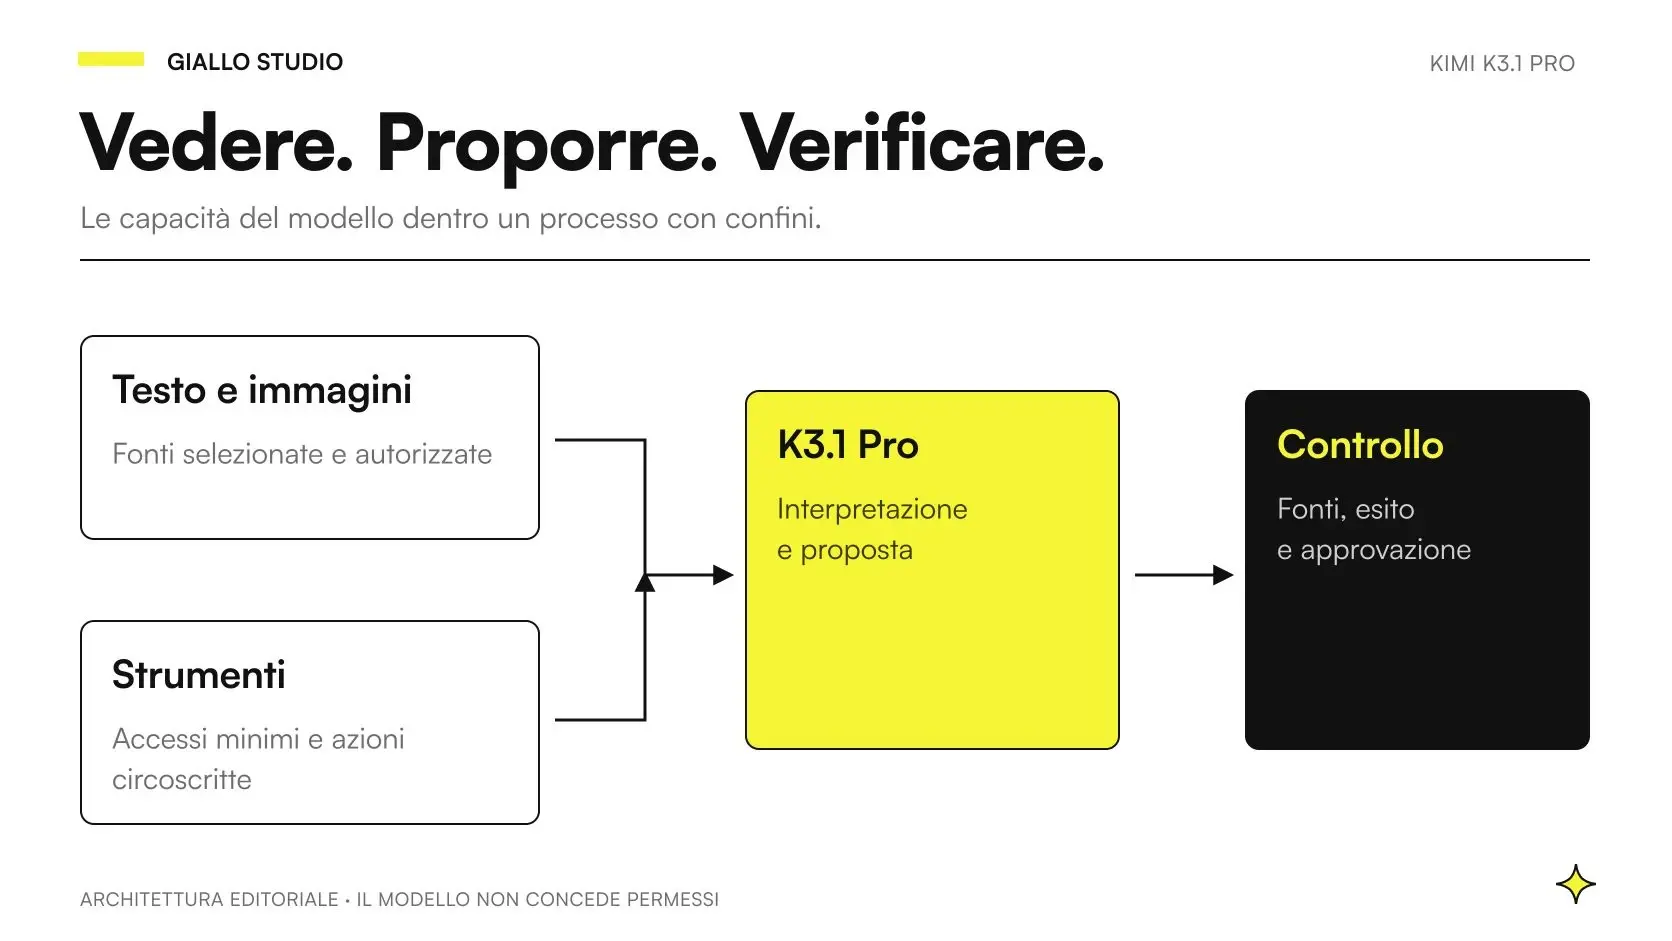
Questa distinzione evita un equivoco frequente: vedere una dimostrazione nell’app e considerarla un collegamento già pronto con il gestionale. L’integrazione richiede di definire quali informazioni entrano, come vengono recuperate, quale risultato deve uscire e chi può accettarlo. Un modello capace non conosce automaticamente struttura, autorizzazioni e regole dell’impresa.
Che cosa cambia rispetto a Kimi K3?
La novità documentata è un ulteriore lavoro di post-training su K3, accompagnato da nuove valutazioni e disponibilità nei canali indicati dal produttore. Post-training significa interventi successivi alla fase principale di addestramento per orientare il comportamento del modello; non rivela da solo ogni modifica interna e non autorizza a inventare differenze architetturali. La fonte per questa descrizione è il blog tecnico K3.1 Pro.
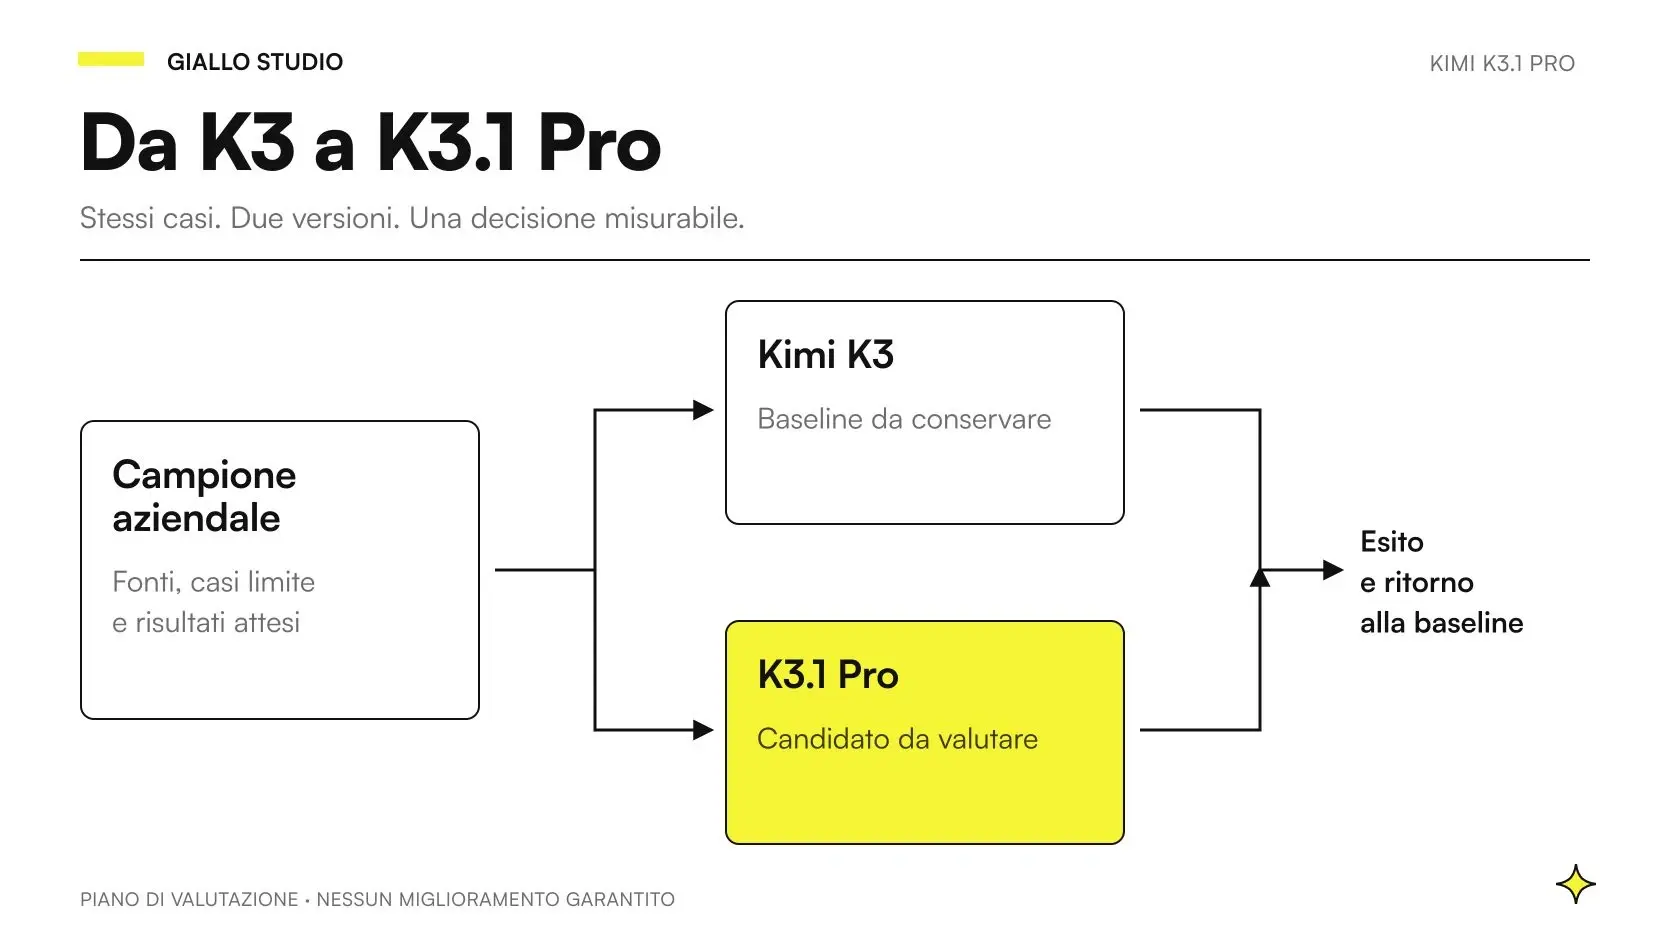
Per chi impiega già K3, la domanda pratica riguarda la continuità del proprio sistema. Un modello successivo può rispondere in modo diverso allo stesso messaggio, scegliere uno strumento in un altro momento oppure generare una spiegazione più estesa. Nessuno di questi cambiamenti equivale automaticamente a un miglioramento del risultato accettato dal responsabile del processo.
La guida alla migrazione da K3 a K3.1 Pro approfondisce questo passaggio. Conviene conservare il comportamento del sistema precedente come riferimento e aggiornare separatamente modello, istruzioni e strumenti: cambiando tutto insieme diventa difficile capire l’origine di un miglioramento o di una regressione.
Che cosa significa un contesto da un milione di token?
La finestra dichiarata indica quanto materiale il modello può gestire nel contesto, secondo i limiti del servizio utilizzato. Un token non è una pagina, e la sua relazione con parole, codice o immagini cambia in base al contenuto. Il dato da un milione di token è pubblicato da Kimi e va letto con la documentazione del canale API, consultate il 24 ottobre.
Un contesto ampio può essere interessante quando occorre mettere in relazione parti lontane di documenti o di un repository. Non dimostra però che ogni dettaglio sia stato interpretato correttamente. Il modello può ignorare una nota, confondere due revisioni oppure collegare un importo alla riga sbagliata. Caricare più materiale non corregge automaticamente la qualità delle fonti.
Per un archivio aziendale serve anche decidere quali informazioni meritino di entrare nella richiesta. Materiale duplicato, versioni superate e istruzioni nascoste nei documenti aumentano l’ambiguità. Una procedura utile conserva origine, data e revisione dei file, poi chiede risposte che permettano al lettore di risalire al passaggio pertinente. Il contesto diventa così un contenitore organizzato, invece di una promessa di memoria universale.
Kimi K3.1 Pro capisce immagini, video e documenti?
La documentazione API descrive input visivi, incluse immagini e video, oltre al testo. La raccolta del lancio comprende anche valutazioni su documenti e ricostruzione CAD. Questo rende ragionevole progettare prove con contenuti eterogenei, ma non dimostra che ogni formato sia accettato direttamente da ogni interfaccia o che il modello produca qualsiasi tipo di file finale. Le fonti sono il quickstart API e il blog con i protocolli.
Un PDF può contenere testo selezionabile, pagine scansionate, tabelle spezzate, note e immagini. Trasformarlo in input richiede una scelta tecnica: recuperare il testo, rendere le pagine come immagini oppure combinare le due strade. Il risultato dipende anche da risoluzione, ordine e preparazione dei materiali, non soltanto dal nome del modello.
Per esempio, riconoscere una quota in un disegno non certifica la correttezza di un progetto. Estrarre un importo da un documento non autorizza una registrazione contabile. La guida agli agenti multimodali con K3.1 Pro affronta il passaggio dalla capacità di lettura alla costruzione di un processo con controlli e responsabilità riconoscibili.
Perché API e Kimi Code hanno ID e default diversi?
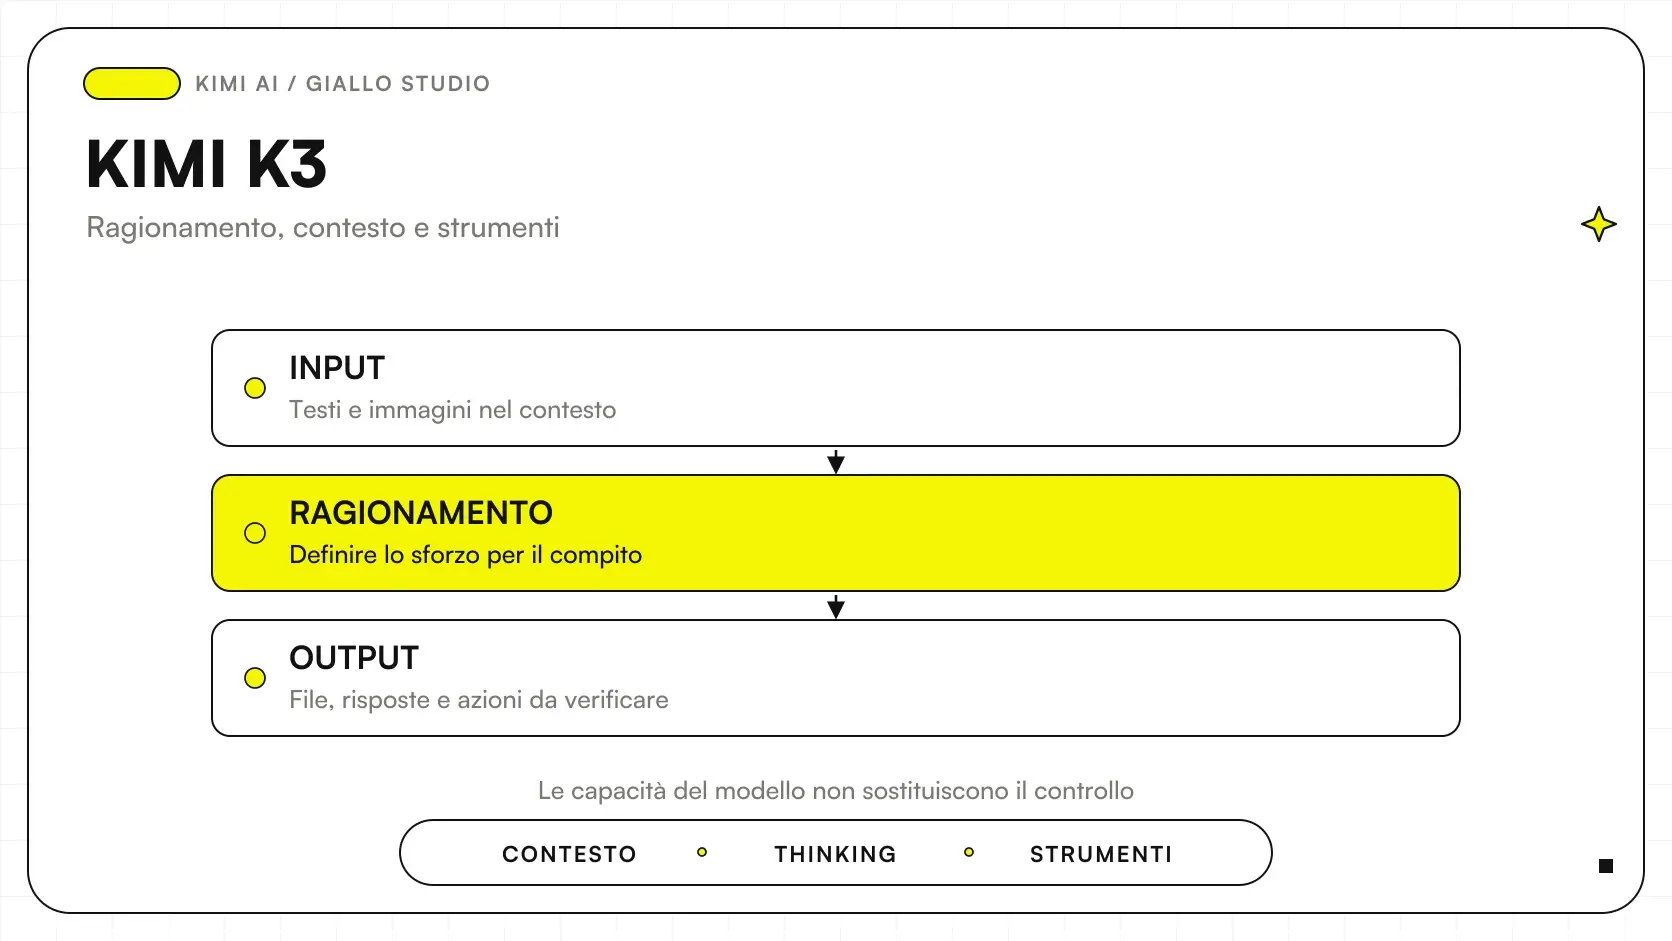
Le pagine ufficiali descrivono due contratti operativi. Nell’API a consumo si usano kimi-k3.1-pro e kimi-k3.1-pro-highspeed; il thinking è sempre attivo e gli effort disponibili sono low, high e max, con default max. In Kimi Code gli ID sono k3.1-pro e k3.1-pro-highspeed, mentre la tabella dettagliata indica high come valore predefinito. Lo riportano il quickstart API, la configurazione Kimi Code e il changelog.
La differenza conta quando due persone confrontano le proprie risposte. “Ho usato K3.1 Pro” lascia ancora aperti canale, variante, effort e strumenti. Un confronto ripetibile annota questi elementi, insieme alla versione delle istruzioni e al materiale fornito. In caso contrario si rischia di attribuire al modello una differenza introdotta dalla configurazione.
Non serve trasformare il primo test in un progetto infrastrutturale complesso. Serve però una scheda minima che identifichi il sistema realmente usato. Per un team di sviluppo, la guida K3.1 Pro per coding raccoglie i dettagli operativi, compresa l’indicazione ufficiale di aprire una nuova sessione nel passaggio da K3.
A che cosa serve la variante Highspeed?
Highspeed è presentata come una variante con capacità equivalenti e generazione più rapida. Kimi dichiara un output circa due o tre volte più veloce, ma distingue questa velocità dal tempo impiegato dagli strumenti. La tabella del lancio non contiene una valutazione separata Highspeed per ogni benchmark: non possiamo assegnarle punteggi sperimentali autonomi. Il riferimento è la documentazione dei modelli Kimi Code, verificata il 24 ottobre 2026.
Un’attività composta da lettura di file, ricerca, esecuzione di programmi e attesa delle risposte può dipendere soprattutto da questi passaggi. Se il modello genera più rapidamente ma lo strumento rimane lento, il tempo totale non segue necessariamente lo stesso rapporto. Anche il lavoro umano di revisione può pesare più della fase di output.
La scelta richiede quindi una misura sul processo completo. La guida a prezzi e API K3.1 Pro aiuta a separare consumi, variante e cache. Il criterio operativo è pagare una velocità che migliori il servizio nel caso reale, dopo aver controllato che la qualità accettata rimanga adeguata.
Kimi K3.1 Pro è già open weight e utilizzabile in locale?
Al 24 ottobre la formulazione corretta è: il rilascio completo dei pesi è promesso entro il 4 novembre 2026. Il catalogo pubblico consultato mostra il predecessore K3, ma non una repository pubblica K3.1. Il blog Kimi e il catalogo Moonshot AI sono i riferimenti da verificare di nuovo prima di pianificare un’installazione.
L’annuncio orienta la ricerca tecnica, ma non sostituisce gli artefatti necessari. Occorrono pesi effettivamente accessibili, model card, licenza applicabile e documentazione d’inferenza. Le condizioni di K3 non si trasferiscono automaticamente a K3.1. Senza questi elementi non è fondato indicare hardware minimo, costo di esercizio o diritti d’uso commerciale come se fossero già confermati.
Anche dopo il rilascio, ospitare il modello richiederà una valutazione distinta dall’uso API. Infrastruttura, manutenzione, aggiornamenti, controllo degli accessi e disponibilità del servizio entrano nel costo operativo. “Pesi aperti” descrive un aspetto della distribuzione; non significa che un’integrazione sia pronta o che la gestione aziendale sia gratuita.
I benchmark dimostrano che è migliore di Claude e GPT?
Dimostrano risultati su compiti e protocolli specifici. Nella raccolta ufficiale Kimi ottiene 65,7 su Terminal-Bench 4.0, rispetto a 66,4 per Claude Opus 5.5, mentre su SWE Marathon v1.1 riporta 51,7, sopra gli altri valori esposti in quel pannello. Sono dati compilati da Kimi con provenienze e ambienti non uniformi; non costituiscono una prova generale a parità di condizioni. La fonte è la tabella ufficiale con metodologia.
Una PMI può usare questi risultati per scegliere che cosa investigare. Se il bisogno riguarda manutenzione software, i test di coding suggeriscono un candidato pertinente. Se riguarda documenti complessi, sono più utili i protocolli che mettono alla prova lettura e strumenti. La differenza è sostanziale: un vantaggio su un test non autorizza a promettere la stessa qualità su preventivi, procedure o archivi dell’impresa.
Il confronto benchmark K3.1 Pro con gli altri LLM riporta grafici, tabelle accessibili e limiti dei dati. Non abbiamo replicato le misure e non le trasformiamo in stime di ritorno economico. Una valutazione aziendale deve includere anche gli errori che una media può nascondere.
Primo scenario ipotetico: preparare una scheda da documenti di fornitura
Immaginiamo una PMI che distribuisce componenti e riceve schede tecniche, listini e note di revisione dai fornitori. Prima di preparare un’offerta, una persona deve capire quali caratteristiche siano confermate, quali opzioni siano compatibili e quali informazioni manchino. È uno scenario progettuale, non un caso cliente o una prova eseguita con K3.1 Pro.
Un primo incarico utile sarebbe produrre una scheda interna con caratteristiche richieste, fonte di ogni dato e punti da verificare. Se il materiale contiene immagini o scansioni, il sistema dovrebbe mostrare il passaggio originale accanto all’estrazione. Se due revisioni riportano informazioni diverse, il risultato deve evidenziare il conflitto, senza scegliere silenziosamente quella più conveniente.
La verifica non si limita alla fluidità del testo. Il referente controlla se il codice prodotto è corretto, se un requisito assente è stato dichiarato e se la fonte appartiene alla revisione valida. Il sistema rimane in preparazione: prezzo finale, disponibilità e impegni verso il cliente richiedono ancora le verifiche previste dal processo aziendale.
Un risultato utile può essere una base più ordinata per la decisione umana. Solo dopo aver capito gli errori ricorrenti ha senso valutare l’aggiornamento automatico di campi o documenti. Il passaggio successivo dipende dalla verificabilità dei dati estratti, non dalla lunghezza del contesto o dall’aspetto professionale della risposta.
Secondo scenario ipotetico: assistere la manutenzione di un gestionale
Una piccola software house vuole analizzare segnalazioni di errore nel gestionale di un cliente. Il materiale comprende descrizione del comportamento, log selezionati e repository di sviluppo. L’incarico iniziale potrebbe essere trovare i percorsi coinvolti, formulare un’ipotesi e proporre una correzione circoscritta. Anche questo è un esempio ipotetico, senza risultati attribuiti a Giallo.
Per rendere la prova utile, il team prepara un ambiente isolato e un modo per riprodurre il problema. Una buona risposta indica quali indizi sostengono la diagnosi e quali restano incerti. Se propone codice, la modifica deve rispettare le convenzioni del progetto e includere una verifica pertinente. L’esistenza di una patch non prova che il difetto sia risolto.
Il confronto con il flusso attuale può osservare qualità della diagnosi, ampiezza della modifica, passaggi di controllo e lavoro residuo del manutentore. Il tempo del modello è soltanto una parte: una risposta veloce che richiede una lunga revisione può essere meno utile di una proposta più lenta ma precisa. La decisione nasce dall’intero percorso fino alla correzione accettata.
Come scegliere un primo test senza cambiare tutta l’azienda?
Parti da un’attività con un ingresso riconoscibile, un’uscita definita e un responsabile capace di valutare il risultato. “Aiutare il commerciale” è troppo ampio; “preparare una scheda interna dei requisiti citando i documenti” è verificabile. Il campione dovrebbe includere materiali normali, casi ambigui e informazioni mancanti, così da osservare anche quando il sistema deve fermarsi.
Scegli il percorso in base al risultato che ti serve
Documento interno: prepara esempi con fonti controllabili e chiedi di distinguere dati presenti, deduzioni e domande aperte.
Lavoro sul codice: usa un ambiente isolato, definisci il comportamento atteso e chiedi una modifica che possa essere riprodotta e verificata.
Agente con strumenti: disegna prima gli accessi e i punti di approvazione, poi verifica separatamente lettura, proposta e azione.
Installazione propria: attendi e verifica pesi, licenza e documentazione K3.1 prima di assumere requisiti o convenienza.
Per ogni risposta conserva il materiale di partenza, le istruzioni e il giudizio del revisore. I criteri devono descrivere il risultato desiderato: correttezza dei riferimenti, completezza dei campi, rispetto dei vincoli e capacità di riconoscere un dato assente. Un confronto basato solo sullo stile favorisce il testo persuasivo e lascia nascosti gli errori più costosi.
Quali errori evitare nella prima adozione?
Il primo errore è confondere la finestra di contesto con la correttezza. Più informazioni disponibili non eliminano conflitti, omissioni e interpretazioni sbagliate. Il secondo è usare le stesse parole per canali diversi: una prova nell’app e un’integrazione API possono avere configurazioni e condizioni differenti. La scheda del test deve renderle riconoscibili.
Il terzo errore è dare al modello accessi estesi prima di capire gli errori che commette. Un sistema che prepara una proposta non ha bisogno, nella stessa fase, del permesso di inviarla o registrarla come definitiva. Il quarto è misurare soltanto il costo dei token, trascurando preparazione, strumenti, tentativi e revisione. Il quinto è considerare annunciati i pesi e quindi già risolto il tema dell’installazione.
Un controllo concreto riguarda anche i dati: prima di usare materiale aziendale occorre capire quale servizio lo riceve, quali condizioni si applicano e chi può accedervi. Le impostazioni dell’interfaccia consumer non dimostrano da sole le condizioni contrattuali di un’altra API. La scelta del canale precede il caricamento dei documenti del processo.
Quando K3.1 Pro merita una prova nella tua PMI?
Merita una prova quando esiste un compito complesso ma delimitabile, il risultato può essere controllato e il sistema attuale offre un termine di confronto. È meno utile iniziare da incarichi vaghi, dati non ordinati o azioni che nessuno sa verificare. In questi casi la prima attività progettuale è rendere osservabile il processo, prima ancora di selezionare un modello.
La novità di K3.1 Pro amplia le possibilità da valutare; la decisione pratica rimane sul lavoro dell’azienda. Per approfondire i vincoli economici consulta prezzi e API; per un sistema che lavora con strumenti parti dalla guida agli agenti multimodali.
Se vuoi scegliere un incarico circoscritto, preparare un campione controllabile e capire quali risultati giustifichino il passo successivo, possiamo impostarlo insieme con una consulenza AI per la tua azienda.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Kimi K3.1 Pro benchmark: confronto con gli altri LLM
 Kimi K3.1 Pro: prezzi API, cache e budget per le PMI
 Kimi K3.1 Pro per coding: configurazione e prove utili
 Kimi K3.1 Pro: agenti multimodali per processi aziendali
 Kimi K3.1 Pro vs K3: differenze e migrazione verificabile
 Kimi AI: cos'è, cosa fa e quando usarlo
 Kimi K3: modello, ragionamento e limiti pratici
FAQ
Che cos’è Kimi K3.1 Pro?
Kimi K3.1 Pro è un modello multimodale di Moonshot AI, primo della serie K3.1, ottenuto con ulteriore post-training di K3. Al 24 ottobre 2026 è disponibile nei prodotti ospitati e nel catalogo API. Va distinto dall’app Kimi, da Kimi Code e dagli agenti che lo utilizzano.
Kimi K3.1 Pro è uscito il 23 o il 24 ottobre 2026?
Il changelog ufficiale Kimi Code data il rilascio al 23 ottobre 2026. Il blog tecnico consultato presenta una data di modifica del 24 ottobre senza una data di pubblicazione esplicita. In questa guida il 24 ottobre indica la verifica delle fonti, non un secondo lancio.
I pesi di Kimi K3.1 Pro si possono già scaricare?
Alla verifica del 24 ottobre 2026 i pesi completi sono annunciati entro il 4 novembre, ma non risultano nel catalogo pubblico Moonshot AI consultato. Non abbiamo verificato una model card o una licenza dei pesi K3.1. La disponibilità via API non equivale alla disponibilità del download.
Quanto contesto supporta Kimi K3.1 Pro?
Kimi dichiara una finestra di contesto da un milione di token. È una capacità del modello da leggere insieme ai limiti del canale utilizzato, non la promessa di ricordare o interpretare correttamente qualsiasi documento. Token e pagine non hanno una conversione fissa.
Qual è l’identificatore API di Kimi K3.1 Pro?
Nell’API a consumo gli identificatori documentati sono kimi-k3.1-pro e kimi-k3.1-pro-highspeed. In Kimi Code sono k3.1-pro e k3.1-pro-highspeed. Anche i default differiscono: max nell’API a consumo, high nella configurazione dettagliata di Kimi Code.
Kimi K3.1 Pro Highspeed è più intelligente della versione standard?
La documentazione dichiara capacità equivalenti e una maggiore velocità di generazione per Highspeed. Non pubblica una colonna separata di benchmark Highspeed nella tabella del lancio. La velocità di output non coincide con la durata totale di un processo che usa strumenti.
Una PMI dovrebbe sostituire subito il modello che usa?
No. È più utile scegliere un processo circoscritto, preparare esempi verificabili e confrontare il sistema attuale con il candidato. La decisione deve considerare qualità accettata, errori, costo completo, attese e controlli sui dati.