
ML Drift diventa open source: AI locale su smartphone, browser e desktop
ML Drift Google diventa open source standalone: differenza fra runtime e modello, backend GPU, limiti e prove per applicazioni AI locali.
Tempo di lettura: 12 min
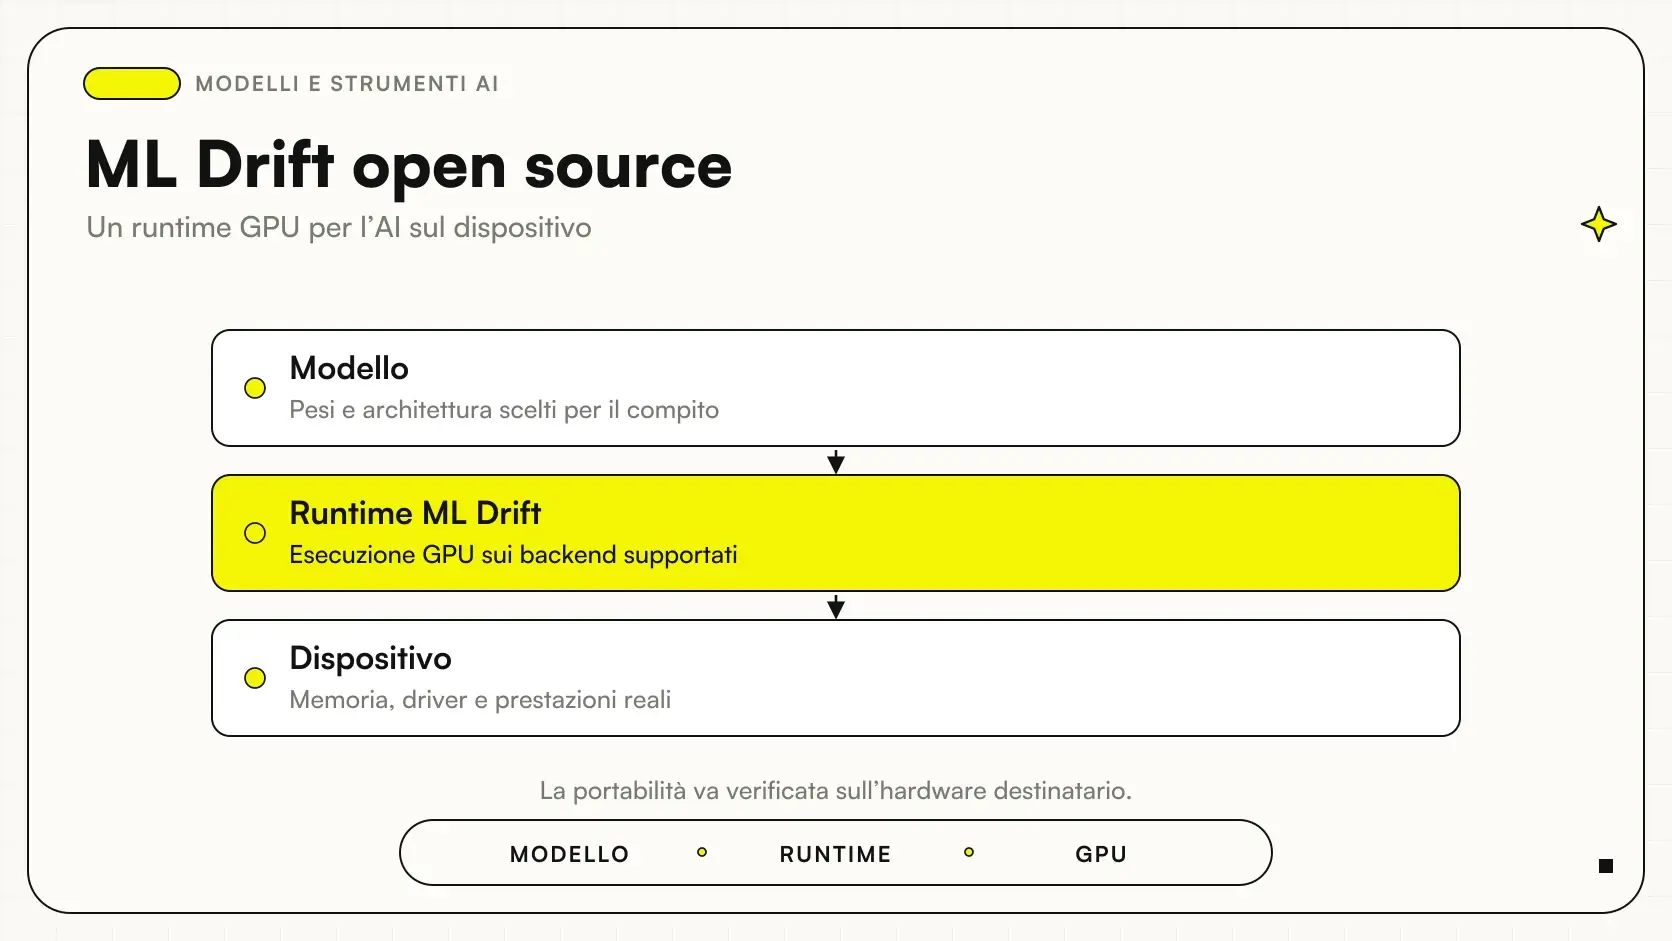
ML Drift è un motore per eseguire inferenza AI locale su GPU: aiuta un'applicazione a far funzionare un modello sul dispositivo. Non è un modello linguistico, non contiene da solo le conoscenze di un assistente e non trasforma automaticamente un programma in un'app offline.
L'8 ottobre 2026 Google ne ha annunciato il rilascio open source standalone. Il motore era già presente nell'ecosistema LiteRT e in lavori precedenti: la notizia riguarda l'apertura come componente utilizzabile anche separatamente, non la nascita dell'inferenza locale. L'annuncio mantiene il focus su mobile ed edge e descrive Windows e Linux come desktop preview. Annuncio ufficiale Google Developers.
In sintesi
- ML Drift è un runtime: il modello AI rimane una scelta distinta.
- Il rilascio standalone permette di valutare un'integrazione separata da LiteRT.
- Compatibilità e prestazioni dipendono da modello, precisione, GPU e driver.
- Un'app locale deve progettare anche dati, aggiornamenti, interfaccia e comportamento senza rete.
- La decisione richiede una prova su dispositivi rappresentativi dell'uso previsto.
Qual è la differenza fra runtime e modello AI?
Il modello rappresenta ciò che il sistema ha appreso e il tipo di trasformazione che sa eseguire. Il runtime organizza l'esecuzione di quel modello nell'ambiente disponibile. Per spiegare la distinzione senza confondere i componenti, si può pensare a un file e al programma che lo apre: conoscere le caratteristiche del file non dimostra che qualsiasi programma riesca a utilizzarlo correttamente.
ML Drift appartiene al livello dell'esecuzione. Il repository ufficiale descrive un motore GPU con backend come OpenGL ES, OpenCL, Metal e WebGPU, distribuito con licenza Apache 2.0. La disponibilità di questi percorsi non equivale alla compatibilità garantita di ogni modello su ogni dispositivo. L'integrazione concreta deve essere valutata insieme al resto dell'applicazione. Repository ufficiale ML Drift.
Il confronto con EmbeddingGemma 2 rende chiaro il confine: quest'ultimo è un modello di embedding per rappresentare contenuti, mentre ML Drift è un componente di esecuzione. Non sono alternative da mettere nella stessa classifica. Prima si definisce il compito, poi si verifica la compatibilità fra modello, runtime e piattaforma, senza presumere che l'esistenza di entrambi basti a integrarli.
Che cosa cambia con il rilascio standalone?
Un componente utilizzabile separatamente può essere valutato senza adottare necessariamente l'intero ambiente di cui faceva parte. Google descrive ML Drift come parte di LiteRT e come libreria standalone, con attenzione alle ottimizzazioni dei carichi generativi. È un'opportunità per chi sviluppa applicazioni e deve scegliere il percorso di inferenza, non un servizio consumer da attivare con un abbonamento. Descrizione del rilascio Google.
Per una PMI questo è rilevante quando esiste già un problema applicativo concreto: operare in luoghi con connettività incerta, elaborare informazioni sul dispositivo o integrare una funzione AI in un'interfaccia specifica. Il nome del runtime non dovrebbe diventare il punto di partenza del progetto. Se il compito può essere risolto più semplicemente con una funzione ordinaria, introdurre un modello aumenta il lavoro senza un beneficio dimostrato.
Il rilascio open source permette inoltre di esaminare il codice e le condizioni di distribuzione. Non comprende automaticamente supporto, manutenzione del prodotto aziendale o compatibilità futura con ogni hardware. Il team deve decidere come aggiornare il componente e quali configurazioni sostenere. Il costo del progetto rimane legato al software che si vuole consegnare e gestire, oltre alla licenza del runtime.
Come scegliere fra AI locale, cloud e una combinazione?
La scelta dipende dal compito e dai vincoli, non da una superiorità generale del locale. Un'elaborazione sul dispositivo può essere utile quando il lavoro deve proseguire senza rete. Un servizio centrale può semplificare la gestione di fonti condivise. Una combinazione può distribuire alcune attività sul dispositivo e altre sul server, ma richiede di rendere comprensibile cosa accade quando la connessione manca.
| Vincolo dell'applicazione | Domanda da verificare | Possibile conseguenza progettuale |
|---|---|---|
| Connettività intermittente | Quale parte del compito deve funzionare senza rete? | Modello e dati necessari disponibili sul dispositivo |
| Fonti aggiornate di frequente | Come si riconosce la versione valida? | Sincronizzazione esplicita e indicazione dello stato |
| Dispositivi molto diversi | Qual è la configurazione minima sostenuta? | Perimetro di compatibilità e percorso alternativo |
| Materiali riservati | Quali dati possono uscire dal dispositivo? | Mappa del trattamento e controllo dei servizi esterni |
| Qualità insufficiente del modello locale | Quale comportamento è accettabile? | Arresto, richiesta di chiarimento o percorso autorizzato diverso |
Il tema della privacy aziendale nell'AI attraversa tutte queste opzioni. Locale descrive un luogo di esecuzione; la privacy dipende anche da ciò che l'app invia, conserva e sincronizza. Per confrontare le architetture serve seguire il percorso dei dati, non fermarsi all'etichetta scelta per il modello.
Quali prove servono su smartphone, browser e desktop?
Bisogna provare il compito sull'hardware che verrà davvero utilizzato. Un risultato ottenuto su una configurazione di sviluppo non basta per un parco dispositivi diverso. Modello, precisione, GPU e driver influenzano il comportamento; l'annuncio Google descrive le piattaforme e i backend, ma non autorizza a dichiarare prestazioni identiche su tutti i sistemi. Condizioni e ambito descritti nell'annuncio.
La prova dovrebbe osservare avvio, elaborazione, uso ripetuto e interazione con il resto dell'app. Un tempo di risposta accettabile in un test isolato potrebbe non descrivere il lavoro mentre la persona usa altre funzioni. Vanno considerate anche memoria, consumo del dispositivo e gestione degli errori. Non vengono indicati valori universali: i criteri devono essere fissati sul contesto d'uso e misurati nella configurazione prevista.
Nel browser occorre verificare il percorso effettivamente disponibile nell'ambiente scelto, senza dedurre la compatibilità dalla sola presenza di WebGPU fra i backend. Per desktop va mantenuta la distinzione di stato: Google descrive Windows e Linux come preview nell'annuncio. Un progetto destinato alla produzione deve valutare questo limite prima di promettere supporto a tutte le postazioni dell'organizzazione.
Come capire se la qualità dipende dal modello o dall'esecuzione?
Una risposta poco utile può avere cause diverse. Il modello potrebbe non essere adatto al compito, il contenuto di ingresso potrebbe essere incompleto oppure una configurazione dell'esecuzione potrebbe modificare il risultato. Per questo conviene conservare esempi ripetibili e cambiare un elemento per volta. Se si aggiornano contemporaneamente modello, precisione e interfaccia, diventa più difficile capire quale modifica abbia aiutato.
Il criterio principale rimane il lavoro richiesto. Una classificazione deve essere corretta sui casi previsti; una funzione generativa deve produrre risultati che la persona possa usare o verificare. Una misura tecnica migliore non compensa una qualità insufficiente. La prova deve includere anche ciò che l'app non dovrebbe fare, come trasformare un dato mancante in una risposta presentata con certezza.
Questo vale anche per strumenti rivolti agli sviluppatori. Il caso di Copilot CLI con Ollama e modelli locali riguarda un'altra integrazione e non dimostra automaticamente la fattibilità di un'app basata su ML Drift. Il punto condiviso è separare modello, percorso di esecuzione e strumenti accessibili, verificando il compito invece di giudicare soltanto l'etichetta «locale».
Il prototipo funziona sul computer dello sviluppatore, ma non sul dispositivo del team?
Confronta configurazione hardware, GPU, driver, versione del runtime, modello e precisione. Riduci il caso al compito che fallisce e conserva un ingresso ripetibile. Verifica i requisiti documentati prima di cambiare il prompt: il problema potrebbe appartenere all'esecuzione o alla compatibilità, non al modo in cui viene formulata la richiesta.
Un'app per tecnici fuori sede: scenario ipotetico
Immaginiamo una PMI di manutenzione che vuole aiutare i tecnici a consultare informazioni operative in luoghi dove la connessione è instabile. In questo scenario ipotetico una funzione locale potrebbe classificare una nota o supportare una ricerca su materiali disponibili sul dispositivo. Prima di scegliere ML Drift, il team dovrebbe definire quale parte del compito richiede un modello e quale può essere gestita da una ricerca o da campi ordinari.
La prova utilizzerebbe dispositivi rappresentativi, con un archivio autorizzato e riconoscibile come versione. L'interfaccia mostrerebbe se i contenuti sono aggiornati e quali operazioni richiedono rete. Se il materiale necessario non è presente, l'app dovrebbe dirlo invece di produrre istruzioni plausibili. L'obiettivo non sarebbe sostituire la responsabilità del tecnico, ma rendere accessibili informazioni verificabili nelle condizioni previste.
Il test includerebbe l'uso ripetuto durante il lavoro, oltre alla singola dimostrazione. Si osserverebbe se l'app rimane utilizzabile, come gestisce un'interruzione e cosa succede quando torna la connessione. La scelta finale dipenderebbe dal comportamento dell'intero prodotto. La disponibilità di un runtime open source, da sola, non dimostrerebbe né la qualità delle istruzioni né l'utilità operativa per i tecnici.
Uno studio professionale con app desktop: scenario ipotetico
Consideriamo uno studio che vuole preparare appunti interni su materiali riservati, senza affidare ogni elaborazione a un servizio remoto. In questo secondo scenario ipotetico il progetto potrebbe valutare una funzione locale con un perimetro preciso: assistere la preparazione di una bozza e mantenere una revisione obbligatoria prima dell'utilizzo professionale.
La prova partirebbe dalle postazioni effettive e dal modello adatto al compito. Il team verificherebbe che i documenti utilizzati, le copie temporanee e gli eventuali log seguano le regole dello studio. Non basterebbe osservare che l'inferenza avviene sul computer: un componente di sincronizzazione o monitoraggio potrebbe avere un percorso diverso. La sicurezza dei dati nell'AI riguarda anche queste dipendenze.
Per il desktop si valuterebbe inoltre lo stato preview indicato nell'annuncio e il supporto che lo studio è disposto a sostenere. Un prototipo può servire a capire la fattibilità senza trasformarsi subito in una promessa di distribuzione a tutte le postazioni. Se la qualità della bozza non è sufficiente, il risultato della prova può essere restringere il compito, scegliere un'altra architettura o mantenere una procedura ordinaria.
Quali parti restano da progettare per funzionare senza rete?
Un'app offline deve avere sul dispositivo ciò che serve al compito: modello, dati autorizzati e regole operative. Deve anche spiegare quali informazioni potrebbero essere superate. Se un catalogo cambia, la versione locale non si aggiorna per effetto del runtime. Serve una politica di sincronizzazione e un comportamento comprensibile quando l'aggiornamento non è disponibile.
La revoca degli accessi richiede una scelta specifica. Una copia locale può rimanere sul dispositivo anche quando cambiano le autorizzazioni del server, se l'applicazione non prevede come gestirlo. Il progetto deve quindi definire distribuzione dei contenuti, accesso al dispositivo e ciclo di vita dei materiali. Non si tratta di una funzione da presumere leggendo la licenza del motore di inferenza.
Va progettato anche l'aggiornamento del modello. Prima di distribuire una nuova versione conviene ripetere i casi di prova e controllare che l'app riconosca la configurazione utilizzata. Se il risultato cambia, il team deve poter ricostruire quali componenti erano in uso. Questa disciplina è particolarmente utile quando un cliente utilizza dispositivi aggiornati in momenti diversi e segnala un comportamento che non compare sulla macchina di sviluppo.
Che cosa deve mostrare l'app mentre il modello lavora?
La prova tecnica dovrebbe includere l'esperienza della persona. Un modello che richiede un'attesa deve essere inserito in un'interfaccia che distingua elaborazione, risultato pronto ed errore. Se il compito può essere interrotto, il comando di annullamento e lo stato successivo vanno progettati e provati. Il runtime non decide automaticamente quale messaggio sia comprensibile per l'utente.
È utile distinguere anche il primo avvio dagli utilizzi successivi. Caricamento dei componenti, disponibilità dei dati e recupero dopo un'interruzione possono influenzare il percorso percepito. Non serve promettere un tempo astratto: serve osservare se la persona riesce a completare il proprio lavoro e se comprende cosa sta accadendo. Quando il dispositivo non soddisfa i requisiti, l'app dovrebbe spiegare il limite e offrire il percorso previsto dal progetto, anziché lasciare una funzione apparentemente bloccata.
Gli errori che fanno scegliere il runtime troppo presto
Il primo è chiamare ML Drift «nuovo modello Google» e aspettarsi una chat pronta. Il secondo è confondere il rilascio standalone con la nascita del motore: il lavoro era già presente nella ricerca, come mostra il paper CVPR precedente sull'inferenza GPU locale. Il terzo è trasferire misure di una configurazione a dispositivi diversi senza prova.
Un altro errore è stimare solo la licenza e ignorare integrazione, aggiornamenti e assistenza. Infine, non bisogna trasformare la scelta locale in un vincolo ideologico. Un agente con attività persistente in cloud, come quello annunciato per Gemini agent, affronta esigenze diverse. Il confronto utile riguarda dove deve avvenire il lavoro e quali dati servono, non un vincitore universale fra device e server.
Le basi degli agenti AI per aziende aiutano a separare l'obiettivo del processo dalla tecnologia di esecuzione: un componente locale può sostenere un compito preciso senza assumere da solo il ruolo di un agente completo.
Se il tuo progetto richiede AI sul dispositivo, possiamo preparare una prova di fattibilità per un'app locale sul compito e sull'hardware previsti. Partiamo da qualità attesa, dati disponibili e comportamento senza rete. Solo dopo scegliamo il runtime e le dipendenze, con criteri che rendano verificabile la decisione di proseguire. Se il componente deve collegarsi a gestionali e archivi, il percorso di software aziendale su misura comprende anche queste integrazioni.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 AI e privacy aziendale: cosa succede ai tuoi dati nei tool AI
 AI e sicurezza dei dati: rischi concreti e come gestirli
 Agenti AI per aziende: quando servono davvero e come si adottano
 EmbeddingGemma 2: ricerca AI locale nei documenti aziendali
 Copilot CLI trova i modelli Ollama locali: requisiti e limiti della modalità offline
 Gemini agent per aziende: cosa ha annunciato Google e cosa verificare prima di usarlo
FAQ
ML Drift è un modello AI?
No. È un motore di esecuzione per inferenza AI locale su GPU. Il modello rimane un componente distinto, con propri pesi, caratteristiche e condizioni d’uso.
Qual è la novità dell’annuncio ML Drift?
Google annuncia il rilascio open source standalone del motore. ML Drift era già presente nell’ecosistema LiteRT e in lavori di ricerca precedenti.
Quali backend utilizza ML Drift?
L’annuncio e il repository descrivono backend come OpenGL ES, OpenCL, Metal e WebGPU. La disponibilità concreta va verificata sulla piattaforma e sul dispositivo previsti.
ML Drift funziona su qualsiasi computer o telefono?
Non si può dedurlo dall’annuncio. Compatibilità e prestazioni dipendono da modello, precisione, GPU, driver e integrazione dell’applicazione.
ML Drift rende un’app automaticamente offline?
No. Occorre progettare disponibilità locale di modello e dati, interfaccia, aggiornamenti e comportamento senza rete. Altri servizi dell’app potrebbero continuare a usare connessioni esterne.
Come valutare un progetto con ML Drift?
Prepara una prova del compito su dispositivi rappresentativi e osserva qualità, memoria, attese e comportamento durante l’uso. La scelta del runtime va verificata insieme al modello e all’intera applicazione.