
Claude Fable 5.2 benchmark: cosa misurano davvero e come verificarli
Claude Fable 5.2 benchmark spiegati in parole semplici: FrontierCode, OSWorld, AutomationBench e gli altri, con i numeri di Anthropic e come testarli.
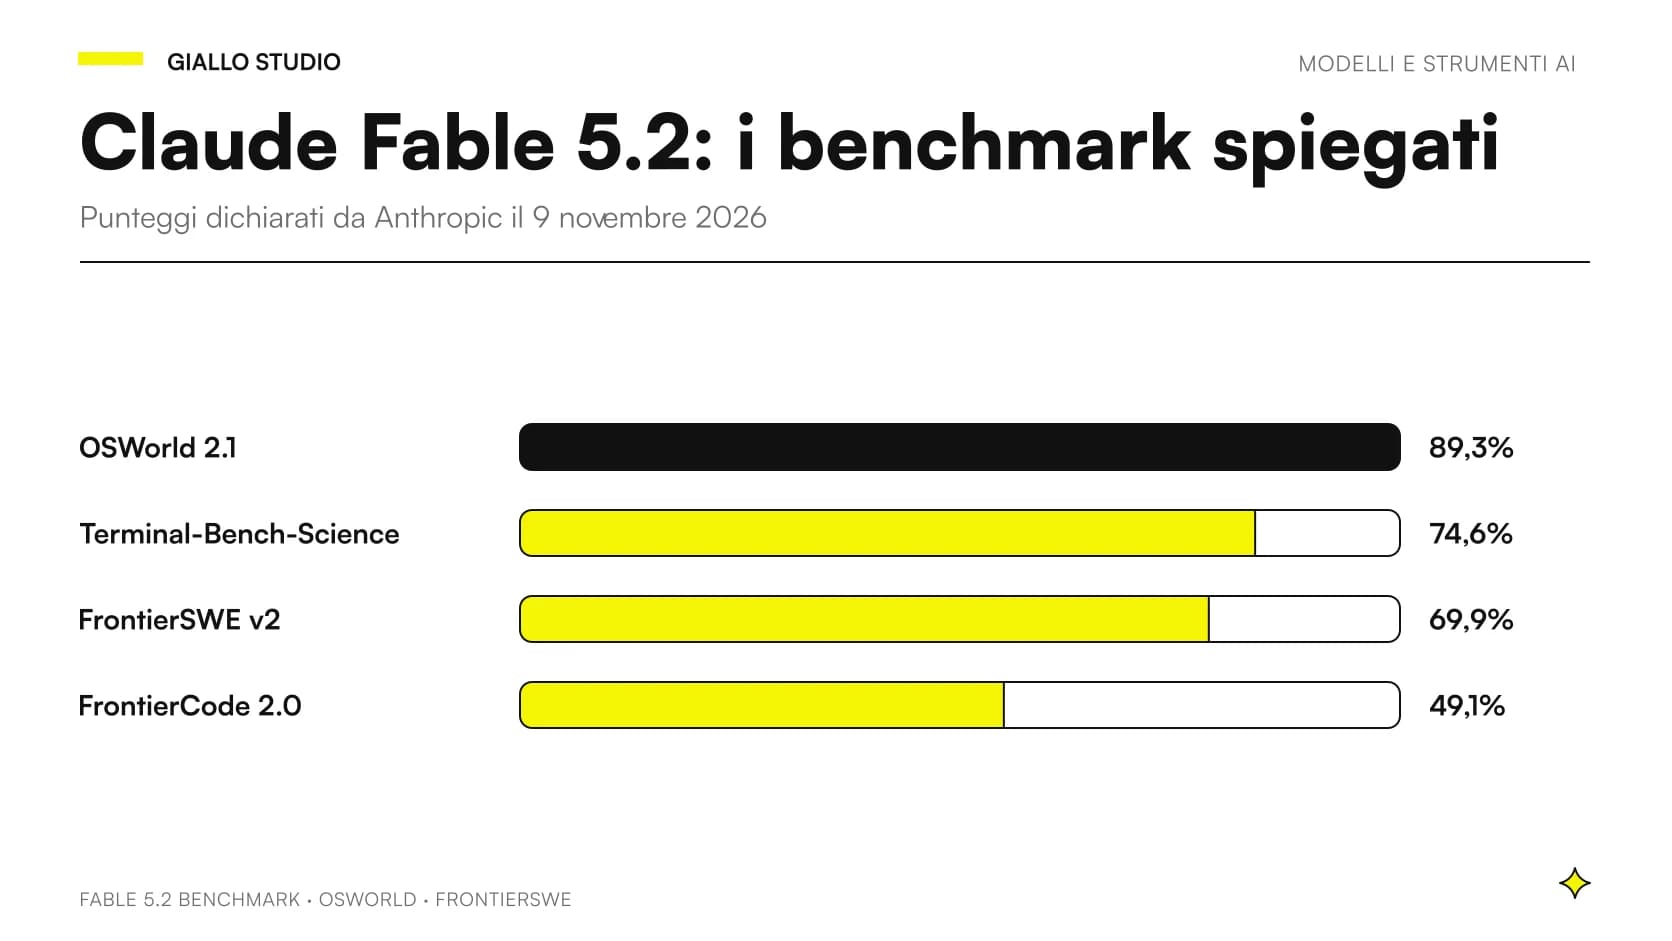
Claude Fable 5.2 è un modello Anthropic rilasciato il 9 novembre 2026 e i suoi benchmark dichiarati lo collocano sopra Opus 5.5 in quasi tutte le prove della tabella ufficiale. Il dato più citato è FrontierCode 2.0: 49,1% a effort Xhigh, contro 32,4% di Fable 5.1 e 45,5% di Opus 5.5, secondo la pagina di annuncio di Anthropic consultata il 9 novembre 2026.
Una percentuale da sola, però, non dice se il modello serve a te. In questa guida spieghiamo in parole semplici che cosa misura ogni test, quali numeri ha ottenuto Fable 5.2, quanto è cresciuto rispetto alla 5.1 e perché i risultati scelti dal produttore vanno sempre verificati sui propri documenti. Per la scheda tecnica completa c'è la guida Claude Fable 5.2: cos'è, prezzo e cosa cambia.
In sintesi
- Fable 5.2 ottiene 49,1% su FrontierCode 2.0 a effort Xhigh, il punteggio più alto tra i modelli rilasciati che Anthropic ha messo alla prova, secondo la pagina ufficiale.
- Rispetto a Fable 5.1 migliora su tutti i test della tabella, con salti da 4,6 punti percentuali (AA-Briefcase, punteggio a rubrica) fino a 37,3 (RoboDojo Sim).
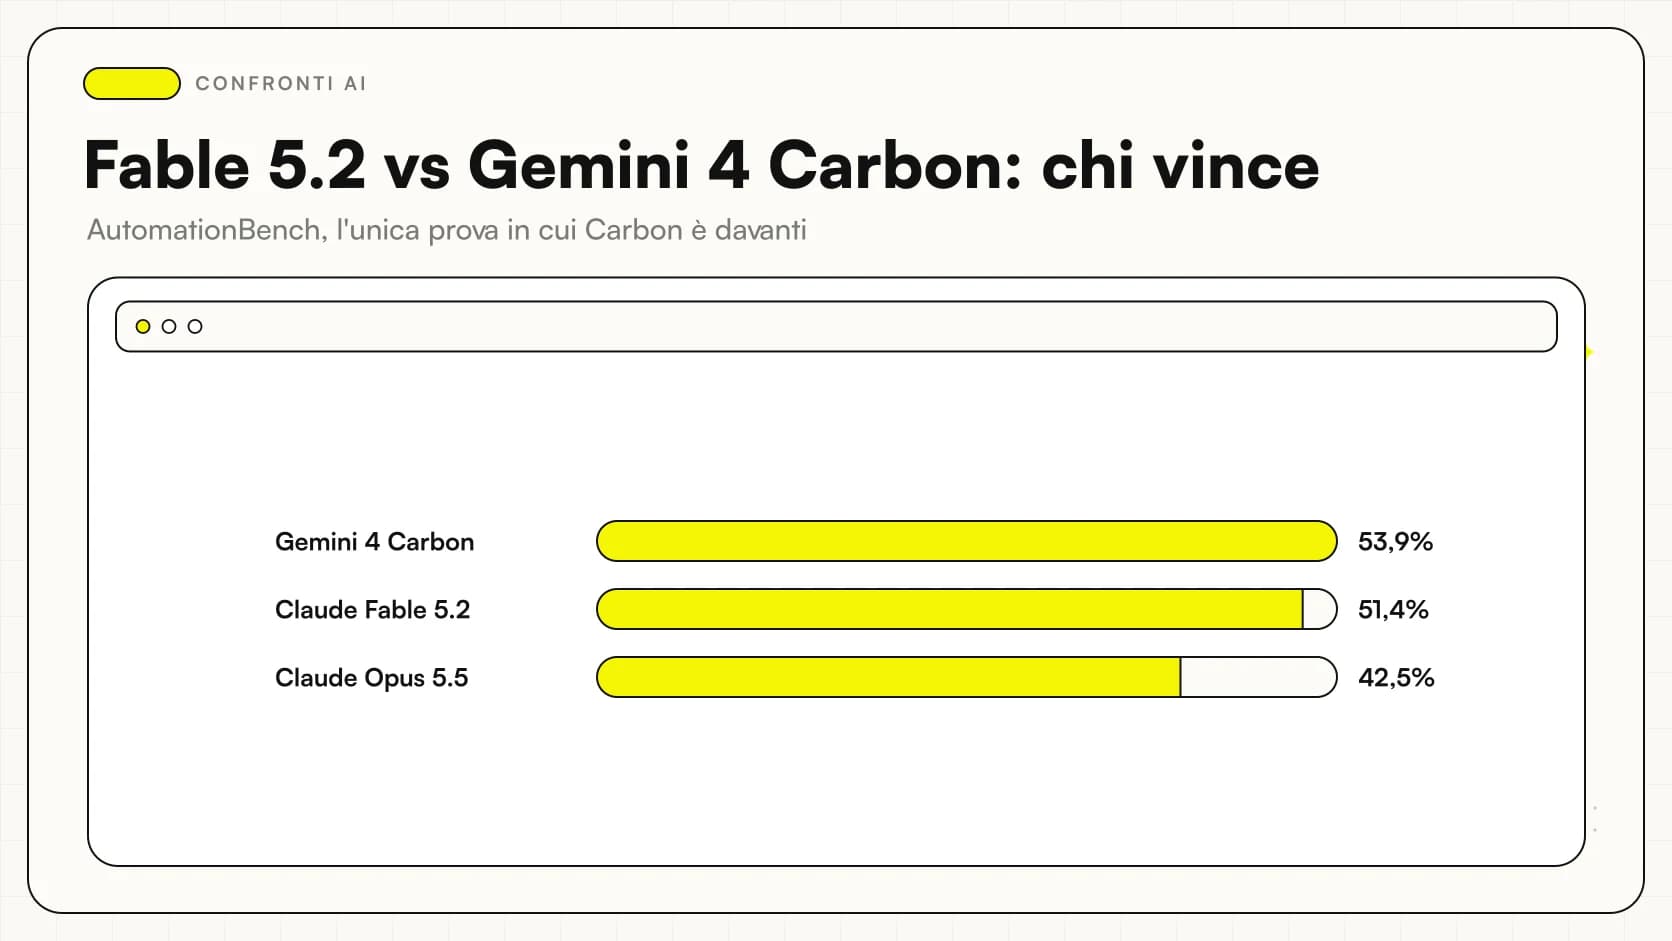
- Non vince ovunque: su AutomationBench è davanti Gemini 4 Carbon (53,9% contro 51,4%), dato riportato dalla stessa tabella.
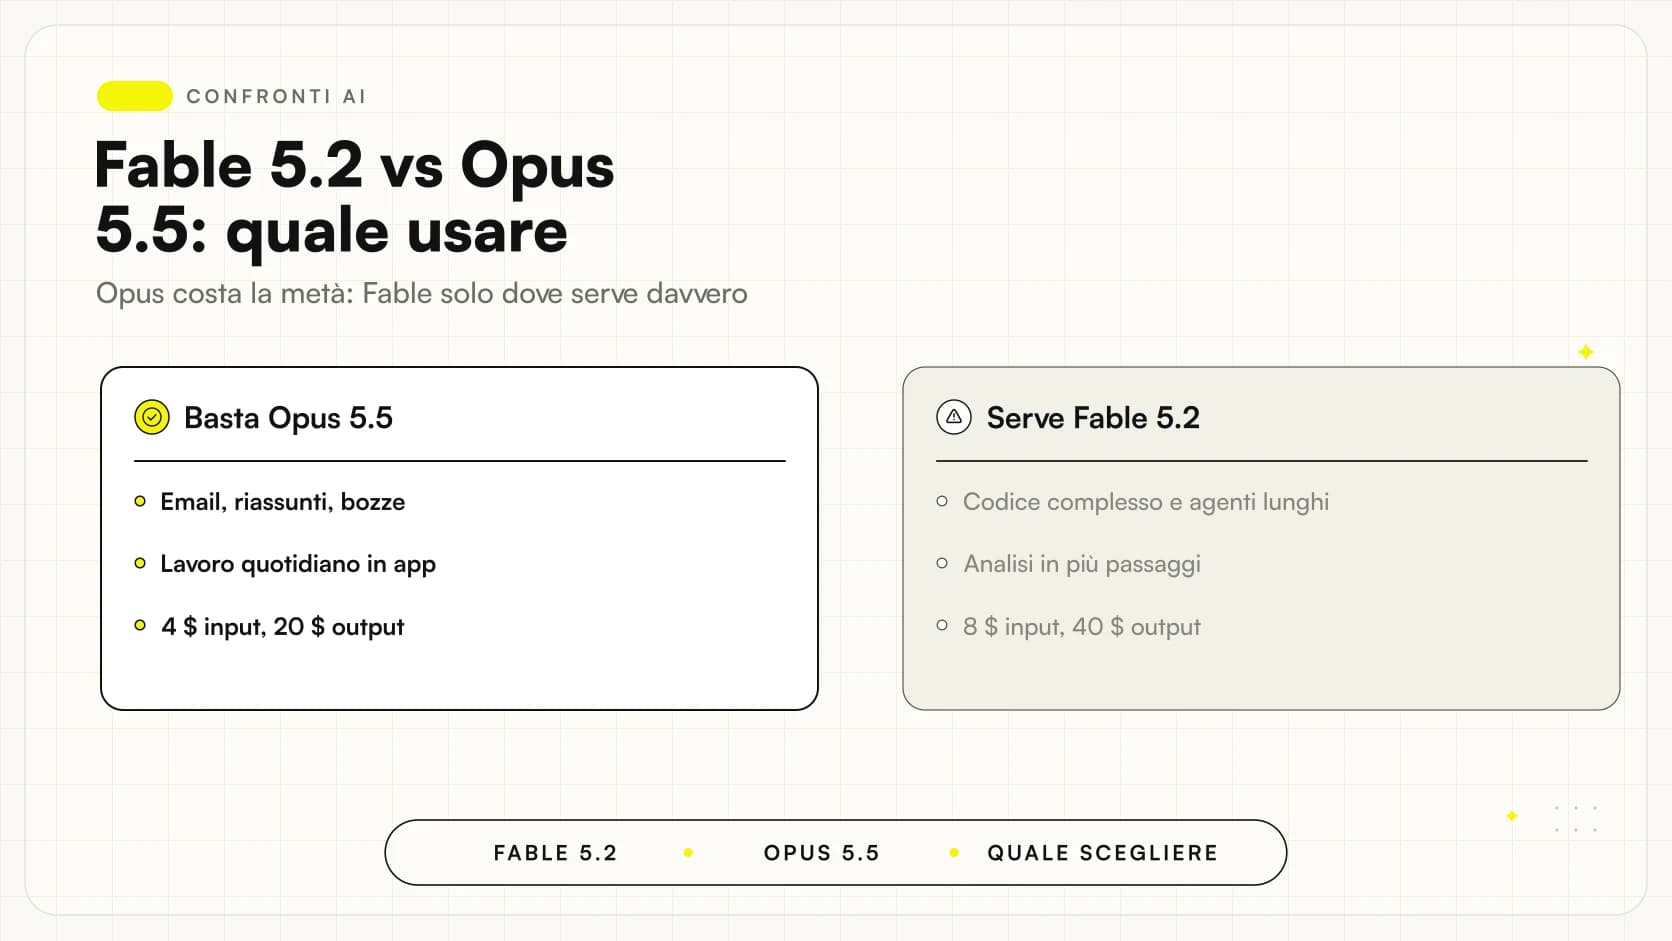
- Il confronto più utile è punteggio e costo: a effort High Fable 5.2 pareggia Opus 5.5 al massimo su FrontierCode per circa metà del costo per compito, come dichiarato da Anthropic.
- Tutti i numeri sono scelti ed eseguiti da Anthropic e non sono stati replicati da terzi: servono per restringere la scelta, non per chiuderla.
- Il test decisivo è il vostro: 20-30 compiti reali, stesso prompt, più modelli, conteggio di errori, tempi e costo.
Quali benchmark ha dichiarato Anthropic per Fable 5.2?
Anthropic pubblica una tabella con cinque colonne: Fable 5.2, Fable 5.1, Opus 5.5, GPT-6 Astra e Gemini 4 Carbon. Ecco le righe confrontabili con tutti i modelli, riprese dalla pagina di annuncio consultata il 9 novembre 2026.
| Benchmark (punteggio in %) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (Fable a Xhigh) | 49,1 | 32,4 | 45,5 | 42,8 | 41,1 |
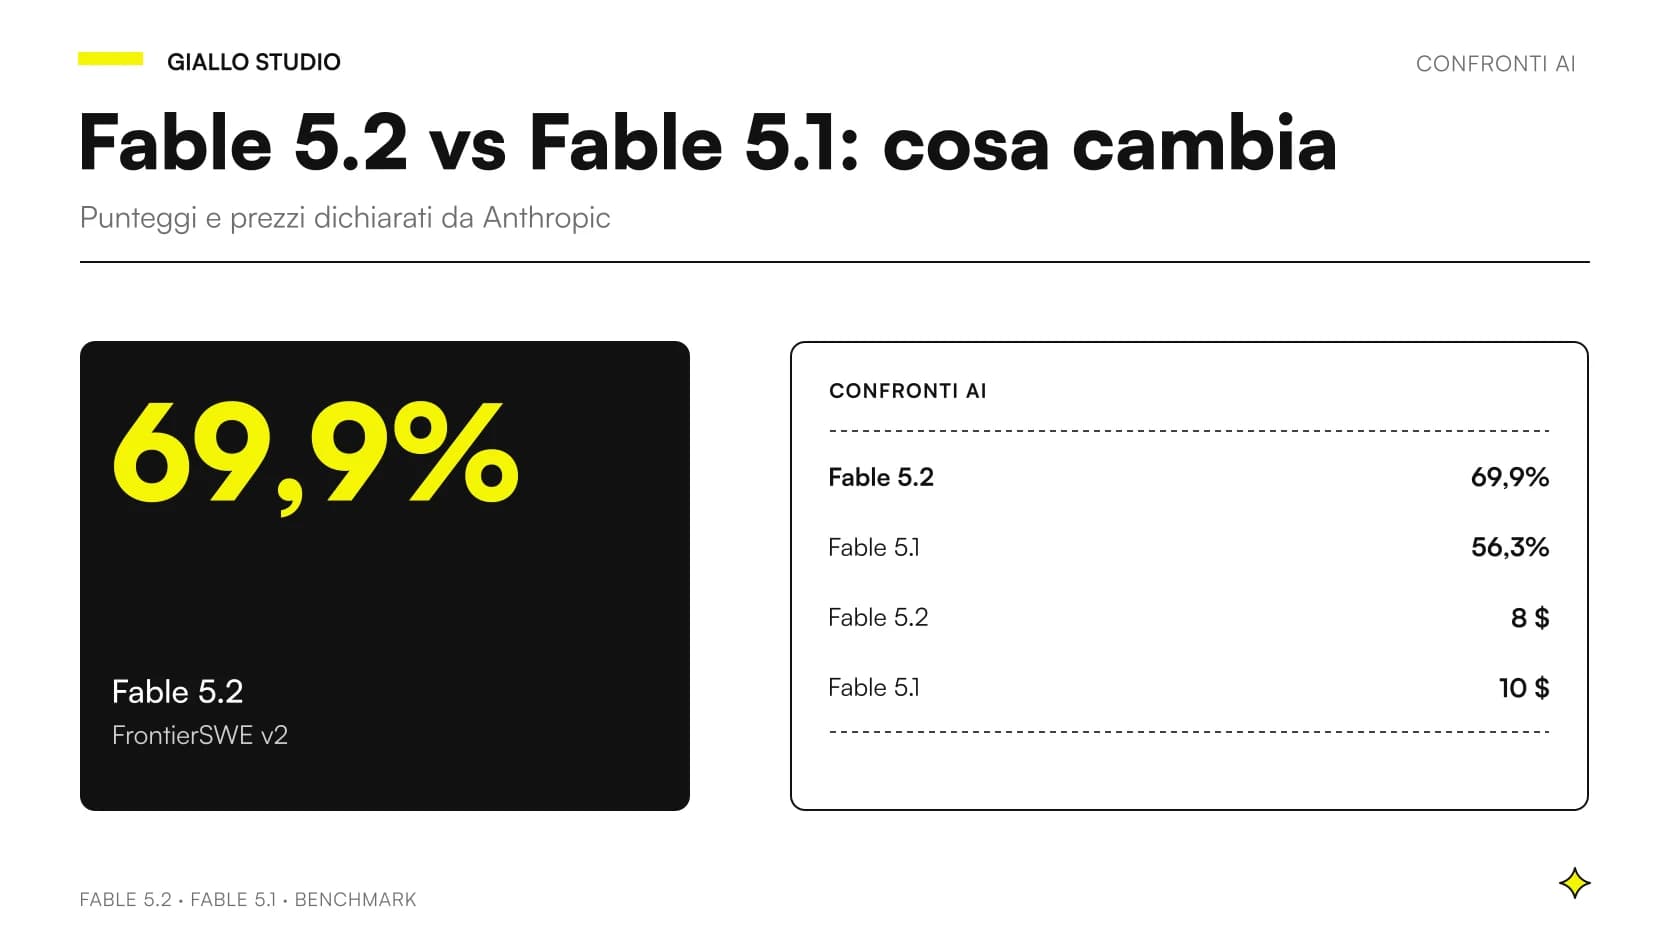
| FrontierSWE v2 | 69,9 | 56,3 | 62,3 | 65,5 | 61,2 |
| AutomationBench | 51,4 | 31,4 | 42,5 | 41,4 | 53,9 |
| Terminal-Bench-Science 0.1 | 74,6 | 52,6 | 58,7 | 68,1 | 64,8 |
| OSWorld 2.1 (set offline, parziale) | 89,3 | 83,5 | 87,2 | 79,5 | 81,5 |
| Chartography (senza strumenti) | 73,4 | 44,8 | 64,4 | 71,0 | 72,5 |
| AA-Briefcase v1.1 (punteggio a rubrica) | 66,1 | 61,5 | 61,2 | 52,0 | 61,8 |
Altre prove, sempre secondo la stessa pagina, sono confrontate solo con alcuni modelli: Humanity's Last Exam con strumenti (74,2% contro 65,6% di Fable 5.1, 67,7% di Opus 5.5 e 57,2% di GPT-6 Astra), WANDR (82,1% contro 68,7% e 72,3%) e Remote Labor Index (41,3% contro 17,9%, 21,3% e 20,8%).
Due avvertenze della stessa pagina. Primo: i punteggi di Fable 5.2, Fable 5.1 e Opus 5.5 sono con le salvaguardie attive, e ogni modello è mostrato al massimo livello di effort disponibile, salvo diversa indicazione. Secondo: RoboDojo Sim è stato eseguito internamente da Anthropic. Non sono quindi esami indipendenti.
Che cosa misura ciascun benchmark, in parole semplici?
Il nome dice poco, il compito dice tutto. Ecco i test in ordine di rilevanza per un'azienda. Dove la pagina ufficiale non spiega il metodo, lo scriviamo: per i dettagli Anthropic rimanda alla system card.
| Benchmark | Che cosa misura | Cosa ti dice |
|---|---|---|
| FrontierCode 2.0 | Se le modifiche al codice proposte dal modello verrebbero accettate dai manutentori di repository open source (definizione di Anthropic) | Qualità del codice su progetti reali, non su esercizi |
| FrontierSWE v2 | Categoria «agentic coding», cioè programmazione svolta in autonomia da un agente | Capacità di portare avanti lavori di sviluppo a più passaggi |
| AutomationBench | Categoria «business workflows», flussi di lavoro aziendali | Il test più vicino a un'automazione di processo |
| Terminal-Bench-Science 0.1 | Categoria «agentic scientific research», ricerca scientifica svolta da un agente | Affidabilità su compiti tecnici lunghi da riga di comando |
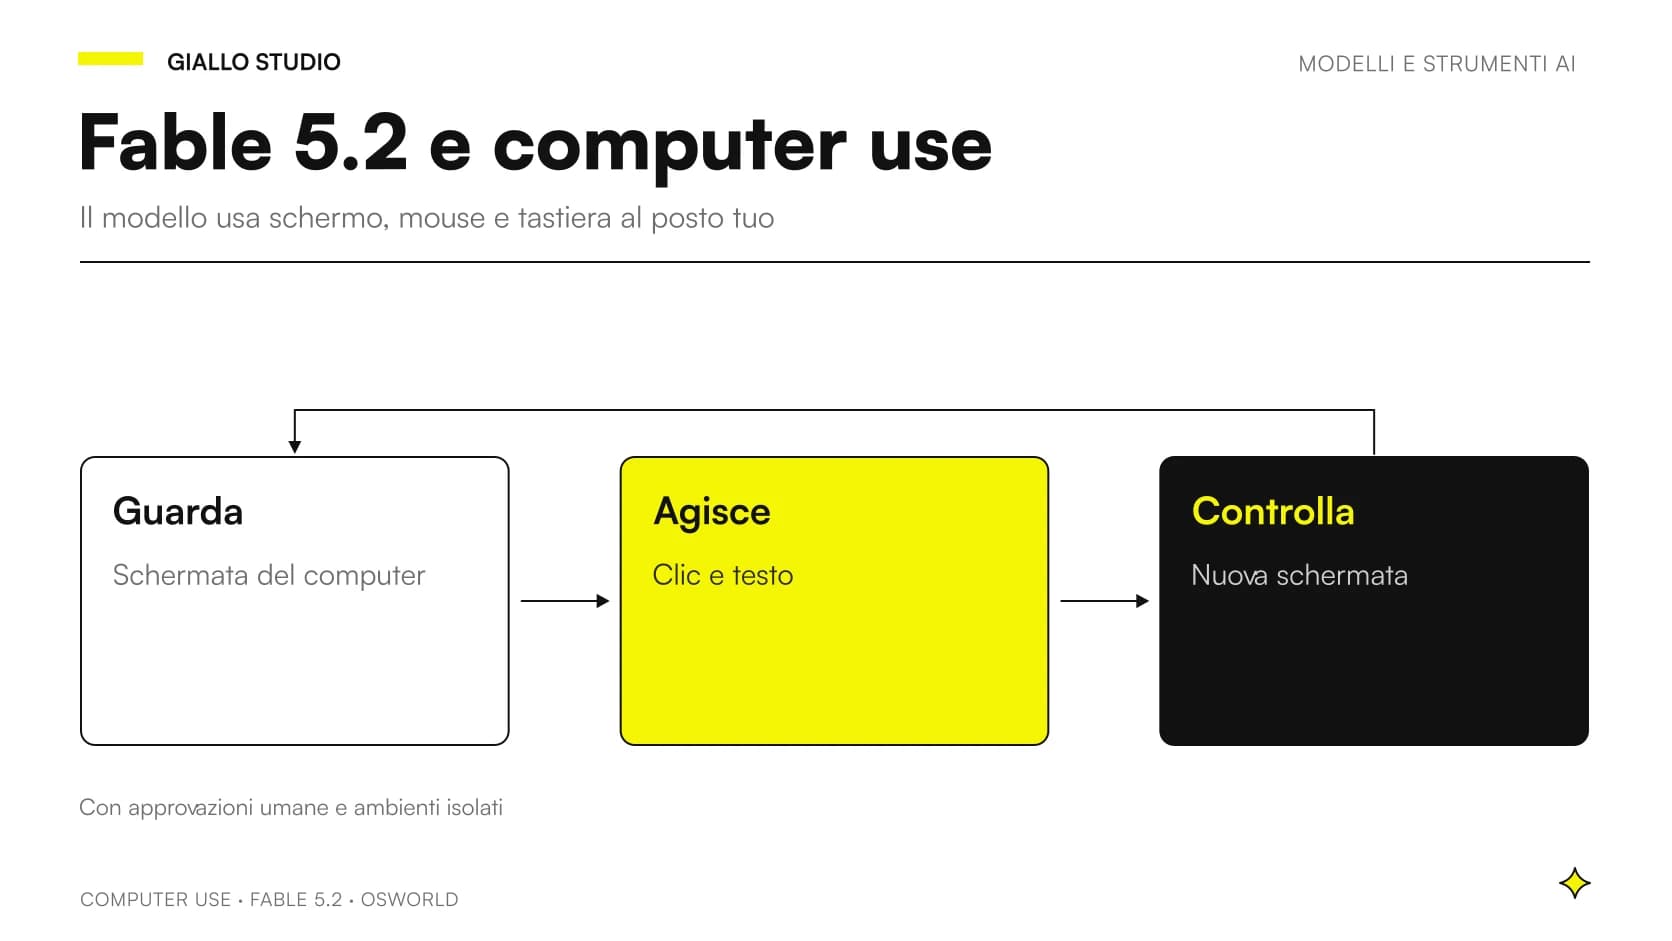
| OSWorld 2.1 | Categoria «computer use», uso di un computer come farebbe una persona | Utile se vuoi un agente che opera su software e schermate |
| Humanity's Last Exam | Conoscenza accademica di livello esperto e ragionamento (definizione di Anthropic) | Ragionamento difficile, poco legato al lavoro d'ufficio |
| Chartography | Quanto bene il modello legge grafici e figure (definizione di Anthropic) | Utile per report, bilanci, schede tecniche con grafici |
| RoboDojo Sim | Controllo di un robot simulato a due braccia partendo da immagini di telecamera (definizione di Anthropic) | Per ora interessa la robotica, non l'ufficio |
| AA-Briefcase v1.1 | Categoria «knowledge work», lavoro di conoscenza d'ufficio | Compiti da analista o impiegato qualificato |
| Remote Labor Index | Categoria «knowledge work», lavoro a distanza | Quanto lavoro reale un modello porta a termine |
WANDR, citato da Anthropic nelle curve di costo, è un test di Perplexity su grandi attività di raccolta dati: riguarda gli agenti che cercano e riordinano informazioni sul web.
Quanto è migliorato Fable 5.2 rispetto a Fable 5.1?
Su ogni riga della tabella ufficiale il punteggio sale. Calcolando le differenze sui dati della pagina Anthropic, il quadro è questo:
- Salti grandi (dati Anthropic): RoboDojo Sim da 27,6% a 64,9%, Chartography da 44,8% a 73,4%, Remote Labor Index da 17,9% a 41,3%, Terminal-Bench-Science da 52,6% a 74,6%.
- Salti medi: AutomationBench da 31,4% a 51,4%, FrontierCode 2.0 da 32,4% a 49,1%, FrontierSWE v2 da 56,3% a 69,9%.
- Salti piccoli: Humanity's Last Exam da 65,6% a 74,2%, OSWorld 2.1 da 83,5% a 89,3%, AA-Briefcase da 61,5% a 66,1%.
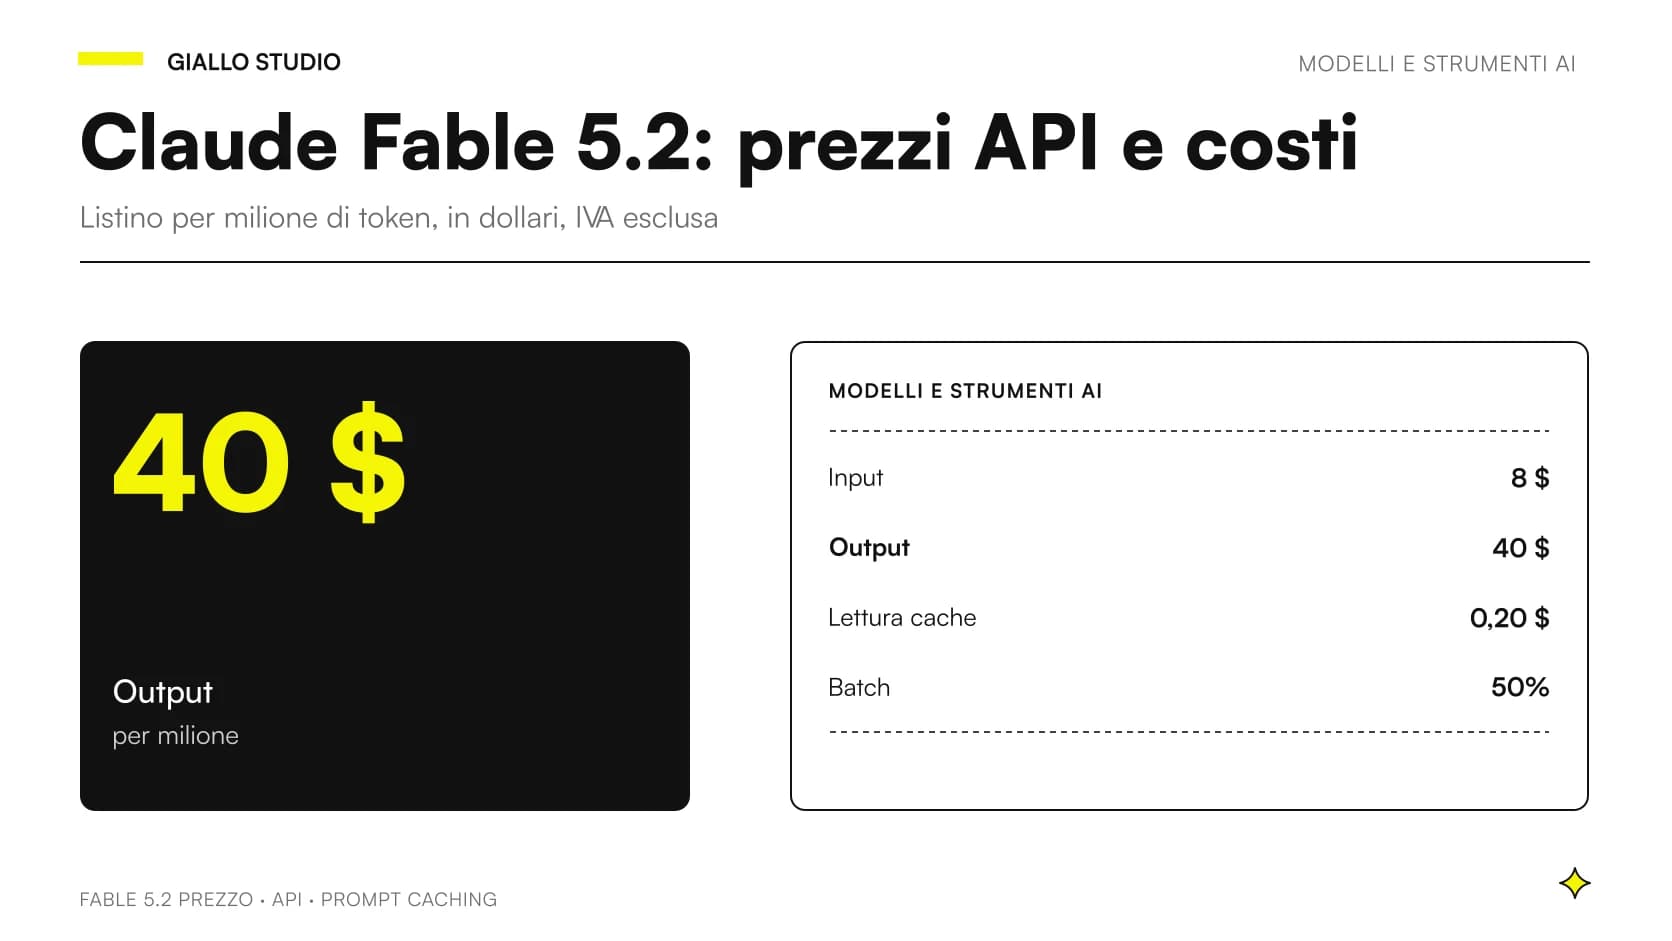
Nel frattempo il prezzo è sceso: 8 dollari per milione di token in input e 40 in output, contro 10 e 50 della 5.1, secondo la scheda della documentazione. Chi usa ancora la 5.1 ottiene quindi più punteggio pagando meno. Il confronto completo è in Fable 5.2 vs Fable 5.1.
Dove Fable 5.2 non vince?
Tre punti da tenere presenti, tutti dalla tabella ufficiale.
- AutomationBench: Gemini 4 Carbon ottiene 53,9%, Fable 5.2 51,4%. È proprio il test sui flussi di lavoro aziendali.
- AA-Briefcase: la riga a punteggio con griglia di valutazione dà Fable 5.2 in testa (66,1 contro 61,2 di Opus 5.5), ma la pagina riporta anche una riga Elo, che confronta i modelli a coppie, con valori da 1569 a 1800 senza etichetta per colonna. Se l'ordine è quello delle colonne, Opus 5.5 avrebbe 1800 e Fable 5.2 1785: lo scarto sarebbe piccolo, ma lo stesso test darebbe ordini diversi a seconda di come si legge.
- Chartography: Fable 5.2 è avanti (73,4%), ma Gemini 4 Carbon (72,5%) e GPT-6 Astra (71,0%) sono vicini.
Per la sfida diretta con gli altri due modelli rimandiamo a Fable 5.2 vs GPT-6 Astra e a Fable 5.2 vs Gemini 4 Carbon. I test di GPT-6 Astra sono analizzati in GPT-6 Astra: benchmark, quelli di Gemini in Gemini 4 Carbon: benchmark e confronto.
Contano di più i punteggi o il costo per compito?
Il costo. Anthropic stessa presenta i risultati come curve «punteggio contro costo» ai diversi livelli di effort, e i casi citati sono i più utili per chi paga il conto. Tutti dichiarati da Anthropic nella pagina di annuncio:
| Benchmark | Fable 5.2 a effort | Risultato dichiarato |
|---|---|---|
| FrontierCode 2.0 | High | 45,3% contro 45,5% di Opus 5.5 al massimo, per circa metà del costo per compito |
| WANDR | Medium | Pari al miglior punteggio di Opus 5.5, per circa il 40% del costo per compito |
| Humanity's Last Exam | Low | Pari al miglior punteggio di Opus 5.5, per meno di un decimo del costo |
| Chartography | Medium | 66,4% contro 64,4% di Opus 5.5 al massimo, per meno di un decimo del costo |
| BenchCAD 2.1 | Max | 83,5 contro 65,3 di Opus 5.5 e 44,4 di Fable 5.1 (scala 0-100) |
Il messaggio operativo è che il livello di effort cambia il conto più del nome del modello. Come scegliere l'effort lo spieghiamo in Fable 5.2: livelli di ragionamento; sui prezzi in dettaglio c'è Claude Fable 5.2: prezzi API. Per un confronto sui tipi di lavoro vedi Fable 5.2 vs Opus 5.5.
Perché i benchmark del produttore non bastano?
Quattro motivi concreti, nessuno è un'accusa: valgono per qualsiasi produttore.
- Chi sceglie i test sceglie la storia. La tabella contiene quello che Anthropic ha ritenuto rappresentativo.
- Il livello di effort cambia. Ogni modello è mostrato al massimo disponibile salvo diversa indicazione: nell'uso quotidiano userai probabilmente un livello più basso. Nelle app Claude e in Claude Code il predefinito è Medium, secondo la pagina di annuncio.
- I compiti standard non sono i vostri. Un benchmark di codice open source non dice come il modello legge un vostro capitolato o un listino con formati strani.
- Il costo reale dipende da come lavori. Più agenti, più passaggi, più token: i limiti noti di Fable 5.2 elencati nella pagina delle novità includono proprio il costo più alto quando si usano molti subagent.
Anche Anthropic invita alla prudenza nella scelta: per la maggior parte dei lavori di codice e di conoscenza consiglia di partire da Opus 5.5 e salire a Fable solo se serve.
Come fa un'azienda a testare Fable 5.2 sui propri casi?
Un esempio dichiarato: l'ufficio tecnico di un'azienda meccanica a Brescia vuole capire se un modello può leggere le richieste di offerta dei clienti, estrarre materiali, quantità e tolleranze e preparare una bozza di preventivo. Il test si fa così.
- Raccogli i compiti veri. Prendi 20-30 richieste già gestite da una persona, comprese quelle storte: PDF scansionati, email incomplete, disegni con note a mano.
- Scrivi prima la risposta giusta. Per ogni caso fai preparare alla persona che le conosce la soluzione corretta e un criterio chiaro: campo giusto, campo sbagliato, campo mancante.
- Usa lo stesso prompt per tutti. Un prompt unico, senza ritocchi caso per caso, su Opus 5.5 e Fable 5.2. Per Fable prova almeno due livelli di effort, per esempio Medium e High.
- Conta errori, tempi e costo. Per ogni modello e livello annota gli errori, le correzioni a mano necessarie e il costo per compito, che trovi nei consumi di token.
- Decidi con una regola semplice. Se il modello più economico sbaglia in modo accettabile, usa quello. Fable ha senso quando l'errore costa più dei token in più.
Un secondo esempio: uno studio di commercialisti che vuole usare un modello per controllare la coerenza tra bilancio e note. Qui la prova guarda soprattutto gli errori non segnalati: quante incoerenze il modello trova e quante inventa. Sono due numeri che nessuna tabella ufficiale riporta per i vostri documenti.
I benchmark servono per
- Restringere la scelta a due o tre modelli
- Capire in quale famiglia di compiti un modello è forte
- Valutare quanto costa salire di livello di effort
I benchmark non servono per
- Dire che un modello non sbaglierà sui vostri documenti
- Stimare il costo reale di un flusso con molti passaggi
- Sostituire un test con persone che conoscono il lavoro
Quali errori evitare quando si leggono i benchmark?
- Non confrontare punteggi di effort diversi. Controlla sempre a quale livello è stato ottenuto il numero.
- Non fidarti del vincitore assoluto. Su AutomationBench conta Gemini 4 Carbon, su Chartography la distanza è di meno di un punto.
- Non ignorare il costo. Un punto in più di accuratezza a doppio costo non sempre conviene.
- Non scambiare un test di laboratorio per un collaudo. RoboDojo Sim riguarda robot simulati, non il vostro magazzino.
- Non saltare la prova sui vostri dati. È la sola che dice qualcosa sul vostro caso.
Da dove cominciare, in pratica?
Parti da Opus 5.5 su un campione di compiti e sali a Fable 5.2 solo dove Opus sbaglia. Se i risultati sono vicini, scegli il più economico; se Fable risolve compiti che Opus non risolve, calcola quanto vale quell'errore evitato. Per i flussi con più agenti, guarda anche il miglior modello AI per agenti e il confronto Claude Opus 5.5: benchmark e prezzi. Per la parte organizzativa, l'adozione in azienda è trattata in Claude Fable 5.2 per aziende.
Se vuoi impostare questo test sui tuoi documenti e non solo leggerlo, la consulenza AI di Giallo Studio prepara con te il campione di compiti, i criteri di valutazione e il confronto dei costi, così la scelta del modello si basa sui tuoi dati e non sulla tabella di un produttore.
Metodo e fonti delle guide di Giallo Studio
Vuoi applicarlo alla tua azienda?In 30 minuti, gratis: il processo da automatizzare per primo e il ritorno stimato, per iscritto.
Prenota l’audit gratuitoCome lo applichiamo in azienda
Risorse correlate
 Claude computer use con Fable 5.2: usare il PC da solo
 Claude Fable 5.2: cos'è, cosa cambia, quanto costa e a chi serve
 Fable 5.1 vs 5.2: cosa cambia davvero e se conviene aggiornare
 Fable 5.2 vs Opus 5.5: quale usare e quando
 Fable 5.2 vs Astra: benchmark e prezzi di Claude e GPT-6 a confronto
 Fable 5.2 vs Gemini 4 Carbon: chi vince dove
 Claude Fable 5.2 prezzo: listino API e costi reali
 GPT-6 Astra: tutti i benchmark ufficiali
 Claude Opus 5.5: benchmark ufficiali, prezzi e confronto con Fable 5.1 e GPT-6 Astra
FAQ
Quali sono i benchmark di Claude Fable 5.2?
Nella tabella ufficiale di Anthropic del 9 novembre 2026 Fable 5.2 ottiene 49,1% su FrontierCode 2.0 (Xhigh), 69,9% su FrontierSWE v2, 51,4% su AutomationBench, 74,6% su Terminal-Bench-Science, 89,3% su OSWorld 2.1, 74,2% su Humanity's Last Exam con strumenti e 73,4% su Chartography senza strumenti. Sono numeri dichiarati da Anthropic, non replicati da terzi.
Fable 5.2 è davvero meglio di Fable 5.1?
Sì, su tutti i benchmark della tabella ufficiale. Il salto più piccolo è su AA-Briefcase (66,1 contro 61,5), il più grande su RoboDojo Sim (64,9 contro 27,6). Su FrontierCode 2.0 si passa da 32,4% a 49,1%. Per un'azienda conta soprattutto la voce che somiglia al proprio lavoro.
Fable 5.2 batte GPT-6 Astra e Gemini 4 Carbon?
Nella tabella di Anthropic sì in sei prove su sette tra quelle confrontate con entrambi i modelli, ma non su AutomationBench: lì Gemini 4 Carbon ottiene 53,9% contro 51,4%. Anthropic ha scelto i test e li ha eseguiti con le proprie impostazioni, quindi il quadro va verificato sui propri casi.
Cosa significa che Fable 5.2 a effort High vale Opus 5.5 a Max?
Su FrontierCode 2.0 Fable 5.2 a effort High ottiene 45,3%, quasi lo stesso 45,5% che Opus 5.5 ottiene al massimo, per circa metà del costo per compito, secondo Anthropic. Vuol dire che il confronto giusto non è solo il punteggio, ma punteggio e costo insieme.
I benchmark bastano per scegliere un modello in azienda?
No. Sono compiti standard, scelti e misurati dal produttore. Servono per restringere la scelta a due o tre modelli, poi bisogna provarli su 20-30 compiti veri dell'azienda, con lo stesso prompt, e contare errori, tempo e costo.
Come si fa un test sui propri casi d'uso?
Si raccolgono 20-30 compiti reali già svolti da una persona, si definisce prima cosa vuol dire risposta corretta, si eseguono con Opus 5.5 e Fable 5.2 a più livelli di effort e si confrontano errori, tempi e costo per compito. Un pomeriggio di lavoro basta per avere un'indicazione molto più utile di qualsiasi classifica.