
Perplexity apre i nuovi embedding multimodali: cercare anche nelle pagine PDF
Perplexity embedding multimodali PDF: pesi pubblici, ricerca su pagine e immagini, rollout API e verifiche per un archivio aziendale con fonti.
Tempo di lettura: 11 min
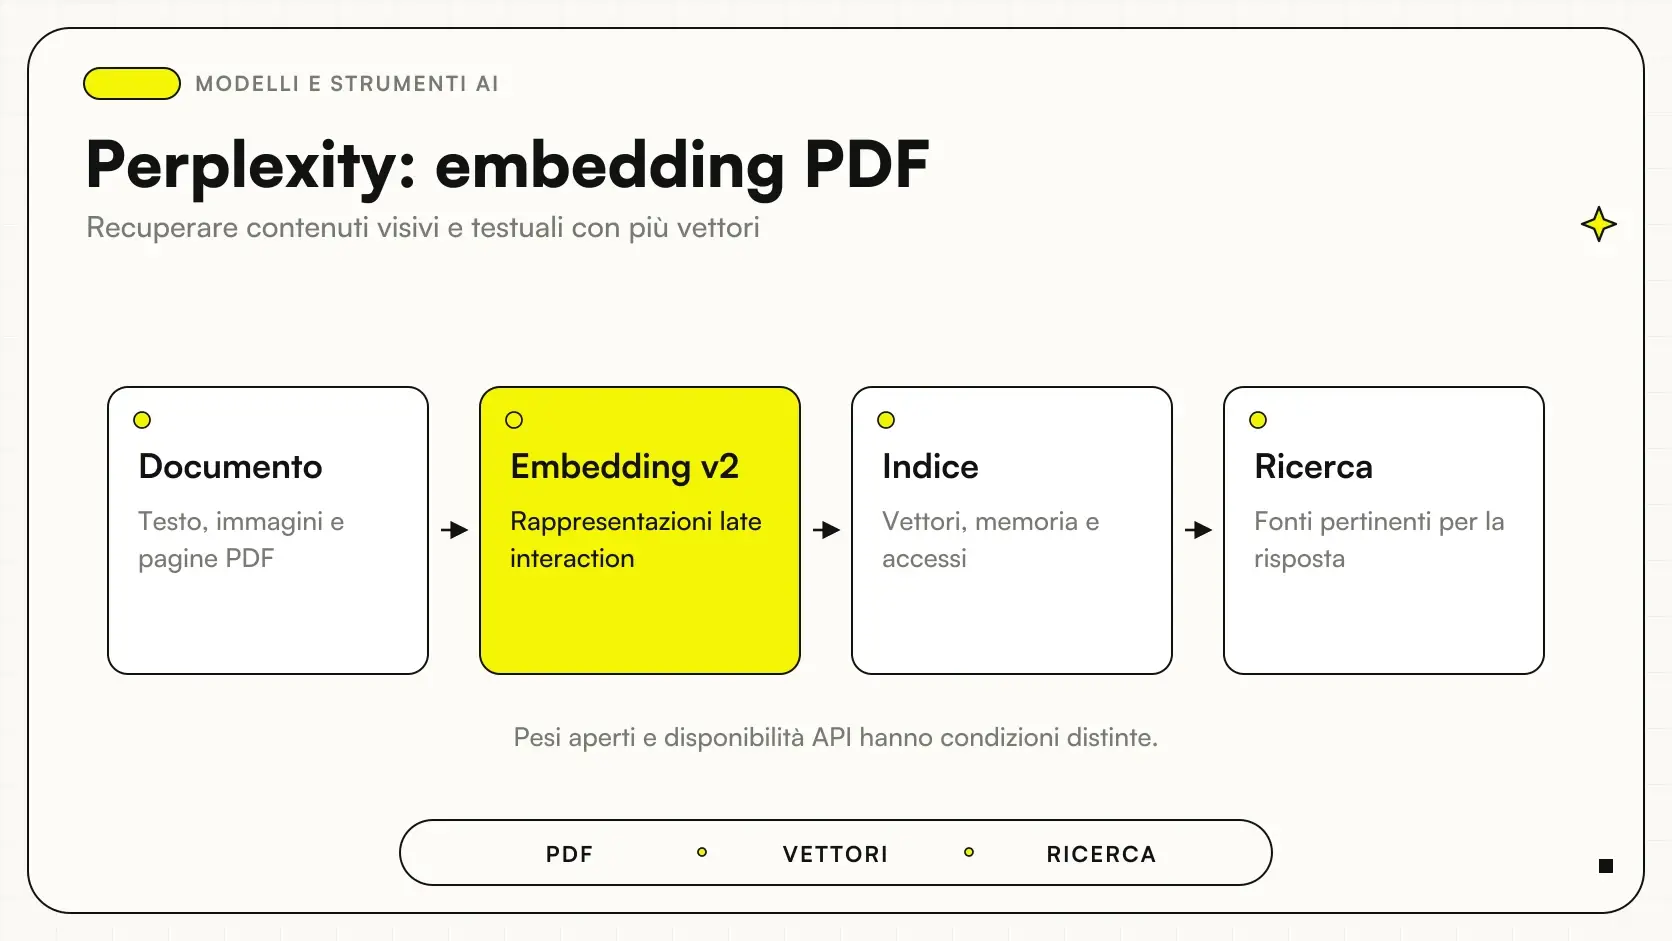
I nuovi embedding multimodali Perplexity permettono di cercare informazioni anche in immagini e pagine PDF, usando rappresentazioni multi-vector. Per un'azienda il caso concreto è la ricerca interna in manuali, cataloghi e documenti in cui figure e tabelle contano quanto il testo. Non è una funzione che rende automaticamente corretto ogni assistente documentale.
Il 7 ottobre 2026 Perplexity ha annunciato i modelli pplx-embed-v2-late 0.6B e 9B, con pesi pubblici. I modelli condividono uno spazio di rappresentazione che permette al modello più piccolo di interrogare un indice costruito con quello più grande. Sono caratteristiche dichiarate dal fornitore, non un benchmark Giallo. Annuncio ufficiale.
La disponibilità dei pesi va distinta dal servizio API: il blog descrive un rollout progressivo. Non è prova che un endpoint v2-late sia già attivo e prezzato per ogni account. Prima di progettare l'integrazione bisogna verificare il percorso realmente disponibile. Blog tecnico Perplexity.
In sintesi
- Gli embedding servono a recuperare contenuti pertinenti, non a garantire la correttezza della risposta finale.
- La ricerca multimodale può essere rilevante quando immagini, impaginazione e tabelle contengono informazioni decisive.
- La rappresentazione multi-vector richiede una valutazione di calcolo, spazio e manutenzione dell'indice.
- Pesi pubblici e rollout API sono disponibilità differenti.
- Permessi, versioni dei documenti e citazioni delle fonti restano parte del progetto aziendale.
Che cosa cambia rispetto alla ricerca nel solo testo?
Un manuale può spiegare una procedura con un disegno, identificare un componente in una figura o presentare compatibilità in una tabella. Se l'indicizzazione conserva soltanto testo estratto male, quella struttura può andare persa. La ricerca multimodale prova a rappresentare anche contenuti visuali e pagine, secondo il disegno del modello.
Il metodo late-interaction usa più vettori per rappresentare il contenuto, anziché riassumerlo interamente in un unico vettore. L'obiettivo descritto da Perplexity è conservare informazioni utili al confronto fra query e documenti. Non ne segue che ogni archivio diventi più preciso: il vantaggio va misurato sul corpus e sulle domande dell'azienda. Spiegazione tecnica ufficiale.
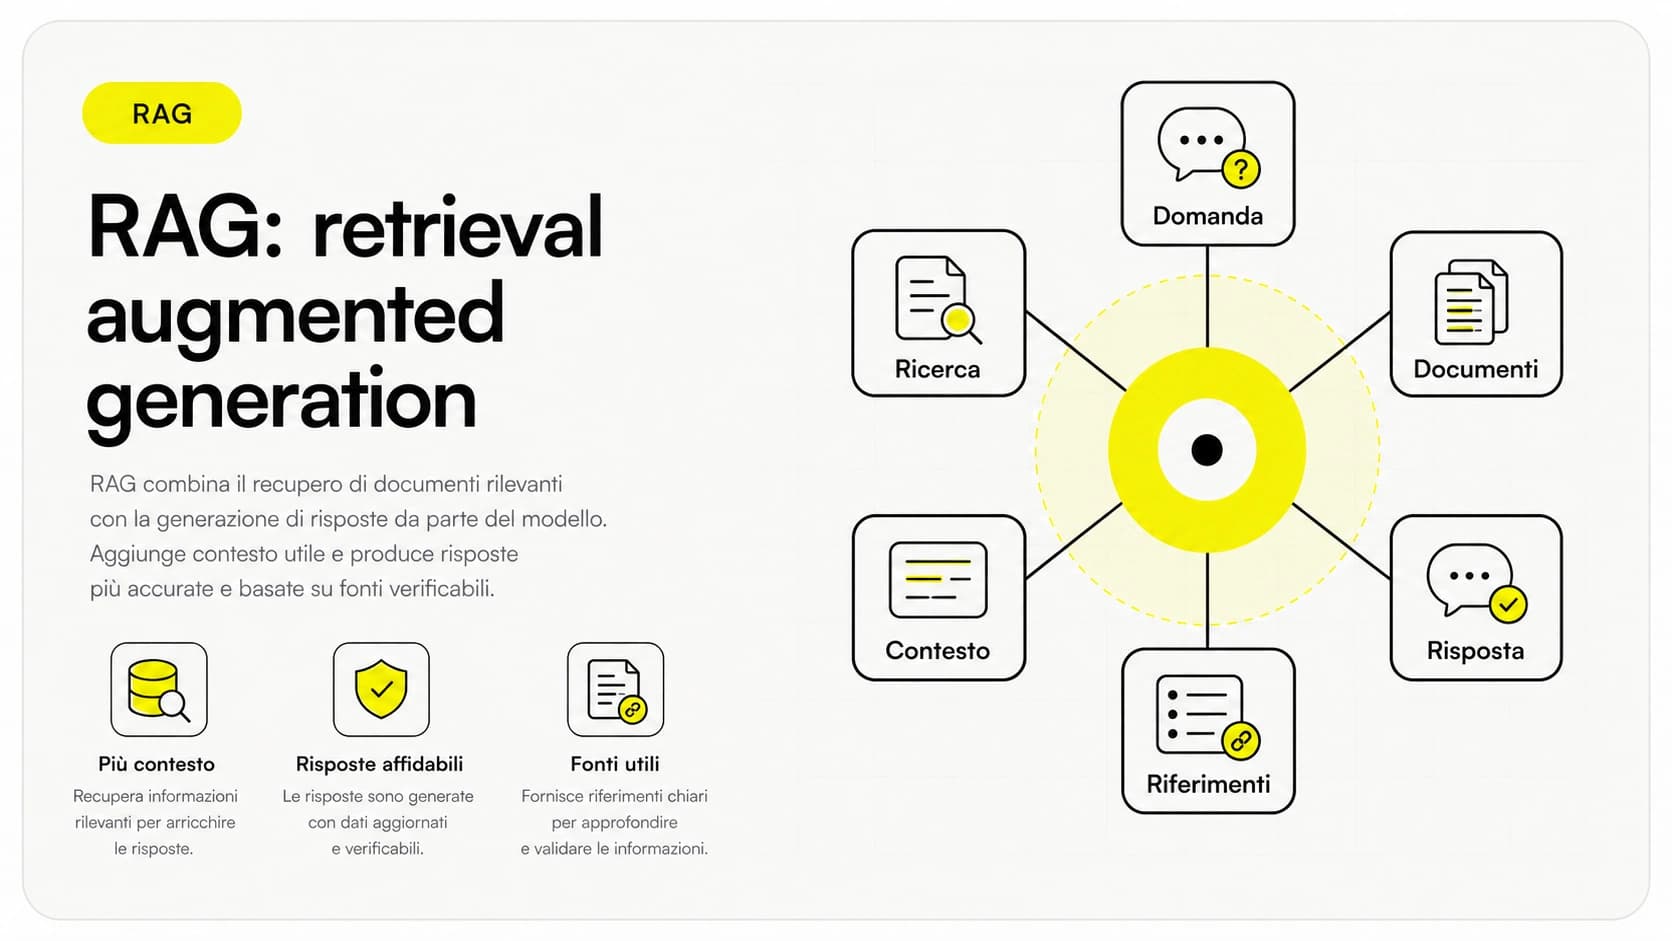
La guida al RAG spiega come il recupero delle fonti entri nella risposta di un assistente. Gli embedding intervengono nella ricerca dei materiali pertinenti. La generazione viene dopo e può ancora interpretare male il documento: il progetto deve valutare separatamente ciò che viene recuperato e ciò che viene detto all'utente.
Perché uno spazio condiviso fra modelli può essere utile?
Perplexity descrive compatibilità fra i modelli rilasciati: il 0.6B può interrogare un indice costruito con il 9B. Questo apre una scelta progettuale fra costruzione dell'indice e gestione delle query, da valutare in termini di risorse e qualità. Non autorizza a mescolare arbitrariamente modelli di embedding diversi. Annuncio dei modelli.
In un archivio aziendale, i documenti possono essere indicizzati quando vengono pubblicati o aggiornati, mentre le domande arrivano durante il lavoro. Le due attività hanno requisiti differenti. La compatibilità dichiarata offre un'opzione, ma il team deve verificare il comportamento con i propri documenti, soprattutto se contengono termini tecnici italiani o immagini poco leggibili.
Il confronto con EmbeddingGemma per documenti aziendali va fatto sul compito: tipo di contenuto, qualità del recupero, risorse richieste e manutenzione. Non esiste una scelta migliore in assoluto per ogni corpus. Un archivio quasi soltanto testuale può avere esigenze diverse da un catalogo pieno di tavole tecniche.
Che cosa preparare prima di indicizzare i PDF?
Prima del modello servono documenti identificabili e aggiornati. Ogni file dovrebbe avere titolo, versione, data pertinente e proprietario. Se un manuale obsoleto e quello corrente sono indistinguibili, il sistema può recuperare una fonte plausibile ma sbagliata. Il modello non dovrebbe essere incaricato di inventare quale versione abbia valore.
Anche le pagine devono restare collegabili alla fonte. L'utente deve poter aprire il documento e controllare il punto citato. Un risultato che descrive una figura senza indicare dove si trovi è più difficile da verificare. Il rendering dei PDF, l'estrazione e la gestione delle pagine sono parti dell'infrastruttura, non dettagli eliminati dall'embedding.
La guida all'analisi dei documenti aziendali con AI aiuta a definire il risultato atteso. In un progetto di ricerca, l'obiettivo iniziale può essere trovare il documento corretto, senza generare subito una risposta completa. Questo perimetro rende più semplice riconoscere gli errori della fase di recupero.
Come confrontare le opzioni di ricerca?
| Contenuto | Approccio da valutare | Verifica decisiva |
|---|---|---|
| Procedure prevalentemente testuali | Ricerca testuale o embedding | Recupero del passaggio corretto |
| Manuali con figure | Embedding multimodale | Collegamento fra domanda e pagina |
| Cataloghi con tabelle | Rappresentazione della pagina e metadati | Variante e versione corrette |
| Archivio con accessi differenti | Filtri autorizzativi | Nessun documento fuori perimetro |
| Risposta generata | RAG con citazioni | Coerenza fra risposta e fonte |
Il recupero e il filtro rispondono a domande diverse: la guida a JEV nel filtraggio RAG riguarda la selezione dei candidati, da valutare prima della risposta finale.
La tabella propone criteri, non attribuisce prestazioni garantite ai modelli. Un confronto utile include una soluzione semplice già disponibile: ricerca per codice, filtri o testo. Se quella strada risolve il compito, aggiungere una pipeline più complessa potrebbe non essere necessario.
I metadati sono particolarmente importanti. Il nuovo lavoro di Foundry IQ su SharePoint e metadati riguarda un'altra piattaforma, ma evidenzia il ruolo del contesto documentale. Un vettore non sostituisce categoria, versione, proprietà e autorizzazione quando questi elementi determinano quale fonte sia appropriata.
Scenario ipotetico: un distributore cerca nelle tavole tecniche
Immaginiamo un distributore che conserva cataloghi PDF con esplosi e tabelle di compatibilità. Il personale vuole trovare la pagina pertinente partendo da una domanda sul componente. Il pilota usa un insieme di documenti autorizzati, con versioni riconoscibili e domande preparate da chi conosce il catalogo.
Il sistema restituisce pagine candidate e riferimenti, senza formulare automaticamente una conferma commerciale di compatibilità. Il tecnico verifica il risultato e segnala i casi in cui la figura corretta viene confusa con una simile. Le domande includono codici, nomi comuni e descrizioni incomplete.
Questo è uno scenario ipotetico, non un caso cliente. La misura utile è quante richieste trovino la fonte corretta e quali errori restino. Non vengono dichiarati tempi risparmiati o accuratezza. Un risultato visivamente pertinente può appartenere a una versione diversa del prodotto: la verifica deve includere proprio questa possibilità.
Scenario ipotetico: una società di manutenzione consulta manuali
Consideriamo una PMI di manutenzione con manuali di macchinari e istruzioni operative. L'assistente deve aiutare il personale autorizzato a trovare informazioni, mantenendo visibili documento e pagina. Non deve trasformarsi in una fonte autonoma di indicazioni che superano procedure e competenze previste dall'azienda.
Il pilota separa archivi per macchina, versione e permessi. Una domanda generica può richiedere un chiarimento prima della ricerca. Se il sistema recupera più manuali incompatibili, il risultato deve rendere visibile il dubbio. La risposta migliore può essere chiedere il modello esatto, anziché scegliere il documento più simile.
Anche questo caso è ipotetico. Il team valuta soprattutto fonti, versioni e capacità di fermarsi. La ricerca multimodale può aiutare quando la risposta dipende da un diagramma, ma non sostituisce la verifica tecnica del personale. L'azienda mantiene una procedura alternativa per accedere ai manuali quando la ricerca assistita non è disponibile.
Pesi pubblici significa servizio pronto?
No. La model card del modello 0.6B indica licenza MIT e pubblicazione dei pesi. La licenza del modello va distinta dai diritti sui documenti e dalle condizioni degli altri componenti usati nel progetto. Non prova che infrastruttura, indice e API siano già pronti per l'azienda. Model card ufficiale.
Il self hosting richiede risorse per elaborare documenti, produrre rappresentazioni, conservare l'indice e servire query. Una struttura multi-vector va stimata sul corpus reale: spazio e calcolo non si ricavano soltanto dalla dimensione del modello. Servono anche aggiornamenti, backup e monitoraggio del servizio.
La disponibilità API è un percorso distinto, descritto in rollout progressivo dal fornitore. Non viene qui riportato un prezzo o un endpoint v2-late non verificato. Stato del rollout. Prima di scegliere fra servizio e self hosting, il team deve avere evidenza delle condizioni realmente accessibili.
Come preparare una valutazione sul proprio archivio?
Apri la scheda per un pilota di ricerca documentale
Scegli documenti autorizzati e versioni identificabili. Prepara domande con la fonte corretta attesa, includendo figure, tabelle, termini italiani e richieste senza risposta. Valuta separatamente recupero della pagina, permessi e risposta finale. Confronta il risultato con una ricerca più semplice e registra i motivi degli errori.
Le domande non dovrebbero essere riscritture perfette dei titoli. Il personale usa abbreviazioni, descrizioni incomplete e termini propri del settore. Anche l'assenza di una risposta va provata: un sistema deve riconoscere quando il corpus non contiene l'informazione necessaria. Recuperare qualcosa a ogni costo rende meno affidabile il servizio.
Un set di valutazione dovrebbe restare separato dagli esempi usati per correggere la pipeline. Altrimenti si rischia di migliorare soltanto le domande già viste. Il team deve inoltre controllare gli accessi prima della generazione: filtrare dopo aver consegnato il documento al modello può arrivare troppo tardi rispetto al perimetro previsto.
Quali errori sono specifici della ricerca multimodale?
Il primo è indicizzare senza distinguere versioni. Il secondo è misurare soltanto la risposta finale, senza vedere quali pagine siano state recuperate. Il terzo è scegliere in base a un benchmark del produttore e assumere lo stesso risultato sui manuali italiani. Il quarto è ignorare il costo dell'indice e degli aggiornamenti.
Un altro errore è leggere “multimodale” come capacità di capire correttamente ogni immagine. Scansioni degradate, testo minuscolo o tabelle complesse possono creare difficoltà. Questi casi devono apparire nella valutazione se sono presenti nell'archivio, senza essere esclusi perché peggiorano il risultato.
Infine, il contesto organizzativo conta. L'integrazione Rovo fra Jira, Confluence e OpenAI riguarda un ecosistema differente, ma mostra perché documenti e attività debbano restare collegati ai permessi. Un assistente non dovrebbe vedere una fonte soltanto perché l'indice tecnico riesce a recuperarla.
Come mantenere aggiornato l'indice?
Ogni nuova versione deve produrre una decisione sul documento precedente: rimuoverlo dalla ricerca corrente, mantenerlo come archivio o limitarlo a un contesto specifico. La scelta dipende dal processo aziendale. Senza una regola, l'indice può accumulare fonti contraddittorie e restituire quella sbagliata con apparente sicurezza.
Il team dovrebbe controllare anche documenti eliminati o accessi revocati. La ricerca deve seguire queste modifiche, altrimenti la copia indicizzata può sopravvivere al permesso originario. La manutenzione comprende contenuti e autorizzazioni, non soltanto la salute del server.
La guida a Perplexity per aziende offre un quadro più ampio degli usi. Questi embedding hanno però un intento specifico: aiutare a costruire ricerca interna. Non vanno confusi con una ricerca web generica o con la disponibilità automatica di tutti i documenti aziendali in un'applicazione pronta.
Come mostrare una fonte senza renderla più certa di quanto sia?
Il risultato della ricerca dovrebbe distinguere pagina candidata e informazione confermata. Un documento può sembrare pertinente perché contiene gli stessi termini, ma riguardare un modello diverso. Mostrare titolo, versione e contesto aiuta l'utente a riconoscere questa differenza. Il sistema non dovrebbe nascondere tali elementi dietro una risposta troppo sintetica.
Quando la ricerca restituisce più fonti, il team deve decidere come trattare i conflitti. Una procedura corrente può prevalere su un documento archiviato, ma questa regola deve essere esplicita. Se il conflitto non è risolvibile con i metadati, l'assistente dovrebbe segnalarlo invece di fondere le informazioni in una spiegazione apparentemente coerente.
Le citazioni devono restare utili anche quando cambia il documento. Un collegamento a una pagina rimossa o a un file sostituito rende difficile verificare una risposta precedente. La progettazione deve considerare versionamento e accesso alle fonti, compatibilmente con le regole dell'azienda. Non serve conservare ogni copia per sempre, ma serve una decisione comprensibile su ciò che viene mantenuto.
Anche il personale ha bisogno di un modo semplice per segnalare risultati sbagliati. Una nota può indicare domanda, fonte recuperata e motivo dell'errore, senza riportare contenuti riservati non necessari. Questi riscontri aiutano a capire se il problema riguardi rappresentazione, filtri, versione o linguaggio della query.
Il miglioramento non coincide sempre con un modello più grande. Potrebbero bastare metadati più chiari, una domanda di disambiguazione o documenti meglio organizzati. La prova dovrebbe lasciare spazio a queste alternative. Se una modifica semplice risolve il problema, è preferibile valutarla prima di aggiungere una pipeline più costosa da mantenere.
Da quale archivio conviene iniziare?
Si parte da un corpus circoscritto in cui figure o tabelle abbiano un ruolo evidente. Occorrono fonti autorizzate, domande rappresentative e un responsabile che possa giudicare il risultato. Prima si verifica il recupero; poi si decide se aggiungere una risposta generata e quali controlli applicare.
Se il personale fatica a trovare la pagina giusta fra manuali e cataloghi, un progetto di software su misura Giallo può partire da quella ricerca concreta. Il risultato da chiedere è una fonte corretta, accessibile alla persona giusta e verificabile, con costi e manutenzione leggibili prima di estendere l'archivio.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 EmbeddingGemma 2: ricerca AI locale nei documenti aziendali
 Foundry IQ e SharePoint: perché i metadati cambiano le risposte della knowledge base
 OpenAI e Atlassian ampliano Rovo: Jira e Confluence nel lavoro con l'AI
 RAG: cos'è e perché migliora le risposte AI
 AI per analizzare documenti aziendali: guida pratica
 Perplexity AI per aziende
FAQ
A cosa servono i nuovi embedding Perplexity?
A recuperare contenuti pertinenti anche da immagini e pagine PDF secondo il modello multimodale. Non garantiscono da soli la correttezza di una risposta generata.
Che cosa significa multi-vector?
Il contenuto viene rappresentato con più vettori anziché un'unica rappresentazione complessiva. Calcolo e spazio dell'indice vanno valutati sul corpus reale.
I modelli rilasciati possono condividere l'indice?
Perplexity descrive uno spazio condiviso fra i modelli del rilascio. Questa compatibilità non autorizza a mescolare arbitrariamente modelli di embedding diversi.
Pesi pubblici significa API v2-late già pronta?
No, il blog descrive un rollout API progressivo. Endpoint, prezzo e disponibilità per l'account devono essere verificati prima dell'integrazione.
Il self hosting elimina costi e manutenzione?
No, servono elaborazione dei documenti, indice, query, aggiornamenti e protezione del servizio. La licenza dei pesi è distinta dai diritti sui documenti e dagli altri componenti.
Come verificare il valore sul proprio archivio?
Con domande rappresentative, fonti corrette attese e casi senza risposta. Recupero, permessi e risposta finale devono essere valutati separatamente.