
Qwen3.8-27B vs Qwen3.6-35B-A3B: cosa cambia in locale
Qwen3.8-27B vs Qwen3.6-35B-A3B: dense, MoE, memoria e compatibilità. Come verificare se un cambio di modello migliora davvero il processo.
Qwen3.8-27B e Qwen3.6-35B-A3B differiscono soprattutto per architettura: il primo è dense, il secondo è MoE. Passare da uno all'altro non è un aggiornamento automaticamente migliore per un sistema locale: cambiano pesi totali, calcolo attivo e configurazione da verificare. Le card ufficiali dichiarano rispettivamente 27B linguistici e 35B totali con 3B attivi per la parte linguistica. Fonti: Qwen3.8-27B, Qwen3.6-35B-A3B.
Il confronto riguarda chi sta scegliendo un checkpoint oppure vuole sostituire un modello già integrato. In entrambi i casi servono evidenze sul lavoro: una numerazione più recente può giustificare una prova, ma non elimina il controllo di accuratezza, compatibilità e memoria. Questa guida usa fonti primarie consultate il 27 ottobre 2026 e non racconta test eseguiti da Giallo Studio.
In sintesi
- Qwen3.8-27B è dense; Qwen3.6-35B-A3B è MoE, con 35B linguistici totali e 3B attivi.
- Entrambi hanno una componente visiva e un contesto nativo dichiarato di 262.144 token.
- I parametri attivi del 35B-A3B non rappresentano il peso completo da caricare.
- Compatibilità dei file, template e parser degli strumenti va verificata nella versione del runtime usata.
- Una migrazione affidabile conserva configurazione precedente e casi di regressione.
Perché un 27B può avere una sigla successiva a un 35B?
Il numero della generazione e quello dei parametri misurano cose diverse. “3.8” identifica una serie di modelli; “27B” descrive una taglia. “35B-A3B” indica invece la distinzione tra parametri totali e attivi nel checkpoint MoE. Non esiste una regola che trasformi automaticamente queste etichette in un ordinamento unico di qualità.
La card Qwen3.6-35B-A3B presenta il modello come variante con attenzione ai flussi di coding e alla stabilità operativa; la card Qwen3.8-27B descrive miglioramenti della nuova serie su più attività. Queste sono descrizioni del produttore. Per il tuo assistente serve un'altra domanda: quale dei checkpoint, nella configurazione disponibile, rispetta meglio i requisiti che hai stabilito? Puoi leggere anche la scheda decisionale Qwen3.8-27B prima di pianificare la prova.
Che cosa cambia tra dense e MoE?
Qwen3.8-27B usa un modello linguistico dense; Qwen3.6-35B-A3B seleziona esperti durante l'elaborazione e dichiara 3B attivi rispetto a 35B linguistici totali. Entrambi includono un encoder visivo, quindi il nome della taglia non è il conteggio completo di ogni componente del checkpoint. Fonti: card 27B, card 35B-A3B.
La distinzione può modificare il lavoro eseguito per token e il modo in cui il runtime usa l'hardware. Non autorizza però a considerare il MoE un modello da 3B quando stimi la memoria dei pesi. Gli esperti non attivi in un passaggio devono restare disponibili per quelli successivi. Se vuoi confrontare lo stesso compromesso fuori dalla famiglia, vedi Qwen3.8-27B vs Gemma 4 26B A4B.
Quali specifiche sono comuni e quali no?
Le card riportano per entrambi 262.144 token di contesto nativo e comprensione visiva. Per il 27B è descritta un'estensione fino a 1.000.000 token; per il 35B-A3B fino a 1.010.000. Sono configurazioni di estensione, non una promessa di funzionamento a quel massimo su qualunque macchina. Fonte 27B, fonte 35B-A3B.
| Caratteristica | Qwen3.8-27B | Qwen3.6-35B-A3B |
|---|---|---|
| Architettura linguistica | Dense | MoE |
| Parametri linguistici | 27B | 35B totali / 3B attivi |
| Visione | Presente | Presente |
| Contesto nativo | 262.144 token | 262.144 token |
| Licenza dichiarata | Apache 2.0 | Apache 2.0 |
| Uso effettivo sul tuo hardware | Da verificare | Da verificare |
| Sostituzione senza controlli | Da evitare | Da evitare |
La vicinanza delle capacità nominali rende il confronto sensato, ma non garantisce che un'applicazione possa sostituire il nome del modello senza altri cambiamenti.
Il MoE da 35B richiede meno memoria del dense da 27B?
Non lo puoi stabilire dai parametri attivi. Considerando i soli pesi linguistici a 4 bit, 35B corrispondono teoricamente a circa 17,5 GB decimali e 27B a circa 13,5 GB. Il calcolo è parametri per bit diviso otto; non è un requisito reale né una misura comparativa.
Il formato effettivo può usare precisioni miste e aggiunge metadati, componenti visive e altre risorse. La memoria durante la richiesta comprende inoltre cache, buffer e margine per il sistema. Un motore può spostare alcuni pesi tra dispositivi, cambiando il profilo operativo: questo va osservato, non inferito dal nome. Per distinguere dimensione teorica e ambiente reale, consulta Qwen3.8-27B, RAM e VRAM e quantizzazione GGUF per modelli locali.
Quanto conta il motore di inferenza nella scelta?
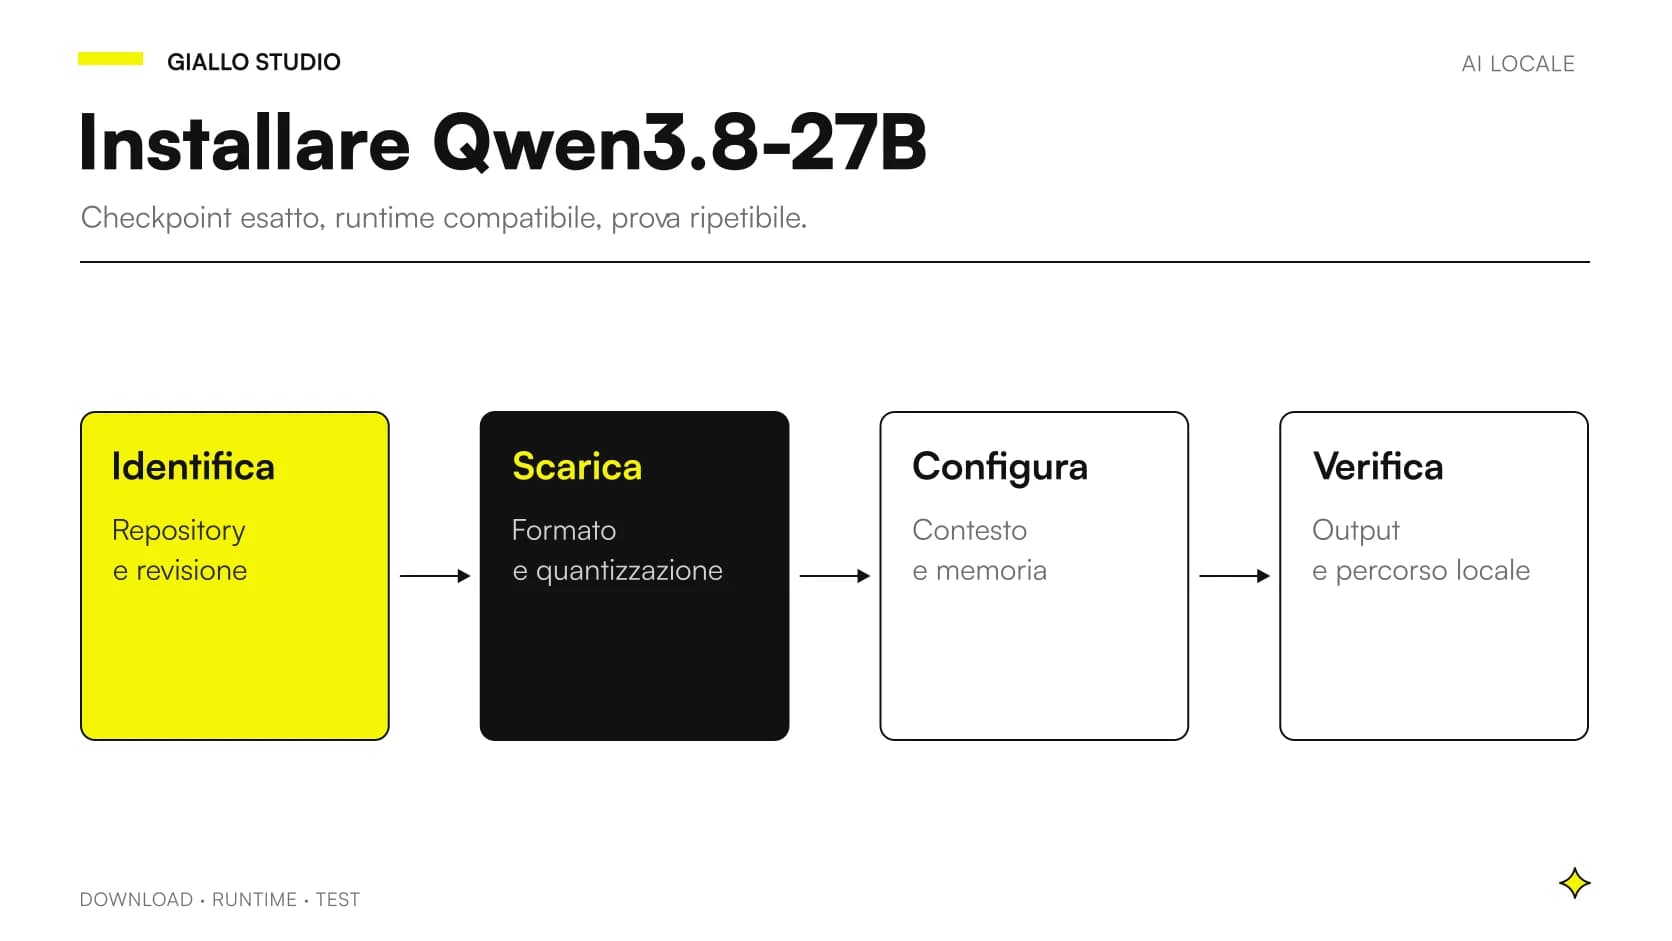
La stessa famiglia non garantisce lo stesso livello di supporto in ogni versione di un motore. Le card documentano integrazioni con framework e impostazioni specifiche; il repository ufficiale della serie Qwen è un ulteriore riferimento per seguire le indicazioni correnti. Controlla sempre le istruzioni del checkpoint esatto, invece di applicare una guida generica trovata per una versione precedente.
Prima di valutare le risposte, fai una prova minima con testo, poi una con immagine e infine una chiamata a uno strumento se il progetto la prevede. Un errore di caricamento, di template o di parser può compromettere il risultato prima che inizi il confronto di qualità. Annota la versione funzionante; un ambiente che cambia automaticamente mentre provi i modelli rende difficile ricostruire la causa di un problema.
Come confrontare la capacità di completare un compito?
Scegli un'attività con un risultato osservabile: estrarre campi con fonte, preparare una bozza vincolata o modificare codice sottoposto a test. Il compito deve avere casi normali e condizioni in cui il modello deve fermarsi. Una conversazione generica, senza risposta attesa, favorisce giudizi sullo stile più che sulla correttezza.
Se l'attività richiede più passaggi, valuta ogni transizione. Il sistema ha chiesto il documento giusto? Ha riconosciuto che mancava un'autorizzazione? Ha corretto un errore senza introdurre una nuova modifica fuori scope? La card può presentare capacità agentiche, ma il comportamento dell'applicazione dipende anche dai tool concessi e dal ciclo di esecuzione. Per una rubrica riutilizzabile rimanda al protocollo dei benchmark LLM locali in italiano, evitando punteggi aggregati che nascondono errori bloccanti.
Come provare i due modelli su codice aziendale?
Scenario ipotetico: una software house interna vuole chiedere una modifica circoscritta a un gestionale. Il test dovrebbe usare un repository autorizzato, un requisito chiaro e una procedura di verifica esistente. Il risultato non è soltanto il codice prodotto: comprende test, file modificati e coerenza con il comportamento richiesto.
Concedi a entrambi gli stessi strumenti e lo stesso tempo operativo, oppure dichiara perché la configurazione differisce. Se uno modifica file estranei, disattiva test o chiede credenziali non necessarie, registra il problema anche quando la funzionalità sembra corretta. Non trasferire al checkpoint più piccolo numeri di benchmark ottenuti da altri Qwen. Per una scelta orientata specificamente alla programmazione, guarda anche Qwen3-Coder-Next vs Devstral Small 2 e la guida ai modelli AI per programmare.
E su schede tecniche e procedure interne?
Secondo scenario ipotetico: un'azienda vuole rispondere a domande su schede di prodotto, immagini di componenti e istruzioni di manutenzione. Qui serve collegare il testo alla versione giusta della fonte. La presenza della visione in entrambi i modelli rende plausibile il test, ma non dimostra lettura accurata di ogni dettaglio.
Prepara immagini leggibili e casi in cui una sigla è incompleta. Inserisci due procedure con revisioni differenti e chiedi esplicitamente quale applicare. Il sistema deve mostrare il riferimento e segnalare l'incertezza quando l'identificazione non è possibile. Se il recupero documentale fornisce una scheda sbagliata, registra l'errore nella pipeline. La guida all'AI multimodale locale aiuta a isolare lettura della pagina, selezione delle informazioni e generazione della risposta.
Che cosa verificare nel thinking e nella cronologia?
Le card descrivono impostazioni per il ragionamento e la gestione del contesto delle conversazioni. Qwen3.6 presenta anche un'opzione per conservare il ragionamento nei messaggi precedenti; la documentazione di ciascuna versione va letta prima di riutilizzare un'integrazione. Fonte: Qwen3.6-35B-A3B, fonte Qwen3.8-27B.
Per il pilota, non basta controllare il primo turno. Prova una correzione dell'utente, la revoca di un'ipotesi e un documento sostitutivo. Il sistema deve aggiornare la risposta senza conservare come fatto l'errore iniziale. Registra come il runtime invia la cronologia e cosa viene escluso quando il contesto cresce. Una regressione in questa gestione può sembrare un limite del nuovo modello, mentre nasce dalla forma dei messaggi inviati dall'applicazione.
Quale migrazione è più facile da verificare?
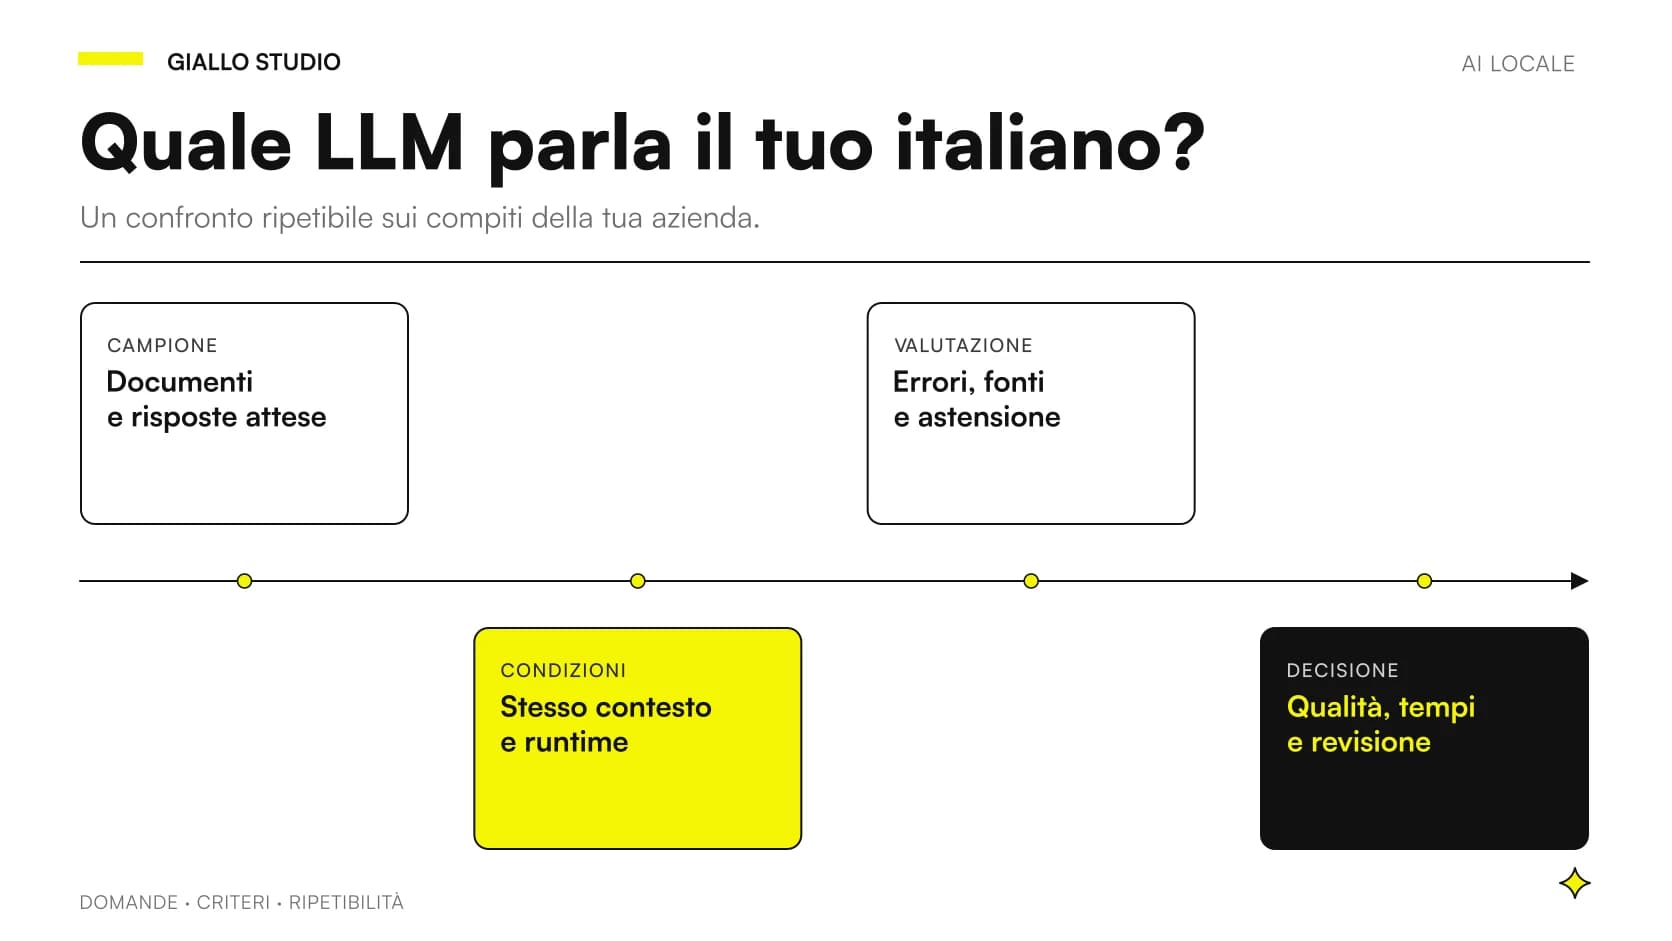
Mantieni il sistema precedente disponibile e prepara un ambiente di prova con le stesse fonti autorizzate. Fai elaborare il campione al candidato senza permettergli di scrivere su sistemi operativi. Confronta risposte, errori e memoria, poi rivedi i casi in cui i risultati divergono. Il disaccordo non indica automaticamente che il modello nuovo abbia sbagliato: serve una fonte con cui decidere.
Definisci prima quando procedere e quando tornare alla configurazione precedente. Può essere indispensabile non peggiorare i casi con importi, codici o istruzioni in conflitto, anche se migliorano i riassunti. Conserva la revisione precedente dei pesi e le impostazioni funzionanti. Un piano di ritorno riduce il costo di un aggiornamento fallito, ma non sostituisce la prova: il referente deve sapere quali risultati hanno motivato la decisione e quali limiti rimangono aperti.
Controlla inoltre i contratti con il software a valle. Se il precedente assistente restituisce campi strutturati, il nuovo deve rispettarne nomi, tipi e significato, oppure l'integrazione va aggiornata esplicitamente. Un codice prodotto dalla forma corretta ma associato all'articolo sbagliato non è una migrazione riuscita. Usa un validatore indipendente e conserva i motivi dei rifiuti. Quando il sistema non sa rispondere, anche la forma dell'astensione deve essere gestibile dall'applicazione: una frase libera infilata in un campo numerico può rompere il flusso senza che il modello abbia inventato un dato. La compatibilità comprende queste condizioni di errore.
Quali errori fanno sembrare il nuovo modello migliore?
Uno è usare domande appena modificate per il nuovo checkpoint e confrontarle con vecchie risposte ottenute con istruzioni diverse. Un altro è selezionare solo gli esempi riusciti, omettendo quelli in cui il modello si è interrotto o ha avuto bisogno di correzioni. Un terzo è attribuire all'architettura un miglioramento dovuto a un OCR aggiornato o a un recupero documentale più preciso.
Evita anche il giudizio basato sul tono: maggiore sicurezza espositiva non garantisce maggiore fedeltà. Chiedi ai valutatori di vedere evidenze e risultato prima del nome del modello, quando possibile. Conserva il campione bloccato e separa i nuovi casi usati per migliorare il prompt da quelli riservati alla verifica finale. Se ottimizzi e giudichi sullo stesso insieme senza dichiararlo, rischi di scegliere un sistema adatto soprattutto ai tuoi esempi.
Licenza comune significa stesso perimetro di dati?
No. I checkpoint ufficiali qui confrontati dichiarano Apache 2.0, come risulta dalle rispettive card e dal LICENSE del 27B. Questo non descrive il percorso di chat, immagini o strumenti. Un'applicazione può usare l'inferenza locale e inviare altrove documenti per altri passaggi.
Durante una migrazione ricontrolla endpoint, log, cartelle di upload e backup. Potrebbero cambiare insieme al motore, introducendo una differenza non visibile nel nome del modello. Se il servizio deve restare isolato, usa una prova di rete e contenuti di test autorizzati; non affidarti a un'etichetta nell'interfaccia. Per la mappa dei componenti da verificare, leggi AI locale e privacy: controllo dell'offline. Anche i permessi delle chiamate agli strumenti devono restare coerenti con il ruolo dell'utente.
Quando mantenere il modello già funzionante?
Quali segnali giustificano il rinvio di una migrazione?
Il candidato non completa casi essenziali, richiede interventi manuali non previsti, non è stabile nel runtime scelto oppure non mostra un vantaggio utile rispetto al sistema precedente. In queste condizioni conserva le evidenze, correggi il problema identificato e ripeti il confronto prima di cambiare il servizio usato dal team.
Mantenere un checkpoint che soddisfa il processo può essere una decisione ragionevole. Vale la pena cambiare quando il vantaggio è verificabile e il costo di integrazione è sostenibile. Il criterio resta il lavoro svolto correttamente, non la necessità di avere sempre la sigla più recente.
Per un confronto con un'altra famiglia guarda Qwen3.8-27B vs Ministral 3 14B. Se stai aggiornando un assistente già usato dai colleghi, Giallo Studio progetta agenti AI con controlli sul processo, includendo prove di regressione e un ritorno operativo definito prima del rilascio.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Qwen3.8-27B vs Ministral 3 14B: quale portare in locale
- Qwen3-Coder-Next vs Devstral Small 2: codice in locale
- Qwen3.8-27B vs gpt-oss-20b: visione, testo e memoria
- RPA vs AI automation: differenze, costi e quando usare quale
- Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
- Voice AI o chatbot: quale canale scegliere
- Qwen3.8-27B vs Gemma 4 26B A4B: dense o MoE?
- AI in abbonamento o su misura: cosa conviene
- PWA aziendale su misura: quando conviene rispetto a un software pronto
- AI fai da te o agenzia: come decidere
- Perplexity vs Google: risposta con fonti o lista di link
- AI locale vs cloud: come confrontare i costi in azienda
FAQ
Qwen3.8-27B è un aggiornamento diretto di Qwen3.6-35B-A3B?
Sono checkpoint diversi per architettura e taglia. Il primo è dense, il secondo è MoE: sostituirli richiede controlli su compatibilità, memoria e qualità del processo.
Qwen3.6-35B-A3B ha soltanto 3B parametri?
No. La card dichiara 35B linguistici totali e 3B attivi per token, con componente visiva aggiuntiva. Il numero attivo non rappresenta i pesi completi da gestire.
Qual è il contesto nativo dei due modelli?
Entrambe le card dichiarano 262.144 token nativi. Le estensioni documentate richiedono configurazioni appropriate e non garantiscono il massimo su qualsiasi hardware.
Quale modello occupa meno memoria?
Va verificato sul formato e sul carico reale. Il 27B ha meno parametri linguistici totali, ma quantizzazione, encoder, cache e runtime influiscono sulla memoria richiesta.
Come verificare una migrazione da un Qwen all’altro?
Conserva il sistema precedente e prova un campione bloccato con fonti e risposte attese. Confronta errori, memoria e compatibilità prima di cambiare il servizio usato dal team.