
Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
Qwen3.8-27B vs Gemma 4 31B: immagini, documenti, contesto e memoria. Criteri verificabili per scegliere un modello locale in azienda.
Qwen3.8-27B e Gemma 4 31B sono due candidati per un assistente locale che deve comprendere testo e immagini; non abbiamo un vincitore misurato sui tuoi documenti. La differenza utile emerge confrontando checkpoint, memoria, gestione delle fonti e qualità sul processo reale, non leggendo soltanto il numero dei parametri. Le specifiche vengono dalle card ufficiali di Qwen e Google DeepMind, consultate il 27 ottobre 2026.
Entrambi permettono di controllare la versione eseguita sul proprio hardware. Questo può aiutare una PMI a costruire un assistente documentale verificabile, purché siano locali anche i componenti che preparano i documenti e recuperano le informazioni. La scelta del modello arriva dentro quel progetto: non sostituisce l'organizzazione dell'archivio, i permessi o il controllo delle risposte.
In sintesi
- Qwen3.8-27B e Gemma 4 31B usano architetture dense e comprendono immagini.
- Qwen dichiara 262.144 token nativi; Gemma 4 31B dichiara 256K.
- Gemma 4 31B non include l'ingresso audio presente in altre taglie Gemma 4.
- Per entrambi, il confronto deve specificare formato dei pesi, runtime e contesto effettivo.
- La decisione dipende dagli errori tollerabili nel processo, oltre che dalla memoria disponibile.
Quali versioni stiamo confrontando?
Il primo modello è il checkpoint ufficiale Qwen/Qwen3.8-27B, con un modello linguistico dense da 27B e un encoder visivo. Il secondo è Gemma 4 31B, che Google descrive come dense da 30,7B, con un encoder visivo di circa 550M parametri. Sono numeri pubblicati dai rispettivi produttori: i perimetri dei conteggi vanno letti con attenzione. Fonti: Qwen, Gemma 4 model card.
Non stiamo confrontando Qwen3.8-Max né Gemma 3 27B. Anche Gemma 4 26B A4B è un'altra variante, con architettura MoE: trovi quel confronto nella guida Qwen3.8-27B vs Gemma 4 26B A4B. Registrare il nome completo evita di scegliere sulla base di risultati ottenuti con pesi diversi.
Quali differenze sono già documentate?
La tabella sintetizza le specifiche dichiarate, senza trasformarle in una graduatoria di qualità. Qwen descrive comprensione di immagini e video; per Gemma 4 31B la tabella delle modalità indica testo e immagini, con output testuale. Le altre taglie Gemma non devono prestargli capacità per associazione. Card Qwen, card Google.
| Criterio | Qwen3.8-27B | Gemma 4 31B |
|---|---|---|
| Architettura linguistica | Dense | Dense |
| Dimensione dichiarata | 27B del modello linguistico | 30,7B dense |
| Componente visiva | Encoder visivo | Encoder visivo, circa 550M |
| Contesto nativo dichiarato | 262.144 token | 256K token |
| Audio nativo della variante | Non dichiarato nella card come modalità di ingresso | Non presente |
| Licenza del checkpoint | Apache 2.0 | Apache 2.0 |
| Risultato sui tuoi documenti | Da verificare | Da verificare |
L'ultima riga è il punto decisivo. Una specifica può escludere un modello inadatto; raramente dimostra da sola quale gestirà meglio il tuo archivio.
La dimensione maggiore significa risposte migliori?
No: il numero dei parametri non misura direttamente l'accuratezza di una risposta aziendale. Per questa scelta è più utile chiedere se il modello trova il passaggio giusto, distingue versioni in conflitto e si ferma quando non ci sono evidenze. Anche una risposta più dettagliata può peggiorare il processo se introduce elementi non presenti nella fonte.
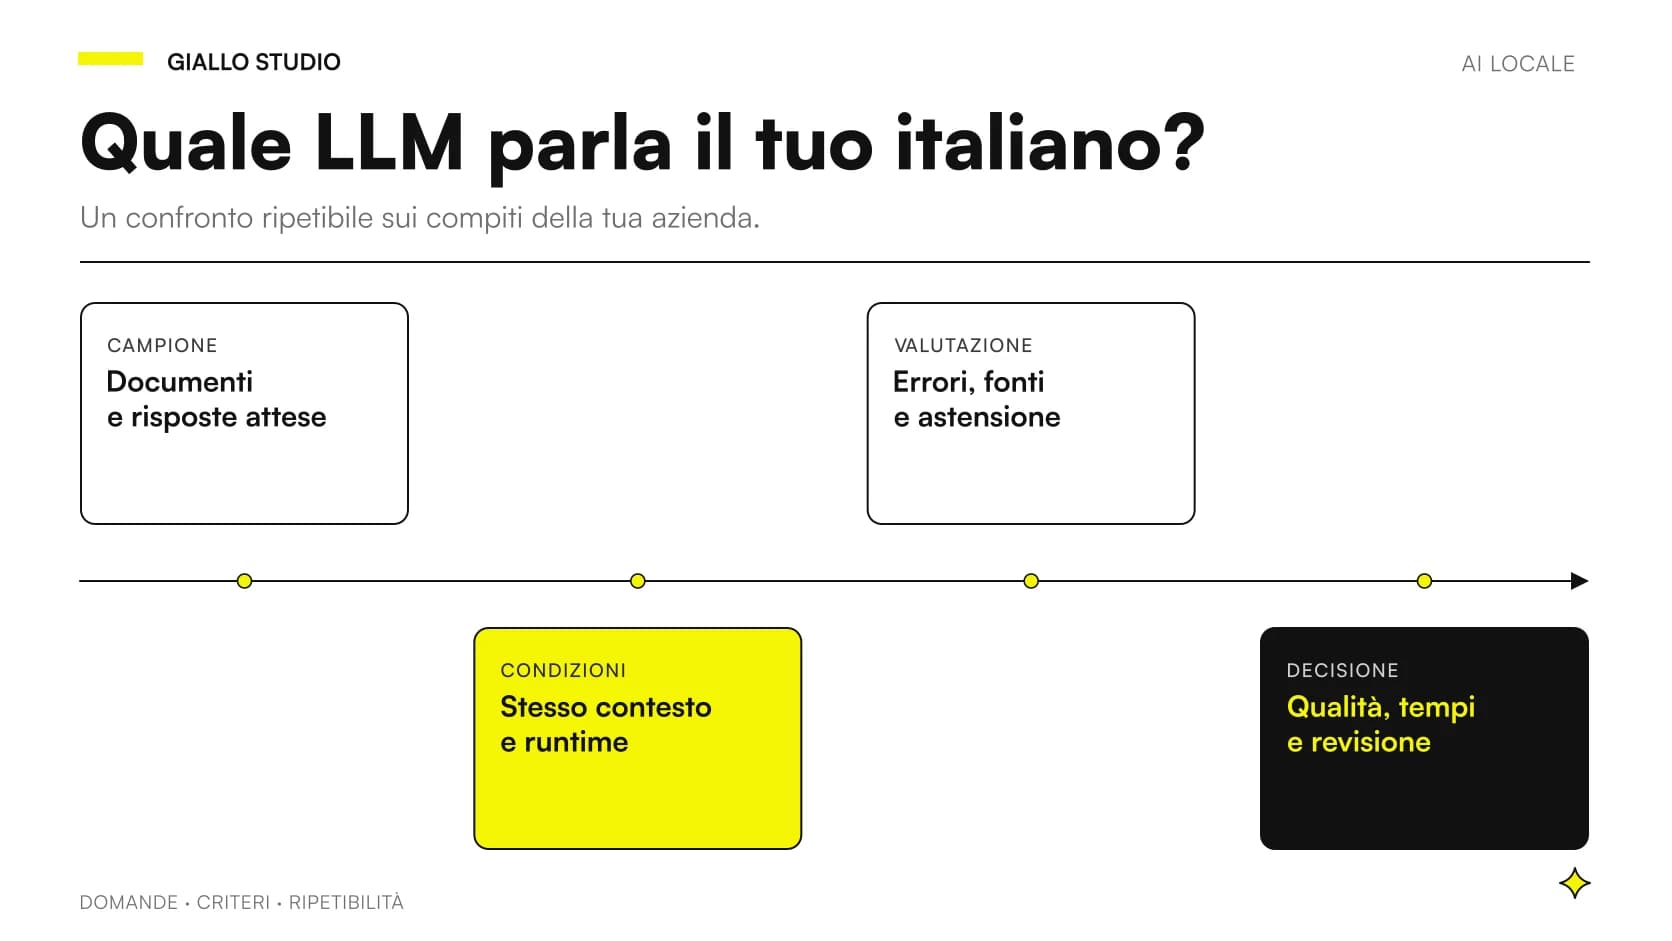
Le pagine dei produttori riportano benchmark con metodologie e obiettivi specifici. Non li sommiamo per ricavare un punteggio generale, né li presentiamo come test Giallo Studio. Se un indicatore ti sembra pertinente, conserva nome del benchmark, versione, configurazione e strumenti concessi. Per la decisione operativa, costruisci poi un campione interno autorizzato: manuali effettivamente usati, domande ricorrenti e risposte attese concordate con chi conosce il lavoro.
Quanto incidono i pesi sulla memoria?
Per Qwen, 27B parametri a 4 bit corrispondono teoricamente a circa 13,5 GB decimali di soli pesi linguistici. Il calcolo non include encoder, scale della quantizzazione, cache o buffer e non equivale a un requisito sufficiente. La memoria di un file quantizzato va verificata sul formato effettivo, non dedotta soltanto dal suo nome.
Per Gemma 4 31B, Google pubblica stime di caricamento di circa 69,9 GB BF16, 34,9 GB SFP8 e 17,5 GB Q4_0, includendo un overhead indicativo del 20%. Sono stime del produttore, dipendenti dall'ambiente; non misure del nostro test e non una promessa di contesto pieno. Fonte: Gemma 4 overview.
Non confrontare direttamente i 13,5 GB teorici di Qwen con i 17,5 GB stimati per Gemma come se avessero identico perimetro. Per approfondire il metodo, leggi quanta RAM e VRAM serve a Qwen3.8-27B.
Un contesto simile permette la stessa esperienza?
Le finestre native dichiarate sono vicine come ordine di grandezza, ma ciò non garantisce la medesima memoria o la stessa qualità sui passaggi lontani. L'architettura, il motore e il formato della cache influenzano l'esecuzione. Qwen documenta inoltre un'estensione del contesto fino a un milione, da configurare; non va confusa con la disponibilità immediata di quella capacità su una macchina qualsiasi. Fonte Qwen.
Per un assistente sui documenti, valuta prima quanto materiale deve entrare davvero nella singola richiesta. Un archivio grande può essere consultato tramite recupero di passaggi pertinenti, come spiega la guida al RAG locale aziendale. Riempire tutta la finestra con documenti superati rende più difficile diagnosticare gli errori e può sprecare risorse senza migliorare la risposta.
Come confrontare la lettura di PDF e tabelle?
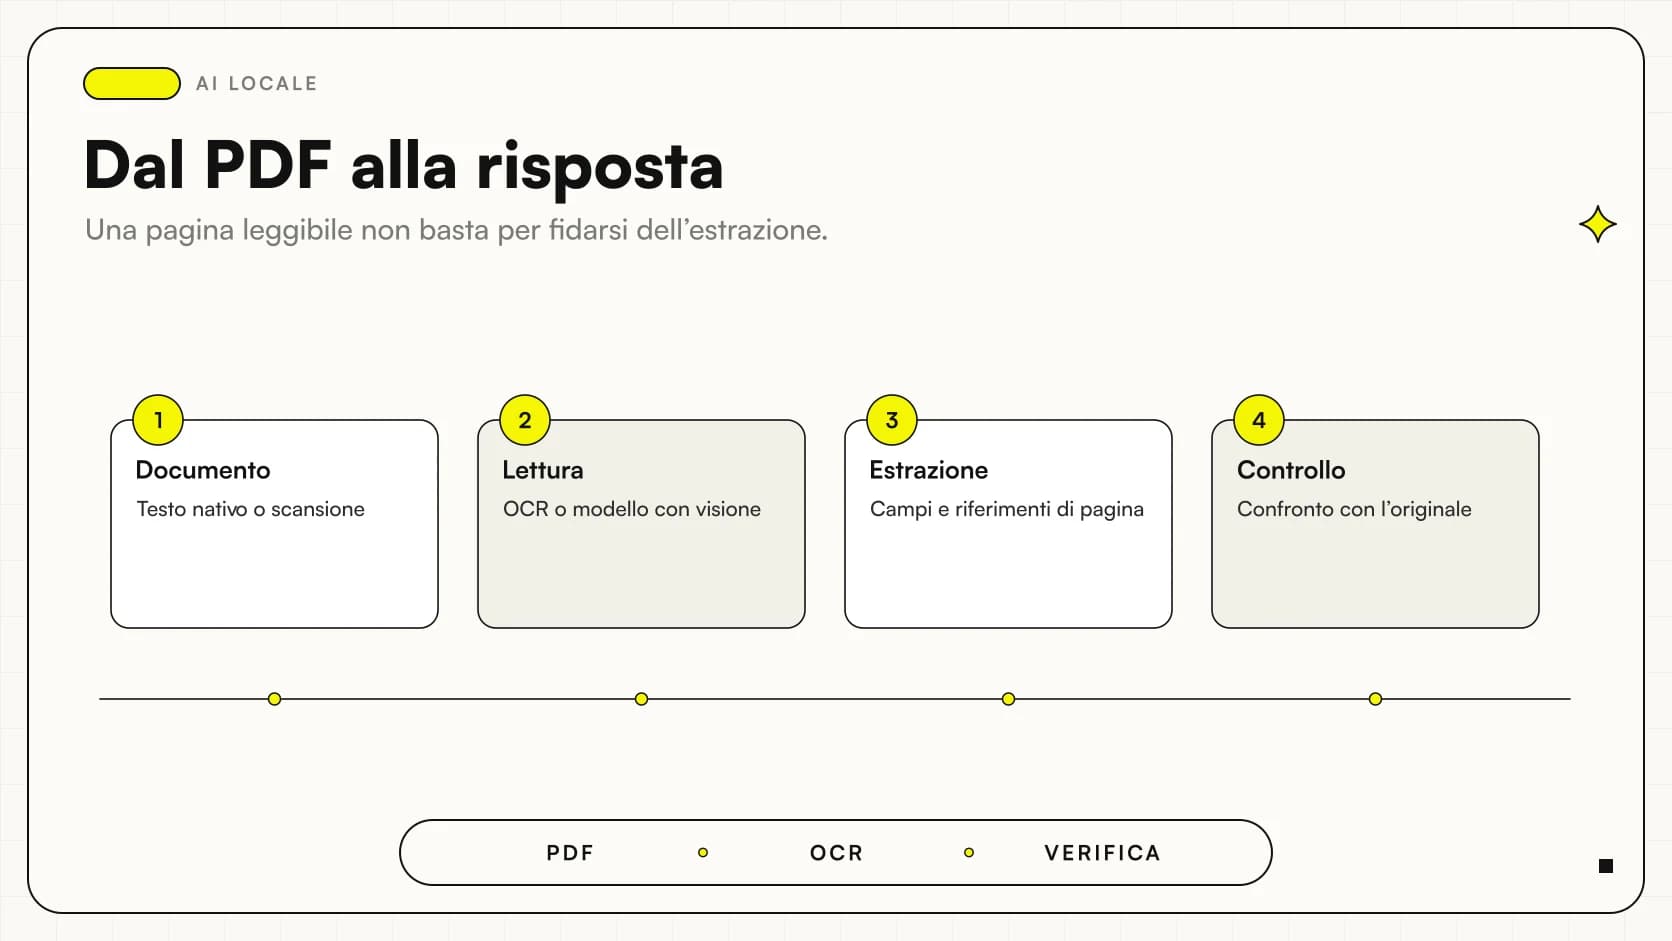
Usa lo stesso documento originale e controlla quale rappresentazione riceve ogni modello. Se Qwen vede l'immagine della pagina mentre Gemma riceve soltanto testo estratto, stai confrontando due pipeline, non solamente due modelli. Questo può essere utile per scegliere un prodotto completo, ma va dichiarato nella scheda del test.
Prepara documenti con caratteristiche diverse: testo pulito, scansioni inclinate, tabelle con celle unite e note a fondo pagina. Chiedi campi specifici e riferimenti verificabili. In un capitolato, per esempio, una nota può cambiare il significato di una riga della tabella: una semplice lista di valori estratti non basta. La guida all'AI multimodale locale per PDF e immagini descrive come separare errori di preparazione, riconoscimento e risposta.
Quale modello scegliere per assistenza tecnica interna?
Scenario ipotetico: una PMI riceve richieste dal reparto manutenzione e vuole suggerire la procedura corretta. Il campione deve comprendere guasti con descrizioni simili, modelli di macchina differenti e istruzioni revocate. Il risultato atteso è un percorso documentato con riferimenti, non una diagnosi autonoma formulata con sicurezza.
Fai rispondere entrambi sullo stesso insieme di fonti e fai valutare gli esiti a un referente tecnico. Segna separatamente errore sul dispositivo, istruzione mancante, citazione sbagliata e mancata astensione. Definisci prima quali errori escludono il sistema. Se una risposta potenzialmente pericolosa viene nascosta da una media complessiva alta, la metrica non sta rappresentando il rischio del processo. Il modello scelto deve migliorare la consultazione mantenendo il tecnico responsabile della verifica.
Cosa cambia per un ufficio acquisti?
Secondo scenario ipotetico: un ufficio acquisti confronta offerte ricevute in PDF. Qui il modello deve distinguere prezzo, quantità, termini, esclusioni e riferimenti dei fornitori. Una frase come “trasporto incluso” può essere errata anche quando tutti gli importi sono stati trascritti bene.
Chiedi una tabella in cui ogni differenza sia collegata alla fonte, con una colonna per le informazioni non dichiarate. Includi un'offerta che usa unità differenti o un allegato che modifica le condizioni iniziali. Il responsabile deve poter verificare senza cercare di nuovo ogni frase nell'intero archivio. Confronta quindi non solo i dati corretti, ma il lavoro necessario per controllarli. Non attribuire un tempo risparmiato prima di averlo effettivamente misurato su un flusso rappresentativo.
Come valutare italiano, astensione e istruzioni?
Una prova linguistica utile va oltre grammatica e stile. Domanda se il modello conserva una denominazione tecnica, interpreta correttamente negazioni e distingue un obbligo da una possibilità. Usa anche richieste formulate nel linguaggio reale dei colleghi, con abbreviazioni e riferimenti incompleti. Il sistema dovrebbe domandare un chiarimento quando quel riferimento cambia il significato della risposta.
Per l'astensione, prepara domande che non hanno risposta nel materiale, richieste su una versione mancante e passaggi realmente contraddittori. Una risposta parzialmente corretta con una conclusione inventata deve restare identificabile come errore. La guida ai benchmark degli LLM locali in italiano propone una struttura di valutazione riutilizzabile. Il confronto deve distinguere l'errore del modello da quello provocato da fonti mancanti o recuperate male.
Valuta anche il formato dell'output. Se una risposta deve entrare in un gestionale, un testo leggibile non basta: servono campi riconoscibili e regole per segnalare quelli sconosciuti. Prevedi una validazione esterna al modello, capace di respingere una data impossibile o un codice assente dal catalogo. Il confronto dovrebbe contare le risposte accettate dal validatore e distinguere quelle corrette soltanto dopo una correzione manuale. Non lasciare che un campo compilato con una stringa plausibile venga scambiato per un dato verificato.
Quali impostazioni devono rimanere comparabili?
Conserva macchina, runtime, revisione del modello, formato dei pesi, contesto, istruzioni e documenti. Quando le opzioni non corrispondono perfettamente, scrivi la differenza. Per esempio, un confronto con ragionamento esteso per un solo modello può descrivere una scelta di prodotto plausibile, ma non dimostra una superiorità indipendente dal budget di generazione.
Non serve forzare valori numerici identici se il produttore raccomanda configurazioni differenti; serve rendere chiaro il criterio scelto. Puoi effettuare una prova con configurazioni raccomandate e una seconda sotto il vincolo reale dell'azienda, come memoria disponibile e attesa accettabile. Ogni esito deve restare associato alle proprie condizioni. Evita di cambiare contemporaneamente modello, prompt e preparazione dei PDF: perderesti la spiegazione di eventuali miglioramenti.
Misura inoltre l'esperienza completa: apertura del documento, preparazione, attesa del primo contenuto e completamento della risposta. Una generazione rapida non compensa necessariamente un'elaborazione iniziale lunga. Riporta questi tempi soltanto dopo averli osservati, separando avvio a freddo e modello già caricato. Per un ufficio con pochi accessi al giorno la prima condizione può essere frequente; per un servizio sempre attivo può contare maggiormente la stabilità con più richieste. Non sono due modi diversi di presentare lo stesso dato, ma situazioni operative da distinguere.
Le licenze permettono l'utilizzo aziendale?
Entrambi i checkpoint qui considerati dichiarano Apache 2.0. Per Qwen controlla il file di licenza ufficiale; per Gemma 4 il collegamento è nella model card Google. Le condizioni di eventuali applicazioni commerciali e dei derivati scaricati restano da leggere separatamente.
La licenza non decide dove viaggiano i dati. Un'applicazione può ospitare il modello nel computer ma usare servizi remoti per OCR, ricerca, telemetria o backup. Il confronto operativo deve quindi includere il percorso dei documenti, non soltanto l'eseguibile che produce la risposta. Nella guida su AI locale, privacy e funzionamento offline trovi i controlli da collegare a una prova di rete effettiva.
Quali scorciatoie portano a scegliere male?
Una scorciatoia è decidere sul testo più elegante. Un'altra è selezionare il modello che ha caricato una volta senza verificare un documento lungo o una seconda richiesta contemporanea. Anche confrontare “Q4” e “8 bit” come etichette complete nasconde differenze di formato e conversione.
Evita poi un campione composto soltanto da casi pubblici già disponibili online: potrebbe non rappresentare il tuo linguaggio operativo. Non scegliere i casi dopo aver visto quale modello li risolve meglio. Definisci campione, criteri di errore e soglia prima di leggere gli esiti. Conserva separatamente i casi difficili emersi durante l'uso e aggiungili alle prove future: così l'aggiornamento di un checkpoint può essere verificato contro problemi concreti già incontrati, invece di ricominciare da una chat improvvisata.
Per un flusso esclusivamente testuale puoi valutare un’alternativa diversa: il confronto tra Qwen3.8-27B e gpt-oss-20b distingue supporto visivo, architettura e formato dei pesi. Serve a restringere i candidati prima di investire in una pipeline documentale.
Come arrivare a una scelta motivata?
Prova prima Qwen3.8-27B
- Vuoi valutare specificamente il checkpoint Qwen e il suo percorso multimodale.
- Hai già un'integrazione compatibile e puoi controllare conversione, contesto e fonti.
Prova prima Gemma 4 31B
- Il tuo ambiente supporta già la variante Google e i suoi formati.
- Le stime di memoria sono compatibili con una macchina da verificare sul carico reale.
Questi sono criteri per ordinare le prove, non verdetti di prestazione. Se nessuno supera i controlli essenziali, valuta un modello diverso o riduci il compito delegato; la correttezza del processo viene prima della preferenza per una famiglia.
Per un'alternativa più compatta puoi leggere Gemma 4 12B vs Ministral 3 14B. Se vuoi costruire un confronto sui tuoi manuali o sulle offerte dei fornitori, Giallo Studio progetta il pilota di consulenza AI partendo da fonti, domande e criteri che il tuo team possa controllare.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Qwen3.8-27B vs Gemma 4 26B A4B: dense o MoE?
- Qwen3.8-27B vs gpt-oss-20b: visione, testo e memoria
- PWA aziendale su misura: quando conviene rispetto a un software pronto
- Qwen3.8-27B vs Ministral 3 14B: quale portare in locale
- Perplexity vs Google: risposta con fonti o lista di link
- Qwen3.8-27B vs Qwen3.6-35B-A3B: cosa cambia in locale
- Claude Opus 5 vs Sonnet 5
- Qwen3-Coder-Next vs Devstral Small 2: codice in locale
- Claude Opus 5 vs GPT-6 Astra
- RPA vs AI automation: differenze, costi e quando usare quale
- Claude Opus 5 vs Gemini 3.1 Pro
- Voice AI o chatbot: quale canale scegliere
FAQ
È meglio Qwen3.8-27B o Gemma 4 31B?
Non c’è un vincitore verificato per ogni utilizzo. La scelta richiede prove sugli stessi documenti, registrando configurazione, errori, riferimenti e memoria effettiva.
Gemma 4 31B comprende audio?
La variante 31B dichiara testo e immagini in ingresso e testo in uscita. L’audio nativo della famiglia riguarda altre taglie, come E2B, E4B e 12B.
I due modelli sono MoE?
No, Qwen3.8-27B e Gemma 4 31B sono varianti dense. Gemma 4 26B A4B è invece una variante MoE distinta.
Quale richiede meno memoria?
Non basta confrontare i nomi. Vanno considerati formato effettivo dei pesi, quantizzazione, cache, contesto e runtime; le stime teoriche non sono requisiti sufficienti.
Posso usarli sui documenti aziendali in locale?
Sì, con un’infrastruttura compatibile. Devi verificare anche preparazione dei PDF, recupero dei documenti, permessi e servizi esterni usati dall’applicazione.