
Qwen3-Coder-Next vs Devstral Small 2: codice in locale
Qwen3-Coder-Next vs Devstral Small 2: pesi, memoria, immagini e agenti sul repository. Scegli con test riproducibili e permessi circoscritti.
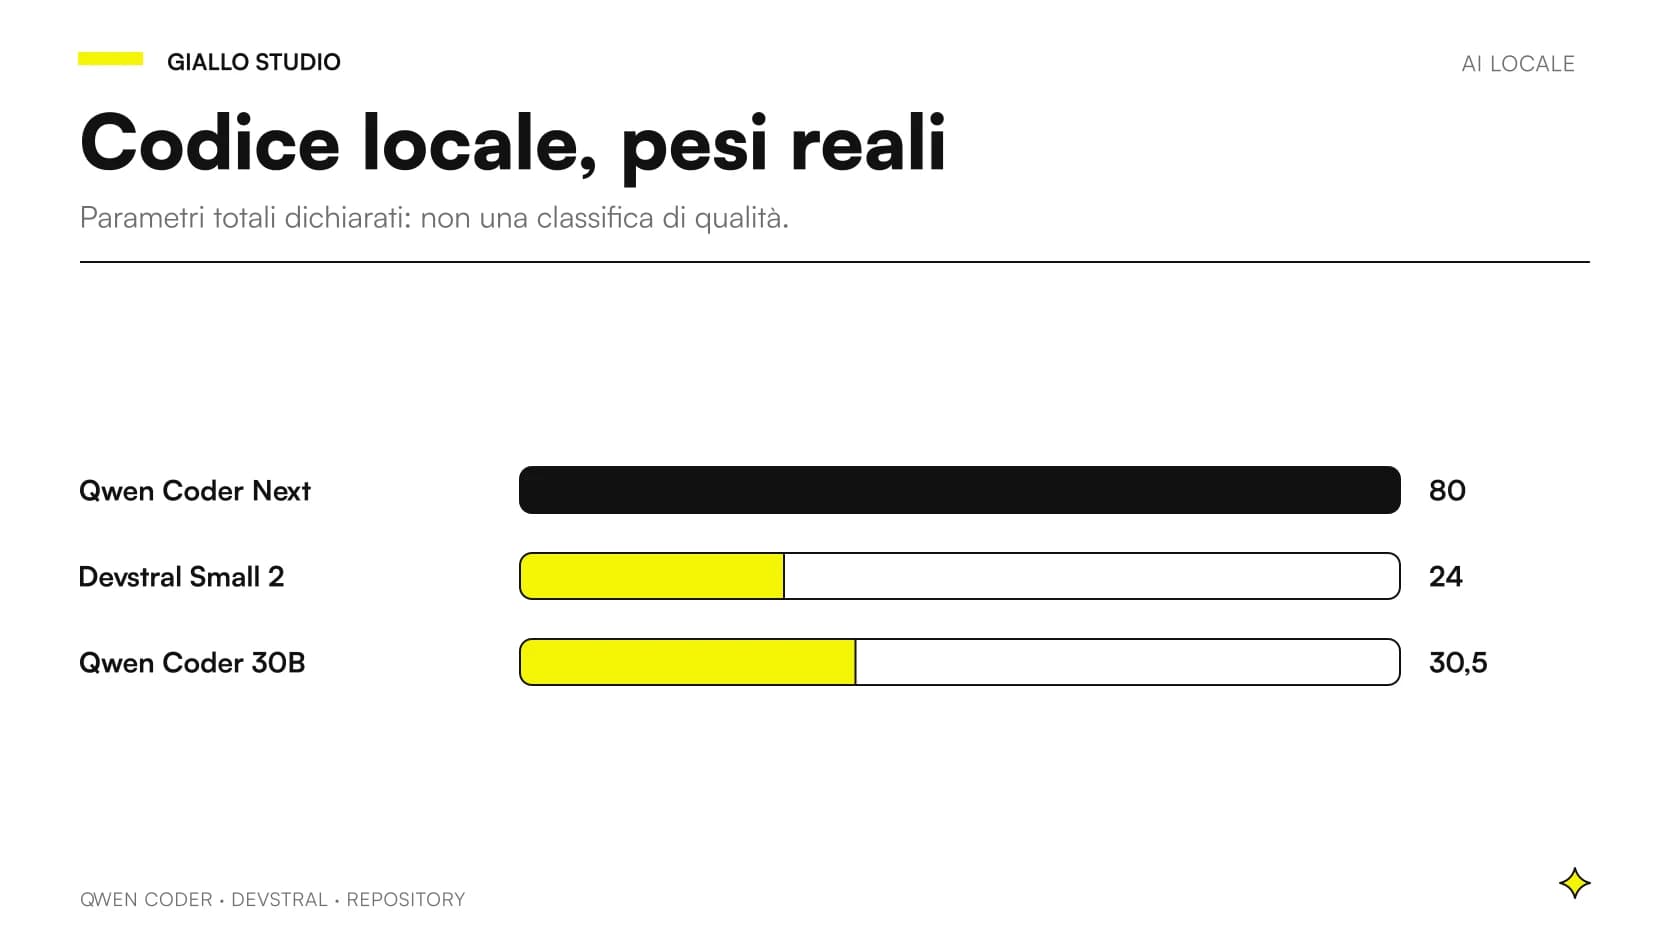
Qwen3-Coder-Next vs Devstral Small 2 va valutato sul lavoro che un agente completa nel repository, non sulla sola risposta in chat. Giallo non ha eseguito un test comparativo di questi checkpoint: non attribuiamo a uno dei due un primato sulla qualità del tuo codice.
La differenza iniziale riguarda il dimensionamento. Qwen3-Coder-Next è un MoE da 80B parametri totali, con 3B attivi; Devstral Small 2 24B Instruct è un modello da 24B orientato all'ingegneria del software, con supporto visivo. Questi dati, verificati sulle schede ufficiali il 27 ottobre 2026, servono a preparare una prova, non a prevedere automaticamente quale patch sarà corretta.
In sintesi
- I parametri attivi di Qwen non descrivono tutta la memoria necessaria.
- Un agente comprende modello, strumenti, ambiente e regole di esecuzione.
- I benchmark richiedono dataset e configurazioni confrontabili.
- La patch va verificata con test pertinenti e lettura del diff.
- Codice locale e strumenti con accesso alla rete sono scelte separate.
Perché una chat sul codice non basta a scegliere?
Scrivere una funzione isolata è diverso dal correggere un difetto in un progetto. L'agente deve trovare i file giusti, capire dipendenze e convenzioni, formulare una modifica, eseguire controlli e interpretarne gli esiti. Una risposta apparentemente brillante può fallire quando incontra un comando di test diverso da quello atteso o una libreria con un'API cambiata.
Il primo documento della prova dovrebbe quindi descrivere il lavoro: correzioni brevi, manutenzione di integrazioni, modifiche a componenti oppure navigazione in un archivio ampio. La selezione dei modelli AI per programmare parte da questi compiti. Se il team usa soprattutto l'AI per spiegare codice, può bastare una configurazione semplice. Se pretende modifiche autonome, deve valutare anche uso degli strumenti, recupero dagli errori e rispetto dei confini assegnati.
Che cosa comportano 80B totali e 3B attivi?
In un MoE soltanto una parte degli esperti partecipa a ciascun passaggio, ma questo non significa che il checkpoint completo scompaia dalla memoria. Qwen3-Coder-Next non va presentato come un modello minuscolo usando il numero dei parametri attivi. La distinzione fra dimensione complessiva e calcolo per token è essenziale quando si decide dove eseguirlo.
Un calcolo autonomo sui soli pesi, assumendo idealmente quattro bit per ciascuno degli 80 miliardi di parametri, dà circa 40 GB decimali. È un ordine di grandezza teorico, precedente a metadati e memoria operativa. Conversioni e offload possono cambiare il percorso reale, che deve essere documentato. La panoramica sulla quantizzazione di Hugging Face aiuta a distinguere precisione, hardware e metodo; non sostituisce una misura sul file e sul runtime scelti.
Come interpretare l'indicazione hardware di Devstral?
Mistral indica nella scheda di Devstral Small 2 la possibilità di esecuzione su una RTX 4090 o un Mac con 32 GB. È un riferimento del produttore da riportare come tale: non dimostra che ogni configurazione lavori bene sul repository di un'azienda, con un contesto esteso e altri programmi aperti.
Prima di acquistare hardware occorre fissare formato dei pesi, runtime, lunghezza del contesto e numero di richieste. Il computer di uno sviluppatore può ospitare contemporaneamente editor, browser, servizi locali e build. La disponibilità nominale della memoria non coincide con lo spazio lasciato all'inferenza. Per il Mac la guida a LLM con 16, 24 o 32 GB spiega come provare il carico; su PC vale la distinzione fra RAM e VRAM su Windows.
Quali differenze annotare prima del test?
| Voce | Qwen3-Coder-Next | Devstral Small 2 | Conseguenza pratica |
|---|---|---|---|
| Dimensione dichiarata | 80B totali, 3B attivi | 24B | Dimensionare il checkpoint effettivo |
| Modalità rilevante | Testo | Testo e immagini | Separare task visivi e testuali |
| Specializzazione | Coding e agenti | Ingegneria del software | Provare navigazione e modifica |
| Licenza della scheda | Apache 2.0 | Apache 2.0 | Conservare termini e provenienza |
| Risultato aziendale | Da misurare | Da misurare | Valutare patch e regressioni |
Le specifiche provengono dalle due model card ufficiali citate. Non sono giudizi sulla qualità italiana o sul proprio stack. Anche una differenza di modalità può non incidere sul lavoro: una schermata aiuta a descrivere un difetto visivo, ma una riproduzione verificabile e un test possono restare necessari. L'accesso alle immagini non risolve automaticamente la diagnosi del browser.
Modello e agente: quali componenti devono essere uguali?
Per isolare l'effetto del modello, il confronto dovrebbe mantenere uguali repository, descrizione del problema, strumenti disponibili e criteri di successo. Anche il budget operativo deve essere esplicito: numero di tentativi, durata massima e possibilità di installare dipendenze. Un candidato lasciato libero di lavorare a lungo non è direttamente confrontabile con uno interrotto alla prima patch.
Esistono però integrazioni specifiche che richiedono formati diversi per le chiamate agli strumenti. In questo caso si documenta la differenza, senza fingere un isolamento perfetto della variabile. Il risultato riguarda la configurazione completa utilizzabile dal team. La scelta fra Ollama e LM Studio è un'altra decisione di questo tipo: compatibilità e osservabilità possono contare quanto la comodità iniziale dell'interfaccia.
Come leggere SWE-bench senza costruire una falsa classifica?
SWE-bench valuta modifiche a repository a partire da problemi software e mette a disposizione un ambiente di valutazione riproducibile. Le varianti del dataset e le condizioni di esecuzione vanno distinte. Un risultato pubblicato con un particolare agente non descrive qualsiasi editor collegato agli stessi pesi.
Nel confronto aziendale conviene riportare i benchmark come contesto, indicando esattamente che cosa misurano. Non sommare percentuali di dataset differenti e non attribuire a una quantizzazione il risultato della versione originale senza una prova. Per la decisione finale serve un campione interno: difetti rappresentativi dello stack, con soluzione e controlli definiti prima. Il metodo di benchmark per LLM locali descrive come tenere separati qualità, fallimenti e tempi.
Uno scenario: correggere un'importazione nel gestionale
Immaginiamo un team che mantenga un gestionale e debba gestire un file di importazione con campi mancanti. È un esempio ipotetico. La consegna all'agente contiene un file fittizio, il comportamento atteso e i comandi di verifica. Entrambi i candidati lavorano su copie equivalenti del progetto, senza credenziali o dati di produzione.
Il successo non consiste soltanto nell'accettare il file difettoso. La patch deve distinguere dati mancanti da dati invalidi, restituire un errore comprensibile e conservare il comportamento dei casi già funzionanti. Si controlla se l'agente modifica file estranei, nasconde l'errore o elimina una validazione utile. Una soluzione più corta può risultare preferibile se copre il problema senza introdurre un sistema di importazione completamente nuovo. Il confronto conserva anche i tentativi falliti, perché rappresentano lavoro e rischio reali.
Uno scenario: capire un difetto mostrato in uno screenshot
Un secondo caso illustrativo riguarda una pagina amministrativa in cui un pulsante diventa illeggibile. L'input comprende screenshot, percorso della pagina e condizioni per riprodurre il problema. Il supporto visivo di Devstral può diventare un requisito da provare; con un candidato testuale occorre trasformare parte dell'evidenza in una descrizione, oppure affiancare un altro componente.
La valutazione deve dichiarare questa differenza. Non sarebbe equo descrivere accuratamente il difetto a un modello e fornire all'altro un'immagine ambigua senza contesto. Dopo la modifica bisogna aprire la pagina e controllare lo stato che aveva causato l'errore, comprese dimensioni dello schermo e tema. Uno screenshot corretto non dimostra che tutte le interazioni funzionino. L'agente deve produrre evidenze collegate al requisito, mentre il revisore distingue il difetto risolto dalle regressioni introdotte.
Quali permessi assegnare al primo esperimento?
- Preparare una copia del repository con dati fittizi e dipendenze conosciute.
- Consentire lettura e modifiche soltanto nelle cartelle necessarie.
- Definire i comandi di verifica e osservare ogni richiesta di accesso aggiuntiva.
- Rivedere la patch prima di collegarla a sistemi reali o pubblicarla.
Questi sono confini progettuali proposti per la prova, non funzioni attribuite automaticamente ai due modelli. L'ambiente scelto deve essere capace di applicarli. Un'istruzione nel prompt può esprimere una regola, ma non crea da sola un isolamento tecnico.
Occorre verificare separatamente la rete degli strumenti. Un modello eseguito sul computer può invocare estensioni o servizi che comunicano altrove. Il tema riguarda l'intero percorso offline dell'AI locale, compresi installazioni, diagnostica e ricerca della documentazione. Una configurazione di sviluppo deve rendere queste operazioni visibili e controllabili.
Che cosa misurare oltre ai test verdi?
I test possono passare mentre la patch resta fragile o sproporzionata. Un agente potrebbe aggirare la condizione problematica, cambiare l'aspettativa del test oppure introdurre una dipendenza non necessaria. Per questo il verbale include lettura del diff e spiegazione del nesso fra modifica e difetto. L'operatore deve poter capire perché la correzione copre il caso.
Sono utili categorie separate: soluzione corretta, soluzione incompleta, modifica fuori ambito, errore di esecuzione, mancata comprensione del progetto. Si registra anche il tempo di revisione. Se una patch richiede un lungo controllo di cambiamenti non richiesti, il costo non è rappresentato dai soli secondi impiegati per generarla. Non servono percentuali decorative: bastano definizioni stabili e casi tracciabili. Il confronto diventa ripetibile e può essere aggiornato quando cambiano stack o requisiti.
Come gestire contesto e informazioni sul repository?
Fornire l'intero progetto senza selezione può aggiungere rumore, consumare memoria e rendere difficile controllare quali istruzioni abbiano inciso. Conviene partire da descrizione del problema, struttura essenziale e accesso di ricerca ai file. Il modello deve trovare i riferimenti e collegarli al comportamento, non ricevere una raccolta indiscriminata di contenuti.
Le regole del progetto devono distinguere convenzioni, comandi verificati e vincoli sul cambiamento. Se il repository include documenti di terzi o esempi con istruzioni, l'ambiente deve trattarli come materiale da analizzare, non come autorizzazioni. Si misura inoltre il comportamento quando manca un file o un comando fallisce: fermarsi con una spiegazione accurata può essere migliore che inventare un esito. La qualità di un agente comprende la capacità di riconoscere ciò che non ha potuto verificare.
Gli errori che fanno sembrare economico un progetto fragile
Considerare soltanto i parametri attivi sottostima il dimensionamento. Considerare soltanto i token generati ignora il lavoro di revisione. Considerare soltanto il benchmark pubblico trascura il repository reale. Questi errori possono sommarsi e rendere convincente una configurazione che non sostiene il lavoro quotidiano.
Un'altra scorciatoia è aggiornare contemporaneamente modello, integrazione dell'editor e librerie del progetto. Se compare una regressione, diventa difficile attribuirla. Le versioni approvate vanno registrate e cambiate con una prova di riferimento. Il risultato atteso non è un agente che sembra autonomo in una dimostrazione, ma uno strumento che aiuta il team entro confini comprensibili e ripetibili, con un percorso di recupero quando il lavoro non riesce.
Che cosa consegnare insieme alla configurazione approvata?
Chi userà lo strumento deve poter riprodurre il percorso senza dipendere da chi ha svolto la dimostrazione. La consegna comprende un elenco dei componenti, le impostazioni necessarie, il campione di verifica e un esempio di esito rifiutato. Quest'ultimo chiarisce quando il team deve interrompere il tentativo e procedere con il normale sviluppo.
Serve anche una regola per le sessioni persistenti: quali conversazioni si conservano, quando si riparte da un contesto pulito e come si escludono informazioni ormai superate. Un agente che ricorda una vecchia struttura del progetto può proporre una modifica coerente con il passato e sbagliata oggi. Il team deve sapere come riconoscere e correggere questa situazione, senza compensarla aggiungendo istruzioni sempre più lunghe.
Infine, la valutazione deve restare consultabile dopo l'adozione. Quando un collega trova una regressione, dovrebbe poter aggiungere il caso al campione e verificare se riguarda solo quella versione o l'intero flusso. La manutenzione della prova costa lavoro, ma evita di trasformare ogni problema in una discussione soggettiva sulla capacità del modello.
Dalla prova locale a uno strumento del team
La scelta finale può favorire la configurazione più semplice da mantenere, anche se un'altra appare più ambiziosa sulla carta. Conta completare il tipo di modifica necessario con qualità sufficiente e revisione sostenibile. Il verbale deve indicare compiti ammessi, esclusioni, hardware, versioni e controlli richiesti prima di accettare una patch.
Per iniziare basta un gruppo circoscritto di difetti rappresentativi, senza affidare all'agente rilascio e accessi di produzione. Se il confronto deve diventare un'integrazione nel tuo processo di sviluppo, Giallo Studio realizza software su misura e può impostare ambiente, valutazione e regole operative intorno al repository effettivo. È quel percorso che trasforma un modello scaricato in un aiuto concreto per chi scrive e mantiene codice.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Qwen3.8-27B vs Qwen3.6-35B-A3B: cosa cambia in locale
- RPA vs AI automation: differenze, costi e quando usare quale
- Qwen3.8-27B vs Ministral 3 14B: quale portare in locale
- Voice AI o chatbot: quale canale scegliere
- Qwen3.8-27B vs gpt-oss-20b: visione, testo e memoria
- AI in abbonamento o su misura: cosa conviene
- Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
- AI fai da te o agenzia: come decidere
- Qwen3.8-27B vs Gemma 4 26B A4B: dense o MoE?
- AI locale vs cloud: come confrontare i costi in azienda
- PWA aziendale su misura: quando conviene rispetto a un software pronto
- Automazione tradizionale e automazione con AI: differenze per una PMI
FAQ
Qwen3-Coder-Next è un modello da tre miliardi di parametri?
Ha 80 miliardi di parametri totali e circa tre miliardi attivi, secondo la model card. La memoria dei pesi non si calcola usando soltanto i parametri attivati per token.
Devstral Small 2 può essere eseguito su un Mac da 32 GB?
Mistral cita un Mac con 32 GB fra le possibilità di distribuzione locale. È un'indicazione del produttore, non una garanzia di qualsiasi contesto, precisione, concorrenza o velocità.
Quale dei due è migliore sul codice di un'azienda?
Non è stato svolto un benchmark Giallo che stabilisca un vincitore. Occorre misurare patch corrette, regressioni, tempi e revisione sul repository e sullo stack effettivi.
I benchmark SWE-bench misurano soltanto il modello?
Il risultato dipende anche da strumenti, ambiente, budget e modalità di valutazione. Punteggi di dataset o configurazioni diversi non vanno trattati come una classifica direttamente confrontabile.
Un agente locale può inviare codice all'esterno?
Il modello può essere locale mentre gli strumenti usano servizi remoti. Vanno verificati rete, estensioni, provider configurati e comandi consentiti lungo l'intero percorso.