
Qwen3.8-27B vs Gemma 4 26B A4B: dense o MoE?
Qwen3.8-27B vs Gemma 4 26B A4B: parametri attivi, memoria, documenti e prove. Come valutare dense e MoE senza false promesse.
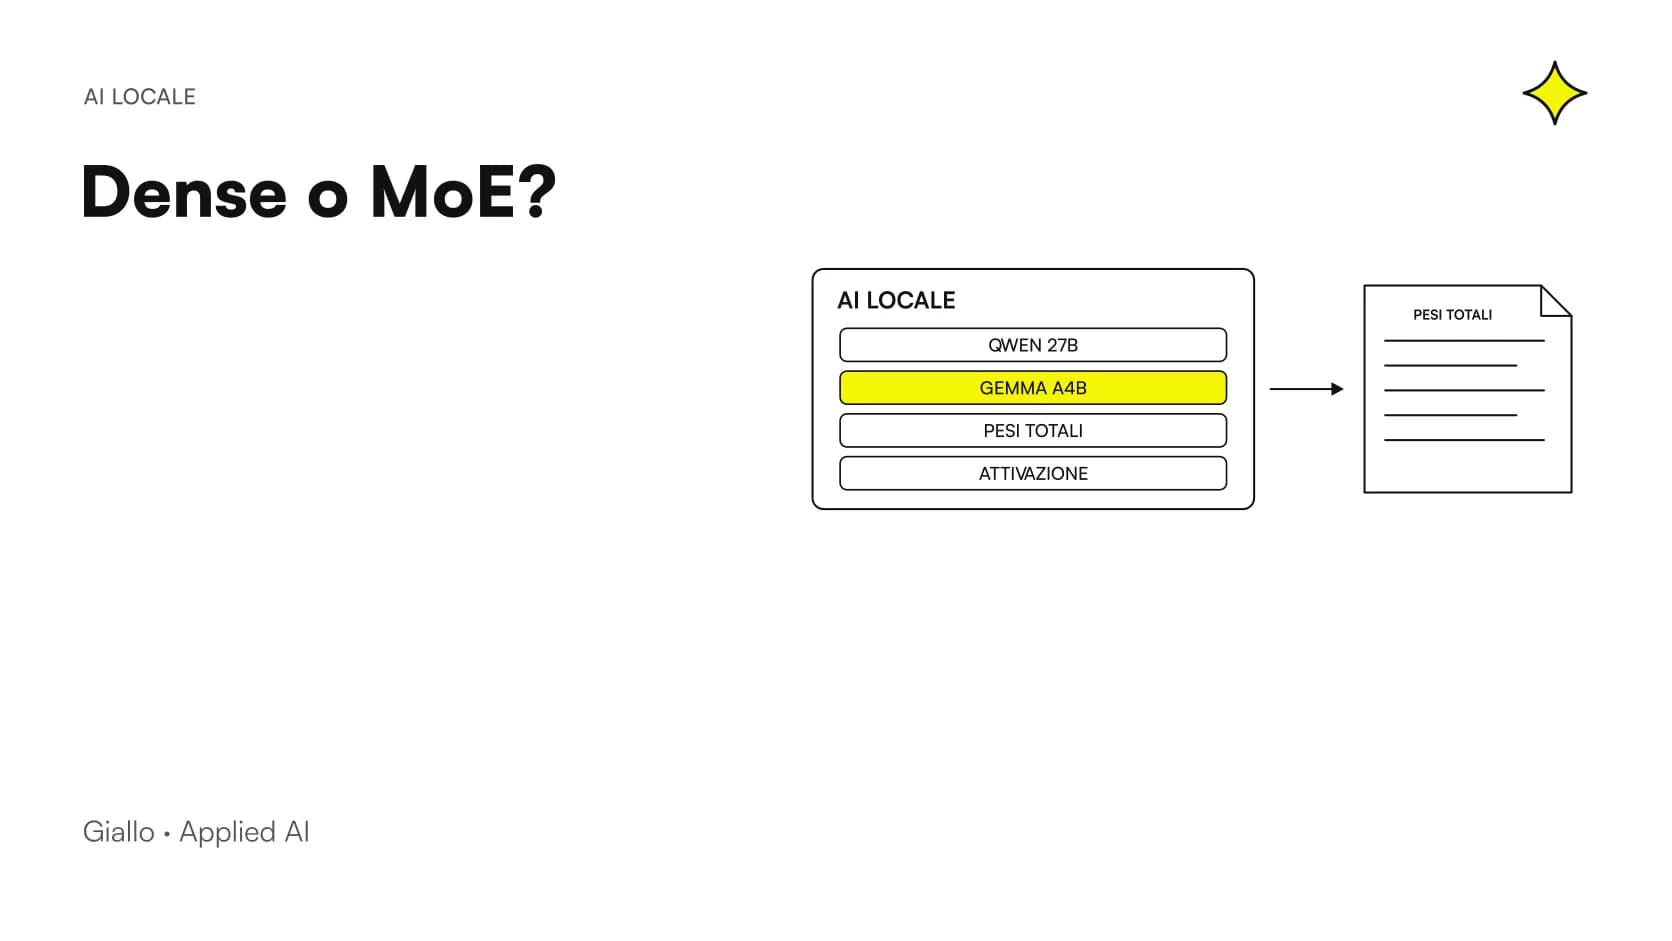
Qwen3.8-27B è dense; Gemma 4 26B A4B è un MoE che attiva soltanto una parte dei propri parametri per ciascun token. Questa differenza può cambiare il lavoro di calcolo, ma non permette di dedurre che Gemma richieda la memoria di un modello da 4B o che sia sempre più veloce. Le specifiche sono documentate nelle card ufficiali di Qwen e Google, consultate il 27 ottobre 2026.
Il confronto interessa chi vuole mantenere il modello sotto il proprio controllo e deve scegliere come usare la memoria disponibile. La risposta utile arriva quando separi tre domande: quanti pesi caricare, quanto lavoro eseguire per generare, quali risposte risultano corrette nel processo. Le tre dimensioni si influenzano, ma non sono intercambiabili. Qui trovi criteri e prove da impostare; non una classifica basata su misurazioni che non abbiamo eseguito.
In sintesi
- Qwen3.8-27B ha un modello linguistico dense da 27B con encoder visivo.
- Gemma 4 26B A4B dichiara 25,2B parametri totali e 3,8B attivi, oltre alla componente visiva indicata nella card.
- Un minor numero di parametri attivi non cancella il resto dei pesi da conservare e rendere disponibili.
- La memoria reale dipende anche da formato, cache, contesto e runtime.
- Il confronto valido distingue capacità, risorse richieste ed errori sul lavoro aziendale.
Cosa significa dense nel Qwen da 27B?
Nel linguaggio del confronto, dense indica che il modello non seleziona soltanto un gruppo di esperti per svolgere il calcolo del blocco linguistico. Qwen3.8-27B viene descritto come modello dense da 27 miliardi di parametri, con un encoder visivo separato. Il numero commerciale non deve quindi essere usato come conteggio esatto dell'intero pacchetto multimodale. Fonte: card Qwen3.8-27B.
Per chi decide in azienda, il vantaggio di capire questo termine è evitare paragoni sbagliati. Un “27B dense” e un “26B con circa 4B attivi” non svolgono necessariamente lo stesso lavoro per ogni token, anche se il numero totale appare vicino. Questo non assegna automaticamente un vincitore: motore di inferenza, memoria e dati in ingresso restano parte della valutazione. Per le caratteristiche generali del checkpoint, consulta la scheda Qwen3.8-27B in locale.
Cosa significa A4B nel nome Gemma?
Nella variante Gemma 4 26B A4B, la A indica i parametri attivi. La card ufficiale Google riporta 25,2B totali, 3,8B attivi, un encoder visivo di circa 550M e un insieme di esperti di cui viene selezionata una parte per token. È questa architettura a distinguere la variante dal Gemma 4 31B dense.
Il modello conserva la possibilità di indirizzare token differenti verso esperti differenti. La selezione riduce il lavoro attivo, non la dimensione del checkpoint al valore A4B. Perciò una scheda tecnica deve riportare sia parametri totali sia attivi. Se un fornitore presenta un sistema come “4B” omettendo il resto, chiedi quale file carica, dove risiedono i pesi e quale memoria rimane libera quando il servizio è pronto a rispondere.
Quali specifiche possiamo confrontare senza inferenze?
Entrambi i checkpoint dichiarano capacità testuali e visive e licenza Apache 2.0. Qwen documenta 262.144 token nativi; Gemma dichiara 256K per la variante 26B A4B. Il modello Google di questa pagina non ha l'ingresso audio nativo indicato per altre taglie Gemma 4. Fonti: Qwen, Google.
| Dimensione | Qwen3.8-27B | Gemma 4 26B A4B |
|---|---|---|
| Famiglia architetturale | Dense | Mixture of Experts |
| Parametri linguistici dichiarati | 27B | 25,2B totali / 3,8B attivi |
| Componente visiva | Presente | Presente, circa 550M |
| Contesto nativo dichiarato | 262.144 token | 256K token |
| Ingresso audio nativo | Non dichiarato per questo checkpoint | Non presente |
| Memoria completa in esecuzione | Da misurare sul carico | Da misurare sul carico |
| Qualità sulle procedure aziendali | Da verificare | Da verificare |
La tabella descrive il punto di partenza. Le ultime due righe richiedono prove e non si ricavano dalle prime.
Perché un MoE non occupa soltanto la memoria degli esperti attivi?
Gli esperti non selezionati per un token possono servire al successivo. Il sistema deve quindi conservarli e renderli accessibili, tramite memoria del dispositivo o un meccanismo di trasferimento previsto dal runtime. Spostare parte dei pesi altrove modifica il modo di esecuzione; non equivale a farli scomparire.
Questa distinzione è importante quando guardi una macchina con memoria limitata. Non puoi stimare il caricamento di Gemma 4 A4B moltiplicando soltanto 3,8B per i bit della quantizzazione. Devi partire dall'intero pacchetto effettivamente distribuito, poi aggiungere le altre risorse richieste. La guida sulla quantizzazione GGUF, Q4 e Q8 spiega perché anche due file descritti come “4 bit” possano avere dimensioni e comportamento diversi. Una prova che va in errore con un documento lungo non viene salvata dalla sola etichetta MoE.
Quali stime di memoria sono disponibili per Gemma?
Nella documentazione Gemma 4, Google stima per la variante 26B A4B circa 57,7 GB BF16, 28,8 GB SFP8 e 14,4 GB Q4_0 per il caricamento, includendo un overhead indicativo del 20%. La pagina precisa che gli importi possono cambiare con ambiente e strumento. Si tratta di memoria stimata dal produttore, non di una prova Giallo Studio.
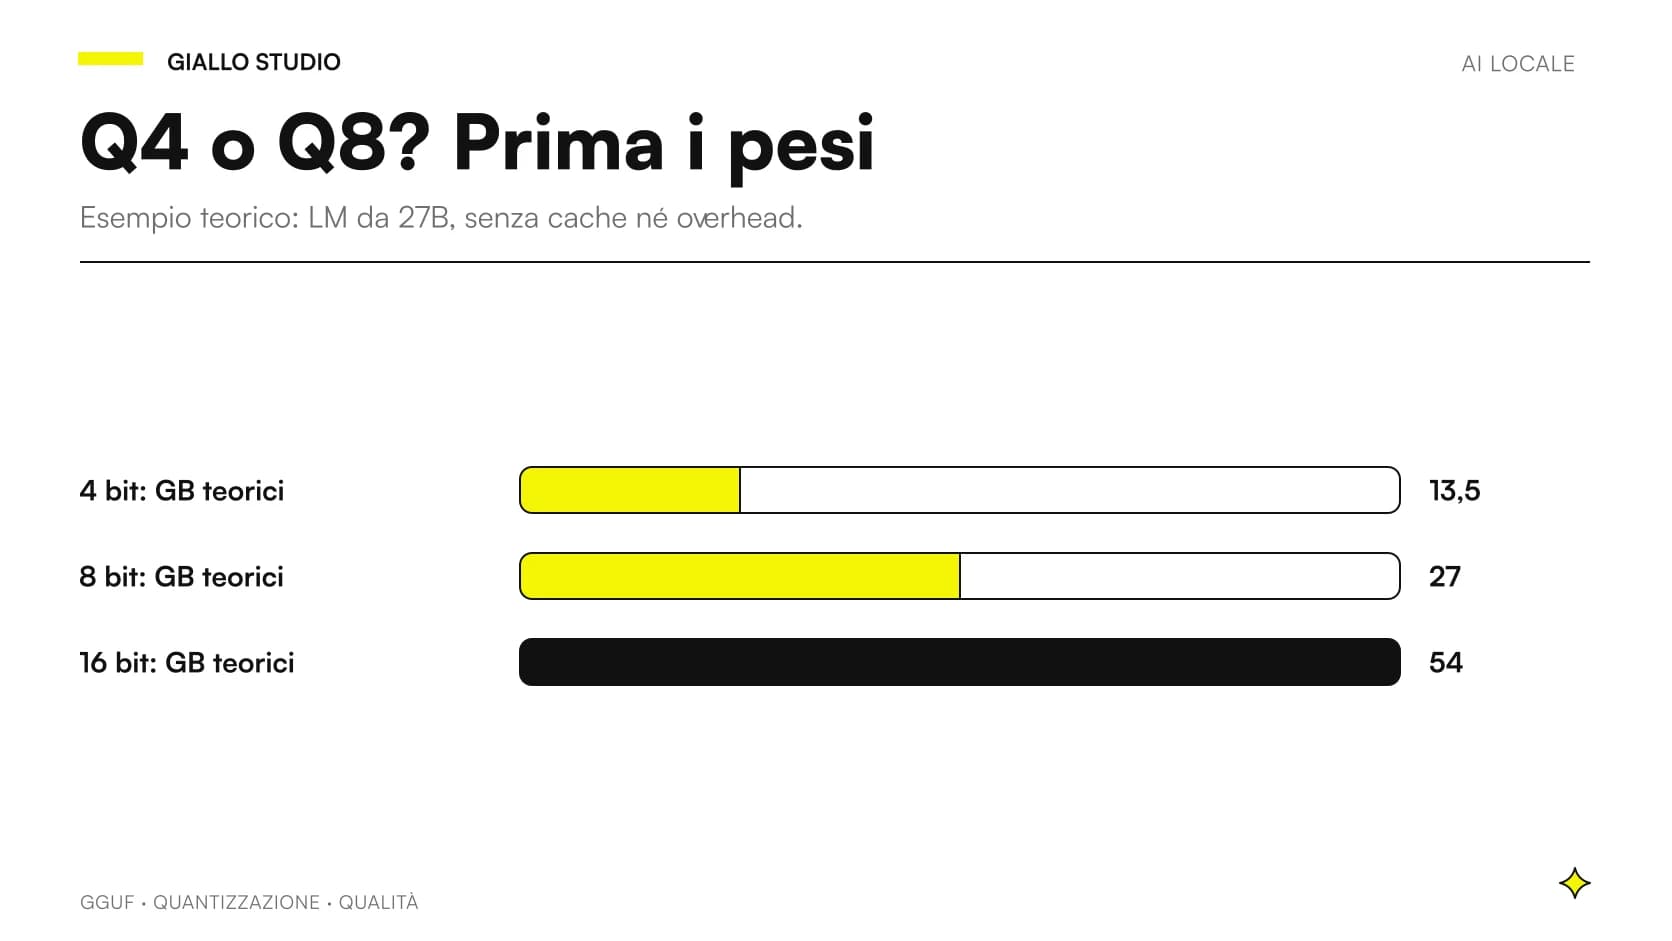
Per Qwen3.8-27B, il calcolo teorico dei soli 27B pesi linguistici a 4 bit dà circa 13,5 GB decimali. Il perimetro è diverso: non include tutto ciò che serve al sistema e non è direttamente comparabile alla stima Google. Prima di un acquisto serve un'osservazione sul file reale, con lo stesso contesto e la stessa pipeline. La guida ai requisiti RAM e VRAM di Qwen separa questi livelli di calcolo.
Il MoE risponde sempre più rapidamente?
Non possiamo prometterlo per una configurazione che non abbiamo misurato. Il numero di parametri attivi descrive una parte del lavoro, mentre il tempo percepito dipende anche da implementazione, hardware, trasferimenti, lunghezza dell'input e quantità di output generato. La documentazione Google presenta l'architettura come orientata a un'esecuzione efficiente; è una caratteristica da verificare nel tuo ambiente, non un dato universale in token al secondo. Fonte: architettura Gemma 4.
Dividi la misurazione in caricamento, preparazione dell'input, comparsa del primo token e completamento. Una richiesta con fotografia può avere un profilo diverso da una domanda breve. Valuta anche risposte corrette per intervallo operativo: una generazione più rapida ma spesso da rifare può peggiorare il lavoro del reparto. Non aggregare tutte queste condizioni in un numero privo di contesto.
Come cambia il confronto con documenti molto lunghi?
Il contesto dichiarato indica la finestra supportata, non garantisce che tutte le evidenze vengano utilizzate correttamente. Un documento può contenere numerose ripetizioni, allegati in contraddizione o istruzioni non più valide. La qualità del confronto dipende dalla capacità di individuare proprio il passaggio pertinente, senza nascondere le incongruenze.
Usa una domanda la cui risposta è all'inizio del documento, un'altra a metà e un'altra vicino alla fine; inserisci anche una richiesta non risolvibile. Mantieni stabile la preparazione del testo. Qwen documenta inoltre l'estensione del proprio contesto, ma non va attivata indiscriminatamente: il massimo configurabile non è l'obiettivo del pilota. Fonte Qwen. Per consultare un archivio articolato considera il RAG locale sui documenti aziendali, mantenendo data e versione di ogni fonte.
Quale prova serve per un archivio qualità?
Scenario ipotetico: un'azienda manifatturiera vuole interrogare procedure di qualità, istruzioni operative e verbali di non conformità. Lo scopo non è ottenere una risposta lunga, ma ricostruire quali documenti regolano il caso e quali informazioni mancano. La prova deve includere una procedura valida e una versione precedente con lo stesso titolo.
Chiedi a entrambi i modelli di fornire risposta, fonte, revisione ed eventuale dubbio. Fai valutare gli esiti al responsabile qualità senza mostrargli inizialmente il nome del modello. Se uno confonde sistematicamente i documenti revocati, quel problema pesa più di un buon risultato su domande semplici. Dopo la scelta, conserva il campione come prova di regressione: quando aggiorni pesi o runtime, ripeti i casi che avevano già creato difficoltà.
Quale prova serve per una rete commerciale?
Secondo scenario ipotetico: una piccola rete commerciale vuole preparare risposte sui prodotti consultando schede tecniche e listini autorizzati. La capacità critica è distinguere una caratteristica disponibile da un'opzione, una disponibilità aggiornata da un'informazione storica e un prezzo approvato da un calcolo libero.
Costruisci casi in cui il listino non contiene il prodotto richiesto e casi in cui una fotografia mostra soltanto una parte dell'etichetta. Il sistema deve chiedere il dato mancante, non completarlo per analogia. Verifica anche che l'assistente non trasformi automaticamente la bozza in un'offerta inviata al cliente. Il modello locale può aiutare a preparare il lavoro, ma le operazioni verso l'esterno richiedono permessi e controlli nel software che lo circonda. L'architettura dense o MoE non definisce quei confini.
Come evitare un confronto truccato dalle impostazioni?
Prepara un registro con revisioni dei checkpoint, conversioni, quantizzazione, runtime e macchina. Scegli se confrontare le configurazioni raccomandate dai produttori oppure quelle che rientrano nello stesso vincolo operativo; entrambe le prove possono essere utili se sono dichiarate. Non mostrare un modello con contesto ridotto e l'altro con tutte le fonti necessarie, attribuendo poi la differenza all'architettura.
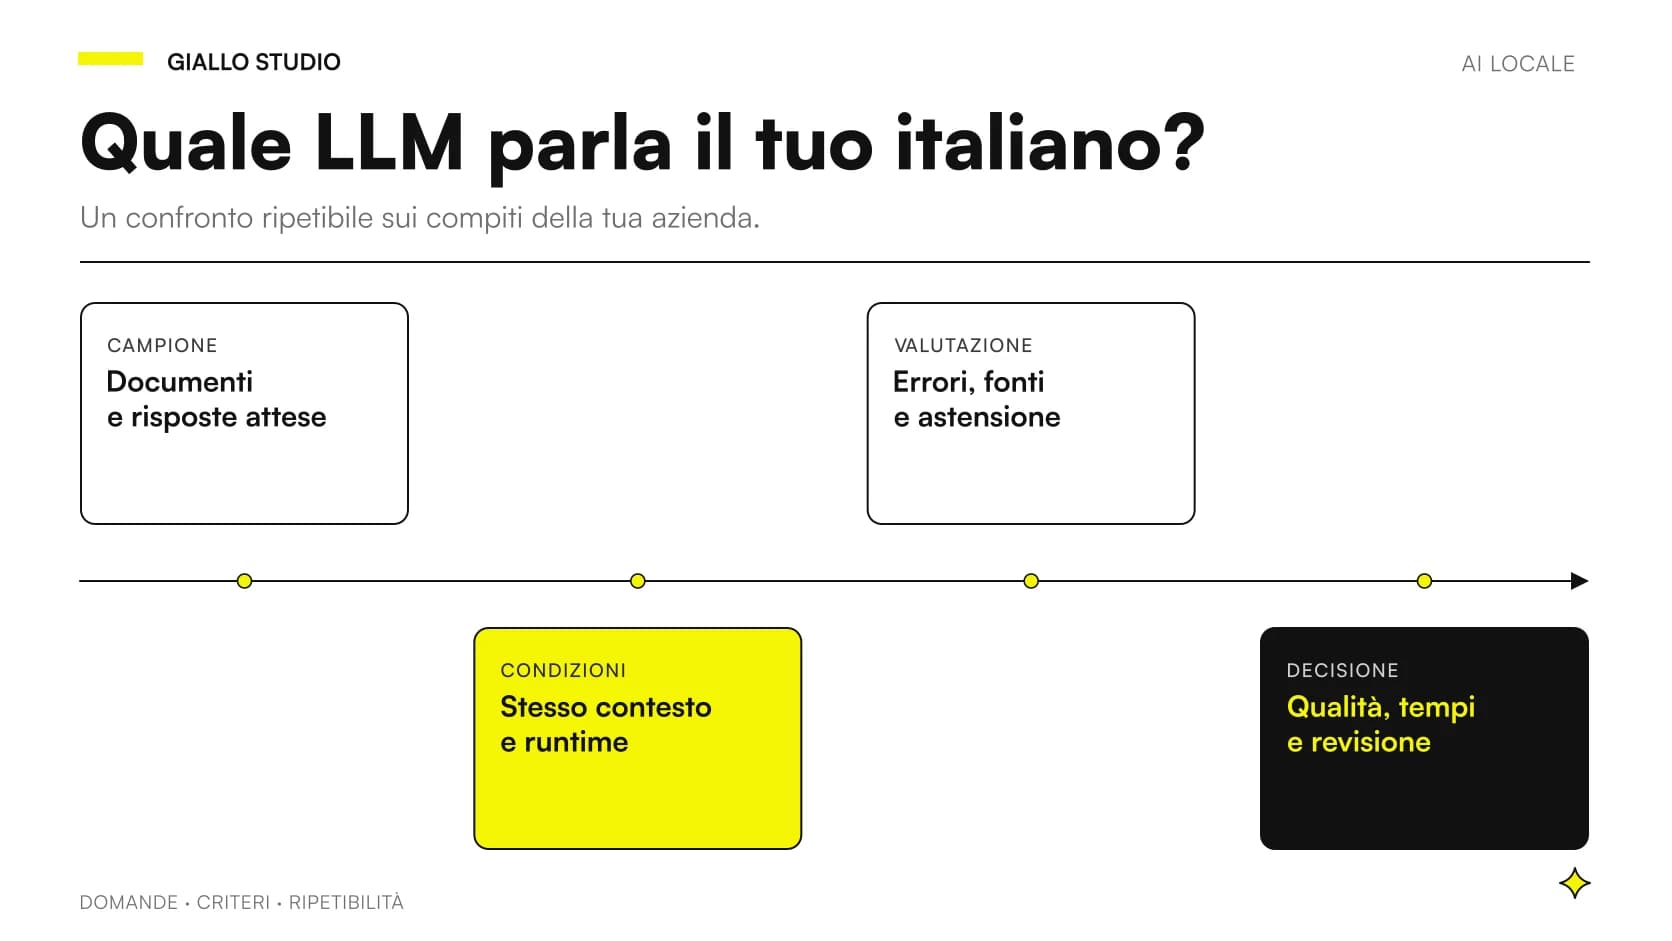
Anche il budget di risposta conta. Una risposta interrotta prima della conclusione può risultare inutilizzabile pur avendo identificato correttamente le evidenze. Registra quindi eventuali troncamenti, tentativi ripetuti e correzioni manuali. Il protocollo per confrontare LLM locali in italiano aiuta a separare esiti corretti, astensioni appropriate e risposte inventate. Scegli le regole prima di leggere i risultati, così il test resta contestabile e ripetibile.
Quali costi restano oltre al calcolo per token?
L'architettura non riassume il costo del servizio. Considera acquisto o disponibilità dell'hardware, aggiornamenti, integrazione con gli archivi, monitoraggio e assistenza al personale. Se il sistema richiede frequenti interventi per correggere fonti o riavviare il runtime, il minor lavoro teorico per token non basta a rendere sostenibile la scelta.
Calcola il costo sul risultato accettato dal processo, mantenendo distinta la correzione umana. Un confronto economico deve poi usare volumi e ore del tuo caso reale, oppure dichiarare esplicitamente che sta simulando uno scenario. Nell'articolo AI locale vs cloud e costi aziendali trovi le voci da collegare al preventivo. Non inseriamo qui prezzi correnti di GPU o tempi di rientro, perché senza macchina, utilizzo e tariffa energetica sarebbero numeri privi di fondamento.
Quali errori di interpretazione riconoscere subito?
“Quattro miliardi attivi, quindi bastano quattro gigabyte” confonde parametri, precisione e risorse. “Ventisette è maggiore di ventisei, quindi Qwen è migliore” usa il totale come punteggio di qualità. “Entrambi Apache, quindi tutti i componenti sono gratuiti e utilizzabili allo stesso modo” estende indebitamente la licenza a interfacce, servizi e derivati.
Controlla il LICENSE di Qwen e quello collegato dalla card Gemma 4. La famiglia e la generazione contano: non trasferire a Gemma 4 le condizioni di Gemma 3 o a un altro Qwen quelle del 27B. Sul piano dei dati, anche un'inferenza locale può essere accompagnata da OCR o ricerca remoti: va verificato l'intero percorso dei documenti.
Per isolare la differenza fra dense e MoE dentro la stessa famiglia, prosegui con Qwen3.8-27B vs Qwen3.6-35B-A3B. Quel confronto mette a fuoco un possibile cambio di checkpoint: prima si misura la memoria, poi si verificano le regressioni sul campione del proprio processo.
Quando scegliere l'uno come primo candidato?
Come decidere l'ordine del pilota senza proclamare un vincitore?
Parti dal modello già compatibile con il tuo ambiente, se soddisfa modalità di ingresso e licenza richieste. Prepara poi lo stesso campione per l'alternativa, misura memoria e qualità e annota gli errori che bloccano il processo. Se stai valutando proprio il compromesso dense/MoE, mantieni esplicito quali risorse e quali impostazioni cambiano.
Gemma 4 26B A4B merita la prova quando vuoi valutare il suo compromesso tra pesi totali e calcolo attivo; Qwen3.8-27B quando il checkpoint dense e il suo percorso multimodale corrispondono al tuo progetto. Il risultato deve restare una scelta spiegabile con evidenze, non un'affermazione assoluta sul migliore modello locale.
Per confrontare due dense guarda Qwen3.8-27B vs Gemma 4 31B. Per costruire il pilota con documenti, metriche e limiti di accesso, Giallo Studio sviluppa software AI su misura: il punto di partenza è una domanda di lavoro che il team sappia verificare.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Qwen3.8-27B vs Qwen3.6-35B-A3B: cosa cambia in locale
 Qwen3.8-27B in locale: capacità, limiti e requisiti
 Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
 Quantizzazione GGUF: Q4 o Q8 per gli LLM locali?
 RAG locale sui documenti aziendali: come progettarlo
 LLM locali in italiano: come confrontarli senza falsi test
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- PWA aziendale su misura: quando conviene rispetto a un software pronto
- Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
- Perplexity vs Google: risposta con fonti o lista di link
- Qwen3.8-27B vs gpt-oss-20b: visione, testo e memoria
- Claude Opus 5 vs Sonnet 5
- Qwen3.8-27B vs Ministral 3 14B: quale portare in locale
- Claude Opus 5 vs GPT-6 Astra
- Qwen3.8-27B vs Qwen3.6-35B-A3B: cosa cambia in locale
- Claude Opus 5 vs Gemini 3.1 Pro
- Qwen3-Coder-Next vs Devstral Small 2: codice in locale
- Claude Opus 5 vs Fable 5.1
- RPA vs AI automation: differenze, costi e quando usare quale
FAQ
Cosa cambia tra Qwen3.8-27B e Gemma 4 26B A4B?
Qwen è un modello linguistico dense da 27B con componente visiva. Gemma 4 26B A4B usa un’architettura MoE: la card dichiara 25,2B totali e 3,8B attivi, oltre all’encoder visivo indicato.
Gemma 4 A4B richiede la memoria di un 4B?
No. I parametri attivi descrivono il lavoro selezionato per token, mentre i pesi completi devono essere conservati e resi disponibili dal sistema.
MoE significa che il modello è sempre più veloce?
No. La velocità effettiva dipende anche da hardware, runtime, formato, trasferimenti e tipo di richiesta. Va misurata nella configurazione prevista.
Quale dei due è migliore per documenti aziendali?
Serve un campione con documenti rappresentativi e risposte attese. Conta la correttezza delle evidenze, la gestione delle versioni e l’astensione quando manca una fonte.
Entrambi hanno licenza Apache 2.0?
Sì, i checkpoint ufficiali considerati qui dichiarano Apache 2.0. Verifica separatamente condizioni di conversioni, applicazioni e servizi che userai.