
AI multimodale locale: leggere PDF e immagini aziendali
AI multimodale locale per PDF, scansioni e immagini: OCR, modelli visivi, citazioni e controlli. Progetta un flusso verificabile sui tuoi documenti.
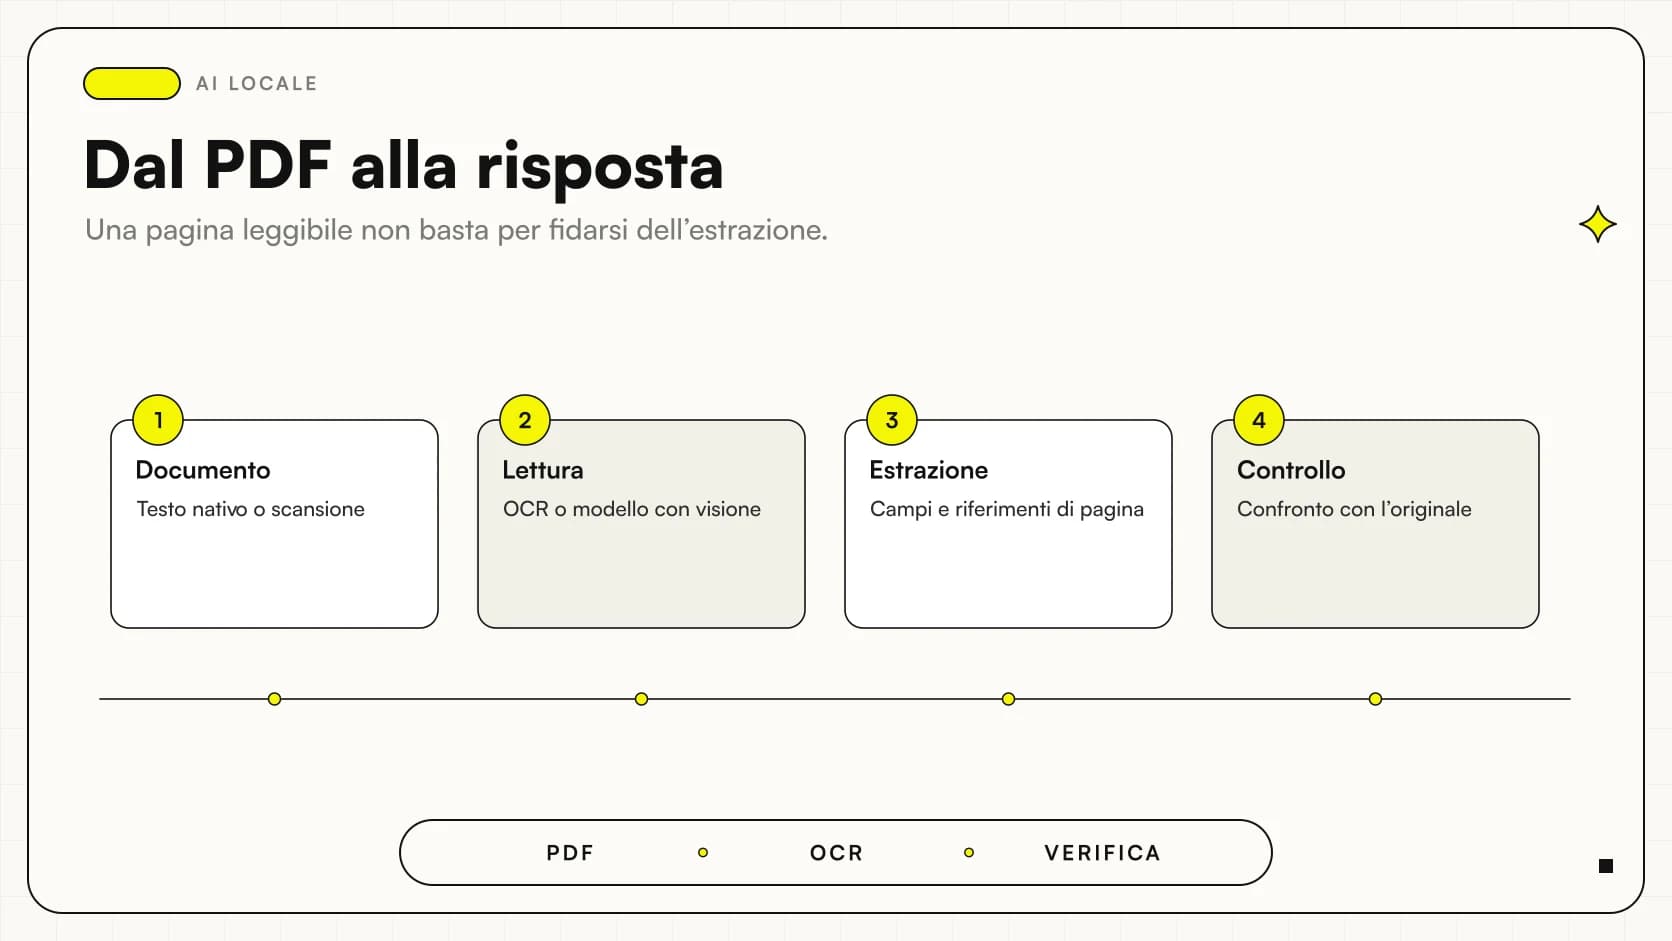
L'AI multimodale locale può interpretare immagini e aiutare a leggere documenti senza usare necessariamente un modello cloud, ma un PDF non diventa affidabile soltanto caricandolo in chat. Serve distinguere testo digitale, scansioni e contenuti visivi, poi verificare che ogni risposta sia sostenuta dal documento corretto.
Per una PMI il problema concreto è spesso meno spettacolare di una demo: leggere una tabella, riconoscere un riferimento, confrontare una nota a margine o ricostruire una condizione. Un flusso utile deve conservare queste informazioni e permettere all'operatore di controllarle. Le capacità dei modelli sono un componente; estrazione, collegamenti alle fonti e gestione degli errori completano il lavoro.
In sintesi
- Un PDF digitale e una scansione richiedono percorsi diversi.
- Capacità visiva non significa estrazione esatta di ogni campo.
- Testo, pagina e versione devono restare collegati.
- Una citazione va controllata sul documento di origine.
- La prova deve includere pagine difficili e dati mancanti.
Il PDF contiene testo o soltanto fotografie delle pagine?
Il primo controllo riguarda il file, non il modello. Un PDF generato da un gestionale può contenere testo estraibile; una scansione può contenere soltanto immagini; un altro file può mescolare entrambe le cose. La documentazione di pypdf sull'estrazione spiega perché l'estrazione testuale non sostituisce l'OCR e può non restituire il contenuto di una pagina scansionata.
La presenza di testo selezionabile è un indizio utile, non una garanzia di ordine corretto. Colonne, intestazioni e tabelle possono produrre una sequenza ambigua. Per preparare il progetto si campionano i file reali e si osserva il risultato prima di passarlo all'AI. Se un importo appartiene alla riga sbagliata già nell'estrazione, cambiare modello potrebbe non risolvere il problema. La diagnostica deve mantenere visibili i passaggi intermedi.
Quando scegliere estrazione testuale, OCR o visione?
L'estrazione del testo è una prima candidata quando il documento è digitale e la struttura rilevante si conserva. L'OCR può produrre una trascrizione utile delle scansioni. La visione diventa pertinente quando contano disposizione, simboli, immagini o relazioni che la trascrizione perde. Queste sono opzioni da sperimentare sul campione, non una graduatoria universale.
| Documento o domanda | Percorso da provare | Controllo decisivo |
|---|---|---|
| Contratto digitale lineare | Estrazione del testo | Ordine delle clausole |
| Modulo scansionato | OCR o modello visivo | Campi e caratteri ambigui |
| Tabella con celle unite | Estrazione strutturata e visione | Associazione fra righe e valori |
| Fotografia di un'etichetta | Modello visivo | Leggibilità e dettaglio utile |
| Archivio con molte versioni | Indicizzazione e recupero | Versione autorizzata |
Un documento può richiedere più percorsi: testo per le clausole, immagini per una planimetria. Il risultato si valuta sulla domanda specifica. Non conviene convertire indistintamente ogni pagina in un'immagine quando le informazioni necessarie sono già disponibili in forma più controllabile.
Che cosa dichiarano Qwen e Gemma sui contenuti visivi?
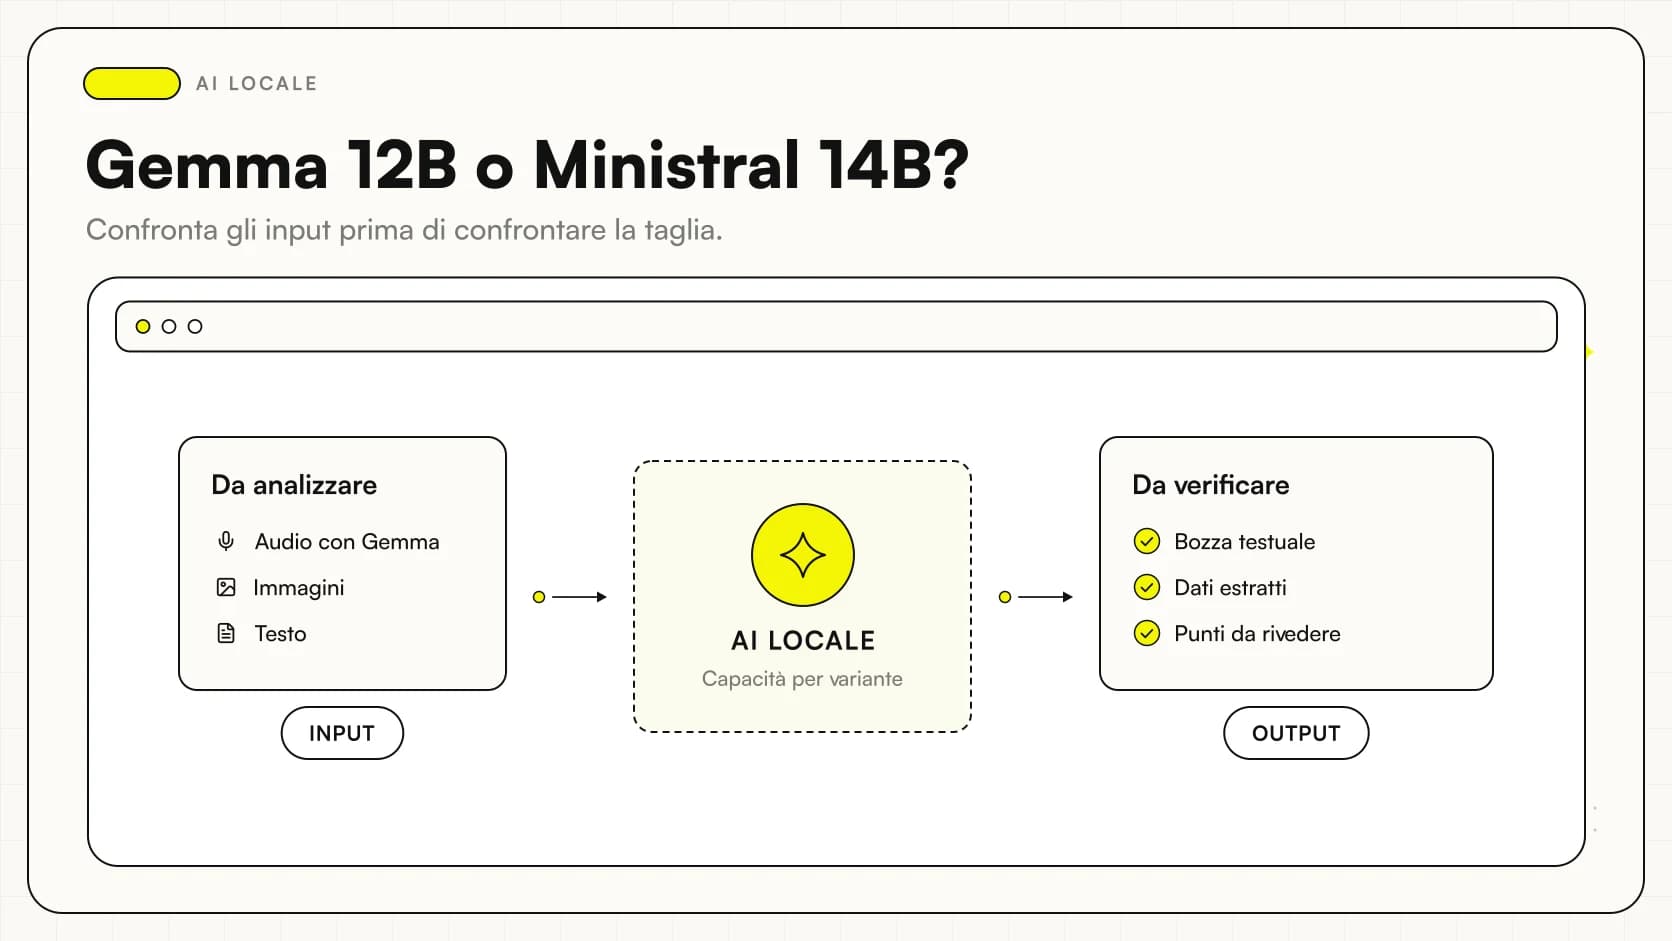
La scheda Qwen3.8-27B descrive input testuali e visivi. La model card Gemma 4 distingue varianti e modalità supportate. Sono capacità dichiarate dai produttori, verificate il 27 ottobre 2026; non dimostrano che i due sistemi leggano allo stesso modo una fattura, una tabella o una fotografia sfocata.
La selezione parte dal requisito: quale informazione manca quando si usa solo testo? Se il problema riguarda le relazioni fra elementi della pagina, il campione deve renderle necessarie alla risposta. La guida a Qwen3.8-27B in locale descrive il checkpoint; per confronti fra modelli conviene mantenere separati riconoscimento del contenuto e ragionamento successivo. Un errore su un timbro non va confuso con una conclusione sbagliata su una clausola letta correttamente.
Perché il runtime deve supportare tutta la parte multimodale?
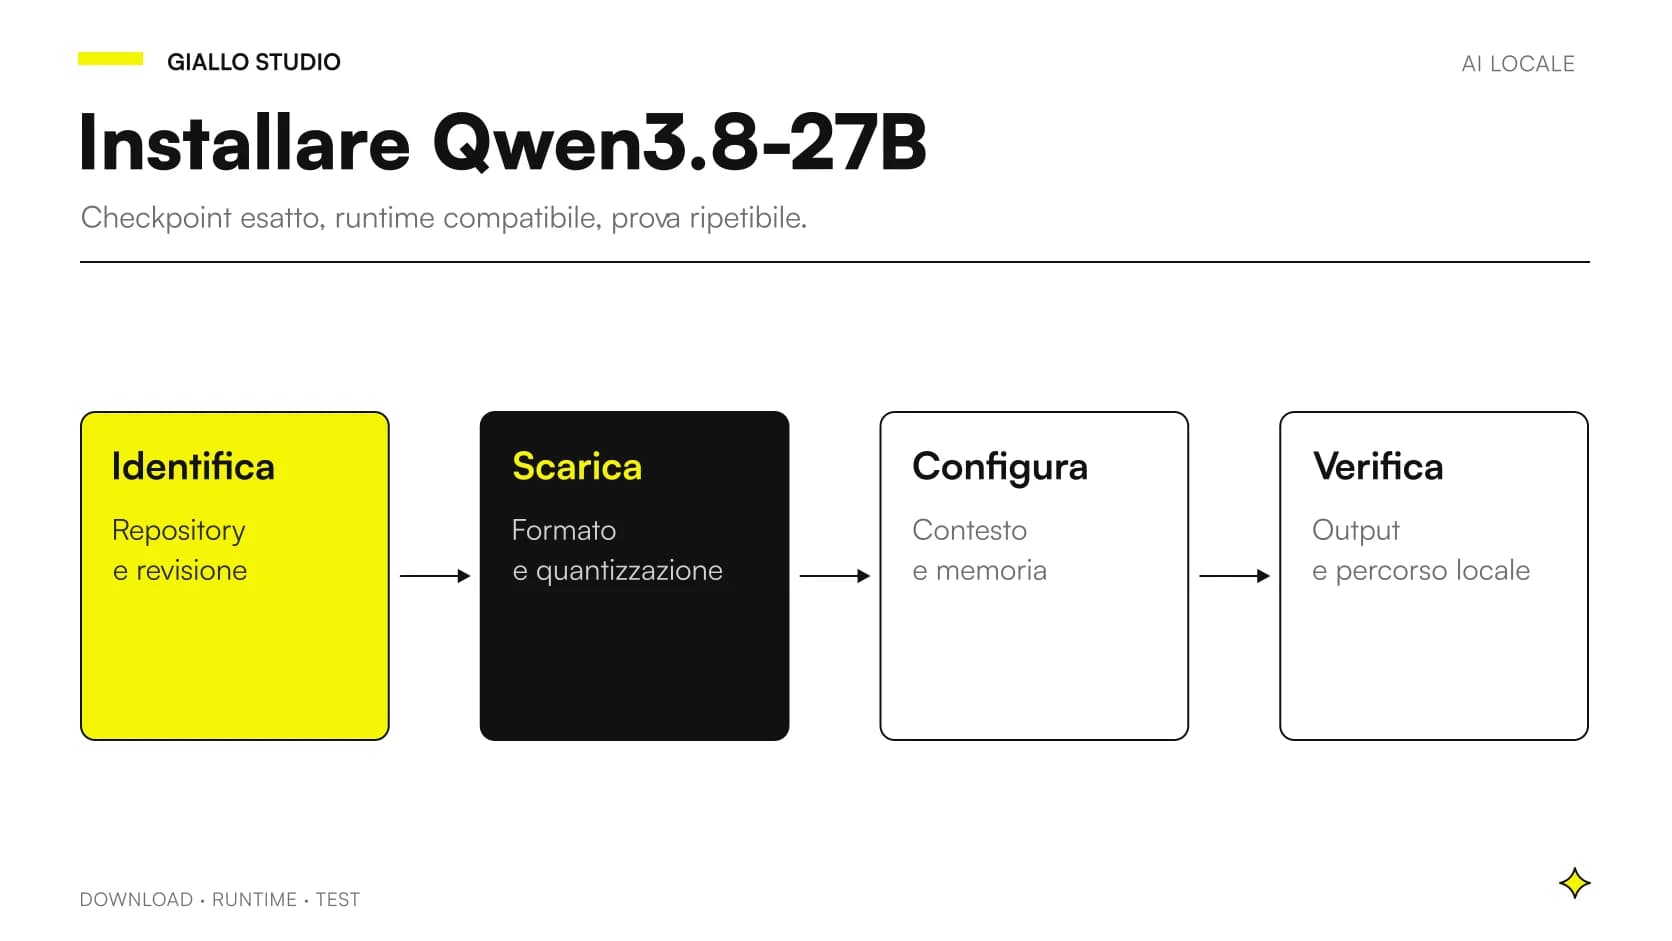
Scaricare i pesi linguistici non dimostra che le immagini arrivino al modello. La guida multimodale di llama.cpp documenta anche il componente di proiezione multimodale e la sua configurazione. Occorre verificare il formato e la combinazione di file richiesta dal percorso effettivamente utilizzato.
Un errore insidioso consiste nell'accettare un allegato nell'interfaccia e presumere che sia stato interpretato. La prova minima deve contenere una domanda la cui risposta sia presente soltanto nell'immagine, senza indizi nel nome del file. Se il sistema non risponde correttamente, bisogna capire se l'allegato è stato scartato, ridimensionato in modo inadeguato o elaborato male. La verifica dell'input precede qualunque giudizio sulla qualità del modello.
Come conservare pagina, file e versione durante l'elaborazione?
Ogni frammento dovrebbe mantenere un'identità stabile: documento, revisione e riferimento alla pagina originale. Se il sistema spezza o converte le pagine, deve conservare la corrispondenza. Altrimenti una citazione apparentemente precisa può aprire il file sbagliato o indicare il numero della pagina convertita anziché quello visibile nel documento.
La progettazione deve stabilire anche che cosa significhi “versione corretta”. Un'offerta approvata e una bozza possono contenere valori diversi. Recuperare entrambe senza distinguerle crea risposte contraddittorie anche con un ottimo modello. Questo aspetto si affronta prima dell'indicizzazione, assegnando stato e validità ai file. Nel RAG locale sui documenti aziendali il recupero non è soltanto una ricerca semantica: deve rispettare metadati e accessi del processo.
Come verificare una risposta con citazioni?
Chiedere “cita la fonte” non basta. La prova controlla tre cose: il riferimento porta al documento giusto, il passaggio esiste e quel passaggio sostiene davvero la frase prodotta. Una pagina può contenere parole simili e tuttavia non giustificare il collegamento formulato dal modello.
Per ogni domanda del campione si prepara quindi una risposta attesa e il relativo supporto. Si includono casi in cui la risposta non è presente: il sistema dovrebbe dichiarare il limite invece di costruire un riferimento verosimile. È utile distinguere citazione errata da risposta errata, perché suggeriscono interventi diversi. Un link rotto può richiedere una correzione del flusso documentale; una deduzione non supportata può richiedere istruzioni, selezione del contesto o un confine più ristretto del compito.
Una tabella letta bene può produrre un totale sbagliato?
Sì: lettura e calcolo sono operazioni distinte. Prima si controllano intestazioni, unità, righe e note; poi si verifica l'operazione. Non ha senso premiare una risposta che arriva casualmente al totale giusto usando valori errati. Allo stesso modo, un errore aritmetico non dimostra che l'immagine sia stata interpretata male.
Per i flussi con importi o quantità è ragionevole estrarre campi con provenienza e far eseguire il calcolo a software deterministico. L'AI può spiegare un'anomalia o individuare righe da rivedere, mentre il controllo aritmetico resta ripetibile. Le tabelle del campione dovrebbero includere righe vuote, separatori decimali e note che cambiano il significato dei numeri. Il requisito da approvare è la correttezza del percorso, non la fluidità della spiegazione finale.
Uno scenario: documenti di consegna e note a mano
Immaginiamo un distributore che riceva documenti di consegna con annotazioni manoscritte. È un caso illustrativo. Il compito è segnalare quantità contestate e riferimenti degli ordini, mantenendo accessibile la pagina. La scrittura incerta deve produrre una richiesta di controllo; non va trasformata in una quantità sicura soltanto per riempire tutti i campi.
La prova usa documenti fittizi rappresentativi: stampa pulita, fotografia inclinata, nota vicino a un'altra riga, foglio parzialmente coperto. Si osserva se il sistema sa distinguere un dato letto da un'ipotesi. Per l'addetto è utile vedere il ritaglio pertinente insieme al campo estratto e allo stato di verifica. Il progetto può iniziare dalla preparazione di una lista da controllare, lasciando l'aggiornamento del gestionale a un passaggio successivo. Questo confine rende misurabile l'utilità senza affidare subito scritture autonome al modello.
Uno scenario: manuali tecnici con immagini e revisioni
Secondo esempio ipotetico: un'officina consulta manuali di apparecchiature simili. Le immagini possono aiutare a identificare un componente, ma la risposta deve appartenere al modello e alla revisione corretti. Un'istruzione tecnicamente plausibile tratta da un manuale diverso resta un risultato inaccettabile per il processo.
Il campione include pagine quasi identiche e un riferimento mancante. Si verifica se il sistema chiede l'identificativo dell'apparecchiatura prima di rispondere e se distingue descrizione da istruzione operativa. Per attività che richiedono competenza e responsabilità specifiche, l'AI deve restare entro il ruolo assegnato e rimandare alla procedura ufficiale quando non dispone delle evidenze necessarie. La multimodalità può migliorare l'accesso all'informazione; non modifica da sola chi può autorizzare un intervento o verificare che sia eseguito correttamente.
Quando una chat con documenti diventa un progetto RAG?
La documentazione LM Studio sui documenti distingue l'inclusione del contenuto nel contesto dal recupero di porzioni pertinenti. Per una prova personale può bastare allegare pochi file. Un archivio condiviso introduce invece aggiornamenti, permessi e selezione delle fonti da rendere espliciti.
La domanda progettuale è quale materiale debba poter influenzare ogni risposta. Se l'utente vede soltanto alcuni documenti, il recupero deve rispettare quel confine. Se un file viene ritirato, il sistema deve smettere di proporlo. Sono comportamenti da verificare con casi concreti, non da dedurre dalla presenza di una funzione “chat con PDF”. La guida introduttiva al RAG chiarisce la tecnica; l'adozione aziendale richiede un contratto operativo più preciso.
Che cosa controllare prima di dichiarare tutto locale?
- Conversione delle pagine e OCR elaborano i file nell'ambiente previsto.
- Il modello visivo e gli eventuali embedding usano pesi locali identificati.
- Strumenti, log e cartelle sincronizzate hanno un percorso conosciuto.
- La risposta resta consultabile insieme alla versione del documento usata.
La pagina ufficiale LM Studio offline descrive le funzioni locali e le operazioni che richiedono rete. Il tuo progetto può però includere altri componenti. Per questo il controllo deve seguire il documento fino alla conservazione e all'esportazione della risposta. “Il modello gira qui” è un'informazione necessaria, ma non descrive tutto il flusso. La verifica di privacy e funzionamento offline entra nel dettaglio di questo perimetro.
Gli errori che una demo con un PDF perfetto nasconde
Una dimostrazione su una pagina pulita non misura affidabilità su un archivio reale. Possono restare invisibili perdita dell'ordine delle colonne, associazione errata dei valori e confusione fra revisioni. Anche la selezione di pochi file favorevoli può rendere un confronto ingannevole senza che nessuna singola risposta sia stata falsificata.
Il campione deve comprendere documenti difficili, ma rappresentativi, e registrare i rifiuti. Una pipeline che segnala correttamente “illeggibile” può essere più utile di una che completa sempre la risposta. Si concorda inoltre chi corregge un'estrazione e se la correzione debba essere conservata per le elaborazioni successive. Senza questa regola gli operatori possono risolvere manualmente lo stesso errore ogni volta, mentre il progetto sembra automatico soltanto nelle statistiche più superficiali.
Come costruire un campione che rappresenti l'archivio?
Il campione non dovrebbe coincidere con i file che si aprono più facilmente. Chi conosce il processo può raggruppare i documenti per origine, qualità, struttura e frequenza d'uso, poi scegliere esempi per ciascun gruppo. Sono importanti anche le eccezioni che causano lavoro manuale: pagine ruotate, allegati mancanti, descrizioni distribuite fra più fogli e documenti con informazioni apparentemente discordanti.
Le domande di verifica devono avere uno scopo operativo. “Riassumi questo documento” lascia molto spazio a giudizi soggettivi; “quale condizione cambia fra queste due revisioni, con il relativo passaggio?” permette un controllo più preciso. Per ogni domanda si conserva l'esito atteso e si decide come valutare risposte parziali, riferimenti incompleti e corretta dichiarazione di impossibilità.
Un sottoinsieme resta fuori dalla messa a punto delle istruzioni e viene usato soltanto per verificare la configurazione finale. Altrimenti il team può perfezionare il sistema sui propri esempi e scambiare quella familiarità per affidabilità generale. Il verbale distingue inoltre i documenti esclusi intenzionalmente da quelli che il sistema ha tentato senza riuscire: entrambe le informazioni servono a definire un confine di utilizzo credibile.
Quale risultato approvare prima dell'integrazione?
Un risultato concreto è una risposta verificabile a un insieme definito di domande, con provenienza e limiti visibili. Prima dell'adozione si misurano errori sui campi importanti, riferimenti sbagliati e tempo di revisione; si annotano runtime, modelli e configurazione. Il protocollo di benchmark in italiano permette di ripetere la prova dopo un aggiornamento.
Per iniziare, scegli una famiglia di documenti e un compito circoscritto, come preparare una lista di discrepanze per l'operatore. Estendi il flusso solo dopo aver capito dove sbaglia e come recupera. Se vuoi progettare questa lettura dei PDF intorno ai tuoi archivi, Giallo Studio sviluppa software su misura che collega estrazione, modelli e controlli al processo effettivo, senza confondere una risposta ben scritta con un dato già verificato.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Gemma 4 12B vs Ministral 3 14B: AI locale compatta
 Installare Qwen3.8-27B in locale: controlli e procedura
 Qwen3.8-27B in locale: capacità, limiti e requisiti
 RAG locale sui documenti aziendali: come progettarlo
 LLM locali in italiano: come confrontarli senza falsi test
 RAG: cos'è e perché migliora le risposte AI
 AI locale e privacy: come verificare che resti offline
FAQ
Un modello multimodale può leggere qualsiasi PDF?
No. Il PDF deve essere elaborato da una pipeline compatibile, che può estrarre testo oppure convertire pagine in immagini. Qualità della scansione, impaginazione e componenti del runtime influenzano il risultato.
Per leggere una scansione serve sempre OCR separato?
Un modello visivo compatibile può interpretare l'immagine direttamente, ma non garantisce estrazione esatta. L'OCR separato resta un'opzione da confrontare, specialmente quando servono testo ricercabile e controlli sui singoli campi.
Qwen3.8-27B e Gemma 4 leggono immagini in locale?
Le rispettive schede dichiarano capacità visive. Occorre però verificare il checkpoint preciso e il supporto completo del runtime, compresi i componenti multimodali richiesti.
Una citazione con numero di pagina prova che la risposta sia corretta?
No. La pagina deve esistere, essere quella effettivamente analizzata e contenere un passaggio che sostiene l'affermazione. La sola presenza di un riferimento non dimostra il supporto della risposta.
Come verificare che i documenti restino in locale?
Bisogna seguire anche conversione dei PDF, OCR, embedding, strumenti, log e salvataggi. Un modello locale non rende automaticamente locali tutti questi componenti.