
Qwen3.8-27B vs Ministral 3 14B: quale portare in locale
Qwen3.8-27B vs Ministral 3 14B: dimensioni, memoria, immagini e compiti aziendali. Come scegliere senza inventare velocità o requisiti.
Qwen3.8-27B e Ministral 3 14B sono modelli locali con capacità visive, ma hanno un impegno diverso in termini di pesi da gestire. Ministral è il candidato più compatto di questo confronto; non possiamo dedurre che sia sempre più veloce, né che Qwen sia automaticamente più accurato sul tuo lavoro. Le specifiche provengono dai repository ufficiali di Qwen e Mistral, consultati il 27 ottobre 2026.
La domanda pratica è se un modello più piccolo soddisfi già i requisiti del processo. Se deve classificare richieste interne, non è detto che una dimensione maggiore migliori il risultato abbastanza da giustificare un'infrastruttura più impegnativa. Se deve leggere documenti complessi, il confronto cambia: bisogna individuare quali errori dipendono dal modello, quali dalla preparazione dei file e quali da istruzioni incomplete. Questa pagina serve a progettare quella scelta, senza spacciare stime per misure.
In sintesi
- Qwen3.8-27B comprende un modello linguistico dense da 27B più encoder visivo.
- Ministral 3 14B combina un modello linguistico da 13,5B con un encoder visivo da 0,4B.
- Entrambi i checkpoint ufficiali considerati qui dichiarano Apache 2.0.
- Il nome Instruct, Reasoning o Base identifica varianti da scegliere e registrare separatamente.
- Un modello più piccolo conviene quando supera i controlli del compito mantenendo risorse e gestione sostenibili.
Quale Ministral 3 14B stiamo confrontando?
Il riferimento principale è Ministral-3-14B-Instruct-2512, con attenzione alla distribuzione BF16 e alle conversioni ufficiali disponibili. La famiglia comprende varianti Base, Instruct e Reasoning: non vanno trattate come lo stesso comportamento con un nome diverso. La card del modello Instruct descrive una versione post-addestrata per seguire istruzioni, con capacità visive e supporto al function calling. Fonte: card Mistral.
Per un assistente destinato ai colleghi devi scegliere esplicitamente la variante da provare e conservarne la revisione. Il termine “Ministral” da solo non è sufficiente. La presentazione di Mistral 3 distingue inoltre i piccoli modelli dense dal grande modello MoE della famiglia. Questa distinzione evita di attribuire al 14B prestazioni pubblicate per un checkpoint molto più grande.
Dove si trova la differenza di dimensione?
Qwen dichiara 27B per il modello linguistico; Ministral dichiara 13,5B per il linguistico e 0,4B per l'encoder visivo. In entrambi i casi conviene distinguere la parte che genera testo dal pacchetto completo necessario a elaborare un'immagine. Fonti: Qwen3.8-27B, Ministral 3 14B.
Questo ordine di grandezza suggerisce che Ministral possa essere un punto di partenza più agevole quando la memoria è il vincolo principale. Non è però un requisito hardware completo e non dimostra la qualità delle risposte. Per leggere la scheda del candidato maggiore senza ripetere tutto il confronto, puoi usare Qwen3.8-27B in locale. La decisione deve restare collegata al carico, non al fascino di una taglia.
Quali caratteristiche sono comparabili?
Le card dichiarano per entrambi comprensione di testo e immagini. Qwen descrive anche capacità video. Il contesto nativo dichiarato è di 262.144 token per Qwen e di 256K per Ministral 3 14B; non significa che il massimo sia disponibile senza vincoli su qualsiasi computer. Fonti: card Qwen, card Ministral.
| Criterio | Qwen3.8-27B | Ministral 3 14B Instruct |
|---|---|---|
| Modello linguistico | Dense, 27B | Dense, 13,5B |
| Visione | Encoder presente | Encoder da 0,4B dichiarati |
| Contesto nativo | 262.144 token | 256K token |
| Licenza | Apache 2.0 | Apache 2.0 |
| Taglia del candidato | Maggiore | Più compatta |
| Prestazione sul processo | Da verificare | Da verificare |
| Memoria realmente disponibile | Dipende dalla configurazione | Dipende dalla configurazione |
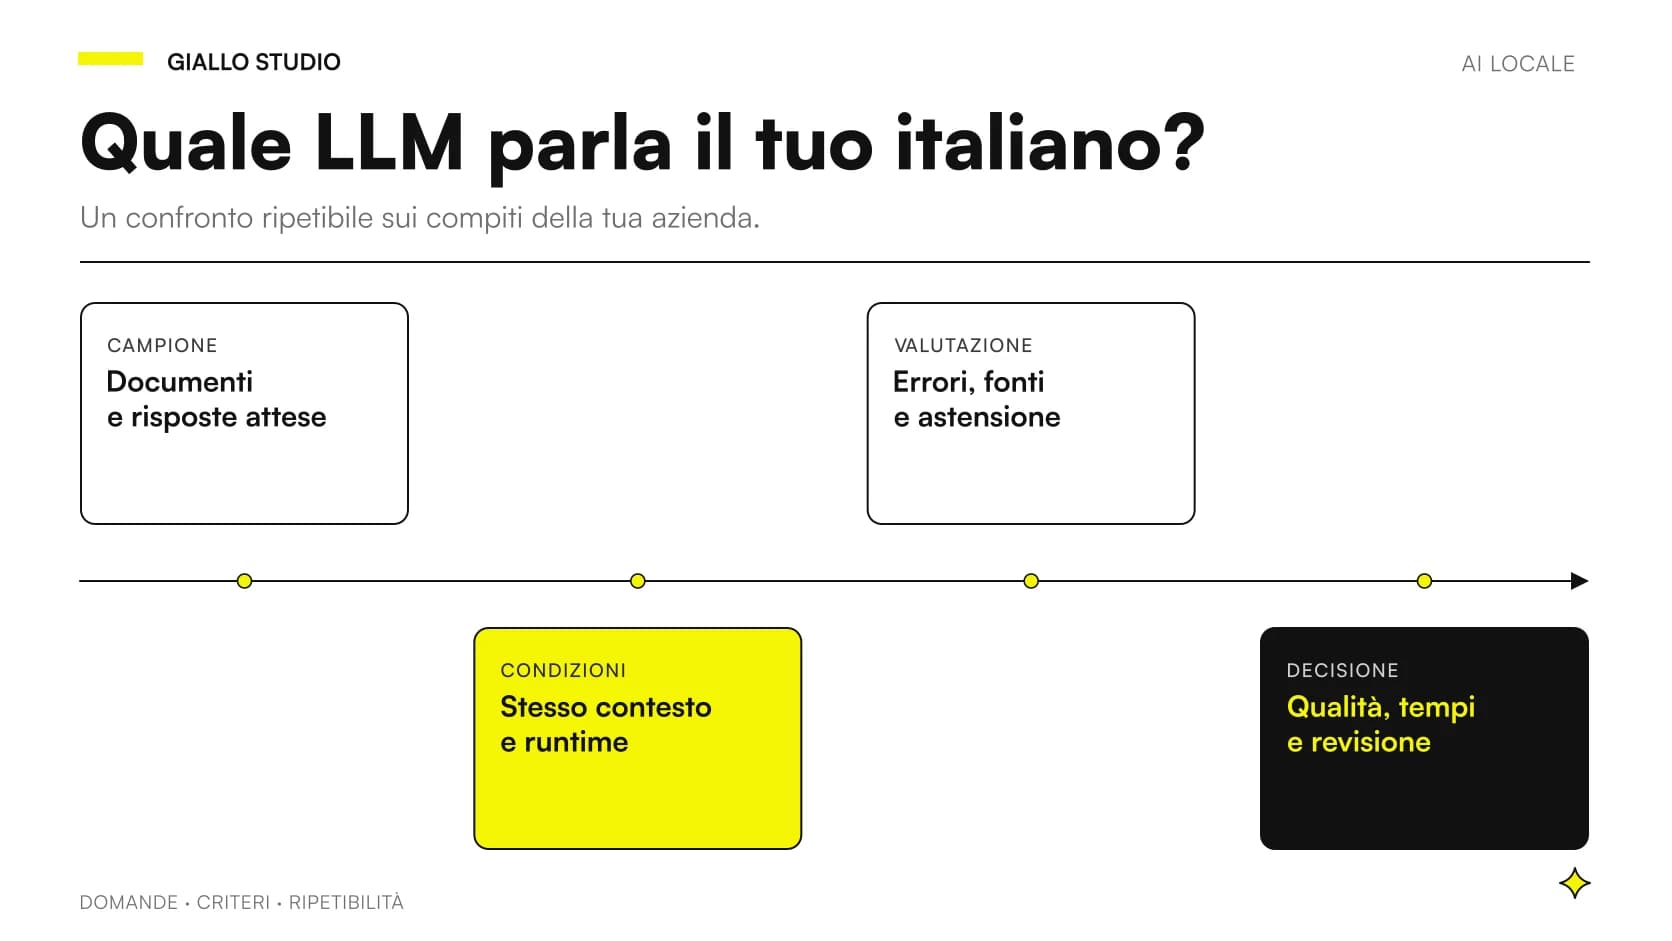
Le caratteristiche eliminano alcuni casi incompatibili. Per scegliere tra quelli rimasti, servono documenti, domande e criteri condivisi.
Che cosa sappiamo dei requisiti di Ministral?
Mistral dichiara che la variante 14B può rientrare in 32 GB di VRAM in BF16 e in meno di 24 GB di RAM o VRAM quando quantizzata. La card ufficiale BF16 presenta queste indicazioni come possibilità di deployment: non sono una misura Giallo Studio né una garanzia sul contesto pieno, sulla concorrenza o sul tuo computer.
Un formato quantizzato deve essere identificato precisamente. Nel repository GGUF ufficiale trovi una distribuzione diversa dal BF16: scegliere il file giusto è parte della configurazione. Prima di acquistare una macchina, controlla spazio richiesto, runtime supportato e margine durante una richiesta rappresentativa. Un modello che si carica senza errori può comunque non avere risorse sufficienti per una scansione lunga o una seconda sessione.
Come stimare Qwen senza promettere un minimo fittizio?
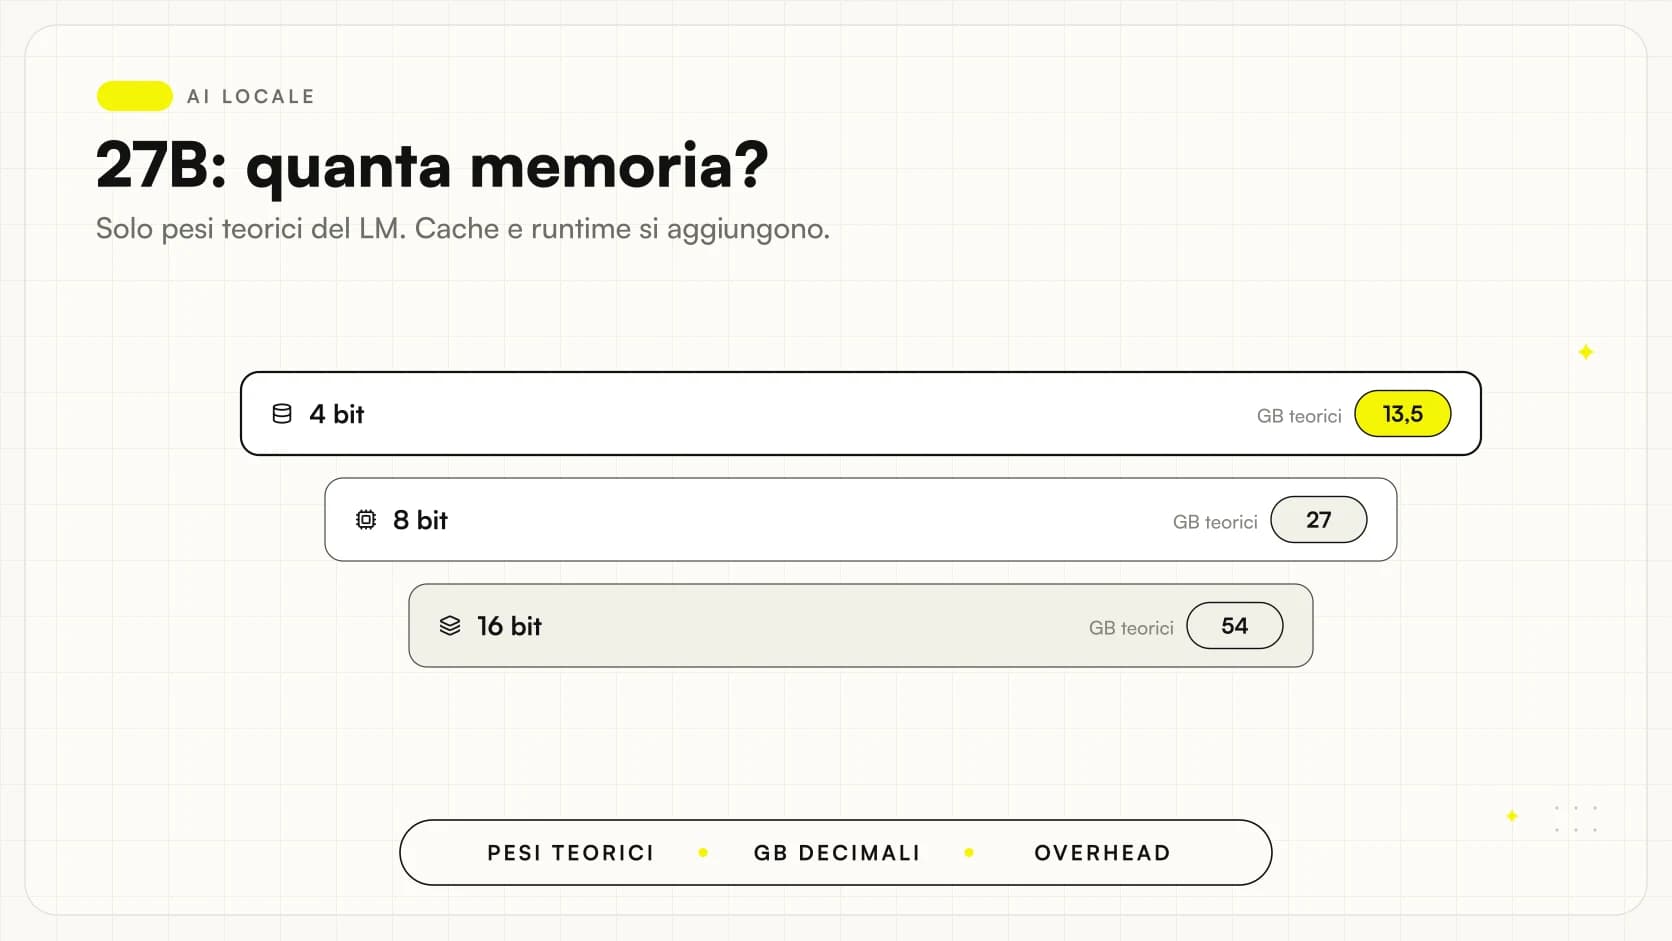
Per 27B parametri, il calcolo teorico dei soli pesi linguistici è circa 54 GB decimali a 16 bit, 27 GB a 8 bit o 13,5 GB a 4 bit. La formula moltiplica parametri e bit e divide per otto. Non include encoder, metadati di quantizzazione, cache del contesto, buffer o memoria del sistema.
Queste cifre aiutano a scartare un'aspettativa impossibile, ma non autorizzano frasi come “bastano 16 GB”. Il file reale può usare precisioni miste e il carico può aggiungere risorse importanti. Le guide su RAM e VRAM di Qwen3.8-27B e quantizzazione GGUF ti aiutano a tenere separati calcolo teorico, dimensione del download e comportamento osservato. I requisiti utili vanno formulati insieme alla configurazione che li ha prodotti.
Quando un 14B può essere la scelta più sensata?
Un modello compatto è un candidato ragionevole quando il compito ha confini chiari: assegnare una categoria, estrarre campi da un testo regolare, preparare una bozza seguendo uno schema. La condizione è che superi i controlli del processo. Non serve acquistare più memoria per inseguire una capacità generale che l'applicazione non userà.
Parti quindi da un campione che contenga eccezioni oltre ai casi normali. Se devi instradare richieste, inserisci testi ambigui, messaggi con due temi e richieste che non appartengono ad alcuna categoria. Definisci quando il sistema deve lasciare la decisione a una persona. Il criterio non è il numero di risposte generate, ma quante sono accettabili senza correzioni sostanziali. Questo approccio segue la logica della guida come scegliere un modello AI.
Quando vale la pena provare anche il 27B?
Qwen merita una prova aggiuntiva se il candidato più piccolo incontra errori sul compito essenziale e la pipeline è già stata controllata. Prima di cambiare modello, verifica che l'informazione richiesta sia realmente arrivata al sistema: nessuna taglia risolve un passaggio omesso durante l'estrazione del documento.
Prepara i casi problematici senza riscriverli per favorire l'alternativa. Mantieni uguali fonti e obiettivo, poi controlla se il 27B corregge gli errori o ne introduce di nuovi. Può essere utile aumentare la dimensione; non è un upgrade garantito. Se il problema è la selezione delle fonti, intervieni sul recupero documentale. Il RAG locale per archivi aziendali affronta proprio il collegamento tra domanda e passaggio pertinente, che spesso decide il risultato prima della generazione.
Come sarebbe una prova per un'officina?
Scenario ipotetico: un'officina vuole preparare una bozza di risposta interna consultando manuali e fotografie di targhette. La prova deve verificare se il sistema riconosce il modello esatto, distingue procedure per versioni simili e segnala quando la fotografia è illeggibile. L'obiettivo non è delegare decisioni tecniche sensibili all'assistente.
Fai valutare ogni risposta a un addetto competente e richiedi il riferimento alla pagina del manuale. Un errore sulla sigla della macchina può essere più importante di diversi riassunti ben fatti. Confronta i due modelli anche quando manca la foto o quando il codice è parzialmente coperto. L'astensione è un risultato corretto se evita di associare una procedura al dispositivo sbagliato. Conserva il dato di origine accanto alla bozza, così il collega può verificare senza rifare la ricerca da zero.
E per un ufficio che gestisce richieste di assistenza?
Secondo scenario ipotetico: una PMI riceve email su consegne, resi e manutenzione. Un primo uso può essere classificare il messaggio e proporre quali documenti aprire, evitando di rispondere direttamente al cliente. Qui un modello più piccolo che rispetta bene le categorie potrebbe essere sufficiente.
Usa un elenco di categorie con definizioni e casi esclusi. Se una richiesta contiene un reclamo e una domanda tecnica, il sistema deve segnalare entrambi o applicare la regola concordata. Valuta separatamente classificazione, campi estratti e bozza. Non trattare una risposta scorrevole come prova che l'instradamento sia corretto. Per estendere il progetto agli agenti AI, aggiungi controlli sui permessi: consultare uno stato ordine, modificarlo e inviare una comunicazione sono azioni con conseguenze diverse.
Come confrontare lingua italiana e output strutturati?
La card Ministral elenca supporto multilingue che comprende l'italiano; Qwen documenta capacità linguistiche della propria famiglia. Queste dichiarazioni motivano il test, ma non dimostrano affidabilità sul lessico della tua azienda. Fonte: supporto linguistico Ministral, fonte Qwen.
Usa termini reali, sigle e denominazioni che il personale non deve vedere parafrasate. Per i dati destinati a un software, richiedi uno schema e valida il risultato fuori dal modello: formato di una data, elenco dei codici ammessi, presenza di campi obbligatori. Un JSON formalmente valido può contenere un valore inventato; correttezza sintattica e fedeltà alla fonte vanno contate separatamente. Non assegnare il punteggio pieno a una risposta che completa un campo sconosciuto soltanto per rispettare lo schema.
Quali condizioni rendono credibile il test?
Decidi se confrontare i formati migliori che la macchina può sostenere oppure due configurazioni con un vincolo comune. Nel primo caso stai scegliendo il sistema più utile sul tuo hardware; nel secondo stai isolando un compromesso preciso. Scrivi quale dei due obiettivi guida il lavoro e non mescolare i risultati.
Registra versione del runtime, checkpoint, revisione, quantizzazione, contesto, istruzioni e documenti. Misura l'attesa completa della richiesta, distinguendo avvio a freddo e modello già pronto. Se il candidato più grande forza un trasferimento di pesi che l'altro evita, quel costo fa parte dell'esperienza reale. Per rubriche e giudizi coerenti, usa il protocollo sui benchmark degli LLM locali in italiano. Qui non riportiamo token al secondo perché non abbiamo eseguito una prova comparabile su una macchina dichiarata.
Una sola postazione o un servizio condiviso?
Una prova individuale non descrive automaticamente l'uso di un gruppo. Se il modello viene caricato sul computer di una persona, l'applicazione può competere con videoconferenze, browser e software di lavoro. Se viene esposto come servizio interno, diventano rilevanti coda delle richieste, accessi concorrenti e isolamento delle conversazioni. Il requisito utile deve precisare quale situazione è prevista.
Per confrontare i candidati, prepara anche una richiesta lunga mentre arriva una domanda breve. Osserva se il sistema completa entrambe e se il tempo di attesa resta accettabile per chi lavora. Non serve pubblicare una classifica generale: serve capire quale configurazione rispetta il servizio concordato. Se il modello compatto permette di mantenere un margine maggiore, verifica che quel margine si traduca davvero in stabilità. Se il maggiore risolve meglio i casi difficili, valuta se dedicarlo soltanto a quelli invece di usarlo per ogni messaggio.
Quali errori evitare tra licenza, offline e aggiornamenti?
I checkpoint ufficiali considerati dichiarano Apache 2.0, ma la licenza dell'applicazione o di una conversione va controllata separatamente. Leggi il LICENSE di Qwen e le condizioni collegate dalla card Ministral. Non trasferire automaticamente diritti o capacità a varianti con nomi simili.
Evita anche di chiamare offline un processo senza averlo verificato. La preparazione dei PDF, gli embedding, i tool e i backup possono usare la rete. Una scelta locale richiede una mappa del percorso dei dati, come descritto in AI locale e privacy aziendale. Infine, non aggiornare indiscriminatamente durante la valutazione: se cambi pesi o runtime, conserva la configurazione precedente e ripeti i casi essenziali prima di usare la nuova versione.
Come portare il confronto nel lavoro quotidiano?
Definisci un referente del processo, un campione verificabile e una modalità di revisione. Parti con sole letture e bozze, raccogli gli errori e amplia l'integrazione soltanto quando il team sa riconoscere le condizioni in cui l'assistente deve fermarsi. Il confronto dimensionale serve a decidere quanto hardware impegnare; la prova documentale serve a decidere quanto lavoro affidare.
Per una variante compatta che include anche audio, leggi Gemma 4 12B vs Ministral 3 14B. Se devi scegliere tra una postazione e un servizio interno condiviso, la consulenza AI di Giallo Studio può impostare il confronto sul tuo flusso di richieste e sulle risorse già disponibili.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Qwen3.8-27B vs gpt-oss-20b: visione, testo e memoria
- Qwen3.8-27B vs Qwen3.6-35B-A3B: cosa cambia in locale
- Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
- Qwen3-Coder-Next vs Devstral Small 2: codice in locale
- Qwen3.8-27B vs Gemma 4 26B A4B: dense o MoE?
- RPA vs AI automation: differenze, costi e quando usare quale
- PWA aziendale su misura: quando conviene rispetto a un software pronto
- Voice AI o chatbot: quale canale scegliere
- Perplexity vs Google: risposta con fonti o lista di link
- AI in abbonamento o su misura: cosa conviene
- Claude Opus 5 vs Sonnet 5
- AI fai da te o agenzia: come decidere
FAQ
Ministral 3 14B è più piccolo di Qwen3.8-27B?
Sì. La card Ministral indica 13,5B parametri del modello linguistico e 0,4B dell’encoder visivo; Qwen indica 27B per il modello linguistico più la componente visiva.
Il modello più piccolo risponde sempre più velocemente?
No. Il tempo dipende da hardware, runtime, formato, contesto e quantità di testo generato. Serve una misurazione nella configurazione prevista.
Quale Ministral 3 14B usare per una chat aziendale?
La variante Instruct è un punto di partenza per seguire istruzioni. Base e Reasoning sono checkpoint distinti: registra sempre nome completo, formato e revisione prima del confronto.
Entrambi possono leggere immagini?
Sì, i checkpoint ufficiali qui considerati dichiarano capacità visive. La precisione su scansioni, targhette e tabelle va verificata sui documenti rappresentativi del processo.
Quando scegliere un modello locale più piccolo?
Quando supera i requisiti essenziali del compito con risorse e gestione sostenibili. Il confronto deve includere eccezioni, astensione e lavoro di correzione, non solo risposte facili.