
Quantizzazione GGUF: Q4 o Q8 per gli LLM locali?
GGUF, Q4 e Q8 spiegati senza scorciatoie: dimensione dei pesi, memoria reale, qualità e metodo per scegliere una quantizzazione.
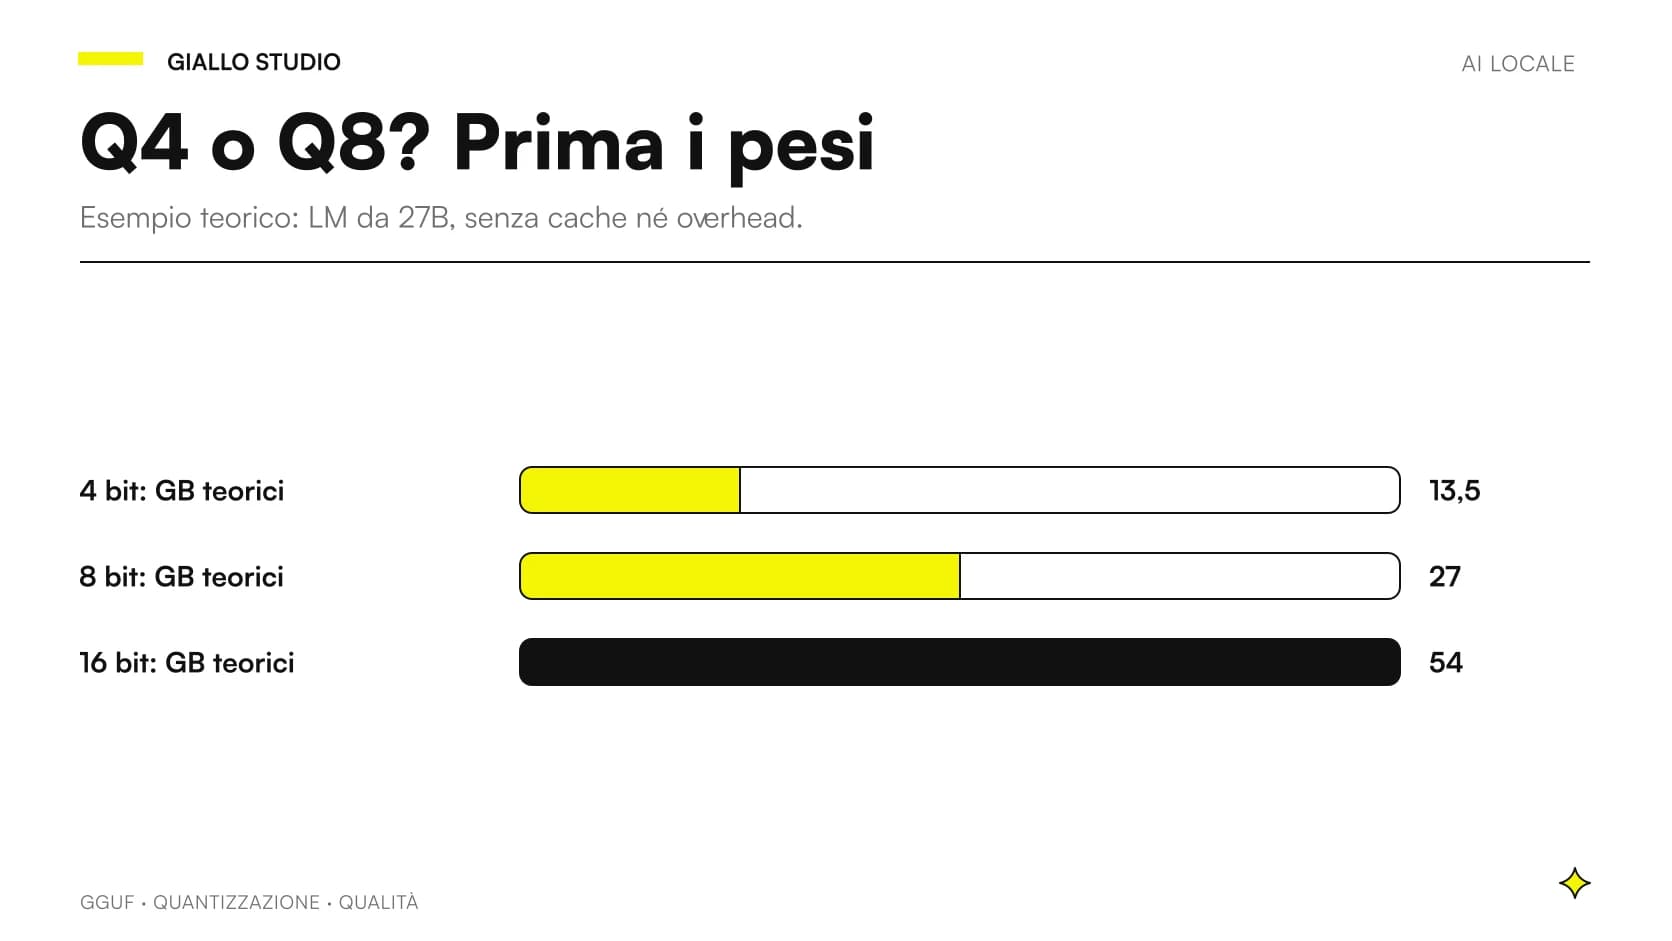
La quantizzazione GGUF permette di scegliere rappresentazioni dei pesi che occupano meno memoria, ma Q4 e Q8 non indicano due livelli universali di affidabilità. La scelta utile è la quantizzazione che consente al modello di lavorare sulla tua macchina mantenendo risultati adeguati al compito.
Prima serve separare due concetti: GGUF è un formato, mentre le sigle come Q4_K_M e Q8_0 descrivono modalità di rappresentazione dei tensori. Questa distinzione è documentata nella specifica GGUF del progetto ggml. Non abbiamo eseguito test comparativi da cui ricavare una perdita percentuale di qualità valida per ogni LLM.
In sintesi
- GGUF contiene pesi e metadati; non identifica una sola precisione.
- Q4 e Q8 sono indicazioni da leggere insieme al metodo e al nome completo del file.
- La memoria reale comprende più dei soli pesi teorici.
- Il confronto corretto usa lo stesso checkpoint, lo stesso compito e impostazioni documentate.
- Una risposta formalmente fluida può nascondere errori che il solo benchmark generale non intercetta.
Perché si quantizzano i pesi di un modello?
Un LLM contiene grandi quantità di valori numerici. Rappresentarli con meno bit può ridurre lo spazio necessario per conservarli e caricarli. Il progetto llama.cpp offre diversi metodi, elencati negli strumenti ufficiali di quantizzazione.
La riduzione non è una cancellazione ordinata delle conoscenze meno importanti. È una trasformazione numerica, il cui effetto dipende da modello, metodo, tensori coinvolti e compito. Per questo non possiamo affermare che un modello quantizzato conserverà una percentuale fissa della qualità originale.
In azienda la domanda non è quanto sembri intelligente una risposta generica. È se il sistema continua a estrarre correttamente codici, rispettare istruzioni e distinguere ciò che sa da ciò che manca. La guida su come scegliere un modello AI parte proprio dall'attività da svolgere.
Che cosa contiene un file GGUF?
GGUF organizza tensori e metadati per l'inferenza nei motori compatibili con GGML. Le informazioni possono riguardare l'architettura, la tokenizzazione e altri elementi necessari a interpretare i pesi. La documentazione Hugging Face sul formato aiuta a leggere questi file e a distinguerli dalle distribuzioni originali.
Il contenitore non decide da solo se il modello è adatto al tuo caso. Un file può essere valido e tuttavia richiedere un'architettura appena introdotta o funzionalità non ancora disponibili nella versione del programma installata.
Controlla inoltre da chi arriva il GGUF. Il produttore del checkpoint e l'autore della conversione possono essere soggetti diversi. Conservare origine, revisione e nome completo del file rende il lavoro riproducibile e facilita la diagnosi se due download apparentemente uguali si comportano diversamente.
Q4_K_M e Q8_0 significano esattamente quattro e otto bit?
Le sigle identificano schemi concreti. Non conviene ridurle a un'etichetta generica «quattro bit contro otto bit», ignorando suffissi e metodo. L'elenco delle opzioni nel codice di quantizzazione llama.cpp mostra che esistono più varianti all'interno della stessa famiglia.
Alcune rappresentazioni usano blocchi, scale e trattamenti differenti per i tensori. Il numero nominale non coincide necessariamente con i bit medi effettivi di tutto il checkpoint. Questa è una ragione per cui il calcolo fatto sulla sigla può non corrispondere alla dimensione del file scaricato.
Nella scheda di prova scrivi quindi Q4_K_M, se questo è il formato effettivo, e non soltanto Q4. Lo stesso vale per il repository: un nome incompleto rende impossibile ricostruire quale versione hai valutato.
Come stimare l'ordine di grandezza dei pesi?
La formula di base è parametri × bit / 8. Serve a capire l'ordine di grandezza; non sostituisce la misura del file o della memoria utilizzata.
Per un ipotetico insieme di 27 miliardi di pesi rappresentati tutti con la medesima precisione:
| Precisione uniforme ipotetica | Calcolo | Soli pesi teorici |
|---|---|---|
| 16 bit | 27 miliardi × 16 / 8 | 54 GB decimali |
| 8 bit | 27 miliardi × 8 / 8 | 27 GB decimali |
| 4 bit | 27 miliardi × 4 / 8 | 13,5 GB decimali |
Sono calcoli illustrativi autonomi, non dimensioni dichiarate di file Qwen. La model card di Qwen3.8-27B distingue il modello linguistico dall'encoder visivo. La guida alla memoria del 27B spiega quali voci aggiungere prima di parlare di requisiti.
Registra inoltre l'unità di misura usata dal programma. GB decimali e GiB non rappresentano la stessa quantità: confrontare un download espresso in un'unità con la memoria mostrata in un'altra può creare un margine apparente. Non serve introdurre precisioni inutili; basta mantenere coerenti le unità nella scheda di prova e distinguere file su disco, memoria allocata e picco osservato. Se il repository distribuisce il checkpoint in più parti, verifica l'insieme richiesto dal caricamento. Il singolo file più piccolo della cartella non rappresenta necessariamente il modello completo da utilizzare.
Perché un file che entra sul disco può non entrare in memoria?
Il disco conserva il download; RAM e VRAM sostengono l'esecuzione. Oltre ai pesi, il motore deve gestire il lavoro richiesto dalla conversazione e dai documenti. Contesto, componenti multimodali e richieste contemporanee possono cambiare il consumo.
La documentazione sul contesto di Ollama conferma che una finestra più ampia aumenta la memoria necessaria. Ridurre la dimensione dei pesi non elimina questa voce.
Se una quantizzazione più leggera ti permette di allargare il contesto, confronta entrambe le conseguenze. Un modello più preciso con documenti troncati può essere meno utile di una configurazione che riesce a leggere il materiale necessario; l'opposto può accadere se la compressione introduce errori decisivi. Sono ipotesi da verificare, non un verdetto sulla superiorità di Q4 o Q8.
Una quantizzazione più piccola è sempre più veloce?
Non è una promessa che si possa ricavare dal nome. Velocità e latenza dipendono da kernel disponibili, backend, banda di memoria, trasferimenti e configurazione. Il vantaggio più chiaro da verificare è se una rappresentazione consente di mantenere il lavoro sulla GPU evitando un percorso diverso.
Anche il parametro da misurare cambia la lettura. Il primo token riguarda l'attesa iniziale; il tempo di completamento comprende la risposta; un processo documentale include inoltre estrazione, ricerca e controllo.
Per il PC Windows osserva la ripartizione CPU/GPU. Sul Mac con memoria unificata controlla pressione memoria e applicazioni concorrenti. Non trasferire una misura da un sistema all'altro soltanto perché il file ha lo stesso suffisso.
Quando confrontare Q4 con Q8 invece di cambiare modello?
Ha senso farlo quando hai già individuato un checkpoint adatto e vuoi capire come distribuirlo sull'hardware disponibile. Se il modello fallisce sistematicamente un'istruzione o non supporta gli input necessari, cambiare precisione potrebbe non risolvere il problema di base.
Il modello entra soltanto nella rappresentazione più compressa
Trattala come candidata e confrontala con un checkpoint più piccolo ma meno compresso. Mantieni lo stesso insieme di richieste e controlla gli errori che hanno conseguenze sul processo. Non scegliere soltanto in base al numero di parametri nominali.
Un modello piccolo che esegue correttamente il compito può essere preferibile a uno più grande che richiede compromessi non accettabili. Il confronto va effettuato tra configurazioni complete e utilizzabili, oltre che tra varianti dello stesso checkpoint.
Quali richieste rivelano differenze utili in italiano?
Prepara materiali vicini al lavoro: una tabella con righe simili, una clausola con un'eccezione, una richiesta di risposta in un formato rigoroso. Aggiungi una domanda senza risposta nei documenti, per verificare che il sistema non inventi un completamento.
Non serve scegliere soltanto rompicapi difficili. Se l'assistente dovrà lavorare su codici prodotto, una cifra scambiata è più significativa di un piccolo vantaggio su un esercizio astratto.
Per leggere i risultati, conserva anche gli esempi che entrambe le versioni superano. Un confronto composto soltanto dalle differenze più vistose può esagerare l'effetto della quantizzazione. Annota quali errori ricorrono e quali dipendono da una singola risposta, quindi ripeti i casi importanti senza cambiare le istruzioni. Non cercare retroattivamente il prompt che fa vincere la configurazione preferita: il compito deve restare lo stesso. Se usi un valutatore automatico, controlla a mano un campione dei giudizi e non attribuirgli un'autorità superiore ai documenti con la risposta attesa.
Il protocollo di confronto dei modelli locali in italiano distingue accuratezza, citazioni, rispetto del formato e astensione. Per la quantizzazione mantieni invariati modello di partenza, prompt e condizioni del test. Se modifichi insieme precisione e checkpoint, puoi valutare il sistema finale ma non isolare l'effetto della quantizzazione.
Un'officina meccanica: contano i codici, non la prosa
Immaginiamo un caso ipotetico: un'officina usa l'assistente per preparare una bozza di elenco ricambi da una procedura interna. Due rappresentazioni dello stesso modello producono testi scorrevoli, ma una confonde codici che differiscono per un carattere.
Il criterio di scelta deve registrare il codice esatto e la fonte, non assegnare un voto soltanto alla leggibilità. Aggiungi campioni con ricambi esclusi, versioni precedenti e unità di misura: sono aspetti nei quali una risposta plausibile può essere inutilizzabile.
Se entrambe le configurazioni sbagliano gli stessi passaggi, verifica estrazione del documento e istruzioni prima di attribuire tutto alla compressione. La fonte potrebbe essere stata letta male o presentata al modello senza il contesto necessario. Una prova ben progettata distingue questi casi.
Uno studio di comunicazione: quando la differenza è accettabile?
In un secondo scenario ipotetico, uno studio prepara varianti di descrizioni prodotto, sottoposte sempre a revisione. Qui piccoli cambiamenti stilistici possono essere accettabili, mentre nomi, materiali e caratteristiche non devono essere inventati.
La valutazione può separare i vincoli oggettivi dalla preferenza editoriale. Prima controlla che nessuna configurazione aggiunga certificazioni inesistenti o alteri le misure; soltanto dopo confronta tono e naturalezza.
Questo esempio mostra perché un risultato medio non basta. Una configurazione può soddisfare lo studio e non l'officina, pur usando lo stesso modello. Il livello di compressione va scelto in relazione al rischio dell'errore e al controllo umano effettivamente previsto, non al prestigio del nome.
Quanto incidono template, tokenizer e versione del runtime?
I pesi non sono l'unico elemento che determina la richiesta letta dal modello. Template di conversazione, tokenizzazione e supporto dell'architettura devono essere coerenti con il checkpoint. La specifica GGUF include metadati proprio per descrivere parti di questo contesto tecnico.
Quando un modello quantizzato si comporta in modo strano, prima verifica compatibilità, provenienza e configurazione. Un risultato incoerente non dimostra automaticamente che la quantizzazione abbia «rovinato» il modello.
Controlla anche che le funzioni utilizzate siano supportate: testo, immagini e strumenti non sono intercambiabili. Per una procedura concreta su un checkpoint del cluster, la guida a installare Qwen3.8-27B in locale raccoglie i controlli da eseguire prima del primo documento aziendale.
Prima di cambiare una configurazione già usata dall'ufficio, prepara una possibilità di ritorno alla versione precedente. Conserva il riferimento dei pesi, le impostazioni e i risultati del confronto. Questo rende l'aggiornamento una decisione verificabile: una rappresentazione nuova può essere vantaggiosa per un compito e peggiorare un vincolo che nessuno aveva inserito nella prova. La revisione deve quindi riguardare il servizio consegnato alle persone, non soltanto il fatto che il caricamento termini senza errori.
Quali scorciatoie evitare durante la selezione?
La prima è trasformare una misura di perplessità pubblicata su un altro modello in una percentuale di affidabilità del proprio assistente. Sono grandezze differenti e compiti differenti.
La seconda è confrontare due file senza verificare che derivino dallo stesso checkpoint. La terza è comprimere ancora un file già quantizzato senza valutare il percorso e le perdite aggiuntive. La quarta è scegliere sulla base di una risposta riuscita, ignorando le domande nelle quali il sistema inventa o non rispetta il formato.
Infine, conserva i file effettivamente provati o riferimenti che consentano di recuperarli. Un suffisso simile e un download recente non sono una documentazione sufficiente per ripetere la prova dopo un aggiornamento.
Come decidere senza inseguire la sigla perfetta?
Scrivi i requisiti prima del confronto: quali errori sono bloccanti, quale attesa è accettabile, quali documenti devono essere elaborati e quanta memoria deve restare alle altre attività. Se nessuna configurazione li soddisfa, cambia checkpoint, flusso o hardware: non abbassare implicitamente i criteri per far entrare il modello preferito.
La decisione dovrebbe contenere il nome completo del file, le impostazioni e le ragioni per cui la configurazione è sufficiente. Conserva un gruppo di richieste da ripetere quando cambiano runtime o pesi.
Per progettare un confronto legato ai tuoi documenti, Giallo Studio può affiancarti nella scelta del sistema AI: prima i compiti e le verifiche, poi la quantizzazione che rende il progetto praticabile.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Gemma 4 12B vs Ministral 3 14B: AI locale compatta
 Qwen3.8-27B vs Gemma 4 26B A4B: dense o MoE?
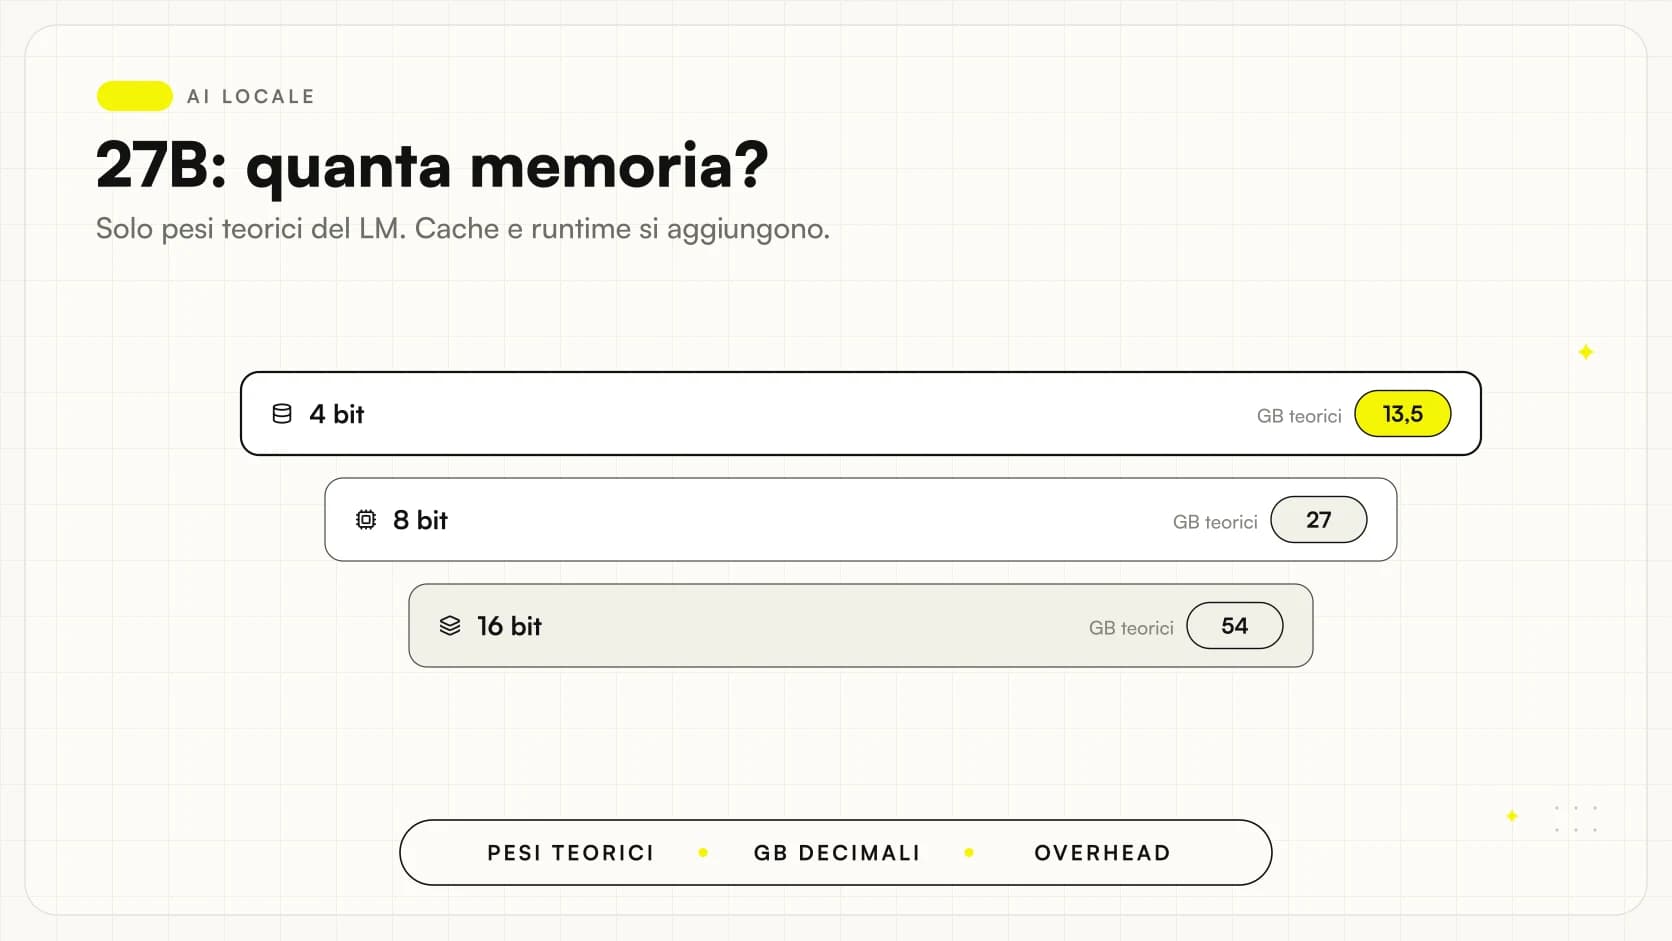 Qwen3.8-27B: quanta RAM e VRAM servono davvero?
 LLM locale su Windows: GPU, VRAM e limiti pratici
 LLM locale su Mac: scegliere con 16, 24 o 32 GB
 LLM locali in italiano: come confrontarli senza falsi test
 Installare Qwen3.8-27B in locale: controlli e procedura
FAQ
Che cos'è la quantizzazione di un LLM?
È una rappresentazione dei pesi con precisione ridotta rispetto al formato di partenza. Può ridurre l'occupazione, ma l'effetto sul risultato dipende dal metodo e dal modello. La scelta va verificata sul compito richiesto.
GGUF significa che il modello è a quattro bit?
No. GGUF è un formato che contiene tensori e metadati; può ospitare rappresentazioni differenti. Per conoscere la quantizzazione devi leggere il nome completo del file e le informazioni del repository.
Q8 è sempre migliore di Q4?
Non è una regola sufficiente per scegliere un sistema. Una rappresentazione meno compressa può conservare più informazione nei pesi, ma richiede più memoria e non garantisce da sola risposte corrette. Confronta lo stesso checkpoint sul lavoro reale.
Un modello da 27B a quattro bit occupa esattamente 13,5 GB?
Quello è il calcolo teorico dei soli pesi a quattro bit uniformi. Il file reale può includere scale, tensori con precisioni diverse, metadati e componenti aggiuntivi. Durante l'esecuzione servono anche cache e buffer.
Posso usare lo stesso GGUF in ogni programma?
Solo se il runtime supporta l'architettura, la quantizzazione e le funzionalità del checkpoint. La presenza dell'estensione GGUF non garantisce compatibilità con tutte le versioni di Ollama, LM Studio o llama.cpp.