
Qwen3.8-27B vs gpt-oss-20b: visione, testo e memoria
Qwen3.8-27B vs gpt-oss-20b: visione, testo, MXFP4, memoria e italiano. Come confrontare due modelli locali con criteri verificabili.
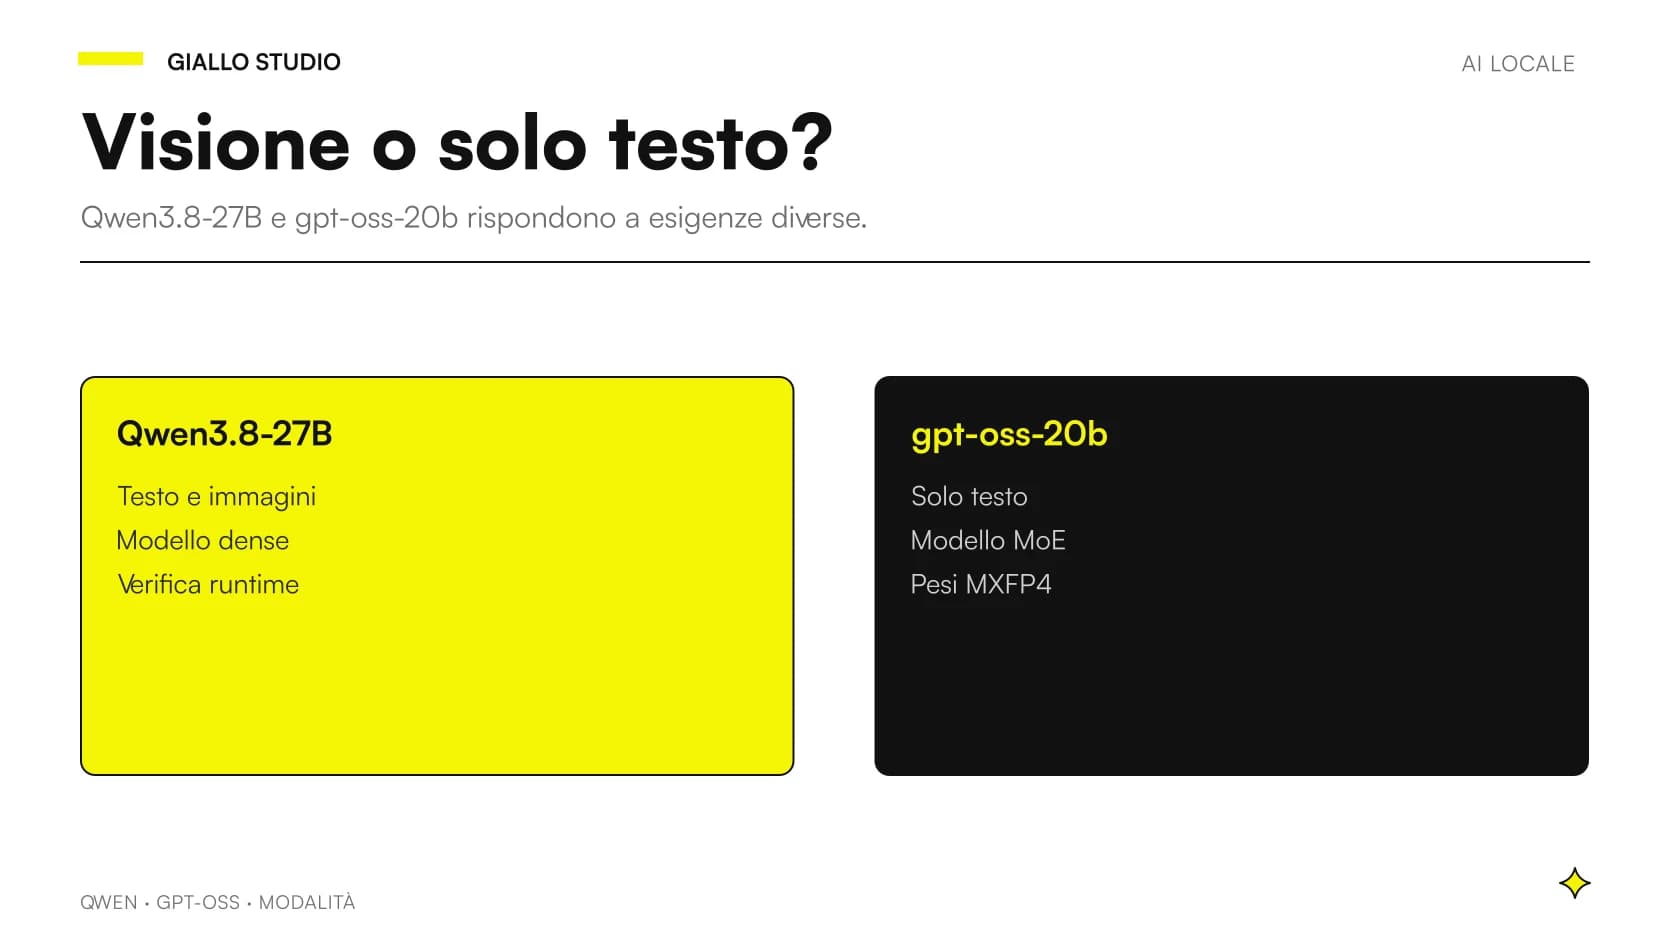
Qwen3.8-27B è multimodale, mentre gpt-oss-20b è un modello testuale: questa è la prima differenza da considerare per l'uso locale. Nessuno dei due può essere dichiarato migliore in assoluto senza una prova comparabile sul lavoro richiesto. Se devi interpretare direttamente un'immagine, i candidati non offrono la stessa modalità di ingresso; se lavori su testo già preparato, il confronto può invece essere pertinente. Fonti: card Qwen, annuncio gpt-oss.
Il nome OpenAI non rende gpt-oss una copia locale di ChatGPT. È un checkpoint scaricabile, da eseguire con un'infrastruttura compatibile e da valutare autonomamente. Qui separiamo architettura, formato, memoria e qualità in italiano, usando documentazione primaria consultata il 27 ottobre 2026. Non presentiamo benchmark Giallo Studio né un requisito hardware universale.
In sintesi
- Qwen3.8-27B comprende testo, immagini e video; gpt-oss-20b lavora sul testo.
- Qwen è dense da 27B per la parte linguistica; gpt-oss-20b è MoE con 21B totali e 3,6B attivi.
- gpt-oss viene distribuito con quantizzazione MXFP4 e richiede il formato conversazionale Harmony.
- Il dato vendor di 16 GB per gpt-oss-20b non garantisce ogni contesto o applicazione.
- Su italiano e fonti aziendali servono prove: la reputazione della famiglia non sostituisce i risultati.
Che cosa scarichi con gpt-oss-20b?
Scarichi i pesi di un modello open-weight di OpenAI, distinto dai servizi ChatGPT e dalle famiglie offerte tramite API. Il repository ufficiale gpt-oss raccoglie implementazioni di riferimento e indicazioni per l'esecuzione; la card del checkpoint 20b identifica la variante piccola, senza attribuirle le dimensioni del 120b.
La differenza è operativa. Con un modello locale sei tu a controllare versione, file e configurazione del motore; funzioni come gestione documentale, strumenti e interfaccia dipendono dal software che costruisci o scegli. Non puoi assumere che una funzione vista dentro ChatGPT sia inclusa nei pesi gpt-oss. Per chiarire i termini prima della scelta, consulta modelli AI locali e modelli AI a pesi aperti.
Dove si separano visione e testo?
La card Qwen descrive comprensione nativa di immagini e video. L'annuncio OpenAI descrive invece modelli addestrati su dati testuali, prevalentemente in inglese. Un sistema basato su gpt-oss può ricevere il testo ricavato da una scansione tramite OCR, ma questa preparazione avviene in un componente separato.
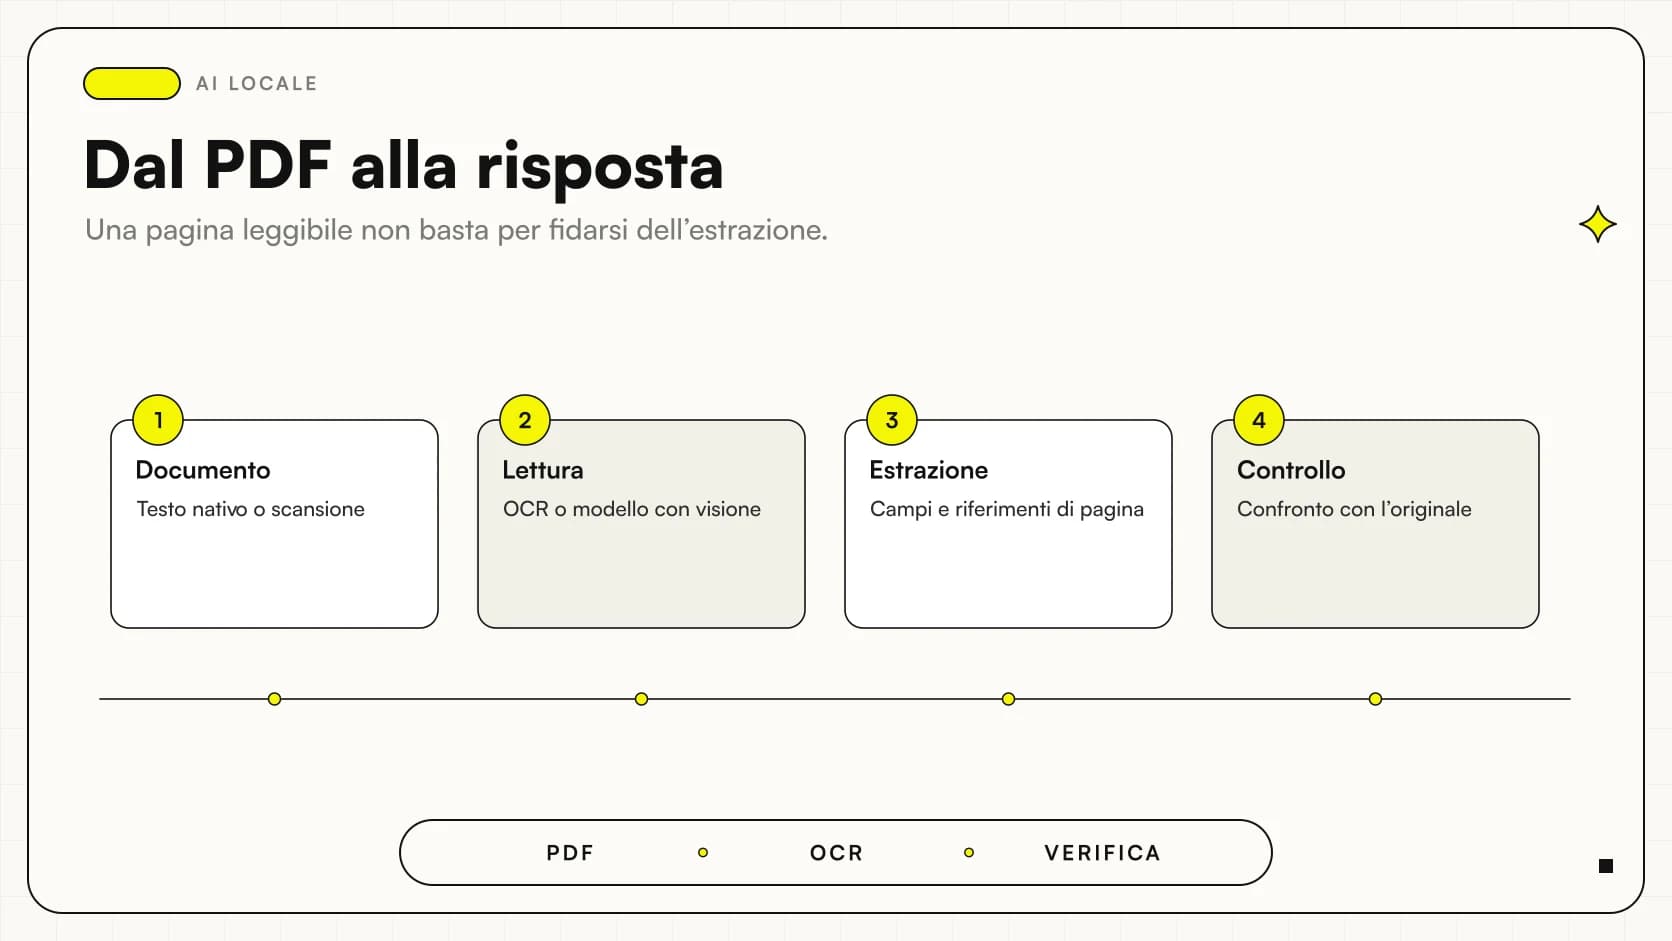
È una differenza importante se vuoi leggere una fotografia, una tabella o una nota nel margine. Il testo estratto può perdere ordine, relazione tra celle o elementi grafici; un modello visivo può provare a interpretarli direttamente, senza diventare per questo infallibile. Nella guida all'AI multimodale locale per PDF e immagini trovi come controllare il percorso dalla pagina alla risposta. Prima di confrontare la qualità, stabilisci se stai valutando il solo modello oppure l'intero sistema di lettura.
Quali numeri descrivono i due modelli?
Per Qwen, la parte linguistica dense è dichiarata da 27B, più encoder visivo. Per gpt-oss-20b, il nome commerciale corrisponde a circa 21B totali e 3,6B attivi per token, con architettura MoE. Il contesto nativo dichiarato è rispettivamente 262.144 token e 128K. Fonti: Qwen3.8-27B, gpt-oss architecture.
| Caratteristica | Qwen3.8-27B | gpt-oss-20b |
|---|---|---|
| Architettura | Dense | MoE |
| Parametri dichiarati | 27B linguistici più visione | 21B totali / 3,6B attivi |
| Input visivo nativo | Sì | No |
| Contesto nativo | 262.144 token | 128K token |
| Formato di distribuzione rilevante | Dipende dal checkpoint e dalla conversione | MXFP4 ufficiale |
| Licenza | Apache 2.0 | Apache 2.0, con policy d'uso da consultare |
| Qualità italiana sul processo | Da verificare | Da verificare |
I parametri attivi di gpt-oss non rappresentano la quantità totale di pesi da rendere disponibile al motore.
Cosa significa MXFP4 per la memoria?
MXFP4 è il formato quantizzato con cui OpenAI distribuisce i pesi gpt-oss, pensato per contenerne l'impegno di memoria. Nell'annuncio ufficiale, OpenAI indica che gpt-oss-20b può essere eseguito con 16 GB di memoria. È una dichiarazione del produttore sul modello e sulla sua distribuzione, non una misura eseguita qui.
Non trasformare il numero in una garanzia per qualsiasi portatile da 16 GB, qualsiasi runtime o contesto pieno. Parte della memoria può essere usata dal sistema e dalle altre applicazioni; il carico aggiunge cache e buffer. Anche il supporto del formato dipende dal motore. Prima di una scelta d'acquisto, verifica il file effettivo e la configurazione. La guida sulla quantizzazione degli LLM locali distingue precisione, contenitore e conversione: nomi simili non rendono i pesi automaticamente intercambiabili.
Perché non basta confrontare 16 GB e 13,5 GB?
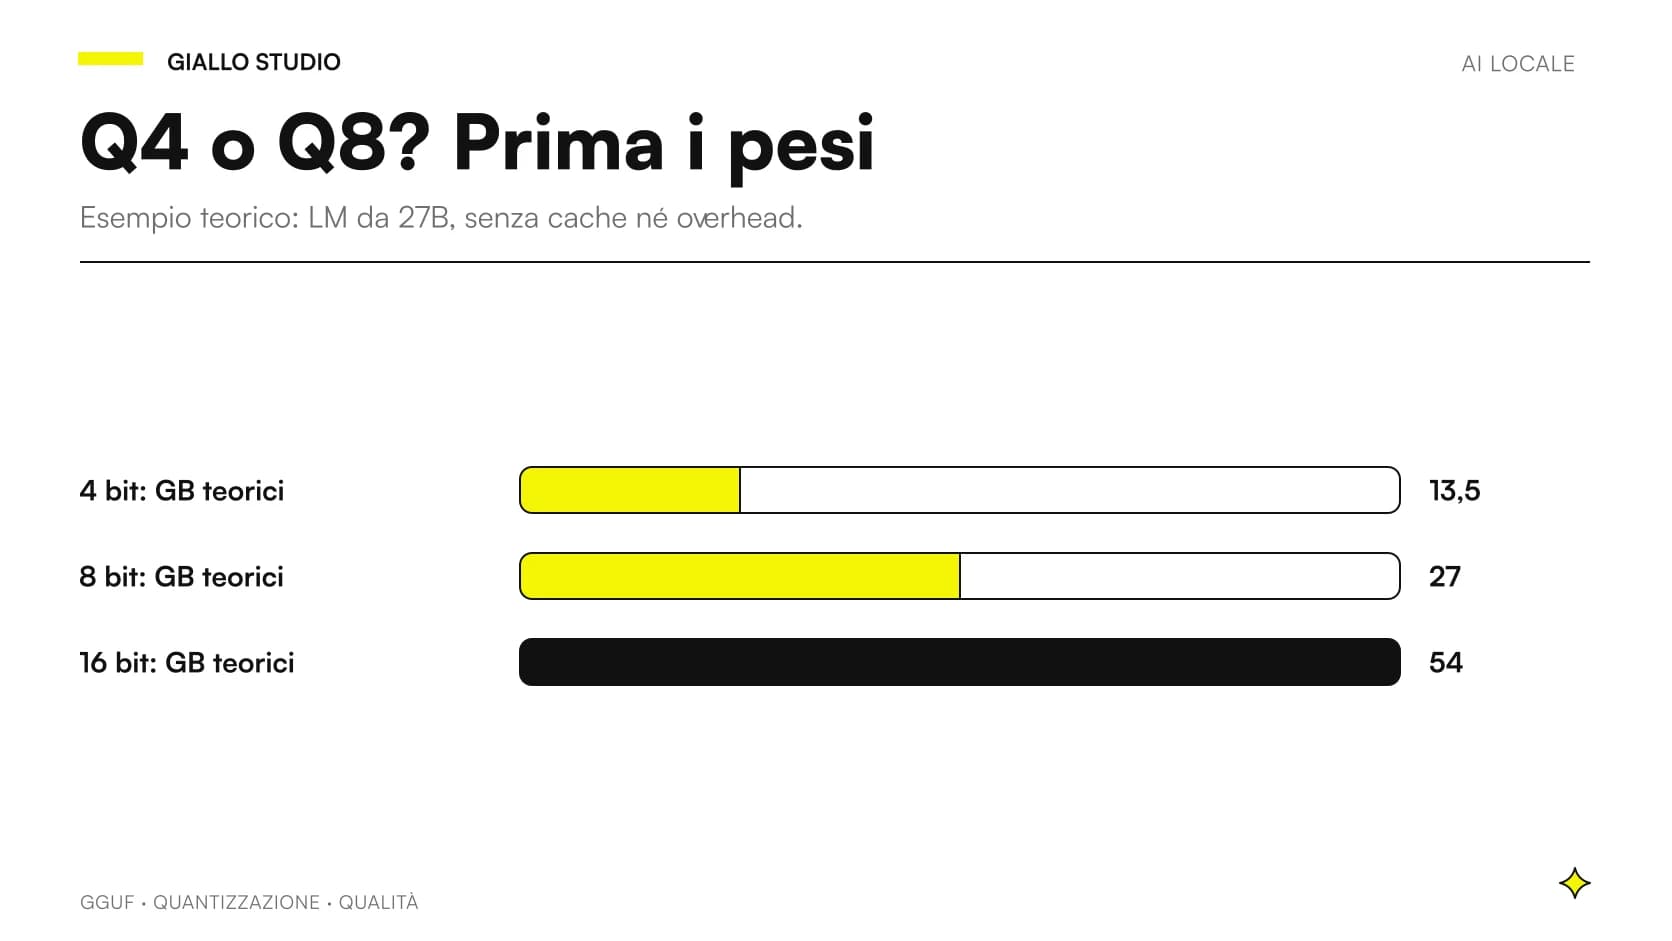
I circa 13,5 GB che si ottengono per 27B parametri a 4 bit sono un calcolo teorico dei soli pesi linguistici Qwen. Non includono componente visiva, scale della quantizzazione, cache o spazio del motore. La formula parametri per bit diviso otto serve a capire l'ordine di grandezza, non a indicare un requisito completo.
Il dato OpenAI di 16 GB riguarda una distribuzione e un'indicazione di esecuzione del produttore; il perimetro è diverso. Metterli affiancati con l'etichetta “RAM richiesta” produrrebbe un confronto fuorviante. Per Qwen consulta quanta RAM e VRAM serve davvero. Nella prova operativa osserva memoria al caricamento e durante la richiesta più impegnativa prevista, conservando un margine per sistema, documenti e altre attività. La capacità di aprire una chat vuota non basta.
Harmony è un dettaglio trascurabile?
No. La card gpt-oss precisa che il modello deve usare il formato Harmony per funzionare correttamente. Il repository ufficiale Harmony descrive struttura delle conversazioni, canali e chiamate agli strumenti. Se usi una soluzione di inferenza compatibile, il formato può essere gestito dal software; se sviluppi un'integrazione, va verificato esplicitamente.
Un output strano non dimostra immediatamente che il modello sia incapace: può indicare un template errato o una conversione non gestita correttamente. Prima di giudicare qualità, controlla che ruoli, fine turno e risposta finale siano interpretati nel modo previsto. Anche il codice che separa un messaggio destinato a un tool da uno da mostrare all'utente deve rispettare il protocollo. Evita correzioni improvvisate che eliminano parti della risposta senza capire che cosa rappresentano.
Come confrontare il ragionamento senza confondere il budget?
gpt-oss supporta livelli di ragionamento; Qwen documenta controlli per il thinking. Le impostazioni permettono di orientare il compromesso tra approfondimento e attesa, ma non sono una scala identica tra produttori. Fonti: card gpt-oss-20b, controlli Qwen.
Per un confronto utile puoi provare prima le configurazioni raccomandate e poi quelle che rispettano il vincolo del reparto. Specifica quale prova stai raccontando e registra il budget di risposta. Una conclusione corretta arrivata dopo un output molto lungo può essere inadatta a una classificazione frequente; una risposta breve può invece omettere una condizione essenziale. Non usare la lunghezza del ragionamento come misura della correttezza. Il giudizio finale deve guardare al risultato verificabile e ai limiti del processo.
Quale test serve per un archivio di testi puliti?
Scenario ipotetico: uno studio di consulenza vuole interrogare istruzioni interne già disponibili come testo selezionabile. Qui il vantaggio multimodale di Qwen può non essere decisivo. La prova può concentrarsi su recupero della fonte, gestione di versioni e capacità di non colmare vuoti informativi.
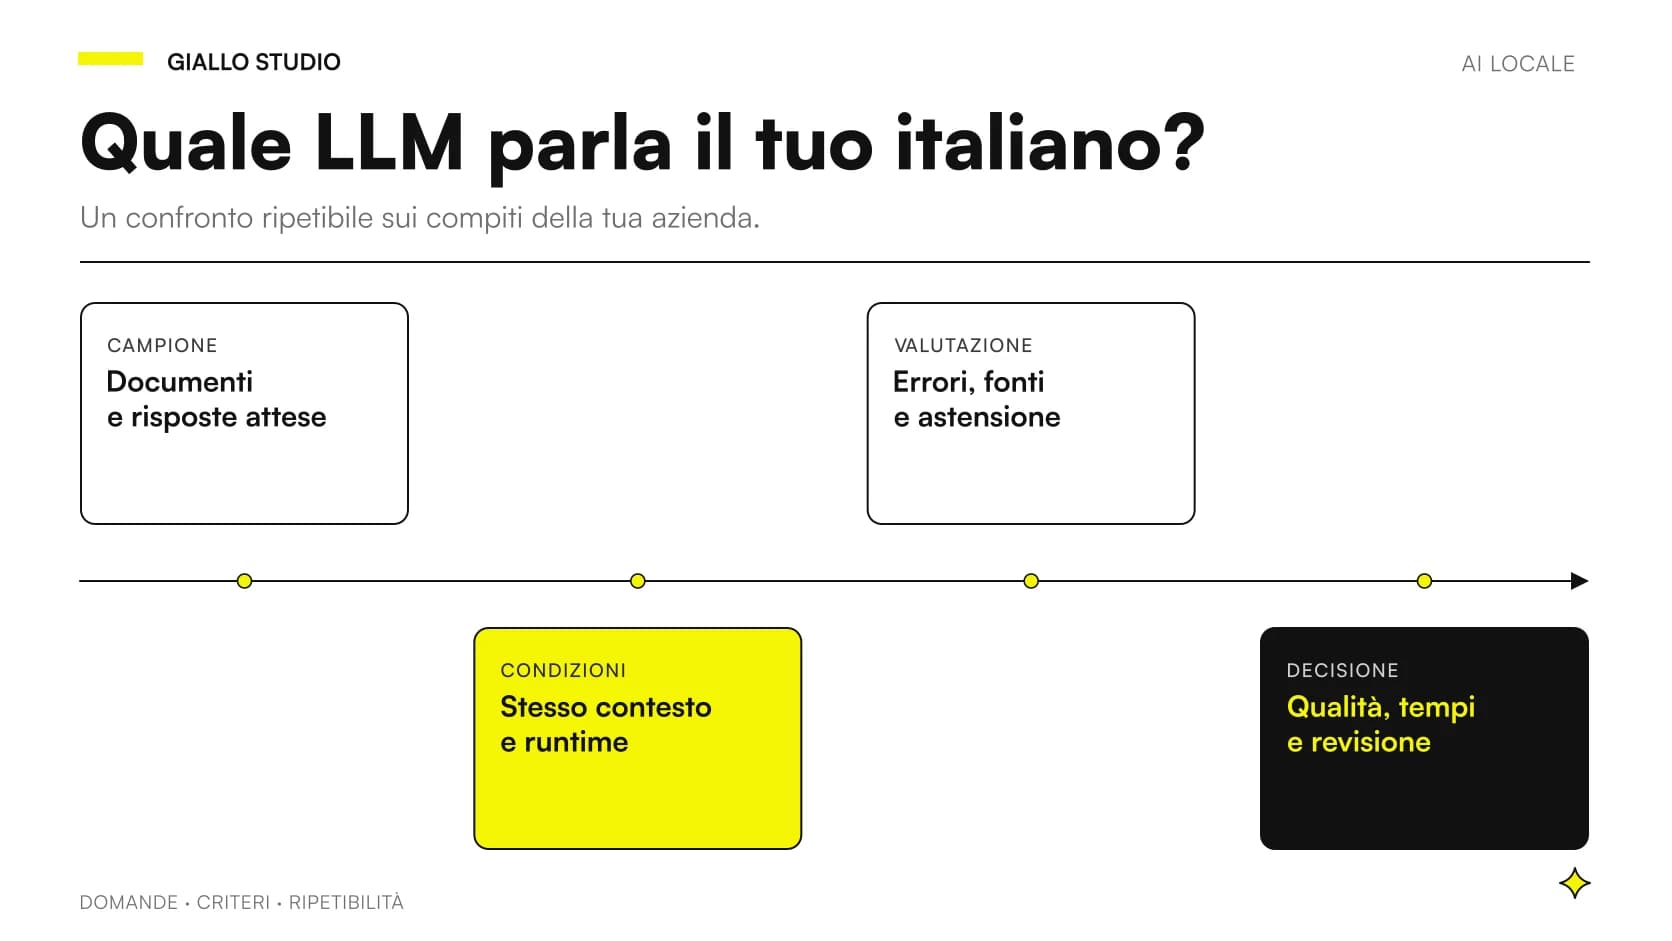
Prepara richieste sulla procedura vigente, su un caso escluso e su un'informazione non presente. Entrambi ricevono gli stessi passaggi e devono citare il riferimento. Fai valutare la risposta senza assegnare punti alla familiarità del marchio. Se il sistema deve consultare un archivio ampio, includi la qualità del recupero: un buon modello con il documento sbagliato può produrre una risposta inapplicabile. La guida al RAG locale sui documenti aziendali chiarisce come separare questa parte dalla generazione.
Cosa cambia con moduli fotografati e allegati misti?
Secondo scenario ipotetico: una PMI riceve richieste corredate da foto, moduli e testo scritto a mano. Qwen può essere provato direttamente sul percorso visivo; gpt-oss richiede che un altro componente trasformi il materiale in testo. Il confronto corretto deve dichiarare questi passaggi e includerne errori e risorse.
Conserva la pagina originale e annota dove l'OCR ha perso una cifra o l'ordine di una tabella. Non attribuire a gpt-oss un errore già presente nel testo ricevuto; non attribuire a Qwen un successo se un operatore ha corretto prima la pagina. Valuta anche campi non leggibili: il sistema dovrebbe segnalarli senza inventare. Un processo può usare percorsi differenti secondo il documento, ma ciascun percorso deve essere verificato e deve mantenere il riferimento alla fonte che l'operatore controlla.
Come verificare che l'italiano sia adatto al lavoro?
Il training prevalentemente inglese dichiarato per gpt-oss non autorizza a definirlo inadatto all'italiano, ma rende necessario un test nella lingua d'uso. Lo stesso vale per Qwen: supporto linguistico e qualità sul tuo lessico non coincidono. Usa domande formulate come quelle del personale, con acronimi, abbreviazioni e riferimenti incompleti.
Presta attenzione a negazioni, unità di misura e condizioni. “Non applicabile” non può diventare una raccomandazione; una sigla di prodotto non dovrebbe essere tradotta creativamente. Verifica anche che il modello chieda chiarimenti quando una parola ambigua cambia il significato operativo. Il protocollo dei benchmark LLM locali in italiano aiuta a documentare correzioni e astensioni. Se una risposta sembra migliore soltanto perché è più naturale da leggere, controlla nuovamente ogni dato prima di assegnare il giudizio.
Prepara anche risposte attese che non coincidano con una singola formulazione. Se il documento dice che una richiesta va approvata dal responsabile, sono accettabili più modi di esprimerlo; non è accettabile saltare l'approvazione. Una rubrica utile separa fatti obbligatori, aggiunte vietate e riferimenti da mostrare. Questo rende il giudizio meno dipendente dal gusto di chi legge e permette a due referenti di discutere un errore preciso. Quando i valutatori non concordano, conserva la divergenza e correggi la regola prima di scegliere il modello. Un confronto con criteri ambigui non diventa oggettivo soltanto perché produce una percentuale.
Quali strumenti possono uscire dalla macchina?
La chiamata a un tool non diventa locale perché il modello è locale. Un sistema può consultare un motore di ricerca remoto, un archivio cloud o un servizio OCR. Le implementazioni di riferimento gpt-oss includono esempi di integrazione con strumenti: sono possibilità del software, non una prova di isolamento automatico. Fonte: repository gpt-oss.
Per un pilota riservato, elenca tutti i passaggi e decidi quali possono usare rete e quali no. Verifica con contenuti autorizzati se l'applicazione continua a funzionare quando blocchi le connessioni esterne previste dalla policy. Controlla anche log, allegati e backup. La guida AI locale e privacy affronta il flusso completo. Non descrivere il sistema come offline basandoti esclusivamente sull'indirizzo locale dell'endpoint di generazione.
Quali errori falsano la scelta tra i due?
Il primo è aspettarsi da gpt-oss le funzioni dell'applicazione ChatGPT. Il secondo è chiamare gpt-oss “un modello da 3,6B” omettendo i pesi totali. Il terzo è giudicare la capacità visiva confrontando Qwen con un OCR non controllato, senza distinguere chi ha letto la pagina e chi ha generato la risposta.
Un quarto errore è usare un template conversazionale incompatibile e interpretare il problema come limite di qualità. Infine, non trattare una licenza permissiva come un'autorizzazione a qualunque uso dei dati. Leggi il LICENSE Qwen, la licenza e la policy d'uso gpt-oss. Le condizioni del runtime o di un servizio ospitato restano ulteriori elementi da verificare nella configurazione scelta.
Quale criterio usare per la decisione finale?
Documento visivo come requisito
Prova il percorso multimodale Qwen e verifica precisione, riferimenti e gestione dei dettagli illeggibili. Confronta eventuali alternative includendo l'intera preparazione del documento.
Testo già preparato come requisito
Metti entrambi sullo stesso campione e valuta fedeltà alle fonti, italiano, memoria e attesa completa. La presenza della visione non assegna punti se il processo non la usa.
Definisci un responsabile delle risposte, una modalità di revisione e un elenco di azioni vietate nel pilota. Se nessun candidato soddisfa i requisiti, cambia il perimetro dell'assistente o considera altre opzioni; non trasformare una scelta di modello in una promessa di autonomia.
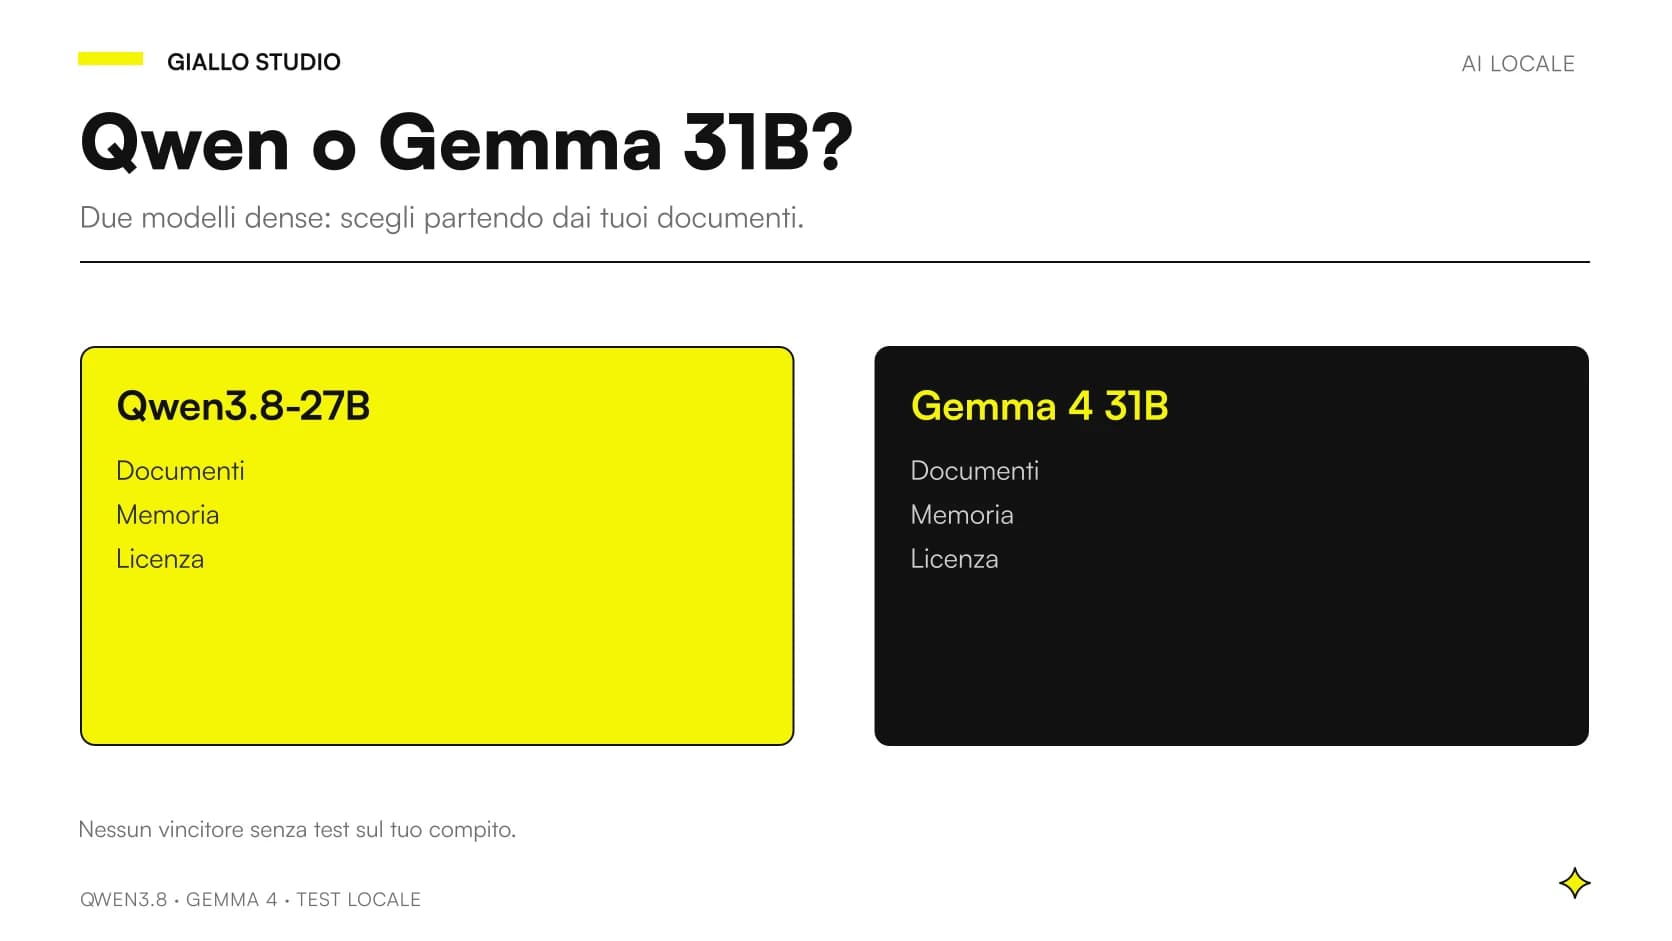
Puoi confrontare Qwen anche con Gemma 4 31B. Se devi collegare un modello locale al tuo archivio senza perdere traccia delle fonti, Giallo Studio progetta software AI su misura partendo dai documenti e dai controlli che il tuo team userà ogni giorno.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
- Qwen3.8-27B vs Ministral 3 14B: quale portare in locale
- Qwen3.8-27B vs Gemma 4 26B A4B: dense o MoE?
- Qwen3.8-27B vs Qwen3.6-35B-A3B: cosa cambia in locale
- PWA aziendale su misura: quando conviene rispetto a un software pronto
- Qwen3-Coder-Next vs Devstral Small 2: codice in locale
- Perplexity vs Google: risposta con fonti o lista di link
- RPA vs AI automation: differenze, costi e quando usare quale
- Claude Opus 5 vs Sonnet 5
- Voice AI o chatbot: quale canale scegliere
- Claude Opus 5 vs GPT-6 Astra
- AI in abbonamento o su misura: cosa conviene
FAQ
Qual è la differenza principale tra Qwen3.8-27B e gpt-oss-20b?
Qwen è multimodale e comprende immagini e video; gpt-oss-20b è testuale. Per documenti scansionati, gpt-oss necessita di una preparazione separata, per esempio OCR.
gpt-oss-20b è ChatGPT installato sul PC?
No. È un modello a pesi scaricabili distinto da ChatGPT. Interfaccia, strumenti e gestione dei documenti dipendono dal software di inferenza e dall’applicazione.
Quanti parametri ha gpt-oss-20b?
OpenAI dichiara circa 21 miliardi totali e 3,6 miliardi attivi per token. È un MoE: i parametri attivi non rappresentano l’intero checkpoint da gestire.
Bastano sempre 16 GB per gpt-oss-20b?
OpenAI indica la possibilità di eseguirlo con 16 GB nella distribuzione prevista. Non è una garanzia per qualsiasi macchina, contesto, runtime o carico concorrente.
Posso confrontarli in italiano?
Sì, usando le stesse fonti e domande rappresentative del lavoro. Valuta fedeltà ai dati, gestione dei termini tecnici e astensione, non soltanto fluidità del testo.