
LLM locali in italiano: come confrontarli senza falsi test
Un protocollo per confrontare LLM locali in italiano: compiti, risposte attese, citazioni, astensione, latenza e configurazioni riproducibili.
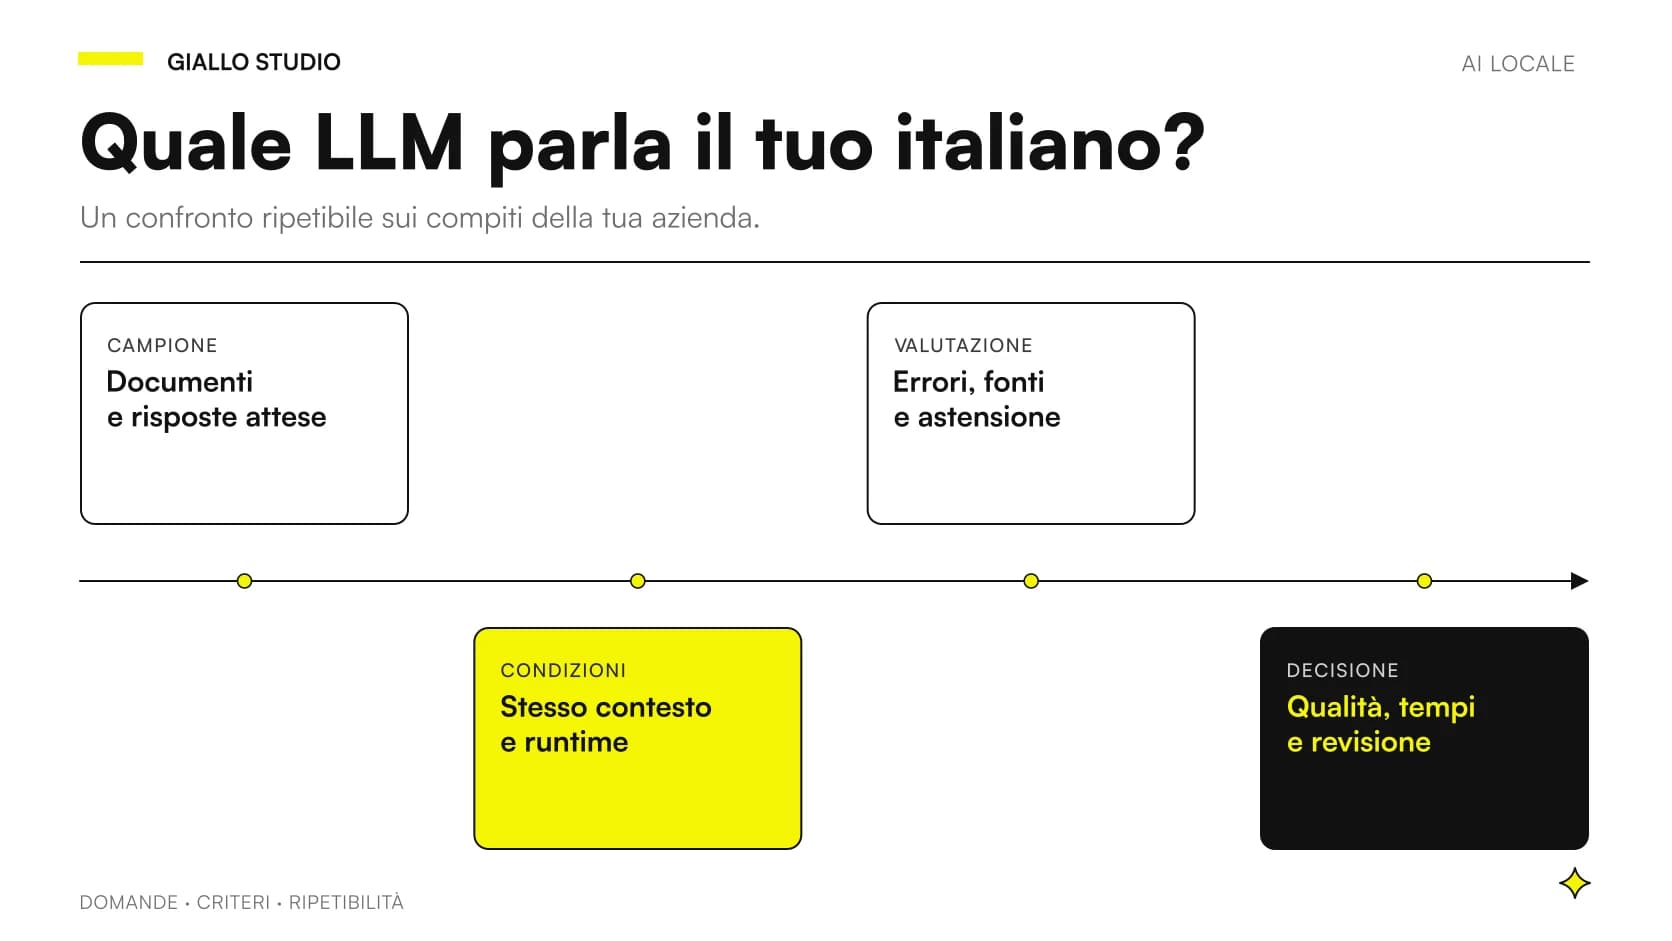
Un benchmark di LLM locali in italiano è utile quando confronta compiti definiti, configurazioni documentate e risposte verificabili. Una raccolta di impressioni o punteggi presi da fonti diverse non dimostra quale modello funzioni meglio nella tua azienda.
Qui proponiamo un protocollo di valutazione, non risultati ottenuti da Giallo Studio. Serve per confrontare candidati come Qwen3.8-27B, Gemma 4 o altri checkpoint compatibili con il proprio hardware, distinguendo qualità linguistica, correttezza, capacità di usare le fonti e prestazioni operative.
In sintesi
- Definisci il lavoro e i criteri prima di vedere le risposte dei modelli.
- Confronta checkpoint e impostazioni identificabili, non soltanto nomi di famiglie.
- Valuta separatamente correttezza, citazioni, formato e capacità di astenersi.
- Registra caricamento, latenza e completamento senza trasformare una misura in una velocità universale.
- Conserva anche fallimenti e limiti: il risultato deve poter essere ricontrollato.
Che cosa deve dimostrare il confronto?
La domanda «qual è il migliore?» è troppo ampia. Chiedi invece quale configurazione completa meglio un'attività specifica, sulla macchina disponibile e con i controlli previsti.
Un assistente per consultare procedure richiede prove diverse da un modello per preparare bozze commerciali. Nel primo caso possono essere decisivi versione del documento e citazioni; nel secondo vanno separati stile e fedeltà ai dati forniti.
La guida a come scegliere un modello AI aiuta a trasformare l'obiettivo in requisiti. Scrivi anche le esclusioni: un modello che prepara una bozza non viene automaticamente autorizzato a inviarla, e un test di scrittura non dimostra capacità di operare su un gestionale.
Perché «supporta l'italiano» non basta?
Il supporto linguistico dichiarato non equivale alla correttezza sul lessico, sui documenti e sulle ambiguità del tuo settore. La model card Gemma 4 descrive capacità multilingua e valutazioni della famiglia; resta necessario un controllo sul lavoro italiano richiesto.
Una risposta naturale può contenere una data scambiata, un'eccezione omessa o una conclusione non presente nelle fonti. Per questo la valutazione deve distinguere leggibilità e fedeltà.
Prepara formulazioni realistiche: abbreviazioni interne, richieste incomplete, sinonimi e domande scritte come le porrebbero le persone. Non limitarti a tradurre un quiz inglese. Se il servizio verrà usato anche da chi conosce poco la terminologia tecnica, includi quel tipo di richiesta nel campione.
Come identificare esattamente i modelli candidati?
Registra produttore, repository, checkpoint e revisione. Aggiungi file, precisione o quantizzazione, versione del runtime e impostazioni di generazione. Il nome della famiglia non è sufficiente.
La model card Qwen3.8-27B distingue capacità e controlli del checkpoint. Se una prova abilita ragionamento, strumenti o un contesto differente, deve dichiararlo: stai confrontando configurazioni, non un'entità astratta chiamata Qwen.
Quando valuti Qwen3.8-27B e Gemma 4 31B, specifica se vuoi isolare una caratteristica o scegliere il sistema finale. Nel primo caso mantieni più condizioni uguali possibile; nel secondo puoi adottare configurazioni differenti ma devi documentarne costi e limiti.
Come costruire il campione senza inventare risultati?
Raccogli attività rappresentative e prepara per ciascuna la risposta attesa o una rubrica. Usa materiali sintetici o autorizzati, evitando di trasformare il test in una copia indiscriminata dell'archivio aziendale.
Il campione dovrebbe includere casi ordinari, eccezioni, informazioni mancanti e documenti con versioni differenti. Decidi prima quali errori sono bloccanti. Non aumentare il peso di una domanda soltanto dopo aver visto che fa vincere il modello preferito.
Conserva una parte delle richieste per il controllo finale, senza usarla continuamente per modificare il prompt. Altrimenti rischi di costruire una configurazione adattata a pochi esempi, apparentemente valida nel test e fragile sul lavoro nuovo. Non esiste qui una numerosità universale: dimensiona la prova secondo varietà e conseguenze dell'errore.
Fai scrivere le risposte attese da chi conosce i documenti e il processo, prima di generare gli output. Quando esistono più risposte ammissibili, descrivi i vincoli che tutte devono rispettare invece di pretendere la stessa formulazione parola per parola. Per una bozza commerciale, per esempio, puoi accettare stili differenti ma richiedere che nessuna versione aggiunga uno sconto non presente nei dati. Questo rende la valutazione più solida e impedisce di premiare un modello soltanto perché usa parole simili a quelle del valutatore.
Quale scheda usare per segnare le risposte?
La tabella seguente è un modello vuoto da compilare, non una presentazione di risultati misurati.
| Criterio | Che cosa verificare | Evidenza da conservare |
|---|---|---|
| Correttezza | Dati e conclusioni corrispondono alla risposta attesa | Risposta e riferimento |
| Completezza | Sono presenti elementi ed eccezioni richiesti | Elenco dei vincoli |
| Fonti | I passaggi citati sostengono le affermazioni | Documento e sezione |
| Astensione | Il sistema riconosce informazione assente | Caso senza risposta |
| Formato | L'output rispetta lo schema richiesto | Controllo del formato |
| Lingua | Il testo è chiaro e adeguato al contesto | Rubrica editoriale |
| Operatività | Tempi e memoria rispettano il processo | Configurazione e misure |
Non fondere subito tutto in un punteggio unico. Una citazione inventata o una violazione di accesso può essere bloccante anche se stile e velocità sono ottimi. Se usi pesi, dichiarali e mostra come cambiano le conclusioni.
Riporta inoltre il denominatore delle misure e conserva il conteggio degli errori per categoria. Una percentuale isolata può nascondere un campione minuscolo o una distribuzione squilibrata delle attività. Se molte domande riguardano riassunti semplici e poche riguardano eccezioni decisive, la media può dare un'immagine rassicurante senza rappresentare il rischio operativo. Mostra quindi separatamente i gruppi di compiti e i casi bloccanti, segnalando quando i dati non sono sufficienti per una conclusione generale.
Come verificare citazioni e astensione?
Inserisci una domanda la cui risposta sia presente, una che richieda più passaggi e una plausibile ma senza sostegno nel materiale. Il modello deve distinguere queste condizioni.
Controlla che la fonte esista, sia quella prevista e supporti il punto della risposta. Un link autentico ma non pertinente non è una citazione corretta. Per i sistemi documentali, la guida al RAG locale distingue errori di recupero ed errori del generatore.
L'astensione non significa rifiutare ogni domanda difficile. Il criterio è riconoscere quando le informazioni disponibili non bastano, spiegando quale dato manca. Conserva sia le invenzioni sia i rifiuti inutili: un assistente che non sbaglia mai perché non risponde non completa il lavoro richiesto.
Come tenere separati retrieval e generazione?
Se il sistema cerca in un archivio, una risposta sbagliata può dipendere dal mancato recupero della fonte. Cambiare LLM senza vedere cosa ha ricevuto nel contesto rende la diagnosi poco affidabile.
Prepara quindi un controllo del recupero: quali documenti e passaggi devono arrivare al modello per ogni domanda? Poi prova il generatore con i passaggi corretti forniti direttamente. Le due valutazioni rispondono a domande differenti.
Puoi anche confrontare il sistema completo, perché è ciò che utilizzeranno le persone. Conserva però il percorso intermedio, così sai se intervenire su estrazione, indicizzazione, ricerca o risposta. Questo evita di attribuire al modello linguistico un limite introdotto prima della sua chiamata.
Come misurare velocità e memoria correttamente?
Distingui caricamento, elaborazione del prompt, attesa iniziale e generazione. Le metriche di utilizzo Ollama espongono conteggi e durate utili a descrivere alcune di queste fasi.
Per prove del motore, llama-bench permette misure tecniche documentate. Non confondere quei risultati con il tempo di un processo completo che include caricamento dei file, ricerca e revisione.
Annota se il modello era già caricato, quali altre applicazioni erano attive e quante richieste erano contemporanee. Ripeti i casi importanti e conserva la dispersione, non soltanto il valore più favorevole. Un numero senza configurazione non consente di stimare cosa accadrà su un altro PC, con un altro contesto o sotto carico.
Se modelli differenti producono risposte di lunghezza molto diversa, il tempo totale va letto insieme al contenuto utile. Una risposta breve ma incompleta non vince automaticamente perché termina prima; una risposta prolissa non giustifica da sola una maggiore attesa. Definisci il formato richiesto e verifica il completamento del compito, mantenendo separati i token prodotti dal valore consegnato all'utente. Nei servizi condivisi aggiungi un carico rappresentativo: il test di una sola persona non dimostra l'esperienza di un ufficio durante i picchi.
Come confrontare quantizzazioni senza cambiare domanda?
Per isolare l'effetto della compressione, usa lo stesso checkpoint di partenza e mantieni uguali prompt, materiali e impostazioni pertinenti. La guida a Q4 e Q8 in GGUF chiarisce perché il nome del contenitore non basta a descrivere i pesi.
Se cambi anche modello, puoi comunque scegliere una configurazione pratica, ma non attribuire tutte le differenze alla quantizzazione. Un modello più piccolo meno compresso e uno più grande molto compresso sono due sistemi differenti.
Misura ciò che interessa al processo: la configurazione che entra nella memoria potrebbe consentire un contesto più utile, mentre una più capiente potrebbe richiedere un percorso hardware diverso. Riporta entrambi gli effetti insieme alla qualità, senza dichiarare una perdita percentuale universale.
Un ufficio acquisti: come valutare estrazione e vincoli?
Consideriamo uno scenario ipotetico: un ufficio acquisti deve ricavare codici, quantità e condizioni da documenti di offerta. Il campione può contenere righe simili, opzioni escluse e note che modificano il significato della tabella.
La risposta attesa deve indicare i campi corretti e il riferimento. Uno stile convincente non compensa una quantità attribuita alla riga sbagliata. Se il compito richiede un formato strutturato, verifica anche che i dati possano essere letti dall'applicazione successiva.
Aggiungi un'offerta nella quale un'informazione manca. Il sistema dovrebbe segnalarlo invece di completarla per analogia. Nessuno di questi esempi rappresenta un risultato già ottenuto: descrivono il materiale da preparare per una valutazione legata al processo.
Un'assistenza tecnica: come evitare il manuale sbagliato?
In un secondo esempio ipotetico, un'assistenza confronta modelli per consultare manuali. La domanda non è soltanto se il modello conosce il prodotto, ma se usa la revisione corretta e cita il passaggio pertinente.
Prepara coppie di documenti quasi uguali con differenze operative e domande che richiedano di chiedere chiarimenti. Il sistema dovrebbe distinguere l'informazione certa da quella che dipende da una versione non specificata.
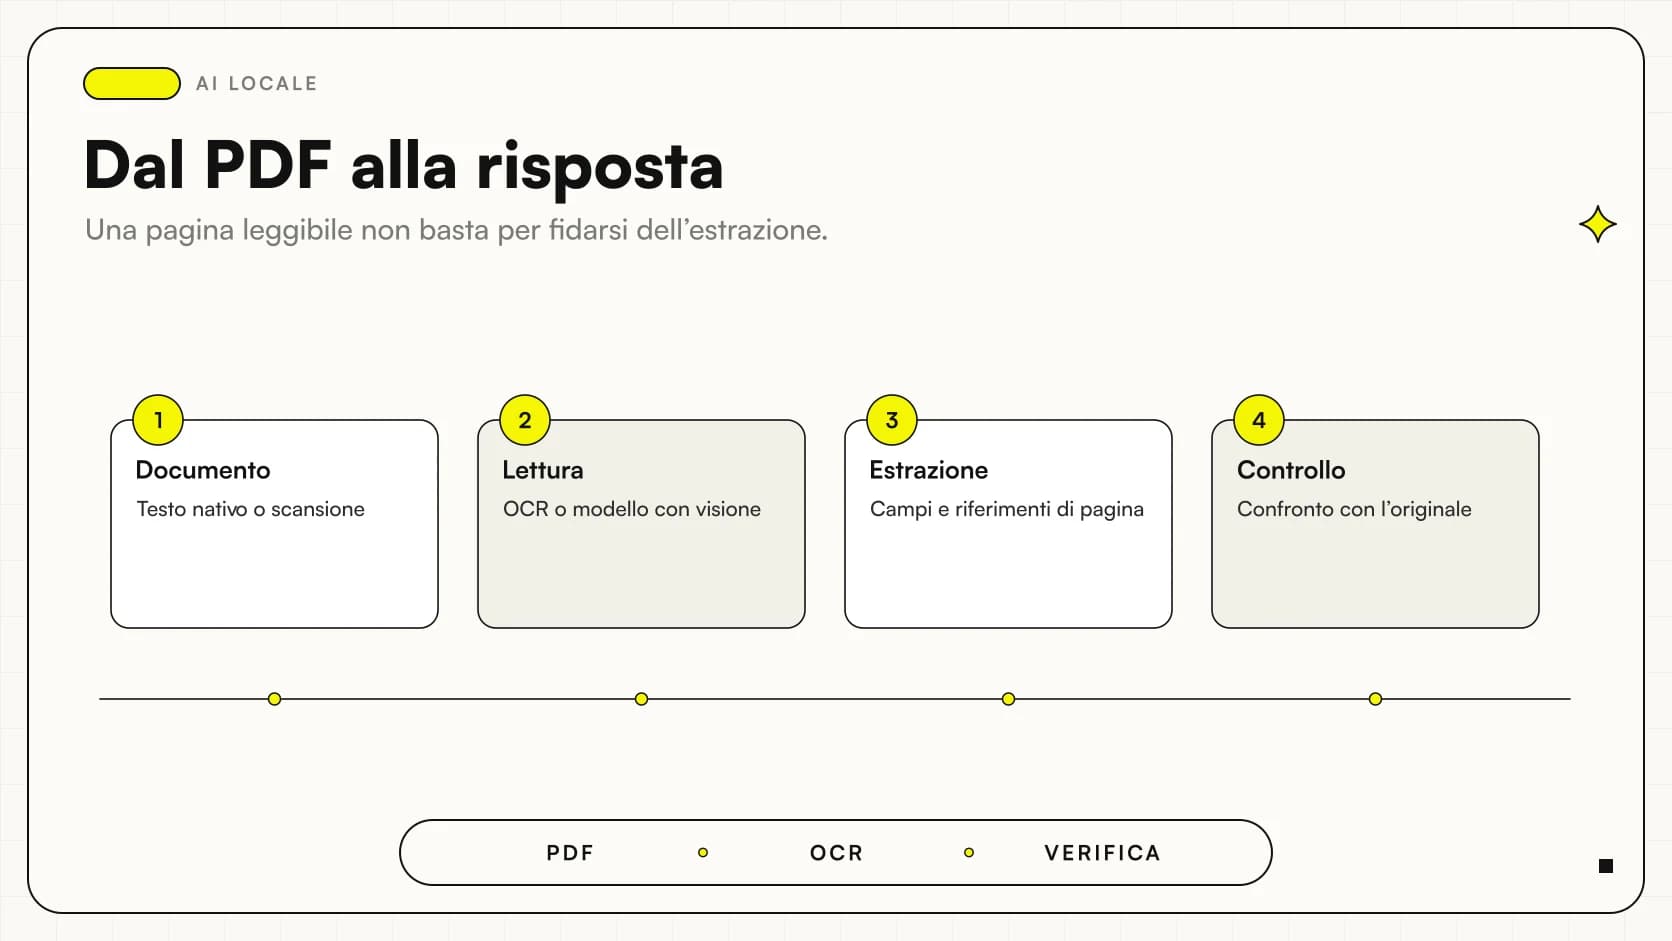
Valuta inoltre come viene presentato il limite. Una risposta prudente ma vaga può non aiutare l'operatore; una risposta utile indica il dato necessario o la fonte da verificare. Per PDF e scansioni, separa la lettura multimodale dei documenti dalla capacità di ragionare sul testo già estratto.
Come leggere i benchmark pubblicati da altri?
Annota chi ha eseguito la valutazione, quale dataset ha usato e quali condizioni dichiara. I risultati dei produttori sono informazioni da attribuire al produttore, non test indipendenti svolti dal tuo team.
Non unire numeri che appartengono a versioni o compiti diversi. Strumenti come LM Evaluation Harness rendono espliciti molti dettagli della valutazione: task, configurazioni e modalità di esecuzione sono parte del risultato.
Anche quando il nome del benchmark coincide, controlla budget, prompt, strumenti e checkpoint. Una misura può orientare la selezione iniziale, ma non sostituisce le prove sul processo italiano. Se una tabella non consente di capire queste condizioni, presenta il limite invece di trasformarla in una classifica certa.
Quando usare un giudice automatico e un controllo cieco?
Un valutatore automatico può aiutare a organizzare molte risposte, se la rubrica è chiara e viene verificata. Non trattarlo come una fonte infallibile: può preferire testi lunghi o ben scritti anche quando contengono errori.
Per ridurre preferenze legate al marchio, puoi presentare le risposte senza il nome del modello e alternarne l'ordine. È una scelta metodologica da documentare, non una garanzia di imparzialità.
Due valutatori danno giudizi diversi
Conserva il disaccordo e controlla la rubrica insieme alla fonte. Se il criterio è ambiguo, chiariscilo prima di decidere. Non scegliere automaticamente il giudizio che conferma la preferenza iniziale.
Per dati oggettivi, privilegia controlli diretti sul documento e sul formato. Usa il giudizio editoriale per gli aspetti che richiedono davvero valutazione umana.
Il confronto fra DeepSeek R1 Distill 32B e Qwen3.8-27B offre un esempio di candidati con input diversi. Se il campione contiene immagini, una capacità assente non va trattata come un errore di italiano: si separano idoneità al formato e accuratezza delle risposte testuali.
Che cosa deve contenere il verdetto finale?
Scrivi quale configurazione soddisfa il compito, quali errori restano e in quali condizioni la conclusione è valida. Conserva richieste, risposte, fonti e versioni necessarie a ripetere la prova.
Collega la decisione al costo dell'AI locale e cloud, perché correzioni, tentativi e manutenzione influenzano il servizio. Ripeti i casi critici quando aggiorni modello o runtime; non cambiare la data del confronto senza un nuovo lavoro sostanziale.
Per preparare una valutazione sui tuoi processi, Giallo Studio può definire il pilota AI: compiti rappresentativi, criteri di accettazione e prove leggibili prima di scegliere quale modello introdurre in azienda.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 AI multimodale locale: leggere PDF e immagini aziendali
 DeepSeek R1 Distill 32B vs Qwen3.8-27B in locale
 Qwen3.8-27B vs Gemma 4 31B: confronto per uso locale
 Quantizzazione GGUF: Q4 o Q8 per gli LLM locali?
 RAG locale sui documenti aziendali: come progettarlo
 AI locale vs cloud: come confrontare i costi in azienda
 Come scegliere un modello AI
FAQ
Qual è il miglior LLM locale in italiano?
Senza definire compito, hardware e criteri non esiste una risposta verificata. Il modello va confrontato su richieste rappresentative con risposte attese e vincoli espliciti. Un punteggio generale non dimostra affidabilità sui documenti dell'azienda.
Posso confrontare i punteggi pubblicati dai produttori?
Puoi usarli come orientamento, verificando benchmark, versione, impostazioni e strumenti. Se le condizioni differiscono, i numeri non costituiscono un confronto controllato. Segnala sempre chi ha eseguito la valutazione.
Bastano alcune domande difficili per scegliere?
Possono far emergere limiti, ma non rappresentano necessariamente il lavoro quotidiano. Prepara casi normali, eccezioni e domande senza risposta, con criteri stabiliti prima del test. Evita di scegliere soltanto gli esempi favorevoli.
Come misuro le prestazioni di un modello locale?
Distingui caricamento, attesa iniziale, elaborazione del prompt e completamento della risposta. Registra hardware, runtime, checkpoint, quantizzazione e carico. La velocità non va valutata separatamente dalla correttezza.
Un altro LLM può giudicare automaticamente le risposte?
Può aiutare se la rubrica è chiara e viene validata su un campione controllato da persone competenti. Non sostituisce automaticamente le fonti e può introdurre errori o preferenze. Conserva le risposte e verifica i giudizi importanti.