
Gemma 4 12B vs Ministral 3 14B: AI locale compatta
Gemma 4 12B vs Ministral 3 14B: audio, immagini, memoria e documenti. Come confrontare due modelli compatti per un processo aziendale.
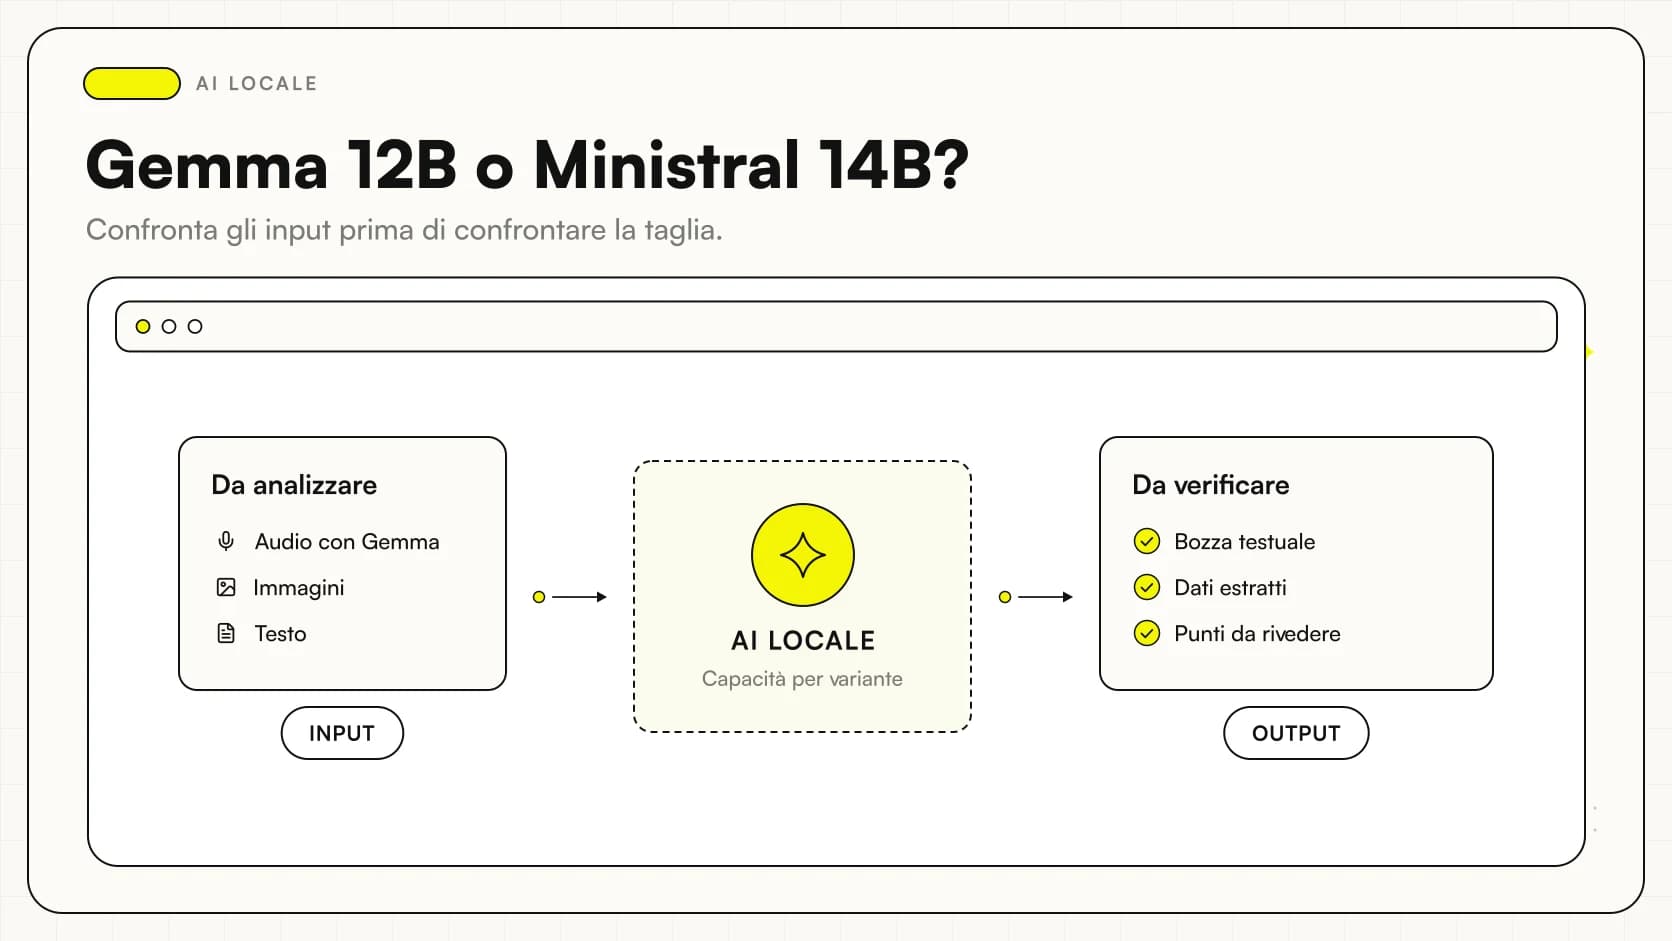
Gemma 4 12B comprende testo, immagini e audio; Ministral 3 14B comprende testo e immagini. Se il tuo processo locale deve ricevere audio direttamente, questa differenza orienta già il pilota; per i soli documenti testuali o visivi serve invece un confronto sul lavoro reale. Non abbiamo un vincitore misurato sui tuoi dati. Fonti: Gemma 4 model card, Ministral 3 14B Instruct.
Le due taglie possono interessare una PMI che cerca un assistente meno impegnativo dei modelli con molte più decine di miliardi di parametri. “Compatto” resta però un confronto relativo: non significa che ogni computer sia adatto, né che l'intero processo sia automaticamente offline. Questa guida distingue capacità, stime del produttore e prove da eseguire, sulla base delle fonti ufficiali consultate il 27 ottobre 2026.
In sintesi
- Gemma 4 12B Unified dichiara 11,95B parametri e ingressi testuali, visivi e audio.
- Ministral 3 14B combina 13,5B parametri linguistici con un encoder visivo da 0,4B.
- Entrambi dichiarano un contesto da 256K e licenza Apache 2.0.
- Gemma genera testo: l'ingresso audio non equivale a una voce sintetica in uscita.
- Per documenti, riunioni e richieste interne conta la precisione verificata, oltre alla memoria.
Quali checkpoint entrano nel confronto?
Per Google il riferimento è Gemma 4 12B Unified, variante dense descritta nella model card ufficiale. Per Mistral è Ministral-3-14B-Instruct-2512, usando la distribuzione BF16 come riferimento delle caratteristiche e distinguendo gli altri formati. Base e Reasoning sono varianti differenti, non semplici alias di Instruct. Fonte Mistral.
Il nome completo serve a evitare confronti con risultati della variante Gemma 4 31B o con quelli di un Mistral Large. Se una recensione parla soltanto di “Gemma” o “Mistral”, chiedi quale modello abbia usato e con quali pesi. La guida ai modelli AI locali chiarisce la distinzione tra famiglia, checkpoint e applicazione, utile prima di scegliere il programma con cui iniziare la prova.
Che cosa significa Unified per Gemma 4 12B?
Google descrive la variante 12B come encoder-free: invece di passare prima da encoder multimodali dedicati, immagini e audio vengono proiettati direttamente nello spazio degli embedding attraverso componenti leggere. La card indica 11,95B parametri e supporto a testo, immagini e audio, con generazione testuale. Fonte: architettura Gemma 4 12B.
Per chi usa l'applicazione, il punto pratico è la possibilità di valutare ingressi diversi nello stesso modello. Il vantaggio effettivo del percorso va però provato con il motore scelto: una capacità presente nella card non garantisce che qualunque interfaccia sappia inviare correttamente un file audio. Prima di giudicare la risposta, controlla cosa riceve davvero il checkpoint e quali trasformazioni applica il software. Se il file viene trascritto da un servizio remoto, stai già valutando un percorso differente.
Quale ingresso audio manca a Ministral 3 14B?
La card Ministral dichiara testo e capacità visive attraverso un modello linguistico da 13,5B e un encoder visivo da 0,4B. Non descrive un ingresso audio nativo per questo checkpoint. Un'applicazione può comunque associargli un trascrittore separato e passare il testo risultante. Fonte: Ministral 3 14B Instruct BF16.
Questa soluzione può essere adatta, ma il confronto deve includere anche la trascrizione. Un nome sbagliato nel verbale può nascere prima della generazione, e un modello testuale non vede il suono originale per correggerlo. Con Gemma puoi provare il percorso audio diretto supportato dal runtime, senza presumere che sia migliore: serve verificare nomi, negazioni e riferimenti. La scelta è tra sistemi da mettere alla prova, non tra un numero di passaggi che assegna da solo un punteggio.
Quali specifiche aiutano a delimitare la prova?
Le fonti dichiarano per entrambe le varianti un contesto di 256K token e licenza Apache 2.0. La finestra nominale non descrive però quanti minuti di una registrazione o quante pagine potrai elaborare in ogni ambiente: preparazione, tokenizzazione e risorse disponibili fanno parte del percorso. Fonte Google, fonte Mistral.
| Criterio | Gemma 4 12B Unified | Ministral 3 14B Instruct |
|---|---|---|
| Architettura di riferimento | Dense, multimodale unificata | Linguistico dense più encoder visivo |
| Dimensione dichiarata | 11,95B | 13,5B linguistici + 0,4B visivi |
| Immagini | Sì | Sì |
| Audio nativo in ingresso | Sì | Non dichiarato per questa variante |
| Output | Testo | Testo |
| Contesto dichiarato | 256K | 256K |
| Licenza | Apache 2.0 | Apache 2.0 |
| Adeguatezza al tuo processo | Da misurare | Da misurare |
La tabella serve a selezionare il campione appropriato, senza aggiungere vantaggi che le fonti non dimostrano.
Quanta memoria indicano i produttori?
Google pubblica per Gemma 4 12B stime di caricamento di circa 26,7 GB BF16, 13,4 GB SFP8 e 6,7 GB Q4_0, includendo un overhead indicativo del 20%. La documentazione precisa che il risultato dipende da strumento e ambiente. Questi valori non dimostrano che un carico con audio e contesto lungo rientri sempre nella stessa memoria. Fonte: Gemma 4 overview.
Mistral indica per il 14B la possibilità di rientrare in 32 GB VRAM BF16 e in meno di 24 GB RAM o VRAM quantizzato. Anche questa è un'indicazione vendor, non una prova comparabile con il perimetro Google. Fonte: card Mistral. Non trasformare due stime costruite diversamente in una graduatoria. Osserva il file e il carico effettivi e tieni distinto il margine per sistema, cache e altre applicazioni.
Quale formato conviene provare per primo?
Scegli il formato supportato dalla tua infrastruttura e documenta la conversione. Per Ministral esiste un repository GGUF ufficiale; per Gemma parti dai collegamenti di download e dagli ambienti indicati nella guida ufficiale di avvio. Non dare per scontato che una conversione mantenga tutte le modalità e le funzioni dell'originale nel tuo runtime.
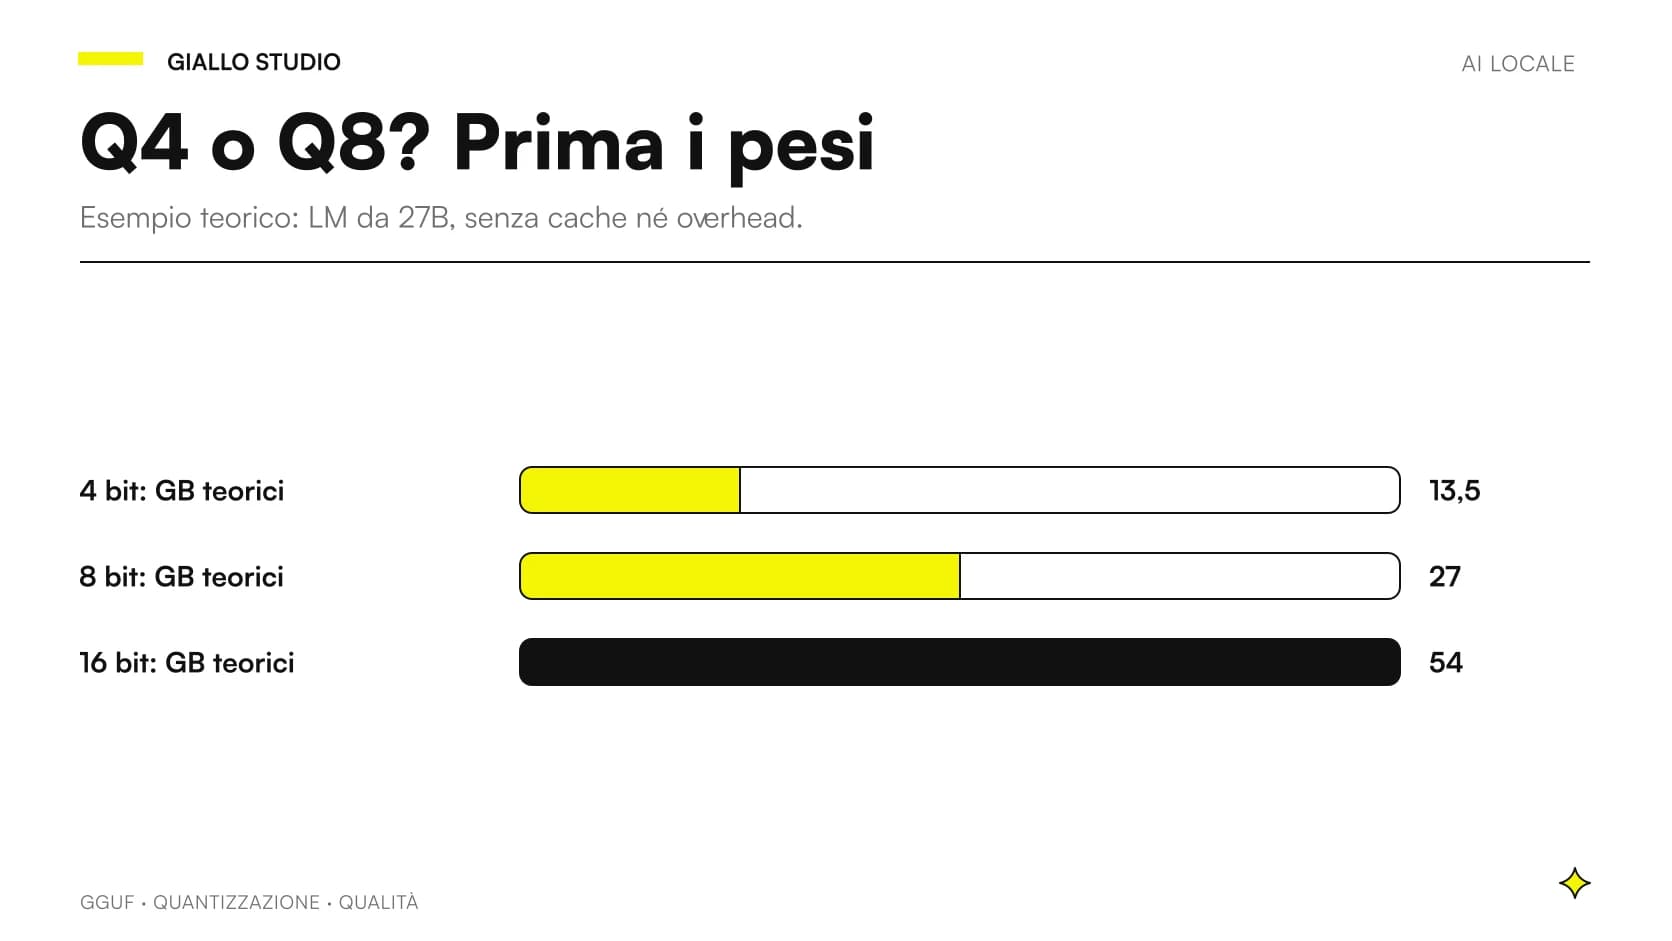
Per il primo confronto, evita di cambiare contemporaneamente precisione, preparazione dei file e prompt. Se la memoria impone una variante più compressa, registra il vincolo e controlla gli errori sui campi delicati. La guida su GGUF, Q4 e Q8 aiuta a capire perché contenitore e precisione sono elementi differenti. Un download più piccolo è utile soltanto se il risultato resta adatto al compito che devi svolgere.
Come provarli sui documenti di un ufficio amministrativo?
Scenario ipotetico: un ufficio vuole confrontare condizioni riportate in ordini, preventivi e allegati. Il compito consiste nel segnalare differenze e riferimenti, non approvare automaticamente il documento. Le capacità visive di entrambi permettono di impostare una prova, ma la fedeltà ai campi deve essere controllata.
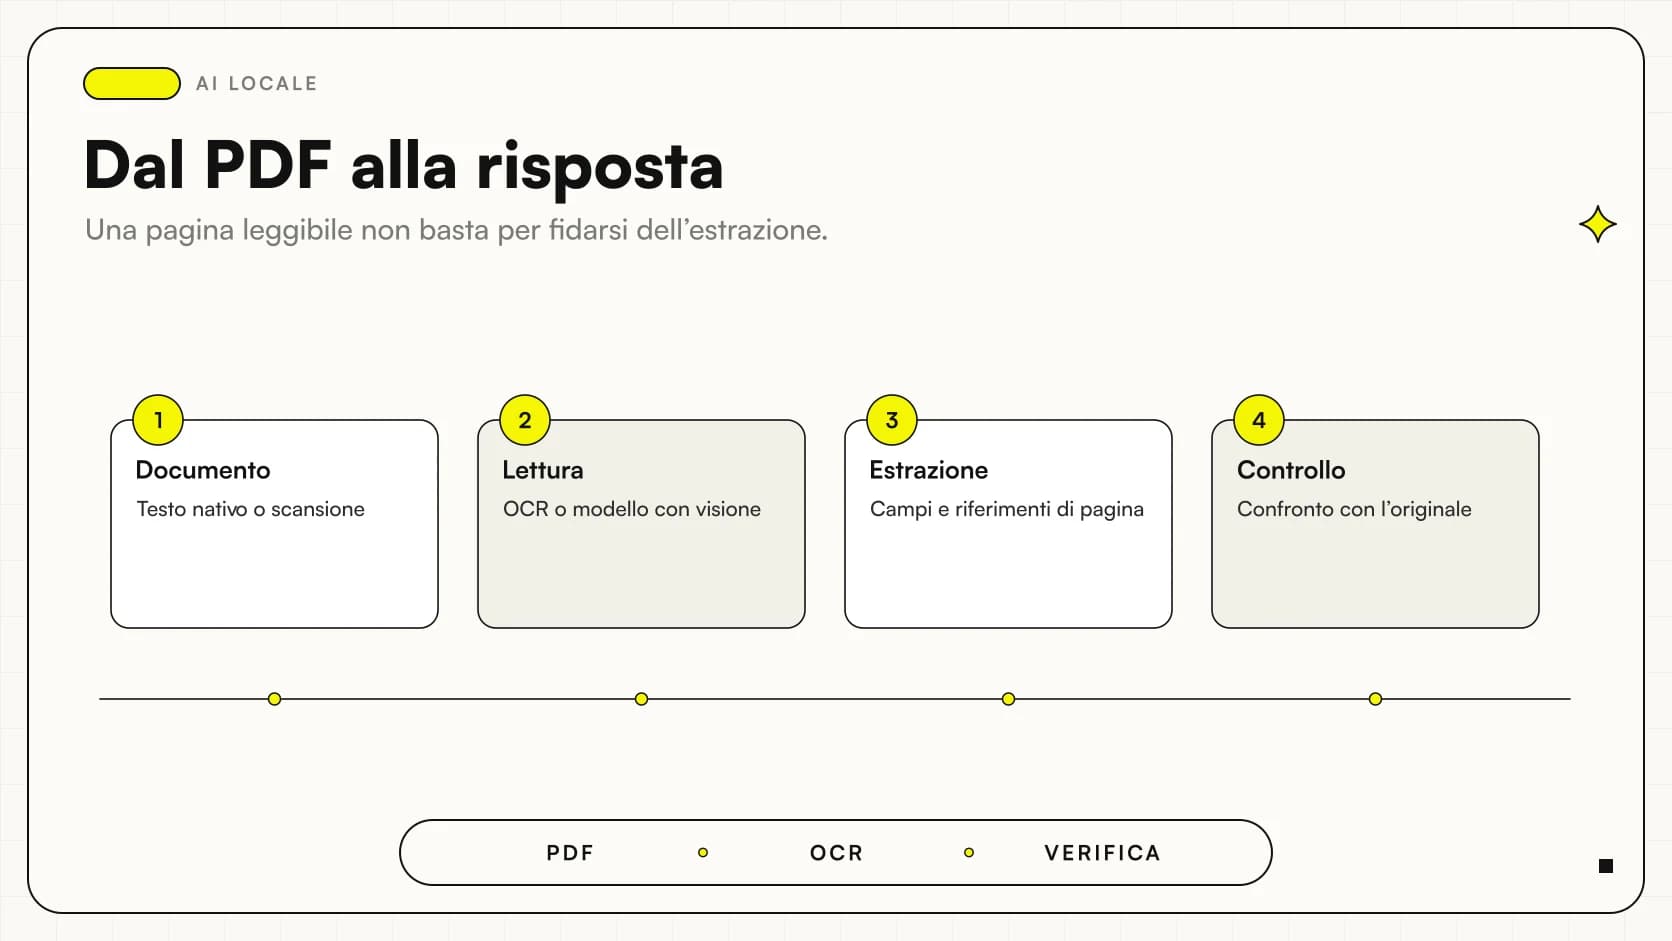
Prepara documenti con date in formati diversi, sconti descritti nel testo ed esclusioni in una nota. Chiedi una tabella con dato, fonte e informazione mancante. Verifica anche se il modello attribuisce al documento una condizione che appartiene a un altro allegato. Se una cella è illeggibile, l'output deve dichiararlo. L'articolo sull'AI multimodale locale per PDF e immagini descrive come preservare il riferimento alla pagina: è quel riferimento a rendere la bozza controllabile dal personale.
Come cambia una prova sulle riunioni interne?
Secondo scenario ipotetico: un team di progetto vuole preparare un riepilogo di una riunione autorizzata, con decisioni, attività assegnate e questioni aperte. Con Gemma provi l'audio diretto se il runtime lo supporta; con Ministral provi una trascrizione preparata da un componente separato. Il campione deve conservare questi percorsi distinti.
Chiedi di non inventare un assegnatario quando l'intervento non è chiaro. Una proposta discussa non deve diventare una decisione approvata e un dubbio non deve sparire dal verbale. Fai controllare l'esito a chi ha partecipato, confrontandolo con il materiale originale. Registra separatamente errori di trascrizione, attribuzione e sintesi. Se serve una voce di risposta, aggiungi un componente dedicato: l'output testuale dichiarato per Gemma non diventa automaticamente sintesi vocale perché il modello riceve audio.
Quali prove distinguono una sintesi utile da una plausibile?
Una sintesi utile conserva ciò che cambia una decisione: condizioni, responsabilità, eccezioni e riferimenti. Prepara quindi casi in cui il testo contiene una negazione, una scadenza corretta nel corso della discussione o un'istruzione sostituita da un allegato. Il risultato atteso deve rendere visibile il cambiamento, senza appiattirlo.
Valuta inoltre ciò che il modello aggiunge. Una frase ragionevole ma non supportata può essere più pericolosa di un dettaglio omesso, soprattutto se viene presentata come accordo del team. Definisci categorie di errore prima di leggere le risposte: fatto inventato, riferimento errato, informazione essenziale mancante, astensione appropriata. Puoi usare la guida ai benchmark degli LLM locali in italiano per organizzare il giudizio. Non serve assegnare una percentuale se non hai chiarito prima che cosa conta come risposta corretta.
Serve il contesto massimo per lavorare bene?
Non necessariamente. Un documento breve ben preparato può essere più utile di un insieme enorme di allegati senza ordine. La finestra da 256K dichiarata dai produttori indica una capacità tecnica, non un obbligo di usarla interamente. Fonti: Google, Mistral.
Per un archivio aziendale, parti dal recupero dei passaggi pertinenti e conserva data, revisione e permessi della fonte. Il RAG locale sui documenti aziendali permette di progettare questo passaggio senza caricare ogni file in tutte le richieste. Per registrazioni lunghe, verifica come vengono suddivisi gli ingressi e se la sintesi mantiene i collegamenti tra parti distanti. Una suddivisione può perdere il riferimento a una correzione pronunciata dopo; il test deve cercare proprio quel tipo di errore.
Come misurare l'esperienza sulla postazione reale?
Osserva l'intero percorso, dall'apertura del file al risultato verificabile. Il tempo di generazione è soltanto una parte: importazione, conversione e caricamento del modello possono cambiare l'attesa percepita. Misura separatamente avvio a freddo e richieste con il modello già in memoria, senza attribuire valori che non hai osservato.
Controlla la postazione mentre sono aperti gli strumenti abituali del lavoro. Se la prova avviene con tutte le applicazioni chiuse ma l'assistente dovrà convivere con browser e gestionale, il risultato potrebbe non rappresentare l'uso previsto. Per una scelta su Apple Silicon leggi LLM locale su Mac con 16, 24 o 32 GB; per una postazione con GPU dedicata, LLM locale su Windows e VRAM. Nessuna di queste condizioni si deduce dal nome del modello.
Valuta anche il modo di correggere un risultato. L'interfaccia dovrebbe permettere di tornare al passaggio originale, indicare che una frase è incerta e conservare la revisione approvata separatamente dalla bozza. Per una riunione, il team può dover rettificare un nome o distinguere una proposta da un incarico assegnato. Se il sistema sovrascrive la fonte o nasconde le correzioni, la qualità del modello non risolve il problema del prodotto. Prima di ampliare l'uso, verifica quindi che una persona possa capire cosa è cambiato e perché. Il pilota deve osservare anche questo lavoro, senza inventare un risparmio di tempo.
Quali errori evitare con audio, privacy e licenze?
Non confondere ingresso audio e voce generata, né capacità della famiglia e modalità della singola variante. Non definire un sistema offline se la trascrizione o l'OCR inviano contenuti a un servizio esterno. Non descrivere una stima di caricamento come memoria sufficiente per qualsiasi richiesta.
Entrambi i checkpoint considerati dichiarano Apache 2.0; controlla i collegamenti alla licenza nelle card di Google e Mistral, oltre alle condizioni dei programmi e dei derivati usati. Per dati e registrazioni, definisci accessi, conservazione e destinazioni prima del pilota. La guida su AI locale e privacy aziendale aiuta a verificare il percorso completo. Il fatto che la generazione avvenga nel computer non dimostra da solo dove finiscano allegati, log e backup.
Quale candidato provare in funzione del processo?
Audio tra gli ingressi richiesti
Valuta Gemma 4 12B nel percorso diretto supportato dal runtime e confrontalo con un sistema testuale completo di trascrizione. Conserva gli errori di ogni passaggio.
Testo e immagini come ingressi sufficienti
Metti Gemma e Ministral sullo stesso campione documentale. Scegli in base a fedeltà delle evidenze, risorse osservate e semplicità di gestione.
Parti con un'attività verificabile e lascia a una persona l'approvazione del risultato. Il modello compatto giusto è quello che soddisfa i controlli essenziali senza rendere fragile la postazione o difficile il controllo delle fonti.
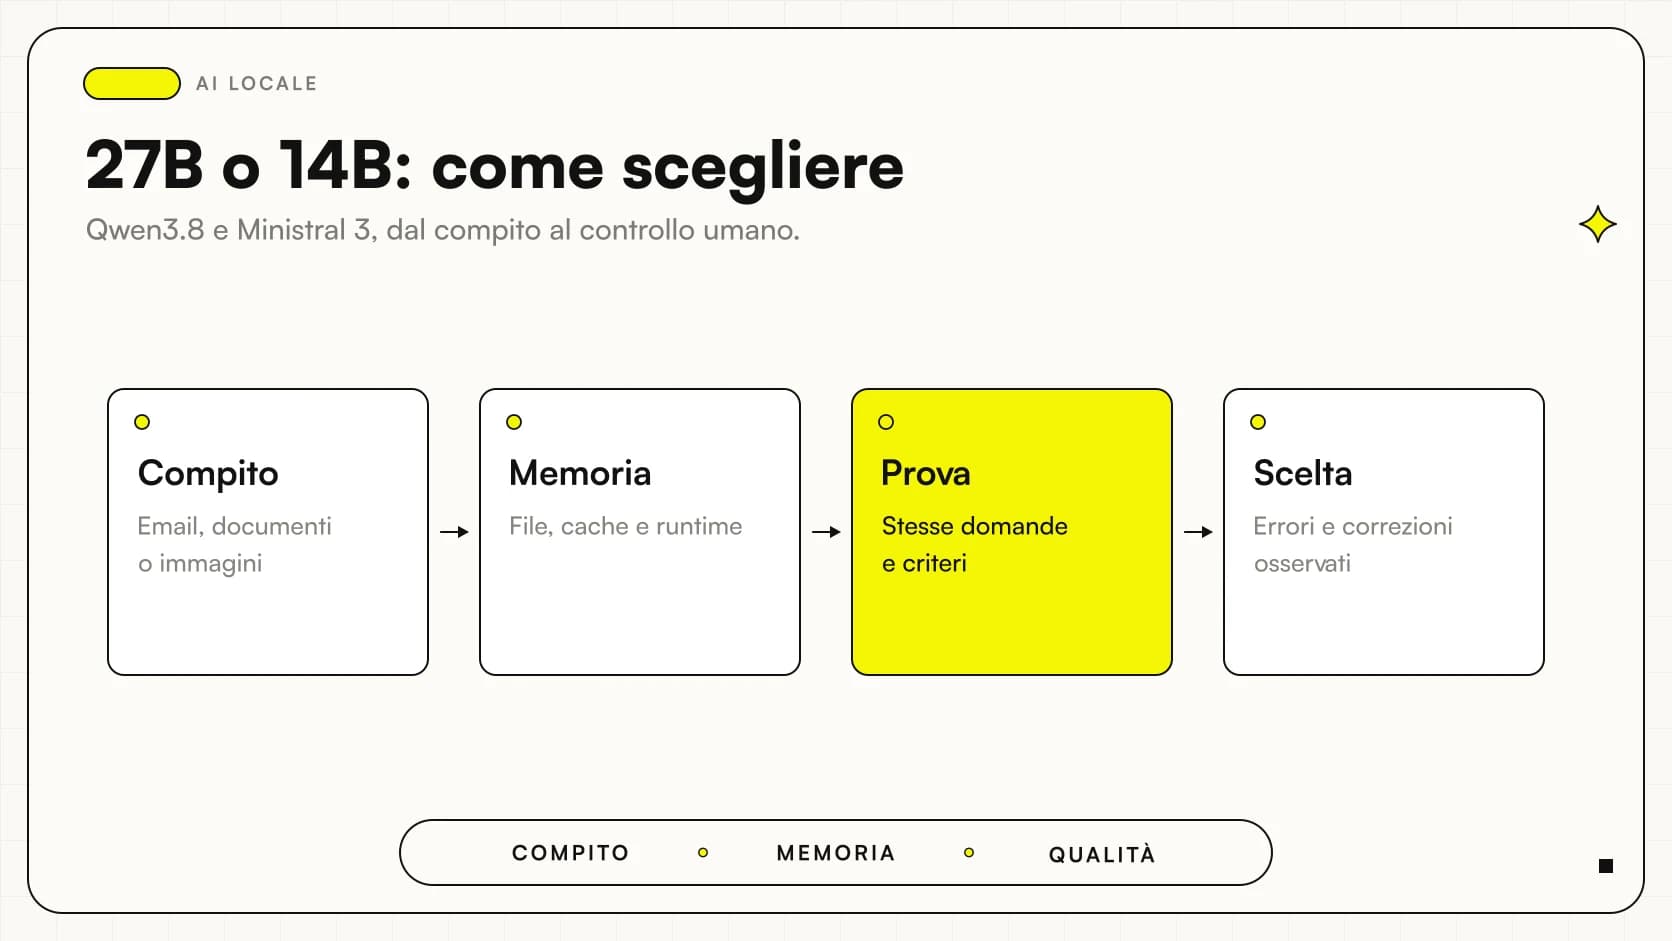
Se serve una taglia maggiore, confronta Qwen3.8-27B e Ministral 3 14B. Per progettare un assistente che colleghi documenti e riunioni al lavoro del team, Giallo Studio offre consulenza AI sul processo, con un pilota che renda espliciti input, risultati attesi e criteri di revisione; in The Lab trovi altri esempi di applicazione.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Gemini vs Copilot: quale scegliere
- GPT-5.6 Sol vs Terra: quale conviene
- ChatGPT vs Gemini: quale abbonamento conviene a ottobre 2026
- GPT-6 Astra vs Claude Fable 5.1
- Gemini 4 Argon vs ChatGPT e Claude: quale scegliere
- GPT-6 Astra vs GPT-5.6 Sol
- Gemini 3.6 Flash vs 3.5 Flash
- GPT-6 Sol vs Claude Opus 5.5: i numeri ufficiali e quando usare quale
- Claude Fable 5.1 vs Sonnet 5
- GPT-6 Sol vs Luna: quale scegliere e per quali lavori
- DeepSeek R1 Distill 32B vs Qwen3.8-27B in locale
- Claude Haiku 4.5 vs Gemini Flash-Lite
FAQ
Gemma 4 12B e Ministral 3 14B leggono entrambi immagini?
Sì, le card ufficiali dichiarano capacità visive per entrambi. La precisione su tabelle, note e scansioni richiede una prova sui documenti effettivi del processo.
Quale dei due comprende audio direttamente?
Gemma 4 12B dichiara audio in ingresso, oltre a testo e immagini. Ministral 3 14B non dichiara audio nativo per il checkpoint considerato e può essere associato a un trascrittore separato.
Gemma 4 12B produce voce?
La model card dichiara output testuale. L’ingresso audio non equivale a sintesi vocale: per una risposta parlata serve un percorso dedicato da verificare.
Quale modello richiede meno RAM?
Le dimensioni nominali non bastano. Confronta formato dei pesi, quantizzazione, contesto, cache e pipeline; le stime dei produttori non hanno necessariamente lo stesso perimetro.
Quale scegliere per una PMI?
Parti dalle modalità necessarie e da un campione verificabile. Per audio diretto considera Gemma; per testo e immagini prova entrambi, misurando errori, risorse e lavoro di revisione.