
RAG locale sui documenti aziendali: come progettarlo
Progettare un RAG locale con documenti aziendali: OCR, embedding, permessi, fonti e aggiornamenti. Criteri per verificare l'intera pipeline.
Un RAG locale sui documenti aziendali cerca passaggi pertinenti in un archivio e li fornisce a un modello eseguito nell'infrastruttura scelta dall'azienda. Per poterlo definire interamente locale, devono esserlo anche estrazione, embedding, ricerca ed eventuali servizi che elaborano i file.
Il risultato utile è una risposta controllabile, collegata alle fonti accessibili all'utente. Il RAG non garantisce correttezza e non sostituisce l'organizzazione dei documenti: un archivio con versioni confuse può produrre risposte sbagliate anche con un ottimo modello. Per la definizione generale trovi la guida a che cos'è il RAG; qui ci concentriamo sulle decisioni necessarie per un sistema aziendale locale.
In sintesi
- Locale deve descrivere tutta la pipeline, non soltanto il modello che risponde.
- Il recupero dei passaggi e la generazione sono due problemi da valutare separatamente.
- I permessi vanno applicati prima di consegnare i documenti al modello.
- Una citazione è utile soltanto se sostiene davvero l'affermazione associata.
- Versioni, aggiornamenti e rimozioni fanno parte del progetto fin dall'inizio.
Quando serve il RAG invece di allegare un documento?
Se lavori occasionalmente su un file breve, allegarlo alla conversazione può essere sufficiente. La documentazione LM Studio distingue l'inserimento del documento nel contesto dal recupero di porzioni pertinenti quando il materiale è più lungo.
Un RAG diventa interessante quando le domande attraversano un archivio, le fonti si aggiornano o persone diverse devono accedere a raccolte differenti. In quel caso il problema non è soltanto «quanto testo entra nel modello», ma come trovare la versione giusta e renderla verificabile.
Non costruire una knowledge base per compensare file mai organizzati. Prima identifica quali documenti rispondono alle domande ricorrenti. Un sottoinsieme affidabile è una base migliore di un'importazione indiscriminata dell'intero disco condiviso.
Scrivi anche quali attività restano fuori. Cercare una regola in una procedura è diverso da approvare una spesa, modificare un ordine o inviare una comunicazione. Un RAG documentale può limitarsi a mostrare informazioni e preparare bozze; eventuali azioni richiedono un progetto aggiuntivo con autorizzazioni e controlli propri. Chiarire il confine rende più semplice valutare il primo rilascio: il successo non dipende da quante funzioni vengono mostrate nella demo, ma dalla capacità di completare il lavoro definito senza introdurre passaggi opachi.
Quali fasi devono restare dentro il perimetro locale?
Il percorso comprende acquisizione, estrazione, suddivisione dei testi, embedding, indicizzazione, ricerca e generazione. A queste fasi possono aggiungersi OCR, reranker, trascrizione, registri e strumenti collegati.
| Fase | Funzione | Verifica da documentare |
|---|---|---|
| Estrazione | Ricava contenuti dal file | Dove vengono elaborati PDF e immagini |
| Embedding | Rappresenta testi e query per la ricerca | Modello, percorso e servizio utilizzato |
| Ricerca | Seleziona passaggi candidati | Filtri, raccolte e versioni interrogate |
| Reranking | Riordina i candidati, se previsto | Modello e dati che riceve |
| Generazione | Produce la risposta | Checkpoint, contesto e istruzioni |
| Conservazione | Mantiene file e conversazioni | Accessi, copie e tempi di conservazione |
La guida alla privacy e alla verifica offline aiuta a controllare i collegamenti esterni. «Il modello gira sul nostro server» non risponde alle altre righe della tabella.
Come preparare PDF, tabelle e documenti scansionati?
Per ogni formato, verifica che il testo ricavato conservi ciò che serve alla ricerca. Intestazioni, colonne e riferimenti possono perdere significato se trattati come una sequenza indistinta di parole.
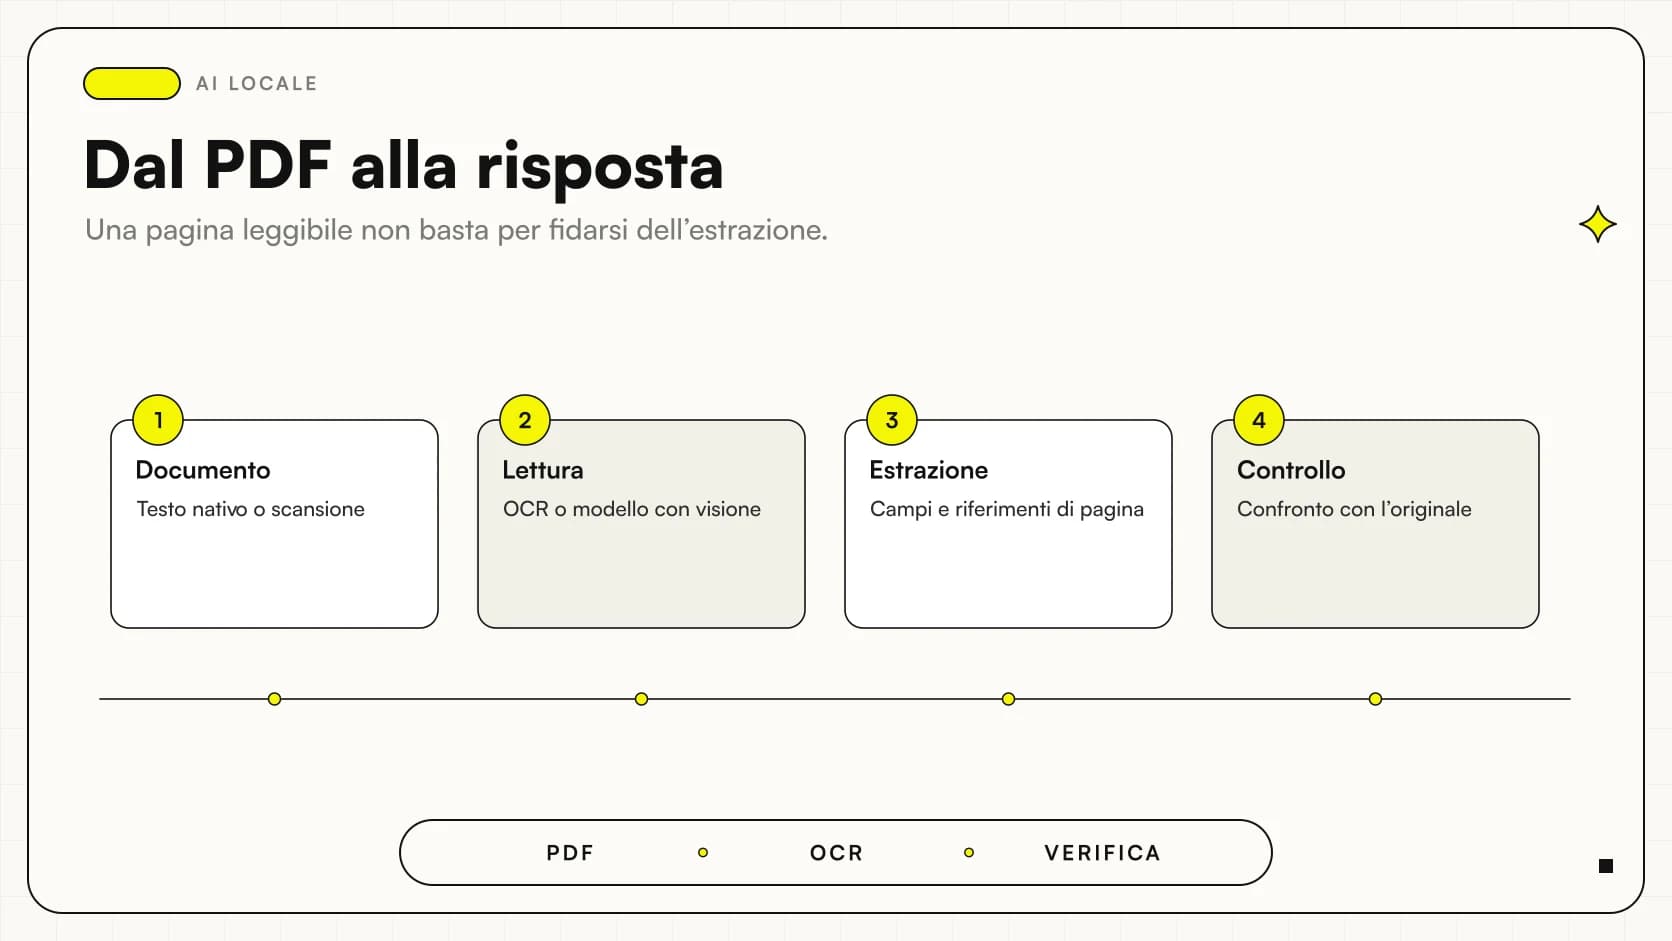
Un documento scansionato richiede un passaggio adeguato: OCR o modello visivo compatibile, secondo la configurazione. La guida all'AI multimodale per PDF e immagini chiarisce perché lettura visiva ed estrazione testuale non siano la stessa cosa.
Prepara esempi problematici prima dell'importazione completa: una tabella su più pagine, un codice simile a un altro, un'eccezione in nota. Conserva il legame tra testo estratto e file di origine. Se non riesci a risalire alla pagina o sezione, il successivo controllo della risposta diventa molto più difficile.
Come dividere i testi senza perdere il significato?
Il chunking suddivide i documenti in unità da cercare e recuperare. Non esiste una lunghezza magica che funzioni per ogni archivio. Una procedura operativa, un listino e un contratto hanno strutture diverse.
Evita di separare una condizione dalla sua eccezione o una riga di tabella dall'intestazione che la spiega. Aggiungi metadati utili: titolo, sezione, versione, data di validità e riferimento alla fonte. La scelta delle unità va valutata sulle domande, non soltanto sulla comodità dell'importazione.
Un controllo semplice è leggere il passaggio recuperato senza aprire il resto del file: contiene abbastanza informazione per rispondere correttamente? Se manca il soggetto o il perimetro della regola, occorre recuperare contesto aggiuntivo o cambiare il modo in cui il documento viene suddiviso.
La stessa attenzione vale per gli allegati. Una procedura può rimandare a un modulo separato o a una tabella che contiene il dato decisivo. Registrare la relazione tra documenti aiuta a ricostruire il contesto senza affidarsi a somiglianze testuali casuali. Durante le prove chiedi esplicitamente informazioni contenute negli allegati e controlla che il sistema distingua il rimando dalla risposta effettiva. Se l'allegato non è disponibile o non è autorizzato, questo limite deve emergere nella risposta invece di essere coperto da una formulazione generica.
Quale modello embedding usare per l'italiano?
Il modello che genera le risposte non è necessariamente quello che produce gli embedding. Questi ultimi rappresentano query e documenti per la ricerca; la documentazione Sentence Transformers descrive questa funzione e le differenze tra i possibili modelli.
Per un archivio italiano, valuta richieste con sinonimi, abbreviazioni aziendali e linguaggio effettivamente usato dalle persone. La semplice etichetta multilingua non prova che il sistema recuperi correttamente una procedura con termini specialistici.
Ollama offre un endpoint dedicato agli embedding. Usarlo localmente è una possibilità tecnica, non la garanzia che qualsiasi modello embedding sia adatto. Controlla anche eventuali troncamenti: se una porzione importante non viene rappresentata, il generatore potrebbe non riceverla mai.
Quando aggiungere ricerca lessicale e reranking?
Una ricerca semantica può aiutare con formulazioni diverse da quelle dei documenti. Per codici, numeri di pratica o sigle esatte, conviene valutare anche la ricerca lessicale. La combinazione va provata sul corpus, senza assumere che una tecnica sostituisca sempre l'altra.
Il reranker valuta più attentamente i candidati già recuperati. La pipeline retrieve and rerank di Sentence Transformers mostra la distinzione tra selezione iniziale e riordino successivo.
Aggiungerlo comporta altra elaborazione e un componente da gestire. Fallo quando le prove mostrano che i documenti giusti compaiono tra i candidati ma non arrivano al modello nella selezione finale. Se il testo non è stato estratto correttamente, un reranker non recupera ciò che nell'indice manca.
Come evitare che un utente legga documenti non autorizzati?
L'autorizzazione deve essere applicata dal sistema prima del recupero o comunque prima che il contenuto venga esposto al modello e all'utente. Non affidarla a una frase nel prompt come «non mostrare informazioni riservate».
La documentazione di Qdrant sulla separazione dei tenant descrive filtri e strategie per isolare insiemi di dati. I permessi Open WebUI riguardano invece le risorse e le funzioni accessibili nell'applicazione. I due livelli devono essere progettati coerentemente.
Verifica anche nomi dei file, anteprime e citazioni: possono rivelare l'esistenza di documenti non autorizzati. Prepara utenti di prova con ruoli differenti e richieste identiche. Il controllo deve riguardare sia la risposta sia ciò che viene recuperato lungo il percorso.
Come rendere le citazioni davvero controllabili?
Una risposta con un link non è automaticamente una risposta fondata. Il riferimento deve portare alla versione usata e il passaggio deve sostenere l'affermazione, non soltanto trattare lo stesso argomento.
Open WebUI documenta citazioni e metadati nel RAG. Qualunque interfaccia scegli, verifica che l'utente riesca a trovare rapidamente il punto rilevante e abbia diritto ad aprirlo.
Il documento esiste, ma la risposta non è presente
Il sistema deve poter dichiarare che nelle fonti disponibili non ha trovato un sostegno sufficiente. Una citazione generica al documento non colma questa mancanza. Nei test inserisci domande plausibili la cui risposta sia deliberatamente assente.
Per le risposte che combinano più fonti, collega ciascuna conclusione ai passaggi pertinenti. Questo permette di individuare dove il modello ha aggiunto un'inferenza che richiede controllo umano.
Un produttore: come distinguere manuali e revisioni?
Consideriamo uno scenario ipotetico: un produttore di macchinari vuole aiutare l'assistenza a consultare manuali. Lo stesso nome commerciale può avere revisioni diverse e istruzioni differenti.
Il RAG dovrebbe cercare nel perimetro del modello e della revisione dichiarati, chiedendo chiarimenti quando mancano. Una risposta corretta per un'altra versione è un errore anche se la citazione conduce a un manuale autentico.
Il campione di prova deve includere procedure quasi identiche con una differenza importante. Se il recupero privilegia il documento più lungo o più recente senza controllare la compatibilità, cambiare soltanto LLM non risolve il difetto. Prima va sistemata la relazione tra macchina, manuale e metadati.
La decisione di autorizzare l'uso operativo spetta al processo aziendale: l'assistente può preparare informazioni, mentre responsabilità e verifiche sulle istruzioni restano definite.
Una società di consulenza: come cercare nelle procedure interne?
In un secondo esempio ipotetico, una società vuole rispondere alle domande sulle procedure di rendicontazione. Alcuni documenti valgono per tutti, altri per una divisione o un periodo contrattuale.
Prima di indicizzare, il responsabile identifica la fonte vigente e il pubblico autorizzato. Le domande di prova includono richieste formulate con il linguaggio dei colleghi, non soltanto il titolo esatto dei documenti.
Un risultato utile contiene la regola applicabile, l'eventuale eccezione e il collegamento alla procedura corretta. Se la fonte non basta, il sistema deve indicare a quale referente rivolgersi invece di inventare una politica aziendale.
Questo progetto ha un valore verificabile anche senza promettere percentuali di tempo risparmiato: meno passaggi inutili nella ricerca e maggiore facilità nel controllare quale regola si sta applicando.
Come gestire aggiornamenti e rimozioni dall'archivio?
Il progetto deve riconoscere quando un file viene sostituito, cambia autorizzazione o non deve più essere utilizzato. La sola aggiunta di nuovi documenti può lasciare nell'indice passaggi superati che continuano a comparire nelle risposte.
Conserva un identificativo stabile del documento e una versione. Quando aggiorni il contenuto, verifica testo, embedding, metadati e riferimenti. Se cambi modello embedding, controlla che indice e query restino coerenti: non trattare rappresentazioni differenti come se fossero automaticamente comparabili.
Inserisci nella procedura una domanda che in precedenza recuperava il documento vecchio. Ripeterla dopo l'aggiornamento permette di verificare l'effetto sull'utente finale. Considera anche conversazioni salvate e copie: una rimozione dall'indice non equivale alla scomparsa del dato da ogni archivio del sistema.
Quali prove separano un errore di ricerca da uno del modello?
Mantieni due valutazioni. Nella prima controlli se il recupero trova le fonti attese e rispetta i permessi. Nella seconda consegni al generatore i passaggi corretti e verifichi come li utilizza.
Se il documento giusto non viene recuperato, indaga estrazione, suddivisione, ricerca e filtri. Se arriva nel contesto ma la risposta lo contraddice, valuta prompt, modello e formato della richiesta. Il protocollo di benchmark locale in italiano aiuta a documentare questa distinzione.
Aggiungi prove di assenza della risposta, versioni obsolete e tentativi di ottenere materiale fuori dal proprio ruolo. La qualità media non deve nascondere una violazione di accesso. Le soglie di accettazione vanno definite in funzione delle conseguenze dell'errore.
Conserva per ogni errore la domanda, le fonti recuperate, la configurazione e la correzione attesa. Questo rende la manutenzione concreta: dopo una modifica puoi ripetere i casi già falliti e verificare che il miglioramento non abbia compromesso altro. Evita invece un archivio indiscriminato di conversazioni reali con dati riservati soltanto per comodità di sviluppo. Il materiale di valutazione va selezionato e gestito con gli stessi criteri di accesso e conservazione previsti per il servizio.
Come passare dalla demo a un servizio utile?
Parti da una raccolta con proprietario, documenti affidabili e domande ricorrenti. Definisci chi aggiorna le fonti, chi controlla gli errori e come si segnala una risposta sbagliata. Soltanto dopo amplia il perimetro.
Scegli il generatore tra i modelli locali compatibili con il lavoro, valutando anche hardware e manutenzione. La modalità offline di Open WebUI ricorda che modelli e dipendenze devono essere preparati prima dell'isolamento: una casella nelle impostazioni non sostituisce una prova completa.
Per collegare permessi, documenti e strumenti esistenti, Giallo Studio progetta software AI su misura. Il primo risultato da costruire è un percorso controllabile dalla domanda alla fonte, con limiti chiari e responsabilità operative definite.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 AI locale vs cloud: come confrontare i costi in azienda
 Ollama vs LM Studio: come scegliere per l'AI locale
 AI multimodale locale: leggere PDF e immagini aziendali
 AI locale e privacy: come verificare che resti offline
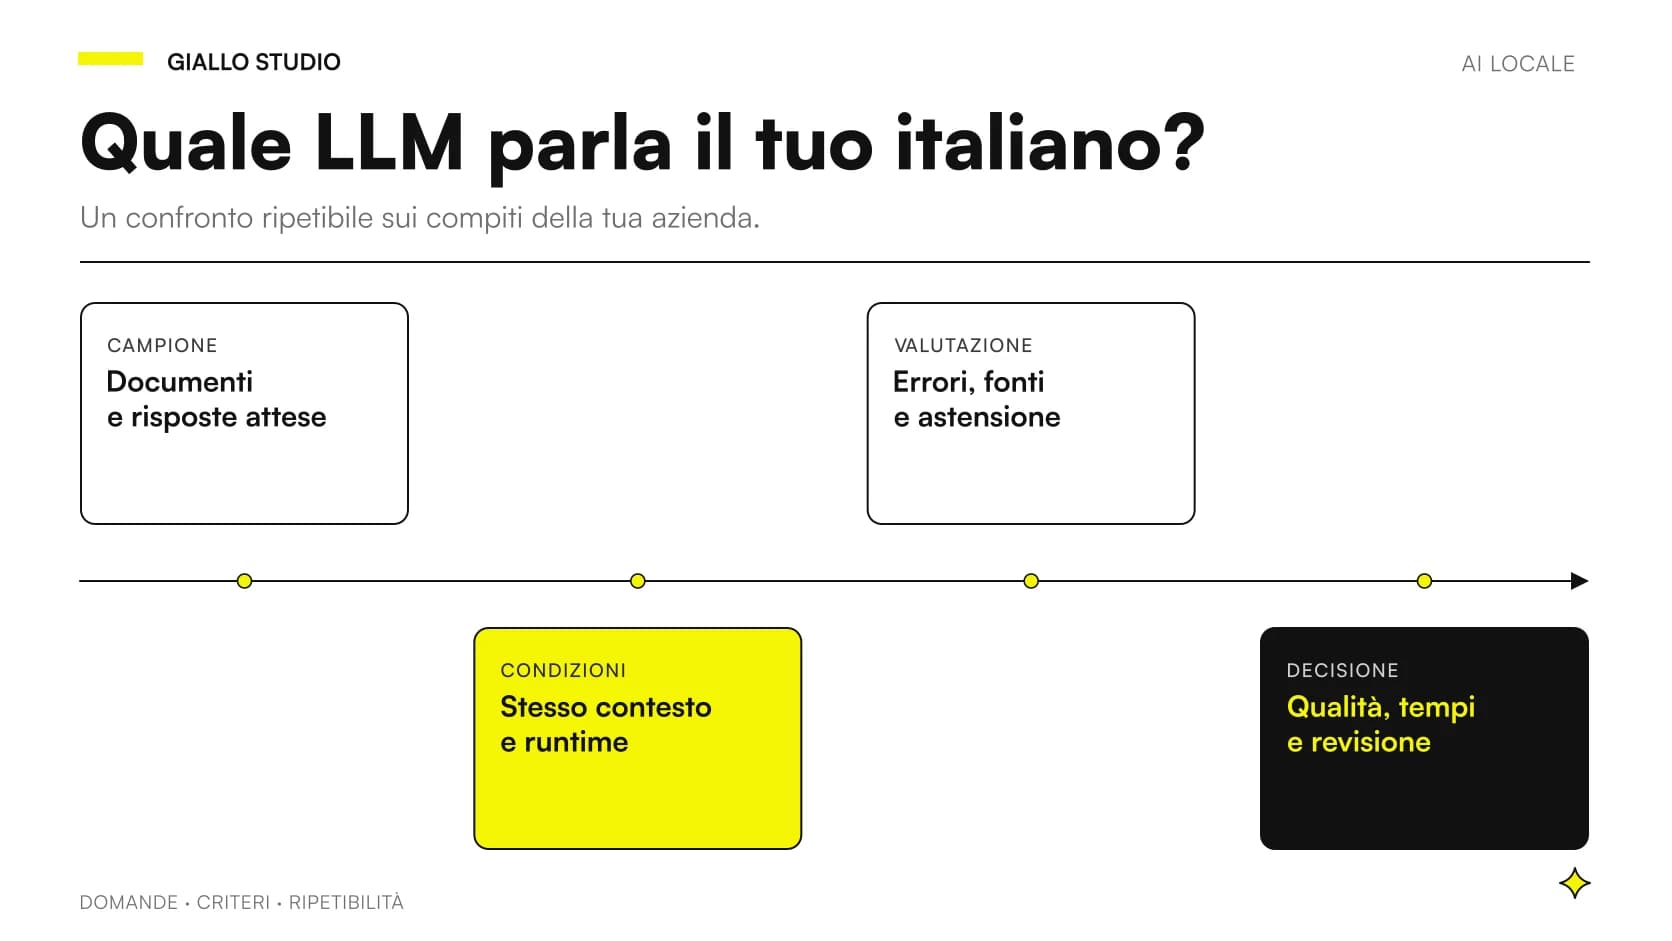 LLM locali in italiano: come confrontarli senza falsi test
 Qwen3.8-27B in locale: capacità, limiti e requisiti
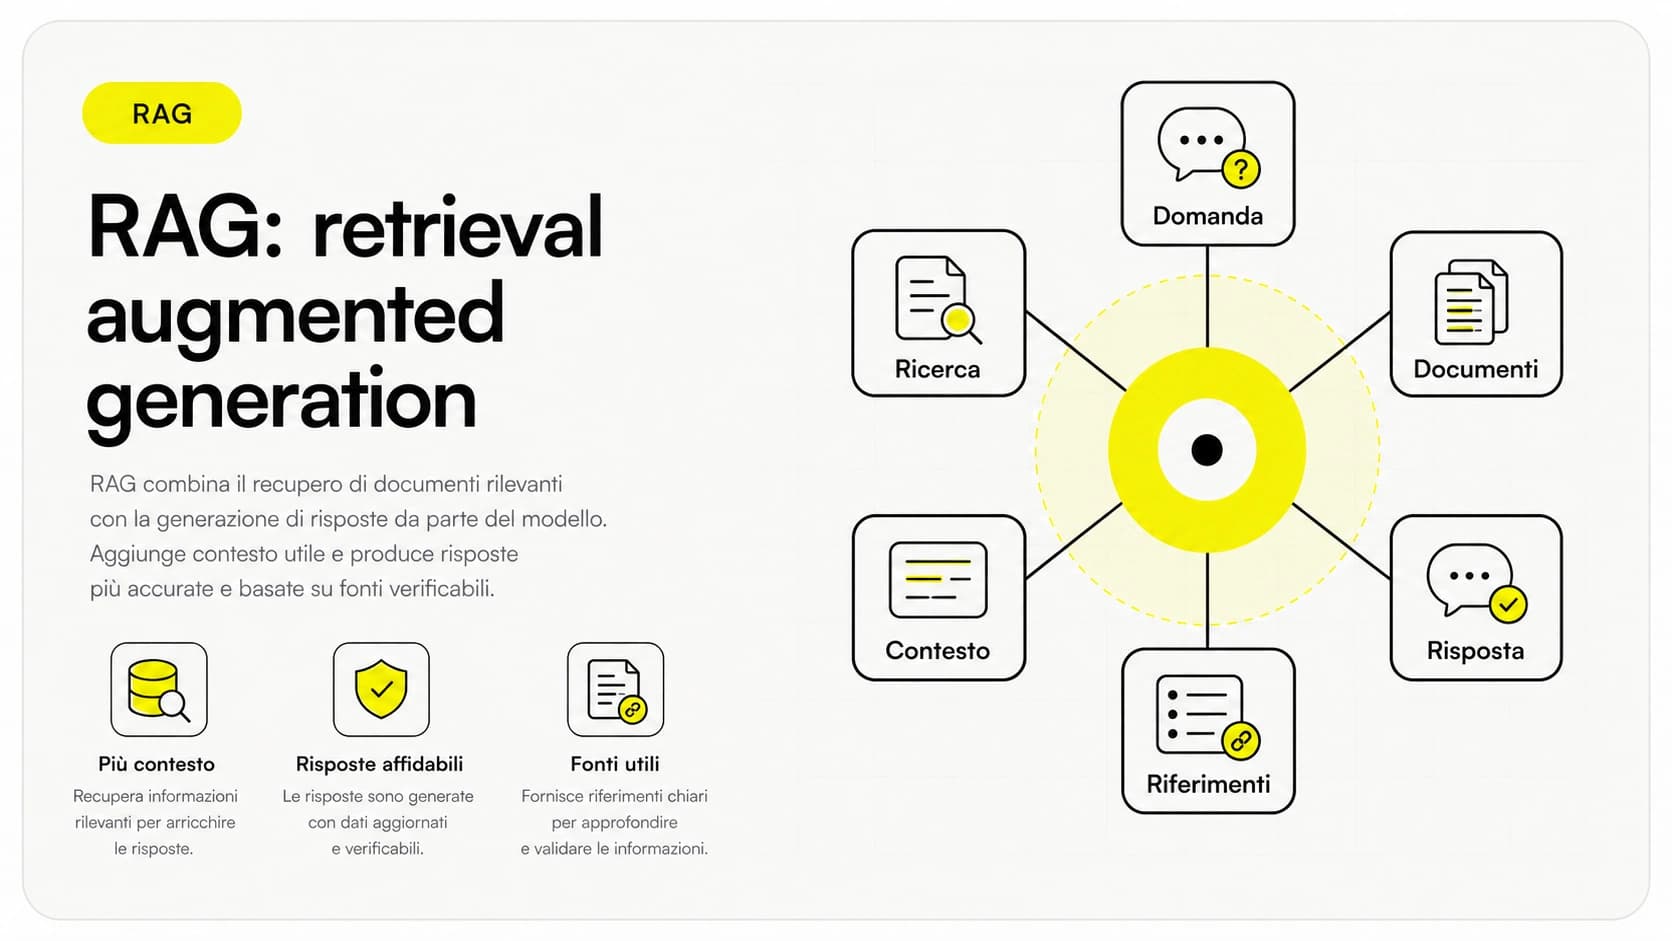 RAG: cos'è e perché migliora le risposte AI
FAQ
Che cosa rende locale un RAG?
Devono restare nel perimetro previsto tutte le fasi: estrazione dei documenti, embedding, ricerca, eventuale reranking e generazione. Un LLM locale collegato a OCR o embedding esterni non rende locale l'intero flusso.
Il RAG elimina le allucinazioni?
No. Può fornire al modello passaggi pertinenti, ma la ricerca può sbagliare e la risposta può interpretarli male. Servono verifiche su recupero, citazioni e capacità di dichiarare che la risposta manca.
Posso usare il RAG con PDF scansionati?
Sì, se il sistema include un percorso di estrazione adatto, come OCR o elaborazione visiva compatibile. Va verificata la correttezza del testo estratto, soprattutto per tabelle, codici e riferimenti.
Basta dire al modello di non mostrare documenti riservati?
No. I permessi devono essere applicati dal sistema prima che i passaggi entrino nel contesto del modello. Il prompt non è un controllo di autorizzazione.
Come aggiorno i documenti indicizzati?
Serve una procedura che riconosca versioni, sostituzioni e rimozioni, aggiornando indice e metadati. Poi bisogna verificare che le domande restituiscano la fonte vigente e rispettino gli accessi aggiornati.