
GPT-6 Sol vs Claude Opus 5.5: i numeri ufficiali e quando usare quale
GPT-6 Sol vs Claude Opus 5.5, usciti lo stesso giorno: i benchmark pubblicati da OpenAI e Anthropic, perché non si confrontano 1:1, prezzi e casi d'uso.
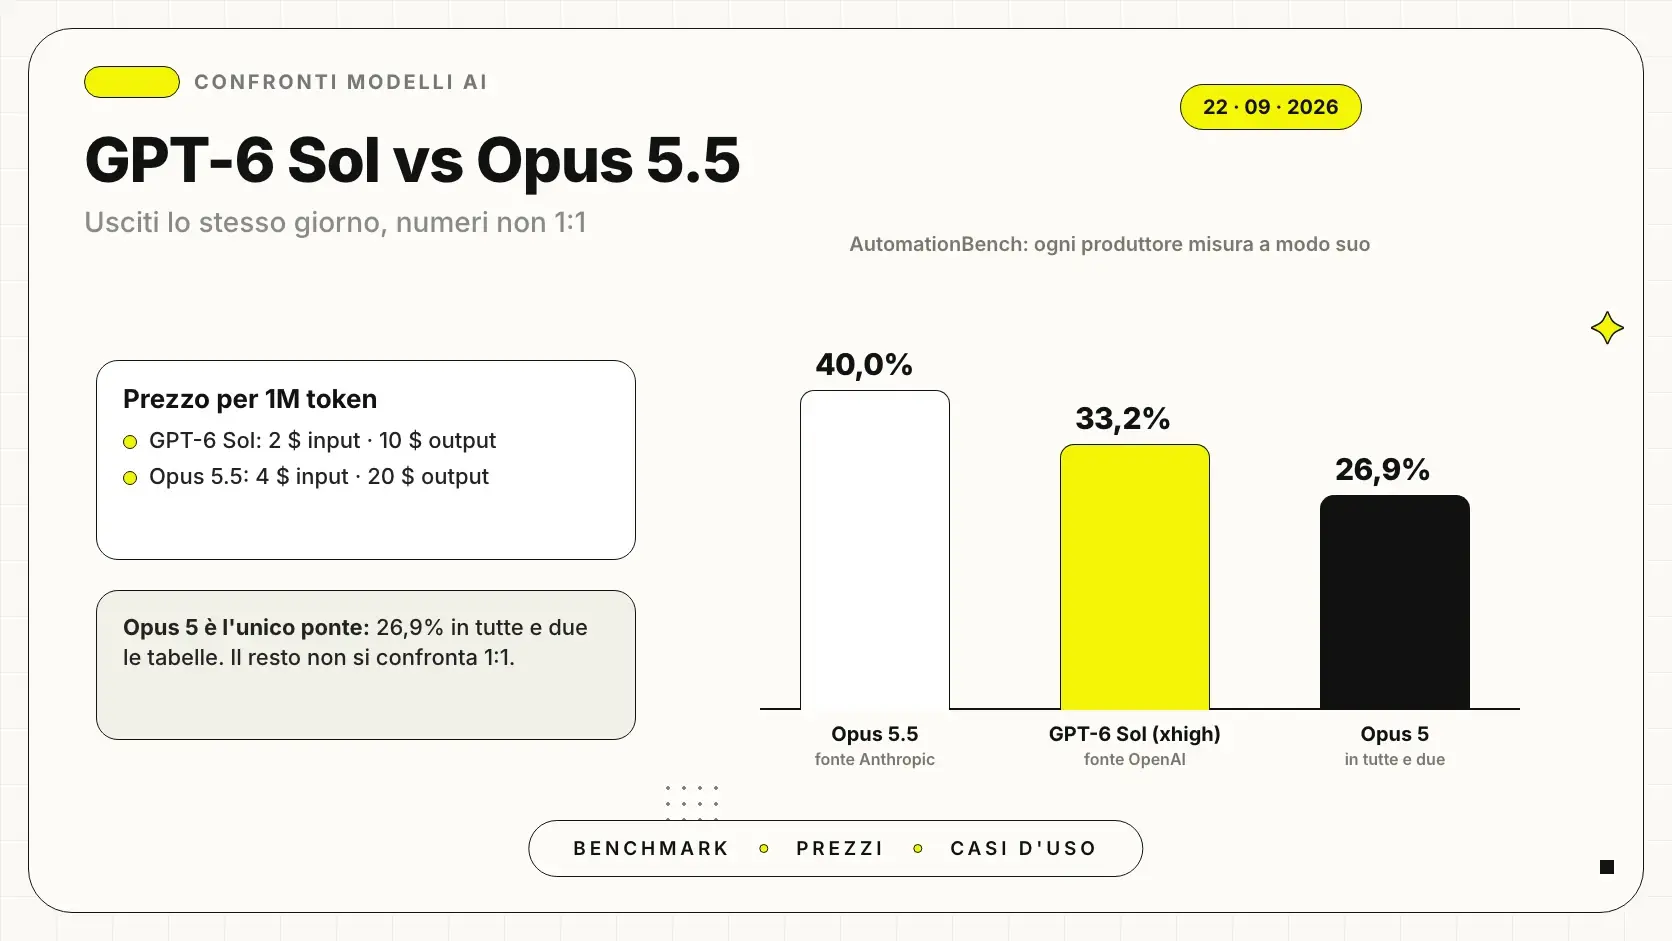
GPT-6 Sol e Claude Opus 5.5 sono usciti lo stesso giorno, il 22 settembre 2026, e proprio per questo nessuno dei due produttori li ha messi a confronto. OpenAI misura Sol contro Claude Opus 5, Anthropic misura Opus 5.5 contro GPT-6 Astra e GPT-5.6 Sol. La risposta onesta a "quale è meglio" è che con i dati ufficiali non si può stabilire: si può mettere accanto quello che ciascuno ha pubblicato e capire dove i numeri si parlano e dove no.
Il quadro pratico, per una PMI, è questo. Sol costa la metà per token, 2 $ e 10 $ contro 4 $ e 20 $ per milione, e lavora dentro ChatGPT e Codex. Opus 5.5 ha il numero più alto sull'unico test con un riferimento comune alle due tabelle, AutomationBench, e tiene lo stesso prezzo fino a 1 milione di token di contesto. Dati verificati il 23 settembre 2026 sulle pagine di lancio di OpenAI e di Anthropic: prima di decidere ricontrolla sempre le pagine ufficiali.
In sintesi
- Non esiste un confronto ufficiale diretto: OpenAI si misura con Claude Opus 5, Anthropic con GPT-6 Astra e GPT-5.6 Sol.
- Solo tre test hanno lo stesso nome nelle due tabelle, AutomationBench, OSWorld 2.0 e FrontierCode, e su nessuno il confronto è 1:1.
- Su AutomationBench Opus 5.5 segna 40,0 e Sol 33,2, con Claude Opus 5 fermo a 26,9 in entrambe le tabelle: è il dato più solido che c'è.
- Sol costa la metà per token, ma sopra i 272.000 token di input la distanza quasi sparisce.
- Opus 5.5 ragiona sempre, Sol accetta anche il livello none.
- Niente vincitore assoluto: il verdetto cambia con il lavoro da fare.
I numeri pubblicati, uno accanto all'altro
La tabella riporta solo valori scritti nelle due pagine di lancio, ciascuno con le condizioni dichiarate dal produttore. Dove una casella dice "non pubblicato", quel produttore il test non l'ha proprio riportato: non significa zero.
| Test | GPT-6 Sol, dato OpenAI | Claude Opus 5.5, dato Anthropic | Condizioni dichiarate |
|---|---|---|---|
| AutomationBench | 33,2% | 40,0% | Sol a sforzo xhigh, versione 1.0.6. Opus 5.5 misurato da Zapier senza modelli di riserva |
| OSWorld 2.0 | 60,5% | 81,8% | Sol: set offline, punteggio parziale, release v2026.08.08. Opus 5.5: punteggio parziale |
| FrontierCode v1.1 Main | nessun numero | 54,4% | per Sol solo "pari a Claude Fable 5.1 xhigh" |
| DeepSWE v1.1 | 68,8% | non pubblicato | Sol a sforzo max |
| Agents' Last Exam V1 | 56,4% | non pubblicato | Sol a sforzo max |
| Terminal-Bench 4.0 | non pubblicato | 66,4% | Opus 5.5 a sforzo xhigh, errore standard di 2,6 punti |
| CursorBench 4.0 | non pubblicato | 57,8% | compiti ambigui su più file |
| GDPval-AA v2.1 | non pubblicato | 1846 Elo | lavoro professionale in 44 mestieri |
| Humanity's Last Exam | non pubblicato | 67,7% | con strumenti |
| Terminal-Bench-Science 0.1 | non pubblicato | 58,7% | ricerca scientifica da terminale |
| Chartography | non pubblicato | 89,0% | lettura di grafici, con strumenti |
| Fonte | annuncio OpenAI | annuncio Anthropic | lette il 23 settembre 2026 |
Undici righe, e solo tre con lo stesso nome dalle due parti. È già una prima risposta: i due produttori hanno scelto test quasi del tutto diversi per raccontare il proprio modello. Per leggere tabelle come questa c'è una guida in come si leggono i benchmark AI.
Perché questi numeri non si confrontano 1:1
Sono usciti lo stesso giorno
OpenAI ha misurato Sol contro Claude Opus 5 e Claude Fable 5.1, usando Fable 5 dove mancava il dato, con punteggi dei concorrenti presi da report pubblici. Anthropic ha messo Opus 5.5 accanto a GPT-6 Astra e al vecchio GPT-5.6 Sol. I due modelli nuovi non compaiono mai nella stessa tabella.
Stesso nome, prova diversa: il caso OSWorld 2.0
OpenAI dichiara di riportare il punteggio parziale sul set offline della release v2026.08.08. Anthropic scrive soltanto "partial". Che non sia la stessa misura lo dimostra un modello presente in tutte e due le tabelle: per OpenAI Claude Opus 5 a sforzo medium fa 60,3%, per Anthropic lo stesso Opus 5 fa 74,0%. Tra versione del test e livello di sforzo ballano quasi 14 punti: l'81,8 di Opus 5.5 e il 60,5 di Sol stanno su due scale diverse.
Lo sforzo: scritto da una parte, sottinteso dall'altra
OpenAI mette il livello di ragionamento accanto a ogni numero. Anthropic usa una regola generale, sforzo massimo per Opus 5.5 salvo diversa indicazione, ma per AutomationBench rimanda alla prova di Zapier senza dire con quale sforzo è stata fatta. Quanto conti lo mostra Anthropic stessa: su CursorBench Opus 5.5 fa 52,5% allo sforzo predefinito e 57,8% al massimo, cinque punti di differenza senza cambiare modello. Il tema è approfondito in reasoning effort: cosa cambia nei confronti.
FrontierCode: il numero di Sol non c'è
Per Sol OpenAI scrive solo che eguaglia Claude Fable 5.1 a sforzo xhigh, a un costo molto più basso. Nella tabella di Anthropic Fable 5.1 vale 50,3, ma ricavare da lì un punteggio per Sol vuol dire saltare tra due tabelle con condizioni diverse. Il dato, semplicemente, non esiste.
L'unico ponte tra le due tabelle: Claude Opus 5 su AutomationBench
C'è una riga in cui le due tabelle si parlano. Su AutomationBench, il test di Zapier sui flussi di lavoro tra app diverse, Claude Opus 5 vale 26,9% sia nella tabella di OpenAI, dove è indicato a sforzo max, sia in quella di Anthropic. Con un riferimento comune i due numeri nuovi si possono almeno mettere in fila: Opus 5.5 a 40,0, Sol a 33,2 con sforzo xhigh.
Resta un confronto indicativo. Anthropic non indica versione del test e sforzo della prova di Zapier, e precisa che è stata fatta senza modelli di riserva: ogni intervento delle protezioni conta come fallimento, e secondo Anthropic questo abbassa il punteggio rispetto all'uso reale. OpenAI invece dichiara per Sol un costo di 0,27 $ per attività, mentre Anthropic per questa riga non scrive un costo per attività.
Anche su questa riga lo sforzo pesa. GPT-6 Astra compare con 30,3% a sforzo low nella tabella di OpenAI e con 41,4% in quella di Anthropic, presa dalla classifica pubblica di Zapier: undici punti per lo stesso modello. Il confronto tra Astra e Opus 5 lo avevamo fatto in Claude Opus 5 vs GPT-6 Astra.
Le note in piccolo delle due pagine di lancio
Anthropic: Opus 5.5 è stato valutato con le protezioni di produzione attive. Quando sono intervenute, i compiti di cybersecurity sono stati completati da Claude Opus 4.8, quelli di biologia e di sviluppo di modelli AI da Claude Opus 5: secondo Anthropic questo probabilmente abbassa i punteggi di Opus 5.5.
OpenAI: i modelli GPT sono stati valutati nell'ambiente di ricerca o via API, che possono dare risposte leggermente diverse da ChatGPT. Il dato di Claude Fable 5.1 su AutomationBench non include il costo del modello di riserva, usato in circa quattro attività su dieci.
Prezzi e contesto: dove Sol costa la metà e dove no
| Voce | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, per milione di token | 2 $ | 4 $ |
| Output, per milione di token | 10 $ | 20 $ |
| Lettura dalla cache | 0,20 $ | 0,20 $ |
| Scrittura in cache | 2,50 $ | 5 $ per 5 minuti, 8 $ per un'ora |
| Oltre 272.000 token di input | 4 $ in, 15 $ out, cache a 0,40 $ | nessun rincaro fino a 1 milione |
| Batch, input e output | 1 $ e 5 $ | 2 $ e 10 $ |
| Modalità veloce | 4 $ e 20 $ | 8 $ e 40 $, fino a 2,5 volte più veloce |
| Finestra di contesto e output massimo | 1.050.000 e 128.000 token | 1 milione e 128K token |
| Data limite della conoscenza | 20 aprile 2026 | giugno 2026 |
| Livelli di ragionamento | sei, da none a max; predefinito medium | cinque, da low a max, ragionamento sempre attivo; predefinito medium |
| Fonte | listino e scheda OpenAI | listino e panoramica modelli Anthropic |
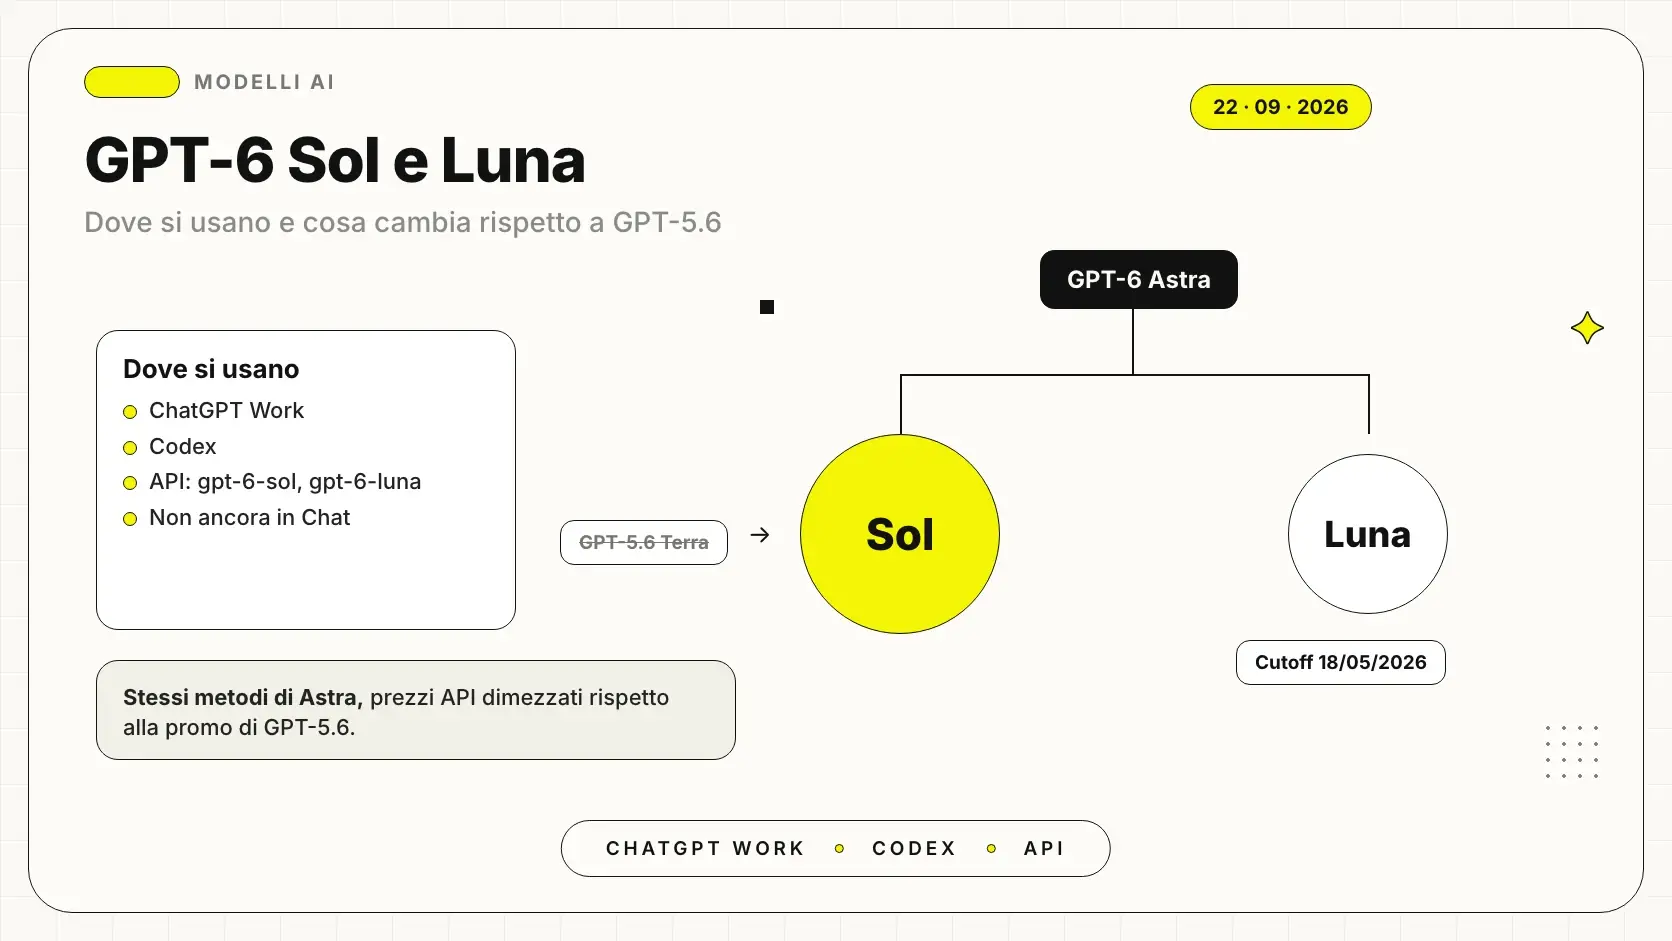
Il "metà prezzo" vale per le richieste normali. Sopra i 272.000 token di input OpenAI fa pagare tutta la richiesta il doppio in ingresso e una volta e mezza in uscita, mentre Anthropic applica a Opus 5.5 lo stesso listino su tutta la finestra da 1 milione. In quella fascia l'input costa uguale, 4 $ contro 4 $, l'output di Sol resta più basso, 15 $ contro 20 $, e la cache di Opus 5.5 costa la metà. Il listino completo di Sol, con Flex e le altre modalità, è nella guida ai prezzi di GPT-6 Sol e Luna.
| Esempio, prezzi Standard | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Richiesta normale: 50.000 token in ingresso, 5.000 in uscita | 0,15 $ | 0,30 $ |
| Documento lungo: 400.000 in ingresso, 10.000 in uscita | 1,75 $ | 1,80 $ |
| Seconda domanda sullo stesso documento: 380.000 letti dalla cache, 20.000 nuovi, 10.000 in uscita | 0,38 $ | 0,36 $ |
Gli esempi sono costruiti per mostrare l'andamento, con token ipotizzati e senza contare la prima scrittura in cache. Il ragionamento si paga in entrambi i casi come output, per OpenAI come per Anthropic: il conto vero dipende da quanto ragiona il modello sui tuoi compiti. Su come cambia la gestione di contesti così grandi c'è finestra di contesto: quanto conta davvero.
Un dettaglio operativo pesa sugli agenti che alternano passaggi semplici e difficili. OpenAI dichiara che su GPT-6 cambiare lo sforzo tra una chiamata e l'altra non rompe più la cache. Nella documentazione di Anthropic un esempio con Opus 5.5 mostra che, con il punto di cache nei messaggi, passare da sforzo medium a low fa ripartire la cache da zero. Chi progetta l'agente deve saperlo prima di scegliere.
Quale provare per primo, lavoro per lavoro
| Lavoro | Prova prima | Il dato pubblicato che lo suggerisce |
|---|---|---|
| Automazioni tra CRM, gestionale, posta e fatturazione | Claude Opus 5.5 | AutomationBench, l'unica riga con un riferimento comune |
| Sviluppo e revisione del codice dentro ChatGPT o Codex | GPT-6 Sol | metà prezzo per token, DeepSWE v1.1 dichiarato da OpenAI |
| Sessioni di codice da terminale in Claude Code | Claude Opus 5.5 | Terminal-Bench 4.0 e CursorBench dichiarati da Anthropic, nessun dato per Sol |
| Contratti, bandi e capitolati oltre 272.000 token | Claude Opus 5.5 | listino fisso fino a 1 milione, cache più economica nel contesto lungo |
| Report e analisi per la direzione | tutti e due | GDPval-AA per Opus 5.5, Agents' Last Exam e valutazione sui fatti per Sol |
| Agenti con molti passaggi semplici | GPT-6 Sol | livello none disponibile, cache che resiste ai cambi di sforzo |
| Agenti che usano il computer come una persona | tutti e due | OSWorld misurato in modo diverso; per OpenAI il migliore qui resta GPT-6 Astra |
Un e-commerce di ricambi che collega ordini, magazzino e corriere. Pensa a un negozio online dove ogni ordine deve aggiornare le giacenze, generare l'etichetta di spedizione e avvisare il cliente. È il territorio di AutomationBench, e il dato pubblicato suggerisce di partire da Opus 5.5. Ma Sol costa la metà per token: la prova giusta sono trenta ordini reali, stesso sforzo per entrambi, contando quante attività arrivano in fondo senza intervento umano e quanto costa ciascuna.
Uno studio tecnico che legge capitolati con decine di allegati. Qui molte richieste superano i 272.000 token, e la differenza di prezzo quasi sparisce. Conviene scegliere sulla qualità della lettura: quante incongruenze tra capitolato e allegati trova ciascun modello su tre gare già chiuse, di cui conosci le risposte giuste. Sul rischio di dati inventati i due produttori dichiarano cose diverse: nel test interno di Anthropic 16 report su 18 di Opus 5.5 hanno superato una verifica in cui un solo numero inventato bastava a bocciarli, mentre OpenAI dichiara per Sol circa la metà degli errori fattuali di GPT-5.6 Sol.
Quattro letture sbagliate che girano in questi giorni
- "Su OSWorld Opus 5.5 stacca Sol di 21 punti." I due numeri vengono da versioni e condizioni diverse: lo stesso Opus 5 cambia di quasi 14 punti tra una tabella e l'altra.
- "GPT-6 Sol fa 37,3 su Terminal-Bench." Quel valore nella tabella di Anthropic è di GPT-5.6 Sol, il modello precedente.
- "Su FrontierCode Sol vale quanto Fable 5.1, quindi circa 50." È un numero ricavato incrociando due tabelle diverse: OpenAI non lo ha pubblicato.
- "Sol costa sempre la metà." Solo sotto i 272.000 token di input. Sopra, l'input costa uguale, l'output di Sol resta più economico e la cache di Opus 5.5 costa la metà.
Il verdetto, caso per caso
Non c'è un vincitore unico, e chi lo annuncia sta confrontando numeri che i produttori stessi non hanno messo sulla stessa scala. C'è invece una mappa: Sol dove contano il prezzo per token, i volumi di codice e l'ecosistema ChatGPT e Codex; Opus 5.5 dove contano i flussi tra più app e i documenti molto lunghi. Per tutto il resto, la prova sui tuoi casi decide più di qualunque tabella. Il perché dei limiti di questi confronti è raccontato in perché i benchmark dei vendor non sono comparabili.
Se ti manca il quadro di partenza, i due modelli OpenAI sono spiegati in cosa sono GPT-6 Sol e Luna, cosa cambia con Opus 5.5 in Claude Opus 5.5: cos'è e a chi conviene, la sua tabella completa con Fable 5.1 e GPT-6 Astra in benchmark e prezzi di Claude Opus 5.5, e la scelta dentro la famiglia OpenAI in GPT-6 Sol vs Luna. Quando l'agente che hai in mente deve scegliere tra i due, possiamo impostare con te la prova sugli stessi compiti e leggere insieme il costo per attività finita: si parte da agenti AI su misura.
Come lo applichiamo in azienda
Risorse correlate
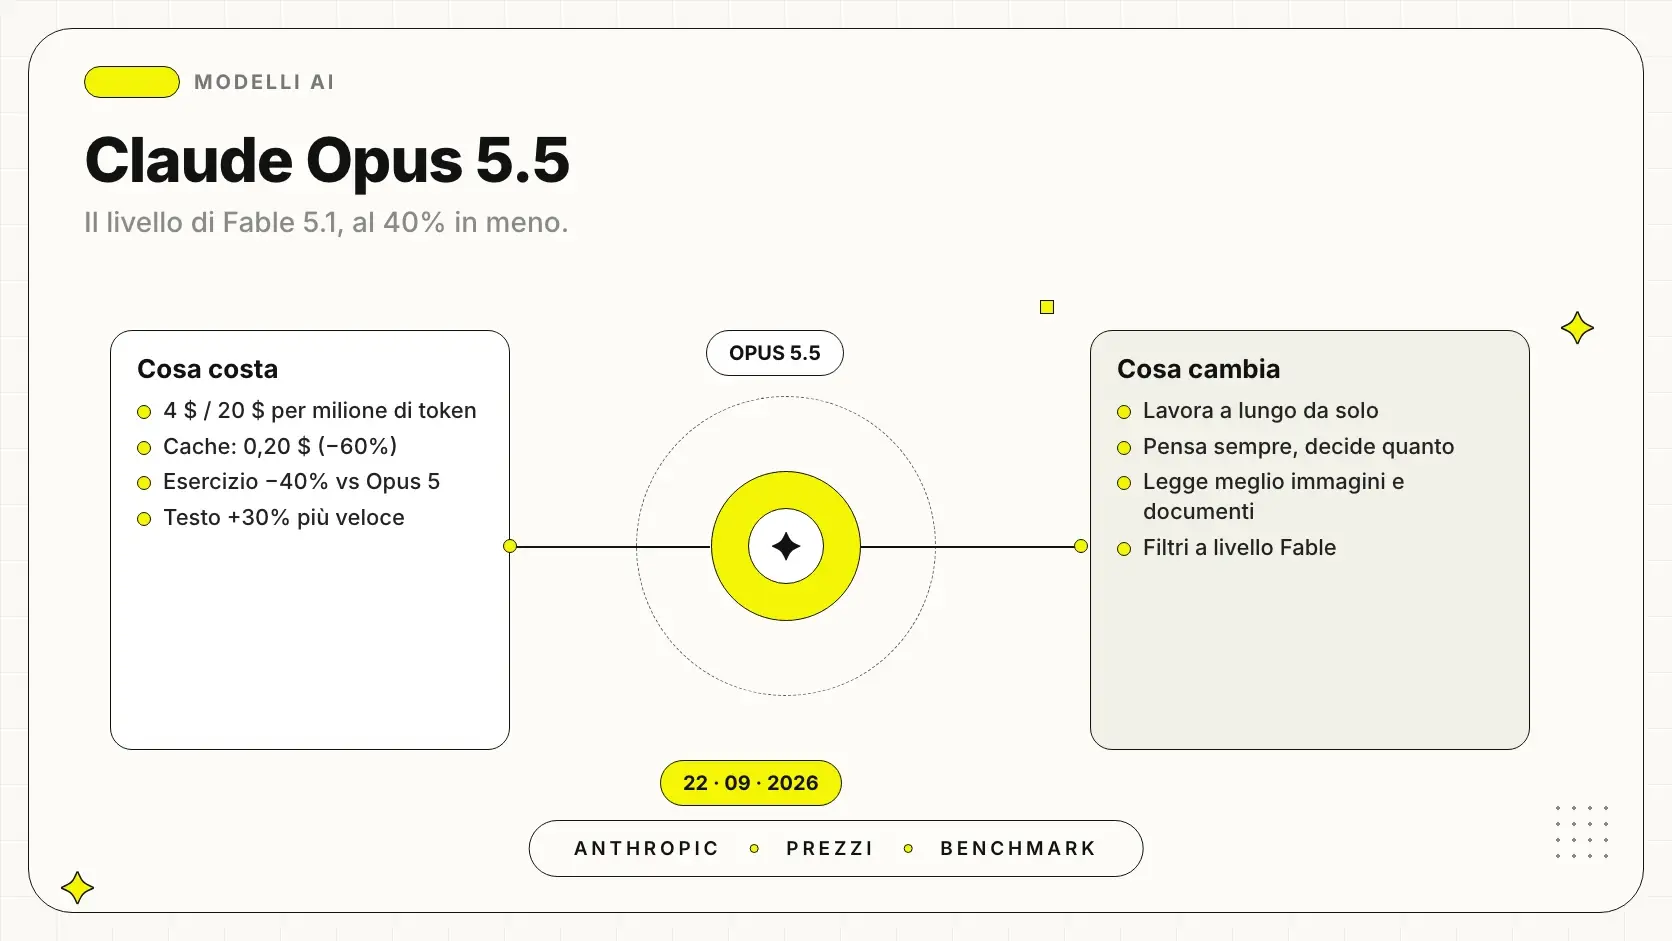 Claude Opus 5.5: cos'è, cosa cambia e a chi conviene
 Claude Opus 5.5: benchmark ufficiali, prezzi e confronto con Fable 5.1 e GPT-6 Astra
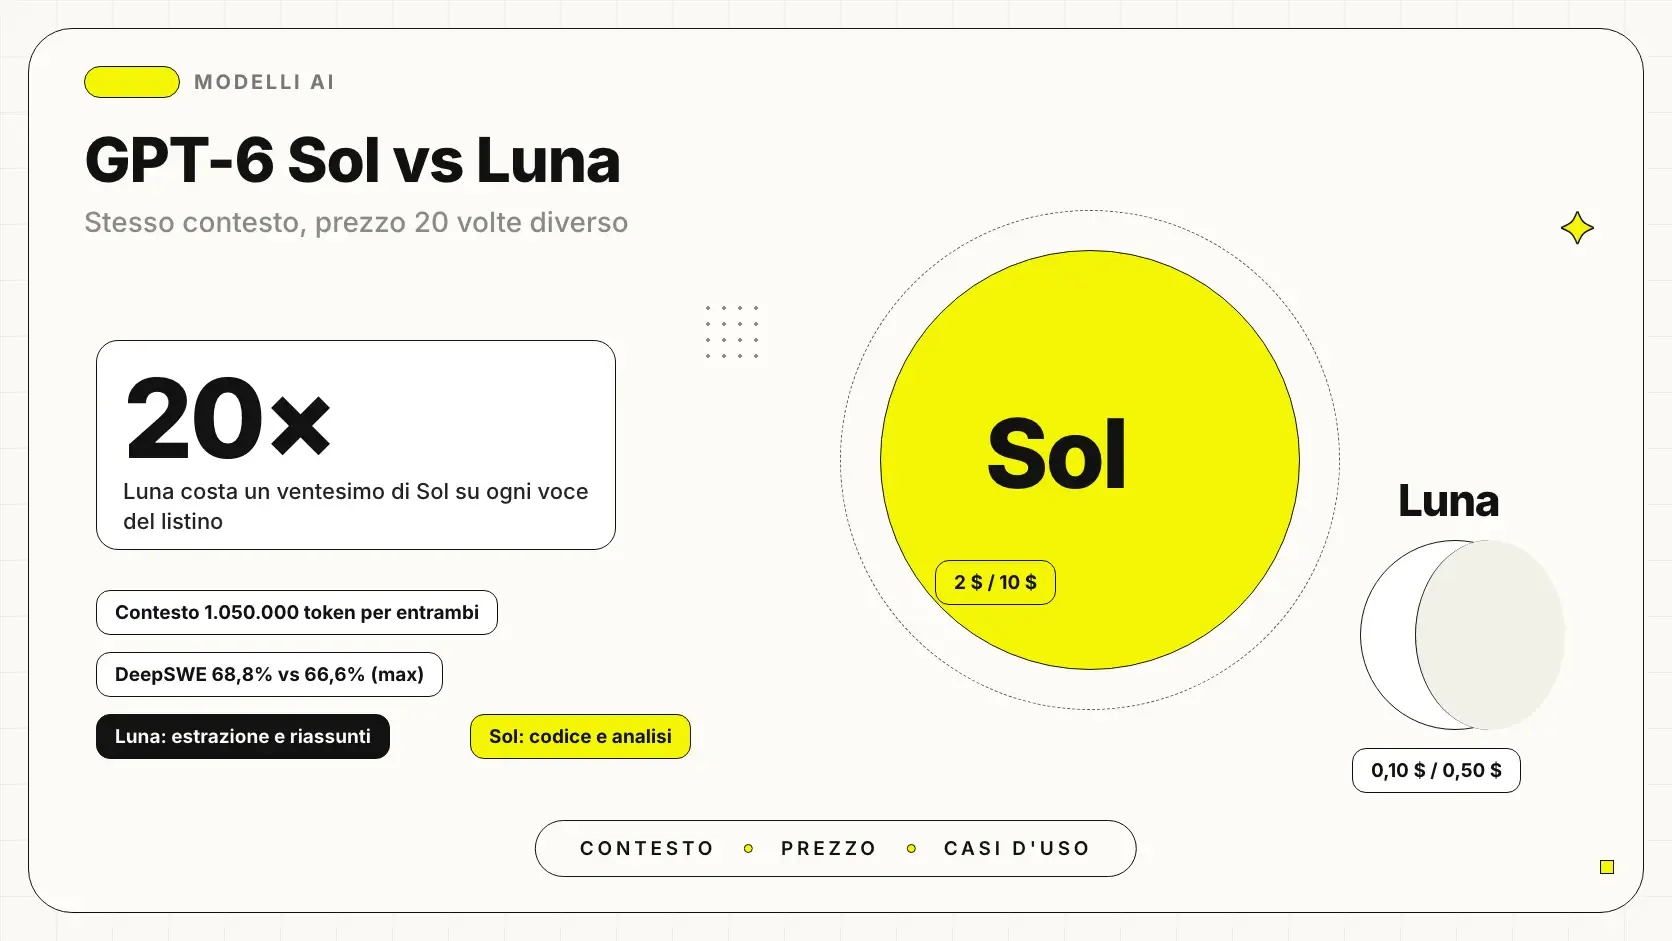 GPT-6 Sol vs Luna: quale scegliere e per quali lavori
 GPT-6 Sol e Luna: cosa sono, dove si usano e cosa cambia
 Perché i benchmark dei vendor non sono comparabili
 Claude Opus 5 vs GPT-6 Astra
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- GPT-6 Astra vs GPT-5.6 Sol
- GPT-6 Sol vs Luna: quale scegliere e per quali lavori
- GPT-6 Astra vs Claude Fable 5.1
- Claude Haiku 4.5 vs Gemini Flash-Lite
- GPT-5.6 Sol vs Terra: quale conviene
- Claude Haiku 4.5 vs GPT-5.6 Luna
- Gemini vs Copilot: quale scegliere
- Make vs Zapier vs n8n: quale scegliere per la tua azienda
- Gemini Advanced vs ChatGPT Plus
- Mistral vs Llama: confronto tra i due modelli a pesi aperti
- Gemini 3.6 Flash vs 3.5 Flash
- Claude Opus 5 vs Fable 5.1
FAQ
È meglio GPT-6 Sol o Claude Opus 5.5?
Con i dati ufficiali non si può dire in assoluto. I due modelli sono usciti lo stesso giorno e nessun produttore ha misurato il proprio contro l'altro. Sui test con lo stesso nome cambiano versione, ambiente e sforzo, quindi la scelta si fa per caso d'uso, provando entrambi sugli stessi compiti.
Quanto costano GPT-6 Sol e Claude Opus 5.5?
GPT-6 Sol costa 2 dollari per milione di token in ingresso e 10 in uscita, Claude Opus 5.5 ne costa 4 e 20. La lettura dalla cache costa 0,20 dollari per entrambi. Sopra i 272.000 token di input Sol raddoppia il prezzo d'ingresso, mentre Opus 5.5 mantiene lo stesso listino fino a 1 milione di token.
Perché OpenAI confronta GPT-6 Sol con Claude Opus 5 e non con Opus 5.5?
Perché Claude Opus 5.5 è uscito il 22 settembre 2026, lo stesso giorno di GPT-6 Sol, e OpenAI ha preso i punteggi dei concorrenti da report pubblici, dove Opus 5.5 non c'era ancora. Per lo stesso motivo Anthropic confronta Opus 5.5 con GPT-6 Astra e GPT-5.6 Sol, non con GPT-6 Sol.
L'81,8 di Opus 5.5 e il 60,5 di Sol su OSWorld 2.0 sono confrontabili?
No. OpenAI riporta il punteggio parziale sul set offline della release v2026.08.08, Anthropic un punteggio parziale senza altre indicazioni. Lo stesso Claude Opus 5 ottiene risultati distanti quasi 14 punti nelle due tabelle, segno che le due misure non stanno sulla stessa scala.
Quale dei due ha la finestra di contesto più grande?
Sono quasi uguali: 1.050.000 token per GPT-6 Sol e 1 milione per Claude Opus 5.5, con output massimo di 128.000 token per entrambi. La differenza pratica è nel prezzo delle richieste lunghe, perché sopra i 272.000 token Sol costa di più e Opus 5.5 no.
Claude Opus 5.5 si può usare senza ragionamento?
No. Anthropic ha tolto la possibilità di spegnere il ragionamento su Opus 5.5, che parte da uno sforzo medio e decide da solo quanto pensare. GPT-6 Sol accetta anche il livello none, utile nei passaggi semplici e veloci di un agente.
Quale conviene a una PMI?
Dipende dal lavoro. Per automazioni tra più app e documenti molto lunghi conviene provare prima Opus 5.5, per grandi volumi di codice e per chi lavora già in ChatGPT o Codex conviene provare prima Sol. In entrambi i casi decide il costo per attività finita, misurato sui tuoi casi.