
Gemini 4 Argon vs ChatGPT e Claude: quale scegliere
Gemini 4 Argon vs ChatGPT e Claude: modelli, benchmark e criteri aziendali. Quando provare Argon, Astra o Claude senza scegliere dal solo nome.
Nel confronto Gemini 4 Argon vs ChatGPT e Claude, la prima scelta è separare il modello dall'applicazione che lo rende utilizzabile. Argon, GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5 sono identificativi di modelli nella documentazione considerata. ChatGPT e Claude indicano anche esperienze di prodotto: strumenti, piani, permessi e flussi di lavoro possono cambiare il risultato che ottieni.
Al 23 ottobre 2026, le evidenze pubbliche non sostengono un vincitore universale. La model card Google Argon riporta vantaggi e sconfitte rispetto a quei modelli; la leaderboard Vals v2.2 del 22 ottobre aggiunge una fotografia diversa, sensibile al trattamento dei rifiuti. Qui analizziamo quelle fonti, senza presentare una prova pratica svolta da Giallo.
Se cerchi una panoramica delle capacità parti da che cos'è Gemini 4 Argon. Questa guida serve a decidere quale sistema mettere alla prova per un processo preciso, e quali condizioni controllare prima di sostituire uno strumento già in uso.
In sintesi
- Confronta identificativi e versioni dei modelli, poi applicazioni e condizioni del servizio.
- Argon guida alcuni benchmark pubblicati e perde su altri: il tipo di attività cambia la scelta.
- Un account Workspace, un piano consumer e un'API non condividono automaticamente le stesse tutele.
- La presenza di strumenti utili conta solo se il processo può usarli con permessi e controlli adeguati.
- Decidi la migrazione dopo una prova con risultati controllabili e costi della revisione visibili.
Stai scegliendo un modello o un'applicazione?
Il modello genera una risposta dato un contesto. L'applicazione decide quali informazioni possono raggiungerlo, quali strumenti sono disponibili e come il risultato viene presentato. Un'integrazione aziendale aggiunge altre scelte: autenticazione, connessioni al gestionale, archiviazione e autorizzazioni. È possibile preferire un modello su un task e un'applicazione concorrente su un altro flusso.
La distinzione evita un equivoco comune: un dato ottenuto da GPT-6 Astra in un benchmark non dimostra cosa farà qualsiasi chat di ChatGPT. Allo stesso modo, una funzione dell'app Claude non si descrive correttamente riportando soltanto un punteggio di Fable o Opus. Occorre identificare la configurazione utilizzata, senza dedurla dal logo.
Per Argon, Google distingue la scheda del modello API dall'annuncio dell'app Gemini. Le app collegate e i flussi dell'interfaccia non diventano automaticamente funzioni autonome del modello. Lo stesso criterio vale quando confronti un assistente personale con un software integrato nei processi.
Quali modelli confronta davvero la documentazione Argon?
La tabella seguente riprende tre prove dalla raccolta Google di ottobre 2026. Le versioni sono esattamente quelle pubblicate: GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. Non sono risultati generici di ChatGPT o Claude. Dati e condizioni provengono dalla model card e dalla metodologia Google, consultate il 23 ottobre.
| Modello | DeepSWE 1.1, successo pass@1 | FrontierSWE v2, successo | GraphWalks 256K–1M, BFS F1 |
|---|---|---|---|
| Gemini 4 Argon | 77,9% | 55,0% | 84,2 |
| GPT-6 Astra | 74,1% | 65,5% | 71,8 |
| Claude Fable 5.1 | 67,4% | 56,3% | 65,0 |
| Claude Opus 5.5 | 74,2% | 62,3% | 66,8 |
Le colonne non hanno un denominatore comune da sommare. Su DeepSWE Argon è calcolato da Google con mini-swe, mentre i concorrenti provengono dalle fonti pubblicate indicate nella metodologia. FrontierSWE riprende la leaderboard Proximal. GraphWalks è calcolato da Google per tutti, sul sottoinsieme lungo di problemi sintetici. Questa diversa provenienza impedisce di trattare la tabella come una nostra gara controllata.
Il quadro suggerisce ipotesi di prova: Argon per alcuni problemi di contesto lungo e coding, Astra e Opus come concorrenti da mantenere quando il lavoro assomiglia ai task più impegnativi del confronto software. Non assegna automaticamente un modello a un reparto. La guida ai benchmark Argon spiega le metriche e le eccezioni.
Perché Vals aggiunge un confronto diverso?
Il Vals Index v2.2 del 22 ottobre aggrega finanza, codice, diritto e fisco con pesi riferiti al PIL USA. Nella classifica principale Sonnet 5.5 ottiene 70,85%, Opus 5.5 70,18%, Argon 69,24% e Astra 65,02%. Sonnet 5.5 è un modello diverso da Fable 5.1: non sostituiamo il suo nome nelle colonne precedenti.
| Vals Index v2.2 | Punteggio principale | Con rifiuti trattati come fallimenti |
|---|---|---|
| Claude Sonnet 5.5 | 70,85% | 69,03% |
| Claude Opus 5.5 | 70,18% | 64,16% |
| Gemini 4 Argon | 69,24% | 69,24% |
| GPT-6 Astra | 65,02% | Non indicato separatamente nella fotografia usata |
La fonte segnala fallback per alcuni task Claude dopo rifiuti del provider. Contandoli come fallimenti, Argon passa davanti ai due modelli Claude riportati. Questa differenza serve a scegliere una politica operativa: un rifiuto deve interrompere il tuo processo, passare a una persona oppure attivare un modello alternativo? La risposta riguarda l'intero sistema, non una preferenza astratta.
Non interpretare l'indice come una percentuale di attività italiane automatizzabili. Una valutazione sul diritto statunitense non dimostra affidabilità nella contrattualistica italiana, e l'accuratezza aggregata non include il costo di integrare i tuoi archivi. La classifica aiuta a costruire una rosa di candidati; il resto richiede dati e criteri tuoi.
Quando vale la pena mettere Argon nella rosa dei candidati?
Argon merita attenzione quando hai un compito che beneficia di input differenti o di un contesto ampio, purché il risultato sia controllabile. La scheda API conferma input di testo, immagini, audio, video e PDF, con output testuale. Questo non significa generazione diretta di immagini o audio, né disponibilità identica in ogni applicazione Gemini.
Un archivio lungo può rendere interessante il modello, ma va deciso se passarlo direttamente o recuperare soltanto i documenti pertinenti. Il RAG con Argon è una scelta di sistema: indicizzazione, fonti e autorizzazioni contano almeno quanto la capacità del contesto. Se un utente non può leggere un contratto, un buon modello non deve riceverlo per preparare una risposta.
Nel coding, Argon è un candidato per un confronto su patch e analisi del repository; non basta il risultato DeepSWE per affidargli un rilascio. Se il problema è invece la quotidianità di un team già attrezzato, misura anche il costo di cambiare interfaccia e procedure. Un vantaggio sul test può non compensare il lavoro operativo richiesto dalla sostituzione.
Quando ampliare il confronto
- Hai un campione di task con risultati verificabili.
- Il modello attuale fallisce su documenti o vincoli specifici.
- Puoi provare candidati diversi con dati autorizzati e strumenti documentati.
Quando mantenere prima il processo attuale
- Non sai ancora quali errori vuoi ridurre.
- La migrazione richiederebbe nuovi accessi non valutati.
- Non esiste un responsabile che possa giudicare i risultati.
Come scegliere se il lavoro riguarda Google Workspace?
Usare già Gmail e Drive può rendere più naturale un percorso dentro Workspace. È però una valutazione del flusso di lavoro, non una prova che Argon sia presente in ogni editor. Nelle fonti considerate non abbiamo trovato una dichiarazione che identifichi Argon come modello di ogni operazione in Gmail, Docs o Sheets. Verifica la funzione e l'edizione invece di trasferire le specifiche API all'interfaccia.
Il Privacy Hub Workspace, consultato il 23 ottobre, descrive protezioni per le edizioni idonee e accesso ai contenuti secondo i permessi dell'utente. Un indirizzo con dominio aziendale, da solo, non dimostra che quelle condizioni si applichino. Anche una cartella condivisa troppo ampiamente resta un problema da correggere.
Per un primo confronto prepara una matrice con account, fonte, attività e risultato. «Riassumere un documento autorizzato» è un caso diverso da «cercare in tutta la posta». La guida Gemini per aziende offre il contesto generale; per i confini contrattuali specifici rimandiamo a privacy e sicurezza Argon.
Come imposterebbe il confronto uno studio tecnico?
Scenario ipotetico: uno studio tecnico vuole preparare schede interne da capitolati e verbali. L'esempio non descrive un cliente o una prova Giallo. Il responsabile seleziona documenti ripuliti e stabilisce cosa deve comparire nella scheda: vincoli, scadenze, riferimenti e questioni aperte. Il materiale contiene anche una revisione superata, per verificare come il sistema tratta le contraddizioni.
Argon, Astra e i modelli Claude disponibili vengono confrontati senza presumere un vincitore. Il test richiede di distinguere fonte vigente e fonte obsoleta, collegare ogni affermazione importante al documento e astenersi quando manca una prova. Il revisore valuta il contenuto senza scegliere in base al marchio che lo ha prodotto.
Se Argon trova più facilmente un riferimento ma introduce una scadenza non sostenuta, il caso non è risolto. Se un concorrente chiede un chiarimento corretto, quella richiesta può essere un comportamento desiderabile. La griglia di accettazione deve premiare la gestione dell'incertezza, non soltanto la completezza apparente della scheda.
Come cambierebbe la scelta per un e-commerce?
Scenario ipotetico: un e-commerce italiano prepara bozze per richieste su resi e garanzie. La prova proposta usa richieste sintetiche e policy approvate, senza dati reali dei clienti. Il risultato resta una bozza interna. Nessun modello riceve il permesso di inviare messaggi o autorizzare rimborsi.
La priorità è riprodurre correttamente le condizioni del negozio, non scrivere la risposta più brillante. Inserisci richieste incomplete, prodotti esclusi e messaggi che provano a imporre istruzioni estranee alla procedura. Controlla che il sistema chieda il dato mancante e che la fonte esterna non possa cambiare la delega assegnata dall'azienda.
Il confronto può rivelare che l'interfaccia o il recupero delle policy pesano più della differenza fra modelli. Prima di migrare, verifica allora se basta correggere i documenti, il prompt o i permessi. La progettazione di agenti e automazioni con Argon distingue la generazione di una proposta dall'esecuzione di un'azione.
Che cosa confrontare oltre al costo dei token?
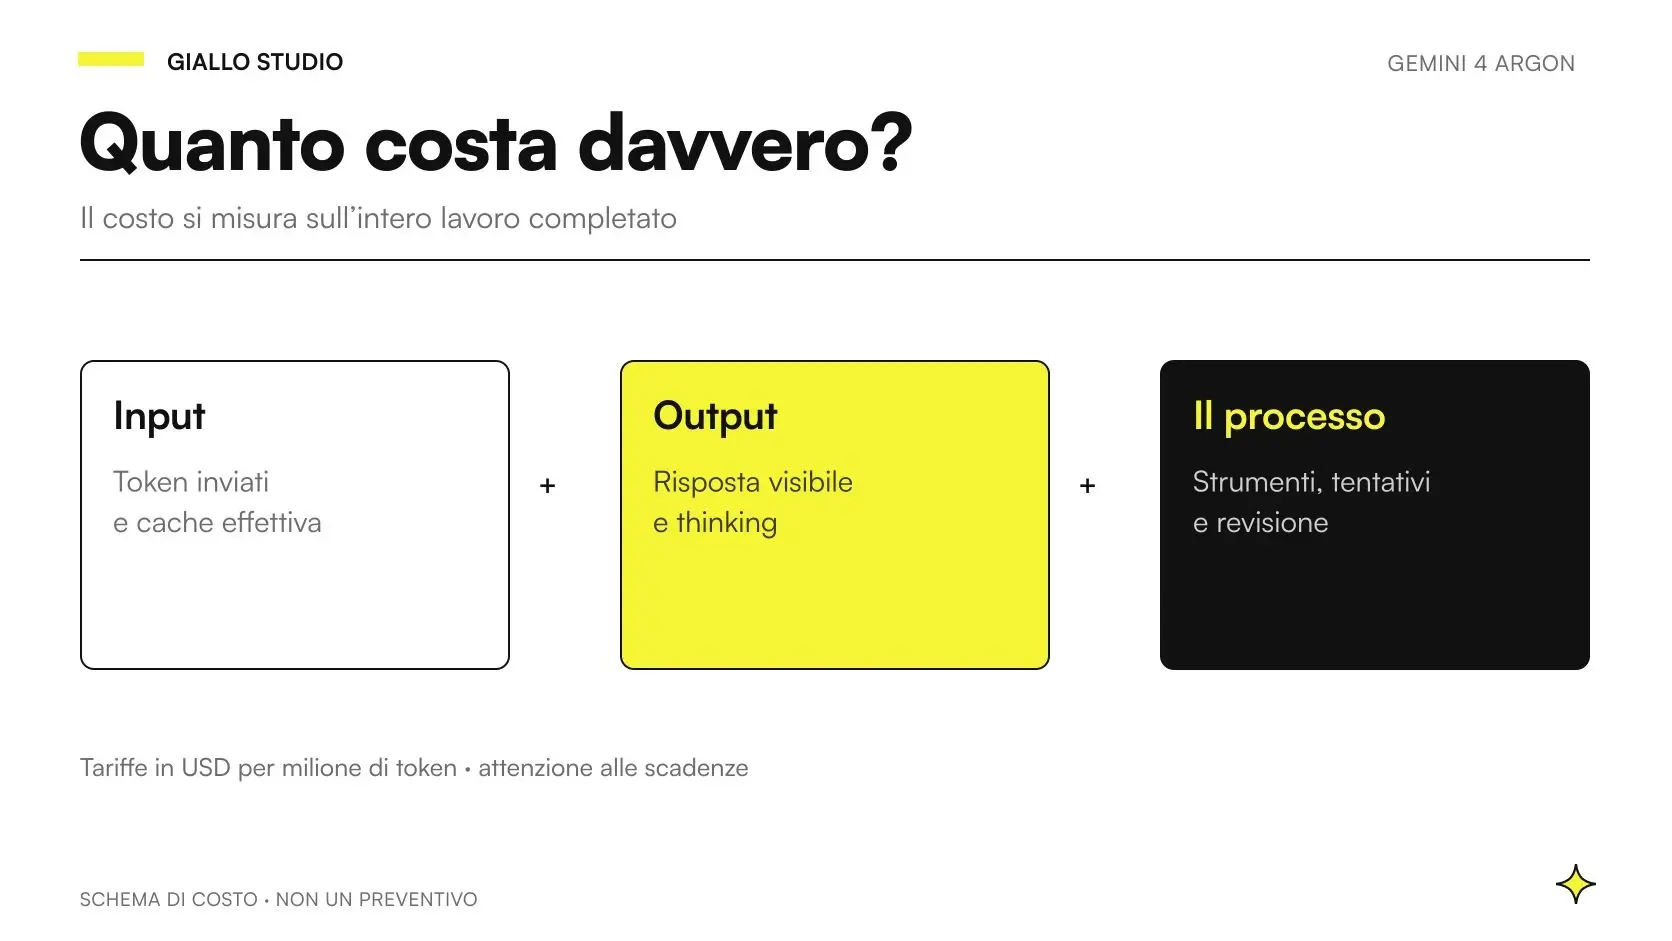
Il costo del processo comprende richieste, eventuali strumenti, tentativi scartati e lavoro umano. Un modello meno caro per token può richiedere risposte più lunghe o più correzioni; uno più capace può essere sproporzionato per una semplice classificazione. La metrica utile è il costo per risultato accettato, insieme alla qualità e alle attese tollerabili.
Per Argon il listino API Google, verificato il 23 ottobre, distingue tariffe introduttive fino al 30 novembre 2026 e tariffe successive; l'output fatturato comprende il thinking. Per gli altri fornitori consulta le rispettive pagine ufficiali prima di compilare un preventivo. Non confrontare il prezzo di un abbonamento consumer con quello di una chiamata API come se fossero la stessa unità.
Una decisione matura considera anche uscita e manutenzione: puoi esportare i casi di valutazione, cambiare modello e controllare i log senza riscrivere tutto? La risposta non richiede un'architettura complessa, ma un confine chiaro tra dati aziendali, integrazione e configurazione del fornitore. Il percorso di integrazione API Argon approfondisce questi passaggi.
Apri i criteri da concordare prima del confronto
- Quale risultato permette davvero al collega di proseguire il lavoro?
- Quale errore blocca l'utilizzo anche se il resto della risposta è corretto?
- Che cosa deve succedere quando mancano documenti o autorizzazioni?
- Quali strumenti e dati vengono concessi a ogni candidato?
- Come vengono contati interruzioni, ritentativi e revisione umana?
- Chi decide se i risultati giustificano una nuova fase del progetto?
Quali errori evitare prima di cambiare assistente AI?
Il primo errore è attribuire a un'intera applicazione il punteggio di una singola versione del modello. Il secondo è cambiare sistema perché un grafico mostra una vittoria, ignorando i benchmark dove il candidato perde. Il terzo è presumere che le condizioni privacy del piano aziendale di un prodotto valgano anche per il suo account personale.
Il quarto è confrontare risposte su input differenti: un candidato con documenti aggiornati e strumenti attivi non ha lo stesso compito di uno senza fonti. Il quinto è usare soltanto domande facili già viste durante la preparazione. Mantieni un campione nuovo per capire se il sistema segue davvero i requisiti, oppure riproduce gli esempi ottimizzati.
Non serve attendere una graduatoria definitiva. Serve una decisione circoscritta e reversibile, basata su un problema che esiste già. Se hai un assistente utile, il nuovo candidato deve dimostrare un vantaggio rilevante per quel processo, comprese le condizioni d'uso e la fatica del cambiamento.
Quale risultato deve lasciare la prima valutazione?
La prima prova dovrebbe produrre una scheda leggibile: casi usati, configurazioni, risultati accettati, errori bloccanti e questioni irrisolte. Può giustificare una migrazione, suggerire un uso limitato di Argon oppure confermare che conviene mantenere il sistema attuale. Sono tutti esiti utili quando sono sostenuti da evidenze.
Per preparare il passaggio leggi la guida alla migrazione Argon. Se vuoi impostare il confronto su un processo reale, la consulenza AI di Giallo può aiutarti a trasformare documenti, vincoli e responsabilità in un campione verificabile prima di scegliere il fornitore.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Gemini 4 Argon: cos’è, cosa fa e quando usarlo in azienda
 Gemini 4 Argon benchmark: come leggere il confronto LLM
 Migrare a Gemini 4 Argon: valutazione, test e rollback
 Gemini 4 Argon privacy e sicurezza: guida per aziende
 Gemini 4 Argon coding: come valutarlo nello sviluppo software
 Gemini 4 Argon: prezzi API e calcolo dei costi aziendali
 ChatGPT vs Grok
 ChatGPT Plus vs Claude Pro: quale abbonamento scegliere
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Gemini 3.6 Flash vs 3.5 Flash
- ChatGPT vs Gemini: quale abbonamento conviene a ottobre 2026
- Claude Fable 5.1 vs Sonnet 5
- Gemini vs Copilot: quale scegliere
- Claude vs Perplexity
- GPT-5.6 Sol vs Terra: quale conviene
- Claude vs Gemini: quale usare
- GPT-6 Astra vs Claude Fable 5.1
- Claude vs DeepSeek: quale scegliere
- GPT-6 Astra vs GPT-5.6 Sol
- Claude Duet, Cowork e Claude Code: quale scegliere
- GPT-6 Sol vs Claude Opus 5.5: i numeri ufficiali e quando usare quale
FAQ
Gemini 4 Argon è meglio di ChatGPT e Claude?
Non esiste un vincitore dimostrato per ogni attività. La raccolta Google di ottobre 2026 mostra Argon davanti su DeepSWE 1.1 e GraphWalks lungo, ma dietro GPT-6 Astra e Claude Opus 5.5 su FrontierSWE v2. La scelta richiede una prova sul processo aziendale.
ChatGPT è lo stesso modello di GPT-6 Astra?
ChatGPT è il nome di un'applicazione; GPT-6 Astra identifica un modello nel confronto qui riportato. Un benchmark di Astra non descrive automaticamente ogni risposta ottenuta nell'app, con ogni piano e configurazione. Va verificato il modello e il prodotto effettivamente utilizzato.
Perché il confronto include Fable 5.1 e Opus 5.5?
Sono le versioni Claude presenti nella tabella della model card Argon di ottobre 2026. La leaderboard Vals aggiornata usa anche Sonnet 5.5: non va trattato come un altro nome di Fable. Ogni risultato resta legato alla versione pubblicata.
Si può trasferire un abbonamento consumer a un'integrazione API?
Un abbonamento dell'app e l'utilizzo API hanno condizioni, quote e fatturazione da controllare separatamente. Non assumere che un piano personale includa chiamate gratuite o illimitate per il gestionale aziendale.
Argon conviene se l'azienda usa già Google Workspace?
La familiarità con Workspace può aiutare a definire il percorso operativo, ma non prova che ogni funzione Gemini in Gmail o Docs usi Argon. Controlla edizione, account, disponibilità della funzione e permessi. Poi valuta la qualità sul compito concreto.
Quale prova fare prima di cambiare fornitore AI?
Prepara casi ripuliti con risposta attesa, fonti autorizzate e criteri di errore grave. Esegui il confronto con condizioni documentate e misura anche revisione umana, interruzioni e costi delle risposte scartate. Un risultato di benchmark aiuta a scegliere i candidati, non decide la migrazione.