
DeepSeek R1 Distill 32B vs Qwen3.8-27B in locale
DeepSeek R1 Distill 32B vs Qwen3.8-27B: testo, immagini, ragionamento e memoria. Come scegliere il modello locale con prove pertinenti.
DeepSeek R1 Distill 32B vs Qwen3.8-27B è soprattutto una scelta fra due percorsi di lavoro: ragionamento su testo e gestione anche di contenuti visivi. Non esiste un vincitore misurato da Giallo su questi due checkpoint: la scelta dipende dai documenti, dall'hardware e dagli errori che il processo può tollerare.
Il primo nome identifica precisamente DeepSeek-R1-Distill-Qwen-32B, un modello testuale dense basato su Qwen2.5-32B. Qwen3.8-27B appartiene a una generazione diversa e supporta testo, immagini e video. Sono informazioni dei produttori, verificate il 27 ottobre 2026; non equivalgono a una prova comparativa di qualità.
In sintesi
- Il Distill 32B non coincide con DeepSeek R1 completo.
- Il percorso testuale e quello visivo richiedono prove differenti.
- I parametri spiegano solo una parte del consumo di memoria.
- Più testo di ragionamento non significa più risposte corrette.
- Il criterio utile è il lavoro affidabile che resta dopo la revisione.
Che cosa significa davvero Distill in questo confronto?
La distillazione trasferisce comportamenti attraverso dati o segnali di addestramento: non riduce semplicemente il file del modello originale. In questo caso il produttore distingue esplicitamente il checkpoint derivato dal modello R1 completo nella tabella dei modelli DeepSeek. Il riferimento alla famiglia Qwen nel nome descrive la base di partenza, non una relazione di aggiornamento con Qwen3.8.
Per chi acquista un progetto aziendale la conseguenza è concreta: chiedere il repository esatto. Una proposta che scrive soltanto “DeepSeek” non chiarisce quale software verrà installato, quale memoria richiederà e quali capacità siano state effettivamente valutate. Lo stesso vale per una promessa generica di “Qwen locale”. Nella guida alla scelta del modello AI il checkpoint è quindi una voce da fissare prima della sperimentazione, insieme alla revisione dei pesi e al runtime.
Testo e immagini: dove cambia la pipeline?
Un contratto esportato come testo e una fotografia dello stesso contratto non sono lo stesso input. Nel primo caso entrambi i sistemi possono ricevere il contenuto estratto. Nel secondo, il Distill richiede un passaggio esterno di lettura delle immagini, mentre Qwen può utilizzare un percorso visivo compatibile. Se l'OCR esterno sbaglia una cifra, la risposta finale può sembrare un errore del modello anche quando nasce prima.
La documentazione multimodale di llama.cpp distingue i pesi linguistici dai componenti necessari a elaborare gli input visivi. Il nome del file scaricato, da solo, non conferma che questo percorso sia configurato. Per progettare la prova servono due domande separate: il sistema ha letto correttamente la pagina? Ha ragionato correttamente su ciò che ha letto? La guida su PDF e immagini in locale sviluppa questa distinzione operativa.
Quali differenze mettere nella scheda decisionale?
| Aspetto | DeepSeek R1 Distill Qwen 32B | Qwen3.8-27B | Verifica da fare |
|---|---|---|---|
| Input del modello | Testo | Testo e input visivi | Provare il formato reale |
| Famiglia di partenza | Qwen2.5 | Qwen3.8 | Salvare repository e revisione |
| Architettura considerata | Dense | Dense | Non applicare regole MoE |
| Obiettivo del confronto | Ragionamento testuale | Ragionamento e lettura visiva | Separare i risultati |
| Qualità in italiano | Da misurare sul compito | Da misurare sul compito | Usare risposte attese |
| Memoria operativa | Dipende dalla configurazione | Dipende dalla configurazione | Leggere log e picchi |
La tabella serve a decidere che cosa sperimentare, non a distribuire medaglie. Un requisito essenziale può escludere un candidato prima dei punteggi: se occorre interpretare direttamente una disposizione grafica, una pipeline solo testuale deve dimostrare come conserva quelle informazioni. Se arrivano esclusivamente record già strutturati, questa capacità aggiuntiva potrebbe non portare un beneficio utilizzabile.
Quanto pesa la differenza fra 32B e 27B?
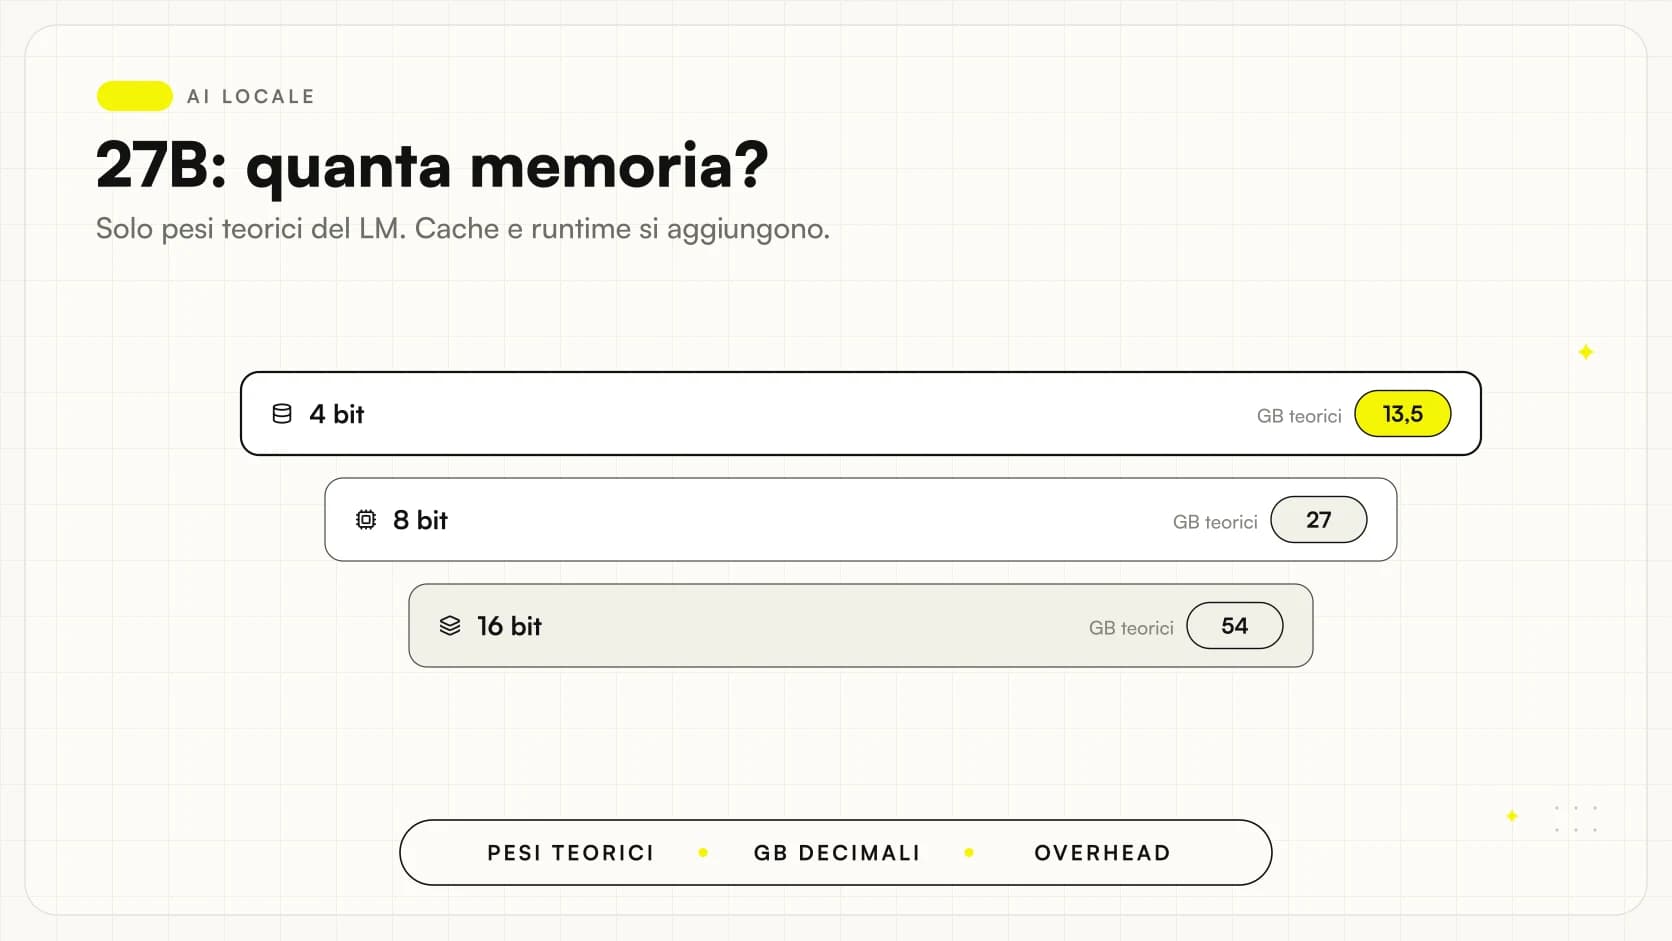
Come calcolo autonomo, limitato ai soli pesi linguistici, parametri moltiplicati per bit e divisi per otto danno circa 16 GB decimali per 32 miliardi di parametri a quattro bit e 13,5 GB per 27 miliardi. Non sono misure dei file distribuiti e non dicono che una macchina con quella memoria possa eseguire il servizio.
La documentazione Hugging Face sulla quantizzazione spiega il compromesso fra precisione e occupazione. Nel progetto vanno aggiunti metadati, componenti multimodali, cache e spazio di lavoro del runtime. Anche la memoria lasciata alle applicazioni ordinarie conta. Il confronto corretto registra il file effettivamente caricato e la configurazione, invece di assegnare un computer a un modello guardando soltanto il suffisso B. Per dimensionare Qwen è utile la guida a RAM e VRAM del 27B.
Il ragionamento più lungo rende la risposta migliore?
Un modello può produrre un percorso argomentato e arrivare comunque a una conclusione falsa. Può anche impiegare molto testo per una domanda che richiedeva un controllo breve. Nell'uso aziendale interessa l'esito verificabile: una scadenza estratta correttamente, una quantità riconciliata, una contraddizione segnalata con la fonte. La lunghezza della spiegazione è una caratteristica dell'output, non una certificazione.
Conviene separare la risposta destinata all'operatore dai dati usati per controllarla. Per esempio, chiedere valore, documento di origine e passaggio di supporto, poi verificare il formato con regole definite. Non occorre conservare una lunga catena di pensiero per dimostrare l'affidabilità di un totale: servono i valori di partenza e un calcolo ripetibile. Su decisioni delicate la revisione umana deve poter ricostruire la prova senza affidarsi alla sicurezza del tono.
Come evitare un confronto truccato dai prompt?
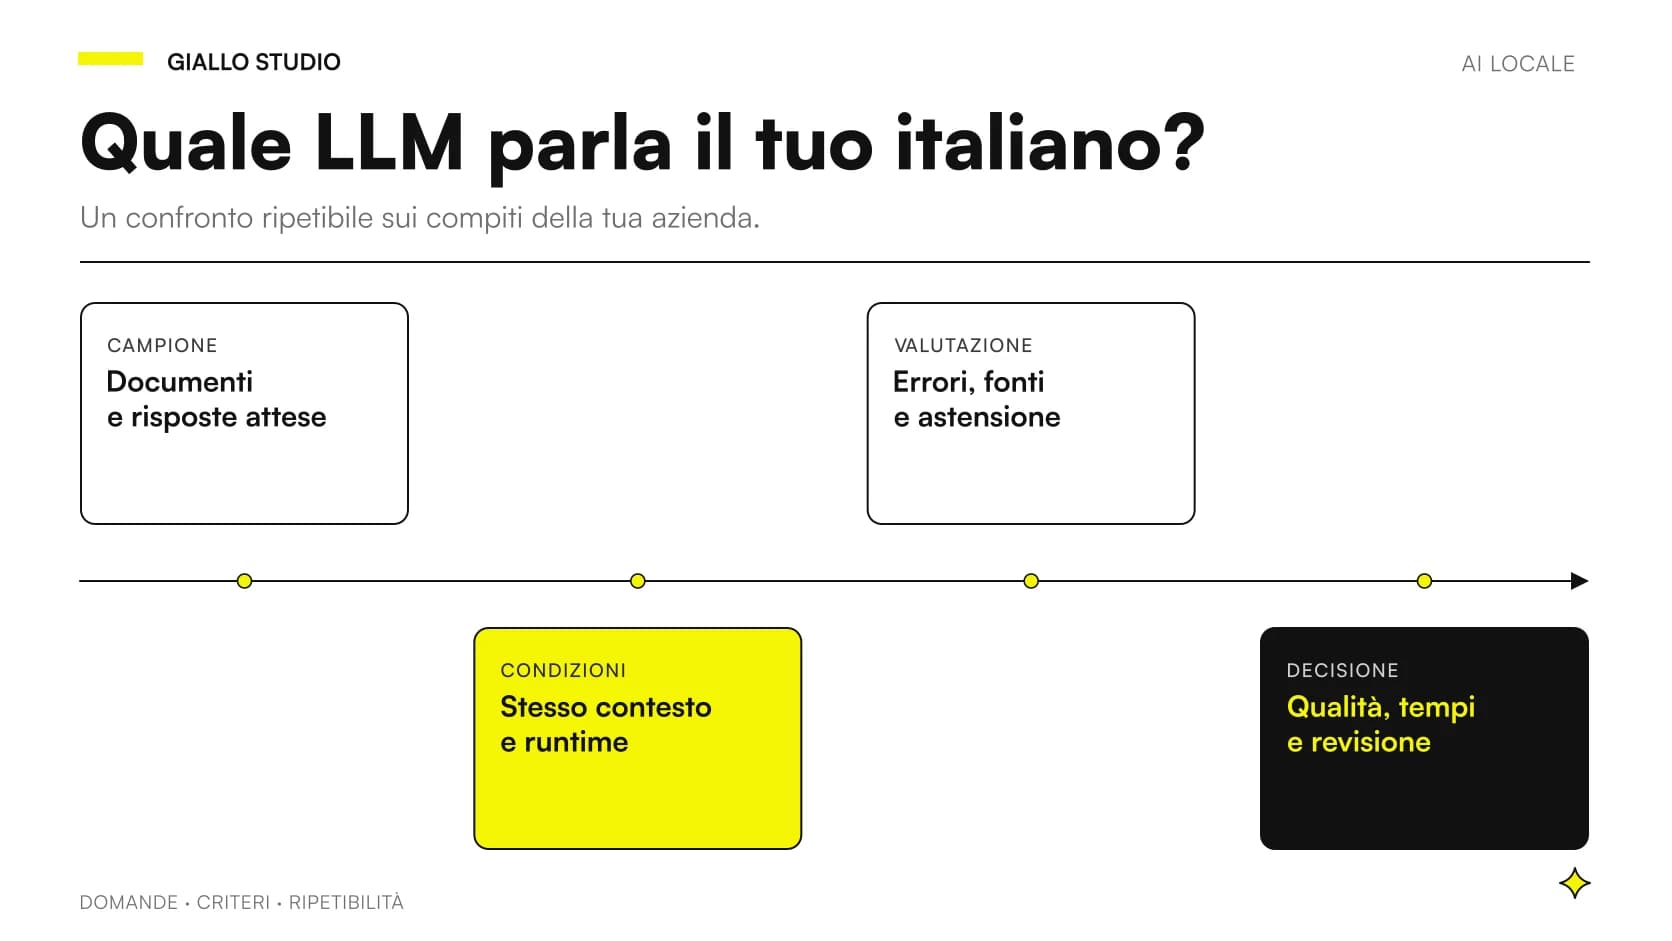
Una prova equa parte dallo stesso problema, ma rispetta i formati documentati di ciascun modello. Copiare alla cieca il template di chat di una famiglia nell'altra può penalizzare un candidato. Occorre registrare istruzioni, impostazioni di generazione, limite dell'output e trattamento dei documenti, distinguendo ciò che è comune da ciò che il runtime richiede.
La scheda DeepSeek pubblica raccomandazioni specifiche di utilizzo. Applicarle non autorizza a modificare il quesito soltanto per il candidato preferito. Un buon verbale riporta anche gli errori di formato e le risposte interrotte: eliminarli dal conteggio migliorerebbe artificialmente il risultato. Per approfondire il metodo, il protocollo di benchmark in italiano propone criteri separati per correttezza, astensione e latenza.
Uno studio tecnico che confronta capitolati
Immaginiamo uno studio che debba confrontare due capitolati e un preventivo. È uno scenario illustrativo, non un cliente Giallo. Se tutti i testi sono digitali, la prova può chiedere quali prestazioni mancano, dove cambiano le quantità e quali condizioni sono incompatibili. Una tabella preparata da una persona diventa il riferimento: ogni osservazione dell'AI deve indicare documento e passaggio.
Si aggiunge poi una variante con una pagina scansionata e una nota a margine. Il risultato non va mescolato al precedente: qui entra in gioco anche la lettura visiva. Un candidato potrebbe essere adeguato sul confronto testuale e fallire proprio sulla nota. Questa informazione è più utile di un unico punteggio medio, perché suggerisce un confine operativo: documenti digitali ammessi, scansioni da controllare con un percorso diverso.
Un ufficio amministrativo che verifica addebiti
Secondo scenario ipotetico: un ufficio deve spiegare differenze fra ordini e addebiti. Il modello riceve estratti già normalizzati, quindi l'immagine non porta automaticamente valore. La prova importante riguarda corrispondenze, eccezioni e dati mancanti. Un addebito privo del documento di supporto deve restare segnalato, senza inventare una causale plausibile.
Le somme si controllano con software deterministico; il modello può aiutare a descrivere le discrepanze e proporre verifiche. Si misura anche quanto lavoro resta all'addetto dopo la risposta. Una spiegazione elegante ma difficile da verificare può costare più tempo di una tabella essenziale. Per questo il confronto economico deve includere revisione e manutenzione, come spiegato nell'analisi di AI locale e cloud per i costi aziendali.
Quando conviene mantenere due candidati?
Il flusso riceve documenti molto diversi: serve un solo modello?
Non necessariamente. Prima si separano i compiti e si verifica se una sola configurazione li copre con qualità sufficiente. Un secondo modello ha senso quando risolve un limite osservato e il beneficio compensa duplicazione, aggiornamenti e controlli aggiuntivi.
Mantenere due sistemi significa raddoppiare alcune responsabilità, non soltanto scaricare un altro file. Vanno gestite versioni, configurazioni, prove di regressione e persone autorizzate. La scelta può essere ragionevole per lavori distinti; è meno convincente quando nasce soltanto dall'incertezza su quale modello preferire.
Una piccola impresa può iniziare con un candidato e conservare il secondo come confronto periodico. Conta documentare il motivo della scelta e la condizione che la farebbe riaprire: peggioramento su documenti nuovi, nuovo requisito visivo o riduzione del costo operativo. Si evita così una rotazione continua dettata dagli annunci.
Quali errori rendono inaffidabile la valutazione?
Il primo errore è attribuire al Distill i risultati di R1 completo. Il secondo è confrontare un modello quantizzato aggressivamente con l'altro a precisione diversa senza indicarlo. Il terzo è modificare contemporaneamente runtime, prompt e documenti: quando l'esito cambia, non si sa più quale variabile abbia inciso.
Un quarto errore consiste nel misurare soltanto le risposte corrette più appariscenti. Vanno incluse domande senza risposta nei documenti, contraddizioni e input illeggibili. Infine, “locale” non dimostra che l'intero processo sia isolato: OCR esterno, strumenti e salvataggi possono coinvolgere altri servizi. La guida ai modelli AI locali chiarisce il perimetro; la verifica deve seguire il flusso effettivo del contenuto, non fermarsi al nome del modello.
Come leggere un risultato senza nascondere gli errori rari?
Un campione composto soltanto da domande semplici tende a rendere tutti i candidati soddisfacenti. Per questo il responsabile del processo deve aggiungere casi che separano davvero le alternative: una tabella spezzata fra pagine, un riferimento a una versione superata, due aziende con nomi simili, un documento privo dell'allegato richiamato. Non sono trabocchetti artificiali quando rappresentano problemi possibili nell'archivio di lavoro.
La valutazione può distinguere risposta corretta, risposta incompleta, errore correggibile e affermazione priva di supporto. Le categorie vanno definite prima di leggere gli output. Una persona diversa da chi ha configurato il modello può valutare un sottoinsieme senza vedere il nome del candidato: riduce il rischio di premiare la formulazione più vicina alle proprie aspettative.
Occorre conservare anche il motivo dell'errore. “Ha confuso due versioni” suggerisce un problema diverso da “non ha letto una cifra” oppure “ha ignorato l'istruzione di segnalare dati mancanti”. La correzione potrebbe stare nell'archivio, nell'estrazione o nel formato della richiesta. Cambiare modello senza questa distinzione rischia di spostare il problema e ripetere la stessa prova senza imparare nulla.
Che cosa chiedere a chi propone l'installazione?
Una proposta concreta dovrebbe consegnare l'identificativo dei pesi, la revisione, la provenienza della conversione e una descrizione leggibile dei componenti. Deve chiarire chi aggiorna il runtime, chi vede le conversazioni e dove finiscono i documenti temporanei. Le licenze si controllano sui file distribuiti e sulle dipendenze del progetto: il nome commerciale di una famiglia non basta a stabilire tutti gli obblighi applicabili.
Il verbale della prova dovrebbe includere campione, criteri di esclusione e risultati sfavorevoli, oltre alla configurazione scelta. Non servono promesse su qualunque computer: serve una misurazione sulla macchina prevista, con le altre applicazioni necessarie al lavoro aperte. Se la proposta riguarda un servizio condiviso, la prova deve simulare richieste sovrapposte invece di mostrare soltanto una chat individuale.
Infine, è utile chiedere una dimostrazione del percorso di recupero. Un file non leggibile, una risposta interrotta o l'esaurimento della memoria devono produrre un esito comprensibile per l'operatore. La continuità del processo dipende anche da questo comportamento, spesso meno visibile di una risposta riuscita durante la presentazione.
Dal confronto alla scelta di un processo circoscritto
La decisione finale dovrebbe essere una frase verificabile: “questa configurazione aiuta a confrontare questi documenti, con queste esclusioni e questa revisione”. È più utile di “abbiamo installato il modello migliore”. Si conserva un campione di riferimento e lo si ripete dopo ogni aggiornamento dei pesi o del runtime, senza sostituire silenziosamente la configurazione approvata.
Prima di estendere il servizio si assegna un responsabile delle anomalie e si decide come tornare al lavoro manuale quando la risposta manca o non è supportata. Un progetto locale diventa affidabile attraverso questi confini, non attraverso una classifica. Se vuoi trasformare il confronto fra DeepSeek e Qwen in una prova sui tuoi documenti, la consulenza AI di Giallo Studio può definire campione, criteri e configurazione prima dell'integrazione.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Claude vs Perplexity
- Claude Fable 5.1 vs Sonnet 5
- Claude vs Gemini: quale usare
- Gemini 3.6 Flash vs 3.5 Flash
- Claude vs DeepSeek: quale scegliere
- Gemini 4 Argon vs ChatGPT e Claude: quale scegliere
- Claude Duet, Cowork e Claude Code: quale scegliere
- ChatGPT vs Gemini: quale abbonamento conviene a ottobre 2026
- ChatGPT vs Perplexity: ricerca o generazione
- Gemini vs Copilot: quale scegliere
- ChatGPT vs Grok
- Gemma 4 12B vs Ministral 3 14B: AI locale compatta
FAQ
DeepSeek R1 Distill 32B è il modello DeepSeek R1 completo?
No. DeepSeek-R1-Distill-Qwen-32B è un checkpoint dense basato su Qwen2.5-32B e addestrato con dati generati da R1. I risultati del modello R1 completo non possono essergli attribuiti automaticamente.
Quale dei due legge immagini direttamente?
Qwen3.8-27B accetta input visivi nel percorso multimodale supportato. DeepSeek R1 Distill Qwen 32B è testuale: per una scansione serve un componente separato che estragga il contenuto.
Qwen3.8-27B è sempre migliore perché più recente?
La data non dimostra la qualità sul proprio processo. Occorre confrontare risultati corretti, errori, tempi di revisione e consumo di memoria usando gli stessi documenti e criteri.
Quanta memoria richiedono i pesi a quattro bit?
Il calcolo teorico sui soli parametri linguistici dà circa 16 GB decimali per 32B e 13,5 GB per 27B. Non comprende encoder, metadati, cache, buffer o sistema operativo e non rappresenta un requisito sufficiente.
Un modello reasoning garantisce calcoli esatti?
No. Una spiegazione plausibile può contenere operazioni sbagliate. Nei processi con importi o quantità conviene verificare i risultati tramite calcolo deterministico e controlli sui dati di partenza.