
GPT-6 Sol vs Luna: quale scegliere e per quali lavori
GPT-6 Sol vs Luna: stessa finestra da 1,05 milioni di token, prezzo 20 volte diverso. Benchmark ufficiali, esempi di costo e una tabella per scegliere.
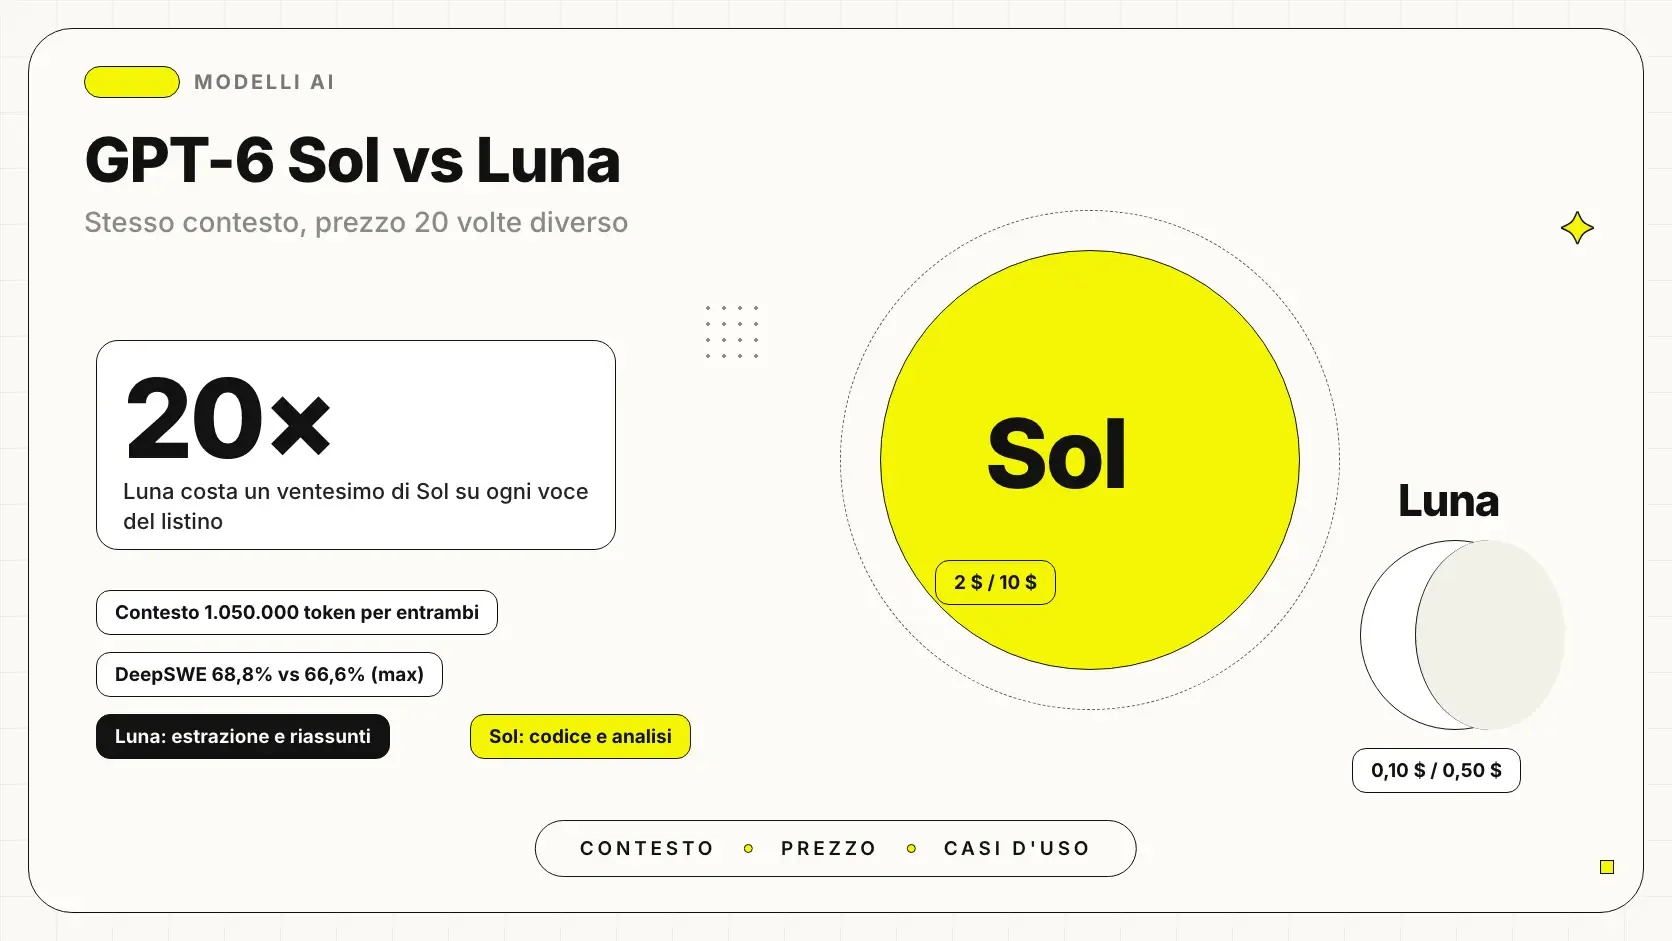
GPT-6 Sol e GPT-6 Luna sono i due modelli che OpenAI ha affiancato a GPT-6 Astra il 22 settembre 2026. La scelta tra i due si riduce a una domanda: il lavoro ha una risposta che puoi controllare in fretta? Se sì, come quando estrai i campi di una fattura o riassumi una mail, parti da Luna. Se il compito chiede di ragionare su più passaggi, come scrivere o rivedere codice o costruire un'analisi, parti da Sol.
Il confronto è insolito perché sulla carta i due modelli sono quasi gemelli: stessa finestra di contesto da 1.050.000 token, stesso output massimo, stessi livelli di ragionamento, stessi strumenti. Cambia il prezzo, venti volte su ogni riga del listino, e cambia quanto OpenAI promette su ciascuno. Dati verificati il 23 settembre 2026 sulla documentazione API di OpenAI: prima di mettere a budget un progetto ricontrolla sempre la pagina ufficiale.
In sintesi
- Sol e Luna hanno la stessa finestra di contesto (1.050.000 token), lo stesso output massimo e gli stessi sei livelli di ragionamento, da none a max.
- Luna costa un ventesimo di Sol su ogni voce: 0,10 $ contro 2 $ in ingresso e 0,50 $ contro 10 $ in uscita, per milione di token.
- OpenAI presenta Sol per il codice complesso e i flussi agentici, Luna per i compiti mirati ad alto volume.
- L'unico test in cui OpenAI scrive un punteggio per entrambi è DeepSWE v1.1: poco più di due punti di distanza, tutti e due allo sforzo massimo.
- Curiosità: Luna ha una data di conoscenza più recente di Sol, 18 maggio contro 20 aprile 2026.
- Regola pratica: Luna dove l'errore si vede subito, Sol dove un errore non visto ti costa caro.
Cosa hanno in comune GPT-6 Sol e Luna, e cosa no
Nelle schede ufficiali di GPT-6 Sol e di GPT-6 Luna le differenze stanno in poche righe: prezzo, livello di ragionamento dichiarato e limiti di richieste.
| Voce | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| Identificativo API | gpt-6-sol |
gpt-6-luna |
| Per cosa lo presenta OpenAI | codice complesso e flussi agentici | compiti mirati ad alto volume |
| Ragionamento (etichetta della scheda) | il più alto | alto |
| Velocità (etichetta della scheda) | veloce | veloce |
| Finestra di contesto | 1.050.000 token | 1.050.000 token |
| Output massimo | 128.000 token | 128.000 token |
| Livelli di ragionamento | none, low, medium (predefinito), high, xhigh, max | gli stessi |
| Data limite della conoscenza | 20 aprile 2026 | 18 maggio 2026 |
| Prezzo input e output, per milione di token | 2 $ e 10 $ | 0,10 $ e 0,50 $ |
| Token al minuto, livello di utilizzo Tier 2 | 1 milione | 2 milioni |
| Token al minuto, livello di utilizzo Tier 5 | 40 milioni | 180 milioni |
Due dettagli delle schede dicono come OpenAI immagina l'uso dei due modelli. Entrambi hanno la stessa etichetta di velocità, quindi la rapidità non è il motivo per scegliere Luna. E i limiti di Luna sono più larghi: già al Tier 2 accetta il doppio dei token al minuto di Sol, al Tier 5 più del quadruplo, coerente con un modello pensato per i grandi volumi. Chi parte da zero trova il quadro generale, piani ChatGPT compresi, in cosa sono GPT-6 Sol e Luna.
Venti volte meno: dove si vede sul listino
Il rapporto tra i due prezzi è lo stesso su ogni riga del listino ufficiale: input, lettura e scrittura della cache, output, contesto lungo, e anche le modalità Batch, Flex e Fast. Per avere un riferimento, il predecessore GPT-5.6 Luna costava 0,20 $ e 1,20 $ e lo avevamo messo accanto a Claude Haiku 4.5 in questo confronto.
Due regole valgono per entrambi e spostano il conto più della scelta del modello. Sopra i 272.000 token di input l'intera richiesta si paga il doppio in ingresso e una volta e mezza in uscita, come indicano le schede dei modelli: Sol passa a 4 $ e 15 $, Luna a 0,20 $ e 0,75 $. E i token di ragionamento, anche se non li vedi, si pagano come token di output. Alzare lo sforzo su Luna costa meno che su Sol, ma non è gratis.
Quanto è lontana Luna da Sol nei test di OpenAI
I numeri vengono dall'annuncio del 22 settembre e li ha misurati OpenAI stessa. In ogni riga guarda il livello di sforzo: lo stesso modello, a sforzo diverso, dà risultati diversi.
| Test e cosa misura | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| DeepSWE v1.1: compiti di ingegneria del software su codebase reali | 68,8% a sforzo max | 66,6% a sforzo max |
| AutomationBench 1.0.6: flussi aziendali con 47 strumenti | 33,2% a sforzo xhigh, 0,27 $ per attività | 5,4 punti in più di GPT-5.6 Luna a sforzo high, con un costo per attività inferiore del 58% |
| OSWorld 2.0 offline, punteggio parziale: uso del computer | 60,5% a sforzo xhigh | a sforzo max supera GPT-5.6 Sol (medium) a un decimo del costo |
| Agents' Last Exam V1: lavoro professionale in 55 sotto-settori | 56,4% a sforzo max | non pubblicato |
| FrontierCode 1.1 Main: codice pronto per il merge | nessun numero, solo "pari a Claude Fable 5.1 xhigh" a costo più basso | non pubblicato |
| Valutazione interna sui fatti | circa metà degli errori di GPT-5.6 Sol | a sforzo alto pari a GPT-5.6 Sol, a circa un centesimo del costo |
| Fonte | annuncio OpenAI | stessa pagina |
La riga che risponde davvero alla domanda "Sol o Luna" è una sola, DeepSWE v1.1: 68,8 contro 66,6, stesso test, stesso sforzo. Poco più di due punti di distanza con un prezzo per token venti volte più basso. È un test di sviluppo software, quindi non dice nulla di diretto su fatture o mail, ma suggerisce che tra i due c'è meno distanza di quanta ne mostri il listino.
Le altre righe vanno lette con più attenzione. Per Luna OpenAI misura il salto rispetto ai modelli GPT-5.6, non la distanza da GPT-6 Sol. E la valutazione sui fatti usa conversazioni in cui gli utenti avevano segnalato un errore, che OpenAI stessa dichiara non rappresentative dell'uso normale. Il perché di queste cautele è in perché i benchmark dei vendor non sono comparabili, il peso dello sforzo in reasoning effort: cosa cambia nei confronti.
La curiosità: Luna sa cose più recenti di Sol
Nella famiglia precedente le tre varianti di GPT-5.6 avevano la stessa data limite, il 16 febbraio 2026, come avevamo riportato in GPT-5.6 Sol vs Terra. Con GPT-6 le date si separano, e al contrario di quanto ci si aspetterebbe: la conoscenza di Luna arriva al 18 maggio 2026, quella di Sol si ferma al 20 aprile 2026. Il modello più economico è quello più aggiornato, e OpenAI non spiega il motivo.
Per una PMI pesa poco: quattro settimane in più non bastano per fidarsi della memoria del modello su prezzi, norme o scadenze. Per i fatti recenti si passano i documenti giusti o si attiva la ricerca web, disponibile per entrambi. Il tema è approfondito in knowledge cutoff: cosa significa in pratica.
Quanto costa lo stesso lavoro con Sol e con Luna
Tre esempi con i prezzi Standard, richieste sotto i 272.000 token e nessuna cache. Volumi e token sono ipotesi per mostrare l'ordine di grandezza, non misure fatte su un'azienda.
| Esempio (volumi ipotizzati) | Token al mese | GPT-6 Luna | GPT-6 Sol |
|---|---|---|---|
| 3.000 fatture e DDT, 4.000 token in ingresso e 400 in uscita ciascuno | 12 milioni in, 1,2 milioni out | 1,80 $ | 36,00 $ |
| 60.000 mail di assistenza da riassumere e smistare, 1.500 in e 250 out | 90 milioni in, 15 milioni out | 16,50 $ | 330,00 $ |
| 120 revisioni di codice, 80.000 in e 12.000 out compreso il ragionamento | 9,6 milioni in, 1,44 milioni out | 1,68 $ | 33,60 $ |
Il primo e il terzo caso dicono la stessa cosa: quando la bolletta sta sotto i 40 $ al mese, tra i due modelli ballano poche decine di dollari, e pesa di più la qualità del risultato. Lì si sceglie su quella. Il secondo caso è quello in cui il listino decide davvero: in un anno fanno circa 200 $ con Luna e quasi 4.000 $ con Sol, per un lavoro che Luna è costruito per fare.
Due correzioni avvicinano gli esempi al conto reale. Le istruzioni fisse ripetute a ogni chiamata, in cache, costano un decimo del prezzo d'ingresso, secondo la scheda di Luna. Lo sforzo alzato aggiunge token di ragionamento all'uscita. Con Luna i due effetti spostano centesimi, con Sol decine di dollari.
Il lavoro di una PMI, diviso tra Luna e Sol
La tabella parte dai lavori, non dai modelli. La colonna di destra dice quale segnale, misurato sui tuoi casi, giustifica un cambio.
| Lavoro | Parti da | Quando cambiare |
|---|---|---|
| Estrarre campi da fatture, DDT e ordini | Luna | Sol se sbaglia le scansioni storte o i formati mai visti |
| Riassumere mail, ticket e verbali | Luna | Sol se perde il dettaglio che decide, una data o un importo |
| Classificare e smistare le richieste in arrivo | Luna | Sol se troppe richieste finiscono nella coda sbagliata |
| Rispondere a domande sui tuoi documenti | Luna | Sol se mescola due documenti o aggiunge dettagli |
| Tradurre e adattare schede prodotto | Luna | Sol se la terminologia tecnica va corretta a mano |
| Rivedere il codice prima del merge | Sol | Luna solo per i controlli di stile |
| Sviluppare funzionalità e fare debug | Sol | mai: un bug costa più del risparmio |
| Analisi che incrociano più fonti, report per la direzione | Sol | Luna se il report è sempre lo stesso |
| Agente che lavora tra CRM, gestionale e posta | Sol per decidere, Luna per i passaggi semplici | Luna su ogni passaggio che supera la prova |
Un distributore di materiale elettrico con 150 ordini al giorno. Pensa a un'azienda che riceve ordini via mail, metà in PDF e metà scritti nel messaggio. Luna legge ogni ordine e compila codici, quantità e date di consegna nel gestionale. Gli ordini con un codice assente dal listino o una quantità fuori scala vanno in una coda a parte, dove Sol li confronta con lo storico del cliente e propone la correzione a chi approva. La prima metà del flusso si vede nella demo di data entry automatico.
Una software house di sei persone. Qui il rapporto si ribalta. Sol lavora in Codex su funzionalità nuove e revisioni prima del merge, dove un bug sfuggito costa più del consumo di un mese. Luna fa il contorno: riassume le issue aperte, scrive le note di rilascio, genera dati di prova. I dettagli sono in Codex con GPT-6 Sol e Luna.
Quando Luna non basta, e come accorgersene prima
Serve una prova breve sui tuoi casi peggiori. Prendi trenta casi reali per flusso, con le scansioni storte e le mail scritte di fretta, e fai girare Luna con le istruzioni di produzione. Poi alza lo sforzo e ripeti: solo quello che resta sbagliato è materia per Sol.
Resta su Luna se
- gli errori sono rari e si vedono in un controllo a campione
- alzando lo sforzo a high gli errori residui spariscono
- quando un'informazione manca, il modello lo dice invece di inventarla
- il compito è sempre lo stesso e il volume è alto
Passa a Sol se
- gli errori restano anche a sforzo max e toccano i casi che contano
- il compito chiede di collegare informazioni da più fonti
- serve scrivere o modificare codice che andrà in produzione
- un errore non visto costa più di un mese di consumo
C'è una terza strada, spesso la più economica: Luna fa il grosso e passa a Sol solo i casi incerti. Qui funziona bene perché i due modelli condividono contesto, API e strumenti, quindi spostare un passaggio non cambia l'architettura: lo schema è in strategia a modello misto. Se nemmeno Sol basta, sopra c'è GPT-6 Astra, il modello migliore di OpenAI, confrontato con il rivale diretto in GPT-6 Astra vs Fable 5.1.
Cinque sbagli che gonfiano il conto
- Mettere Sol ovunque per prudenza. Su estrazione e riassunti paghi venti volte tanto per un margine che nei tuoi casi potrebbe non esserci.
- Confrontare i due modelli a sforzi diversi. Luna a none contro Sol a medium è un test sullo sforzo, non sui modelli. Fissa lo stesso livello e alzalo solo su quello che perde.
- Dimenticare i token di ragionamento. Si pagano come output anche se non compaiono nella risposta: misurali sui tuoi casi prima del preventivo.
- Superare i 272.000 token senza accorgersene. Un allegato di troppo e tutta la richiesta passa al prezzo del contesto lungo. Con documenti enormi manda solo le parti utili.
- Provare solo su documenti puliti. La distanza tra i due modelli si vede su scansioni, tabelle spezzate e richieste ambigue. Sono quelli da mettere nella prova.
Sol o Luna: la regola da portarti via
Luna per quello che si ripete e si controlla, Sol per quello che va ragionato e poi firmato. Con lo stesso contesto, gli stessi strumenti e un prezzo venti volte diverso, la domanda utile non è quale dei due sia migliore, ma quanti dei tuoi passaggi possono scendere a Luna senza perdere qualità. La risposta arriva da una prova sui tuoi casi, non dal listino.
Se valuti anche l'alternativa di Anthropic uscita lo stesso giorno, il confronto è in GPT-6 Sol vs Claude Opus 5.5. E se vuoi mettere Luna e Sol al posto giusto dentro un flusso che esiste già, ordini, ticket o revisioni di codice, con Giallo Studio partiamo dai tuoi documenti veri e misuriamo prima di decidere.
Come lo applichiamo in azienda
Risorse correlate
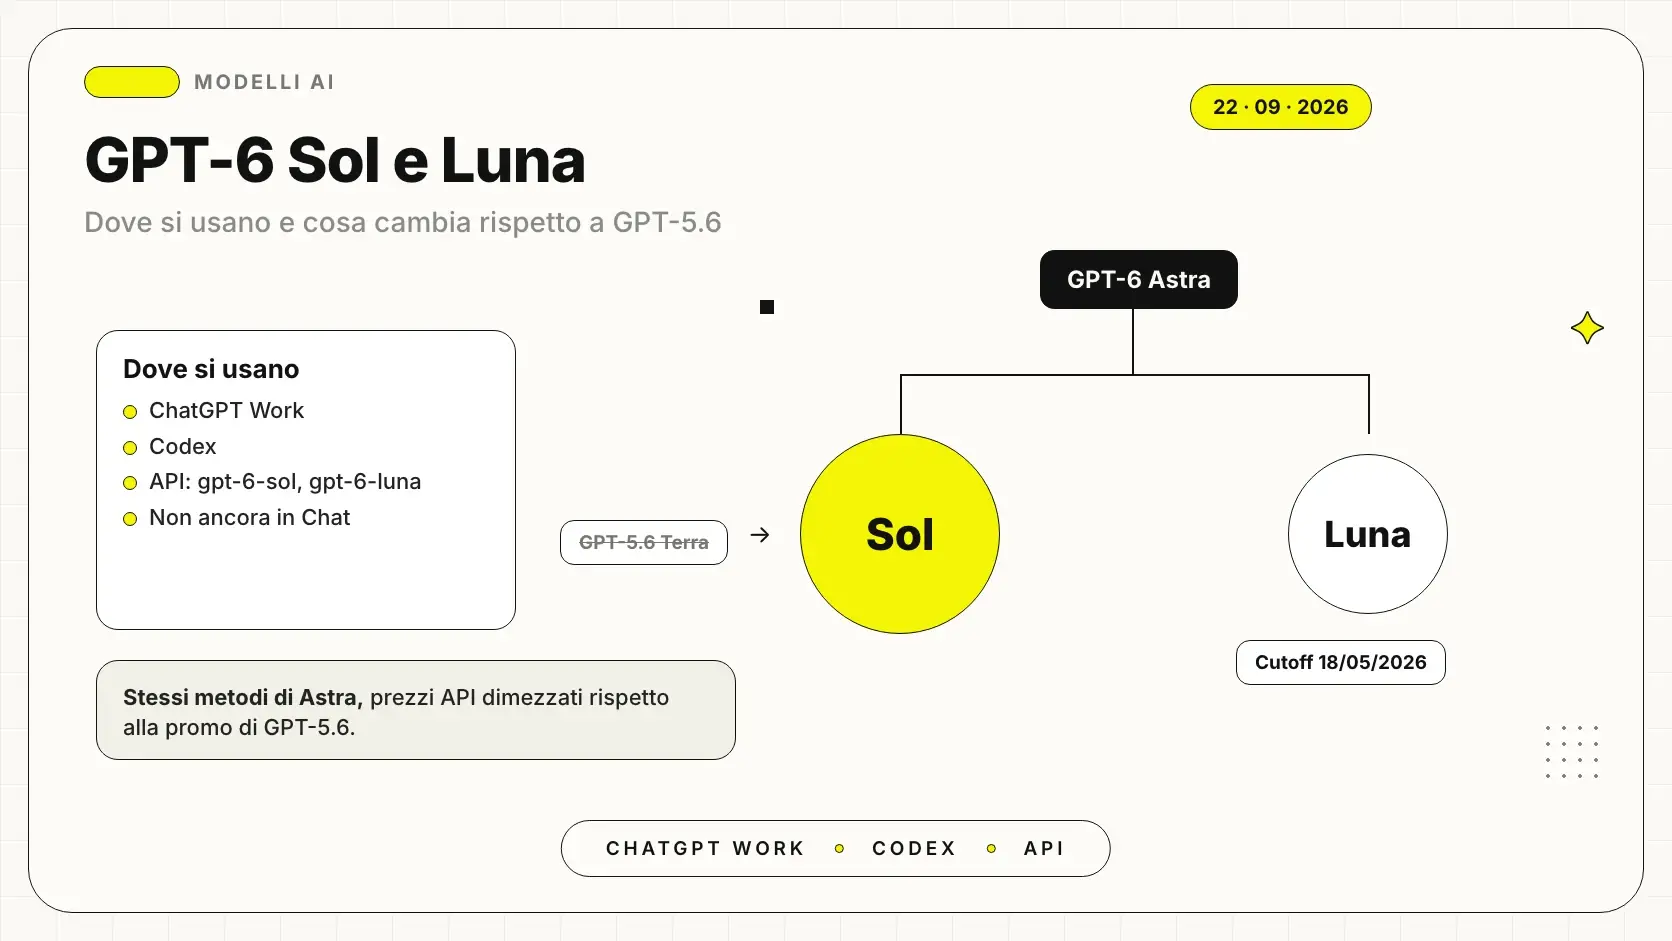 GPT-6 Sol e Luna: cosa sono, dove si usano e cosa cambia
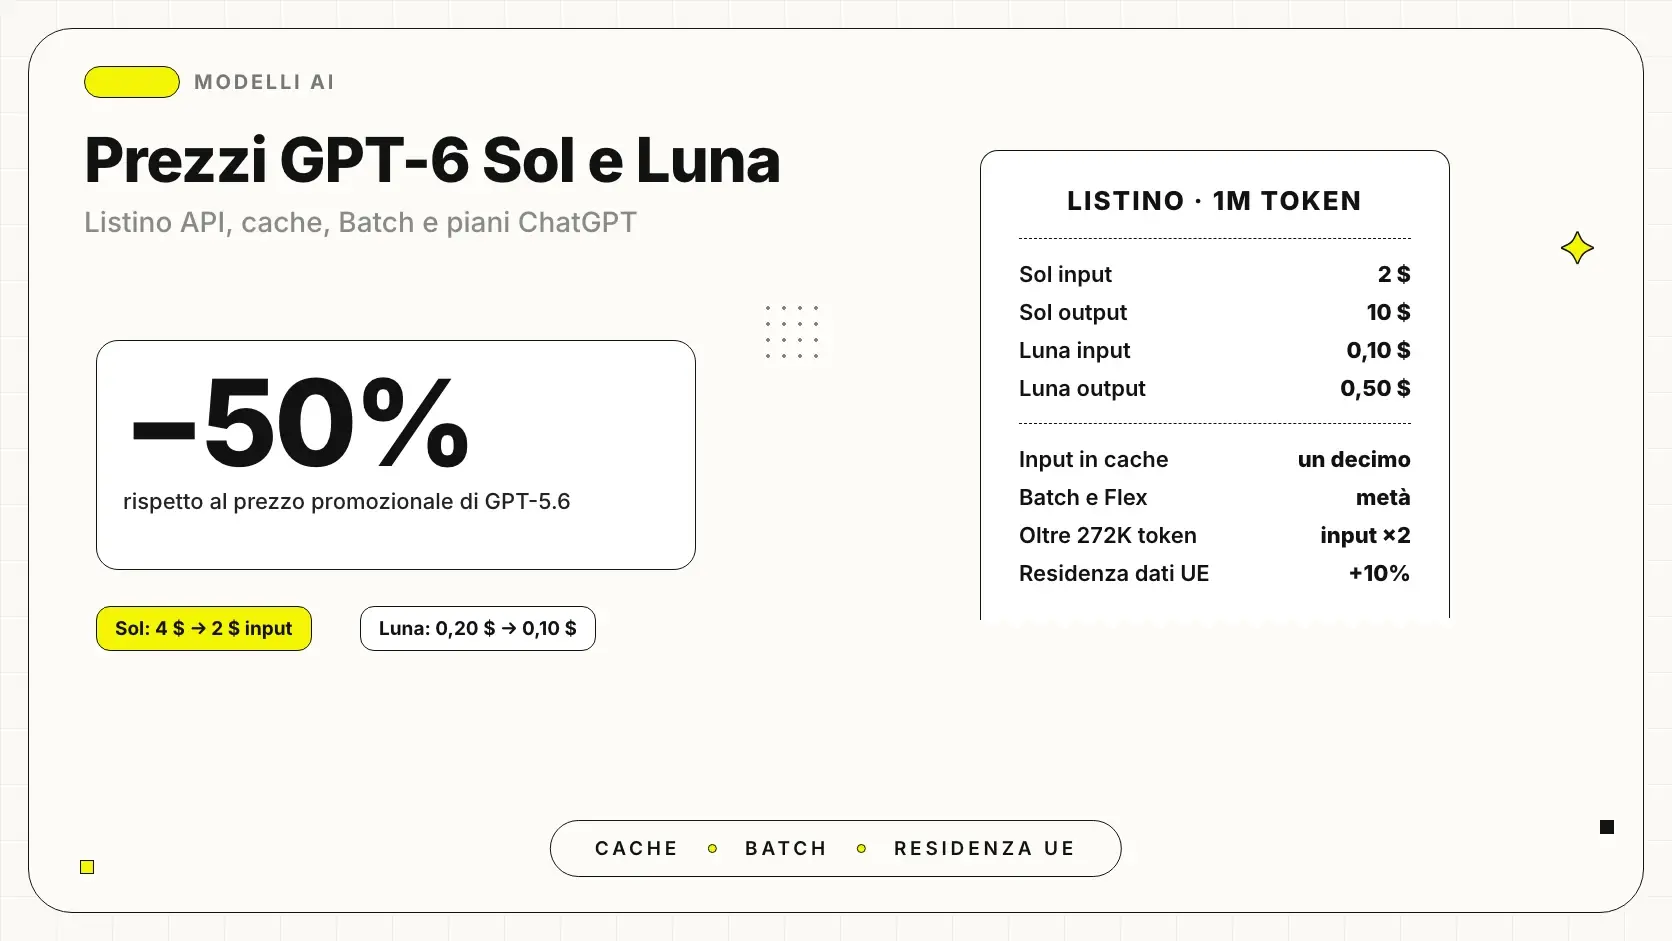 Prezzi GPT-6 Sol e Luna: listino API, conti di esempio e piani ChatGPT
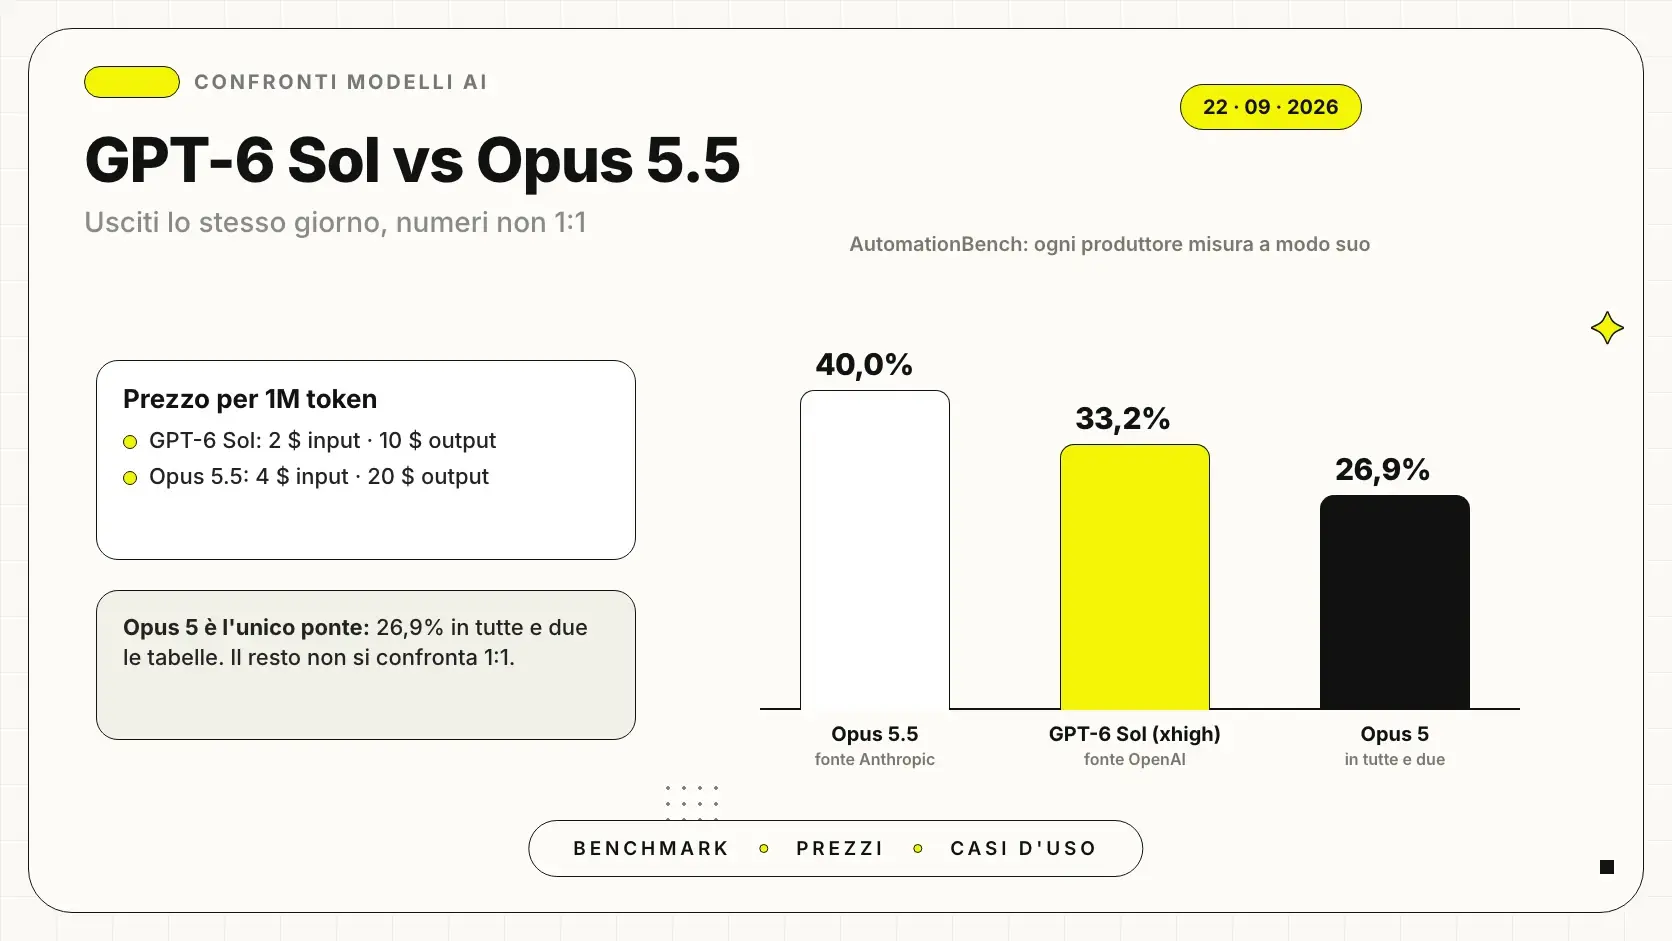 GPT-6 Sol vs Claude Opus 5.5: i numeri ufficiali e quando usare quale
 Strategia a modello misto: leggero e potente
 Claude Haiku 4.5 vs GPT-5.6 Luna
 GPT-5.6 Sol vs Terra: quale conviene
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- GPT-6 Sol vs Claude Opus 5.5: i numeri ufficiali e quando usare quale
- Claude Haiku 4.5 vs Gemini Flash-Lite
- GPT-6 Astra vs GPT-5.6 Sol
- Claude Haiku 4.5 vs GPT-5.6 Luna
- GPT-6 Astra vs Claude Fable 5.1
- Make vs Zapier vs n8n: quale scegliere per la tua azienda
- GPT-5.6 Sol vs Terra: quale conviene
- Mistral vs Llama: confronto tra i due modelli a pesi aperti
- Gemini vs Copilot: quale scegliere
- Claude Opus 5 vs Fable 5.1
- Gemini Advanced vs ChatGPT Plus
- Claude Opus 5 vs Gemini 3.1 Pro
FAQ
Che differenza c'è tra GPT-6 Sol e GPT-6 Luna?
Hanno la stessa finestra di contesto da 1.050.000 token, lo stesso output massimo da 128.000 token e gli stessi livelli di ragionamento. Cambiano capacità e prezzo: OpenAI presenta Sol per il codice complesso e i flussi agentici, Luna per compiti mirati ad alto volume, a un prezzo per token venti volte più basso.
Quanto costano GPT-6 Sol e GPT-6 Luna via API?
Sol costa 2 dollari per milione di token in ingresso e 10 in uscita, Luna 0,10 e 0,50, per richieste fino a 272.000 token di input. Sopra quella soglia l'intera richiesta si paga il doppio in ingresso e una volta e mezza in uscita, con lo stesso rapporto di venti a uno tra i due modelli.
Perché GPT-6 Luna ha una data di conoscenza più recente di Sol?
Le schede ufficiali indicano il 18 maggio 2026 per Luna e il 20 aprile 2026 per Sol, e OpenAI non spiega il motivo. Per una PMI conta poco: sui fatti recenti conviene comunque dare al modello i documenti giusti o attivare la ricerca web.
GPT-6 Luna va bene per programmare?
Per compiti circoscritti sì. Su DeepSWE v1.1, l'unico test in cui OpenAI scrive un punteggio per entrambi, Luna resta a poco più di due punti da Sol, tutti e due allo sforzo massimo. Per il codice complesso e i flussi agentici OpenAI indica Sol.
Conviene partire da Luna o da Sol?
Da Luna quando il risultato si controlla in fretta: estrarre campi, riassumere, classificare. Si passa a Sol solo per i casi che Luna sbaglia anche con più ragionamento. Per codice e analisi complesse vale il contrario: si parte da Sol e si prova Luna sui passaggi semplici.
Si possono usare GPT-6 Sol e Luna insieme?
Sì, ed è spesso la scelta più economica. Luna smista, estrae e prepara, Sol interviene sui casi incerti o sulla verifica finale. Avendo la stessa finestra di contesto e gli stessi strumenti, spostare un passaggio dall'uno all'altro non richiede di cambiare architettura.
GPT-6 Sol e Luna sono disponibili in ChatGPT?
Sì, in ChatGPT Work e in Codex per gli abbonamenti Plus, Pro, Business, Enterprise ed Edu. Con i piani Free e Go si trova solo Luna, nell'app desktop. Via API gli identificativi sono gpt-6-sol e gpt-6-luna.