
Gemini 4 Carbon vs GPT-6 Astra e Claude: quale scegliere per ogni attività
Gemini 4 Carbon vs GPT-6 Astra, Opus 5.5 e Fable 5.1: chi è in testa per coding, agenti, automazioni, documenti, sicurezza e costo, con margini e limiti.
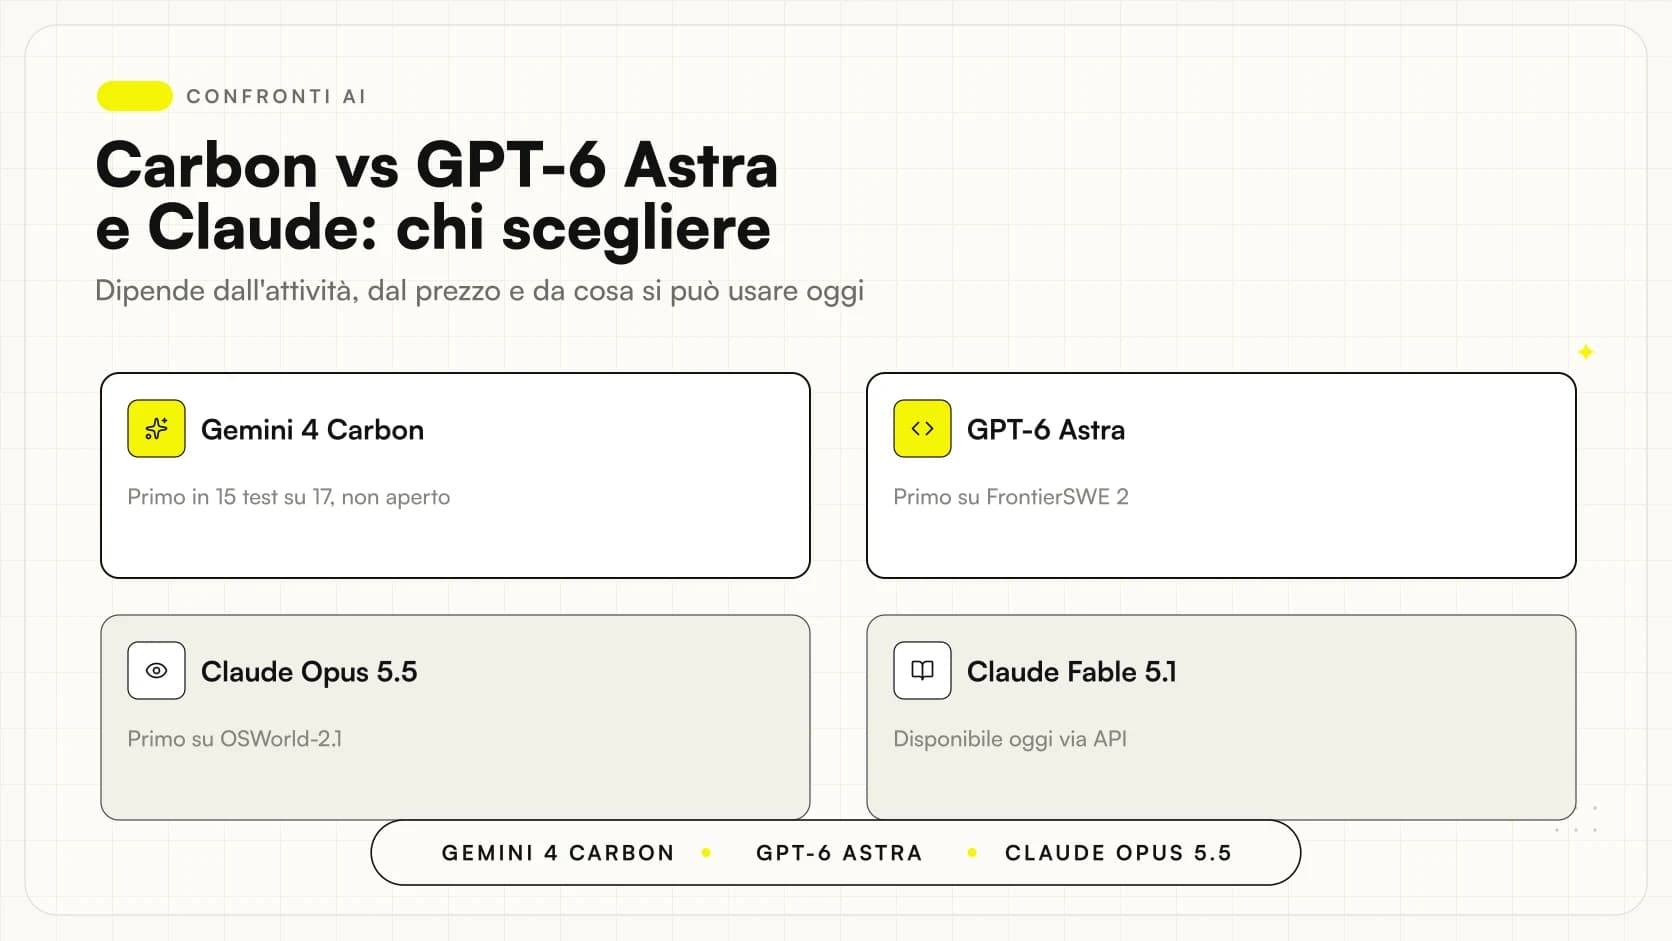
Nel confronto Gemini 4 Carbon vs GPT-6 Astra, Claude Opus 5.5 e Claude Fable 5.1 la risposta cambia con il tipo di lavoro, e oggi cambia soprattutto per una ragione concreta: Carbon non si può ancora usare. Nella tabella pubblicata da Google il 28 ottobre 2026 il modello è primo in 15 dei 17 test, ma non su FrontierSWE 2, dove è primo GPT-6 Astra, e non su OSWorld-2.1, dove è primo Claude Opus 5.5.
Questa guida non fa una classifica generale: scompone la tabella per attività e per ognuna dice chi è in testa, di quanto e con quale limite. Poi mette accanto disponibilità e prezzo, che per una PMI pesano quanto i punteggi.
Per la panoramica parti da che cos'è Gemini 4 Carbon; per la tabella completa c'è il confronto benchmark. Qui l'obiettivo è decidere quale modello mettere alla prova per quale lavoro.
In sintesi
- Gemini 4 Carbon al 28 ottobre 2026 non è utilizzabile da aziende e sviluppatori: Google lo apre prima ai difensori informatici e poi ai partner Fairwind, senza data per gli altri.
- Nei numeri Google Carbon è primo in 15 test su 17, ma non su FrontierSWE 2 (primo GPT-6 Astra) e su OSWorld-2.1 (primo Claude Opus 5.5).
- I margini più larghi di Carbon sul secondo classificato sono su ExploitGym (12,4 punti su Astra) e GraphWalks (12,0 su Argon), seguiti da Terminal-Bench 4.0 (5,6 su Opus 5.5); i più stretti sono sotto un punto.
- Carbon costa, secondo Google, 2 e 10 dollari per milione di token nel periodo introduttivo, poi 4 e 20; Opus 5.5 costa 4 e 20; Astra e Fable 5.1 costano 10 e 50.
- Per scegliere oggi si prova su casi propri tra i modelli disponibili, scrivendo la prova in modo da poter aggiungere Carbon quando arriverà.
Gemini 4 Carbon vs GPT-6 Astra: chi è in testa in ogni attività?
La tabella ordina per tipo di lavoro i test della valutazione di Google, «as of October, 2026». Il margine è la differenza in punti con il secondo classificato tra Carbon, Gemini 4 Argon, GPT-6 Astra, Claude Opus 5.5 e Claude Fable 5.1; la sottrazione è nostra.
| Attività (test) | In testa | Margine | Nota |
|---|---|---|---|
| Coding su repository (SWE-sweep) | Carbon 9,6% | 0,1 punti su Astra (9,5%) | Quasi un pareggio; fonti diverse |
| Coding su repository (FrontierSWE 2) | Astra 65,5% | 3,2 punti su Opus 5.5 (62,3%) | Carbon terzo con 61,2%; leaderboard Proximal |
| Coding da terminale (Terminal-Bench 4.0) | Carbon 65,2% | 5,6 punti su Opus 5.5 (59,6%) | Misura di Artificial Analysis, non di Google |
| Agenti che usano il computer (OSWorld-2.1) | Opus 5.5 87,2% | 5,7 punti su Carbon (81,5%) | Sottoinsieme offline di 82 compiti |
| Agenti su compiti lunghi (Agents' Last Exam v1.1) | Carbon 77,4% | 4,3 punti su Astra (73,1%) | Fable 5.1 assente; compiti del 17/10/2026 |
| Automazioni d'ufficio (AutomationBench) | Carbon 53,9% | 2,6 punti su Argon (51,3%) | Set privato Zapier |
| Documenti lunghi (GraphWalks, 256k–1M token) | Carbon 96,2 | 12,0 punti su Argon (84,2) | Calcolato da Google per tutti i modelli |
| Grafici (Chartography) | Carbon 72,5% | 0,9 punti su Argon (71,6%) | Test senza strumenti; margine minimo |
| Disegni tecnici (Blueprint-Bench 2) | Carbon 58,6 | 4,2 punti su Argon (54,4) | Punteggio di somiglianza; leaderboard Andon Labs |
| Sicurezza del codice (CWE-bench, ExploitGym) | Carbon 71,0% e 54,8% | 3,0 punti su Astra e Argon (CWE-bench); 12,4 su Astra (ExploitGym) | Cybersecurity valutata «senza guardrail» |
| Costo per milione di token | Nessun primo assoluto | Carbon 2 $ / 10 $ introduttivo, poi 4 $ / 20 $ | Prezzo di Carbon non ancora in listino API |
Nelle classifiche generali i margini sono minimi: l'Artificial Analysis Intelligence Index v5.0 vede Carbon a 59, Opus 5.5 a 58 e Astra a 57, mentre su Vals Index v2.2 Carbon ha 70,4% e Opus 5.5 70,2%. Una differenza di 0,2 punti non è una ragione per cambiare fornitore. Claude Fable 5.1 non è mai primo nella tabella e su quattro test non ha il dato: descrive i test scelti da Google, non la sua utilità per il tuo lavoro.
Quale modello si può usare davvero oggi?
Al 28 ottobre 2026 Gemini 4 Carbon non è disponibile per aziende e sviluppatori. Secondo l'annuncio di Google, dalla settimana dell'annuncio l'accesso va a un sottoinsieme di difensori informatici; poi, gradualmente, ad altri partner fidati tramite il Fairwind Program. Per sviluppatori, aziende e consumatori Google scrive «il prima possibile» e «presto», senza una data.
Google non ha pubblicato l'ID del modello nell'API, la finestra di contesto, i limiti di output, i paesi né la presenza in Gemini app, AI Studio o Vertex AI, e il listino Gemini API non elenca Carbon (elenca Argon). Una PMI italiana non può ancora fare un contratto o un test; la stima di costo resta provvisoria.
GPT-6 Astra, Claude Opus 5.5, Claude Fable 5.1 e Gemini 4 Argon hanno invece un prezzo a listino e si possono usare. Scrivi oggi la prova sui tuoi casi, eseguila sui modelli disponibili e tienila pronta per Carbon. Se ti chiedi se valga la pena aspettare, leggi il confronto tra Carbon e Argon.
Per il coding su repository vince Carbon o Astra?
Su SWE-sweep Carbon ottiene 9,6% e Astra 9,5%: 0,1 punti, nella pratica un pareggio, e con condizioni diverse, perché Carbon è calcolato da Google con harness mini-swe-agent mentre i concorrenti vengono dalla leaderboard pubblica, come indica la metodologia Google. Su FrontierSWE 2 l'ordine cambia: Astra 65,5%, Opus 5.5 62,3%, Carbon 61,2%, Fable 5.1 56,3%, Argon 55,0%. Su Terminal-Bench 4.0, misurato da Artificial Analysis, Carbon torna primo con 65,2% contro 59,6% di Opus 5.5 e 59,1% di Astra.
Un modello primo in due test su tre non è «il migliore nel coding»: conta quanto il tuo lavoro somiglia al test. Chi ha un repository grande può già oggi confrontare Astra e Opus 5.5 sulle proprie issue; le guide a GPT-6 Astra per programmare e a Claude Opus 5.5 con Claude Code aiutano a impostare la prova.
Per gli agenti che usano il computer serve Carbon o Opus 5.5?
Su OSWorld-2.1, un sottoinsieme offline di 82 compiti, il primo è Claude Opus 5.5 con 87,2%; Carbon è secondo con 81,5% e Astra terza con 80,9%. Il vantaggio di Opus 5.5 è di 5,7 punti, e le condizioni non coincidono: per Carbon e Argon Google riporta il massimo su tre esecuzioni, mentre i concorrenti vengono dalle loro pubblicazioni (metodologia).
Su Agents' Last Exam v1.1 Carbon è primo con 77,4%, davanti ad Astra (73,1%); Fable 5.1 non ha il dato. Google l'ha calcolato su 122 compiti, finestra di cinque ore, versione dei compiti del 17 ottobre 2026 senza l'aggiornamento del 26 ottobre. Il segnale favorisce Carbon, ma su un campione piccolo e con una versione già superata. Un agente che clicca e compila va comunque limitato: agenti AI e automazioni con Argon spiega come separare proposta ed esecuzione.
Per automazioni d'ufficio e documenti lunghi, quanto pesa il vantaggio di Carbon?
Su AutomationBench, il set privato della leaderboard Zapier, Carbon ha 53,9%, Argon 51,3%, Opus 5.5 42,5% e Astra 41,4%: il margine sul secondo classificato, Argon, è di 2,6 punti. Su Vending-Bench 2, saldo bancario in dollari, Carbon arriva a 16.484 contro 15.515 di Astra e 9.235 di Opus 5.5 (Google).
Su AutomationBench il secondo posto è di Gemini 4 Argon, che si può usare ora, con prezzo uguale a quello introduttivo di Carbon; per Argon la promozione vale fino al 30 novembre 2026 secondo il listino Google: un banco di prova ragionevole per smistare email o preparare preventivi.
Sui documenti lunghi il margine è uno dei due più ampi della tabella (12,0 punti; ExploitGym 12,4). Su GraphWalks (256k–1M token) Carbon ottiene 96,2, Argon 84,2, Astra 71,8, Opus 5.5 66,8 e Fable 5.1 65,0, e Google lo ha calcolato per tutti i modelli, quindi il confronto è omogeneo. I limiti sono due: è un sottoinsieme di 200 problemi, non la lettura di un contratto, e Google non ha pubblicato la finestra di contesto di Carbon. Per documenti reali vedi Claude Opus 5.5 per controllare documenti.
Grafici, disegni tecnici e sicurezza del codice: dove il margine è reale?
Su Chartography, test senza strumenti, Carbon ha 72,5%, Argon 71,6% e Astra 71,0%: 0,9 punti non bastano per un vincitore, mentre Fable 5.1 è molto indietro con 46,2% (Google). Su Blueprint-Bench 2, punteggio di somiglianza, Carbon ha 58,6 contro 54,4 di Argon. Dal nome riguarda i disegni tecnici: controlla il compito esatto sulla leaderboard di Andon Labs prima di fidarti.
Sulla sicurezza del codice il margine è netto: Carbon ha 71,0% su CWE-bench (68,0% per Argon e Astra), 54,8% su ExploitGym (42,4% per Astra) e 88,2% su SEC-bench Pro (85,4% per Astra, senza dato per Opus 5.5 e Fable 5.1). Google precisa nell'annuncio che questi benchmark sono valutati senza guardrail, cioè senza le protezioni dell'uso reale, e riguardano chi lavora sulla difesa informatica, il gruppo a cui Carbon è aperto oggi. Il lato sicurezza è nell'articolo su Gemini 4 Carbon e cybersecurity.
Quanto costa ogni modello e perché il prezzo di Carbon è provvisorio?
Il prezzo conta quanto il punteggio, perché un'automazione consuma milioni di token. La tabella riporta i prezzi per milione di token dai listini ufficiali (Google, Anthropic, OpenAI), verificati il 28 ottobre 2026, per l'uso standard.
| Modello | Input | Output | Input in cache | A listino il 28/10/2026 |
|---|---|---|---|---|
| Gemini 4 Carbon, periodo introduttivo | 2 $ | 10 $ | 0,10 $ (calcolo nostro, sconto 95%) | No: non compare nel listino API |
| Gemini 4 Carbon, dopo l'introduttivo | 4 $ | 20 $ | 0,20 $ se lo sconto resta del 95% (calcolo nostro; Google non l'ha precisato) | No: data di fine promo non dichiarata |
| Gemini 4 Argon, fino al 30/11/2026 | 2 $ | 10 $ | 0,10 $ | Sì |
| Gemini 4 Argon, dal 1/12/2026 | 4 $ | 20 $ | 0,20 $ | Sì |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ | Sì |
| GPT-6 Astra (fino a 272K token) | 10 $ | 50 $ | 1 $ | Sì |
| Claude Fable 5.1 | 10 $ | 50 $ | 0,25 $ | Sì |
| Claude Sonnet 5.5; GPT-6.1 Sol (fino a 272K token) | 2 $ | 10 $ | 0,10 $ | Sì |
Google ha detto nell'annuncio che il prezzo introduttivo di Carbon finirà, ma non quando. La data del 30 novembre 2026 vale per Argon e non va trasferita a Carbon. Oltre i 272K token in input, Astra passa a 20 $ in input e 75 $ in output secondo il listino OpenAI.
Scenario ipotetico: un'automazione che consuma 50 milioni di token in input e 5 milioni in output al mese, senza cache. Con prezzi 2/10 il costo mensile è di 150 dollari; con 4/20 (Carbon dopo l'introduttivo, Opus 5.5) è di 300 dollari; con 10/50 (Astra, Fable 5.1) è di 750 dollari. Il calcolo è nostro, parte dai listini ufficiali e non conta i token di ragionamento, che nel listino Argon si fatturano come output. Dettagli in prezzi GPT-6 Astra, Opus 5.5 tra benchmark e prezzi e prezzi e costi API di Carbon.
Quando aspettare Carbon e quando non conviene?
Quando conviene aspettare Carbon
- Il tuo lavoro è su documenti molto lunghi o automazioni a molti passaggi, dove Carbon è primo in tabella (con margine ampio sui documenti lunghi).
- Non hai urgenza e intanto puoi lavorare con Argon, della stessa famiglia.
Quando non conviene aspettare
- Il processo deve partire entro poche settimane: Google non ha dato una data per le aziende.
- Il tuo caso somiglia a FrontierSWE 2 o OSWorld-2.1, dove Carbon non è primo.
- Ti servono paesi, contesto e limiti di output, oggi non pubblicati.
Quali domande ti fanno scegliere il modello giusto?
- Il compito somiglia a un test pubblicato o è diverso?
- Quale errore blocca il lavoro anche se il resto è corretto?
- Il modello è disponibile per te oggi, nel tuo paese e con un contratto?
- Quanti token consuma il processo in un mese e a che prezzo, anche dopo l'offerta introduttiva?
- Quali dati può ricevere il modello e chi controlla il risultato?
- Puoi cambiare modello senza riscrivere tutto, tenendo i casi di prova?
Per un metodo più generale c'è la guida a come scegliere un modello AI; per il confronto prima di Carbon, Gemini 4 Argon vs ChatGPT e Claude.
Come cambierebbe la scelta per una software house e per uno studio di commercialisti?
Scenario ipotetico: una software house di sei persone con repository grandi. Il test usa venti issue già risolte, con la soluzione nascosta: Astra e Opus 5.5 vengono confrontati oggi, misurando patch accettate, correzioni richieste e costo. Carbon è un candidato per il terminale (Terminal-Bench 4.0) ma non un favorito su FrontierSWE 2: decide il campione, non il grafico.
Scenario ipotetico: uno studio di commercialisti che vuole automatizzare lo smistamento di documenti e la preparazione di schede. Qui contano AutomationBench e i documenti lunghi, dove Carbon è primo e Argon è secondo: 12,0 punti di margine su GraphWalks, 2,6 su AutomationBench. Lo studio parte con Argon su documenti ripuliti, con un responsabile che controlla ogni scheda, e scrive la prova in modo da sostituire il modello in seguito. Le automazioni di processo vanno progettate con permessi minimi: il modello propone, una persona conferma.
Quali errori evitare quando si confrontano questi modelli?
- Leggere un solo test come verdetto. Carbon è primo in 15 test su 17 nella tabella Google, ma i due in cui non lo è coincidono con coding agentico e computer use, due lavori centrali per gli agenti.
- Confrontare margini minimi. 0,1 punti su SWE-sweep, 0,2 su Vals Index e 0,9 su Chartography (dati Google) non indicano un vantaggio utile.
- Scegliere sul prezzo introduttivo. Il 2 $ / 10 $ di Carbon non ha una data di fine dichiarata nell'annuncio: il conto va fatto anche con 4 $ / 20 $.
Come impostare la scelta senza aspettare Carbon?
La strada più solida è piccola: un processo reale, venti casi ripuliti con la risposta attesa, una definizione di errore grave e due o tre modelli disponibili, compreso Argon. Conta anche la revisione umana, non solo i token. Quando Google aprirà Carbon alle aziende, ripeti la prova senza cambiare i criteri.
In sintesi: Carbon è un candidato molto forte sulla carta, ma oggi le scelte concrete sono Astra, Opus 5.5, Fable 5.1 e Argon, e nessun punteggio sostituisce una prova sui tuoi casi. Per Astra e Fable c'è GPT-6 Astra vs Claude Fable 5.1.
Se vuoi trasformare i tuoi processi in un campione verificabile, la consulenza AI di Giallo aiuta a scegliere casi, criteri e permessi; per agenti e integrazioni ci sono gli agenti AI, per il codice la software house. Per parlarne, contattaci.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Gemini 4 Carbon: cos’è, cosa dichiara Google e quando sarà disponibile
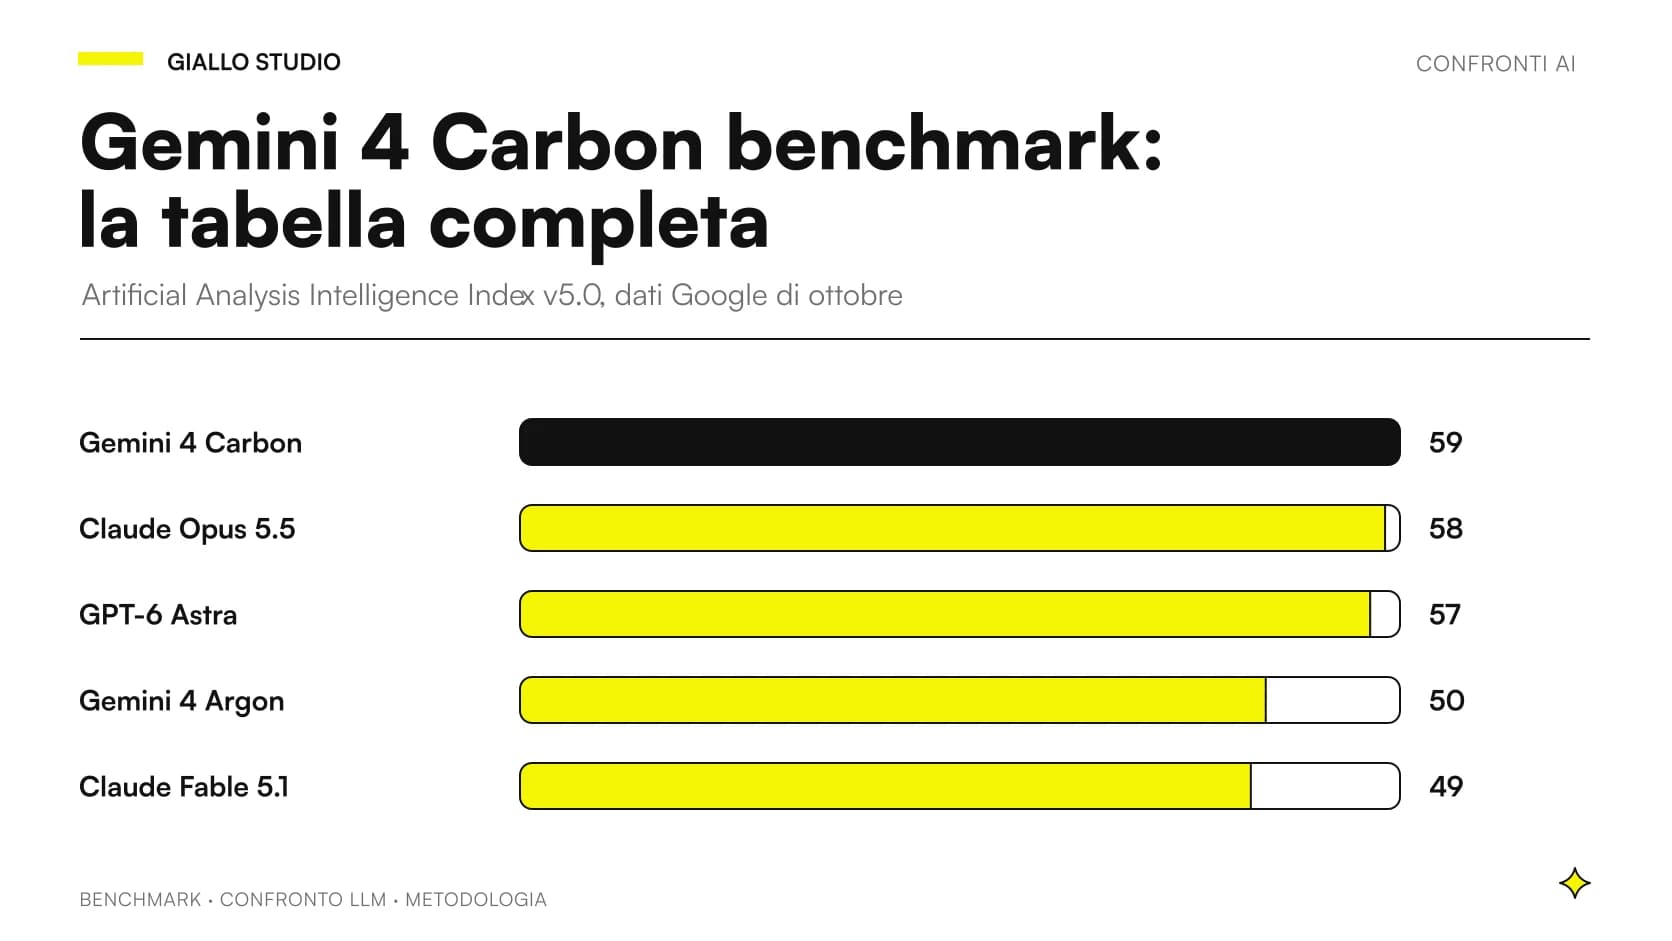 Gemini 4 Carbon benchmark: la tabella completa e come leggerla
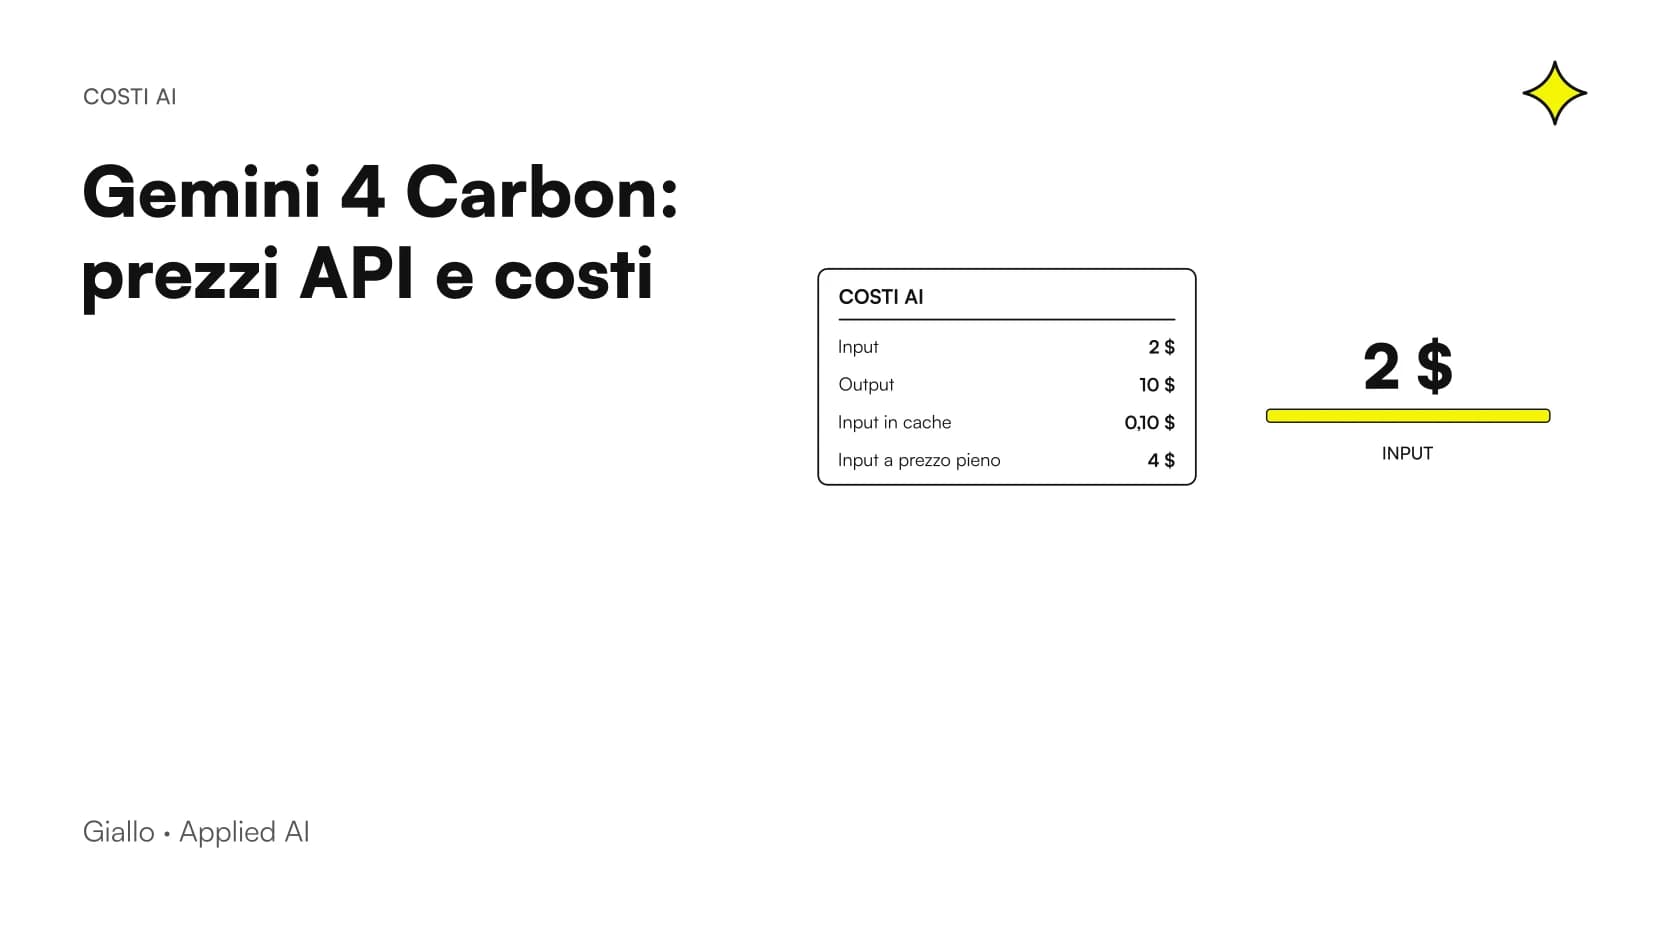 Gemini 4 Carbon: prezzi API, costo per milione di token e confronto
 Gemini 4 Carbon vs Argon: differenze e conviene aspettare?
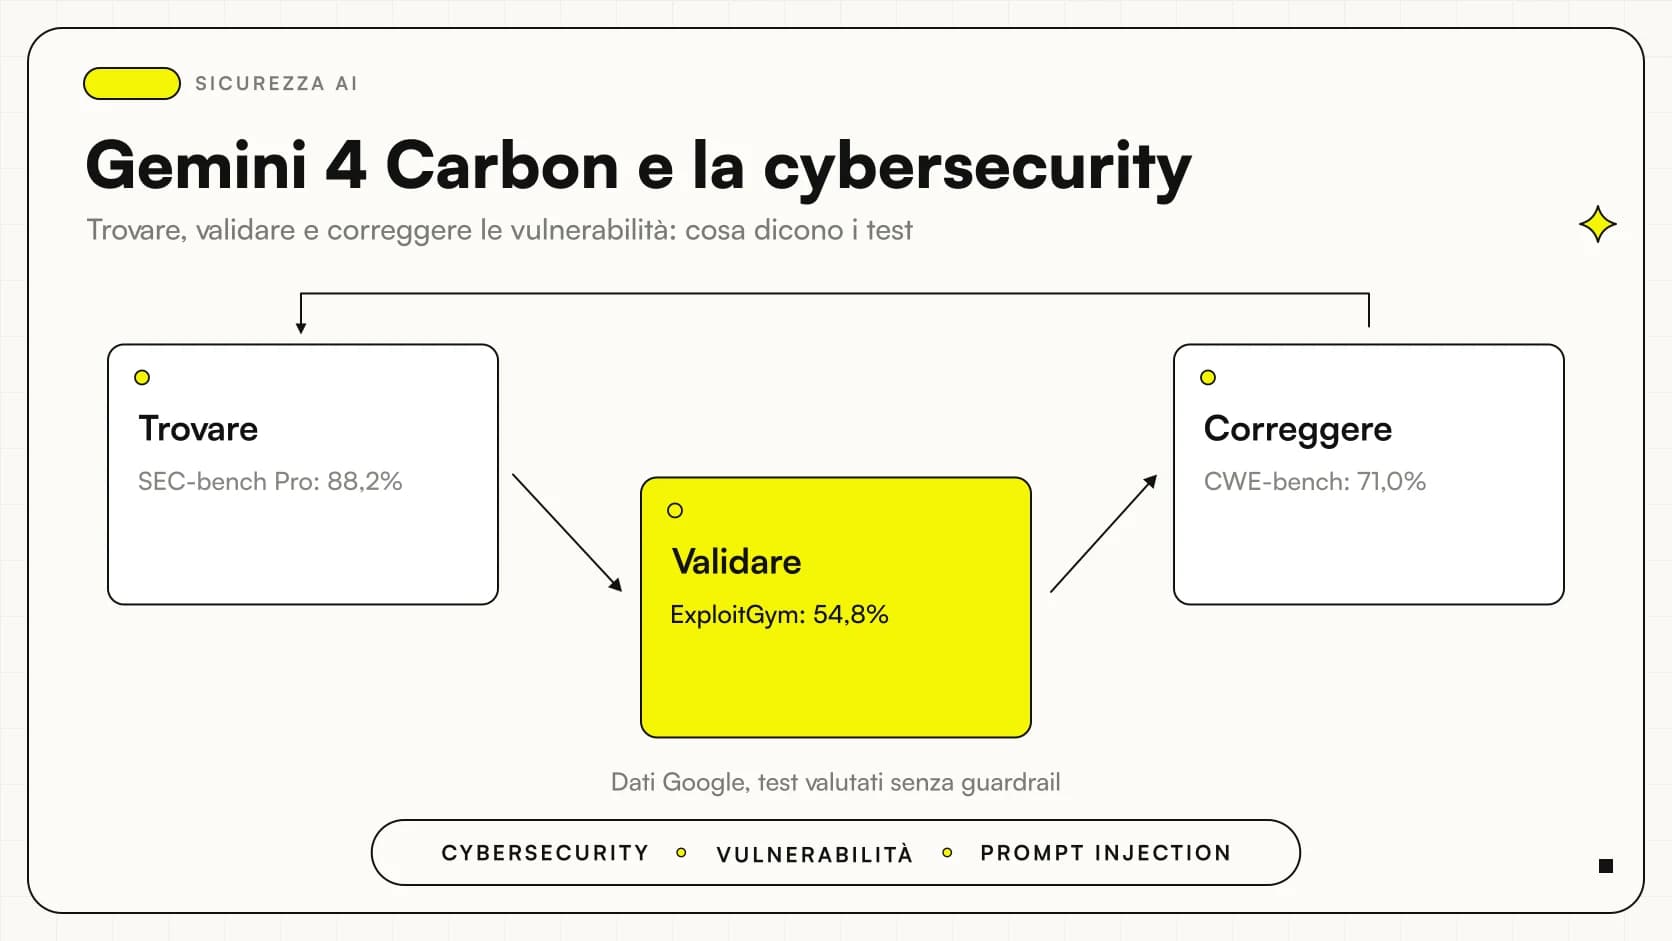 Gemini 4 Carbon cybersecurity: trovare, validare e correggere le vulnerabilità
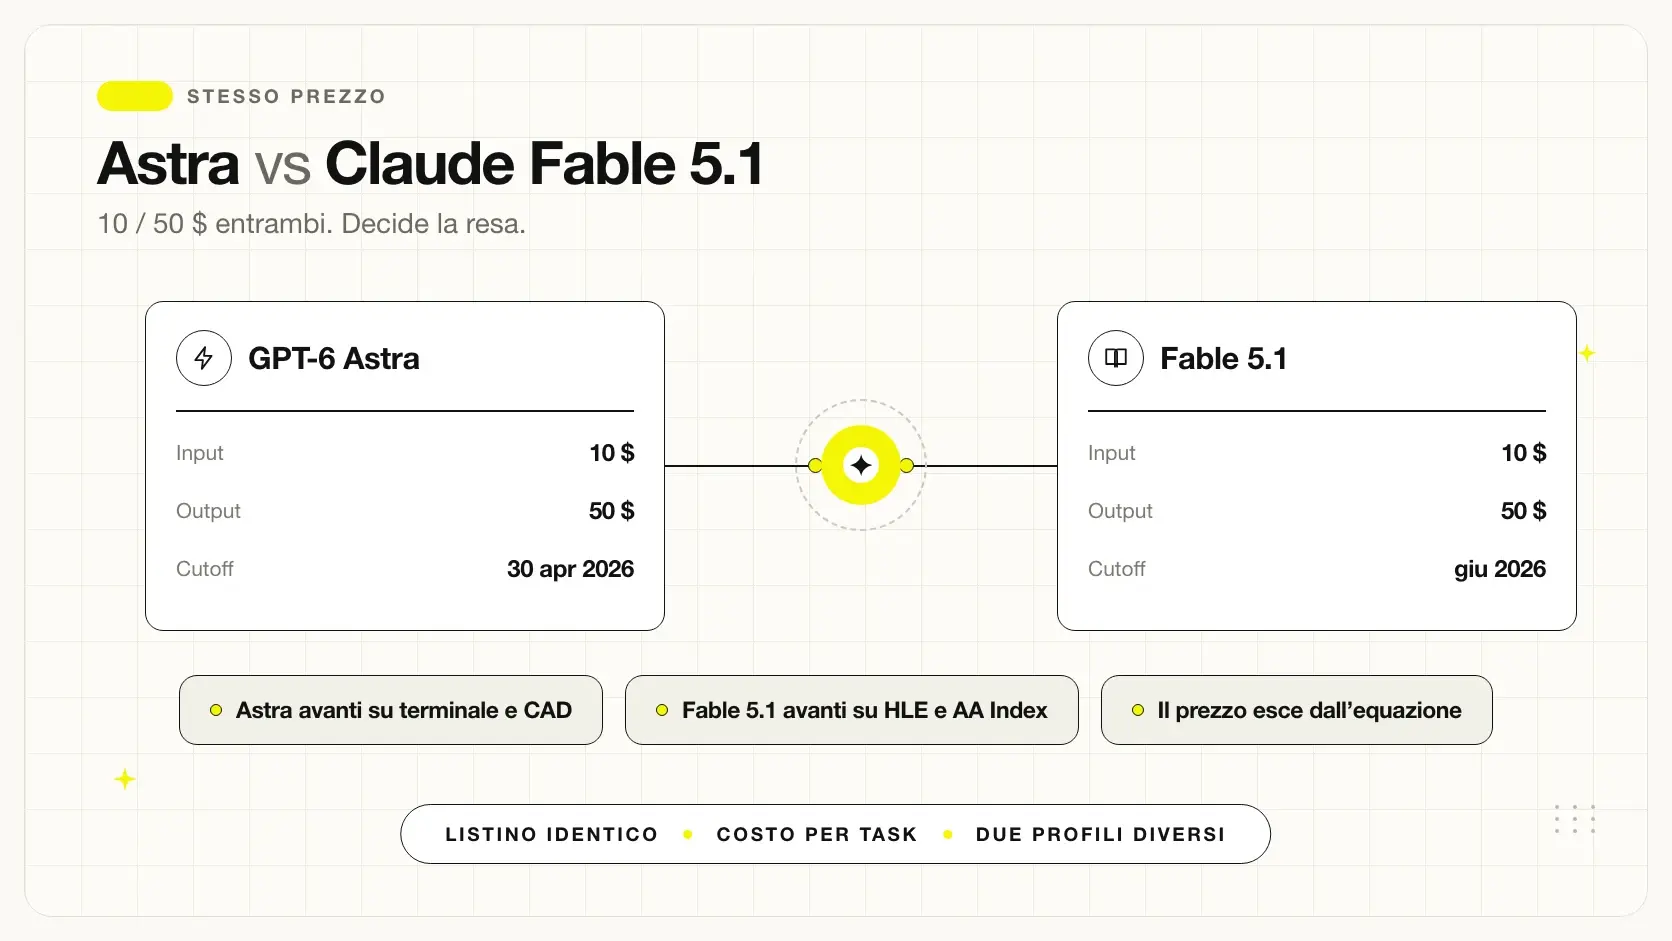 GPT-6 Astra vs Claude Fable 5.1
 Claude Opus 5.5: benchmark ufficiali, prezzi e confronto con Fable 5.1 e GPT-6 Astra
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Gemini 4 Carbon vs Argon: differenze e conviene aspettare?
- ChatGPT vs Gemini: quale abbonamento conviene a ottobre 2026
- Gemini 4 Argon vs ChatGPT e Claude: quale scegliere
- Gemini vs Copilot: quale scegliere
- Gemini 3.6 Flash vs 3.5 Flash
- Gemma 4 12B vs Ministral 3 14B: AI locale compatta
- Claude Fable 5.1 vs Sonnet 5
- GPT-5.6 Sol vs Terra: quale conviene
- DeepSeek R1 Distill 32B vs Qwen3.8-27B in locale
- GPT-6 Astra vs Claude Fable 5.1
- Claude vs Perplexity
- GPT-6 Astra vs GPT-5.6 Sol
FAQ
Gemini 4 Carbon è meglio di GPT-6 Astra?
Dipende dall'attività. Nella tabella pubblicata da Google il 28 ottobre 2026 Carbon è primo in 15 dei 17 test e davanti ad Astra in 16, ma su FrontierSWE 2 è primo GPT-6 Astra con 65,5% contro il 61,2% di Carbon. Su SWE-sweep la differenza è di 0,1 punti (9,6% contro 9,5%).
Gemini 4 Carbon è meglio di Claude Opus 5.5?
Nella tabella Google Carbon è davanti a Opus 5.5 in 14 dei 16 test in cui entrambi hanno un valore (su SEC-bench Pro Opus non ha dato il dato), ma Opus 5.5 è davanti su OSWorld-2.1 (87,2% contro 81,5%) e su FrontierSWE 2 (62,3% contro 61,2%). Su Vals Index la distanza è di appena 0,2 punti (70,4% contro 70,2%). Il confronto si basa su numeri pubblicati da Google, che per Opus 5.5 provengono dai fornitori o da leaderboard.
Quale modello AI scegliere oggi, 28 ottobre 2026?
Gemini 4 Carbon oggi non è utilizzabile da aziende e sviluppatori: Google lo apre prima ai difensori informatici e poi ai partner del Fairwind Program, senza data per tutti gli altri. Le scelte reali sono GPT-6 Astra, Claude Opus 5.5, Claude Fable 5.1 e Gemini 4 Argon. Conviene provarle sui propri casi, tenendo pronta la stessa prova per Carbon.
Quanto costa Gemini 4 Carbon rispetto a Opus 5.5 e Astra?
Carbon costa 2 dollari per milione di token in input e 10 in output nel periodo introduttivo, poi 4 e 20. Claude Opus 5.5 costa 4 e 20, GPT-6 Astra e Claude Fable 5.1 costano 10 e 50. Google non ha indicato quando finisce il periodo introduttivo di Carbon.
Per scrivere codice conviene Gemini 4 Carbon o GPT-6 Astra?
I numeri sono divisi: Carbon è primo su Terminal-Bench 4.0 con 65,2% e su SWE-sweep con 9,6%, Astra è primo su FrontierSWE 2 con 65,5%. Chi lavora su repository grandi dovrebbe provare entrambi sulle proprie issue. Carbon non è comunque disponibile per gli sviluppatori al 28 ottobre 2026.
Per gli agenti che usano il computer vince Carbon?
Non in tutto. Su Agents' Last Exam v1.1 Carbon è primo con 77,4%, ma su OSWorld-2.1 è secondo con 81,5% dietro Claude Opus 5.5 (87,2%). OSWorld-2.1 in questa tabella è un sottoinsieme offline di 82 compiti, quindi un campione piccolo.
Perché i numeri di Google vanno letti con prudenza?
Perché una parte dei numeri di Carbon e Argon è calcolata da Google con proprie impostazioni, mentre per gli altri modelli la tabella usa numeri dichiarati dai fornitori o da leaderboard diverse. Google lo scrive nella metodologia di Gemini 4 Carbon. Per questo i margini piccoli non vanno trattati come vantaggi certi.