
GPT-6 Astra per sviluppatori: codice, API e uso del computer
GPT-6 Astra lato sviluppo: punteggi sul codice, endpoint e strumenti dell'API, livelli di ragionamento, contesto lungo e uso del computer.
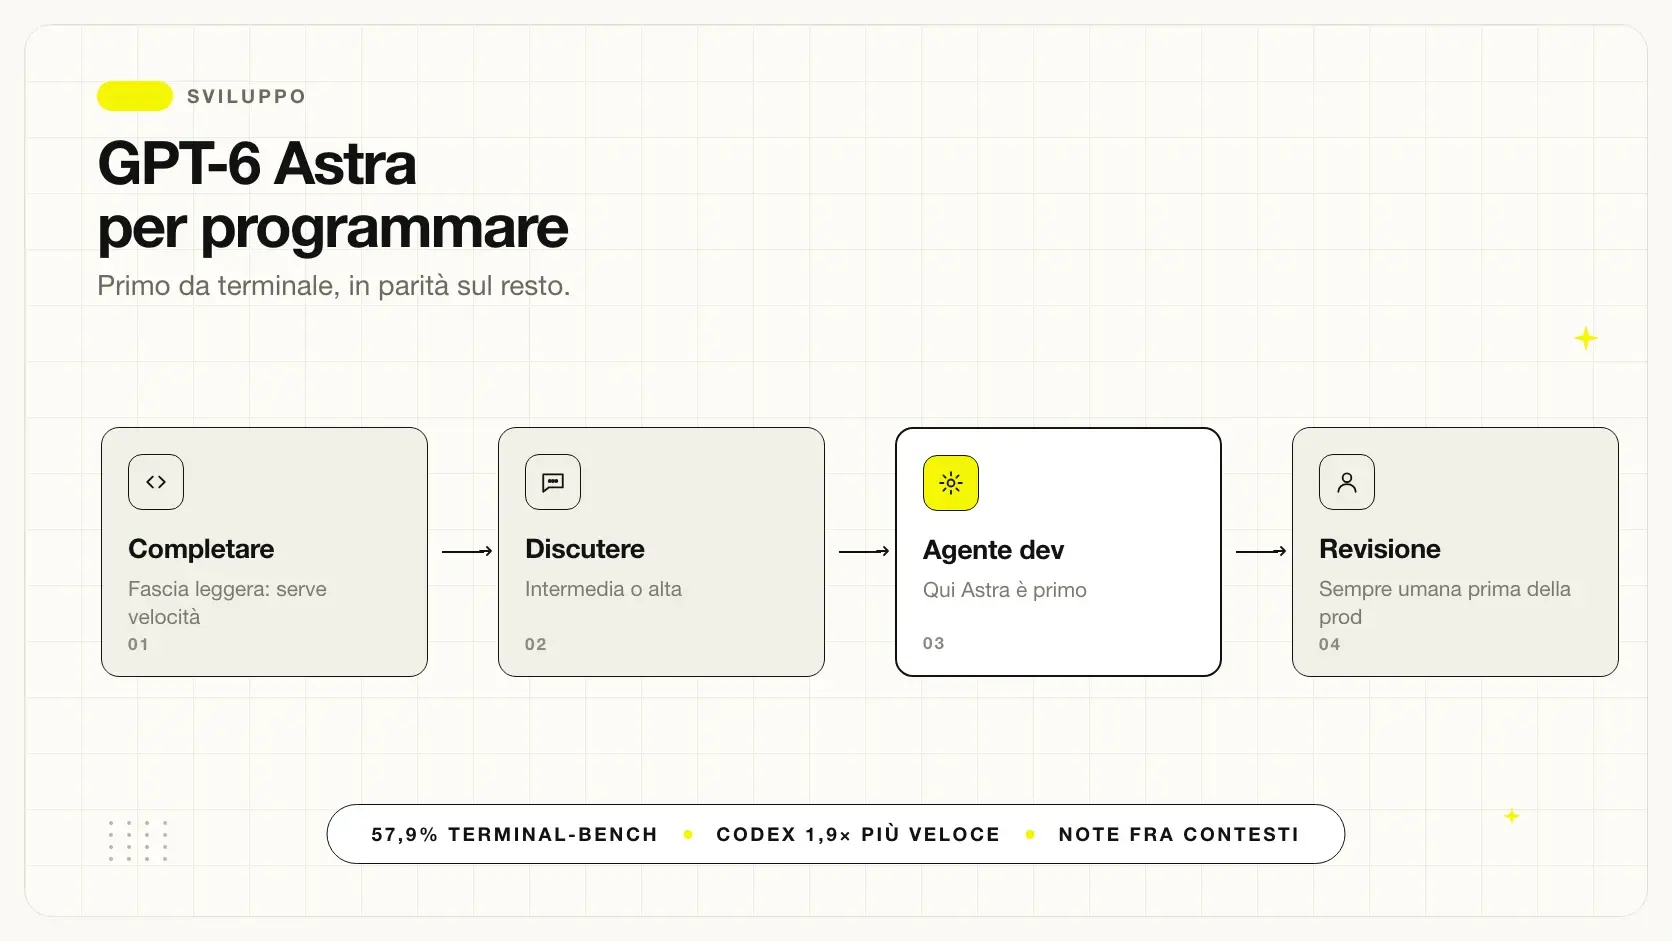
Questa è la pagina tecnica su GPT-6 Astra: i punteggi sul codice e quanto valgono davvero, come è fatta l'API — identificativi, endpoint, strumenti —, cosa cambia fra i cinque livelli di ragionamento, come si comporta sul contesto lungo e cosa sa fare quando gli si lascia usare il computer.
Tutto dalle fonti ufficiali: scheda tecnica dell'API, annuncio e scheda di sistema. Dati verificati il 4 settembre 2026.
In sintesi
- Cinque livelli di ragionamento: i benchmark pubblicati sono al massimo.
- La cache è la prima leva su costo e latenza in un agente.
- Contesto da un milione di token, ma riempirlo è quasi sempre sbagliato.
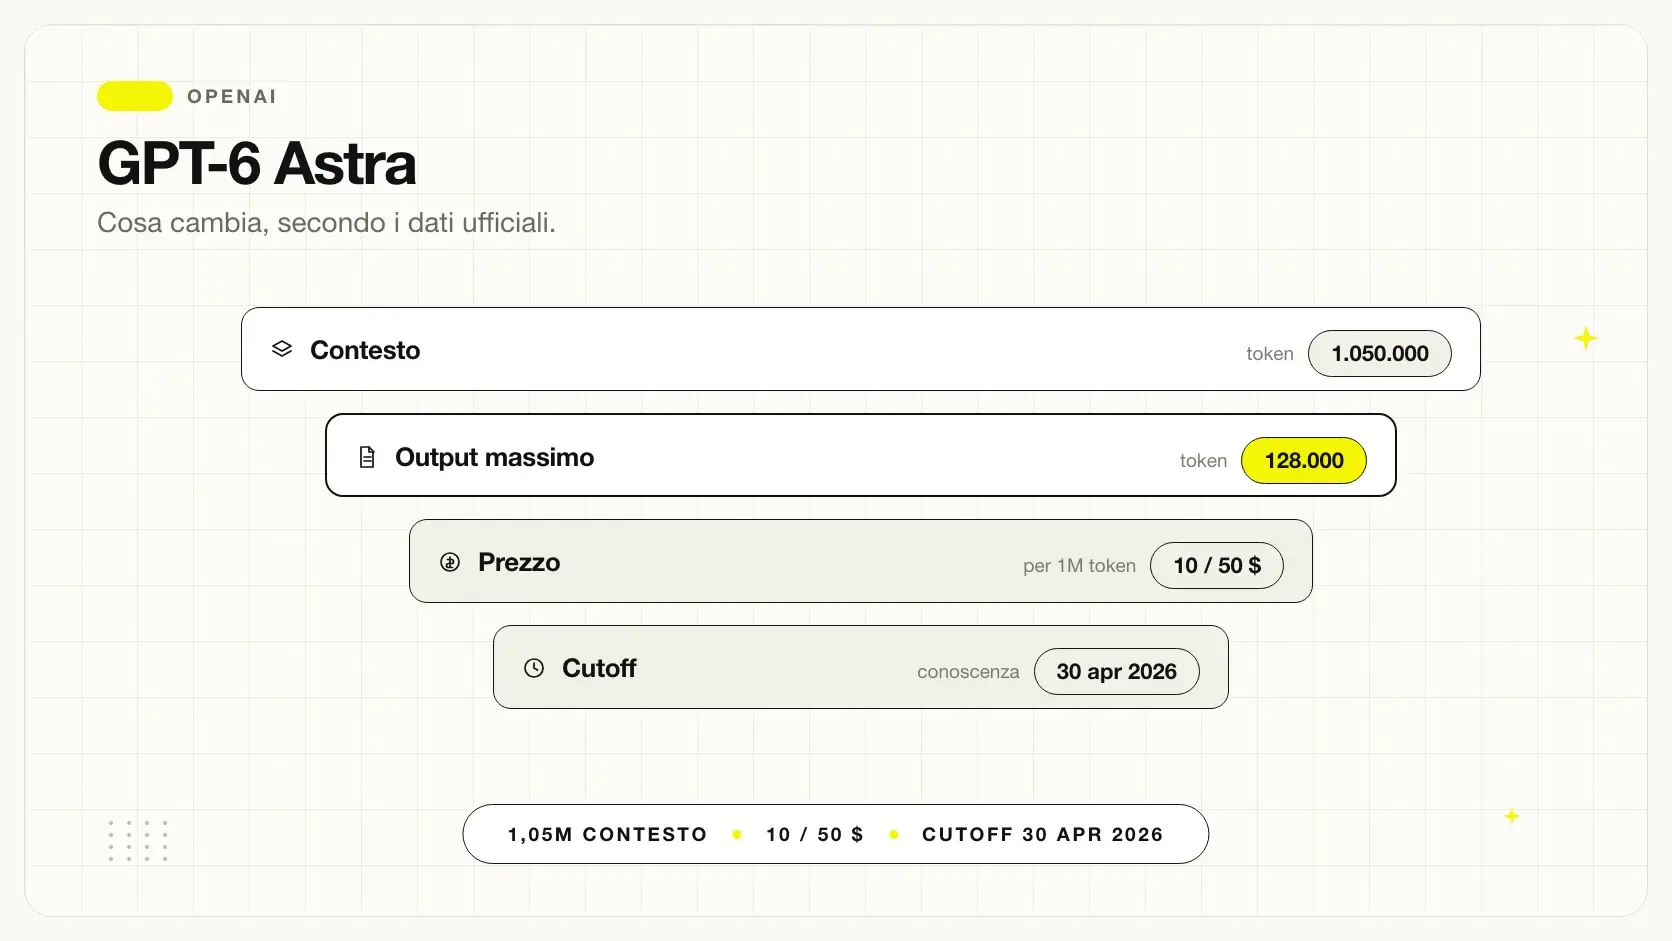
- L'output è il limite che si incontra per primo: 128.000 token.
- Sull'uso del computer il fattore che conta più del punteggio è il tempo.
- Niente fine-tuning: si lavora su prompt, strumenti e contesto.
I numeri, per intero
| Benchmark | Astra | Sol | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|
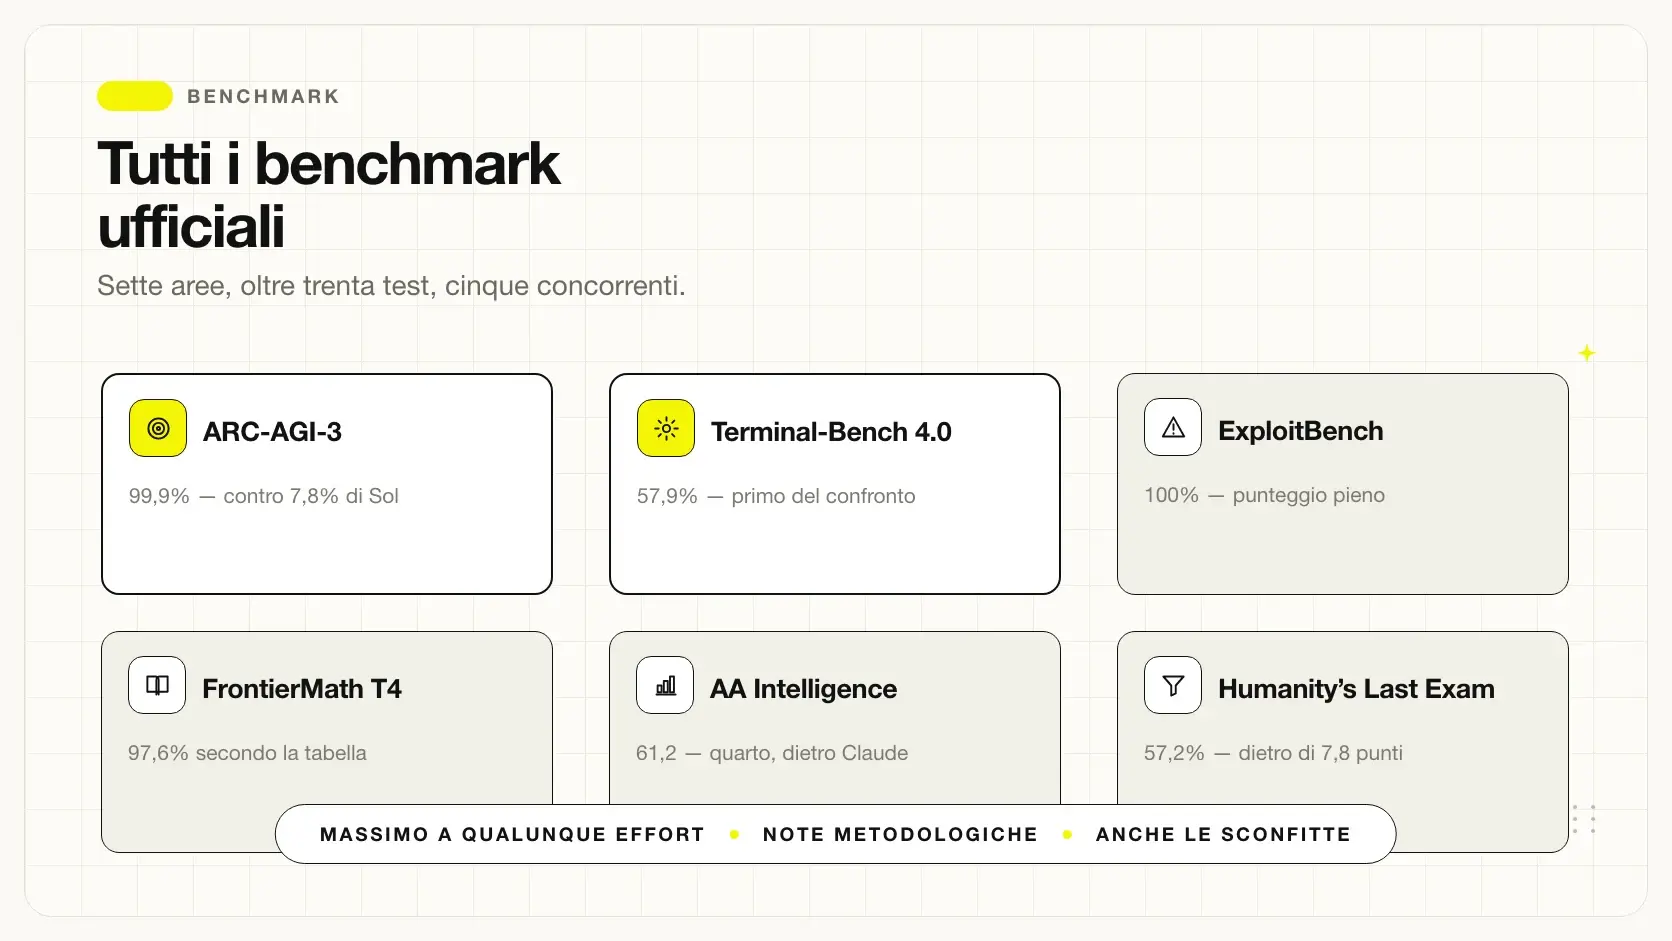
| Terminal-Bench 4.0 | 57,9% | 37,3% | 55,8% | 44,5% | 52,6% |
| DB Migration (interno) | 63,9% | 42,7% | 57,8% | 50,3% | — |
| DeepSWE v1.1 | 74,1% | 72,7% | 67,4% | 69,9% | 73,7% |
| FrontierCode 1.1 Extended | 64,5% | 60,6% | 63,6% | 64,9% | 63,6% |
| FrontierCode 1.1 Main | 53,3% | 47,5% | 50,9% | 53,5% | 53,4% |
| AA Coding Agent Index v1.4 | 67,0 | 65,1 | — | 67,2 | 68,1 |
Il quadro è chiaro se si separano due cose.
Sui compiti da terminale — configurazione di sistema, analisi dati, ingegneria del software eseguita da riga di comando — Astra è primo con margini reali: 2,1 punti su Fable 5.1 e 5,3 su Opus 5, oltre a un +20,6 sulla propria generazione precedente.
Sulla programmazione misurata in senso ampio il primato sparisce: su entrambe le varianti di FrontierCode è Fable 5 in testa, e sull'indice di coding di Artificial Analysis — una misura di terza parte — è primo Opus 5.
Il dato che conta più del punteggio
Su Terminal-Bench 4.0 OpenAI dichiara che il 57,9% arriva a circa il 9% di costo stimato in meno rispetto a Sol e circa il 63% in meno rispetto a Fable 5.1.
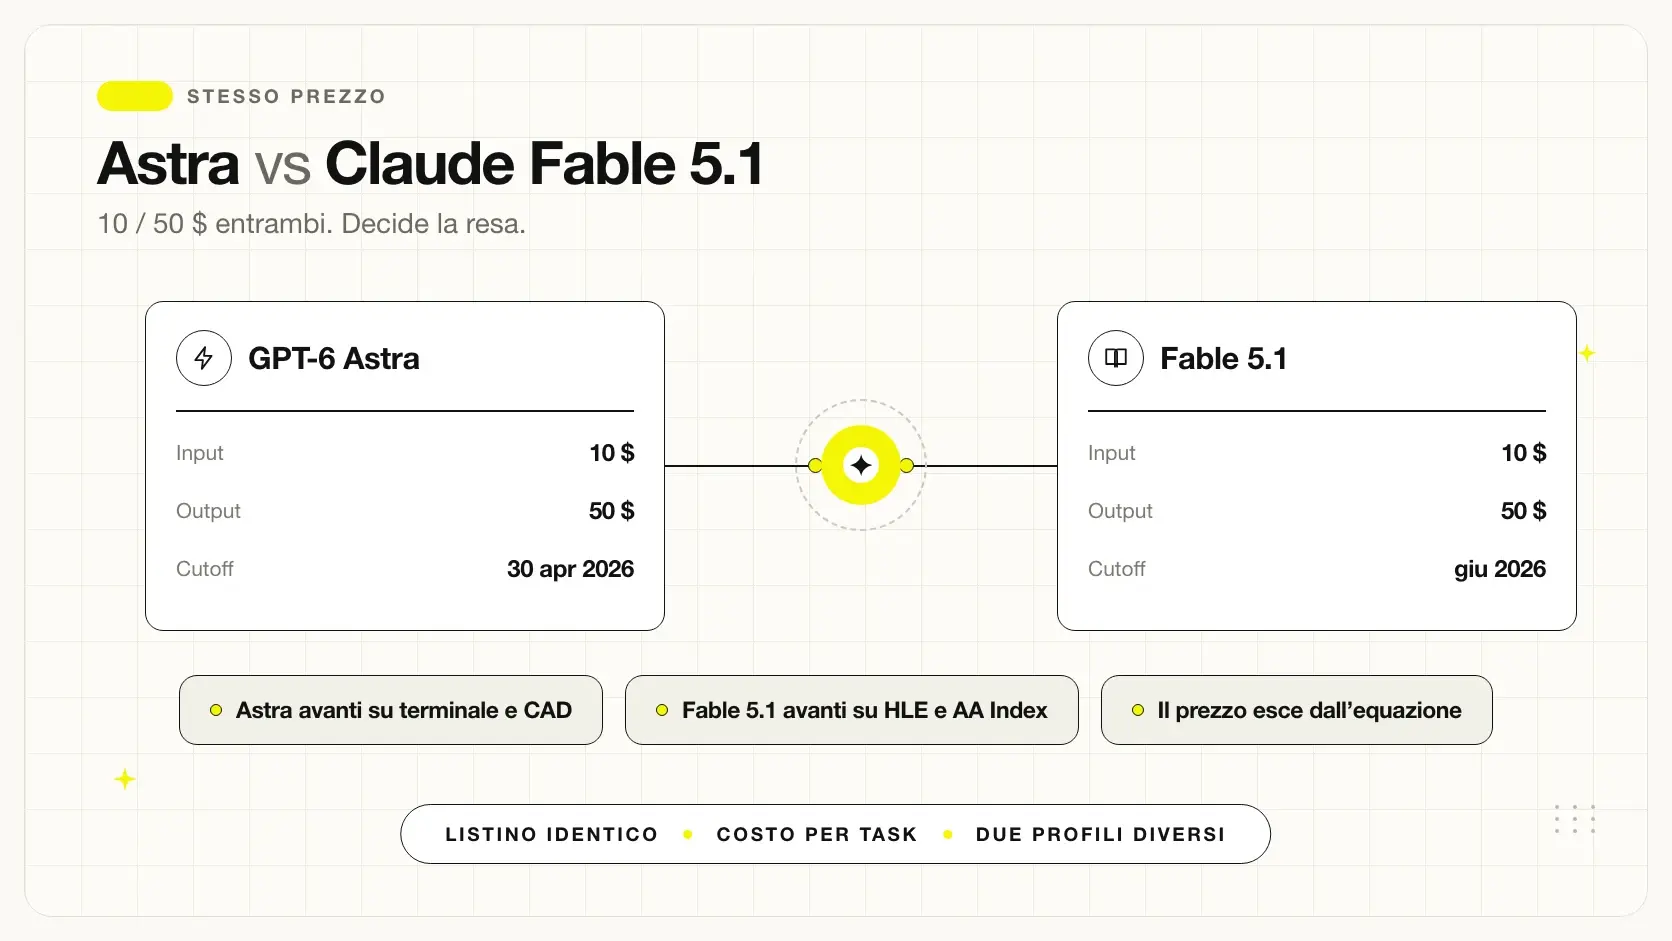
La seconda cifra è quella importante: a parità di listino con Fable 5.1 — entrambi 10 e 50 dollari per milione di token — un costo per task inferiore del 63% significa che il modello consuma molto meno per arrivare allo stesso punto. Su un team che lavora tutto il giorno, quella differenza vale più di due punti di benchmark.
Va detto che è una stima del produttore su un singolo test, non una regola generale. Ma è verificabile: bastano cinquanta problemi reali eseguiti su entrambi, contando i token effettivamente fatturati.
Cosa cambia in Codex
Insieme ad Astra, OpenAI ha aggiornato l'impalcatura Codex dichiarando un completamento dei task 1,9 volte più veloce rispetto all'esperienza con GPT-5.6 Sol sul benchmark Mind2Web.
C'è poi una novità architetturale interessante per chi lavora su sessioni lunghe. Storicamente, quando la finestra di contesto si riempie, i modelli usano la compattazione: riassumono il lavoro fatto. Ogni compattazione però può perdere dettagli su perché una correzione non ha funzionato o su come si comporta un componente.
Con Astra, Codex può tenere note attraverso finestre di contesto diverse, preservando i dettagli accumulati senza comprimerli ogni volta in un unico riassunto. Le finestre precedenti restano consultabili, quindi il modello può ritrovare requisiti o risultati di test da messaggi passati anche se non erano stati catturati nelle note.
È una funzione sperimentale, da abilitare nella configurazione di Codex, che OpenAI dichiara diventerà predefinita per Astra nelle settimane successive.
Quale fascia serve, per quale uso
Astra si giustifica
- Agenti che eseguono, testano e correggono
- Compiti da terminale e configurazione
- Migrazioni di database
- Refactoring che tocca molti file
- Sessioni lunghe con molto contesto
Basta una fascia più bassa
- Completamento mentre si scrive
- Generazione di test ripetitivi
- Documentazione di codice esistente
- Conversioni di formato meccaniche
La colonna di destra copre una quota consistente delle richieste quotidiane di un team. Per i suggerimenti in tempo reale conta la velocità più della capacità: un completamento che arriva dopo tre secondi non serve a nessuno, per quanto sia buono.
Un team maturo usa modelli diversi per i tre modi d'uso — completamento, discussione, agente autonomo — invece di sceglierne uno solo. Il criterio è in miglior modello AI per programmare, e il modo corretto di leggere i benchmark di coding in SWE-bench e i benchmark di coding.
Cosa dicono i team che l'hanno provato
L'annuncio riporta giudizi di aziende che hanno avuto accesso anticipato. Sono testimonianze raccolte da OpenAI, quindi selezionate, ma contengono osservazioni concrete che vale la pena riportare.
Da Cognition, che integra Astra nell'impalcatura di Devin, viene segnalato che l'uso del computer, la scrittura e la comprensione della base di codice hanno migliorato i test «da subito», con video più facili da seguire e report più chiari e concisi.
Da Jane Street arriva l'osservazione forse più utile per un team: usato per il coding agentico, Astra «comunica in un modo più facile da seguire per gli sviluppatori e produce codice che richiede meno iterazioni per raggiungere la qualità di produzione».
Quest'ultimo punto tocca esattamente ciò che i benchmark non misurano. Un modello che produce codice accettabile al primo giro fa risparmiare più di uno che ottiene un punteggio più alto ma richiede tre passaggi di revisione — sia in costo API sia, soprattutto, in tempo delle persone.
Una nota metodologica su FrontierCode
Sulle due righe di FrontierCode c'è una footnote che cambia la lettura del risultato.
OpenAI dichiara che su quel benchmark Astra è stato eseguito con un messaggio di sistema simile a una sezione del suo messaggio in Codex, che chiede in sostanza: evitare di creare file di test superflui, riutilizzare le utilità esistenti, leggere le convenzioni del repository e ispezionare codice, test e documentazione vicini, con l'obiettivo di produrre codice pulito e integrabile.
OpenAI precisa che il prompt non era ottimizzato per quel test. Ma resta il fatto che il risultato è stato ottenuto con istruzioni specifiche sul comportamento atteso, e che quelle istruzioni descrivono buone pratiche di sviluppo.
È un'informazione utile in due modi. Primo: ridimensiona il confronto diretto, perché non tutti i modelli in tabella hanno ricevuto lo stesso trattamento. Secondo, e più pratico: suggerisce che istruzioni di questo tipo migliorano il risultato, il che è replicabile sul proprio ambiente indipendentemente dal modello scelto.
Il costo di un team di sviluppo
Facciamo un conto realistico. Un team di cinque persone che usa un assistente agentico tutto il giorno può generare volumi consistenti, perché il codice come contesto è pesante.
Ipotizziamo 400 richieste al giorno complessive, con 15.000 token di input (file pertinenti, storico della sessione) e 2.000 di output.
| Voce | Token mensili | Costo |
|---|---|---|
| Input | 132M | 1.320 $ |
| Output | 17,6M | 880 $ |
| Totale mensile | — | ~2.200 $ |
Due leve cambiano radicalmente questo conto, ed entrambe sono più efficaci di un cambio di modello.
La prima è la cache: su Astra l'input letto dalla cache costa 1 dollaro invece di 10. Su un contesto di progetto stabile riletto decine di volte al giorno, è la differenza fra 1.320 e poche centinaia di dollari.
La seconda è la selezione dei file: uno strumento che individua i tre file pertinenti costa una frazione di uno che manda l'intero repository, e produce anche risposte migliori perché il modello non deve cercare l'ago nel pagliaio.
Il rischio specifico del codice generato
Un ultimo avvertimento che vale per qualunque modello, incluso questo.
Un modello che genera codice palesemente rotto non fa danni: il test fallisce, qualcuno se ne accorge, si corregge. Un modello che genera codice che funziona sui casi previsti ma sbaglia su quelli non testati produce un problema che emergerà in produzione, magari mesi dopo.
Più il modello è capace, più questo rischio cresce, perché il codice prodotto è plausibile e supera la revisione superficiale. La contromisura non è tecnica ma di processo: chiedere sempre di spiegare la modifica e di dichiarare le assunzioni fatte. Un modello che scrive «ho assunto che questo campo sia sempre valorizzato» ti sta dando l'informazione per verificare; uno che non lo dichiara ha fatto la stessa assunzione in silenzio.
Per andare più a fondo. Se stai valutando l’adozione, parti da GPT-6 Astra: cos'è e cosa cambia. Il calcolo della spesa reale — quella che comprende ragionamento, tentativi e revisione umana — è in GPT-6 Astra: prezzi e come si paga, mentre i limiti dichiarati sono raccolti in GPT-6 Astra: tutti i benchmark ufficiali.
Identificativo e snapshot
L'identificativo è gpt-6-astra. La scheda indica che gli snapshot e gli alias disponibili puntano tutti allo stesso nome.
Gli snapshot servono a bloccare una versione specifica del modello, così che comportamento e prestazioni restino costanti nel tempo. È una pratica consigliata per i sistemi in produzione, perché evita che un aggiornamento silenzioso cambi il comportamento di un flusso già tarato.
Endpoint supportati
| Endpoint | Supportato |
|---|---|
| Chat Completions | sì |
| Responses | sì |
| Batch | sì |
| Fine-tuning | no |
| Embeddings | no |
| Generazione immagini | no |
| Video | no |
| Audio (sintesi, trascrizione, traduzione) | no |
| Moderazione | no |
| Realtime | no |
Due assenze meritano attenzione. Il fine-tuning non è disponibile: non puoi specializzare il modello sui tuoi dati, e devi ottenere lo stesso risultato con contesto e istruzioni. E l'audio non è supportato in nessuna forma, quindi un progetto che prevede trascrizione richiede un modello affiancato.
L'endpoint Responses è quello da usare se ti servono gli strumenti: la scheda indica che le funzionalità di tool sono disponibili attraverso quella interfaccia.
Gli strumenti disponibili
| Strumento | Cosa fa |
|---|---|
| Web search | Ricerca sul web |
| File search | Ricerca nei file caricati |
| Image generation | Generazione di immagini |
| Code interpreter | Esecuzione di codice |
| Hosted shell | Shell ospitata |
| Apply patch | Applicazione di modifiche al codice |
| Skills | Capacità estese |
| Computer use | Uso del computer |
| MCP | Model Context Protocol |
| Tool search | Ricerca fra gli strumenti |
La dotazione è ampia. Computer use è quello che abilita i casi d'uso descritti nell'annuncio — compilare moduli, navigare software, aggiornare anagrafiche — ed è approfondito in GPT-6 Astra e il computer use.
MCP merita una nota: è il protocollo che permette di collegare il modello a fonti e strumenti esterni in modo standardizzato, ed è la strada più pulita per dargli accesso ai sistemi aziendali senza costruire un'integrazione su misura per ciascuno.
Funzionalità
- Streaming: supportato — utile per mostrare la risposta mentre arriva
- Chiamata di funzioni: supportata
- Output strutturati: supportati — essenziali per l'estrazione dati
- Token di ragionamento: supportati, con cinque livelli di effort
- Fine-tuning: non supportato
Lo streaming ha un valore pratico spesso sottovalutato: negli scenari interattivi il tempo alla prima parola visibile conta più di quello alla risposta completa. Su un modello che ragiona prima di rispondere è la differenza fra un'attesa tollerabile e una che sembra un blocco.
Gli output strutturati sono la funzione da usare in qualunque flusso di estrazione dati, perché eliminano la fragilità di dover interpretare testo libero.
Le modalità di elaborazione, in pratica
La scheda indica quattro modi di far girare la stessa richiesta, con prezzi molto diversi. Sceglierli bene vale più di qualunque ottimizzazione del codice.
| Modalità | Prezzo relativo | Quando usarla |
|---|---|---|
| Batch | 50% | Elaborazioni in blocco, nessuna urgenza |
| Flex | 50% | Carichi che tollerano attesa |
| Standard | riferimento | Flusso applicativo ordinario |
| Fast | 200% | Latenza è un requisito stringente |
Fra l'estremo economico e quello veloce c'è un fattore quattro. Su un sistema che mescola carichi urgenti e non urgenti senza distinguerli, significa pagare fino al quadruplo del necessario su una parte del traffico.
La verifica da fare è banale e quasi nessuno la fa: elencare le richieste che il sistema genera e segnare quali hanno davvero qualcuno che aspetta. Nella maggior parte dei casi aziendali una quota consistente può attendere — arricchimento di archivi, report periodici, classificazione retroattiva — e quella quota può stare su Batch.
La cache: come usarla bene
Con l'input da cache a 1 dollaro contro i 10 dell'input normale, la cache è la leva economica più potente disponibile su questo modello. Ma va usata sapendo come funziona.
La scrittura in cache costa 12,50 dollari per milione di token, cioè 1,25 volte l'input non memorizzato. Significa che memorizzare un contenuto conviene solo se verrà riletto almeno due volte.
| Contenuto | Conviene la cache? |
|---|---|
| Prompt di sistema, riletto sempre | Sì, moltissimo |
| Documenti di riferimento stabili | Sì |
| Schema del database in un flusso SQL | Sì |
| Contesto diverso a ogni chiamata | No, costa di più |
| Documento analizzato una volta sola | No |
Il caso più redditizio è il prompt di sistema: su decine di migliaia di chiamate mensili con le stesse istruzioni, passare da 10 a 1 dollaro per milione di token su quella porzione cambia l'ordine di grandezza della bolletta.
Gestire le interruzioni
Un requisito architetturale specifico di questo modello, che va previsto e non scoperto.
OpenAI dichiara che i controlli di sicurezza aggiuntivi possono rallentare, mettere in pausa o fermare lavoro legittimo. In ChatGPT o Codex può essere richiesta una revisione; in API il task si ferma.
Per un flusso automatico questo significa che una chiamata può non tornare mai il risultato atteso, per ragioni che non dipendono dal tuo codice né dai tuoi dati. La contromisura è ordinaria ma va implementata.
- Registra ogni interruzione con il contesto della richiesta
- Prevedi una coda per i casi non conclusi
- Stabilisci chi se ne accorge: un'automazione muta è peggio di una ferma
- Non ritentare all'infinito: limita i tentativi e passa oltre
- Monitora la percentuale di interruzioni nel tempo
L'ultimo punto è quello che rivela i problemi prima che diventino gravi: se la percentuale cambia improvvisamente, qualcosa è cambiato — nei dati, nel modello o nelle protezioni — e va indagato.
Privacy e conservazione dei dati
Per un progetto aziendale c'è un ultimo elemento da verificare prima di scrivere codice.
OpenAI dichiara che Astra supporta la conservazione zero dei dati per i clienti API idonei, e che sta sperimentando un'elaborazione di sicurezza privata pensata per rafforzare il monitoraggio preservando la riservatezza dei clienti.
Va però tenuto presente che per i modelli di questa classe è attivo un monitoraggio del disallineamento in produzione: un sistema di classificatori che analizza ragionamento e azioni alla ricerca di comportamenti non autorizzati.
Sono due informazioni da mettere insieme nella valutazione. L'idoneità alla conservazione zero va confermata sul proprio contratto, non data per scontata — ed è il tipo di verifica da fare prima di progettare l'architettura, non dopo aver messo in produzione un flusso che tratta dati riservati.
Da qui, tre approfondimenti utili. Per i numeri ufficiali completi vedi GPT-6 Astra: cos'è e cosa cambia. Il listino con le condizioni che cambiano il conto è in GPT-6 Astra: tutti i benchmark ufficiali. E per il verdetto per tipo di azienda, Dove GPT-6 Astra non è il migliore.
Cosa succede quando alzi il livello
Il modello non diventa più capace: si prende più spazio per arrivare alla risposta. Produce ragionamento intermedio, considera più strade, verifica di più prima di concludere.
Le conseguenze sono tre e vanno considerate insieme.
- La qualità sale sui compiti che richiedono più passaggi concatenati
- Il costo sale, perché i token intermedi si pagano come output
- La latenza sale, spesso in modo sensibile
- Sui compiti semplici il guadagno è nullo o negativo
L'ultimo punto sorprende sempre. Su un compito di riconoscimento — classificare un messaggio, estrarre una data — alzare il livello non migliora nulla e a volte peggiora: il modello elabora una risposta semplice più del necessario e finisce per complicarla.
I risultati a livelli ridotti
OpenAI pubblica però anche due risultati a impostazioni più economiche, e sono i più utili dell'intero annuncio per chi deve progettare un sistema reale.
| Test | A livello ridotto | Confronto |
|---|---|---|
| GPQA Diamond | 94,9% | supera il 94,6% di Sol al massimo, a ~37% di costo in meno |
| Terminal-Bench Science 0.1 | 61,1% | contro il 22,4% di Sol, a ~27% di costo in meno |
La prima riga è quella che dovrebbe orientare le scelte: a impostazione ridotta Astra supera comunque il miglior risultato della generazione precedente, spendendo circa un terzo in meno.
Tradotto: nella maggior parte dei casi non serve il livello massimo per ottenere un risultato migliore di quello che avevi prima. È il tipo di informazione che cambia un preventivo.
Come scegliere il livello
| Livello | Quando ha senso | Effetto |
|---|---|---|
| low | Classificazione, estrazione, instradamento | Veloce ed economico |
| medium | Sintesi, risposte articolate | Equilibrato |
| high | Analisi multi-passo, codice | Più lento, più caro |
| xhigh | Problemi difficili, volumi contenuti | Costo sensibile |
| max | Casi eccezionali, valore molto alto | Costo massimo |
La regola pratica è semplice: alza il livello quando il compito concatena passaggi di ragionamento, abbassalo quando è di riconoscimento o estrazione. La scelta va fatta per tipo di compito, non una volta per tutte.
I due errori speculari
Impostare il massimo ovunque "per sicurezza". Sembra prudente e non lo è: moltiplica il costo su tutto il traffico, comprese le migliaia di richieste banali che non ne traggono alcun beneficio, e peggiora la latenza proprio dove gli utenti la notano. Su un modello con l'output a 50 dollari, è l'errore più caro che si possa fare.
Tenere il minimo ovunque per risparmiare. Produce risposte affrettate sui compiti che richiedono ragionamento, che poi vanno corrette a mano — e il tempo di correzione costa più del risparmio.
Il conto: quanto costa alzare il livello
Facciamo un esempio concreto per rendere tangibile l'impatto economico.
Prendiamo 20.000 richieste al mese con 3.000 token di input e una risposta visibile di 500 token. Il consumo di output cambia radicalmente col livello, perché i token di ragionamento si sommano alla risposta.
| Livello | Output stimato per richiesta | Costo output mensile |
|---|---|---|
| Basso | ~600 token | 600 $ |
| Medio | ~1.500 token | 1.500 $ |
| Alto | ~3.000 token | 3.000 $ |
| Molto alto | ~6.000 token | 6.000 $ |
I moltiplicatori sono indicativi e vanno misurati sul proprio caso — l'unica cosa certa è la direzione. Ma illustrano il punto: la stessa identica richiesta può costare dieci volte tanto solo cambiando un parametro, senza toccare il prompt.
L'input resta invece costante a 600 dollari mensili in tutti gli scenari. È per questo che su un modello con l'output a cinque volte l'input, il livello di ragionamento è la leva economica più potente a disposizione.
L'effetto sulla latenza
Il ragionamento non costa solo denaro: costa tempo. E in alcuni scenari il tempo pesa più del denaro.
Alzare il livello significa che il modello produce token intermedi prima di iniziare a rispondere. Su un'interfaccia dove qualcuno guarda uno schermo, la differenza fra due secondi e dieci non è un dettaglio: è la differenza fra uno strumento che si usa e uno che si abbandona.
Nei flussi agentici l'effetto si moltiplica per il numero di passaggi. Un agente che compie dodici passi a livello alto paga il ritardo dodici volte, e un'esecuzione che a livello medio dura tre minuti può arrivare a dieci.
| Scenario | Livello sensato |
|---|---|
| Chat con utente in attesa | Il più basso che regge |
| Suggerimenti in tempo reale | Basso |
| Agente notturno in blocco | Libero, conta solo il costo |
| Analisi singola ad alto valore | Alto o massimo |
L'ultima riga è quella dove il livello massimo si giustifica davvero: pochi casi, valore alto per caso, nessuno che aspetta. Fuori da lì è quasi sempre eccessivo.
Come si combina con Fast mode
Su Astra c'è un secondo parametro che tocca la velocità: la Fast mode, che secondo la documentazione offre fino al doppio della velocità al doppio del prezzo applicabile.
I due si sommano in modo che vale la pena capire. Fast mode raddoppia la tariffa; un livello di ragionamento alto moltiplica i token consumati. Attivarli insieme su tutto il traffico produce un conto che sorprende.
La combinazione sensata è quasi sempre l'opposto di quella istintiva: livello di ragionamento adeguato al compito, Fast mode solo dove la latenza è un requisito reale. Alzare entrambi "per sicurezza" è il modo più rapido di moltiplicare la spesa senza un guadagno corrispondente.
Vale infine ricordare che Batch e Flex costano metà dello Standard: su un carico non urgente, la combinazione più efficiente è livello adeguato e modalità economica, come descritto in GPT-6 Astra: prezzi e come si paga.
Una domanda che precede la scelta del livello
Prima di tarare l'effort, vale la pena porsi una domanda più a monte: serve questo modello?
Il livello di ragionamento è la leva giusta quando il modello è quello giusto. Ma se il compito è classificare messaggi o estrarre campi da documenti strutturati, il problema non è quale effort impostare su Astra: è che un modello di fascia economica farebbe lo stesso lavoro a un cinquantesimo del prezzo, con qualunque impostazione.
L'ordine corretto è quindi: prima la fascia, poi il livello, poi la modalità. Invertirlo — tarare finemente i parametri di un modello sovradimensionato — è un'ottimizzazione che produce risparmi marginali su una spesa che non doveva esistere.
Il criterio per la prima decisione è in quando basta un modello economico.
Un dettaglio sulla documentazione
La scheda del modello elenca i cinque livelli senza indicare quale sia il predefinito. È un'informazione che vale la pena verificare direttamente nella propria integrazione, perché determina cosa succede se non specifichi nulla — e quindi quanto stai spendendo oggi senza averlo deciso.
È la stessa categoria di verifica che conviene fare sull'identificativo del modello: controllare cosa usa davvero il sistema, invece di assumere. Nei progetti cresciuti nel tempo la differenza fra configurazione voluta e configurazione effettiva è più comune di quanto si creda.
Il resto del percorso, in tre pagine. Il confronto con la generazione precedente è in GPT-6 Astra: cos'è e cosa cambia. Per i benchmark su cui il modello resta indietro, GPT-6 Astra: tutti i benchmark ufficiali. Il metodo per verificare tutto sui tuoi casi è in Dove GPT-6 Astra non è il migliore.
I numeri sul recupero a lunga distanza
Il benchmark MRCR verifica se un modello riesce a ritrovare informazioni specifiche nascoste in un contesto molto lungo — nella variante citata, otto informazioni diverse da recuperare.
| Fascia di contesto | Astra | GPT-5.6 Sol |
|---|---|---|
| 256K – 512K token | 100,0% | 91,5% |
| 512K – 1M token | 96,3% | 73,8% |
Il dato interessante è la seconda riga: nella fascia più difficile la generazione precedente perdeva più di un quarto delle informazioni, mentre Astra ne recupera oltre il 96%.
È il miglioramento più regolare dell'intero annuncio, e ha una conseguenza pratica: su documenti molto lunghi il rischio che un dettaglio importante venga trascurato si riduce sensibilmente. Non sparisce — il 96,3% significa comunque che qualcosa può sfuggire — ma cambia ordine di grandezza.
Perché riempire la finestra è quasi sempre sbagliato
C'è un'idea diffusa e costosa: se il modello accetta un milione di token, tanto vale usarli. Ci sono tre ragioni per cui non conviene.
Costa, e a ogni chiamata. Il contesto non è una funzione inclusa: si paga ogni volta che lo mandi. Un documento da 300.000 token passato per intero a venti domande diverse costa venti volte quel documento — e oltre soglia, al doppio della tariffa.
Non migliora la risposta. Nella pratica le informazioni all'inizio e alla fine del contesto vengono usate in modo più affidabile di quelle sepolte a metà. Su documenti molto lunghi un dettaglio centrale può essere trascurato anche se tecnicamente il modello lo ha letto — e il 96,3% di MRCR conferma che qualcosa sfugge.
Nasconde il problema vero. Se un sistema ha bisogno di mandare tutto, di solito significa che nessuno ha costruito un modo per trovare la parte pertinente. Ed è quel pezzo a rendere il sistema utile, non la dimensione della finestra.
Serve leggere tutto
- Analisi completa di un contratto
- Verifica di coerenza interna
- Confronto fra due versioni
- Ricerca di contraddizioni
Basta selezionare
- Trovare una clausola specifica
- Rispondere a una domanda puntuale
- Estrarre campi noti
- Cercare in un archivio
La colonna di destra copre la maggior parte delle richieste aziendali reali, e in tutte la finestra grande è una capacità che si paga senza usarla. Il ragionamento completo è in finestra di contesto: quanto conta davvero.
Il limite che si incontra per primo
Tutti guardano l'input; quasi nessuno guarda quanto il modello può produrre. E in molti progetti documentali è quello il vincolo che si tocca prima.
Centoventottomila token di output sono molti per una risposta, ma diventano stretti in tre scenari ricorrenti: tradurre un documento lungo per intero, riscriverlo o riformattarlo completamente, produrre una tabella con una riga per ogni voce di un elenco esteso.
La soluzione è spezzare il lavoro e ricomporlo, ma va previsto in progettazione: scoprirlo a metà sviluppo costa più che tenerne conto dall'inizio.
La cache, l'alleata del contesto stabile
Su un modello con l'input a 10 dollari per milione di token, c'è una leva che cambia il conto: l'input letto dalla cache costa 1 dollaro, cioè un decimo.
La scrittura in cache costa però 12,50 dollari, più dell'input normale. Quindi memorizzare conviene solo se quel contenuto verrà riletto più di una volta — ma su un prompt di sistema o su documenti di riferimento stabili è esattamente il caso.
| Situazione | Conviene la cache? |
|---|---|
| Prompt di sistema riletto ogni volta | Sì, molto |
| Documenti di riferimento stabili | Sì |
| Contesto diverso a ogni chiamata | No, costa di più |
| Sessione lunga con storico crescente | In parte, sulla base fissa |
Quanto è davvero un milione di token
Per rendere concreta la finestra, qualche riferimento pratico.
| Contenuto | Ordine di grandezza |
|---|---|
| Una email | Qualche centinaio di token |
| Un contratto di 20 pagine | Alcune migliaia |
| Un manuale tecnico | Decine di migliaia |
| Un intero repository di codice medio | Centinaia di migliaia |
| La soglia dei 272K | Alcune centinaia di pagine |
| Un milione di token | Migliaia di pagine |
La conversione esatta dipende dalla lingua e dal tipo di testo, e l'italiano tende a consumare un po' più dell'inglese a parità di contenuto — un dettaglio che va tenuto presente quando si confrontano stime trovate online, quasi sempre calcolate su testi inglesi.
Il riferimento più utile è la penultima riga: la soglia dei 272.000 token corrisponde a alcune centinaia di pagine. Per la maggior parte dei compiti aziendali è abbondante, il che significa che la maggiorazione riguarda una minoranza di casi — ma quella minoranza va identificata prima, non scoperta in fattura.
I numeri ufficiali
| Benchmark | Astra | GPT-5.6 Sol | Claude Opus 5 | Claude Fable 5 |
|---|---|---|---|---|
| ScreenSpot-Pro (senza tool) | 92,7% | 76,9% | — | 87,3% |
| OSWorld 2.0 | 72,6% | 65,7% | 70,2% | — |
| Agents' Last Exam | 59,3% | 53,6% | 55,5% | 48,7% |
Il salto generazionale è netto: quindici punti su ScreenSpot-Pro rispetto a Sol, sette su OSWorld, quasi sei su Agents' Last Exam.
Il confronto con la concorrenza è più sfumato di quanto la comunicazione lasci intendere: su OSWorld 2.0 il vantaggio su Opus 5 è di 2,4 punti, su Agents' Last Exam di 3,8. Sono margini reali ma non schiaccianti.
Il fattore tempo
Accanto ai punteggi, l'annuncio riporta due misure di velocità — cosa rara e particolarmente rilevante per gli agenti.
Su OSWorld 2.0, in simulazioni di latenza, Astra ottiene 72,6% impiegando circa 40 minuti per task, contro il 65,7% in circa 75 minuti della generazione precedente. Più risultato in circa metà del tempo.
Sul benchmark Mind2Web, con l'impalcatura Codex aggiornata, OpenAI dichiara un completamento dei task 1,9 volte più veloce rispetto all'esperienza con GPT-5.6 Sol.
Questo conta più di quanto sembri. Nei flussi che usano il computer la latenza si moltiplica per il numero di passaggi: se un compito richiede quaranta azioni, dimezzare il tempo di ciascuna cambia se quel flusso può girare mentre qualcuno guarda o solo durante la notte.
Cosa dichiara di saper fare
L'annuncio elenca compiti concreti, che vale la pena riportare perché sono più informativi di un punteggio.
- Compilare moduli online e aggiornare anagrafiche clienti in un CRM
- Organizzare il calendario
- Fare ricerche online e scrivere riassunti dentro email o documenti
- Analizzare dati scientifici, generare grafici, creare un sito
- Eseguire controlli di qualità sul frontend di un sito
- Installare e testare software, diagnosticare problemi visti a schermo
Gli esempi mostrati includono il layout di un circuito stampato in un software di progettazione elettronica, la compilazione di un modulo fiscale, la formattazione di un documento legale e l'uso di strumenti di business intelligence.
Sono compiti accomunati da una caratteristica: software specialistici senza API comode. È esattamente lo spazio in cui l'uso del computer ha senso — dove l'integrazione tradizionale non esiste o costerebbe troppo.
Quando serve davvero
L'uso del computer ha senso
- Software gestionale senza API disponibili
- Portali esterni che vanno compilati a mano
- Applicazioni desktop specialistiche
- Processi che attraversano più sistemi scollegati
- Controlli visivi su interfacce
Meglio un'integrazione
- Il sistema espone già una API
- Esiste un tracciato di scambio dati
- Il volume è molto alto e il compito fisso
- Serve affidabilità totale sul singolo passaggio
La colonna di destra merita una nota: far navigare un'interfaccia a un modello è più fragile di chiamare una API. Se l'integrazione esiste, resta la strada corretta. L'uso del computer è la soluzione per il caso in cui non esiste.
Come si comporta quando l'istruzione è ambigua
Un aspetto che i benchmark catturano poco e che nell'uso quotidiano di un agente pesa moltissimo.
L'annuncio descrive Astra come migliore dei modelli precedenti nel decidere cosa fare quando le istruzioni lasciano spazio all'interpretazione: usa il contesto per colmare i vuoti di routine e pone domande mirate quando la risposta cambierebbe l'esito. In Codex può chiedere in modo asincrono, continuando nel frattempo il lavoro che non dipende dalla risposta.
Se non riceve risposta, procede con assunzioni ragionevoli dove è appropriato, ma attende sulle decisioni con conseguenze.
C'è poi un miglioramento sul mantenere l'orientamento: i modelli precedenti a volte trattavano un messaggio di correzione come un nuovo obiettivo, perdendo la richiesta originale o i vincoli iniziali. Astra è descritto come capace di incorporare nuovi requisiti, cambiare rotta quando richiesto e rispondere a domande laterali senza abbandonare il compito principale.
Sicurezza: i numeri e il prezzo da pagare
Sull'uso del computer OpenAI pubblica metriche di allineamento specifiche, dove un valore più basso è migliore.
| Metrica | Astra | Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| Sicurezza uso computer | 2,4% | 22,0% | 9,5% | 11,5% |
| Con AutoReview attivo | 1,8% | 4,3% | — | — |
Il confronto è stato fatto, dichiara OpenAI, con un'impalcatura generica basata sugli strumenti di uso del computer disponibili nelle API di entrambi i fornitori, e senza le protezioni aggiuntive normalmente attive in Codex e ChatGPT Work.
Il rovescio della medaglia è dichiarato con altrettanta chiarezza: i controlli extra possono rallentare, mettere in pausa o fermare lavoro legittimo. In ChatGPT o Codex può essere chiesta una revisione prima di continuare; in API il task si ferma.
Per chi progetta un'automazione che gira di notte senza supervisione, questo è un requisito architetturale, non un dettaglio: serve un meccanismo che registri l'interruzione e la porti all'attenzione di qualcuno.
Il salto che rende possibili progetti prima esclusi
Vale la pena isolare cosa cambia davvero per una PMI, al di là dei punteggi.
Finora automatizzare un processo che passa da un software senza API significava una di tre cose: pagare un'integrazione su misura, rassegnarsi al lavoro manuale, oppure costruire uno script che imita i clic e si rompe al primo cambio di interfaccia. Tutte e tre hanno un costo che spesso supera il beneficio su volumi medi.
Un modello che guarda lo schermo e capisce cosa sta vedendo cambia quel calcolo: tollera piccole variazioni dell'interfaccia, non richiede di mappare in anticipo ogni campo, e non va riscritto quando il fornitore aggiorna il gestionale.
Questo non lo rende adatto a tutto — resta più fragile e più lento di una API, e va usato dove l'alternativa non esiste. Ma sposta la soglia oltre la quale un'automazione diventa conveniente, e alcuni processi che finora restavano manuali entrano nella fascia sostenibile.
È il tipo di guadagno che i benchmark non catturano e che si misura in un modo solo: quante ore di lavoro ripetitivo tornano disponibili.
Tre riferimenti collegati. La panoramica generale è in GPT-6 Astra: cos'è e cosa cambia, i costi reali in GPT-6 Astra: prezzi e come si paga, e la valutazione per caso d’uso aziendale in GPT-6 Astra: tutti i benchmark ufficiali.
L'esempio della presentazione
L'annuncio mostra un caso specifico: Astra crea una presentazione su un modello fittizio usando poche slide del template OpenAI come riferimento, mantenendo tono e impaginazione corretti per tutto il documento.
L'affermazione che ne deriva è pratica: puoi aspettarti presentazioni formattate secondo gli standard della tua azienda, non secondo un layout generico.
Per chi produce materiali commerciali o relazioni ricorrenti, questo è il punto che cambia il calcolo. Il tempo speso a riformattare un documento generato è spesso vicino a quello che sarebbe servito per scriverlo — e se quel tempo sparisce, il guadagno diventa reale.
La creazione di siti e applicazioni
Accanto ai documenti, l'annuncio descrive una capacità adiacente: Astra porta un giudizio visivo più solido nei siti, giochi, applicazioni e rendering che costruisce.
Con la funzione Sites in ChatGPT, dichiara OpenAI, può creare, ospitare e condividere siti, web app e giochi direttamente da un prompt. Fra gli esempi mostrati ci sono una scena architettonica modellata in Blender e trasformata in un ambiente navigabile in Unreal Engine, e giochi con grafica e movimento coerenti.
Da Higgsfield AI viene riportato un giudizio che tocca il punto economico: Astra esegue i flussi creativi più complessi «usando fino al 20% di token in meno rispetto agli altri modelli testati», con l'effetto principale di una qualità di output più alta per i clienti.
È lo stesso schema che ricorre in tutto l'annuncio: il vantaggio dichiarato non è solo qualitativo ma di efficienza, e su una fascia di prezzo come questa i due si sommano.
Il costo dei documenti lunghi
C'è un aspetto economico specifico di questo caso d'uso che merita un calcolo.
Produrre documenti significa generare molto output, ed è la voce cara: 50 dollari per milione di token contro 10 dell'input. Un documento articolato può richiedere diverse migliaia di token in uscita.
| Tipo di output | Token stimati | Costo per documento |
|---|---|---|
| Email o risposta breve | ~500 | ~0,025 $ |
| Relazione di 5 pagine | ~4.000 | ~0,20 $ |
| Presentazione di 20 slide | ~8.000 | ~0,40 $ |
| Documento lungo strutturato | ~20.000 | ~1,00 $ |
Le cifre per singolo documento sembrano trascurabili, e lo sono. Diventano rilevanti sul volume: mille relazioni al mese sono duecento dollari di solo output, e vanno aggiunti i token di ragionamento, che su compiti strutturati non sono pochi.
Il confronto che conta resta quello con l'alternativa: se produrre quella relazione a mano richiede quaranta minuti, il costo di venti centesimi è irrilevante. È il caso in cui il calcolo del ritorno è semplice e favorevole — a patto che il documento esca utilizzabile, altrimenti il tempo di sistemazione mangia il guadagno.
Attenzione al limite di output
Un vincolo tecnico che in questo caso d'uso si incontra più che altrove: l'output massimo è di 128.000 token.
Sono molti per una singola risposta, ma diventano stretti in tre situazioni ricorrenti quando si producono documenti.
- Tradurre un documento lungo per intero
- Riscrivere o riformattare completamente un testo esteso
- Produrre una tabella con una riga per ogni voce di un elenco lungo
- Generare un documento strutturato molto ampio in un colpo solo
La soluzione è spezzare il lavoro in parti e ricomporlo, con l'accortezza di mantenere coerenza di stile fra le parti. Non è complicato, ma va previsto in progettazione: scoprirlo a metà sviluppo costa più che tenerne conto dall'inizio.
Il quadro completo sui limiti di contesto e output è in GPT-6 Astra e il contesto lungo.
Il vantaggio di lavorare dentro gli strumenti
C'è un elemento che distingue questo caso d'uso da un normale generatore di testo: Astra può operare direttamente nel software che usi.
L'annuncio cita l'analisi di dati con generazione di grafici, l'uso di strumenti di business intelligence, la formattazione di un documento legale e la compilazione di moduli. Non "produce un file che poi importi": lavora dentro l'applicazione.
Per un'azienda la differenza è sostanziale. Un output che arriva già nel formato e nel posto giusto elimina il passaggio manuale che di solito annulla il guadagno dell'automazione. Ed è anche il motivo per cui questa capacità si collega direttamente a quella descritta in GPT-6 Astra e il computer use: sono la stessa cosa vista da due angolazioni.
Il limite resta quello dell'uso del computer in generale: è più fragile e più lento di un'integrazione vera. Dove esiste una API, quella resta la strada corretta.
Tre riferimenti collegati. La panoramica generale è in GPT-6 Astra: cos'è e cosa cambia, i costi reali in GPT-6 Astra: prezzi e come si paga, e la valutazione per caso d’uso aziendale in GPT-6 Astra: tutti i benchmark ufficiali.
Esempi pratici
Team che automatizza migrazioni di database. Sulle migrazioni interne il distacco è di 6,1 punti su Fable 5.1 e di 21,2 su Sol. È l'area più distintiva insieme al terminale.
Software house che valuta l'assistente quotidiano. Qui il verdetto è aperto: su FrontierCode e sull'indice di Artificial Analysis siamo in parità con Claude, e Opus 5 costa la metà. Vale la prova su dieci problemi reali già risolti dal team.
Progetto con sessioni di debug molto lunghe. Le note fra contesti sono pensate esattamente per questo. È la funzione da provare per prima, tenendo presente che è sperimentale.
Errori da evitare
- Leggere "miglior modello per il software" come "vince ovunque".
- Usarlo per il completamento, dove serve velocità e costa troppo.
- Ignorare l'indice di Artificial Analysis, che è di terza parte.
- Confrontare punteggi ottenuti con impalcature diverse.
- Attivare le note fra contesti in produzione senza provarle: sono sperimentali.
- Dimenticare la soglia dei 272K token nelle sessioni lunghe.
Come applicarlo in azienda
Per un team di sviluppo il percorso ha tre passaggi, e il primo è quello che quasi nessuno fa.
Separa i tre modi d'uso. Completamento mentre si scrive, assistente conversazionale, agente autonomo. Hanno requisiti opposti — il primo ha bisogno di velocità, il terzo di capacità — e trattarli come un unico problema fa spendere troppo per ottenere poco.
Prova sul tuo codice. Dieci problemi reali già risolti dal team, di cui almeno tre interventi su codice esistente e non file nuovi. Scrivere una funzione da zero è un compito che tutti i modelli moderni svolgono; modificare codice con convenzioni accumulate negli anni è il lavoro vero.
Valuta due cose separatamente. Se il codice funziona e se è codice che accetteresti in revisione. Solo la prima la misura un benchmark.
Infine, conta i tentativi: un modello che costa il doppio ma chiude al primo colpo invece che al quarto conviene, e su questa fascia è il calcolo che decide.
Conclusione
Lato sviluppo la differenza non la fa il punteggio su un benchmark, ma tre scelte: il livello di ragionamento giusto per il compito, una cache costruita bene e un contesto tenuto corto e stabile. Sbagliarle costa più di qualunque differenza di listino fra modelli.
E un modello che usa il computer al posto tuo apre progetti prima fuori portata, ma sposta il problema sul perimetro: cosa può toccare, con quali credenziali, con quale registro. Per i conti, prezzi e costo reale; per il quadro generale, cos'è e dove non arriva.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
FAQ
Quanto è forte GPT-6 Astra sul coding?
Molto sui compiti da terminale: 57,9% su Terminal-Bench 4.0 contro 37,3% della generazione precedente. Meno distintivo sulla programmazione in senso ampio, dove su FrontierCode e sull'indice di Artificial Analysis è pari o leggermente dietro ai modelli Claude.
Batte Claude sul coding?
Dipende dal test. Su Terminal-Bench 4.0 sì, di 2,1 punti su Fable 5.1. Sull'Artificial Analysis Coding Agent Index no: 67,0 contro 68,1 di Opus 5. Su FrontierCode Fable 5 è avanti di frazioni di punto.
Cosa cambia in Codex?
OpenAI ha aggiornato l'impalcatura Codex dichiarando un completamento dei task 1,9 volte più veloce, e ha introdotto un sistema di note che preserva il contesto fra finestre diverse invece di comprimerlo in un riassunto.
Cos'è la funzione delle note fra contesti?
Un modo per conservare dettagli accumulati durante sessioni lunghe senza comprimerli a ogni compattazione. Le finestre precedenti restano consultabili. È sperimentale e va abilitata nella configurazione di Codex.
Quanto costa rispetto alle alternative?
10 dollari input e 50 output per milione di token, come Claude Fable 5.1 e il doppio di Claude Opus 5. Su Terminal-Bench 4.0 OpenAI dichiara però circa il 63% di costo stimato in meno rispetto a Fable 5.1.
Va bene per il completamento mentre si scrive?
È sovradimensionato. Per i suggerimenti in tempo reale contano velocità e costo, e una fascia più bassa fa lo stesso lavoro rispondendo prima.
Qual è l'identificativo API di GPT-6 Astra?
gpt-6-astra. La scheda ufficiale indica che alias e snapshot disponibili puntano tutti a questo identificativo.
Quali endpoint supporta?
Chat Completions, Responses e Batch, secondo la scheda del modello. Non sono supportati fine-tuning, embeddings, generazione immagini, video, audio e moderazione.