
GPT-6 Astra: prezzi, costo reale e quando conviene
Listino ufficiale di GPT-6 Astra, le voci di costo che il listino non contiene e i casi in cui per un'azienda si giustifica davvero.
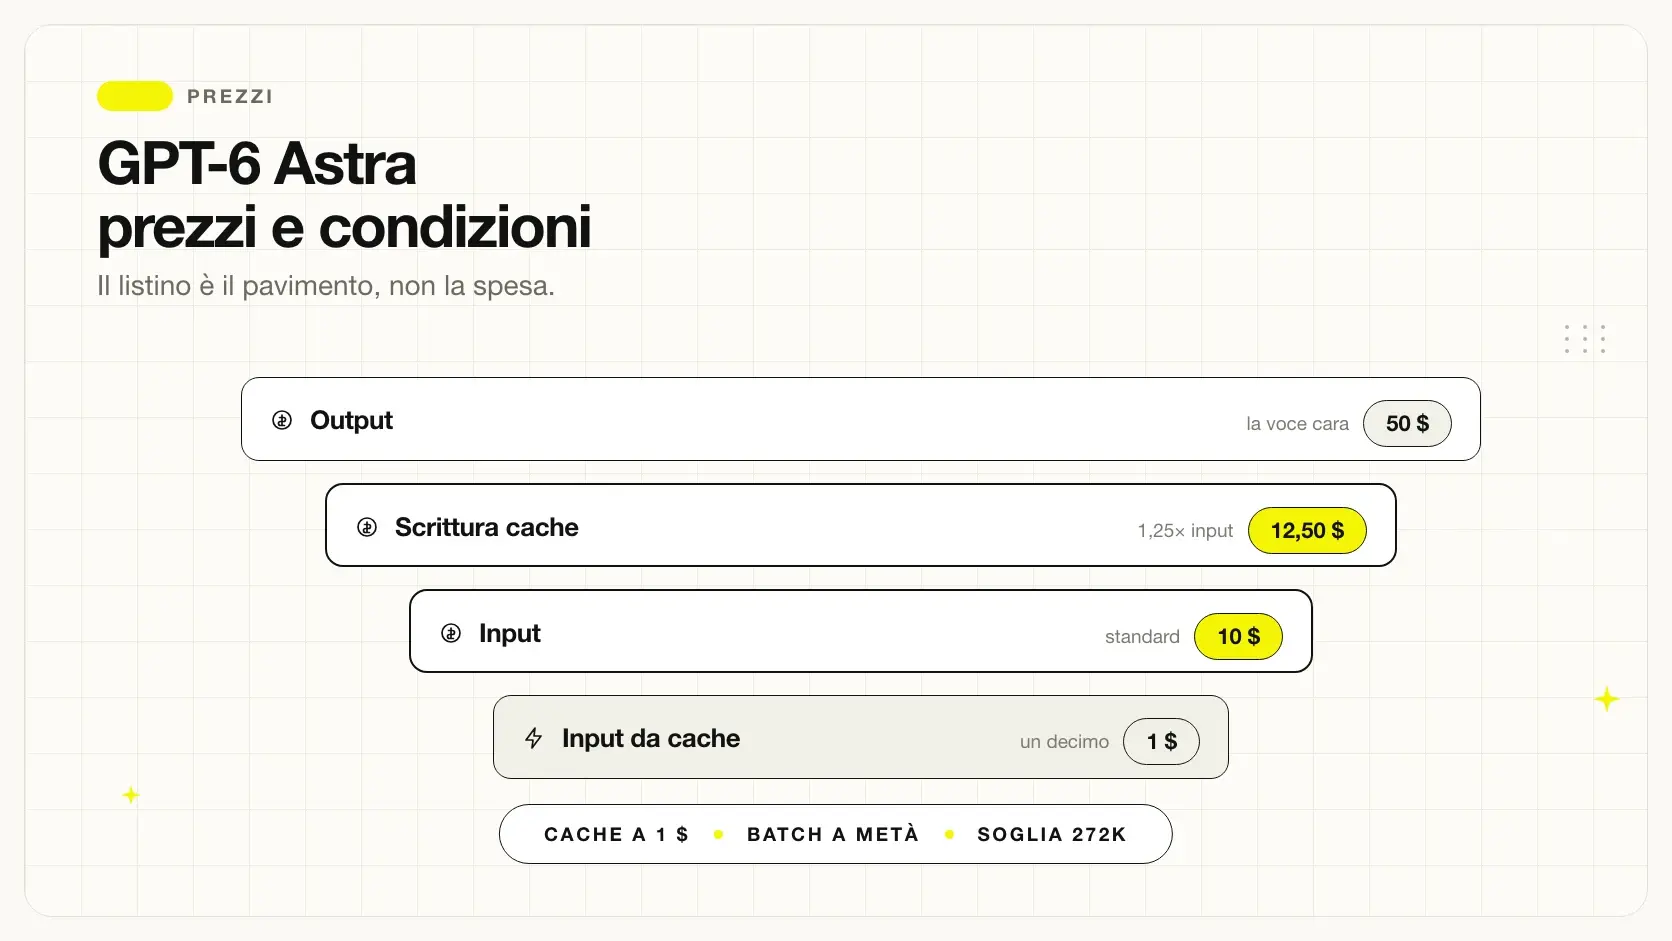
Il listino di GPT-6 Astra si legge in trenta secondi: 10 dollari per milione di token in input, 50 in output. Il conto vero, però, è un'altra cosa: fra prompt di sistema ripetuti a ogni chiamata, token di ragionamento fatturati come output e la soglia che raddoppia la tariffa, la differenza fra il preventivo e la fattura può essere di diverse volte.
Questa pagina mette in fila il listino ufficiale, le voci che il listino non contiene e i casi in cui per un'azienda la spesa si giustifica davvero. Dati verificati il 4 settembre 2026.
In sintesi
- Standard: 10 $ input / 50 $ output per milione di token.
- Oltre 272.000 token di prompt la tariffa cambia sull'intera richiesta.
- I token di ragionamento si pagano come output, e non si vedono.
- Batch e Flex costano meno, Fast mode costa di più.
- La cache è la leva che sposta di più il conto ricorrente.
- Il modello è quasi mai la voce più cara: lo è il tempo delle persone.
Il listino completo
| Voce | Prezzo per 1M token |
|---|---|
| Input | 10 $ |
| Input letto dalla cache | 1 $ |
| Scrittura in cache | 12,50 $ |
| Output | 50 $ |
Due osservazioni immediate. La prima: l'output costa cinque volte l'input, quindi un sistema che genera risposte lunghe spende molto più di uno conciso, a parità di modello. La seconda: la cache in lettura costa un decimo, che è uno sconto molto aggressivo.
La scrittura in cache, però, costa più dell'input normale: 12,50 contro 10 dollari, cioè 1,25 volte la tariffa non memorizzata. Significa che memorizzare conviene solo se quel contenuto verrà riutilizzato più di una volta.
La soglia dei 272.000 token
È il dettaglio che rovina più preventivi ed è scritto in una riga sola nella documentazione.
I prompt che superano i 272.000 token di input vengono fatturati al doppio per input e cache e a una volta e mezza in output. La maggiorazione si applica all'intera richiesta, non solo alla parte che eccede la soglia.
| Dimensione del prompt | Input | Output |
|---|---|---|
| Fino a 272K token | 10 $ | 50 $ |
| Oltre 272K token | 20 $ | 75 $ |
La conseguenza pratica è brutale: una richiesta da 271.000 token costa una cosa, una da 273.000 ne costa il doppio in input. Non c'è gradualità.
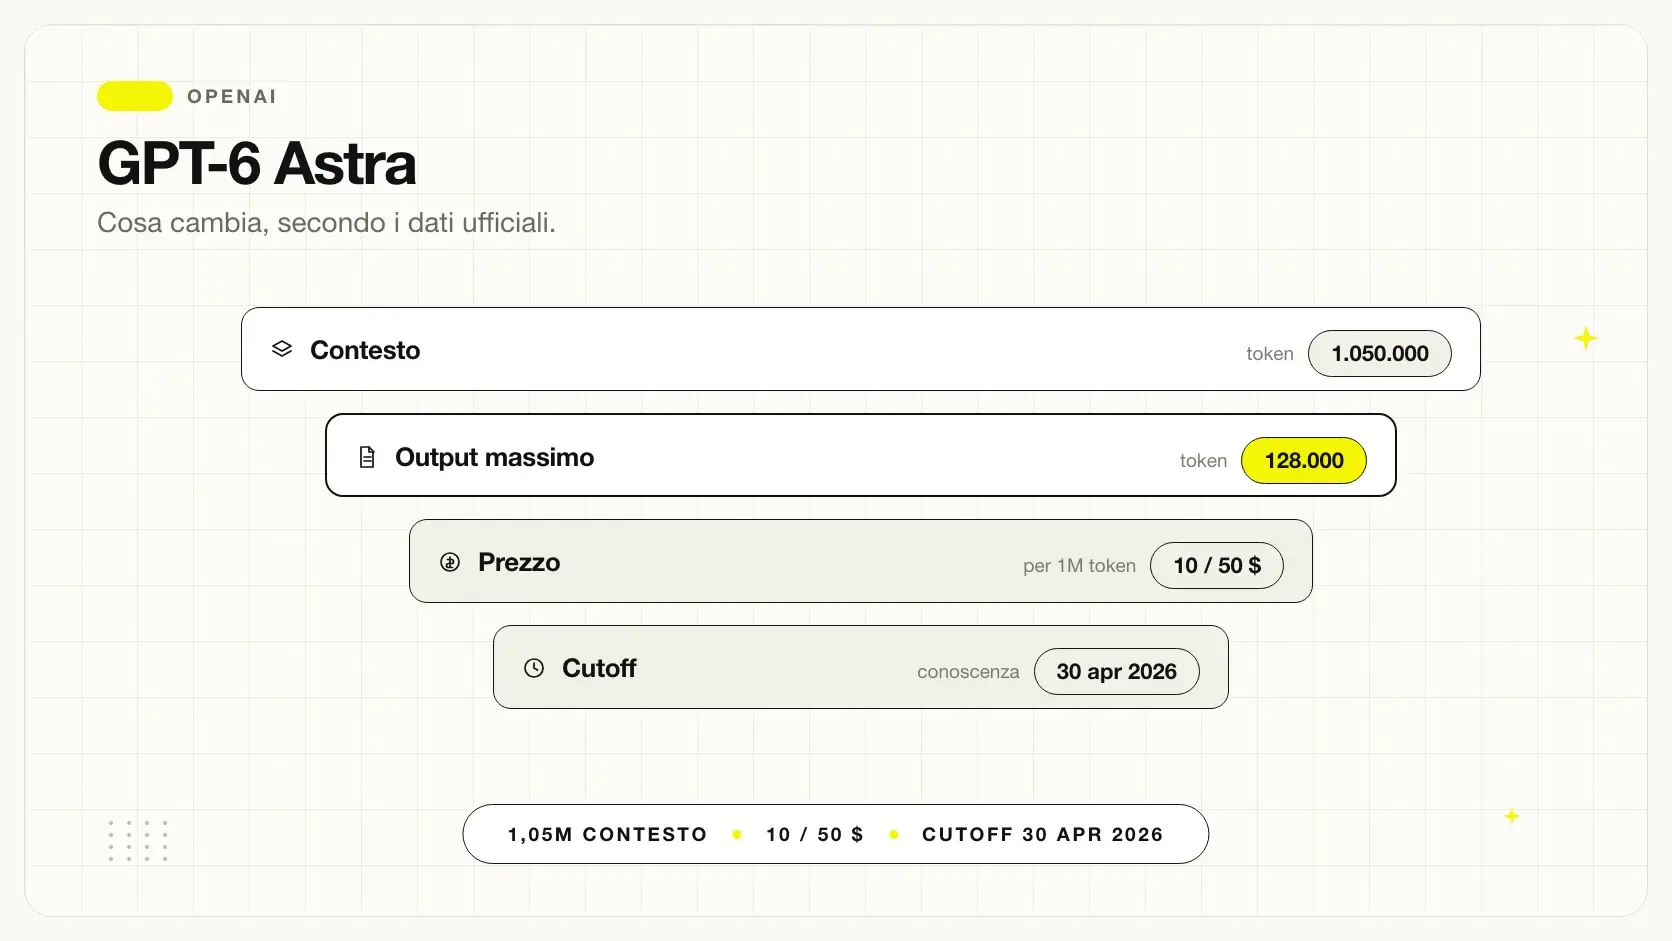
Chi passa documenti lunghi, interi archivi o conversazioni con molto storico può superare quella soglia senza rendersene conto. E siccome la finestra dichiarata è di 1.050.000 token, è tecnicamente possibile stare quattro volte sopra la soglia restando dentro i limiti del modello.
Batch, Flex e Fast mode
La documentazione indica tre modalità che cambiano il conto.
Batch e Flex costano il 50% delle tariffe Standard. Sono pensate per lavorazioni che possono attendere: elaborazioni notturne, arricchimento di archivi, analisi periodiche, classificazione retroattiva.
Fast mode offre fino al doppio della velocità al doppio del prezzo applicabile.
Batch o Flex
- Elaborazioni notturne programmate
- Arricchimento di archivi storici
- Report e analisi periodiche
- Classificazione retroattiva
Standard o Fast
- Chat con un utente che attende
- Suggerimenti in tempo reale
- Agenti che rispondono a comando
- Flussi applicativi interattivi
Molti sistemi aziendali contengono entrambe le cose e le trattano allo stesso modo, perché è stato più semplice costruirli così. Separare i due flussi permette di mandare la parte non urgente sul piano dimezzato: è un risparmio che non costa nulla in termini di risultato.
Cosa il listino non contiene
Come per ogni modello, il prezzo per token è il pavimento della spesa. Su Astra ci sono tre voci che pesano in modo particolare.
I token di ragionamento. Il modello espone cinque livelli di elaborazione, e i token intermedi si conteggiano come output — cioè alla voce da 50 dollari. Alzare il livello su un modello di questa fascia è la decisione con il maggiore impatto economico.
Il prompt di sistema ripetuto. Si paga a ogni chiamata. Su 20.000 richieste mensili, ogni migliaio di token di istruzioni sono 20 milioni di token di input al mese: 200 dollari solo per ripetere lo stesso testo — a meno di usare la cache.
I tentativi falliti. Ogni chiamata che non produce un risultato utilizzabile si paga comunque.
I limiti di traffico
La documentazione riporta soglie che crescono con il livello dell'account. Vale la pena conoscerle prima di progettare un sistema ad alto volume, perché sono un vincolo reale.
| Livello | Richieste al minuto | Token al minuto |
|---|---|---|
| Gratuito | non supportato | non supportato |
| Livello 1 | 500 | 500.000 |
| Livello 2 | 5.000 | 1.000.000 |
| Livello 3 | 5.000 | 2.000.000 |
| Livello 4 | 10.000 | 4.000.000 |
| Livello 5 | 15.000 | 40.000.000 |
Il livello sale automaticamente con l'uso e la spesa accumulata. Per un progetto che parte da zero significa che i primi giorni si lavora entro limiti stretti: va messo in conto nella pianificazione di una migrazione o di un lancio, soprattutto se prevedi di elaborare un archivio storico in blocco.
Le cinque voci del costo reale
| Voce | Nel listino? | Peso tipico |
|---|---|---|
| Testo dell'utente | sì | base |
| Prompt di sistema ripetuto | no, ma si paga sempre | spesso enorme |
| Token di ragionamento | parzialmente | molto variabile |
| Tentativi falliti | no | proporzionale ai passaggi |
| Revisione umana | no | quasi sempre la maggiore |
Le ultime due righe non compaiono in nessun preventivo e sono quelle che decidono se un progetto ha senso.
Il prompt di sistema, moltiplicato
Le istruzioni che governano il comportamento del modello si pagano a ogni singola chiamata.
Su 20.000 richieste mensili, ogni migliaio di token di istruzioni sono 20 milioni di token di input al mese: 200 dollari solo per ripetere lo stesso testo. Con un prompt da 3.000 token diventano 600.
Qui c'è però la contromisura più efficace disponibile su questo modello: la cache. L'input letto dalla cache costa 1 dollaro invece di 10, cioè un decimo. Su un prompt di sistema stabile riletto migliaia di volte, la differenza è di un ordine di grandezza.
I token di ragionamento
Su Astra questa è la voce che cresce più in fretta, perché i cinque livelli di effort producono quantità di token intermedi molto diverse, tutti conteggiati come output a 50 dollari per milione.
Un esempio con 20.000 richieste mensili, input da 3.000 token e risposta visibile da 500.
| Livello di effort | Output stimato | Costo output mensile |
|---|---|---|
| Basso | ~600 token | 600 $ |
| Medio | ~1.500 token | 1.500 $ |
| Alto | ~3.000 token | 3.000 $ |
| Molto alto | ~6.000 token | 6.000 $ |
I moltiplicatori sono indicativi e vanno misurati sul proprio caso, ma la direzione è certa: la stessa richiesta può costare dieci volte tanto cambiando un parametro.
L'input resta invece costante a 600 dollari in tutti gli scenari. Su un modello dove l'output costa cinque volte l'input, è il livello di ragionamento la leva economica principale — il dettaglio è in i cinque livelli di ragionamento.
Il tempo delle persone
È la voce che nessuno mette in preventivo e che quasi sempre supera tutte le altre messe insieme.
Se ogni esito richiede due minuti di controllo umano, su 20.000 casi al mese sono oltre 660 ore. Confrontale con qualunque cifra di questa pagina: non c'è paragone.
Ne discende una conseguenza controintuitiva ma solida: un modello più caro che riduce la revisione può costare meno in totale. Ed è esattamente ciò che OpenAI rivendica in diversi punti dell'annuncio, dichiarando costi per task inferiori nonostante la tariffa più alta.
| Benchmark | Costo dichiarato |
|---|---|
| Terminal-Bench 4.0 | ~9% meno di Sol, ~63% meno di Fable 5.1 |
| BenchCAD | ~43% meno di Sol, ~86% meno di Fable 5.1 |
| Terminal-Bench Science | ~31% meno di Fable 5.1 |
| GPQA Diamond (livello ridotto) | ~37% meno di Sol |
| Agents' Last Exam | ~65% di token di output in meno di Opus 5 |
Sono stime del produttore su singoli benchmark, non misurazioni indipendenti. Ma indicano dove guardare: il costo per compito completato, non il prezzo per token.
Un caso completo, dal preventivo alla fattura
Seguiamo un esempio realistico, perché mostra dove le stime si rompono.
La stima iniziale. Un'azienda vuole analizzare 8.000 documenti al mese. Calcolo a tavolino: 2.500 token per documento, 600 di risposta. Risultato: 200 dollari di input più 240 di output, 440 dollari al mese. Sembra sostenibile.
Cosa succede in produzione. Il prompt di sistema, con le istruzioni e tre esempi, occupa 2.200 token e si paga a ogni chiamata: sono 17,6 milioni di token mensili, cioè 176 dollari che nessuno aveva previsto. Il livello di ragionamento impostato su medio porta l'output medio a 1.400 token invece di 600, quindi la voce di output passa da 240 a 560 dollari. Il 15% dei documenti richiede un secondo passaggio.
| Voce | Stima | Realtà |
|---|---|---|
| Input documenti | 200 $ | 200 $ |
| Prompt di sistema | non previsto | 176 $ |
| Output | 240 $ | 560 $ |
| Ritentativi (15%) | non previsti | 140 $ |
| Totale API | 440 $ | 1.076 $ |
| Revisione umana | non prevista | ~130 ore/mese |
La spesa API è più che raddoppiata. Ma il dato che colpisce è l'ultima riga: se il 5% dei documenti richiede un controllo di venti minuti, sono oltre centotrenta ore mensili — che valgono molto più dei mille dollari.
Dove intervenire. Mettere in cache il prompt di sistema porta quella voce da 176 a circa 18 dollari. Abbassare il livello di ragionamento, se il compito è di estrazione, riporta l'output vicino alla stima. Ma l'intervento con il ritorno più alto resta ridurre quel 5% di documenti da rivedere — e quello si ottiene migliorando le istruzioni, non cambiando modello.
Il conto su un volume reale
Prendiamo un sistema che elabora 20.000 richieste al mese, con 3.000 token di input e 800 di output ciascuna, tutto sotto la soglia dei 272K.
| Voce | Token mensili | Costo |
|---|---|---|
| Input | 60M | 600 $ |
| Output | 16M | 800 $ |
| Totale base | — | 1.400 $ |
| Con Batch (50%) | — | 700 $ |
| Con 20% di ritentativi | — | 1.680 $ |
Due letture. La prima: l'output pesa più dell'input anche con prompt quattro volte più lunghi delle risposte, perché costa cinque volte tanto. Chiedere risposte concise dove la lunghezza non serve è l'intervento più rapido in assoluto.
La seconda: spostare quel carico su Batch, se non ha urgenza, vale 8.400 dollari all'anno. È più di quanto si ottenga da qualunque ottimizzazione del prompt, e richiede una riga di configurazione.
Quanto costa rispetto alle alternative
Per dare un riferimento, ecco i listini di altri modelli di punta, tutti per milione di token e tutti verificati sulle documentazioni ufficiali dei rispettivi fornitori.
| Modello | Input | Output |
|---|---|---|
| GPT-6 Astra | 10 $ | 50 $ |
| Claude Fable 5.1 | 10 $ | 50 $ |
| Claude Opus 5 | 5 $ | 25 $ |
| GPT-5.6 Sol | 4 $ | 20 $ |
| GPT-5.6 Terra | 2 $ | 12 $ |
Astra si colloca esattamente sullo stesso punto di Fable 5.1: al vertice del mercato il prezzo ha smesso di essere una leva competitiva, e i due principali fornitori si sono allineati.
Rispetto alla generazione precedente dello stesso produttore, però, il salto è netto: Astra costa due volte e mezzo GPT-5.6 Sol in input e due volte e mezzo in output. È una differenza che va giustificata con un guadagno misurabile sui propri casi, non con la scheda tecnica.
Il confronto esteso fra le fasce di punta è in i modelli di punta a confronto sui prezzi.
Una nota sul confronto fra piani
Quando confronti Astra con un modello Google, ricorda che i due listini non sono costruiti allo stesso modo: OpenAI espone una tariffa unica con modalità dichiarate (Standard, Batch, Flex, Fast), Google articola il prezzo su piani di servizio e su alcuni modelli applica scaglioni per dimensione del prompt.
Un confronto onesto richiede quindi di dichiarare quale modalità si sta citando da entrambe le parti. Un numero Batch di OpenAI accostato a un prezzo prioritario di Google, o viceversa, produce una differenza che non esiste.
Il modo per neutralizzare tutto questo è sempre lo stesso: eseguire cento casi reali su entrambi, leggere i token effettivamente consumati e dividere la spesa totale per i casi conclusi correttamente. Quel numero è confrontabile; il prezzo di listino da solo non lo è.
Da qui, tre approfondimenti utili. Per i numeri ufficiali completi vedi GPT-6 Astra: cos'è e cosa cambia. Il listino con le condizioni che cambiano il conto è in GPT-6 Astra: tutti i benchmark ufficiali. E per il verdetto per tipo di azienda, Dove GPT-6 Astra non è il migliore.
La domanda che decide
Tutti i numeri dell'annuncio convergono su una distinzione sola: il tuo compito richiede di eseguire o di sapere?
| Area | Guadagno di Astra sulla generazione precedente |
|---|---|
| Terminal-Bench Science | +42 punti |
| SRE-Bench | +32 punti |
| AutomationBench | +23 punti |
| ScreenSpot-Pro | +16 punti |
| GPQA Diamond (conoscenza) | +1,4 punti |
| LifeSciBench (conoscenza) | +0,4 punti |
Sui compiti che richiedono di portare a termine lavoro, il salto è di decine di punti. Su quelli che richiedono di sapere, è di frazioni di punto.
Se il tuo processo è "rispondere a domande sui nostri documenti", questo modello ti dà poco più di quello precedente e costa due volte e mezzo. Se è "compilare, verificare, aggiornare, portare a conclusione", il quadro cambia.
Quando si giustifica
Ha senso valutarlo
- Processi dentro software senza API disponibili
- Portali esterni da compilare a mano
- Catene di molti passaggi concatenati
- Lavoro tecnico specialistico o da terminale
- Documenti che devono seguire template rigidi
- Analisi che incrociano più fonti
È sovradimensionato
- Classificare messaggi o ticket
- Estrarre campi da documenti strutturati
- Rispondere da una base documentale
- Scrivere email o testi brevi
- Riassumere contenuti
- Instradare richieste
La colonna di destra copre la maggior parte dei progetti AI che una PMI affronta per primi. Per quelli esiste, nella stessa famiglia OpenAI, un modello che costa un cinquantesimo in input.
La colonna di sinistra descrive invece uno spazio che finora era difficile da automatizzare: processi che attraversano software non integrabili, dove l'alternativa era pagare un'integrazione su misura o continuare a mano.
Il paradosso del costo
C'è un punto controintuitivo che merita attenzione prima di scartarlo per il prezzo.
Astra costa di più a token, ma OpenAI dichiara costi per task inferiori su diversi benchmark: circa il 63% in meno di Fable 5.1 su Terminal-Bench 4.0, circa il 43% in meno di Sol su BenchCAD, circa il 65% di token di output in meno di Opus 5 su Agents' Last Exam.
Il meccanismo è semplice: se il modello consuma meno passaggi e meno token per arrivare al risultato, la tariffa più alta viene compensata. E se aumenta la percentuale di compiti conclusi senza intervento umano, si riduce la voce più grande di tutte — il tempo delle persone.
Sono stime del produttore, non misurazioni indipendenti. Ma indicano cosa misurare: non il prezzo per token ma il costo per compito completato, con il metodo descritto in quanto costa davvero GPT-6 Astra.
Cosa conta più del modello
Vale la pena essere chiari su una cosa: la scelta del modello è raramente il fattore che decide il successo di un progetto AI in azienda.
I documenti. Un sistema che risponde da una base documentale disordinata produrrà risposte disordinate, con qualunque modello. Riordinare quei documenti vale più di qualunque scelta tecnica.
Le istruzioni. Precise, non lunghe. Un campo descritto in modo ambiguo produce errori che sembrano capricci del modello e sono invece istruzioni imprecise.
L'integrazione. Se il sistema richiede di aprire un altro strumento o cambiare abitudini, l'adozione crolla in poche settimane. È la causa più frequente di fallimento, molto più del modello sbagliato.
I controlli. Un campione settimanale di esiti rivisti da una persona. Mezz'ora che protegge l'investimento intero.
Tre profili aziendali
PMI di servizi, dieci persone, primo progetto AI. Il lavoro tipico è rispondere a richieste ricorrenti e produrre documenti standard. Nessuna delle due cose richiede questa fascia: si risolvono con modelli che costano un quinto o meno. Il consiglio è partire da lì, misurare, e semmai salire dopo aver capito il problema — non prima.
Azienda manifatturiera con gestionale storico. Qui il quadro cambia. Se ci sono processi che passano da un software senza API — inserimento ordini, aggiornamento anagrafiche, controlli su portali esterni — l'uso del computer apre una possibilità che prima non c'era. Vale la prova su dieci flussi completi.
Studio professionale con analisi documentali complesse. Poche pratiche al mese, ognuna di valore alto e con un costo dell'errore importante. Il prezzo unitario conta poco; conta che il modello segnali i punti dubbi invece di risolverli in silenzio. È un caso in cui la fascia alta si giustifica, ma dove conviene confrontare anche le alternative allo stesso prezzo.
Il criterio generale per una PMI, indipendente dal modello specifico, è in quale modello AI conviene a una PMI.
Il vincolo che esclude a monte
Tre limiti tecnici possono chiudere la valutazione prima di iniziare, e vale la pena controllarli per primi.
Audio e video non supportati. Se il processo prevede trascrizione di chiamate o analisi di contenuti parlati, serve un altro strumento affiancato — e a quel punto conviene ripensare l'intera architettura.
Fine-tuning non disponibile. Non puoi specializzare il modello sul linguaggio della tua azienda. Il risultato equivalente si ottiene con istruzioni e documenti di riferimento, ma è una scelta diversa che va progettata.
I controlli possono fermare un task. In API l'esecuzione si interrompe. Per un flusso notturno senza supervisione è un requisito architetturale: serve registrare l'interruzione e portarla all'attenzione di qualcuno.
Nessuno dei tre è insormontabile, ma scoprirli a metà progetto costa molto più che verificarli il primo giorno.
Per andare più a fondo. Se stai valutando l’adozione, parti da GPT-6 Astra: cos'è e cosa cambia. Il calcolo della spesa reale — quella che comprende ragionamento, tentativi e revisione umana — è in GPT-6 Astra: prezzi e come si paga, mentre i limiti dichiarati sono raccolti in GPT-6 Astra: tutti i benchmark ufficiali.
Il primo progetto, se decidi di partire
Un'ultima raccomandazione che vale a prescindere dal modello scelto.
Il primo progetto AI di un'azienda non dovrebbe essere il più ambizioso: dovrebbe essere quello che permette di imparare senza rischiare. Un processo ripetitivo, con criteri chiari, volumi sufficienti a giustificare l'automazione e errori riconoscibili e correggibili.
Un primo progetto ambizioso ha molte probabilità di deludere, e una delusione iniziale chiude la porta a tutto il resto per anni. Un progetto semplice che funziona bene crea invece la fiducia e l'esperienza per affrontarne uno più difficile — e produce, come effetto collaterale, i dati necessari per tarare tutto il resto.
Se il caso d'uso che giustifica Astra è complesso — un agente che opera dentro software, una catena di molti passaggi — vale doppio: conviene arrivarci per gradi, partendo da un pezzo del processo invece che da tutto insieme.
Le domande da fare a chi te lo propone
Se un fornitore o un consulente ti propone questo modello, tre domande rivelano in pochi minuti quanto lavoro c'è dietro.
- «Avete provato una fascia inferiore? Con che risultato?»
- «Cosa succede quando il modello non sa rispondere?»
- «Quanta revisione umana resta dopo l'automazione?»
La prima è quella che fa risparmiare di più: la tentazione commerciale spinge verso l'alto, e chi propone una fascia inferiore spiegando perché basta sta lavorando nel tuo interesse.
La seconda separa una proposta seria da una demo. Se non c'è una risposta precisa, il sistema chiuderà con sicurezza anche i casi che non ha capito — e quelli producono errori che nessuno verificherà.
La terza è quella che stabilisce il vero ritorno. Un'automazione che lascia il 30% dei casi da rivedere a mano ha liberato molto meno tempo di quanto sembri.
Come presentare il costo a chi decide
Un punto pratico che spesso manca. Il costo di un progetto AI è difficile da comunicare perché il confronto naturale — «prima costava X, ora Y» — spesso non esiste: quel lavoro prima non veniva fatto, o veniva fatto da persone il cui tempo non era tracciato.
Tre modi che funzionano meglio del confronto diretto.
- Costo per caso trattato: una cifra piccola e confrontabile nel tempo
- Ore liberate: quante ore di lavoro ripetitivo sono tornate disponibili
- Cose che ora si fanno e prima restavano indietro
Il terzo è quasi sempre il più convincente, perché descrive un guadagno che il confronto sui costi non cattura: un archivio finalmente classificato, un controllo fatto su tutto invece che a campione, una risposta che arriva in minuti invece che in giorni.
Da qui, tre approfondimenti utili. Per i numeri ufficiali completi vedi GPT-6 Astra: cos'è e cosa cambia. Il listino con le condizioni che cambiano il conto è in GPT-6 Astra: prezzi e come si paga. E per il verdetto per tipo di azienda, GPT-6 Astra: tutti i benchmark ufficiali.
Esempi pratici
Estrazione dati, 20.000 documenti al mese. Prompt di sistema da 1.500 token, documento da 2.000, risposta da 400, livello di ragionamento basso. Ordine di grandezza: circa 300 dollari base, che scendono sensibilmente con la cache sul prompt e con Batch se il carico è notturno.
Assistente interno, 3.000 richieste al mese. Volumi bassi: la spesa API è nell'ordine di poche decine di euro e non è la voce da ottimizzare. Conviene investire il tempo nella qualità dei documenti forniti.
Agente su compiti multi-passo, 5.000 esecuzioni al mese. Qui il costo cresce più che linearmente, perché a ogni passaggio il contesto si allunga e i tentativi falliti si pagano interi. La stima va fatta su esecuzioni complete, non su singole chiamate.
Errori da evitare
- Moltiplicare a tavolino invece di misurare i token reali.
- Dimenticare il prompt di sistema, che si paga sempre.
- Stimare l'output dalla lunghezza delle risposte visibili.
- Ignorare la soglia dei 272K.
- Escludere il tempo delle persone dal calcolo.
- Trattare i carichi in blocco come urgenti.
Il terzo punto merita un chiarimento: sui modelli che ragionano, i token intermedi non compaiono nel testo finale ma si pagano. Stimare il consumo dalla lunghezza della risposta porta sistematicamente a sottovalutarlo.
Come applicarlo in azienda
La procedura che produce una stima affidabile richiede un pomeriggio e sostituisce qualunque calcolo teorico.
Prendi cento casi reali ed eseguili sul modello. Leggi i token effettivamente consumati, che l'API riporta per ogni chiamata — è l'unico modo di catturare in un colpo solo prompt di sistema, ragionamento e verbosità. Somma tutto, compresi i tentativi falliti, e dividi per il numero di casi conclusi correttamente.
Poi aggiungi il tempo di revisione: minuti per caso moltiplicati per il volume mensile.
L'ordine degli interventi che fa risparmiare di più, in ordine di ritorno:
- Verifica se serve questa fascia — vale fino al 95%
- Sposta i carichi non urgenti su Batch o Flex — vale il 50%
- Metti in cache il contesto stabile — vale fino al 90% su quella porzione
- Abbassa il ragionamento dove non serve — vale molto sull'output
- Accorcia il prompt di sistema — un'ora di lavoro, effetto permanente
Il primo punto viene prima di tutto: per classificare o estrarre esiste quasi sempre una fascia che fa lo stesso lavoro a un cinquantesimo, secondo il criterio di quando basta un modello economico.
Conclusione
Il prezzo di un modello non è il suo listino. È il listino moltiplicato per come lo usi: quante volte rispedisci lo stesso prompt di sistema, quanto ragionamento chiedi, se superi la soglia dei 272.000 token, quanto lavoro umano resta a valle.
Prima di decidere, fai il conto su un volume reale per un mese e confrontalo con l'alternativa più economica che porta comunque a casa il risultato. Se la differenza non si vede nel bilancio, la scelta è già fatta. Per capire cosa fa il modello, parti da cos'è e dove non arriva; per i numeri, i benchmark ufficiali.
Come lo applichiamo in azienda
Risorse correlate
FAQ
Quanto costa GPT-6 Astra?
Sul piano Standard costa 10 dollari per milione di token in input e 50 in output. L'input letto dalla cache costa 1 dollaro e la scrittura in cache 12,50 dollari per milione di token.
Cosa succede oltre i 272.000 token di prompt?
La documentazione indica che i prompt con più di 272.000 token di input vengono fatturati al doppio per input e cache e a una volta e mezza in output, e la maggiorazione si applica all'intera richiesta.
Batch e Flex quanto costano?
Il 50% delle tariffe Standard. Sono adatti alle lavorazioni che non hanno urgenza, dove il dimezzamento non ha alcun effetto sul risultato prodotto.
Cos'è la Fast mode?
Una modalità che offre fino al doppio della velocità rispetto all'elaborazione Standard, al doppio del prezzo applicabile. Ha senso solo dove la latenza è un requisito stringente.
La cache fa davvero risparmiare?
Sì, molto: l'input letto dalla cache costa un decimo di quello normale. Ma la scrittura in cache costa più dell'input non memorizzato, quindi conviene solo su contenuti riutilizzati più volte.
Il piano gratuito include Astra?
No. La tabella dei limiti di traffico indica che il livello gratuito non è supportato per questo modello.
Il listino corrisponde alla spesa reale?
No, la sottostima sistematicamente. Vanno aggiunti il prompt di sistema ripetuto, i token di ragionamento contati come output, i tentativi falliti e il tempo di revisione umana.
Qual è la voce che pesa di più?
Quasi sempre il tempo delle persone. Se ogni esito richiede due minuti di controllo, su 20.000 casi al mese sono oltre 660 ore: molto più della spesa di API.