
Claude Opus 5.5: benchmark ufficiali, prezzi e confronto con Fable 5.1 e GPT-6 Astra
Claude Opus 5.5 è uscito il 22 settembre 2026: 4 $ input e 20 $ output per milione di token, livello di Fable 5.1. Tutti i benchmark ufficiali a confronto con GPT-6 Astra.
Claude Opus 5.5 è il nuovo modello di Anthropic, uscito il 22 settembre 2026 come primo membro della famiglia Claude 5.5. La notizia non è il punteggio in più: è il prezzo. Costa 4 dollari per milione di token in ingresso e 20 in uscita, contro i 10 e 50 di Claude Fable 5.1 e di GPT-6 Astra, e secondo Anthropic lavora al livello di Fable 5.1 sulla maggior parte dei compiti.
Per una PMI che usa l'AI dentro i processi, non per curiosità, questo cambia il conto: la stessa fattura letta da un agente, la stessa mail classificata, lo stesso preventivo compilato costano meno della metà rispetto a tre settimane fa, a qualità uguale o superiore. In questo articolo trovi i benchmark ufficiali riga per riga, i prezzi, dove GPT-6 Astra resta davanti e come decidere in azienda. Dati verificati il 23 settembre 2026 sulle pagine di Anthropic e OpenAI: i modelli cambiano in fretta, verifica sempre la pagina ufficiale prima di firmare un contratto.
In sintesi
- Claude Opus 5.5 costa 4 $ input e 20 $ output per milione di token: il 60% in meno di Fable 5.1 e di GPT-6 Astra a listino.
- Sul lavoro tipico costa il 40% in meno di Opus 5 e genera testo il 30% più in fretta.
- Nella tabella ufficiale Anthropic è davanti a Fable 5.1 in 9 benchmark su 9 e a GPT-6 Astra in 4 su 6.
- GPT-6 Astra resta davanti su AutomationBench e Terminal-Bench-Science.
- Contesto da 1 milione di token, modalità Fast a 8 e 40 $, protezioni su biologia e cybersecurity come Fable 5.1.
- La scelta giusta si fa sul costo per attività finita, non sul punteggio.
Cos'è Claude Opus 5.5 e cosa cambia rispetto a Opus 5?
Opus 5.5 è il modello che Anthropic definisce "the new leading model": un salto netto rispetto a Opus 5, ma con un consumo di calcolo inferiore, e quindi un prezzo più basso. È la stessa strategia che abbiamo raccontato in Fable 5.1 contro Sonnet 5: i modelli di punta arrivano prima, poi la stessa capacità scende di fascia e di prezzo.
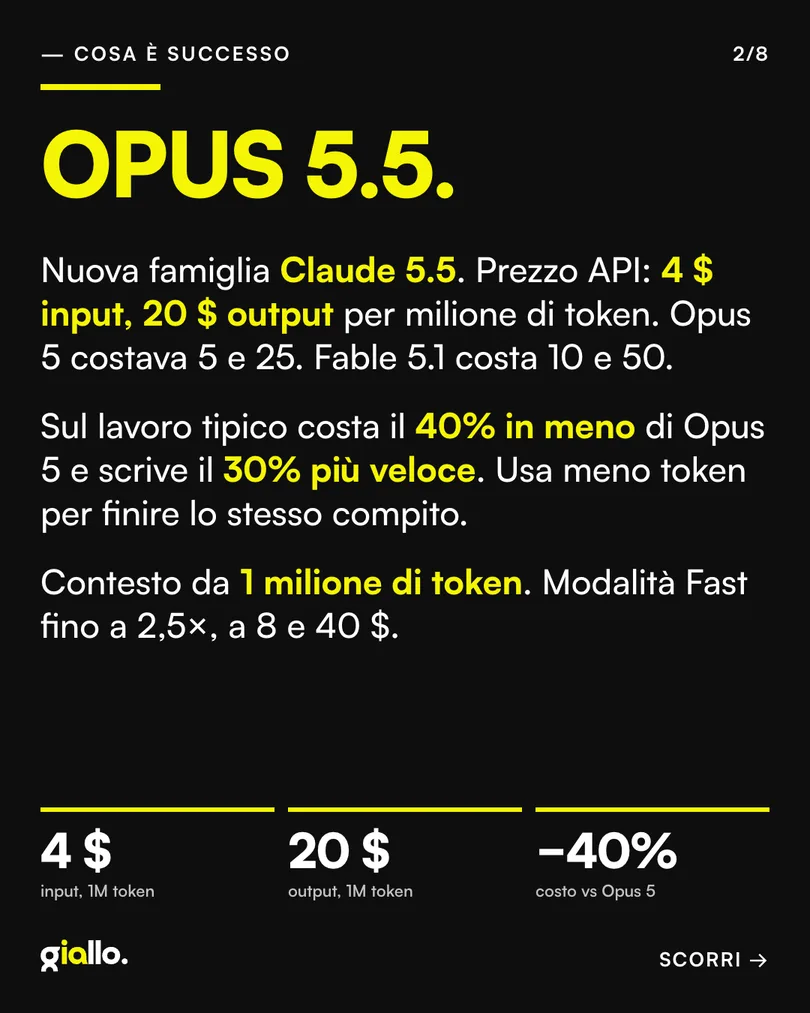
Tre numeri dichiarati da Anthropic riassumono il cambio:
- −40% di costo sui carichi di lavoro tipici rispetto a Opus 5. Il calo viene da due fattori insieme: il prezzo per token più basso e il fatto che il modello usa meno token e meno passaggi per chiudere lo stesso compito.
- +30% di velocità nella generazione del testo, con una modalità Fast che arriva a 2,5 volte.
- −85% di tentativi di aggirare i limiti rispetto a Opus 5 nei test comportamentali interni. Un dato che in azienda pesa quanto un benchmark: un agente che rispetta i confini che gli dai è un agente che puoi lasciare lavorare da solo.
C'è anche un cambio di tono nelle risposte. Anthropic dice che i messaggi sono "molto più facili da capire a colpo d'occhio", e i tester citati parlano di risposte più corte del 40% a parità di contenuto. Per chi paga i token in uscita è un risparmio diretto.
Quanto costa Claude Opus 5.5?
Ecco i listini ufficiali per milione di token, aggiornati al 23 settembre 2026.
| Modello | Input | Output | Contesto | Uscita |
|---|---|---|---|---|
| Claude Opus 5.5 | 4 $ | 20 $ | 1M in / 128K out | 22 settembre 2026 |
| Claude Opus 5 | 5 $ | 25 $ | 1M | primavera 2026 |
| Claude Fable 5.1 | 10 $ | 50 $ | 1M | 1 settembre 2026 |
| GPT-6 Astra | 10 $ | 50 $ | 1,05M in / 128K out | 3 settembre 2026 |
La lettura dalla cache di Opus 5.5 costa 0,20 $ per milione di token (era 0,50 su Opus 5): per gli agenti che rileggono lo stesso contesto a ogni passaggio, come un archivio di preventivi o un manuale interno, è la voce che pesa di più. Se vuoi il quadro completo dei piani e dei modelli Claude, lo tieni aggiornato in Claude: prezzi e modelli a confronto.
Benchmark ufficiali: Opus 5.5 contro Fable 5.1, Opus 5 e GPT-6 Astra
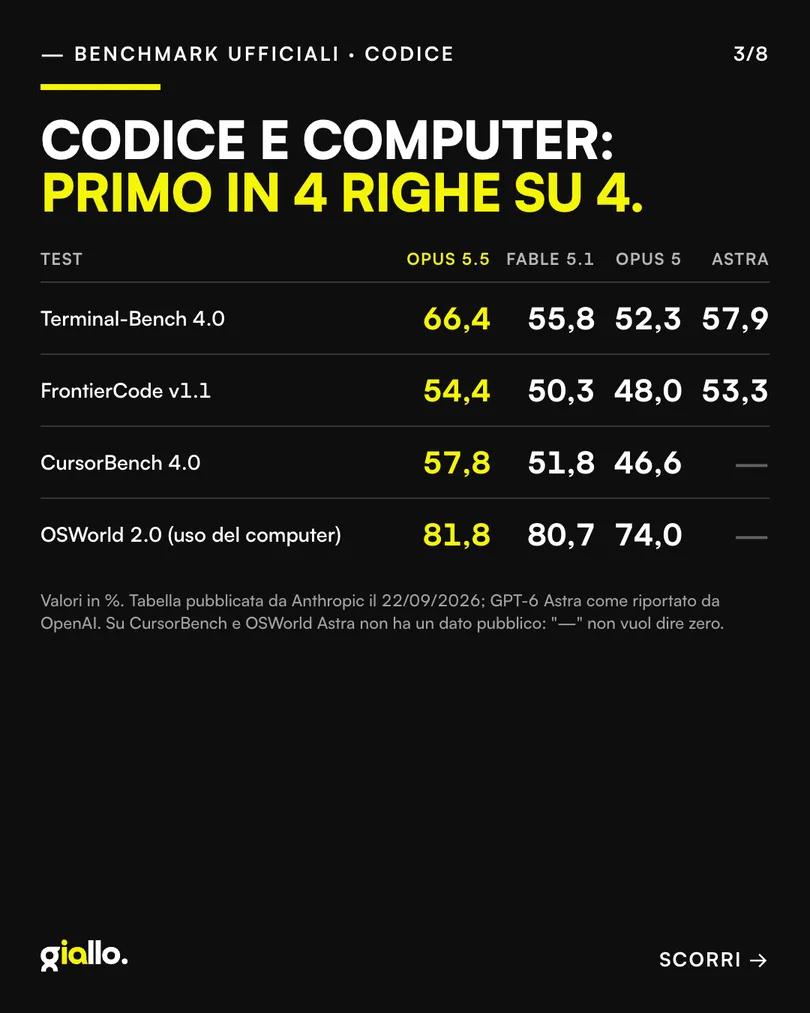
La tabella sotto riporta i valori pubblicati da Anthropic nella pagina di annuncio, con i risultati di GPT-6 Astra così come riportati da OpenAI. In percentuale, salvo dove indicato. Il trattino significa che non esiste un dato pubblico, non che il modello ha fatto zero.
| Benchmark | Cosa misura | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | compiti professionali da riga di comando | 66,4 | 55,8 | 52,3 | 57,9 |
| FrontierCode v1.1 | modifiche al codice che verrebbero approvate | 54,4 | 50,3 | 48,0 | 53,3 |
| CursorBench 4.0 | compiti ambigui su più file, da sessioni reali | 57,8 | 51,8 | 46,6 | — |
| OSWorld 2.0 | uso del computer (punteggio parziale) | 81,8 | 80,7 | 74,0 | — |
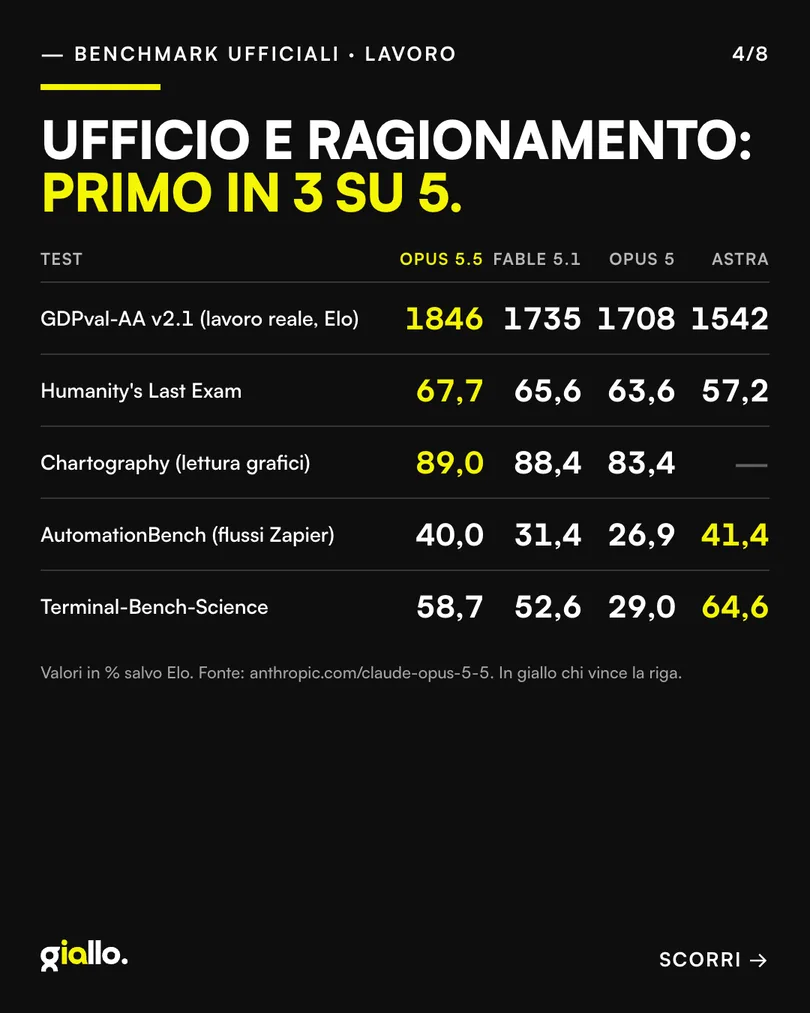
| GDPval-AA v2.1 (Elo) | lavoro professionale reale in 44 mestieri | 1846 | 1735 | 1708 | 1542 |
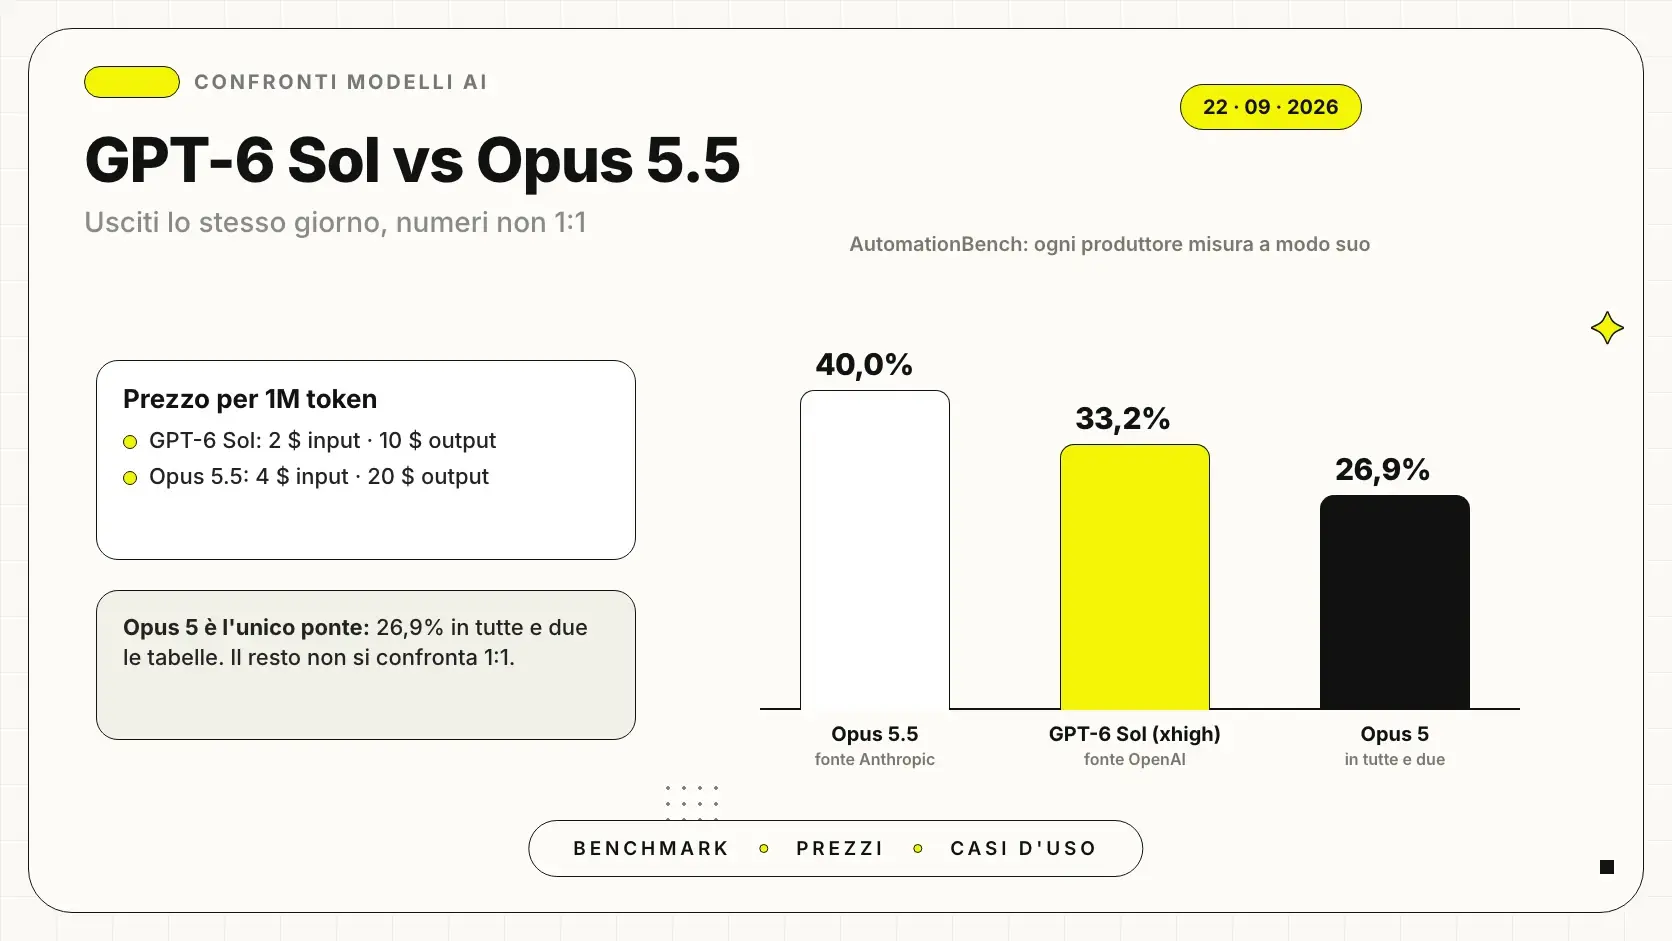
| AutomationBench | flussi di lavoro tra app, misurato da Zapier | 40,0 | 31,4 | 26,9 | 41,4 |
| Humanity's Last Exam | ragionamento multidisciplinare, con strumenti | 67,7 | 65,6 | 63,6 | 57,2 |
| Terminal-Bench-Science 0.1 | ricerca scientifica da terminale | 58,7 | 52,6 | 29,0 | 64,6 |
| Chartography | lettura di grafici, con strumenti | 89,0 | 88,4 | 83,4 | — |
Tre note che Anthropic scrive in piccolo e che vanno lette:
- I risultati di Opus 5.5 usano il ragionamento adattivo al massimo sforzo; Terminal-Bench 4.0 è riportato a sforzo "xhigh" per Opus 5.5 e "high" per Astra, come pubblicato da OpenAI. L'errore standard su Terminal-Bench è di ±2,6 punti.
- AutomationBench è stato eseguito da Zapier senza modelli di riserva: gli interventi delle protezioni contano come fallimenti. È il motivo per cui il punteggio Claude è più basso di quello misurato altrove.
- Anthropic ha cambiato la suite di test: non pubblica più GPQA Diamond, SWE-bench Verified o ARC-AGI. I confronti con i record di Astra su quei test, che trovi in tutti i benchmark di GPT-6 Astra, non sono possibili su fonti ufficiali. Anche i test omonimi esistono in versioni diverse: Terminal-Bench 4.0 per Anthropic e OpenAI, 2.0 per Google, 3.0 per xAI.
Il dato che Anthropic sottolinea di più non è il primato ma l'efficienza: su FrontierCode, allo sforzo predefinito, Opus 5.5 batte il miglior punteggio di Astra a circa un quinto del costo per attività.
Dove GPT-6 Astra resta davanti
Sarebbe facile fermarsi al titolo. Nella stessa tabella Astra vince due righe, e non sono righe da poco per una PMI:
- AutomationBench (41,4 contro 40,0): flussi tra app connesse, cioè il lavoro che fanno gli automatismi tipo "arriva un ordine, aggiorna il gestionale, avvisa il magazzino". La differenza è di 1,4 punti, dentro il margine d'errore, ma esiste.
- Terminal-Bench-Science (64,6 contro 58,7): ricerca scientifica agentica da terminale. Per la maggior parte delle aziende non è un caso d'uso; per chi fa R&S lo è.
A questo si aggiungono i record di Astra su test che Anthropic non pubblica, in particolare ARC-AGI-3 e FrontierMath. Il confronto ragionato tra i due modelli di punta lo abbiamo fatto in GPT-6 Astra contro Fable 5.1; con Opus 5.5 la conclusione si sposta su un punto: Astra costa due volte e mezzo a listino, quindi il vantaggio di 1,4 punti va pagato 2,5 volte.
Esempi pratici
Studio di consulenza del lavoro, 12 dipendenti. Un agente legge ogni mattina le mail dei clienti, estrae le richieste (cedolini, assunzioni, malattie), le smista e prepara la bozza di risposta. Volume: circa 400 mail al giorno, 2.500 token medi ciascuna in ingresso e 300 in uscita. Con Fable 5.1 il conto API era intorno a 13 $ al giorno; con Opus 5.5 scende a poco più di 5 $, a qualità dichiarata equivalente. Su un anno lavorativo sono circa 1.900 $ risparmiati senza toccare il flusso.
Azienda metalmeccanica, 40 dipendenti. Il preventivatore riceve disegni e richieste in PDF e deve produrre un preventivo strutturato. Qui il beneficio non è solo il prezzo: su GDPval-AA, che misura lavoro professionale reale, Opus 5.5 segna 1846 Elo contro 1735 di Fable 5.1, e la cache a 0,20 $ rende quasi gratis rileggere il listino interno da 80 pagine a ogni richiesta. Il collo di bottiglia torna a essere il processo, non il modello: chi valida il preventivo, in quanto tempo, con quali regole.
Opus 5.5 o Fable 5.1: quando usare quale
Scegli Opus 5.5
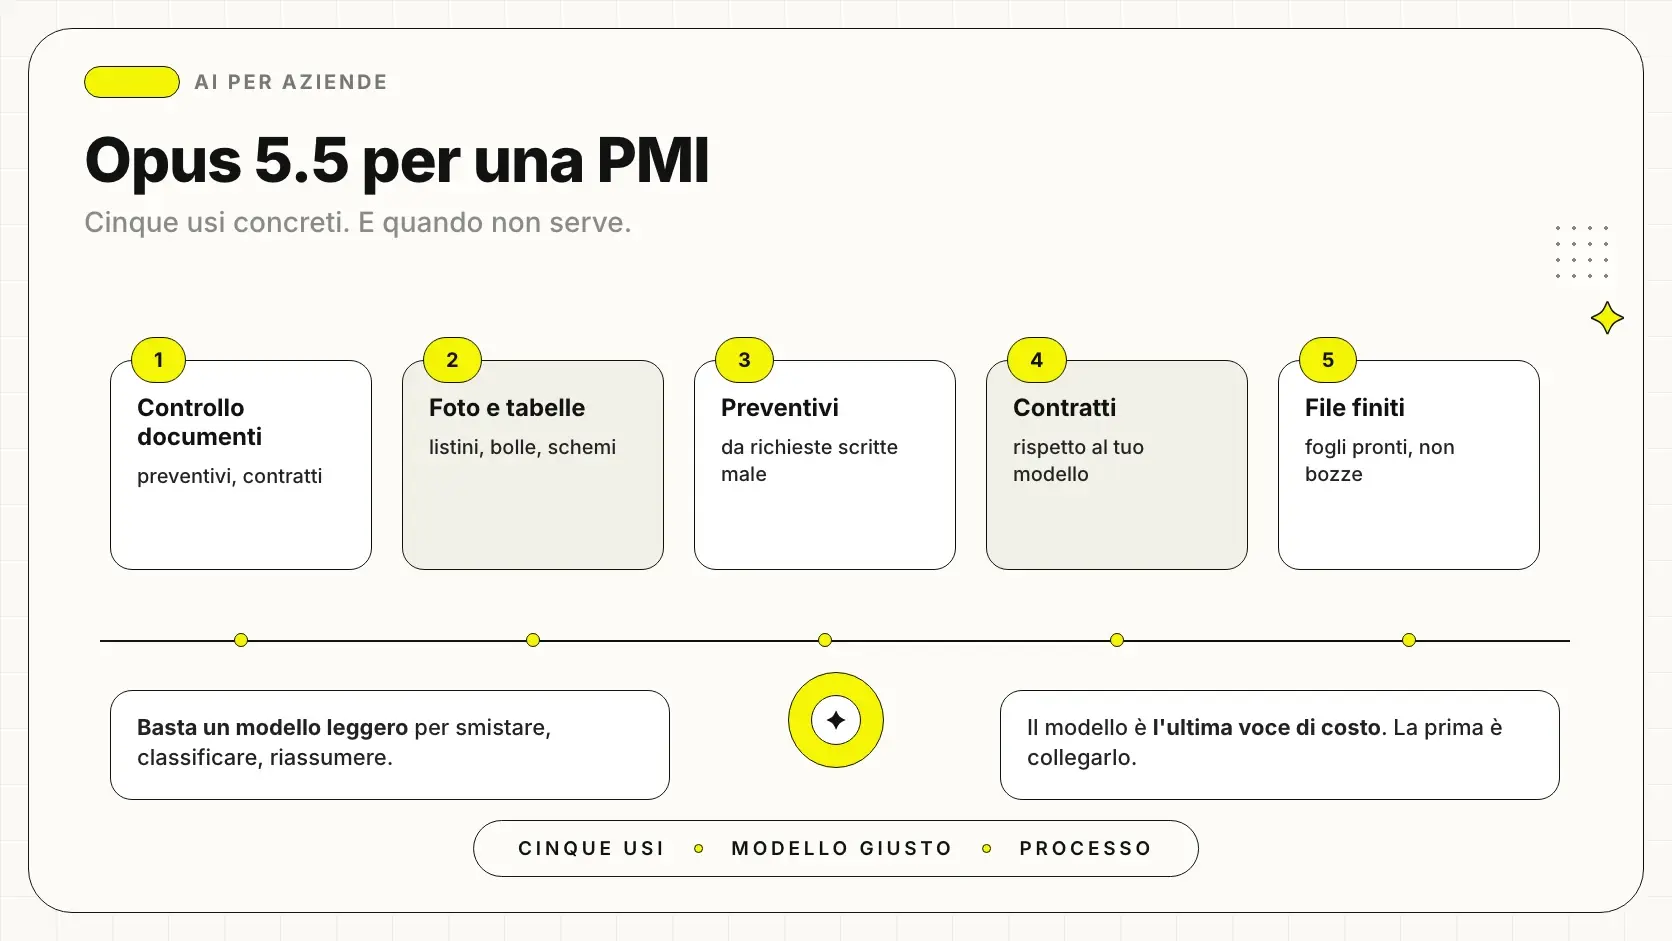
- Agenti che girano tutto il giorno: lettura documenti, classificazione, risposte, estrazione dati.
- Codice e automazioni interne: vince su tutti e tre i benchmark di coding.
- Budget contato: 4 e 20 $ contro 10 e 50 $.
- Ti serve velocità: +30% e modalità Fast.
Resta su Fable 5.1 o valuta Astra
- Casi limite di ragionamento dove i pochi punti in più valgono il prezzo.
- Flussi tra molte app dove AutomationBench è la misura giusta: Astra è avanti di 1,4 punti.
- Ricerca scientifica agentica.
- Hai già un sistema in produzione tarato su un modello: cambia solo dopo un test sui tuoi casi.
Per capire come si posizionano gli altri modelli della famiglia, il quadro completo è in confronto tra i modelli Claude.
Errori da evitare
- Scegliere dal titolo del benchmark. I test omonimi cambiano versione e regole: confronta solo dentro la stessa tabella ufficiale.
- Confondere prezzo per token e costo per attività. Un modello più caro che finisce in meno passaggi può costare meno. Anthropic misura proprio questo quando dichiara il −40%.
- Cambiare modello in produzione senza un test. Le stesse istruzioni possono dare risultati diversi: rifai i tuoi 20 casi reali prima di migrare.
- Ignorare le protezioni. Se il tuo processo tocca biologia, chimica o sicurezza informatica, prova prima le richieste tipiche: alcune verranno rifiutate.
- Dare credito ai numeri virali. Nei giorni di lancio girano percentuali che non stanno in nessuna tabella. Le fonti sono due: anthropic.com e openai.com.
Come applicarlo in azienda
- Elenca i processi in cui oggi un modello legge o scrive per te: mail, preventivi, fatture, ticket, report. Per ciascuno segna volume mensile e modello usato.
- Calcola il costo per attività finita, non per token: quanto ti costa una fattura letta, un preventivo compilato, un ticket chiuso.
- Prendi i 20 casi più difficili di ogni processo e falli girare su Opus 5.5 con le stesse istruzioni. Confronta qualità e costo con quello che usi oggi.
- Attiva la cache per i contesti che si ripetono (listini, manuali, regole): a 0,20 $ per milione è la leva più grande.
- Migra un processo alla volta e misura per due settimane: errori, tempo di validazione umana, costo. Poi passa al successivo.
Se il primo passo ti spaventa, parti da qui: cosa sono i token e perché contano spiega la base del conto, e Claude per le aziende mostra dove i modelli Claude entrano davvero nei processi.
Il carosello in 8 card
La stessa notizia in formato social, da salvare o girare a chi decide il budget AI in azienda.
Conclusione
Claude Opus 5.5 non è il modello più forte che esista su ogni test: è quello che porta le prestazioni di Fable 5.1 a un prezzo che una PMI può mettere a budget senza pensarci. Nove benchmark su nove contro il modello di punta di Anthropic, quattro su sei contro GPT-6 Astra, il 60% in meno a listino. Dove Astra vince, vince di poco e costa due volte e mezzo.
La regola gialla resta la stessa: non scegliere il modello dal benchmark, scegli dal costo per attività finita. Se vuoi passare dai test con ChatGPT a un sistema AI integrato nei processi aziendali, Giallo Studio progetta agenti e automazioni su misura, e in The Lab puoi provare alcuni di questi agenti al lavoro.
Come lo applichiamo in azienda
Risorse correlate
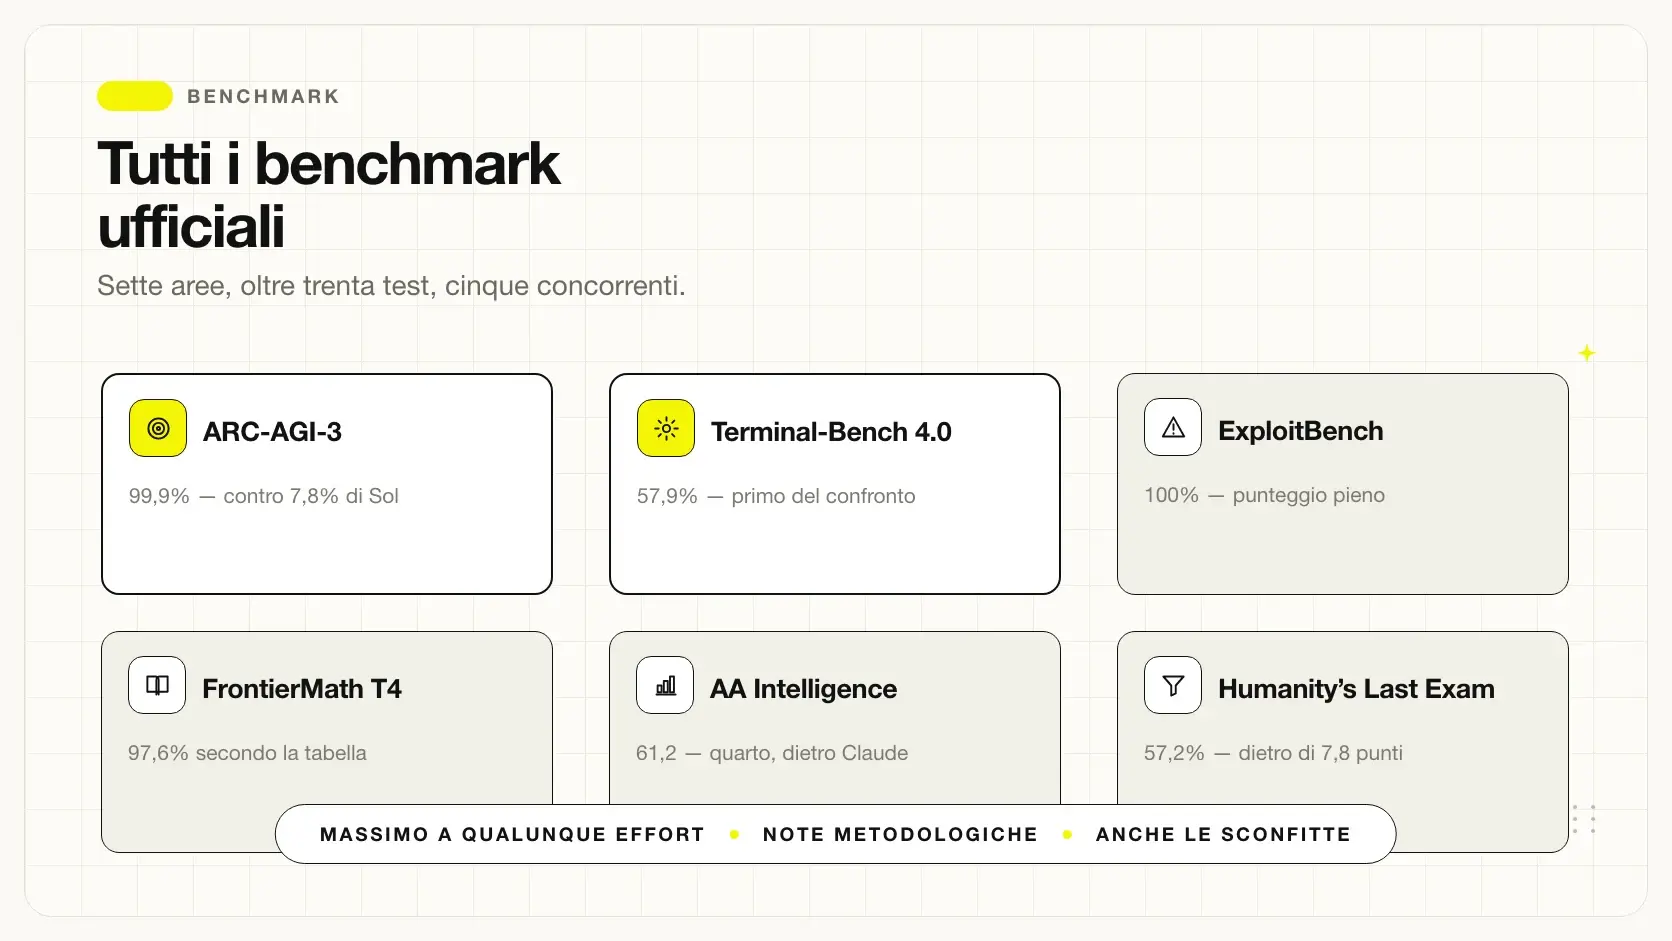 GPT-6 Astra: tutti i benchmark ufficiali
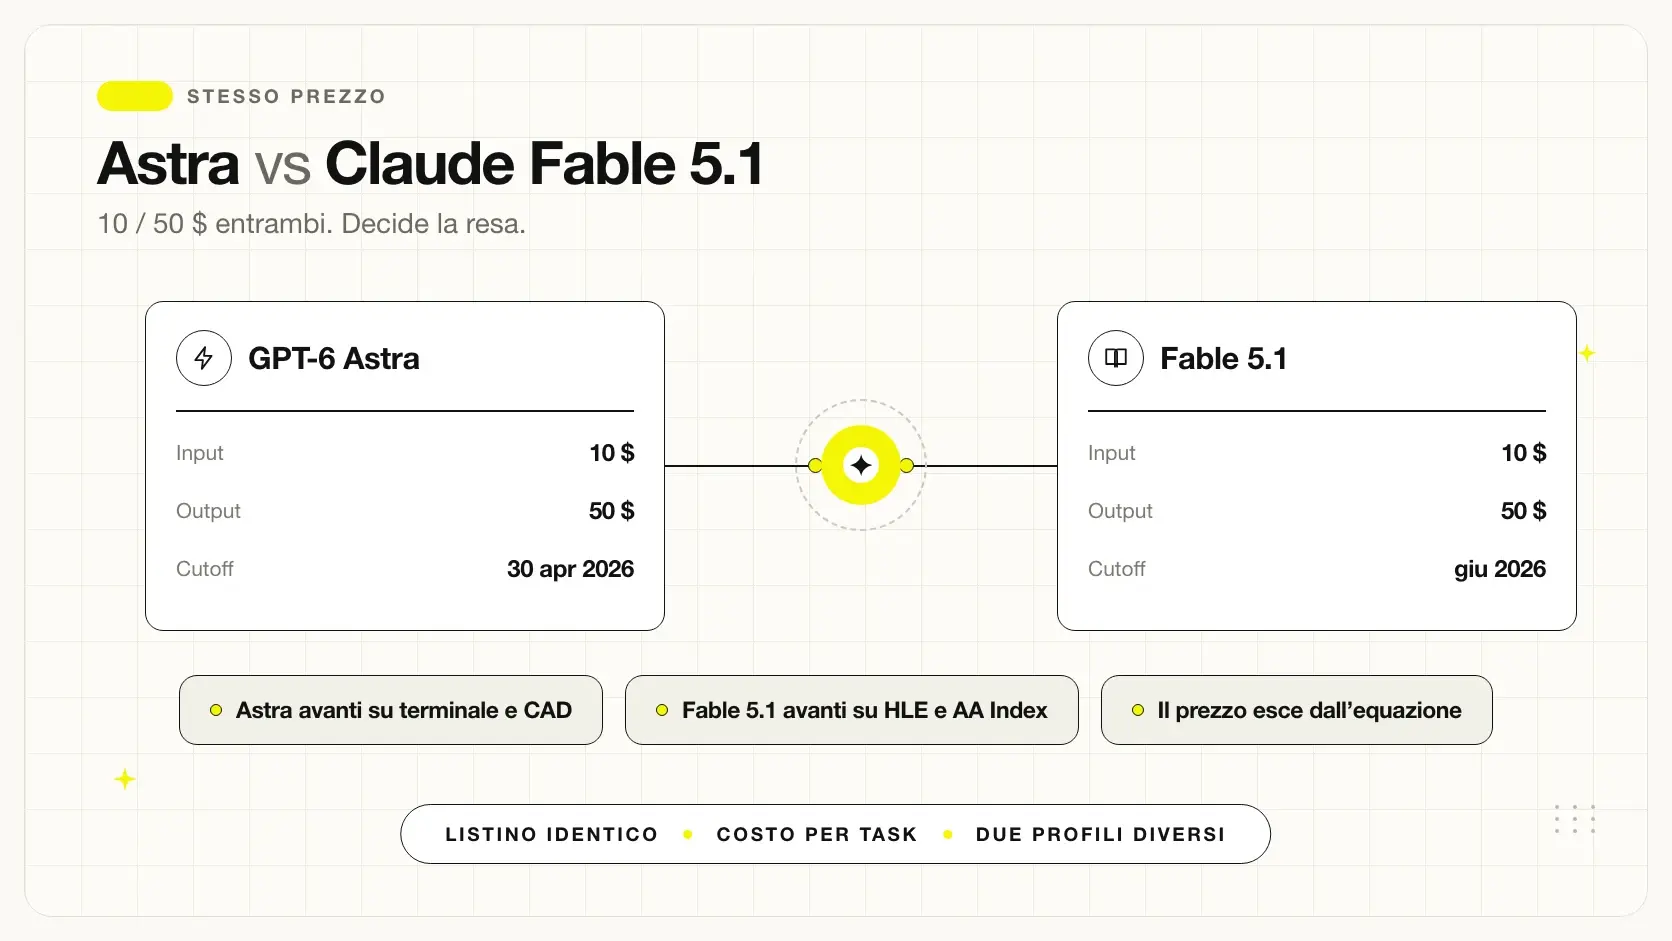 GPT-6 Astra vs Claude Fable 5.1
 Claude Fable 5.1 vs Sonnet 5
 Prezzi dei modelli Claude a confronto
 Modelli Claude a confronto: quale scegliere e quando cambiare
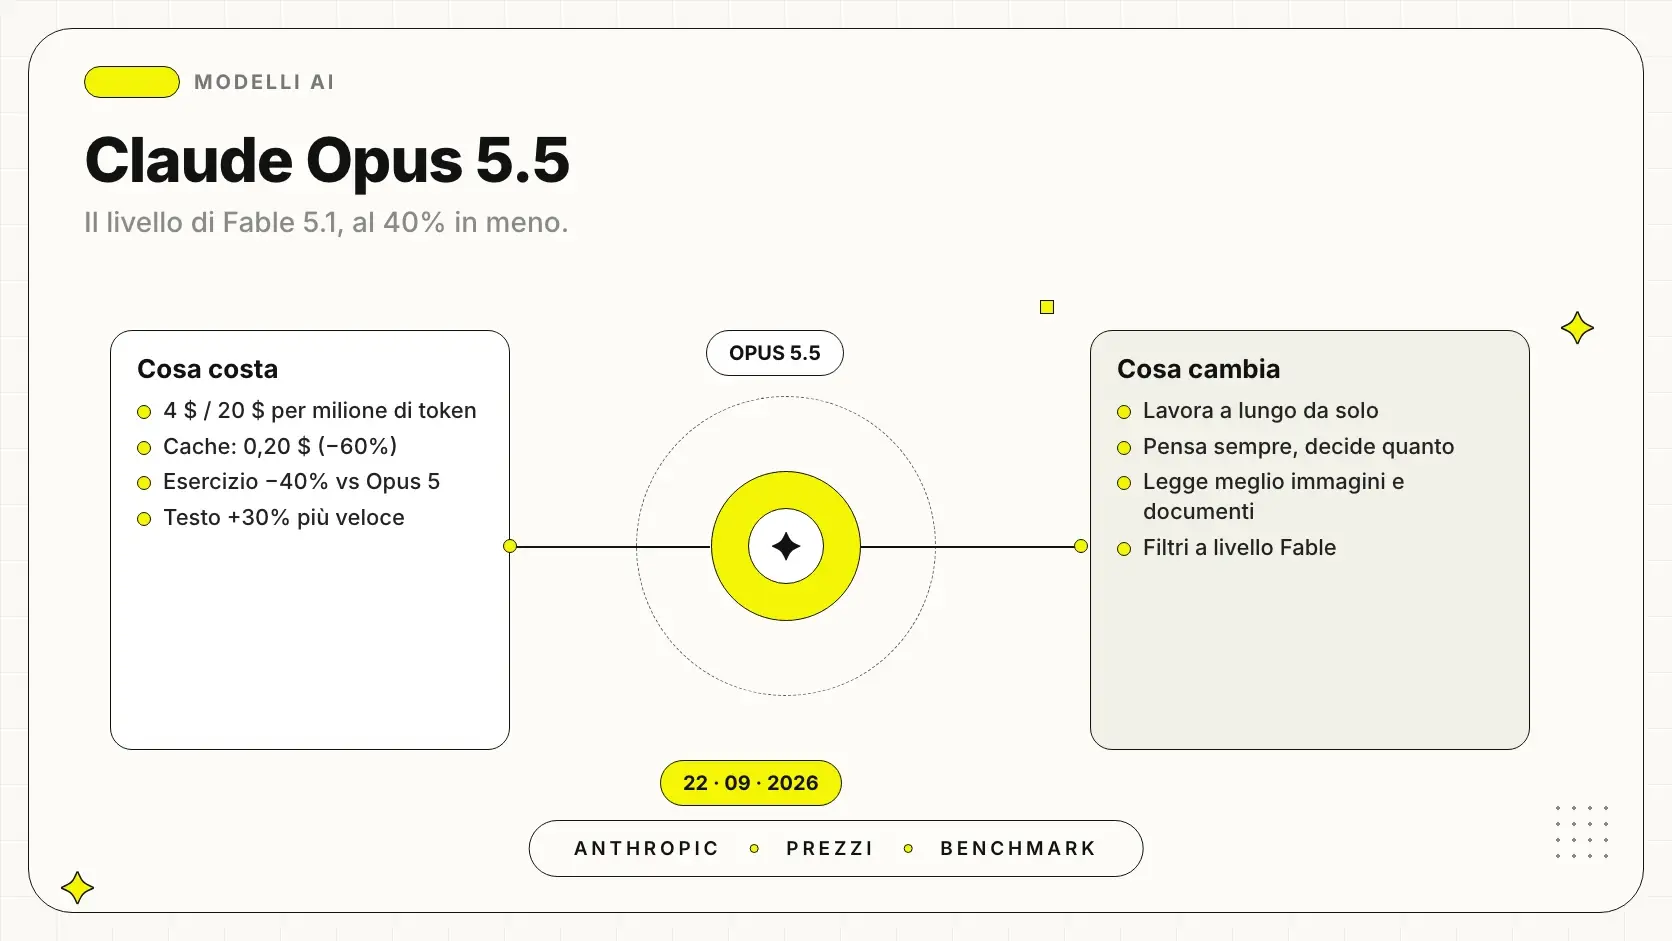 Claude Opus 5.5: cos'è, cosa cambia e a chi conviene
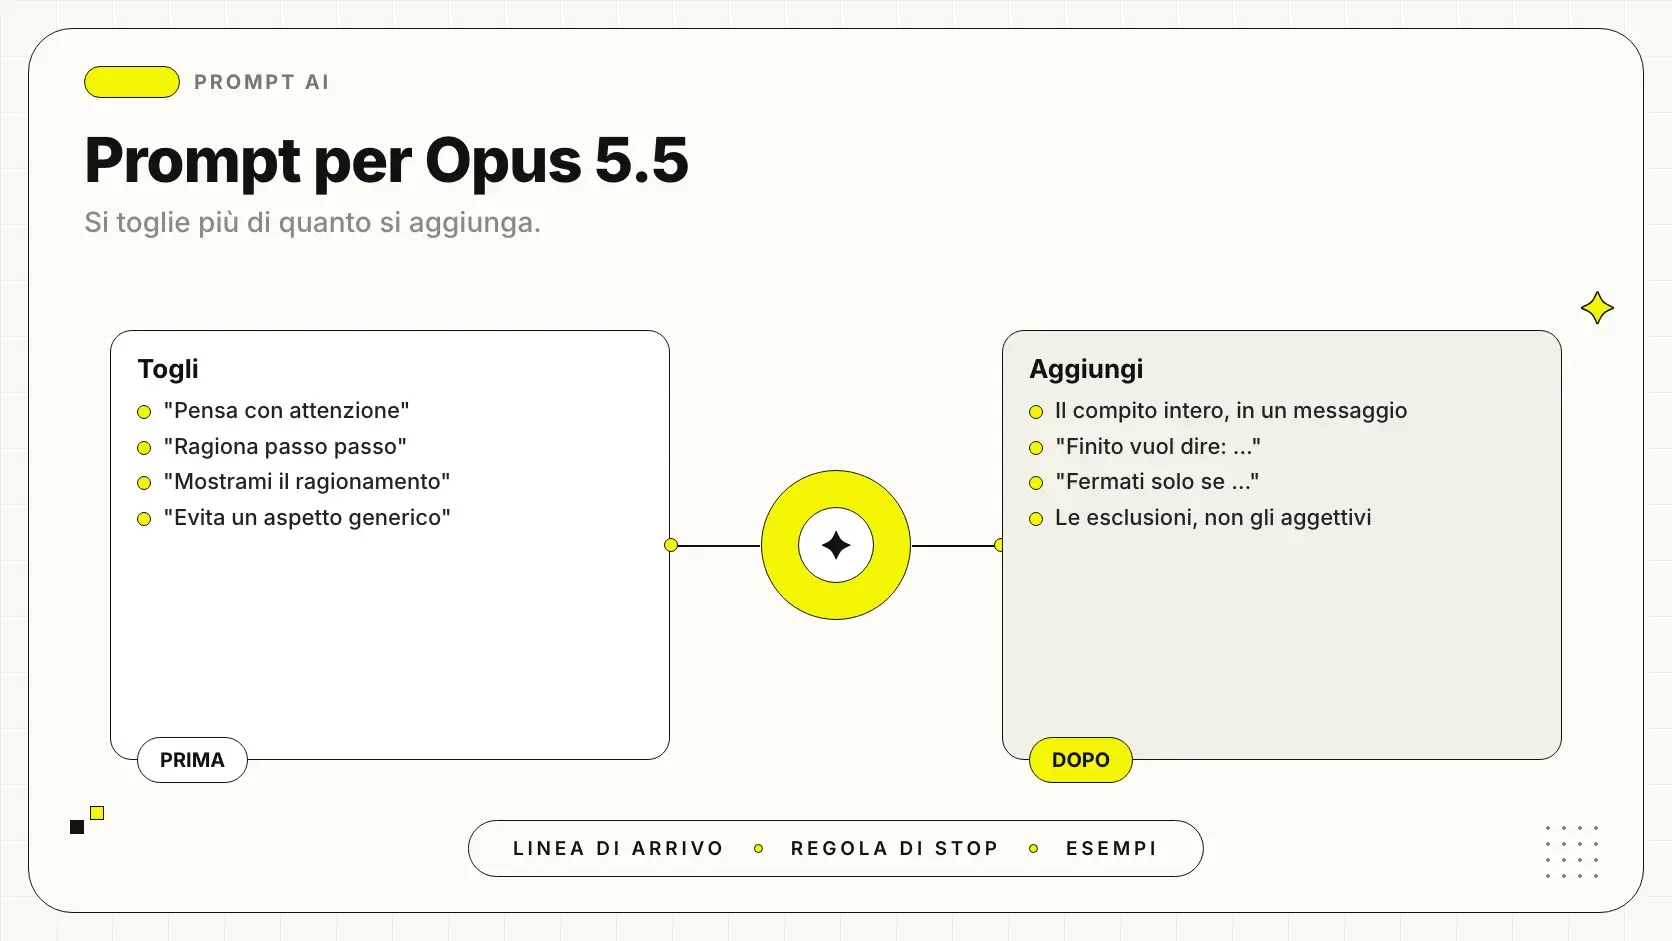 Prompt per Claude Opus 5.5: cosa togliere, cosa aggiungere, esempi
 Claude Opus 5.5 per una PMI: cinque usi concreti e quando non serve
 I livelli di ragionamento di Claude Opus 5.5: cosa sono e quando alzarli
 GPT-6 Sol vs Claude Opus 5.5: i numeri ufficiali e quando usare quale
FAQ
Quanto costa Claude Opus 5.5?
4 dollari per milione di token in ingresso e 20 in uscita sull'API. La lettura dalla cache costa 0,20 dollari. La modalità Fast, fino a 2,5 volte più veloce, costa 8 e 40 dollari.
Claude Opus 5.5 è meglio di Fable 5.1?
Sui 9 benchmark pubblicati da Anthropic è davanti a Fable 5.1 in tutti e 9 e costa il 60% in meno a listino. Fable 5.1 resta il modello di punta per i casi limite, ma Anthropic stessa dice che Opus 5.5 lavora al suo livello sulla maggior parte dei compiti.
Claude Opus 5.5 batte GPT-6 Astra?
Sulle 6 righe in cui esiste un dato per entrambi, Opus 5.5 vince 4 volte: Terminal-Bench 4.0, FrontierCode, GDPval-AA e Humanity's Last Exam. Astra resta davanti su AutomationBench e Terminal-Bench-Science, con un prezzo di listino di 10 e 50 dollari.
Cosa vuol dire che costa il 40% in meno?
Anthropic misura il costo su carichi di lavoro tipici: il prezzo per token è più basso di Opus 5 e il modello usa meno token per finire lo stesso compito. Sommando i due effetti, il conto scende del 40% circa.
Quanto contesto gestisce Opus 5.5?
Una finestra da 1 milione di token in ingresso e fino a 128 mila in uscita, secondo la documentazione della piattaforma Claude.
Ha limitazioni particolari?
Sì. Per biologia e cybersecurity usa le stesse protezioni di Fable 5.1: alcune richieste in quei campi vengono bloccate e per la ricerca serve una verifica dell'organizzazione. Non è più disponibile con il ragionamento spento.
I benchmark sono confrontabili con quelli di OpenAI e Google?
Solo in parte. Anthropic pubblica benchmark diversi da quelli classici (niente GPQA, SWE-bench o ARC-AGI) e i test con lo stesso nome esistono in versioni diverse. Il confronto affidabile è quello dentro la stessa tabella ufficiale.