
Gemini 4 Carbon benchmark: la tabella completa e come leggerla
Gemini 4 Carbon benchmark: tutte le 17 righe della tabella Google, dove non vince, chi ha calcolato i numeri e come fare un test tuo.
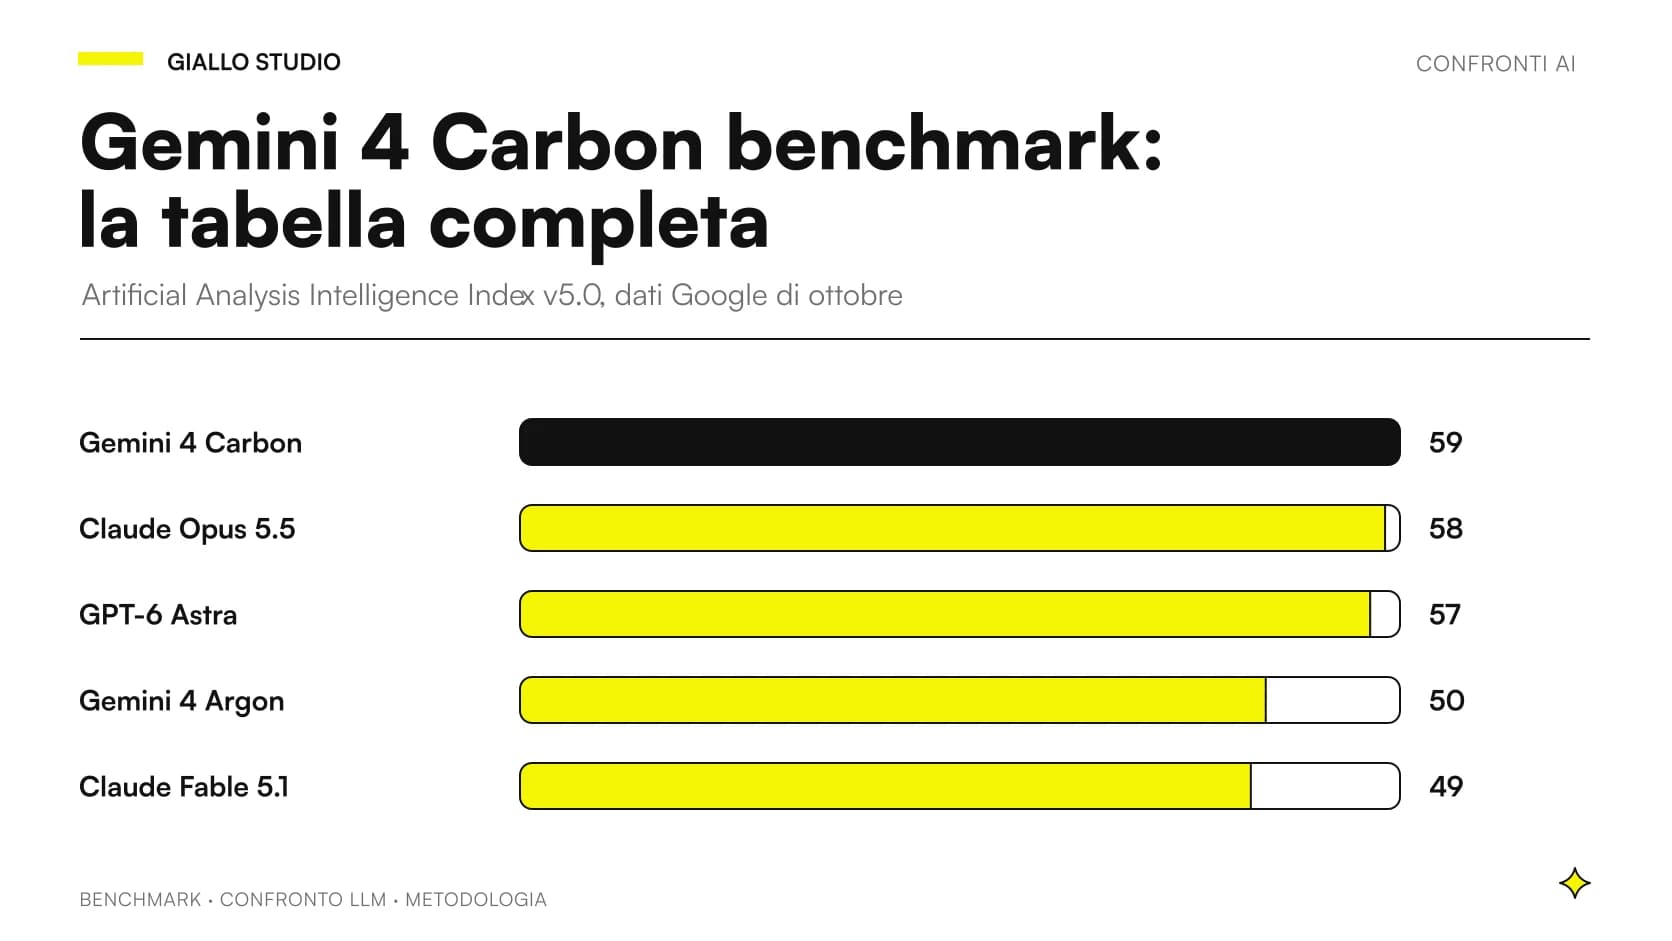
Nella tabella ufficiale pubblicata da Google il 28 ottobre 2026, Gemini 4 Carbon risulta primo in 15 delle 17 righe, ma non su FrontierSWE 2 (primo GPT-6 Astra con 65,5%) né su OSWorld-2.1 (primo Claude Opus 5.5 con 87,2%). Il conteggio è nostro e vale solo per i modelli scelti da Google: Gemini 4 Argon, GPT-6 Astra, Claude Opus 5.5 e Claude Fable 5.1. Qui trovi i Gemini 4 Carbon benchmark completi e un metodo per leggerli senza trasformare la tabella di un fornitore in una decisione d'acquisto.
I dati vengono dall'annuncio di Google e dalla valutazione del modello, con tabella "as of October, 2026" e note di metodologia, consultati il 28 ottobre 2026. Giallo non ha provato Gemini 4 Carbon e non ha rieseguito nessun benchmark: leggiamo ciò che Google ha pubblicato. Al 28 ottobre il modello non è disponibile per aziende e sviluppatori: Google lo apre prima a un sottoinsieme di difensori informatici, poi ad altri partner tramite il Fairwind Program.
Per capire che cos'è il modello e quando potrebbe arrivare, parti dalla guida a Gemini 4 Carbon.
In sintesi
- Gemini 4 Carbon è primo in 15 delle 17 righe della tabella Google di ottobre 2026 (conteggio nostro), con distacchi molto diversi.
- Non è primo su FrontierSWE 2 (61,2% contro 65,5% di GPT-6 Astra) né su OSWorld-2.1 offline (81,5% contro 87,2% di Opus 5.5).
- Su Vals Index (0,2 punti), SWE-sweep (0,1 punti), Chartography (0,9 punti) e Artificial Analysis Index (59, 58, 57) le differenze sono troppo piccole per dichiarare un vincitore.
- Ogni riga ha un autore diverso: per Carbon spesso ha calcolato Google, per gli altri modelli contano dichiarazioni dei fornitori e leaderboard.
- Al 28 ottobre 2026 una PMI non può usare Carbon: può usare la tabella per scegliere cosa testare e preparare il proprio campione.
Quali sono i Gemini 4 Carbon benchmark ufficiali, riga per riga?
La tabella Google di ottobre 2026 confronta cinque modelli su 17 benchmark in otto aree. "—" indica un dato non disponibile; il grassetto segna il valore più alto della riga. I valori sono quelli della valutazione del modello.
| Area | Benchmark | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|---|
| Capacità generali | AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Capacità generali | Vals Index v2.2 | 70,4% | 69,2% | 65,0% | 70,2% | — |
| Coding agentico | SWE-sweep | 9,6% | 4,3% | 9,5% | 3,6% | 2,9% |
| Coding agentico | FrontierSWE 2 | 61,2% | 55,0% | 65,5% | 62,3% | 56,3% |
| Coding agentico | Terminal-Bench 4.0 (AA) | 65,2% | 57,1% | 59,1% | 59,6% | 52,0% |
| Computer use | Agents' Last Exam v1.1 | 77,4% | 69,0% | 73,1% | 71,6% | — |
| Computer use | OSWorld-2.1 (offline) | 81,5% | 74,7% | 80,9% | 87,2% | 76,8% |
| Lavoro d'ufficio | AutomationBench (Zapier) | 53,9% | 51,3% | 41,4% | 42,5% | 31,4% |
| Lavoro d'ufficio | Vending-Bench 2 (saldo in $) | 16.484 | 13.718 | 15.515 | 9.235 | 5.422 |
| Multimodale | Chartography | 72,5% | 71,6% | 71,0% | 66,3% | 46,2% |
| Multimodale | Blueprint-Bench 2 (similarity) | 58,6% | 54,4% | 49,7% | 51,2% | 41,9% |
| Contesto lungo | GraphWalks (256k–1M, BFS F1) | 96,2% | 84,2% | 71,8% | 66,8% | 65,0% |
| Scienza e matematica | RiemannBench | 80,0% | 76,0% | 72,0% | 69,6% | 65,6% |
| Scienza e matematica | Terminal-Bench-Science 0.1 (AA) | 64,8% | 52,9% | 63,3% | 59,0% | 43,3% |
| Cybersecurity | CWE-bench | 71,0% | 68,0% | 68,0% | 67,0% | 58,0% |
| Cybersecurity | ExploitGym | 54,8% | 42,0% | 42,4% | 34,5% | — |
| Cybersecurity | SEC-bench Pro | 88,2% | 83,4% | 85,4% | — | — |
Le colonne non hanno tutte lo stesso peso: i numeri dei concorrenti sono dichiarati dai fornitori o presi da leaderboard, quelli di Carbon sono spesso calcolati da Google. Per il confronto fra i due modelli Google c'è l'analisi Carbon contro Argon.
Dove Gemini 4 Carbon è davanti, area per area?
Il vantaggio è netto in alcune righe e fatto di decimali in altre: conviene leggerlo per area, perché è l'area a dire se il numero somiglia al tuo lavoro.
Capacità generali e coding agentico
Nell'Artificial Analysis Intelligence Index v5.0, calcolato da Artificial Analysis con strumenti, Carbon ha 59, Opus 5.5 ha 58 e Astra 57; Google lo indica anche nell'annuncio come primo posto. Sul coding il quadro è misto. Su SWE-sweep Carbon fa 9,6% contro il 4,3% di Argon (più del doppio, calcolo nostro) ma solo 0,1 punti sopra Astra. Su Terminal-Bench 4.0 (AA) Carbon è a 65,2% e Opus 5.5, secondo, è a 59,6%: 5,6 punti di distacco (calcolo nostro). Su FrontierSWE 2, invece, Carbon è dietro.
Nell'annuncio Google aggiunge che gli imbrogli riusciti su Terminal-Bench 4.0 sono scesi a 0,0%, con tentativi allo 0,4%: è un'affermazione del fornitore, non una verifica esterna. Per il confronto con Astra c'è la pagina su Carbon, GPT-6 Astra e Claude e la tabella Astra.
Computer use e lavoro d'ufficio
Su Agents' Last Exam v1.1 Carbon totalizza 77,4% contro 73,1% di Astra e 71,6% di Opus 5.5. Su OSWorld-2.1 offline Carbon è secondo (81,5%), appena sopra Astra (80,9%) e dietro Opus 5.5. Su AutomationBench (set privato, leaderboard Zapier) Carbon ha 53,9% contro 51,3% di Argon, il secondo (2,6 punti), 41,4% di Astra e 42,5% di Opus 5.5: ampio il distacco dai modelli non Google, contenuto quello da Argon. Su Vending-Bench 2 il saldo di Carbon è 16.484 dollari contro 15.515 di Astra: è il punteggio di un test, non un incasso reale.
Multimodale, contesto lungo, scienza
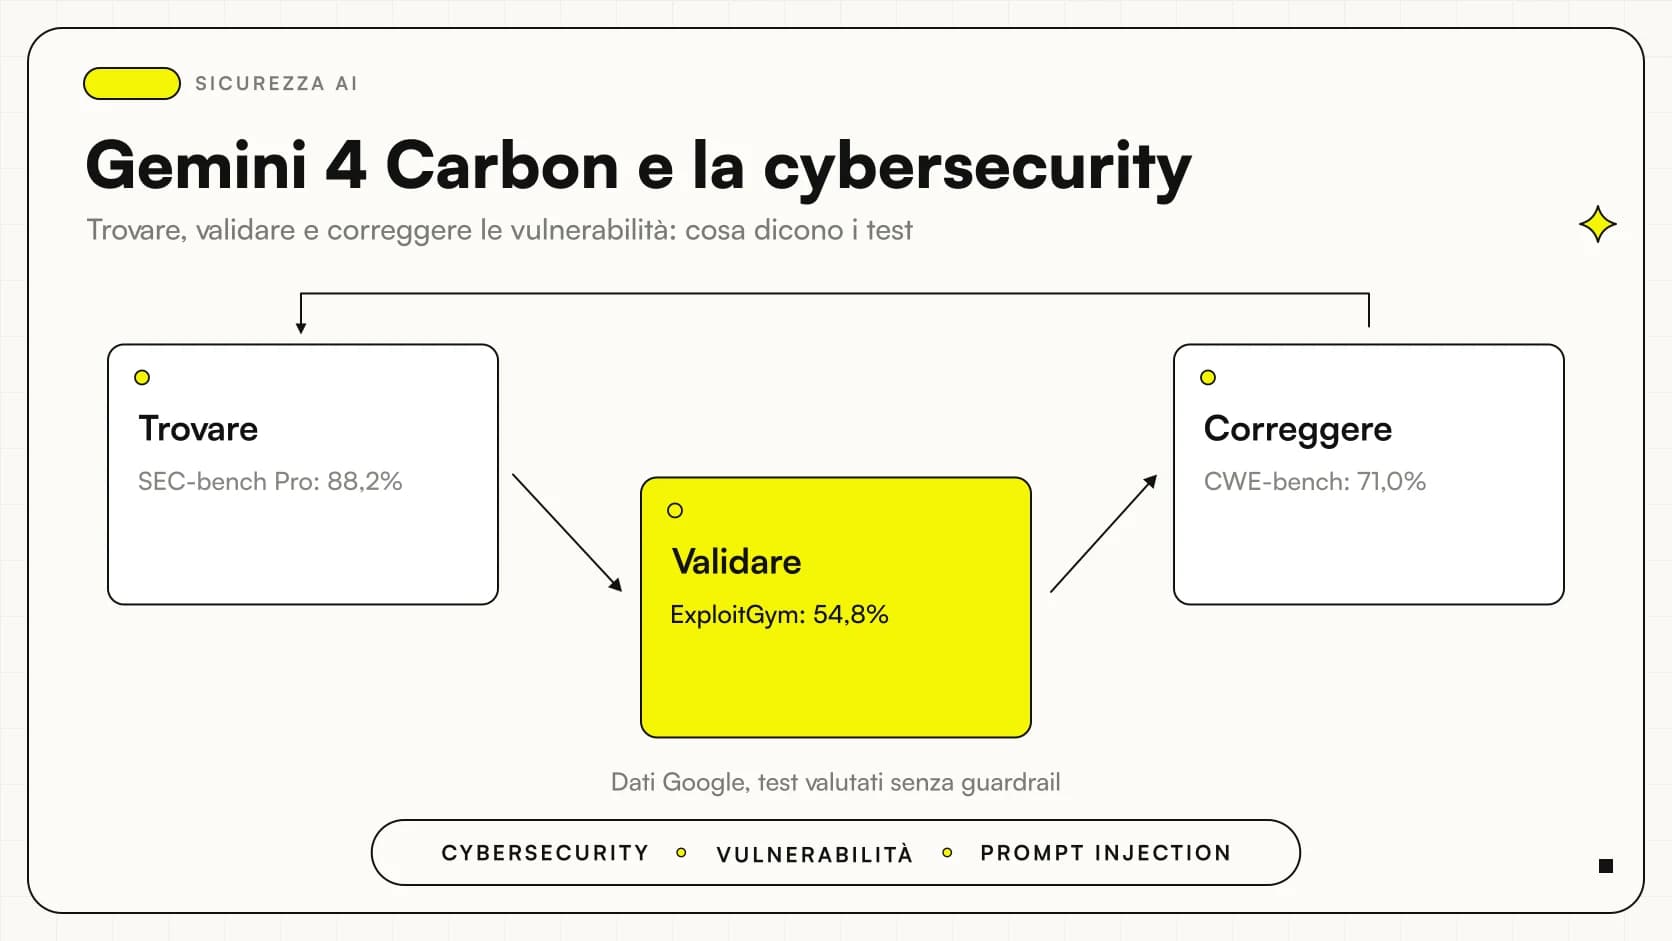
Su Chartography Carbon ha 72,5% e Argon 71,6% (senza strumenti); su Blueprint-Bench 2 58,6% contro 54,4%. GraphWalks, da 256k a 1M token, vede Carbon a 96,2% contro 84,2% di Argon e 71,8% di Astra: è, con ExploitGym, uno dei due vantaggi più grandi della tabella. In scienza Carbon è a 80,0% su RiemannBench e a 64,8% su Terminal-Bench-Science 0.1, dove Astra è vicino con 63,3%. Per CWE-bench, ExploitGym e SEC-bench Pro, dove Carbon è primo, c'è l'approfondimento su Carbon e cybersecurity.
Dove Gemini 4 Carbon non vince?
Gemini 4 Carbon non è primo in due righe su 17, entrambe sul lavoro agentico. Google parla di capacità allo stato dell'arte in cybersecurity e su compiti di lunga durata, non di primato assoluto.
Su FrontierSWE 2 l'ordine è Astra (65,5%), Opus 5.5 (62,3%), Carbon (61,2%), Fable 5.1 (56,3%), Argon (55,0%): Carbon è a 4,3 punti da Astra (calcolo nostro). Il numero viene dalla leaderboard di Proximal, non da un calcolo Google. Rispetto ad Argon Carbon guadagna 6,2 punti, ma non scavalca i due modelli davanti.
Su OSWorld-2.1 Carbon è a 5,7 punti da Opus 5.5 (calcolo nostro). Il test è un sottoinsieme offline di 82 task e Google riporta, per Carbon e Argon, il massimo su 3 esecuzioni con un harness Gemini CUA aggiornato. È un criterio favorevole a Carbon, e Opus 5.5 resta davanti; per i concorrenti vale ciò che hanno pubblicato i fornitori nelle loro system card. Chi cerca un agente che usi il computer non può leggere l'area "Computer use" come una vittoria di Carbon.
Quando una differenza di punteggio è troppo piccola per contare?
Una differenza di 0,2 punti non basta per dire che un modello sia migliore dell'altro. Quattro righe hanno un distacco minuscolo fra primo e secondo e vanno trattate come parità fino a prova contraria: Vals Index v2.2 (Carbon 70,4% contro 70,2% di Opus 5.5, cioè 0,2 punti), SWE-sweep (9,6% contro 9,5% di Astra, 0,1 punti), Artificial Analysis Index (59, 58 e 57) e Chartography (72,5% contro 71,6% di Argon, 0,9 punti).
Il Vals Index v2.2 è prodotto da Vals AI; per ogni modello abbiamo un solo valore e nessun margine di errore da citare, quindi 0,2 punti possono essere vantaggio reale o rumore di misura. Su SWE-sweep il problema è doppio: il dato di Carbon è calcolato da Google con l'harness mini-swe-agent e un reward pesato per sottocompiti, quelli dei concorrenti vengono dalla leaderboard pubblica. Procedure diverse e 0,1 punti di distanza non autorizzano alcuna classifica.
Nell'Artificial Analysis Index, 59 contro 58 e 57 descrive un gruppo di testa stretto, non un modello chiaramente più intelligente: gli indici aggregati comprimono attività molto diverse, come spiega la guida su come leggere i benchmark AI.
Come si legge la metodologia: chi ha calcolato cosa?
La metodologia dice per ogni riga chi ha prodotto il numero, e il peso della riga cambia di conseguenza. Per Carbon e Argon Google dichiara pass@1 salvo note, un solo tentativo senza voto di maggioranza né calcolo parallelo, con le impostazioni di thinking più alte della Gemini API. Per Astra, Opus 5.5 e Fable 5.1 usa i numeri dei fornitori, con ragionamento al massimo quando disponibile, come riporta la valutazione del modello.
| Chi ha prodotto il numero | Benchmark |
|---|---|
| Google (per Carbon, in alcuni casi anche per Argon) | SWE-sweep, Agents' Last Exam v1.1, OSWorld-2.1, ExploitGym, SEC-bench Pro |
| Google (per tutti i modelli) | GraphWalks |
| Artificial Analysis | AA Index v5.0, Terminal-Bench 4.0, Terminal-Bench-Science 0.1 |
| Vals AI | Vals Index v2.2 |
| Proximal | FrontierSWE 2 |
| Zapier (set privato) | AutomationBench |
| Andon Labs | Vending-Bench 2, Blueprint-Bench 2 |
| Surge | Chartography (senza strumenti), RiemannBench |
| Collinear AI (tutti i modelli) | CWE-bench v1 |
Una riga calcolata da Google per i propri modelli non è un test indipendente. Le schede sotto dicono che cosa controllare prima di fidarsi di un numero.
Harness: lo strumento attorno al modello cambia il punteggio
Su SWE-sweep Google ha usato mini-swe-agent, su Agents' Last Exam v1.1 ALE-Claw (122 task), su OSWorld-2.1 un harness Gemini CUA aggiornato, su ExploitGym e SEC-bench Pro Antigravity. I concorrenti sono stati misurati altrove: la tabella confronta modelli più strumenti, non modelli nudi.
Timeout e tentativi: quanto tempo e quante prove ha avuto il modello
Agents' Last Exam ha una finestra di 5 ore. ExploitGym prevede un tentativo per task e la metodologia riporta timeout di 6 e di 10 ore: La tabella riporta un solo valore (54,8%) senza indicare a quale dei due timeout corrisponda. OSWorld-2.1 conta il massimo su 3 esecuzioni; SEC-bench Pro la media di 3 tentativi su 183 task dello split "JavaScript engine" di maggio 2026.
Filtri e versioni: che cosa era acceso e di quale data
Su Agents' Last Exam i filtri di sicurezza erano attivi, con i task del 17 ottobre 2026 e senza l'aggiornamento del 26 ottobre; Claude Fable 5.1 è assente. Nella cybersecurity i valori sono ottenuti senza guardrail e in ExploitGym internet e mitigazioni erano spenti: condizioni di laboratorio, non l'uso di un'azienda.
GraphWalks: l'unica riga dove Google ha misurato tutti
GraphWalks è calcolato da Google per tutti e cinque i modelli, su 200 problemi fra 256k e 1M token, con F1 sul compito BFS. È il confronto più omogeneo della tabella e il distacco di Carbon (96,2%) è netto, ma resta un test sintetico su grafi: misura il contesto lungo, non la comprensione dei tuoi PDF. Per i concetti di base, vedi la guida ai token nei modelli AI.
Che cosa significano questi numeri per una PMI italiana?
Per una PMI la tabella serve a scegliere che cosa provare, non a scegliere un fornitore. Al 28 ottobre 2026 Carbon non è accessibile a un'azienda e Google non ha pubblicato data di disponibilità generale, finestra di contesto né limiti di output. Le righe vicine al tuo lavoro servono a scegliere i modelli disponibili da confrontare nel frattempo.
| Se il tuo lavoro è… | Righe da guardare | Prudenza |
|---|---|---|
| Automazioni e processi d'ufficio | AutomationBench, Vending-Bench 2 | Set privato di Zapier: non puoi rifare il test |
| Sviluppo software | SWE-sweep, FrontierSWE 2, Terminal-Bench 4.0 | Harness diversi, distacchi minimi su SWE-sweep |
| Agenti che usano il computer | OSWorld-2.1, Agents' Last Exam | Sottoinsieme di 82 task, esecuzioni diverse |
| Documenti molto lunghi | GraphWalks | Test sintetico su grafi |
Scenario ipotetico: un'officina di 15 persone riceve ordini per email e vuole preparare le bozze delle conferme. La riga più vicina è AutomationBench, ma è un set privato e non si può ripetere: serve un campione proprio di 30-40 email reali, anonimizzate, con la bozza che il responsabile considera corretta. Scenario ipotetico: uno studio di commercialisti vuole interrogare fascicoli di bilancio molto lunghi. GraphWalks dice solo che Carbon regge contesti lunghi su un test sintetico; allo studio interessa se cita la pagina giusta in un fascicolo con scansioni.
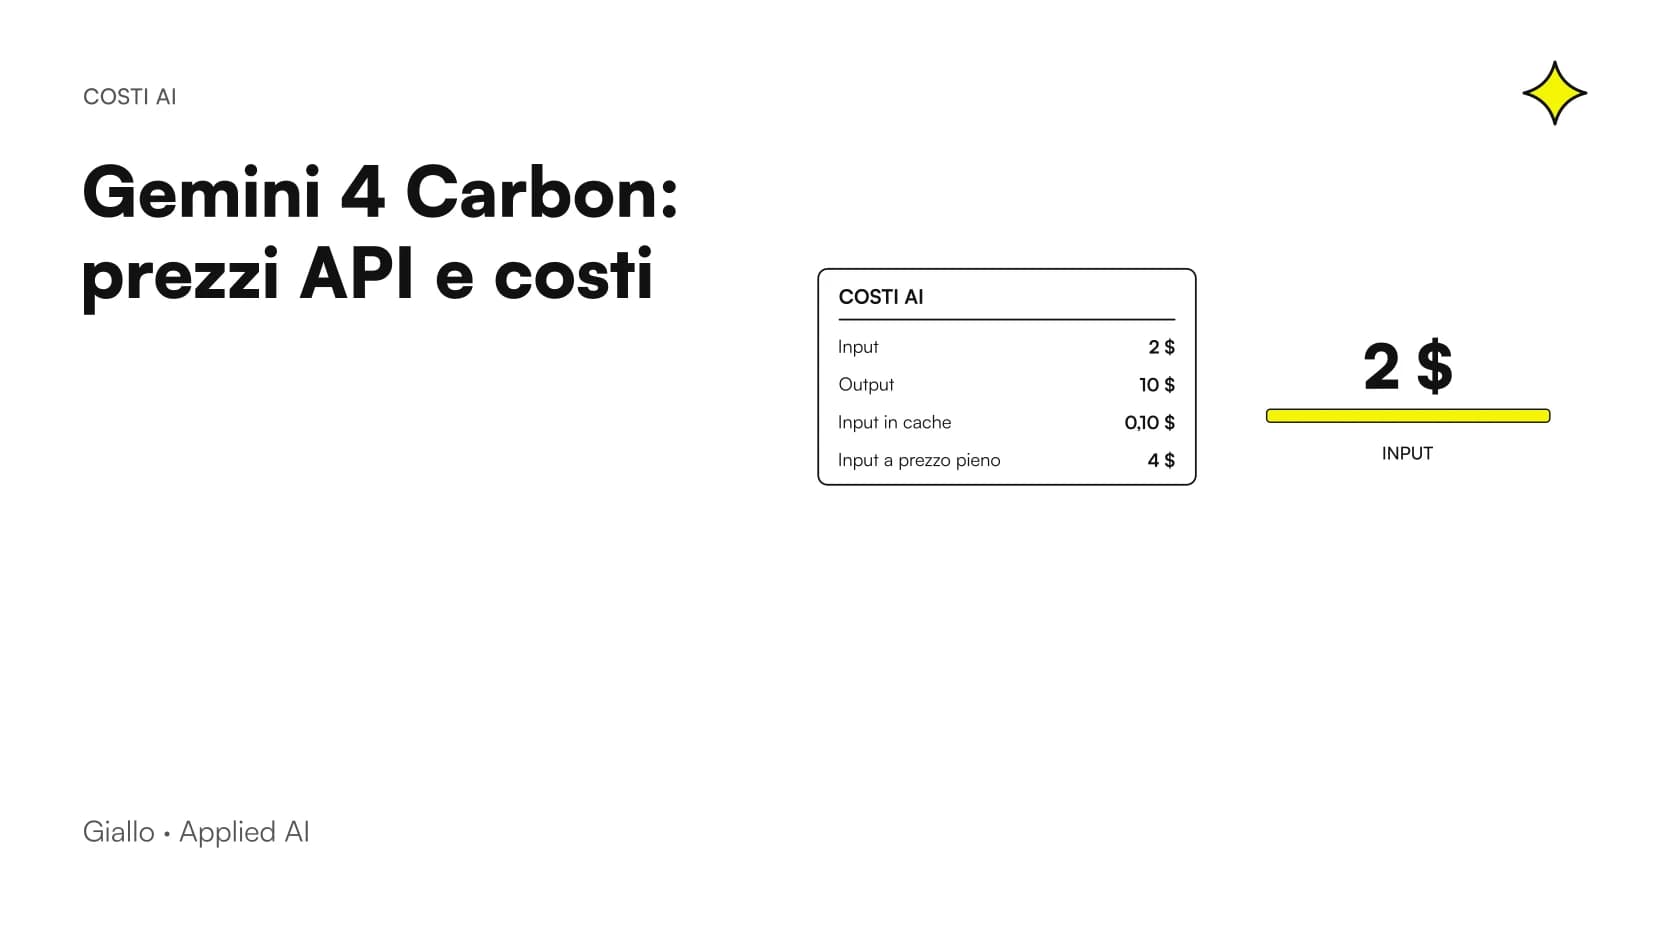
Un benchmark non dice nulla del costo per risposta accettata. Il prezzo introduttivo dichiarato nell'annuncio è 2 dollari per milione di token in input e 10 in output, uguale ad Argon, poi 4 e 20 dollari; Google non ha indicato quando finisce il periodo introduttivo di Carbon. Claude Opus 5.5 costa 4 e 20 dollari secondo il listino Anthropic. I conti sono nella guida ai prezzi API di Carbon.
Come costruire un proprio test quando Gemini 4 Carbon sarà disponibile?
Si parte dai tuoi casi, con un metodo che vale oggi per altri modelli e domani per Carbon: la tabella Google ti dà i candidati, il tuo campione la risposta. Il percorso di valutazione per Argon usa lo stesso schema con un modello già disponibile via API.
- Scegli un solo processo con risultato verificabile: una bozza di preventivo, una classificazione di email, una patch su un difetto noto.
- Raccogli 30-50 casi reali, anonimizzati, compresi i difficili e quelli in cui il sistema deve dire «non lo so».
- Scrivi prima il criterio di accettazione e che cosa è un errore grave.
- Dai a ogni modello stesso materiale, stesse istruzioni e stessi strumenti; registra versione, data e impostazioni.
- Misura correttezza (controllata da una persona), attesa e costo dei risultati accettati, ritentativi inclusi.
- Tieni un secondo campione, mai usato per mettere a punto le istruzioni, per verificare che regga.
- Ripeti il confronto quando cambia la versione del modello.
Nel frattempo puoi provare modelli accessibili, per esempio Gemini 4 Argon via API: il campione sarà pronto quando Carbon arriverà. Un progetto di agenti AI parte proprio da un campione di questo tipo; per la scelta in generale c'è la guida a come scegliere un modello AI.
Quali errori fanno più danni leggendo i benchmark di un nuovo modello?
Il primo errore è trattare colonne con autori diversi come un solo esperimento (vedi perché i benchmark dei fornitori non sono comparabili). Il secondo è contare le vittorie: «15 righe su 17» non pesa le righe, e una vittoria per 0,1 punti vale quanto una per 12.
Il terzo è ignorare le condizioni di laboratorio: guardrail spenti, internet disattivato, finestre di 5 ore e massimo su più esecuzioni non somigliano all'uso quotidiano. Il quarto è dimenticare le allucinazioni, che un punteggio alto non elimina (guida). Il quinto è aspettare Carbon senza preparare alcun test.
Conviene aspettare Gemini 4 Carbon o partire con i modelli disponibili?
Conviene partire dal test, non dal modello. Il vantaggio dichiarato di Carbon è ampio in poche righe (contesto lungo con GraphWalks, exploit con ExploitGym) e stretto o incerto in altre (coding e computer use), e l'accesso per la tua azienda non ha data. Preparare oggi campione e criteri richiede lo stesso lavoro, qualunque modello vinca.
Se vuoi trasformare questa tabella in un confronto ripetibile sui tuoi processi, la consulenza AI di Giallo parte dai tuoi documenti e dalle tue regole di accettazione. Verifica sempre le pagine ufficiali: tabelle, versioni e prezzi possono cambiare.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Gemini 4 Carbon: cos’è, cosa dichiara Google e quando sarà disponibile
 Gemini 4 Carbon vs GPT-6 Astra e Claude: quale scegliere per ogni attività
 Gemini 4 Carbon: prezzi API, costo per milione di token e confronto
 Gemini 4 Carbon cybersecurity: trovare, validare e correggere le vulnerabilità
 Gemini 4 Carbon vs Argon: differenze e conviene aspettare?
 Gemini 4 Argon benchmark: come leggere il confronto LLM
 GPT-6 Astra: tutti i benchmark ufficiali
FAQ
Gemini 4 Carbon è primo in tutti i benchmark della tabella Google?
No. Nella tabella ufficiale di ottobre 2026 Gemini 4 Carbon è davanti in 15 delle 17 righe (conteggio nostro), ma su FrontierSWE 2 è terzo con 61,2% dietro GPT-6 Astra (65,5%) e Claude Opus 5.5 (62,3%). Su OSWorld-2.1, sottoinsieme offline, è secondo con 81,5% dietro Claude Opus 5.5 (87,2%).
Quanto vale Gemini 4 Carbon nell'Artificial Analysis Intelligence Index?
Nell'Artificial Analysis Intelligence Index v5.0 Gemini 4 Carbon ha 59 punti, davanti a Claude Opus 5.5 con 58 e a GPT-6 Astra con 57. Gemini 4 Argon ha 50 e Claude Fable 5.1 ha 49. Il dato è riportato da Google nell'annuncio del 28 ottobre 2026 e nella tabella di valutazione.
Chi ha calcolato i numeri della tabella di Gemini 4 Carbon?
Dipende dalla riga. Alcuni li ha calcolati Google per Carbon e in certi casi anche per Argon (SWE-sweep, Agents' Last Exam, OSWorld-2.1, ExploitGym, SEC-bench Pro), altri arrivano da leaderboard di terzi come Artificial Analysis, Vals AI, Proximal, Zapier, Andon Labs, Surge e Collinear AI. I numeri dei modelli concorrenti sono dichiarati dai fornitori o presi da leaderboard, salvo note.
La differenza di 0,2 punti sul Vals Index conta davvero?
Da sola no. Nel Vals Index v2.2 Gemini 4 Carbon ha 70,4% e Claude Opus 5.5 ha 70,2%: abbiamo un solo valore per modello, senza margine di errore da citare. Una distanza così piccola non permette di dire che un modello sia migliore dell'altro.
Posso usare Gemini 4 Carbon nella mia azienda al 28 ottobre 2026?
No. Al 28 ottobre 2026 Google ha aperto Gemini 4 Carbon a un sottoinsieme di difensori informatici e, poi, ad altri partner fidati tramite il Fairwind Program. Per sviluppatori e aziende parla di arrivo presto, senza data. Nel frattempo una PMI può preparare i propri test e lavorare con i modelli già disponibili.
Giallo ha eseguito i benchmark di Gemini 4 Carbon?
No. Giallo non ha provato Gemini 4 Carbon e non ha rieseguito nessun benchmark: l'articolo riporta i risultati pubblicati da Google il 28 ottobre 2026 e le loro note metodologiche. Il piano di test proposto per la tua azienda è un metodo di lavoro, non il resoconto di una prova.
Come si confronta Gemini 4 Carbon con GPT-6 Astra in modo corretto?
Si guarda riga per riga chi ha prodotto il numero, con quale harness e con quali impostazioni. Sulla tabella Google Carbon è davanti ad Astra in molte righe (per esempio Terminal-Bench 4.0: 65,2% contro 59,1%), ma Astra è primo su FrontierSWE 2. Il confronto decisivo resta un test sui tuoi documenti e processi.