
Fable 5.2 vs Astra: benchmark e prezzi di Claude e GPT-6 a confronto
Fable 5.2 vs Astra: i benchmark dichiarati da Anthropic, i prezzi API di Claude e GPT-6 Astra e come scegliere in azienda con un test sui tuoi casi.
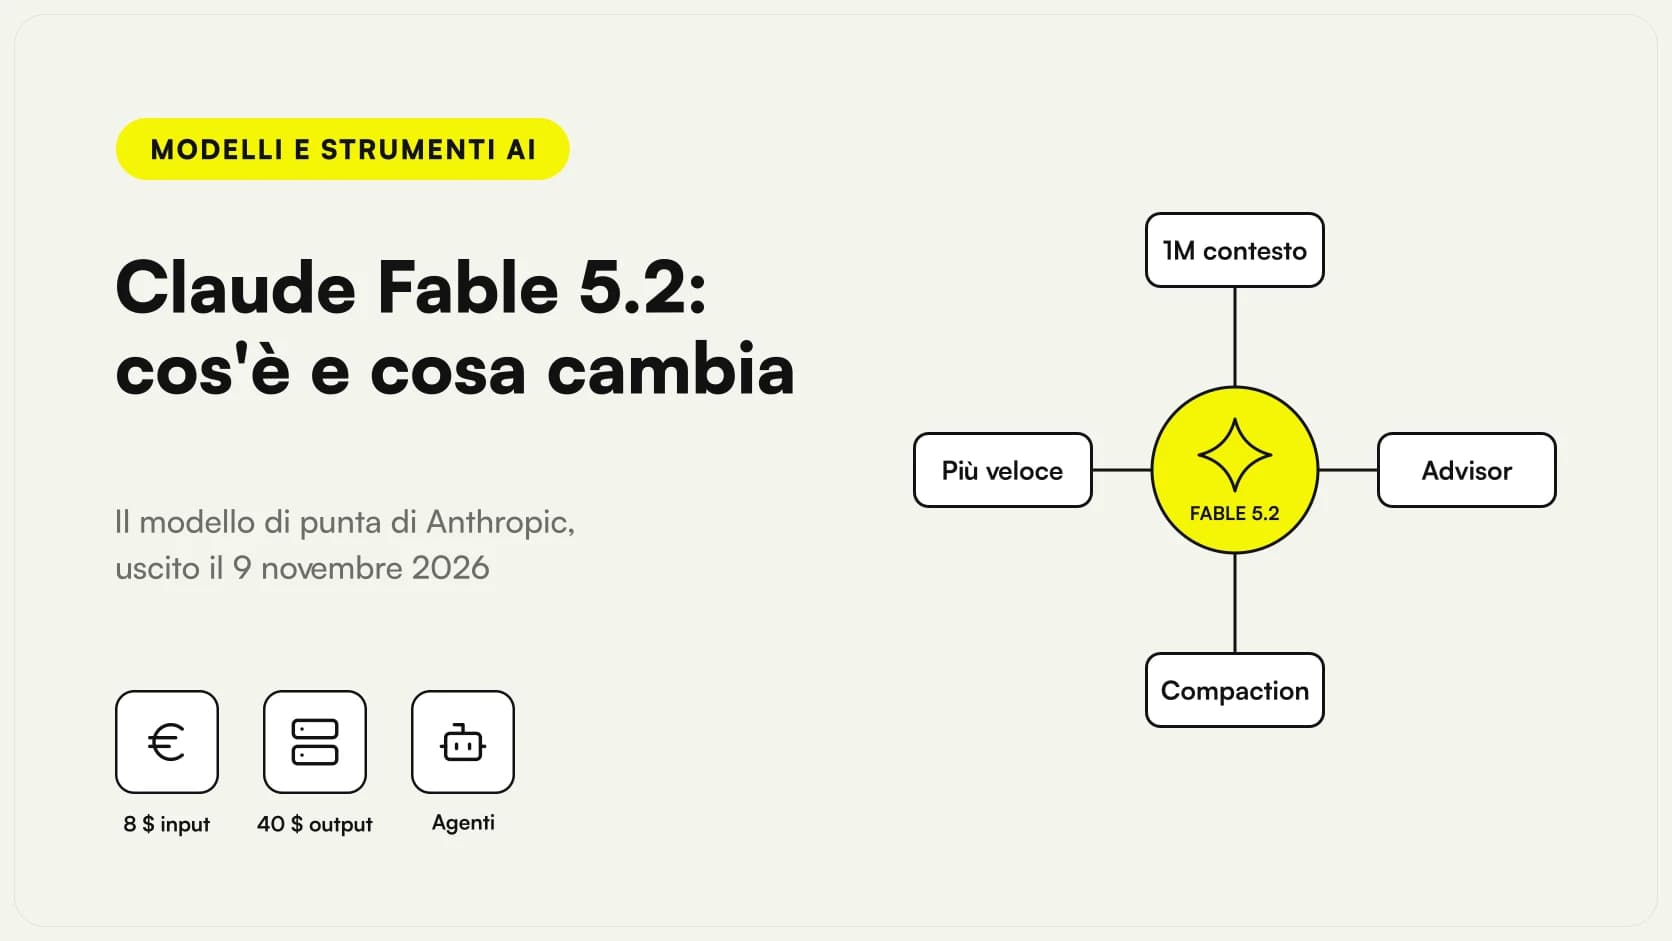
Fable 5.2 vs Astra è il confronto tra due dei modelli di fascia più alta oggi acquistabili: Claude Fable 5.2, rilasciato da Anthropic il 9 novembre 2026, e GPT-6 Astra di OpenAI. Sulla tabella che Anthropic ha pubblicato nell'annuncio ufficiale, Fable 5.2 ha il punteggio più alto in tutte e dieci le prove in cui Astra è presente. Per token costa anche meno: 8 e 40 dollari per milione di token contro i 10 e 50 di Astra, secondo la scheda ufficiale di Fable 5.2 e la pagina del modello nella documentazione OpenAI, consultate il 9 novembre 2026.
Il punto da non perdere è chi ha scritto la tabella: Anthropic, cioè il produttore di uno dei due modelli. I numeri sono dichiarati e non risultano replicati da terzi nelle pagine che abbiamo consultato. Questo articolo li legge riga per riga, mette in fila i prezzi e dà un criterio per scegliere. Per la scheda tecnica completa di Fable 5.2 c'è la guida a Claude Fable 5.2; per Astra, GPT-6 Astra: cos'è e come funziona.
In sintesi
- Nell'annuncio di Anthropic del 9 novembre 2026, Fable 5.2 batte GPT-6 Astra in tutte e dieci le prove con un dato per entrambi, ma la tabella è del produttore di Fable.
- Il listino di Fable 5.2 è di 8 $ in input e 40 $ in output per milione di token, quello di Astra di 10 $ e 50 $: Fable costa il 20% in meno per token (fonte OpenAI).
- Astra applica una maggiorazione ai prompt oltre 272.000 token; nelle pagine di Fable consultate non compare una soglia analoga.
- Su codice e uso del computer Anthropic dichiara scarti netti a favore di Fable; su lettura di grafici lo scarto è di 2,4 punti.
- Mythos 5.2 non è un terzo concorrente: è Fable 5.2 senza salvaguardie cyber e biologia, per organizzazioni approvate.
- Per scegliere servono 15-20 casi vostri provati su entrambi i modelli, misurando qualità e costo per caso concluso.
Come vanno Fable 5.2 e GPT-6 Astra nei benchmark ufficiali?
La tabella di Anthropic confronta Fable 5.2 con altri quattro modelli. Quella che segue tiene solo le righe in cui esiste un punteggio per Astra. Anthropic precisa che i punteggi mostrano, salvo diversa indicazione, il livello di effort più alto disponibile per ciascun modello.
| Prova | Cosa misura | Fable 5.2 (%) | GPT-6 Astra (%) |
|---|---|---|---|
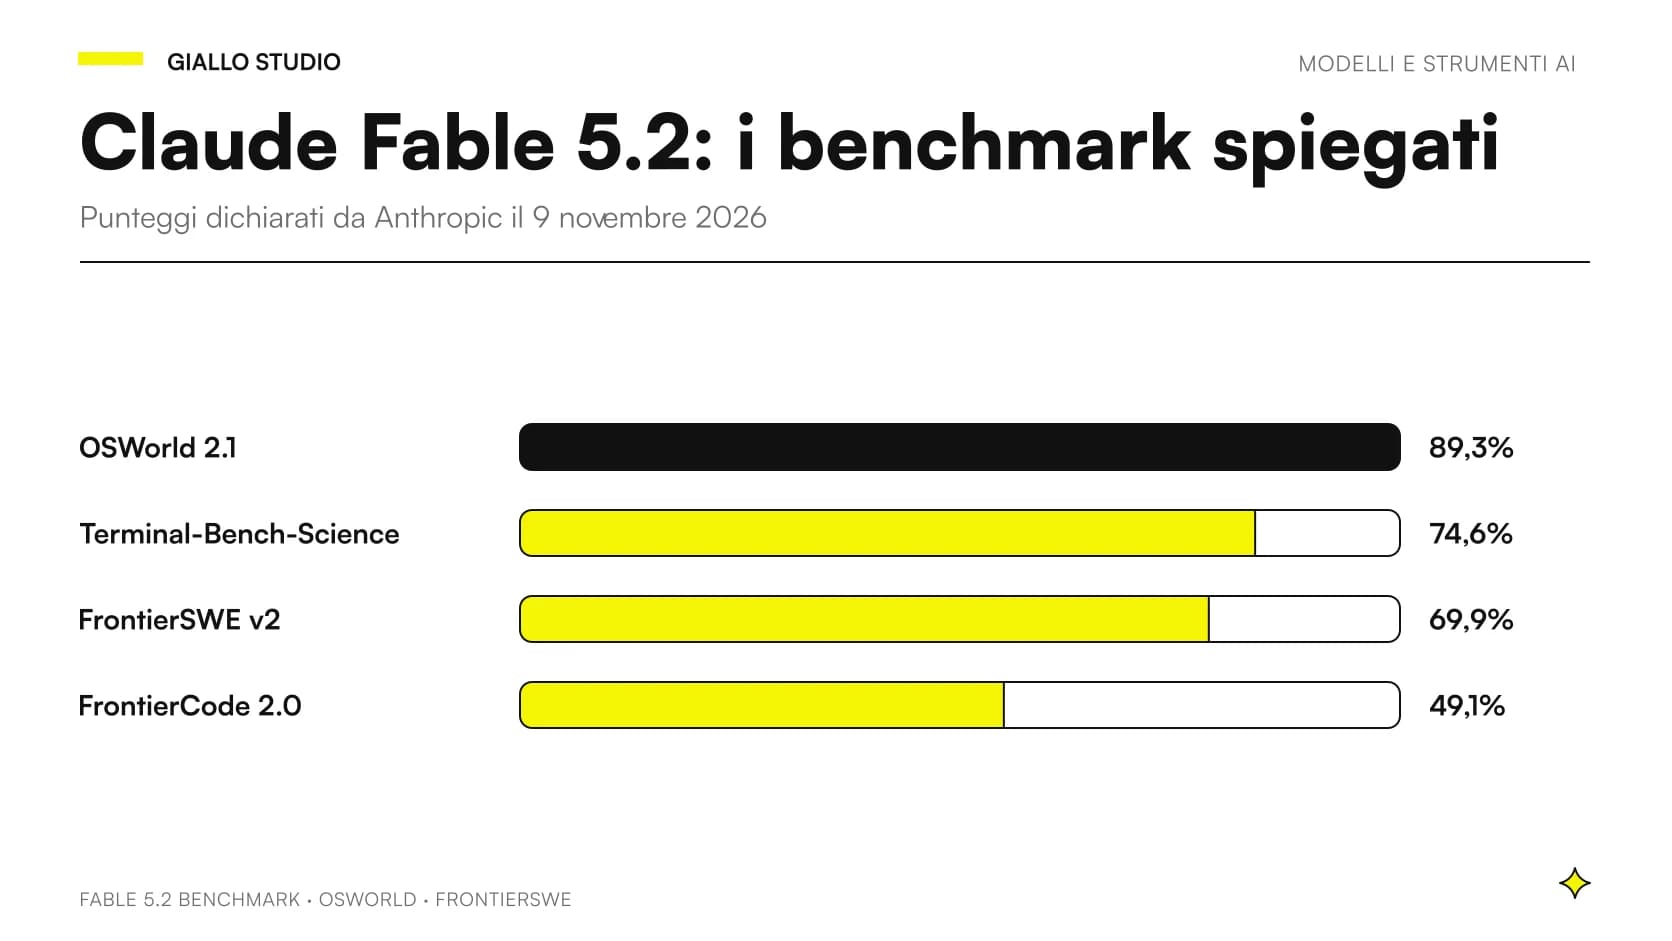
| FrontierCode 2.0 | modifiche al codice che i manutentori accetterebbero | 49,1 | 42,8 |
| FrontierSWE v2 | ingegneria del software | 69,9 | 65,5 |
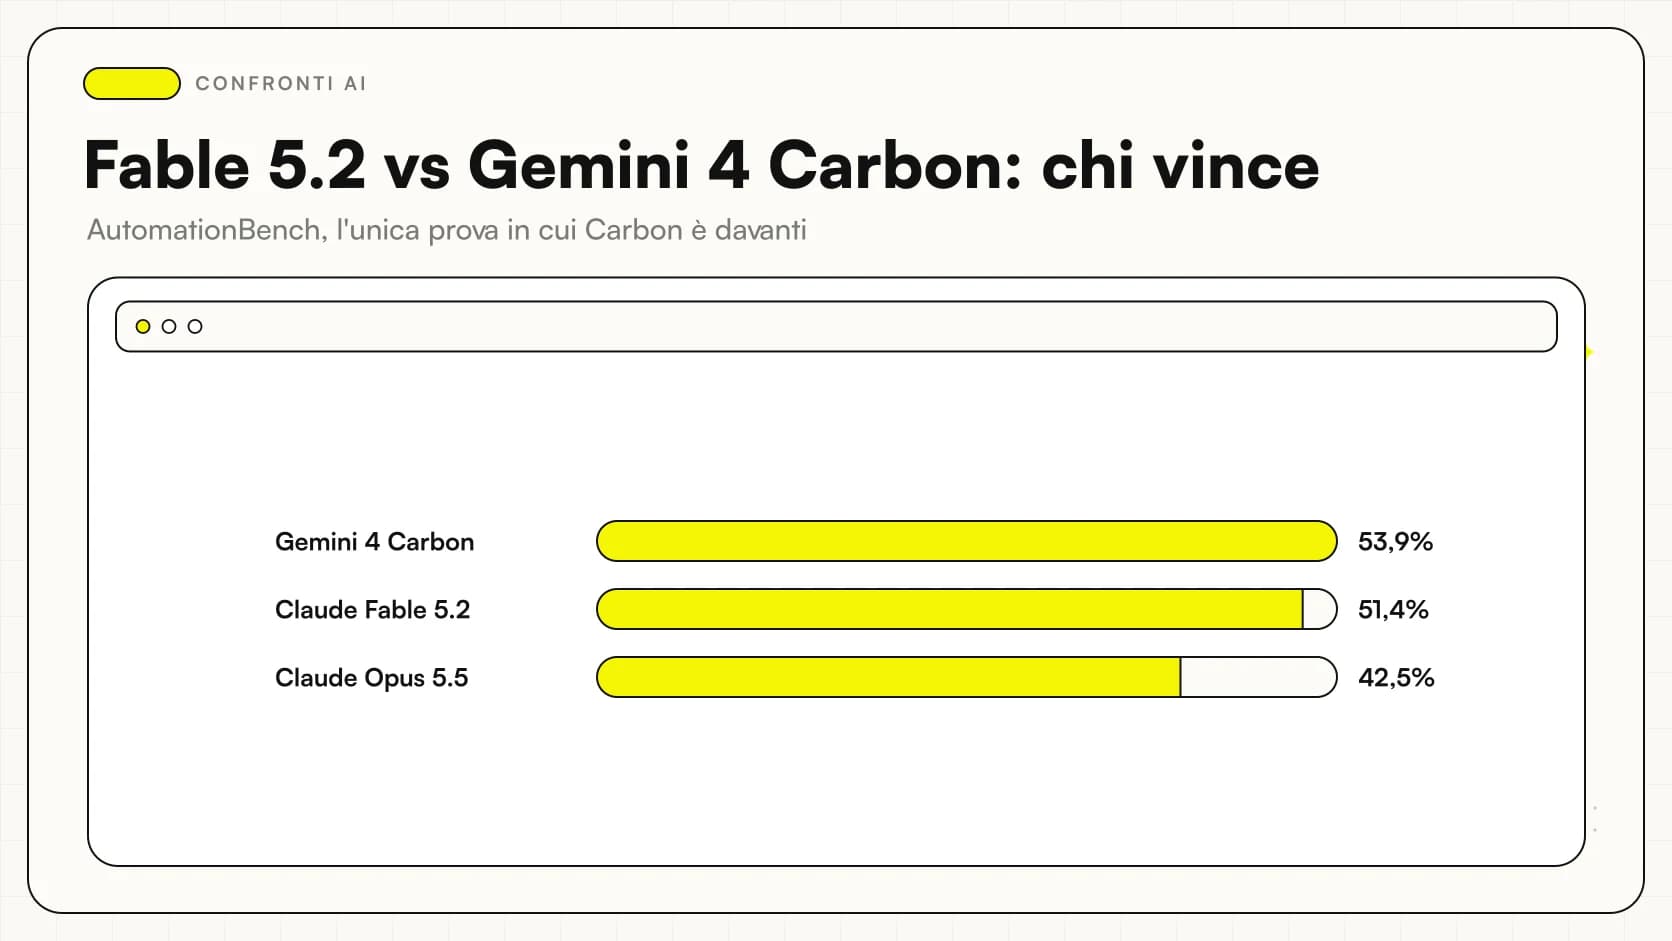
| AutomationBench | flussi di lavoro aziendali | 51,4 | 41,4 |
| Terminal-Bench-Science | ricerca scientifica con agenti | 74,6 | 68,1 |
| OSWorld 2.1 | uso del computer | 89,3 | 79,5 |
| Humanity's Last Exam, con strumenti | conoscenza esperta | 74,2 | 57,2 |
| Chartography, senza strumenti | lettura di grafici | 73,4 | 71,0 |
| RoboDojo Sim | controllo di un robot simulato | 64,9 | 29,8 |
| AA-Briefcase v1.1 (punteggio a rubrica) | lavoro d'ufficio | 66,1 | 52,0 |
| Remote Labor Index | lavori su commissione a distanza | 41,3 | 20,8 |
Fonte: annuncio ufficiale di Anthropic, consultato il 9 novembre 2026. Tre cautele servono per leggerla bene.
- Gli scarti non sono tutti uguali. Calcolati sui punteggi dell'annuncio: su Chartography la differenza è di 2,4 punti, su FrontierSWE di 4,4. Su OSWorld sono quasi 10 punti, su AutomationBench 10 punti esatti, su Humanity's Last Exam 17 punti.
- Alcune righe sono misure interne. Anthropic scrive che RoboDojo Sim è stato eseguito internamente, e che i dati di Astra su quella prova sono «our run», cioè una sua misura. Il punteggio di 29,8% contro 64,9% è il più ampio della tabella, ed è anche il meno verificabile da fuori.
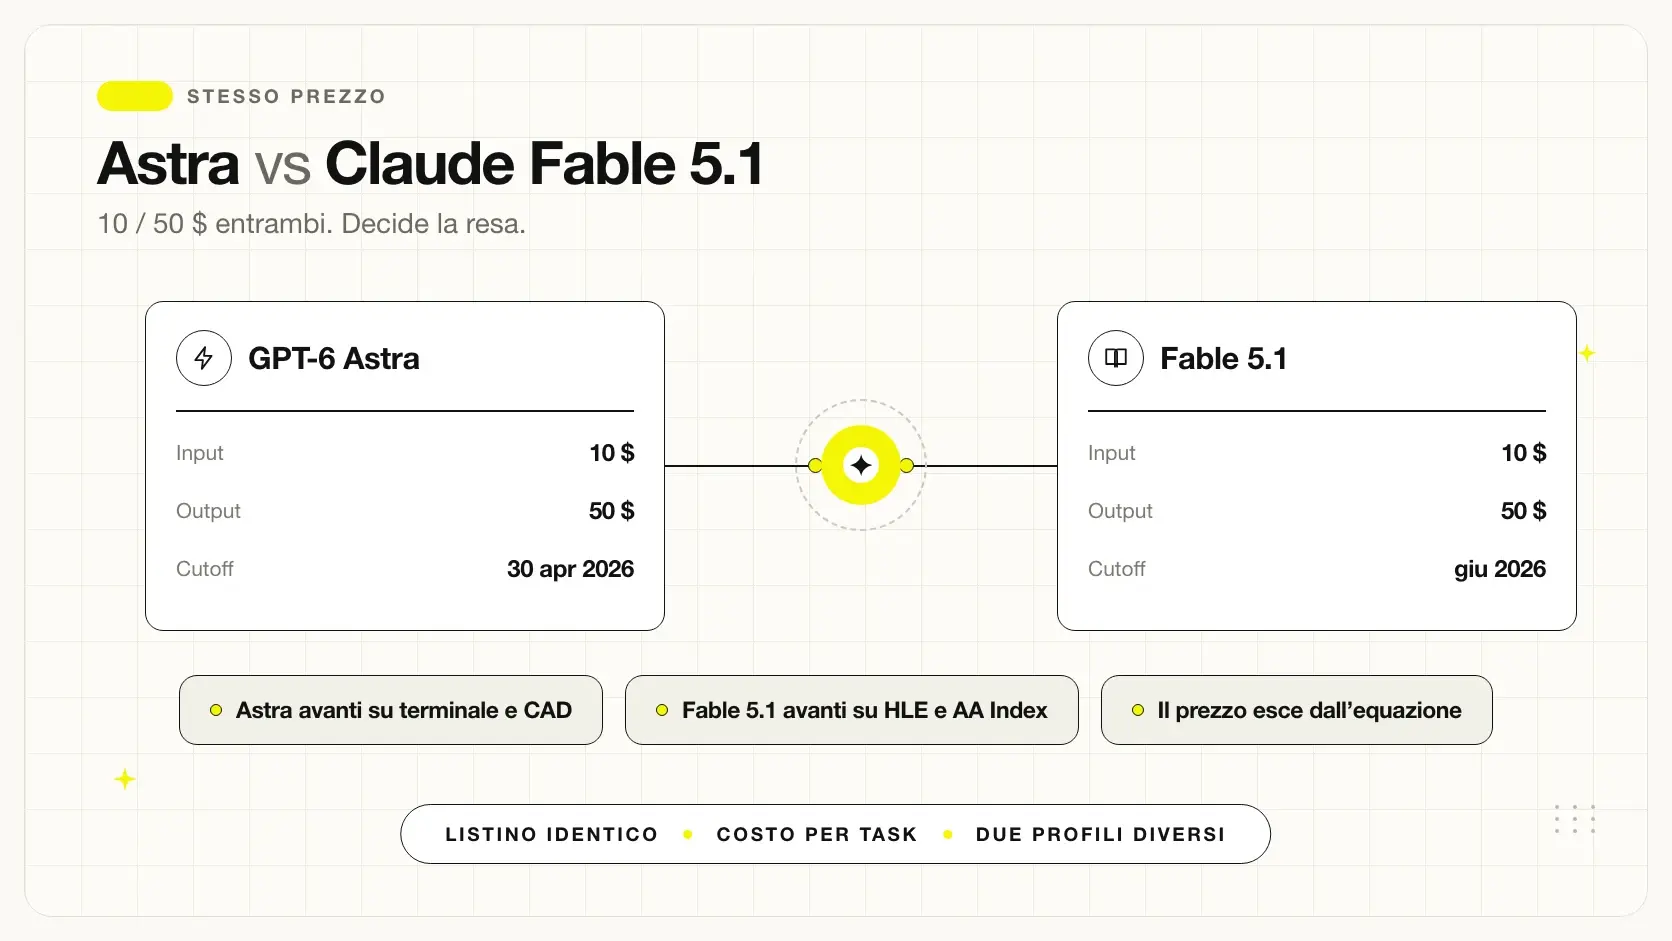
- Una tabella di parte mostra i punti forti di chi la scrive. Nel nostro confronto precedente tra GPT-6 Astra e Fable 5.1, basato sulle tabelle di OpenAI, Astra risultava davanti su alcune prove di terminale, su AutomationBench e su BenchCAD. Le tabelle dei due laboratori raccontano storie diverse perché scelgono prove diverse. Per un quadro più ampio, GPT-6 Astra: i benchmark ufficiali elenca le righe pubblicate da OpenAI.
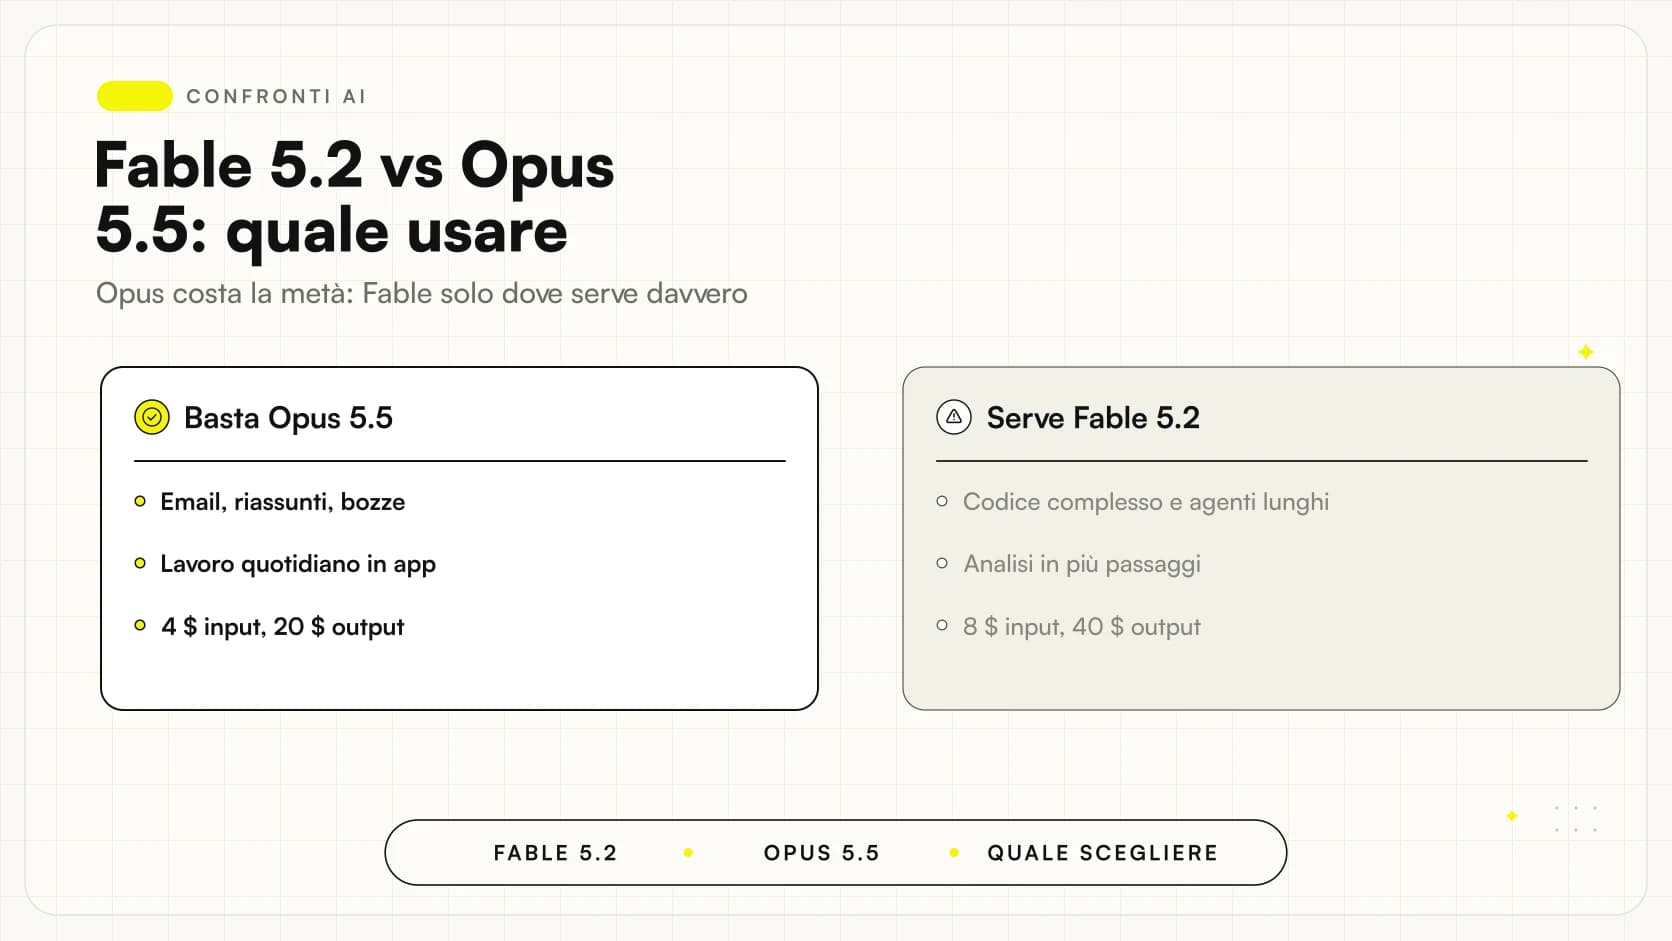
Un confronto a tre con Opus 5.5, il modello che Anthropic consiglia come uso quotidiano, è in Fable 5.2 vs Opus 5.5; le singole prove sono spiegate in Claude Fable 5.2: i benchmark spiegati.
Il dato sul costo: FrontierCode a parità di spesa
Nell'annuncio c'è un grafico di punteggio contro costo per compito su FrontierCode 2.0. Secondo Anthropic, a effort High Fable 5.2 ottiene circa lo stesso risultato del miglior punteggio di Opus 5.5 (45,3% contro 45,5%) per circa metà del costo per compito, ed è davanti al miglior punteggio di Astra (42,8%) a un costo circa uguale. A effort Xhigh Fable 5.2 arriva a 49,1%, il valore più alto tra i modelli rilasciati che Anthropic dichiara di aver testato. È l'informazione più utile della tabella, perché lega la qualità alla spesa. Resta una misura del produttore su un solo insieme di compiti di programmazione.
Quanto costano Fable 5.2 e GPT-6 Astra?
I due listini hanno la stessa forma, con input, output, cache e sconto per l'elaborazione differita. Cambiano i valori e due regole.
| Voce di listino | Fable 5.2 ($ per milione di token) | GPT-6 Astra ($ per milione di token) |
|---|---|---|
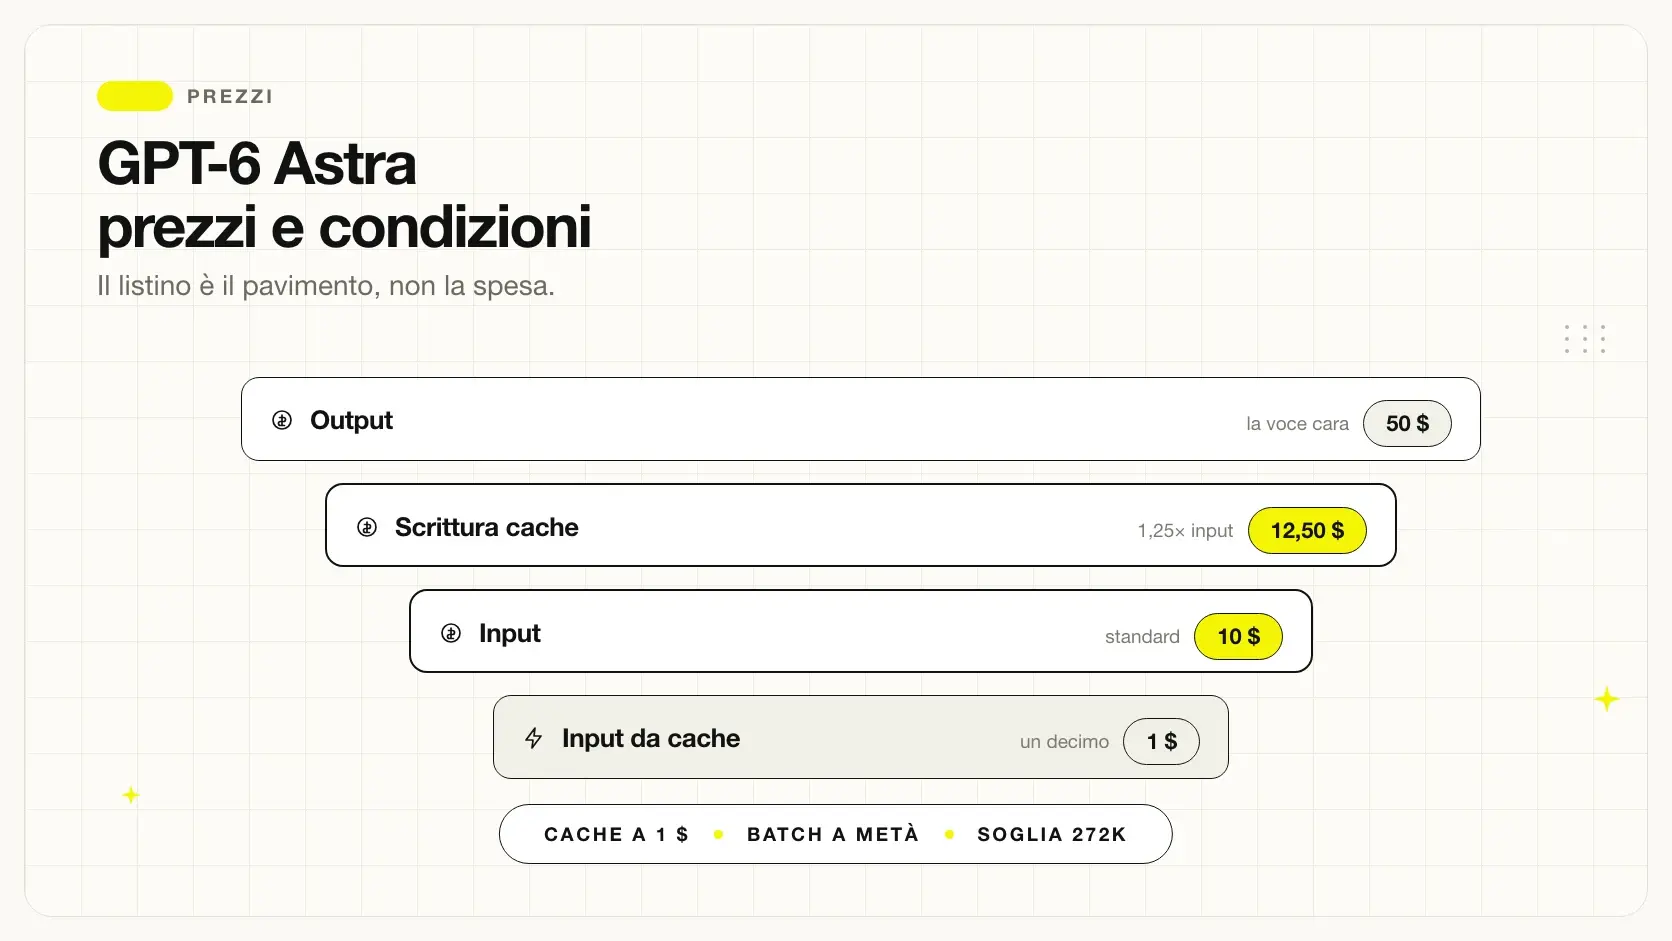
| Input | 8 | 10 |
| Output | 40 | 50 |
| Lettura dalla cache | 0,20 | 1 |
| Scrittura in cache | 10 (5 minuti) o 16 (1 ora) | 12,50 |
| Batch: input / output | 4 / 20 | 5 / 25 |
| Fast mode: input / output | 16 / 80 | 20 / 100 |
Fonti: scheda ufficiale di Fable 5.2, pagina «What's new» e pagina di GPT-6 Astra sulla documentazione OpenAI, tutte consultate il 9 novembre 2026. I valori di Batch di Astra e della Fast mode sono calcolati da noi dalle regole che OpenAI indica (Batch al 50% e Fast al doppio delle tariffe applicabili). Per Astra esiste anche il piano Flex al 50% delle tariffe Standard.
Due differenze pesano oltre il prezzo per token.
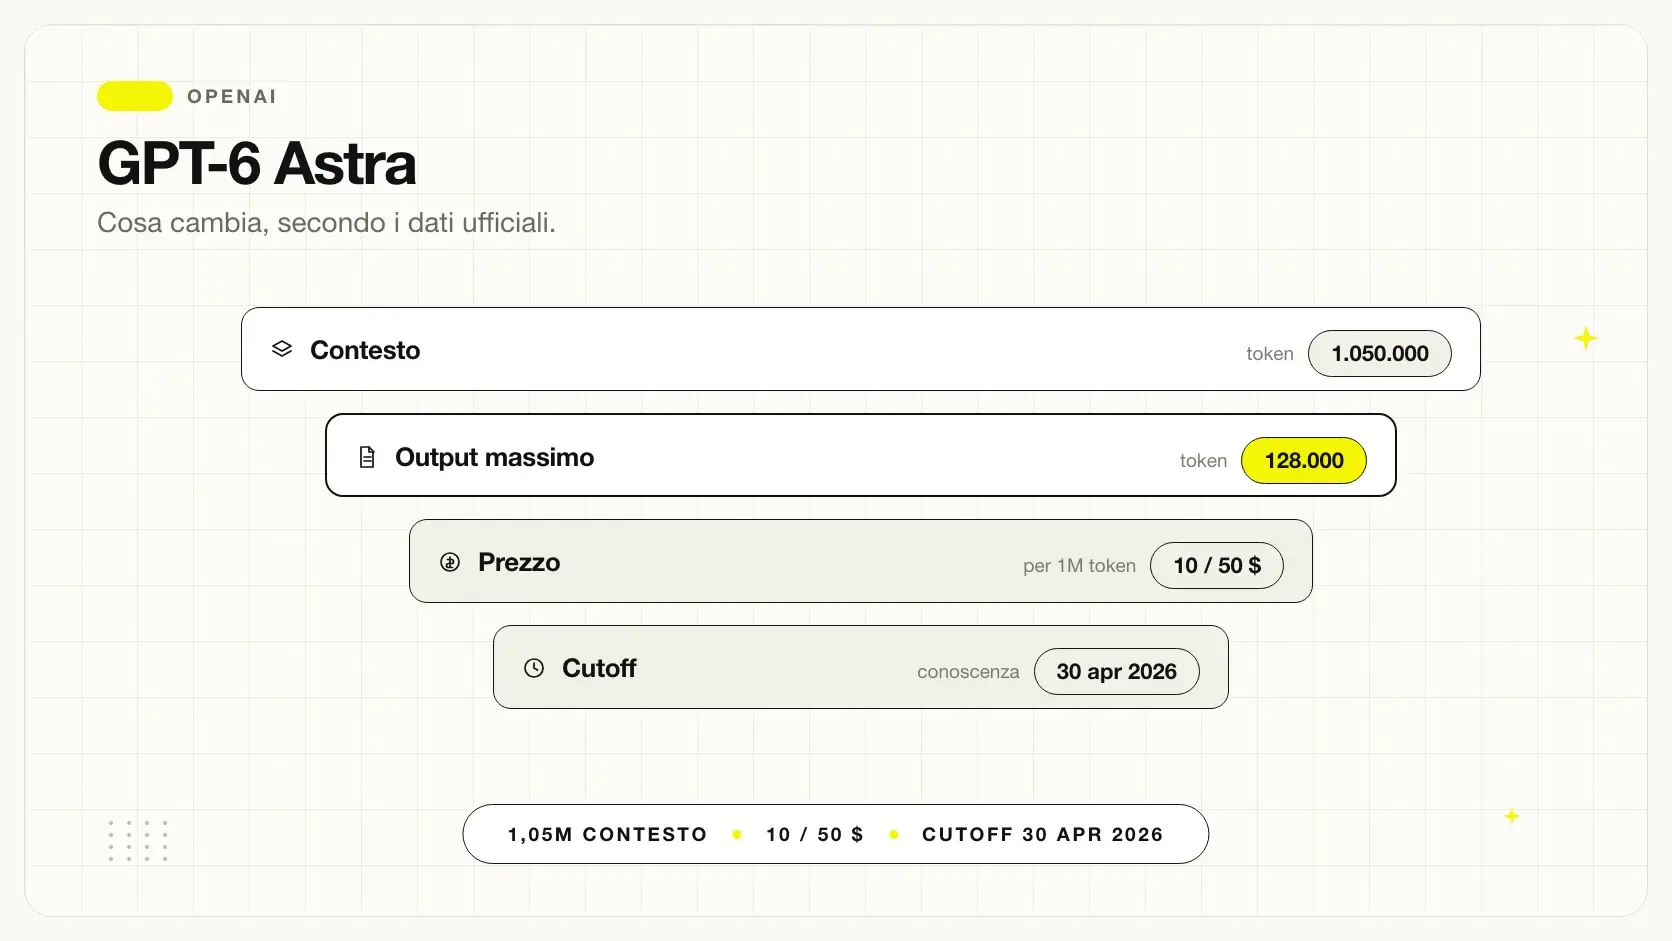
- La soglia dei 272.000 token di Astra. La documentazione OpenAI scrive che i prompt con più di 272.000 token in input sono fatturati al doppio per input e cache e a una volta e mezza per l'output, sull'intera richiesta. Nelle pagine di Fable 5.2 consultate non abbiamo trovato una regola analoga: prima di progettare un sistema che manda documenti molto lunghi, controllate il listino completo di Anthropic. I dettagli di Astra sono in GPT-6 Astra: prezzi, costo reale e quando conviene.
- La lettura dalla cache. Costa 0,20 $ su Fable 5.2 e 1 $ su Astra. Per chi riusa spesso lo stesso contesto, come un catalogo o un prompt di istruzioni lungo, è la voce che sposta di più il conto ricorrente.
Per le altre voci di Fable 5.2 (cache, batch, fast mode) c'è Claude Fable 5.2: prezzi API e costi reali.
Cosa cambia per un e-commerce di cosmetica a Napoli?
Un esempio, dichiarato come tale. Un e-commerce di cosmetica a Napoli usa un agente che prepara le schede prodotto, risponde ai clienti sulle compatibilità degli ingredienti e controlla le descrizioni prima della pubblicazione. Ipotizziamo 10.000 richieste al mese, 3.000 token in input e 800 in output per richiesta, senza cache e senza contare il ragionamento.
- Fable 5.2 (listino della scheda ufficiale): 30 milioni di token in input × 8 $ = 240 $, più 8 milioni in output × 40 $ = 320 $. Totale 560 $.
- GPT-6 Astra (listino OpenAI): 30 milioni × 10 $ = 300 $, più 8 milioni × 50 $ = 400 $. Totale 700 $.
La differenza è di 140 dollari al mese, il 20% (esempio calcolato sui prezzi ufficiali di Fable 5.2 e di Astra citati sopra), perché i volumi sono uguali. È una cifra piccola rispetto al tempo di chi controlla i testi. Per questa attività la domanda corretta non è «quale dei due», ma «serve davvero un modello di questa fascia». Per schede prodotto e risposte ai clienti spesso bastano modelli più economici: nella famiglia Claude Anthropic consiglia di partire da Opus 5.5, e il confronto tra Opus 5 e Astra è in Opus 5 vs GPT-6 Astra. Il modello di punta si giustifica su un compito difficile e raro, per esempio la verifica di centinaia di schede contro le normative sui cosmetici. Se l'azienda ha anche uno shop da costruire o migliorare, la parte tecnica si affronta con un e-commerce su misura.
Quando scegliere Fable 5.2 e quando GPT-6 Astra?
Non c'è un vincitore valido per tutti. Questi sono i criteri che usiamo noi di Giallo per orientare la scelta, tenendo i limiti di una tabella di parte.
Orientati verso Fable 5.2
- Compiti di codice complessi e agenti che lavorano per ore, dove Anthropic dichiara il vantaggio più netto.
- Uso del computer, per esempio pratiche su gestionali senza API.
- Contesti molto lunghi, se vi riguarda la maggiorazione di Astra sopra 272.000 token.
- Volumi con molta cache, dove la lettura costa 0,20 $ invece di 1 $.
Orientati verso GPT-6 Astra
- Avete già un'integrazione OpenAI, ChatGPT in azienda e un accordo sui dati firmato: cambiare costa più dei 140 $ del nostro esempio.
- Servono strumenti dell'ecosistema OpenAI già in uso.
- I vostri test mostrano che Astra vince sul vostro compito: conta più di qualunque tabella.
- Lavorate su Amazon Bedrock con il modello
openai.gpt-6-astra, come indicato nella documentazione OpenAI.
Anche i limiti di ciascun modello pesano. Astra, secondo la pagina OpenAI, non supporta audio, video e fine-tuning. Fable 5.2 accetta testo e immagini e risponde con testo, e ha tre comportamenti da conoscere dalla documentazione ufficiale: a effort medium o superiore pensa anche quando gli si chiede di non farlo, su compiti lunghi può fermarsi prima, e segue alla lettera le regole di stile.
Che cosa cambia sui dati personali dei clienti?
È la parte che i confronti sui benchmark di solito saltano. Fable 5.2 e Mythos 5.2 sono «Covered Models»: la pagina di Anthropic, consultata il 9 novembre 2026, indica una conservazione minima di 30 giorni e l'assenza della zero data retention, anche per Enterprise e per le piattaforme di terzi, salvo esenzione. Per Astra non abbiamo verificato oggi le condizioni di conservazione dei dati: non risultano condizioni di conservazione che abbiamo potuto leggere e riassumere nella pagina del modello, quindi non le riportiamo. Con dati personali o riservati chiedete per iscritto a entrambi i fornitori conservazione, regioni di elaborazione e accordo sul trattamento. Il capitolo dedicato a Fable è in Fable 5.2 e privacy: dati conservati 30 giorni.
Dove entra Mythos 5.2 nel confronto con Astra?
Molte ricerche mettono Claude Mythos accanto a GPT-6 Astra, ma i due non sono avversari diretti. Secondo l'annuncio, Fable e Mythos sono lo stesso modello: Fable ha forti salvaguardie su cybersecurity e biologia e per questo è offerto a tutti, Mythos si ottiene tramite i programmi di verifica per organizzazioni che lavorano in quei campi. Per un'azienda che non fa ricerca di sicurezza o biomedica, il confronto utile è quello con Fable. Il quadro dei due fratelli è in Fable 5.2 vs Mythos 5.2.
Sulla cybersecurity la tabella di Anthropic mette Mythos 5.2 accanto non ad Astra ma a «GPT-6 Cyber» (76,3% contro 61% su CyScenarioBench), con una nota: ogni laboratorio usa compiti propri. Non è quindi un confronto alla pari. Il lato OpenAI è in GPT-6 Cyber.
Come decidere in azienda con un test di una settimana
- Scegliete un compito difficile e ricorrente, non il più comune: un controllo tra documenti, una modifica di codice, una pratica su un gestionale.
- Raccogliete 15-20 casi reali, anonimizzati, di cui conoscete la risposta giusta.
- Eseguiteli su Fable 5.2 e su Astra con lo stesso prompt di partenza e un livello di ragionamento comparabile (entrambi hanno low, medium, high, xhigh e max).
- Annotate per ogni caso esito corretto, token consumati e minuti di revisione umana.
- Dividete la spesa per i casi riusciti e decidete. Un risparmio sul listino non conta se un modello sbaglia un caso in più ogni dieci.
Quali errori evitare nel confronto?
- Decidere dalla tabella del produttore. La tabella di Anthropic fotografa le prove scelte da Anthropic. Quelle di OpenAI fotografano le sue.
- Confrontare modelli a effort diversi. Un punteggio a Max non è paragonabile a uno a Low: guardate sempre l'effort e il costo per compito.
- Ignorare le regole di prezzo nascoste. La soglia dei 272.000 token di Astra e il ragionamento fatturato come output cambiano il conto più della differenza di listino.
- Cambiare fornitore per un punto di benchmark. Integrazioni, accordi sui dati e prompt già messi a punto hanno un costo che le tabelle non mostrano.
- Usare il modello di punta per tutto. Per i compiti d'ufficio quotidiani un livello inferiore costa molto meno; il quadro di insieme è nel confronto tra Claude, GPT e Gemini.
Fable 5.2 o Astra: la scelta pratica
Sulle prove dichiarate da Anthropic, Fable 5.2 è avanti, costa meno per token e non mostra, nelle pagine consultate, la maggiorazione sui prompt lunghi di Astra. Sono tre motivi sufficienti per includerlo nel vostro test, non per decidere al posto del test. La stessa cautela vale al contrario: se i vostri casi favoriscono Astra, i punti di una tabella non devono farvi cambiare. Il terzo concorrente della generazione è trattato in Fable 5.2 vs Gemini 4 Carbon.
Se volete un confronto fatto sui vostri documenti e sul vostro gestionale, con costo per caso concluso e tempo di revisione, la consulenza AI di Giallo Studio parte da una prova su dati reali e termina con una raccomandazione scritta, indipendente dal fornitore. Prima di firmare qualunque contratto controllate le pagine ufficiali di Anthropic e di OpenAI: versioni, prezzi e soglie cambiano di settimana in settimana.
Metodo e fonti delle guide di Giallo Studio
Vuoi applicarlo alla tua azienda?In 30 minuti, gratis: il processo da automatizzare per primo e il ritorno stimato, per iscritto.
Prenota l’audit gratuitoCome lo applichiamo in azienda
Risorse correlate
 Claude Fable 5.2: cos'è, cosa cambia, quanto costa e a chi serve
 Fable 5.2 vs Opus 5.5: quale usare e quando
 GPT-6 Astra: cos'è, come si usa e dove non arriva
 GPT-6 Astra: prezzi, costo reale e quando conviene
 GPT-6 Astra vs Claude Fable 5.1
 Claude Fable 5.2 benchmark: cosa misurano davvero e come verificarli
 Fable 5.2 vs Gemini 4 Carbon: chi vince dove
 Claude, GPT e Gemini a confronto
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Fable 5.2 vs Gemini 4 Carbon: chi vince dove
- Claude Mythos vs Fable 5.2: differenze vere e chi può usarli
- Fable 5.1 vs 5.2: cosa cambia davvero e se conviene aggiornare
- Fable 5.2 vs Opus 5.5: quale usare e quando
- Claude Fable 5.1 vs Sonnet 5
- Gemini 3.6 Flash vs 3.5 Flash
- DeepSeek R1 Distill 32B vs Qwen3.8-27B in locale
- Gemini 4 Argon vs ChatGPT e Claude: quale scegliere
- Claude vs Perplexity
- Gemini 4 Carbon vs Argon: differenze e quale scegliere
- Claude vs Gemini: quale usare
- Gemini 4 Carbon vs GPT-6 Astra e Claude: quale scegliere per ogni attività
FAQ
Fable 5.2 è meglio di GPT-6 Astra?
Nella tabella pubblicata da Anthropic il 9 novembre 2026, Fable 5.2 ha il punteggio più alto di Astra in tutte e dieci le prove in cui i due sono confrontati. È una tabella del produttore di Fable, non replicata da terzi, quindi dice dove Fable è forte, non chi vincerà sui vostri compiti. Per deciderlo serve una prova su casi vostri.
Quanto costano Fable 5.2 e GPT-6 Astra?
Fable 5.2 costa 8 dollari per milione di token in input e 40 in output. GPT-6 Astra costa 10 e 50 dollari sul piano Standard. Per token, Fable costa quindi il 20% in meno. Sono prezzi di listino in dollari: il costo reale dipende dai token di ragionamento, dalla cache e dai tentativi falliti.
Claude Mythos 5.2 si confronta con GPT-6 Astra?
Non direttamente. Mythos 5.2 è lo stesso modello di Fable 5.2 senza le salvaguardie su cybersecurity e biologia, ed è riservato a organizzazioni approvate. Per la sicurezza informatica il concorrente indicato da Anthropic non è Astra ma GPT-6 Cyber, e i punteggi non sono confrontabili perché ogni laboratorio usa compiti diversi.
Quale dei due costa meno per un compito di codice?
Secondo Anthropic, su FrontierCode 2.0 Fable 5.2 a effort High supera il miglior punteggio di Astra (45,3% contro 42,8%) a un costo per compito circa uguale. Il dato viene dal grafico costo-prestazioni dell'annuncio ed è una misura di Anthropic. Sul vostro codice il rapporto può essere diverso.
Posso usare GPT-6 Astra con audio o video?
No. La pagina del modello nella documentazione OpenAI, consultata il 9 novembre 2026, indica input di testo e immagini, output di solo testo, e audio e video non supportati. Fable 5.2 accetta anch'esso testo e immagini e risponde con testo.
Conviene cambiare fornitore per passare a Fable 5.2?
Di norma no, se non avete un compito dove il modello attuale sbaglia in modo misurabile. Cambiare fornitore costa test, revisione dei prompt e un nuovo accordo sui dati. Conviene invece misurare Fable 5.2 e Astra sugli stessi 15-20 casi reali e tenere il modello che, per costo e qualità, vince sulla vostra lavorazione.