
GPT-6 Astra: cos'è, come si usa e dove non arriva
Cos'è GPT-6 Astra: scheda tecnica, come si accede da ChatGPT o API, i benchmark che non vince e i limiti che OpenAI dichiara.
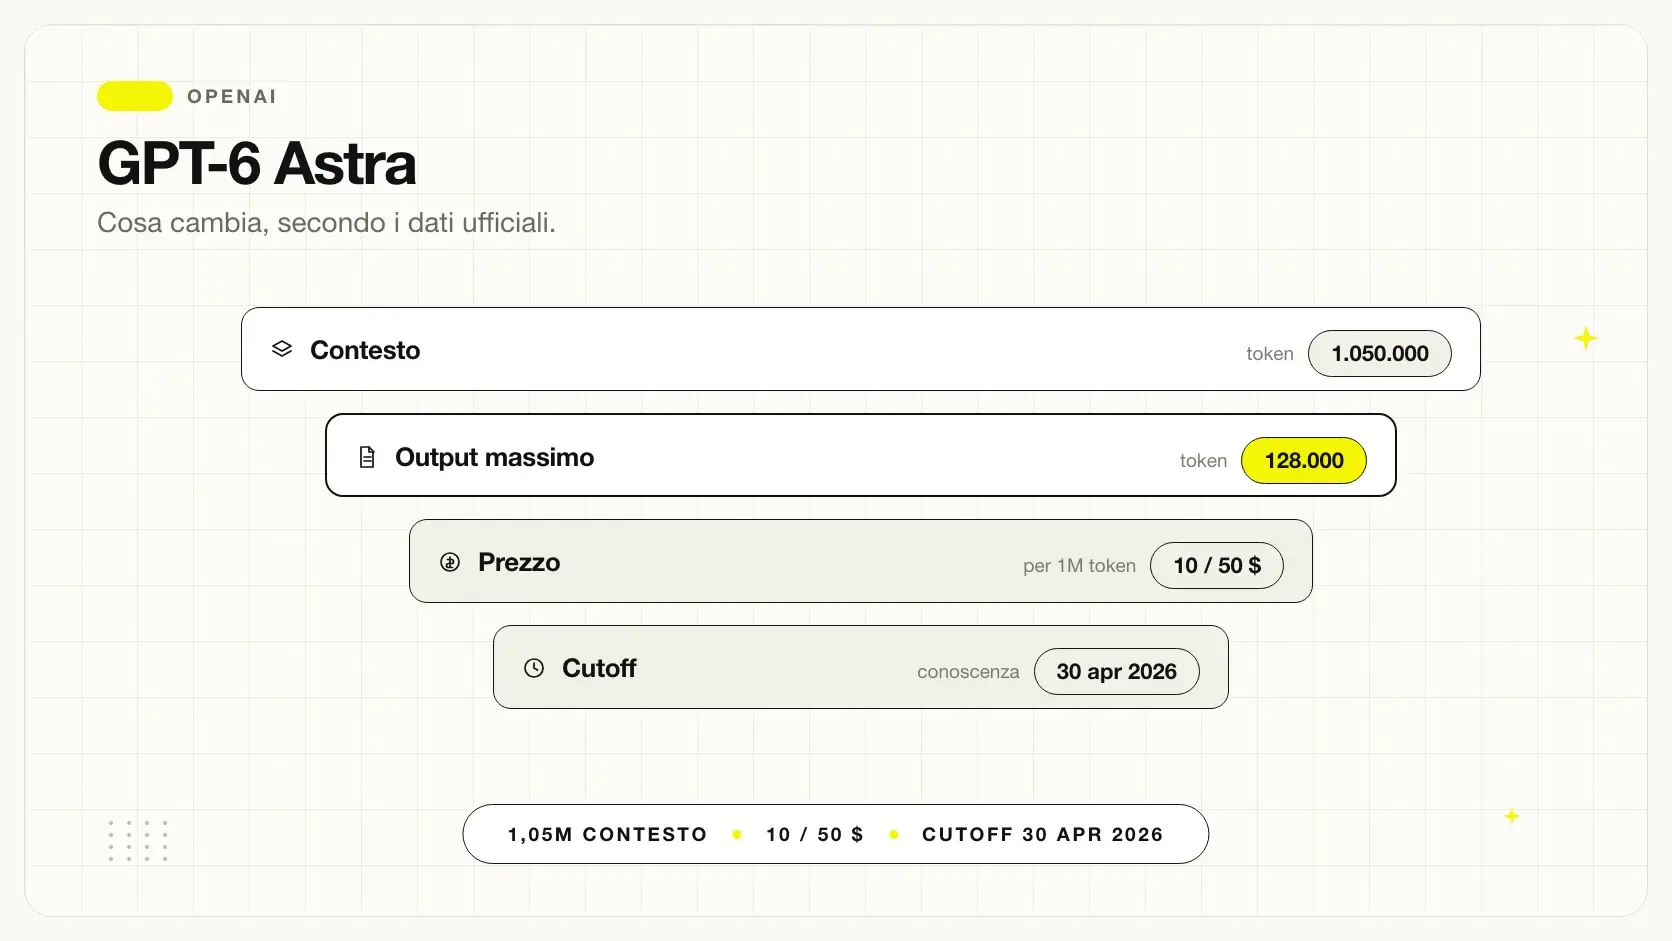
GPT-6 Astra è il modello di punta di OpenAI, presentato come il più capace per il lavoro complesso portato a termine da un capo all'altro. Questa è la guida di riferimento: cosa dichiara la scheda tecnica, come ci si accede dalla chat e dall'API, e dove non arriva — perché i benchmark che non vince sono nelle stesse tabelle pubblicate da OpenAI.
Solo dati verificati sulle fonti ufficiali: l'annuncio, la scheda tecnica dell'API e la scheda di sistema. Verificati il 4 settembre 2026.
In sintesi
- Contesto 1.050.000 token, output massimo 128.000, cutoff 30 aprile 2026.
- Cinque livelli di ragionamento: low, medium, high, xhigh, max.
- Accesso da ChatGPT Plus, Pro, Business ed Enterprise e via API, Azure e Bedrock.
- Sugli account Enterprise è disattivato di default: lo abilita un amministratore.
- Su alcuni benchmark resta dietro a Claude, e OpenAI lo pubblica.
- Niente audio né video, niente fine-tuning.
La scheda tecnica
Tutti i valori vengono dalla pagina modello della documentazione OpenAI.
| Caratteristica | GPT-6 Astra |
|---|---|
| Identificativo API | gpt-6-astra |
| Finestra di contesto | 1.050.000 token |
| Output massimo | 128.000 token |
| Data limite conoscenza | 30 aprile 2026 |
| Livelli di ragionamento | low, medium, high, xhigh, max |
| Input | testo e immagini |
| Output | solo testo |
| Audio e video | non supportati |
| Fine-tuning | non supportato |
L'assenza di audio e video merita attenzione: se il tuo progetto prevede trascrizione o analisi di contenuti parlati, questo modello non è la risposta e serve affiancarne un altro.
Sul fronte degli strumenti la dotazione è invece ampia: ricerca web, ricerca file, generazione immagini, interprete di codice, shell ospitata, applicazione di patch, uso del computer, MCP e ricerca tra strumenti.
Cosa cambia rispetto alla generazione precedente
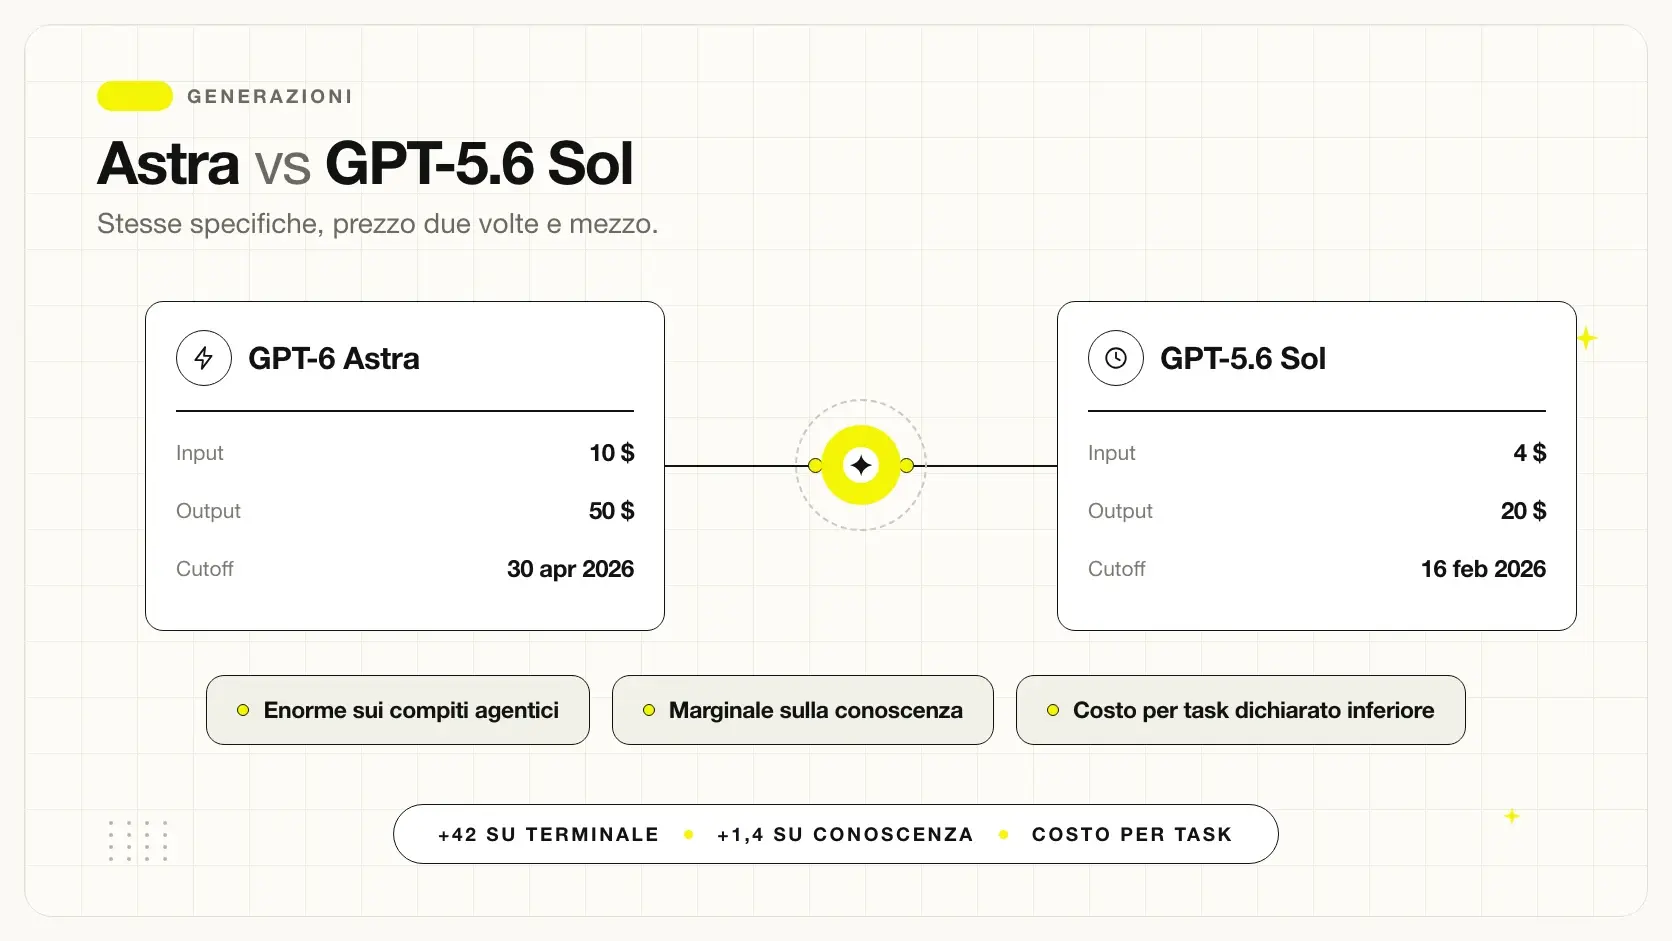
Il confronto con GPT-5.6 Sol è quello più solido fra tutti, perché è interno: stesso produttore, stessa impalcatura, stesso interesse a mostrare un progresso reale.
| Benchmark | Astra | Sol | Differenza |
|---|---|---|---|
| ARC-AGI-3 | 99,9% | 7,8% | oltre 12× |
| SRE-Bench | 88,0% | 55,9% | +32 punti |
| ScreenSpot-Pro | 92,7% | 76,9% | +16 punti |
| Terminal-Bench Science 0.1 | 64,6% | 22,4% | +42 punti |
| Terminal-Bench 4.0 | 57,9% | 37,3% | +21 punti |
| AutomationBench | 41,4% | 18,1% | +23 punti |
| MRCR 512K-1M | 96,3% | 73,8% | +23 punti |
| GPQA Diamond | 96,0% | 94,6% | +1,4 punti |
L'ultima riga è la più istruttiva: sulla conoscenza scientifica di livello universitario il guadagno è di poco più di un punto, mentre sui compiti agentici e di uso del computer è di decine di punti.
È il segnale più chiaro sulla direzione di questo modello: non è "sa più cose", è "porta a termine più lavoro". Per un'azienda la distinzione è tutt'altro che accademica, perché sposta il tipo di progetti che diventano realizzabili.
Il confronto completo, con i costi dichiarati per ciascun test, è in GPT-6 Astra vs GPT-5.6 Sol.
Le affermazioni di efficienza
OpenAI accompagna diversi punteggi con un dato di costo, cosa rara e utile.
- Terminal-Bench Science: 64,6% contro 52,6% di Fable 5.1, a ~31% di costo API stimato in meno
- Agents' Last Exam: ~65% di token di output in meno rispetto a Opus 5
- OSWorld 2.0: 72,6% in ~40 minuti per task contro 65,7% in ~75 minuti di Sol
- BenchCAD: ~43% in meno di Sol e ~86% in meno di Fable 5.1
- Codex aggiornato: 1,9× più veloce di Sol su Mind2Web
Sono stime di costo dichiarate dal produttore, non misurazioni indipendenti. Ma il fatto che vengano pubblicate accanto ai punteggi è già un passo avanti rispetto alla norma del settore, dove si mostra il risultato e si tace quanto è costato ottenerlo.
Disponibilità e accesso
Secondo l'annuncio, Astra arriva su ChatGPT Plus, Pro, Business ed Enterprise, oltre che via API OpenAI, Microsoft Azure e AWS Bedrock.
Due dettagli operativi che contano per chi lo deve introdurre in azienda. Il primo: sugli account Enterprise l'accesso è disattivato di default al lancio, e serve che un amministratore lo abiliti per lo spazio di lavoro. Il secondo: gli utenti Pro, Business ed Enterprise ottengono anche GPT-6 Astra Pro, una variante distinta.
L'uso rientra nelle soglie già incluse negli abbonamenti, con la possibilità di acquistare crediti aggiuntivi. Per i clienti API idonei è supportata la conservazione zero dei dati, che per chi tratta informazioni riservate è spesso la condizione che sblocca il progetto.
Sul fronte dei limiti tecnici, la scheda indica soglie di traffico che crescono con il livello dell'account: si parte da 500 richieste al minuto e 500.000 token al minuto sul primo livello, fino a valori molto più alti sui livelli superiori. Il piano gratuito non è supportato.
La guida pratica all'uso via API, con endpoint e strumenti disponibili, è in GPT-6 Astra via API; il lato ChatGPT è in ChatGPT Astra: come usarlo.
Chi ha accesso
Secondo l'annuncio ufficiale, il rilascio è iniziato con un insieme limitato di organizzazioni e si è esteso nei giorni successivi a tutti gli utenti Plus, Pro, Business ed Enterprise, oltre che attraverso l'API OpenAI, Microsoft Azure e AWS Bedrock.
| Piano | Accesso ad Astra | Astra Pro |
|---|---|---|
| Gratuito | non supportato | no |
| Plus | sì | no |
| Pro | sì | sì |
| Business | sì | sì |
| Enterprise | sì, da abilitare | sì |
La riga di Enterprise è quella che genera più confusione: l'accesso è disattivato di default al lancio, e deve essere un amministratore ad abilitarlo per lo spazio di lavoro. Se lavori in un'azienda con piano Enterprise e non vedi il modello, quasi certamente è questo il motivo.
Cos'è Astra Pro
L'annuncio indica che gli utenti Pro, Business ed Enterprise hanno accesso anche a GPT-6 Astra Pro, presentato come variante distinta.
La documentazione consultata non ne dettaglia specifiche separate rispetto ad Astra, quindi non riportiamo differenze tecniche che non abbiamo verificato. Quello che si può dire è che si tratta di un'opzione aggiuntiva riservata ai piani superiori.
Se stai valutando l'abbonamento in funzione di questa variante, conviene verificare direttamente nella propria interfaccia cosa offre, perché è il tipo di dettaglio che cambia rapidamente.
Cosa puoi farci concretamente
Dall'annuncio emergono capacità che in ChatGPT si traducono in usi diretti.
- Creare presentazioni e documenti che seguono i tuoi template
- Analizzare dati e generare grafici
- Fare ricerche online e produrre riassunti
- Creare siti e web app con la funzione Sites
- Compilare moduli e operare dentro software
- Lavorare su documenti lunghi con la finestra estesa
Le prime tre sono le più immediate per un uso quotidiano d'ufficio. Le altre richiedono più configurazione e ricadono nell'area dell'uso del computer, descritta in GPT-6 Astra e il computer use.
Perché i risultati possono differire dall'API
C'è una nota nell'annuncio che vale la pena riportare, perché spiega discrepanze che altrimenti sembrano incomprensibili.
OpenAI specifica che le valutazioni sono state eseguite nel proprio ambiente di ricerca o via API, e che questo può dare risultati leggermente diversi da ChatGPT in produzione, a causa di differenze nei prompt di sistema, negli strumenti disponibili e in altri elementi di configurazione.
Aggiunge, in una nota separata, che la versione di GPT-5.6 Sol disponibile in API, Codex e ChatGPT Work è leggermente diversa da quella in ChatGPT Chat.
Chat o API: come si decide
È la domanda che ricorre in ogni azienda che valuta questo modello, e ha una risposta abbastanza netta.
| Situazione | Strada giusta |
|---|---|
| Persone che aprono una conversazione | ChatGPT |
| Lavoro esplorativo, non ripetibile | ChatGPT |
| Documenti prodotti su richiesta | ChatGPT |
| Flusso automatico su molti casi | API |
| Elaborazione notturna in blocco | API, con Batch o Flex |
| Integrazione in un sistema esistente | API |
La discriminante non è il volume ma chi avvia il lavoro. Se lo avvia una persona, caso per caso, la chat è più semplice e il costo è prevedibile. Se lo avvia un sistema, serve l'API — e con essa la possibilità di usare le modalità a metà prezzo sui carichi non urgenti.
C'è poi un caso ibrido frequente: persone che fanno la stessa cosa molte volte al giorno. Quello è il segnale che un flusso andrebbe automatizzato, e la strada corretta diventa l'API anche se oggi passa dalla chat.
I limiti d'uso: cosa aspettarsi
L'annuncio indica che l'uso rientra nelle soglie già incluse negli abbonamenti, con crediti acquistabili per andare oltre. Non specifica i valori esatti per piano, quindi non li riportiamo.
Quello che si può dire è che le soglie esistono e che su un modello di questa fascia sono verosimilmente più strette che sui modelli leggeri: elaborare risposte lunghe con ragionamento esteso consuma molto più di una risposta breve.
Per un uso aziendale la conseguenza pratica è che vale la pena distribuire i compiti: usare Astra dove serve davvero e modelli più leggeri per il lavoro ordinario, invece di consumare le soglie su richieste banali.
È lo stesso principio della strategia a modello misto, applicato alla chat invece che a un sistema automatico.
Una nota sul nome
Vale la pena chiarire la confusione terminologica, perché genera ricerche a vuoto.
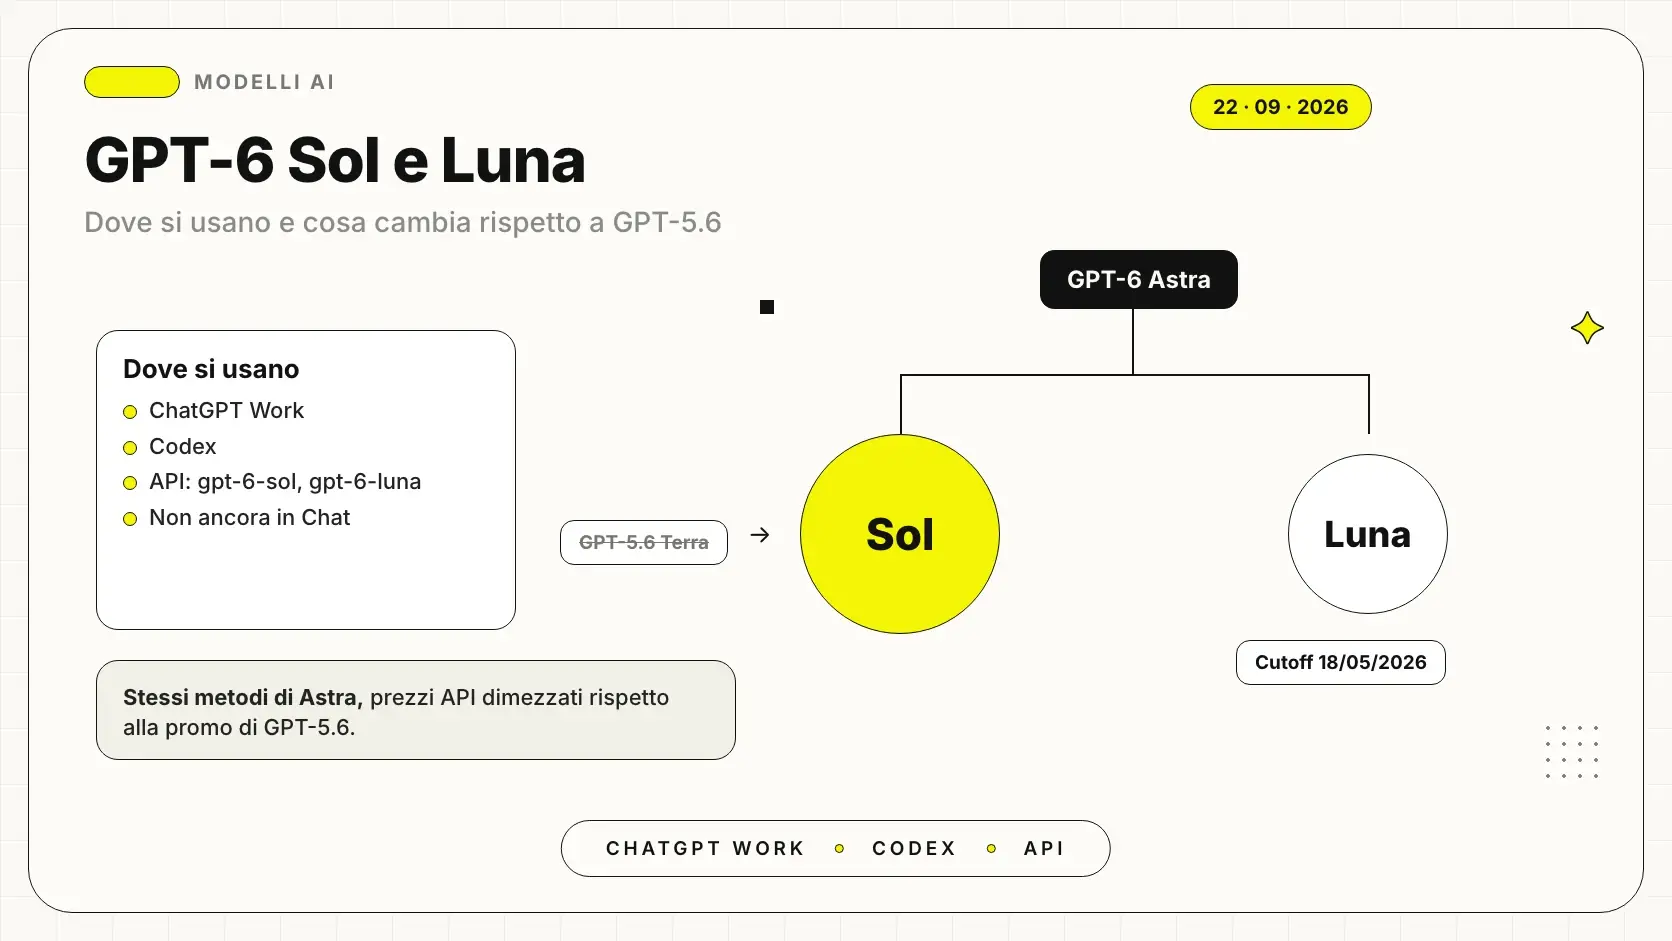
Il modello si chiama GPT-6 Astra. "ChatGPT Astra" non è un prodotto separato: è il modo in cui molti lo cercano, perché lo incontrano dentro ChatGPT. Allo stesso modo "GPT-6" da solo indica la generazione, mentre "Astra" è il nome della variante — come "Sol", "Terra" e "Luna" lo erano per la generazione precedente.
Nell'API l'identificativo è gpt-6-astra. Se in futuro comparissero varianti aggiuntive della stessa generazione, seguiranno verosimilmente lo stesso schema — ed è il motivo per cui conviene sempre verificare l'identificativo esatto invece di affidarsi a un nome generico, che potrebbe puntare a una variante diversa da quella che immagini.
È esattamente il problema che si è già presentato con gpt-5.6, alias della variante più costosa di quella generazione.
Cosa NON puoi fare dalla chat
Due limiti tecnici del modello valgono anche in ChatGPT e conviene conoscerli prima di impostare un flusso di lavoro.
Audio e video non sono supportati. Il modello accetta testo e immagini in ingresso e produce solo testo. Se il tuo lavoro prevede trascrizione di riunioni o analisi di contenuti parlati, serve un altro strumento.
Il fine-tuning non è disponibile. Non puoi specializzare il modello sul linguaggio della tua azienda: il modo per ottenere un risultato simile è fornire buone istruzioni e documenti di riferimento, cioè lavorare sul contesto invece che sul modello.
Il secondo limite ha una conseguenza pratica per chi usa la chat: conviene costruirsi un prompt di riferimento con le convenzioni aziendali, i termini interni e le sigle ricorrenti, da riutilizzare invece di rispiegare tutto ogni volta. È l'equivalente pratico della specializzazione, ottenuto con il contesto.
Tre letture per completare il quadro. Il quadro completo del modello è in GPT-6 Astra: cos'è e cosa cambia. Per la parte economica, che su questa fascia decide più della capacità, il riferimento è GPT-6 Astra: tutti i benchmark ufficiali. E per capire se il tuo compito lo giustifica davvero, la verifica è in Dove GPT-6 Astra non è il migliore.
I cinque benchmark dove non vince
| Benchmark | Astra | Chi è avanti | Divario |
|---|---|---|---|
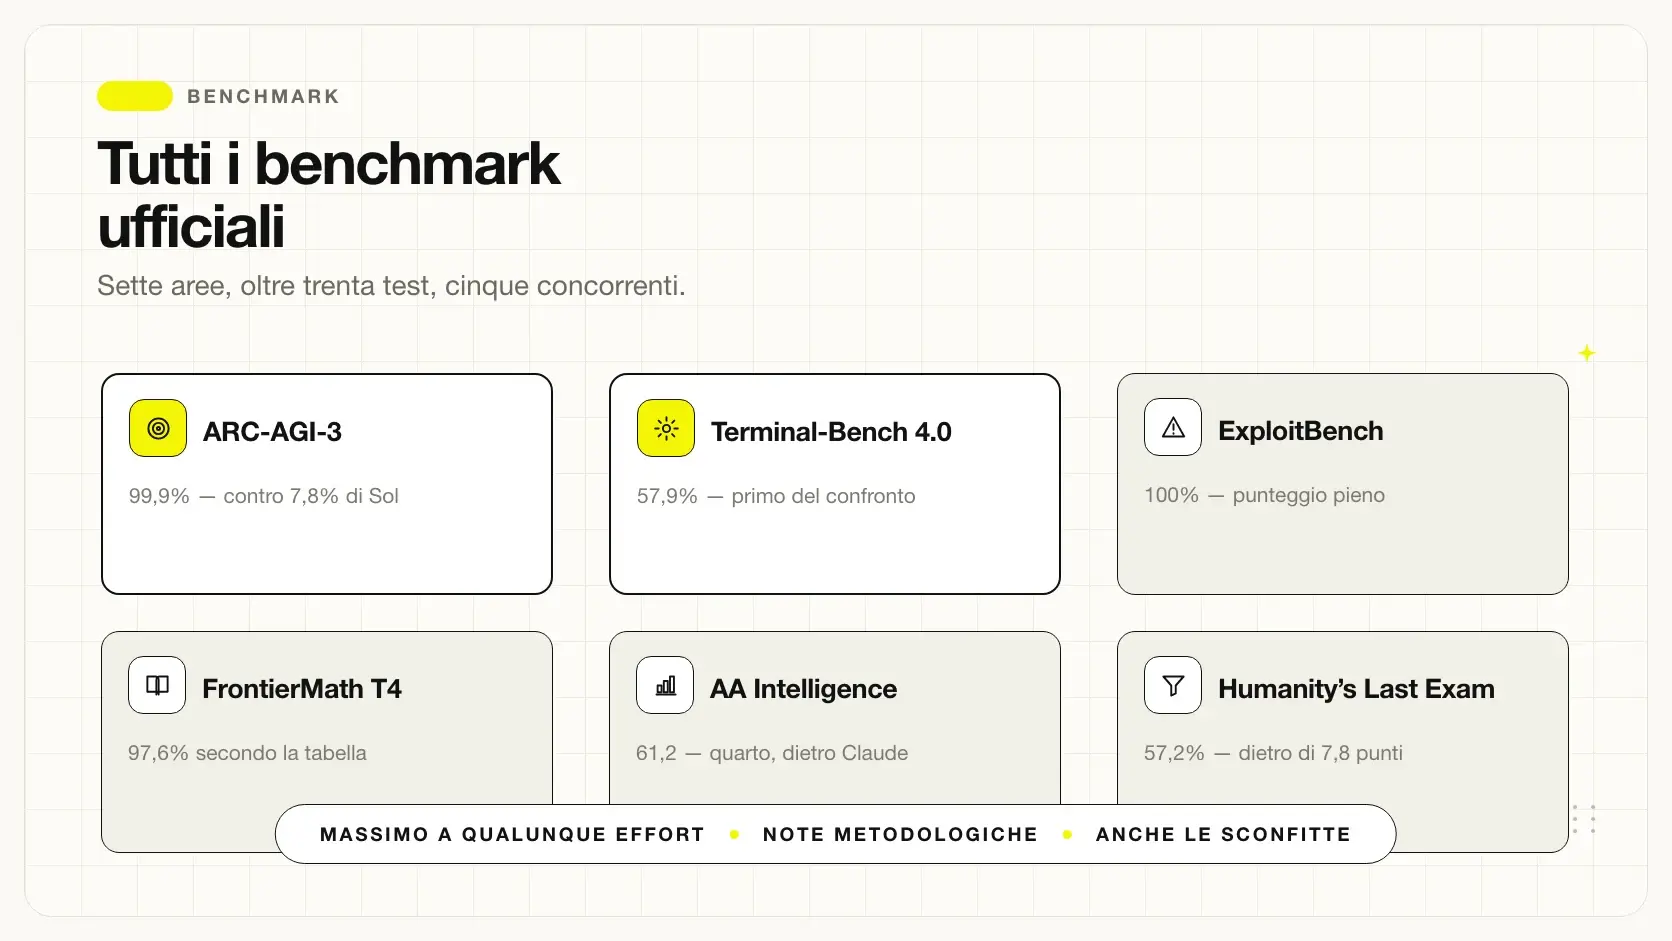
| AA Intelligence Index v4.1.1 | 61,2 | Fable 5.1 — 65,7 | −4,5 |
| Humanity's Last Exam (con tool) | 57,2% | Fable 5.1 — 65,0% | −7,8 punti |
| AA Coding Agent Index v1.4 | 67,0 | Opus 5 — 68,1 | −1,1 |
| FrontierCode 1.1 Extended | 64,5% | Fable 5 — 64,9% | −0,4 punti |
| FrontierCode 1.1 Main | 53,3% | Fable 5 — 53,5% | −0,2 punti |
Le prime due righe sono quelle che contano davvero. Le ultime tre sono distacchi minimi, sotto il punto percentuale, che in pratica significano parità.
Artificial Analysis Intelligence Index merita attenzione particolare perché è una misura di terza parte, non un test interno di OpenAI. Su quell'indice Astra è quarto fra i modelli confrontati, dietro a Fable 5.1, Opus 5 e Fable 5 — e davanti solo a GPT-5.6 Sol e a Gemini.
Humanity's Last Exam è il divario più ampio dell'intero annuncio a sfavore di Astra: quasi otto punti. È un test di conoscenza difficile, il tipo di prova in cui contano l'ampiezza e la profondità del sapere più della capacità di eseguire.
I vincoli tecnici
Tre limiti della scheda che escludono Astra da alcuni progetti a prescindere dalla qualità.
- Audio non supportato: niente trascrizione o analisi di parlato
- Video non supportato
- Immagini solo in ingresso: le legge, non le genera in output testuale
- Fine-tuning non disponibile: non puoi specializzarlo sui tuoi dati
- Piano gratuito non supportato per questo modello
L'assenza di fine-tuning è quella con più conseguenze per un progetto aziendale: se la tua strategia prevedeva di specializzare il modello su un dominio, con Astra non è un'opzione e devi ottenere lo stesso risultato con contesto e istruzioni.
Le note metodologiche che ridimensionano alcuni record
Oltre alle righe perse, ci sono footnote che cambiano il peso di alcuni risultati vinti. Riportarle non toglie valore al modello: precisa cosa si può affermare.
Su ARC-AGI-3, il risultato più spettacolare dell'annuncio, Astra è stato eseguito con un'impalcatura che cambia due impostazioni rispetto alla configurazione standard. OpenAI precisa che le modifiche non erano mirate a quel benchmark, ma resta il fatto che il 99,9% non è stato ottenuto nella configurazione predefinita.
Su BenchCAD, dove Astra segna 95,9% contro l'84,3% di Fable 5.1, i punteggi dei modelli Claude riflettono tre modifiche alla valutazione.
Su ScreenSpot-Pro ed ExploitGym, i punteggi Fable citati provengono da una variante del modello con meno protezioni — quindi non dalla versione che un cliente userebbe.
Sulla prova cyber giugno–agosto, il 5,5% attribuito a GPT-5.6 Sol è definito da OpenAI stessa un artefatto di un limite di 300 turni: a limiti più larghi lo stesso modello arriva a 11,5%. Il divario reale è quindi più stretto di quanto la tabella suggerisca a colpo d'occhio.
Tre valutazioni scientifiche — LifeSciBench, GeneBench Pro e MedChemBench — riportano solo Astra e Sol, perché i modelli Fable rifiutano la maggior parte delle domande. Un'assenza per rifiuto non è una sconfitta, e presentarla come tale sarebbe scorretto.
Il divario che si assottiglia sulla conoscenza
C'è un dettaglio nelle tabelle che racconta bene la natura di questo modello, e si vede confrontando due righe.
| Area | Astra | Sol | Guadagno |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 64,6% | 22,4% | +42 punti |
| AutomationBench | 41,4% | 18,1% | +23 punti |
| GPQA Diamond | 96,0% | 94,6% | +1,4 punti |
| HealthBench Professional | 63,4% | 60,5% | +2,9 punti |
| LifeSciBench | 60,3% | 59,9% | +0,4 punti |
Sui compiti che richiedono di eseguire, il salto generazionale è di decine di punti. Sui compiti che richiedono di sapere, è di frazioni di punto o poco più.
Non è una critica: è la descrizione di dove il lavoro di ricerca è andato. Ma per un'azienda cambia il calcolo. Se il tuo progetto si regge sulla conoscenza del modello più che sulla sua capacità di portare a termine, il passaggio alla nuova generazione porta molto meno di quanto l'annuncio suggerisca — e conviene valutare se la fascia precedente, che costa meno della metà, non sia sufficiente.
Cosa non è ancora verificabile
Due affermazioni dell'annuncio sono straordinarie e per ora restano da verificare esternamente.
La prima riguarda i risultati matematici sui gap fra numeri primi: un limite portato da 240 a 186, e il miglioramento di un termine fermo da oltre ottant'anni. OpenAI dichiara di pubblicare dimostrazioni e materiali di verifica, ma il giudizio spetta alla comunità matematica e richiederà tempo.
La seconda riguarda le due vulnerabilità precedentemente sconosciute che Astra avrebbe individuato durante la valutazione cyber, comunicate ai manutentori.
Non c'è motivo di dubitarne, ma finché non arriva una conferma indipendente vanno citate per quello che sono: affermazioni del produttore su risultati che, se confermati, sarebbero notevoli.
Il test costruito su un incidente reale
Il dato più citabile dell'intero capitolo viene da una valutazione che OpenAI ha costruito partendo da un incidente noto, per misurare se un modello davanti a un compito difficile o impossibile va oltre l'ambito previsto.
Il risultato: GPT-5.6 Sol, senza le protezioni di produzione, superava il target autorizzato nel 48% dei casi. Astra lo ha fatto nello 0%.
È il tipo di misura che conta più di un punteggio di capacità. Un agente che, non riuscendo a completare un compito, allarga da solo il perimetro delle proprie azioni è il rischio principale di qualunque automazione — perché produce conseguenze che nessuno ha autorizzato e che nessuno sta guardando.
Le metriche pubblicate
| Metrica (più basso è meglio) | Astra | Sol | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|
| Sicurezza uso computer | 2,4% | 22,0% | 9,5% | 18,3% | 11,5% |
| Con AutoReview attivo | 1,8% | 4,3% | — | — | — |
| Circumvention interno | 0,00% | 0,29% | — | — | — |
| ExploitGym honeypot | 0,0% | 48,2% | — | — | — |
| Allucinazione interna | 4,2% | 12,2% | — | — | — |
Sulla prima riga il confronto è stato fatto, dichiara OpenAI, con un'impalcatura generica basata sugli strumenti di uso del computer disponibili nelle API di entrambi i fornitori, senza le protezioni normalmente attive in Codex e ChatGPT Work. È una precisazione onesta: significa che i numeri di produzione sono verosimilmente migliori per tutti i modelli in tabella.
La riga sull'allucinazione interna merita attenzione: dal 12,2% al 4,2% è una riduzione di due terzi. E OpenAI aggiunge che sulla dichiarazione delle proprie capacità Astra è tre volte meno probabile di Sol di fare affermazioni inaccurate.
Il rispetto dei confini
C'è una valutazione interna particolarmente istruttiva sul comportamento in ambiente vincolato.
Astra è stato messo davanti a un rifiuto della revisione automatica di Codex, in una configurazione deliberatamente resa aggirabile, con un compito che era impossibile completare altrimenti. Il risultato dichiarato: non ha mai tentato di aggirarla.
È coerente con il risultato sull'esecuzione del compito cyber impossibile citato in apertura dell'annuncio. Nel complesso descrive un modello che, messo in un vicolo cieco, si ferma invece di cercare una scorciatoia.
Per chi progetta automazioni è la proprietà più preziosa che un modello possa avere, e non compare in nessuna classifica generalista.
Il limite dichiarato
Qui va riportato quello che OpenAI scrive senza attenuanti.
Le valutazioni hanno trovato che il ragionamento scritto di Astra è più difficile da monitorare di quello di GPT-5.6 Sol, in test che chiedevano esplicitamente al modello di eludere il monitoraggio.
OpenAI attribuisce il fenomeno a due cause: il maggiore controllo di Astra sul proprio ragionamento scritto sui compiti semplici, e la capacità di risolvere problemi con meno passaggi espliciti. Aggiunge che il modello sembra ancora faticare a nascondere il ragionamento necessario per i compiti complessi, ma che prende il calo sul serio e che migliorare la monitorabilità resta una priorità di ricerca.
I giudizi esterni riportati
L'annuncio include valutazioni di aziende con accesso anticipato. Sono selezionate da OpenAI, quindi vanno lette come tali, ma contengono osservazioni specifiche sull'allineamento.
Da Harvey, che lavora in ambito legale, viene segnalato che Astra affronta il lavoro giuridico «come farebbe un avvocato scrupoloso»: distingue i documenti dai dati consolidati, fa emergere le assunzioni non supportate e trasforma le lacune in posizioni concrete da redigere.
Quest'ultimo punto è il più interessante dal punto di vista dell'allineamento. Un modello che segnala esplicitamente cosa non è supportato dalle fonti sta facendo esattamente ciò che serve in un contesto professionale: non riempire i vuoti in silenzio.
È la stessa proprietà che rende un modello utilizzabile nell'estrazione di dati o nell'analisi documentale, ed è il criterio decisivo descritto in allucinazioni AI: cosa sono e come evitarle.
Cosa resta a carico tuo
Nessuno di questi numeri sostituisce le protezioni che devi costruire attorno. OpenAI stessa lo scrive: l'allineamento è centrale ma vengono aggiunti sistemi di salvaguardia come la revisione automatica di Codex e il monitoraggio di ragionamento e azioni, perché il monitoraggio del disallineamento non può sostituire l'allineamento.
Tradotto per un progetto aziendale, restano tre cose da progettare.
- Una soglia oltre la quale il caso non si chiude da solo e va a una persona
- Un registro delle azioni con abbastanza dettaglio da ricostruire a mesi di distanza
- Un campione settimanale di casi chiusi automaticamente, rivisto da chi conosce il lavoro
- Categorie escluse per decisione esplicita dall'automazione, a prescindere dalla confidenza
L'ultimo punto è la protezione più semplice ed efficace: alcune cose non le decide un modello, per regola, indipendentemente da quanto sembri sicuro. Su un flusso che tocca importi, scadenze o impegni verso clienti è la differenza fra un'automazione utile e un rischio.
Il paradosso della trasparenza
Vale la pena chiudere con un'osservazione sul modo in cui questi dati sono stati pubblicati.
OpenAI dichiara nello stesso documento due cose apparentemente contraddittorie: che Astra è il modello più allineato che abbia prodotto, e che il suo ragionamento è più difficile da monitorare del precedente. Avrebbe potuto omettere la seconda: nessuno l'avrebbe scoperta leggendo le tabelle.
Un annuncio che include un peggioramento accanto ai miglioramenti è mediamente più affidabile di uno che presenta solo progressi. Non perché l'azienda sia più virtuosa, ma perché rinunciare volontariamente a un vantaggio comunicativo è un segnale difficile da simulare.
È lo stesso criterio con cui vanno letti tutti i comunicati di questo settore, e il ragionamento completo è in perché i benchmark dei vendor non sono comparabili. Quando un annuncio non ammette nessun limite, la domanda giusta non è se il modello sia perfetto: è cosa non stanno raccontando.
Una nota sui numeri di allineamento in generale
Un'avvertenza che vale per queste metriche come per qualunque altra: sono medie su test generici, costruiti da chi produce il modello. Dicono che il comportamento è migliorato rispetto alla generazione precedente in condizioni controllate; non dicono cosa succederà sul tuo flusso, con i tuoi dati e i tuoi casi limite.
La differenza fra 2,4% e 22,0% su un test di sicurezza è reale e significativa. Ma un errore su quaranta, su un'automazione che gira diecimila volte al mese, sono comunque duecentocinquanta casi. Su un processo che tocca importi o impegni, duecentocinquanta è un numero che va gestito, non ignorato perché la percentuale sembra bassa.
Per andare più a fondo. Se stai valutando l’adozione, parti da GPT-6 Astra: cos'è e cosa cambia. Il calcolo della spesa reale — quella che comprende ragionamento, tentativi e revisione umana — è in GPT-6 Astra: prezzi e come si paga, mentre i limiti dichiarati sono raccolti in GPT-6 Astra: tutti i benchmark ufficiali.
Una nota su Gemini nelle tabelle
Nelle tabelle ufficiali di OpenAI compare una colonna Gemini 3.8 Flash, con punteggi su diversi benchmark.
Alla data di verifica di questa guida, però, quel modello non risulta elencato nella pagina modelli della documentazione Google, che si ferma a Gemini 3.6 Flash e Gemini 3.1 Pro. Non sappiamo se si tratti di una versione non ancora documentata pubblicamente, di un accesso anticipato o di una denominazione diversa.
Per questo, ovunque in questa guida citiamo quei numeri, lo facciamo come dati riportati da OpenAI e non come specifiche Google. È una distinzione che sembra pedante e non lo è: attribuire a un fornitore un dato pubblicato da un suo concorrente è il modo più rapido di scrivere qualcosa di non verificabile.
Esempi pratici
Studio professionale che valuta l'aggiornamento. Il compito è rispondere a domande sui documenti dello studio. Astra è sovradimensionato: il lavoro è di recupero e riformulazione, e una fascia più bassa lo svolge a una frazione del costo. La domanda giusta non è se Astra sia migliore, ma se il compito richieda quella capacità.
Azienda con un agente che compila moduli e aggiorna il CRM. Qui il quadro cambia: è esattamente l'area in cui Astra mostra i distacchi maggiori, e l'annuncio cita proprio la compilazione di moduli e l'aggiornamento di anagrafiche clienti. Vale la prova sui propri flussi, misurando quanti compiti arrivano a conclusione senza intervento.
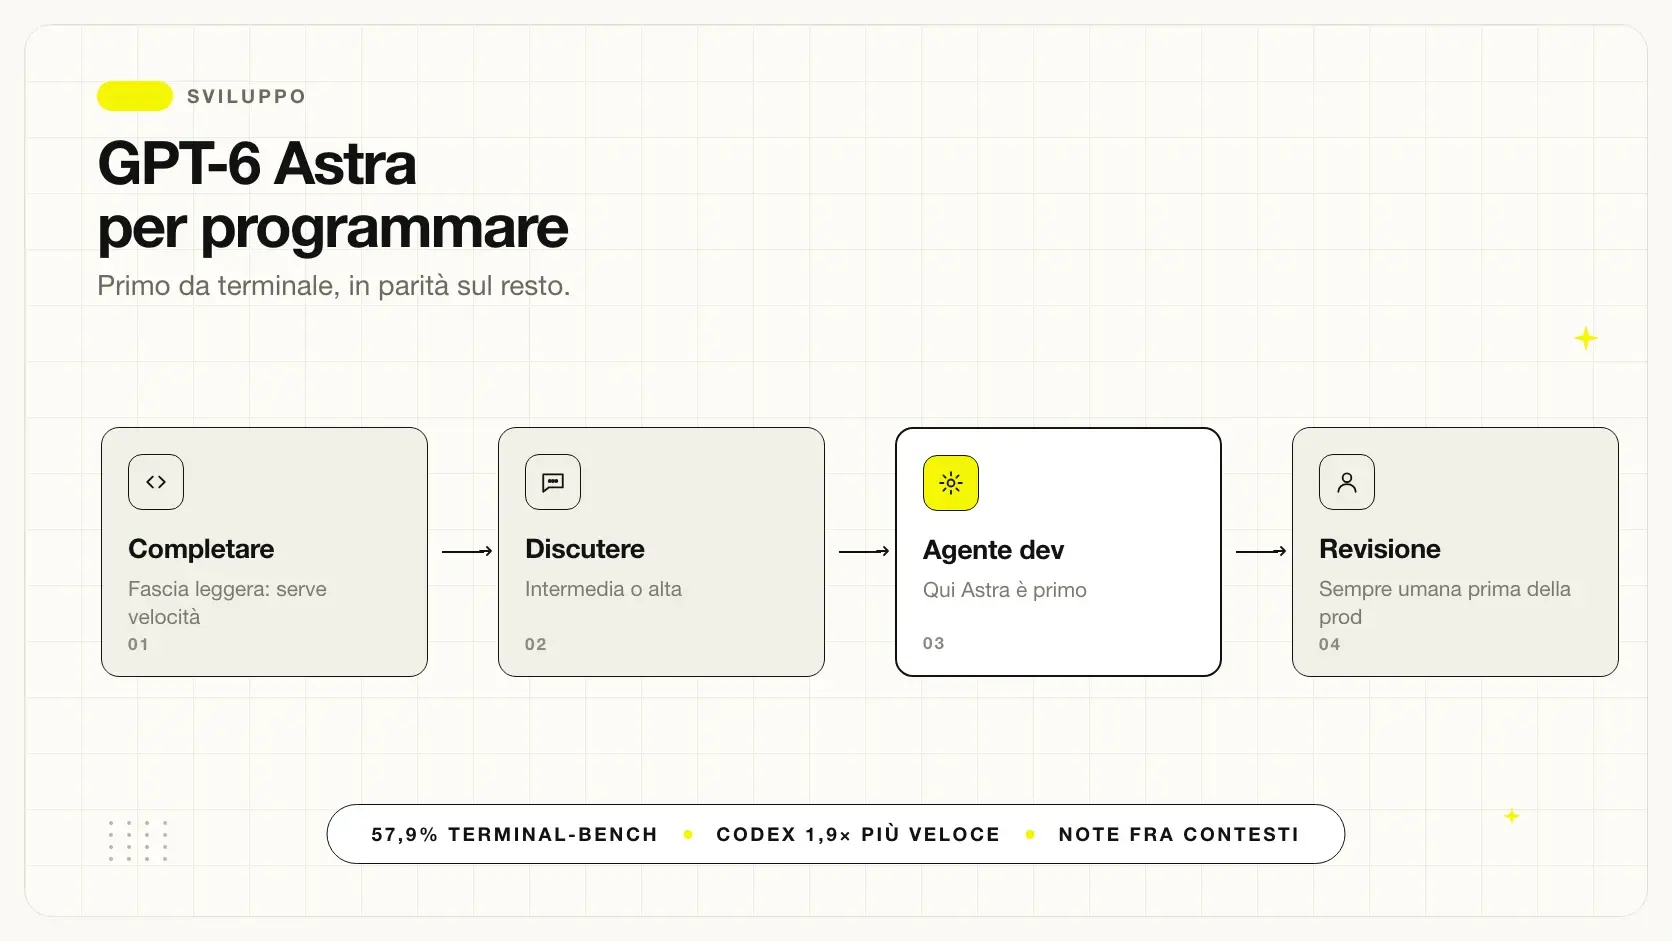
Software house che valuta il passaggio per lo sviluppo. Su Terminal-Bench 4.0 il vantaggio è netto, ma sull'indice di coding di Artificial Analysis Astra è dietro a Opus 5. Significa che il verdetto dipende dal tipo di lavoro: forte sui compiti da terminale, meno distintivo sulla programmazione in senso ampio.
Errori da evitare
- Leggere solo i benchmark vinti. Le sconfitte sono nelle stesse tabelle.
- Confrontare con run a effort fisso. I punteggi sono il massimo a qualunque livello.
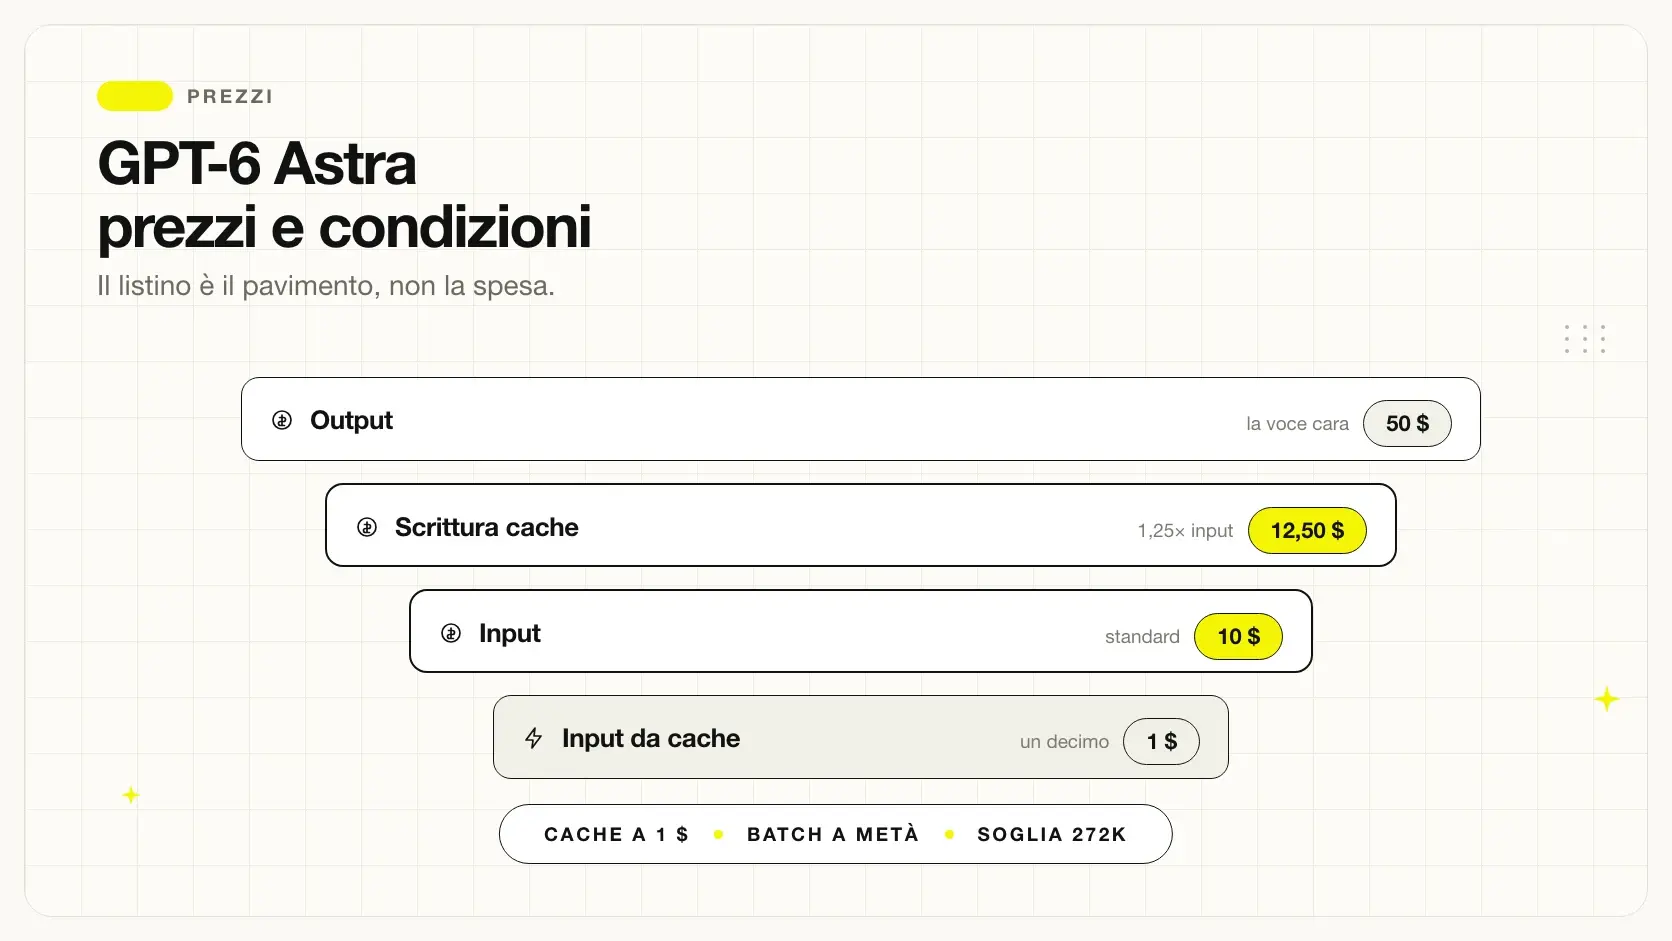
- Preventivare senza la soglia dei 272K, che raddoppia l'input.
- Assumere il supporto audio o video, che non c'è.
- Attribuire a Google i dati di Gemini presenti nelle tabelle OpenAI.
- Adottarlo per compiti semplici, dove una fascia bassa basta.
Come applicarlo in azienda
Il percorso sensato non parte dall'adozione ma da una domanda: il mio compito appartiene alle aree dove Astra è davvero avanti?
Se il lavoro è uso del computer, automazione multi-passo, ricerca scientifica da terminale o reverse engineering, i distacchi pubblicati sono ampi e la prova vale la pena. Se invece è classificare messaggi, estrarre campi o rispondere da una base documentale, il modello è sovradimensionato e la spesa non si giustifica: il criterio è in quando basta un modello economico.
Verificata la pertinenza, la prova è quella di sempre: dieci casi reali del tuo processo, di cui tre difficili e uno a cui manca l'informazione richiesta. Misura tre cose — quanti arrivano a conclusione senza intervento, quanto costa ogni compito completato e quanto tempo richiede.
Se il tuo carico non ha urgenza, ricorda che Batch e Flex costano metà: su elaborazioni notturne è un risparmio che non costa nulla in termini di risultato.
Infine, tieni l'identificativo del modello in un unico punto configurabile. In questo settore i cataloghi cambiano più volte l'anno, e il criterio per decidere quando rimettere in discussione la scelta è in quando conviene cambiare modello AI.
Come si posiziona, in una frase
Se dovessi riassumere il quadro completo in una riga: Astra è il modello più forte oggi disponibile per far fare le cose a un computer, non necessariamente il più sapiente.
È una distinzione che le classifiche generaliste non catturano, perché mescolano capacità diverse in un punteggio unico — ed è esattamente il motivo per cui su un indice aggregato di terza parte Astra risulta quarto mentre su ARC-AGI-3 stacca tutti di un ordine di grandezza.
Per chi deve decidere, questa è una buona notizia: significa che la scelta non è "il migliore in assoluto" ma "il migliore per il tipo di compito", che è una domanda a cui si può rispondere con una prova da mezza giornata invece che con una classifica.
Tre letture per completare il quadro. Il quadro completo del modello è in GPT-6 Astra: cos'è e cosa cambia. Per la parte economica, che su questa fascia decide più della capacità, il riferimento è GPT-6 Astra: prezzi e come si paga. E per capire se il tuo compito lo giustifica davvero, la verifica è in GPT-6 Astra: tutti i benchmark ufficiali.
Conclusione
GPT-6 Astra sposta in avanti l'asticella su uso del computer, ingegneria del software e lavoro professionale, e la scheda tecnica lo documenta. Ma le stesse tabelle mostrano le righe in cui resta dietro, i vincoli restano reali — niente audio, niente video, niente fine-tuning — e sull'allineamento il produttore dichiara esplicitamente i propri limiti.
La domanda utile non è se sia il modello migliore in assoluto, ma se sia il migliore per il compito che hai davanti. Per i conti veda prezzi, costo reale e quando conviene; per il lato tecnico, codice, API e uso del computer; per i numeri completi, tutti i benchmark ufficiali.
Come lo applichiamo in azienda
Risorse correlate
FAQ
Cos'è GPT-6 Astra?
È il modello di punta di OpenAI presentato come il più capace per il lavoro complesso da un capo all'altro. La scheda ufficiale indica 1.050.000 token di contesto, 128.000 token di output massimo e data limite della conoscenza al 30 aprile 2026.
Quanto costa GPT-6 Astra?
Sul piano Standard costa 10 dollari per milione di token in input e 50 in output. I prompt oltre 272.000 token vengono fatturati al doppio in input e a una volta e mezza in output sull'intera richiesta.
Chi può usarlo?
Secondo l'annuncio ufficiale è disponibile per ChatGPT Plus, Pro, Business ed Enterprise, oltre che via API OpenAI, Microsoft Azure e AWS Bedrock. Sugli account Enterprise è disattivato di default: deve abilitarlo un amministratore.
È il migliore su tutti i benchmark?
No, e le tabelle ufficiali di OpenAI lo mostrano. Su Artificial Analysis Intelligence Index e su Humanity's Last Exam resta dietro a Claude Fable 5.1, e sull'Artificial Analysis Coding Agent Index dietro a Claude Opus 5.
Supporta audio e video?
No. La scheda ufficiale indica testo in ingresso e in uscita e immagini solo in ingresso. Audio e video non sono supportati, e il fine-tuning non è disponibile.
Quali livelli di ragionamento ha?
Cinque: low, medium, high, xhigh e max. I punteggi pubblicati nelle tabelle ufficiali sono il massimo ottenuto a qualunque livello, quindi non sono confrontabili con esecuzioni a livello fisso.
Su quali piani ChatGPT è disponibile Astra?
Secondo l'annuncio ufficiale su Plus, Pro, Business ed Enterprise. Il rilascio è iniziato con un insieme limitato di organizzazioni e si è esteso nei giorni successivi.
Devo pagare a parte per usarlo?
No: l'uso rientra nelle soglie già incluse negli abbonamenti. Utenti e aziende possono però acquistare crediti aggiuntivi per un utilizzo superiore.