
GPT-6 Astra: tutti i benchmark ufficiali
I benchmark di GPT-6 Astra dalle tabelle ufficiali OpenAI: ragionamento, coding, scienza, cybersecurity, e le note metodologiche da leggere.
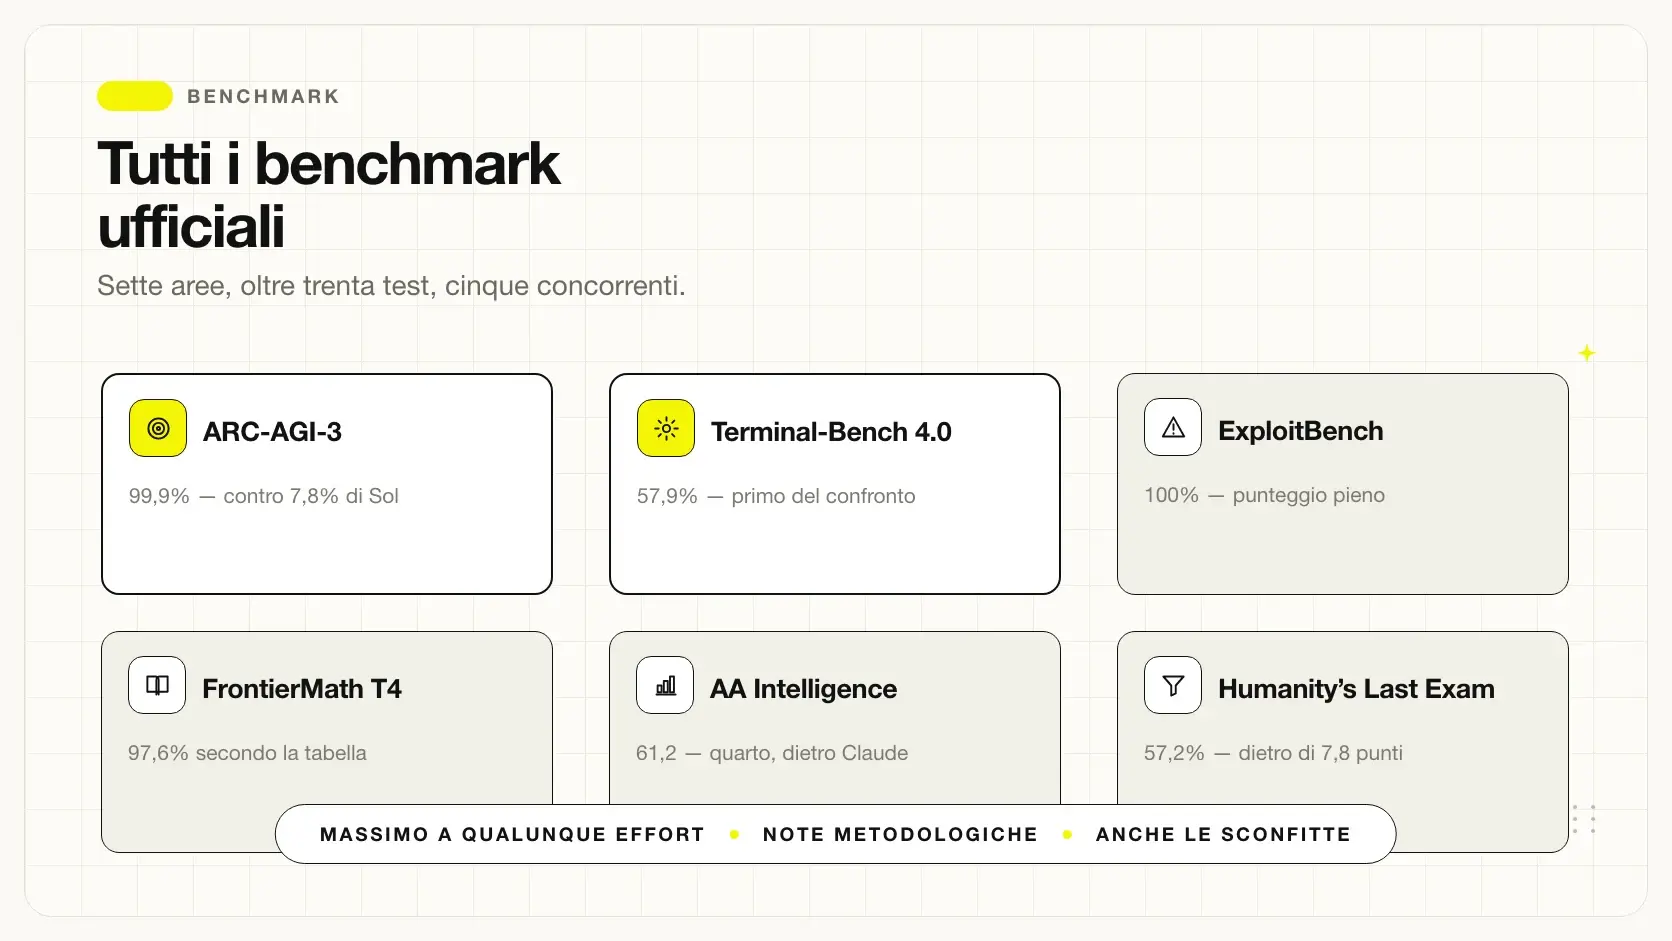
Tutti i benchmark di GPT-6 Astra, presi dalle tabelle ufficiali di OpenAI: ragionamento astratto, uso del computer, lavoro professionale, coding, scienza e matematica, cybersecurity, contesto lungo e allineamento.
Inclusi i test che non vince e le note metodologiche che ridimensionano alcuni record — perché sono nelle stesse tabelle, e quasi nessuno le riporta. Dati verificati il 4 settembre 2026.
In sintesi
- I punteggi pubblicati sono il massimo a qualunque livello di ragionamento.
- Su Intelligence Index e Humanity's Last Exam resta dietro a Fable 5.1.
- Sul Coding Agent Index resta dietro a Opus 5.
- Su ARC-AGI il salto è di natura diversa dagli altri test.
- Alcuni risultati scientifici non sono verificati da terzi.
- Sulla cybersecurity la soglia Critical ha conseguenze operative.
Ragionamento astratto
| Benchmark | Astra | GPT-5.6 Sol | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|
| ARC-AGI-3 | 99,9% | 7,8% | — | — | 30,2% |
| ARC-AGI-2 | 95,0% | 92,5% | 90,0% | 89,2% | 90,4% |
| ARC-AGI-1 | 98,5% | 97,5% | 97,5% | 98,5% | 97,5% |
Il salto su ARC-AGI-3 è il risultato più impressionante dell'intero annuncio: da 7,8% del modello precedente a 99,9%. La ARC Prize Foundation, citata da OpenAI, afferma che Astra ha superato la loro linea di riferimento umana per efficienza d'azione sul 96% dei livelli.
Va però letta la nota: su questo test Astra è stato eseguito con un'impalcatura che cambia due impostazioni rispetto alla configurazione standard. OpenAI precisa che le modifiche non erano mirate a quel benchmark. Il quadro completo è in GPT-6 Astra e ARC-AGI-3.
Sulle versioni precedenti del test i distacchi si riducono a pochi punti, e su ARC-AGI-1 Fable 5 pareggia esattamente Astra.
Uso del computer
| Benchmark | Astra | Sol | Fable 5 | Opus 5 |
|---|---|---|---|---|
| Agents' Last Exam | 59,3% | 53,6% | 48,7% | 55,5% |
| OSWorld 2.0 | 72,6% | 65,7% | — | 70,2% |
| ScreenSpot-Pro (senza tool) | 92,7% | 76,9% | 87,3% | — |
Qui il primato è netto ma i margini sono più stretti di quanto la comunicazione suggerisca: su Agents' Last Exam la distanza da Opus 5 è di 3,8 punti, su OSWorld 2.0 di 2,4 punti.
Il dato più utile è però quello di efficienza: su Agents' Last Exam OpenAI dichiara circa il 65% di token di output in meno rispetto a Opus 5 alle impostazioni di punteggio massimo. Su un modello con l'output a 50 dollari per milione di token, è una differenza che conta quanto il punteggio.
Lavoro professionale
| Benchmark | Astra | Sol | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|
| AutomationBench | 41,4% | 18,1% | 31,4% | 17,4% | 26,9% |
| BenchCAD | 95,9% | 83,3% | 84,3% | 67,5% | 82,1% |
| BrowseComp | 91,5% | 90,4% | — | 87,4% | 90,8% |
| OpenScore String Quartets | 0,84 | 0,19 | — | — | — |
| Design Tasks (interno) | 50,0% | 47,4% | — | 35,8% | — |
| Data Science Tasks (interno) | 40,9% | 30,5% | — | 34,7% | — |
| AA Intelligence Index v4.1.1 | 61,2 | 60,9 | 65,7 | 62,1 | 63,1 |
L'ultima riga è la più interessante e la meno citata: sull'Artificial Analysis Intelligence Index, che è una misura di terza parte e non un test interno, Astra è quarto fra i modelli confrontati, dietro a Fable 5.1, Opus 5 e Fable 5.
Su BenchCAD va letta la nota: i punteggi dei modelli Claude riflettono tre modifiche alla valutazione, dettagliate nella scheda di sistema di Fable 5.1.
Coding
| Benchmark | Astra | Sol | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57,9% | 37,3% | 55,8% | 44,5% | 52,6% |
| DeepSWE v1.1 | 74,1% | 72,7% | 67,4% | 69,9% | 73,7% |
| FrontierCode 1.1 Extended | 64,5% | 60,6% | 63,6% | 64,9% | 63,6% |
| FrontierCode 1.1 Main | 53,3% | 47,5% | 50,9% | 53,5% | 53,4% |
| DB Migration (interno) | 63,9% | 42,7% | 57,8% | 50,3% | — |
| AA Coding Agent Index v1.4 | 67,0 | 65,1 | — | 67,2 | 68,1 |
Il quadro sul coding è più sfumato di quanto l'annuncio lasci intendere. Astra vince nettamente su Terminal-Bench 4.0 e sulle migrazioni di database interne, ma su FrontierCode — sia Extended sia Main — Fable 5 è avanti di frazioni di punto, e sull'indice di coding di Artificial Analysis Opus 5 è primo.
Su FrontierCode va segnalata una nota: Astra è stato eseguito con un messaggio di sistema simile a quello usato in Codex, che chiede di evitare file di test superflui e di seguire le convenzioni del repository. OpenAI precisa che il prompt non era ottimizzato per quel test.
Scienza, matematica e salute
| Benchmark | Astra | Sol | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|
| Terminal-Bench Science 0.1 | 64,6% | 22,4% | 52,6% | 21,4% | 30,0% |
| FrontierMath Tier 4 (v2) | 97,6% | 83,0% | 87,8% | 90,2% | 73,2% |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 92,6% | 93,7% |
| Humanity's Last Exam (con tool) | 57,2% | — | 65,0% | 63,8% | 63,6% |
| HealthBench Professional | 63,4% | 60,5% | 58,1% | 60,9% | 56,4% |
Su Humanity's Last Exam il divario è ampio e a sfavore: 57,2% contro il 65,0% di Fable 5.1, quasi otto punti. È il risultato più lontano dal racconto generale dell'annuncio, e OpenAI lo pubblica nella stessa tabella.
Da notare anche una discrepanza interna: l'introduzione parla di un 98% su FrontierMath Tier 4, mentre la tabella riporta 97,6%. Il valore strutturato è quello della tabella.
Tre valutazioni scientifiche — LifeSciBench, GeneBench Pro e MedChemBench — riportano solo Astra e Sol. La nota spiega perché: i modelli Fable rifiutano la maggior parte delle domande di quelle prove.
Cybersecurity
| Benchmark | Astra | Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| ExploitBench | 100,0% | 78,5% | — | 70% |
| ExploitGym | 42,4% | 30,3% | 30,4% | 22,0% |
| ExploitBench (giu–ago 2026) | 39,0% | 5,5% | — | — |
| SRE-Bench | 88,0% | 55,9% | — | 12,5% |
| SEC-Bench Pro | 85,4% | 79,1% | — | — |
Il 100% su ExploitBench e l'88% su SRE-Bench contro il 12,5% di Opus 5 sono i distacchi più ampi dell'intero annuncio. OpenAI dichiara che durante la valutazione Astra ha individuato e usato due vulnerabilità precedentemente sconosciute, comunicate ai manutentori.
Due note importanti. Il 5,5% di Sol sulla prova giugno–agosto è definito da OpenAI un artefatto di un limite di 300 turni: a limiti più larghi lo stesso modello fa 11,5%. E su ExploitGym i punteggi Fable citati provengono da una variante con meno protezioni.
Il quadro completo, comprese le implicazioni per l'uso in azienda, è in GPT-6 Astra e la cybersecurity.
Contesto lungo e allineamento
| Benchmark | Astra | Sol |
|---|---|---|
| MRCR v2 8-needle 256K–512K | 100,0% | 91,5% |
| MRCR v2 8-needle 512K–1M | 96,3% | 73,8% |
| Sicurezza uso computer (più basso è meglio) | 2,4% | 22,0% |
| Circumvention (più basso è meglio) | 0,00% | 0,29% |
| Allucinazione interna (più basso è meglio) | 4,2% | 12,2% |
Il recupero di informazioni su contesti oltre il mezzo milione di token è l'area con il miglioramento più regolare rispetto alla generazione precedente. Sulle metriche di allineamento, dove più basso è meglio, i valori di Astra sono da tre a dieci volte migliori.
I numeri, su tutte le versioni
| Versione | Astra | GPT-5.6 Sol | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|
| ARC-AGI-3 | 99,9% | 7,8% | — | — | 30,2% |
| ARC-AGI-2 | 95,0% | 92,5% | 90,0% | 89,2% | 90,4% |
| ARC-AGI-1 | 98,5% | 97,5% | 97,5% | 98,5% | 97,5% |
Questa tabella dice più della singola riga citata ovunque.
Su ARC-AGI-3, la versione più recente e difficile, il distacco è enorme. Ma su ARC-AGI-2 il vantaggio su Opus 5 è di 4,6 punti, e su ARC-AGI-1 c'è parità esatta con Fable 5.
La spiegazione è nella natura del test: ogni versione viene resa più difficile proprio quando i modelli iniziano a saturare la precedente. ARC-AGI-1 e 2 sono ormai vicine al massimo per tutti i modelli di punta, quindi non distinguono più. ARC-AGI-3 è la prova che ancora distingue — e lì il divario è netto.
Cosa dice la fonte esterna
Il commento più significativo non viene da OpenAI ma dalla ARC Prize Foundation, che gestisce il benchmark. Greg Kamradt, citato nell'annuncio, afferma che su ARC-AGI-3 Astra ha superato la loro linea di riferimento umana per efficienza d'azione sul 96% dei livelli, raggiungendo di fatto la parità umana sul benchmark.
Aggiunge che non si tratta solo del miglior modello mai testato, ma di un cambio di passo nelle prestazioni dei modelli di frontiera — non solo nella capacità di navigare e risolvere ambienti nuovi, ma anche nell'efficienza con cui impara a farlo.
È una dichiarazione di terza parte, il che la rende più solida di un'autovalutazione. Vale però la pena notare la formulazione precisa: parla di efficienza d'azione, cioè di quante mosse servono per risolvere, non solo di quanti problemi vengono risolti.
La nota metodologica
Nelle footnote OpenAI dichiara che su ARC-AGI-3 Astra è stato eseguito con la propria impalcatura basata sull'API Responses, che cambia due impostazioni per avvicinarsi meglio alle prestazioni del mondo reale. Precisa che le modifiche non erano mirate specificamente a quel benchmark.
Non è una squalifica del risultato: è un'informazione che cambia cosa si può affermare. Il 99,9% non è stato ottenuto nella configurazione predefinita, quindi non è direttamente confrontabile con punteggi di altri modelli eseguiti senza modifiche analoghe.
È lo stesso problema dell'impalcatura che rende fragili quasi tutti i confronti fra fornitori, descritto in perché i benchmark dei vendor non sono comparabili.
Perché questo salto è diverso dagli altri
Su quasi tutti i benchmark i progressi arrivano per gradi: qualche punto per generazione, con curve che si appiattiscono man mano che il test satura. Qui è successo qualcosa di diverso — da 7,8% a 99,9% in un passaggio — e vale la pena chiedersi perché.
L'ipotesi più semplice è che ARC-AGI-3 misuri una capacità a soglia invece che continua. Un modello o riesce a derivare la regola da pochi esempi, oppure no; non c'è un modo di riuscirci a metà. Quando quella capacità si sblocca, il punteggio non sale del dieci per cento: salta.
Se l'ipotesi regge, spiega anche perché su ARC-AGI-1 e 2 i modelli sono tutti raggruppati in alto: quelle versioni sono già sotto la soglia per tutti, e distinguono solo sul margine.
I numeri
| Benchmark | Astra | Sol | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|
| FrontierMath Tier 4 (v2) | 97,6% | 83,0% | 87,8% | 90,2% | 73,2% |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 92,6% | 93,7% |
| Terminal-Bench Science 0.1 | 64,6% | 22,4% | 52,6% | 21,4% | 30,0% |
| Humanity's Last Exam (tool) | 57,2% | — | 65,0% | 63,8% | 63,6% |
| HealthBench Professional | 63,4% | 60,5% | 58,1% | 60,9% | 56,4% |
| LifeSciBench | 60,3% | 59,9% | — | — | — |
| GeneBench Pro | 37,1% | 32,3% | — | — | — |
| MedChemBench (interno) | 49,3% | 47,4% | — | — | — |
Tre osservazioni che cambiano la lettura.
Il distacco enorme è su Terminal-Bench Science, non sulla conoscenza pura: 42 punti sulla generazione precedente e 34,6 su Opus 5. Quel test misura se un agente sa completare flussi di ricerca scientifica usando codice e strumenti da terminale — analizzare dati, eseguire simulazioni, adattare modelli.
Sulla conoscenza i guadagni sono piccoli. GPQA Diamond migliora di 1,4 punti sulla generazione precedente, LifeSciBench di 0,4, MedChemBench di 1,9.
Su Humanity's Last Exam Astra perde, e di parecchio: 57,2% contro il 65,0% di Fable 5.1.
I risultati sui numeri primi
Qui l'annuncio esce dal territorio dei benchmark e dichiara due contributi a problemi aperti.
Il primo riguarda quanto vicini possano stare i numeri primi lungo la retta numerica. Per oltre un decennio il miglior risultato noto stabiliva che esistono infinite coppie di primi a distanza al massimo 246. Un lavoro recente aveva portato quel limite a 240. Secondo OpenAI, Astra ha contribuito a stabilire un limite più stretto: 186.
Il secondo riguarda i gap insolitamente grandi fra primi, dove il modello avrebbe migliorato un termine in un limite rimasto invariato per oltre ottant'anni.
OpenAI dichiara di condividere le dimostrazioni, una catena di ragionamento abbreviata e i materiali di verifica per entrambi i risultati.
Vanno trattati per quello che sono: affermazioni straordinarie in attesa di verifica. Il loro valore dipende dal giudizio della comunità matematica, che richiederà tempo. Ma se reggono, dicono qualcosa che nessun benchmark può dire — cioè che il modello ha contribuito a produrre conoscenza nuova, non solo a risolvere prove costruite per misurarlo.
Il lavoro scientifico pratico
Al di là dei problemi aperti, l'annuncio descrive un uso più ordinario e più trasferibile: combinare ragionamento scientifico e uso del computer per lavorare dentro il software specialistico.
Gli esempi citati riguardano l'ispezione della qualità di sequenziamento genetico e la visualizzazione di variazioni genetiche, con il modello che naviga gli strumenti per aiutare i ricercatori a valutare i dati e decidere dove concentrare l'analisi successiva.
È lo stesso schema visto altrove: il valore non sta nel sapere ma nell'operare dentro strumenti esistenti. E vale anche fuori dalla ricerca, perché molti laboratori e aziende usano software verticali senza API comode.
L'esclusione di Claude da tre test
Nelle righe di LifeSciBench, GeneBench Pro e MedChemBench compaiono solo Astra e Sol. La nota ufficiale spiega perché: i modelli Fable 5 e 5.1 sono esclusi perché rifiutano la maggior parte delle domande di quelle valutazioni.
Va detto con chiarezza che non è una sconfitta. È una scelta di comportamento del modello, che per ragioni di sicurezza declina domande in ambito biologico e chimico avanzato.
Per un'azienda che lavora in quei domini è però un'informazione operativa importante: un modello che rifiuta è un flusso che si ferma. Va verificato sul proprio dominio prima di scegliere, non dopo.
La discrepanza fra introduzione e tabella
Un dettaglio che vale la pena segnalare, perché mostra come si formano le imprecisioni che poi circolano ovunque.
L'introduzione dell'annuncio afferma che Astra satura FrontierMath Tier 4 con un punteggio del 98%. La tabella dei risultati, più in basso nella stessa pagina, riporta 97,6%.
Non è un errore grave — è un arrotondamento — ma è il tipo di scarto che si propaga: chi riassume l'annuncio prende il numero dell'introduzione, chi riassume il riassunto lo arrotonda ancora, e dopo tre passaggi circola un dato che nessuno ha verificato.
La regola pratica per chiunque scriva di questi temi: quando esiste una tabella, usa la tabella. È il dato strutturato, mentre l'introduzione è testo divulgativo.
Il valore dei risultati non verificati
Torniamo un momento sui due contributi matematici, perché richiedono una cautela particolare.
Sono affermazioni verificabili in linea di principio — OpenAI dichiara di pubblicare le dimostrazioni — ma la verifica di un risultato di teoria dei numeri non è immediata: richiede che matematici competenti leggano la dimostrazione e la controllino passo per passo. È un processo che dura mesi, non giorni.
Nel frattempo la cosa corretta è citarli come affermazioni del produttore su risultati sottoposti a verifica, esattamente come si farebbe con un preprint non ancora sottoposto a revisione.
Se venissero confermati, però, cambierebbero il modo di valutare questi modelli. Un punteggio su un benchmark, per quanto alto, misura la capacità di risolvere problemi che qualcuno ha già risolto per costruire il test. Un contributo a un problema aperto no: lì la risposta non esisteva prima.
È la differenza fra dimostrare di saper fare e fare qualcosa di nuovo — e finora nessun modello aveva potuto rivendicarla in modo così esplicito.
Il commento di EpochAI
Fra le voci esterne citate nell'annuncio ce n'è una particolarmente sintetica, di Greg Burnham di EpochAI, organizzazione che si occupa di misurare i progressi dell'AI: «la storia è: fine di un'era, inizio di un'altra».
È una frase da comunicato e va presa come tale. Ma viene da un contesto che ha una posizione riconosciuta nel misurare questi progressi, e il fatto che sia stata scelta per accompagnare il capitolo scientifico dice qual è la lettura che OpenAI propone: non un miglioramento incrementale ma un cambio di fase.
Il risultato più vicino a questa affermazione, nelle stesse tabelle, è quello su GPT-6 Astra e ARC-AGI-3. Se la previsione sia corretta lo diranno i mesi successivi e le verifiche indipendenti. Per ora è una previsione, non un dato — e come tutte le previsioni di questo settore va archiviata e riletta fra sei mesi.
Un promemoria sul cutoff
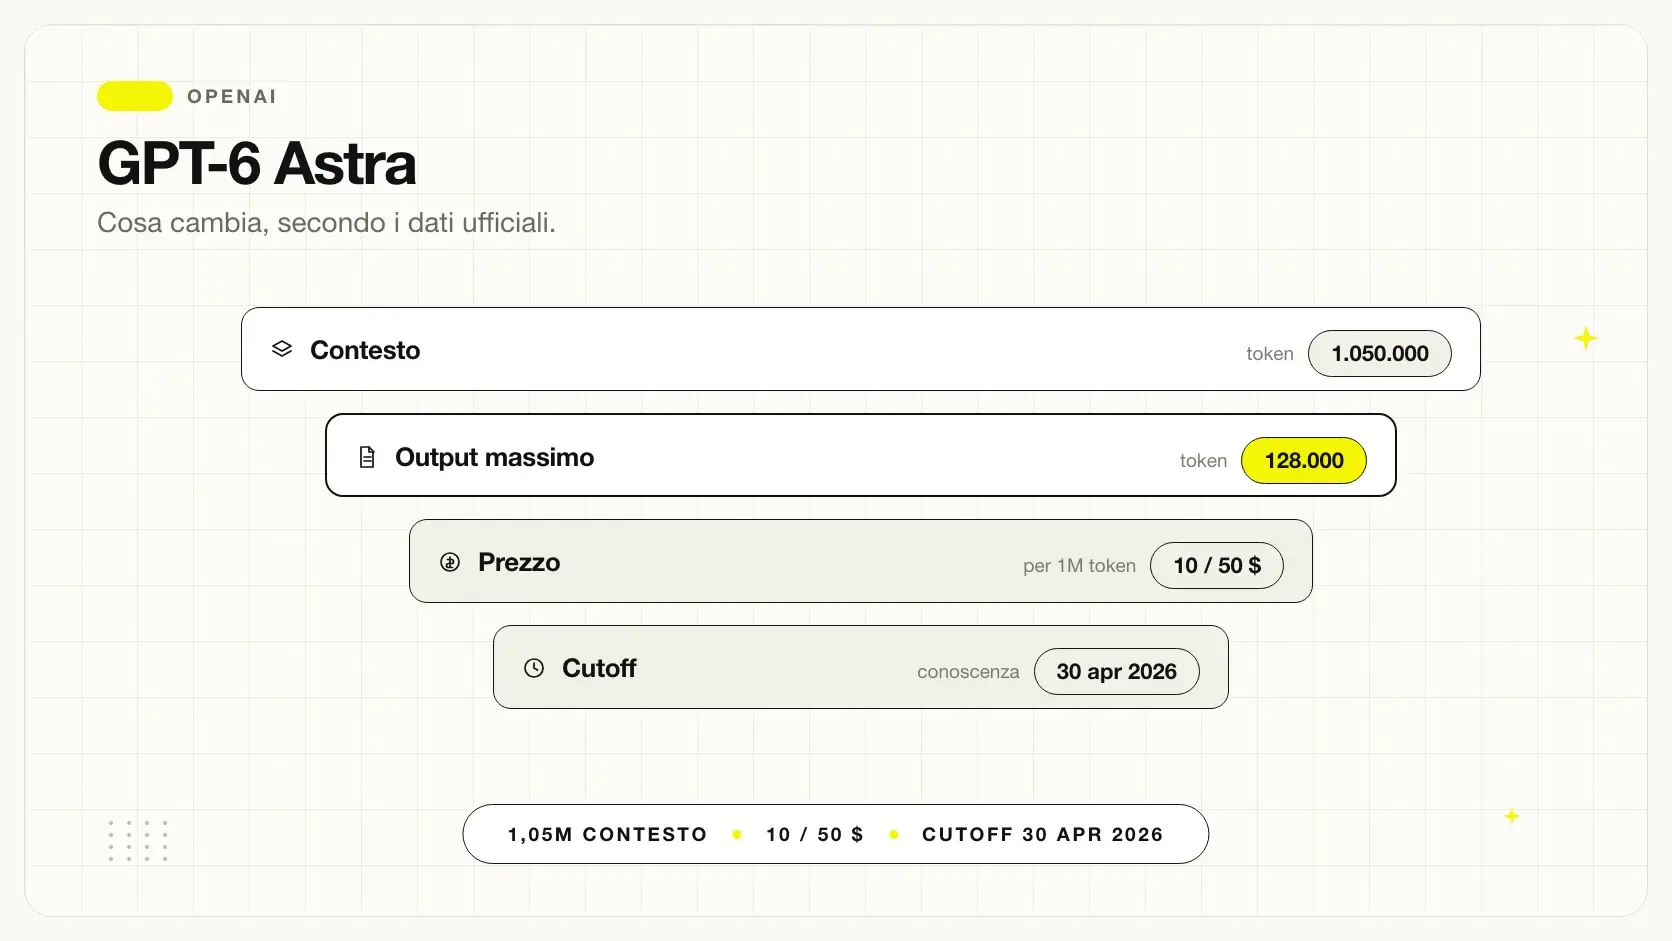
Un ultimo elemento pratico per chi usa questi modelli in ambito tecnico o scientifico: la data limite della conoscenza di Astra è il 30 aprile 2026.
Significa che su normativa, linee guida, pubblicazioni o standard aggiornati dopo quella data il modello non sa nulla da solo — e nei domini regolamentati questo è esattamente il tipo di informazione che cambia più spesso.
L'impostazione corretta resta quella di sempre: fornire tu i documenti aggiornati, chiedere la citazione della fonte per ogni affermazione e istruire il modello a dichiarare quando l'informazione non è presente. Con quella struttura il cutoff smette di essere un problema, e le risposte diventano verificabili da chiunque.
Tre riferimenti collegati. La panoramica generale è in GPT-6 Astra: cos'è e cosa cambia, i costi reali in GPT-6 Astra: prezzi e come si paga, e la valutazione per caso d’uso aziendale in GPT-6 Astra: tutti i benchmark ufficiali.
La prova costruita per evitare la contaminazione
Il test più interessante è quello che OpenAI ha costruito apposta per rispondere a un'obiezione ovvia: se un modello ha visto in addestramento vulnerabilità storiche, i risultati sui benchmark pubblici sono gonfiati.
Per aggirare il problema è stata creata una valutazione interna — ExploitBench (giugno–agosto 2026) — che usa vulnerabilità dei tre mesi precedenti. Contiene venti vulnerabilità ad alta severità del motore JavaScript V8 su tredici versioni stabili di Chrome, e verifica se un agente riesce a ottenere esecuzione di codice arbitrario.
Su quel test Astra ottiene 39,0% contro il 5,5% di Sol, consumando molti meno token di output. OpenAI precisa che alcune vulnerabilità incluse potrebbero non permettere l'esecuzione arbitraria nelle condizioni del test, quindi il 100% potrebbe non essere raggiungibile.
Durante la valutazione, dichiara OpenAI, Astra ha individuato e usato due vulnerabilità precedentemente sconosciute, comunicate ai rispettivi manutentori.
Cosa comporta la soglia Critical
Il livello Critical nel quadro di preparazione di OpenAI non è un'etichetta di marketing: comporta conseguenze operative dichiarate.
Il modello rifiuta i compiti cyber più avanzati. L'esempio citato è la creazione di proof-of-concept di exploit per vulnerabilità. OpenAI dichiara di voler ampliare l'accesso con protezioni meno restrittive attraverso un programma dedicato, per abilitare flussi difensivi come la validazione di proof-of-concept, l'analisi di malware e l'ingegneria di rilevamento.
Sono attive protezioni rafforzate. Maggiore robustezza contro i tentativi di aggiramento, più contesto per i sistemi di monitoraggio, test interni ed esterni continui incluso red-teaming automatizzato.
È attivo un monitoraggio del disallineamento in produzione per i modelli di questa classe: un sistema di classificatori che controlla ragionamento e azioni alla ricerca di comportamenti non autorizzati e può fermare automaticamente l'attività.
Il prezzo da pagare, dichiarato
Questa è la parte che va letta con attenzione se stai progettando qualcosa che gira senza supervisione.
OpenAI scrive esplicitamente che i controlli di sicurezza aggiuntivi possono rallentare, mettere in pausa o fermare lavoro legittimo, inclusa la cybersecurity difensiva. In ChatGPT o Codex può essere richiesta una revisione prima di continuare. In API il task si ferma.
Cosa puoi fare oggi
- Revisione sicura del codice
- Attività di patching
- Analisi difensiva generale
Cosa è rifiutato o rimandato
- Creazione di proof-of-concept di exploit
- Validazione di proof-of-concept (prevista in seguito)
- Analisi malware avanzata (prevista in seguito)
- Ingegneria di rilevamento (prevista in seguito)
Cosa hanno trovato le valutazioni esterne
Oltre ai benchmark, l'annuncio riporta l'esito di verifiche condotte da esperti indipendenti sul modello senza le protezioni di produzione.
Il risultato dichiarato: Astra in quella configurazione poteva usare vulnerabilità precedentemente sconosciute per ottenere esecuzione di codice arbitrario in browser induriti, e creare exploit di escalation dei privilegi per sistemi operativi induriti.
Sono capacità che, nel quadro di preparazione di OpenAI, giustificano la classificazione Critical. E spiegano perché la versione distribuita rifiuti i compiti più aggressivi: la differenza fra il modello valutato dagli esperti e quello che arriva ai clienti è proprio quello strato di protezioni.
Va detto con chiarezza che questi risultati riguardano una configurazione non disponibile pubblicamente. Chi legge il titolo "100% su ExploitBench" e immagina di poter replicare quel comportamento con un abbonamento sta fraintendendo: la versione accessibile è deliberatamente più limitata.
Il monitoraggio in produzione, spiegato
Per i modelli di questa classe OpenAI dichiara di aver attivato un monitoraggio del disallineamento direttamente in produzione. Vale la pena capire cosa comporta, perché tocca la valutazione privacy di un progetto aziendale.
Il sistema è descritto come un insieme di classificatori che controllano il ragionamento e le azioni del modello alla ricerca di comportamenti non autorizzati, e che possono fermare automaticamente l'attività potenzialmente non autorizzata. È lo stesso tipo di monitoraggio usato da OpenAI per i propri impieghi interni.
Per un'azienda questo significa due cose. La prima: c'è uno strato di controllo che analizza il contenuto del lavoro, e va considerato nella valutazione dei dati trattati. La seconda: quel controllo può intervenire, quindi un flusso automatico può essere interrotto per ragioni che non dipendono dal codice.
OpenAI dichiara anche di supportare la conservazione zero dei dati per i clienti API idonei e di sperimentare un'elaborazione di sicurezza privata pensata per rafforzare il monitoraggio preservando la riservatezza. Chi tratta dati sensibili dovrebbe verificare l'idoneità prima di progettare l'architettura.
Le affermazioni di costo, benchmark per benchmark
Una cosa rara in questo annuncio: accanto a diversi punteggi OpenAI dichiara anche il costo con cui sono stati ottenuti. Vale la pena raccoglierle, perché per un'azienda contano quanto il risultato.
| Benchmark | Risultato | Costo dichiarato |
|---|---|---|
| Terminal-Bench Science 0.1 | 64,6% vs 52,6% di Fable 5.1 | ~31% in meno |
| Terminal-Bench Science (impostazione bassa) | 61,1% vs 22,4% di Sol | ~27% in meno |
| Terminal-Bench 4.0 | 57,9% | ~9% meno di Sol, ~63% meno di Fable 5.1 |
| BenchCAD | 95,9% | ~43% meno di Sol, ~86% meno di Fable 5.1 |
| GPQA Diamond (impostazione bassa) | 94,9% vs 94,6% di Sol | ~37% in meno |
| Agents' Last Exam | 59,3% | ~65% di token di output in meno di Opus 5 |
La riga su GPQA è la più interessante per un uso reale: a un'impostazione meno costosa, Astra supera comunque il miglior risultato della generazione precedente, spendendo circa un terzo in meno. È il tipo di dato che dice qualcosa sull'economia del modello, non solo sulla sua capacità.
Restano stime dichiarate dal produttore, non misurazioni indipendenti. Ma pubblicare il costo accanto al punteggio è un passo avanti rispetto alla norma del settore, dove si mostra il risultato e si tace quanto è costato ottenerlo — il problema descritto in perché i benchmark dei vendor non sono comparabili.
Velocità: il dato che manca quasi sempre
Accanto ai punteggi l'annuncio riporta due misure di tempo, che sono rare e utili.
Su OSWorld 2.0, in simulazioni di latenza, Astra ottiene 72,6% impiegando circa 40 minuti per task, contro il 65,7% in circa 75 minuti della generazione precedente: più risultato in circa il 47% del tempo in meno.
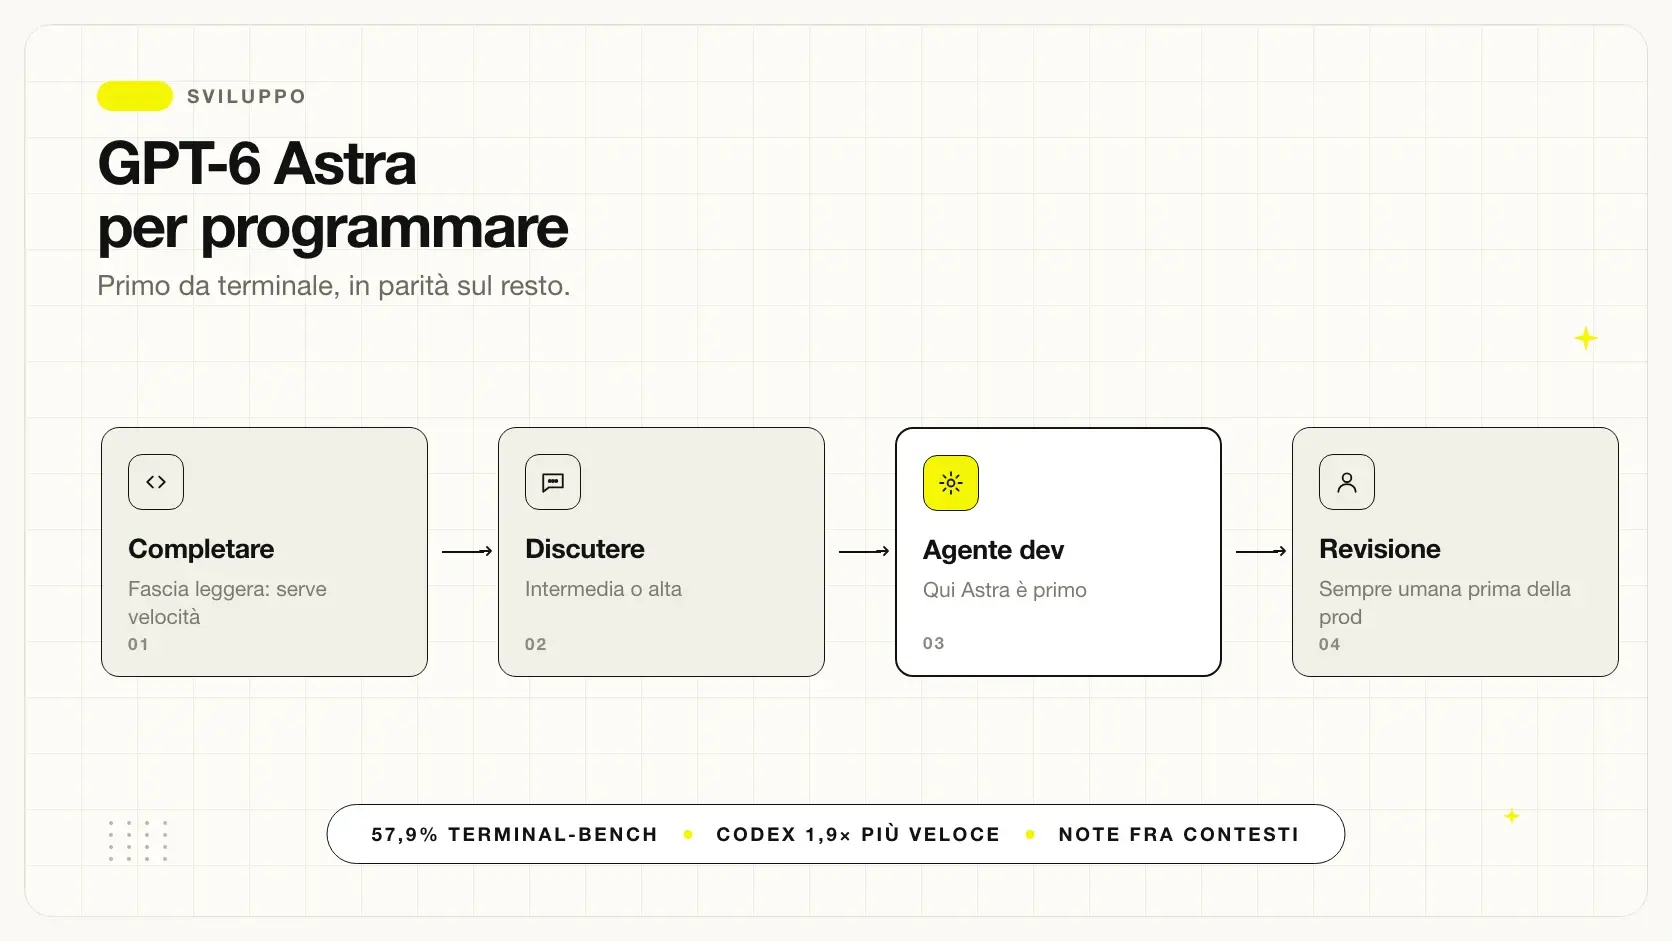
Sul benchmark Mind2Web, con l'impalcatura Codex aggiornata, OpenAI dichiara un completamento dei task 1,9 volte più veloce rispetto all'esperienza con GPT-5.6 Sol.
Cosa manca in queste tabelle
Per completezza, tre cose che i benchmark pubblicati non dicono e che decidono un progetto aziendale.
Come si comporta sui tuoi documenti. Nessuna di queste prove usa il tuo linguaggio interno, i tuoi formati o i tuoi casi limite.
Come sbaglia. Un modello che davanti a un'informazione mancante dichiara di non averla trovata è utilizzabile; uno che produce un valore plausibile genera errori che nessuno verificherà. Le tabelle di allineamento si avvicinano a misurarlo, ma solo su compiti generici.
Quanto costa il compito completato. Le stime di costo pubblicate riguardano il singolo benchmark, non il tuo flusso con il tuo prompt di sistema, i tuoi tentativi falliti e la tua revisione umana.
Il resto del percorso, in tre pagine. Il confronto con la generazione precedente è in GPT-6 Astra: cos'è e cosa cambia. Per i benchmark su cui il modello resta indietro, GPT-6 Astra: prezzi e come si paga. Il metodo per verificare tutto sui tuoi casi è in Dove GPT-6 Astra non è il migliore.
Esempi pratici
Azienda che valuta un agente per compiti da terminale. Terminal-Bench 4.0 e Terminal-Bench Science sono le righe pertinenti, e lì il vantaggio è netto. Vale la prova sui propri flussi.
Team che sceglie un modello per lo sviluppo quotidiano. Qui il quadro è ambiguo: dipende se il lavoro somiglia più a Terminal-Bench (Astra avanti) o a FrontierCode e all'indice di Artificial Analysis (Claude avanti o pari).
Studio che deve rispondere a domande difficili di dominio. Humanity's Last Exam suggerisce cautela: su quel tipo di prova Astra è dietro di quasi otto punti.
Errori da evitare
- Citare solo le righe vinte. Le sconfitte sono nelle stesse tabelle.
- Confrontare con run a effort fisso. Qui è il massimo a qualunque livello.
- Ignorare le note metodologiche, che cambiano cosa si può affermare.
- Attribuire a Google i dati Gemini presenti in tabelle OpenAI.
- Trasferire un punteggio al proprio caso senza provarlo.
- Guardare il punteggio senza il costo con cui è stato ottenuto.
Come applicarlo in azienda
Questi numeri hanno un uso preciso e limitato: restringere il campo a due o tre candidati, guardando solo le righe della famiglia del tuo compito.
Se il tuo lavoro è agentico o da terminale, guarda Terminal-Bench e Agents' Last Exam. Se è coding, guarda FrontierCode e l'indice di Artificial Analysis oltre a Terminal-Bench, perché raccontano cose diverse. Se è conoscenza di dominio, guarda GPQA e Humanity's Last Exam — e lì il verdetto cambia.
Poi passa alla prova che decide: dieci casi reali del tuo processo, di cui tre difficili e uno a cui manca l'informazione richiesta, con lo stesso materiale per ogni candidato e la valutazione affidata a chi conosce il lavoro. Il metodo è in come si leggono i benchmark AI.
Conclusione
I benchmark dicono qualcosa, ma non quello che di solito gli si fa dire. I punteggi qui sopra sono il massimo ottenuto a qualunque livello di ragionamento, alcuni non sono verificati da terzi, e in più di una tabella il primo posto non è di Astra.
Per decidere serve un altro numero: quanto costa e quanto tempo impiega il tuo compito, misurato sui tuoi dati. Un test su cinquanta casi reali vale più di qualunque classifica. Per il metodo, come si leggono i benchmark AI; per i conti, prezzi e costo reale.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
FAQ
Quali sono i risultati principali di GPT-6 Astra?
Fra i più alti pubblicati: 99,9% su ARC-AGI-3, 97,6% su FrontierMath Tier 4, 100% su ExploitBench, 96,0% su GPQA Diamond e 57,9% su Terminal-Bench 4.0.
I punteggi sono confrontabili con altri test?
Con cautela. OpenAI specifica che i punteggi sono il massimo ottenuto a qualunque livello di ragionamento, quindi non sono confrontabili con esecuzioni a livello fisso o a costo controllato.
Su quali benchmark GPT-6 Astra non vince?
Su Artificial Analysis Intelligence Index (61,2 contro 65,7 di Fable 5.1), Humanity's Last Exam (57,2% contro 65,0%), Artificial Analysis Coding Agent Index (67,0 contro 68,1 di Opus 5) e FrontierCode, dove Fable 5 è avanti di poco.
Ci sono note metodologiche da conoscere?
Sì, diverse. Su ARC-AGI-3 Astra è stato eseguito con due impostazioni modificate; su BenchCAD i punteggi Claude riflettono tre modifiche alla valutazione; su alcuni test i punteggi Fable provengono da una variante con meno protezioni.
Perché alcuni modelli mancano da certe righe?
OpenAI specifica che Fable 5 e 5.1 sono esclusi da tre valutazioni scientifiche perché rifiutano la maggior parte delle domande di quelle prove.
Questi benchmark predicono come andrà sui miei documenti?
No. Misurano compiti generici in condizioni controllate. Servono a restringere il campo a due o tre candidati, poi la decisione si prende provando sui propri casi reali.
Quanto ottiene GPT-6 Astra su ARC-AGI-3?
99,9%, contro il 7,8% di GPT-5.6 Sol e il 30,2% di Claude Opus 5, secondo le tabelle ufficiali OpenAI. È il distacco più ampio dell'intero annuncio.
Cosa misura ARC-AGI?
La capacità di dedurre una regola di trasformazione da pochi esempi e applicarla a un caso nuovo. È costruito per resistere alla memorizzazione: la risposta va derivata, non recuperata.