
Fable 5.2 vs Opus 5.5: quale usare e quando
Fable 5.2 vs Opus 5.5: prezzi 8/40 $ contro 4/20 $, benchmark dichiarati da Anthropic e una matrice per scegliere il modello giusto per ogni compito.
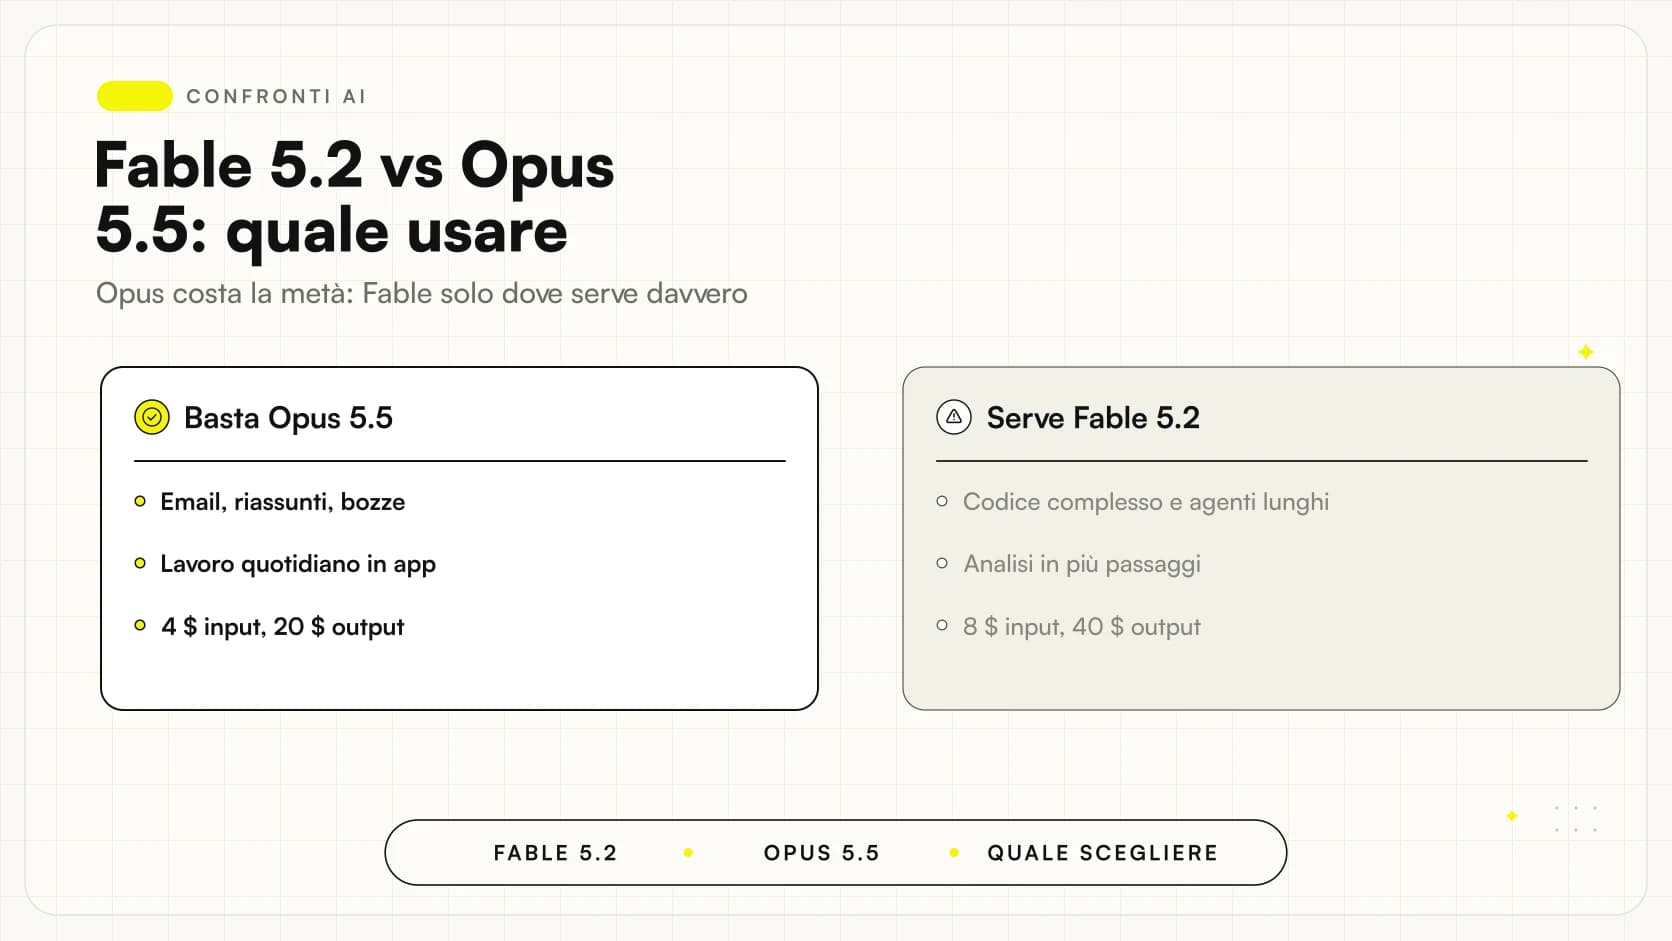
Fable 5.2 vs Opus 5.5 si decide con una regola: partite da Claude Opus 5.5 e salite a Claude Fable 5.2 solo quando Opus, anche a effort alto, non raggiunge la qualità che vi serve. Fable 5.2, rilasciato da Anthropic il 9 novembre 2026, costa il doppio per token e vince nei benchmark dichiarati. Opus 5.5 è il modello che Anthropic stessa chiama «our strongest daily driver», cioè quello da usare tutti i giorni, secondo l'annuncio ufficiale consultato il 9 novembre 2026.
Questo articolo mette i due modelli sullo stesso piano: prezzo, benchmark, effort, dati, e una matrice per assegnare ogni compito al modello giusto. La scheda tecnica completa di Fable è nella guida a Claude Fable 5.2; qui parliamo solo di cosa cambia nella scelta. Tutti i punteggi sono dichiarati da Anthropic e non risultano replicati da terzi nelle pagine consultate.
In sintesi
- Anthropic consiglia di iniziare con Opus 5.5 per la maggior parte dei compiti di codice e di conoscenza, e di salire a Fable 5.2 per il lavoro più ambizioso (annuncio del 9 novembre 2026).
- Fable 5.2 costa 8 dollari in input e 40 in output per milione di token, Opus 5.5 costa 4 e 20 (scheda ufficiale): a parità di token il rapporto è di due a uno.
- Nelle prove a punteggio percentuale della tabella Anthropic Fable 5.2 è davanti a Opus 5.5 ovunque, con scarti da 2,1 a 25,5 punti.
- Su FrontierCode 2.0 Fable 5.2 a effort High eguaglia Opus 5.5 a effort Max per circa metà del costo per compito (fonte Anthropic).
- Le due schede hanno stessa finestra di contesto e stesso output massimo, ma effort predefinito diverso in API: high per Fable, medium per Opus.
- Fable 5.2 è un Covered Model con conservazione dati di almeno 30 giorni; Opus 5.5 non è nell'elenco consultato (pagina di supporto).
Fable 5.2 o Opus 5.5: quale conviene per il lavoro di tutti i giorni?
Per il lavoro di tutti i giorni conviene Opus 5.5. Lo dice Anthropic nell'annuncio: per la maggior parte dei compiti di codice e di conoscenza si parte da Opus 5.5, poi si passa a un altro modello in base all'ampiezza e alla complessità del lavoro, in su verso Fable o in giù verso Sonnet 5.5 e Haiku 5.5. La documentazione API è più operativa: passate a Fable 5.2 quando le vostre prove su Opus a effort più alto non soddisfano ancora i requisiti.
Il criterio è un test, non un'impressione. Se Opus 5.5 a high produce già il risultato che accettereste da una persona, Fable vi fa pagare di più per niente. Se sbaglia sempre nello stesso punto, per esempio perde un vincolo a pagina 80, può valere il sovrapprezzo. La generazione precedente è in Opus 5 vs Fable 5.1.
Quanto costano a confronto, e cosa hanno in comune?
I dati sono presi dalla scheda ufficiale di Fable 5.2, che riporta anche la riga di Opus 5.5, consultata il 9 novembre 2026. I prezzi sono in dollari, IVA esclusa per l'Italia. Non abbiamo trovato listini in euro nelle pagine ufficiali.
| Caratteristica | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Input (dollari per milione di token) | 8 | 4 |
| Output (dollari per milione di token) | 40 | 20 |
| Contesto (token) | 1M | 1M |
| Output massimo (token) | 128K | 128K |
| Ragionamento | Adattivo, sempre attivo | Adattivo, sempre attivo |
| Effort predefinito in API | high | medium |
| Latenza dichiarata | Moderata | Moderata |
| Conoscenze aggiornate a | giugno 2026 | giugno 2026 |
Contesto, output massimo e ragionamento sono identici: documenti e conversazioni lunghe entrano in entrambi. La differenza sta nella qualità sul compito difficile e nel costo di ogni tentativo.
Su Fable 5.2 esistono anche il Batch API (sconto del 50% secondo la scheda) e una modalità veloce: i dettagli sono in Fable 5.2: prezzi API e costi reali. Per l'intera famiglia prima di questo lancio, Claude: prezzi dei modelli a confronto.
Il rapporto di due a uno è un punto di partenza: il costo di un lavoro è token per prezzo, e i token dipendono da quanto il modello ragiona e da quante volte riprova. Nelle pagine consultate il costo per compito rispetto a Opus 5.5 compare solo in alcuni grafici (FrontierCode, WANDR, Humanity's Last Exam, Chartography), e sempre contro Opus al massimo effort.
Di quanto Fable 5.2 batte Opus 5.5 nei benchmark?
Secondo la tabella dell'annuncio, Fable 5.2 e Mythos 5.2 sono «un passo sopra» Opus 5.5 in quasi tutte le capacità valutate. Ecco le prove in cui esiste un punteggio percentuale per entrambi, con lo scarto calcolato da noi.
| Prova (cosa misura) | Fable 5.2 (%) | Opus 5.5 (%) | Scarto (punti) |
|---|---|---|---|
| FrontierCode 2.0 (codice che i manutentori accetterebbero) | 49,1 | 45,5 | 3,6 |
| FrontierSWE v2 (ingegneria del software) | 69,9 | 62,3 | 7,6 |
| AutomationBench (flussi di lavoro aziendali) | 51,4 | 42,5 | 8,9 |
| Terminal-Bench-Science (ricerca scientifica con agenti) | 74,6 | 58,7 | 15,9 |
| WANDR, punteggio rilassato (ricerca agentica) | 82,1 | 72,3 | 9,8 |
| OSWorld 2.1 (uso del computer, set offline parziale) | 89,3 | 87,2 | 2,1 |
| RoboDojo Sim (robotica, eseguita internamente) | 64,9 | 39,4 | 25,5 |
| AA-Briefcase v1.1 (lavoro di conoscenza, punteggio a rubrica) | 66,1 | 61,2 | 4,9 |
| Remote Labor Index (lavoro remoto, Fable a effort High) | 41,3 | 21,3 | 20,0 |
| Humanity's Last Exam, con strumenti (conoscenza esperta) | 74,2 | 67,7 | 6,5 |
| Chartography, senza strumenti (lettura di grafici) | 73,4 | 64,4 | 9,0 |
Come si legge questa tabella senza farsi ingannare:
- Punteggi al massimo effort disponibile, salvo indicazioni diverse: FrontierCode per Fable è a Xhigh, il Remote Labor Index a High. Sono numeri da laboratorio.
- Scarto piccolo dove Opus era già buono. Uso del computer (2,1 punti) e codice accettabile (3,6): qui il sovrapprezzo di Fable è più difficile da giustificare.
- Scarto grande dove il lavoro è lungo e autonomo. Ricerca scientifica con agenti, robotica e lavoro remoto superano i 15 punti.
- Fonte unica. Sono dichiarazioni di Anthropic, senza recensioni indipendenti nelle pagine consultate il 9 novembre 2026. Prova per prova: Claude Fable 5.2: i benchmark spiegati.
Il dato che cambia i conti: FrontierCode a metà costo
C'è un'informazione che conta più del primato. Sempre secondo l'annuncio, su FrontierCode 2.0 Fable 5.2 a effort High raggiunge il 45,3% contro il 45,5% di Opus 5.5 al suo miglior punteggio, per circa metà del costo per compito. In pratica, un modello che costa il doppio per token può costare la metà per compito se arriva alla stessa qualità con molti meno tentativi e molto meno ragionamento.
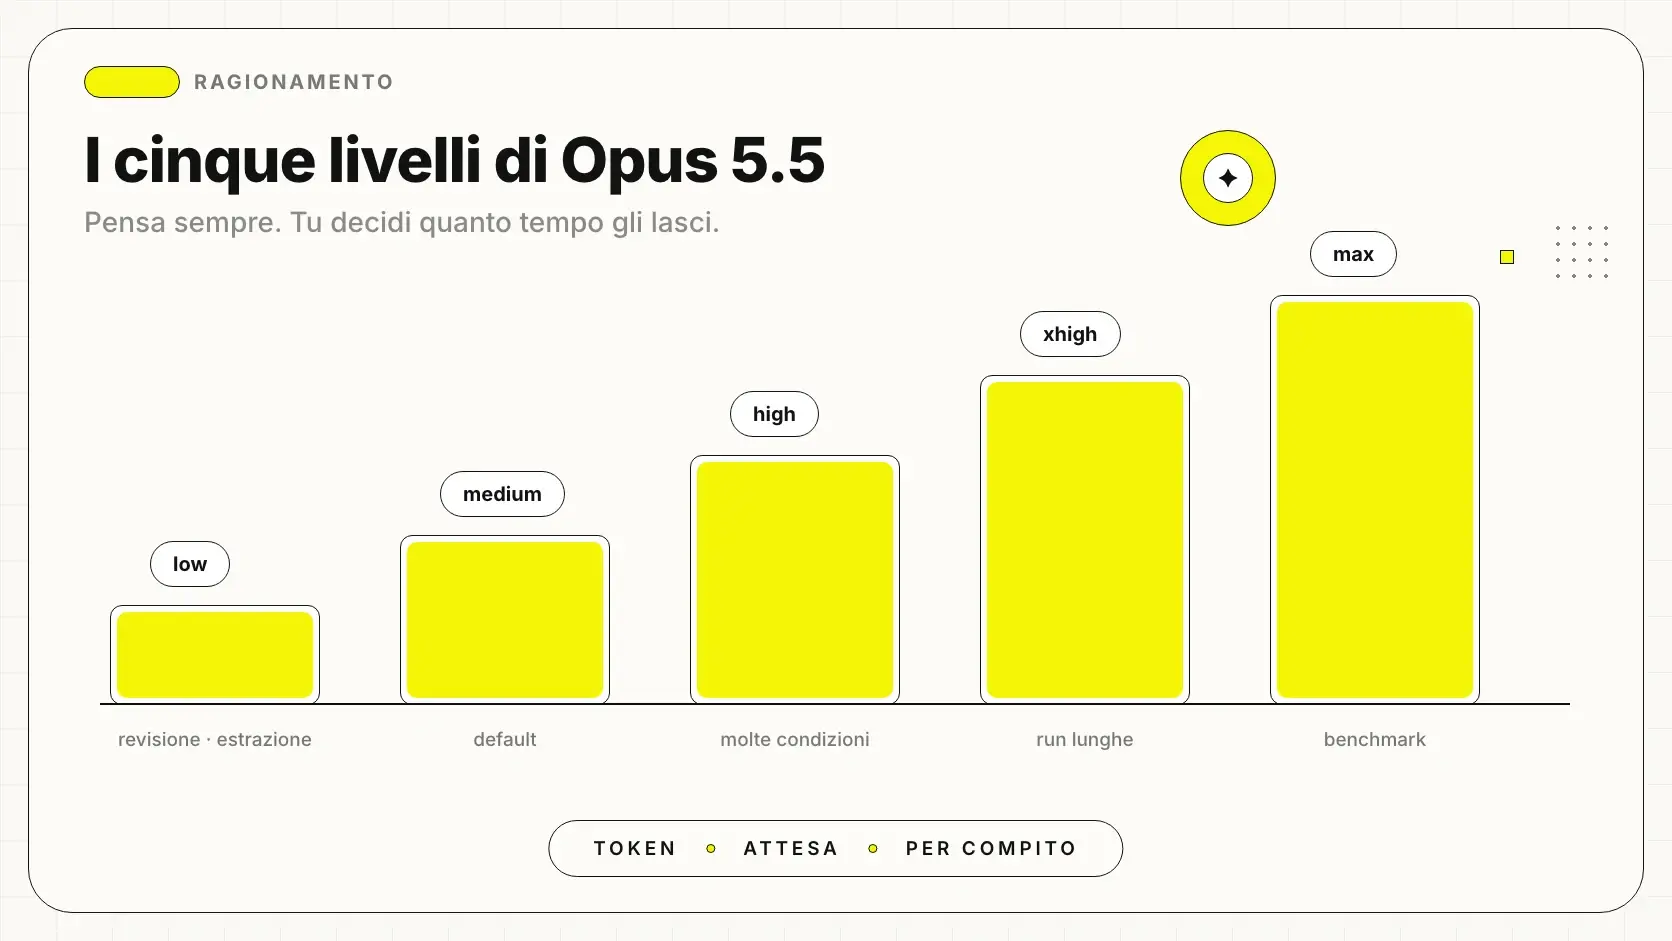
Va letto con cautela: il confronto è con Opus 5.5 spinto a effort Max, la configurazione più cara. Non dice come vadano i due modelli a livelli intermedi, che sono quelli che userete davvero. Per questo il test sui vostri casi, descritto più sotto, vale più di qualunque grafico. Come si regolano i livelli lo spieghiamo in Fable 5.2: livelli di ragionamento e in Opus 5.5: livelli di ragionamento.
Quale modello per quale compito?
Non è un verdetto di Anthropic: è una nostra lettura dei benchmark e del consiglio ufficiale, da verificare sui vostri dati.
| Compito | Parti da | Passa a Fable 5.2 quando |
|---|---|---|
| Email, bozze, riassunti, risposte ai clienti | Opus 5.5 (o Sonnet 5.5 per volumi alti) | Quasi mai |
| Revisione di singoli documenti e contratti | Opus 5.5 a effort high | Opus perde vincoli o contraddizioni nonostante l'effort alto |
| Confronto incrociato di molti documenti | Opus 5.5 a effort high | Le incoerenze tra documenti lontani sfuggono ancora |
| Codice quotidiano, correzioni, test | Opus 5.5 | Le modifiche richiedono molti file e vengono rifiutate in revisione |
| Migrazioni, refactoring ampi, agenti di codice per ore | Provate entrambi | Fable chiude il lavoro con meno interventi umani |
| Uso del computer (compilare, navigare, inserire dati) | Opus 5.5 | Il flusso fallisce a metà su Opus dopo prove ripetute |
| Coordinare altri modelli o assistere un agente in difficoltà | Opus come esecutore | Fable come consulente (Advisor) per i passaggi duri |
L'ultima riga è la più interessante per i costi. Anthropic descrive Fable 5.2 anche come Advisor, consultato da Haiku, Sonnet o Opus davanti a un problema difficile, e come Orchestrator, che delega i compiti semplici a modelli più economici. Il modello caro solo dove serve: ne parliamo in Fable 5.2 come Advisor e Orchestrator.
Restate su Opus 5.5 se
- Il lavoro è ripetitivo e ad alto volume: ogni centesimo per token si moltiplica.
- Il risultato passa comunque da una revisione umana veloce.
- I test su Opus a effort high danno già una qualità accettabile.
- Trattate dati per cui una conservazione di 30 giorni è un problema.
Provate Fable 5.2 se
- Un compito lungo fallisce sempre nello stesso punto, anche con Opus a effort alto.
- Un errore a metà costa ore di lavoro umano per essere recuperato.
- L'agente deve lavorare per ore senza supervisione.
- Il costo di un risultato sbagliato supera quello di una tariffa doppia.
Due casi pratici: studio legale a Firenze e software house a Brescia
Studio legale a Firenze. Un esempio, dichiarato come tale: lo studio deve verificare una raccolta di contratti di locazione commerciale per una cessione d'azienda, cercando clausole incompatibili tra i contratti e con la documentazione societaria. Per l'estrazione dei dati (scadenze, canoni, recessi) basta Opus 5.5, o anche Sonnet 5.5. Il passaggio difficile è il confronto incrociato, dove un vincolo sepolto in un allegato contraddice una clausola di un altro contratto.
Qui conviene misurare. Ipotizziamo, per fare un conto, 600.000 token in input e 40.000 in output per pratica, uguali per entrambi i modelli: sul listino Opus 5.5 costerebbe 3,20 dollari e Fable 5.2 6,40. Sono numeri dimostrativi, non misure: la differenza reale dipende dai token che ciascun modello consuma davvero. Anche con Fable al doppio del costo, circa 3 dollari in più per pratica sono una frazione dell'ora di un avvocato: il sovrapprezzo si ripaga se evita una sola clausola mancata ogni tante pratiche. Prima però lo studio deve decidere se può mandare quei contratti a un Covered Model, cioè con conservazione di 30 giorni: per il segreto professionale serve una valutazione con il consulente privacy, come spieghiamo in Fable 5.2 e privacy: dati conservati 30 giorni. Per il contesto dei professionisti legali c'è la pagina su AI per studi legali.
Software house a Brescia. Secondo esempio dichiarato: un gestionale per officine, con un agente che propone modifiche al codice. Per correzioni e test quotidiani la base è Opus 5.5; Fable è riservato alle migrazioni di versione, che toccano decine di file. Il criterio è la quota di modifiche accettate in revisione al primo giro: se Fable la alza abbastanza da risparmiare ore di sviluppatore, il prezzo per token passa in secondo piano.
Cosa cambia sui dati: Fable è un Covered Model, Opus 5.5 no
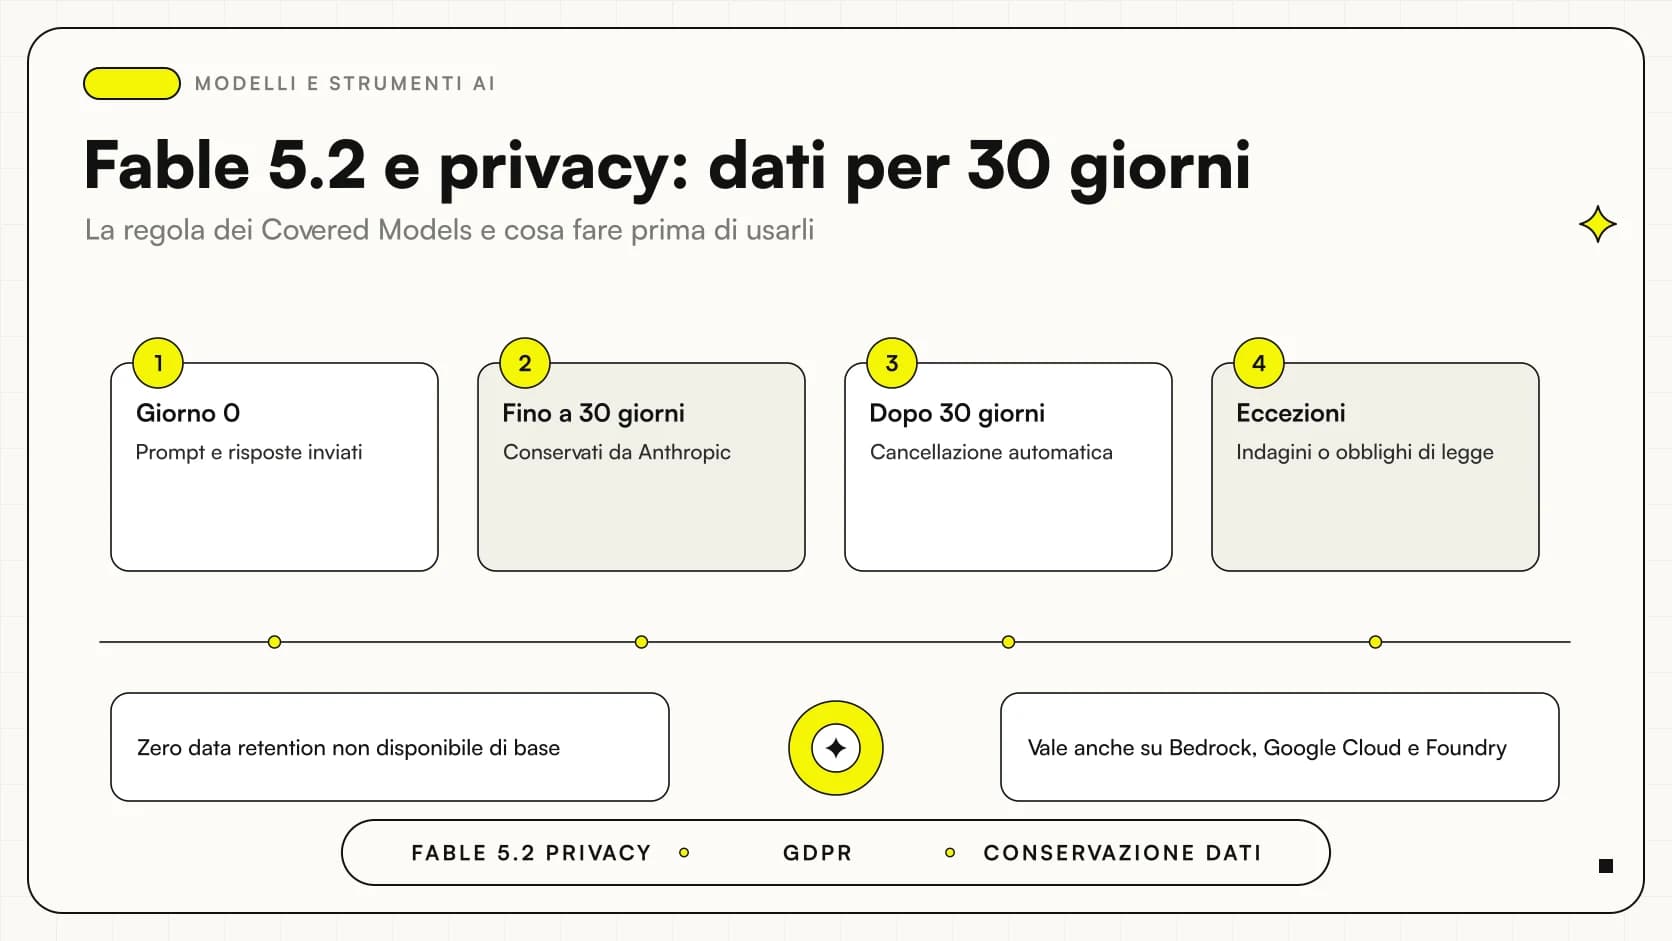
Secondo la pagina di supporto sui Covered Models, consultata il 9 novembre 2026, Fable 5.2 è designato come Covered Model: prompt e risposte sono conservati per almeno 30 giorni e la zero data retention non è disponibile, nemmeno per i clienti Enterprise e sulle piattaforme di terzi. Nell'elenco compaiono i modelli Fable e Mythos; Opus 5.5 non c'è.
La stessa pagina precisa che gli altri modelli Claude restano sotto l'accordo e le impostazioni di conservazione già configurati, e che i clienti idonei alla zero data retention possono continuare a usare i modelli precedenti. Se avete una ragione seria per non far conservare i dati, la scelta tra Fable e Opus non è solo di qualità. Non è una valutazione legale: dipende dai vostri contratti e dai dati.
In che cosa si comportano diversamente via API?
Chi usa i modelli solo dalle app non deve fare nulla. Chi li integra ha tre cose da sapere, dalla documentazione di Fable 5.2:
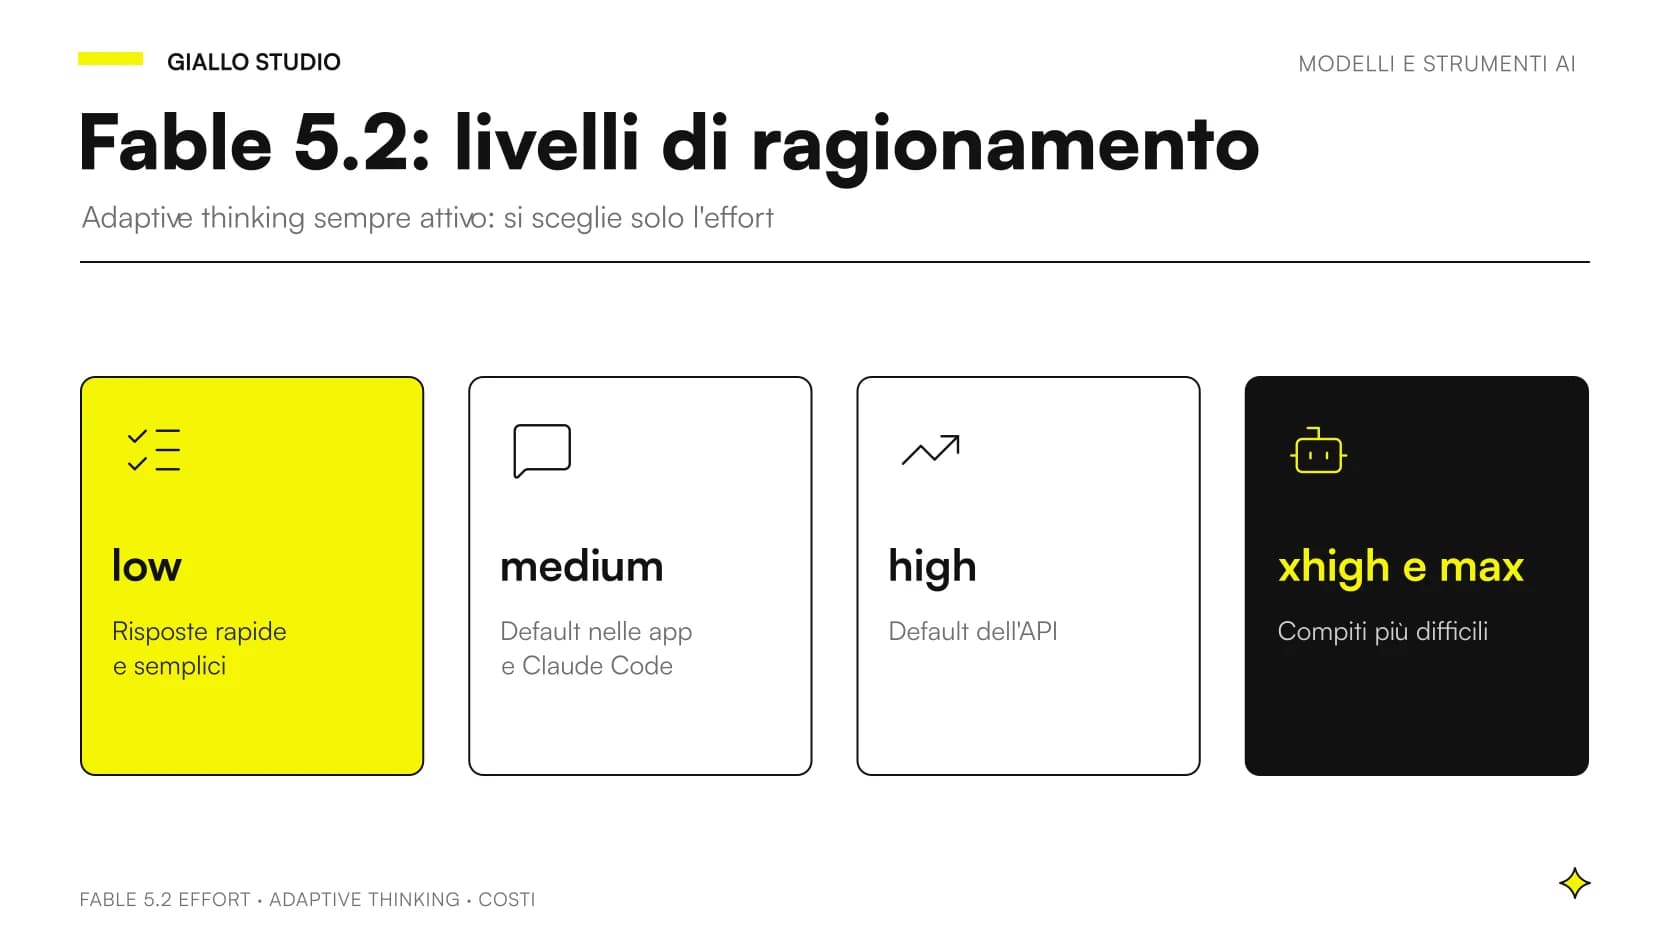
- Effort predefinito diverso. In API Fable 5.2 parte da high, Opus 5.5 da medium. Se confrontate i due con le impostazioni predefinite, non state confrontando alla pari: fissate lo stesso livello.
- Il ragionamento non si spegne. Su Fable 5.2 è adattivo e sempre attivo, e a medium o oltre il modello ragiona anche se il prompt gli chiede di non farlo. Per le richieste semplici conviene abbassare l'effort, non scrivere «rispondi senza pensare».
- Il costo dei subagent. Possono pesare molto sul costo di una sessione; con un modello a prezzo doppio è una voce da tenere d'occhio.
Gli errori 400 da prevenire sono in Migrare a Fable 5.2; la versione precedente è in Fable 5.2 vs Fable 5.1.
E Mythos 5.2 rispetto a Opus 5.5?
Chi cerca «claude mythos vs opus» di solito vuole sapere se esiste un livello ancora sopra. La risposta è no, per una PMI. Secondo la scheda ufficiale, Mythos 5.2 offre le stesse capacità di Fable 5.2 solo a organizzazioni verificate dai programmi di Anthropic, e ne condivide specifiche e prezzo. Non è un modello più forte: è lo stesso modello senza le salvaguardie su cybersecurity e biologia. Quindi il confronto sulle prestazioni generali è lo stesso di Fable contro Opus, e il tema dell'accesso è spiegato in Claude Mythos 5.2: cos'è e chi può usarlo.
Quali errori evitare quando si sceglie tra Fable e Opus?
- Scegliere Fable «per sicurezza». Per email, riassunti e risposte ai clienti è denaro speso per un vantaggio che nessuno vede.
- Confrontare i modelli a livelli di effort diversi. Con default diversi in API, Fable a high contro Opus a medium misura l'effort, non il modello.
- Leggere il punteggio come garanzia. Un benchmark di codice open source dice poco sui vostri contratti. Sono numeri del produttore.
- Dimenticare la conservazione dei dati. Se il progetto tratta dati sensibili, la scelta del modello entra nell'analisi privacy dal primo giorno, non alla fine.
- Non misurare il costo per compito. Il prezzo per token è metà della storia; l'altra metà sono token consumati e tentativi.
Come fare il test in azienda, in una settimana
Il metodo che usiamo prima di consigliare un modello è semplice e costa poco.
- Raccogliete 15-20 casi reali già chiusi, di cui conoscete la risposta giusta: contratti, pratiche, ticket, richieste di revisione.
- Fissate lo stesso effort per entrambi i modelli e lo stesso prompt, poi eseguite i casi su Opus 5.5.
- Ripetete su Fable 5.2 e, se Opus ha ancora errori, rifate Opus a un effort più alto.
- Annotate tre numeri per modello: casi risolti bene, token consumati, tempo di revisione umana.
- Decidete con il costo per caso risolto, non con il prezzo per token. Se i risultati sono pari, vince il modello meno caro.
Di solito la quota di lavoro che richiede davvero Fable è piccola, e conviene isolarla in un passaggio dedicato. Nella consulenza AI a Milano partiamo proprio da questo test, prima di scrivere una riga di integrazione. Per la lettura decisionale destinata ai titolari, c'è anche Claude Fable 5.2 per le PMI: quando conviene, e per capire il modello di partenza Claude Opus 5.5: cos'è e a chi conviene e Opus 5.5: benchmark, prezzi e confronti.
Cosa fare adesso
Partite da Opus 5.5, fissate un banco di prova di 15-20 casi e fate salire Fable 5.2 solo dove Opus a effort alto non basta. Controllate le pagine ufficiali prima di decidere: modelli, prezzi e offerte di lancio cambiano in fretta, e l'offerta di lancio per Pro e posti standard Team dura una settimana, fino al 16 novembre 2026 (dettagli per piano). Se volete una mano a costruire il test e a decidere quali passaggi del vostro lavoro meritano il modello più costoso, Giallo Studio progetta agenti AI che usano il modello giusto nel passaggio giusto.
Metodo e fonti delle guide di Giallo Studio
Vuoi applicarlo alla tua azienda?In 30 minuti, gratis: il processo da automatizzare per primo e il ritorno stimato, per iscritto.
Prenota l’audit gratuitoCome lo applichiamo in azienda
Risorse correlate
 Claude Fable 5.2 limiti: quelli noti e come aggirarli
 Fable 5.2 privacy: dati conservati 30 giorni e cosa fare in una PMI
 Claude Fable 5.2: cos'è, cosa cambia, quanto costa e a chi serve
 Claude Opus 5.5: cos'è, cosa cambia e a chi conviene
 Claude Opus 5 vs Fable 5.1
 Claude Fable 5.2 aziende: quando conviene alle PMI
 Claude Fable 5.2 prezzo: listino API e costi reali
 Fable 5.2 effort: i livelli di ragionamento e come sceglierli
 Prezzi dei modelli Claude: listino e costo del lavoro
 I livelli di ragionamento di Claude Opus 5.5: cosa sono e quando alzarli
Altri confronti diretti
Gli stessi criteri applicati alle altre coppie di modelli.
- Claude Mythos vs Fable 5.2: differenze vere e chi può usarli
- Gemini 3.6 Flash vs 3.5 Flash
- Fable 5.2 vs Astra: benchmark e prezzi di Claude e GPT-6 a confronto
- Gemini 4 Argon vs ChatGPT e Claude: quale scegliere
- Fable 5.2 vs Gemini 4 Carbon: chi vince dove
- Gemini 4 Carbon vs Argon: differenze e quale scegliere
- Fable 5.1 vs 5.2: cosa cambia davvero e se conviene aggiornare
- Gemini 4 Carbon vs GPT-6 Astra e Claude: quale scegliere per ogni attività
- Claude Fable 5.1 vs Sonnet 5
- Gemini 4 Hydrogen vs Carbon e Argon: quale modello Gemini scegliere
- DeepSeek R1 Distill 32B vs Qwen3.8-27B in locale
- ChatGPT vs Gemini: quale abbonamento conviene a ottobre 2026
FAQ
Meglio Fable 5.2 o Opus 5.5?
Dipende dal compito, non dal modello. Anthropic consiglia di partire da Opus 5.5 per la maggior parte dei lavori di codice e di conoscenza e di passare a Fable 5.2 solo per il lavoro più ambizioso. Fable è davanti nei benchmark dichiarati, ma costa il doppio per token.
Quanto costa Fable 5.2 rispetto a Opus 5.5?
Fable 5.2 costa 8 dollari per milione di token in input e 40 in output; Opus 5.5 costa 4 e 20. A parità di token, quindi, Fable costa il doppio. Il conto reale dipende da quanti token ciascun modello consuma per finire lo stesso compito.
Fable 5.2 costa davvero meno di Opus 5.5 su certi compiti?
Può succedere, secondo i grafici di Anthropic. Su FrontierCode 2.0 Fable 5.2 a effort High ottiene un punteggio quasi uguale a Opus 5.5 a effort Max, per circa metà del costo per compito; su WANDR, Humanity's Last Exam e Chartography Fable a effort più basso eguaglia o supera il miglior punteggio di Opus spendendo dal 40% a meno di un decimo. Il confronto è sempre con Opus al livello massimo, non con Opus a effort medio.
Quale effort conviene con Fable 5.2 e con Opus 5.5?
Partite dal livello predefinito e misurate sui vostri casi. In API Fable 5.2 parte da high e Opus 5.5 da medium; nelle app Claude e in Claude Code il predefinito di Fable è medium. Per confrontare i due modelli in modo onesto usate lo stesso livello su entrambi.
Mythos 5.2 è meglio di Opus 5.5?
Mythos 5.2 è lo stesso modello di Fable 5.2 senza le salvaguardie su cybersecurity e biologia, con le stesse specifiche e lo stesso prezzo. È riservato a organizzazioni approvate dai programmi di verifica di Anthropic. Per una PMI che non fa ricerca di sicurezza o biomedica non è un'opzione, e il confronto utile resta Fable contro Opus.
Posso usare Opus 5.5 con dati riservati più facilmente di Fable 5.2?
Sul piano della conservazione dei dati c'è una differenza. Fable 5.2 è un «Covered Model», con conservazione minima di 30 giorni e senza zero data retention salvo autorizzazione; Opus 5.5 non compare nell'elenco consultato il 9 novembre 2026. Per dati personali o coperti da segreto professionale va comunque fatta una valutazione con il vostro consulente privacy.