
Modelli Claude a confronto: guida alla scelta
Confronta Haiku, Sonnet e Opus 5.5 con Fable 5.1: prezzi, contesto, ragionamento e prove. Scegli Claude sul compito e pianifica una migrazione verificabile.
Tempo di lettura: 16 min
I modelli Claude a confronto per un progetto attuale sono Haiku 5.5, Sonnet 5.5, Opus 5.5 e Fable 5.1, secondo il catalogo verificato il 9 ottobre 2026. La scelta utile identifica il modello che soddisfa i criteri del compito con un costo e un tempo accettabili. Nome, prezzo e finestra di contesto descrivono il candidato; una prova sul processo determina se sia adatto. Catalogo Anthropic.
Per una PMI il confronto deve partire dall’operazione: estrarre campi, classificare una richiesta, preparare un documento o coordinare strumenti. Le descrizioni del produttore aiutano a restringere il campo, ma non sono una classifica indipendente sulla qualità del tuo lavoro. Questa guida propone criteri di prova e un percorso di migrazione; non riporta benchmark Giallo, chiamate a pagamento o prestazioni misurate dall’Italia.
In sintesi
- Il modello va scelto sul compito e sugli errori che contano.
- Tutti i candidati attuali dichiarano contesto da 1M e output standard fino a 128K token.
- La tariffa Haiku cambia oltre 100K token di prompt.
- Opus e Fable hanno ragionamento adattivo sempre attivo.
- Una migrazione deve verificare anche strumenti, formato e consumo.
- Un workflow a più modelli richiede prove dell’instradamento e conteggio delle chiamate.
Quali sono le specifiche dei quattro modelli attuali?
La tabella mette insieme identificativi della Claude API e tariffe standard. Ogni modello rimanda alla propria scheda ufficiale. Un nome nell’app e un identificativo API hanno funzioni diverse: il primo indica una scelta nell’interfaccia, il secondo una configurazione del software.
| Modello | API ID | Input / output USD per 1M token | Contesto / output standard | Destinazione descritta da Anthropic |
|---|---|---|---|---|
| Haiku 5.5 | claude-haiku-5-5 |
0,10 / 0,50 fino a 100K; 0,50 / 2,50 oltre 100K | 1M / 128K | Classificazione, routing ed estrazione |
| Sonnet 5.5 | claude-sonnet-5-5 |
2 / 10 | 1M / 128K | Equilibrio fra velocità e capacità |
| Opus 5.5 | claude-opus-5-5 |
4 / 20 | 1M / 128K | Coding agentico lungo e lavoro sulla conoscenza |
| Fable 5.1 | claude-fable-5-1 |
10 / 50 | 1M / 128K | Ragionamento impegnativo e lavoro agentico lungo |
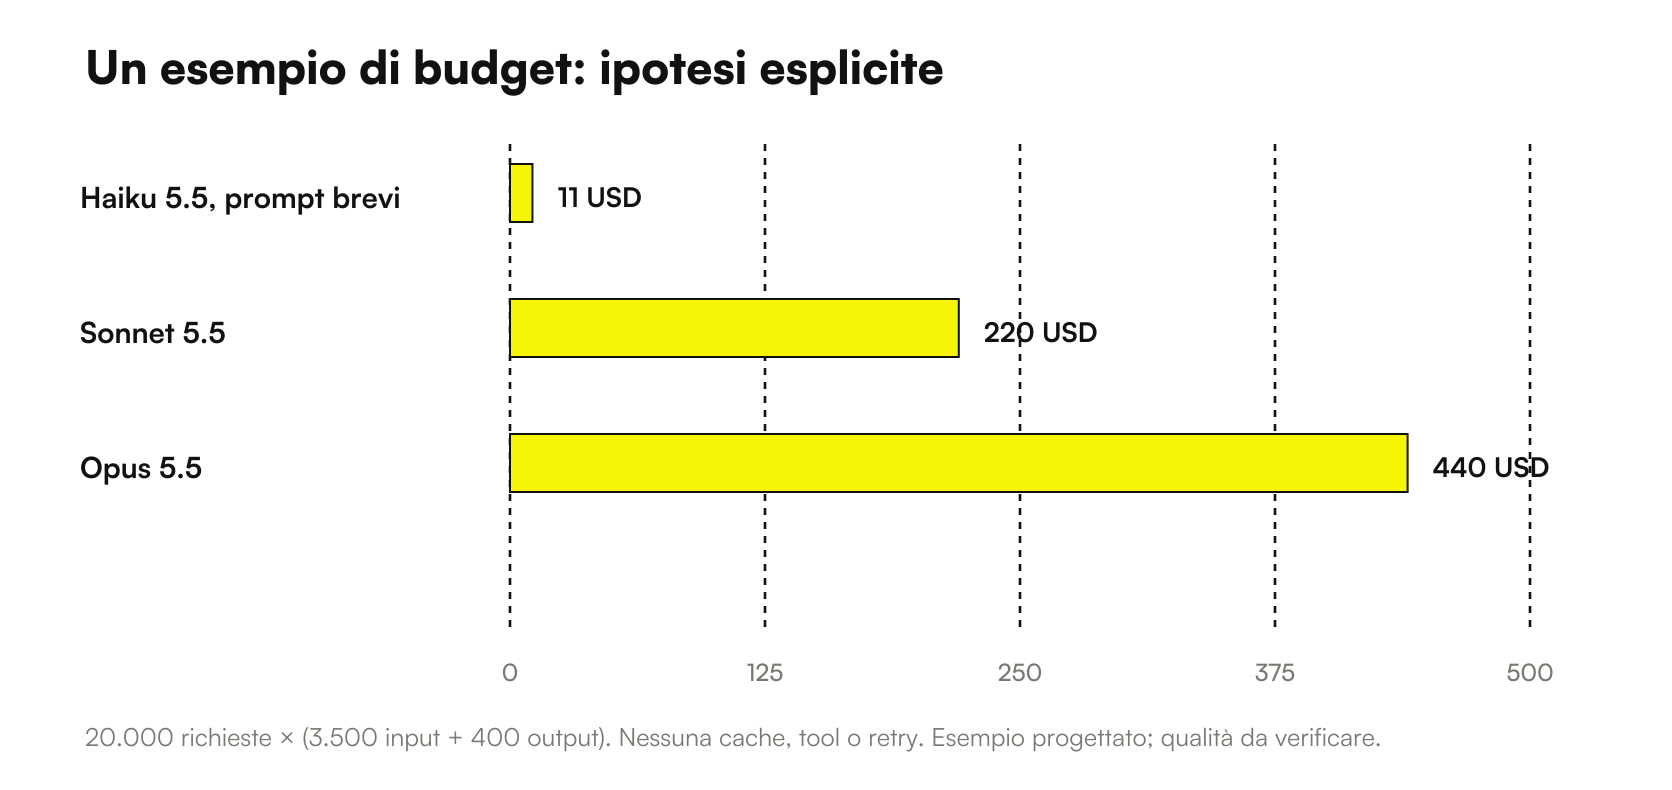
I valori riguardano il listino API, non gli abbonamenti Claude o un preventivo di implementazione. La guida ai prezzi dei modelli Claude approfondisce il calcolo e distingue richieste dirette, ritentativi e router. Limiti massimi simili non rendono i quattro modelli equivalenti: descrivono soltanto alcuni vincoli di input e output.
Da quale compito deve partire il confronto?
Descrivi l’operazione in una frase con input, risultato e criterio. “Estrarre codice articolo e quantità da una riga di ordine, segnalando i campi assenti” è più utile di “automatizzare il commerciale”. La prima formulazione permette di preparare prove e di sapere se il risultato può passare al software successivo.
Poi separa attività diverse. Un sistema può classificare un messaggio, cercare una procedura e preparare una bozza: non sono necessariamente lo stesso problema. La classificazione richiede etichette coerenti; la ricerca richiede fonti pertinenti; la bozza richiede contenuto corretto e un formato utilizzabile. Un unico punteggio di gradimento può nascondere quale passaggio fallisce.
Definisci anche dove finisce l’autonomia. Produrre una proposta di aggiornamento non equivale ad aggiornare un gestionale. La capacità del modello deve essere valutata insieme ai permessi del processo. Un risultato plausibile non è una ragione per eliminare la verifica di un’azione con conseguenze sui dati.
Quando Haiku 5.5 merita una prova?
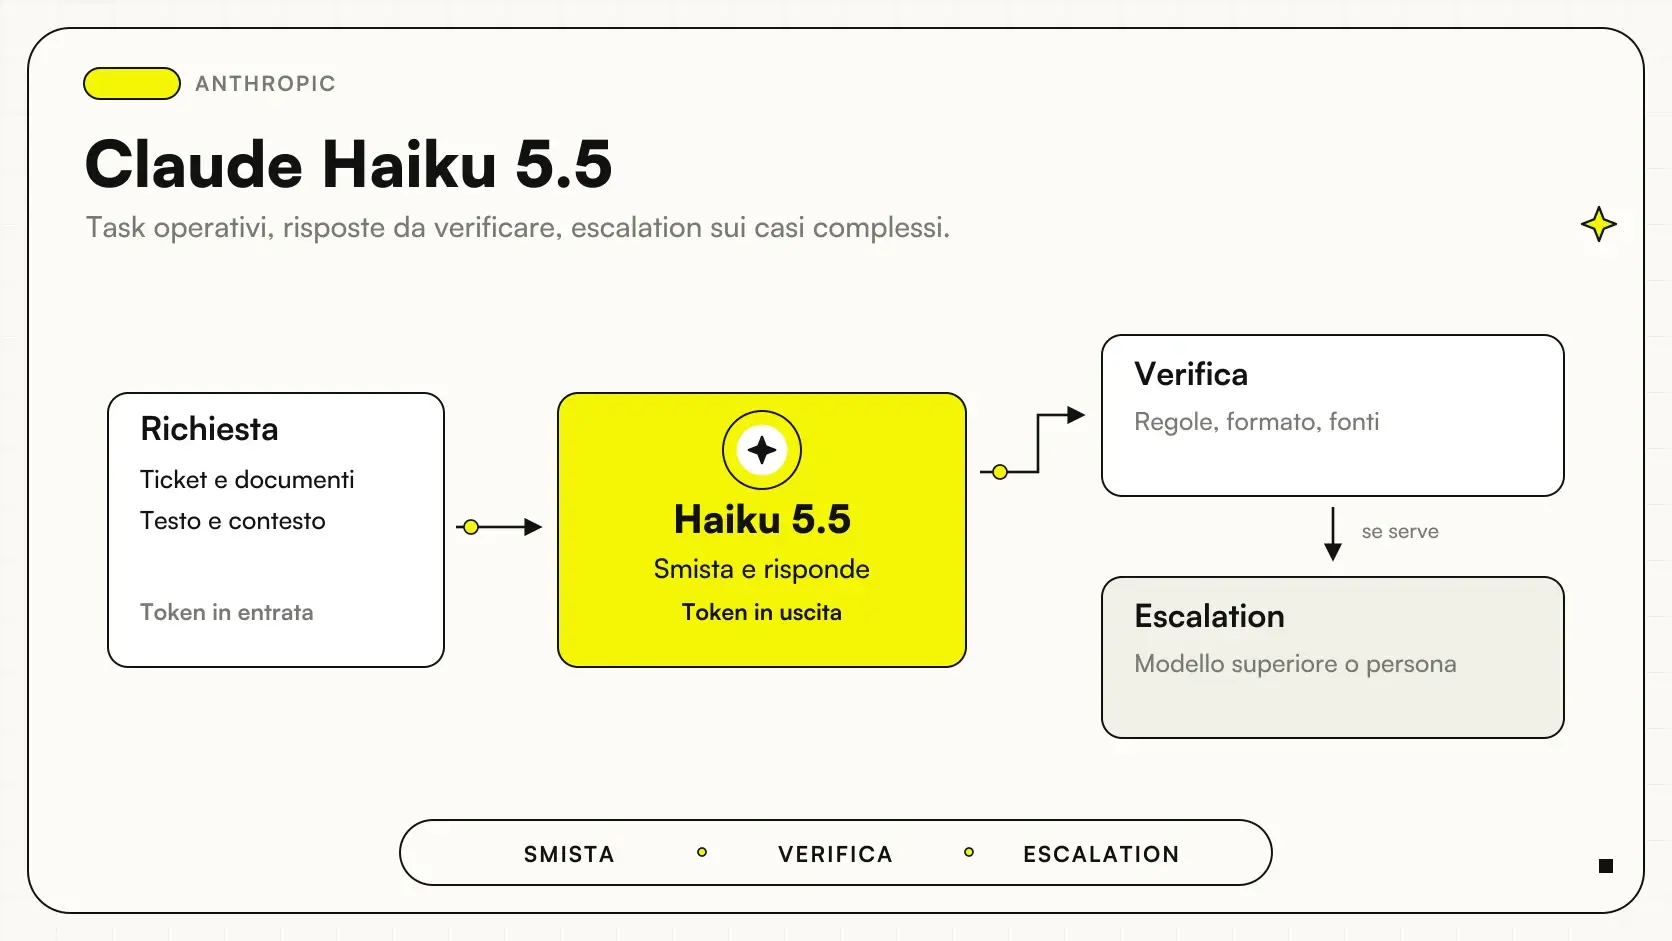
Anthropic posiziona Haiku 5.5 per classificazione, routing ed estrazione ad alto volume. È un punto di partenza da valutare quando il risultato ha un contratto ristretto, come una categoria fra quelle ammesse o un insieme di campi. Questa destinazione non garantisce che ogni documento irregolare venga interpretato correttamente. Scheda Haiku 5.5.
La prova dovrebbe includere casi ordinari, testi ambigui e informazioni mancanti. Non basta verificare che il modello restituisca qualcosa: deve usare la categoria di errore o lo stato incompleto previsti. Se un campo è assente, inventarlo può essere più dannoso di chiedere una review.
La tariffa dipende dal prompt completo e cambia oltre 100K token. Misura anche la tokenizzazione, invece di trasferire una stima fatta per una versione precedente. L’approfondimento Claude Haiku 5.5 descrive il candidato; il tuo dataset stabilisce quali operazioni possa completare secondo il criterio richiesto.
Quali prove distinguono Sonnet 5.5 da una scelta di listino?
Sonnet 5.5 è presentato dal produttore come equilibrio fra velocità e capacità. Per un progetto può essere un candidato da confrontare su sintesi, gestione di istruzioni articolate e preparazione di documenti. Sono ipotesi di adozione: non dichiarano superiorità automatica su Haiku o equivalenza con Opus. Scheda Sonnet 5.5.
Verifica se mantiene i riferimenti necessari, distingue fonti discordanti e rispetta il formato di consegna. Una sintesi scorrevole può omettere un’eccezione decisiva. Un documento formalmente corretto può includere un fatto non presente nelle fonti. Il campione deve rendere questi errori osservabili.
Per un workflow ripetitivo conta anche la configurazione della cache. La guida Sonnet 5.5 e prompt caching riguarda una voce specifica del costo. Il confronto dei modelli dovrebbe usare il percorso previsto, senza attribuire a un candidato uno sconto che il processo non riesce effettivamente a utilizzare.
Quando confrontare Opus 5.5 e Fable 5.1?
Opus 5.5 è descritto per coding agentico lungo e lavoro sulla conoscenza. Fable 5.1 è destinato a ragionamento impegnativo e attività agentiche lunghe. La scheda Fable suggerisce di valutarlo quando le prove su Opus a maggiore effort non raggiungono il criterio. È una raccomandazione del vendor, da confermare sul compito. Opus 5.5, Fable 5.1.
Un confronto pertinente può riguardare una sequenza con strumenti: leggere un problema, trovare informazioni, proporre una modifica e verificare l’esito. Il risultato va misurato sull’intera catena. Un’ottima prima risposta non basta se il processo usa un tool sbagliato o non gestisce una condizione di errore.
Claude Opus 5.5 approfondisce uno dei candidati. La scheda Fable distingue inoltre Mythos 5.1, accessibile soltanto a organizzazioni verificate: non usare i due nomi come sinonimi di disponibilità nel tuo account. L’esistenza del modello nelle docs non prova che il lettore possa già usarlo in ogni ambiente.
Come confrontare il ragionamento senza impostazioni incompatibili?
Il ragionamento adattivo è sempre attivo su Opus 5.5 e Fable 5.1. Non consigliare di spegnerlo indiscriminatamente per ridurre il costo. I parametri supportati e il loro effetto devono essere verificati per il modello, la piattaforma e il percorso API utilizzati. Specifiche Opus, specifiche Fable.
Conserva la configurazione insieme ai risultati della prova. Se confronti un modello a un’impostazione con un altro configurato diversamente, stai confrontando due sistemi, non soltanto due nomi. Può essere una scelta corretta, purché sia dichiarata e non venga presentata come una graduatoria universale.
La guida ai livelli di ragionamento di Opus 5.5 aiuta a leggere questa variabile. Un maggiore effort non va assunto come sempre necessario o sempre più economico di un cambio di modello. Misura esito, consumo e tempo della configurazione che vuoi davvero adottare.
Un milione di token basta a scegliere il modello?
No. Una finestra da 1M token indica una capacità massima dichiarata, mentre un compito richiede informazioni pertinenti e una risposta verificabile. Aggiungere un archivio intero può includere versioni obsolete, documenti contraddittori e materiale non necessario. Un input più lungo non prova che il risultato sia più corretto.
La progettazione deve stabilire quali fonti usare e come gestire l’assenza di una risposta. Se una procedura è cambiata, il modello deve lavorare sulla versione autorizzata, non dedurla dalla frequenza con cui appare un testo. Mantieni identificazione e data dei documenti quando sono rilevanti al processo.
Finestra di contesto e confronto sviluppa questa distinzione. RAG: cos’è descrive il recupero di materiale pertinente. Nessuna delle due tecniche sostituisce una prova con contraddizioni e informazioni mancanti: una capacità tecnica deve essere collegata al criterio di accettazione del lavoro.
Come preparare un campione che produca una decisione?
Il campione deve rappresentare le categorie del processo e contenere risultati attesi definiti da chi conosce il lavoro. Includi casi ordinari, eccezioni, input incompleti e richieste fuori scope. La quantità dipende dalla variabilità e dal rischio: un numero fisso di esempi non certifica qualsiasi applicazione.
Per ogni caso conserva la risposta di riferimento o il criterio di correttezza. Una classificazione può avere un’etichetta attesa; una sintesi può richiedere la presenza di fatti e l’assenza di aggiunte; un agente può dover completare una sequenza senza azioni fuori permesso. Non usare un’unica metrica per attività con responsabilità diverse.
Se i documenti sono riservati, prepara l’ambiente autorizzato e il dato minimo necessario. Un test sintetico serve a verificare il percorso tecnico, ma non dimostra da solo la qualità sui casi reali. Il report deve distinguere queste due prove. Le scelte di dati e accesso fanno parte del confronto applicativo.
Quali metriche rendono il risultato leggibile?
Misura ciò che decide l’adozione: correttezza dei campi, errori non intercettati, richieste di review, formato utilizzabile, consumo e tempo. Il risultato medio deve essere accompagnato dalle categorie in cui il modello fallisce. Una classe poco frequente può avere conseguenze importanti e richiedere una policy dedicata.
| Aspetto | Prova utile | Domanda decisionale |
|---|---|---|
| Contenuto | Risultato rispetto al criterio atteso | È utilizzabile per il compito? |
| Incertezza | Casi senza dati sufficienti | Segnala il limite invece di inventare? |
| Formato | Validazione della struttura | Il software successivo può leggerlo? |
| Strumenti | Sequenza ed effetti osservati | Rispetta permessi e operazione prevista? |
| Consumo | Chiamate e token effettivi | Il percorso rientra nel budget? |
| Tempo | Attesa osservata nel workflow | L’utente o il processo può aspettare? |
Evita di usare una singola risposta convincente come prova finale. Come leggere i benchmark AI aiuta a interpretare numeri esterni; benchmark dei vendor chiarisce perché un posizionamento commerciale non sostituisce il test del processo.
Come misurare la latenza nel lavoro aziendale?
Il tempo utile dipende dal workflow. In un’interfaccia può contare quanto passa prima di un primo contenuto utilizzabile e quanto prima della risposta completa. In un’elaborazione di documenti contano completamento, code e ritentativi. La descrizione relativa del produttore non fornisce il tempo misurato nella tua applicazione.
Registra le condizioni della prova: lunghezza del prompt, configurazione, strumenti e modalità di esecuzione. Un modello può apparire lento perché aspetta un servizio esterno. Separare tempi del modello e del processo aiuta a capire quale componente richieda una modifica.
Anche un lavoro asincrono ha scadenze e capacità limitata. Non chiamare la latenza irrilevante solo perché nessuno guarda una chat. Un’importazione deve finire in un tempo accettabile per il processo; un report deve essere pronto quando serve. La scelta del candidato deve rispettare questi requisiti, senza assumere un ordine universale dei modelli.
Come leggere il costo senza confonderlo con la qualità?
Le tariffe attuali sono un dato del confronto, ma il consumo dipende da input, output, ragionamento, cache, tool e chiamate ripetute. Per Haiku la soglia oltre 100K token di prompt cambia fascia. Un modello economico nel listino può richiedere più passaggi; uno più costoso può comunque non soddisfare il criterio.
Il costo per compito accettato somma il percorso realmente eseguito e lo mette in relazione ai risultati validi. Mantieni distinta la revisione umana, misurandola invece di dichiararla automaticamente dominante. Gli errori rilevanti devono essere classificati secondo le conseguenze del processo.
La pagina prezzi Claude a confronto contiene un conto con ipotesi esplicite. Questa guida non trasferisce quel conto a un cliente: volume e conteggi di token devono appartenere all’applicazione. La scelta economica deve poter essere ricostruita dai dati della prova, non da un rapporto fra tariffe.
Un router con due modelli conserva la qualità automaticamente?
No. Un router decide quale percorso assegnare a un caso e può sbagliare. Il criterio di instradamento deve essere verificato soprattutto sui casi ambigui. La sicurezza dichiarata dal modello non è una probabilità calibrata da usare senza prova: un caso errato ma espresso con sicurezza può restare al primo livello.
Distingui instradamento diretto e seconda chiamata dopo un primo tentativo. Nel primo percorso ogni richiesta usa un candidato selezionato; nel secondo una parte dei casi somma consumo del primo e del secondo. Un classificatore dedicato introduce altre operazioni. La strategia a modello misto richiede questo conteggio e una misura dei risultati chiusi da ciascun ramo.
Controlla anche i casi esclusi dalla review, non soltanto quelli inoltrati. Se osservi solo i casi difficili già riconosciuti, non vedi gli errori che il router ha lasciato passare. Un sistema a più modelli è una nuova configurazione da valutare, non una garanzia ricavata dal catalogo.
Come cambia il confronto quando Claude usa strumenti?
Un agente deve scegliere operazioni, interpretare risultati e gestire errori. Valuta l’azione effettuata, non soltanto la qualità della spiegazione. Un tool può avere effetti sul filesystem o su un sistema esterno; il modello deve rispettare il perimetro del compito e il processo deve imporre i permessi necessari.
Le Mods di Claude personalizzano l’ambiente e possono intervenire su eventi o interfaccia. I Claude Code Hooks collegano eventi a controlli. Questi componenti possono rendere il workflow più osservabile, ma non certificano automaticamente il modello né sostituiscono la validazione del software.
Per un controllo preventivo, PreToolUse ha una responsabilità diversa da una review dopo l’azione. Durante le prove usa sistemi sintetici o separati e impedisci effetti sui dati reali. Il confronto deve poter osservare anche una decisione rifiutata e un servizio non disponibile.
Che cosa verificare prima di cambiare API ID?
Controlla parametri accettati, schema delle risposte, streaming, strumenti e trattamento dei blocchi di ragionamento. La scheda Opus 5.5 segnala cambiamenti incompatibili rispetto a Opus 5, fra cui thinking sempre attivo e limiti al forced tool use. Non trasformare una migrazione in una sola sostituzione di stringa. Migrazione e specifiche Opus.
Il software deve validare gli output secondo il proprio contratto. Se cambia il formato atteso, un risultato semanticamente corretto può essere inutilizzabile dalla fase successiva. Se cambiano i blocchi restituiti fra tool call, anche un’interfaccia di avanzamento può comportarsi diversamente. Questi sono casi di compatibilità da provare prima del traffico reale.
Conserva un punto di configurazione chiaro per modello e parametri, insieme ai test pertinenti. Una configurazione centralizzata rende il cambiamento governabile; non garantisce un tempo universale di ripristino. La via di ritorno deve essere provata con il software che la userà.
Come fare una migrazione osservabile e reversibile?
Definisci quali criteri devono essere soddisfatti prima del passaggio: qualità, formato, consumo, tempo e gestione degli errori. Confronta il nuovo candidato su input autorizzati senza effetti sui sistemi reali. Se esegui due configurazioni sugli stessi casi, conteggia entrambe le chiamate e mantieni separato il risultato destinato all’utente.
Un agente in modalità di confronto non deve duplicare azioni esterne soltanto per produrre due risposte. Gli strumenti che scrivono richiedono un ambiente di prova o un percorso che impedisca effetti. Una valutazione parallela utile conserva input comparabili senza replicare aggiornamenti del gestionale.
Quando il modello nuovo migliora solo alcune categorie
Conserva il risultato per categoria, identifica quali errori rimangono e confronta il costo del percorso. Puoi mantenere la configurazione attuale, cambiare soltanto un modulo o progettare un instradamento dedicato. La decisione deve includere test del nuovo confine e non essere ricavata dalla sola media.
Dopo il passaggio osserva risultati e anomalie secondo la policy del progetto. La guida quando cambiare modello AI approfondisce la decisione. La disponibilità futura di un candidato va verificata nelle comunicazioni del provider, senza dedurla dal numero della versione.
Due percorsi per PMI italiane con esiti da provare
Esempio ipotetico, non testato: un’azienda manifatturiera di Treviso vuole estrarre riferimenti e quantità da ordini di prova. Definisce un formato con campi obbligatori e uno stato di review per righe incomplete. Confronta Haiku e Sonnet su testi ordinari, sigle ambigue e quantità discordanti. Misura campi corretti e casi segnalati, poi valuta il costo del percorso completo. Non sceglie Haiku soltanto per il prezzo né Sonnet soltanto perché più caro.
Esempio ipotetico, non testato: una software house di Napoli prepara un agente che analizza un problema e propone una modifica su un repository separato. Confronta Opus e Fable sulla sequenza, leggendo diff e risultati dei test. Un caso contiene una dipendenza mancante, un altro una richiesta fuori scope. Il criterio include riconoscere l’impedimento e rispettare i permessi, non continuare fino a produrre comunque una modifica.
Il primo percorso richiede un’estrazione strutturata, il secondo una catena con strumenti. I criteri di successo sono diversi. Un’eventuale superiorità osservata in uno non va trasferita automaticamente all’altro, all’italiano in generale o a tutti i clienti dell’azienda.
Quali errori indeboliscono una scelta di modello?
Gli errori principali sono scegliere dal prezzo, dedurre qualità dalla dimensione del contesto, ignorare input anomali, considerare calibrata una confidenza testuale e trascurare la compatibilità degli strumenti. Altri sono cambiare più variabili insieme senza registrarle e valutare soltanto le risposte riuscite.
Non usare moltiplicatori universali di risparmio, durate fisse della prova o promesse di migrazione senza rischi. Il processo può essere reso osservabile e reversibile attraverso configurazione e test; le sue conseguenze vanno comunque valutate. La manutenzione include modello, prompt, dati, tool e controlli.
Mantieni nel report ciò che non è stato verificato. Un test sintetico non è traffico reale; un listino non è una fattura; una raccomandazione del vendor non è una misura indipendente. Questa precisione permette di decidere quali prove mancano senza trasformare il confronto in una conclusione vaga.
Come arrivare a una scelta che il team può mantenere?
La scelta finale dovrebbe indicare compito, configurazione, risultati, costo e limiti. Conserva i casi rappresentativi e riprovali quando cambiano modello, schema o fonti. Una revisione ha senso quando cambiano fatti del processo o condizioni del provider, non perché una classifica suggerisce automaticamente un vincitore.
Se due candidati raggiungono il criterio, valuta consumo, tempo, semplicità del workflow e responsabilità della review. Se nessuno lo raggiunge, rivedi dati e contratto del compito prima di attribuire il problema soltanto alla fascia. Un output più controllato o fonti meglio selezionate possono cambiare il sistema che stai valutando.
Per portare il confronto in un processo interno, la consulenza AI può partire da casi, criteri e prove condivise. Il risultato utile è una decisione spiegabile: il modello scelto svolge un compito definito, nel perimetro stabilito, con risultati verificati e costi che il team può ricostruire.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Prezzi dei modelli Claude: listino e costo del lavoro
 Claude Haiku 5.5: prezzi API e quando usarlo nei processi aziendali
 Claude Opus 5.5: cos'è, cosa cambia e a chi conviene
 I livelli di ragionamento di Claude Opus 5.5: cosa sono e quando alzarli
 Sonnet 5.5 dimezza il costo di lettura cache: quanto cambia la fattura API
 Mods di Claude: cosa sono e quando servono in Claude Code
 Claude Code Hooks: guida pratica in italiano
 Claude Mods API: aggiungere comandi e tool personalizzati
FAQ
Quali modelli Claude confrontare per un progetto attuale?
Il catalogo verificato il 9 ottobre 2026 comprende Haiku 5.5, Sonnet 5.5, Opus 5.5 e Fable 5.1. La scelta dipende dal compito, dai suoi errori rilevanti e dal costo del percorso completo. Le descrizioni del produttore orientano i candidati, ma non dimostrano una graduatoria sul tuo processo.
Quando provare Haiku 5.5?
È un candidato per classificazione, routing ed estrazione, coerentemente con il posizionamento Anthropic. Va provato su input ordinari, ambigui e incompleti. Prezzo e velocità dichiarata non sostituiscono la misura degli esiti accettati.
Che differenza c’è fra Sonnet, Opus e Fable?
Sonnet 5.5 è presentato come equilibrio fra velocità e capacità; Opus 5.5 per coding agentico lungo e lavoro sulla conoscenza; Fable 5.1 per ragionamento impegnativo e workflow agentici lunghi. Sono destinazioni descritte dal vendor. Il confronto utile verifica quali risultati producono sullo stesso contratto di lavoro.
Un milione di token di contesto garantisce risposte corrette?
No. È una capacità dichiarata di input, non una misura di accuratezza su documenti lunghi. Contano selezione delle fonti, informazioni mancanti, contraddizioni e verifica del risultato.
Si può spegnere il ragionamento di Opus e Fable?
Per Opus 5.5 e Fable 5.1 il ragionamento adattivo è sempre attivo secondo le schede ufficiali. Parametri e impostazioni vanno verificati per il modello scelto. Non trasferire una configurazione di un modello a un altro senza una prova di compatibilità.
Come cambiare modello senza perdere controllo del sistema?
Prepara casi con risultati attesi, verifica compatibilità API e confronta qualità, consumo e latenza. Il nuovo modello può essere provato senza effetti sui sistemi reali. La migrazione deve avere criteri di accettazione, monitoraggio e una configurazione precedente ripristinabile.