
Kimi K3.1 Pro benchmark: confronto con gli altri LLM
Kimi K3.1 Pro benchmark: otto prove, sei modelli e quattro grafici su coding, scienza, agenti e CAD. Fonti, configurazioni e limiti del confronto.
I benchmark di Kimi K3.1 Pro mostrano risultati competitivi su coding, agenti e documenti, insieme a differenze nette tra un’attività e l’altra. La raccolta ufficiale non dimostra una superiorità generale su Claude, GPT, DeepSeek o GLM: combina sistemi, strumenti e provenienze differenti. Per scegliere un candidato aziendale bisogna leggere il punteggio insieme alla versione del test e al protocollo.
Questa analisi usa la tabella e le note pubblicate da Kimi, verificate il 24 ottobre 2026. I quattro grafici isolano otto prove e mantengono i sei modelli delle colonne originali. Non abbiamo eseguito i benchmark, effettuato chiamate autenticate né misurato un ritorno economico. I dati sono dichiarazioni pubblicate, non una replica indipendente di Giallo.
Per l’identità e la disponibilità della nuova versione puoi partire da che cos’è Kimi K3.1 Pro. Qui la domanda è più precisa: che cosa raccontano i risultati, quali confronti richiedono cautela e come usarli per disegnare una prova sul proprio lavoro.
In sintesi
- Il confronto comprende Kimi K3.1 Pro, Claude Fable 5.1, GPT-6 Astra, Claude Opus 5.5, DeepSeek e GLM-5.3.
- I grafici separano coding, scienza, agenti e CAD; nessuna media generale combina benchmark differenti.
- Le colonne proprietarie riportano la dicitura con fallback, da conservare quando si leggono i risultati.
- Il dato DeepSeek di Science riguarda una versione precedente rispetto all’intestazione generale.
- BenchCAD misura Voxel IoU; un valore alto non indica la quota di progetti pronti per la produzione.
- Un risultato assente è indicato come N/D e non equivale a zero o a una sconfitta.
Quali dati stiamo confrontando e chi li ha misurati?
La fonte comune dei numeri esposti è la compilazione del produttore. Kimi presenta risultati propri e riprende valori da release e leaderboard per alcuni concorrenti. Questa provenienza permette di ricostruire il confronto pubblicato, ma non trasforma le colonne in un esperimento controllato con gli stessi strumenti, lo stesso tempo e la stessa infrastruttura. Le note ufficiali descrivono le differenze per prova.
Le configurazioni delle colonne sono indicate come max; Claude Fable 5.1, GPT-6 Astra e Claude Opus 5.5 includono inoltre l’etichetta with fallback. La conserviamo nelle tabelle. Non interpretiamo il fallback come un dettaglio irrilevante né come una regola identica in tutti i benchmark: il suo effetto dipende dal protocollo della fonte e dalla gestione dei casi problematici.
Il quadro non include Gemini come concorrente. La presenza di un modello in un ruolo di valutatore dentro un protocollo è diversa dalla presenza come sistema sottoposto a test. Anche K3.1 Pro Highspeed rimane fuori da un confronto sperimentale separato: la tabella del lancio non le assegna una propria colonna di misure. Questi limiti evitano di estendere il dataset oltre ciò che pubblica.
Come leggere punteggi, assenze e differenze tra modelli?
Un benchmark definisce problemi, ambiente e regole di assegnazione del risultato. Il punteggio può descrivere risoluzione di task, accuratezza di risposte oppure somiglianza geometrica. Due valori sulla stessa scala numerica possono quindi rappresentare capacità diverse. Sommarli o farne la media produrrebbe un indice redazionale nuovo, senza una validazione che ne spieghi il significato.
Le tabelle seguono l’ordine delle colonne originali e usano N/D per un valore non riportato. Non assegniamo punteggi ai dati mancanti. Quando due risultati sono vicini, la differenza numerica rimane un’osservazione descrittiva: senza una valutazione appropriata dell’incertezza non dimostra da sola una superiorità stabile. Il sito ufficiale Terminal-Bench, per esempio, presenta i risultati come misure di sistemi modello-agente e include intervalli di confidenza.
Per leggere il divario tra due percentuali si usano i punti percentuali, quando quella è la metrica adottata. Anche una differenza aritmetica corretta non misura però tempo risparmiato, ricavi o quota di un reparto automatizzabile. Per queste conclusioni occorrono dati del processo aziendale, con costi e verifiche che il benchmark non osserva.
Kimi K3.1 Pro come si confronta nel coding?
I primi pannelli mettono affiancate due prove differenti senza creare una classifica unica. Terminal-Bench riguarda compiti operativi in un ambiente terminale; SWE Marathon valuta lavoro software secondo il proprio protocollo. Kimi usa Claude Code per K3.1 Pro in entrambe le prove, mentre i valori degli altri modelli hanno provenienze miste. Le definizioni e i dettagli sono nelle note Kimi, con il riferimento ufficiale di Terminal-Bench.
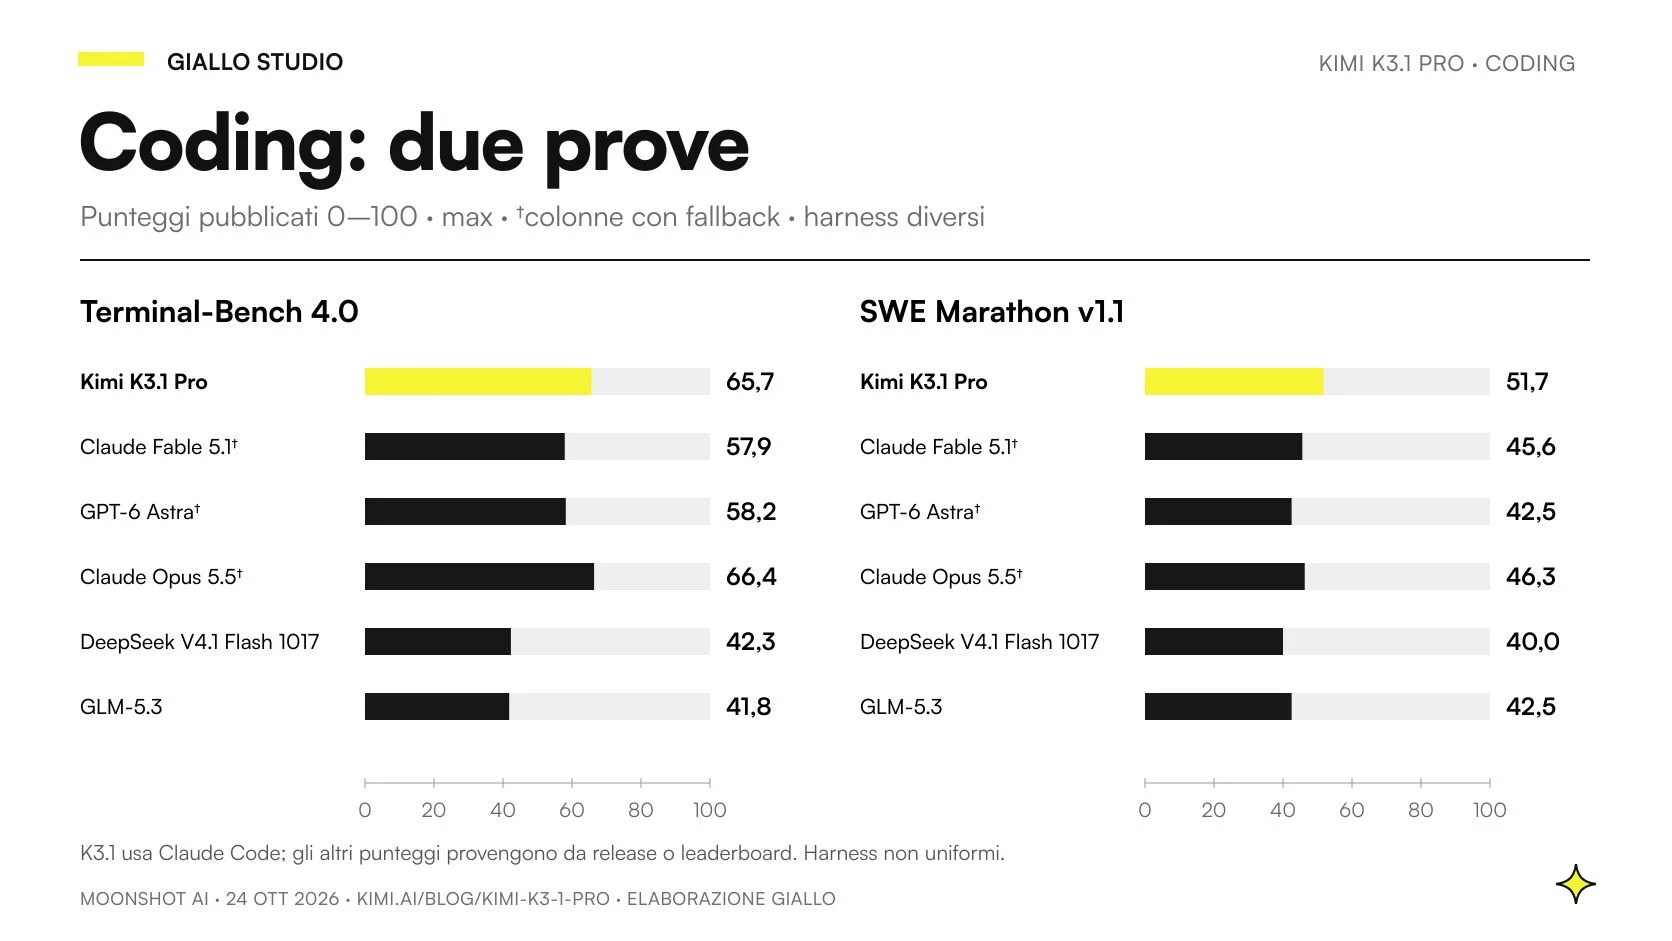
Terminal-Bench 4.0: che cosa significa il 65,7 di Kimi?
| Modello e configurazione pubblicata | Punteggio Terminal-Bench 4.0 |
|---|---|
| Kimi K3.1 Pro — max | 65,7 |
| Claude Fable 5.1 — max, con fallback | 57,9 |
| GPT-6 Astra — max, con fallback | 58,2 |
| Claude Opus 5.5 — max, con fallback | 66,4 |
| DeepSeek-V4.1-Flash-1017 — max | 42,3 |
| GLM-5.3 — max | 41,8 |
In questa fotografia Opus ha il valore più alto, seguito da Kimi. La vicinanza tra i due è interessante per selezionare candidati a una prova, ma non autorizza a considerarli intercambiabili. Terminal-Bench valuta il sistema che affronta i compiti, con strumenti e agente: non soltanto una risposta testuale isolata. Valori e provenienze sono quelli della raccolta Kimi.
Un team che usa una chat senza accesso al repository non sta riproducendo l’ambiente della misura. Lo stesso vale per un’integrazione con strumenti differenti o con un limite operativo più basso. Per avvicinare il benchmark al caso reale bisogna ricostruire quali passaggi il sistema può compiere e quali controlli stabiliscono che il compito sia risolto.
SWE Marathon v1.1: dove cambia l’ordine?
| Modello e configurazione pubblicata | Punteggio SWE Marathon v1.1 |
|---|---|
| Kimi K3.1 Pro — max | 51,7 |
| Claude Fable 5.1 — max, con fallback | 45,6 |
| GPT-6 Astra — max, con fallback | 42,5 |
| Claude Opus 5.5 — max, con fallback | 46,3 |
| DeepSeek-V4.1-Flash-1017 — max | 40,0 |
| GLM-5.3 — max | 42,5 |
Qui Kimi riporta il valore più alto tra le colonne esposte. K3.1 Pro e DeepSeek sono valutati con Claude Code, mentre gli altri numeri sono ripresi dalla leaderboard SWE Marathon secondo le note della pubblicazione. La pagina dinamica della leaderboard non è stata leggibile integralmente nella nostra estrazione: non presentiamo quindi queste righe come una verifica indipendente delle singole misure.
La lettura utile è che il comportamento relativo cambia tra prove di coding. Per un’azienda conta quale attività assomigli davvero alla manutenzione dei propri prodotti, quanto codice il sistema debba esplorare e come vengano accettate le modifiche. La guida K3.1 Pro per coding traduce queste domande in una configurazione e in controlli sul lavoro prodotto.
Nei benchmark scientifici Kimi supera GPT e Claude?
Non nei due pannelli qui riportati. Il primo riguarda workflow scientifici con strumenti; il secondo domande di conoscenza e ragionamento del dataset GPQA-Diamond. La raccolta mostra un vantaggio di Astra su entrambi, con distanze molto diverse. Il sito Terminal-Bench Science descrive la natura dei compiti; i valori usati qui restano quelli della compilazione Kimi.
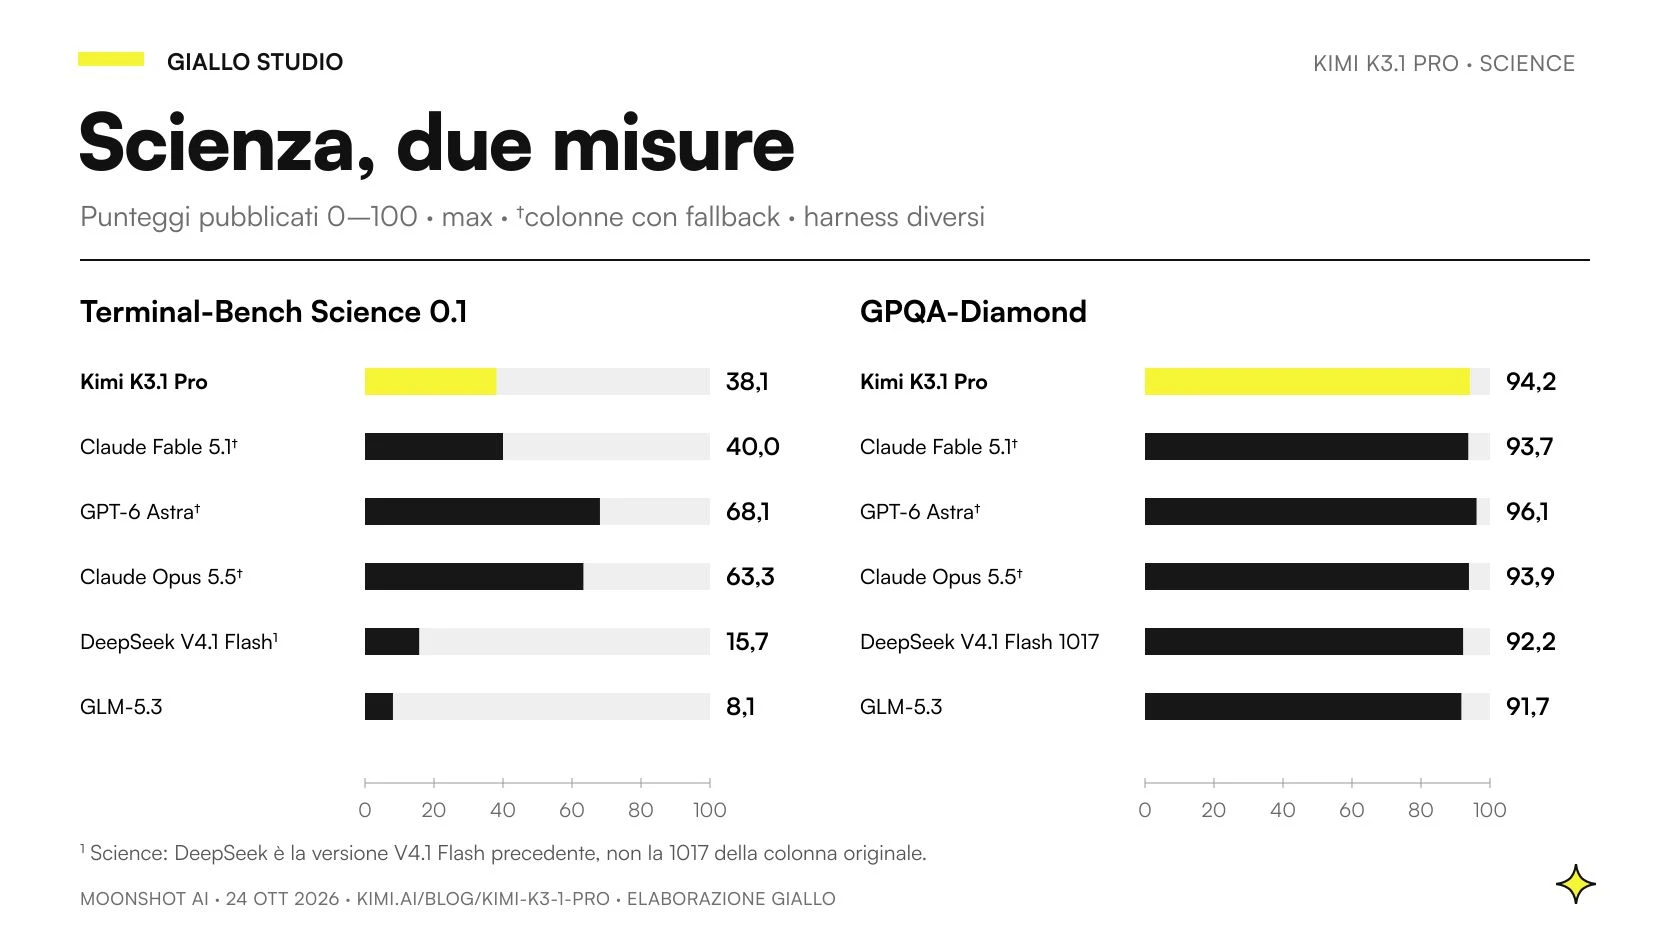
Terminal-Bench Science 0.1 e l’eccezione DeepSeek
| Modello e configurazione pubblicata | Punteggio Terminal-Bench Science 0.1 |
|---|---|
| Kimi K3.1 Pro — max | 38,1 |
| Claude Fable 5.1 — max, con fallback | 40,0 |
| GPT-6 Astra — max, con fallback | 68,1 |
| Claude Opus 5.5 — max, con fallback | 63,3 |
| DeepSeek-V4.1-Flash precedente — max, vedi nota | 15,7 |
| GLM-5.3 — max | 8,1 |
Il 15,7 di DeepSeek appartiene alla precedente V4.1-Flash, non alla variante 1017 dell’intestazione generale. Kimi dichiara di avere ottenuto 9,3 nella propria valutazione della 1017, ma di avere scelto il valore pubblico precedente. Manteniamo la misura esposta e correggiamo il nome della variante nella riga: sostituirlo senza spiegazione altererebbe il confronto. La distinzione è esplicita nelle note ufficiali Kimi.
Questo pannello mostra anche perché non basta selezionare le sole prove favorevoli al modello appena uscito. Se il bisogno riguarda ricerca scientifica operativa, il divario pubblicato merita una verifica specifica. Non significa che una PMI debba scartare Kimi per qualsiasi lavoro tecnico; significa che la pertinenza del compito viene prima della reputazione generale del modello.
GPQA-Diamond: conoscenza avanzata e workflow non coincidono
| Modello e configurazione pubblicata | Punteggio GPQA-Diamond |
|---|---|
| Kimi K3.1 Pro — max | 94,2 |
| Claude Fable 5.1 — max, con fallback | 93,7 |
| GPT-6 Astra — max, con fallback | 96,1 |
| Claude Opus 5.5 — max, con fallback | 93,9 |
| DeepSeek-V4.1-Flash-1017 — max | 92,2 |
| GLM-5.3 — max | 91,7 |
I punteggi sono ravvicinati rispetto alla prova precedente. La tabella non descrive però quanto un assistente sappia cercare un documento interno, usare un programma specialistico o riconoscere un vincolo operativo mancante. Per questa riga la metodologia pubblicata non ricostruisce una parità completa di ambienti e budget; ci atteniamo ai dati della fonte Kimi.
È un promemoria utile per chi lavora in ambito tecnico: una risposta corretta a una domanda avanzata e l’esecuzione di un incarico lungo sono capacità correlate ma distinte. La prova aziendale deve includere il percorso che porta al risultato, oltre alla conoscenza necessaria per spiegarlo.
Come si comporta K3.1 Pro con agenti e documenti?
Agents’ Last Exam e OfficeQA Pro v2 avvicinano l’attenzione al lavoro con software e documenti, pur senza riprodurre i processi di una specifica impresa italiana. La prima prova impiega incarichi operativi; la seconda richiede lavoro su un corpus documentale. Harness, materiali e regole di accettazione restano parte essenziale del confronto. La pubblicazione Kimi ne descrive la configurazione.
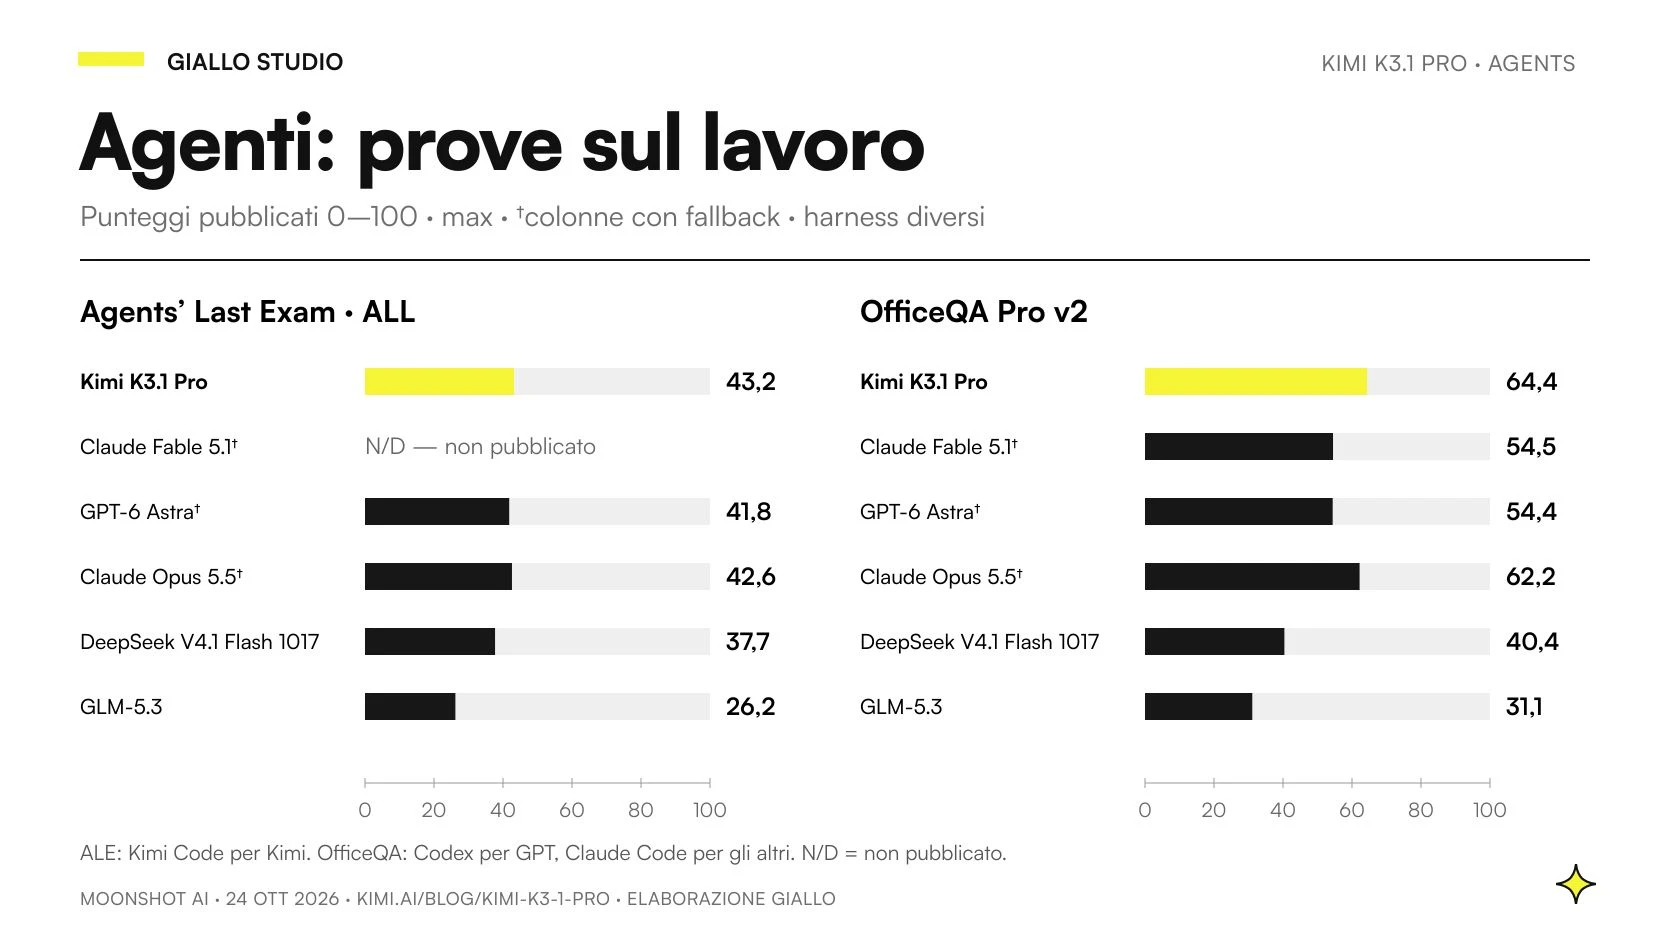
Agents’ Last Exam ALL: che cosa valutano gli incarichi?
| Modello e configurazione pubblicata | Punteggio Agents’ Last Exam ALL |
|---|---|
| Kimi K3.1 Pro — max | 43,2 |
| Claude Fable 5.1 — max, con fallback | N/D |
| GPT-6 Astra — max, con fallback | 41,8 |
| Claude Opus 5.5 — max, con fallback | 42,6 |
| DeepSeek-V4.1-Flash-1017 — max | 37,7 |
| GLM-5.3 — max | 26,2 |
La versione ufficiale ALE v1.1 comprende 122 task attivi, dei quali 86 CLI, secondo il repository Agents’ Last Exam. Kimi dichiara ambienti allineati al rilascio ufficiale e assegna zero ai tentativi che aggirano le istruzioni, per esempio recuperando una risposta invece di eseguire l’analisi richiesta. K3.1 Pro usa Kimi Code; DeepSeek usa Claude Code. Queste scelte sono nelle note Kimi.
Kimi ha il valore maggiore tra quelli riportati, ma il risultato Fable non è pubblicato. L’assenza impedisce un confronto completo su questa riga. Per una PMI il punto interessante è un altro: un agente deve rispettare il percorso richiesto e i limiti dell’incarico. Arrivare a un testo plausibile attraverso una scorciatoia vietata può essere un fallimento del processo.
OfficeQA Pro v2: perché conta la preparazione dei PDF?
| Modello e configurazione pubblicata | Punteggio OfficeQA Pro v2 |
|---|---|
| Kimi K3.1 Pro — max | 64,4 |
| Claude Fable 5.1 — max, con fallback | 54,5 |
| GPT-6 Astra — max, con fallback | 54,4 |
| Claude Opus 5.5 — max, con fallback | 62,2 |
| DeepSeek-V4.1-Flash-1017 — max | 40,4 |
| GLM-5.3 — max | 31,1 |
Kimi descrive una valutazione nella quale l’intero corpus PDF viene reso come immagini senza testo leggibile dalla macchina. Astra usa Codex e gli altri modelli Claude Code. I tentativi che recuperano online le risposte di riferimento ricevono zero, secondo la metodologia ufficiale Kimi. Sono condizioni più precise della semplice frase “legge bene i documenti”.
In azienda il risultato suggerisce un candidato per prove con scansioni e materiali visivi. Non dimostra una conoscenza del proprio archivio, né la correttezza di tutte le citazioni. Occorre verificare il collegamento tra risposta, pagina e dato estratto. La guida agli agenti multimodali K3.1 Pro affronta questo passaggio dal benchmark al sistema operativo.
Che cosa misura davvero il confronto BenchCAD?
BenchCAD valuta ricostruzioni geometriche, con e senza strumenti. La metrica esposta è Voxel IoU, cioè una misura della sovrapposizione tra volumi rappresentati tramite voxel. Il punteggio percentuale esprime somiglianza geometrica secondo la pipeline, non quota di progetti completati, conformità tecnica o sicurezza per l’impiego industriale. I dettagli sono nel protocollo BenchCAD riportato da Kimi.
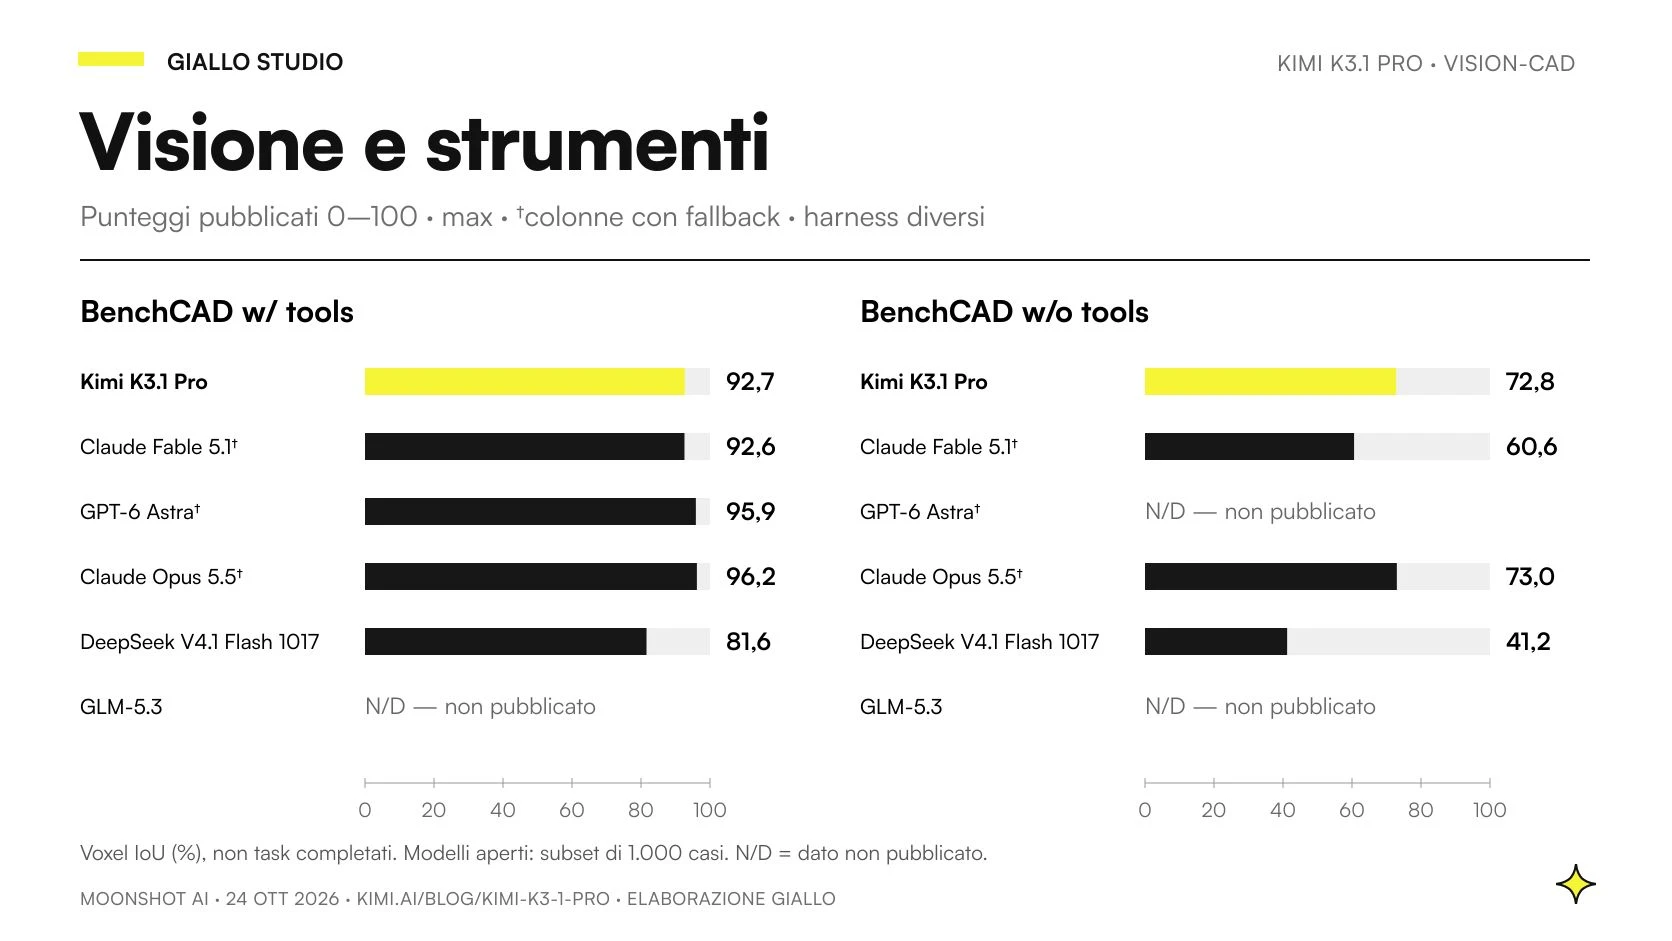
BenchCAD con strumenti: perché non basta il nome del modello?
| Modello e configurazione pubblicata | Voxel IoU con strumenti (%) |
|---|---|
| Kimi K3.1 Pro — max | 92,7 |
| Claude Fable 5.1 — max, con fallback | 92,6 |
| GPT-6 Astra — max, con fallback | 95,9 |
| Claude Opus 5.5 — max, con fallback | 96,2 |
| DeepSeek-V4.1-Flash-1017 — max | 81,6 |
| GLM-5.3 — max | N/D |
Il protocollo Kimi per i modelli aperti usa un sottoinsieme casuale di 1.000 casi tratto dai 17900 di Vision2Code. Nel pannello con strumenti impiega Claude Code; i valori Claude provengono dalla pubblicazione Opus e quello Astra dal rapporto OpenAI, come chiariscono le note Kimi. Per questo anche i campioni e le provenienze vanno tenuti visibili.
Un workflow con strumenti può permettere di esaminare e correggere il risultato intermedio. Il punteggio finale descrive il sistema in quella modalità. Non è corretto attribuirlo a una singola risposta ottenuta senza gli stessi strumenti, né trattare una piccola distanza tra due valori come una garanzia sulla qualità del prossimo disegno aziendale.
BenchCAD senza strumenti: che cosa resta confrontabile?
| Modello e configurazione pubblicata | Voxel IoU senza strumenti (%) |
|---|---|
| Kimi K3.1 Pro — max | 72,8 |
| Claude Fable 5.1 — max, con fallback | 60,6 |
| GPT-6 Astra — max, con fallback | N/D |
| Claude Opus 5.5 — max, con fallback | 73,0 |
| DeepSeek-V4.1-Flash-1017 — max | 41,2 |
| GLM-5.3 — max | N/D |
La modalità senza strumenti usa una generazione singola con prompt e pipeline ufficiali per le valutazioni descritte da Kimi. Astra e GLM non hanno un valore esposto in questo pannello. La fonte permette quindi di confrontare soltanto i risultati presenti, senza ricavare una classifica completa dei sei modelli.
La distanza tra modalità con e senza strumenti ricorda quanto conti la progettazione del sistema. Non permette però di calcolare automaticamente il beneficio degli strumenti su tutti i modelli: le righe non costituiscono un esperimento uniforme isolato. In un ufficio tecnico la verifica deve includere requisiti, vincoli e controlli che la somiglianza geometrica non rappresenta.
Perché alcuni numeri differiscono dalle release degli altri produttori?
Le pubblicazioni possono usare snapshot, harness o criteri di selezione differenti. Kimi riporta per Astra 58,2 su Terminal-Bench 4.0 e 68,1 su Science; la release OpenAI GPT-6 Astra consultata presenta rispettivamente 57,9 e 64,6. Conserviamo i valori della compilazione Kimi nei grafici, dichiarando questa differenza invece di mescolare le raccolte.
Scegliere per ogni modello il numero preferito da una pubblicazione diversa può costruire un confronto mai eseguito da nessuno. Il lavoro editoriale corretto mantiene una fotografia identificabile e spiega dove non coincide con altre fonti. Quando un protocollo non è sufficientemente documentato, la conclusione deve rimanere limitata a ciò che si può osservare.
Quali risultati impediscono di dichiarare un vincitore universale?
Anche fuori dagli otto pannelli selezionati esistono risultati meno favorevoli a Kimi. Nel Program Bench con scoring binario la tabella pubblica 31,5 per K3.1 Pro, 50,0 per Astra e 65,0 per Opus. Kimi assegna successo soltanto quando il punteggio originale del task raggiunge la soglia del 95%: questi valori non sono il punteggio ProgramBench originale. Fonte e regola sono nella pubblicazione Kimi.
La selezione dei grafici serve a rendere leggibili famiglie di compiti, non a nascondere le prove sfavorevoli. Cambiando attività o criterio di successo può cambiare l’ordine. Per un’impresa è più utile sapere dove il candidato deve essere messo alla prova che ricevere un verdetto generale ricavato da un aggregato arbitrario.
Primo scenario ipotetico: confrontare due assistenti per il software
Una software house italiana mantiene un gestionale con regole operative specifiche. Vuole capire se un nuovo modello aiuti a risolvere segnalazioni senza introdurre modifiche estranee. Terminal-Bench e SWE Marathon suggeriscono un’area da investigare, ma non misurano quel repository. Lo scenario è ipotetico e non descrive un test effettuato da Giallo.
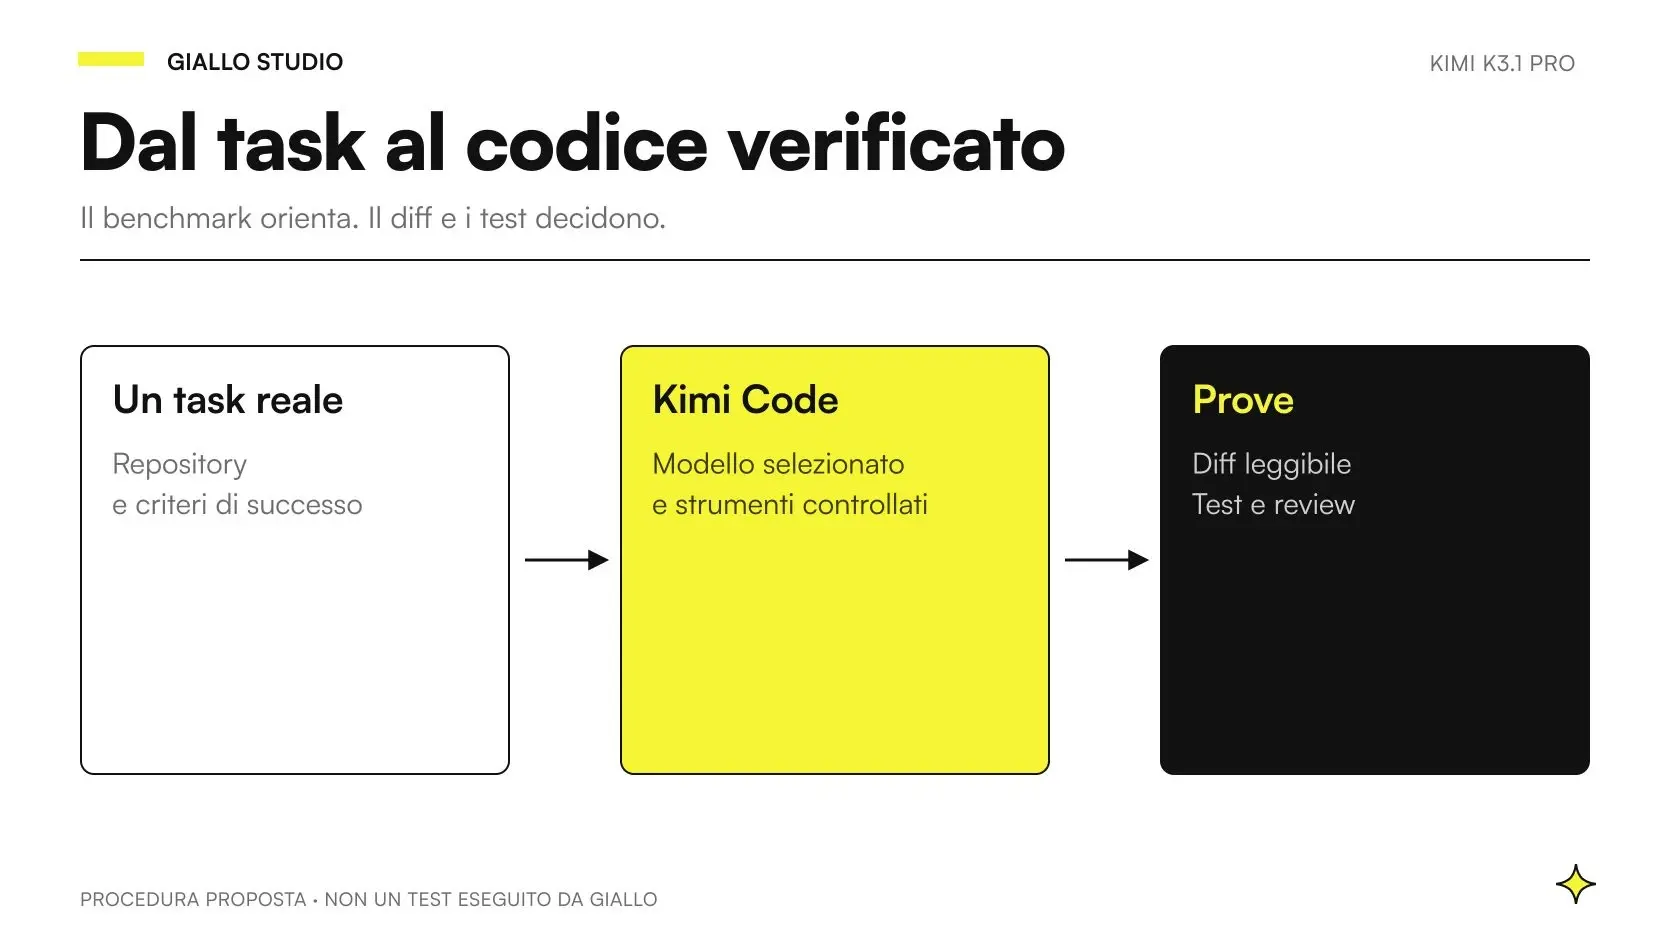
Il team può scegliere difetti già conosciuti, predisporre un ambiente isolato e fornire a entrambi i candidati gli stessi materiali. I criteri di accettazione precedono la prova: riprodurre il comportamento, proporre una correzione circoscritta e mostrare una verifica pertinente. Se il sistema cambia requisiti o elimina un controllo per ottenere un risultato verde, il task non deve essere considerato risolto.
La valutazione registra anche l’intervento umano necessario e i tentativi non accettati. Il punteggio del benchmark aiuta a decidere quali candidati invitare alla prova; la scelta finale dipende dalle modifiche che il team è disposto ad approvare. Se stai già usando K3, la guida alla migrazione K3.1 Pro permette di organizzare il confronto con un riferimento esistente.
Secondo scenario ipotetico: verificare informazioni in un archivio PDF
Un ufficio commerciale prepara schede interne a partire da capitolati, allegati e revisioni ricevute. I risultati OfficeQA rendono interessante una valutazione con documenti visivi, ma non dimostrano che il modello sappia distinguere ogni versione del materiale aziendale. Anche questo è uno scenario progettuale, senza percentuali di successo o risparmio attribuite al prodotto.
Un campione utile comprende una richiesta semplice, documenti con informazioni contrastanti e un caso dove il dato cercato manca. La risposta accettabile indica il documento e il passaggio che sostengono ogni punto importante. Quando le fonti non permettono una conclusione, deve lasciare la domanda aperta. La capacità di fermarsi è parte della qualità, non una risposta da penalizzare perché meno completa.
Il referente verifica correttezza, collegamenti alle fonti e lavoro necessario per arrivare alla scheda accettata. L’eventuale invio al cliente rimane un passaggio distinto. In questo modo il test misura il bisogno reale dell’ufficio e rende visibili errori che un punteggio generale su documenti non potrebbe descrivere.
Come preparare una valutazione aziendale ripetibile?
Definisci prima il risultato accettabile e conserva una versione fissa del campione. Annota canale, modello, effort, strumenti e istruzioni usati. Il default dell’API Kimi è max, mentre Kimi Code indica high nella configurazione dettagliata: per una prova confrontabile l’impostazione va resa esplicita, secondo API quickstart e documentazione Code.
Una scheda minima per leggere ogni risultato
Incarico: descrivi l’ingresso, l’uscita richiesta e i vincoli che non possono essere aggirati.
Sistema: conserva modello, variante, canale, effort, strumenti, istruzioni e versione dei materiali.
Accettazione: registra il controllo che dimostra la correttezza e gli errori che rendono il risultato inutilizzabile.
Costo completo: osserva consumi, strumenti, attese, tentativi e revisione umana fino al risultato accettato.
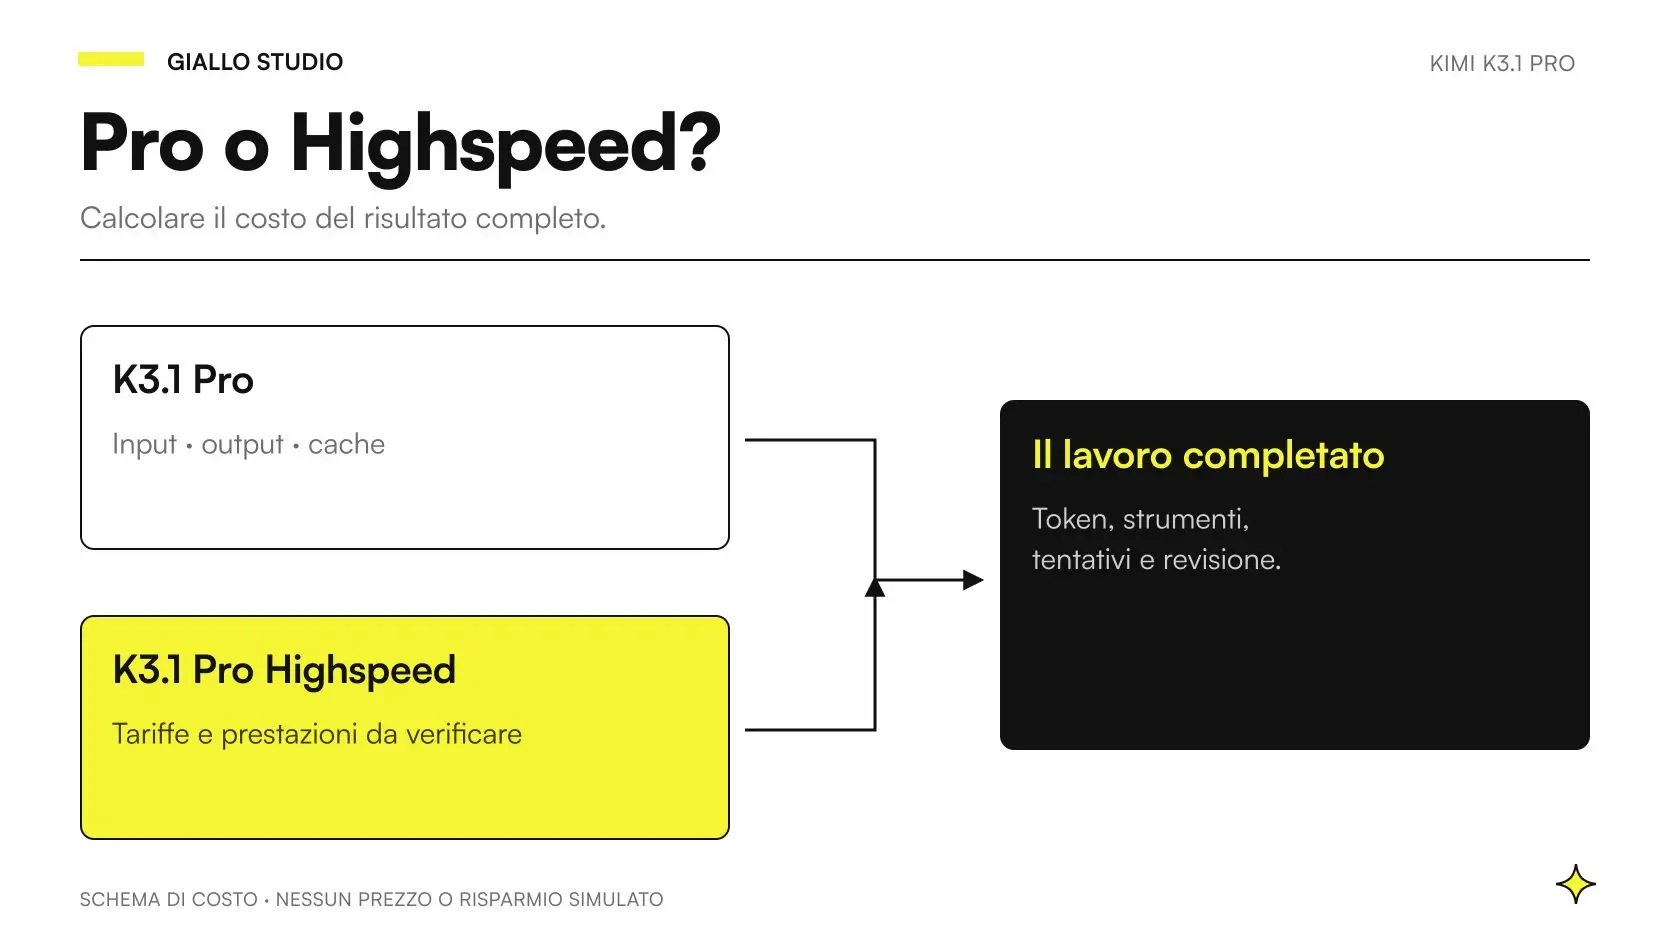
Per il costo consulta prezzi e API K3.1 Pro, mantenendo separati il listino e il consumo osservato. Un modello meno costoso per token può richiedere più tentativi; uno più rapido può lasciare più lavoro al revisore. Senza osservare il risultato accettato, il confronto economico rimane incompleto.
Quali errori rendono inutile un confronto tra LLM?
Il primo è trasformare N/D in zero, producendo una classifica che penalizza un modello senza una misura. Il secondo è dimenticare la variante DeepSeek di Science o l’etichetta con fallback delle colonne proprietarie. Il terzo è sommare metriche diverse, come punteggi di task e Voxel IoU, solo perché entrambe possono apparire su una scala da zero a cento.
Il quarto errore è confrontare configurazioni differenti senza annotarle, attribuendo al modello il vantaggio di strumenti o budget aggiuntivi. Il quinto è dedurre produttività e ritorno economico da una prova pubblica che non misura quel processo. La correzione comune è conservare contesto, protocollo e criterio di accettazione accanto al numero.
Quale decisione prendere dopo aver letto i grafici?
I dati aiutano a scegliere prove pertinenti: manutenzione software, incarichi con strumenti, documenti visivi e ricostruzione geometrica richiedono verifiche diverse. K3.1 Pro merita attenzione in più di una di queste aree, ma i limiti della raccolta rimangono parte della decisione. Il passo utile è una valutazione piccola, ripetibile e capace di registrare anche risultati non accettabili.
Per capire il prodotto oltre i numeri torna alla guida Kimi K3.1 Pro. Se vuoi passare dalle classifiche a un campione che rispecchi documenti, strumenti e controlli della tua impresa, possiamo progettare una valutazione AI sul processo aziendale.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Kimi K3.1 Pro: cos’è, cosa cambia e quando usarlo
 Kimi K3.1 Pro: prezzi API, cache e budget per le PMI
 Kimi K3.1 Pro per coding: configurazione e prove utili
 Kimi K3.1 Pro: agenti multimodali per processi aziendali
 Kimi K3.1 Pro vs K3: differenze e migrazione verificabile
 Gemini 4 Argon benchmark: come leggere il confronto LLM
 Modelli AI: guida ai principali modelli
FAQ
Kimi K3.1 Pro è il migliore in tutti i benchmark?
No. Nella raccolta Kimi verificata il 24 ottobre 2026 guida alcuni confronti mostrati, come SWE Marathon v1.1 e OfficeQA Pro v2, ma resta sotto altri modelli su Terminal-Bench Science 0.1 e BenchCAD con strumenti. Le configurazioni non sono uniformi e non permettono di dichiarare un vincitore generale.
Quali modelli compaiono nel confronto ufficiale K3.1 Pro?
Le colonne confrontano Kimi K3.1 Pro, Claude Fable 5.1, GPT-6 Astra, Claude Opus 5.5, DeepSeek-V4.1-Flash-1017 e GLM-5.3. La riga Science usa però un risultato della precedente DeepSeek-V4.1-Flash, come precisano le note. Gemini non è una colonna concorrente della tabella.
Il 92,7 di Kimi su BenchCAD significa 92,7% di progetti corretti?
No. La metrica è Voxel IoU, espressa in percentuale: misura la sovrapposizione geometrica tra la ricostruzione e il riferimento. Non equivale alla quota di task superati, alla correttezza tecnica completa o all’idoneità del progetto per la produzione.
Perché DeepSeek ha una nota speciale su Terminal-Bench Science?
Il 15,7 esposto da Kimi proviene dalla precedente DeepSeek-V4.1-Flash, non dalla variante 1017 indicata nell’intestazione generale. Kimi dichiara 9,3 per una propria valutazione della 1017, ma sceglie di riportare il valore pubblico precedente. L’articolo rende visibile questa differenza.
N/D in una tabella significa che il modello ha ottenuto zero?
No. Significa che il risultato non è pubblicato nella raccolta utilizzata. Il dato assente non permette di stabilire una posizione relativa e non va trasformato in una barra con valore zero.
Questi benchmark misurano anche K3.1 Pro Highspeed?
La tabella del lancio non presenta una colonna separata Highspeed. I numeri riportati riguardano K3.1 Pro nella configurazione pubblicata. L’equivalenza di capacità dichiarata dal produttore non equivale a una replica separata dei benchmark della variante.
Giallo ha eseguito i benchmark e misurato un ROI?
No. L’articolo analizza dati e protocolli pubblicati, consultati il 24 ottobre 2026. Non abbiamo replicato le valutazioni o eseguito prove autenticate del modello. I due scenari aziendali sono esempi ipotetici di come progettare una verifica.