
Gemini 4 Argon benchmark: come leggere il confronto LLM
Gemini 4 Argon benchmark: Vals v2.2, DeepSWE e FrontierSWE con fonti, protocolli e limiti. Come scegliere cosa provare nella tua azienda.
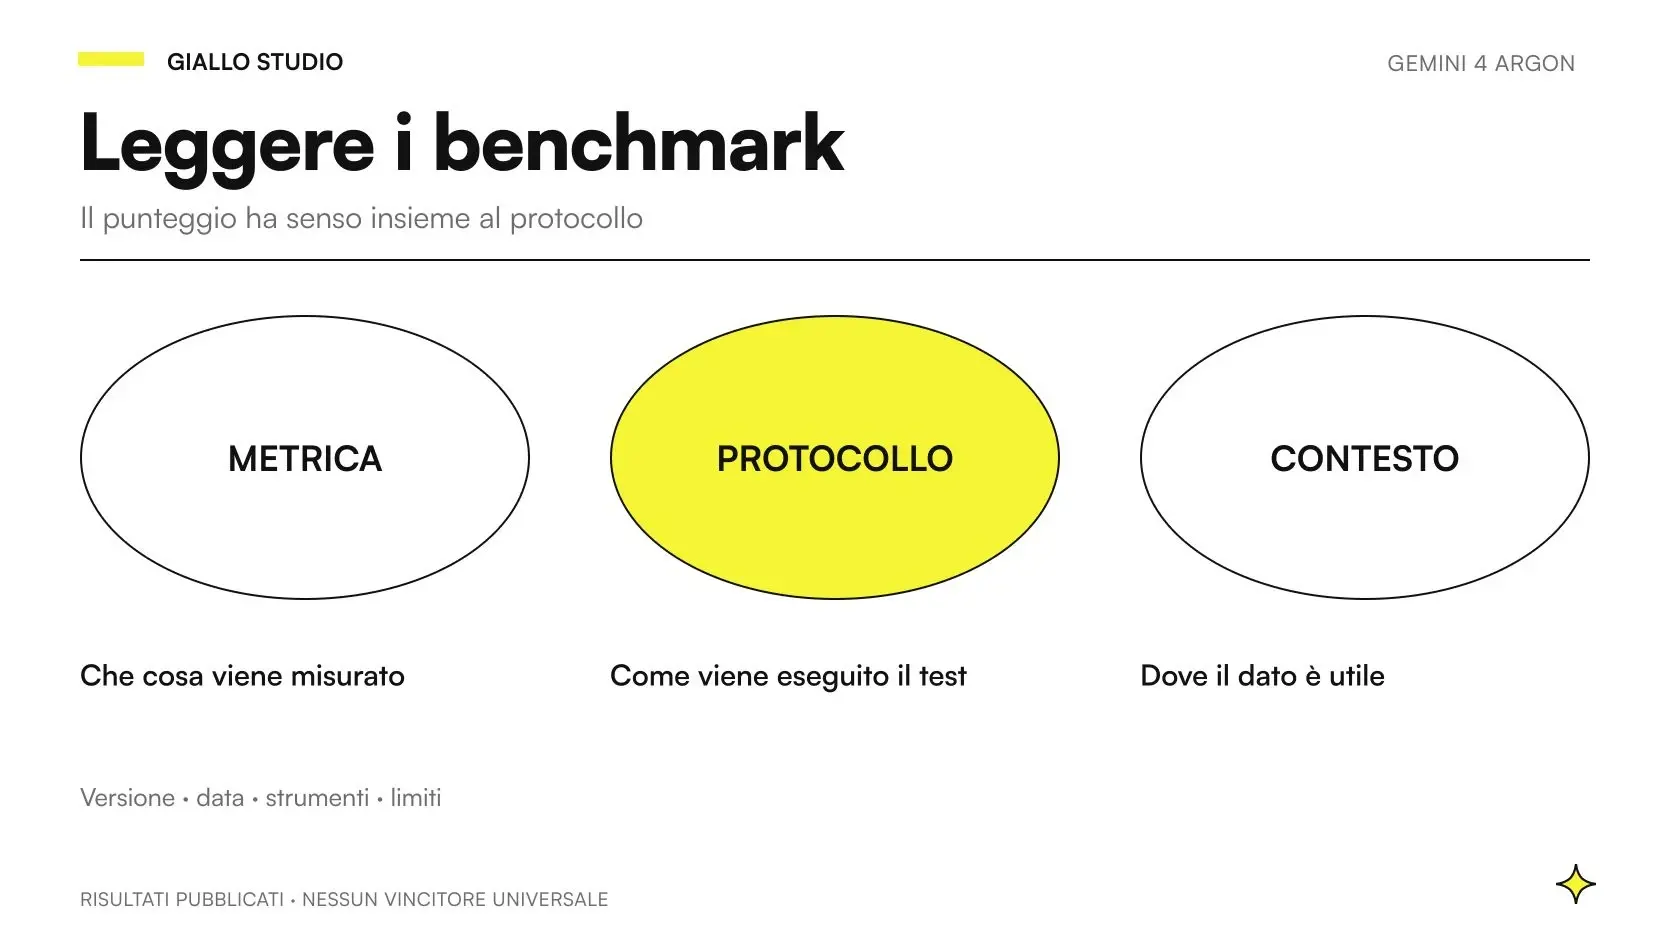
I benchmark di Gemini 4 Argon mostrano punti di forza e limiti diversi per attività: non dimostrano una superiorità generale del modello. Per confrontarlo con GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5 bisogna leggere insieme punteggio, versione del test, strumenti disponibili e origine della misura. Un numero senza queste informazioni permette di costruire una classifica, ma aiuta poco a scegliere un sistema aziendale.
Questo articolo fotografa le fonti disponibili al 23 ottobre 2026. Distingue la raccolta pubblicata da Google nella model card Argon del 13 ottobre dalla leaderboard Vals Index v2.2 aggiornata il 22 ottobre. Non abbiamo eseguito i benchmark o una prova autenticata del prodotto: l'obiettivo è trasformare evidenze pubbliche in domande verificabili sul tuo lavoro.
Per il funzionamento del modello parti dalla guida a Gemini 4 Argon. Qui affrontiamo una decisione più precisa: quali risultati meritano attenzione, quali confronti richiedono cautela e come costruire un campione aziendale che possa confermare o smentire l'utilità del modello.
In sintesi
- Una vittoria su un benchmark vale per quel protocollo, non per ogni attività aziendale.
- La classifica principale Vals v2.2 e la classifica con rifiuti conteggiati come fallimenti danno ordini diversi.
- DeepSWE e FrontierSWE producono risultati diversi e non vanno mediati.
- GraphWalks misura una capacità sintetica di contesto lungo, non la comprensione universale dei documenti.
- Il confronto utile per una PMI include qualità controllata, errori gravi, attese e costo dei risultati accettati.
Che cosa misura un benchmark di un modello AI?
Un benchmark definisce un insieme di problemi e una regola per assegnare punti alle risposte. Può richiedere una risposta breve, una patch software oppure una sequenza di azioni con strumenti. Anche quando il risultato è espresso in percentuale, il significato cambia: accuratezza, successo di un compito e F1 descrivono oggetti diversi.
Il protocollo comprende ciò che circonda il modello: istruzioni, strumenti, memoria della conversazione, budget di ragionamento, timeout e verificatore. Nel coding, per esempio, il sistema che permette di esplorare file ed eseguire test è spesso decisivo. Trasferire il punteggio a una chat senza quegli strumenti significa cambiare l'oggetto che stiamo valutando.
La metodologia Google di Argon, consultata il 23 ottobre, specifica che salvo eccezioni Argon viene valutato pass@1 con il massimo ragionamento disponibile. Molti dati dei concorrenti provengono invece dalle pubblicazioni dei rispettivi fornitori o da leaderboard. Questa raccolta è informativa, ma non equivale a un esperimento unico che controlla ogni variabile nello stesso ambiente.
Quali fonti stiamo confrontando?
È utile distinguere chi produce il modello da chi mantiene il benchmark. La model card Google raccoglie risultati e ne spiega la provenienza; alcune misure sono calcolate da Google, altre riprese da fonti pubbliche. Vals pubblica invece il proprio indice e la relativa metodologia. Nessuna delle due fonti misura direttamente i processi della tua azienda.
| Fonte consultata il 23 ottobre 2026 | Fotografia usata | Provenienza della misura | Limite da ricordare |
|---|---|---|---|
| Model card Google | Tabella etichettata ottobre 2026, pubblicata il 13 ottobre | Raccolta del fornitore, con origini specificate per benchmark | Ambienti e fonti non sono uniformi |
| Metodologia Google | Documento associato ad Argon | Dettagli su harness, input e impostazioni | Le eccezioni possono cambiare la comparabilità |
| Vals Index | Versione 2.2, aggiornata il 22 ottobre | Leaderboard dell'autore del benchmark | Pesi USA e gestione dei fallback influenzano il risultato |
Conservare la data serve anche quando il nome commerciale resta uguale. Un aggiornamento del dataset, del protocollo o di un servizio può cambiare il numero. Non ogni differenza fra due schermate documenta un miglioramento del modello. Prima di interpretarla, verifica che sia rimasto identico ciò che viene misurato.
Gemini 4 Argon è primo nel Vals Index v2.2?
Nella classifica principale Vals v2.2 del 22 ottobre 2026, Argon è dietro Claude Sonnet 5.5 e Claude Opus 5.5. La stessa pagina spiega però che alcuni task Claude vengono serviti con modelli di fallback dopo rifiuti del provider. Se quei casi sono conteggiati come fallimenti, cambia l'ordine. I valori seguenti provengono dall'autore Vals, non da una prova Giallo.
| Modello nella leaderboard | Punteggio principale Vals v2.2 | Rifiuti conteggiati come fallimenti |
|---|---|---|
| Claude Sonnet 5.5 | 70,85% | 69,03% |
| Claude Opus 5.5 | 70,18% | 64,16% |
| Gemini 4 Argon | 69,24% | 69,24% |
| GPT-6 Astra | 65,02% | Dato separato non pubblicato nella tabella qui considerata |
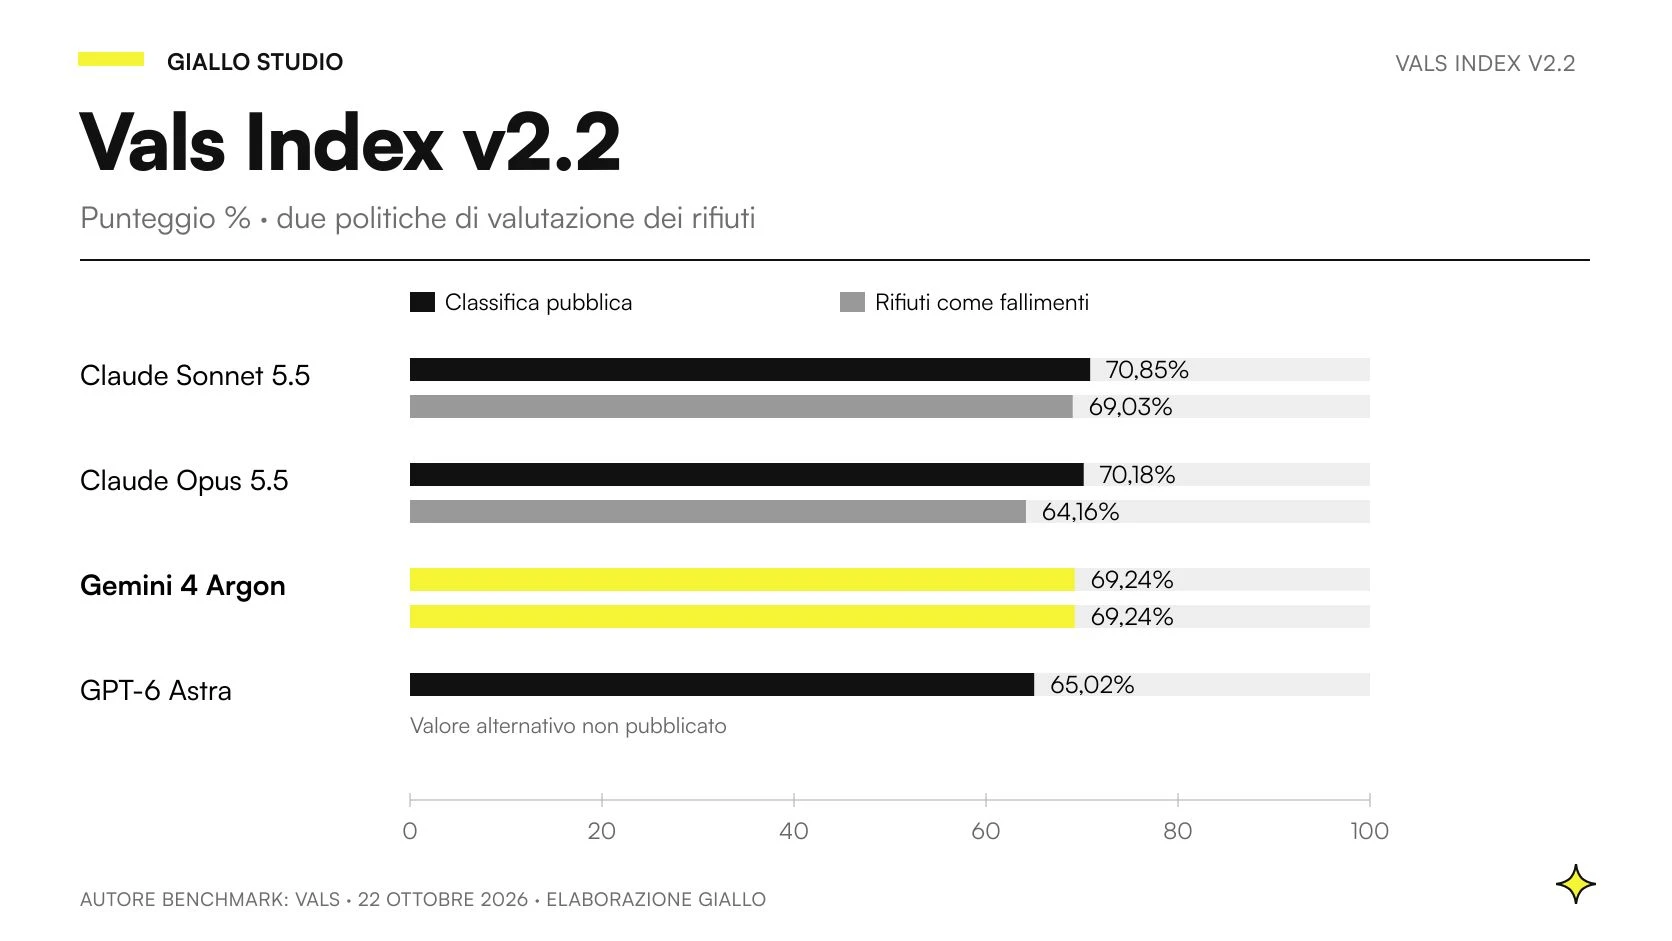
Le due letture rispondono a domande diverse. La classifica principale descrive il servizio secondo il protocollo Vals con i fallback indicati. La seconda rende visibile l'effetto dei rifiuti se non accettiamo quel recupero. Non è corretto scegliere una colonna per sostenere una preferenza e nascondere l'altra. Una PMI può avere bisogno di entrambi gli aspetti: qualità della risposta ottenuta e probabilità che il flusso si interrompa.
Il valore Argon della tabella corrente non va mescolato con il 68,9% della fotografia di lancio nella model card Google. La versione attuale è un oggetto diverso; confrontare quei due numeri come se fossero una crescita misurata sullo stesso test porterebbe a una conclusione non dimostrata.
Perché il Vals Index non è una misura del ROI italiano?
Vals aggrega attività di finanza, sviluppo software, diritto e fisco usando pesi legati alle quote del PIL statunitense. Quella scelta rende esplicita una certa rappresentazione del lavoro economico, ma non riproduce il portafoglio di attività di un'officina lombarda, di uno studio italiano o di un distributore. La fonte e la composizione sono nella pagina Vals Index.
Un indice di accuratezza non include automaticamente integrazione con il gestionale, controllo degli accessi, reperimento delle fonti, revisione umana e conseguenze di un errore. Un risultato corretto può arrivare troppo tardi per il processo; una risposta quasi corretta può richiedere più tempo di una compilazione manuale. Sono grandezze da misurare nel flusso, non da ricavare dalla percentuale della leaderboard.
Anche i costi esposti da una valutazione richiedono una lettura separata. Al 23 ottobre Vals usa per Argon il listino standard di 4 dollari input e 20 dollari output per milione di token, mentre il listino API Google prevede la promozione a 2 e 10 dollari fino al 30 novembre 2026. Non è una contraddizione prestazionale: sono basi economiche differenti. Nella guida ai costi Argon approfondiamo thinking, ritentativi e scadenza delle tariffe.
Che cosa dicono DeepSWE e FrontierSWE sul coding?
Nella raccolta Google di ottobre Argon guida DeepSWE 1.1, mentre GPT-6 Astra guida FrontierSWE v2. Il cambio di ordine è il primo motivo per evitare la frase «migliore AI per programmare» senza specificare la prova. Entrambi i benchmark riguardano attività software, ma non sono la stessa misura. I numeri sono quelli della model card, con i limiti nella metodologia associata.
| Modello | DeepSWE 1.1, successo pass@1 | FrontierSWE v2, successo dei task |
|---|---|---|
| Gemini 4 Argon | 77,9% | 55,0% |
| GPT-6 Astra | 74,1% | 65,5% |
| Claude Fable 5.1 | 67,4% | 56,3% |
| Claude Opus 5.5 | 74,2% | 62,3% |
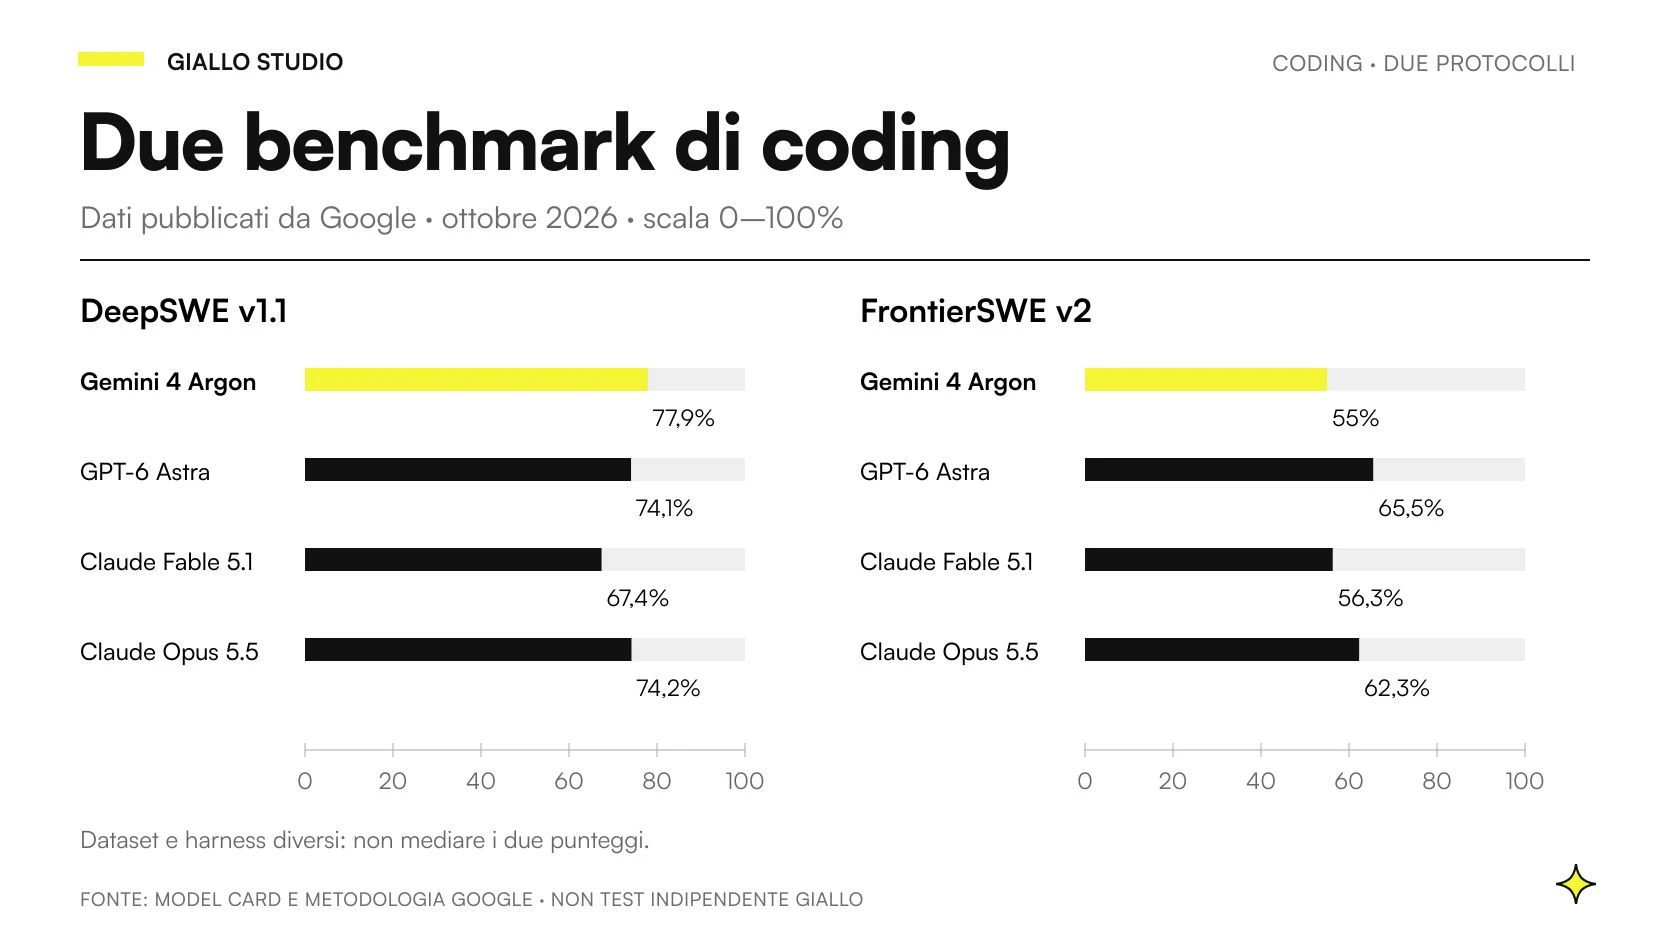
Per DeepSWE, Google calcola Argon con l'harness mini-swe; Astra viene dalla leaderboard pubblica e i dati Claude dalle system card. Per FrontierSWE la metodologia attribuisce i risultati alla leaderboard Proximal. Non abbiamo qui una replica indipendente di ciascuna esecuzione: possiamo riportare le evidenze pubblicate, dichiarando la provenienza.
La scelta pratica è prendere entrambi i segnali sul serio. Argon merita un confronto su repository simili al tuo; Astra e Opus restano candidati credibili quando i problemi assomigliano maggiormente a quelli in cui risultano davanti. Il pezzo su Argon per lo sviluppo software traduce questa lettura in un piano per patch e revisioni.
Un milione di token significa comprensione affidabile?
La capacità del contesto definisce quanto materiale può entrare nella richiesta, non quanto venga utilizzato correttamente. La scheda API Argon indica 1.048.576 token complessivi tra input e output. Quel limite condiviso non promette una lettura infallibile di un archivio, né autorizza a sommare un milione di input a un milione di risposta.
Su GraphWalks, Google valuta problemi sintetici di visita in ampiezza di grafi. Nel sottoinsieme da 256K a 1M token, composto da 200 problemi, riporta F1 84,2 per Argon, 71,8 per Astra, 65,0 per Fable e 66,8 per Opus. Tutti questi valori sono calcolati da Google secondo la metodologia Argon, non misure del numero di documenti aziendali compresi.
| GraphWalks, contesti 256K–1M | BFS F1 riportato da Google |
|---|---|
| Gemini 4 Argon | 84,2 |
| GPT-6 Astra | 71,8 |
| Claude Fable 5.1 | 65,0 |
| Claude Opus 5.5 | 66,8 |
F1 combina aspetti della qualità delle risposte su quella struttura di problema. Non va rinominato «accuratezza PDF». Un capitolato può contenere scansioni, revisioni contraddittorie e tabelle: difficoltà che il grafo sintetico non rappresenta automaticamente. La valutazione RAG e documenti aziendali richiede perciò domande con fonte attesa, documenti mancanti e controlli sui permessi.
Quali confronti è meglio lasciare separati?
Alcuni test sono interessanti ma troppo facili da presentare in modo fuorviante. Su LVBench, per esempio, Google descrive input video con campionamenti diversi fra modelli. Un grafico che nascondesse questa differenza sembrerebbe una prova a parità di informazione. Per OSWorld il dato Argon riguarda un sottoinsieme offline con punteggio parziale, mentre risultati aggregati online e offline hanno un altro perimetro. Queste eccezioni sono documentate nella metodologia Google.
La stessa fonte indica un timeout del verificatore aumentato di sei volte per Argon su Terminal-Bench Science 0.1. Segnalare l'eccezione non annulla il risultato; impedisce però di presentarlo come confronto con un identico budget temporale. Un lettore che deve automatizzare una procedura urgente ha bisogno proprio di sapere quali attese erano ammesse.
Per la correzione di vulnerabilità, la raccolta riporta su CWE-bench v1 un pass@1 del 68% sia per Argon sia per Astra, contro 58% Fable e 67% Opus. La metodologia precisa che il ranking completo può usare pass@4 per gli spareggi. Una parità sul valore mostrato resta una parità su quella metrica, non una certificazione della sicurezza del codice generato.
| CWE-bench v1, raccolta Google di ottobre 2026 | Correzione vulnerabilità pass@1 |
|---|---|
| Gemini 4 Argon | 68% |
| GPT-6 Astra | 68% |
| Claude Fable 5.1 | 58% |
| Claude Opus 5.5 | 67% |
Quali dati servono per rendere verificabile un confronto?
Una scheda di valutazione dovrebbe permettere a un collega di ricostruire cosa è stato chiesto e cosa è stato accettato. Salva l'identificativo del modello, la data, le impostazioni, il set di casi e la regola di giudizio. Se usi strumenti, registra quali erano disponibili e con quali permessi. Se cambi queste condizioni durante la prova, separa i risultati anziché aggiungerli alla stessa media.
Apri la scheda minima per una prova aziendale
- Descrivi il compito e il risultato accettabile prima delle esecuzioni.
- Prepara casi ordinari, eccezioni e casi in cui il sistema deve astenersi.
- Conserva versione del modello, configurazione, strumenti e timeout.
- Separa correttezza dei contenuti, rispetto delle autorizzazioni e qualità del formato.
- Misura costo e attesa anche delle risposte scartate o ritentate.
- Assegna la valutazione a una persona che possa controllare le fonti.
- Registra i cambiamenti di protocollo e ripeti il confronto quando incidono sul processo.
Decidi anche il trattamento dei rifiuti. Una mancata risposta può essere appropriata su una richiesta non autorizzata e un guasto su una domanda lecita. La categoria «fallimento» va definita rispetto al compito. La lezione di Vals è proprio rendere visibile questa politica, senza lasciare che il sistema premi o penalizzi casi diversi con una sola etichetta.
Come valuterebbe Argon un distributore italiano?
Scenario ipotetico: un distributore di ricambi vuole preparare risposte interne su compatibilità e condizioni di vendita. Il campione proposto contiene schede autorizzate, versioni superate e richieste che non trovano risposta nei documenti. Non rappresenta un cliente Giallo e non è stato eseguito: è un modo per collegare le capacità di contesto lungo a un problema controllabile.
Il risultato accettabile deve indicare il codice corretto, citare la versione della scheda e dichiarare quando la compatibilità non è verificabile. Una frase elegante senza fonte viene scartata. Anche un'informazione esatta ma ricavata da un listino riservato a un altro gruppo costituisce un problema, perché qualità e autorizzazione sono requisiti distinti.
Argon e i concorrenti ricevono lo stesso materiale ammesso, lo stesso formato richiesto e possibilità comparabili di recupero. Il revisore annota omissioni, contraddizioni e interventi necessari. Solo dopo questa verifica si misura se il processo riduce il lavoro complessivo. La classifica pubblica serve a scegliere candidati; la prova aziendale decide se uno di essi è utilizzabile.
Come cambierebbe la prova in una software house?
Scenario ipotetico: una piccola software house vuole correggere regressioni su un gestionale. Prepara task chiusi con riproduzione del difetto, criteri di accettazione e test pertinenti. Nessuna credenziale di produzione è necessaria al campione. L'ambiente deve impedire pubblicazioni automatiche: il risultato atteso è una patch revisionabile, non un rilascio autonomo.
Il confronto separa task risolti, patch che introducono regressioni e risposte che si fermano senza completare. Registra anche il tempo del revisore e le richieste di chiarimento. Un modello può produrre più patch che passano i test disponibili, ma costringere il team a controllare modifiche inutilmente ampie: questo costo deve emergere nella valutazione.
Prima di confrontare Argon con un risultato DeepSWE, verifica quali strumenti stai realmente offrendo. Una semplice finestra di chat e un agente che può leggere repository ed eseguire comandi non sono lo stesso prodotto. Il confronto Argon, ChatGPT e Claude chiarisce proprio il passaggio fra modello, applicazione e sistema operativo di lavoro.
Quali errori trasformano i benchmark in una cattiva decisione?
Il primo errore è mescolare versioni: un numero del lancio e uno aggiornato non appartengono automaticamente alla stessa serie storica. Il secondo è nascondere le condizioni che hanno permesso un punteggio: fallback, timeout e strumenti cambiano il servizio osservato. Il terzo è costruire una media unica di F1, accuratezza e successo dei task, assegnandole poi un significato aziendale mai validato.
Un quarto errore è trattare il benchmark come garanzia contrattuale. La model card segnala allucinazioni e limiti: un buon risultato non li elimina. Il quinto è ignorare l'errore grave perché la media sembra buona. Per un preventivo, inventare una condizione economica può pesare più di molte classificazioni corrette; l'azienda deve decidere questa asimmetria prima del test.
Evita infine di cambiare prompt o campione finché vince il candidato preferito. Puoi migliorare il sistema, ma devi distinguere il set usato per svilupparlo dal set usato per giudicarlo. Conservare casi nuovi permette di verificare se il miglioramento supera gli esempi già visti.
Come considerare attese, ritentativi e giudizi incerti?
Il tempo di risposta va letto rispetto al momento in cui serve il risultato. Una classificazione notturna può tollerare attese che interromperebbero un operatore al telefono. Nel protocollo proposto, registra inizio, fine, eventuale timeout e tempo necessario alla revisione. Non confrontare soltanto la migliore esecuzione: conserva anche i casi interrotti, perché fanno parte dell'esperienza operativa.
Un ritentativo può recuperare una risposta, ma consuma risorse e cambia il metodo. Stabilisci prima se è ammesso, con quali istruzioni e quante volte. Se un candidato riceve informazioni aggiuntive durante il recupero, segnalo separatamente dal confronto iniziale. Questo rende leggibile la differenza fra qualità della prima risposta e affidabilità del sistema completo.
Anche il giudizio umano può essere incerto. Una risposta potrebbe essere corretta secondo una procedura interna e sbagliata secondo un documento non aggiornato. Invece di costringere il revisore a scegliere subito, conserva la categoria «da chiarire» e assegna il caso al responsabile della fonte. Il risultato rivela allora un problema dell'archivio, non necessariamente del modello. Risolvere queste contraddizioni prima dell'automazione migliora il processo anche se alla fine scegli di mantenere il lavoro manuale.
Da quale decisione aziendale conviene partire?
Parti da una domanda che possa ricevere una risposta operativa: «Questo sistema prepara una bozza controllabile con meno lavoro totale?» è più utile di «Quale modello è più intelligente?». Scegli il processo, fissa i requisiti e usa i benchmark per costruire una rosa di candidati. Il percorso di migrazione e valutazione Argon aiuta a formalizzare il passaggio senza sostituire tutto in una volta.
Se devi decidere un esperimento, porta una raccolta ripulita di casi e l'elenco degli errori che bloccherebbero l'uso. Con una consulenza AI di Giallo possiamo trasformare quei materiali in un confronto ripetibile, con fonti, criteri di accettazione e costi del processo visibili prima dell'estensione ai dati reali.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Gemini 4 Argon: cos’è, cosa fa e quando usarlo in azienda
 Gemini 4 Argon vs ChatGPT e Claude: quale scegliere
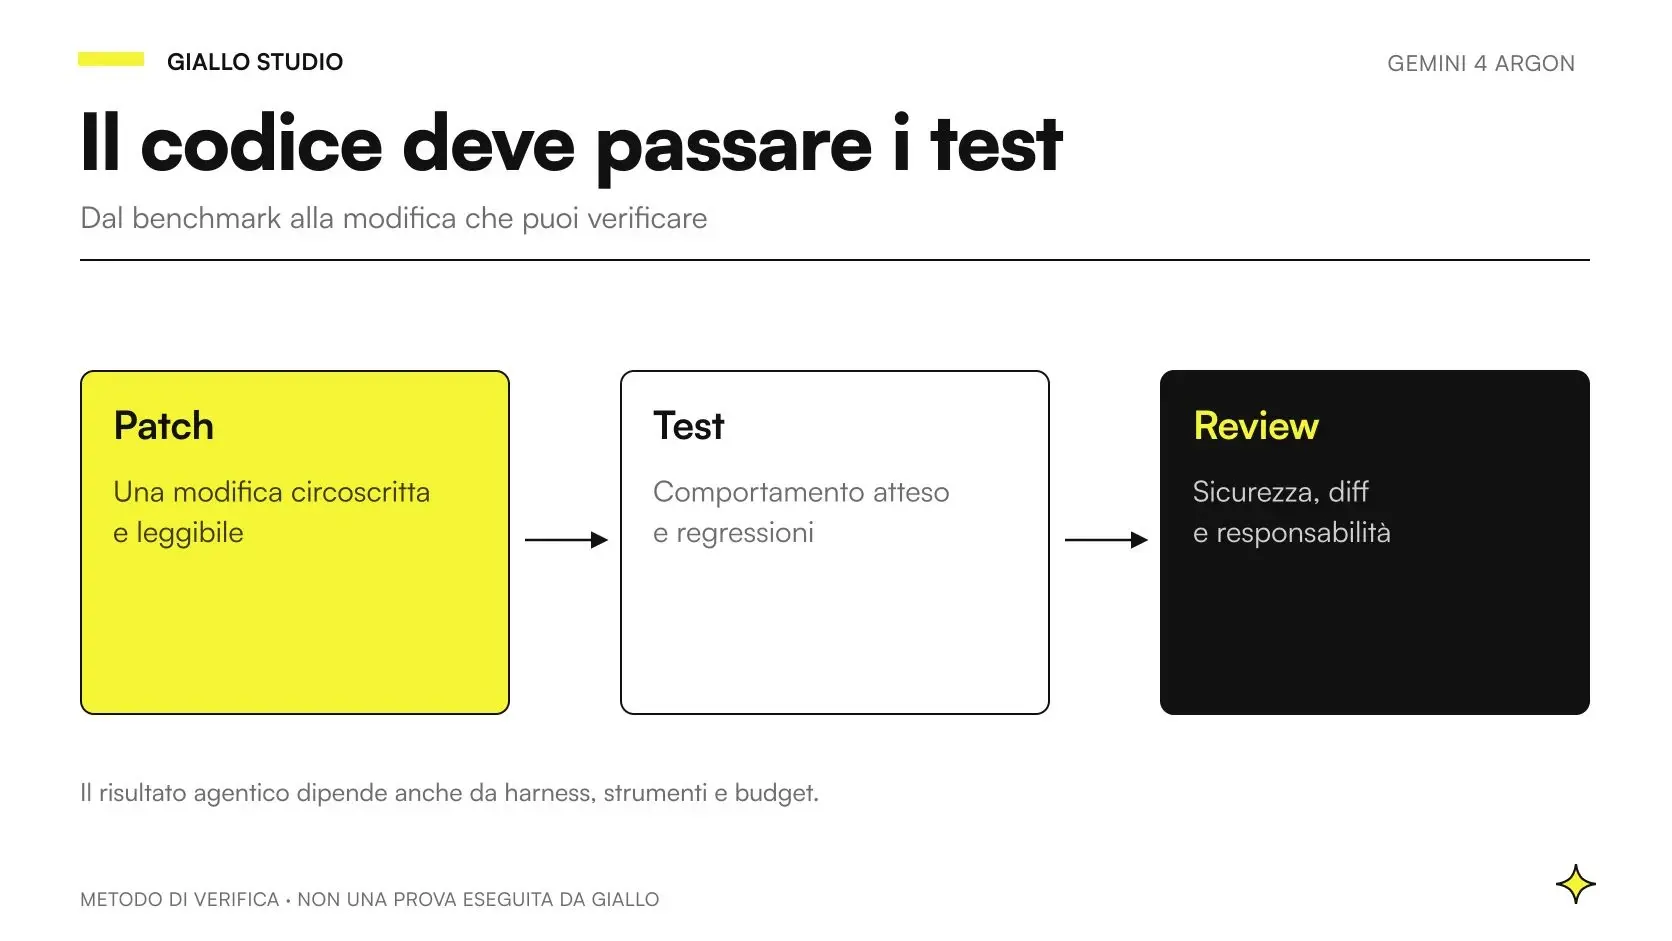 Gemini 4 Argon coding: come valutarlo nello sviluppo software
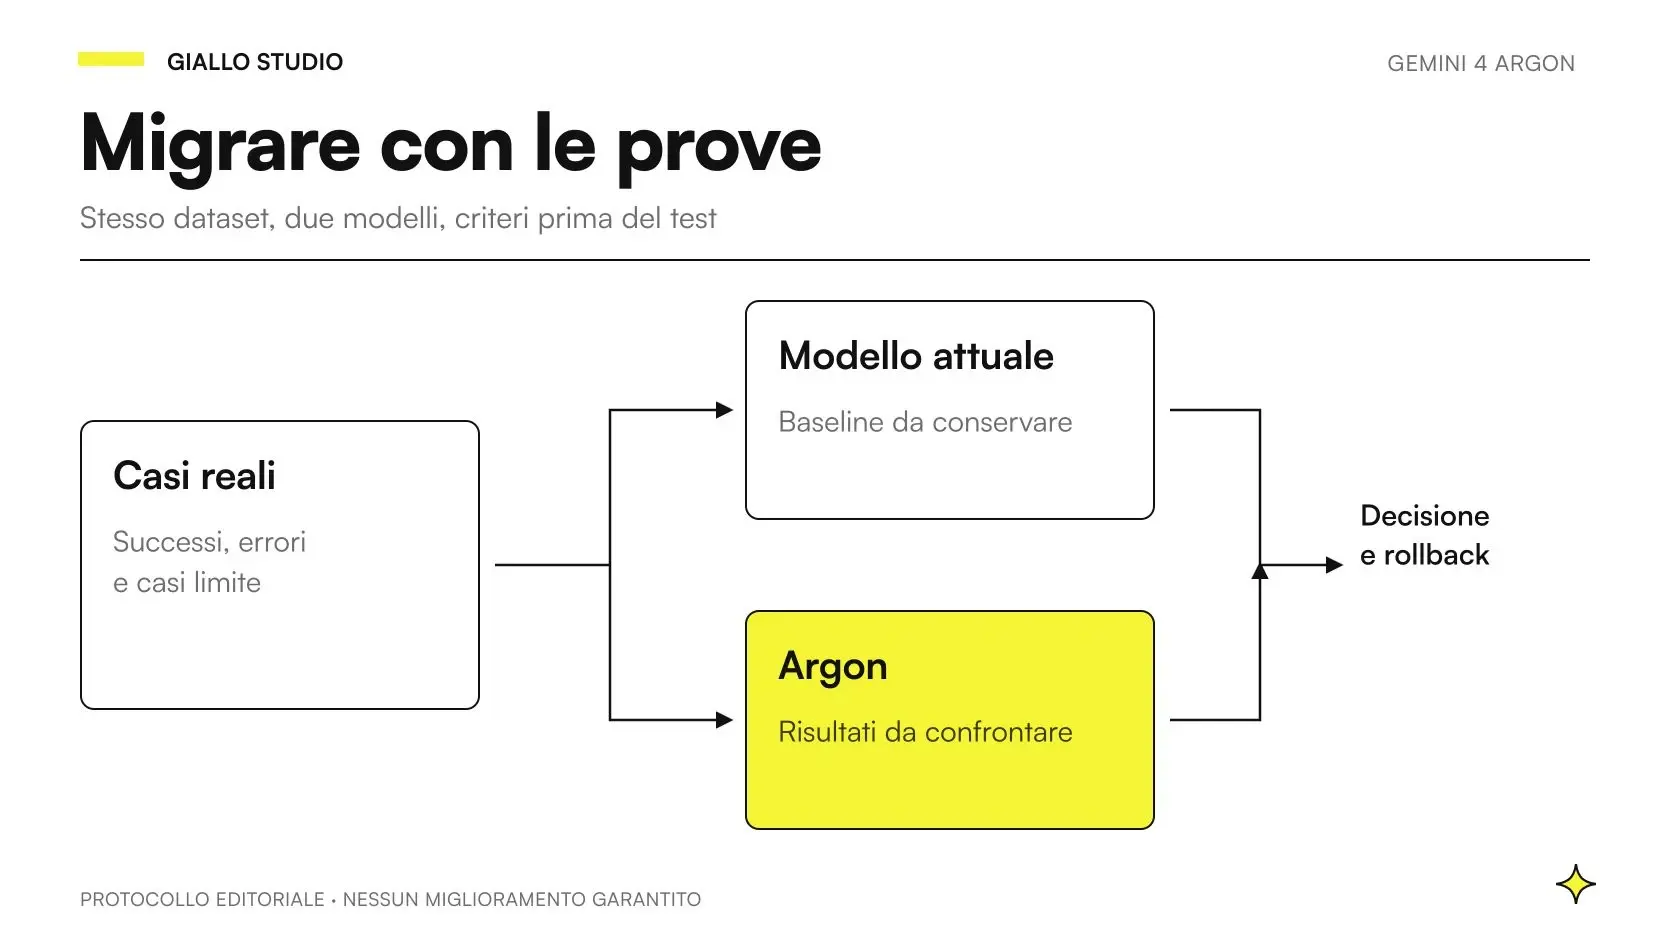 Migrare a Gemini 4 Argon: valutazione, test e rollback
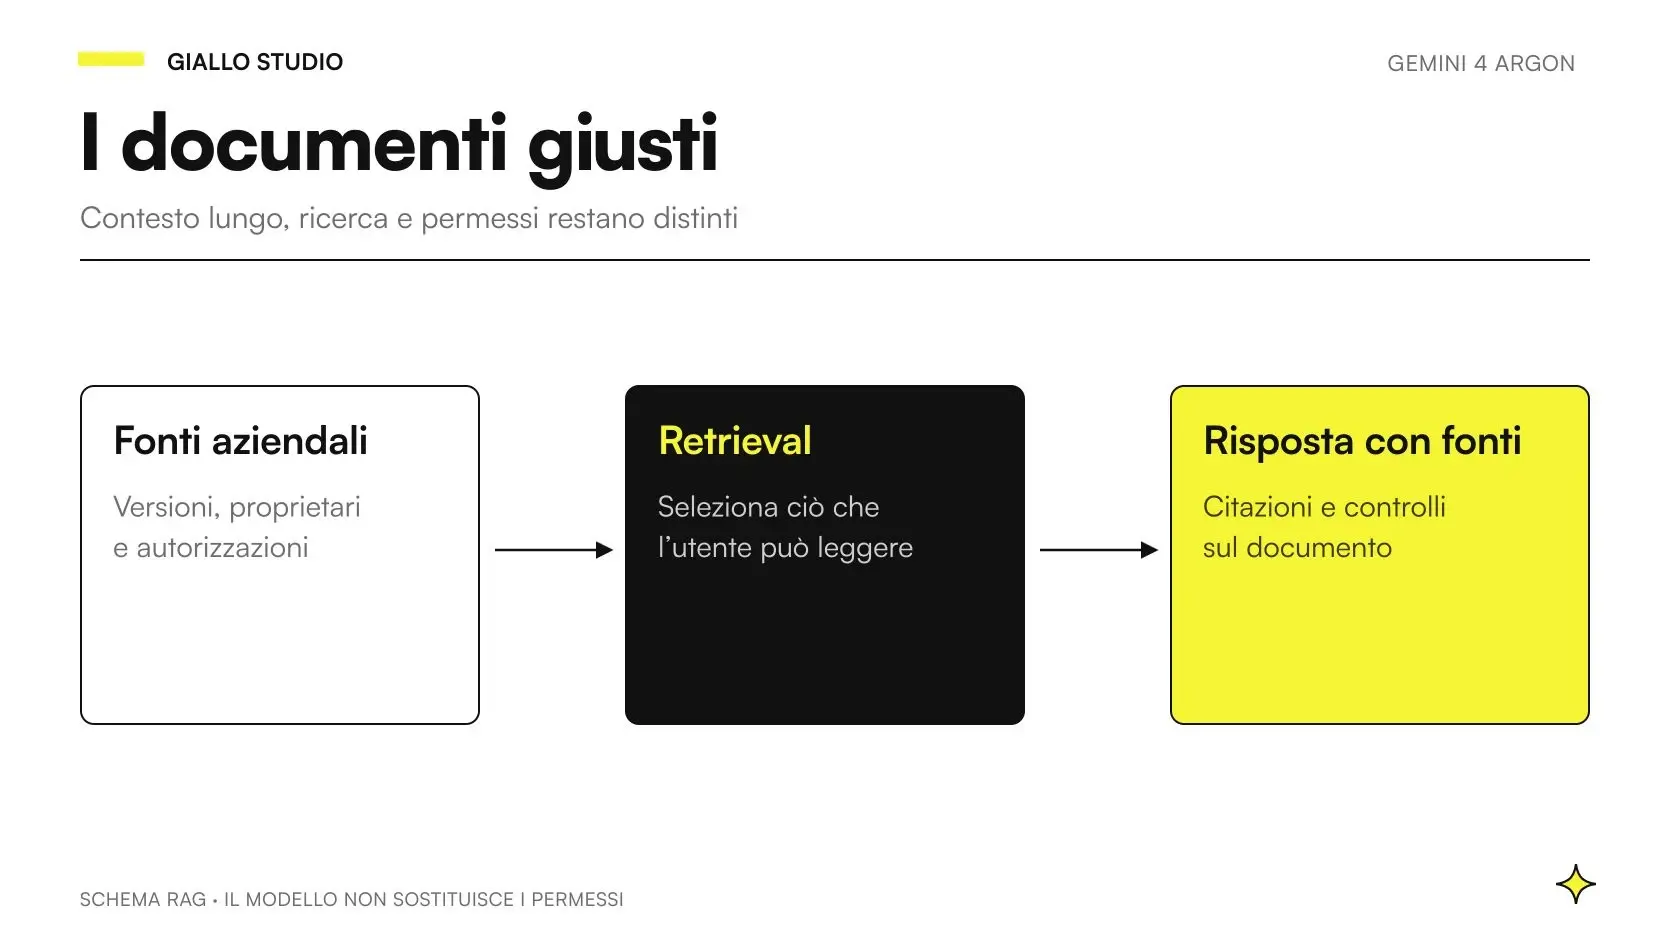 Gemini 4 Argon per RAG e documenti aziendali: fonti e permessi
 Gemini 4 Argon: prezzi API e calcolo dei costi aziendali
 Migliore AI per programmare
FAQ
Gemini 4 Argon è primo in tutti i benchmark?
No. Nella raccolta Google di ottobre 2026 Argon supera GPT-6 Astra su DeepSWE 1.1, ma resta sotto su FrontierSWE v2. La classifica dipende inoltre da versione, strumenti, impostazioni di ragionamento e trattamento dei rifiuti.
Qual è il risultato Argon nel Vals Index aggiornato?
Nel Vals Index v2.2 aggiornato il 22 ottobre 2026 Argon ha 69,24%, dietro Sonnet 5.5 e Opus 5.5 nella classifica principale. Contando come fallimenti i casi Claude risolti con fallback, Argon risulta invece davanti a quei due modelli. Il protocollo va dichiarato insieme al punteggio.
Il 69,24% Vals indica il lavoro aziendale automatizzabile?
No. È un aggregato di accuratezza su attività di finanza, codice, diritto e fisco con pesi legati al PIL statunitense. Non è una misura di produttività, ROI o correttezza sul diritto italiano.
DeepSWE e FrontierSWE si possono sommare?
No. Sono benchmark differenti, con task e protocolli differenti. Una media redazionale produrrebbe un indice nuovo senza una validazione che ne giustifichi l'interpretazione.
GraphWalks dimostra che Argon comprende qualsiasi documento lungo?
No. La prova citata misura F1 su problemi sintetici di visita di grafi. Aiuta a individuare un candidato per test di contesto lungo, ma non sostituisce una verifica su PDF, tabelle e permessi aziendali.
Giallo ha eseguito questi benchmark?
No. L'articolo analizza risultati pubblicati da Google e dalla leaderboard dell'autore Vals, consultati il 23 ottobre 2026. Il piano di valutazione aziendale è una proposta operativa, non il resoconto di un test eseguito.