
Cosa sono i token AI: come si contano e quanto costano (ottobre 2026)
Cosa sono i token AI, con un test in italiano: quante parole fanno 1.000 token, i prezzi per milione di ottobre 2026 e come stimare la spesa.
I token AI sono i pezzi di testo in cui un modello linguistico come ChatGPT, Claude o Gemini spezza tutto quello che legge e scrive: parole intere, frammenti di parola, spazi e punteggiatura. Con i token si misurano due cose concrete: quanto testo il modello regge in una richiesta e quanto si paga usandolo via API.
Una precisazione, visto che la parola è la stessa: qui si parla dei token dei modelli linguistici, non dei token delle criptovalute, che sono gettoni digitali registrati su una blockchain e con l'intelligenza artificiale non c'entrano.
Per l'italiano abbiamo misurato tre testi aziendali con il tokenizer ufficiale di OpenAI: 1.000 token sono stati circa 580 parole. Sotto trovi il test, i prezzi di ottobre 2026 e la formula per stimare la spesa prima di partire.
In sintesi
- Un token è un frammento di testo: le parole brevi e frequenti valgono un token, le altre vengono spezzate in più pezzi.
- Nel nostro test 1.000 token corrispondono a circa 610 parole italiane; la stessa email in inglese ha richiesto un quarto di token in meno.
- La finestra di contesto è il tetto di token per richiesta, risposta compresa: a ottobre 2026 i modelli principali arrivano a circa un milione.
- Via API si pagano a parte i token in ingresso e quelli in uscita, più cari; il ragionamento si paga come uscita.
- La spesa mensile si stima prima: richieste al mese per token a richiesta per prezzo.
Cosa sono i token AI, concretamente
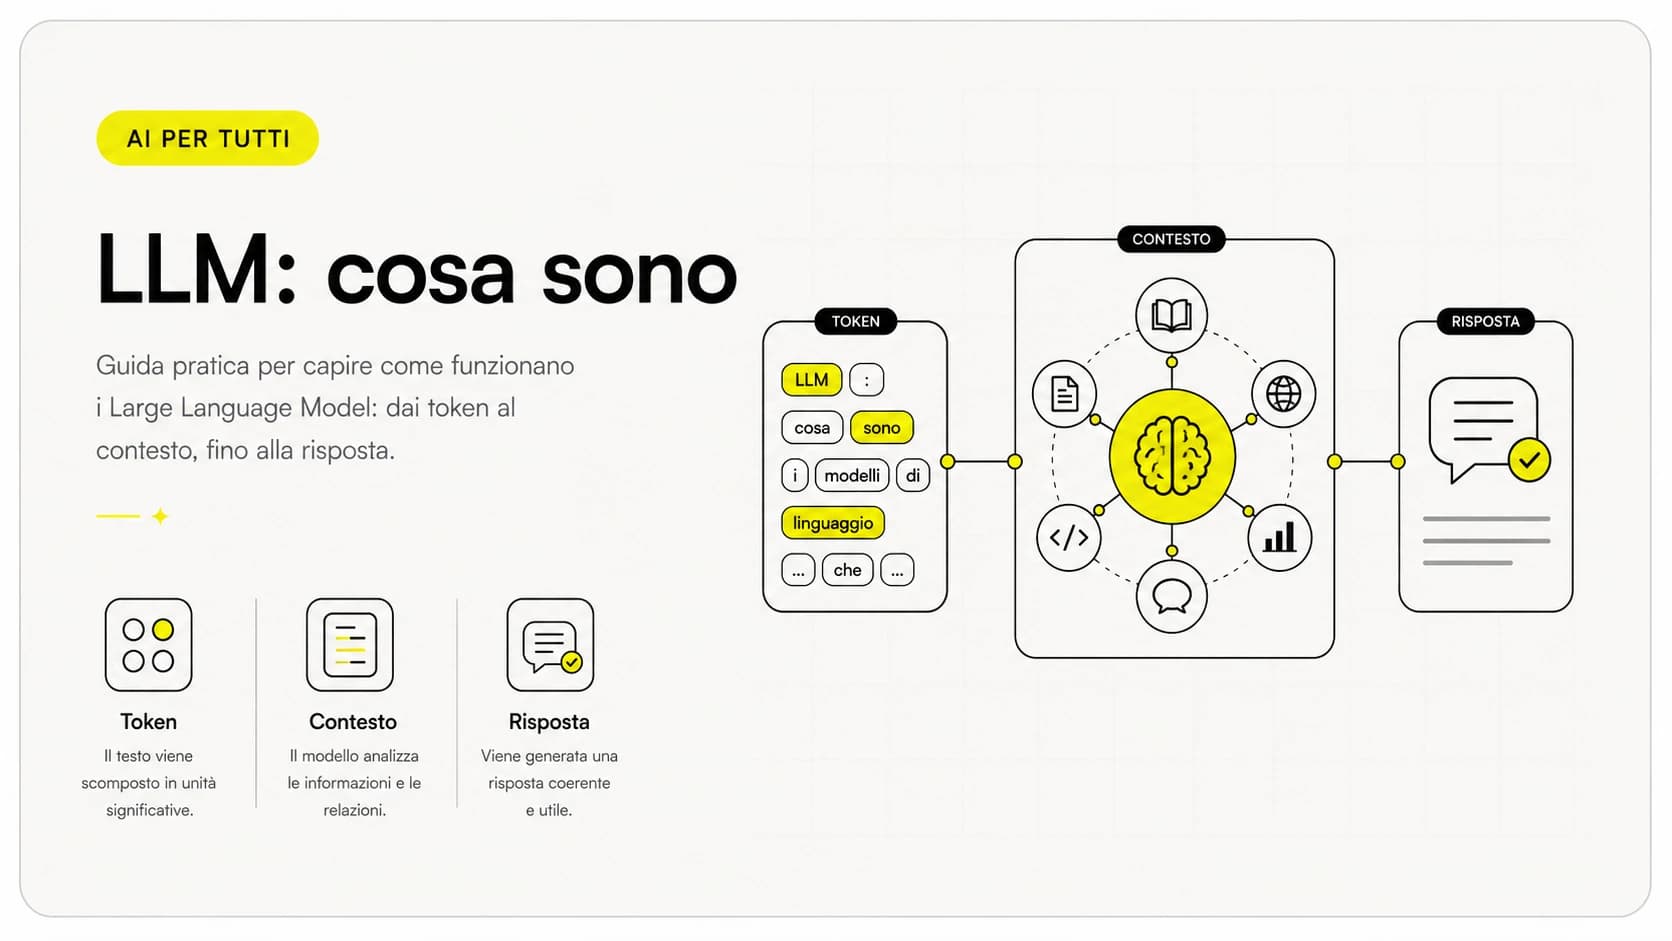
Un modello linguistico non legge lettere né parole. Prima di elaborare un testo lo converte in token, cioè in sequenze di caratteri ricorrenti prese da un vocabolario fisso, ciascuna con un numero che la identifica (pagina del tokenizer OpenAI). Le sequenze molto frequenti diventano un token solo, le altre vengono spezzate.
Un esempio misurato il 3 ottobre 2026 con il tokenizer di OpenAI, impostazione «GPT-5.x & O1/3»:
- Italiano, «Il preventivo aggiornato è in allegato alla fattura.»: 13 token, cioè Il · prevent · ivo · aggiorn · ato · è · in · alleg · ato · alla · fatt · ura e il punto finale.
- Inglese, «The updated quote is attached to the invoice.»: 9 token, uno per parola più il punto.
La lunghezza della parola non basta a prevedere il conto. A metà frase «automaticamente» è un token solo (con la maiuscola a inizio frase diventa due), mentre «Buongiorno» ne vale quattro (Bu · ong · ior · no): pesa quanto spesso una sequenza compariva nei testi usati per costruire il vocabolario.
Ogni famiglia di modelli ha il suo tokenizer: Anthropic, per esempio, scrive che quello introdotto con Claude 4.7 produce circa il 30% di token in più del precedente a parità di testo (prezzi Claude). Anche la risposta nasce un token alla volta, per questo compare a pezzi sullo schermo. Il resto del meccanismo è in cosa sono gli LLM.
Quante parole italiane sono 1.000 token?
Le regole pratiche dei produttori sono scritte per l'inglese. OpenAI indica circa 4 caratteri per token, cioè 100 token per circa 75 parole (tokenizer OpenAI). Google scrive che 100 token valgono 60-80 parole inglesi (token in Gemini). Anthropic dà 0,75 parole per token in inglese e avverte che il conteggio cambia con la lingua (prezzi Claude). Nelle pagine ufficiali che abbiamo consultato nessuno pubblica un valore per l'italiano.
Così abbiamo misurato noi tre testi tipici di una PMI, più la stessa email tradotta in inglese, con il tokenizer di OpenAI (opzione «GPT-5.x & O1/3») il 3 ottobre 2026.
| Testo di prova | Parole | Token | Token ogni 100 parole | Parole ogni 1.000 token |
|---|---|---|---|---|
| Email a un cliente su un contratto di manutenzione | 123 | 199 | 162 | 618 |
| Scheda prodotto di un e-commerce | 95 | 165 | 174 | 576 |
| Clausola di riservatezza di un contratto | 99 | 153 | 155 | 647 |
| Totale dei tre testi italiani | 317 | 517 | 163 | 613 |
| La stessa email in inglese | 127 | 148 | 117 | 858 |
Tre letture pratiche. In italiano 1.000 token valgono fra 575 e 650 parole, a seconda del tipo di testo. Per passare dalle parole ai token basta moltiplicare le parole per 1,6-1,7. E la stessa email è costata 199 token in italiano contro 148 in inglese, il 34% in più: le parole italiane, più lunghe e piene di desinenze, vengono spezzate più spesso (conteggio con il tokenizer OpenAI).
Restano stime, perché Claude e Gemini usano tokenizer diversi. Per un preventivo vero conta i token con lo strumento del fornitore scelto: l'API di conteggio di Anthropic (finestre di contesto Claude) o le funzioni descritte da Google nella pagina citata sopra.
Cos'è la finestra di contesto (e perché conta)
La finestra di contesto è il numero massimo di token che un modello considera in una singola richiesta: istruzioni, messaggi precedenti, documenti e immagini allegati e risposta, ragionamento compreso (finestre di contesto Claude). Se l'ingresso supera da solo il limite, l'API rifiuta la richiesta con l'errore «prompt is too long»; le app di chat possono invece far uscire dalla finestra le parti più vecchie della conversazione.
| Modelli, ottobre 2026 | Finestra di contesto | Risposta massima | Fonte |
|---|---|---|---|
| GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna | 1.050.000 token | 128.000 token | Modelli OpenAI |
| Claude Fable 5.1, Opus 5.5, Sonnet 5.5 | 1.000.000 token | 128.000 token | Modelli Claude |
| Claude Haiku 4.5 | 200.000 token | 64.000 token | Modelli Claude |
| Gemini 3.1 Pro (anteprima), Gemini 3.8 Flash | 1.048.576 token | 65.536 token | Gemini 3.1 Pro, Gemini 3.8 Flash |
Un milione di token è tanto: Anthropic lo stima in circa 555.000 parole con il suo tokenizer attuale (modelli Claude). Anche immagini e audio diventano token: Gemini conta 258 token per un'immagine fino a 384 pixel di lato e 32 token per ogni secondo di audio (token in Gemini), mentre per Claude una foto da 1000 per 1000 pixel vale 1.296 token (visione in Claude).
Riempire la finestra però non è gratis né sempre utile: Anthropic avverte che, con il crescere dei token, precisione e capacità di richiamare i dettagli peggiorano, un fenomeno che chiama context rot (finestre di contesto). Quanto contesto serve davvero è il tema di finestra di contesto: quanto conta davvero.
Come i token determinano il costo delle API AI
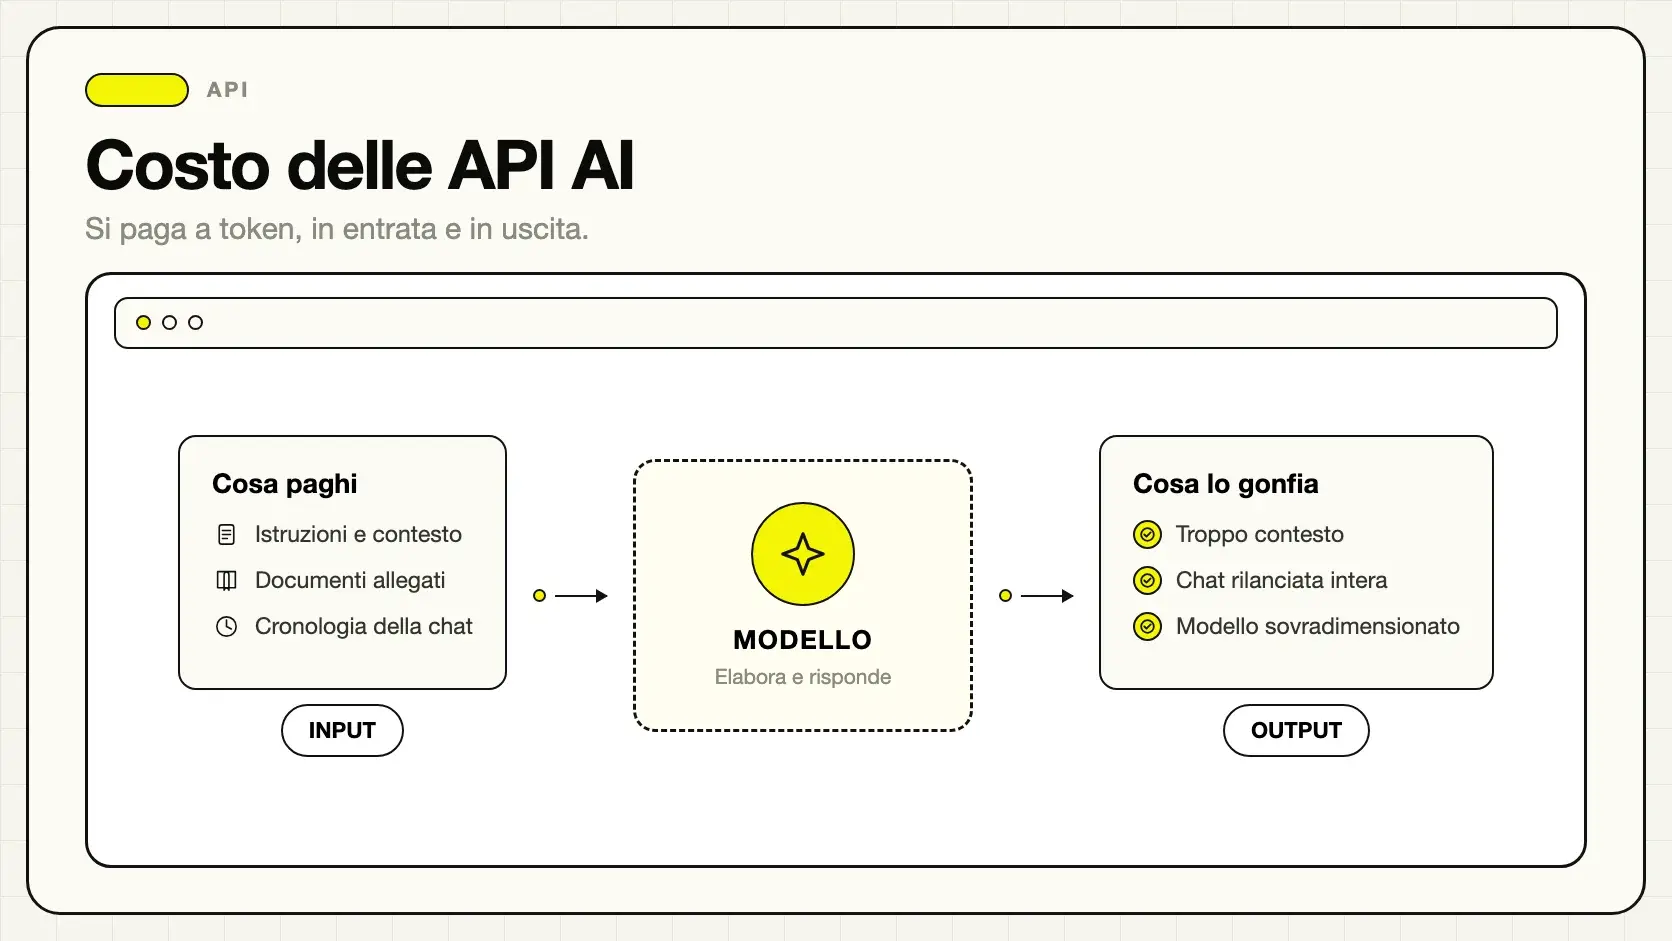
Quando un modello lavora dentro un software, un'automazione o un agente, si paga a consumo con due tariffe: i token in ingresso (istruzioni, domanda, documenti, cronologia) e i token in uscita (la risposta), che costano cinque o sei volte tanto. Il meccanismo, voce per voce, è in prezzo per milione di token spiegato.
Prezzi in dollari per milione di token, verificati sulle pagine ufficiali il 3 ottobre 2026: sono quelli della guida alla migliore intelligenza artificiale, più tre modelli economici.
| Modello | Ingresso | Uscita | Contesto lungo |
|---|---|---|---|
| GPT-6 Astra (OpenAI) | 10 $ | 50 $ | oltre 272.000 token: 20 $ / 75 $ |
| GPT-6.1 Sol (OpenAI) | 2 $ | 10 $ | oltre 272.000 token: 4 $ / 15 $ |
| GPT-6 Luna (OpenAI) | 0,10 $ | 0,50 $ | oltre 272.000 token: 0,20 $ / 0,75 $ |
| Claude Fable 5.1 (Anthropic) | 10 $ | 50 $ | stesso prezzo fino a 1 milione |
| Claude Opus 5.5 (Anthropic) | 4 $ | 20 $ | stesso prezzo fino a 1 milione |
| Claude Sonnet 5.5 (Anthropic) | 2 $ | 10 $ | stesso prezzo fino a 1 milione |
| Claude Haiku 4.5 (Anthropic) | 1 $ | 5 $ | finestra da 200.000 token |
| Gemini 3.1 Pro, anteprima (Google) | 2 $ | 12 $ | oltre 200.000 token: 4 $ / 18 $ |
| Gemini 3.8 Flash (Google) | 0,75 $ | 3,75 $ | fino al 31 dicembre 2026, poi 1,50 $ / 7,50 $ |
Fonti: prezzi OpenAI, prezzi Claude, prezzi Gemini API. I listini cambiano spesso: prima di un preventivo verifica la pagina ufficiale. Prezzi e cache di GPT-6 Sol, la versione precedente di 6.1 Sol, e di GPT-6 Luna sono in prezzi GPT-6 Sol e Luna.
Tre dettagli spostano il conto più del listino:
- Il ragionamento si paga come uscita, sia da OpenAI sia da Anthropic, anche quando non lo vedi (OpenAI, Anthropic); su Opus 5.5 è sempre attivo e si regola con lo sforzo, come spiega la guida ai livelli di ragionamento di Opus 5.5.
- La cache costa molto meno. Su Claude rileggere dalla cache un testo già inviato costa il 10% del prezzo di ingresso su Sonnet 5.5 e Haiku 4.5, il 5% su Opus 5.5 e il 2,5% su Fable 5.1 (prezzi Claude); su GPT-6.1 Sol 0,10 $ invece di 2 $ (prezzi OpenAI).
- I lavori non urgenti costano la metà: OpenAI e Anthropic scontano del 50% le elaborazioni in batch, con risultati in differita (stesse pagine prezzi).
Come si stima il costo di un caso PMI?
La formula è una sola:
costo al mese = richieste al mese × (token in ingresso × prezzo ingresso + token in uscita × prezzo uscita) ÷ 1.000.000
Prendiamo un esempio: un distributore di ricambi riceve 3.000 email al mese all'indirizzo commerciale e vuole che l'AI le smisti (ordine, reclamo, richiesta di preventivo) e prepari una bozza di risposta. Ipotesi: 1.000 token in ingresso per email, di cui 600 di istruzioni e 400 di messaggio, e 200 token di risposta. In un mese fanno 3 milioni di token in ingresso e 600.000 in uscita.
| Modello | Ingresso, 3 milioni di token | Uscita, 600.000 token | Totale al mese |
|---|---|---|---|
| GPT-6 Luna | 0,30 $ | 0,30 $ | 0,60 $ |
| Gemini 3.8 Flash | 2,25 $ | 2,25 $ | 4,50 $ |
| Claude Haiku 4.5 | 3 $ | 3 $ | 6 $ |
| GPT-6.1 Sol o Claude Sonnet 5.5 | 6 $ | 6 $ | 12 $ |
| Claude Opus 5.5 | 12 $ | 12 $ | 24 $ |
| GPT-6 Astra o Claude Fable 5.1 | 30 $ | 30 $ | 60 $ |
Il conto dice due cose. Fra il modello più economico e il più caro c'è un fattore cento, quindi la scelta del modello pesa più di qualunque limatura al prompt. E anche nel caso più caro la spesa in token resta contenuta: in un progetto vero di solito pesano di più lo sviluppo, i controlli e il tempo di chi rivede le bozze. Due avvertenze: con i modelli che ragionano l'uscita reale supera i 200 token visibili, e da gennaio 2027 Gemini 3.8 Flash raddoppia il prezzo (prezzi Gemini API).
Per un calcolo più dettagliato, con prove e margini, c'è costo delle API AI: come si calcola davvero; per scegliere il modello di ogni passaggio, miglior modello AI per caso d'uso e la panoramica sui principali modelli AI.
Tre lavori d'ufficio misurati in token
Studio di commercialisti, riassunti di contratti. Un contratto di 10.000 parole, al rapporto medio misurato nel nostro test (circa 1,6 token per parola), vale circa 16.000 token. Riassumerne 200 al mese significa 3,2 milioni di token in ingresso: con Claude Sonnet 5.5 sono 6,40 $ più le risposte. Se un sistema di ricerca passa al modello solo le clausole che servono, diciamo 2.000 token per contratto, l'ingresso scende a 0,80 $. Il metodo si chiama RAG e aiuta anche la qualità, perché il modello legge meno testo irrilevante.
E-commerce, schede prodotto. Per 800 schede da 120 parole servono circa 168.000 token in uscita, a 1,75 token per parola come nella nostra scheda di prova: con Claude Haiku 4.5 sono 0,84 $ in tutto. Qui conta la resa, non la spesa: meglio investire token in una scheda d'esempio ben scritta dentro il prompt, che il modello imita.
Azienda di servizi, assistente clienti in chat. Ogni nuovo messaggio rimanda al modello tutta la cronologia (finestre di contesto Claude). Con istruzioni da 1.500 token e 300 token in più a ogni scambio, la decima richiesta parte da 4.500 token e la conversazione intera ne consuma 31.500, non i 18.000 che verrebbero moltiplicando la prima per dieci. Su Claude Sonnet 5.5 le istruzioni rilette dalla cache costano un decimo (prezzi Claude).
Il riuso del contesto può cambiare il costo dei token letti, ma occorre misurare le letture effettivamente servite dalla cache. La riduzione del prezzo del prompt caching di Claude Sonnet 5.5 riguarda la lettura della cache: input ordinario, scrittura e output restano voci distinte.
Dove si sprecano token senza accorgersene
- Contare le parole invece dei token. Nel nostro test 100 parole italiane valgono da 155 a 174 token: un preventivo fatto sulle parole sottostima la spesa.
- Allegare il documento intero a ogni chiamata. Un PDF da cinquanta pagine rimandato a ogni domanda moltiplica l'ingresso: bastano le pagine pertinenti, o la cache.
- Dimenticare uscita e ragionamento. Sono la parte più cara del conto: un tetto alla lunghezza della risposta (max_tokens nelle API di Anthropic, max_output_tokens in quelle di OpenAI) è il primo risparmio.
- Usare il modello di punta per tutto. Per smistare messaggi conviene provare prima il modello piccolo e salire solo se sbaglia.
- Ignorare le soglie di contesto lungo. Con i modelli GPT-6 oltre 272.000 token in ingresso l'ingresso costa il doppio e l'uscita una volta e mezza, con Gemini 3.1 Pro la soglia è a 200.000 token, mentre Claude mantiene il prezzo standard fino a un milione (prezzi OpenAI, prezzi Gemini API).
Come tenere i token sotto controllo in un progetto aziendale
- Misura venti richieste vere con lo strumento del fornitore: il tokenizer di OpenAI, l'API di conteggio di Claude o quella di Gemini.
- Applica la formula con i prezzi del giorno e aggiungi un margine per i picchi e per il ragionamento.
- Assegna un modello a ogni compito: smistare ed estrarre dati al modello economico, le decisioni delicate a quello di punta.
- Riduci il contesto: solo le parti utili dei documenti, e in cache le istruzioni che non cambiano.
- Controlla il consumo reale nel primo mese: le API riportano i token di ogni risposta, confrontali con la stima.
Per scrivere istruzioni corte che non perdono precisione aiuta il prompt engineering; per capire come un modello entra in un gestionale o in un sito c'è la guida alle API AI.
Per task molto circoscritti, il confronto può includere API dedicate alla decisione. Perplexity Decider per classificare ticket restituisce scelte o punteggi strutturati: la tariffa del modello è solo una parte del costo, insieme a verifiche, errori ed escalation umana.
Il conto da fare prima di collegare un modello
I token decidono quanto testo puoi dare a un modello in una volta e quanto paghi a fine mese. In italiano ne servono più che in inglese, circa 1,7 per parola nel nostro test, e fra un modello e l'altro il prezzo cambia anche di cento volte. Il primo passo di un progetto serio è una stima scritta: volumi, token per richiesta, modello per ogni compito. Costi e priorità di un'adozione più ampia sono nella guida AI per aziende; come gli stessi modelli differiscono in velocità lo spiega tempo al primo token.
Se stai valutando un assistente o un agente e vuoi sapere prima quanto ti costerà ogni mese, Giallo Studio parte proprio da questo calcolo, con i tuoi volumi reali, prima di scrivere una riga di codice.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Token AI: cosa sono e perché pesano su costi e lunghezza delle risposte
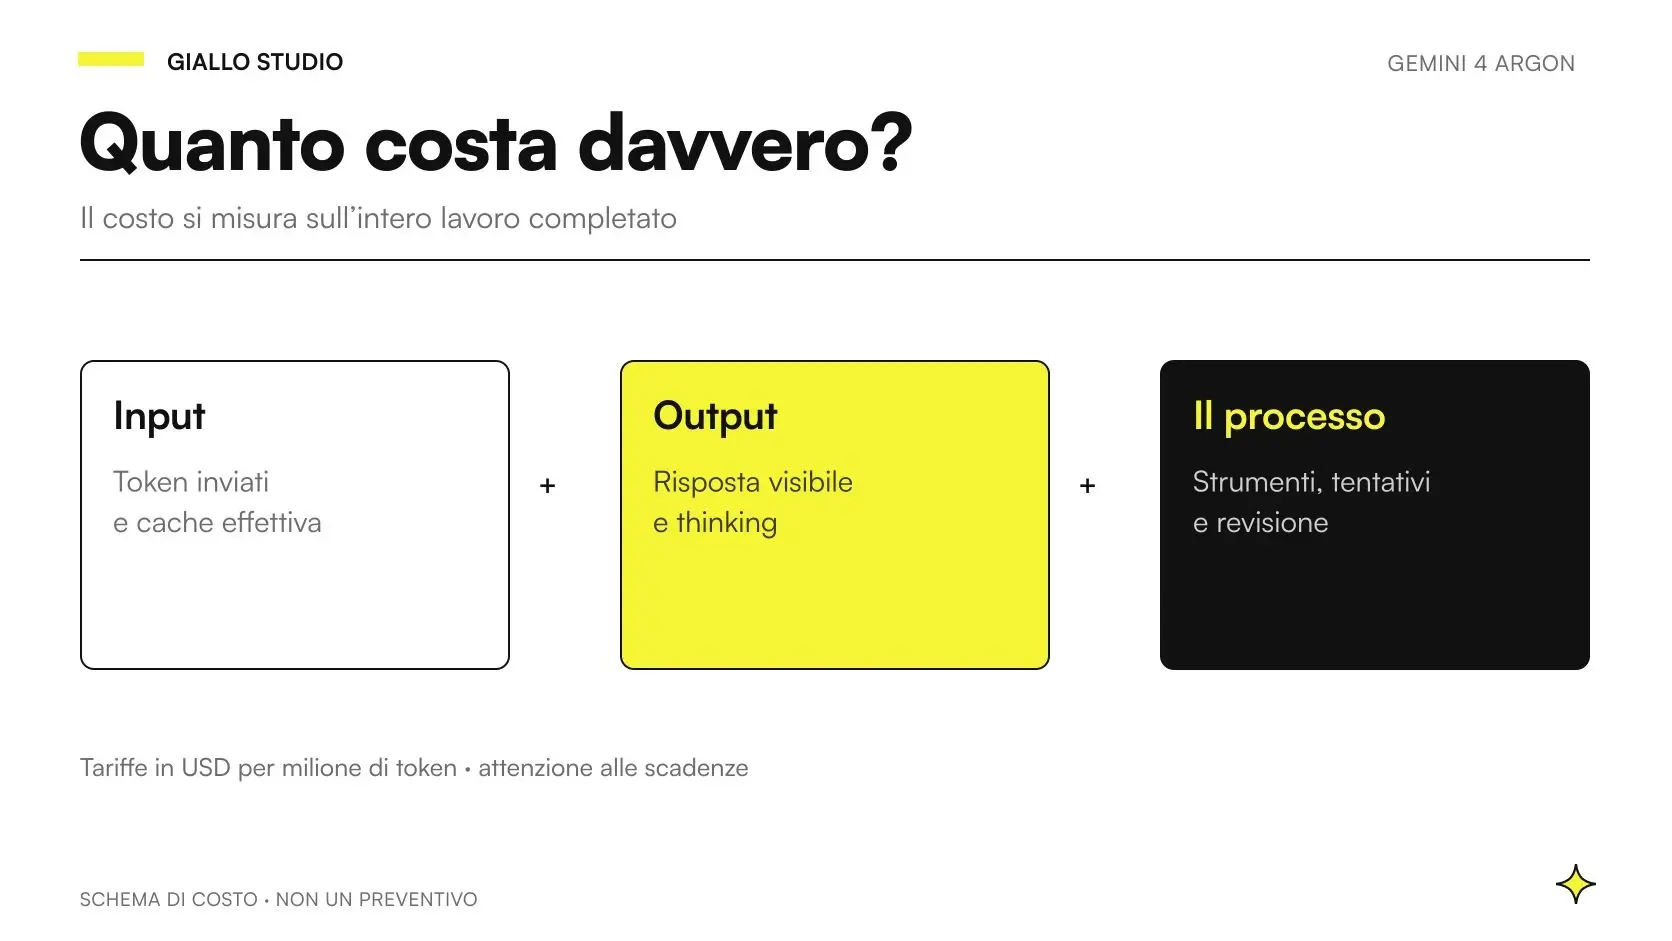 Gemini 4 Argon: prezzi API e calcolo dei costi aziendali
 Prezzo per milione di token spiegato
 Finestra di contesto: quanto conta davvero
 Costo delle API AI: come si calcola davvero
 LLM: cosa sono i modelli linguistici
 API AI: cosa sono e come funzionano
 Prompt engineering: cos'è e come iniziare
 Modelli AI: guida ai principali modelli
 Tempo al primo token: cos'è e perché decide la percezione di velocità
 I livelli di ragionamento di Claude Opus 5.5: cosa sono e quando alzarli
 AI per aziende: guida completa per partire
FAQ
Cosa sono i token AI?
Sono i pezzi di testo in cui un modello linguistico divide quello che legge e scrive: parole intere, frammenti di parola, spazi e punteggiatura. Il modello lavora solo su questi pezzi, uno dopo l'altro. Con i token si misurano sia la quantità di testo che il modello gestisce in una richiesta sia il prezzo delle API.
Quante parole sono 1.000 token in italiano?
Nel test che abbiamo fatto con il tokenizer ufficiale di OpenAI su tre testi aziendali, 1.000 token sono stati fra 576 e 647 parole italiane, circa 610 in media. La stessa email in inglese ha richiesto meno token. Ogni produttore usa un tokenizer diverso: per un preventivo conta i token con lo strumento del fornitore che userai.
Quanto costa un milione di token?
Dipende dal modello e dalla direzione. A ottobre 2026, a prezzo standard, un milione di token in ingresso costa da 0,10 dollari con GPT-6 Luna a 10 dollari con GPT-6 Astra o Claude Fable 5.1, mentre in uscita si arriva a 50 dollari. I listini cambiano spesso, quindi prima di un preventivo va verificata la pagina prezzi ufficiale.
Cos'è la finestra di contesto di un modello AI?
È il numero massimo di token che il modello considera in una singola richiesta: istruzioni, messaggi precedenti, documenti allegati e risposta, ragionamento compreso. A ottobre 2026 i modelli principali di OpenAI, Anthropic e Google arrivano a circa un milione di token. Riempirla tutta costa e può rendere le risposte meno precise.
I token AI sono la stessa cosa dei token delle criptovalute?
No. I token dei modelli linguistici sono unità di testo che misurano il lavoro e il costo di un'intelligenza artificiale. I token delle criptovalute sono gettoni digitali registrati su una blockchain. Hanno in comune solo il nome.
Come si contano i token di un testo?
Il modo più semplice è il tokenizer gratuito di OpenAI: incolli il testo e leggi il numero di token. Per Claude e Gemini il conteggio passa dalle rispettive API. Per una stima al volo su un testo italiano puoi moltiplicare le parole per 1,7, il valore medio del nostro test, sapendo che resta un'approssimazione.
I token contano anche per immagini e audio?
Sì. Nei modelli Gemini un'immagine piccola vale 258 token e l'audio 32 token per ogni secondo, secondo la documentazione di Google. Claude divide le immagini in quadrati da 28 pixel di lato, così una foto da 1000 per 1000 pixel vale 1.296 token. Anche immagini e audio occupano contesto e si pagano.